070|KITTI:把视觉算法放到真正行驶的街道上检验
原论文: Are We Ready for Autonomous Driving? The KITTI Vision Benchmark Suite,Andreas Geiger、Philip Lenz、Raquel Urtasun,CVPR 2012。作者全文。
先接住前作的问题
标定和ICP让多传感器数据可对齐,驾驶视觉仍需要统一测试域。KITTI把采集、标注和评价组合起来。
五个前置概念
理解本文需要的五个概念:
- 视差:双目对应点的水平差,可通过标定转换成深度。
- 端点误差:预测光流向量与参考向量之间的欧氏距离。
- 外参标定:把不同传感器的测量变换到同一坐标框架。
- 相对轨迹漂移:一段估计运动与参考运动的差异。
- AOS:将正确检测与方向相似性结合的评价,而非纯分类准确率。
一、问题设定:道路视觉算法怎样在统一真实输入上暴露失效
实验室中表现很好的立体匹配、光流与定位算法,到了高速移动、弱纹理道路、反光车身和遮挡场景,还可靠吗?KITTI没有提出一个包办自动驾驶的新算法,而是把这个问题变成公开数据上的统一实验。
研究背景与问题定义
这是数据集与基准论文,不是强化学习控制论文。它没有学习油门、刹车或转向策略,也没有用交通奖励优化驾驶回报。任务输出分别是视差、光流、相机运动、目标框与朝向,车辆只是采集平台。
当时常用视觉基准规模较小,许多图像具有较好的纹理、较低运动幅度或受控环境。算法可能在这种分布上形成有效但脆弱的假设。例如前平行表面近似,在道路斜面和建筑立面上容易出错;多尺度光流依赖粗层有可追踪纹理,高速行驶的大位移可能使其失效。
2012论文使用两个彩色和两个灰度相机,10 Hz,原始分辨率1392×512;同类左右相机基线约54厘米。Velodyne HDL-64E提供10 Hz扫描,GPS/IMU结合RTK在开阔天空条件下提供厘米级定位。这里的“开阔天空”是条件,不能改写成所有街道无条件小于5厘米误差。
论文各任务的样本集不同。立体与光流选择静态环境片段;里程计选择有高质量定位的长序列;检测朝向则按目标可见性与朝向多样性筛选。不能把一个任务的数据量套到整个KITTI,也不能用后来版本的统计代替本文。
二、构造车载标定、真值与分任务数据划分
1. 先对齐传感器,再谈算法误差
相机间标定使用棋盘格和重投影优化。激光到相机注册采用半自动方法,包含少量人工对应及误差优化。GPS/IMU到激光的变换转化为手眼标定问题:同一运动在两个坐标系下应满足一致关系。车辆运动还用于补偿扫描期间的自运动,避免把移动扫描当同一时刻拍下的点云。
值得注意的是,激光到相机标定还利用当时优良立体方法的视差异常信息辅助优化。作者将其作为提高真值质量的工程方法;本文的分析是,这也提醒我们真值构建并非与所有算法假设完全无关,应保留独立几何检查。
2. 用激光生成半稠密真值
将目标帧前后各五帧的点云注册累积、投影到相机,得到更多深度覆盖,再由相机几何生成视差和相邻帧对应。窗户、栅栏等含歧义区域手工剔除,真值不做插值,平均覆盖约50%。
立体几何的教学表达为:
是焦距,是双目基线,是深度,是视差。远处同样一像素的视差误差可能对应更大的深度误差。因此像素阈值是清楚的评测标准,却不直接等于固定的米制危险距离。
静态世界点投影到下一帧能够产生光流真值,这也是静态片段选择的重要原因。本文并未以这一步解决任意动态车辆与行人的真实运动标注。
3. 数据多样性不是随机抽几帧
立体和光流用按图像网格汇总的视差与运动描述做聚类,选代表帧,再去掉不良照明片段。最终为194对训练、195对测试。检测集合则平衡可见目标数量与朝向熵,并避免同一序列进入训练和测试两边。
相邻视频帧很相似。如果随机按帧划分,模型可能在训练中见过测试场景几乎相同的邻帧。按序列隔离能够减少这种泄漏,但仍不等于跨城市、天气与季节泛化。
4. 三类指标分别测什么
立体与光流按有效真值像素,统计误差超过阈值的比例。2012论文默认3像素,另考察2到5像素:
是有参考真值的像素;立体的 是视差误差,光流是二维端点欧氏误差。“all”指所有有真值像素,不是整张图每一个像素都被测量。
里程计比较轨迹子段的相对变换。用统一教学记号表示:
分别取平移范数和旋转角,并按子段距离归一化、按距离与速度分组检查。论文式2—3写出相对误差汇总,图 5展示平移百分比和每米旋转角。这样避免单个终点误差依赖“错误发生在早还是晚”。
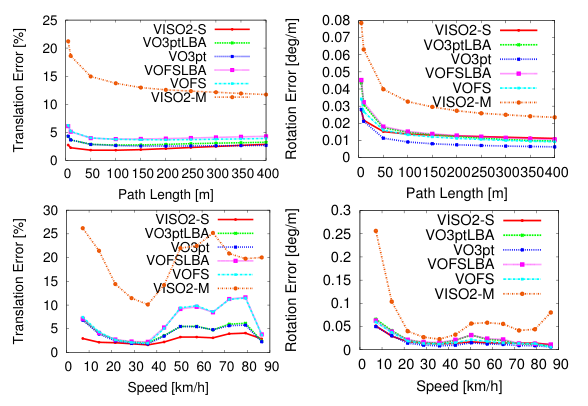
读图:上排按子轨迹长度平均,下排按速度区间平均,单位也不同;不能把不同横轴条件下的百分比与每米角度误差混合。
检测用框重合度与精确率—召回率;朝向用 表示相似性,并对未正确匹配的检测置零,形成AOS。它同时惩罚漏检、错误检测和方向误差,不是只在挑出的正确框上报告角度。
输入:同步车载多传感器记录
完成相机内外参、激光注册和定位坐标转换
为各任务生成真值并剔除无法可靠标注的区域
按任务选择代表样本,按序列隔离训练与测试
冻结评测协议:
    立体/光流:指定有效像素、阈值与无效输出处理
    里程计:比较多个长度与速度的轨迹子段
    检测/朝向:匹配框,计算AP与方向相似性
运行待测方法,保留运行参数和输出密度
汇总均值,同时显示场景、位移、速度上的失效分布
输出:各视觉任务的可比较结果
数学上没有一个统一“自动驾驶损失”。作者改进的是数据采集和评价机制;各待测算法仍优化自己的目标。把基准分数当整个驾驶系统目标,会遗漏预测、规划、交通交互与控制闭环。
真值空白并不是零误差,也不是任意位置都被评分
教学掩膜例:图像100像素,真值只覆盖50个。算法在这50个全对、其余50个全错,官方可评区域误差仍为0;不能因此宣称全图正确率100%。覆盖掩膜本身决定评价问题。KITTI原文为避免人为引入误差,没有把稀疏投影真值任意插值成满图,并人工移除窗口、围栏等歧义区域。原文第2.3节
同样,100米路段终点平移误差1米可写成1%,但若另一路段旋转偏差很大,单个平移百分比不能代表姿态质量。不同长度片段统计能揭示漂移随距离的变化;只在短片段比较可能掩盖长期累计。
本篇把手眼标定及ICP作为传感器对齐和真值生成的模块,和TUM RGB-D构成不同域的平行评价。LOAM等后作可在这里检验里程计,但城市道路成绩不能自然外推到室内楼梯、雨雪或大面积缺测场景。
不同任务需要不同真值和指标,不能把它们合成一个自动驾驶能力分数。下面核对测试划分与有效测量范围,再阅读各类道路失效。
三、固定任务指标和测试协议,检查训练测试隔离
自构例子,未运行。 方法A把远处天空边缘大量像素预测错,但近处车辆位置正确;方法B平均像素更准,却把一辆近处摩托车漏掉。普通平均视觉误差可能更偏爱B,但驾驶风险未必如此。这个例子不是否定平均指标,而是说明任务基准与闭环风险回答不同问题。
再设一辆车走100米产生2米相对位移误差,该段平移归一化误差为2%。如果最后通过回环回到起点,终点误差可能很小,却不代表中间所有位置都准确。对子段评价能揭示这类问题。
阅读范围:核对CVPR 2012全文中采集、标定、真值、指标和四类实验;没有重跑算法或引用后续榜单作为本文结果。上述两个教学例子均未运行。
四、读大位移、弱纹理与遮挡条件下的结果
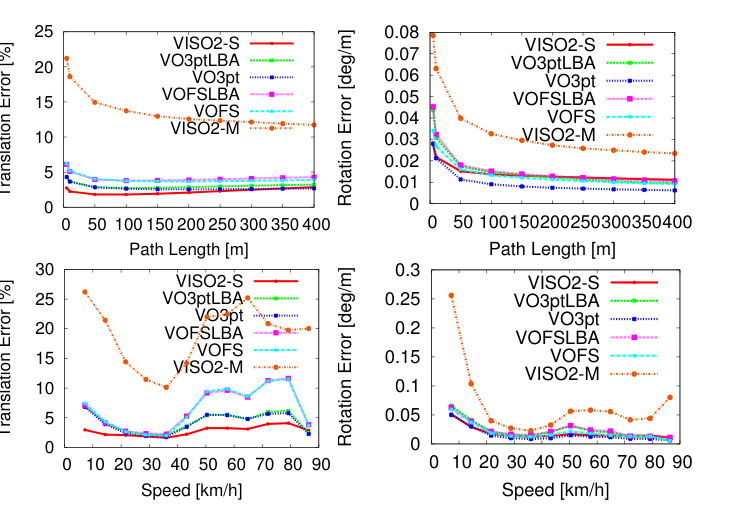
读图:四个面板分别按子段长度和速度统计平移、旋转误差。先看单位,再比较不同速度区间;平移百分比与每米旋转角都不是某个时刻的绝对位置误差。
实验如何验证方法
| 项目 | 2012论文范围 | 所检验的问题 |
|---|---|---|
| 原始采集 | 约3 TB多传感器数据 | 能否从真实行驶中构建多任务参考 |
| 立体/光流 | 静态片段;194训练、195测试对;半稠密真值 | 受控基准优秀方法能否处理道路视觉 |
| 里程计 | 22序列,约41K帧、39.2公里 | 大尺度累计漂移及速度影响 |
| 检测实验 | 文中实验子集12K图像、40K对象 | 检测与方向估计如何联合评价 |
| 立体基线 | 全局、半全局、局部、种子生长方法 | 哪些结构假设在道路失效 |
| 光流基线 | 变分法与局部匹配等 | 大位移和弱纹理的困难 |
| 里程计基线 | VISO2-S/M等;该组不使用回环 | 主要比较局部运动估计漂移 |
| 检测控制 | 朝向分组的部件模型变体;可见性和尺寸限制 | 模型初始化与方向监督的作用 |
这是原始论文协议。其检测示例使用约50%的2D框重叠要求、11点AOS汇总,不能直接混用后来常见的更高IoU阈值、3D检测或更多召回点。表 2是2012年4月2日的结果快照,不代表今天排行榜。
运行参数由作者配套资源提供,但本文没有逐项重新核实所有算法的硬件、时间预算与调参量,因此不从准确率表推导计算效率排名。检测实验只覆盖特定尺寸、遮挡和截断条件,也不能代表所有困难目标。
结果:证据到底有多强
证据1:表 1比较基准结构。 道路里程计数据覆盖39.2公里、多序列,立体与光流有半稠密参考。这说明评测范围扩展,不能说明数据在城市、天气、道路类型上已经无偏。
证据2:表 2的立体结果。 PCBP非遮挡误差4.72%,所有有真值像素6.16%;OCV-SGBM为7.64%与9.13%。这支持不同方法在相同协议下存在差异。作者统一插值无效预测以便比较,同时报告原输出密度;不能把稀疏方法较低输出密度隐藏后只谈误差。
证据3:表 2与图 4的光流困难。 TGV2CENSUS非遮挡错误11.14%,全部有效真值区域18.42%;LDOF为21.86%与31.31%。图 4好坏案例显示,大位移与道路弱纹理是重要困难。个别案例只支持机制诊断,不能证明某个因素是全部误差的唯一原因。
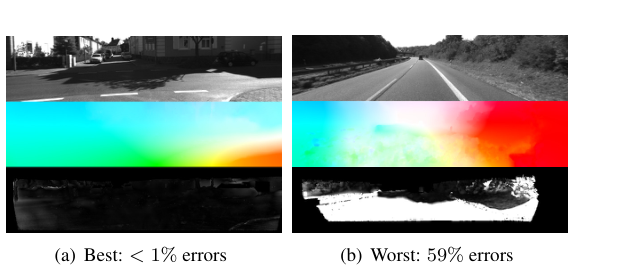
读图:把原始道路影像、流场与错误区域一起看,才能辨认弱纹理和大位移困难。
证据4:图 5及§3.3的里程计。 VISO2-S在该组比较中平均平移误差2.2%,旋转误差0.016度/米。车辆10 Hz采集下相邻帧可移动到约2.8米,高速阶段尤其困难;低速也可能因持续漂移出现较大相对误差。这不是整车绝对位置始终误差2.2%,也不是启用了回环的完整SLAM排名。
证据5:图 6与表 3的朝向。 不同部件模型变体没有显著清晰的总体差异;在裁剪目标的方向任务中,分类SVM相似性0.93,最近邻0.85,回归GP0.92。0.93是余弦型方向相似性,不是93%检测准确率,更不是道路驾驶成功率。
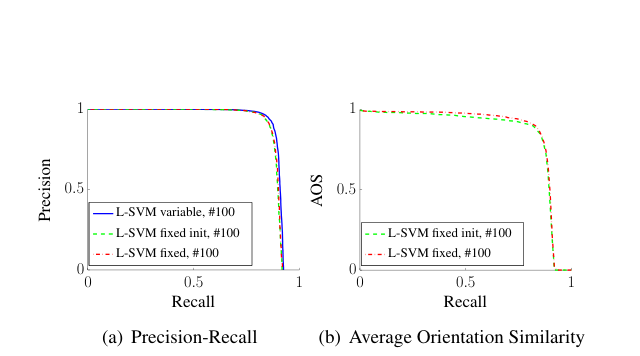
读图:朝向相似性与检测精度是两个指标,纵轴含义不可混为准确率。
作者据此认为更真实的基准揭示了已有方法的限制。实验支持“既有榜单表现不能直接迁移到这组道路数据”,并不支持“所有算法在现实中都无效”或“只要更多训练数据就一定解决”。
五、保留真值覆盖、静态假设与闭环驾驶边界
真正新意是以车载物理测量支撑多个视觉任务,并把应用失效因素纳入评价。数据筛选、标定、真值生成和工具同样构成研究贡献,而不是算法论文的附属劳动。
代价包括昂贵传感器、精细标定、人工剔除歧义区域与3D目标标注。真值是有覆盖掩码和条件的参考,不是每个像素都知道答案。累积点云依赖注册,定位精度依赖接收条件,静态片段不代表动态交通。
本文的进一步分析是:删去照明困难片段有助于可靠标注,也缩小了测试边界;以图像准确率评价自动驾驶,无法说明规划器对少量关键误检的容忍程度;反复针对同一公开基准调参会改变其泛化意义。应结合新场景及闭环测试,而不是把一张视觉排行榜当安全论证。
六、追问:只比较所有像素的平均误差,怎样会掩盖道路任务的具体失效?
只比较所有像素的平均误差,怎样会掩盖道路任务的具体失效?
参考答案:弱纹理、大位移、反光和遮挡样本可能只占部分区域,却决定应用难度。应按论文相应任务与有效真值范围解释结果,保留分场景或分条件证据。平均感知误差也不包含闭环动作后的安全后果。
七、把道路基准用于里程计并对照飞行域
- 模块组合:LOAM:用两种速度处理同一片点云。解释激光里程计成绩时核对输入传感器、运动补偿与真值范围。
- 平行路线:EuRoC:一张定位成绩表背后,真值是怎样产生的。比较另一运动域的基准设计,而不是直接移植难度排名。
八、自测与参考答案
问题1:KITTI表中的“all pixels”是否意味着天空等每个像素都有真值?
答案:不是。它是所有存在参考真值的像素,区别于非遮挡子集。激光投影后的真值平均覆盖约一半,歧义区域还会剔除。评价范围必须跟随有效掩码,不能把它理解成完美稠密真值。
问题2:为什么不把视频随机拆成训练帧和测试帧?
答案:邻帧共享背景、对象和视角,随机拆分会让测试接近训练样本,夸大泛化。按序列隔离减少这种近重复泄漏,但若同一路段或同类天气仍大量重合,跨地域泛化还需要另设测试。
问题3:2.2%的里程计平移误差能否证明自动驾驶已经可用?
答案:不能。这是指定视觉里程计方法在给定数据与子段评价下的运动估计指标,既不覆盖全部瞬时大错,也不评价行人检测、预测、规划和控制。自动驾驶可用性必须在完整闭环任务及相应风险条件下验证。