079|Informed RRT*:已有一条路之后,还值得搜索哪里
论文:Jonathan D. Gammell、Siddhartha S. Srinivasa、Timothy D. Barfoot,Informed RRT: Optimal Sampling-based Path Planning Focused via Direct Sampling of an Admissible Ellipsoidal Heuristic*,IROS 2014。论文记录 · 作者论文存档。
先接住前作的问题
RRT*能渐近改进路径,但有首解后仍可能把大量采样花在无关区域。本篇以可采纳长度下界直接采样可能改进的椭球。
五个前置概念
五个前置概念:
- 可采纳启发式:不会高估真实最优代价的估计。
- 当前可行解上界:已找到路径的代价,是最优值的上界。
- 渐近最优:样本不断增加时趋向最优,不承诺固定时间达到。
- 重连:用新节点改善旧节点的父路径及累计代价。
- 同伦类:在不穿过障碍的连续变形下可以互相变成的路径类别。
一、问题设定:已有首解后怎样只采可能改进路径的区域
假如已经找到一条长 10 米的路,为了寻找更短的路,还需要在整座城市里继续撒随机点吗?某些位置即便没有障碍,从起点经过它再到终点也要走 20 米,显然不可能帮助改进当前解。
背景与问题定义
这是无学习的采样规划。输入是自由空间、起点、目标、碰撞检测器和路径代价;输出是逐渐改善的可行路径。树中保存的累计路径长度不是强化学习中的状态价值函数,也没有奖励驱动的参数更新。
RRT* 的典型步骤包括采样、扩展、选择较优父节点和重新连接邻居。它的优势是能逐步改善解;不足是单一查询往往仍为大量无关位置付出搜索成本。
本文不解决环境未知时的探索,也没有直接处理动力学输入约束。关节空间、非欧氏姿态空间和时间最优控制问题需要相应度量与下界,不能把二维椭圆图原封不动搬过去。
第一个可行解出现之前,当前上界为无穷大,算法仍需要在原问题空间探索。因而它的核心优势是改进已有解,而非天然保证更快找到第一条路。
二、由可采纳长度下界构造长旋转椭球
1. 用下界排除不可能有帮助的状态
设当前最好代价为 ,起点和终点为 。对任意中间点 ,定义
根据三角不等式,任何经过 的路线都不可能比这个无障碍折线更短。因此,只有
中的点才有希望参与更优解。这里是必要条件而非充分条件:椭球内部可能有墙,也可能只能经过很长绕路才能到达。
对读者最重要的区别是“可能改进”和“确定改进”。论文的知情集合利用下界形成真实改进区域的外包围,而不是已经求出了障碍环境中的最短路。
2. 为什么是椭球,怎样均匀采样
记 。其长半轴和其余短半轴分别为
以 表示把第一坐标轴旋转到起终点方向的旋转矩阵,则
其中 在单位球体内部均匀分布。线性变换的雅可比行列式是常数,因此保持相对体积的均匀性。这是教学解释,不需要先学完整椭球矩阵分解才能理解。
单位球体内部均匀采样也有陷阱:半径不能直接在 均匀抽取,否则会偏向球心。在 维空间中,可用单位随机方向乘以 ,其中 均匀分布于 。这是补充的实现方法;不要把“球面均匀”和“球内均匀”混淆。
直接采样的收益可以从体积而不是成功动画看出来。若 维单位球体积为 ,知情椭球体积为
当 且正数 很小时,短半轴近似 ,所以体积随 缩小。维数高时,从固定大区域采样再拒绝会浪费得更快;直接椭球采样主要省掉的是这类必无改进希望的候选,碰撞仍须检查。
原创二维例:起终点相距4,已有路径长5,则半轴为2.5、1.5,面积约11.781;若全局采样区域面积100且完整包含椭圆,命中比例约11.8%。路径改进到4.1后,半轴为2.05、0.45,面积约2.898,命中比例降到2.9%。这不是算法每轮成功概率,因为障碍和连接失败还会进一步消耗样本。原稿式(3)的体积关系给的是改善事件的上界,而非实际速度提升常数。
4. 保证的范围
作者说明方法继承 RRT* 的概率保证,但其意义仍然是满足假设并让采样趋于无穷,而非有限时间全局最优。原文的线性收敛分析另有无障碍及足够连接范围条件,不能推广成任意迷宫中的统一收敛速率。
原文 §V-A 对缩小采样区域后的重连半径还包含经验选择及进一步研究的说明。阅读时应把直接椭球采样的几何正确性,与完整规划器的邻域参数、证明条件分别检查。关于 RRT* 原始证明的后续讨论,见本系列第 062 篇,不用一个算法名称代替全部条件。
下界限定的是所有可能改进路线经过的状态,不是现有路线附近。下面直接采样椭球并核对连接,再读高维采样预算的收益。
三、直接采样并连接,检查区域不等于当前路径细管
初始化以起点为根的树,当前最好代价设为无穷大
循环直到达到时间或迭代预算:
    如果尚无可行解:从原状态空间采样
    否则:
        由起终点与当前最好代价计算椭球
        从单位球内部均匀采样并变换到椭球
        对越出状态空间边界的样本重新采样
    找最近树节点,向样本扩展
    若新边碰撞:跳过
    在合法邻居中选择累计代价最小的父节点
    加入新节点,对能够降低代价的邻居重新连边
    维护受影响子树的累计代价
    若形成更好的目标路径:更新当前最好代价
返回当前最好可行路径以及是否找到解
这是教学流程,保留必要的碰撞和代价维护步骤,不替代原文算法的所有邻域参数。不能通过删除碰撞检查来“充分利用椭球”,也不能将旧树累计代价当作到达某点的理论下界;旧树路径是一个上界,可能排除尚未发现的捷径。
自构算例与前置知识
自构例子,未运行。 起点为 、终点为 ,已有路径长 10。则 ;点 的两段直线距离恰好为 10,位于边界。已有解改善到 8 后,,搜索区域缩小。若墙在中间,椭球内部的点仍可能不可通行,因此仍须碰撞检查。
四、读采样效率与最终代价,核对证明版本
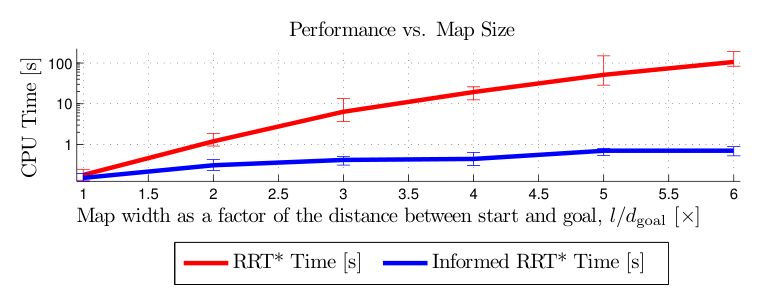
读图:随着问题空间尺度扩大,红色 RRT* 与蓝色 Informed RRT* 达到目标质量所需的中位时间增长不同。目标是最优代价 2% 范围,不能把达到容差写成有限时间精确最优。
实验如何验证
改善椭球来自当前已知解的成本上界;出现首解前没有这个有限集合,因此优化曲线的优势不自动变成首次解优势。
| 项目 | 原文设置与解释 |
|---|---|
| 任务 | 人工障碍、狭窄通道、不同范围及不同维度的随机环境 |
| 对照 | RRT*;共享基础实现以减少工程差异 |
| 随机性 | 每种变化进行 100 次运行,配对使用相同随机种子和地图 |
| 停止条件 | 部分任务达到相对最优代价阈值停止;随机世界给初始解之后的改进分配时间 |
| 时间预算 | 随机世界的改进窗口为 60 秒;不是强化学习环境交互量 |
| 平台 | Ubuntu 12.04、Intel i5-2500K、8 GB RAM,见 §VI 脚注 |
| 指标 | 路径代价、达到目标质量所需时间或迭代、跨运行分布 |
| 额外信息 | 已知几何与可查询碰撞检测器;不存在示范、奖励模型或神经网络预训练 |
同一随机种子不代表两个算法后续访问同样状态,因为样本变换和树结构会分化。它减少环境和随机源差异,却不等于逐次碰撞调用严格一一对应。
五组证据
- 图 6:搜索范围。 相同展示时刻,两棵树覆盖的区域不同。它直观说明计算集中位置,但单个案例不能替代随机统计。
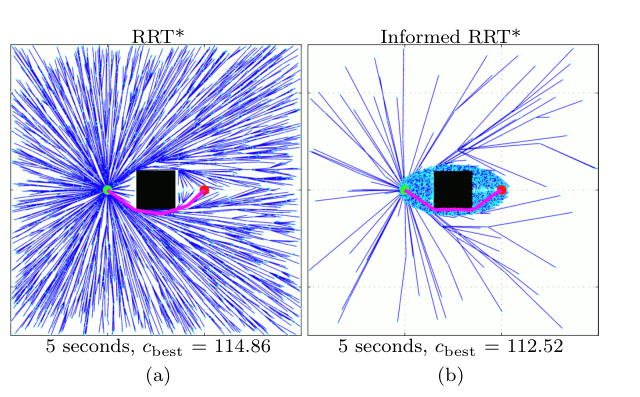
读图:同为五秒,右侧树更集中于可改进当前路径的区域;树形差异体现采样聚焦,但单幅案例不代替统计实验。
- 图 7:另一条通路。 狭窄通道的展示案例中,新方法用 4.00 秒找到对应路线,RRT* 为 12.32 秒。这是案例数值,不是全部任务的平均加速比;它说明聚焦并非锁死在原路径同伦类。
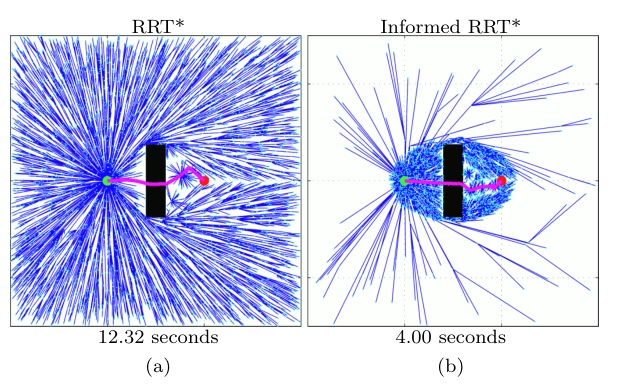
读图:图下注明12.32秒与4.00秒,这是一组示例;右图仍可寻找不同通路,聚焦并不意味着固定在原路径类别。
图 8:地图变大。 比较到达最优代价附近目标质量的成本,支持在这类设置下减少对外围无关空间的依赖。目标阈值为最优代价的 2% 范围,不能换成“精确最优”。
图 9、10:精度与窄通道。 分别改变目标容差和通道几何,检验后期改进及切换路线的能力。图的 CPU 时间轴必须与正文中的迭代解释区分,少迭代不自动等于相同比例时间节省。
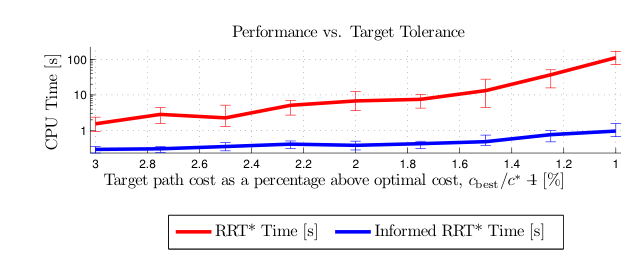
读图:横轴容差收紧时,红色时间曲线上升明显;纵轴衡量CPU时间,不是迭代次数。
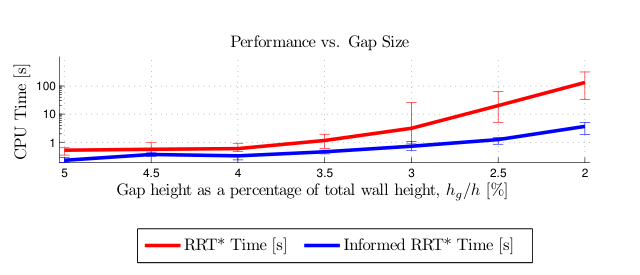
读图:通道变窄时两种方法的计算时间变化不同,误差条提示该趋势来自重复试验而非单条搜索轨迹。
- 图 11:随机环境。 用更复杂与不同维度场景检查趋势,支持超出一个二维例子的有效性。仍未覆盖所有机器人运动学、动力学或真实碰撞检测器成本。
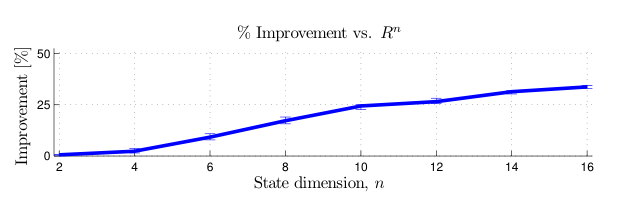
读图:横轴是状态维度,纵轴是改善百分比;这个比较不能直接转换成任意机器人上的固定运行时间加速。
原文部分误差条图注将时间图与“迭代数中位数”的文字并列,本文不据此转录具体置信区间数值。复现实验应从原始运行数据确认统计对象,不能自行修正后当成作者结果。
五、保留障碍、下界有效性与有限预算限制
贡献是一个有效的搜索区域构造及直接采样方案,不是新的碰撞检测器,也不是学习出来的启发式。由于不过高估计的代价下界不会排除潜在更优路径,它可以集中搜索而不强迫沿用当前路线。
我们的分析是:如果障碍很复杂,椭球内部仍可能包含大量无效空间;如果当前解很差,椭球很大,聚焦效果有限;如果主要成本来自复杂碰撞模型,减少无关采样的收益需要实际计时确认。
当当前代价逼近起终点直线距离时,短轴趋近零,数值实现要处理退化情况。更一般的目标还可能不具有椭球形状,例如包含旋转、时间或能耗的代价,需要重新证明启发式的可采纳性。
六、追问:当前最好路径趋近起终点直线距离时,椭球短轴会怎样变化?
当前最好路径趋近起终点直线距离时,椭球短轴会怎样变化?
参考答案:对欧氏长度目标,记当前解长为 ,起终点距离为 ,长半轴为 ,其余半轴为 。当 ,短轴趋于零:仍有改善可能的区域收缩。这是本文几何条件内的推导;有障碍时可行最优未必接近 ,也不能由区域变小推断固定时间必有改进。
七、继续安排采样图中的候选边顺序
- 直接继承:BIT*:让随机采样按照值得尝试的顺序进行搜索。在启发采样之外,继续安排候选边的验证顺序。
八、自测与参考答案
问题 1:椭球内部的点为什么不一定能改善路径?
答案: 两段欧氏距离忽略障碍,只给真实路径长度的下界。下界小于当前解只表示尚不能排除这个点;它可能位于障碍内,也可能需要很长绕行才能到达。
问题 2:为什么不能围绕当前路径只采样一个很窄的管道?
答案: 那样可能排除不同绕障方向的更短路线。可采纳启发式的集合包含所有可能改进的路线所需状态,其形状由代价下界决定,不由当前路径形状决定。
问题 3:第一条路径出现前和之后,算法的工作方式有什么根本区别?
答案: 出现前没有有限代价上界,无法据此形成有限的改进椭球,只能继续一般探索;出现后用已知上界收缩采样范围,每次改善又更新区域。优势主要来自后续优化,不能因此宣称首次解必然更快。