091|CBF-QP:把安全边界写进控制器
论文:Aaron D. Ames、Xiangru Xu、Jessy W. Grizzle、Paulo Tabuada,Control Barrier Function Based Quadratic Programs for Safety Critical Systems,2016 年预印本,2017 年期刊发表。原文 v2 · 版本记录与 PDF。
先接住前作的问题
人工势场通过代价引导避障,但一个低代价方向本身不是集合不变性证明;CBF-QP将安全改写为允许输入集合,并与性能目标组合。
五个前置概念
理解本篇的五个前置概念:
- 正向不变集:从集合内出发的闭环轨迹始终留在集合内。
- Lie 导数:函数沿某个动力学方向的变化率。
- 控制 Lyapunov 函数:用可实现的下降条件表达稳定或趋近目标。
- 相对阶:输出求导多少次后控制输入才显式出现。
- 二次规划:以二次目标和线性约束选择当前控制输入的优化问题。
一、问题设定:性能目标怎样在安全集合边界主动退让
一辆跟车行驶的汽车希望达到设定车速,但前车减速时,这个愿望必须让位于保持车距。把“快一点”和“离远一点”放进同一个加权代价,可能得到一个折中答案:车速很好,却稍微违反了安全距离。对安全约束而言,这种折中未必可接受。
问题定义:需要守住的是状态集合
考虑控制仿射系统:
状态 可以包括车速、相对距离、横向偏移;控制 可以是驱动力或转向相关输入。这里没有强化学习意义的奖励、采样回合和终止奖励,研究对象是连续反馈控制。
用可微函数 定义安全集合:
正向不变性意味着:只要从 内出发,闭环轨迹就一直留在其中。它不同于“最终会回到安全区”,也不同于“有限次测试没有出事”。
难点有三个。首先,朝目标前进的控制可能把系统推向边界。其次,执行器有极限:距离虽然暂时为正,制动能力却可能已经不足。最后,分别设计的控制器不一定能直接叠加,叠加后可能同时破坏原来的性质。
论文不是首次提出控制屏障函数;引言明确讨论前人工作和作者自己的会议版本。这篇工作的重点是屏障条件、两类构造的关系,以及它们与性能控制的统一。
二、把屏障导数变成允许控制集合
2.1 为什么不能要求安全裕量一直增加
若强制 ,车辆可能永远不能缩短车距,即使当前离前车很远。安全集合内部也被限制得过紧。
零化屏障函数采用的条件是:
其中 ,; 是适当的扩展类 函数,常见教学选择为 ,。
当 时,右侧为负,允许裕量下降;到 时,条件退化为 ,阻止向不安全方向穿越边界。这是“尽量少干预”的来源,但不代表对所有性能指标都最少干预。
对于线性选择, 给出比较关系 。这段教学推导说明初始非负裕量为何不会变负;严谨结论还需要闭环解存在以及论文中的正则性条件。
2.2 另一种屏障为什么会趋于无穷
倒数型屏障 在靠近安全边界时趋于无穷。它通过限制 的增长控制接近边界的速度。零化型使用 接近零,倒数型使用 增大,两者表达的几何直觉相通,但定义域、正则性和具体条件不能直接混写。
正文第 II 节和图 1梳理了不同条件之间的关系。不能看到一个任意函数在边界发散,就认为它已经是有效的控制屏障函数;还必须证明存在允许输入满足相应导数约束。
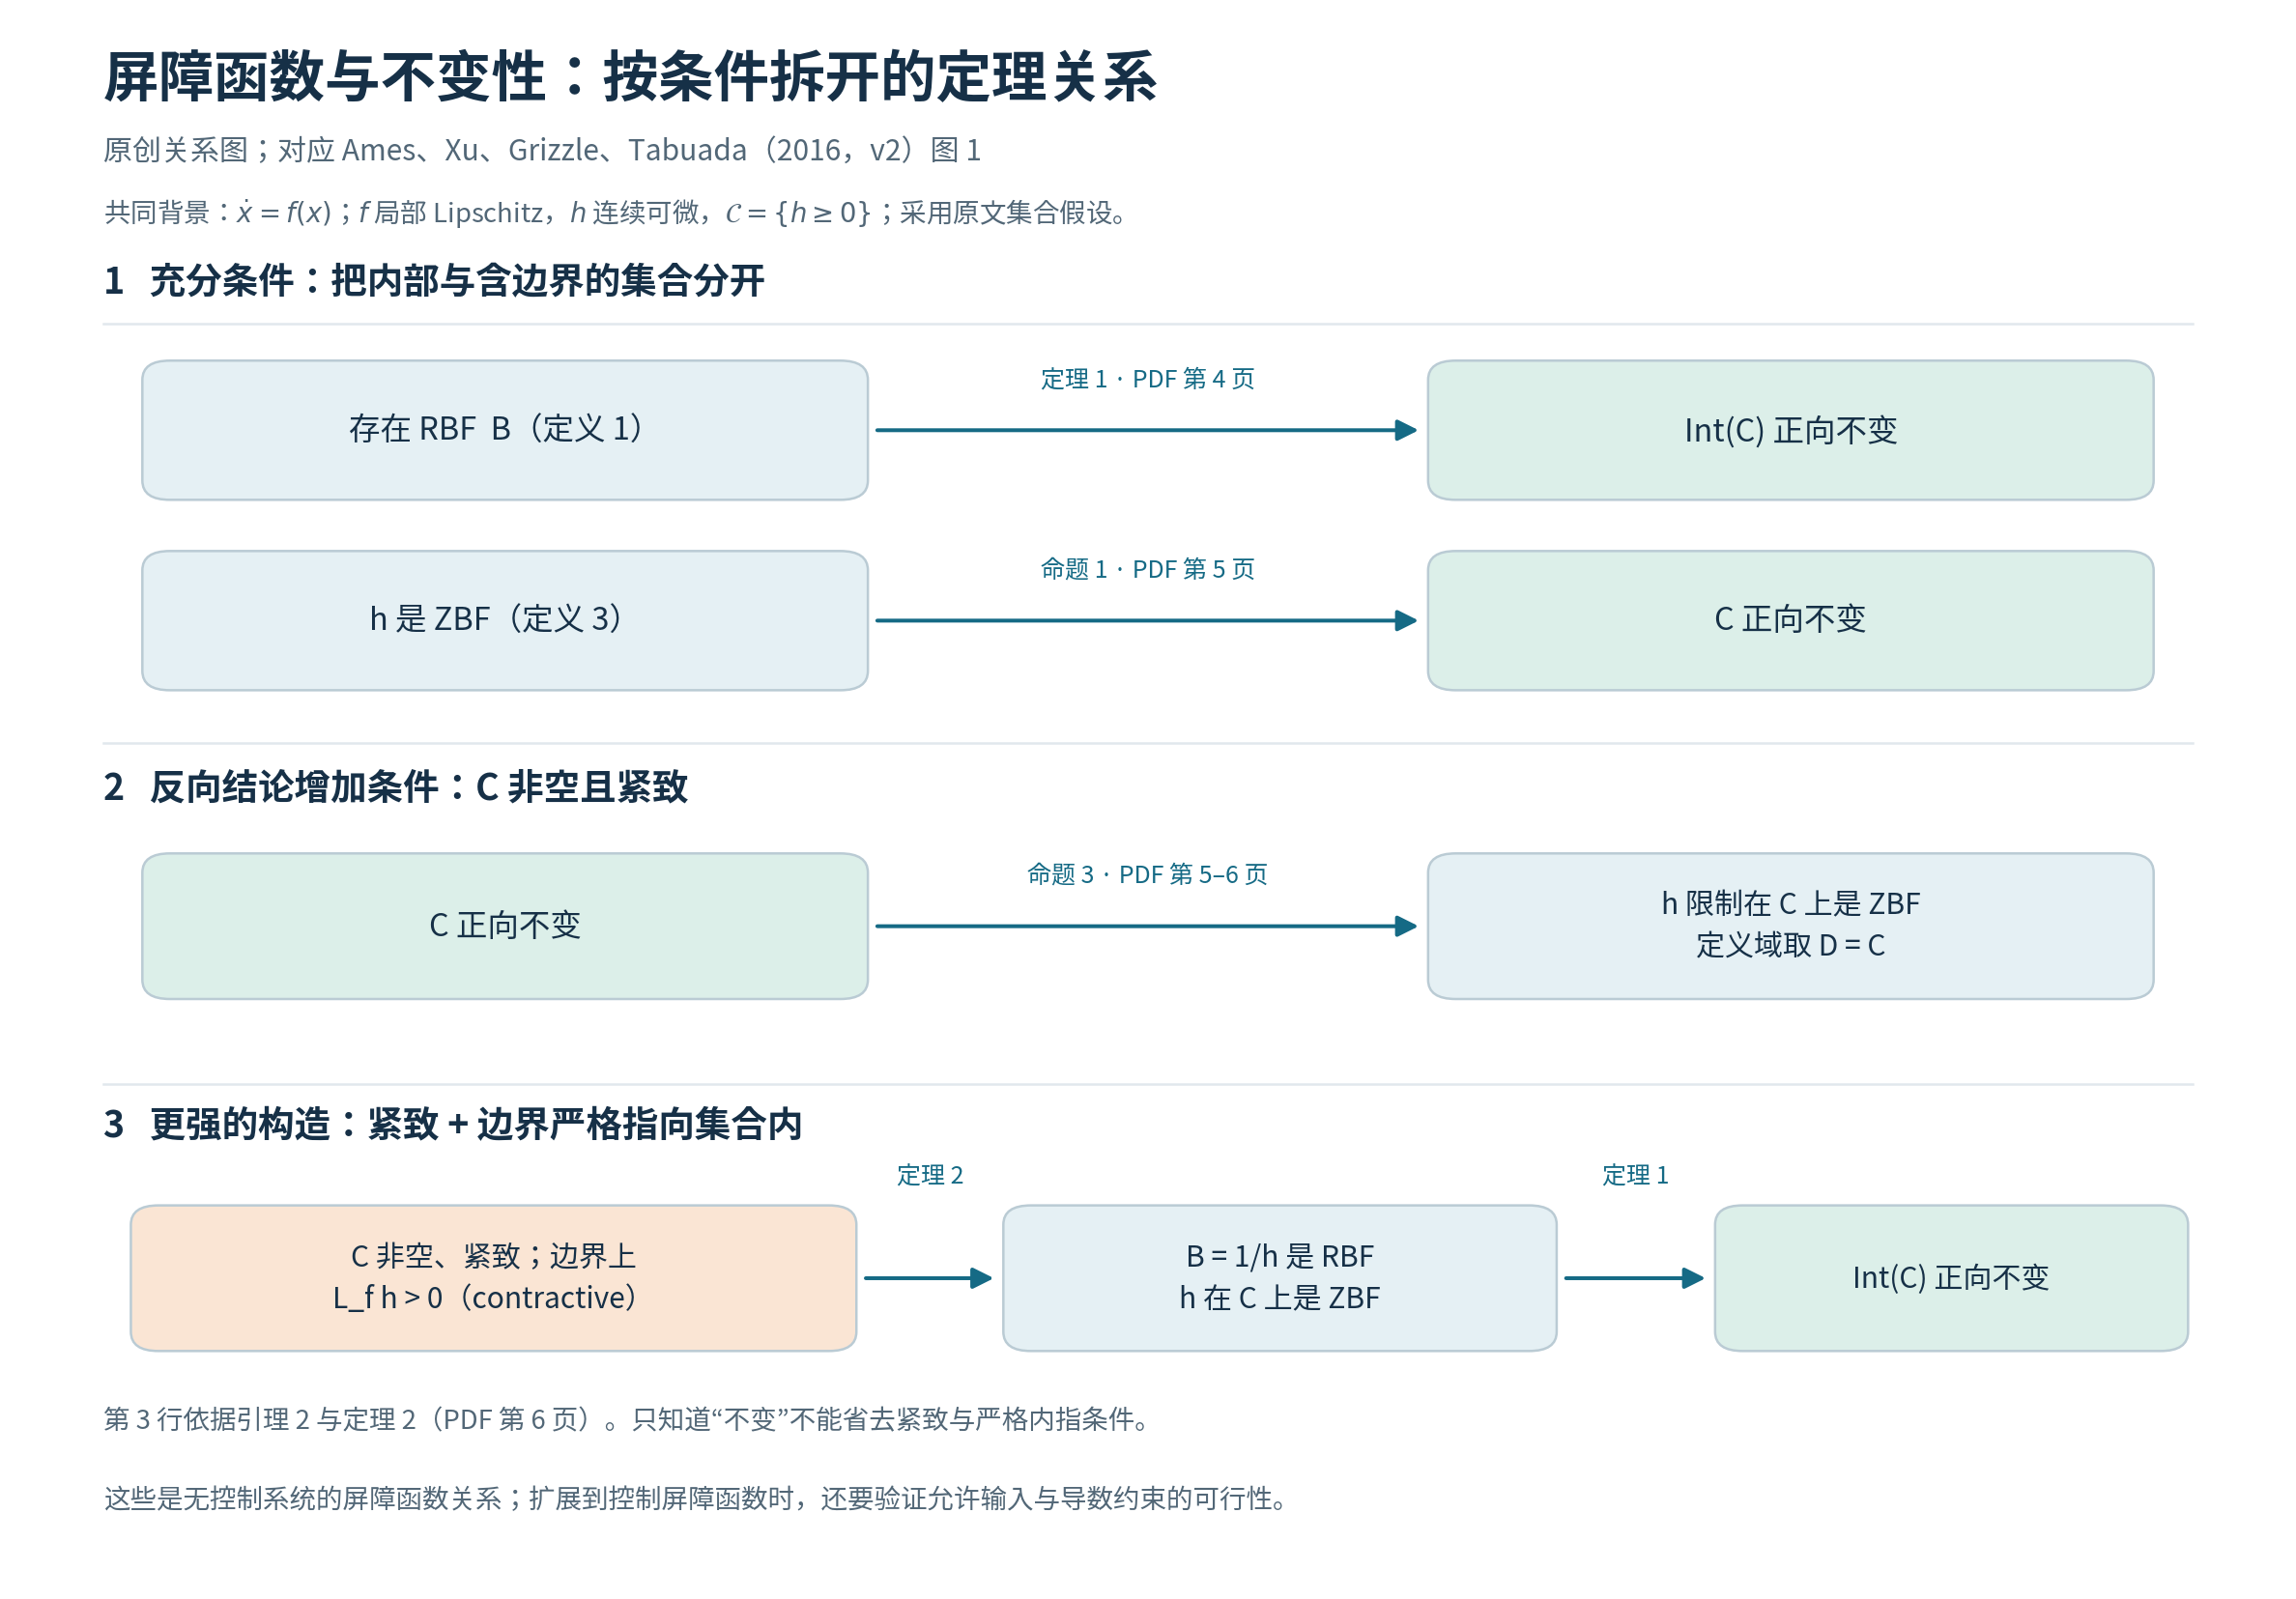
读图:第一组分别给出定理1的RBF充分条件和命题1的ZBF充分条件;第二组增加非空、紧致条件后,以命题3补上ZBF关系的反向结论,且定义域明确取D=C。第三组把原图中紧致且contractive条件下的关系,展开为定理2构造B=1/h及h,再由定理1得到内部正向不变;原图的条件性双向关系不能被读成无条件等价。图按原文定理陈述独立组织,保留Int(C)与C的区别;它尚不是含输入约束系统的可行性保证。
方法:把性能软化,把安全留作硬约束
以下是便于理解的 CLF-CBF-QP 写法,不是逐字复制论文某一应用的代价:
是原本希望执行的输入; 是表达趋近目标的控制 Lyapunov 函数; 允许性能条件暂时不满足; 和 决定偏离名义控制与性能松弛的代价。屏障约束在这个写法里没有松弛量。
目标函数优化的是控制偏差与松弛代价;机制变化是逐时刻限制允许输入;实验观察的是距离、速度、横向偏移与控制力。这三层不应统称为“提高安全奖励”。
最后一行故障处理是工程上必须明确的接口,论文并未提供适用于所有系统的通用安全补救器。直接删除安全约束得到一个输入,不会保留原来的安全保证。
一条安全约束如何改变名义输入
暂时去掉 CLF 和输入界,只保留一条 CBF 半空间,可把当前时刻的问题写为 ,约束 。这里 ,,, 为名义输入;以下推导假设 。拉格朗日函数加入 ,驻点给出 ,互补条件进而得到
它是在控制度量 下投影到安全半空间,不是把障碍距离梯度直接当成附加控制力。多个约束和输入界相交时仍需求解整体 QP,这个单约束闭式不能逐条套用并假定最后全满足。
原创手算与采样反例。 系统 、安全函数 、,当前 ,名义输入 。约束为 ,投影得到 。若连续更新,边界激活时闭环为 ,解 保持正值;若把这次输入冻结两秒,真实解却为 ,一秒后越界。QP 在采样瞬间可行,不等于整段零阶保持输入都满足连续时间不等式。
这个反例没有否定论文的连续反馈定理,而是指出离散实现必须另做采样、误差或裕量分析。原文III-B推论2、IV-B定理3与V节输入约束讨论提供的条件也不能被仿真轨迹“看起来安全”替代。
3.1 可行性和解的连续性为什么关键
只松弛性能,不能自动解决安全约束与输入界的冲突。如果汽车刹车距离已经不够,“请保持不碰撞”对应的可行控制可能根本不存在。因此第 V 节针对力约束重新构造可用的安全条件,而不是仅在原 QP 后面机械加一个饱和器。
第 IV 节定理 3 给出特定 CLF-CBF-QP 解局部 Lipschitz 连续的充分条件,包括相应函数的局部 Lipschitz 性、正定代价以及文中相对阶条件。这个结果有助于保证闭环解定义良好;它不是任意多屏障、任意输入限制下的自动结论。
若 ,当前导数中没有控制量,不能套用一阶公式假装已经约束了输入。正文第 III-C 节讨论更高相对阶,实际建模时必须先检查这一点。
安全不等式必须由实际输入满足,性能松弛不能挪用这一责任。下面检查QP可行与执行限幅,再读连续模型下的仿真。
三、求带松弛性能项的QP,检查输入可行性
输入:状态估计 x,动力学 f/g,安全函数 h,性能函数 V,输入界 U
每个控制周期:
    计算名义控制 u_nom
    计算 h、V 及其 Lie 导数
    用性能松弛变量构造 CLF 约束
    构造硬 CBF 约束与执行器约束
    求解二次规划
    若可行:应用控制 u,并监测下一周期状态
    若不可行:报告假设或约束冲突,转入经过验证的故障处理
输出:满足当前模型约束的输入
一个可以手算的例子
自构例子,未运行:一维系统 ,要求 ,选 、。当前 ,名义控制想执行 ,屏障条件要求 。若只最小化与名义输入的平方偏差,QP 会选 。
系统仍然朝边界移动,但接近速度受限。若连续重复计算,边界不会被有限时间穿过;若长时间保持旧输入却不重新计算,这个推导就不能直接使用。这个例子也显示:屏障不是把机器人永久推离边界的斥力。
四、读巡航与车道仿真,保留连续模型条件
图里可以读出什么
图 1。 各种屏障条件与不变性关系;方法依赖明确的数学条件链;不能据此推出:任何手写距离函数都有效。
图 2 与图 4。 未充分处理力界与纳入力界的巡航控制;制动限制会改变安全控制设计与跟随行为;不能据此推出:单纯给控制结果截幅仍保留证明。
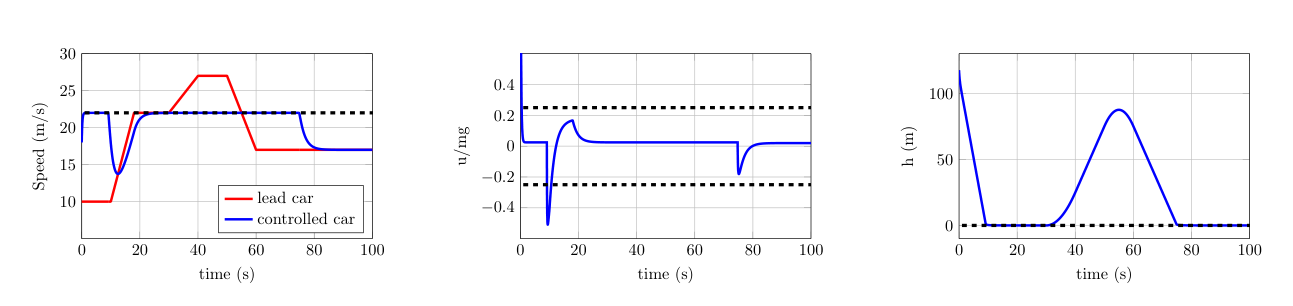
读图:左图比较速度跟踪,中图检查输入界,右图以安全约束量的非负性表示满足约束;三个指标需联合阅读。
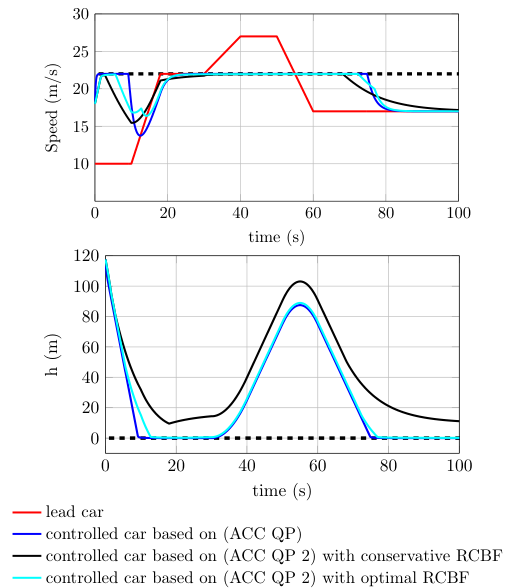
读图:上图读跟踪性能,下图检查间距与安全边界;相近的速度轨迹可能对应不同的安全余量。
图 5。 倒数型与零化型屏障的输入轨迹;本例中可见平滑程度等行为差异;不能据此推出:零化型在所有系统中都更平滑。
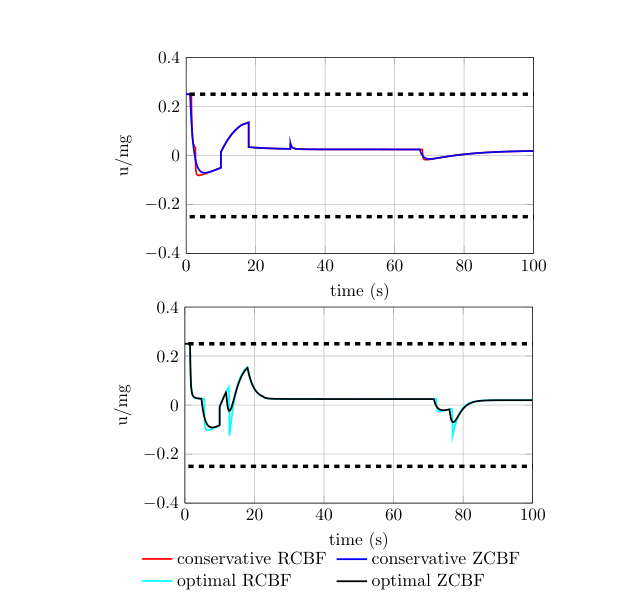
读图:上下面板分别采用保守和优化约束,输入曲线形状与速度/距离不同;在所示设置中更平滑的输入不是对任意扰动的统一保证。
图 6。 车道保持中的状态和控制约束;给定仿真满足设定边界;不能据此推出:对感知失效和未知路况的保证。
作者对图 5 中平滑差异的原因使用带保留的解释;将其归因于某类 Lipschitz 性质的讨论,应当作为作者的分析,而不是已经通过广泛消融证明的普遍规律。
这类论文的证据强度不能只看图中有没有越界。理论回答“条件成立时为什么不会越界”;仿真回答“在选定模型中,控制行为是否合理”。若模型不符,后者不能替代前者缺失的假设。
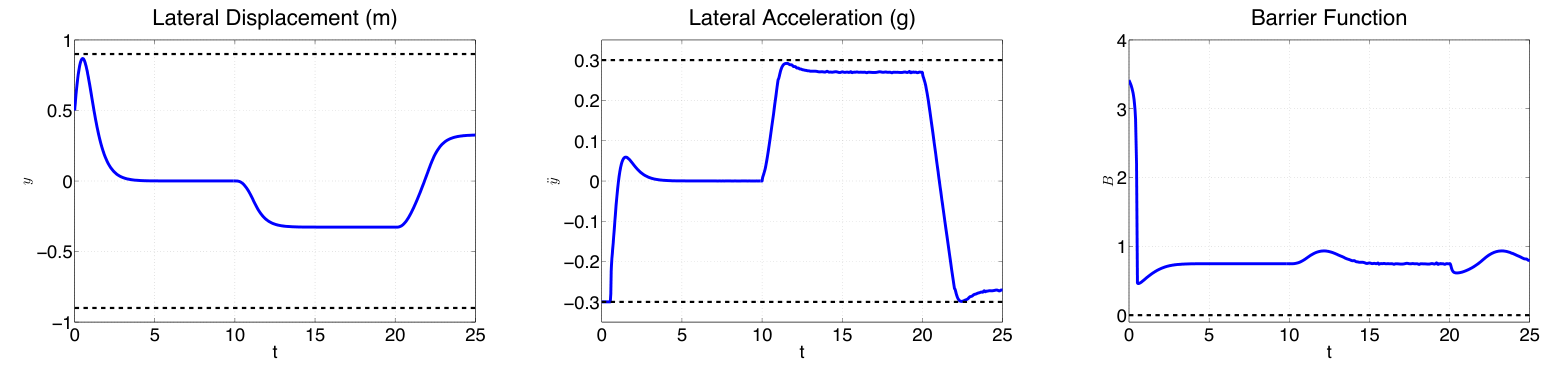
读图:三面板一起检查横向位置、加速度与屏障函数:控制量受限时状态仍保持在模型规定的安全区域。它是给定模型的仿真,不包含感知失效或未知附着条件。
车辆图都是给定模型与初值下的仿真;连续时间屏障证明还要求输入可行和实现条件,不能把有限曲线当作真实道路安全认证。
证据主体是第 VI 节的仿真。正文 Remark 14 提到相关会议工作的实体平台实现,不能把那部分外部证据当作本篇完整实车测试。
| 项目 | 设置与证据位置 | 验证意图 | 解释边界 |
|---|---|---|---|
| 自适应巡航 | 第 V-A、VI-A 节;车辆纵向模型、变化的前车速度 | 跟踪目标与车距约束冲突时如何协调 | 模型仿真,不是开放道路事故率 |
| 输入限制 | 第 V-A3、V-A4、VI-B 节 | 把有限制动力纳入屏障设计 | 不同屏障的允许集合可能不同 |
| 两类屏障 | 第 VI-C 节、图 5 | 比较输入与跟随行为 | 有限案例不足以给出通用优劣 |
| 车道保持 | 第 V-B、VI-D 节;名义控制与屏障约束结合 | 约束横向运动与横向加速度 | 采用给定模型和道路设置 |
| 数据与训练 | 无学习数据集、无策略训练预算 | 在线优化控制 | 不能以样本效率评价 |
| 重复与算力 | 核对的实验节未给出随机种子统计表;实时求解成本未在此统一量化 | 轨迹示例与理论互相补充 | 不能据此断言任意硬件实时可用 |
表 I 给出的示例车辆质量为 1650 kg,巡航期望速度为 22 m/s;车道保持的横向边界为 0.9 m、加速度界为 。这些是实验参数,不是算法普适的推荐参数。
五、检查模型误差、采样延迟与安全初态
真正值得继承的是把“安全集合”和“任务性能”分开表达,并通过对控制输入仿射的约束连接到可解的优化问题。它允许安全边界内部保留自由度,也让执行器限制进入设计讨论。
代价首先是设计工作:怎样找到覆盖实际风险、又不过分保守的屏障函数?其次是可实现性:多个安全要求可能互相冲突。再次是实现误差:状态估计偏差、模型误差、求解容差和采样保持都会影响连续时间推导的落地。
这些并不意味着方法无用,而是说明“有证明”需要连同证明对象一起阅读。碰撞安全、执行器安全、视野限制分别对应不同集合;证明其中一个,不代表覆盖其余两个。
作者在结论中提出继续研究屏障构造及更复杂约束。上述关于离散实现和传感误差的提醒是本文的适用性分析,不冒充本篇已经测试过的失败案例。
六、追问:名义QP可行而执行器实际饱和时,屏障证明的哪项前提需要重查?
名义QP可行而执行器实际饱和时,屏障证明的哪项前提需要重查?
参考答案:证明约束的是被实际施加的控制输入。若执行器截断后输入不再满足屏障不等式,名义解的集合不变性论证不能照搬。应在求解时纳入相应输入范围,并检查离散执行和模型误差;不能只报告QP返回了一个解。
七、区分屏障约束与有限时域接触约束
- 平行路线:Cheetah 凸 MPC:用简化模型提前安排四足机器人的支撑力。有限时域接触力约束与屏障集合约束不同,不自动共享安全证明。
八、自测与参考答案
问题一:安全约束是硬约束,为什么还不能宣称系统绝不会出事?
答案:硬约束只约束优化模型中的输入与状态。结论还需要初始状态在安全集合内、约束可行、动力学与状态可靠、反馈满足正则性,并且实际实现符合推导。若执行器饱和使约束无解,或传感误差让真实状态已经越界,QP 的写法本身不能补上这些条件。
问题二:为什么 比 更适合跟车?
答案:前者允许在安全裕量较大时减小距离,到边界才阻止继续向外穿越;后者要求裕量永远不减,会禁止许多仍然安全的接近动作。较少限制来自集合内部的自由度,不是放松边界安全。
问题三:把一个普通控制器的输出经过饱和限幅,等价于在 QP 中考虑输入界吗?
答案:不等价。QP 输出原本可能依赖一个很大的制动力满足屏障条件,事后限幅会破坏该条件。输入界必须进入可行性分析;必要时还需重新构造安全集合,把有限制动能力提前纳入设计。性能松弛不能解决物理上已无法避免的冲突。