003|最大熵逆强化学习:多条合理轨迹如何共存
原论文:Maximum Entropy Inverse Reinforcement Learning,Ziebart、Maas、Bagnell、Dey,AAAI 2008。作者提供的论文。
先接住前作的问题
学徒学习用特征期望控制性能差距,却允许多种策略都满足同一统计。最大熵IRL要补的是分布选择:哪些完整轨迹应获得多大概率?两者共享特征约束,本篇并非给最大间隔算法换名字。
五个前置概念
五个前置概念分别是熵、指数族、配分函数、特征匹配与条件概率。熵控制未被证据约束的选择;指数族将奖励映射到概率;配分函数负责全局归一化;特征匹配提供梯度;条件概率允许利用部分观测推断后续。
一、问题设定:多条路径都符合示范时怎样分配概率
同一个驾驶员去同一个地点,今天可能走主路,明天可能绕一条支路。把其中一条当作唯一最优解,会把另一条解释成错误;只匹配平均特征,又可能得到许多同样合理的行为分布。最大熵逆强化学习为这种不确定性增加了一个选择原则:在满足观察到的统计约束之后,不额外偏爱某一条轨迹。
二、从全局归一化推到特征差梯度
从奖励函数到轨迹分布
对一条轨迹 ,把每一步特征相加得到 ,奖励为 。在确定性环境与适当路径集合下,最大熵解为:
分子表示这条轨迹相对值得选择的程度,分母保证所有合法轨迹的概率和为一。两条轨迹奖励相等时概率相等,奖励差为 时概率比为 。这里的概率比针对定义好的轨迹集合,不能脱离路径长度、终止规则和可达性讨论。
| 要素 | 本篇讨论的设定 |
|---|---|
| 数据 | 专家实际走过的轨迹 |
| 已知量 | 道路/状态转移结构、轨迹特征 |
| 待学习量 | 线性奖励权重及其诱导的轨迹分布 |
| 优化信号 | 示范的对数似然 |
| 输出用途 | 路径预测、条件动作概率、目的地推断 |
| 适用边界 | 确定性情形更直接,随机转移需要谨慎处理 |
与学徒学习一样,特征决定哪些偏好能被表达。最大熵增加的是对剩余歧义的概率处理,不能让遗漏的“怕经过隧道”偏好自动出现。
梯度为什么又变成特征差
对一条示范:
对参数求导,第一项得到专家特征;第二项通过配分函数得到模型当前的期望特征。因此多条示范平均后的梯度是:
如果模型比专家更常使用某类道路,该特征的梯度会压低相应偏好;若使用得太少,就会提高。它是在整个路径分布上校正统计,不是在每个路口直接复制专家选择。
严格说,线性指数族下对数似然是凹函数,负对数似然是凸函数。原文学习段落的“convex”表述应结合它讨论的优化方向理解,不能照抄成“最大化任意凸函数都容易”。
配分函数的计算看似需要枚举所有路径。原文用后向消息计算到终点的加权路径量,再推出局部动作概率;前向传播访问概率后,累积状态/边频率。这样把指数规模路径求和转成利用图结构的动态规划。
对固定特征的线性指数族,在配分函数有限且可交换求导与求和时,把平均对数似然 的参数梯度再求一次导数,会得到 ,因此 为半负定;这里 是整条轨迹的特征向量,协方差按模型分布 计算。这给“凹”一个可检查的来源:两个特征若总是一起出现,其差方向可能没有曲率,奖励权重便仍然不可辨识。最大熵消除的是没有证据时任意偏向某条路径,不是凭空创造缺失的偏好证据。原文学习目标
在下一节三路例子中,若只记录“总到达一次”这一恒定特征,任意给该特征增加常数都会同时乘到三个路径权重上,再被配分函数约掉。似然没有理由辨别这些参数。实验中较好的路径概率,因而不能单独证明每一项道路代价都有唯一心理含义。
全局归一化为什么重要
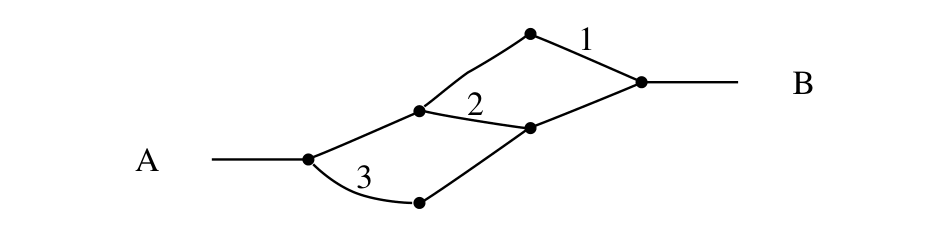
教学构造:从起点先选左或右。左边随后有两条等价路线到终点,右边只有一条。三条完整路线奖励相同。
如果先在起点给左右各一半概率,再在左边分两路,三条路径得到 。右边路径仅因为更少分叉而被偏爱。全局轨迹分布则给三条各 ,左分支的总概率应为 。
这并不是说局部策略永远错误。一个从全局消息正确计算出的局部条件策略可以实现相同轨迹分布。问题在于,简单地按局部最优 Q 做归一化,未必考虑后续所有路径所占的概率质量。
三、用后向权重与前向访问频率拟合分布
梯度需要模型的特征期望,而它不能仅由示范样本替代。下一步用图上的后向计算处理路径权重,再向前累积访问频率,才能得到归一化模型自己的统计。
输入:合法路径图、起终点条件、专家轨迹、特征函数
计算专家平均轨迹特征 f_E
初始化奖励权重 theta
重复:
    reward = feature * theta
    后向计算各状态的加权可达路径量 Z
    从 Z 导出每个状态的动作条件概率
    从初始分布前向传播状态访问概率
    汇总模型期望特征 f_model
    theta += step_size * (f_E - f_model)
输出:奖励权重、轨迹概率模型
预测新路径:
    给定起点与终点,重新计算条件分布
实现中通常在对数域计算配分消息,避免指数溢出。路径循环、终止与时域也必须有明确处理。若把所有无限循环都纳入求和,不能仅因为单步奖励是负数就假定配分函数必然良好;路径数量增长也参与决定收敛。
四、分开读取路径图与两种距离匹配指标
分叉例子检验全局归一化的含义,道路留出集才检验拟合是否有用。二者应分别读:图2解释概率,表1比较距离匹配与路径概率。
作者将它用于道路行为建模,同时给出轨迹概率、动作概率和部分路径下的目的地推断。它不是让机器人无条件随机行动,而是在已有偏好证据之外保留不确定性。原文“Maximum Entropy IRL”与算法 1
原图怎么读: 图2,PDF第4页。从A到B的三条完整路径与每个路口的局部选择是两种归一化对象。按图中分叉把局部概率相乘,就能检查为什么局部均匀不等于路径均匀。
| 证据位置 | 比较对象 | 观察与支持 | 不能证明 |
|---|---|---|---|
| 图2 | 局部动作归一化与全局路径归一化 | 分叉结构会影响局部模型路径概率 | 所有局部概率模型都无效 |
| 算法 1 | 后向与前向频率计算 | 可利用图结构避免直接枚举 | 连续高维机器人中计算同样容易 |
| 表1 | 时间、最大间隔、动作模型与 MaxEnt | 路线匹配与概率建模表现 | 自动驾驶闭环安全 |
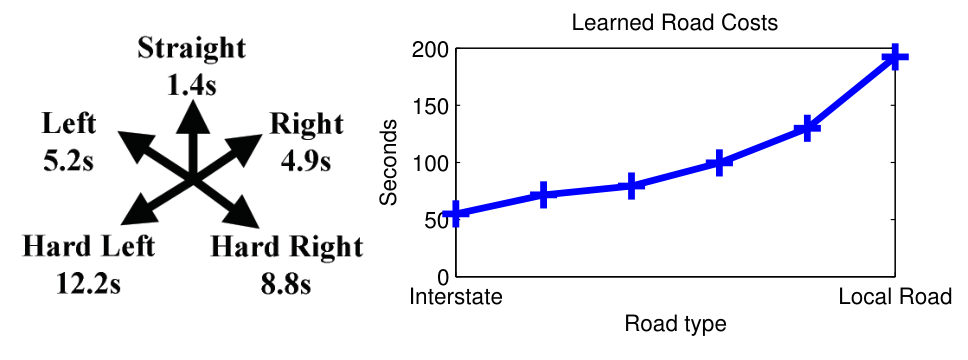
| 图3 | 学得的道路/转弯代价 | 参数可以对应部分直觉偏好 | 恢复唯一真实心理奖励 |
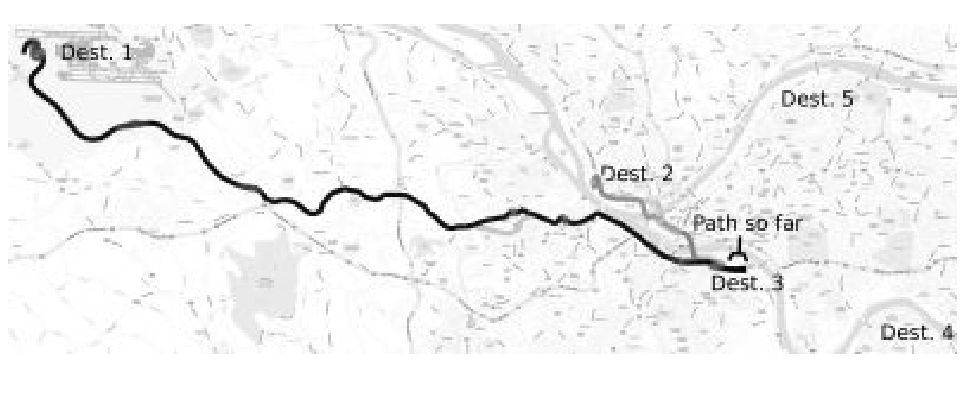
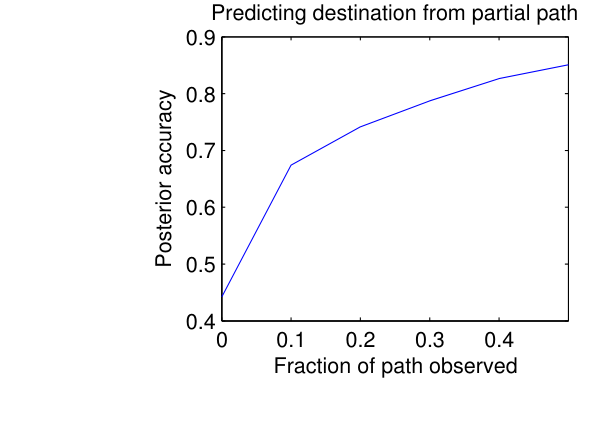
| 图4、图5 | 部分路径下的目的地后验 | 增加路径证据有助于推断目的地 | 任意新城市泛化 |
结果表怎么读: 表1的Matching是平均距离匹配比例,90% Match是达到至少90%距离匹配的样本比例,二者不是同一个成功率。先在同一列比较模型;Log Prob的来源措辞问题另见下文。
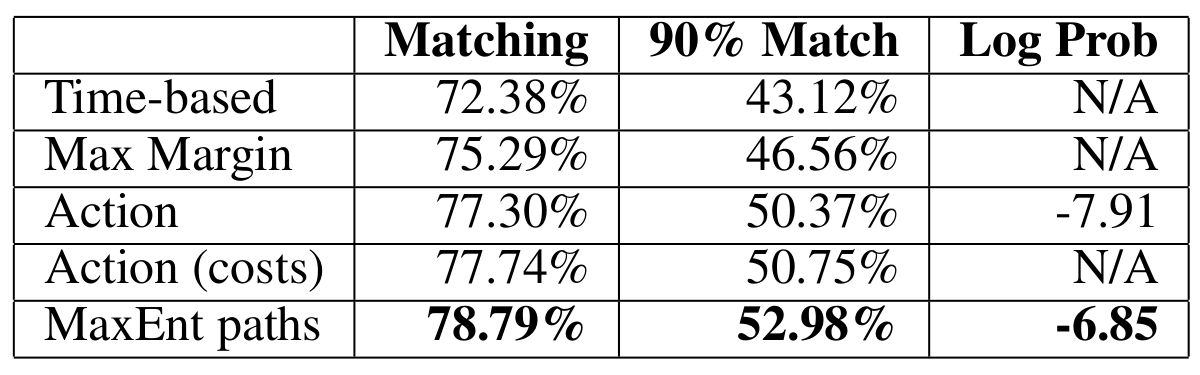
原文道路数据经过地图匹配与轨迹筛选,并使用 22 个特征。表1 的距离匹配比例,MaxEnt 为 78.79%,Action(costs) 为 77.74%;绝对差是 1.05 个百分点,而非 1.05% 相对提升。至少 90% 距离匹配的样本比例分别为 52.98% 与 50.75%。这些数字只对应这一数据切分与候选路径设定。
表1 的说明与邻近正文,对对数概率属于训练还是留出路径存在措辞不一致:表注写 withheld,正文一句写 training。因而这里不把 −6.85 与 −7.91 进一步包装成已完全澄清的测试泛化差距。论文仍提供路线匹配的明确留出集比较。
五、随机转移下区分动作选择与自然结果
随机环境中的轨迹包含智能体选择与自然随机结果。对所有未来结果直接构造全局偏好,可能产生非因果的解释,好像策略能够提前知道随机结果。原文对非确定性路径分布引入可计算近似,不能与后来最大因果熵框架完全等同。
从机器人角度看,若接触成功主要取决于不可观察的摩擦,学得的轨迹偏好可能混合了动作选择和偶然成功。还需要区分“专家有意走这里”和“环境把它推到这里”。这属于方法应用边界,不是该道路实验已经测得的失败率。
追问:为何只改变候选路径集合,就可能改变已经拟合好的概率?
参考答案:配分函数对所允许的路径求和。即使旧路径的奖励不变,新增路径也会分走概率;若重新训练,模型特征期望也会改变,权重可能随之调整。因此比较路径概率时必须固定或说明候选集合、可达性和截断规则。该结论直接来自本篇归一化式,并不表示真实驾驶偏好发生了变化。
六、沿机制关系继续读
与学徒学习的关系是历史延伸:都利用行为统计,但本篇显式建模轨迹概率;GCL直接沿用最大熵轨迹模型,并为连续控制设计自适应采样。这里应区分共同问题与直接继承的目标函数。
七、自测题与参考答案
问题 1:三条等回报路径中,为什么局部“每个路口公平选择”未必让路径公平?
参考答案:经过更多分叉的路径会被连续乘上较小概率,结果受到图的分叉结构影响。要得到每路径相同概率,起点就应根据后续可行路径的总权重分配概率,而不是简单各一半。
问题 2:为什么最大化示范似然的梯度是专家特征减模型特征?
参考答案:对线性奖励项求导得到专家特征;对 log 配分函数求导得到分布加权的所有路径特征。两项相减迫使模型统计接近观察统计,归一化项正是防止无条件抬高所有路径分数的部分。
问题 3:学得的转弯成本直觉合理,是否证明恢复了驾驶员真正的偏好?
参考答案:不能。多个权重可能产生相近路线分布,遗漏特征也可能被其他权重补偿。合理参数是一种解释线索,必须与可辨识性、预测结果和数据范围一起看。