004|PoWER:用回报重加权动作探索
原论文:Policy Search for Motor Primitives in Robotics,Jens Kober、Jan Peters,NIPS 2008。原文。
先接住前作的问题
DMP能从示范拟合形状,但拟合误差并不告诉机器人怎样把球接进杯子。PoWER保留结构化运动坐标,把试验回报用于改变这些坐标;新增问题是探索应落在哪个空间,以及好试验如何转成参数更新。
五个前置概念
理解本篇的五个概念是参数化策略、结构化探索、后续回报、重要性采样和 EM。它们分别规定行为空间、试错形态、信用时间范围、旧数据修正以及回报加权优化视角。
一、问题设定:如何把连贯的动作扰动变成回报改进
接球入杯这样的动作,成功取决于整段摆动的节奏。若每个控制周期独立加入白噪声,产生的往往是抖动,而不是有意义的动作变化。PoWER 把探索与运动基元的参数化联系起来,让试错更像“稍微改变这一段挥动”,再按后续回报决定哪些变化值得保留。
考虑线性参数化动作:
是待学习参数, 是随状态或运动阶段变化的基函数, 是参数扰动。即使参数噪声简单,投影到实际动作后也会被当前基函数调制,因此动作噪声不是处处相同的白噪声。
| 要素 | 方法中的角色 |
|---|---|
| 观察 | 运动状态、阶段与任务结果 |
| 动作表示 | 运动基元产生的连续轨迹/控制量 |
| 初始数据 | 可通过示范得到已有动作参数 |
| 新数据 | 带扰动执行后的状态、动作、奖励和扰动记录 |
| 奖励 | 回合或后续阶段的任务表现 |
| 输出 | 改进的参数化平均策略 |
| 环境模型 | 更新不要求完整已知动力学 |
“模型无关”不代表没有机器人知识。运动基元、状态变量、底层跟踪、任务重置与奖励测量都可能来自工程设计。算法省掉的是对环境动力学求导,而不是省掉整个控制系统。
二、用后续回报重加权参数空间的探索
直觉上,假设在同一参数附近试了几种扰动。如果向右调整的试验经常获得更高回报,参数均值就应往右移动。PoWER 的特定策略形式允许把这种直觉写成回报加权的参数更新,而不必先估计一个梯度再人工指定梯度步长。
对原文算法 1 的简化标量情形,可以写成:
角括号表示对轨迹取平均;实际复用旧轨迹时还要处理重要性权重。使用后续回报,是因为当前探索只能影响未来,已经发生的奖励不应给这一步的偏移提供因果信用。
这个式子适合解释特定推导,不应被当成任意策略网络都能直接套用的更新。多维参数、探索协方差以及基函数的影响在完整算法中需要一致处理。
奖励平移为什么可能改变更新
以正回报作为权重的算法,与普通策略梯度的基线技巧不同。假设两次扰动为 ,回报为 3 和 1,加权偏移为 。若给两次回报都加 100,偏移变成 ,接近零。
这说明相同排序并不保证相同更新:大量公共正基线会稀释权重差异,负权重还会破坏概率式解释。设计奖励时,不仅要看哪条轨迹更好,也要看数值怎样进入更新。
为什么“重复使用高分轨迹”还不等于正确复用
旧参数下采到的扰动,未必是新参数下同样可能出现的动作。原文算法1先重加权并丢弃低重要性样本,再计算回报加权平均;这两层权重分别修正“从哪里采来”和“值不值得学”。原文 §2.3
教学例:旧池里有9次偏左、1次偏右,当前探索却两边各半。直接计数会给偏左九倍话语权;理想重要性比约为左 、右 ,总质量先恢复各半,再用回报决定方向。实际连续轨迹权重可能极不均衡,所以复用省交互与估计低方差并非同时免费获得。评价球入杯训练曲线时,必须把新执行次数与池中反复使用次数区分。
从两个参数看结构化探索
教学构造:一个参数控制摆动前半段的幅度,另一个控制后半段的收回速度。对前者稍加正扰动,会连续影响一段动作,而不是只让一个时间点跳一下。若最终球飞得太远,回报会降低这种偏移的权重;若进入杯口,它获得更大贡献。
由于基函数有局部作用范围,不同参数可以分别调整动作的不同阶段。这比每步独立噪声更容易产生连贯轨迹,但也限制探索范围:如果现有运动基元根本没有“先把杯子翻过来”的行为模式,局部权重搜索可能很难创造它。
再看后续回报。如果动作前半段的扰动导致球进入好轨迹,后半段只是保持,早期参数仍能通过未来成功得到信用。若只使用当前奖励,稀疏终局反馈几乎不能指导这些前段参数。
三、按完整回合回报更新运动参数
局部基函数让一个扰动影响一段动作;实现时必须把该扰动和它之后的回报对齐。若复用旧回合,还要处理旧探索分布与当前分布的差异。
输入:初始运动参数 theta、探索分布、可测量奖励
如有示范:先拟合运动基元得到 theta
循环:
    采样参数扰动并执行若干完整动作
    记录每步扰动 epsilon、特征、奖励
    从轨迹末端反向计算后续回报 Q
    若复用旧轨迹:
        计算与当前采样分布的一致性权重
        降低不合适旧轨迹的影响
    按 Q 加权探索偏移,形成参数更新
    更新 theta
    使用平均策略独立检查任务表现
输出:改进的运动参数
应把“探索时偶然成功”与“更新后无探索的平均策略稳定成功”分开。尤其在接触任务中,噪声可能恰好弥补某次执行偏差,平均掉它之后未必保留成功。训练曲线应明确在评估哪个策略。
四、把回报曲线与无探索平均策略分开
噪声下偶然接球并不保证参数均值已经变好。看学习曲线前先辨认评估的是带探索执行还是更新后的平均动作,再判断结构化搜索带来的收益。
作者从回报加权的概率视角推导策略搜索,与策略梯度建立联系,并在结构化运动任务中评价。最重要的改变既包括更新公式,也包括探索落在哪个空间。原文 §2.3、算法 1
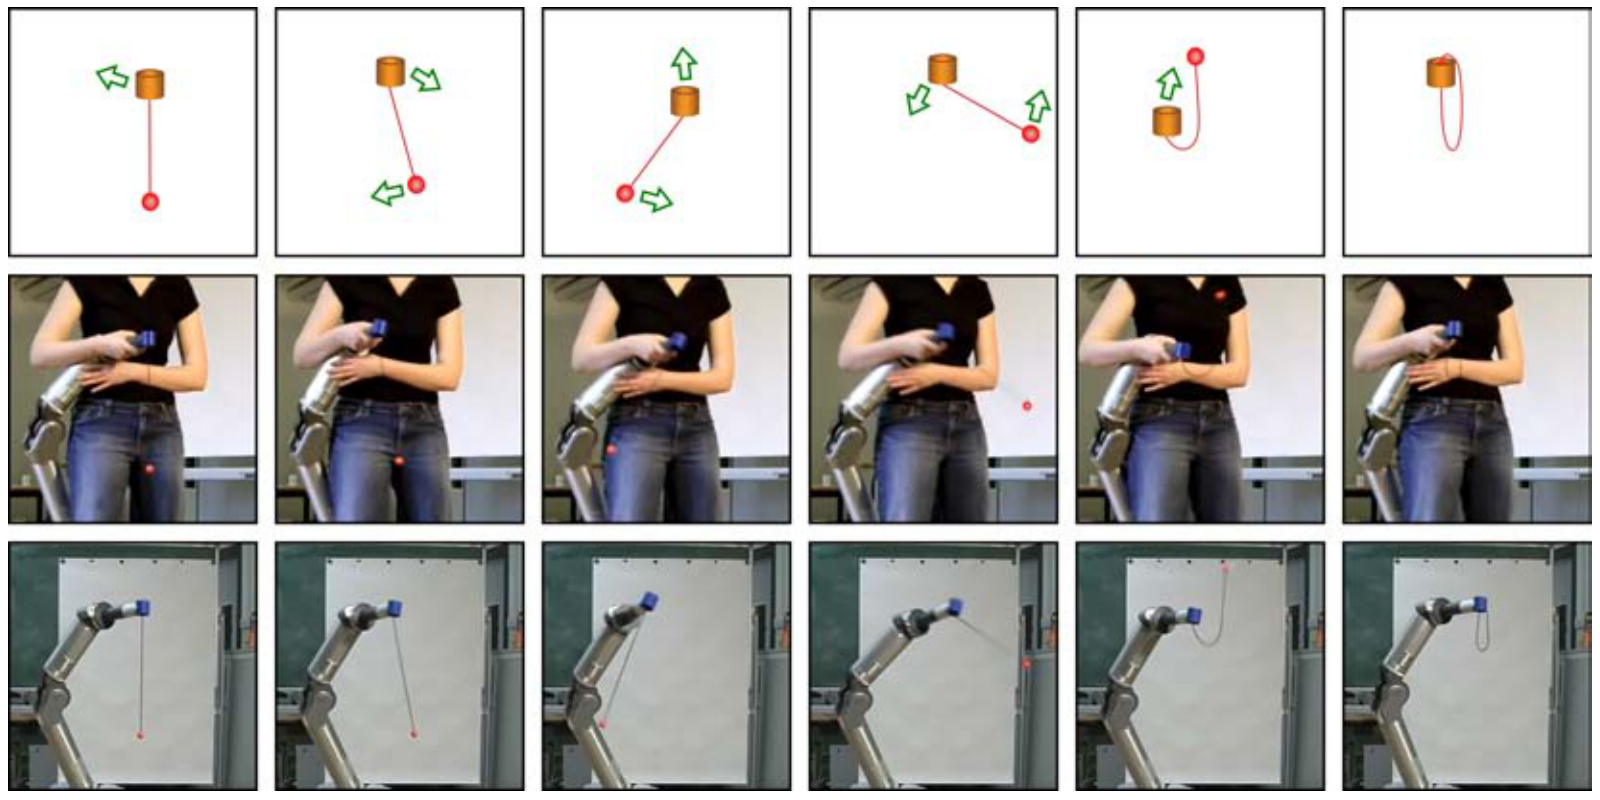
原图怎么读: 图4,PDF第7页。绿色箭头标出各帧的运动方向,图中同时有示教与学习后动作;它说明球杯任务的时序结构,收敛速度则应另看图5的回报曲线。
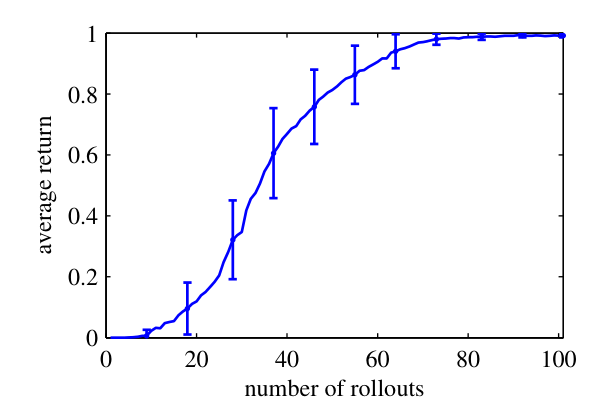
结果图怎么读: 内嵌图5直接检验学习效果:横轴是实际 rollout 数,纵轴是20次运行的平均回报。回报随练习上升,支持在示教初始化后的改进;归一化回报接近1并不等于独立报告了100%的任务成功率。图4的动作序列另见上方原文入口。
| 位置 | 检验内容 | 能支持什么 | 解释边界 |
|---|---|---|---|
| §2、算法 1 | 概率更新与结构化探索 | 更新如何由回报样本形成 | 不是一般神经策略的闭式解 |
| §3、图2、图3 | 参数化学习基准与摆起任务 | 所选探索和更新在这些设置中的效率 | 不能排除表示与调参对差距的影响 |
| 图4 | 示范与真实 WAM 执行流程 | 先模仿再改进的系统可行性 | 不代表从零开始的探索能力 |
| 图5及相邻文字 | Ball-in-a-Cup 学习曲线 | 约 75 次迭代后可经常成功入杯 | 不是跨任务成功率或总工作时间 |
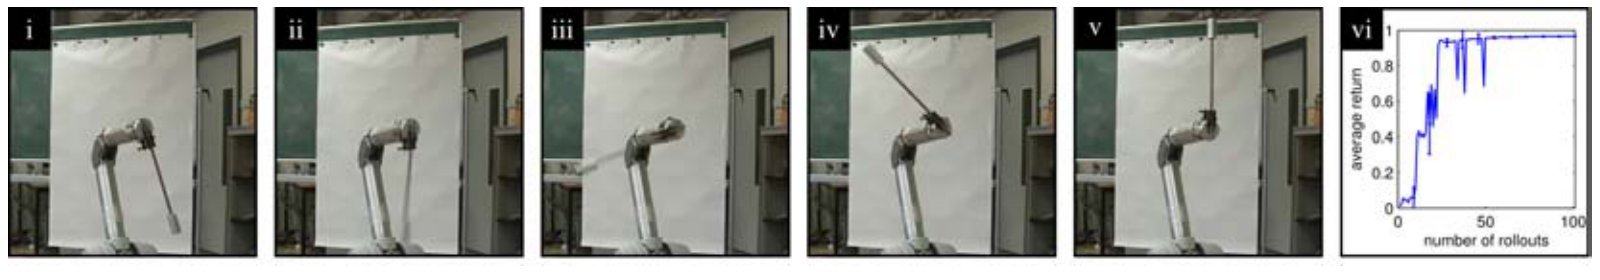
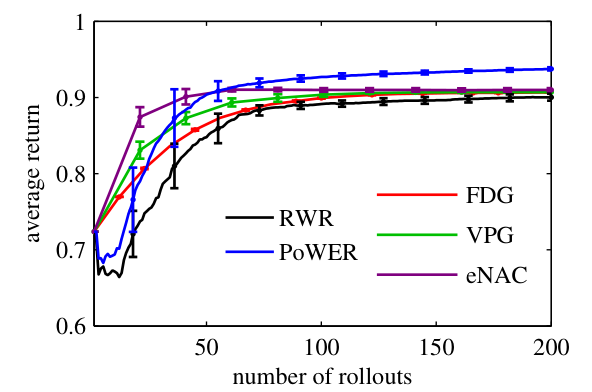
文中比较了有限差分、策略梯度、自然 Actor–Critic 以及回报加权方法,并将摆起与接球入杯用于机器人学习说明。接球入杯的示范采用手把手引导记录;运动参数的选择也是系统设定的一部分。
“75 次”应按原文迭代口径理解,不应擅自换算成 75 秒或 75 次完全无人值守操作。重复次数、全部物理重置成本和计算资源未在此逐项核实,因此不能声称做了完整部署成本审计。
五、检查初始化和重要性权重的支持范围
代价也来自这个选择。初始动作、基函数与奖励若不合适,方法可能局部停滞;高回报异常样本可能产生较大影响;旧经验的重要性权重若极不均匀,有效样本数会下降。以上后两项是统计机制的分析,不能直接当成原文报告的失败统计。
追问:回放旧轨迹很多,为什么有效探索方向仍可能只剩一个?
参考答案:重要性修正和回报加权共同决定每条旧轨迹的贡献,缓存条数不等于有效信息量。若少数轨迹独占归一化权重,更新会接近追随单次偶然结果。可同时记录权重集中度、不同扰动方向的覆盖,以及更新后不加噪声的策略回报;这是检查样本复用质量,不是另报一个更大的总样本数。
六、沿机制关系继续读
DMP提供策略坐标,PoWER提供坐标上的学习规则,属于模块组合;PI²同样利用轨迹加权,但从路径积分控制出发,是平行优化路线。正回报权重与指数负成本权重对平移的反应不同,不能只因外形相似就认作同一算法。
七、自测题与参考答案
问题 1:为什么同样大小的参数噪声,在不同运动阶段产生不同动作变化?
参考答案:动作变化为 。基函数在不同阶段激活程度不同,所以参数扰动被映射成随阶段变化的动作。噪声大小应结合这种映射,而不能只比较参数标准差。
问题 2:所有回报同时加一个大常数,为什么可能让 PoWER 更新变小?
参考答案:公共常数增大权重分母,却可能在正负探索偏移的加权分子中互相抵消。与无偏策略梯度基线不同,这里直接把回报用于概率式加权,所以奖励平移并非无影响操作。
问题 3:示范后很快学会接球,是否证明算法擅长从零探索?
参考答案:不能。示范已提供动作节奏与可行邻域,强化学习主要在附近改进。要检验从零探索,需要另设无示范初始化并保持其余条件可比,还要报告失败与重置成本。