009|GPS:让轨迹优化指导策略学习
原论文:Guided Policy Search,Sergey Levine、Vladlen Koltun,ICML 2013。原文。
先接住前作的问题
PoWER借结构化运动参数降低探索难度,但有限动作基元未必能表达跨地形的状态反馈。GPS转而利用局部轨迹优化提供高回报样本,再训练共享反馈策略。这是探索与表示选择的教学对照,不是PoWER的直接继承。
五个前置概念
五个前置概念是 DDP、时变反馈、重要性采样、自归一化估计和分布支持。分别对应引导生成、局部执行、样本复用、方差取舍和估计是否有依据。
一、问题设定:局部好轨迹怎样教出跨状态的反馈
轨迹优化器可以找到一段漂亮的跑步动作,但它常依赖特定起点、时刻与地形。神经网络策略可以直接根据当前状态反馈控制,却很难从随机探索发现同样好的动作。GPS 把两者连接:用轨迹优化得到的高回报分布提供引导样本,再用这些样本与当前策略样本共同训练参数化策略。
| 组件 | 作用 | 使用边界 |
|---|---|---|
| DDP 引导控制器 | 在局部轨迹附近提供高回报动作和反馈 | 通常时变、依赖模型与局部有效范围 |
| 参数化策略 | 将不同样本组织成状态反馈规律 | 需要足够表示能力与训练覆盖 |
| 采样分布 | 生成引导及历史策略经验 | 必须知道相应概率用于修正 |
| 奖励 | 评价整条动作序列 | 由任务提供,不是从示范自动恢复 |
| 正则化项 | 防止策略逃离样本支持却获得虚假高估 | 不等于现实安全约束 |
GPS 中策略搜索部分可以不依赖环境求导,但 DDP 构造引导分布需要动力学。只引用“model-free policy search”就把整个系统归为不需要模型,会漏掉这一关键成本。
二、连接引导分布、重要性估计与策略正则
本篇讨论的是 2013 年原始 GPS:核心包括重要性采样、引导分布与正则化策略搜索。后来的 BADMM、镜像下降和视觉运动版本采用不同优化形式,不能全部写成同一个算法。原文 §3–5
重要性采样如何复用引导轨迹
设轨迹 来自 ,目标策略轨迹概率为 ,重要性比为:
自归一化估计的示意形式是:
它让不同分布产生的数据参与目标策略回报估计。原文还利用逐步前缀比降低不必要方差;并加入正则化,不能只把上式当作完整 GPS 目标。
为什么需要正则化?假设新策略给所有已观察轨迹的绝对概率都很低,只是给其中最好的一条相对高一点。归一化之后,这条样本几乎独占权重,估计回报看起来很好;但新策略实际运行可能根本不会产生类似轨迹。自归一化只看相对比例,不能独自约束覆盖。
用一个极端算例检验覆盖问题:两条已见轨迹回报为10和0,策略A赋予概率 ,策略B赋予 。若来源概率相同,自归一化估计分别约为5和9.99;后者看起来更好,却把几乎全部质量放到了未见轨迹上。这里是教学分布,不是论文测量值。
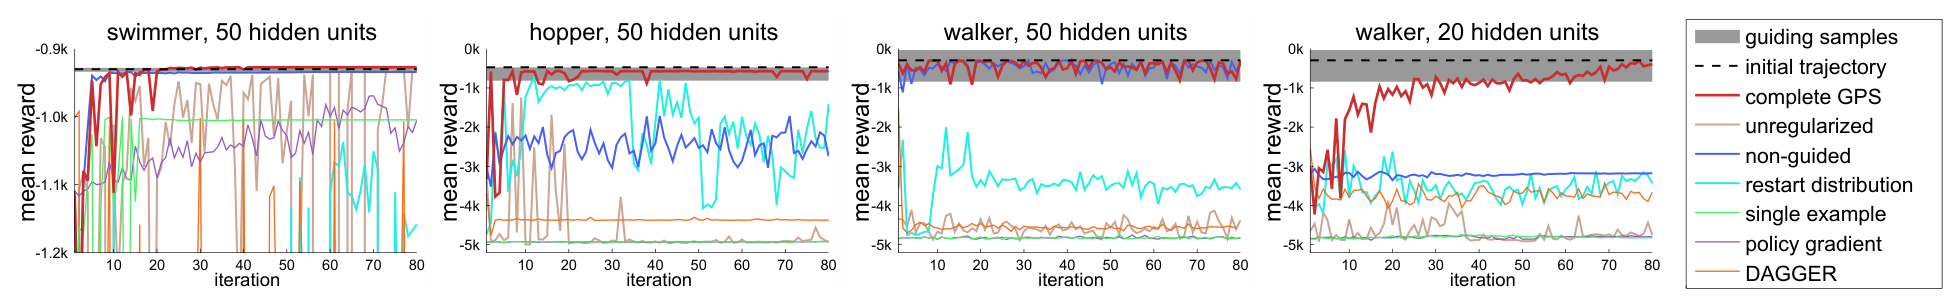
因此正则化保护的不是“别离专家太远”这句泛泛忠告,而是回报估计的证据覆盖。原文图2里去掉正则和去掉引导都是独立消融;每轮策略采样以外,引导变体还有额外引导轨迹。它们一起说明,优化目标、样本来源和交互预算必须同时列清。原文 §3、图2
引导分布如何生成,为什么还要适应
DDP 在名义轨迹附近进行局部动力学与成本近似,得到时变反馈控制器。把它随机化,就不只生成一条完全固定轨迹,还能给策略展示附近的纠正行为。
原文讨论接近高奖励指数分布的引导设计,也给出结合当前策略概率的自适应引导。直觉是让轨迹优化同时考虑“好不好”和“当前策略能不能学会”。
这在观察别名时尤其重要:如果同一状态在不同时间需要完全不同动作,局部时变控制器可以凭时钟区别,但不带时钟的平稳策略可能无法复现。自适应引导尝试寻找更兼容策略表示的行为,而不是强迫网络复制相互冲突的标签。
一个坡道例子
教学构造:机器人训练时在走出两米后遇到坡道。时变控制器在固定时刻抬高腿,即使当前地形发生变化也按时钟动作。把坡道提前一米,它可能还没准备好就撞上。
状态反馈策略如果从引导样本中学到“根据身体姿态和接触变化调整抬腿”,就可能应对坡道位置变化。这不是网络天生懂地形,而是表示与数据支持这种反馈规律。
如果训练只提供完全相同的一条无扰动轨迹,网络也可能把时间相关状态当捷径。随机反馈样本与测试环境变化,才帮助区分它学到的是轨迹记忆还是可复用控制。更陡坡道或不同接触材质仍可能超出这套规律。
三、交替采样引导轨迹与更新反馈策略
重要性权重连接的是两个轨迹分布,因而引导样本不能只在初始化时使用一次后置之不理。当共享策略与局部引导冲突,流程还需要适应引导分布。
输入:任务奖励、动力学接口、参数化策略
用 DDP 生成一个或多个局部反馈方案
从引导控制器采样轨迹
先以引导数据初始化策略
建立引导与当前策略混合的样本池
循环:
    根据样本来源计算重要性比
    优化带正则的回报估计目标
    运行新策略并追加轨迹
    如需要,重新优化适应当前策略的引导分布
    评价当前策略并保留较好候选
输出:状态反馈策略
这份教学流程保留了引导、策略采样和概率修正的关系,省略具体正则化更新及样本集选择。实现若只保留最好的轨迹而不记录来源分布,就无法直接沿用重要性采样解释。
四、用坡道位置变化检验反馈而非轨迹记忆
坡道位置变化能把按时钟重放与状态反馈区分开。图2的去引导、去正则对照则回答另一个问题:收益来自好样本本身,还是样本与策略之间的约束。
原图怎么读: 图2,PDF第6页。同时看完整GPS与去引导、去正则的版本,才能区分有效采样和分布约束各自的作用;单独看最高回报无法判断是哪一个组件带来收益。
| 原文位置 | 比较与设定 | 支持什么 | 不能推出什么 |
|---|---|---|---|
| §3 | 重要性采样与正则化目标 | 为什么仅看归一化回报会退化 | 正则化消除所有样本偏差 |
| §4.2、§6.2 | 引导适应当前策略 | 冲突行为可通过重新引导改善 | 任意策略容量都足够 |
| 图3、§6.3 | 改变坡道开始位置 | 状态反馈可比时变局部轨迹更适应位置变化 | 任意地形泛化 |
| 图4 | 随机分段坡度地形 | 比较 GPS、DDP 与邻近轨迹方案 | 真实机器人部署已验证 |
| 图5、§6.4 | 三维人形跑步模拟 | 高维状态下可学习相应反馈 | 无示范、无模型的从零学习 |
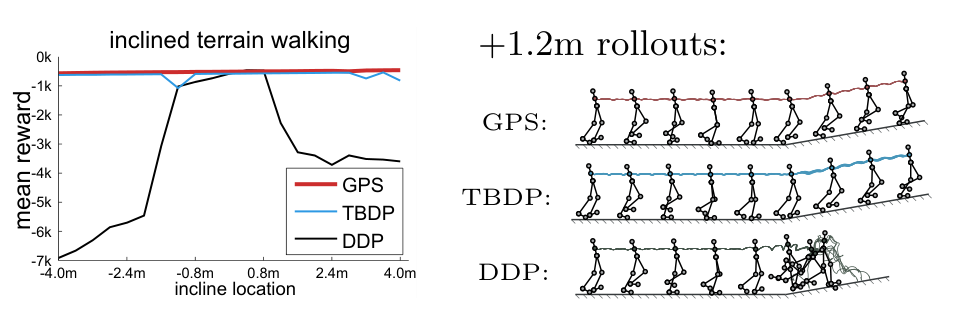
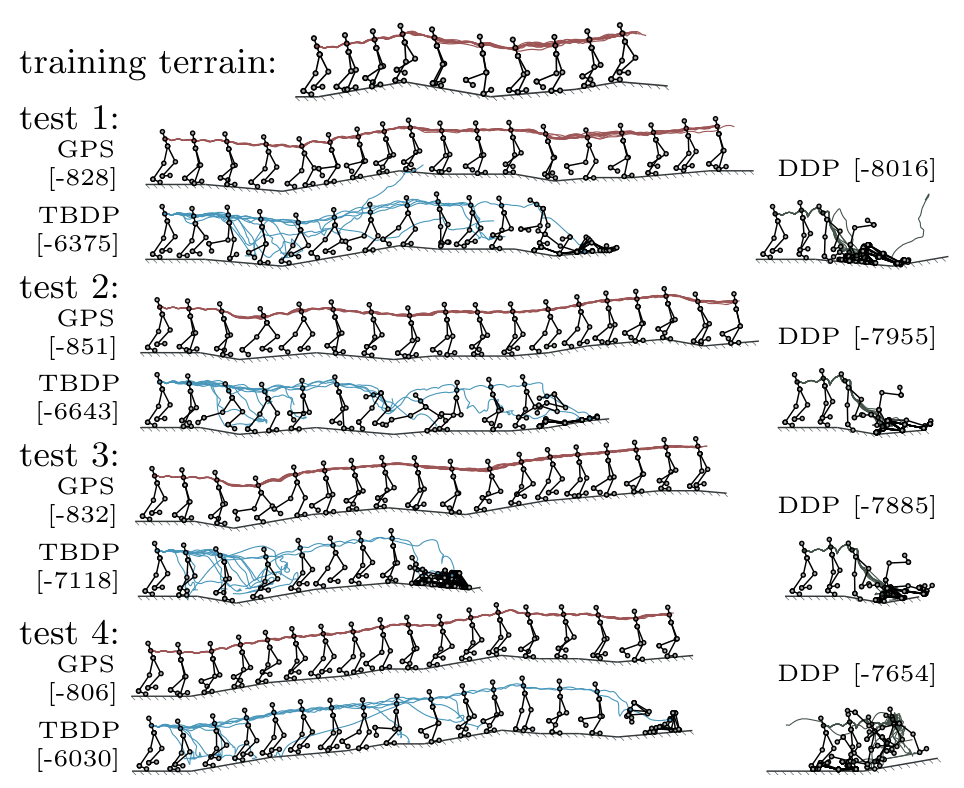
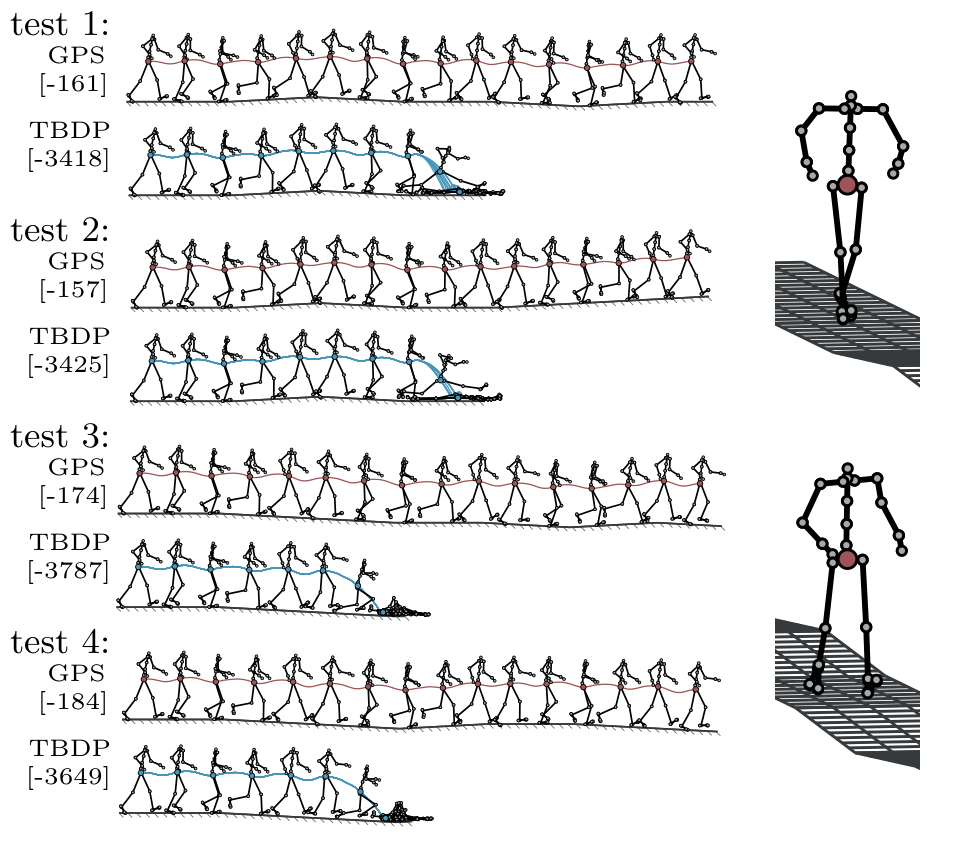
人形任务使用 63 维状态,引导来自人类运动捕捉并经 DDP 转成相应力矩;训练与测试采用不同地形。图4 的四个测试场景是具体泛化样例,不能解释为对整个地形分布的充分覆盖。
图中负奖励的差值需要按原成本定义解读,不适合直接转换为“成功率提升百分比”。自适应引导变体还使用额外引导样本,比较样本效率时要同时计入这些来源。阅读已覆盖主文方法与上述模拟实验,未独立复现。
五、局部教师无法覆盖任意失败状态
局部控制器的有效范围也限制“专家查询”。一个已经摔倒的人形状态,可能远离原始 DDP 轨迹,直接询问这个局部控制器未必能得到正确恢复动作。因此不能把它当成覆盖所有状态的通用专家。
追问:怎样区分坡道泛化来自状态反馈,还是训练中见过相似时间表?
参考答案:可保持坡道形状而改变出现位置和到达时间,并记录策略是否随实际姿态、接触变化调整动作。固定时钟仍成功不足以证明反馈,改变地形后恢复也不能自动推出任意地形泛化。还需核对引导样本是否覆盖这些扰动,并把额外引导成本计入比较。这个对照沿用本篇坡道例子的机制,不新增真机结论。
六、沿机制关系继续读
视觉运动策略直接承接引导式策略搜索思想,但改用约束式交替训练并接入图像网络。2013年的重要性估计与2016年的BADMM并不相同;这里的继承是训练分工的演化,不能把后者公式倒写成原版GPS。
七、自测题与参考答案
问题 1:既然 DDP 已经完成任务,为什么还需要训练神经策略?
参考答案:DDP 通常围绕一条时变轨迹有效,地形或起点变化可能破坏它。参数化策略有机会从多条及受扰轨迹中学到共享状态反馈,但这种泛化必须实验验证。
问题 2:自归一化重要性估计为什么可能“所有样本概率都很低,却认为回报很高”?
参考答案:分子分母共同缩小后,绝对覆盖信息被消去。只要最好样本比其他样本相对大,它就可能独占归一化权重。因此还需要约束或正则化,避免策略逃到无数据支持的区域。
问题 3:引导样本动作相互冲突时,增大神经网络一定能解决吗?
参考答案:如果同一输入确实要求两个不同行为,而策略没有时间或隐状态,再大网络也不能确定性地区分。需要改变输入、策略形式或引导行为。GPS 的自适应引导处理的是这种兼容性问题的一部分。