011|DDPG:在连续动作上直接优化价值
原论文:Continuous Control with Deep Reinforcement Learning,Timothy P. Lillicrap 等,2015 年首次公开。原文。
先接住前作的问题
DQN通过比较动作价值选动作,但连续关节力矩不能逐个枚举。DDPG把动作最大化交给可微Actor,同时组合回放与目标网络;关键未解问题由“怎样列举动作”变成“怎样相信Critic给出的动作梯度”。
五个前置概念
理解方法需要五个概念。动作价值评价先采取一个动作、随后继续执行策略的长期收益。确定性策略在给定状态输出一个动作。离策略学习允许使用其他行为策略收集的数据。自举用估计值构造另一个估计值的监督目标。目标网络用变化更慢的参数缓解目标漂移。
一、问题设定:连续动作不能枚举时怎样改进策略
机械臂的电机力矩不是“左、右、停”三个按钮,而是一组实数。若把每个关节切成十档,七个关节就有一千万种组合。DQN 的逐个动作比较因此难以直接搬到机器人上。DDPG 的办法是让一个网络直接提出动作,再让另一个网络评价这个动作;评价网络还告诉提议网络,动作朝哪个方向改变可能更好。
状态 可以包括关节角度、速度及任务变量;视觉版本使用连续图像提供运动信息。动作 是实值控制向量。奖励和回合结束规则随任务变化,不能为整篇论文填一个统一“成功奖励”。论文的主体是模拟实验,而非真机力矩控制。
对机器人而言,确定性不等于运动一定精确:环境有噪声,观测有误差,同一动作也可能造成不同结果。策略是否有足够信息区分这些情形,比输出分布是否随机更基本。
二、把价值对动作的导数传回确定性Actor
这篇论文将确定性策略梯度与深度网络、经验回放、缓慢更新的目标网络结合起来。它是无模型、在线交互、离策略的 Actor–Critic 方法。这里“无模型”指不学习环境动力学,并不是没有评价模型。
设 Actor 为 ,Critic 为 。Actor 输出动作;Critic 接收状态与动作,并预测长期回报。它们都不预测下一张图像或下一时刻的关节状态。
Critic 的教学形式为:
是折扣, 是回放数据,横线表示目标参数, 表示真正终止。这里显式加入终止掩码便于实现;截断回合是否应清零需根据任务定义判断,不能把时间限制自动当成物理终止。构造 时停止梯度,避免预测网络追着自己移动。
Actor 的更新依赖链式法则:
第一项说“动作改变一点,价值如何改变”;第二项说“参数改变一点,动作如何改变”。按Lilian Weng的DPG链式求导讲法,Actor步把看成常数,却必须保留对动作输入的导数:冻结Critic参数与对Actor动作执行detach不是一回事。后者会切断这条路径,使策略收不到信号。最小化无需对真实环境求导,但仍依赖Critic斜率可信。
目标网络采用软更新:
小 让监督目标变化缓慢,但也让新信息传播滞后。经验回放则重用旧交互,并削弱连续样本相关性;它不能保证所有动作区域都有数据。
训练行为采用 。原文使用具有时间相关性的 OU 噪声,意图适应惯性系统。这里应区分机制与必需条件:论文采用 OU,并不能推出所有机器人任务都必须使用它。批归一化用于处理输入和中间表示的尺度问题,同样属于本文系统设计的一部分。
数学目标是估计并提高折扣回报;算法改动是稳定深度确定性策略梯度的训练;实验指标则是任务回报与归一化分数。三者不能缩写成“损失下降,所以机器人更可靠”。
把“缓慢更新”换算成记忆长度
令目标网络每次以比例 混入在线参数;若在线参数暂时固定,目标参数与它的差经过 次更新后为 倍,半衰期为 。教学设定 时约69次更新, 时约693次。它衡量的是优化更新次数,不能直接换算成机器人秒数:每个环境步训练十次会使同样的 在物理时间上快十倍。
这使目标网络消融更容易读:原文的稳定收益来自降低目标变化速度,但若增加回放更新比,应同时重新核对目标滞后。只复制 而改变更新频率,并没有复制同一个算法时间尺度。原文 §3及图2
一个可手算的例子
以下为自构例子,未运行实验。假设单关节状态固定,Critic 学到 ,当前 Actor 输出 。则动作梯度为 ,更新会把动作向正方向移动。若 Actor 就是一个标量参数,学习率为0.1,一步得到 。
如果 Critic 错学为 ,同样的链式法则会把策略推向错误目标。这说明确定性策略梯度解决的是“如何使用当前价值估计改动作”,没有自动解决“价值估计是否可信”。
三、分开Critic拟合、Actor求导与目标软更新
Critic先拟合固定的自举目标,Actor再沿Critic对动作的导数更新。软更新发生在这些梯度步骤之外;它让目标变化较慢,却不负责纠正一个已学错的价值峰。
初始化 Actor、Critic,并复制各自的目标网络
建立空回放池
重复每个回合:
    重置环境和探索噪声过程
    每个控制步:
        用 Actor(状态) 加探索噪声得到动作
        执行动作,将转移存入回放池
        随机采样一批历史转移
        用目标 Actor 提议下一动作
        用目标 Critic 计算停止梯度的 TD 目标
        最小化 Critic 的平方误差
        固定 Critic 参数,沿动作梯度更新 Actor
        软更新两个目标网络
定期关闭探索噪声,在独立评估回合测量回报
四、把组件消融与归一化回报分开读
作者声称这一组合可以应对多种连续控制任务。实验支持的是模拟物理环境中的学习表现及组件消融,不能据此认定真实机器人已经拥有安全、廉价的学习方案。
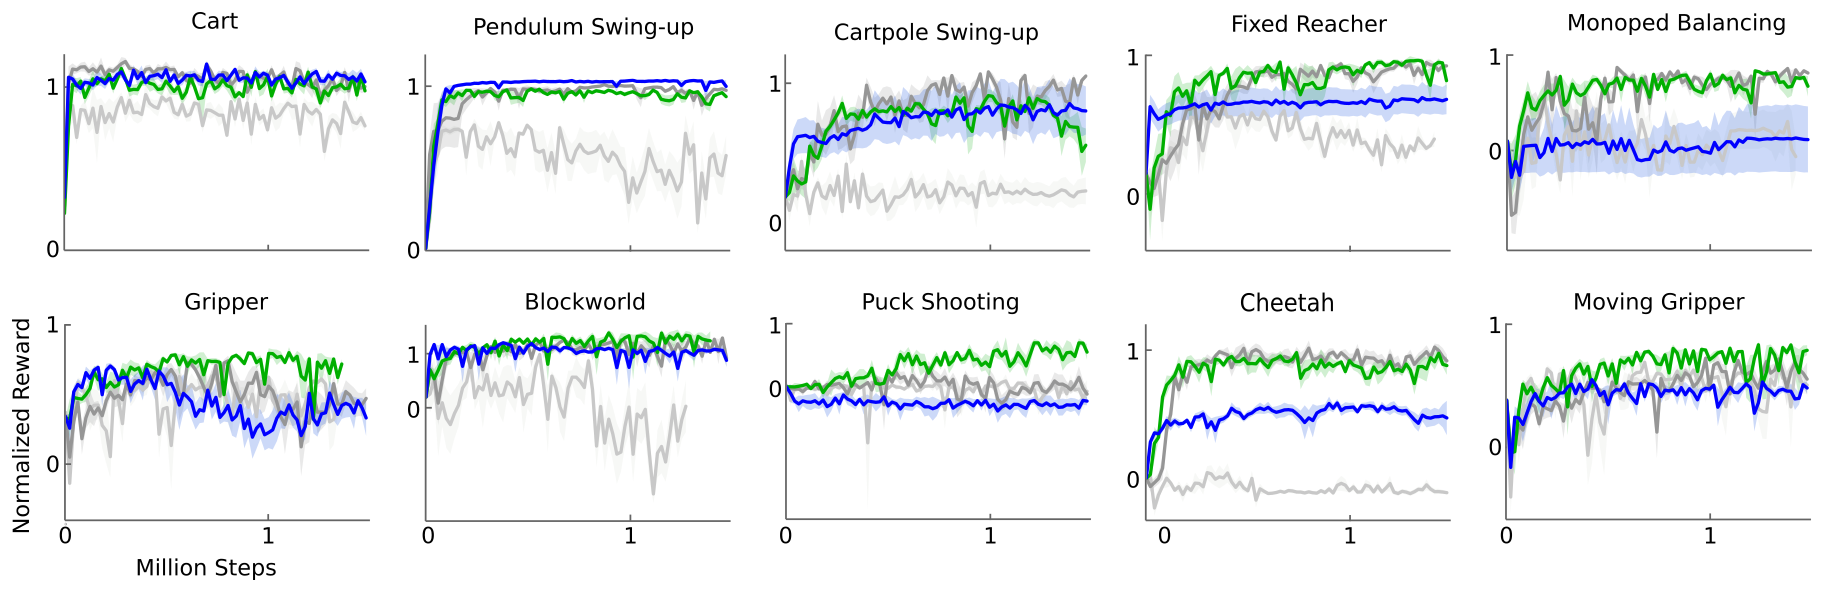
原图怎么读: 图2,原论文图注与图像。按原图颜色区分目标网络和批归一化的组合:浅灰为原始DPG加批归一化,深灰为仅目标网络,绿线为目标网络加批归一化,蓝线为像素输入版本,再比较同一任务的学习曲线;归一化回报不是成功率,不能把跨任务尺度直接解释为物理性能。
| 项目 | 原文设定与阅读要点 |
|---|---|
| 环境 | 第4节的 MuJoCo 控制任务,另讨论驾驶任务;不要归纳成统一真机实验 |
| 观测 | 低维状态与像素两种设置;像素输入为连续三次渲染形成的9通道、64×64图像 |
| 数据 | 策略在线探索生成转移,再经回放重用;没有专家示范训练 Actor |
| 基线 | 随机动作策略和访问真实模型及导数的 iLQG;另有组件移除比较 |
| 预算 | 各任务学习曲线对应各自交互量;第6节称大部分所考察问题在250万步内求解 |
| 统计 | 表1将5个重复实验的结果汇总;不应将最佳单次等同于均值 |
| 指标 | 随机策略均分归一化为0,iLQG均分为1;不是成功率 |
| 核心假设 | 回放、目标网络和归一化能否使深度 DPG 在多种任务中有效学习 |
iLQG 获得额外物理信息,因此它提供的是有意义的控制参照,并不是同信息量的学习算法竞赛。像素设置还包含动作重复:相同的一个“智能体步”可能消耗多个模拟步。比较样本效率时,必须先统一横轴单位。
四处证据应该怎样读
以下定位依据论文全文。
| 原文位置 | 观察与支持 | 不能证明 |
|---|---|---|
| 第3节、Algorithm 1 | 给出 Actor、Critic、回放与双目标网络更新 | 算法形式本身不是收敛证明 |
| 图2 | 完整方法与去掉组件的曲线不同,支持这些设计在所测任务中的实用价值 | 不能认定某组件对所有任务都必要 |
| 表1 | 归一化结果覆盖多种任务,并汇总重复实验 | 大于1表示超过所用 iLQG,不表示超过全局最优 |
| 第4节像素实验 | 部分视觉任务也能学到控制行为 | 不证明任意相机变化下泛化或真机视觉鲁棒 |
| 第6节讨论 | 作者明确承认非线性逼近取消一般收敛保证,且仍需大量交互 | 不能用“稳定”一词消除失败可能 |
一个容易误读的数量是“相对 DQN 更少交互”。两个算法面对不同任务,奖励密度、动作重复和终止方式都不同,因此不能把这个跨领域比值当成严格算法效率提升。论文的机制价值并不需要靠这个比值成立。
五、缓慢目标更新不能保证评分正确
DDPG 的新意是把已有确定性策略梯度扩展为可训练的深度连续控制系统,而不是发明所有 Actor–Critic 思想。它把动作空间的显式搜索转化为网络学习,推理时通常只需一次 Actor 前向传播。相比每一步内循环寻找动作,这对实时控制很有吸引力。
但计算方便不等于数据便宜。Critic 在低覆盖区域可能高估价值,Actor 又主动寻找高价值区域,两者可能形成自我强化的误差循环。这是对算法结构的分析,并非本文已系统验证的全部失败机制。后续 TD3 与 SAC 可以沿这一问题继续阅读。
真机还涉及接触力、速度限制、复位与损坏风险。本文没有把这些工程条件完整纳入算法保证。因此迁移时应首先明确动作接口和约束,而不是直接把网络输出接到电机上。这个局限来自实验范围,不意味着方法没有机器人价值。
追问:目标网络更新率相同,增加每次交互的梯度步数会保持相同滞后吗?
参考答案:不会。软更新的记忆长度首先按参数更新次数计量;每次环境交互执行更多梯度步,相同更新率对应的环境时间尺度就缩短。比较回放比时应同时记录目标更新次数、采样频率和旧目标权重的衰减。上文对记忆长度的换算支持这一辨析,不能只报同一个软更新系数就断言稳定化条件一致。
六、沿机制关系继续读
TD3对DDPG是直接继承:保留确定性actor与回放框架,针对估计误差改动更新;NAF则通过限制Q函数形状解析选动作,是平行方法。两者分别把连续最大化成本交给actor与函数结构。
七、自测三题与参考答案
问题1:Actor 更新时为什么要固定 Critic 参数,却允许梯度穿过 Critic?
答案:我们需要的是 对动作的导数,再由动作传回 Actor 参数。若把 Critic 也一起朝增大预测值更新,它可以只提高自己的输出而不改善动作;若完全切断 Critic 计算图,Actor 又收不到方向。固定参数与停止所有输入梯度不是一回事。
问题2:确定性策略为什么仍能收集多样数据?
答案:训练行为策略在 Actor 输出上加入噪声,目标策略本身仍确定。离策略估计允许二者不同,但若噪声始终探索不到关键状态,回放池也无从补救。离策略是可重用数据的条件,不是探索成功的保证。
问题3:归一化分数1.2能解释成成功率120%吗?
答案:不能。其参考零点是随机策略,单位由 iLQG 与随机策略的回报差决定。1.2只表示超过这个参照间隔;要谈成功率,需要另外定义二元成功事件并统计评估次数。