026|TD3:防止策略利用价值估计错误
原论文:Addressing Function Approximation Error in Actor-Critic Methods,Scott Fujimoto、Herke van Hoof、David Meger,2018。论文。
先接住前作的问题
DDPG的Actor会主动寻找Critic高估的动作,再把这份高估传回自举目标。TD3保留确定性策略与回放框架,分别修改目标估值、更新节奏和目标动作邻域;它针对的是误差闭环,不是更换成最大熵学习。
五个前置概念
五个前置概念:高估偏差是优化倾向挑中正误差;TD 自举使用预测训练预测;确定性策略梯度通过 Q 对动作的导数训练 Actor;双时间尺度让策略与评价器以不同频率更新;蒙特卡洛评价用真实轨迹回报估计价值。
一、问题设定:怎样阻断Actor与Critic相互放大高估
假设机械臂尝试动作 A 得分普通,而价值网络错误地认为动作 B 特别好。Actor 会向 B 靠近;Critic 又用“下一步做 B”的预测给当前动作打分。即使最初误差很小,这个循环也可能把虚假的高分扩散开。
设定是单智能体、在线收集、离策略更新、无模型连续控制。状态是仿真提供的运动状态,动作是连续控制量,奖励和终止沿用七个 OpenAI Gym MuJoCo 任务。没有示范、语言或图像预训练输入。
DQN 的高估很直观:从若干带误差的数里选最大值,更容易选中误差偏大的那个。DDPG 没有枚举动作,却通过梯度让 Actor 朝 Q 的高点移动,这同样是对估计值的选择。因此不能因为“没有 max 符号”就认为最大化偏差消失。
论文第 4.1 节在小步更新等假设下分析这种倾向。这里的结论有条件,不是说每个状态、每次更新、每个网络都必须高估。更重要的是错误与数据分布的互动:Actor 会反复访问它认为好的动作,随后 TD 标签又传播这些预测。
普通 Double DQN 式的“当前网络选动作、目标网络评价”在本实验里帮助有限。作者解释为 Actor 变化慢,两个选择仍高度相关。两个 Critic 也共享数据和目标,因此称它们为完全统计独立并不准确。
二、把双Q、延迟更新和目标平滑放回各自位置
TD3 直接研究这种 Actor 与 Critic 相互强化的错误。在 DDPG 上增加三个机制:两个评价器取较小值、策略慢于评价器更新、目标动作附近加小扰动。前两个分别降低乐观偏差与更新耦合,第三个避免策略依赖一个极窄的虚假价值尖峰。
1. 双 Q 取较小值用于目标
记当前策略为 ,两套评价器为 ,带横线者为目标网络。目标动作先加受限噪声:
然后构造:
两个 Critic 都拟合同一个目标 。取最小值意味着一个网络单独给出的高峰不足以成为乐观标签,但如果两个网络同时出错,最小值仍可能过高。另一方面,低估也可能发生,所以它不是无偏估计器。
2. Actor 每隔几步再更新
Critic 每次更新,而 Actor 与目标网络每隔 次 Critic 更新才调整。论文常用 。Actor 的损失仍使用第一个评价器:
这里与“在 Actor 损失中也取两个 Q 的最小值”有区别。原始 TD3 的最小值关键放在 TD 目标中。延迟也不是停止与环境交互,而是降低网络参数更新频率。多给评价器一些拟合时间,有可能使下一次策略梯度更可靠,但过度延迟又会让策略学习不足。
3. 目标平滑不是采集探索
采集数据时给当前 Actor 加噪声,是为了看见新动作的后果;目标平滑给下一状态的目标 Actor 加噪声,是为了让 TD 标签考虑动作邻域。二者位置和目的不同,可以独立设置。
如果某个动作点预测特别高,而左右稍有偏差就很低,平滑后的目标会降低这座尖峰的吸引力。机器人电机和接触通常存在误差,这一直觉很自然;但如果真实任务确实需要极精确的动作,过大的平滑也可能损害控制。因此“邻近动作应有相近价值”是有适用范围的归纳偏置。
数学目标仍是最大化任务回报,没有 SAC 的熵目标。算法机制针对评价误差,实验改善的是回报与学习速度,三者需要分开描述。
双Q为什么会引入悲观?恒等式 给出:令 为对同一真值 的随机估计;若两者分别无偏,。分歧越大,低估越明显;若两者完全共享同一个正偏差,分歧为零,取最小也无法去掉偏差。这里是标量随机误差的教学分析,不是神经网络误差独立的假设。
因此应分别记录均值偏差和两critic分歧:只看它们彼此一致,不能判断是否准确;只看更悲观,也不能判断策略是否更好。原文将clipped double Q、延迟更新和目标平滑分开,正是因为它们分别干预偏差传播、梯度噪声和尖峰利用。原文§4—6
一个能辨认三种机制的例子
自构例子,未运行:某推力的两个 Q 预测分别是 20 和 8,真实回报暂未知。取小值把标签从 20 限制为 8;如果邻近推力预测也只有 7 到 9,平滑进一步阻止孤立尖峰传播;延迟策略更新则先让评价器多吸收一次经验。三个步骤分别作用于评价选择、动作邻域和时间节奏,并不是同一种“加正则”。
三、先更新双Critic,再按延迟日程更新Actor
双Q取小值放在自举目标,目标平滑放在下一动作附近,采集探索则发生在真实行为上。三者位置不同,实现中互换噪声或更新频率会变成另一种算法。
初始化 Actor、两个 Critic、三套对应目标网络和经验池
每次环境交互:
    用 Actor 加探索噪声选择动作,保存转移
    随机抽取一批经验
    用目标 Actor 生成下一动作,加入截断平滑噪声
    用两个目标 Critic 的较小值形成 TD 目标
    分别更新 Q1、Q2
    如果 Critic 更新次数是 d 的倍数:
        最大化 Q1 对当前 Actor 动作的评分
        缓慢更新 Actor 和两个 Critic 的目标参数
评估时关闭采集探索噪声,累计任务回报
四、用网络匹配对照辨别三项修改的贡献
作者将其概括为减少函数近似误差的影响。实验支持多个连续控制仿真任务上的改进,但不是“两个网络一定给出真实价值”,也没有直接证明真实机器人更安全。
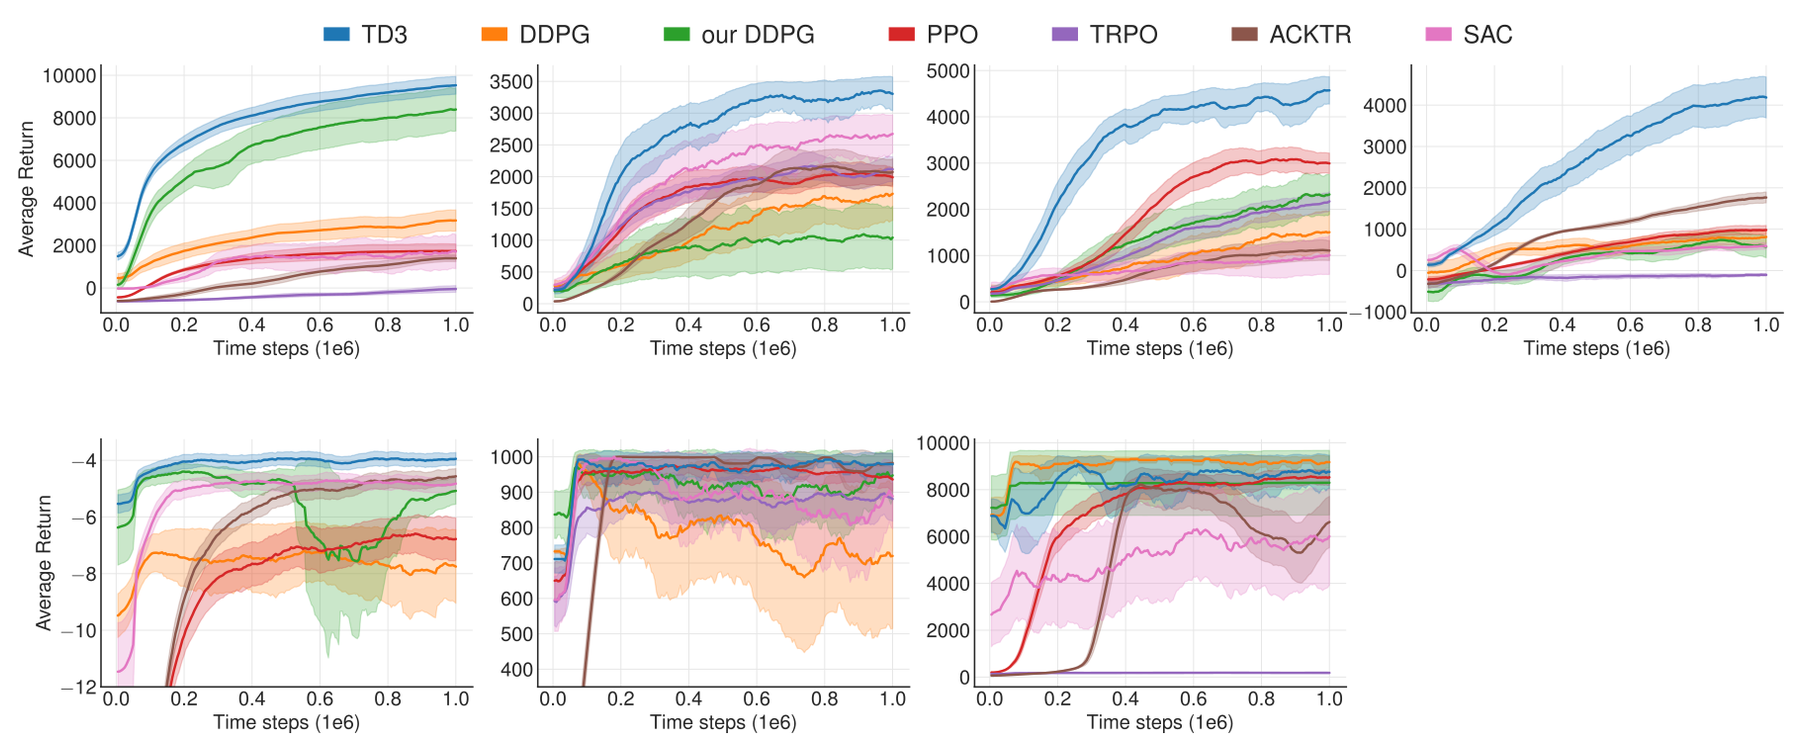
原图怎么读: 图5,原论文图注与图像。上排从左到右是HalfCheetah、Hopper、Walker2d、Ant,下排是Reacher、InvertedPendulum、InvertedDoublePendulum(均为v1任务)。阴影按图注是十次试验统计的半个标准差,曲线还做了平滑;它既不是完整标准差,也不是95%置信区间。跨算法比较应保留这两个处理步骤。
| 项目 | 原文设置 |
|---|---|
| 环境 | HalfCheetah、Hopper、Walker2d、Ant、Reacher、单摆与双摆,共七个旧版 Gym 任务 |
| 数据与预算 | 每任务一百万环境步,每步一次 Critic 更新 |
| 评估 | 每 5000 步评估十回合,关闭探索噪声 |
| 重复 | 十个仿真及网络初始化随机种子 |
| 网络 | Actor、Critic 两层,400 和 300 隐藏单元;Adam 学习率 |
| 批量 | 100 条转移,经验均匀采样 |
| 噪声 | 探索标准差 0.1;目标平滑 0.2,并截断至正负 0.5 |
| 延迟及目标 | ,软更新系数 0.005 |
| 基线 | DDPG、重新调参的 DDPG、PPO、TRPO、ACKTR、当时实现的 SAC |
HalfCheetah 与 Ant 前一万步完全探索,其他环境前一千步。这个差异影响早期数据,因此复现时不应全部替换成一个统一默认值。
作者不仅比较原始 DDPG,还提供包含网络、超参数与探索改动的自家 DDPG。这样能检查提升究竟来自 TD3 三个机制,还是基础实现已经变强。等环境交互量并不代表等训练时间:双 Critic 增加计算,而延迟 Actor 又减少部分更新。硬件和全面等算力调参预算本文没有逐项确认。
五处证据与两个容易看错的表
| 位置 | 观察 | 支持与限制 |
|---|---|---|
| 图1 | 估计 Q 与从状态出发的蒙特卡洛回报对照,DDPG 有明显高估 | 支持偏差在训练中真实出现;蒙特卡洛也只是对真值的估计 |
| 图2 | Double DQN、Double Q 的 Actor–Critic 版本仍有残余偏差 | 说明直接移植离散方案不充分,不否定所有双估计方法 |
| 图3 | 固定策略与持续更新策略下,目标网络速率影响不同 | 支持 Actor 与 Critic 耦合是重要问题 |
| 表1、图5 | TD3 在多数任务表现强,简单单摆多算法达到上限 | 不是每个表格数值都严格第一 |
| 表2 | 去掉各模块,影响随任务明显不同 | 支持组合价值,不能说三模块在每任务都不可缺少 |
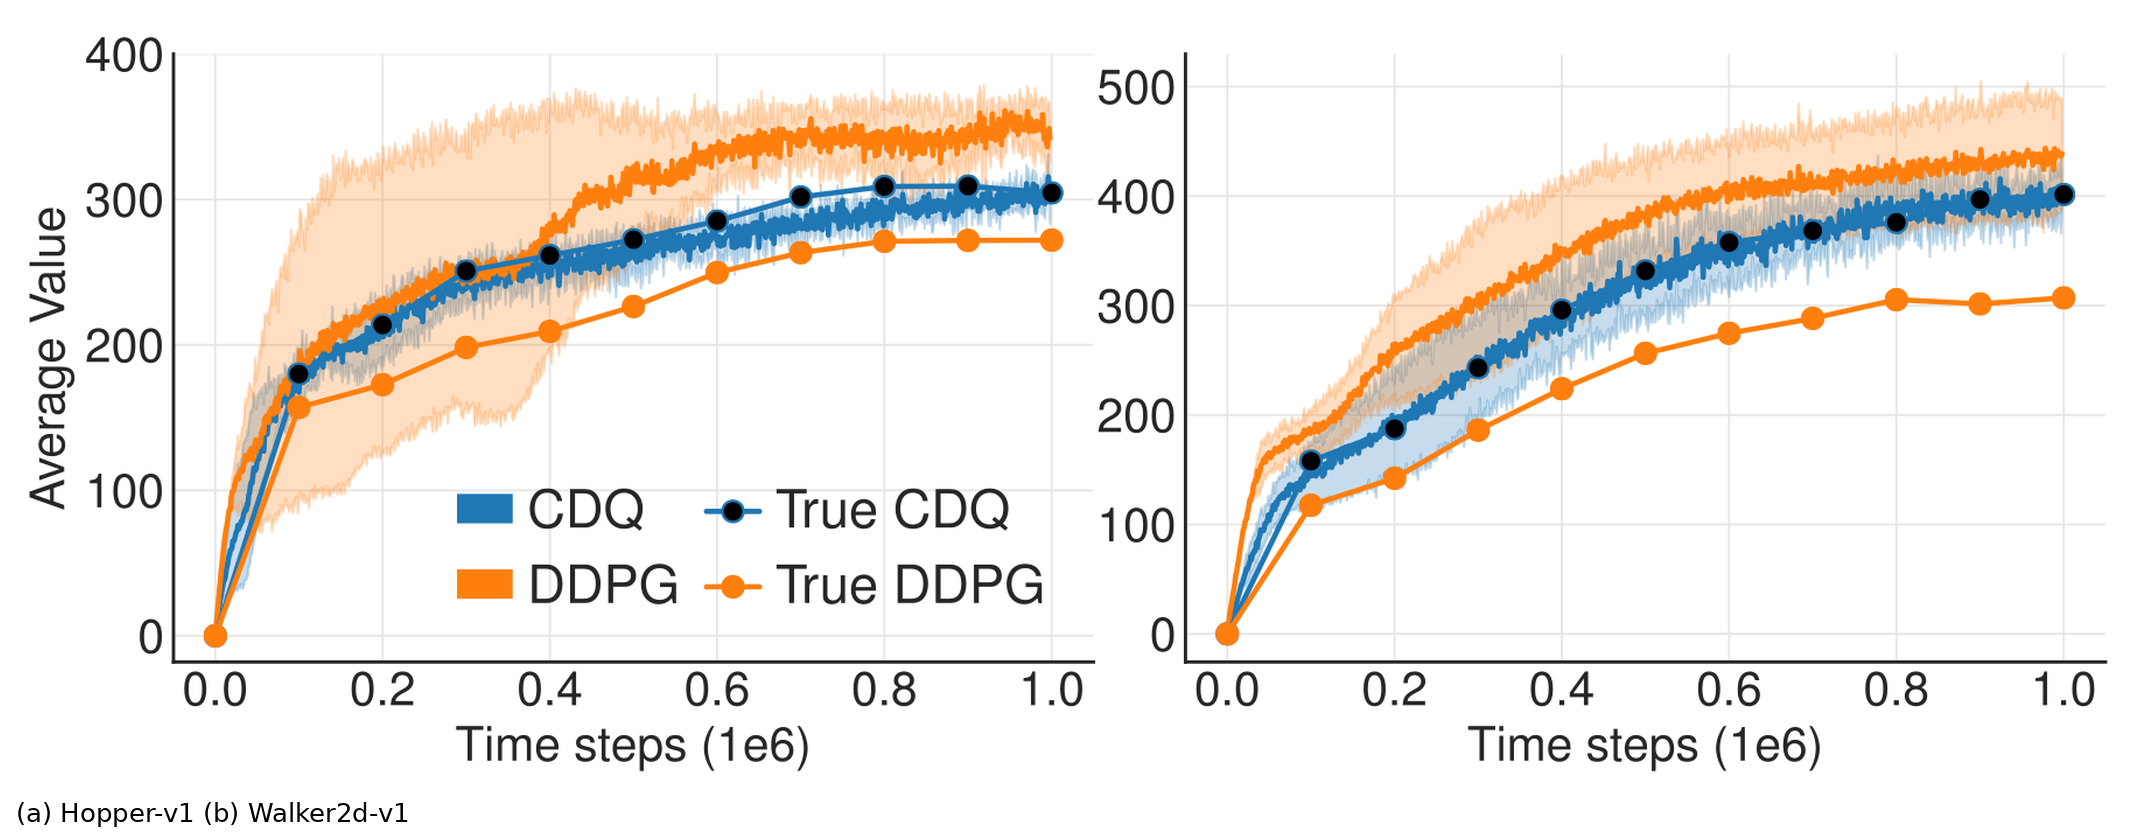
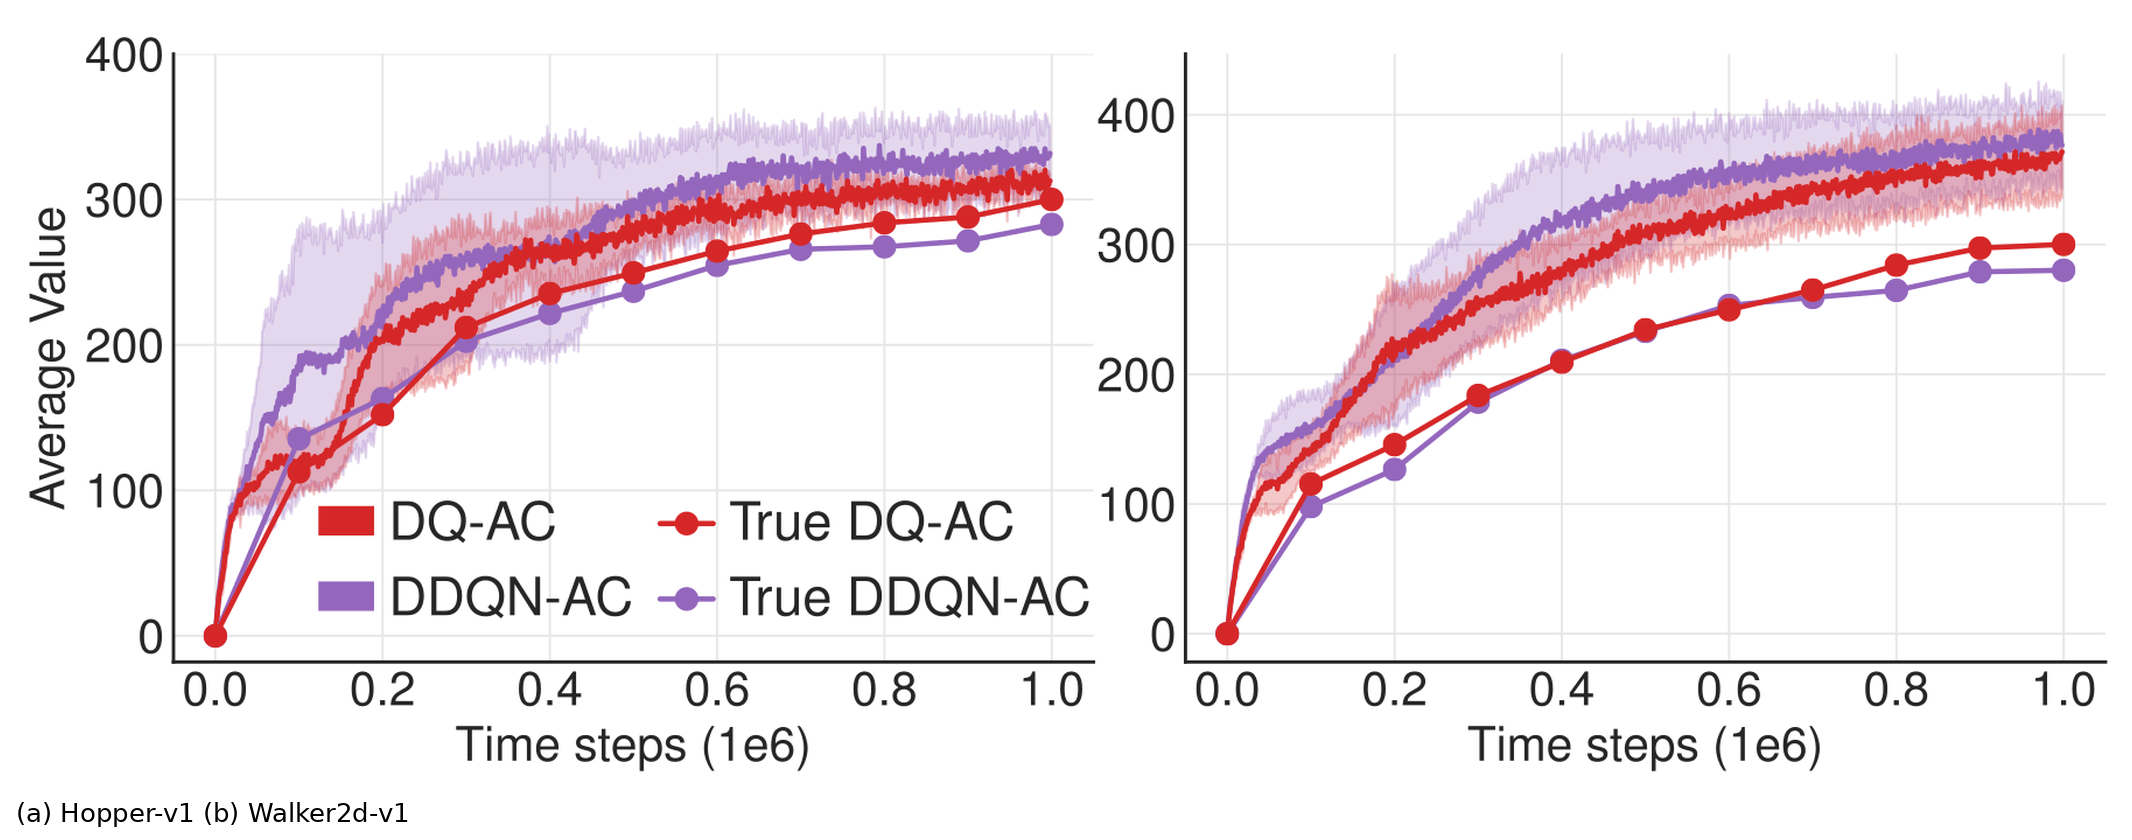
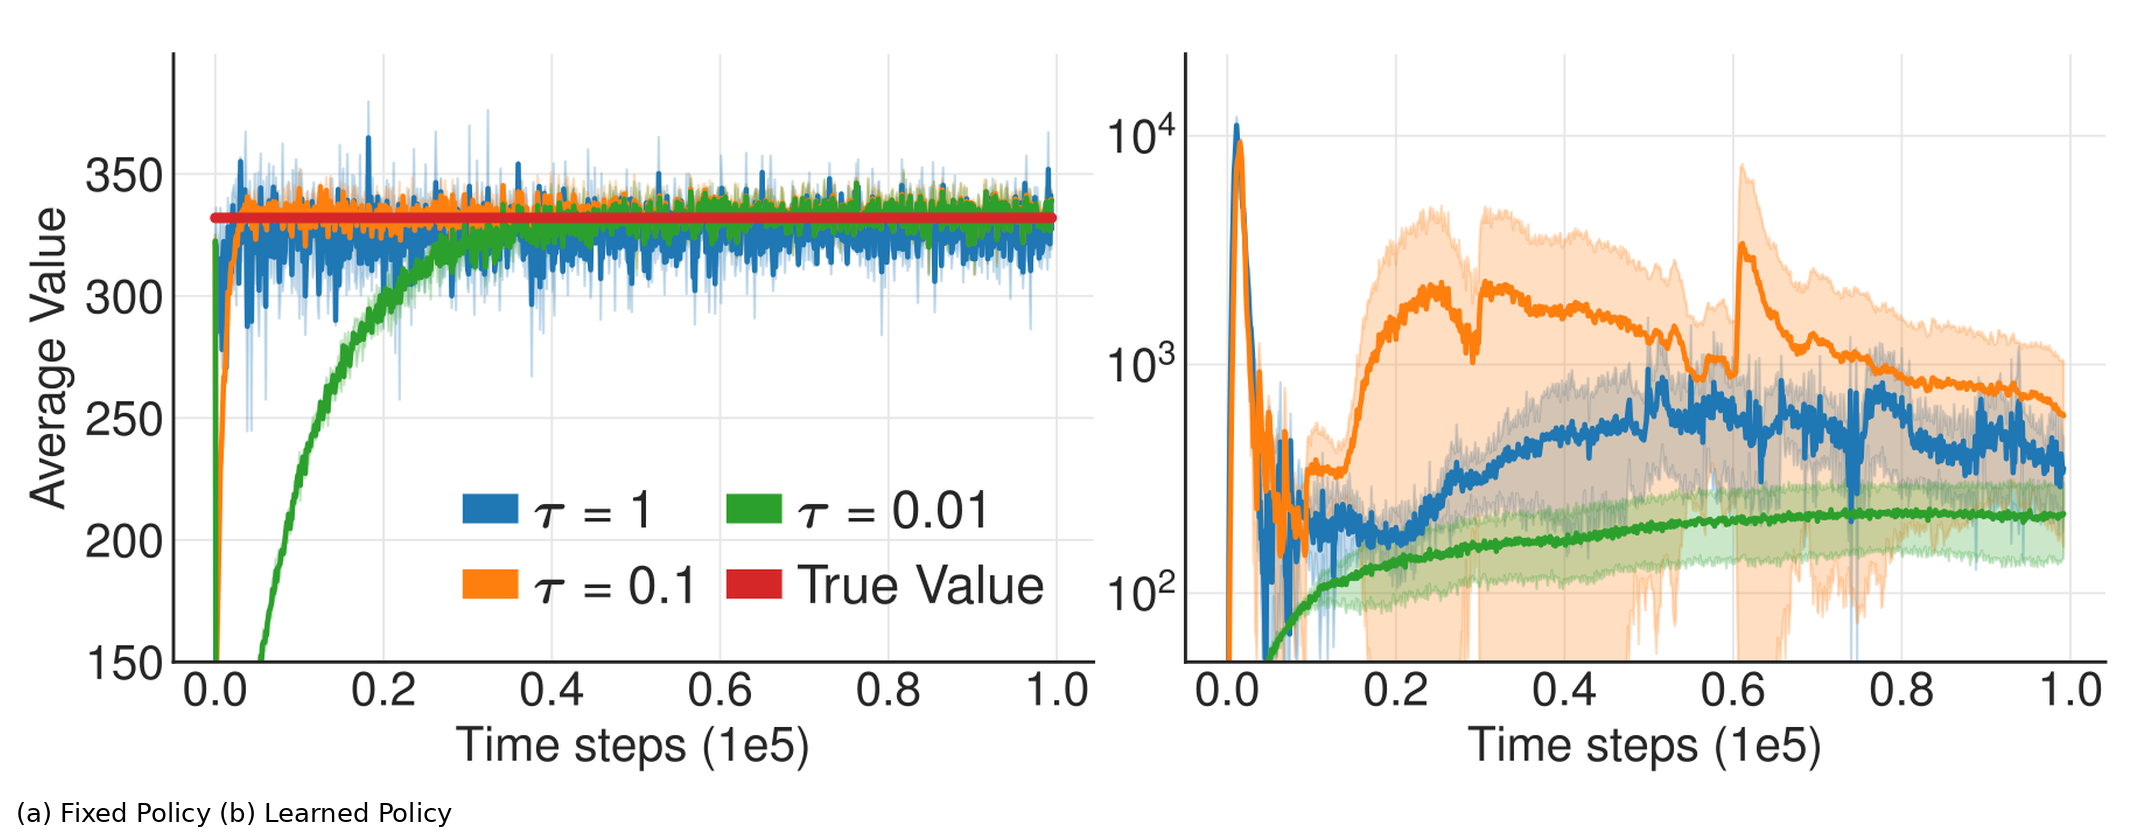
表1 报告 最大平均回报,表2 则是最后十次评估的平均值,两者不能直接拼成同一个排行榜。图5 阴影是十次运行平均评估的半个标准差;表1 的“±”为一个标准差,这也不能混称为 95% 置信区间。
以表1 为例,HalfCheetah 的 TD3 为 ,原 DDPG 为 3305.60,而重新调参的 DDPG 已到 8577.29。相对后者,均值差为 1059.66,约 12.35%;相对原始实现则大得多。这个例子说明选择哪个参照决定“提高多少”的含义。
表1 中双摆 DDPG 为 9355.52,TD3 为 9337.47。因此摘要里的全面优胜措辞应结合接近饱和任务和统计波动理解,不能改写成“所有任务严格超过全部基线”。
表2 更有教学价值:Ant 完整 TD3 为 4185.06,去双 Q 为 849.75,差别很大;但 HalfCheetah 去双 Q 为 9792.80,反而高于完整版本 9532.99。双 Q 是有价值的稳定设计,而不是每个任务上单调增加回报的按钮。
五、保守目标仍可能低估或共同犯错
TD3 把连续控制中的高估、方差累积和策略更新耦合放进同一个分析框架,提出了简单、可插入 DDPG 的工程修正。附录的有限 MDP 收敛结果不等于神经网络 TD3 在任意机器人任务都收敛。
与 SAC 对比也要保留版本边界。本篇使用当时的 SAC 实现,附录 E 专门讨论实现及结果差异;不同论文的基准协议和版本并不构成永久的算法胜负关系。更合理的阅读方式是理解两条路线:TD3 保留确定性目标并约束误差,SAC 用最大熵随机策略改变优化问题。
本文的分析是,最小 Q 值也可能过于悲观,尤其在数据覆盖不足时。TD3 没有明确限制 Actor 只能选择数据支持的动作,因此离线使用时仍可能遇到分布外高估。它也未解决真实硬件安全、视觉表征或稀疏任务发现问题。
追问:两个Critic高度相关时,取最小值为何可能帮助有限?
参考答案:取最小值主要避免追随某一个网络独有的乐观偏差;若两个网络在同一支持不足区域一起高估,较小者仍可能很高。可保持数据与网络预算,记录预测差异、共同偏差和最终回报,而不是把两网络数量当作独立证据。降低相关性也不是越强越好,额外噪声和低估需要一并评估。
六、沿机制关系继续读
本篇直接继承DDPG,并非另起一个最大熵目标;与CQL可作教学联系:二者都限制乐观价值,但CQL针对固定离线数据之外的动作支持,双Q自身不能代替离线保守正则。
七、自测三题与参考答案
问题1:TD3 的两个 Q 取最小值后,为什么不等于有保证的下界?
答案:两个预测都可能高于真值,例如真值为 5,预测为 8 和 10,最小值仍是 8。该机制限制相对高估倾向,缺少校准误差界时不能宣称数学下界。
问题2:把探索噪声加大,能否替代目标策略平滑?
答案:不能。探索噪声改变采集到的数据;目标平滑改变每次 TD 标签使用的下一动作邻域。即使经验池不变,也能改变后者。因此二者独立影响学习,过大的探索还可能降低任务采样质量。
问题3:Actor 只更新一半次数,为什么反而可能更快学会?
答案:更新数量不是有效改进数量。如果每次都沿高误差 Critic 的梯度移动,更多更新会放大错误。先让 Critic 更接近当前数据,再做较少但较好的策略更新,可能用相同交互量获得更高回报。不过这是实验支持的趋势,不保证任意延迟都好。