020|Dex-Net 2.0:解析抓取指标与合成深度数据
原论文:Dex-Net 2.0: Deep Learning to Plan Robust Grasps with Synthetic Point Clouds and Analytic Grasp Metrics,Jeffrey Mahler 等,2017。原文。
先接住前作的问题
手眼协调提供一个阅读起点。Hand-Eye用大量真实抓取结果学习评分,真实交互和复位成本随之增加。Dex-Net 2.0把部分监督搬到解析接触模型与合成深度图,未解问题是模型定义的稳健抓取怎样对应真实成功。
五个前置概念
五个概念是:对向抓取以相对表面接触形成夹持;摩擦锥限制接触能够提供的力方向;抓取扳手空间描述接触可抵抗的力与力矩;鲁棒质量在位姿和摩擦不确定性下评估抓取;候选排序先生成可行动作,再挑高分动作。
一、问题设定:如何用合成监督减少真实抓取采集
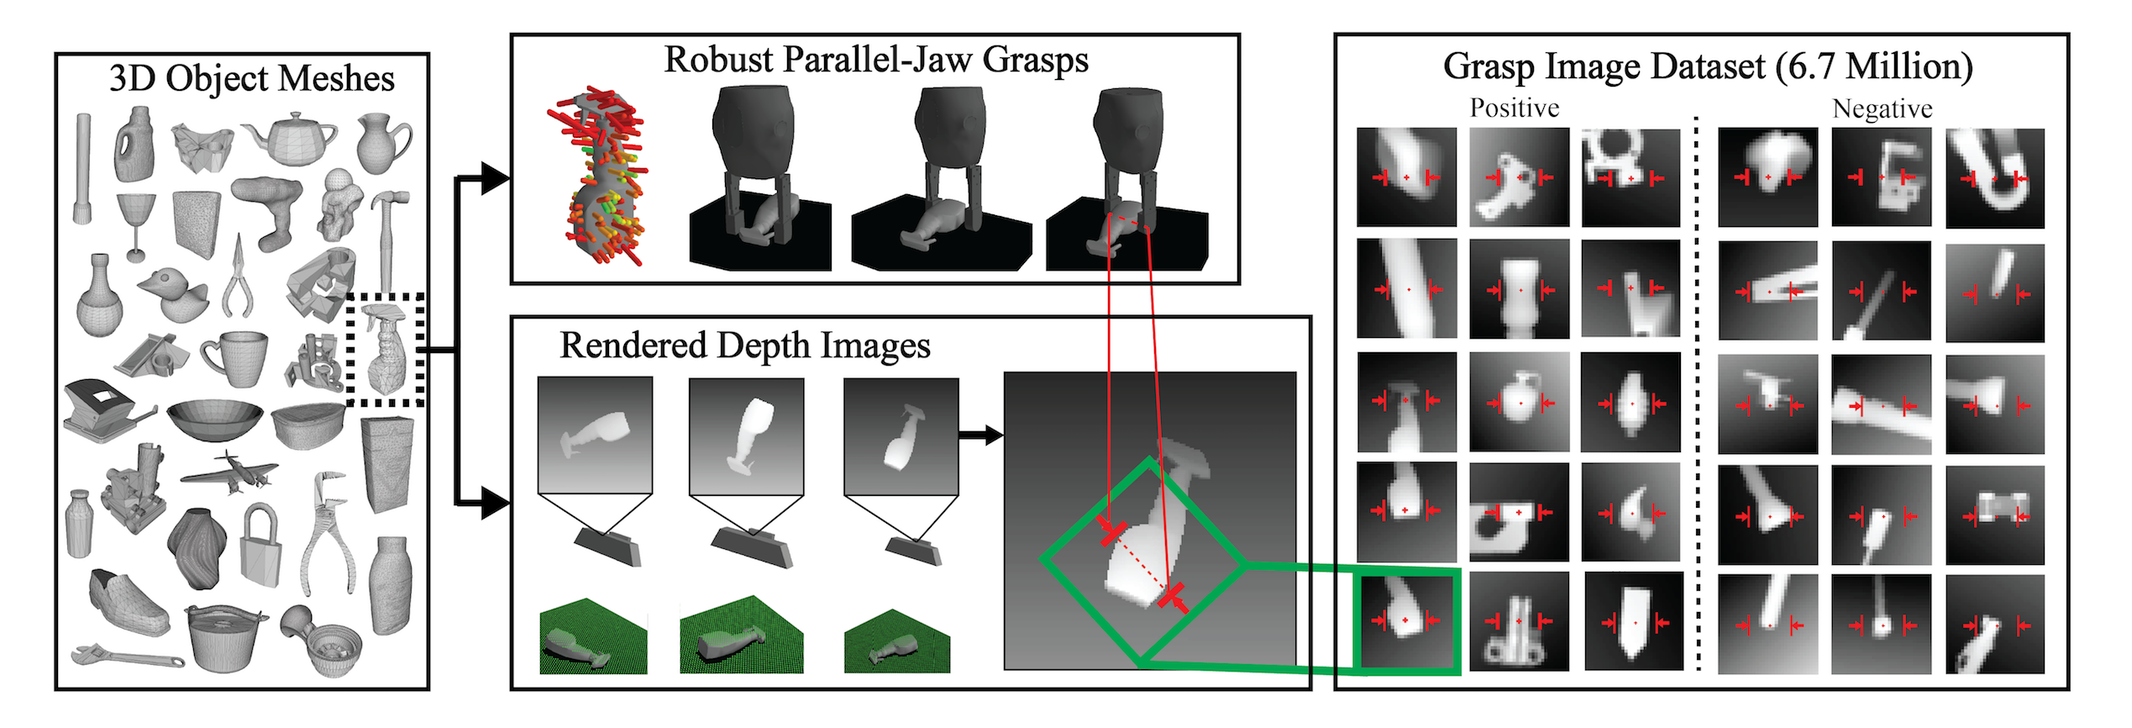
真实机器人收集百万次抓取很昂贵。Dex-Net 2.0 将一部分代价搬到离线:从物体网格生成抓取候选,用解析力学和不确定性采样评估质量,再渲染带噪深度图,训练神经网络快速预测候选抓取的可靠性。
输入是深度图和候选抓取,输出成功鲁棒性分数。抓取由空间中心、桌面内方向及高度描述,采用平行夹爪。主问题假设物体已从堆中分离,不能把后续杂乱场景系统演示说成网络直接解决了全堆抓取。
虽然网络写作 ,这里主要是单次抓取成功预测,不是用 Bellman 自举训练的长期动作价值。文章属于监督式机器人学习加抓取规划,不应仅凭符号Q把它归类为深度Q学习。
二、把解析质量、深度对齐与候选搜索接起来
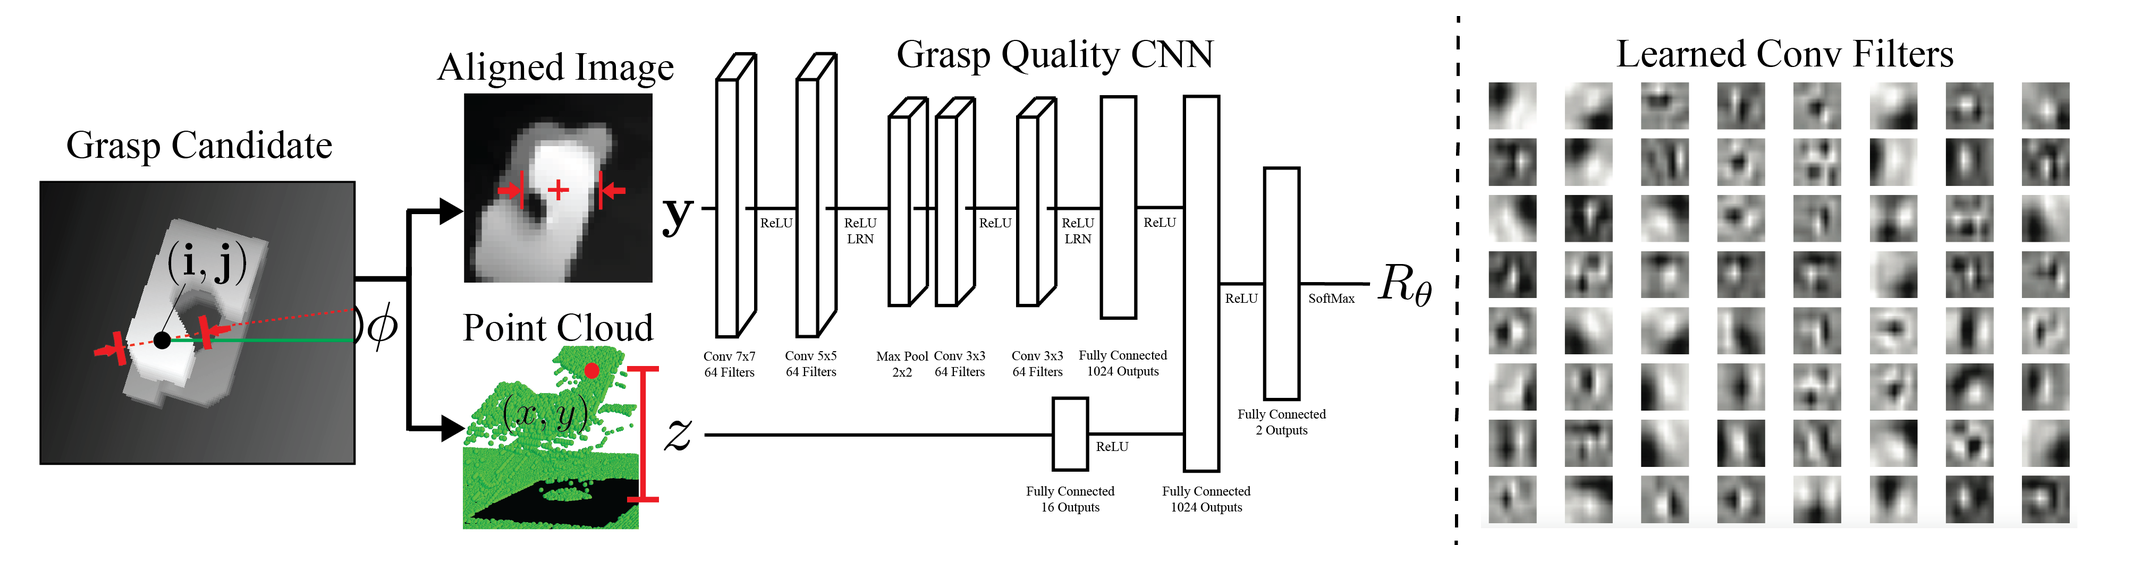
部署时不必先把整个点云精确匹配到已知三维物体,再查找预计算抓取。网络直接对深度图中的候选抓取打分,规划器执行可行的高分选项。
令隐藏场景状态为 ,深度图为 ,抓取为 ,解析成功标签为 。数据生成分布分解为:
覆盖物体、姿态、摩擦与相机, 加入传感器噪声, 提供抓取候选,最后一项来自解析质量。模型并没有从真实失败中发现全部物理规律,物理假设已经进入标签。
解析标签要求鲁棒 epsilon 质量超过阈值且无碰撞。鲁棒性通过对抓取位姿、物体位姿和摩擦变化采样估计。这里阈值化后学的是“按该模型可认为可靠”的事件,不能直接把神经网络分数当成对所有真实场景校准过的概率。
训练使用交叉熵:
如果数据分布与物理标签都恰当,它能学到候选抓取的相对质量。若标签忽略了重要的柔性或接触动态,更多同类合成数据可能只是更准确地复制该偏差。
把抓取对齐到同一个坐标框架
每个候选将深度图平移、旋转并裁剪,使抓取中心与方向对齐,再提供抓取深度。这样网络不必从零学习同一局部几何的所有平移旋转版本。
可把它理解为一种人为设计的等变处理:不是要求CNN自动发现所有对称性,而是先把问题规范化。网络因此更专注夹爪附近的边缘、空间和碰撞关系。代价是全局障碍仍需可行性检查补充。
搜索与质量网络分离
执行策略为:
包含运动学可达、桌面无碰撞等限制。原文主对照使用候选采样,后续40物体泛化测试又加入 CEM 搜索,不能把两个规划预算混成同一结果。
网络负责快速预测,解析几何负责标签与部分约束,规划器负责动作执行。理解这种分工,比把系统一概叫“端到端AI抓取”更准确。
搜索器越努力,越需要关注质量模型没见过的输入。原文附录展示某些完全错过物体的抓取仍获非零分,并指出此类候选不在训练集中。它与一般分类测试误差不是同一问题:规划器会主动寻找预测峰值,从而放大罕见高估。原文CEM附录
教学例:100个候选里99个可行但预测0.8,另一个不可行却误报0.95,argmax会稳定选错;随机挑选反而很少撞上这个错误。这不是主张取消搜索,而是要求候选生成、碰撞过滤和训练负样本共同约束搜索域。于是40物体实验使用CEM,既增加寻找狭窄好抓点的能力,也改变了模型误差被利用的机会;不能与固定候选预算结果直接归因比较。
一个自构示例
未运行的教学例子:杯柄孔很窄,某候选夹爪从图像上看能插入,但深度相机漏掉杯柄一侧。网络可能得到高分,真实执行却碰撞。若另一视角补全了缺失边缘,候选排序才可能改变。
再设100次尝试中只对20次预测“鲁棒”,这20次全成功,其余80次成功50次。precision是100%,总成功率却是70%。这组自构数字解释两个指标为何必须并列,而不代表论文结果。
三、离线生成解析标签,在线筛选可行抓取
解析模型负责产生质量监督,GQ-CNN负责快速近似该评分,搜索器负责提出候选。实现时把深度补丁与抓取坐标对齐,才能让网络学习同一种几何关系。
离线生成:
    选择物体模型和稳定放置姿态
    采样对向平行夹爪抓取
    在位姿、摩擦扰动下评估解析质量并检查碰撞
    渲染带噪深度图
    对每个抓取规范化图像,保存质量标签
训练:
    用交叉熵拟合 GQ-CNN
部署:
    从真实深度图生成候选
    规范化候选图像,批量预测鲁棒性
    排除不可达及已知碰撞候选
    执行最高分抓取
    可选用 CEM 进一步改进候选分布
四、分别计算高分抓取精度与覆盖率
作者展示了合成数据训练与真实抓取验证。实验支持桌面分离物体的平面平行夹爪抓取,并包含新物体测试。
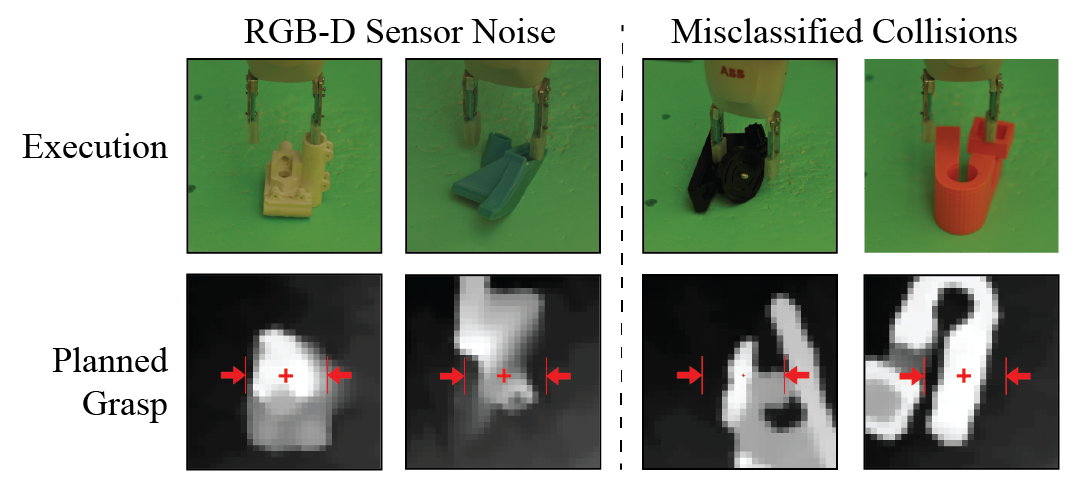
原图怎么读: 图9,原论文图注与图像。左侧失败关联重要几何的深度缺失,右侧关联碰撞误判。回到这两类原图,才能判断问题出在观测覆盖还是抓取评分,而不是一概增加模型容量。
| 项目 | 原文信息与注意点 |
|---|---|
| 合成数据 | 1500个模型、约670万抓取图像数据点,不是670万种物体 |
| 正例 | 质量阈值下约21.2%为正,类别不平衡会影响准确率解释 |
| 训练 | 大模型5个epoch、batch128,GTX1080约48小时 |
| 平台 | ABB YuMi及定制硅胶指尖,深度相机输入 |
| 已知物体 | 8个具有挑战几何的物体,每方法80次 |
| 新物体对照 | 10个家居物体,每方法50次,参数依据训练对象选择 |
| 更大泛化测试 | 40物体、100次,使用CEM增强规划 |
| 指标 | 成功率、precision、被判鲁棒比例、规划时间 |
| 统计 | 表V–VI给成功率95%置信区间,不把单点差异自动视为显著 |
训练与验证的图像划分不能独自证明物体级泛化,因为同一个物体可以出现在不同图像。真实新物体试验补上了部分证据,但其数量和物体限制仍应保留。
物体重量、指尖厚度、夹爪张开范围等影响可抓集合。与其他平台论文比数字时,先比较任务和硬件容差,再讨论学习方法优劣。
证据:precision尤其容易误读
以下依据原文全文。
| 位置 | 观察 | 正确理解 |
|---|---|---|
| 图3、图4、第IV节 | 解析标签与规范化深度图训练GQ-CNN | 物理先验进入数据,而非被完全替代 |
| 表V | 已知物体学习方法约93%成功,与注册方法接近且更快 | 对象已知、测试预算限定 |
| 表VI | 新10物体GQ成功率80±11%,precision100% | 100%只针对29个被判鲁棒的正例 |
| 第VI-G节 | CEM增强在40物体100次中94%成功、99%precision | 规划约2.5秒,不是前一对照的0.8秒 |
| 图9、第VI-I节 | 薄部件深度缺失与窄处碰撞造成失败 | 传感器与几何误差仍制约性能 |
precision为“预测鲁棒的抓取中有多少成功”,成功率为“所有执行尝试中有多少成功”。若系统只把很少候选判作鲁棒,可以取得高precision而覆盖率低,因此必须同时看 Robust Grasp Rate。
第VI-G中的99%来自68/69个正预测成功,四舍五入约98.55%;它不是100次中99次成功。表VI的100%也只有29个正预测样本,不能解释为以后不会失手。
五、解析标签和深度缺陷限定概率解释
解析标签依赖刚体、摩擦和准静态等假设。即使测试包含部分可变形物体并有好结果,也不意味着训练已经学到完整变形力学。这里的跨物体成功可能来自局部几何足以支持部分抓取,是合理分析而非作者已证明的机制。
深度图看不见的薄结构尤其危险:网络可能把缺测当作自由空间。更强CNN并不一定解决信息缺失,需要更好感知或额外碰撞检查。论文的订单履行演示还使用另一个推动分离策略和颜色识别,应作为组合系统阅读。
追问:提高抓取分数阈值时,为什么应同时报告被拒绝的比例?
参考答案:较高阈值可能只留下少量容易样本,使执行集合的precision提高,却降低系统在全部场景中愿意尝试的覆盖率。应在同一物体集合上画出阈值变化时的执行比例与成功比例,并统计拒绝后的处理成本。这个检查来自本篇precision定义,不要求把质量网络分数未经校准地解释成真实概率。
六、沿机制关系继续读
与Hand-Eye是平行抓取方法;与QT-Opt可做教学比较:两者都能在质量网络上搜索,但解析静态抓取质量与多步学习到的Q值不是同一个标签。
七、自测三题与参考答案
问题1:为什么叫Q网络,却没有目标网络和TD误差?
答案:Q在这里表示抓取质量或成功概率,训练标签由解析计算提供。符号相同不代表算法相同;是否有Bellman递推才是区分长期RL价值学习的重要依据。
问题2:99%precision能作为99%抓取成功率宣传吗?
答案:不能。它是被判作鲁棒的子集准确性,分母不同。需同时报告全部执行成功率、正预测数量与比例,才能判断系统可靠性和覆盖范围。
问题3:合成数据越多是否一定更接近真实成功概率?
答案:不一定。更多数据降低抽样误差,却不能消除错误摩擦模型、漏掉的接触因素或传感器分布差异。应把模型误差与有限数据误差区分开。