021|DART:在专家示范中注入恢复机会
原论文:DART: Noise Injection for Robust Imitation Learning,Michael Laskey 等,2017。原文。
先接住前作的问题
DAgger在学习者访问的状态上询问专家,但让较差策略持续控制可能带来危险和标注负担。DART改为让专家继续控制,注入接近学习者误差的扰动;共同目标是恢复状态覆盖,采集主体和成本并不相同。
五个前置概念
五个概念包括:协变量偏移指训练与执行状态分布不同;误差累积指动作误差改变未来输入;噪声协方差描述扰动大小及各动作维度关联;经验风险最小化用监督损失训练策略;留出数据用于评估拟合误差而非重复测训练集。
一、问题设定:怎样在专家控制下收集恢复行为
一条完美示范可能没有教机器人如何恢复。夹爪偏左一点时,人会顺手修正;如果所有训练轨迹都毫无偏差,学习者真正执行时反而不知道怎样回到正确路线。
状态 可以是模拟机器人状态或视觉观测;专家输出 。实际执行带噪动作,让下一状态产生偏差,再由专家给出纠正控制。学习者训练目标仍是模仿专家意图,而不是学习随机扰动本身。
这属于示范收集策略的改变,没有另学环境模型或奖励函数。论文将其称为 off-policy imitation,因为学习者不直接主导采样分布;不要把这个术语自动等同于离线RL中的固定历史数据,因为DART仍分轮收集新示范。
二、从学习误差估计演示时的扰动分布
DART 在专家控制信号上加入经过估计的扰动,让专家在演示过程中自然展示恢复动作。它与 DAgger 的区别是:主要让专家继续控制,在专家附近制造适度偏差,而非让当前学习者长时间自主运行后再索要标签。
令专家受扰动动作分布为:
各向同性噪声 对所有动作维度一视同仁,但机器人可能主要在某些关节上犯错,也可能存在耦合偏差。因此 DART 根据当前学习者相对专家的误差估计协方差:
对角元素反映各维误差能量,非对角元素反映同时偏移方向。它不是对真实执行轨迹分布的精确复制,而是通过易估计的动作误差构造近似扰动。
若希望每条轨迹总扰动平方量约为 ,可缩放:
因为零均值高斯噪声的每步期望平方范数等于协方差的迹。这里的 是对最终误差规模的先验选择,并不是自动发现的唯一正确值。估计为零或数值退化时需要处理,教学公式未覆盖所有工程保护。
监督标签究竟是哪一个动作
按作者博客的恢复示范图把一次采集拆开:专家观察并给出,系统执行而到达,专家再根据真实纠正。存入监督数据的是,不是;噪声作用于环境访问,干净专家意图负责标签。若只在旧文件里改动作列,既没有新的,也没有对应恢复反应,不能替代这条闭环因果链。
理论到底说了什么
第4.2节分析带高斯噪声专家分布与学习者轨迹分布的距离,并以确定性专家且学习者存在误差的设定说明加噪可改善相应分布差异界。理论假设专家自身不因噪声而改变判断机制。
对真人,这个假设并非总成立:扰动太大可能让人紧张、延迟或采取不同策略。因此理论连接提供方向,不能作为物理安全证明,也不保证每一种扰动都提高任务成功率。
优化对象是监督模仿损失,机制改变是示范状态覆盖,实验指标是独立策略回报或任务达成。训练时带噪专家仍表现良好,不等于最终策略已经学好,两者需要分别测量。
协方差学习中容易误叫“方差”的量其实是误差二阶矩。令 为学习者与专家动作之差,则。若学习者总向右偏0.1,即使偏差没有随机波动,二阶矩仍为0.01;零均值扰动会向左右两边扩展状态,无法精确复制单向偏差。DART是在易操作的噪声族中近似覆盖,并非识别了完整学习者误差分布。
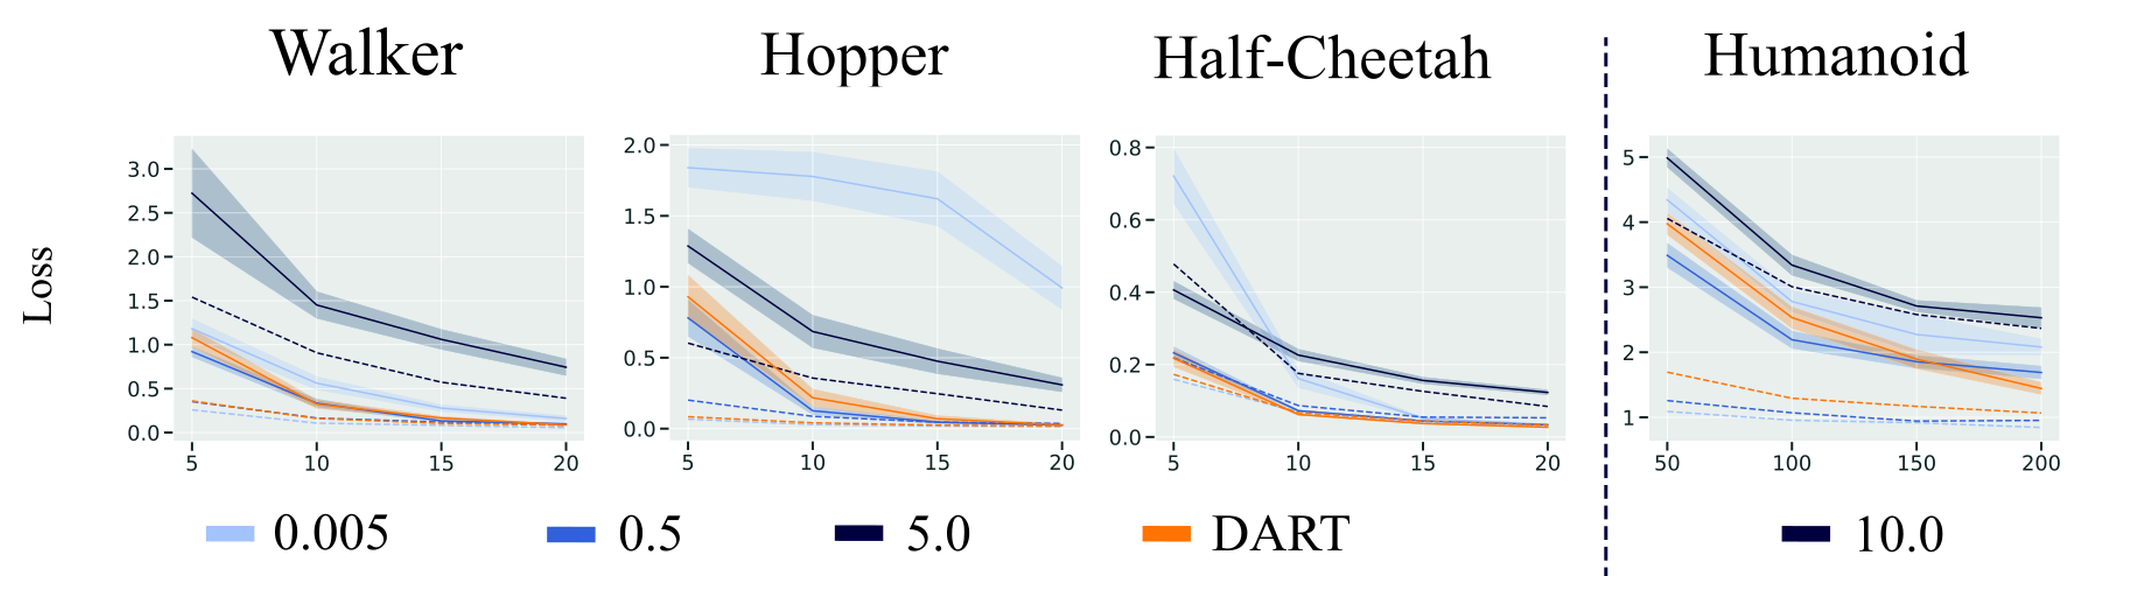
这也让附录随机协方差对照更有意义:作者发现误差总量选得好时,随机方向可能接近DART。不能把所有收益都归因于学习到了精确耦合方向;噪声规模与方向应该分开消融。原文协方差对照
一个自构例子
未运行的教学例子:专家把夹爪移动到瓶子前,系统轻微向左偏。专家下一步向右修正,于是数据多了“偏左时应向右”的状态标签。普通干净示范可能永远没有这种状态。
若扰动把夹爪推到瓶后完全遮挡处,专家也无法可靠判断,数据质量反而下降。适度扰动不是故意把任务搞坏,而是在学习者可能偏离的范围内观察恢复动作。范围如何估计正是算法要解决的问题。
三、扰动实际执行并保留专家意图作标签
采集一小批专家示范
训练初始模仿策略
在留出示范状态上比较学习者输出与专家标签
估计动作误差协方差,并按目标总误差缩放
重复后续采集轮次:
    专家根据当前状态给出控制意图
    在执行信号中加入估计扰动
    保存当前状态与专家原始控制标签
    专家观察偏差并继续恢复
合并示范,重新训练学习者
必要时重新估计扰动,独立评估无专家介入的策略
四、将恢复收益与重训日程分开比较
作者报告这种方式在模拟控制和真机清障任务上改善模仿。实验支持特定扰动模型与任务中的数据覆盖收益,不意味着噪声越大越好。
原图怎么读: 图4,原论文图注与图像。虚线是在受扰专家分布上的代理损失,实线是在机器人自访问分布上的损失。两线接近才针对分布偏移,单独降低一条线不足以得出同样结论。
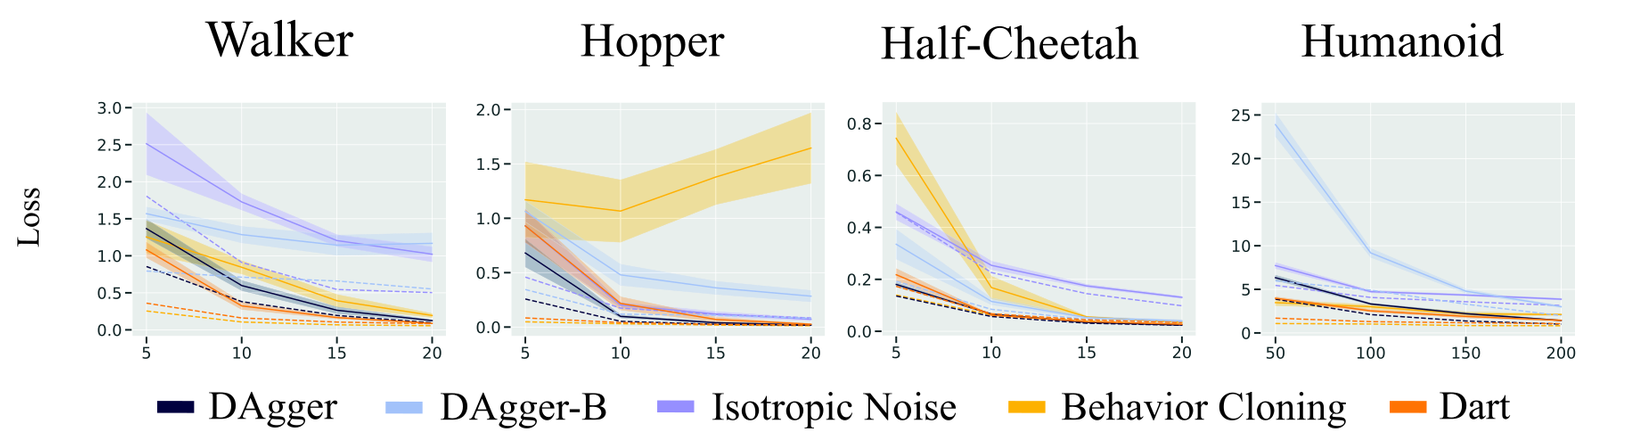
| 项目 | 原文设定及解读 |
|---|---|
| 模拟任务 | Walker、Hopper、Half-Cheetah、Humanoid |
| 模拟专家 | TRPO策略的确定性均值,学习者采用相同两层64单元网络规模 |
| 数据采样 | 每轨迹下采样50组状态控制,增加有限数据难度 |
| 对照 | BC、DAgger、低频重训DAgger-B、各向同性噪声与DART |
| 计算指标 | 比较重训耗时,另外报告采集期间回报和最终回报 |
| 真机 | Toyota HSR,为固定目标芥末瓶清理遮挡 |
| 人类研究 | 4名有机器人经验的示教者,同一人比较各方法,顺序有平衡 |
| 真机数据 | 先10条,再各方法30条,最终40条;噪声只在早期更新一次 |
| 指标边界 | 真机学习策略的成功条件是识别目标且清出夹爪通路,之后接开环抓取计划 |
最后一行很重要:不能把图3所有统计直接宣传为完整末端到末端取物成功率。原文评估定义关注清障并到达可抓取条件,系统还连接了后续计划。
相机描述在正文中出现眼在手与图3头部RGBD表述的差异,这里不据未经核对的统一视角做推论。读取视觉输入不改变本篇关于收集恢复状态的主旨。
证据与反例
依据原文全文及附录。
| 位置 | 观察 | 支持与限制 |
|---|---|---|
| 第4.1节公式、Algorithm 1 | 用学习者误差定向设置扰动 | 不等于随意数据增广 |
| Proposition 4.1 | 特定假设下的轨迹分布比较 | 不是人类适应或安全性定理 |
| 图2 | DART与DAgger最终表现接近,但训练计算与采集回报不同 | 加速依赖本文重训频率和实现 |
| 图3 | 较小噪声设置79%,BC49%,更大噪声72% | 直接反驳噪声越大越好 |
| 附录图4、图5 | 分布损失差距缩小;合适随机协方差也可有好效果 | 优化噪声有实用价值,但并非唯一有效矩阵 |
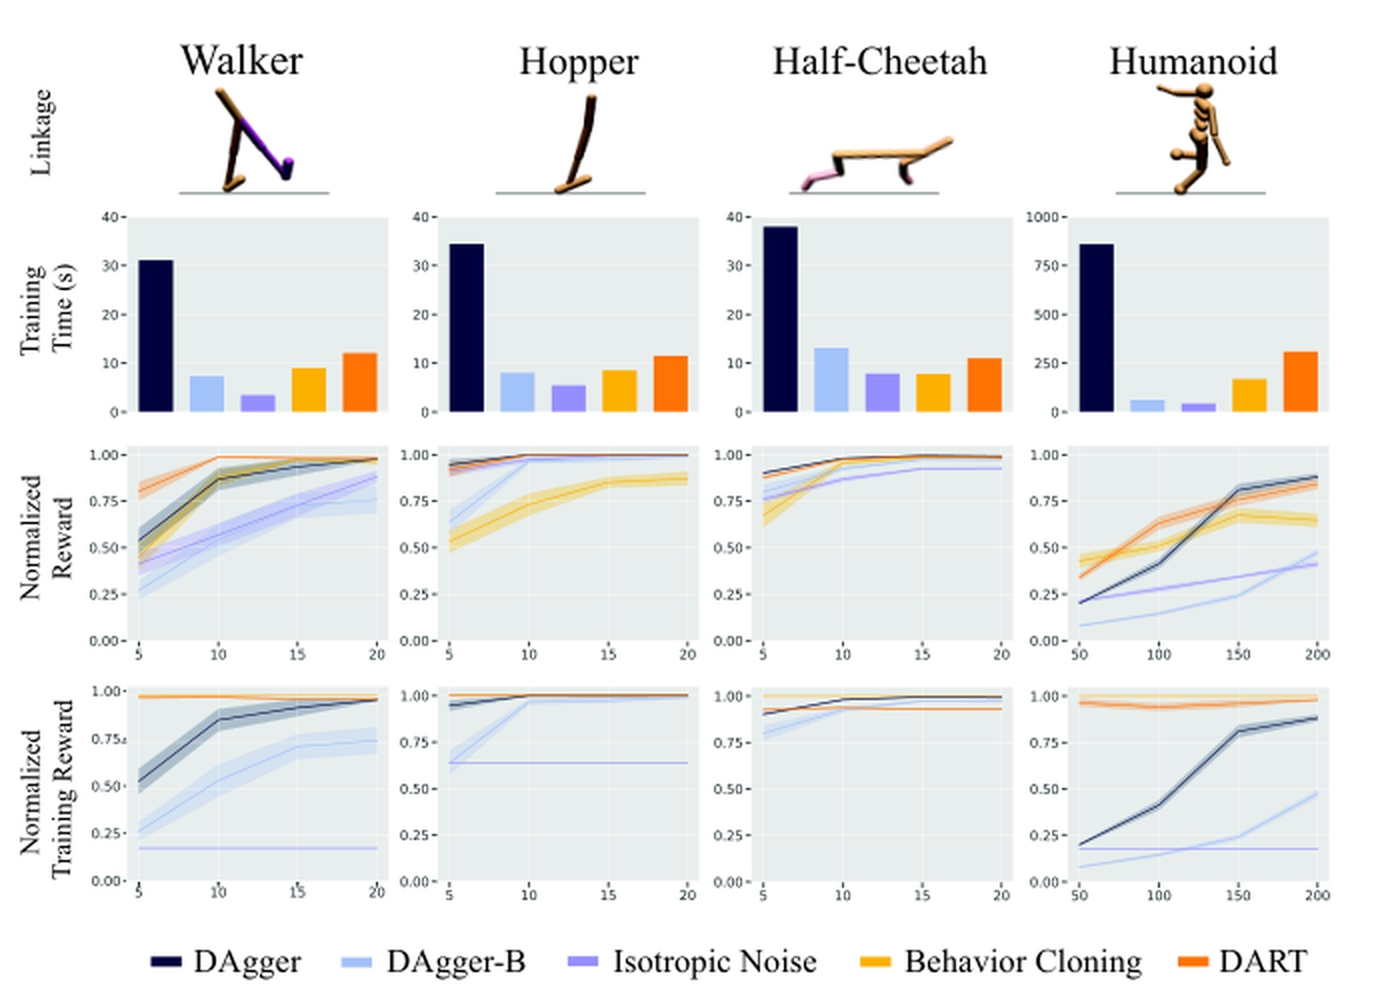
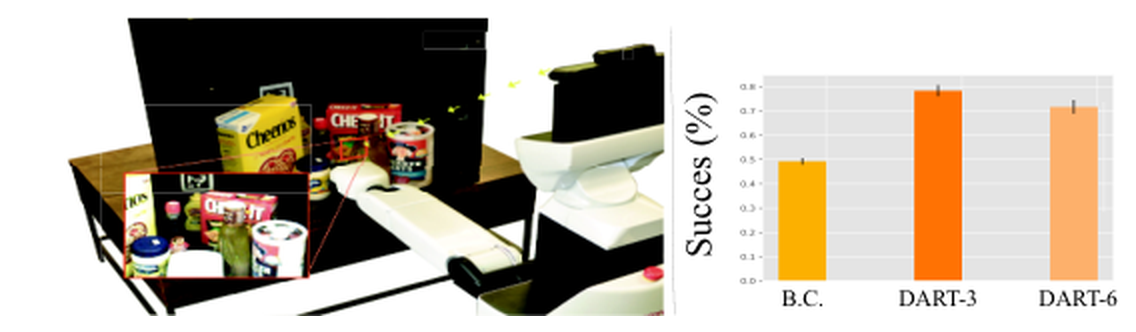
79%相对49%的绝对差为30个百分点;按这两个已四舍五入数字计算相对改善约61.2%。作者给出的约62%应理解为其原始统计的概括,不应把“62%”写为增加62个百分点。
附录还显示噪声尺度合适时,一些随机协方差也表现不错。这说明DART的重要价值包括帮助选择扰动规模,不能把全部增益都归因于学习精确相关结构。
五、全局高斯扰动未必覆盖状态依赖错误
代价是仍需专家在线演示,且模型误差估计来自有限数据。如果学习者部署会犯系统性的、状态依赖的错误,单个固定高斯协方差可能近似不足。比如只在反光时向右偏,全局噪声会在无关状态浪费扰动。
收集期间较高回报是一个实际优点,但不能取代安全约束。原文比较在任务分布内进行,稀有不可恢复偏差并未因此被排除。本文未独立复现实验;理论、作者解释与上述分析应分开阅读。
追问:学习者只在反光时向右偏,固定高斯噪声会遗漏什么?
参考答案:它可能在无关状态浪费扰动,同时低估反光状态下的系统性方向偏差。可先按可观察条件分组检查留出误差,再比较等扰动预算的全局与条件化采集。新增条件必须在采集时可获得,且恢复质量与危险状态比例要同时记录;这是对原扰动近似的诊断方向,不是原论文已经给出的安全保证。
六、沿机制关系继续读
与DAgger是平行方法,改变的都是训练状态覆盖;与动力学随机化仅有教学联系,后者改变物理参数,本篇扰动的是专家执行动作。
七、自测三题与参考答案
问题1:为什么离线给动作标签加噪声不等价?
答案:它不会改变环境访问状态,也就不会记录专家如何从新状态恢复。DART扰动的是采集时的实际执行,并保留专家控制意图作为标签。
问题2:低训练误差是否意味着可以不注入噪声?
答案:训练误差可能乐观,部署分布下误差更大。应在留出数据估计,并考虑状态分布差异;如果确实能完美表示专家且覆盖充分,原文也承认额外噪声未必有益。
问题3:为何比较计算速度要包括DAgger-B?
答案:普通DAgger在本文实现中频繁重训,耗时差可能来自更新日程。DAgger-B降低重训频率,使读者观察节省计算与性能之间的交换,避免把工程日程差全部当作算法定理。