022|HER:失败轨迹中的新目标
原论文:Hindsight Experience Replay,Marcin Andrychowicz 等,2017。原文。
先接住前作的问题
DDPG能反复使用旧转移,但稀疏任务中许多转移都只带失败奖励,回放本身不会创造到达目标的信号。HER保留物理过程,改写目标条件并重算奖励;它补的是经验解释,价值与策略更新仍由底层算法完成。
五个前置概念
五个概念是:目标条件策略把目标作为输入;通用价值函数跨目标共享价值参数;离策略学习利用其他行为策略数据;经验回放重复使用历史转移;奖励重标记根据新目标重新评价同一转移。
一、问题设定:失败转移怎样为实际到达的目标提供监督
机械臂原本想把方块推到桌角,却只推到了桌子中央。对原目标它失败了,但这段经验仍告诉我们:执行这些动作能够到达中央。HER 在回放时更换目标、重新计算奖励,把经验变成对另一个真实可达目标的学习数据。
策略为 ,价值为 。 是目标, 从状态提取已实现目标,例如物体位置。训练时给定期望位置,动作依然作用于同一个物理环境。
HER要求能够判断一个状态是否达到某个目标。若任务目标是“让人满意”,但没有可重算的评价函数,就无法直接照搬位置目标形式。它也不负责从原始图像发现所有目标语义,本文的机器人训练主要使用结构化状态。
二、保持物理转移并重算目标条件奖励
它没有伪造物理轨迹,也没有把原任务的失败算成成功。实际状态转移不变,改变的是“如果当时想去的是这里,这些动作意味着什么”。
原始转移为 。选择新的 后:
成为新的回放样本。对以下一状态位置判断成功的任务,可写:
失败为-1,达到容差为0,不是成功+1。两种奖励有时只差常数,但在终止和有限时域设置下仍要核对,不能随意改变后宣称完全复现原文。
若用DDPG,教学TD目标为:
论文机器人任务采用固定长度回合,成功不必立即终止。若移植到目标达成即终止的环境,重标记时应同步重新判断终止逻辑;只改奖励而保留原目标终止位可能产生不一致。
为什么可以换目标
关键条件是环境转移满足 。目标改变策略意图,却不改变执行同一动作后的物理机制。于是对目标 采到的转移仍能用于目标 的离策略学习。
如果目标同时决定障碍布局或重力,简单替换条件就不成立。也不能把随机环境里偶然达到的结果一律看成可控能力;选择已实现结果会带来条件选择效应,原论文的简单重标记并没有给所有随机系统提供无偏保证。这是适用边界分析。
选哪个新目标
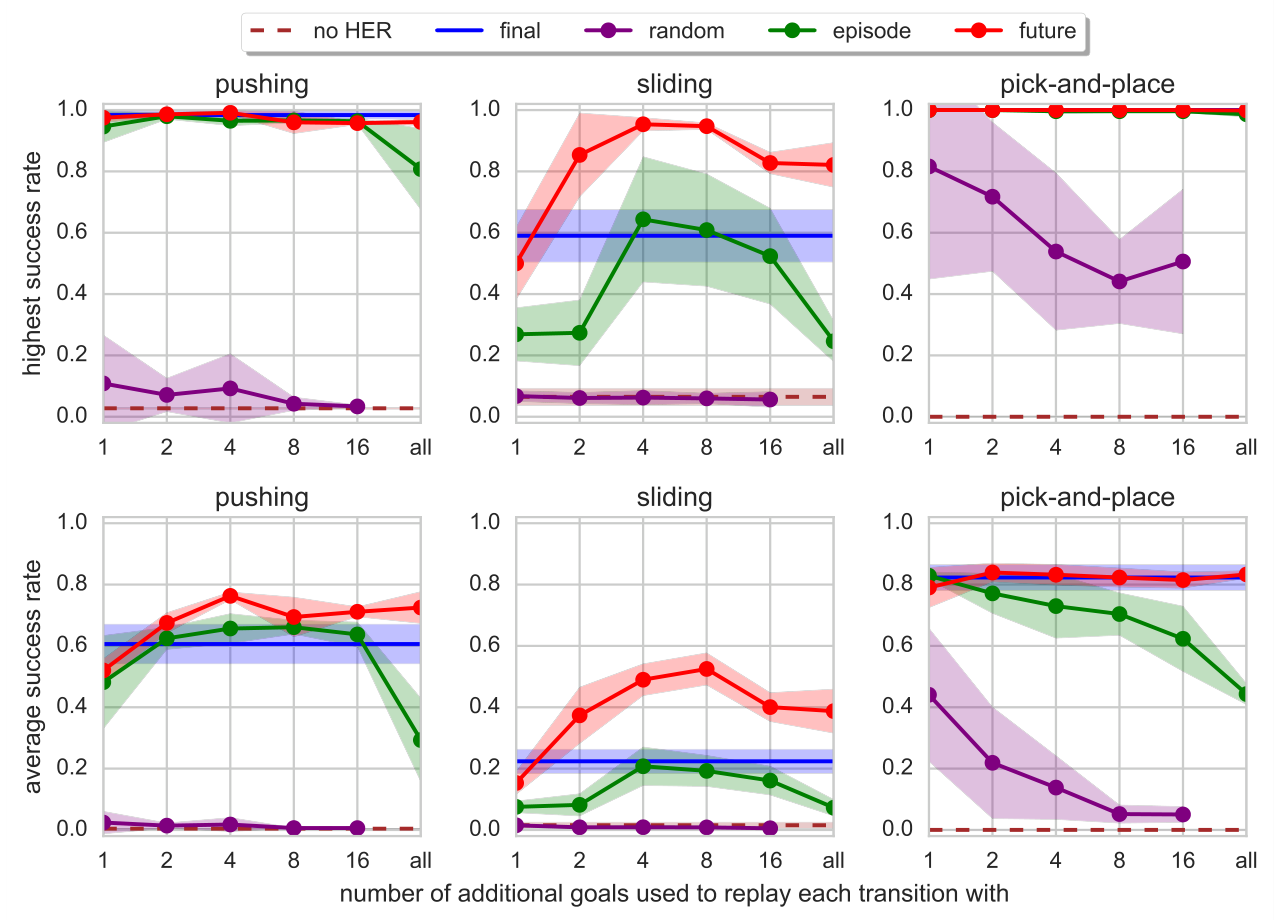
原文比较四种思路:终点目标final;同回合任意时刻episode;同回合之后时刻future;全部历史随机状态random。future更有希望提供从当前状态真正容易到达的目标。
超参数 决定额外目标数。太大将降低原始目标数据的比例,训练可能更擅长自己碰巧做到的事情,却忽略真正关心的目标。HER保留原目标样本,绝非全部数据都改成成功。
HER改变的是数据组织方式,底层策略与价值更新可以沿用已有算法。它不是一个新的环境模型,也不是额外的探索奖励。
一次失败有几份有用监督?若每个原样本再配 个新目标,均匀采样时原目标占比为 。教学计算:时为20%,时只剩5%。这不是创造了五倍独立物理证据,而是在同一转移上提出五个不同的问题;相关性依旧存在。原文图6确实显示过多重标记可损害表现。原文§4.5
还要把“学会已到达目标”与“探索到更远目标”分开。若所有轨迹都在桌面左半边,HER能让左半边监督更密,却不会生成右半边的真实接触转移。评价必须继续从原始目标分布抽样,不能只在改写后的易目标上报成功率。
一个自构计算例子
未运行的例子:目标位置10,物体轨迹从0到1再到2,容差0.1。原目标下两步奖励都是-1。将目标改成2,第一步仍为-1,第二步变为0。于是价值学习可以把“从1推到2”的可达信息传播回去。
若目标改成1,第二步可能再次离开目标。固定时域任务与到达即终止任务会有不同解释,这提醒我们重标记不只有修改一列目标值,奖励、终止、目标条件输入必须保持语义一致。
三、在回放采样时替换目标并重算奖励
新目标来自同一段真实到达经验,状态转移不变,奖励和目标输入同步改变。实现要在这一层重标记,而不是在统计原任务成功率时重新命名失败。
初始化目标条件离策略算法与回放池
每个回合:
    采样原目标,执行探索策略,保存完整轨迹
    对每个转移:
        存入原目标与原奖励
        从同回合未来状态抽取若干已实现目标
        对每个新目标:
            保持状态、动作、下一状态不变
            重算奖励,必要时重算目标相关终止
            保存重标记样本
    随机采样回放批次,更新价值与策略
独立评估原始目标分布上的任务成功率
四、核对目标采样与初始状态的覆盖作用
future采样是否有用取决于哪些状态真的到达过。机器人实验的初始状态和抓放探索条件因此与算法结果同样重要。
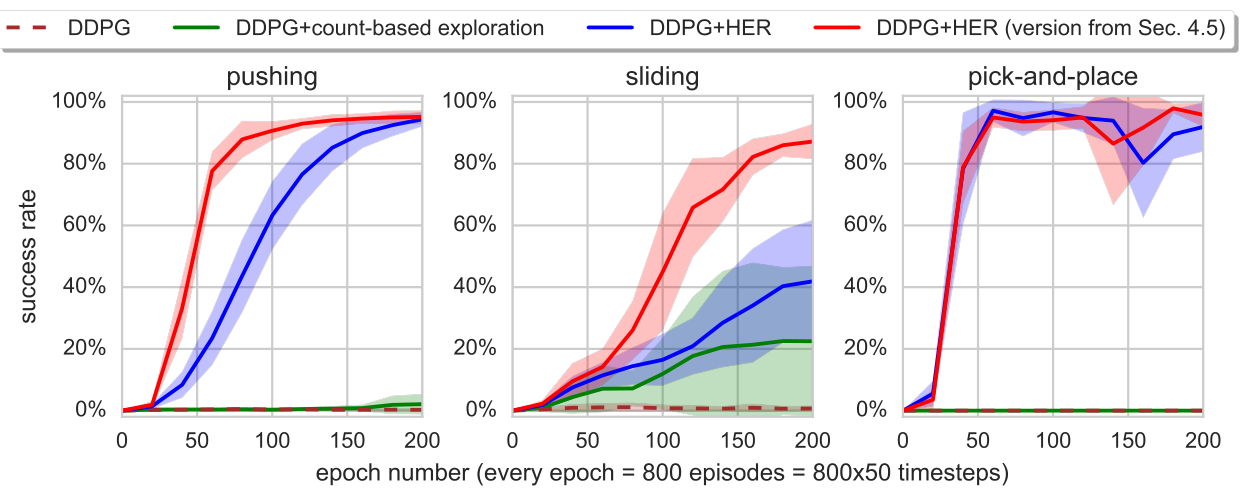
作者通过多目标机器人控制证明这种回放设计能帮助稀疏奖励学习。实验支持指定任务、目标结构与底层离策略算法中的收益。
原图怎么读: 图6,PDF第9页。上排是训练期间最好的测试表现,下排是跨训练阶段的平均表现;横向比较重标记策略时还要固定k,不能把最佳检查点与平均稳定性互换。
| 项目 | 原文设置与解读 |
|---|---|
| 任务 | Fetch推动、滑动、抓取放置,训练在MuJoCo |
| 动作 | 三维末端相对位移加夹爪开度,旋转固定 |
| 奖励 | 目标容差内0,否则-1 |
| 观测 | Actor用位置和夹爪信息,Critic额外得到速度等信息 |
| 训练预算 | 图3每epoch为800回合、每回合50步,不能把epoch当梯度次数 |
| 重复 | 5个随机种子,阴影为一个标准差 |
| 对照 | DDPG、计数探索、final与future等HER配置 |
| 成功容差 | 推动和抓放7厘米,滑动20厘米 |
| 探索辅助 | 抓放任务一半训练回合从已抓住方块的示范状态开始 |
| 真机验证 | 抓放策略部署,物体定位另用训练好的CNN |
示范状态这一项必须写出。HER能从达到的状态学习,但若机器人永远没有抓起物体,重标记不会凭空生成空中目标经验。原文脚注提到另一种目标采样安排后来可免除此技巧,但主实验条件不能因此抹去。
Critic使用更多模拟信息也是训练特权。部署只用Actor,额外信息帮助价值学习,并不要求真机获得全部模拟速度。这是明确的系统设计,不能宣传为所有组件都只看到相同输入。
证据强度与限制
依据原始PDF。
| 原文位置 | 观察 | 支持范围 |
|---|---|---|
| Algorithm 1、第3.3节 | 保留原目标并添加重标记 | 明确HER的数据操作 |
| 图3 | 稀疏奖励中HER明显帮助三类多目标任务 | 不是所有稀疏奖励任务都可解决 |
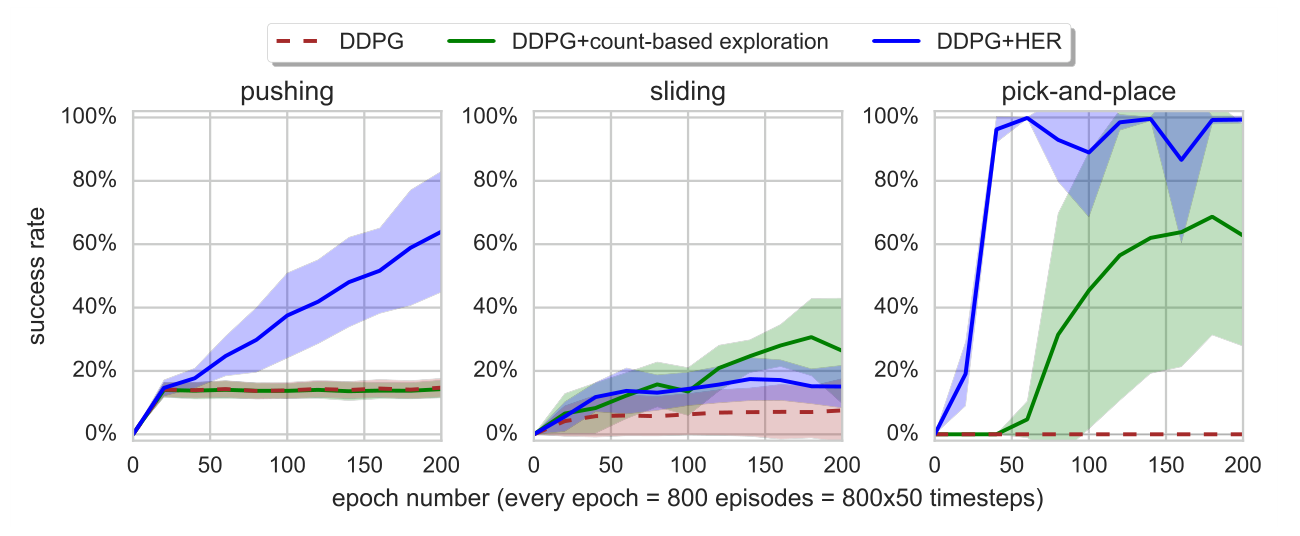
| 图4 | 只关心一个目标时,多目标回放仍有帮助 | 支持共享结构带来的训练收益 |
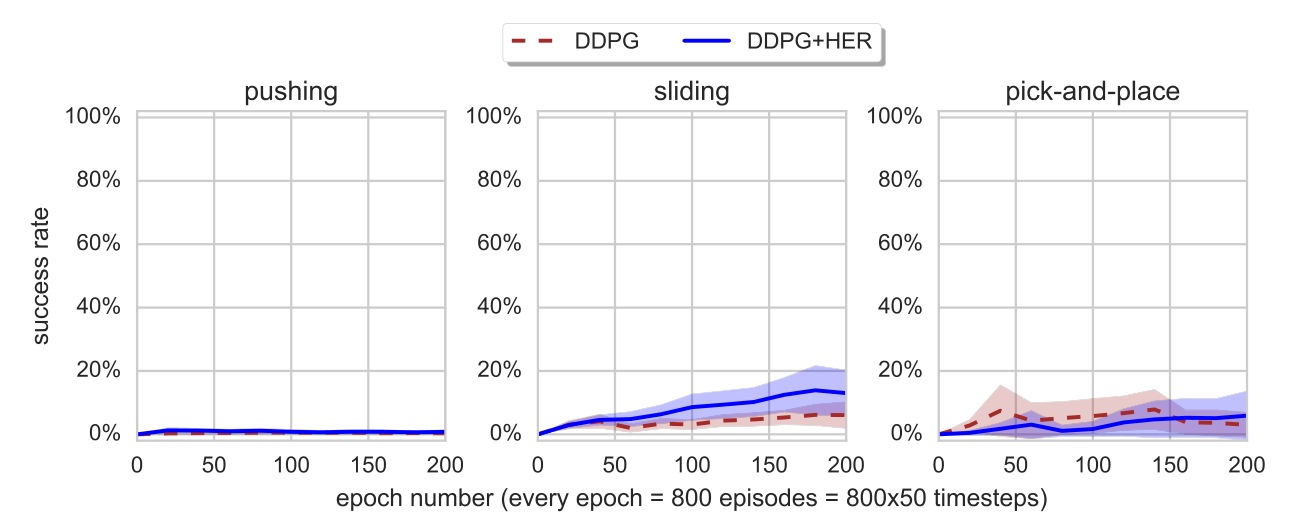
| 图5、图6 | 简单稠密奖励不佳;future的数量与来源影响表现 | 不代表所有奖励塑形都无效 |
| 第4.6节、图7 | 真机初始2/5,模拟中加观测噪声重训后5/5 | 小规模可行性验证,不是高置信部署可靠性 |
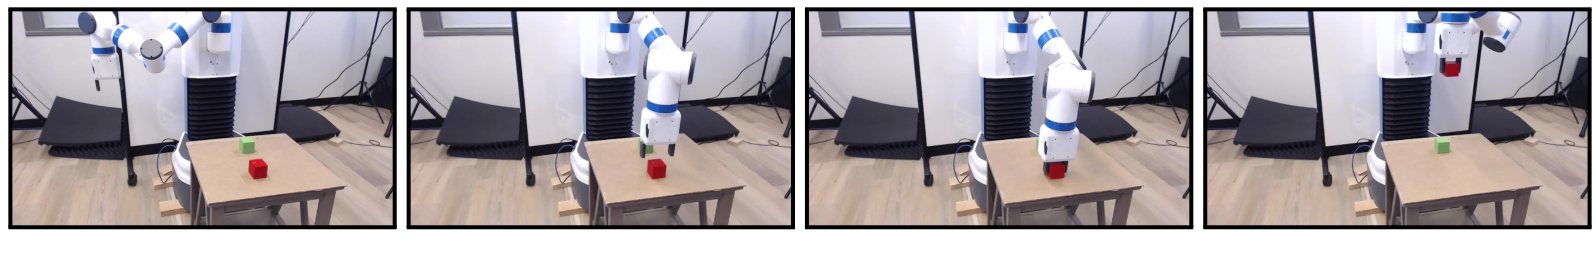
真机第二次结果依赖重新在模拟训练并加入1厘米标准差的观测噪声。所谓“无需真机微调”不应误解成首次策略直接达到5/5,或完全无需根据部署误差改进训练。
图6同时报告训练过程中最高成功率与跨epoch平均成功率,二者回答不同问题。最高点反映曾达到的峰值,平均值还受到学习速度与稳定性影响,不能挑一个更好看的数字代替全部曲线。
五、目标相关动力学会破坏重标记前提
HER最重要的思想是把目标语义带入数据复用。失败数据不再仅提供统一负信号,而能揭示“如何达到别处”。多个相关目标共享参数,形成由已达结果构成的隐式学习课程。
但它不改变已经采到的数据覆盖。如果行为只会在原地抖动,重标记主要教会原地附近目标。稀疏奖励包含“缺乏有用反馈”和“根本没有触及相关行为”两种困难,HER主要补救前者,并借共享结构间接帮助后者。
机器人目标还可能包括不碰倒旁边物体、保持方向和控制力。只把目标写成末端物体位置会忽略这些要求。问题不能归咎于HER伪造成功,而应检查目标定义是否完整。本文未独立复现训练与真机部署。
追问:如果目标本身改变了环境转移,还能直接套用HER吗?
参考答案:不能仅换奖励就视为同一有效样本。HER的重用依赖这段状态动作转移在新目标下仍成立;若目标触发不同障碍、控制规则或物理参数,旧转移可能不来自新任务。应明确把影响动力学的变量放入状态或任务定义,并检查条件转移是否一致。目标可计算不等于目标可任意置换。
六、沿机制关系继续读
HER与DDPG属于模块组合:前者重组任务条件和奖励,后者更新actor/critic;动力学随机化又将HER接入跨物理参数训练,稀疏奖励和迁移覆盖是两项独立贡献。
七、自测三题与参考答案
问题1:HER是不是把失败偷偷算成成功?
答案:原任务评价没有改变。它只在训练中另问一个目标,并用真实转移回答;最后仍在原目标分布评估。混淆发生在把重标记训练成功率当成部署成绩时。
问题2:为什么future往往比全历史random更有用?
答案:未来同轨迹目标与当前转移在可达性和局部上下文上相关,全历史目标可能完全遥远,重算后仍全是失败。这个解释与原文消融一致,但不是任何环境下future必优的定理。
问题3:抓放任务的示范初始状态暴露了什么限制?
答案:HER重用已经发生的结果,不能生成从未发生的抓起动作。探索要先接触有意义的状态;初始状态课程提供这一入口,之后HER才能有效学习不同放置目标。