042|RMA:根据近期运动快速适应新地面
原论文:RMA: Rapid Motor Adaptation for Legged Robots,Ashish Kumar、Zipeng Fu、Deepak Pathak、Jitendra Malik,2021。论文。
先接住前作的问题
动力学随机化中的循环策略可利用历史隐式适应,但适应信息与控制计算混在一起。RMA把特权环境编码和历史估计分开,追问快速关节控制怎样使用较慢更新的环境条件;部署适应并不需要在线梯度训练。
五个前置概念
五个概念:特权信息指训练可得而部署不可得的数据;系统辨识根据输入与响应估计系统特性;潜变量用较少维度表示控制相关环境差别;分布偏移指估计错误让部署历史偏离理想训练轨迹;异步控制允许多个模块以不同频率更新并共享最新结果。
一、问题设定:怎样从近期动作后果及时估计控制上下文
机器人走到湿滑地面,不能停下来重新训练几分钟;动作不及时改变,它可能已经摔倒。RMA 让控制系统保留两个时间尺度:快速策略决定关节位置,较慢的适应模块根据最近的身体运动和动作,更新环境的紧凑表示。
域随机化让策略在很多摩擦与质量条件下都能行走,但一个完全不区分环境的策略可能过于保守。显式系统辨识则要求估计物理参数;接触、负载、驱动衰减可能产生相似表现,未必能从短时历史唯一分解。
RMA 希望得到“足以改变动作的信息”,而不强求可解释的摩擦数值。它是单智能体、在线仿真强化学习,部署时使用固定网络的历史条件推理。没有学习动力学模型后再规划,也没有动作捕捉示范或预定义足端轨迹。
真实机器人大约12千克,12个驱动关节。30维可测状态由12维关节角、12维关节速度、躯干横滚与俯仰、4维足部接触组成;再输入上一步12维动作和8维环境编码。它不使用相机或激光地形图,不能提前看见下一块危险地面。
仿真回合最多1000步,身体过低或横滚、俯仰超过阈值则终止(§IV-A)。奖励鼓励向前移动并惩罚侧移、旋转、机械功、冲击、力矩变化、过大动作与滑脚等。向前项在0.35米/秒截断,因此这篇论文的主张不是极限高速奔跑。
二、训练特权策略并用历史网络估计潜编码
第一阶段在仿真中把质量、摩擦等特权信息交给策略;第二阶段训练一个网络,仅凭可测历史估计这些信息的潜在编码。真实部署时既不读取真实摩擦系数,也不进行梯度更新。所谓在线适应,是条件向量随观测改变。
1. 压缩的是控制上下文
记真实可测状态为 ,仿真环境参数为 ,环境编码器为 :
为17维,包含负载及位置、各电机强度、摩擦与简化局部地形高度; 为8维。策略和编码器通过 PPO 联合优化折扣回报。这意味着编码器被推动去保存有利于控制的区别,而非恢复全部物理世界。
训练用的地形高度先离散,再从四足位置提取简化标量。环境信息并非精确完整的地形扫描。奖励中的部分力、速度信息训练时可以从仿真获取,也不能因此声称策略部署时同样需要这些传感器。
2. 历史网络预测编码,而不是改策略权重
适应网络使用最近50步、约0.5秒的状态动作历史:
它先嵌入每一时刻的状态与动作,再用一维时间卷积捕捉响应。给出了什么关节指令、关节实际上怎样变化,合起来才构成有关负载或打滑的证据。只看当前关节角,通常不足以分辨“地面变滑”与“刚好处于某个步态位置”。
为什么第二阶段不能只收集特权策略的漂亮轨迹?真实运行使用的是不完美估计;误差会把机器人带到不同状态。原文让策略实际使用当前 采集仿真历史,再用仿真中已知的 监督适应模块,迭代至收敛。这继承了 DAgger 处理分布偏移的思想,但标签是环境编码,不是专家动作(§III-B)。
3. 快控制不等待慢估计
部署时基础策略100 Hz,适应模块10 Hz;快速线程使用最近得到的 。输出目标关节角后,PD控制器计算
其中目标关节速度设为0。真实配置 。这里的100 Hz是基础策略动作频率,10 Hz是环境条件更新频率;不能把两者平均成一个“模型帧率”。
机制上改变的是策略对环境的条件化与条件估计;数学目标仍是 PPO 回报加第二阶段均方误差;实验改善则应看行走成功、跌倒时间、距离等,而不是仅看潜变量估计误差。
潜变量误差小不一定动作误差小。局部线性化给出 ,这里 是环境编码误差、 是对应动作变化,其中 是基础策略对环境编码的敏感度。若某方向 很大,小幅编码误差就可能大幅改变关节目标;仅报编码MSE不能代替闭环稳定性。反过来,物理参数不同但控制需要相同,可以共享相近编码。
异步还意味着编码存在年龄:10Hz模块的最新结果最多已接近一个更新周期,外加推理与通信延迟。负载缓慢变化时合理,突然踩空时仍需快速本体反馈救场。原文将慢外部因素与快身体状态分开,是计算与控制结构共同设计。原文§III-B
一个例子与五个前置概念
自构例子,未运行:在机器人背上增加负载,同样的关节目标导致身体高度下降、关节响应改变。适应网络看到连续历史后输出新的编码,基础策略改变支撑动作。网络未必知道新增的是5千克,它只要产生能让控制器补偿的条件即可。若把历史清空,这种能力应短暂减弱;这是可检验的机制预测。
三、先学特权策略,再以自访问历史训练适应器
适应器预测的是策略所用的潜编码,标签来自特权环境表示。部署时快控制读取较慢估计的编码,两个频率和历史窗口共同决定反应速度。
阶段一:特权策略
    随机化摩擦、负载、电机强度,并采样崎岖仿真地形
    z = 环境编码器 μ(e)
    使用 π(x, 上一动作, z) 生成目标关节角
    用 PPO 联合训练 π 与 μ,使混合运动奖励提高
阶段二:适应模块
    固定已经学到的基础策略与环境编码器
    用当前 φ(最近50步历史) 产生 z_hat
    让基础策略实际使用 z_hat 在仿真中行走
    从访问到的历史生成训练样本,标签为 μ(e)
    监督更新 φ,继续收集新历史
真实部署:
    10 Hz线程更新 z_hat = φ(历史)
    100 Hz线程读取最新 z_hat,计算目标关节角并交给 PD
    网络参数保持固定
四、用仿真对照隔离适应模块的收益
论文在 Unitree A1 上展示了负载、泡沫、油滑路面与户外地形适应,并用仿真对照隔离适应模块作用。
原图怎么读: 图3,原论文图注与图像。把进入湿滑区域的时段,与膝关节力矩、触地节奏和潜编码变化对齐。潜编码曲线经过中值滤波,其变化提供适应线索,不等于每一维对应已标定的物理量。
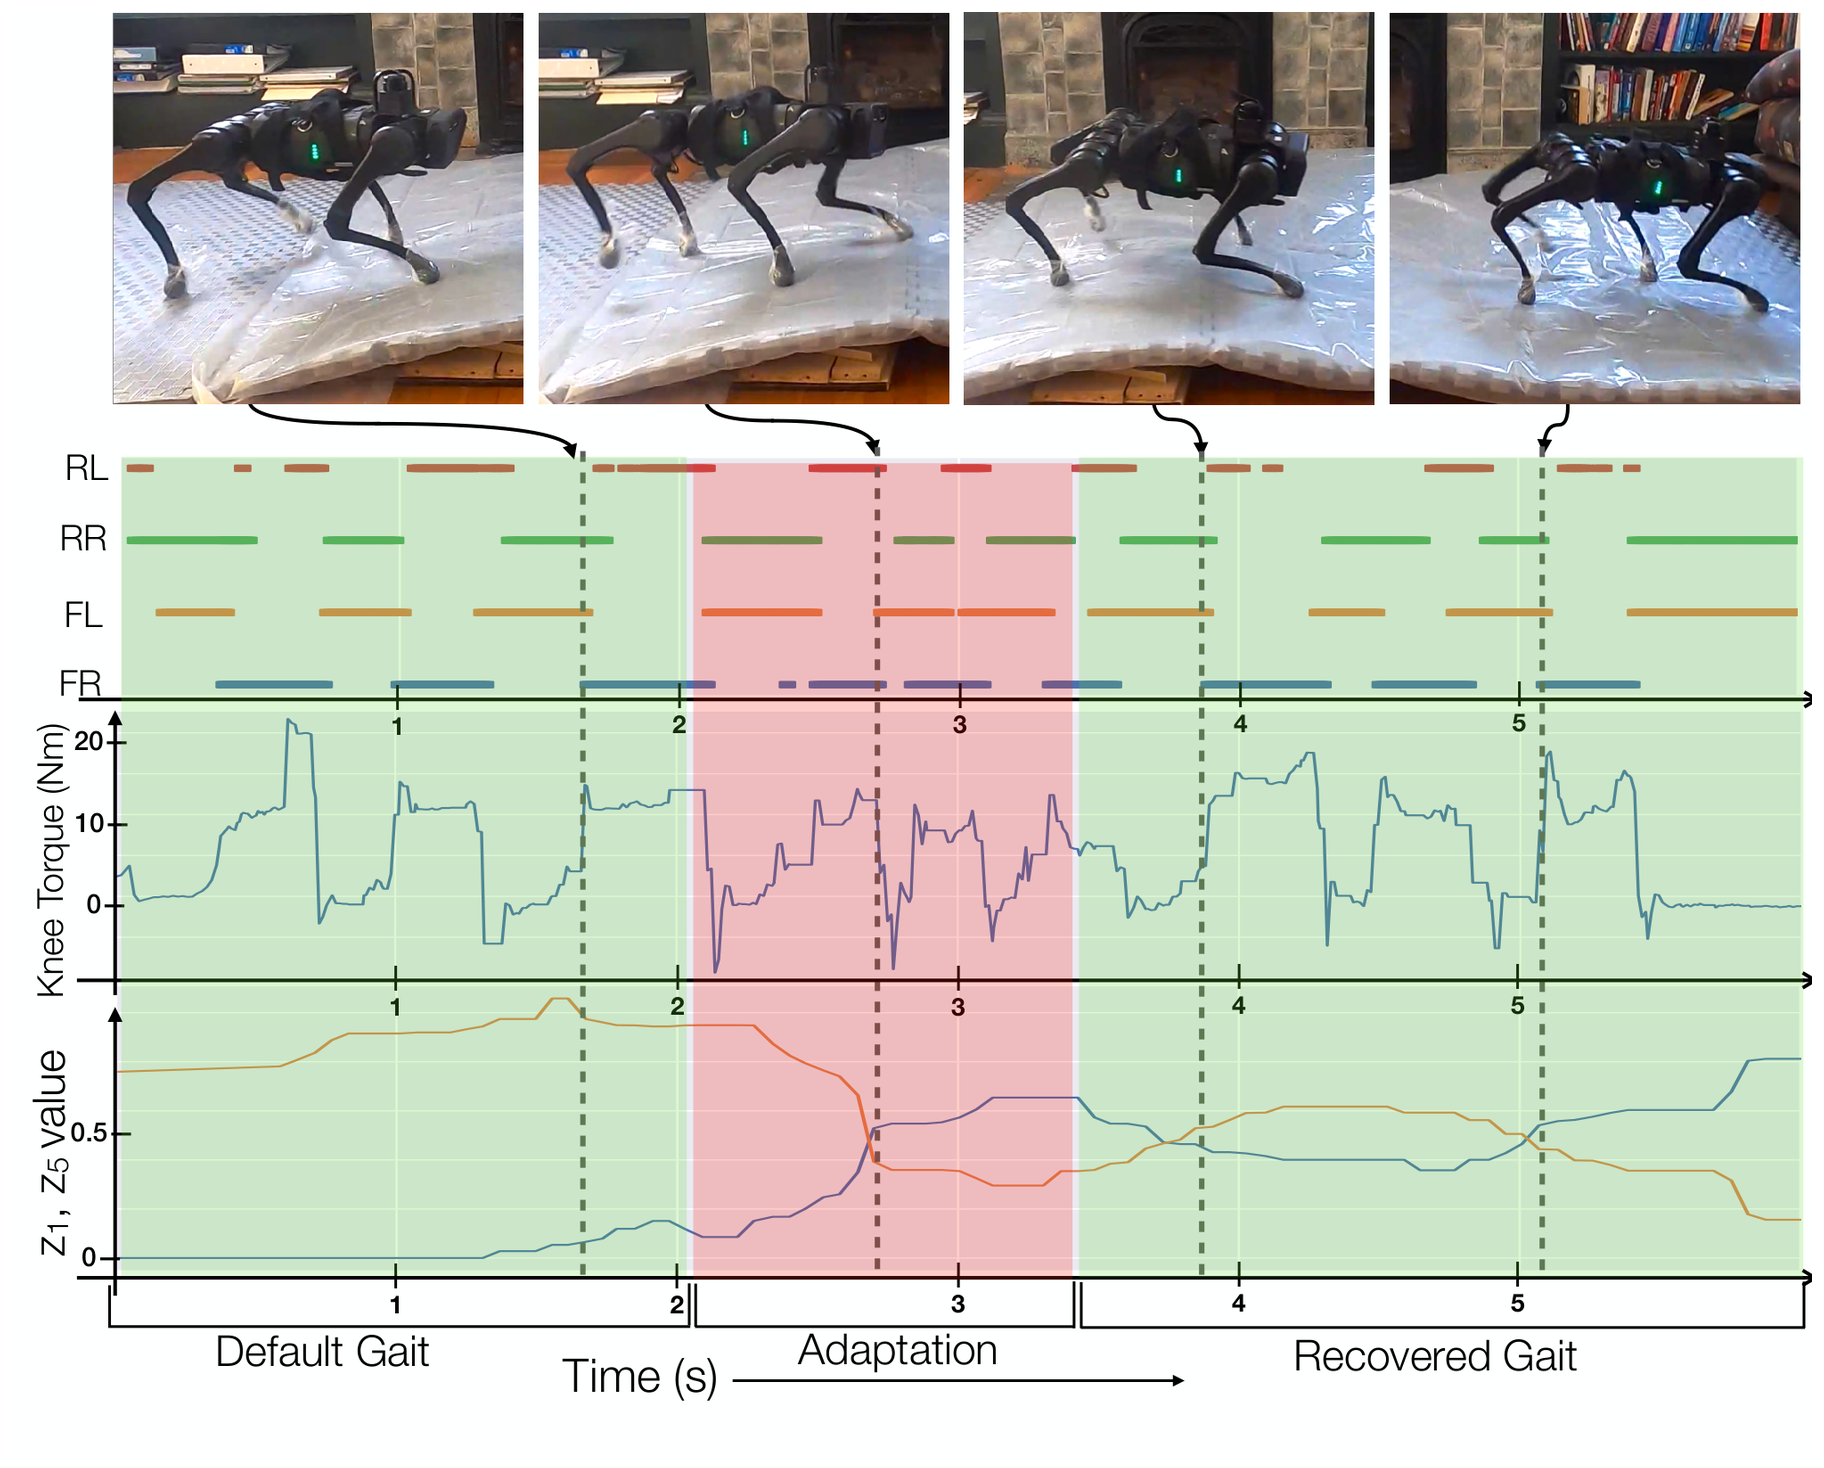
仿真步长与控制频率之间的具体实现关系尚未核实,因此不能仅用其中一个数字推算观测或适应更新频率。
| 项目 | 原文设置与判断用途 |
|---|---|
| 仿真训练 | RaiSim与A1模型,随机化地形及物理参数 |
| 基础策略预算 | 15000次迭代、每批80000样本,共12亿步;单GPU桌面机约24小时 |
| 适应模块预算 | 1000次迭代、每批80000样本,共8000万步;约3小时 |
| 仿真测试 | 参数范围扩大,并以每步0.01概率重采样;训练对应概率0.004 |
| 学习基线 | 无环境编码的鲁棒策略、直接系统辨识、AWR、移除适应模块 |
| 特权参照 | 使用真实环境编码的Expert,只能在仿真访问 |
| 重复数量 | 表II为3个随机初始化策略,每个1000回合 |
| 真实室内 | 厂商控制器、无适应RMA与完整RMA;原则上每组5次,严重失败时2次后停止 |
| 指标 | 成功率、归一化跌倒时间、前向奖励、距离、力矩、平滑性和冲击 |
仿真学习基线使用相同架构、奖励和其他超参数,比较比“两个不同机器人的演示视频”更有解释力。真实实验由于避免损坏硬件只选两个基线,并允许早停,因此不宜把所有柱子当作完全等量独立重复。
还有两个细节值得保留。首先,表II的Samples为0表示无需为测试环境额外收集探索数据做优化,不代表机器人不使用最近历史。其次,§IV-A同时写了100 Hz控制与0.025秒仿真步长,二者时序关系在这段正文中不清楚;不能自行把0.025秒改成猜测的数值。训练步数与真实时间换算应另核实现。
五处关键证据及其解释
表I:测试变化超出训练范围。 摩擦训练区间为0.05至4.5,测试为0.04至6.0;负载训练0至6千克,仿真测试0至7千克。这里既有范围外插,也有回合内参数变化,不能只描述为静态参数随机测试。不过这种可控参数外插仍不等于所有现实接触变化。
表II:适应是否改善成功率。 RMA为73.5%,鲁棒策略62.4%,直接系统辨识56.5%,无适应RMA52.1%,特权Expert76.2%。RMA比鲁棒策略高11.1个百分点,计算为73.5−62.4;相对提升约17.8%,分母是62.4。二者应分开称呼。
表II:并非每项指标最好。 RMA冲击指标4.27,鲁棒策略4.20,SysID4.03,特权Expert3.90。即使成功率较高,也不能把原文“胜过基线”扩大成所有代价指标同时最优。力矩与平滑性亦需要按指标定义理解,不能直接当作电池续航。
图2与§V-A:真实负载和软地面。 15厘米下台阶成功率80%;泡沫与床垫测试为100%;作者报告能携带达到自身重量的12千克负载。100%来自有限短程试验,不能推出长期零失误承载能力。无适应方法在大负载下有时不倒却不前进,说明只报告跌倒率会奖励“站着不动”。
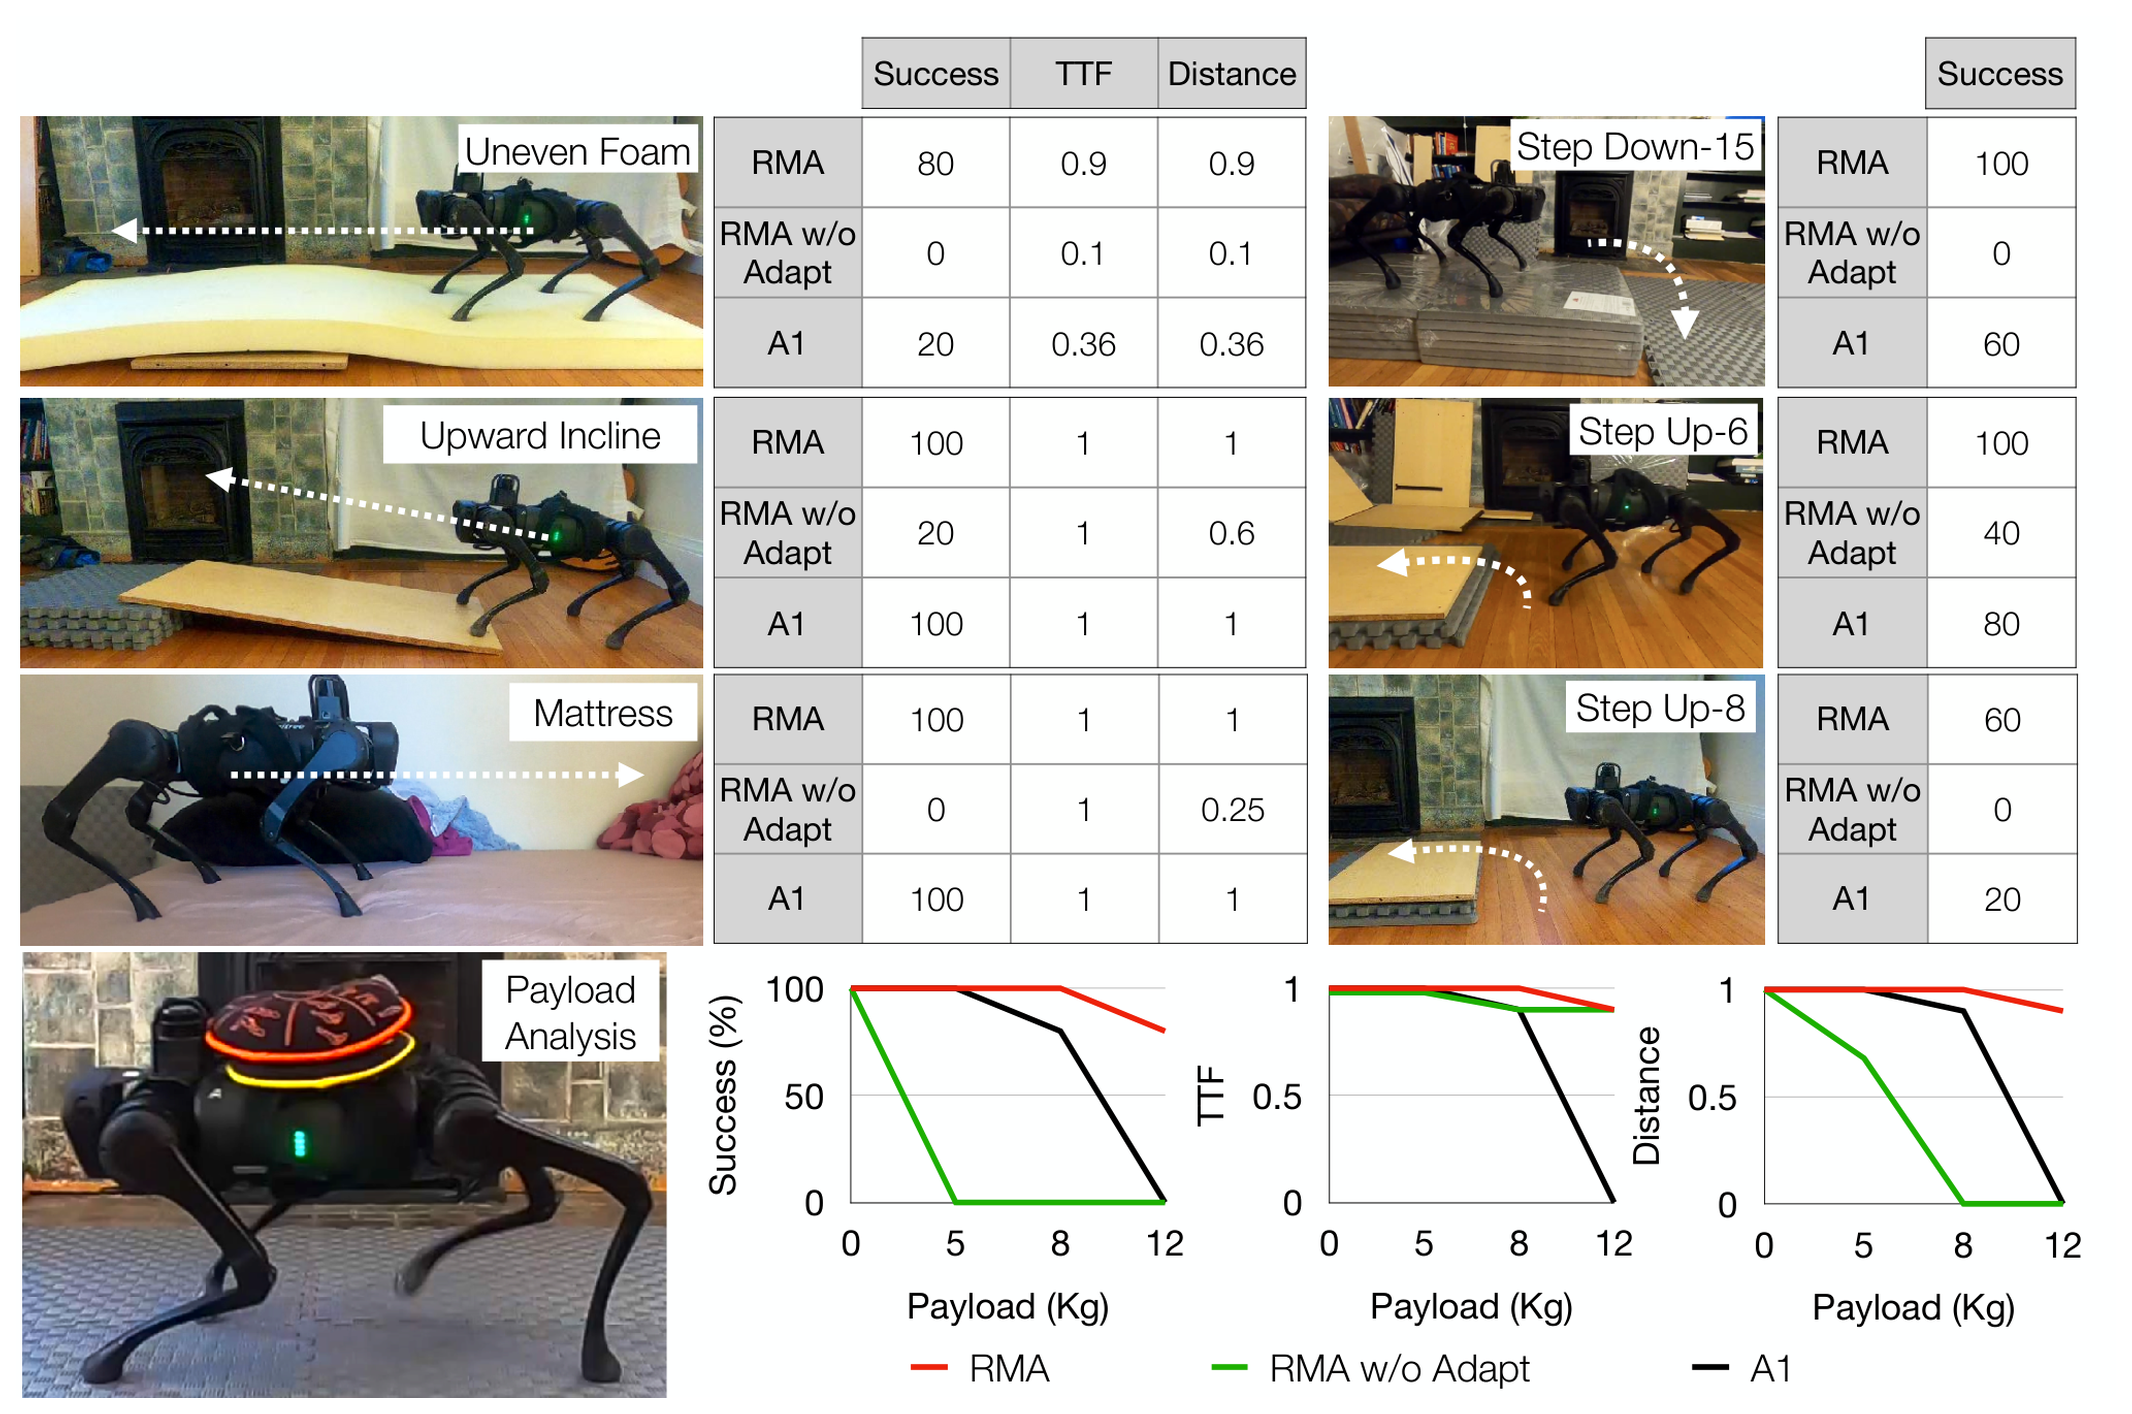
图3与§V-D:适应随打滑发生。 油滑面试验报告90%成功,示例中潜向量分量、力矩和步态同时发生变化。它支持网络根据交互改变控制上下文;潜变量曲线却不是校准后的摩擦系数,也不是仅凭一条曲线就能完成的因果证明。正文与图表见论文完整HTML。
户外下楼梯70%、水泥与碎石堆80%的结果同样重要:论文并非只报成功。对户外每种地形的重复次数,本文未逐项核实,不把百分比擅自换算成固定试验次数。
五、潜编码滞后和盲感知限制突变处理
作者明确承认本体感知的局限:大台阶突然下落、多足同时被障碍卡住等可能导致失败,未来需要外部视觉。本文进一步推断,环境变化必须能及时反映在短时状态动作历史中;某些危险只有发生后才能感觉到,纯反应式适应不可能预先规避全部风险。
“无需仿真校准或真实微调”也不等于没有机器人知识。A1模型、关节接口、传感器、PD参数和奖励工程都已指定;没有预定义步态只是减少了一类先验。机械功和冲击相关奖励不应直接称为最优生物能耗证明。
追问:适应模块越频繁更新就一定越好吗?
参考答案:更频繁更新可能减少条件滞后,却也会把短暂噪声更快传到控制策略,并增加计算与同步开销。可固定策略和历史长度,只改变编码更新频率,比较扰动后的恢复时间、编码抖动与关节指令变化。关键是控制与估计时间尺度配合,不能从更高频率直接推出更强适应。
六、沿机制关系继续读
RMA在历史关联上承接动力学随机化带来的适应问题,把隐式记忆拆为显式编码估计;适应数据收集使用类似DAgger的自访问分布思想,但监督标签是编码,属于模块化借鉴而非动作标签算法原样移植。
七、自测三题与参考答案
问题1:为什么说RMA“在线适应”却没有“在线训练”?
答案:部署时状态历史不断更新,因而环境编码和动作不断变化;但网络权重不通过真实数据梯度更新。适应发生在条件推理层,训练发生在此前仿真中。把两者混淆会误估部署所需算力、数据和故障恢复时间。
问题2:直接预测摩擦、质量为何可能比预测编码更差?
答案:短历史可能不能唯一分离物理因素,而控制也未必需要分离。编码器可合并产生相似控制需求的环境。表II支持本文设置下的潜编码优势,却不证明任何显式辨识都无效;更丰富传感或更长历史可能改变结论。
问题3:怎样检验成功来自适应,而非只是训练更充分?
答案:保持奖励、地形、架构容量与总预算尽量一致,比较固定编码、随机编码、真实编码及历史估计编码;在同一回合突然改变环境,记录变化前后成功、恢复时间及动作代价。还要报告静止不动的失败,避免仅用不摔倒指标掩盖没有完成行走任务。