041|AMP:把动作分布变成运动先验
原论文:AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control,Xue Bin Peng 等,2021;本文依据2022年的v2正文。论文。
先接住前作的问题
DeepMimic用相位对齐的参考运动奖励动作,但切换参考片段与追踪时序仍需设计。AMP改用相邻身体状态的分布判别提供风格奖励,再与任务奖励组合;它沿模仿问题发展,同时借鉴GAIL式比较,而非保留逐帧目标。
五个前置概念
五个前置概念:PPO用受限制的策略更新提高回报;GAE在偏差与方差间折中估计优势;判别器学习区别示范和策略数据;PD控制把位置误差和速度反馈转成执行力矩;动态时间规整允许不同快慢的动作先对齐再比较形状。
一、问题设定:怎样让动作库评价风格而不指定下一帧
如果只奖励“尽快到达目标”,虚拟人可能用奇怪的姿势移动。如果要求它逐帧复现某段跑步动画,又必须决定什么时候切换到走路、跳跃或者翻滚。AMP 把这两个难题拆开:任务奖励告诉角色去哪里,动作数据训练出的判别器评价它动得是否像示范。
本篇属于单智能体、在线、无模型强化学习与从观测模仿的结合。训练需要物理仿真器,示范不需要记录每个关节施加的力矩。人类动作捕捉给出的关节运动,本来就未必由机器人的执行器实现,更不天然附带可复制的控制输入。
状态包含身体各部位相对根节点的位置、旋转和速度;策略还接收目标方向、位置或相关任务信息。动作是关节 PD 控制器的目标位置,而不是直接生成视频或播放动画。每次控制之后,物理引擎计算真实的接触和运动结果。多数任务在非足部身体接触地面时提前结束;翻滚、起身等任务关闭这一判据,不能把统一“不许倒地”套用于所有动作(§6.1、§6.3)。
与 DeepMimic 相比,最重要的改变是去掉参考相位。跟踪式方法知道“现在应该对应示范第几帧”,AMP 只要求当前运动符合动作库的统计特征。它获得了时间组织的自由,也失去了逐帧对齐提供的强学习信号。
动作库仍要与目标有关。只给走路片段,不等于角色可以从中自动得到所有高速跑步技巧。与此同时,仿真人形、霸王龙和狗的成功,不能直接证明真实机器人可以使用同一控制器;本论文实验全部在仿真中完成。
二、分开任务奖励与对抗运动先验
它仍然用 PPO 学控制策略,却不需要为每条动作片段设计跟踪误差,也不要求策略与参考动画保持同一相位。判别器观察相邻两帧的身体特征;走、跑、出拳等片段形成一种可学习的风格约束,策略通过任务反馈学习何时使用这些行为。
1. 两个奖励对应两个问题
令 为状态, 为任务目标, 为判别器使用的身体特征。最终奖励是
任务项 可以衡量速度跟踪、向目标移动或击打;风格项 来自判别器。多任务示例使用 ,单片段模仿则只使用风格奖励(§8.2、§8.4)。这里的“多任务示例”不是一张统一策略同时完成全部任务,各策略仍分别训练。
记 。判别器把示范转移回归到 ,把策略转移回归到 :
是动作示范, 是策略历史经验。最后一项约束示范特征处的判别器梯度,缓解奖励函数突然变化;它对输入特征求导,不是对全部物理状态或者策略参数求导。
按原文式(7),风格奖励为
时奖励为1, 时为0, 时为0.75。因此它不是“被判为真人的概率”;最小二乘判别器没有要求输出经过 sigmoid。平方、平移和截断使奖励落在0到1之间。
2. 为什么要看速度和历史负样本
判别器输入包括根节点局部线速度与角速度、关节旋转和速度、末端相对位置。局部坐标使移动到地图另一位置不必被视为另一种风格;移除目标信息则让判别器专注于怎么动。
只看两帧姿势在数学上似乎也能反推速度,但有限网络和对抗训练未必学得好。原文发现显式速度特征能避免某些“躺着保持一个姿势”的退化结果。策略历史经验则防止判别器只学会区分最新策略,而忘记旧的错误行为。
策略和价值函数使用状态及目标,分别负责生成动作、估计混合奖励的长期回报。PPO 与 GAE 延续现有框架;这里没有学习环境模型,也没有把判别器当作价值函数。判别器经验回放不意味着 PPO 被改为任意历史轨迹上的离策略更新。
下面对应算法1与§6.3,省略网络归一化和批次细节。
数学上优化的是混合回报与判别损失;机制上改变的是模仿反馈与时间同步;实验指标则包括任务回报和姿态误差。这三者不能互相替代。
没有相位对齐后,运动“像不像”与动作“何时发生”被分开。教学反例:向前走两步、向后走两步反复循环,短转移可以都像真人步态,却未必到达目标。判别器约束局部风格,任务奖励才选择方向;两帧转移匹配不能自动约束整段语义顺序。
这也解释了速度消融的重要性。静态滚动姿势可能骗过弱判别器,而显式速度让“不动却摆成滚动样子”更难获奖。原文确实报告去速度后的这种退化,但不能由此断言两帧速度已足以表达所有长时技能结构。原文§5.3与§8.5
建立直觉:目标变了,动作风格可以不变
自构例子,未运行:动作库有慢走和快跑,目标速度由1米/秒变成4米/秒。只优化速度,角色可能跳着冲过去;只复现慢走,速度又达不到。混合奖励会偏好既接近4米/秒、又符合跑步转移特征的控制。它并没有显式输出“选择片段编号7”,行为选择体现在策略生成的连续动作里。
三、用动作片段训练判别器并联合任务回报学控制
判别器接收相邻身体特征,策略仍需在物理仿真中探索动作后果。历史负样本与任务奖励改变训练分布,不能把动作库直接当成随时可执行的技能菜单。
输入:动作库 M,物理环境,任务奖励 rG
初始化策略 π、价值网络 V、判别器 D、历史转移库 B
重复:
    从动作库随机采样初始身体状态,生成任务目标
    用当前 π 收集新轨迹:
        a = π(s, g) 给出的关节目标位置
        PD 控制器和物理引擎推进到 s'
        rS = max(0, 1 - (D(Φ(s), Φ(s')) - 1)^2 / 4)
        保存新轨迹及混合奖励 wG*rG + wS*rS
    将转移加入 B
    交替采样动作库转移与 B 中策略转移
    更新最小二乘判别器,并加入示范输入处的梯度惩罚
    用新轨迹估计 GAE,更新 PPO 策略与价值网络
部署:输入当前状态与任务目标,策略输出关节目标,由 PD 执行
四、同时读任务达成、风格与跟踪结果
作者展示了接近目标后出拳、根据目标速度改变步态、遇到不同障碍采用不同动作等仿真行为。这里的主要价值是组合能力和目标表达方式,并非在所有单动作跟踪误差上取胜。
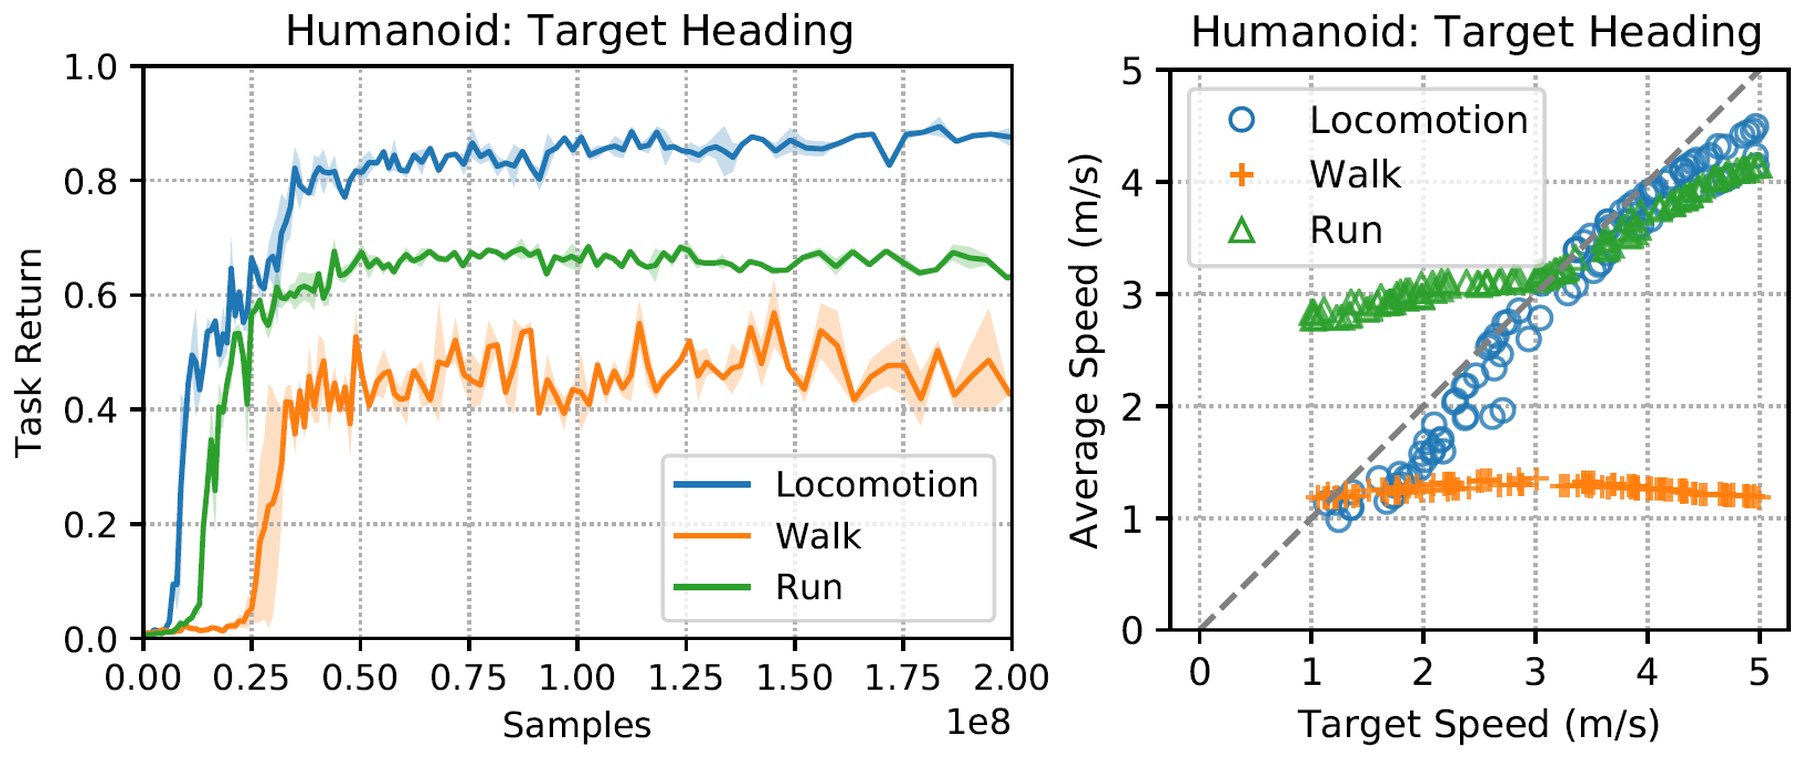
原图怎么读: 图4,原论文图注与图像。左侧比较不同动作数据集下的任务回报,右侧比较目标速度与实际速度。多样风格数据有用的证据不仅是动作好看,还包括能否覆盖所要求的行走速度。
原文标注 CC BY 4.0。本页摘图仅保留图形区域并作栅格化;有面板重排的图另行注明,作者与原文入口见各图注。
| 项目 | 原文设置与验证目的 |
|---|---|
| 仿真环境 | Bullet;人形34自由度、霸王龙59、狗64,验证不同身体结构 |
| 控制频率 | 物理仿真1.2 kHz,策略30 Hz;不能把物理积分频率称为策略推理频率 |
| 动作数据 | 公共及自行采集的动作捕捉、艺术家关键帧;最大库56片段、8名表演者、434.1秒 |
| 训练预算 | 每策略1亿至3亿样本,16 CPU核心约30至140小时;这是仿真交互,不是真机数据 |
| 基线 | 无动作数据的RL、预训练潜空间控制器、单片段跟踪方法 |
| 任务指标 | 归一化任务回报,0和1对应回合最小与最大可能回报 |
| 模仿指标 | 动态时间规整后、根节点相对关节位置平均误差,单位米 |
| 重复 | 表1与表3为3个随机种子模型,每模型32回合;表3每回合最长20秒 |
| 消融 | 移除梯度惩罚、移除速度特征;改变动作库内容 |
潜空间基线先用3亿样本预训练低层控制器,再学习任务高层。因此“下游任务学得更快”与“从零开始总成本更低”不是同一判断。论文承认潜空间结构能帮助探索;AMP 的优势之一是可以联合学习而无需那个独立预训练阶段(§8.3)。
此外,障碍任务使用一维地形高度信息,不是未经处理的真实相机画面。参考状态初始化也提供了强探索帮助:角色可以从动作库中的中间状态起步,不必每次从站立姿态自行发现空翻。
五组证据:成功在哪里,边界在哪里
表1:任务完成程度。 人形目标朝向任务使用完整移动库得到 的归一化回报,只用走路为 ,只用跑步为 。这支持多种步态覆盖较宽目标速度,但0.90不是90%成功率。潜行与僵尸风格使用不同的速度设定,不能凭0.94与0.90直接宣布后者更差。
表2与图4:动作库的具体作用。 完整库涵盖不同速度,策略能随目标改变步态;单一走路或跑步库难以覆盖另一端速度。它支持数据内容影响行为,而非奖励单独创造所有步态。不过完整库的数据量也不同,不能把收益全部归因为“多样性”而排除样本量作用。
图3与§8.2:时间组合。 行走和出拳片段分别存在,未提供完整“走近再出拳”的示范,策略却学会依次执行。这是组合证据;动作库仍含两个组成技能,而且任务反馈指定了击打目标,不能称为完全无示范发现新技能。
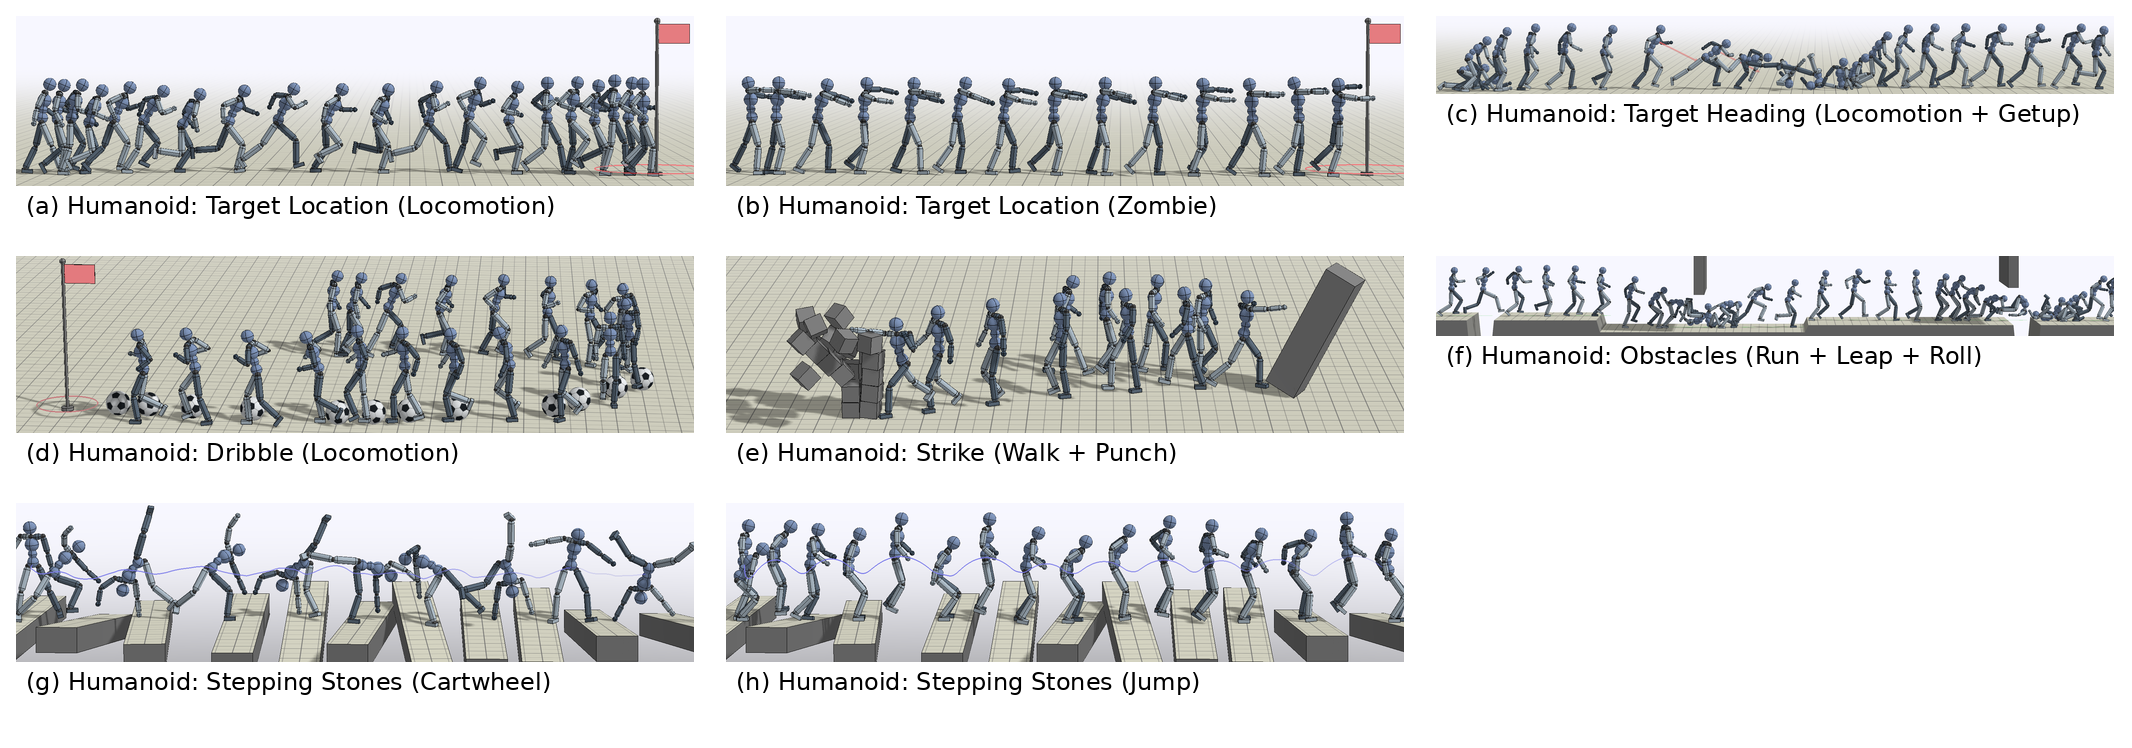
表3与图8:精确模仿的反例。 后空翻跟踪方法误差0.076米,AMP为0.150米;前空翻分别0.278与0.425米。侧空翻则AMP为0.124米、跟踪方法0.191米。总体不是单方面碾压,且误差经过动态时间规整,不能证明原始执行时序同样准确。
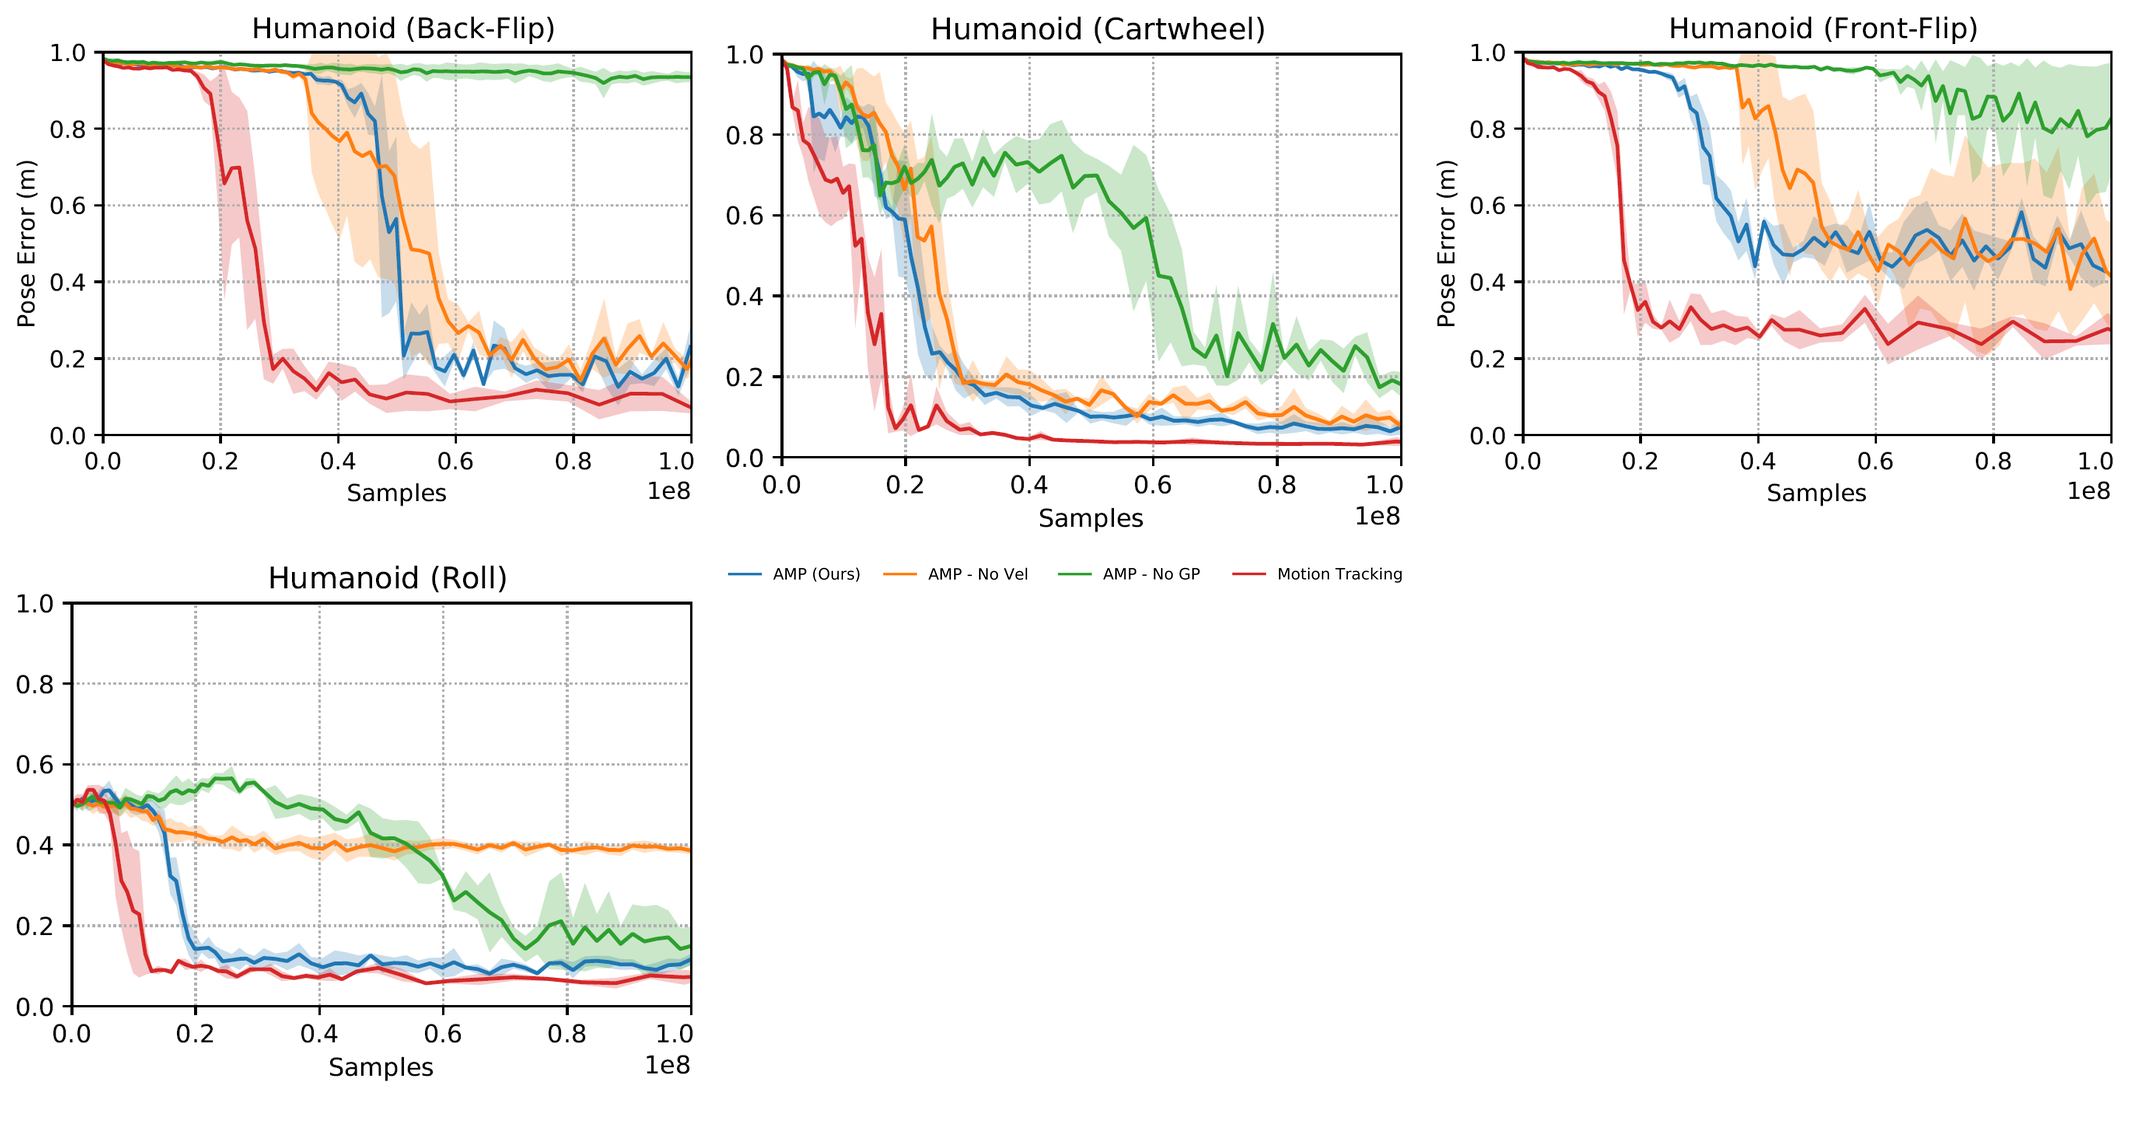
图8与§8.5:稳定性组件。 移除梯度惩罚后学习波动更明显;移除速度特征会使翻滚退化成静止姿态。消融支持这些组件在测试技能上的必要性,但不能证明任意判别器、任意动作数据都必须使用完全相同的系数。
原文§8.4明确记录前空翻局部最优:角色可能向前挪动以避免摔倒。§9还承认模式坍缩,即只使用动作库的一小部分。漂亮的代表画面不能取代这些失败案例。以上定位与数值来自原文方法和实验正文。
五、风格判别可能漏掉动作库中的模式
作者承认,虽然判别器不直接输入任务,负样本来自当前任务策略,因此仍可能隐含任务依赖。实验中的动作先验按策略从头训练;“任务无关输入”不能当作已经验证了冻结判别器的跨任务直接复用。
本文的进一步分析是,运动自然性与硬件可执行性必须分开。真实电机的扭矩、延迟、关节限位与碰撞风险,不能由人类动作库相似性自动保证。若移用于机器人,应额外验证控制接口与身体重定向,不能只检查视频外观。
追问:只看相邻两帧的判别器,能否约束长周期动作的一致性?
参考答案:相邻转移能限制局部速度和姿态变化,却不能唯一决定更长序列如何组合。两个长动作可能具有相近的局部片段分布,却在节奏或顺序上不同。可保持判别器与任务预算,另外报告长窗口运动统计、模式覆盖和任务达成,检查局部自然是否对应长期协调。这是对判别器观察范围的分析,不是原文已经证明的长程保证。
六、沿机制关系继续读
本篇沿DeepMimic的物理运动模仿问题而来,改掉逐相位追踪;它组合GAIL式对抗分布比较与任务奖励,属于模块组合。后续真机人形还需额外处理可行性与迁移。
七、自测三题与参考答案
问题1:动作捕捉没有控制力矩,为什么仍能训练?
答案:判别器学习的是相邻状态特征的分布,不需要专家动作标签。策略在物理仿真中尝试自己的控制,由所产生的状态转移获取风格奖励。前提是示范能转成与角色相容的身体特征;人类运动不一定严格符合角色动力学,所以不能保证完全复现。
问题2:判别器不看目标,为什么不能直接认定它可以跨任务复用?
答案:判别器同时见到正样本和策略负样本,后者受任务影响。训练出的边界可能擅长辨认某一任务的错误,却不了解另一任务会出现的错误。原论文对每个策略重新训练先验,并把通用迁移列为未来方向。
问题3:如何证明“动作更自然”不是单纯以任务性能换来的?
答案:应同时报告独立任务回报、风格或模仿指标,并改变奖励权重形成折中曲线;对照数据量、交互预算及潜空间预训练成本。只看混合奖励无效,因为风格项权重本来就会改变分数。还应保留失败和动作覆盖率,防止只选少数漂亮片段掩盖模式坍缩。