040|Transporter:用空间对应关系学习操作
原论文:Transporter Networks: Rearranging the Visual World for Robotic Manipulation,Andy Zeng 等,首次公开于2020;本文核对2022年的 arXiv v3。论文。
先接住前作的问题
Dex-Net 2.0提供一个阅读起点。Dex-Net可以给抓取候选打分,但完整抓放还要决定抓点改变后应把物体放到哪里。Transporter把抓点附近特征带入放置匹配,用几何关系减少独立坐标回归的负担;这是操作接口的教学延伸,不是解析抓取质量的直接继承。
五个前置概念
五个前置概念:
- 等变性:输入经过变换,输出按对应方式变换。
- 正交投影:消除透视缩放,使像素对应固定空间尺度。
- 互相关:移动一个特征模板,计算它与场景局部的匹配度。
- 多模态动作:同一场景存在多个分离的正确动作。
- 动作基元:由少量参数驱动的一段已有控制程序。
进阶追问与参考答案(3题)
进阶问题1:标定误差多大开始破坏空间输运收益?
参考答案:没有统一厘米阈值,它取决于像素尺度、物体尺寸、抓取容差和旋转误差。可对相机外参施加已知平移/旋转扰动,分别报告抓点偏差、放置偏差和任务成功,比较Transporter与无输运基线的退化曲线。误差应换算到动作平面,不能只用图像像素偏移作为跨装置结论。
进阶问题2:抓取滑移是否需要执行中重观察?
参考答案:只要滑移改变物体相对夹爪的变换,抓取时建立的几何对应就可能过时。可在受控滑移条件下比较固定放置计划、抓后重观察和执行中更新,并记录额外感知延迟。没有滑移且动作短时,频繁观察的成本可能大于收益;滑移风险高时还应加入持物状态或触觉,视觉未必能看清夹持接触。
进阶问题3:语言语义与几何分支应在哪里融合?
参考答案:若语言主要选择对象,语义可较早调制视觉特征;若它还指定相对位置和操作关系,放置查询也需要条件化。可在相同预训练与示范预算下比较输入拼接、编码器中间融合和抓放头融合,并分别评估新词义、空间关系与抓放精度。CLIPort提供具体的双流方案,但不能证明它是所有任务的唯一最优融合位置。
这些回答给出机制分析与待检验设计,不是已经运行的新实验结果。
一、问题设定:抓取点改变时怎样保持正确放置关系
拿起一个物体再放进槽里,放哪里取决于刚才抓在哪里。从物体左边缘吸起,与从中心吸起,末端最终位置不能一样。若把抓取和放置分别回归成两个互不相关坐标,网络要用很多数据才能学会这种几何关系。
这是从示范学习的视觉操作方法,不是靠 Bellman 更新训练的 Q-learning。论文虽然使用 等符号表示动作评分,训练目标实际是专家位置标签的交叉熵。
输入来自校准 RGB-D 相机,先重建点云,再投影成正交俯视的颜色与高度图。动作是两个末端位姿,交给预定义运动基元执行抓放或推移。底层轨迹和逆运动学已承担一部分控制工作。
仿真 Ravens 用于受控比较,真实机器人另用真实示范训练。原论文没有把仿真训练模型直接迁移到真机。因此它的真实结果不能作为域随机化迁移的证据。
每个任务单独训练模型,原始方法没有语言任务条件。后来 CLIPort 才进一步把语言语义与这套空间机制结合。任务序列依赖当前视觉场景判断,模型本身没有循环记忆。
二、用抓取条件特征输运预测放置位置
Transporter Networks 先选抓取位置,再截取其附近的视觉特征,把这块特征在场景中平移、旋转并匹配,预测对应放置位置。它把操作问题中的空间结构写进网络。
1. 正交图让像素对应固定物理尺度
透视图中,同一物体远近不同会改变像素大小。正交投影让一个像素对应工作空间中固定的竖直柱,便于把图像位置直接转成机器人平面位置。
这一步是几何先验,也需要相机内外参。它没有消除遮挡,只是改变坐标表达。如果目标表面从未被看到,高度图不能凭空恢复它。
平移等变性的直觉是:
把整个场景平移,正确动作分布也随之平移。网络因结构而复用这种关系,就不必把每个桌面位置都作为完全独立案例学习。实际离散图像、裁剪与边界效应会使理想等变性存在近似。
2. 先预测抓取热图
抓取网络输出图像位置评分,经 softmax 得到分布:
多个物体或多个可吸取位置可以形成多个峰值。相比直接回归平均坐标,这能避免两个好抓取点的平均恰好落在空白区域。
执行时选取高分位置 。训练时对应专家给出的抓取标签。注意示范可能只标注一个正确动作,并不说明其他位置一定错误;多模态数据和结构共享帮助网络逐渐表达多个可行选择。
3. 放置通过特征互相关计算
一条网络产生抓取区域的 query 特征,另一条产生整幅场景的 key 特征。对候选放置变换 :
星号表示空间互相关,不是普通标量乘法。直觉像拿着一块拼图在底板上移动寻找合适位置,但匹配的是学习特征,不是直接比较 RGB 像素相同。
这样,抓取点偏离物体中心时,局部模板也跟着偏移。匹配得到的是与这个具体抓取位置对应的末端放置位姿,几何关联通过搬运操作自然传递。
平面旋转通过离散角度枚举处理。完整六自由度若直接全部离散,会导致组合爆炸;论文扩展采用先处理平面位置和朝向,再回归高度及另外两个旋转分量的混合方式。
4. 训练目标
是示范标签。目标是提高专家动作似然,没有折扣回报目标,也没有用预测奖励训练 critic。六自由度连续部分另用回归损失。
不需要对象CAD模型,不代表不需要先验。模型明确使用空间投影、局部搬运、离散旋转和动作基元。这些先验恰好是样本效率的来源,不能在宣传时一起抹掉。
闭环发生在动作基元之间。不能把一次抓放决策的模型推理时间,直接解释成机器人每个关节的高频反馈控制周期。
抓取点偏移怎样传到放置点?教学设定:物体中心在 ,夹爪抓在右侧偏移 厘米,要把物体中心放到 厘米且不旋转,末端应到12厘米;若仍输出10厘米,物体只到8厘米。Transporter以抓点裁剪query再搜索放置,把这种相对几何写入结构。
推广到二维,把 改记为抓取点相对物体中心的偏移向量;若物体还旋转角度 ,偏移应随旋转变为 ,其中 为平面旋转矩阵,所以末端目标为物体目标加旋转后的抓取偏移。离散角度枚举近似这组关系,也引入角度分辨率误差。原文少样本证据应和这类强几何先验一起读,而不能概括为无先验的通用动作学习。原文transport互相关
帮助建立理解
自构例子,未运行:吸盘从长条左端抓起,目标要求长条中心落在槽中心。若网络只预测“槽中心”作为末端目标,物体会错位。Transporter 把以左端为中心的局部特征移到槽上,匹配时对应的末端目标也落在槽的左端,于是物体整体对齐。
如果抓取后物体在吸盘上滑动,这个刚性对应就会失效。下一次视觉反馈或更丰富的夹持状态才能修正,空间先验并不等于完整接触动力学。
三、预测抓点后用特征互相关搜索放点
几何增强必须对输入与动作标签施加同一变换。若正交图整体平移像素向量,抓点与放点都应分别变为、;只移动图像而不移动标签,训练会要求网络对相同物体选择错误世界位置。旋转还要同步改变放置方向。等变结构减轻学习负担,不能修正一份违反几何关系的数据。
输入专家抓放/推移示范
每次训练:
    把 RGB-D 转成标定工作空间的正交颜色高度图
    对图像与动作标签施加一致的平面增强
    预测抓取热图
    在专家抓取点提取局部 query 特征
    将 query 平移/旋转,与场景 key 特征互相关
    用专家抓取和放置标签更新网络

每次执行:
    观察当前场景并预测抓取点
    以该抓取点条件化预测放置位姿
    执行动作基元
    重新观察,再决定下一个动作
四、核对空间泛化与动作基元分担的难度
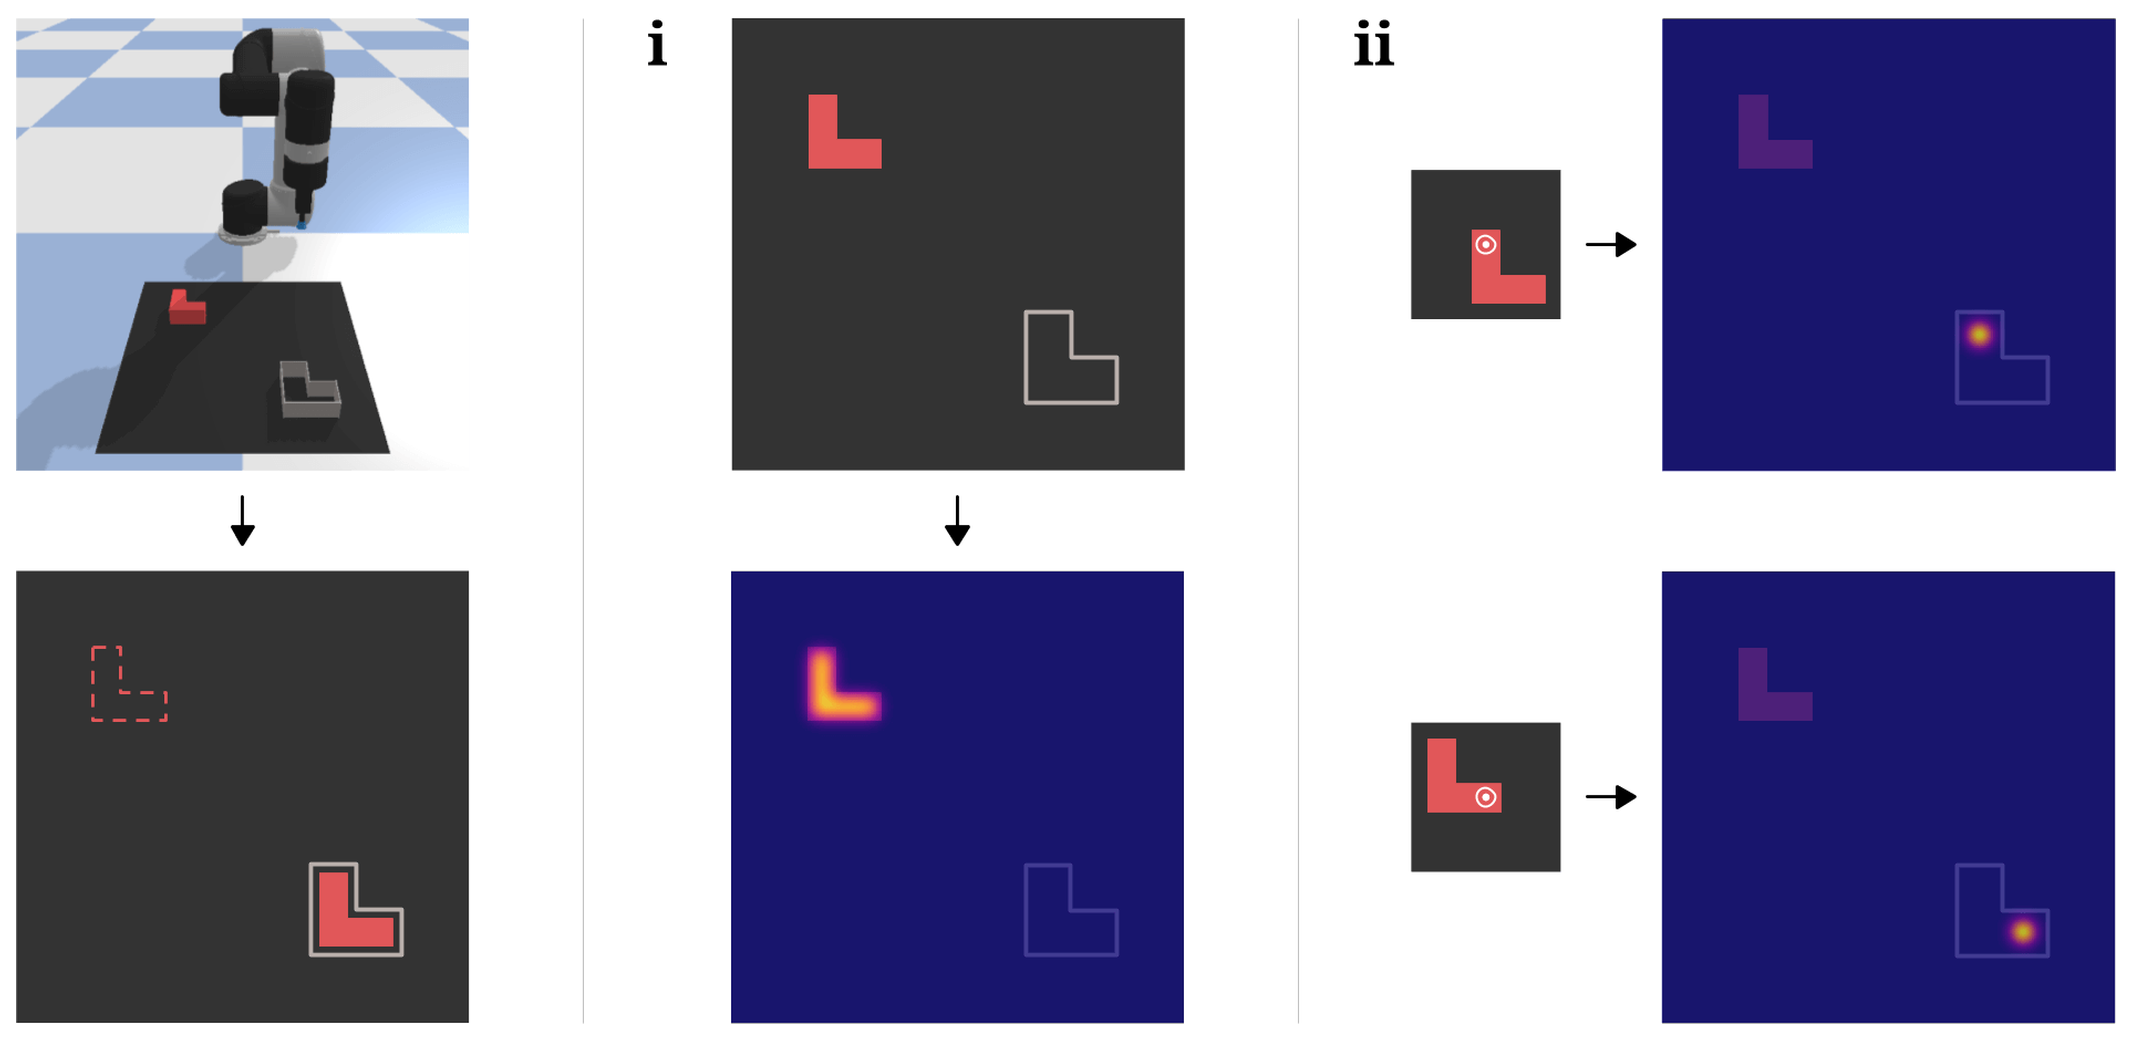
原图怎么读: 图2,原论文图注与图像。先看可成功抓取的位置分布,再看每个抓取位置对应的放置分布。它说明抓放联合结构:固定物体目标并不能唯一确定末端该到哪里。
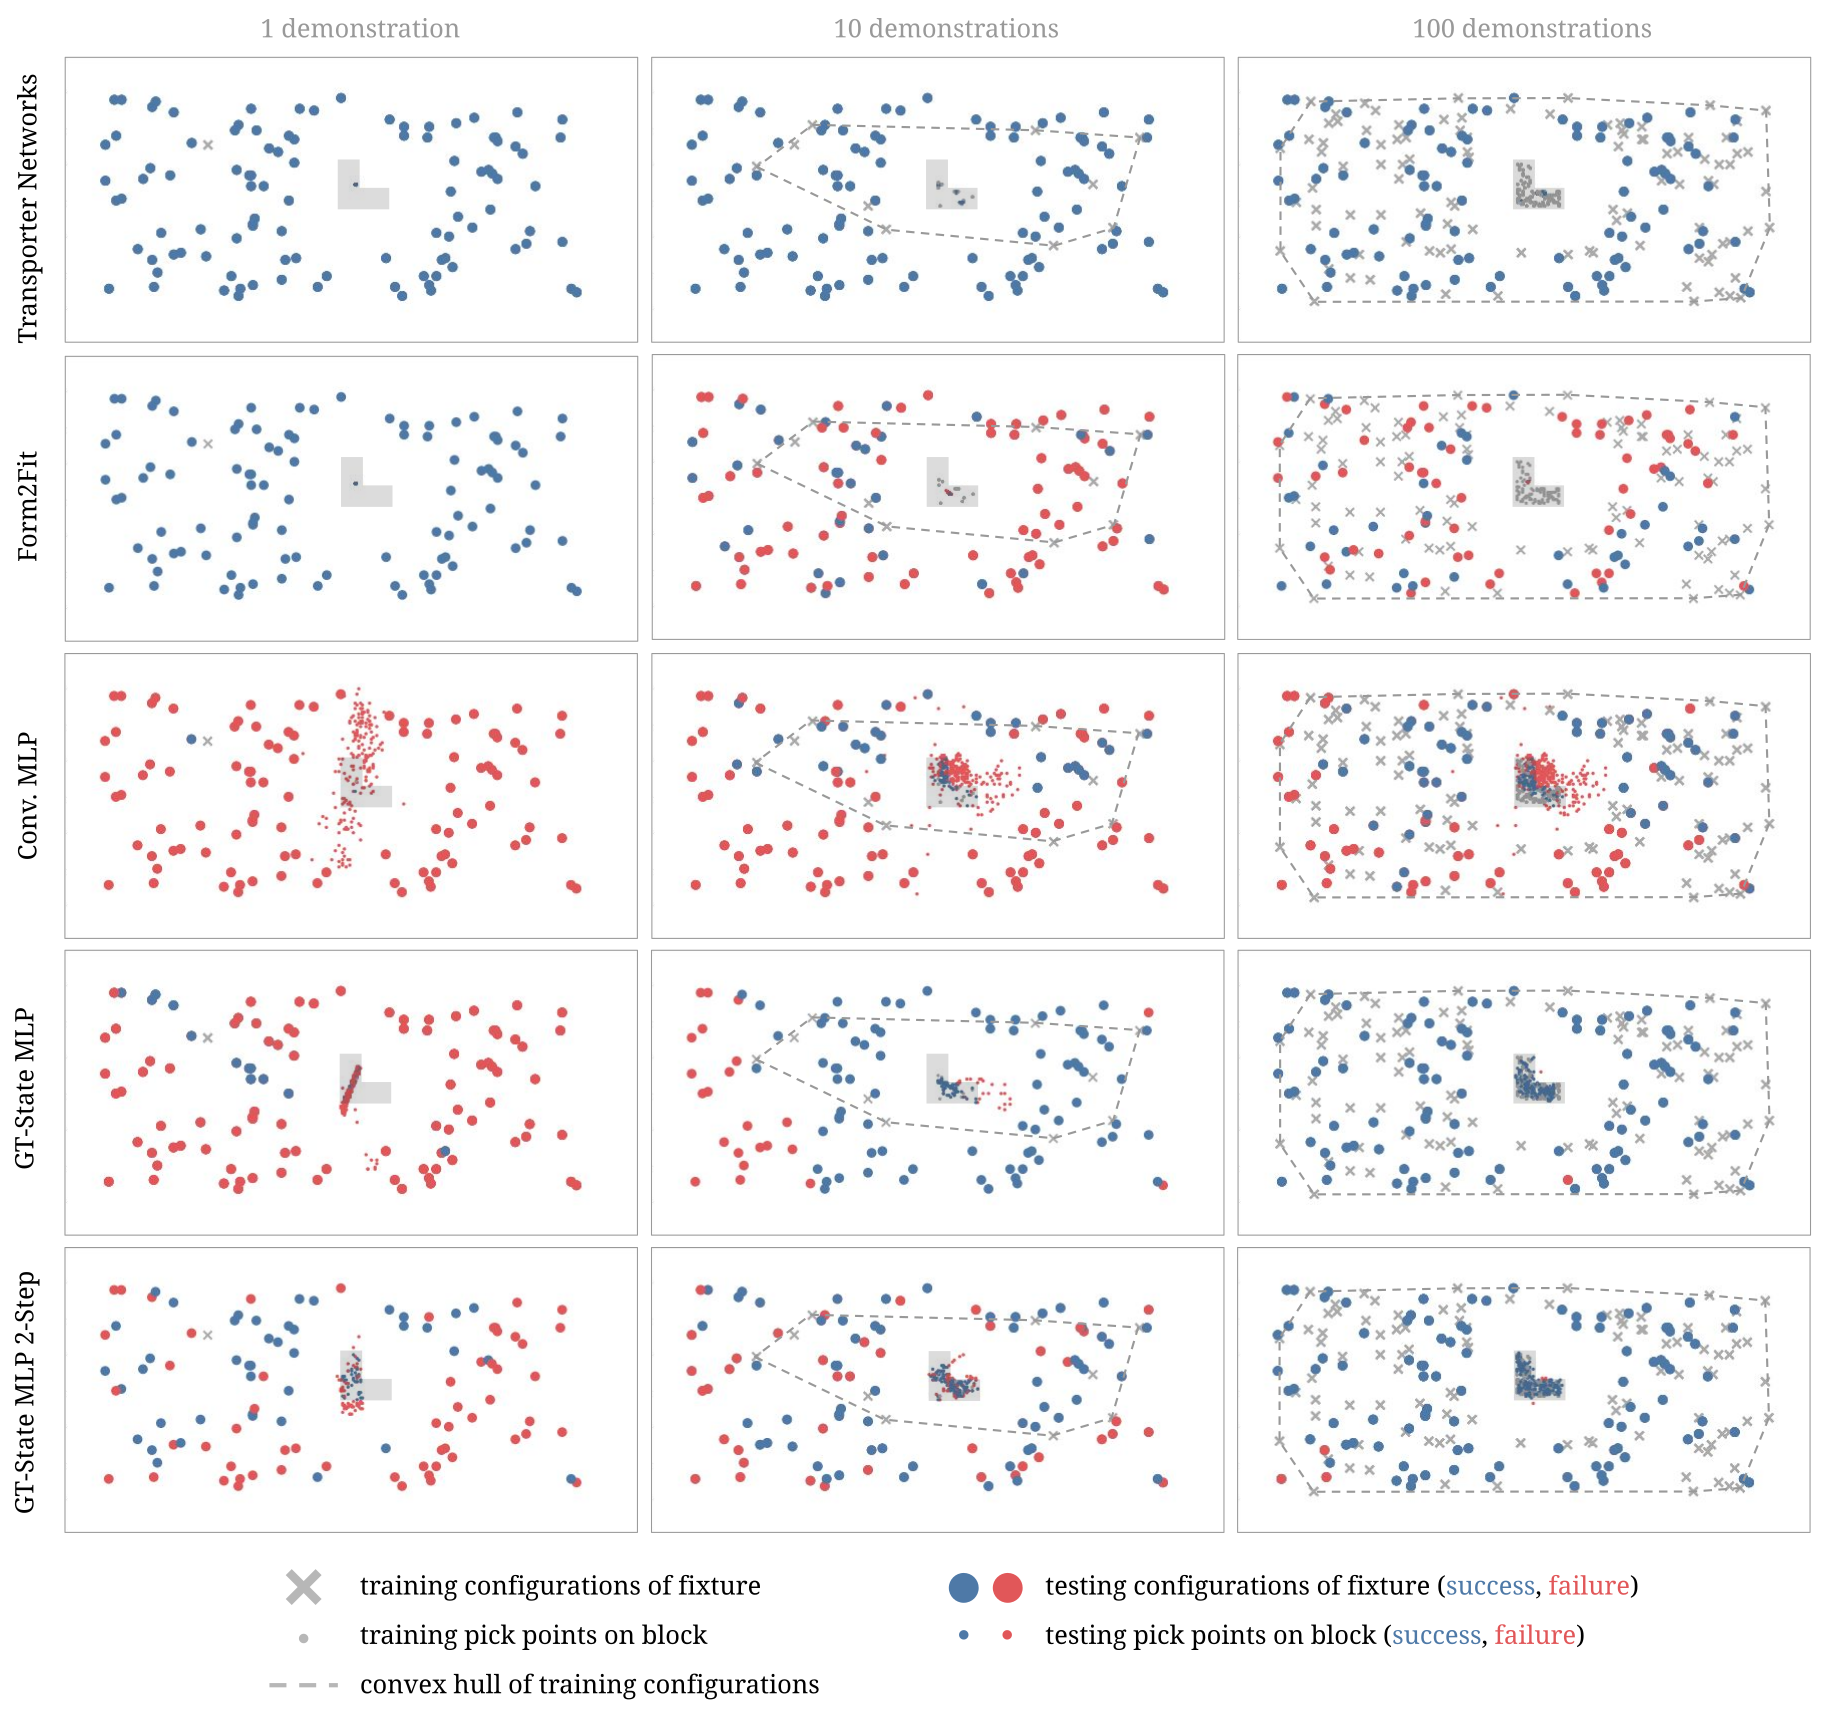
结果图怎么读: 内嵌图9把每次测试放回工作空间:蓝色为成功,红色为失败,灰色标出训练配置,虚线是训练样本凸包。列间改变示范数、行间改变模型;凸包外的蓝点才针对外推,不能把同一区域内插值成功概括为任意物体泛化。
| 项目 | 论文设计 |
|---|---|
| 仿真任务 | Ravens桌面操作,含插入、堆叠、套件装配、绳子与颗粒推移 |
| 数据规模 | 每任务比较1、10、100、1000条示范 |
| 对照 | Form2Fit、ConvMLP、使用真实对象状态的MLP等 |
| 控制变量 | 视觉方法共享输入;所有方法使用一致平面增强 |
| 评估 | 独立场景测试,包含部分完成计分 |
| 真实数据 | 人类遥操作,另行训练真实模型 |
| 特殊分析 | 确定性与随机专家、六自由度扩展、空间外推 |
表格中“条示范”是轨迹,不一定只有一个动作;真实表格的样本数则是动作转移。比较样本效率前必须确认单位,不能把两类数量直接除出倍数。
带真实对象状态的基线拥有额外信息,但其结构未必善于表达几何对应。因此“视觉模型胜过状态MLP”支持架构归纳偏置的重要性,不意味着状态信息本身有害。
任务通过验证集选择模型,再在测试场景评估。模型选择预算与训练种子统计仍应明确;一百次测试场景不是一百次独立训练。
结果:读懂漂亮分数背后的定义
- 表2,仿真示范效率:简单插入任务在一条示范时得分100,说明结构先验在特定几何任务中很强;不能推广成任意操作都能一示范学习。
- 同表,复杂堆叠:金字塔任务一百条示范得56.2,一千条得78.2,显示长序列和多物体关系仍困难。
- 表3,专家随机性:比较多种正确抓放对应,支持抓取条件化搬运更适合处理多模态;不是因为所有基线都只用了简单均方误差。
- 表4,六自由度插入:一百条示范得84.0,一千条得91.0,支持扩展可行;六自由度一示范结果明显不能照搬平面任务结论。
- 表5及真实附录:报告真实任务高分,并说明数据来自人类操作;它验证真实可用性,不验证仿真到真实迁移。
尤其要回看评价定义:有些任务按已完成步骤给部分分,有些按物体处在目标区域的比例给分。因此表中的98分不一定意味着98%的回合完整成功。任务名称相同也要检查计分方式。
真实装配用了8141次抓放动作,扫棋子用了6759次推移动作。它们不是八千多个完整套件,也不是几条示范;数据量与主文少示范仿真实验的语境不同。
五、平面等变结构不自动覆盖三维接触
作者明确指出标定敏感性,以及如何加入力/力矩动作尚不清楚。几何目标能决定物体应到哪里,却未必能决定插接过程中应施加多大力。
本文分析:局部特征匹配可能把相似但语义不同的槽位混淆;无语言条件模型也不能在同一画面下区分“放红色”还是“放蓝色”的新命令。后来的语义操作论文会针对这个缺口继续发展。
六、沿机制关系继续读
CLIPort直接承接Transporter的空间动作结构,再加入语言语义;PerAct则在体素三维空间组织动作,是平行空间表示。共同强调几何,不表示平面等变性自动推广为完整三维接触控制。
七、自测三题与参考答案
问题1:论文写了 Q_pick,为什么不能称它是深度Q学习?
答:符号用于动作评分,但训练采用示范位置的交叉熵,没有 Bellman 自举和折扣回报目标。算法类别由学习目标和数据流决定,不能只看字母Q。
问题2:为什么放置一定要知道抓取点?
答:末端与物体的相对变换取决于抓取位置。相同目标物体位姿,在不同抓取点下需要不同末端位姿。条件化搬运把这个对应嵌入网络,减少独立学习所有坐标组合的负担。
问题3:一条示范插入成功,是否证明一般机器人操作只需一条数据?
答:不证明。该任务具有强空间对称性、固定动作基元和特定场景结构;复杂堆叠与六自由度实验需要更多示范。应把样本效率结论限定在相应任务和先验下。