046|CLIPort:语言语义与空间操作的分工
原论文:CLIPort: What and Where Pathways for Robotic Manipulation,Mohit Shridhar、Lucas Manuelli、Dieter Fox,2021。论文。
先接住前作的问题
Transporter把抓点和放点的几何关系写进网络,却不能仅凭同一画面知道当前指令选的是哪件物体。CLIPort保留空间输运,加入CLIP语义分支;未解问题是预训练“认得什么”怎样影响精确下手位置。
五个前置概念
五个概念:CLIP把图像和文本映射到可对齐表征;语言接地把词语对应到当前场景行动;等变性让输入空间变化对应输出位置变化;互相关扫描局部特征在全局特征中的匹配;动作原语以少量参数调用已有执行过程。
一、问题设定:语言选择怎样进入精确抓放匹配
CLIP能把“红色方块”与图像联系起来,却不会天然给出精确抓取和放置位置。Transporter能做空间对齐,却不知道同一桌面上这次要听哪一句指令。CLIPort把两者连接成语言条件操作策略。
“把粉色方块放进橙色碗”至少包含三个问题:哪个东西是粉色方块,哪个位置属于橙色碗,以及怎样抓起和放好。单纯的图文相似度没有完成第三步;同样,一套会搬方块的几何策略也未必知道语言改了目标。
CLIPort属于离线语言条件模仿学习。观察是正交俯视RGB-D重建,语言可以是一条整体目标,也可以由外部按步骤给出子指令。动作是一对末端位姿,主要在平面 内表示。吸盘抓取的旋转可以固定,放置则离散旋转角。
场景、动作标签与语言配套构成训练样本。没有环境模型、贝尔曼价值迭代或在线奖励优化。原文沿用 等符号并称action-value,但这里由专家像素标签进行交叉熵监督,不能因为字母Q就归入Q-learning。
任务可以包括绳子、布、颗粒等不适合简单物体列表表示的对象,但这来自“直接预测动作位置”的表达优势,不代表系统建立了材料物理模型。每个原语执行完再读图像,原语内部仍然开环。
二、融合语义特征与抓点条件空间输运
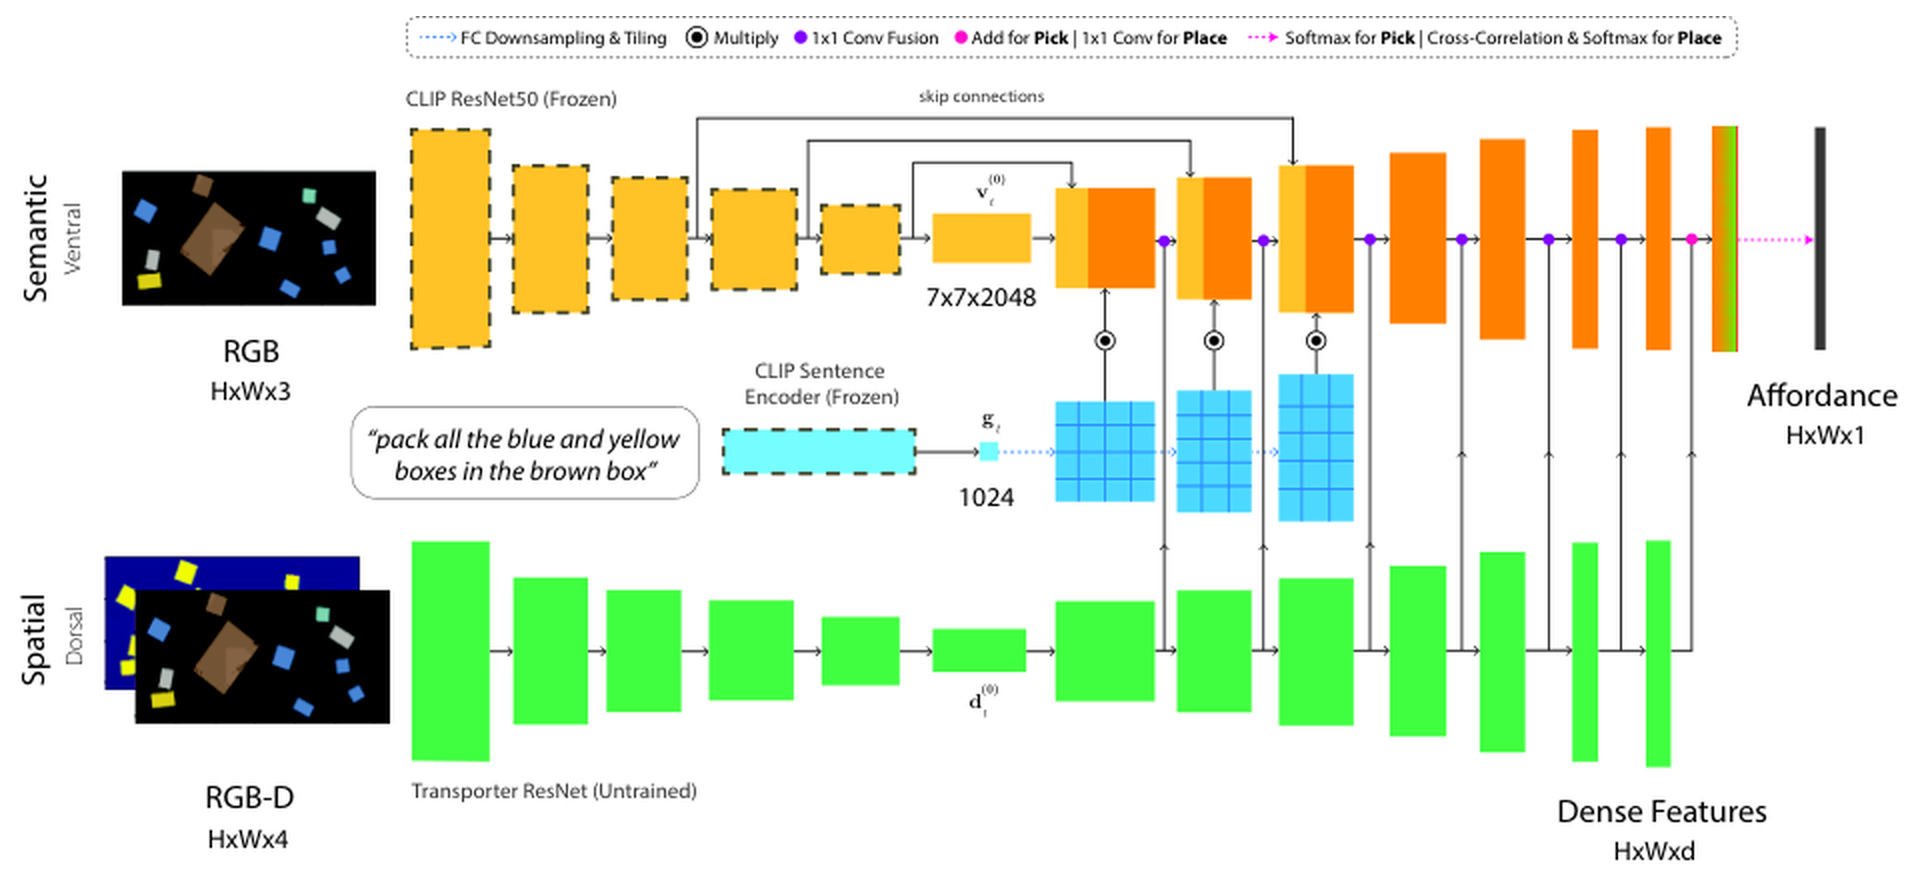
一个语义分支使用预训练CLIP理解颜色、类别和语言,一个空间分支保留RGB-D几何信息,两路特征融合后预测抓取和放置。它用机器人示范训练动作,不需要逐物体检测框或实例分割标签。
1. 三张网络都具有两个分支
抓取网络 输出位置评分,query网络编码抓取点周围的小块,key网络编码完整场景。三者都使用语义和空间两路,而不是先用CLIP挑一个类别再交给完全独立的控制器。
空间路从RGB-D训练小时玻璃式卷积编码解码器。语义路使用冻结的CLIP ResNet50编码RGB,CLIP句子编码器提供1024维语言表示;新加解码层和空间融合层学习动作任务。冻结骨干不等于所有语义路参数都不训练。
在解码层,语言向量经线性映射、空间复制,再与视觉特征逐元素相乘;随后与空间路特征拼接并通过 卷积融合。可以把语言作用理解为调整哪些视觉通道与当前指令有关,但它不是显式符号程序。
2. 从抓取点到放置点
设观察语言对为 :
为互相关;query随抓取点变化,表示拿起的局部内容。旋转query裁剪可搜索不同放置方向。原文用64像素裁剪、36个放置角度、3维匹配特征;36个角度对应10度间隔。
抓取和放置均用softmax后的交叉熵:
上标 表示专家标签。训练放置用专家抓取条件,实际执行用模型预测抓取,所以抓取误差仍会传递。平面重建与卷积结构带来平移上的有利归纳偏置,但语言中“左边”等关系及视角重建也会影响实际泛化,不能只凭架构就承诺任意场景严格等变。
改善的是语义接地、数据效率和空间操作表现;数学目标仍然是行为克隆。预训练提供“是什么”的知识,示范学习“怎样对它行动”,二者不可互相替代。
语言条件可能破坏不加区分的几何增强。教学例:指令“把红块放到蓝块左边”,若图像与动作绕桌面旋转180度而文字不变,原来“左边”变成视觉右边;标签可能已不再满足指令。对象身份类指令较容易保持,绝对方向词必须明确坐标框架或同步改写。
因此空间等变归纳偏置与语言语义并非自动兼容。对颜色、对象组合、空间关系分别留出测试,才能判断是语义组合还是固定位置捷径。原文query旋转搜索解决抓放姿态,不会自行修正语言坐标含义。原文空间与语义两路、旋转输运
例子与五个前置概念
自构例子,未运行:桌上两个同形方块分别红和蓝,两个碗同样可放。语言说红块进蓝碗,语义分支帮助区分对象与目标;空间分支帮助把夹爪落在可抓位置。若训练中所有红块都进绿碗,模型可能忽视“蓝碗”,因此应交叉改变块色和碗色,检查是否真的遵循指令。
三、以语言条件融合两路特征并预测抓放
语义分支选出任务相关内容,空间分支保留抓放几何,两者通过示范动作一起训练。动作原语完成后才重新观察,因此闭环时间尺度不同于连续视觉伺服。
训练:
    单任务抽取观察、指令、专家抓取和放置
    多任务先均匀抽任务,再抽该任务样本
    构建俯视RGB-D,并对图像和动作标签同步做空间增强
    冻结CLIP图像/文本骨干,计算语义特征
    融合可学习空间特征与语言条件解码特征
    预测抓取热图
    在专家抓取点裁剪query,与全图key互相关预测放置
    对两个专家动作位置计算交叉熵,更新可训练参数
执行:
    读取图像和当前语言指令
    选最高分抓取,再条件预测最高分放置
    根据标定将像素和深度转为机器人位姿
    执行选定原语,再次读取图像
    由外部机制判断完成或提供下一步指令
四、区分属性组合、未见物体与真实任务
论文展示了一张多任务策略处理10类仿真任务,以及另一张策略处理9类真实任务。
原图怎么读: 图2,原论文图注与图像。分别沿冻结的语义流与RGB-D空间流看特征如何融合,最后才进入抓取和放置评分。语言预训练提供语义,不自动提供精确抓点或碰撞约束。
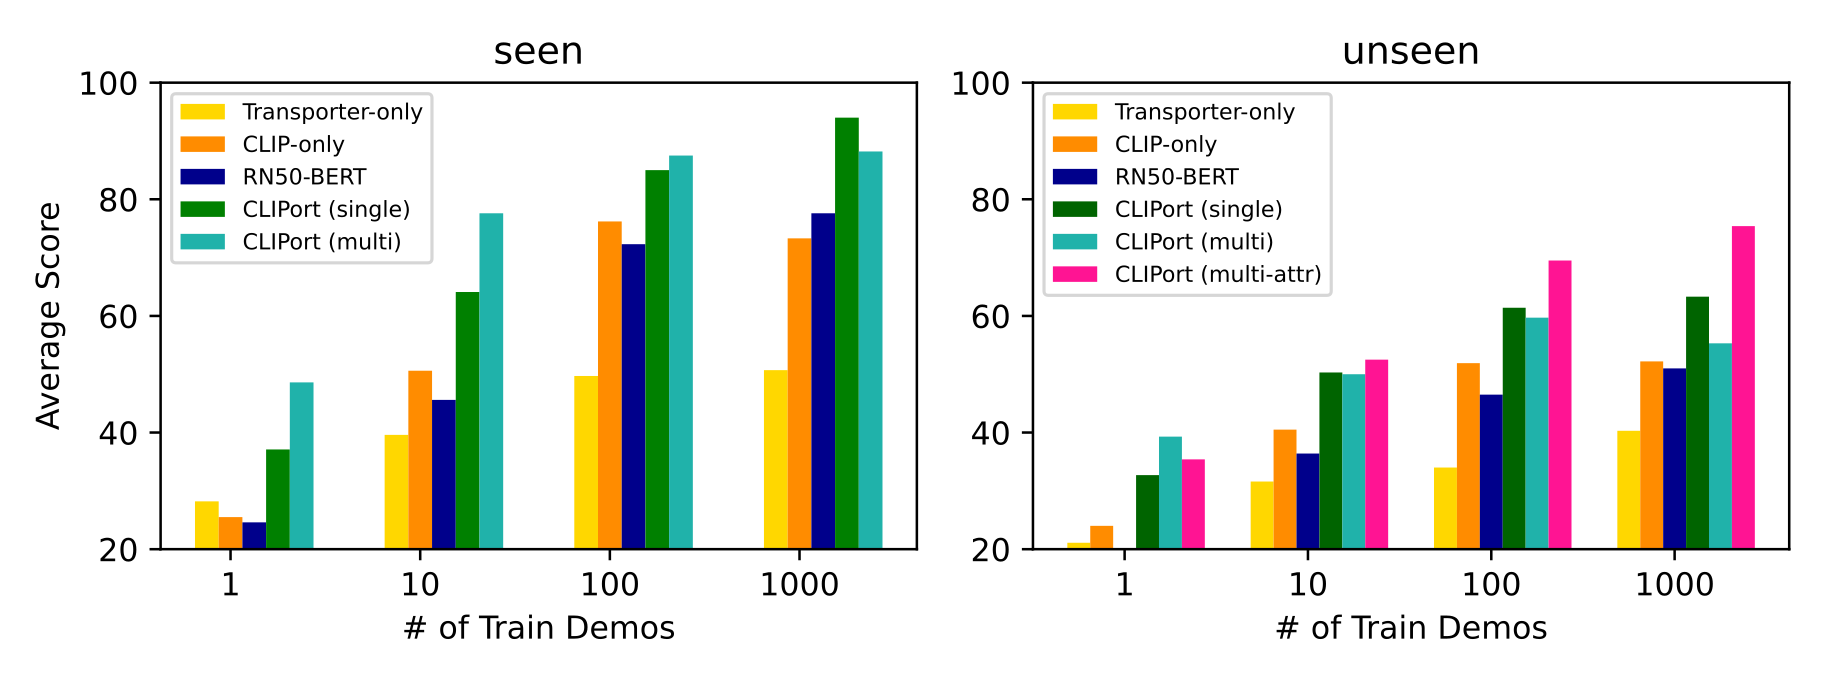
结果图怎么读: 内嵌图3直接比较见过与未见过条件下的平均任务得分。横轴是训练示范数,颜色区分语义流、空间流和两流模型;应在同一示范预算及同一seen/unseen划分内比较,平均分也不表示每个任务都同样改善。
真实演示训练与仿真基准的数据分别构建,因此真实机器人结果不能描述为仿真零样本迁移。
| 项目 | 原文设置及解释 |
|---|---|
| 仿真 | Ravens/PyBullet,UR5e吸盘,3个无噪声640×480相机重建场景 |
| 任务 | 10类,包括装箱、堆叠、绳子对齐、颗粒整理和汉诺塔步骤 |
| 数据规模 | 每任务1、10、100、1000条示范 |
| 单任务训练 | 20万更新、batch1、单GPU约2天 |
| 多任务训练 | 60万更新约6 GPU天,每任务相同示范数但总数据更多 |
| 语言 | 仿真模板生成,真实任务人工标注 |
| 属性划分 | 已见/未见颜色;Google物体37已见、19未见 |
| 评估 | 仿真100个任务实例,按任务部分完成给分 |
| 真实 | Franka Panda,9类任务,共179个图像动作对 |
| 真实测试量 | 每任务5或10次,属于较小规模测试 |
第一类泛化是同一语义下的新位置;第二类是在所有机器人训练任务中没见过的属性;第三类是multi-attr设置,某属性在其他任务里见过,但在目标任务里没见过。第三类是跨任务属性迁移,不是该属性完全零样本。
CLIP预训练本身可能见过粉色、橙色、钳子等语义。论文“未见”应理解为相应机器人训练划分,而非互联网预训练从未包含该概念。
Transporter-only没有语言,CLIP-only缺少完整空间/深度分支,分别回答缺失某种信息能做到什么。因此两者不是完全相同输入预算的架构对照;附录RN50-BERT等替代方案进一步帮助分析预训练表示作用。
五组证据:效果来自哪些条件
图2与表1:两路结合有价值。 已见颜色的方块入碗,100条示范时单任务CLIPort92.5分、Transporter-only62.7分;1000条时前者100分。这里比较的是带语言和不带语言系统,支持目标条件重要,不宜全部归为网络层设计的功劳。
表1:未见属性仍很难。 同样方块入碗,单任务1000条示范的未见颜色得分仅25.0,多任务45.8;已见颜色则可到100。互联网语义没有自动解决物理画面中的颜色接地与训练偏差。
表1的multi-attr:概念可以跨任务使用。 对目标任务不提供未见颜色示范,但其他任务提供相关属性后,方块入碗从45.8升至75.7,增加29.9分。不能把它写成新增数据为零,也不能称为所有任务都获得同样收益。
表1与图3:多任务并非全部更好。 作者统计72组比较中41组更优。1000示范的绳子对齐单任务95.4、多任务74.9。作者推测均匀抽任务会使长程任务动作对覆盖不足;这个解释值得通过按轨迹长度平衡采样验证,而不是已完成因果证明。
表2与附录I:真机能力与数据偏差并存。 179是图像动作对总数,不是179条完整轨迹。真实堆叠得分70、折布57、扫豆60.6,不同任务允许部分完成,不能统一读成每100次的完整成功次数。作者还发现“黄色块总放蓝碗”的偏置:少量补充交叉组合示范,才迫使模型关注语言目标。
这些结果可核对原文表格、方法及局限。本文未确认全部实验的训练随机种子重复安排,不把100个评估实例当作100个独立训练种子;表格单一均值无法说明所有训练方差。
五、语义迁移不能替代连续反馈与标定
这篇论文是视觉语言预训练进入精确机器人操作的一条清楚路径:保留空间结构,把语义接进动作预测。它没有要求先把每颗豆子建成一个符号对象,但通过像素动作仍能操作颗粒或布。
核心边界是动作抽象。平面起终点原语降低了学习维度,同时把连续执行控制交给已有流程;延伸到灵巧手或快速六自由度接触并不直接。附录I明确指出手眼标定敏感、原语内部开环、没有任务完成预测,也没有记忆处理复杂部分可观察任务。
语言理解也受示范语境限制。“sort”在训练里可能只是把一类物体移进箱子,并不意味着懂得按数字大小排序。复杂关系如“中间”、计数和多对象关系容易失败。动作库与数据组合覆盖仍决定实际边界。
追问:怎样检测策略是在理解颜色词,还是记住物体位置?
参考答案:在相同场景改变命令,在相同命令下交换物体位置,并保留颜色与几何的交叉组合,才能减少单一捷径的解释。若只在固定布局中测试新句子,高成功仍可能来自位置关联。还应单独统计抓取对象选择与放置精度,区分语义错误和空间控制错误。
六、沿机制关系继续读
CLIPort直接承接Transporter的抓点条件输运,并组合预训练语言视觉语义;GenAug后续用生成增强训练CLIPort,关系是模块组合,标签几何不变性成为新的审查重点。
七、自测三题与参考答案
问题1:为什么CLIP认识“钳子”仍可能抓错位置?
答案:图文预训练主要支持类别与语义关联,没有监督夹持稳定性、接触位置和执行器限制。CLIPort需要示范将语义转成动作能力;附录钳子例子中也有未见实例失败。识别正确只解决了部分问题。
问题2:multi-attr从45.8到75.7是否证明完全零样本颜色泛化?
答案:不证明。目标任务没有相应颜色示范,但其他机器人任务包含这些属性;改善证明跨任务转移的可能性。还应与总数据和训练步数匹配的对照比较,不能忽略额外监督。
问题3:为什么每次抓放后重新看图,仍不能称为连续视觉伺服?
答案:两次原语之间有闭环反馈,单次原语执行期间却不根据新图像持续修正。物体在抓取途中移动时仍可能失败。连续视觉伺服需要更高频的观察动作反馈以及相应训练或控制机制。