044|IBC:用能量函数表示多峰动作
原论文:Implicit Behavioral Cloning,Pete Florence 等,2021,本文依据v1。论文。
先接住前作的问题
robomimic说明混合示范的相反动作不能简单平均;显式混合分布是一种办法。IBC改为学习观测与候选动作的能量,再搜索低谷,追问如何表达不连续选择;这里延续多模态问题而非同一网络结构。
五个前置概念
五个概念:能量模型给观察动作匹配程度评分;对比学习降低正例相对负例的能量;argmin返回使目标最小的动作或动作集合;多模态表示多个不同动作同时合理;闭环控制每执行一步重新观察并修正。
一、问题设定:连续网络怎样表示分支动作选择
普通行为克隆接收图像,直接输出动作。IBC换了一个接口:网络同时接收图像和候选动作,输出一个“能量”;控制时寻找能量最低的动作。
接触操作经常有阶段边界:推到目标附近要转为微调,物体滑脱要重新接近,扫完一堆要转向另一堆。同一观测附近的适当动作可能变化很快,甚至存在多个同样可行的选择。
确定性平方误差回归倾向于条件均值;混合密度网络能建模多个峰,但仍需要设计分布形式。IBC从更一般的能量函数入手,不预先指定“动作必须服从几组高斯”。
它是离线模仿学习,不需要普通版本的奖励标签、价值函数或学习环境模型。名称中的implicit指动作通过优化隐式定义,与后来 IQL 的 implicit 不是同一个算法机制。预测得分也不是估计未来累积回报的Q值。
实验设定很多,不能混成一个统一机器人:D4RL用低维状态;仿真推块使用脚本示范;平面扫粒子使用人类示范;双臂铲取使用脚本示范;真实xArm6使用鼠标遥操作与RGB图像。真实策略输入只有图像,但执行系统仍需要逆运动学与低层关节控制。
二、用对比能量训练并搜索低能候选
这种变化适合某些存在分支的操作。例如既可以向左绕,也可以向右绕,但不能取两者平均直冲障碍。能量函数可以为两个合理动作各保留一个低谷。即使能量网络连续,最低点的位置也可以突然从一个低谷跳到另一个,因此能够表达动作切换。
1. 学习目标与动作选择
设观察为 ,动作为 ,能量网络为 :
对每个示范动作 ,生成若干候选负动作 ,使用对比损失
这会压低示范动作相对候选的能量。它近似条件分布 的学习,但有限负样本的归一化不是精确计算连续动作空间的积分。
“负动作”只是本次候选,没有来自真实试验的失败标签。另一条成功路径也可能被随机采成负例;足够的数据覆盖、负采样与模型优化共同决定最终分布。不能把这种训练写成已经知道所有动作成败的监督分类。
2. 搜索也是策略的一部分
论文使用无导数搜索、自回归无导数搜索、带梯度惩罚的Langevin方法。真实图像任务采用无导数版本,训练负例从动作范围均匀采样。范围由数据逐维最小最大值加缓冲,再截断到环境允许范围。
无导数推理先均匀采样动作,按负能量softmax重采样,添加逐渐减小的噪声,再次评分。它类似CEM,但没有固定精英数量,也不从精英经验方差更新搜索方差(附录B.1)。因此不宜直接把原算法叫成标准CEM。
视觉特征采用后期融合:先编码图像,再把同一图像特征与很多候选动作组合评分,避免每个候选都重复运行整套视觉编码器。网络参数固定,搜索更新的是候选动作,不是现场重新训练模型。
该流程改变了策略表示和推理方式;监督目标仍然是示范匹配,改善指标是任务表现。没有通过贝尔曼备份提高Q值,也没有凭空解决行为克隆的分布偏移。
3. 理论证明到哪里为止
定理1讨论闭图的非空集合值映射可以表示为连续函数的argmin;定理2给出与目标函数图像距离相关的近似结论。关键直觉是两个连续能量谷的高低顺序可以交换,最佳动作的位置随之跳变。
这不是“所有神经网络都能学到最优策略”的证明。附录G明确说明,它没有保证训练算法找到这样的能量,也没有保证非凸搜索求得全局最小值。图距离接近也不自动等于每个固定观察下的动作误差都一样小,更不等于闭环控制稳定。
连续能量可以给出不连续最优动作。教学构造 ,观察 从负变正时,两座连续能量谷的最低者交换,argmin从约1跳到−1。这里的min能量是说明表示能力的自构函数,并非论文网络实现;它表明能量平滑与动作选择连续不是同一个要求。
真正部署还须找得到谷底。若好动作占均匀采样区域比例 ,抽 个候选至少命中一次的概率是 。维度增加可使 迅速缩小,所以原文高维任务换用自回归或梯度方法很重要。比较成功率时,候选数和迭代数属于策略定义的一部分。原文附录B
一个例子与五个前置概念
自构例子,未运行:在插入前,块体略偏左时需要向右轻推,略偏右时需要向左轻推。过渡区域存在两种接触模式,直接平均可能把动作变成零。能量网络可形成左推与右推两个谷,由当前图像改变它们的相对高度。但如果视觉无法分辨偏向,任何策略都缺少信息,能量形式不会自动补出传感真值。
三、训练能量排序并在每个观测下求低谷
负样本让能量网络学会区分可行与不可行候选,但执行动作还取决于搜索器是否找到低谷。候选生成、迭代次数和边界处理都是策略的一部分。
训练无导数版本:
    由示范统计动作边界,添加缓冲并约束到合法范围
    重复:
        采样观察o和示范动作a+
        在动作范围内均匀生成N个候选负动作
        编码o,分别计算a+与全部负动作的能量
        用对比交叉熵更新能量网络
部署单步:
    编码当前观察
    均匀生成候选动作集合A
    重复规定次数:
        计算每个候选的能量,得到softmax(-E)权重
        若还要继续搜索:
            按权重有放回重采样
            加噪声、裁剪范围,并缩小下轮噪声
    返回最终能量最低的候选
    执行动作,读取新观察,再进行下一轮闭环决策
四、将表示收益与搜索预算分开评估
论文在函数拟合、仿真操作、D4RL及真实推块中验证这一表示选择。真实任务包含毫米级间隙的推入,但机器人运动被限制在桌面上方二维平面。
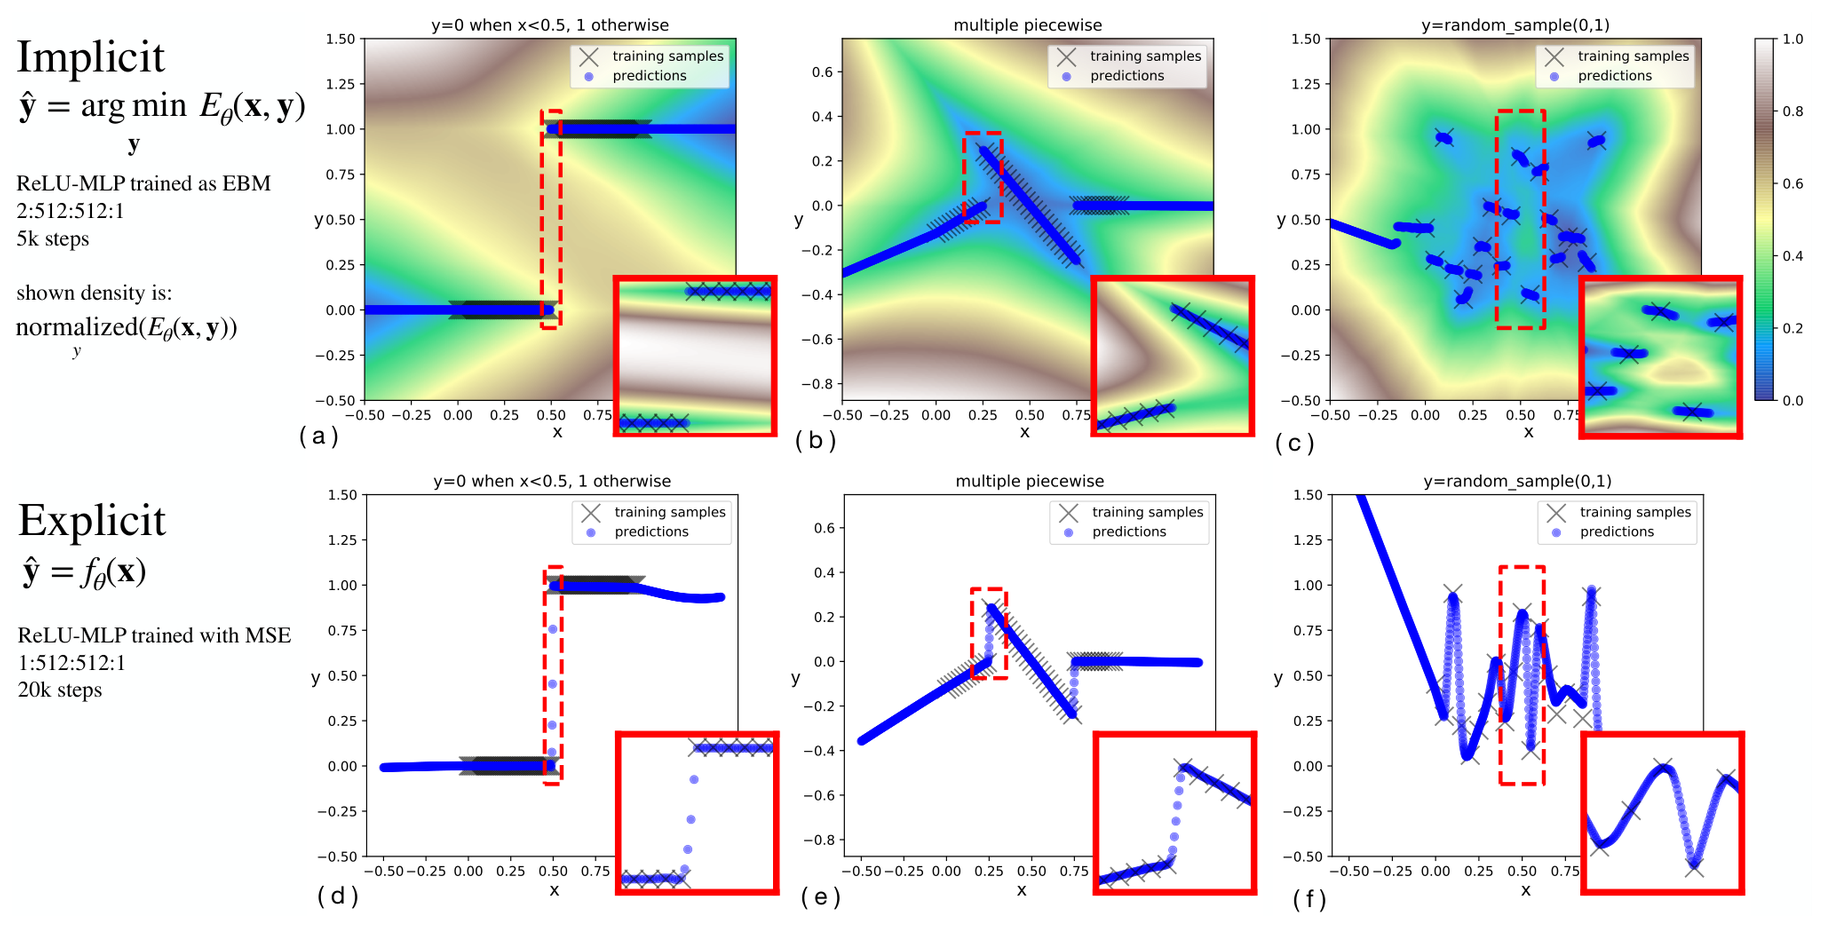
原图怎么读: 图2,原论文图注与图像。红色放大框关注不连续点附近,训练区间外另检验外推。连续能量可以让最优动作分支跳变,但这张一维拟合图不能替代真实接触任务的安全性评估。
真机插入评价包含部分完成得分;图表中的平均分不能换写成完整插入成功率。
| 项目 | 原文设置 |
|---|---|
| 对照 | 显式MSE、混合密度MDN、最近邻;部分D4RL基线引用原作者结果 |
| 粒子维度实验 | 每个维度2000条脚本示范,维度1至32,隔离动作切换与数据稀疏性 |
| 仿真推块 | 2000条脚本示范,单目标、多目标及图像输入 |
| 平面扫粒子 | 50条人类示范,粒子数量50至100,测试不同排列 |
| 双臂铲取 | 1000条脚本示范,12维笛卡尔动作,700步、10 Hz |
| 真机四任务数据 | 95、410、223、502条遥操作示范 |
| 真机评估 | 每种方法每任务3种子,每种子20回合,共60次 |
| 真机控制 | 图像策略5 Hz,设定点插值为100 Hz,经逆运动学传给关节控制 |
| 真机训练 | 10万更新;不同任务批次与网络宽度存在差别 |
| 测试指标 | 既有整任务二元成功,也有部分插入与粒子/物块完成比例 |
学习器的动作界限来自示范数据,会缩小搜索范围并提高分辨率,同时可能排除没有被示范覆盖的有用动作。毫米级结果还依赖固定桌面、目标夹具和受限平面运动,不能当作任意六自由度装配的证据。
D4RL实验还额外研究只取回报最高50%示范的版本,表中标为RWR。这个版本使用奖励进行数据筛选,不能沿用基础IBC“不使用奖励”的描述。
五组证据:收益和失败一起看
图2至图4:表示能力诊断。 简单函数显示隐式形式能够维持分支而不输出中间动作;视觉坐标回归在少数据下也更好。这些实验帮助解释假设,但不是对复杂接触机器人成功原因的完整因果证明。
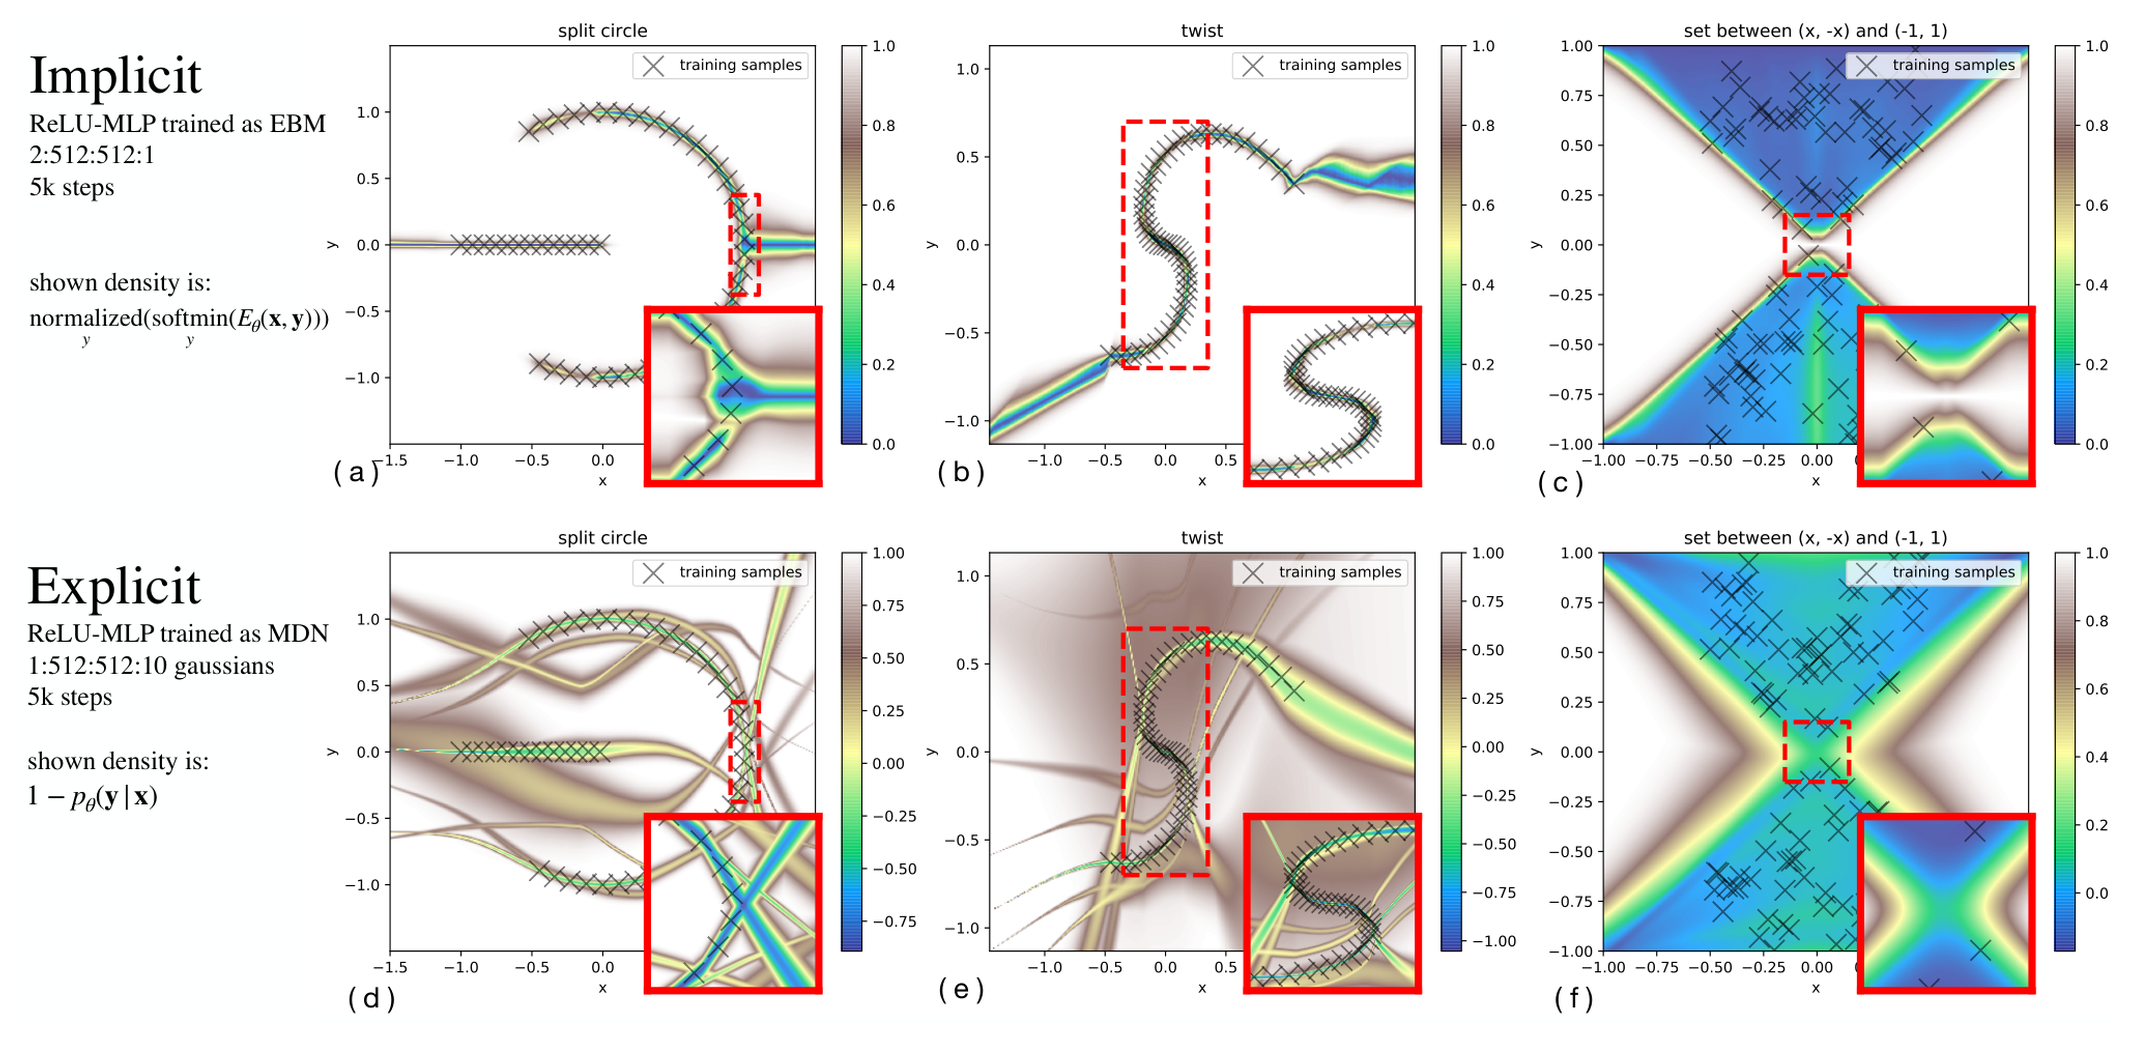
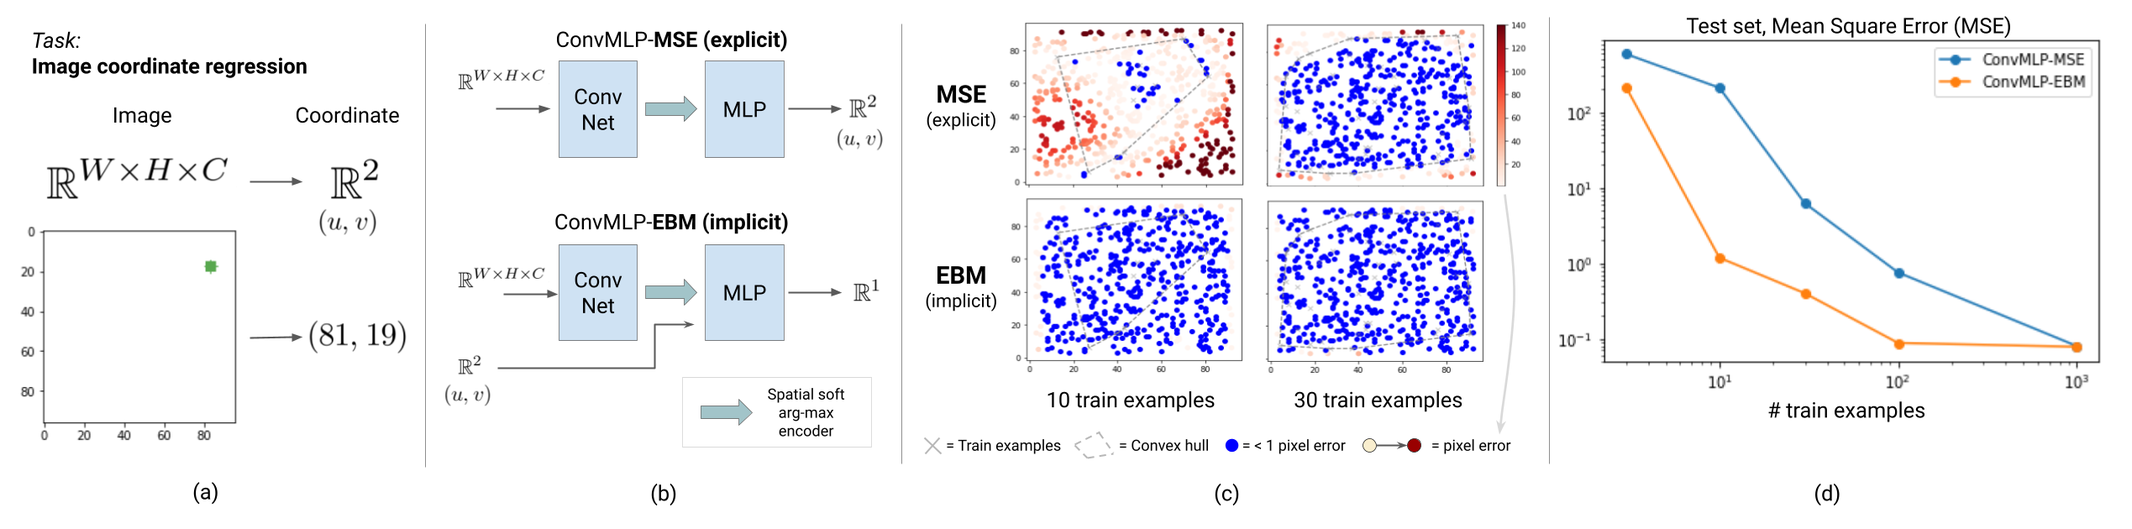
表2:D4RL并不全面胜出。 kitchen-complete中IBC回报3.37、MSE1.76;kitchen-partial中IBC1.45反而低于MSE1.69。hammer-human中IBC为−133,MSE为−38,CQL为300.2。它们是任务回报,不是成功百分比;不能说IBC在所有人类专家任务上击败离线RL。
表3:图像推块的明显优势。 单目标图像任务IBC100%、MSE87%、MDN10%。但多目标状态输入任务MDN99.7%,IBC99.0%,差异很小。结论应是表示与输入条件交互,而不是MDN普遍不能学习多模态。
真实任务结果表:部分得分要单独识别。 顺序推红绿块85.0%对35.0%,多模态推块88.3%对55.0%,是二元任务成功。蓝块插入83.3%对6.7%,但部分插入计0.5;分类48.3%对19.6%,按每个正确物块计八分之一。因此后两项是平均完成分数,不能直接称为完整任务成功率。双臂扫粒子的78.2%同样是粒子完成比例。
附录C.2:性能需付推理成本。 单RTX2080Ti上示例IBC推理7.22毫秒,显式模型3.49毫秒;增加搜索候选到2048后为9.25毫秒。D4RL door示例训练加评估3.4小时对0.66小时。两组设备、输入与算法不同,不应拼成统一加速比,也不能把7.22毫秒倒数直接当作论文真实闭环频率。
证据来自论文正文和附录。HTML的浮动表格编号有转换混乱,真实结果以“Real-world robot results”标题与四个任务名识别更可靠。附录表7的步速与总训练小时也不完全相容,本文仅使用明确的推理测量,不从该表推导训练吞吐结论。
五、能量形状好也可能被优化器错过
主要新意是把能量式条件建模作为完整BC策略,而非仅作为RL中的价值组件,并把理论表达能力与真实闭环证据联系起来。作者明确强调具体EBM采样技巧不是这篇最核心的原创点。
更灵活表示的代价是推理不再一次直接输出:候选数量、噪声日程、动作范围和局部最优都会影响结果。能量函数在数据外出现虚假低谷,搜索可能更积极地找到错误动作;低能量不是经过校准的成功概率。
原文承认计算和实现复杂度增加。本文进一步分析,真实测试只与MSE显式基线比较,不能据此证明胜过所有高质量混合策略或后来的动作生成方法。部分实验所选网络宽度、批次和图像结构也不完全一样,表示能力之外的因素需要在复现时控制。
追问:增加训练负样本与增加执行候选数,为什么不能当作同一种改进?
参考答案:前者改变能量函数学习到的区分边界,后者改变固定函数上找到低谷的机会。可先冻结同一能量网络测试不同搜索预算,再固定搜索器比较负采样训练,分别报告延迟和闭环成功。否则搜索更充分的收益可能被误记为表示更好,训练更强也可能被差搜索掩盖。
六、沿机制关系继续读
IBC与Diffusion Policy是平行多模态行为克隆路线:能量排序加搜索,与学习去噪采样不同;它与IQL中的implicit仅名称相近,后者隐式做离线价值学习,目标并不相同。
七、自测三题与参考答案
问题1:能量网络是连续的,为什么动作可以不连续?
答案:连续性约束作用于能量值,不约束最小值位置。当两个相隔很远的低谷连续地交换高低,argmin会从一个位置跳到另一个。代价是边界附近的小能量误差也可能导致动作分支切换,理论表达力不自动保证平滑控制。
问题2:为什么IBC不能直接视为Q-learning?
答案:IBC通过示范与候选的对比学习能量,没有奖励和贝尔曼目标;Q-learning则估计动作后的长期回报。两者都能通过优化一个标量选择动作,但标量含义、数据需求和训练目标不同。
问题3:蓝块83.3%能否写成“每100次有83次完整插入”?
答案:不能,部分插入也记0.5,83.3%是平均得分。要恢复完整插入次数必须有每回合分类结果,仅靠均值不够。正确比较还需匹配夹具、二维运动约束、示范数量和60次评估协议。