061|Diffusion Policy:在动作空间迭代去噪
原论文:Diffusion Policy: Visuomotor Policy Learning via Action Diffusion,Cheng Chi 等,首次公开2023年;本文阅读2024年3月v5扩展版,并区分新增双臂结果。论文。
先接住前作的问题
IBC通过能量低谷保留多种动作,但执行仍依赖候选搜索,逐步选择也可能在不同路线间摇摆。Diffusion Policy改为条件生成整段动作,通过滚动执行协调时间一致性;去噪目标与能量排序不是同一训练规则。
五个前置概念
五个前置概念:多模态分布有多个合理峰;去噪分数匹配学习不同噪声尺度的分布方向;动作分块联合预测多个时间步;滚动时域执行一部分后重算;EMA用参数移动平均平滑训练模型。
一、问题设定:怎样保留多条路线又避免逐步左右摇摆
推一个T形物体时,机械臂可以从左绕,也可以从右绕。若直接回归平均动作,可能直冲物体;若每一步独立选路线,又可能左右摇摆。Diffusion Policy把一段未来动作作为整体分布来学习,从随机噪声逐步生成一条连贯动作序列,只执行其中一部分,再根据新观测重新生成。
这是离线视觉模仿学习,既测状态输入也测图像输入。策略输入最近步观测,预测步动作,执行步后重新观察。观测可包括图像和本体状态,动作是末端位置、旋转、夹爪等任务相关控制量。
它解决的不是缺少奖励,而是示范动作有多个合理模式、时间相关性强,且接触操作要求精度。单高斯难表达分叉,独立分类难保持整段选择,能量模型的高维采样又可能困难。
示范中的停顿尤其值得注意:倒酱汁时等待勺子装满是必要动作,不能一概作为无效数据删除。单步策略可能被大量静止样本吸引,停在当前状态;序列策略能把等待与随后抬起作为完整局部过程一起学习。
与Diffuser的区别是这里只学习,不联合生成状态轨迹再按奖励引导。与UniPi相比,它省去视频生成和逆动力学转换。没有显式世界模型不代表网络完全没有时间规律,但不能因此说它提供了可验证的动力学预测器。
二、以观测为条件联合去噪一段动作
它生成动作,不生成视频,不学习Q值。训练仍然是模仿学习:把专家动作加噪,学习如何去噪。相比需要负样本的隐式能量策略,训练目标更直接;相比单步回归,能表达更复杂的多模态轨迹。
真实Push-T实验中,最佳CNN版本20次试验成功95%,最终平均IoU为0.80;最强LSTM-GMM版本成功20%。但这不是在所有任务上都由同一个固定网络赢得:CNN与Transformer各有强项。
1. 两种时间必须分清
机器人时间为,动作段包含未来若干动作;扩散时间为,表示同一动作段的噪声强度。使用标准DDPM记法解释原文式3–5:
是干净专家动作段,是累计噪声日程,是观测条件。这里MSE比较的是噪声,不是直接把所有专家动作平均到同一个输出。
推理从高斯动作噪声开始,多次调用去噪网络,逐渐获得符合当前观测的动作段。不同初始噪声可以落到不同合理轨迹模式。采样过程寻找的是学习分布中的动作,不是通过真实奖励搜索全局最优动作。
把噪声预测换成分数时,缩放来自前向高斯核,而不是一个可随意省略的常数。令,对固定干净动作有
对可能的干净动作按后验取平均,得到带噪条件分布的分数;平方误差最优的噪声预测器则给出条件噪声均值。因此在相应正则性和理想拟合条件下,
这解释了为什么同一个噪声输出在不同处对应不同分数尺度,也说明分数属于,不是未经加噪的动作分布。教学数值:、某维预测噪声为0.3,则该维分数近似为;它是动作样本空间的方向,不能直接当机器人力矩。上述推演采用Tedrake课程的条件去噪讲法并展开本篇前向核,具体采样仍遵守原论文式8及噪声日程,不据此声称有限网络得到了精确梯度。
2. 观测只编码一次
ResNet-18视觉编码器端到端训练,使用空间softmax保留位置信息、GroupNorm配合EMA稳定训练。不同视角分别编码,历史特征拼接。去噪过程只更新动作,复用同一份视觉特征,避免每一步都生成或重新解释未来图像。
CNN版本用时间一维U-Net,并通过FiLM注入观测和噪声等级。Transformer版本把含噪动作当token,用观测交叉注意力输出各位置的噪声估计。后者更能适应快速变化的动作,但作者发现调参更敏感。
3. 执行一段,保留重新考虑的机会
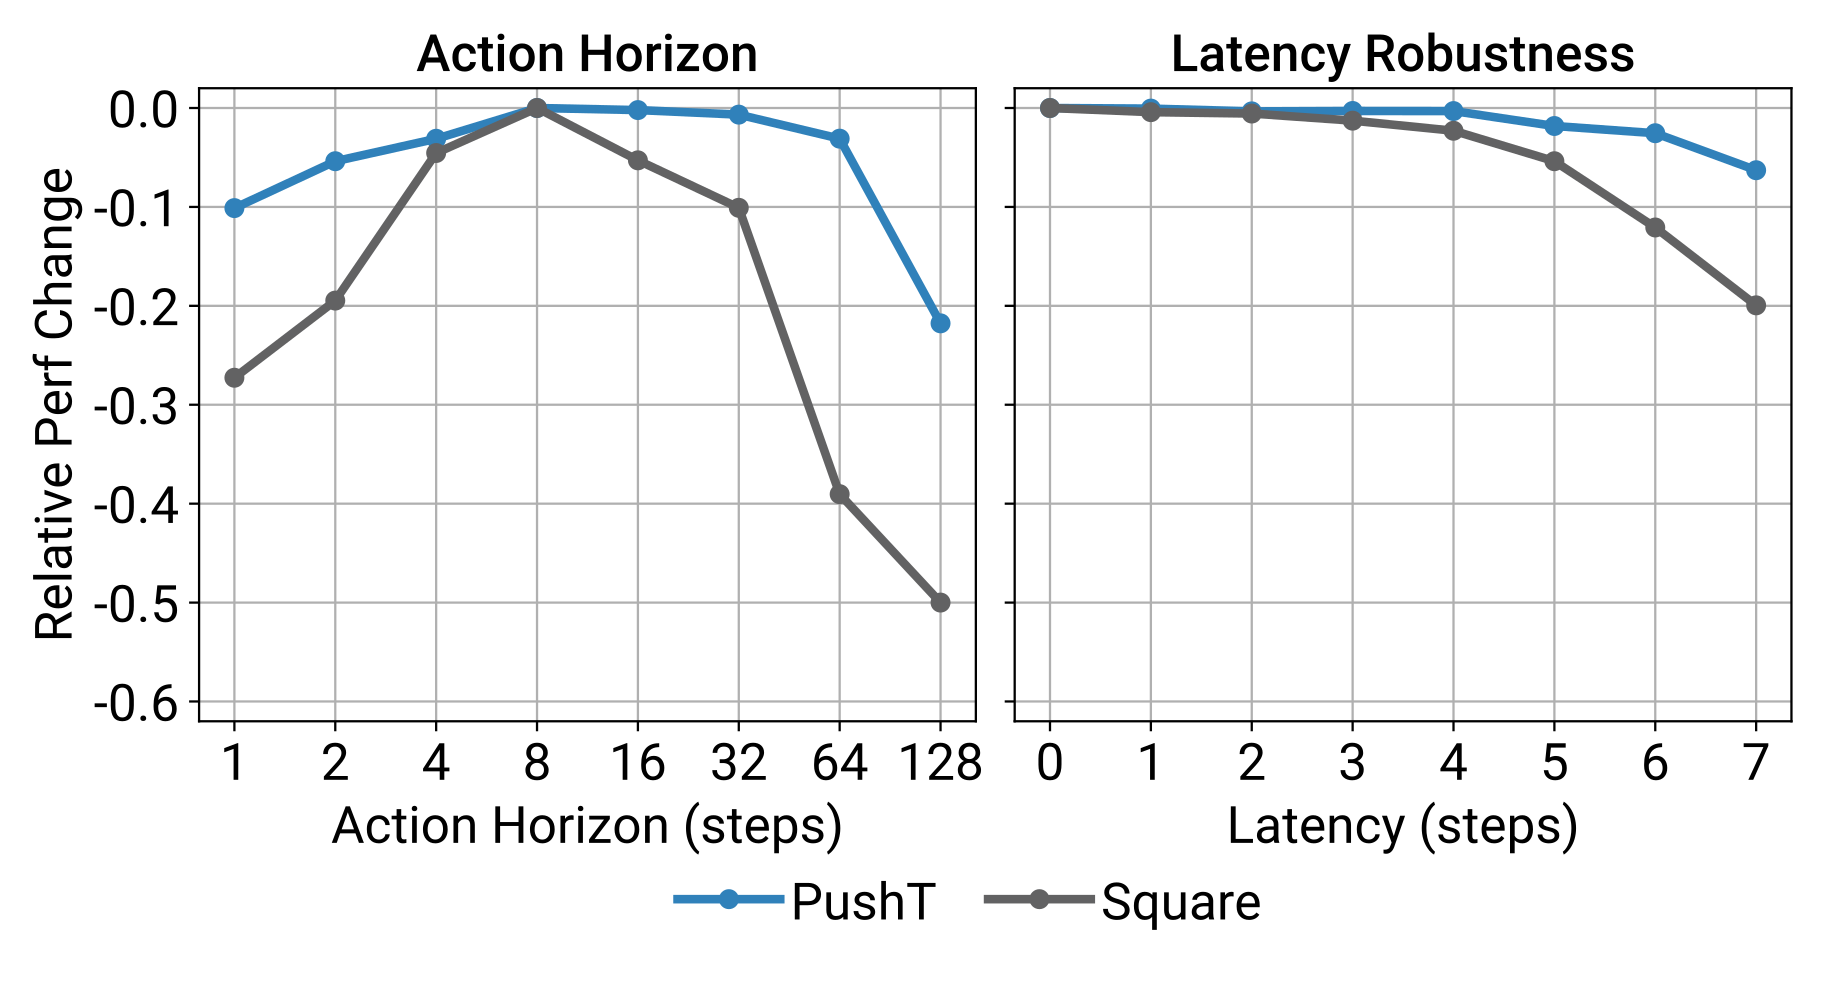
若,反馈快,但可能不断切换模式,推理成本也高;若且很长,动作稳定却难应对中途扰动。论文多数任务选择执行约8步,但具体设置不同,BlockPush甚至用单步执行。
联合动作分布的价值在相关性,而不只是每步多峰。教学设定:左绕动作段为 ,右绕为 ,各占一半;若两步分别从各自边缘独立采样,会以一半概率生成 或 ,在途中换边。整块生成有机会保留两步相关性,而直接取均值又会得到危险的 。
但换到下一块时仍可能重新选模式,所以预测长度与执行长度必须共同调节。原文执行时域消融支持适度执行多步,而非普遍越长越好;8步是多数所测任务的经验折中,实际闭环延迟还取决于每步秒数。原文§4.3与时域消融
如果执行八步期间人把障碍移到所选路线,策略要等下一次观测重规划才能纠正。把执行段改为一步反应更快,却可能反复改变方向。这个例子说明分布表达与反馈速度必须一起设计。
三、用加噪动作训练去噪器并执行短前缀
观察窗口、预测长度和执行长度分别决定看到多久、计划多久、承诺多久。每次动作块只执行一部分,再以新观测去噪,才能兼顾序列一致性与反馈。
训练:
  从示范采样观测历史O和未来动作段A
  随机选择扩散等级k,给A加入高斯噪声
  编码O,预测加入的噪声
  最小化噪声预测MSE,维护EMA参数
推理:
  编码最新观测历史
  初始化整段动作为高斯噪声
  按DDPM或DDIM日程多次去噪
  从生成段中取与当前时刻对齐的Ta步
  交给低层控制器执行
  获取新观测,重复整个过程
这是教学伪代码。原文允许以上一段动作热启动,但不应把可选能力写成所有报告结果的必备实现。机器人仍由位置或速度控制器跟踪目标,策略本身没有解析动力学稳定性保证。
四、分开网络变体、任务与实际执行时域
原图怎么读: 图5,原论文图注与图像。纵轴是相对每任务最佳表现的成功率差值;左侧改动作执行时域,右侧改延迟。读零点和负差值,不要误当绝对成功率。
| 项目 | 原文设置 |
|---|---|
| 仿真数据 | robomimic PH每任务200条、MH300条;Push-T200条;BlockPush1000条脚本示范 |
| 任务范围 | 抓取、装配、双臂搬运、推物和Kitchen多阶段任务 |
| 训练预算 | 状态策略4500 epochs,图像策略3000 epochs |
| 重复 | 3训练种子;通常50初始状态,robomimic脚注明确因评估代码问题实际22个 |
| 结果格式 | 最佳检查点/最后10个检查点平均;每50 epochs保存 |
| 控制接口 | 各方法使用其表现较好的动作空间,扩散多为位置、基线多为速度 |
| 真实Push-T | 136示范;各方法固定训练12小时,20个匹配初始状态 |
| 推理加速 | 正文DDIM例子训练100噪声级、推理10次约0.1秒/RTX3080;附录真实配置列16次 |
| 真实控制 | 策略命令10 Hz;UR5低层125 Hz插值,Franka使用约1 kHz中层控制 |
| 其他真实任务 | 翻杯、倒酱汁、涂抹;v5另增双臂打蛋器、展开垫子和叠衣 |
这篇阅读采用2024年v5扩展版,双臂章节不能全算作2023年首次公开内容。训练epoch也不是固定梯度步数,数据集大小和批量不同会改变总计算。
版本内还有两处数据数量口径值得保留:Kitchen正文说566条,表3为656;酱汁任务附录C.2说50条、90%训练,表3为90条。本文不擅自选一个作为所有实验唯一数据量。准确复现需对应原始数据版本和运行配置。
多数仿真指标是成功率,但Push-T用目标区域覆盖;真实Push-T另设最终IoU阈值和移到结束区的要求。仿真最佳中途覆盖不能和真实最终IoU直接等同。
五组关键结果
表2:视觉操作的显著改善。 Transport-PH最后10检查点均值,CNN扩散0.93对LSTM-GMM0.62,提高31个百分点;ToolHang为0.73对0.49,提高24个百分点。该比较支持稳定的视觉模仿效果,但动作空间、架构和训练选择共同改变,不能单独归因于“用了扩散”四个字。
表4:架构选择仍然重要。 BlockPush完成两个目标的频率,Transformer扩散0.94、BET0.71,而CNN扩散只有0.11。Kitchen完成四项的频率则CNN0.99、Transformer0.96、BET0.44。因此并不是任意扩散网络都稳定胜过任意基线;时间卷积对快速变化的动作有局限。
附录B.2:46.9%怎么计算。 作者对各纳入任务选最优基线和最优扩散版本,计算再取平均,并排除MH结果。这是平均相对改善,不是46.9个百分点,也不是一套固定CNN模型的全任务提升。汇总口径应连同数字一起保留。
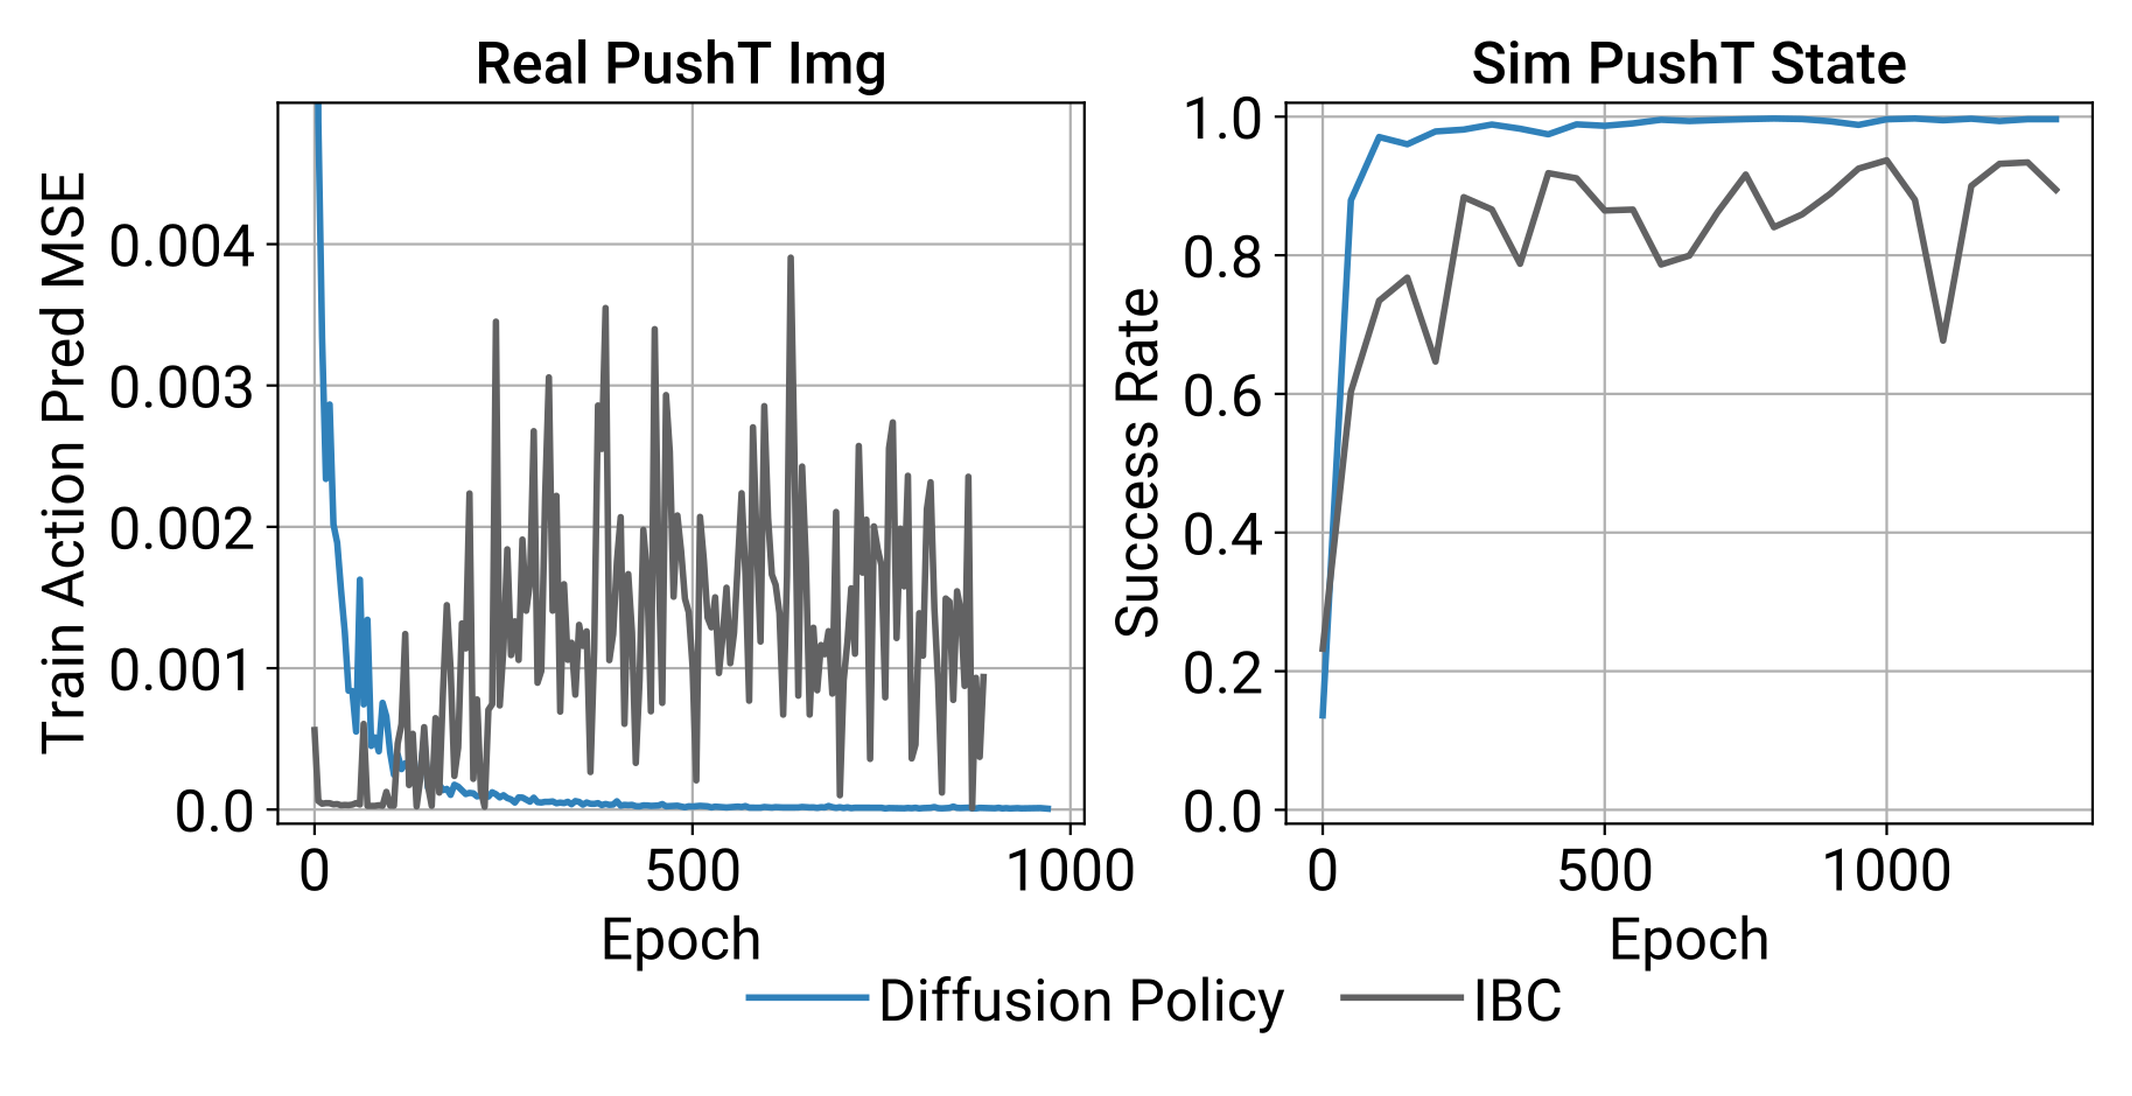
表6:真实Push-T。 最佳CNN端到端版本20次中成功95%,最终IoU0.80、平均时长22.9秒;专家IoU0.84、时长20.3秒。LSTM-GMM最佳成功20%,IBC为0%。所有方法训练12小时,但IBC按训练集动作误差选择检查点,其余使用最后检查点;原始停顿数据保留,作者指出这使单步基线容易卡住。成绩说明该任务上的优势,不是脱离数据处理条件的普遍排名。
图5、图8与§7:闭环优点和真实边界。 执行段太长会降低反应能力;图8的手遮挡、挪动T块属于单独扰动展示,不是表6全部20次都带这些扰动。扩展版双臂任务:打蛋器210示范、20次成功55%;垫子162示范、成功75%;叠衣284示范、成功75%。这些比单臂95%更能体现复杂接触与恢复的难度,不能用最好任务代表整套能力。
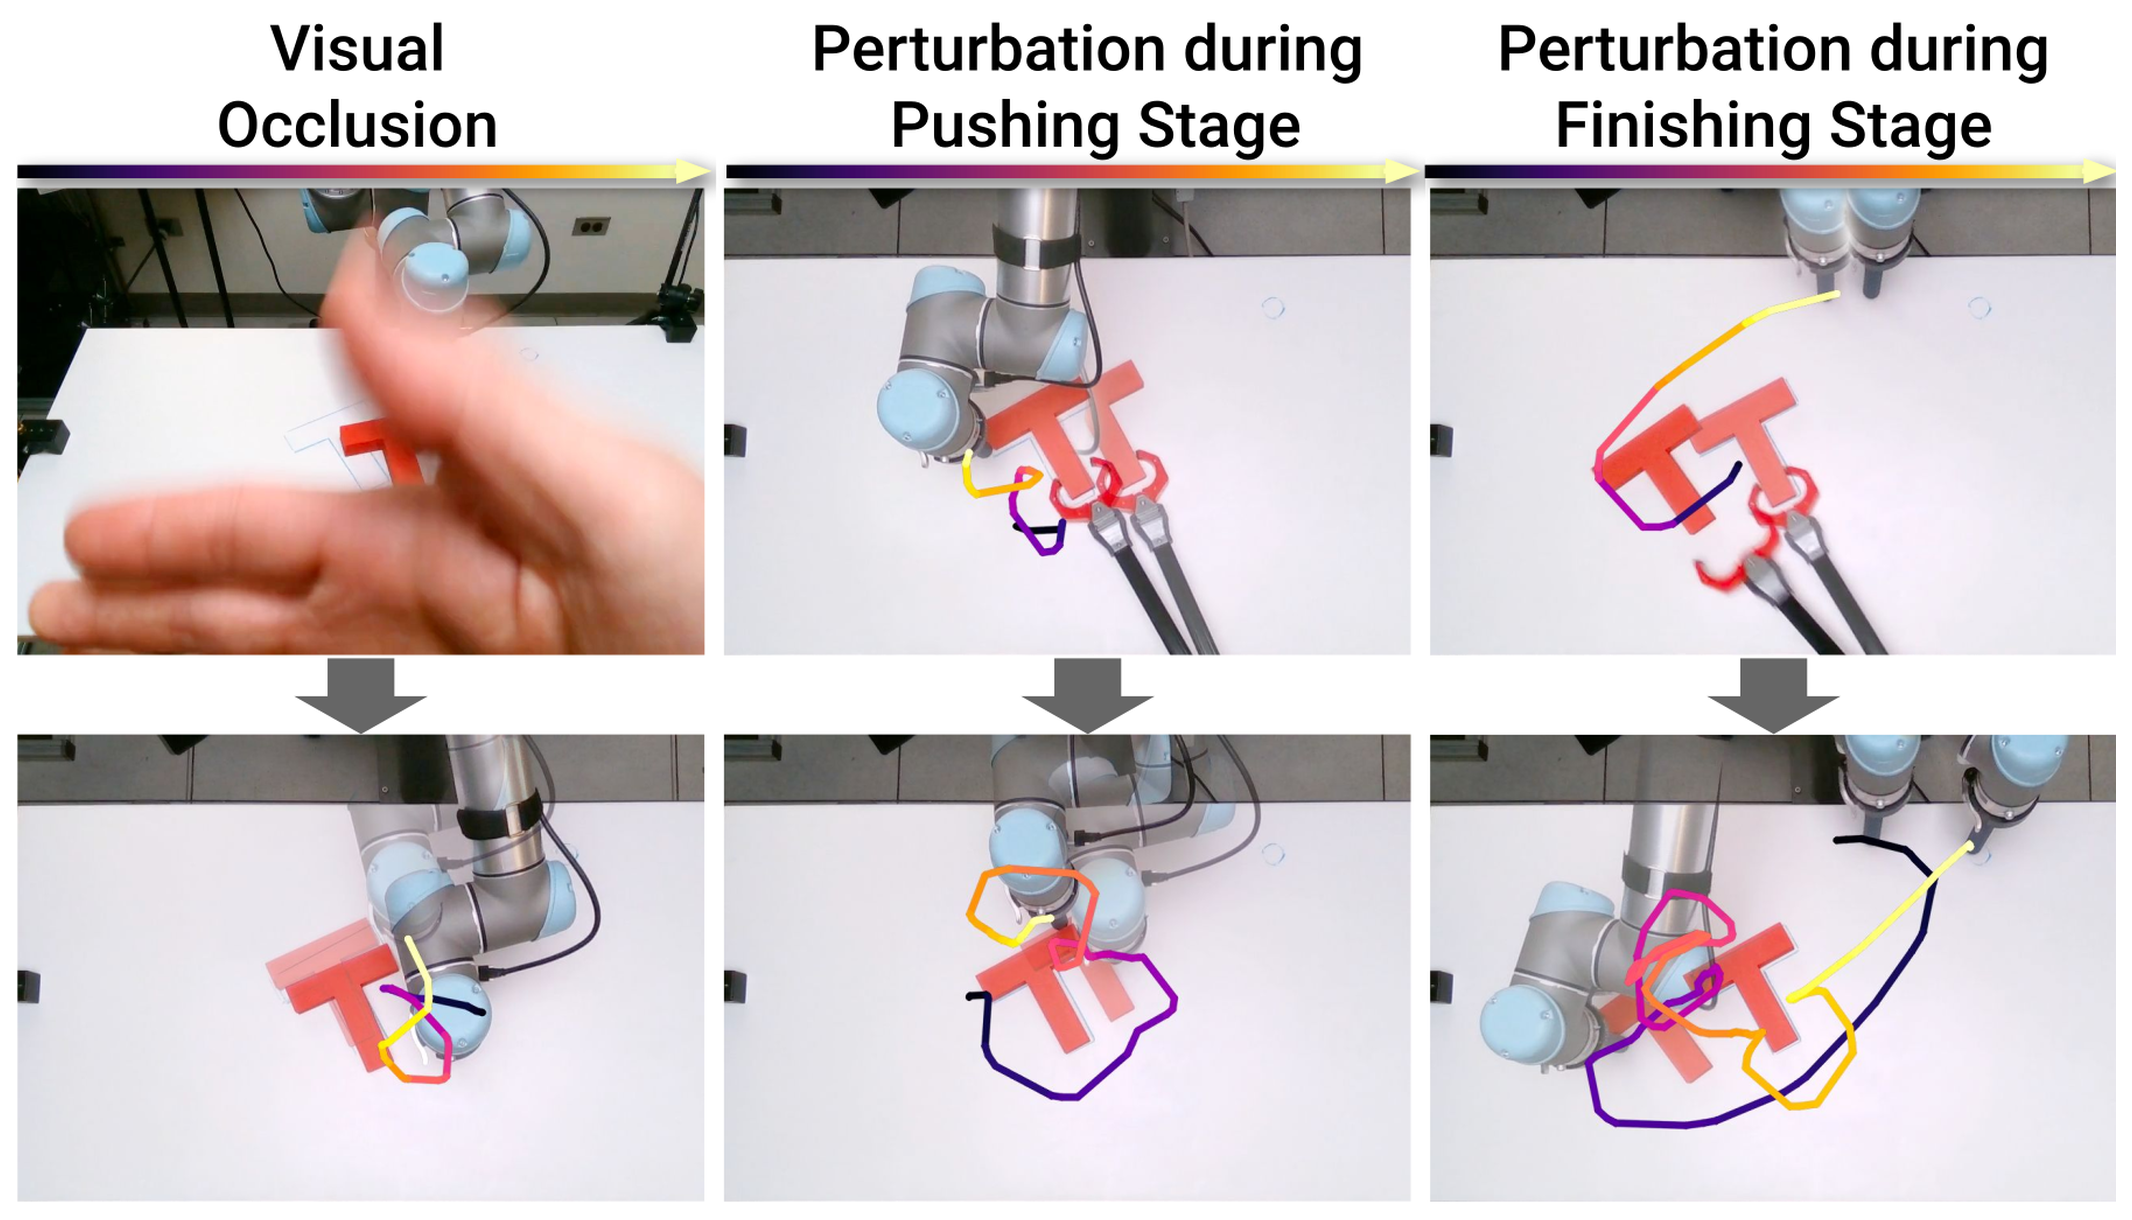
上述依据见扩展版正文及附录。本文未独立复现。机器人重复试验也不等于独立训练种子,表格稳定性应按各自来源解释。
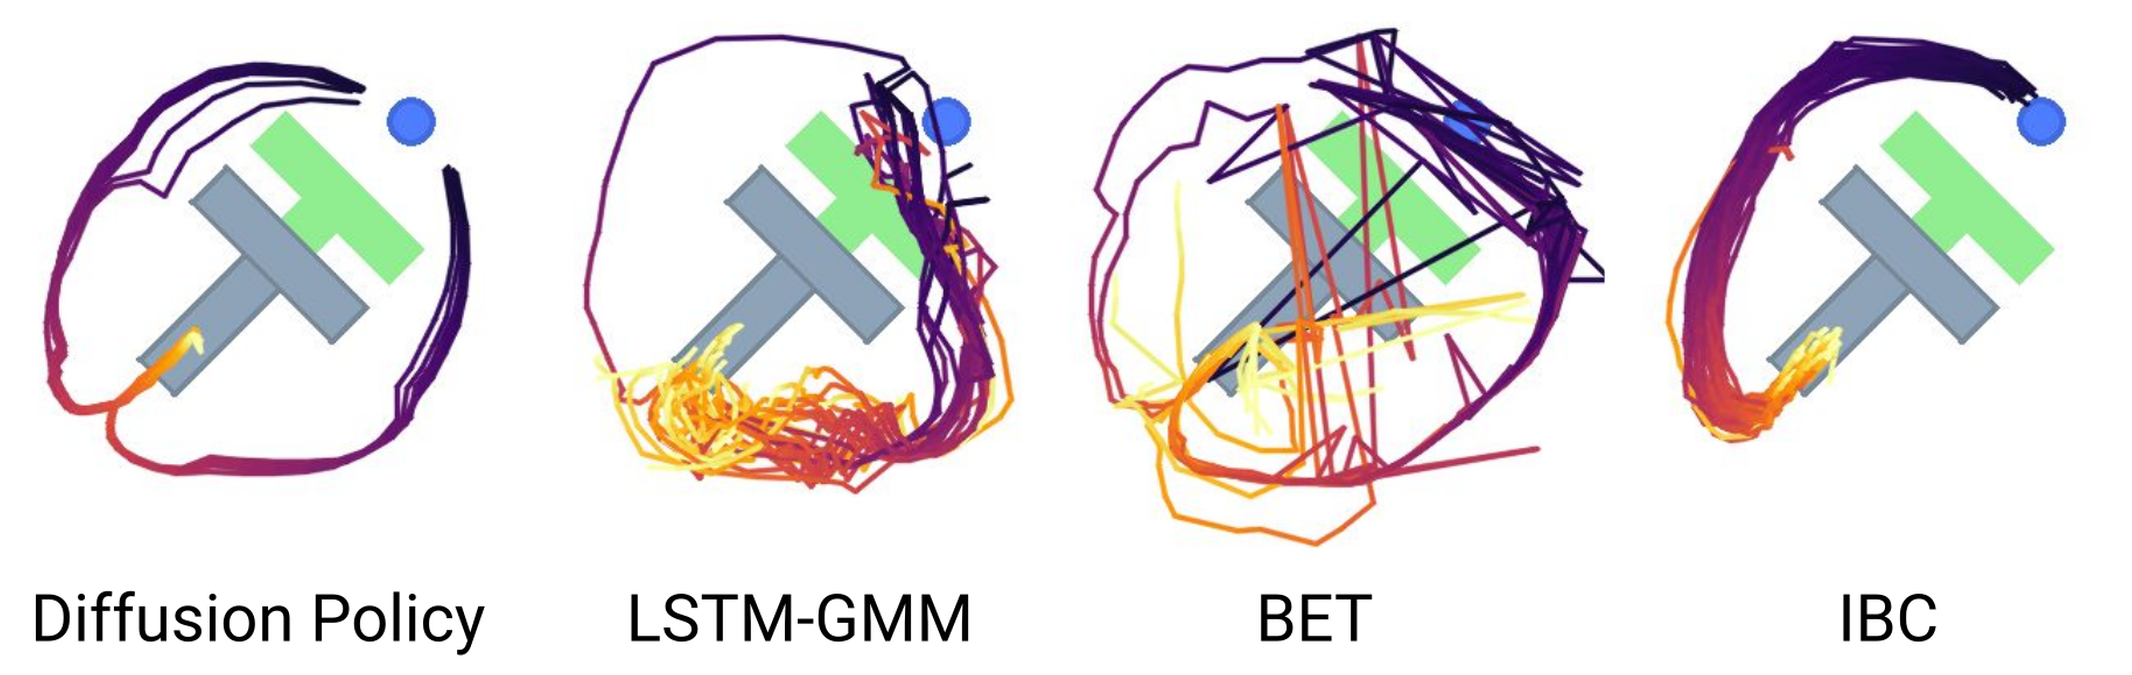
五、动作块长度交换一致性与反馈速度
相较IBC,不用负动作样本估计配分函数,训练更直接;但采样仍需多次网络计算。DDIM可减少次数,却存在速度与精度取舍。正文10次推理例子与附录16次配置应分开看,不应作为一个统一延迟保证。
理论讨论只在简单线性系统和线性专家下给出理想去噪器的合理极限,不代表真实非线性接触控制已获得全局稳定性证明。高表达能力也不会自动补齐示范未覆盖的失败状态;双臂垫子实验仍会因漏抓而重复错误动作。
硬件中的安全与可执行性部分来自中层控制器:Franka约束关节范围、末端工作区和碰撞,UR5限制位置与速度。打蛋器高质量示范还依赖触觉遥操作。不能把整个系统的机械安全和示范质量全部归因于扩散网络。
追问:只增加预测时域而保持执行长度不变,会怎样影响比较?
参考答案:它增加模型需要组织的未来动作,但不直接减少重新观察的频率;执行长度才决定一次承诺多少步。应固定观察窗口、执行长度和采样预算,单独改变预测长度,检查动作一致性与推理延迟。否则把三种时域一起改变,就无法将收益归因于更长计划。
六、沿机制关系继续读
与IBC是平行多模态表示,Diffusion Policy用去噪替代候选能量排序;与ACT共享动作分块这一模块,但动作分布参数化不同。后续DP3直接承接扩散动作框架并更换空间观测表示。
七、自测三题与参考答案
问题1:训练用了MSE,为什么没有必然回到“平均动作”的问题?
答案:MSE监督的是含噪动作在指定噪声等级下应去掉的噪声,模型输入还包含随机动作样本。最终动作由多步采样获得,不是仅根据观测直接输出一个条件均值。
问题2:观察窗口、预测长度和执行长度分别控制什么?
答案:控制看多少历史,控制联合生成多长的动作,控制多久重新获得反馈。增大预测长度不必同样增大执行长度;二者分开才能兼顾轨迹一致性与纠错。
问题3:46.9%的平均改善能否说明一个固定CNN模型在所有任务都获益?
答案:不能。它按任务选择最优扩散版本,再计算相对改善平均;BlockPush的CNN明显弱于Transformer。理解算法路线优势后,仍要为具体动作频率、网络和控制接口做选择。