050|R3M:人类视频中的机器人视觉表征
原论文:R3M: A Universal Visual Representation for Robot Manipulation,Suraj Nair 等,2022。论文。
先接住前作的问题
CLIPort把通用语义与空间动作结构组合,但少示范操作也需要能分辨过程变化的视觉表示。R3M用人类活动视频训练图像编码器,再冻结它学习机器人动作;迁移的是视觉信息,不是人类电机命令。
五个前置概念
五个前置概念:表征学习把图像压成有用特征;对比学习利用正负样本组织特征空间;冻结网络保留参数只前向使用;行为克隆用示范动作监督控制;标准误差描述估计均值的不确定性,不等于单次任务结果的波动范围。
一、问题设定:少量机器人示范怎样借用人类视频表示
只给机器人二十次示范,却要求它同时学会“看懂杂乱桌面”和“怎样控制手臂”,往往太难。R3M把两个问题拆开:先用大量人类活动视频学习视觉表示,再冻结这套视觉网络,用少量机器人示范训练动作网络。
R3M研究视觉表征预训练与行为克隆。下游策略接收图像编码和本体感知,输出连续动作。训练动作网络时使用监督标签,没有价值函数、奖励优化或模型预测控制。模拟示范的一部分由RL专家生成,但这不使下游方法变成RL。
预训练阶段的输入是人类第一视角视频及相应文字描述;输出是单帧视觉编码器。下游阶段输入机器人相机和自身状态,动作标签来自该机器人示范。人和机器人身体不同的问题,被部分绕过:无需把人手关节逐一映射到机械臂关节,但视觉域差异仍真实存在。
论文的动机是,静态分类任务可能擅长识别“有杯子”,却不一定重视“杯子相对手的位置”“物体是否进入容器”。连续视频与操作描述能给这些关系更多学习信号。但这是合理归纳偏置,不是证明模型一定理解了物理因果。
任务覆盖模拟机械臂、厨房及灵巧手,真机使用Franka。状态与动作接口随环境而变,不能把全部任务都叫末端位姿控制。真机以RGB和末端位置提供观测,示范在笛卡尔末端空间遥操作;具体成功判据、控制频率和每类动作维度需要看对应环境实现,正文没有为所有任务给出一个统一定义。
终止和成功在此用于评测,而不是构成训练奖励。因而评估重点是示范覆盖、视觉迁移、动作误差与闭环执行的关系。
二、以时序、语言和正则共同预训练视觉编码
视频中的人没有提供机器人关节命令。它们教会的是哪些视觉变化可能与操作有关,而不是直接教机械臂怎么动。时间对比、视频语言对齐和特征正则化共同训练一个可重复使用的图像编码器。
真机五项任务中,原论文表3报告平均成功率56%,CLIP基线24%,每项任务各20条示范、各10次测试。这是少样本模仿学习的证据,不是无需机器人数据的零样本控制,也不是对强化学习收益的直接验证。
1. 时间对比让表示关注变化
从视频中取 的三帧。编码器为每张图得到 。训练倾向于让 与较近的 比与较远的 更相似,并把其他视频的帧当作负例。
教学式为:
这不是预测下一帧图像,也没有动作条件动力学。时间接近与语义接近只是视频数据中的统计假设;重复动作、停顿或镜头移动可能违背它。
2. 语言指导“什么变化有意义”
一个打分头 接收起始图像、后续图像和文字,判断这一状态变化是否符合描述。训练让较晚、正确配对的片段得分高于较早片段,以及其他视频的不匹配变化。
例如“把苹果放进盘子”,理想表示要关注苹果与盘子的相对状态,而不是衣服颜色。文字在这里是预训练监督,不是部署时每一步必需的指令输入。最终冻结编码器并训练单任务动作头时,可以完全不使用语言打分头。
同样,“越晚越接近完成”的信号依赖片段质量。人可能拿起苹果又放回原处,或者在视频尾部撤销操作。不能把该打分头未经检验就当作可靠的机器人奖励函数。
3. 特征约束与下游训练
总预训练损失组合时间对比、语言对比及特征范数:
注意原文写的是L2范数,不应在解释时无声替换为平方L2。正则施加在表示上,目的是鼓励稀疏、紧凑的特征;它不是简单等同于对全部网络权重做weight decay,也没有直接把向量维数缩小。
下游将 与本体感知 拼接:
动作网络是带输入BatchNorm的两层MLP。冻结视觉网络减少低数据过拟合和反向传播成本,但也会阻止它修复当前任务中缺失的视觉细节。
同一视频一致裁剪很关键:若每帧随机裁不同区域,时间目标可能主要在学习裁剪差异,而非真实状态变化。预训练损失的改善、稀疏机制和最终成功率是三个不同层次,须通过下游实验连接。
冻结表示有一个不可逆的信息瓶颈:若两张观测 被编码成相同 ,而正确动作相反,任何仅接收该特征的确定性动作头都无法同时做对。增加动作头宽度也不能找回被编码器丢掉的接触细节。这里 是冻结视觉编码器,是结构推论而非R3M具体失败率。
教学例:夹爪与杯沿相差1毫米的两帧在语义上都像“拿杯子”,但一帧应下压、一帧应后退。人类视频预训练可能提供语义,也需要下游实验检验精度。原文去稀疏约束的效果在不同环境不一致,因此范数更小与控制更好不能画等号。原文表1消融
一个具体例子
自构例子,未运行。 给机械臂20次把杯子推向目标的示范。随机初始化视觉网络可能只记住训练图像中的桌布纹理;一个只做物体分类的特征可能知道杯子存在,却不能精细区分它离目标多远。R3M试图提供更适合描述交互状态的特征,动作头因此用较少样本学习映射。不过,如果编码器已把两种关键位置压成几乎相同的向量,任何小动作头都难以恢复丢失的信息。
进一步值得问:固定人类视频数量,仅打乱时间顺序会损失多少;同样预算下冻结与微调何时交换优势;在视觉相同而运动速度不同的任务中增加历史帧是否更关键。这些问题分别检验时序、适应能力和可观测性。
三、冻结视频视觉编码器并另训任务动作头
人类视频只提供表征监督,机器人示范才给出动作映射。下游冻结编码器使两类数据作用清楚,也让任务关键细节是否被保留成为一个可检验限制。
预训练:
    采样若干人类视频片段及描述
    每段取初始、最终和按时间排列的中间帧
    对同一视频中的所有帧采用一致随机裁剪
    编码图像,计算近时间正例与远时间/跨视频负例损失
    计算状态变化与语言的对齐损失
    加入特征 L1、L2 范数约束,更新视觉网络与打分头

新机器人任务:
    收集带动作的少量机器人示范
    冻结预训练视觉编码器
    将图像特征与机器人本体状态拼接
    用动作均方误差训练任务策略

执行:
    读取当前图像和本体状态
    前向通过视觉编码器与任务策略,执行动作
    再读取观测,直到评测规定的结束条件
四、把外部预训和下游示范测试分别计账
五项真机任务的均值来自每项少量测试,并另有大规模外部预训练。比较CLIP或从零训练时,不能只报下游二十条示范而隐去预训练成本。
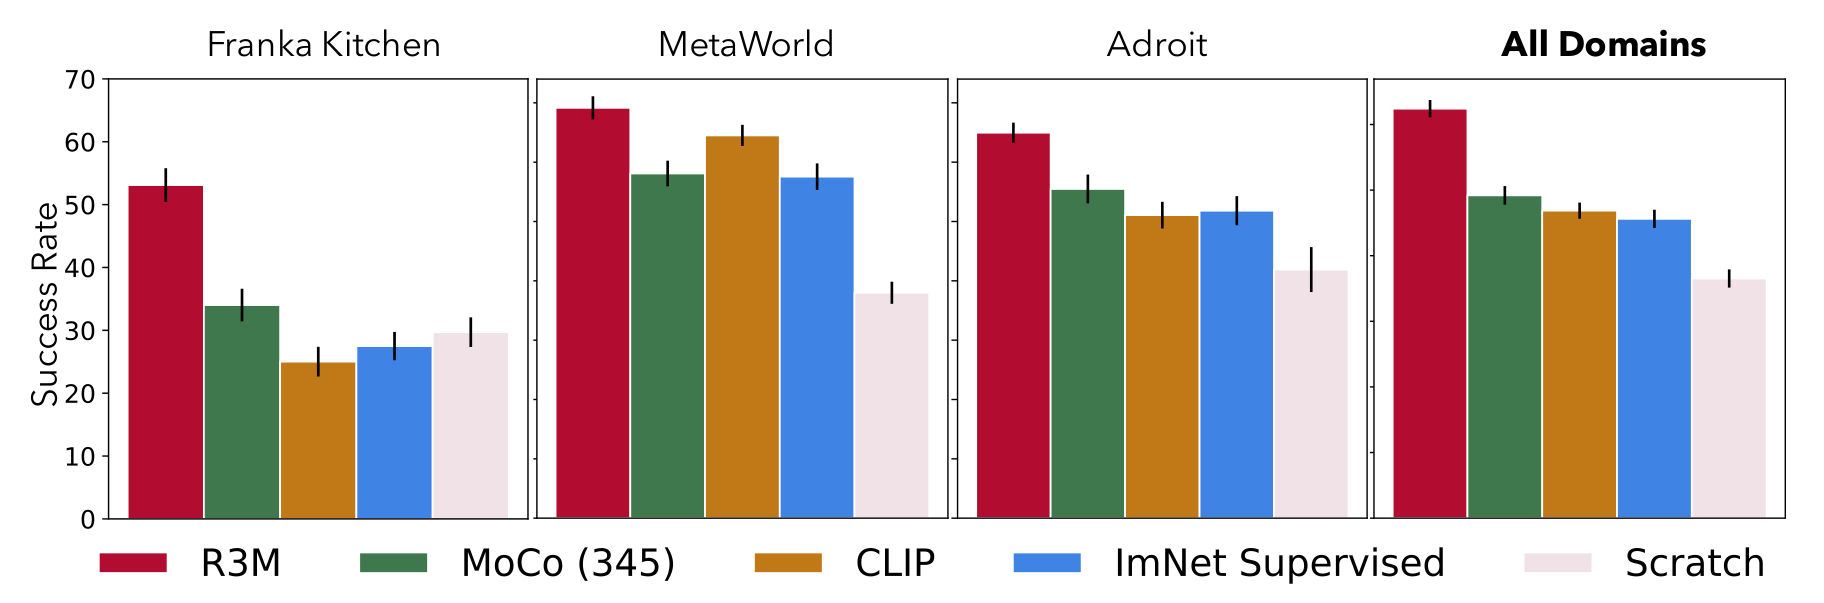
原图怎么读: 图4,原论文图注与图像。误差条按图注是标准误,指标来自下游模仿学习的成功率。它检验表征在新环境/任务上的使用效果,而非预训练视频重建质量。
预训练视频规模、实际采样帧量和总计算成本是不同口径;未确认总帧数时,不能由更新步数直接推算数据效率。
| 项目 | 设置与待区分口径 |
|---|---|
| 人类数据来源 | Ego4D,论文介绍完整数据集超过3500小时;实际使用片段/帧的完整数量未逐项核实 |
| 预训练批次 | 每批16段视频,每段取5帧;主要实验训练100万步,公开模型150万步 |
| 网络 | 主要使用ResNet50;语言采用DistilBERT表示;也发布较小ResNet编码器 |
| 下游模拟任务 | MetaWorld5项、Franka Kitchen5项、Adroit2项 |
| 示范量 | 前两组5/10/25条;Adroit25/50/100条 |
| 示范来源 | Kitchen与Adroit由状态RL专家产生,MetaWorld由状态启发式策略产生,再渲染图像 |
| 下游优化 | 2万次更新、batch32、学习率0.001;每1000次评测一次,报告最佳检查点成功率 |
| 重复 | 每设置3个BC种子,跨视角和示范量汇总;图4使用标准误差 |
| 真机 | 五项任务,每项20条示范,PlayStation手柄遥操作,每项10次试验 |
| 基线 | CLIP、ImageNet监督、MoCo、多层MoCo特征、从头训练;另有同数据MoCo-Ego4D与MVP对照 |
模拟中的不同视角是各设置分别训练评估后汇总,不应直接写成“策略训练时从一个视角,测试时突然换任意视角”。相关结果证明方法在多种视角配置下都有效,和未见相机位姿泛化是不同问题。
“未见目标环境”指视觉编码器预训练没有使用这些机器人环境;动作头确实使用目标任务示范。真实实验更不是模拟策略直接迁移,它训练于真实遥操作数据。
下游比较统一动作头和使用方式有助于隔离表征效果,但外部数据、预训练方法与算力仍不同。表2中的同帧同计算MoCo对照,比单纯与ImageNet模型比较更能区分“数据好”还是“目标函数好”。公开权重又比实验权重多训练50万步,复现实验时应记录这一差别。
结果:五组证据
图4与图9:整体和逐任务。 作者报告跨设置平均约62%的成功率,在12项任务中的11项上领先所选基线。这里的总体值包含视角、示范数量与随机种子的平均,不是某一个机器人连续运行的成功率,也不是每项任务都超过62%。
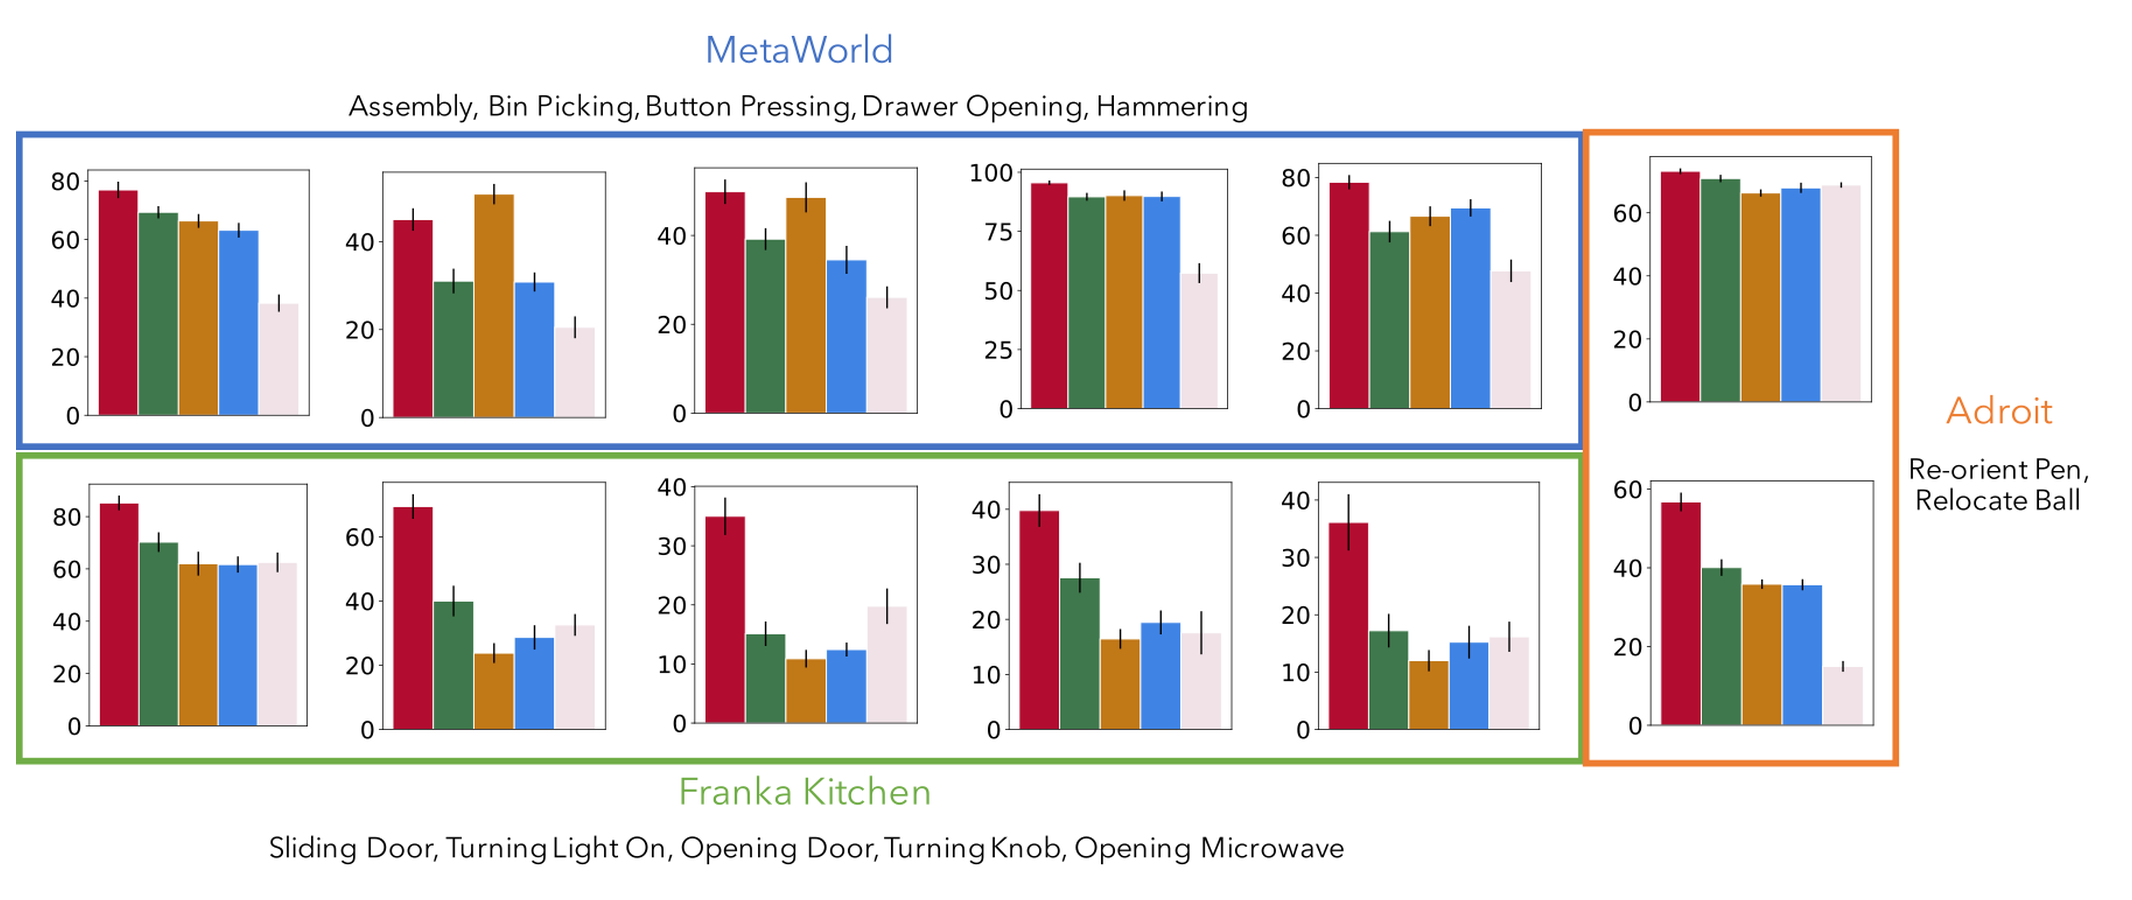
表1:语言监督贡献最明显。 全部领域平均从完整模型62.4%降到去语言的53.2%,绝对下降9.2个百分点;相对于完整模型,下降约 。两种写法分母不同。它支持语言对齐在该设置有帮助,并不证明语言语义是唯一原因。
表1:稀疏项不是各处都必需。 去掉L1后整体59.4%,低于62.4%;但Adroit反而从65.0%升到66.5%。作者推测较多示范可能降低了正则必要性,这是解释而非完整因果验证。不能把摘要中的整体贡献夸成每个模块在每项任务都不可缺。
表2:同数据对照。 Kitchen中R3M53.1%,MoCo-Ego4D42.0%,相差11.1个百分点;Adroit为65.0%与54.9%,相差10.1个百分点。这一比较比跨数据基线更接近检验训练目标的作用,但仍是整体训练目标包的差异,不能分解每个信号的独立效应。
表3:真实任务。 R3M关抽屉80%、放口罩30%、放生菜60%、推杯70%、叠毛巾40%;CLIP分别70%、10%、0%、40%、0%。平均56%比24%高32个百分点,相对增加约133.3%,比值约2.33。正文用“近两倍”的概述不如直接报告表格精确。每任务仅10次,0%表示这10次没成功,不表示真实成功概率严格为零。
最佳检查点选择使用环境评测反馈,会乐观于固定最终检查点或独立验证集选择。所有方法共享规则有比较价值,但它仍是一种额外评测预算,不能忽略。
五、冻结表征仍可能遗漏任务关键接触信息
作者明确承认评估限于少样本行为克隆,并没有验证强化学习中的等价收益。原因不难理解:BC只需拟合示范访问的状态,而RL会主动探索并改变数据分布,视觉表示遗漏的细节可能在新状态中变得关键。
单帧编码也无法单独区分外观相同但速度不同的物体、被遮挡的接触状态或过去已经执行的步骤。所谓“通用”是目标与经验支持的可复用范围,不是所有机器人操作均已验证。
追问:视觉表示在相似帧上稳定,为什么也可能不利于精细插入?
参考答案:过强的不变性可能把微小但决定接触成败的位置差异压在一起。应在固定动作头和示范预算下,测关键阶段的表示可分性与实际成功,而不只测整体视觉迁移分数。预训练希望忽略无关外观,但哪些变化无关仍由下游任务决定,这也是冻结编码器需要单独验证的边界。
六、沿机制关系继续读
与CLIPort是平行预训练利用路线:R3M专门学习机器人可迁移表示,CLIPort组合通用语义与几何结构;后续GR-1进一步将视频与动作预测结合,不能把视觉表征预训练等同于动作策略预训练。
七、自测三题与参考答案
问题1:视频没有机器人动作标签,为什么能帮助控制?
它帮助学习感知表示,不直接训练机器人动作。下游动作示范仍然告诉策略怎样把视觉状态映射为控制命令。迁移成功依赖人类视频中学到的视觉因素与机器人任务相关。
问题2:去掉语言目标之后性能下降,是否说明部署时必须给语言?
不说明。语言是预训练视觉网络的监督信号,可以影响最终图像特征;部署的单任务策略只需图像编码和本体状态。把训练监督与推理输入分清,才能避免误把R3M当作完整语言动作模型。
问题3:公开模型在某任务上复现出更高结果,能否直接声称推翻论文表格?
不能。公开模型训练150万步,原实验为100万步,而且还要对齐示范抽样、视角、BC种子和最佳检查点选择。更高结果可能来自额外预训练或评估差异;只有控制这些条件后,才适合讨论原结论是否稳定。