052|Gato:把多模态决策统一为序列预测
原论文:A Generalist Agent,Scott Reed 等,2022。论文。
先接住前作的问题
一次示范模仿提供一个阅读起点。One-shot模仿在相关任务间共享读取示范的能力,但身体接口和模态仍受任务族限制。Gato把更多观测与输出变成序列,追问一套权重是否容纳这些不同接口;共享存在不等于跨域数据已经帮助每项任务。
五个前置概念
五个前置概念:序列化规定多模态数据的排列;量化将连续值变为有限档;因果注意力只读取已出现内容;损失掩码指定哪些位置需要预测;负迁移指其他任务经验降低当前任务学习表现。
一、问题设定:多种模态与身体接口怎样共用一套权重
一套权重能否既生成文字,又玩游戏,还控制真实机械臂?Gato把这些任务都改写成序列预测:把观测变成输入token,把文字或动作变成要预测的token,用一个Transformer学习。
Gato的训练是离线监督学习。控制数据主要来自已有专家,许多专家通过RL训练,但Gato自身没有在主训练中用TD价值或策略梯度改善回报。它更像把多个专家行为蒸馏进一个通用序列模型。
一个重要区别是“同一组权重能做许多已学任务”与“遇到任意新任务就会做”。前者需要避免任务间干扰;后者还需要迁移、适应或新学习。论文分别展示预训练模型、少样本微调和专门模型,不应把三者最好的分数拼成一个万能模型的成绩单。
在机器人RGB Stacking中,Sawyer需要把红块叠到蓝块上,忽略绿块。观测包括两台128×128相机、机器人关节及末端状态,不包含物体真值位姿。回合400步、名义20 Hz,总20秒。动作是该平台定义的连续控制分量和夹爪离散命令;每个控制域仍需外部接口规定动作长度及解码方式。
奖励主要用于筛选较好控制轨迹与评测。主体损失预测记录中的动作,不显式比较“未执行动作是否更好”。这意味着数据质量上限与覆盖仍很关键。
二、统一序列表示并只对规定输出计算损失
它证明的重点是多种模态与身体接口可以共存于单一网络,而不是一个模型已经掌握任意新任务。机器人实验中,它在未用于堆叠训练的五组物体形状上取得50.2%成功率,与专门BC基线49%相近。单模型承担更多任务的同时维持有竞争力的操作能力,是比“全面战胜专家”更准确的结论。
1. 数据如何进入模型
文字使用子词词表;图像分为16×16图块,再通过小型视觉嵌入模块;连续数值先按适当变换缩放,再离散成1024档;离散动作编码为整数。一个交互步按“观测、分隔符、动作”排序,多个交互步再按时间连接。
连续动作量化的直觉很简单:把实数选择变为类别预测。若一个动作范围为 ,等宽1024档的宽度约为 。模型需要学习各档概率,再由接口映射回实数。实际不同数值还涉及缩放及mu-law处理,不能只拿这个教学间隔代替全部实现。
输入嵌入依模态而异,位置编码也保留图像内位置及交互步内位置。“统一”主要在共享序列主干和输出学习方式,不意味着图像像素和动作数值使用完全相同的前处理。
2. 损失只落在目标输出上
令序列为 ,目标掩码为 :
文字和动作位置的掩码为1;图像与非文字观测位置不作为预测目标。这点非常关键:Gato读图像,但主训练不生成下一帧图像,所以它并不是一个显式预测环境未来的世界模型。
对于多维动作,普通部署方式逐个预测动作token。因果条件允许后一维依赖前面已经选出的维度,从而表达动作分量相关性。但这个优点也带来串行推理时延。
3. 上下文与示范提示
有些任务观测和动作接口相同,仅凭图像难以确定目标。训练时25%的序列会加入同任务示范片段作为提示。测试控制任务默认可用成功示范提示。它不是额外提供任务ID,但仍是额外任务信息;“不使用one-hot任务ID”不能写成“没有任何目标提示”。
受1024token上下文限制,一段含图像的控制历史往往很短。论文对真正未见任务主要使用参数微调,而不是证明仅靠长示范提示就能学会。
4. 真机有专门的时延处理
附录G说明,真实堆叠部署缩短历史上下文,并采用一次推理并行预测动作token的方案,训练输入中对应动作token置零。它牺牲了常规自回归动作维间条件,以减少延迟。文中的“context length to 1”应结合交互序列实现理解,不能解释为整张图像只剩一个token。
方法改变的是多任务表示与监督组织;优化目标是记录token的似然;指标是各任务的回报或成功率。主模型没有额外训练一个通用价值函数来纠正示范。
统一token损失也会隐含任务权重。若任务A每次动作7个token、任务B每次动作20个token,按所有目标token直接求和时,同样一条控制转移并不贡献同样损失权重。再叠加文本长度、图像占用上下文及数据混合比例,“共享模型”并未自动实现任务等权。这里是从掩码交叉熵推导出的检查项。
教学例:两个任务各抽100步,B提供2000个动作目标、A仅700个;如果要按物理决策等权,需明确归一化或采样设计。原文不预测图像与非文本观测,因此大量视觉输入token又会消耗计算而不直接增加输出监督。评估应逐领域看回报,不能用一个总token损失代替多任务能力。原文§2.1—2.3
手算例子与前置概念
自构例子,未运行。 一个二维动作“向右0.3、向上0.1”被编码为两个离散档位。常规自回归模型先选水平档,再根据它选垂直档,因此可以表达“右移多时少向上”的相关性。并行预测时两维同时决定,速度更快,但需要模型用共同观测隐含协调它们。这个变化会影响控制分布,不能只当成无损加速。
三个后续实验可以分别固定总计算改变数据混合比例、固定模型比较并行与串行动作误差、在未见身体上测试同token接口是否仍有效。它们对应共享效率、实时性和跨身体语义。
三、按模态编码序列并遮蔽非预测位置的损失
共同Transformer接收不同token,但并非要求生成所有输入。训练要保留各模态编码和输出掩码,机器人连续动作的量化也仍是一项接口选择。
训练:
    按指定混合权重选择一个数据域
    将文字、图像块、数值观测和动作序列化
    部分样本加入同任务示范提示
    截取固定长度上下文
    经共享Transformer输出下一token分布
    只在文字与动作目标上计算交叉熵
    更新共享模型及嵌入参数

通用控制部署:
    放入任务提示,追加当前观测token
    按环境规定的动作长度预测动作token
    反量化并交给该环境执行器
    追加新观测,在有限上下文内循环

真实堆叠部署:
    使用论文专门的短历史与动作并行预测配置
    记录模型时延,不能假设仿真会等待策略计算
四、区分共同容纳任务与跨任务正迁移
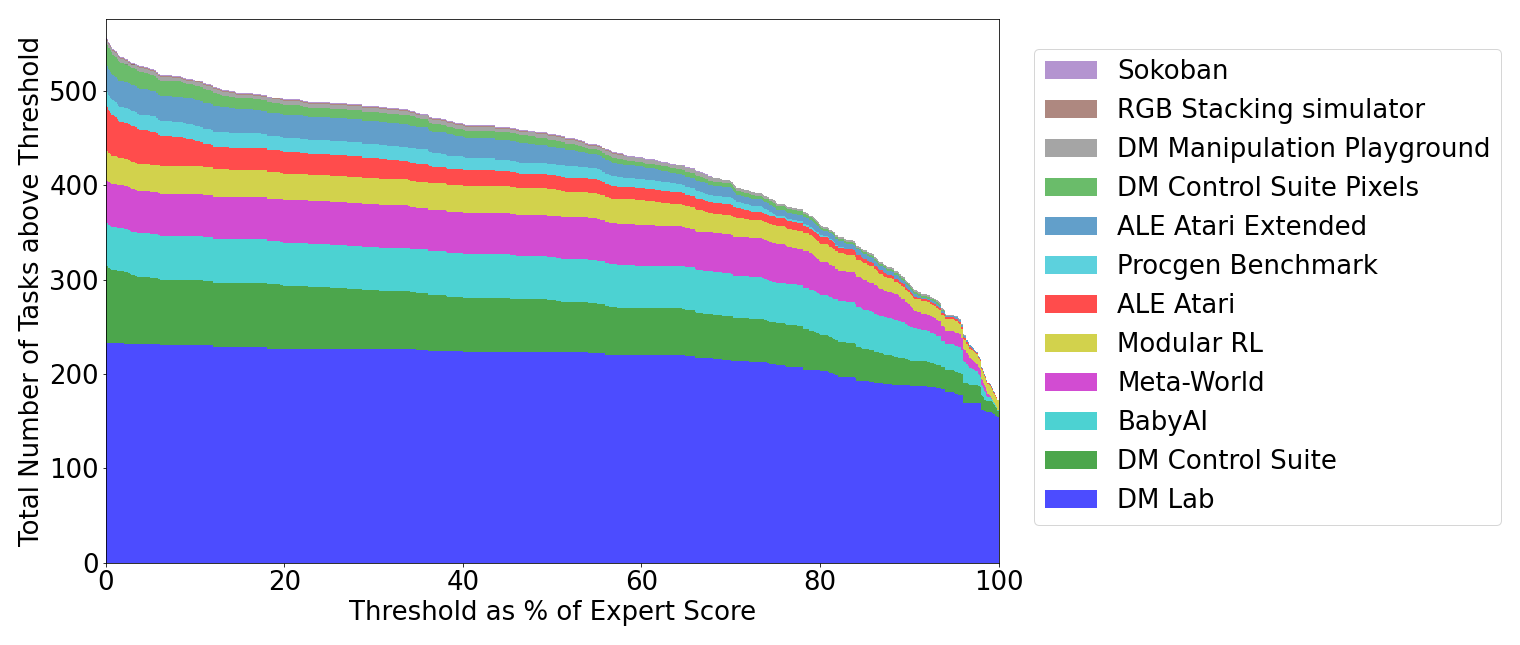
原图怎么读: 图5,原论文图注与图像。横轴是达到专家分数的比例阈值,纵轴是超过阈值的任务数。它是任务覆盖分布,既不是一条随训练时间增长的曲线,也不是统一成功率。
原文标注 CC BY 4.0。本页摘图仅保留图形区域并作栅格化;有面板重排的图另行注明,作者与原文入口见各图注。
| 项目 | 原文设置 |
|---|---|
| 主模型 | 约1.18B参数,常称1.2B;24层decoder-only Transformer |
| 主训练 | 16×16 TPUv3切片,100万更新,batch512,序列1024token,约4天 |
| 数据构成 | 多种模拟控制、真实堆叠、文字及视觉语言数据,按手工混合权重采样 |
| 控制数据规模 | 表1总约6300万回合、约1.5万亿可序列化token;不是模型实际完整遍历次数 |
| 机器人预训练 | 约38.7万模拟成功轨迹及约1.57万真实轨迹,测试物体形状不在该训练集合 |
| 主真机评测 | 五个测试物体三元组,每组200回合 |
| 模拟评测 | 每个任务50次;归一化参照随机策略与生成数据的专家 |
| 未见任务适应 | 四项保留任务做少量示范微调;相应消融使用364M模型 |
| 实时性 | RTX3090运行大模型,附录称仍比20Hz预算多约10毫秒 |
| 未完全核实 | 全专家数据采集的综合成本及主预训练独立随机重训次数 |
604是论文整体任务口径,表1控制任务合计596并另列语言视觉数据集。它不意味着604项都是独立真实机器人技能,也不意味着每项都达到专家水平。
监督训练使用已有专家数据,专家本身的RL交互成本很高。因此“4天训练一个会这么多任务的模型”只描述共享模型训练阶段,不包含创造专家和数据的全部过程。
名义20Hz给每步50毫秒;多约10毫秒意味着推理约60毫秒,约16.7次/秒,这是据文字做的粗略换算,不是完整闭环控制实测频率。机器人不会像同步仿真一样暂停等待模型。
五处结果与证据
图5:覆盖广度。 论文报告超过450项任务达到专家归一化分数的50%以上。这里50%不是任务成功概率,而是相对于随机和专家的回报位置。它支持广覆盖,不能证明专家级掌握,更不能把所有任务权重相同视为真实应用价值相同。
表2:真实形状泛化。 Gato五组成功率24.5%、33%、50.5%、76.5%、66.5%,平均50.2%;BC-IMP平均49%。平均差1.2个百分点,且Gato在第二、第四组更低。结论应是接近专门基线,而不是每组优越。
图9:未见任务有负迁移。 对保留的Boxing,作者没有观察到预训练优势,随机初始化反而更好;只用非控制数据预训练,在某些无视觉控制任务无益甚至有害。不同任务共用网络,不代表不同数据天然相互促进。
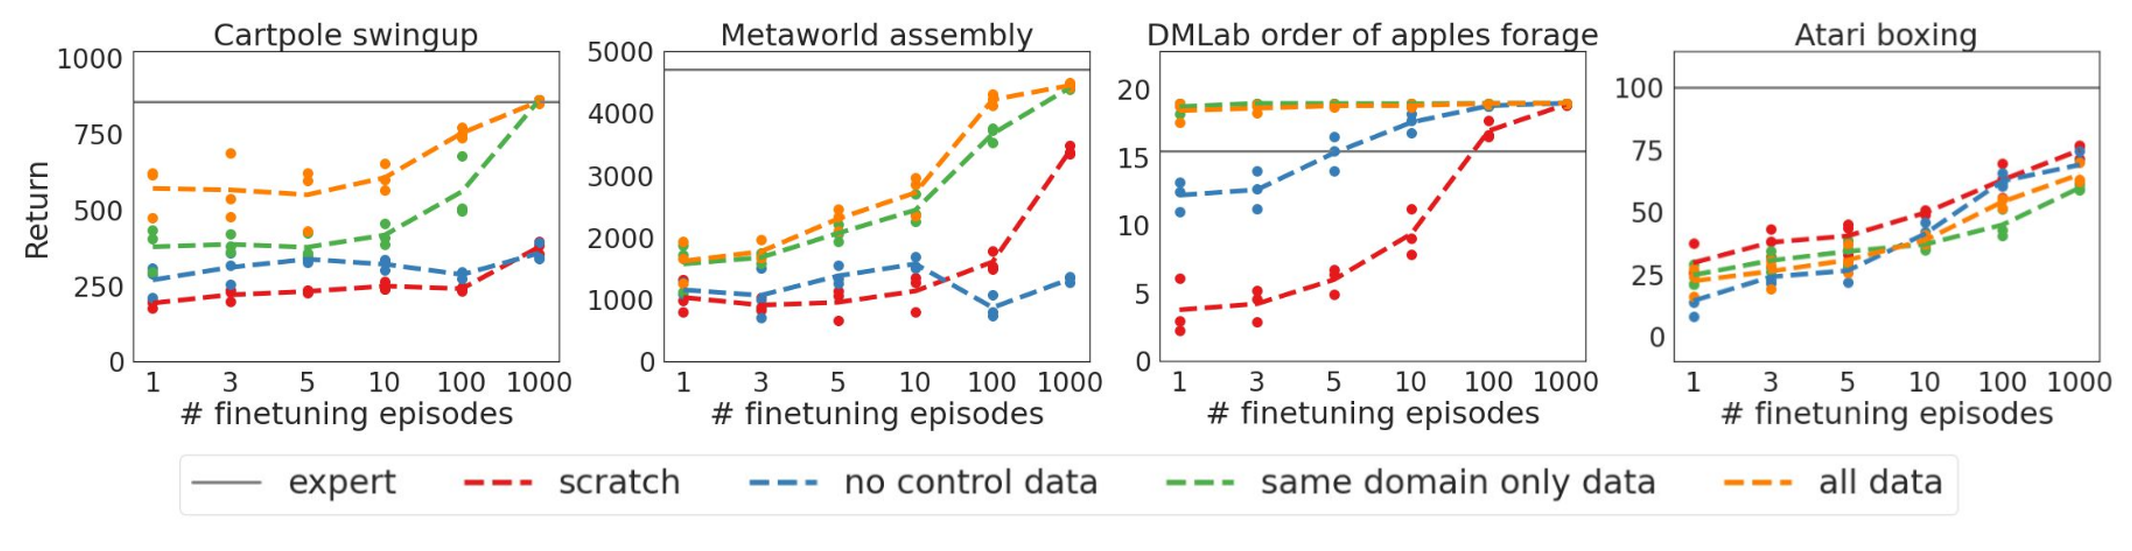
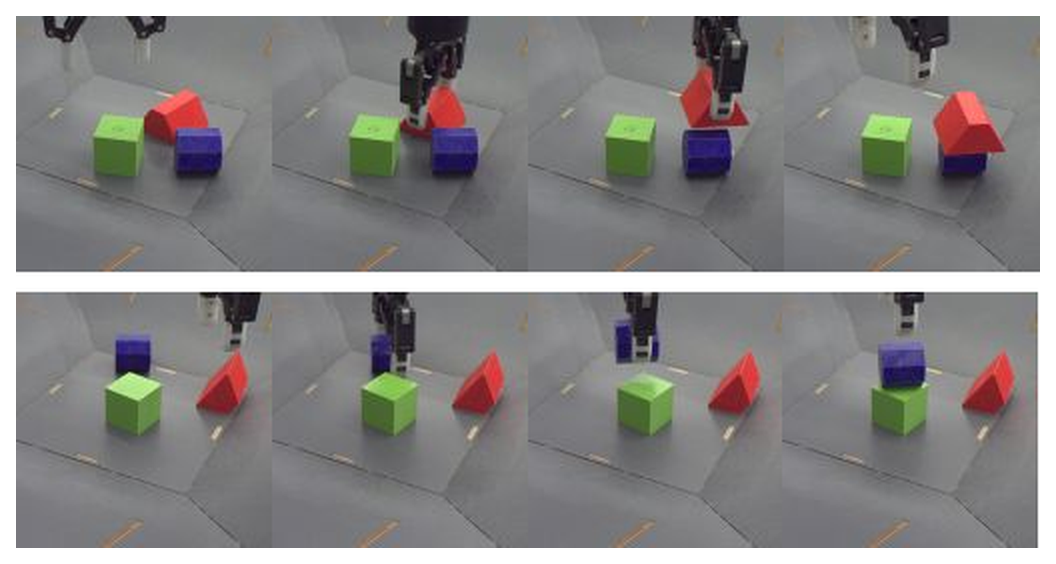
图10、图11:微调能改变任务能力,但要计入新数据。 改为“蓝叠绿”时,使用500条真实示范,约2小时45分钟,并加入模拟示范,最终真机成功60%;从头BC为0.5%。它支持预训练有助适应,却不是一句新语言指令立即完成颜色目标切换。
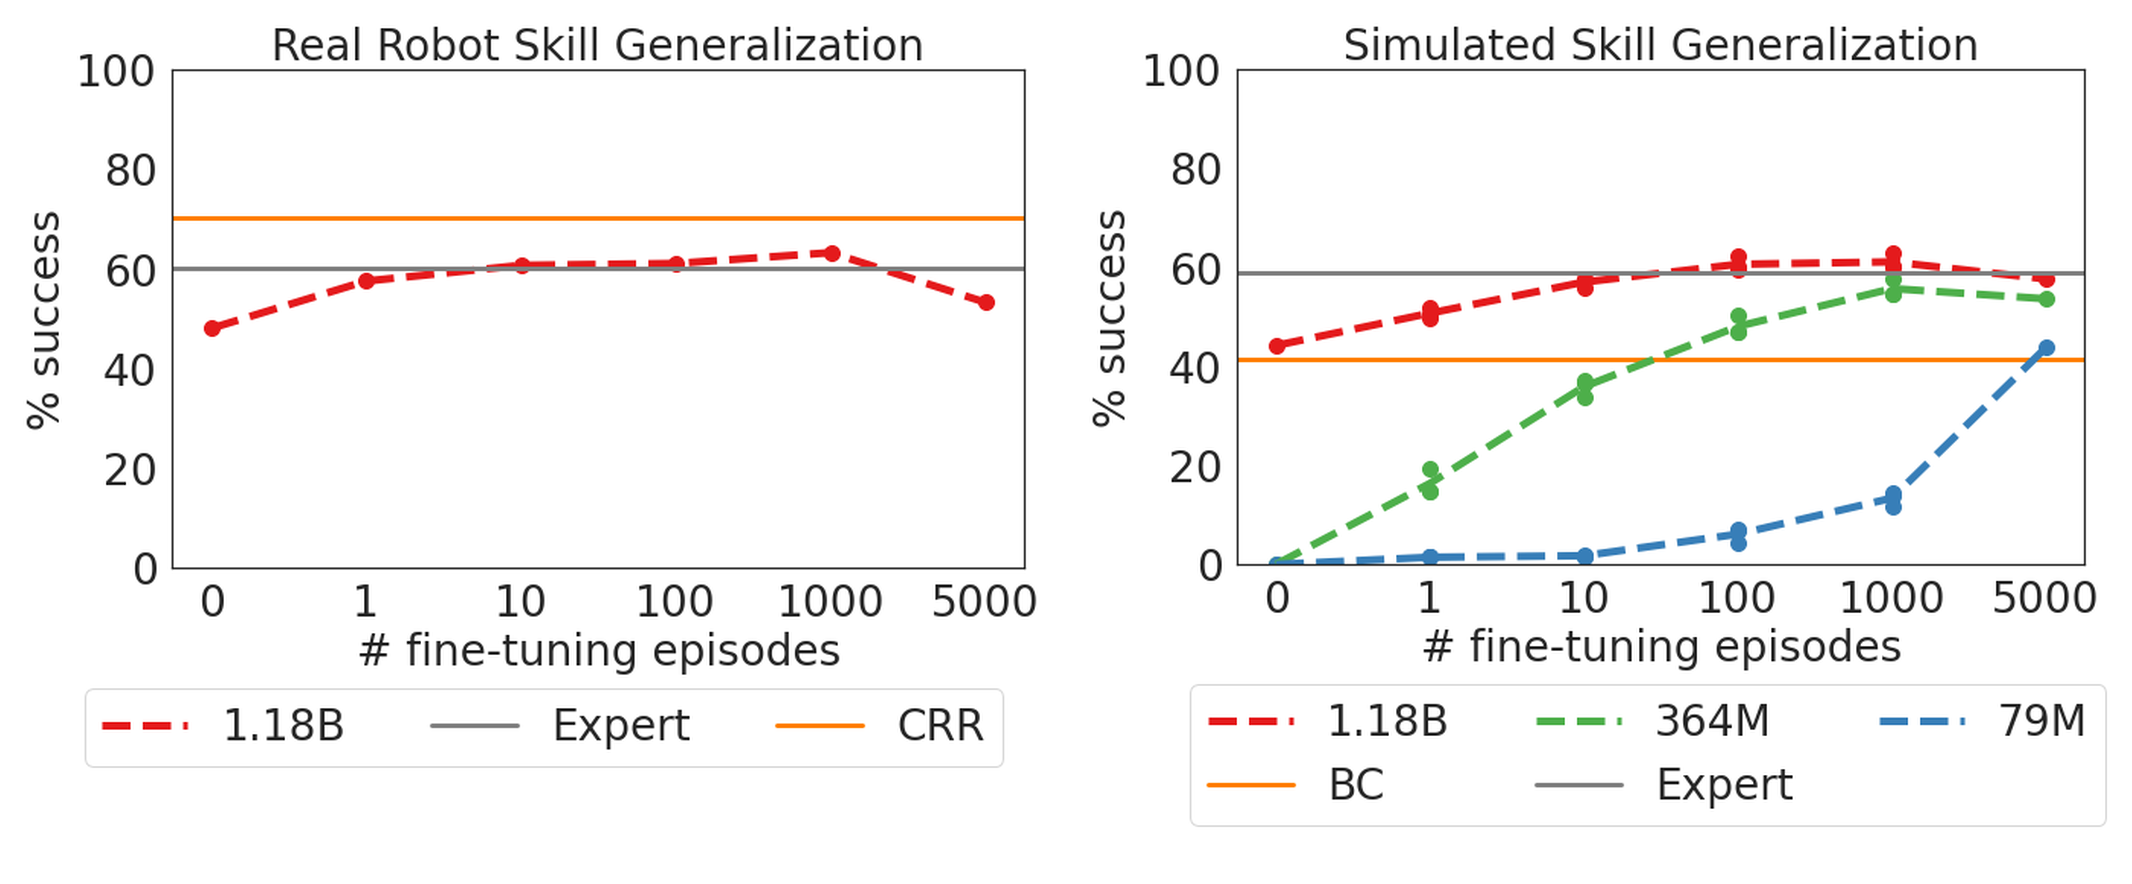
附录I、图19:同域专家仍有优势。 部分机器人微调对照中,只在相同领域预训练的模型表现最好。这给“大杂烩数据一定优于专业数据”提供了直接反例。更大数据多样性可能与有限容量、采样频率和任务干扰形成权衡。
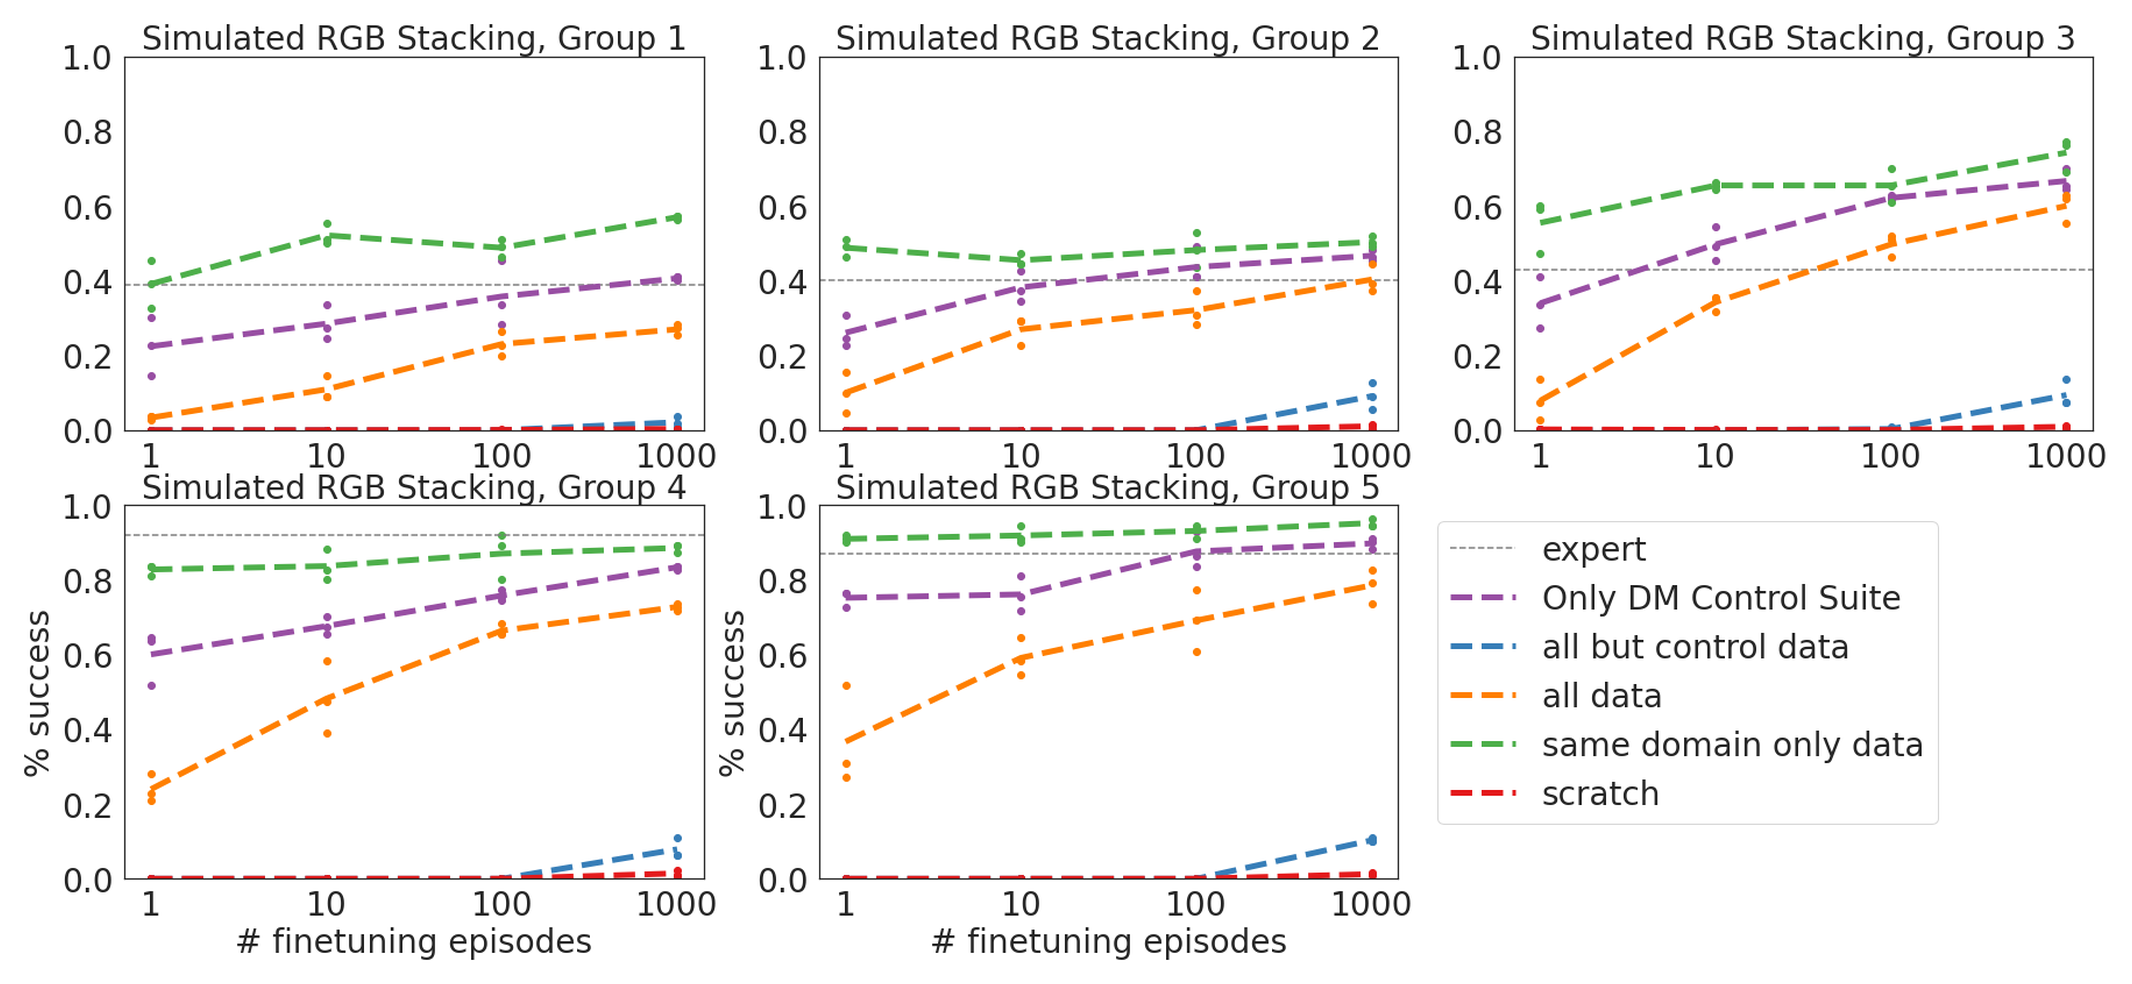
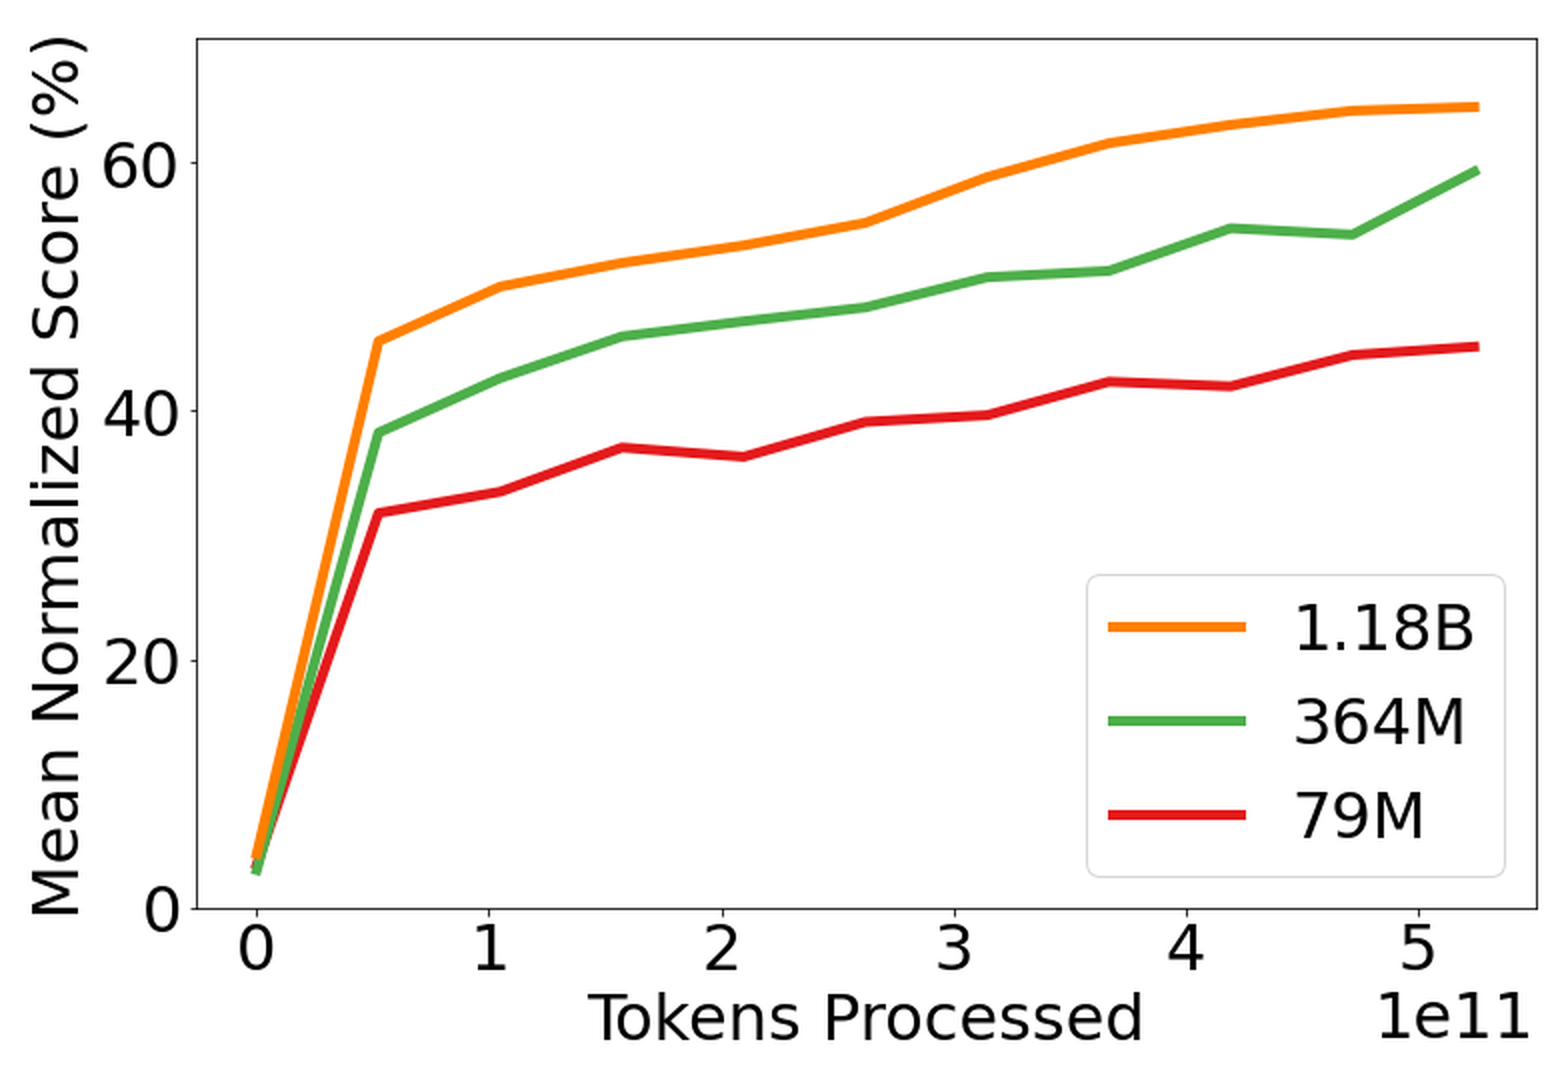
图8的规模趋势是在相同处理token数量下比较不同参数量。参数更大意味着更多计算,不能把这张图解释为严格固定FLOPs的最优设计证明。注意力可视化也只是选定头的现象展示,不是因果解释。
五、数据混合和量化影响单任务表现
但它仍依赖环境专用的输入序列化和动作反量化接口。相同token编号在不同身体上的物理意义不同,网络需要依赖上下文学习区分;统一格式不会自动创造跨身体的可执行动作语义。
训练于好轨迹的行为克隆也难以主动发现超越数据的新策略。作者把未来结合RL作为方向,不能倒过来把可能的未来能力写成本篇成果。
阅读时还有一处具体口径值得留意:§3.1文字称窗口大小是数据量10%或“至少1000”,括号却写 ,两者不一致。本文不据此重算专家归一化分数,复现需要确认数据过滤实现。这个局部定义疑点不否定多任务共享结果,但影响精确复现。
追问:若机器人数据在混合中只占很小比例,怎样判断下降来自负迁移还是采样不足?
参考答案:先记录机器人样本的实际更新次数,再在相同机器人更新预算下比较有无其他领域数据;也应控制总模型与算力。若只固定总步数,加入大量其他任务会稀释机器人训练,下降不能直接证明表示冲突。共享网络的容量竞争与样本配额是两种不同解释。
六、沿机制关系继续读
与RT-1是平行序列策略路线:Gato优先统一多领域接口,RT-1针对真机控制延迟与机器人数据设计;RT-2再将预训练视觉语言模型用于动作输出,三者不能简化为只靠参数增大的线性版本链。
七、自测三题与参考答案
问题1:使用下一token预测,为什么不必把图像也生成出来?
输入可以为预测提供条件而不成为目标。损失掩码使图像参与理解上下文,但只对文字和动作位置计算监督。它学的是条件策略,不必同时学习像素生成模型。
问题2:同一模型会游戏和堆叠,能否推断玩游戏的数据提高了堆叠成功率?
不能。能力共存和正迁移是两个命题。必须比较相同预算下去掉该数据的模型;论文部分消融甚至显示同域预训练更好,说明容量与数据混合存在权衡。
问题3:60%的蓝叠绿结果是否证明模型能凭语言直接换目标?
不是。该实验进行了500条真实示范及额外模拟示范的微调。它证明预训练有助学习新的目标排列,不能替代无需参数更新的语言条件泛化实验。