057|RT-1:大规模真实机器人动作序列
原论文:RT-1: Robotics Transformer for Real-World Control at Scale,Anthony Brohan 等,首次公开2022年;本文阅读2023年8月v2正文与附录。论文。
先接住前作的问题
SayCan把请求拆成已有技能,但每项技能仍需可靠的视觉动作执行器。RT-1把大量真实示范训练成共享语言条件策略,并可放入SayCan系统;本篇自身输出动作,不承担同样的显式可行性评分。
五个前置概念
五个前置概念:行为克隆拟合专家动作;FiLM用条件信号调制特征;TokenLearner学习压缩视觉信息;动作离散化把连续值变成分类标签;组合泛化重组已见概念而非发明新控制机制。
一、问题设定:多种厨房指令怎样共用低延迟动作策略
RT-1 的问题是,能不能把大量厨房操作示范放进一个模型,让它执行新的物体—动作组合,而不为每条指令单独训练?作者用13台机器人、17个月采集约13万条真实示范,并设计一个能以3 Hz输出动作的视觉语言策略。
机器人有7自由度机械臂、双指夹爪和移动底盘。策略读取自然语言指令及最近六张图像,输出末端平移旋转、夹爪开度、底盘平移转向,以及选择控制机械臂、底盘或结束的模式。
这是离线行为克隆,训练使用成功示范。论文§3以最终二元奖励描述任务目标,但实际优化不是策略梯度或Q学习,而是专家动作分类损失。在线执行时不断重新观察,直到预测终止或达到步数限制。
表1的744项按语言指令计数。例如“移动可乐到苹果旁”和“移动可乐到水瓶旁”是不同指令,但共享移动技能。原文将它们按动词组织成技能家族。这个计数适合描述组合覆盖,不适合直接与另一论文的任务模板数比较。
“未见任务”主要是已知物体与已知技能的新组合。若测试拿起苹果,训练中仍可以见过苹果用于其他动作、拿起动作用于其他物体。作者在§7明确承认,模型还不能生成完全没有见过的新运动。
训练场是按办公室厨房搭建的真实机器人教室,不是物理仿真;另外两个办公室厨房提供背景、布局、照明等变化。这个区分重要,因为主结果的真实部署优势建立在真实示范上。
二、用语言调制和token压缩预测动作
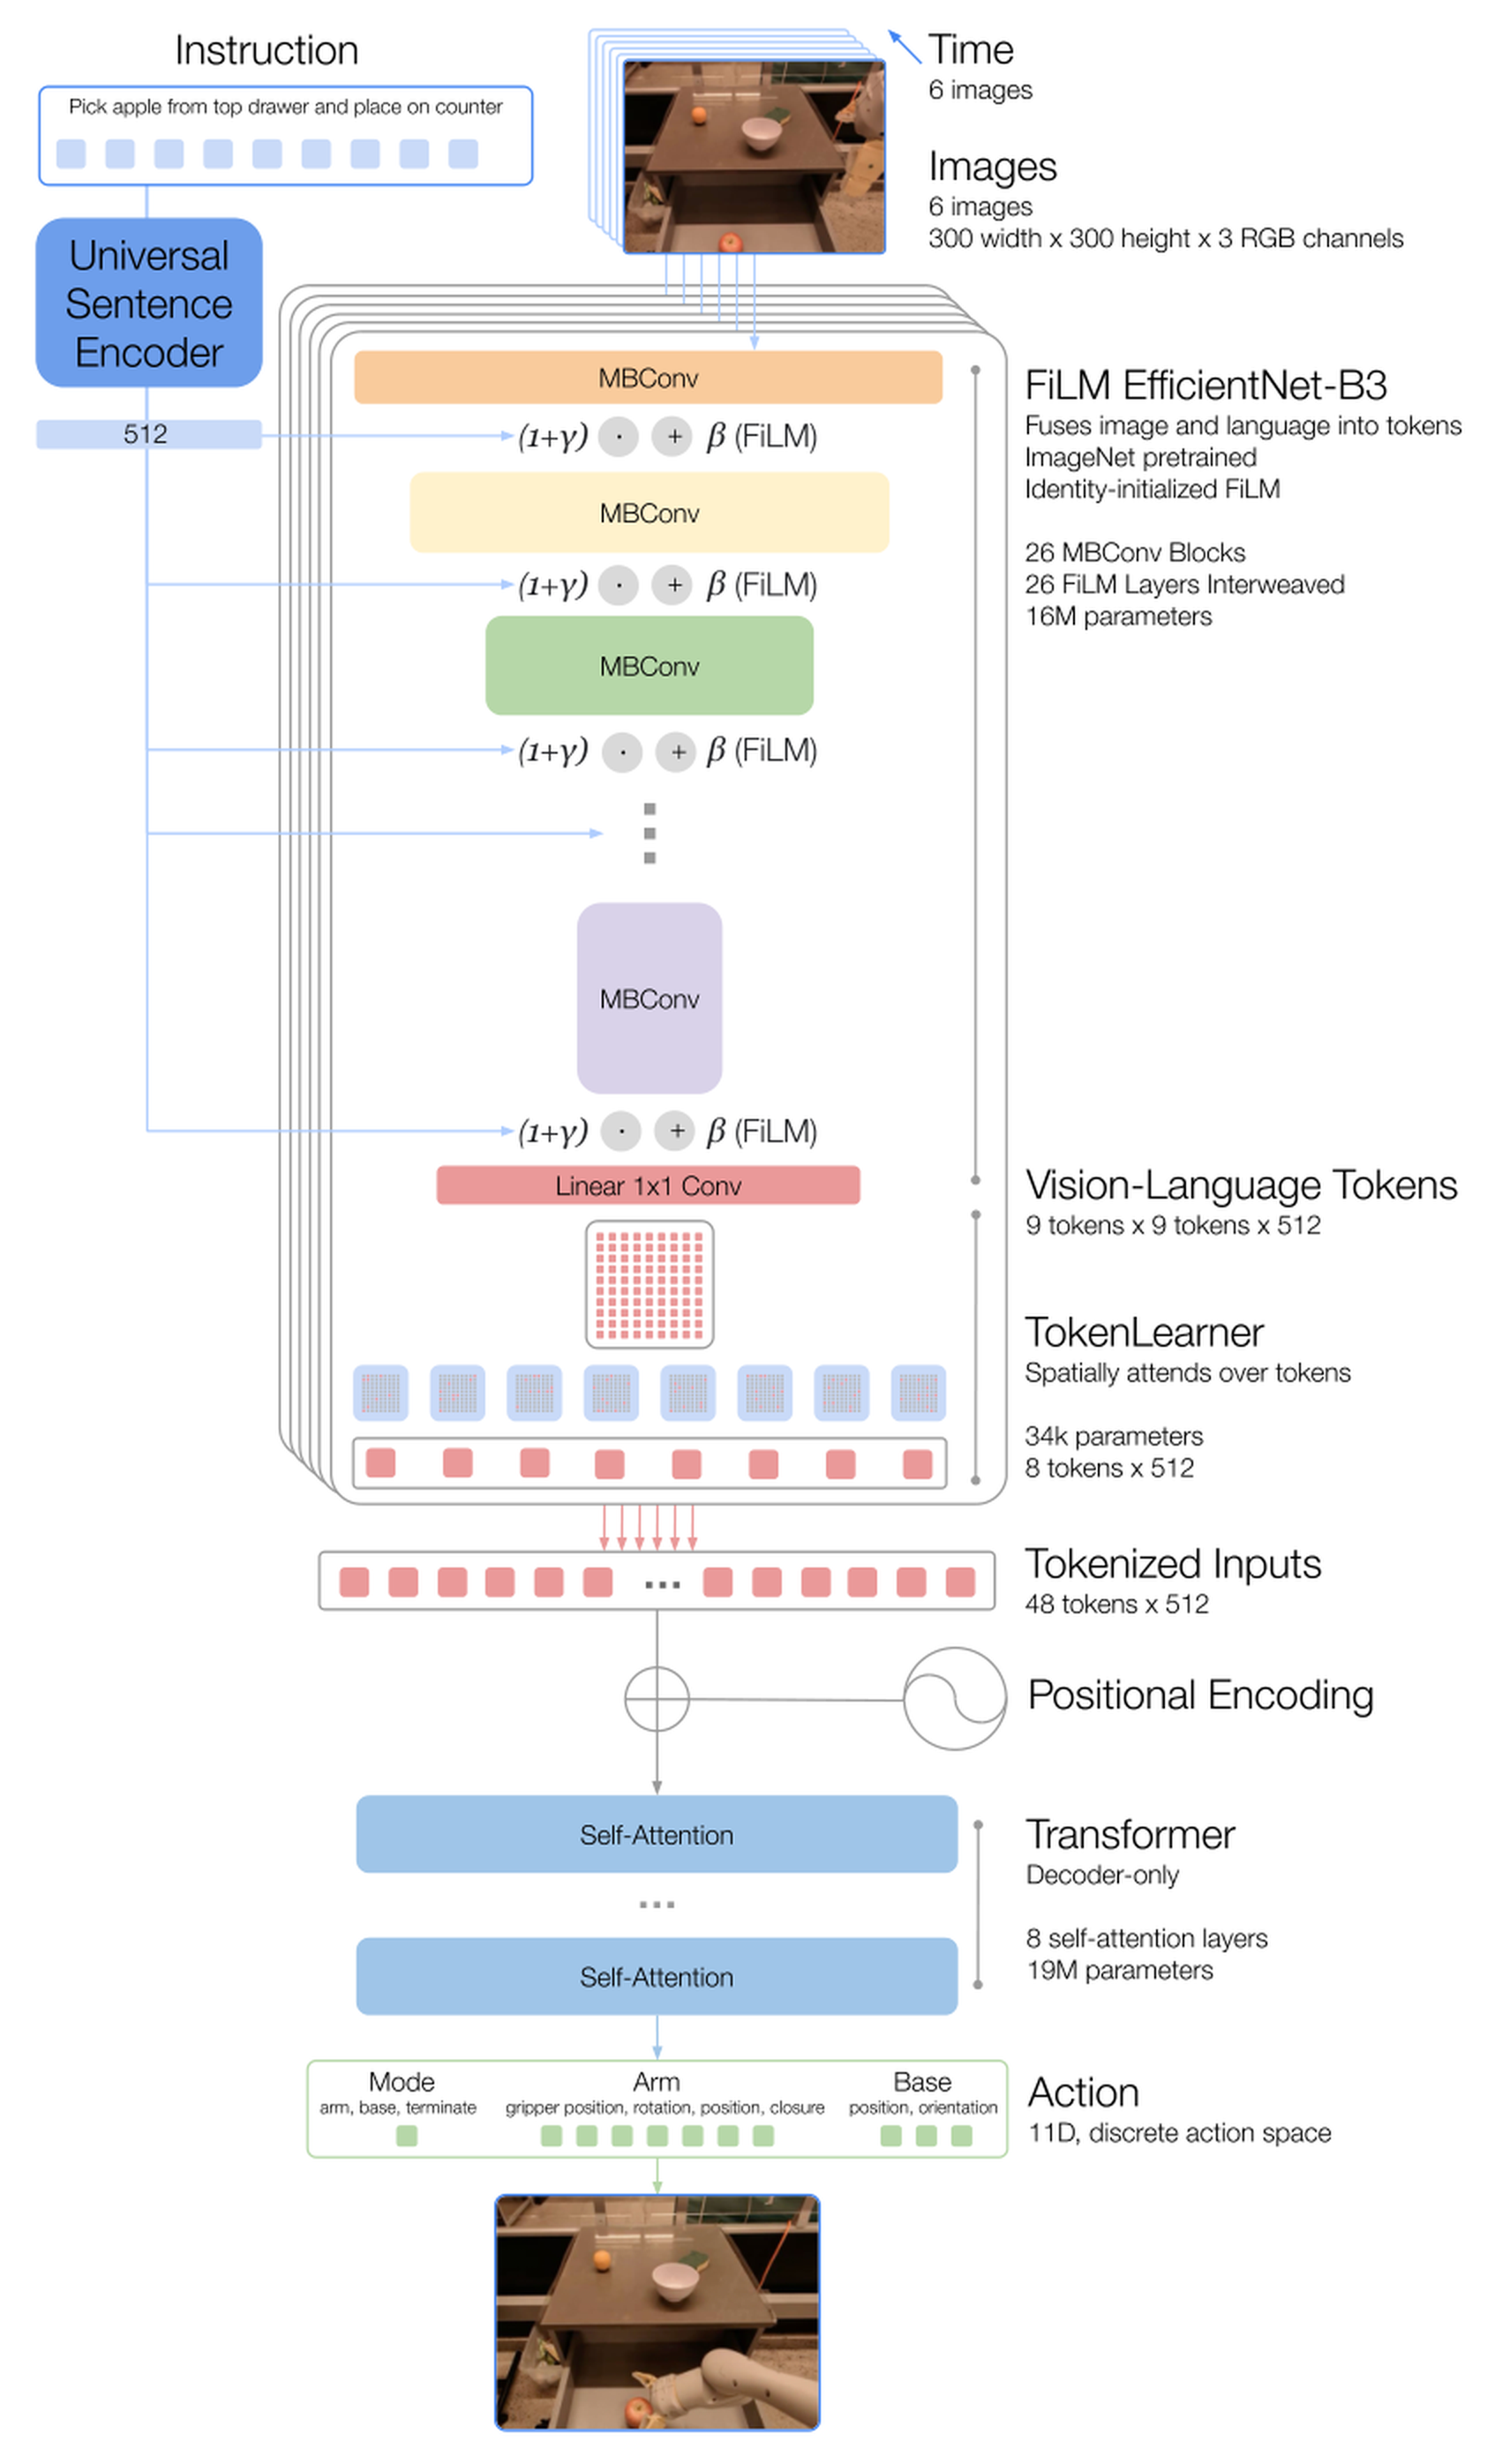
它没有让语言模型先写计划再选择技能。RT-1自身是低层操作策略:图像先被语言调制,再压缩成少量token,Transformer根据短历史预测机械臂、底盘或终止命令。长任务实验则把这个策略放入已有SayCan系统。
表2中,已见任务成功率97%,未见组合76%,干扰物83%,新背景59%。这些数字说明多任务真实控制有明显进步,也说明换厨房远比训练场表现困难。
1. 语言在视觉编码早期介入
图像经过ImageNet预训练的EfficientNet-B3。自然语言先由Universal Sentence Encoder编码,再通过FiLM调制视觉特征。教学形式为
是中间视觉特征, 是指令,是语言产生的缩放偏移。将新增分支初始化为零,使整个调制最初等于恒等映射,避免一插入语言层就破坏预训练视觉表示。
直觉上,“拿苹果”和“关抽屉”需要注意不同区域。早期条件化让后续压缩保留与当前任务有关的信息。但注意力图只能展示相关位置,不足以独立证明网络形成了完整物理理解。
2. 先压缩视觉,再处理时间
每张300×300图像形成9×9×512特征,即81个视觉语言token。TokenLearner把它们压缩为8个;六帧共48个token进入8层Transformer。视觉语言编码部分约16M参数,Transformer约19M,总计35M。
这与VIMA的对象检测不同:TokenLearner学的是软加权特征组合,没有显式要求一个token对应一个物体。它更容易端到端训练,但不能把压缩槽位直接解释为可读对象清单。
3. 动作分类,而不是逐维慢慢生成
连续动作分量在各自范围内均匀离散成256档,模式变量表示机械臂、底盘或终止。监督目标可以写成
为第个动作分量的离散标签。不同输出头共享视觉历史特征。该式是教学概括:实现仍需对应动作掩码与有效模式。
最终RT-1不在动作维度之间进行自回归生成。它采用序列模型处理观测历史,不等于每次动作都要按语言模型的方式逐token解码。消融显示后者会增加延迟,却没有整体收益。
离散分布可以表示一个分量上的多个峰,而单高斯回归常把它们平均到不合理位置。但各维分布有多个峰,不意味着完整联合动作分布的相关性问题已经消失。
数学优化的是示范动作概率;算法改变的是表征、离散动作与推理路径;实验评价是成功率和延迟。RT-1本体没有价值函数和环境模型。SayCan扩展中的可行性价值来自另行训练的MT-OPT,不应归为RT-1网络内部组件。
视觉token压缩能减多少注意力计算?六帧每帧81个token共有486个,压到每帧8个后为48个;仅比较二次注意力项,比例约 。这不是总推理快百倍:EfficientNet编码、TokenLearner、线性投影、动作解码和数据传输仍需计算。
缓存旧帧还利用滑动窗口重叠,减少重复视觉编码,却不减少控制环节的相机/执行延迟。教学上即使网络只用50毫秒,若传感器等待100毫秒、执行调度再150毫秒,总周期仍是300毫秒。原文为机器人设定明确实时预算,正说明模型大小需要放在整条控制链中讨论。原文架构及Inference speed
一个教学例子
自构例子,未运行:训练有“拿苹果”“移动香蕉到碗边”,测试“移动苹果到碗边”。语言FiLM突出苹果与碗,视觉历史帮助判断苹果是否已被抓住,策略输出末端移动和夹爪命令。成功依赖它学到了可复用的物体与动作关系。
换成“削苹果皮”则不同:即便词语能被语言编码器理解,控制数据里没有刀具接触、施力和旋转的运动范式,已有组合能力也不足以凭空制造技能。
三、以短观察历史并行预测动作命令
Token压缩帮助模型满足控制预算,但网络前向耗时与系统3 Hz动作接口不是同一个频率。机械臂、底盘和终止命令还需遵守各自输出约定。
输入:成功示范、每条示范的语言指令
训练:
  取最近六帧和对应专家动作
  用语言FiLM调制EfficientNet视觉特征
  每帧用TokenLearner压缩为八个token
  Transformer聚合带位置编码的图像历史
  并行预测离散动作分量与模式
  最小化专家动作交叉熵
  用经过视觉转换的模拟器辅助选择检查点
部署:
  缓存旧帧token,只编码新帧
  读取最近六帧,预测本步动作
  经过固定时序等待后交给底层轨迹控制
  继续观察,直到终止命令或步数上限
四、把已见组合、新背景和控制频率分开
原图怎么读: 图3,原论文图注与图像。指令先调制视觉编码,TokenLearner再压缩视觉token,最后Transformer输出离散动作。沿这条数据流读,能避免把视觉压缩等同于逐动作token自回归。
结果图怎么读: 内嵌表2所附结果柱图,四组分别是已见任务、未见任务、干扰物和背景变化。逐组比较RT-1与同表基线,才能看清准确性和泛化的不同难度;已见任务的高成功率不能代替新背景可靠性。
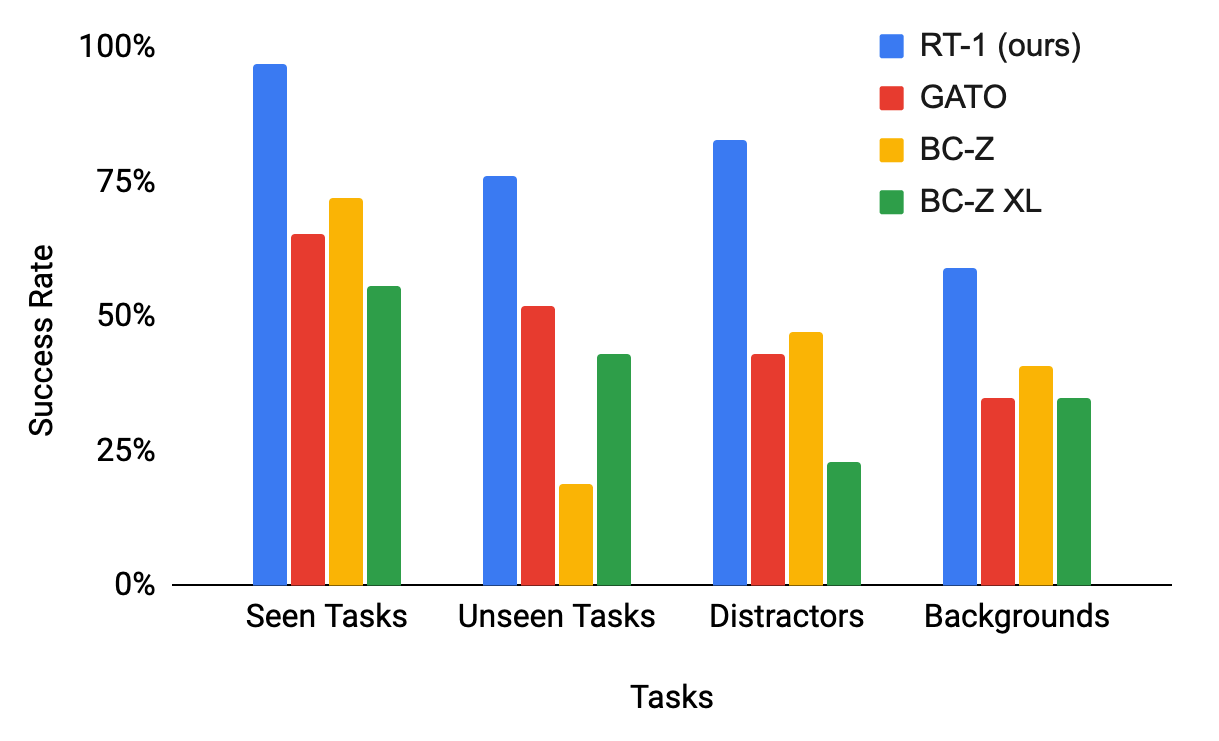
表2数值摘录(成功率%,Brohan等,2022,原表):四种架构使用同一训练数据,比较的是架构表现。下表补充原有柱形图的精确数值。
| Model | Seen Tasks | Unseen Tasks | Distractors | Backgrounds |
|---|---|---|---|---|
| Gato | 65 | 52 | 43 | 35 |
| BC-Z | 72 | 19 | 47 | 41 |
| BC-Z XL | 56 | 43 | 23 | 35 |
| RT-1 | 97 | 76 | 83 | 59 |
| 项目 | 原文设置 |
|---|---|
| 主数据 | 约130k成功真实示范,13台机器人,17个月 |
| 任务 | 表1共744条语言指令;多条指令共享技能 |
| 对比 | 同数据训练Gato架构变体、BC-Z、BC-Z XL |
| 参数约束 | RT-1 35M;Gato变体37M,受实时推理限制 |
| 输入与控制 | 六帧图像、语言;策略3 Hz,底层轨迹跟踪负责实际运动 |
| 测试 | 全文超过3000次真实试验,含已见、组合、背景、干扰及长任务 |
| 选模 | 附录C.3用RetinaGAN转换的模拟器做real-to-sim策略排序 |
| 混合仿真数据 | 另加518k成功仿真轨迹;先通过多任务RL获得采集策略 |
| 跨机器人数据 | 209k条QT-Opt成功抓取,与本机示范混合 |
| 训练资源 | 本文未逐项确认训练更新总量、计算设备及每项独立训练种子数 |
选模中使用模拟器,不表示主模型训练示范来自模拟器。模拟器只要能较好排序检查点就有帮助,不要求模拟成功率等于真实成功率;这也是论文明确强调的用途边界。
v2正文§6.1说已见评估超过200项、未见指令21项,附录D.1则说已见744项、未见53项,并在表8列出53项。两处口径不同,本文保留表2结果及其技能加权说明,不推断每个百分数的唯一原始试验分母。超过3000次是全实验总量,也不能视作每个模型每个类别有3000次。
五组证据及其边界
表2:相同示范数据下的架构比较。 RT-1已见97%,BC-Z72%,差25个百分点;未见76%,Gato变体52%,差24个百分点;干扰物83%对最强基线47%,差36个百分点;背景59%对41%,差18个百分点。这里不是相对增加25%、24%等。结果支持整套设计,但不能单凭此表归因于Transformer,因为预训练、历史与动作表示也不同。
表13:哪些组件重要。 去除ImageNet预训练后未见成功率76%降至43%;改成单高斯连续动作也为43%;去掉历史后干扰表现83%降至50%。自回归动作推理为36 ms,完整模型15 ms,而背景成功率反而65%高于59%。因此“每个组件都在每个指标上更好”不成立。离散动作对这组多样示范有效,也不证明所有连续分布策略都差,扩散策略就不是单高斯。
表7:多样性与数量。 保留97%数据却只保留75%任务,综合泛化从73降到54;保留全部任务但只用51%数据则为50。作者据此强调多样性。但删除的是示范最少的任务,改变了长尾覆盖;实验支持“这组长尾技能有价值”,不能升格为任意数据集上增加类别永远优于增加样本。
表4、表5:异构数据可以互补。 混入仿真后,仅在仿真见过物体的已见技能真实成功率23%升到87%,新组合7%升到33%;原真实物体92%变90%,是小幅下降,不能称完全不变。跨机器人混合使本机抓箱内物体22%升至39%,差17个百分点、结果约1.77倍。只用Kuka数据在本机为0%,说明需要本机经验作为桥梁,不是无需适配的任意机器人迁移。
表6与附录D.3:长任务系统。 15条高层指令平均9.6步、平均2.4个操作技能;SayCan搭配RT-1在两个厨房执行均为67%,规划87%。第二厨房BC-Z为13%、Gato变体0%。这支持低层技能可靠性对组合任务的重要性。50步结果来自补充视频展示,不能当作15条系统评估的平均长度,更不能把SayCan的规划能力算成RT-1独立产生。
对应方法、表格与附录见论文全文。本文核对上述正文与附录,未独立复现网络训练或机器人试验。
五、数据广度不能凭空补出新运动机制
原文§7承认模仿学习能力受示范限制、难以产生未见运动、操作不够灵巧、背景泛化仍不足。这里的3 Hz足以支撑部分厨房动作,却不是面向高速接触控制的通用频率。
部署延迟也有两层:表13的15 ms只是网络推理。附录C.1还安排从图像状态采集起等待固定280 ms后施加动作,以降低时序抖动;实际闭环还包含相机、通信和执行。不能由15 ms倒推出机器人能以约67 Hz有效纠错。
本文进一步的分析是:成功数据采集和real-to-sim选模都需要持续工程维护。若新环境反复导致失败,纯离线策略不会自动把失败转换成纠错经验;必须补数据或引入新的学习机制。
追问:语言调制有效,怎样排除模型仍利用厨房背景猜任务?
参考答案:需要同一场景不同命令,以及同一命令不同背景的交叉测试;分别记录目标对象选择与实际动作完成。只换新物体而保持场景关联,仍可能留下背景捷径。原文新背景下降提醒我们,组合泛化与环境迁移不能合并成一个成功率。
六、沿机制关系继续读
与Gato是平行序列策略;后作RT-2承接语言条件机器人动作接口,并将互联网视觉语言预训练纳入动作模型。RT-1这里仍是示范监督策略,不是内部带SayCan价值函数的模型。
七、自测三题与参考答案
问题1:RT-1是Transformer,为什么不需要逐个动作token生成?
答案:Transformer可以处理输入历史后并行产生多个输出分量。最终模型去掉动作维度的自回归依赖以降低延迟;历史序列建模与输出自回归是两个独立设计选择。
问题2:15 ms网络推理是否等于约67 Hz机器人闭环?
答案:不是。还存在相机、传输、固定等待和执行延迟。论文实际命令频率是3 Hz,附录还控制从状态采集到动作施加的固定时序。评估实时能力必须看端到端闭环。
问题3:跨机器人混合数据的39%结果说明了什么,为什么0%对照很关键?
答案:混合本机数据与Kuka成功抓取,使本机箱内抓取从22%升到39%,支持经验互补;只用Kuka数据则0%,说明形态和场景差异不会被模型自动消除。本机数据提供映射桥梁,因此证据是条件迁移,不是任意机器人之间直接通用。