058|UniPi:把文本生成视频变成动作策略
原论文:Learning Universal Policies via Text-Guided Video Generation,Yilun Du、Mengjiao Yang 等,2023年;本文阅读2023年11月v3。论文。
先接住前作的问题
Diffuser联合生成状态与动作计划,动作坐标仍与特定控制系统相连。UniPi把共享计划放到视频中,再由身体专属逆动力学转成动作;未解问题是没有动作标签的视频知识怎样穿过这个适配器。
五个前置概念
五个前置概念:条件生成学习给定上下文的样本分布;扩散逐步去噪生成视频;逆动力学从观测变化推断控制;时间超分辨率补齐稀疏帧;开环控制执行预定动作而不依据中途误差重规划。
一、问题设定:视频计划怎样连接不同机器人的动作
同一个“把杯子放到碗旁”的任务,不同机器人需要不同关节命令,但人看视频通常都能理解目标。UniPi据此把规划和执行拆开:一个文本条件视频模型生成完成任务的未来画面,另一个逆动力学模型把画面转换成特定机器人的控制。
常规策略把观测映射到动作,动作定义常常绑定具体机器人。若换成不同关节数或不同控制频率,模型接口和数据标签都可能改变。另一障碍是互联网视频没有机器人力矩、状态和奖励记录,不能直接作为普通强化学习转移数据使用。
UniPi提出UPDP,即以图像、文本、有限时域和条件视频分布描述决策:
为图像空间,为任务文本,为计划长度,产生可能完成任务的视频。再用环境相关的动作适配器得到动作序列。
这是作者提出的建模抽象,不是证明MDP不能表示跨任务问题。MDP本身足够一般;困难在于怎样获得好表示、任务监督和可迁移的数据接口。UPDP把这些工程选择显式移到视频与语言上,同时也引入依赖视频描述数据的新条件。
论文称其为离线决策设定。实际学习使用视频生成和动作监督,未进行基于环境回报的在线策略优化。任务终止与成功仍需环境判断,只是视频模型训练不要求设计标量奖励。
组合任务中,机器人先把白色方块放入彩色碗使其变色,再摆到指定相对位置。观测是图像,动作包括六个关节值与一个离散接触变量。附录A.4的接触动作会把最近方块附着到夹爪上,因此它不是完整真实抓取接触物理。所有执行实验使用开环动作序列,以节省生成成本。
二、先生成条件视频再用逆动力学执行
它的价值是让没有动作标签的视频也能参与学习计划,而不是强迫每种机器人共用一套关节坐标。关键技术是首帧条件、在所有生成帧旁重复提供当前图像,以及先生成稀疏关键帧再补齐时间细节。
证据必须分两类:组合操作与多任务迁移实验确实在仿真中执行动作;真实数据实验主要评价生成视频质量与末帧成功分类器。后者不能当作机器人真实执行率。
1. 当前画面必须是计划的约束
普通文本视频可以从任意合理场景开始,但机器人已经站在一个确定位置。如果模型凭空换了杯子位置,视频再漂亮也没法执行。
作者比较了只在采样时固定首帧的方式,发现后续画面仍容易漂移。UniPi在训练时就显式给定首帧,并把该图像复制到整个时间轴,与每个待去噪帧按通道拼接。这让每一步生成都能参考实际初始物体配置。
这是一种强条件信号,不是物理守恒约束。网络仍可能生成物体穿透、消失或无法达到的中间位置。
2. 扩散的时间与任务时间不同
令干净视频为,扩散噪声等级为,加噪过程是
表示去噪阶段,不是机器人第几步。视频模型在文本和首帧条件下学习逆向去噪。用常见噪声预测参数化作教学概括,损失可写为
原文§2.3用条件去噪器描述,并以classifier-free guidance增强条件:
提高生成计划对首帧和文本的服从程度,过强并不天然更好,也不构成可执行性的证明。
3. 先稀疏计划,再补中间帧
模型先产生较稀疏的未来帧,之后用时间超分辨率模型插入细节。仿真配置先生成10帧、每8帧采样一次的计划,再生成20帧、每4帧采样一次的细化视频。这样可先解决“先染色再摆放”的整体顺序,再表达中间运动。
这与Diffuser直接在状态—动作轨迹中扩散不同:UniPi的共享空间是视频,动作由另一个模型负责;也与Dreamer不同,它没有在动作条件动力学里通过价值函数优化策略。
4. 逆动力学补上身体接口
令代表把视频观测转换为机器人控制的适配器,监督损失是动作均方误差:
通常的逆动力学会用前后状态推断动作;这里不把该通用定义强行替代实现。附录A.2描述的是从图像观测预测7维控制的卷积网络,具体帧拼接细节本文未进一步核实。可靠的结论是它独立于视频规划器训练、需要动作标注,并承担环境相关控制转换。
视频与动作之间还存在可控性条件。教学例:相邻画面显示杯子从桌左到桌右,但中间隔着固定挡板;一个逆动力学网络可以输出看似合理的右移动作,却没有证据表明这对画面之间存在可行的真实短动作。缺少动作标注的视频既不能指定真实执行器带宽,也不能保证生成转移可逆。
因此“通用视频计划+身体适配器”分解的好处是复用视觉经验,代价是两级误差相乘:计划要可实现、动作转换要准确。原文明确全部实验为开环执行,执行中的外部扰动不会通过每步重新生成计划自动纠正;可选MPC不能当作已测结果。原文Action Execution
一个具体例子
自构例子,未运行:命令“把白块染红,放在蓝块右侧”。视频模型先画出白块进入红碗,再画出红块到达右侧。稀疏帧表达任务顺序,时间细化补上机械臂移动,逆动力学输出关节目标。
若生成视频偷偷把白块直接变成红色,视觉任务似乎完成,却缺少实际染色动作。若视频路径穿过桌子,逆动力学也不能让现实机械臂这样运动。这个例子说明为什么应同时评估视频语义、状态一致性、动作可实现性和执行回报。
三、生成稀疏视频计划,再补帧并反演身体动作
首帧条件要持续约束生成内容,时间细节补齐后才交给逆动力学模型。无动作视频可以训练计划,动作适配器仍需要身体相关监督。
输入:带文本的视频,以及含控制标注的机器人数据
训练视频模型:
  从真实视频抽取首帧、稀疏未来帧与文本
  给未来帧加噪,将首帧复制到各时间位置作为条件
  学习条件去噪与时间超分辨率
训练动作适配器:
  使用有控制标签的观测拟合机器人动作
推理:
  给定当前图像与任务文本
  生成稀疏未来视频,再补齐中间帧
  用动作适配器将视频转换为动作序列
  按顺序开环执行整段动作
  在环境中评价最终任务完成情况
这段伪代码对应论文实际开环实验。每步重新生成的MPC是文中提出的可选执行方式,不能误写成已在全部实验中使用。
四、区分真实视频质量与真实机器人执行
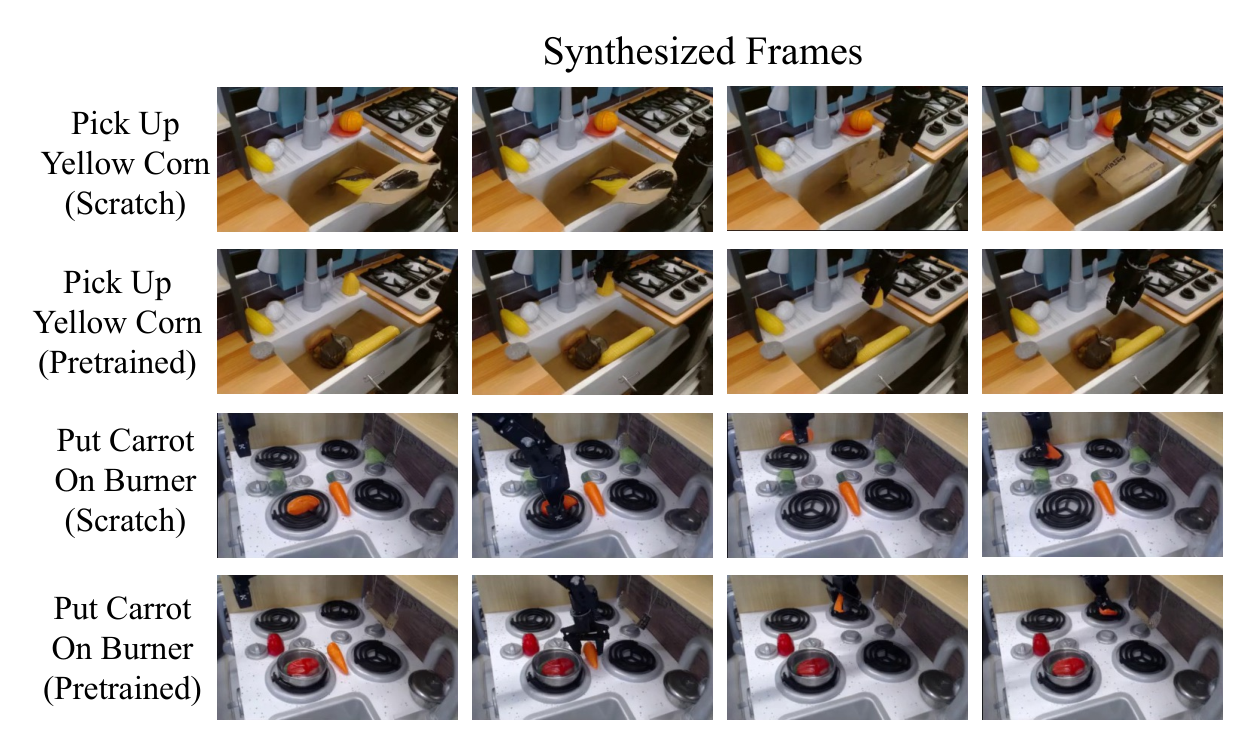
原图怎么读: 图8,原论文图注与图像。比较有无互联网预训练时生成的视频计划是否符合未见任务组合;这是计划生成的证据,还没有经过逆动力学、接触执行和机器人闭环的检验。
原文标注 CC BY 4.0。本页摘图仅保留图形区域并作栅格化;有面板重排的图另行注明,作者与原文入口见各图注。
| 项目 | 原文设置与解释 |
|---|---|
| 组合任务 | 200k脚本专家视频;语言组合70%训练、30%测试;位置随机化 |
| 组合动作标注 | 逆动力学使用其中20k视频的动作标签 |
| 多任务迁移 | 约200k视频;正文称10种训练任务,3种测试任务 |
| 动作执行 | PyBullet关节控制器尝试到达预测关节状态;超时2秒;接触变量附着物体 |
| 视频模型 | 仿真首帧生成与时间超分辨率各1.7B参数,T5-XXL文本编码4.6B |
| 优化预算 | 各视频模型2M步、batch2048、学习率 ;使用256 TPU-v4芯片 |
| 动作网络 | 小型卷积加MLP,Adam训练2M步,梯度范数裁剪1 |
| 真实视频 | Bridge约7.2k视频—文本对,80/20划分,任务ID作为文本 |
| 互联网预训练 | 14M视频文本对、60M图文对和LAION-400M |
| 指标 | 仿真最终任务完成率;真实视频CLIP、FID、FVD及末帧分类成功率 |
| 不确定性 | 表中给出±;本文未确认其完整统计定义及独立训练重复数 |
附录A.5实际列出11个训练任务名称,而正文说10个;这影响精确复现任务集合,宜按发布配置进一步确认,不据此猜测哪一项应删除。
基线包括Transformer BC、预测未来动作的Transformer TT,以及在动作空间扩散的Diffuser式变体。它们共享T5文本特征,但Transformer基线约10M,视频模型规模大得多。因此结果不能简单解释为“视频规划在同算力下必然优于直接动作”。同训练步数也不等于同FLOPs。
与CLIPort直接比较同名环境的成功率也不合适:CLIPort预测抓放位姿原语,这里采用关节控制接口;任务环境相近,不意味着执行难度相同。
五处证据:从图像质量走到控制,需要逐层核对
表1:组合泛化确实执行了动作。 未见Place任务UniPi为60.1±3.9,Image+TT为13.2±4.1;未见Relation为46.1±3.0,Diffuser为9.6±1.7。按表中百分数,后者绝对差36.5个百分点。这支持所测组合条件下的仿真控制优势,不能直接推广到真实抓取,尤其接触机制被简化。
表2:首帧与层级的消融。 已见Place从无三个组件时13.2升到仅首帧条件52.4,完整方法59.1;Relation对应12.4、34.7、53.2。最大跳变来自明确初始状态,而层级细化对相对位置任务进一步有帮助。消融是逐项累加,没有完全析因实验,不能由差值断言每个组件独立贡献固定。
表3:留出任务迁移。 Place Bowl、Pack Object、Pack Pair分别为51.6、75.5、45.7,均高于所列变体。它表明学习的视频结构可跨相关仿真任务复用,但仍是同类桌面机器人接口,不证明任意身体和环境的通用策略。
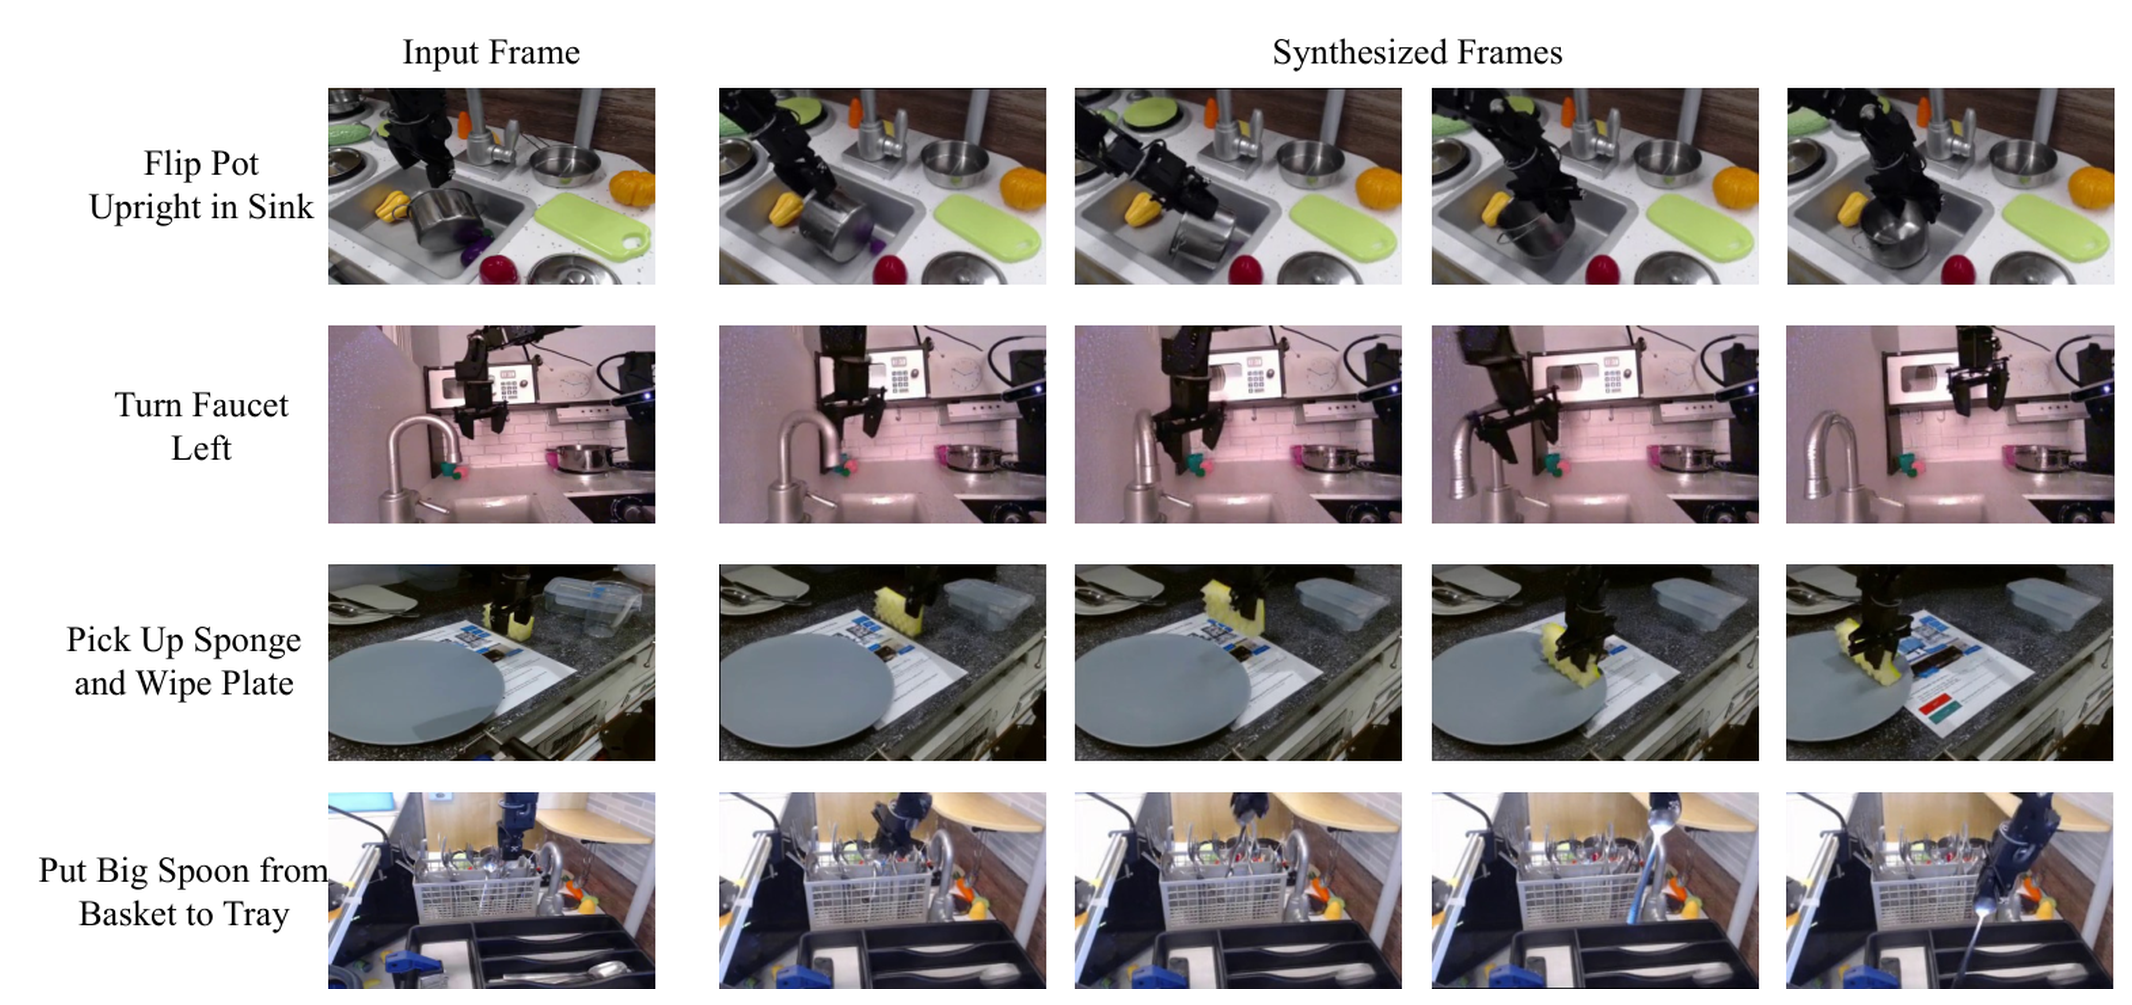
表4:真实世界部分是视频质量。 互联网预训练使FID从17.75降到14.54、FVD从288.02降到264.66,CLIP分数24.43略升到24.54。FID/FVD越低越好;正文一处写“higher”与表头方向不一致,解释应以指标定义和实际下降为准。表格注明分辨率24×40,不能把这里的分数直接当成高分辨率演示视频的统一评价。
表4、图6、图8:77.1%的含义。 成功分类器看生成视频的最后一帧,预训练后判定成功77.1%,从零训练72.6%,提高4.5个百分点。这是在生成画面上预测成功,不是机器人执行了77.1%的任务。作者也指出CLIP分数未充分反映任务失败。生成视频、分类器评估和真实控制是三种不同层次的证据。
上述数字和定位来自原文及附录。本文阅读v3方法、实验和附录,没有独立训练,也没有把生成结果作为硬件实验。
五、可见未来未必满足接触和身体约束
代价是视频模型很大,首帧生成与时间超分辨率都耗计算。§6承认高逼真视频可能需一分钟,初步蒸馏实验约16倍加速,但没有据此给出完整真实闭环性能证明。开环执行节约了反复规划费用,也放弃了及时纠偏。
作者承认大多考虑充分观测环境,部分可观测时可能幻觉对象或运动。本文的进一步分析是,即使充分看见物体,也未必看见摩擦、质量与接触力;视频中可见的路径不一定对应可实现的动力学。逆动力学只能把可解释的视觉变化翻译成控制,不能自动修复物理上不可能的视频。
UPDP避免手写奖励,却把任务规范转移到文本、成功视频分布和评估器中。若数据里的成功仅是“杯子看起来靠近碗”,模型可能不理解防倾倒等隐含条件,因此不能说任务规范问题已经消失。
追问:逆动力学在两帧之间给出动作,为什么仍可能丢掉必要的接触历史?
参考答案:相似的前后图像可能对应不同摩擦、受力或隐蔽接触状态,短图像对不一定足以确定可执行控制。可固定视频计划,比较有无可用本体或历史信息的适配结果,区分计划不合理和动作反演不足。视觉可达性不能单独证明物理可执行性。
六、沿机制关系继续读
与Diffuser是平行生成规划:UniPi在视频中规划,再用动作适配器接身体;与Visual Foresight有教学联系,后者动作条件预测并在线搜索,本篇文本条件生成的因果接口不同。
七、自测三题与参考答案
问题1:为什么视频计划能用无动作标签的数据,而整个机器人系统仍不能完全摆脱动作数据?
答案:视频模型只需学习“任务完成过程长什么样”,但具体关节命令属于机器人控制接口。逆动力学适配器需要动作监督。共享计划减少接口耦合,不代表执行映射可以凭空获得。
问题2:论文中的77.1%能否用来声称真实机器人成功率超过七成?
答案:不能。它是成功分类器对生成视频末帧的判断。真实控制还需经过动作转换、接触和误差积累。把它称为执行率会越过实验没有验证的一整层。
问题3:只固定第一帧,为什么还可能生成不可执行的视频?
答案:首帧只约束开始,后续可能改变物体身份或违反物理。训练时持续提供首帧有助于一致性,但不是动力学约束。闭环重规划、接触验证或可执行性模型可能进一步帮助,这些需要单独实验。