056|VIMA:多模态提示中的任务组合
原论文:VIMA: General Robot Manipulation with Multimodal Prompts,Yunfan Jiang 等,首次公开2022年;本文阅读2023年5月的v2正文与附录。论文。
先接住前作的问题
一次示范模仿提供一个阅读起点。One-shot模仿用一条示范说明任务,但用户还可能提供目标照片、对象图或文字。VIMA把这些说明统一成多模态提示,并让策略反复读取;它扩展任务接口,不代表从未训练过的机器人可立即使用。
五个前置概念
五个前置概念:行为克隆是拟合示范动作;对象中心表示把场景拆成实体;交叉注意力让一个序列查询另一个序列;组合泛化指重组已知属性或技能;动作原语是已经实现的低层执行程序。
一、问题设定:文字、对象图和示范怎样共同指定操作
机器人任务不只有一句话。有时人指着一个物体,有时给目标照片,有时展示一段动作。VIMA 把这些输入写成同一种多模态提示:文字中可以插入物体图、场景图和示范视频帧,策略结合当前观测与历史直接预测操作动作。
这是多任务、单机器人、离线模仿学习。数据来自仿真专家,策略训练阶段不访问模拟器;评估时才执行动作。观测包括正面和顶视 RGB,任务提示可以穿插视觉参照。动作是抓取放置或扫动原语的位姿参数,底层执行器负责把这些参数转成机器人运动,不能理解为直接预测每个关节的力矩。
VIMA-Bench 有 17 种任务模板、六类任务表达。训练使用其中 13 种,每种约 5 万条成功专家轨迹,共约 65 万条。模板和实例要区分:更换物体、纹理、位置和提示产生许多实例,不意味着有同样多种独立操作技能。
论文§3定义四级评估:
| 级别 | 测试变化 | 能回答的问题 |
|---|---|---|
| L1 | 已见提示下的新物体摆放 | 是否只记住训练轨迹位置 |
| L2 | 已见物体与纹理的新组合 | 是否能组合已知属性 |
| L3 | 新物体或纹理 | 表示是否适应外观变化 |
| L4 | 留出的任务模板 | 是否能迁移到新的任务组织方式 |
L1 的提示可以与训练完全相同;L4 才直接针对留出模板。四级不是同一任务难度的连续加噪,因而不能把级别间下降全部解释为某一种因素。奖励在这里主要作为环境成功判定的背景,训练目标本身不使用回报。
原有问题是不同任务接口往往需要不同策略:语言策略不自然接收目标图,单次模仿策略也不自然理解一句约束。作者的假设是,这些差别可以先在输入序列层统一,再由一个条件策略处理。它仍依赖对象可检测、提示能表达任务,以及所需动作属于已有原语。
二、用对象token和交叉注意力持续读取提示
它的关键选择不是把整张图直接变成很长的像素序列,而是先检测物体,把每个物体的外观和位置变成一个 token;控制器在每一步通过交叉注意力重新读取提示。训练仍是离线行为克隆,没有通过奖励优化策略。
1. 不让控制器重新发明整个视觉系统
场景图片先经过域内微调的 Mask R-CNN。每个检测框有位置编码,框内 RGB 裁剪经过 ViT,二者构成对象表示。单物体提示图也用类似编码,但配置虚拟边界框。检测器输出的类别名字不作为策略输入,避免把识别类别标签直接当作语言答案。
文本经 T5 的词表与嵌入处理,视觉 token 经适配 MLP 接入提示编码器。论文§4将 T5 描述为冻结预训练编码器;§5.3 的编码器尺寸消融明确微调最后两层。理解时应区分主流程描述和该消融配置,不能不加条件地说所有实验都冻结全部 T5 参数。
对象表示带来的归纳偏置很具体:一个杯子通常保持一个对象槽位,而不是随图像分辨率拆成许多小块。但这同时把分割任务交给另一个经过监督训练的系统。
2. 每个动作都重新查询任务
令提示为 ,历史为 ,策略为
控制器交替使用因果自注意力与提示交叉注意力。后者可以写成
来自当前轨迹特征, 来自提示, 是特征维数。这里的 是注意力查询矩阵,不是强化学习价值函数。直觉上,控制器一边回顾已经做了什么,一边重新核对目标物体与约束,不必只靠序列最前面的一段提示维持任务记忆。
输出头预测离散化的操作位姿。模型没有环境动力学模块,也没有价值网络:策略学习的是示范中的条件动作分布。
3. 优化目标没有变成强化学习
数学目标是提高专家动作似然;机制变化是对象 token 与提示条件化方式;改善指标是闭环任务成功率和同数据预算下的泛化。三者不能混成“最大化推理能力”。
为应对检测器假阳性,训练随机添加伪对象。附录D具体使用 95% 不添加、5% 添加一个伪对象的分布。这鼓励策略忽略不相关对象,但不能保证应对关键对象漏检。
对象token把信息瓶颈移到了检测器。教学例:提示要求“把图中的杯子放进盒子”,真实场景有杯子却漏检,策略输入里没有它,再强的跨注意力也无法精确恢复其位置;多检一个干扰物则仍可能靠提示排除。漏检与假阳性不是对称错误。
原文因此偏向高召回检测器,再用伪对象增强处理假阳性。这个策略是合理分工,但有额外域内标注成本,不能把全部收益解释为提示模型从零学会对象感知。评估对象数量泛化还应区分已成功检测的对象集合扩张,与检测本身在拥挤场景的退化。原文附录C.4
用小例子建立直觉
自构例子,未运行:提示写“把这个[红色星形图片]放到那个[蓝色容器图片]里”,桌面有红星、红方块、蓝碗。只依赖文字类别可能把两个红物体混淆;对象编码让控制器同时比较红星的外观与位置,交叉注意力把当前对象与提示参照联系起来。第一次动作后,历史记录红星是否已经移动,下一次观测再决定是否继续。
如果检测器把红星漏掉,控制器没有一个可以正常匹配的候选对象。即使提示理解完全正确,动作仍可能失败。这说明理解任务和获取可行动的观测是两件事。
三、编码对象与提示并按历史预测操作原语
对象检测先决定哪些实体进入token序列,策略再持续以交叉注意力读取提示。检测器成本与原语执行能力因此不能从示范学习预算中消失。
输入:带多模态提示的专家轨迹、对象检测器、T5 提示编码器
训练:
  取一个批次的提示与观测—动作序列
  将文本、单物体图和场景对象分别编码
  在观测对象集合中随机加入伪检测对象
  交替处理历史自注意力与对提示的交叉注意力
  预测各步专家动作的离散分布
  最小化专家动作的负对数似然
  用独立验证集动作准确率选择检查点
执行:
  编码任务提示
  重复:
    检测当前图像中的对象,加入交互历史
    查询提示并预测下一操作位姿
    用既定动作原语执行,取得新观测
  直到环境成功、失败或达到任务步数限制
以下是教学伪代码,省略网络层细节:
四、逐级检查提示泛化而不只看L4平均
四级泛化改变的因素不同。L4平均分尤其需要逐任务展开,否则全成功与全失败混合后会被误读成普遍拥有中等能力。
实验支持的结论是:在 VIMA-Bench 的程序生成仿真桌面任务中,这种对象表示和提示连接方式,比论文改造的几种 Transformer 基线更容易泛化。但最困难的新任务平均分掩盖了明显分化:部分任务几乎全成功,另一些仍为零。
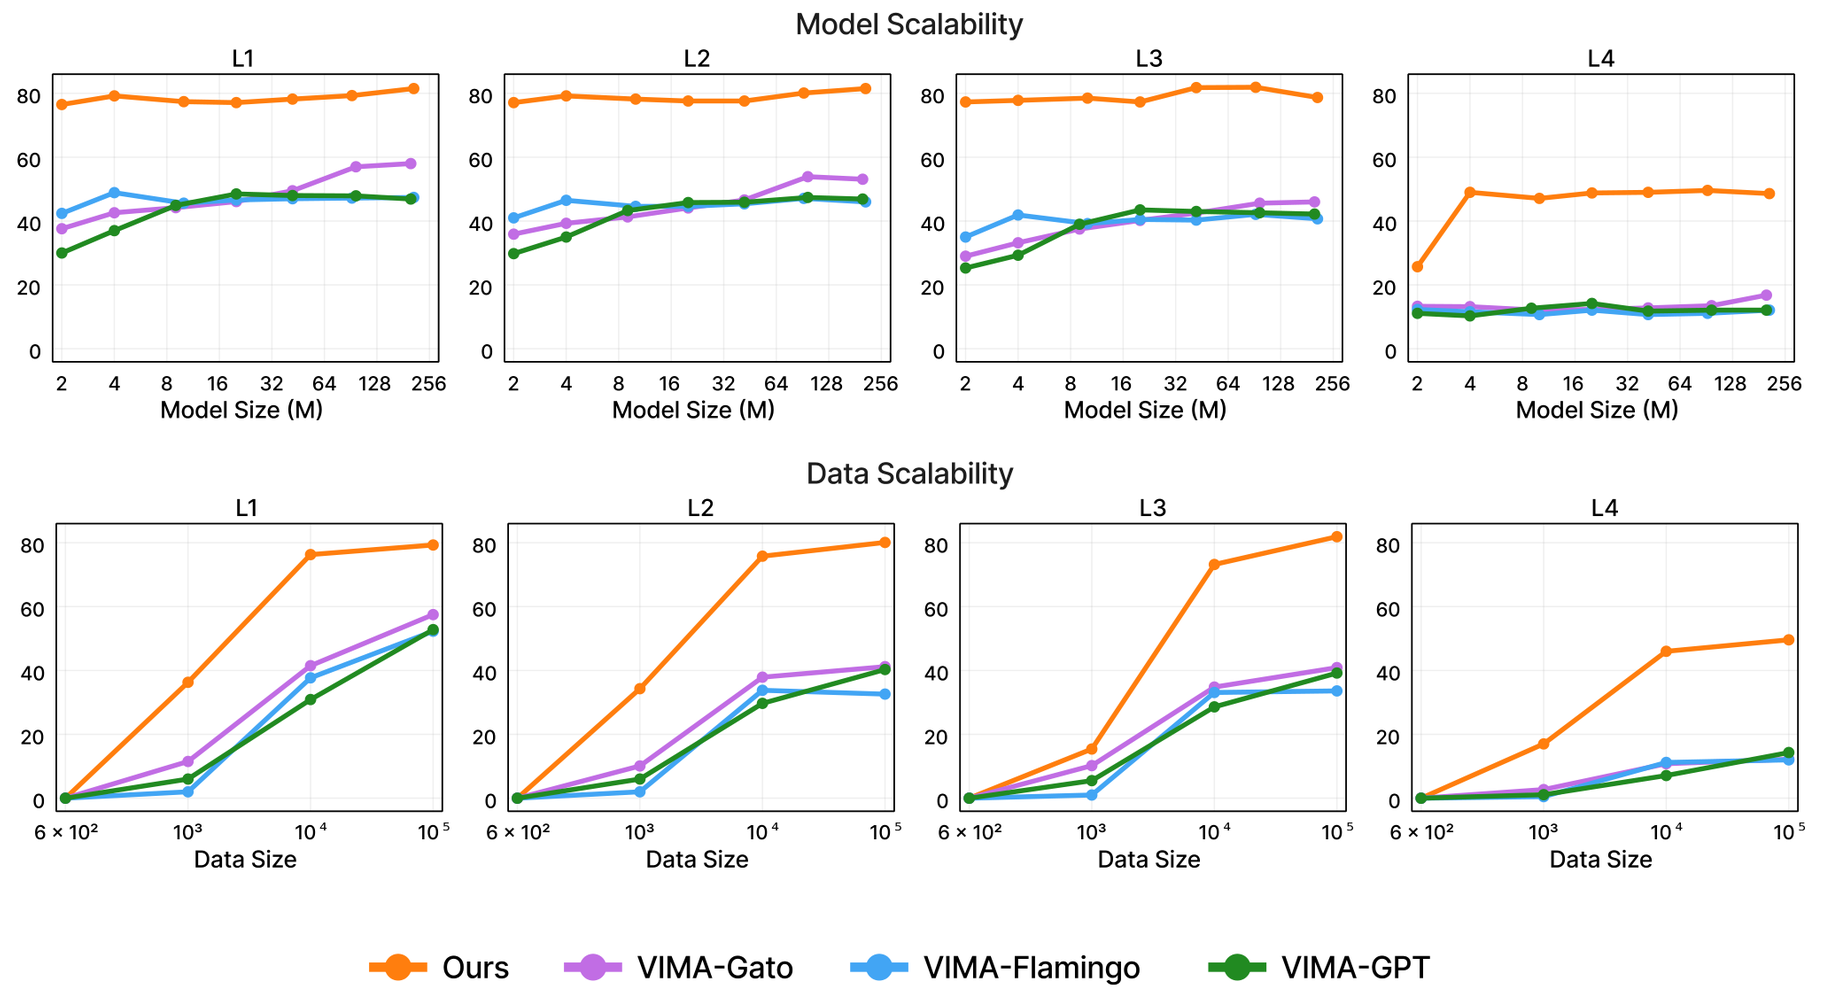
原图怎么读: 图4,原论文图注与图像。上排改变模型规模,下排固定模型后改变示范数据比例。沿同一排比较才能区分容量和数据量,且每一泛化等级有不同留出条件。
原文标注 CC BY 4.0。本页摘图仅保留图形区域并作栅格化;有面板重排的图另行注明,作者与原文入口见各图注。
| 项目 | 原文设置与解释 |
|---|---|
| 环境 | VIMA-Bench 仿真桌面操作;没有真实机器人实验 |
| 策略数据 | 13 个训练模板、约 65 万成功专家轨迹;程序专家可访问仿真信息 |
| 检测器数据 | 每任务100条轨迹的子集,22,741张图、61,822个标注;域内微调10轮 |
| 方法基线 | VIMA-Gato、VIMA-Flamingo、VIMA-GPT,是为同一接口重新实现的架构变体 |
| 容量扫描 | 控制部分2M至200M、七个尺寸;不计固定的111M T5-Base |
| 数据扫描 | 固定92M,使用0.1%、1%、10%、100%示范数据 |
| 优化 | AdamW;表7学习率 、warmup 7K、余弦调度17K |
| 算力 | 附录E.1:每节点8张V100,最大单项实验约一天 |
| 选模与指标 | 独立验证集聚合动作准确率选检查点;最终报告模拟器任务成功率 |
| 重复与不确定性 | 本文未确认独立训练种子数及完整置信区间,不能把表格小数当作稳定性证明 |
同控制器参数量不代表同整套系统参数,也不意味着所有表示拥有同样的监督信号。数据规模实验中,像素基线使用 MVP 预训练 ViT,并在与检测器相同的域内图像上进行 MAE 微调。这是作者减少预训练信息差的尝试,但检测框监督与图像重建仍是不同训练任务。
另一个容易误读的地方是“击败 Gato”:这里比较的是 VIMA-Gato 变体,不是直接运行上一章原始 Gato 的全部预训练模型。它支持架构设计比较,不能据此排列两个基础模型在所有领域的能力。
五处证据:平均数之外还剩什么
图4与表10:容量和表示。 在200M控制器下,L1成功率为81.5%,VIMA-Gato为58.0%,绝对差23.5个百分点;L4为48.6%对16.8%。这支持在这一基准与配置中对象策略的优势。但 VIMA 的 L4 从4M的49.0%到200M的48.6%并没有单调提高,不能把图写成无条件的规模定律。
附录E.2:宣传倍率的分母。 作者对20M的L4用48.8%与VIMA-Gato的12.3%计算“2.9倍提升”。其计算是 ,表示相对增加约297%;结果本身约为基线3.97倍。它不是“成功率是基线2.9倍”。此外表10同尺寸VIMA-GPT为14.2%,高于12.3%;因此这项宣传使用的是指定VIMA-Gato比较对象,不能称为该单元格所有基线中的最强者。
表11与附录E.3:少数据的结果。 10%数据的VIMA在L4为46.0%,全数据VIMA-Gato为12.2%。差33.8个百分点,相对增加约277%,结果比值约3.77。论文“2.7倍提升”同样使用差值除基线的口径。减少的是行为克隆数据,不代表检测器和语言预训练数据也同步减少十倍。
图6、图7:模块消融。 用真实边界框代替检测框的提升较小;把对象集合压缩为固定数量 Perceiver token 会损失性能。保持对象编码不变、改成仅拼接提示的因果解码器,较小模型和L4通常受损。前者支持保留细粒度对象信息,后者支持提示连接设计;“控制器更专注”是作者对现象的机制假说,不是已直接测量的因果解释。
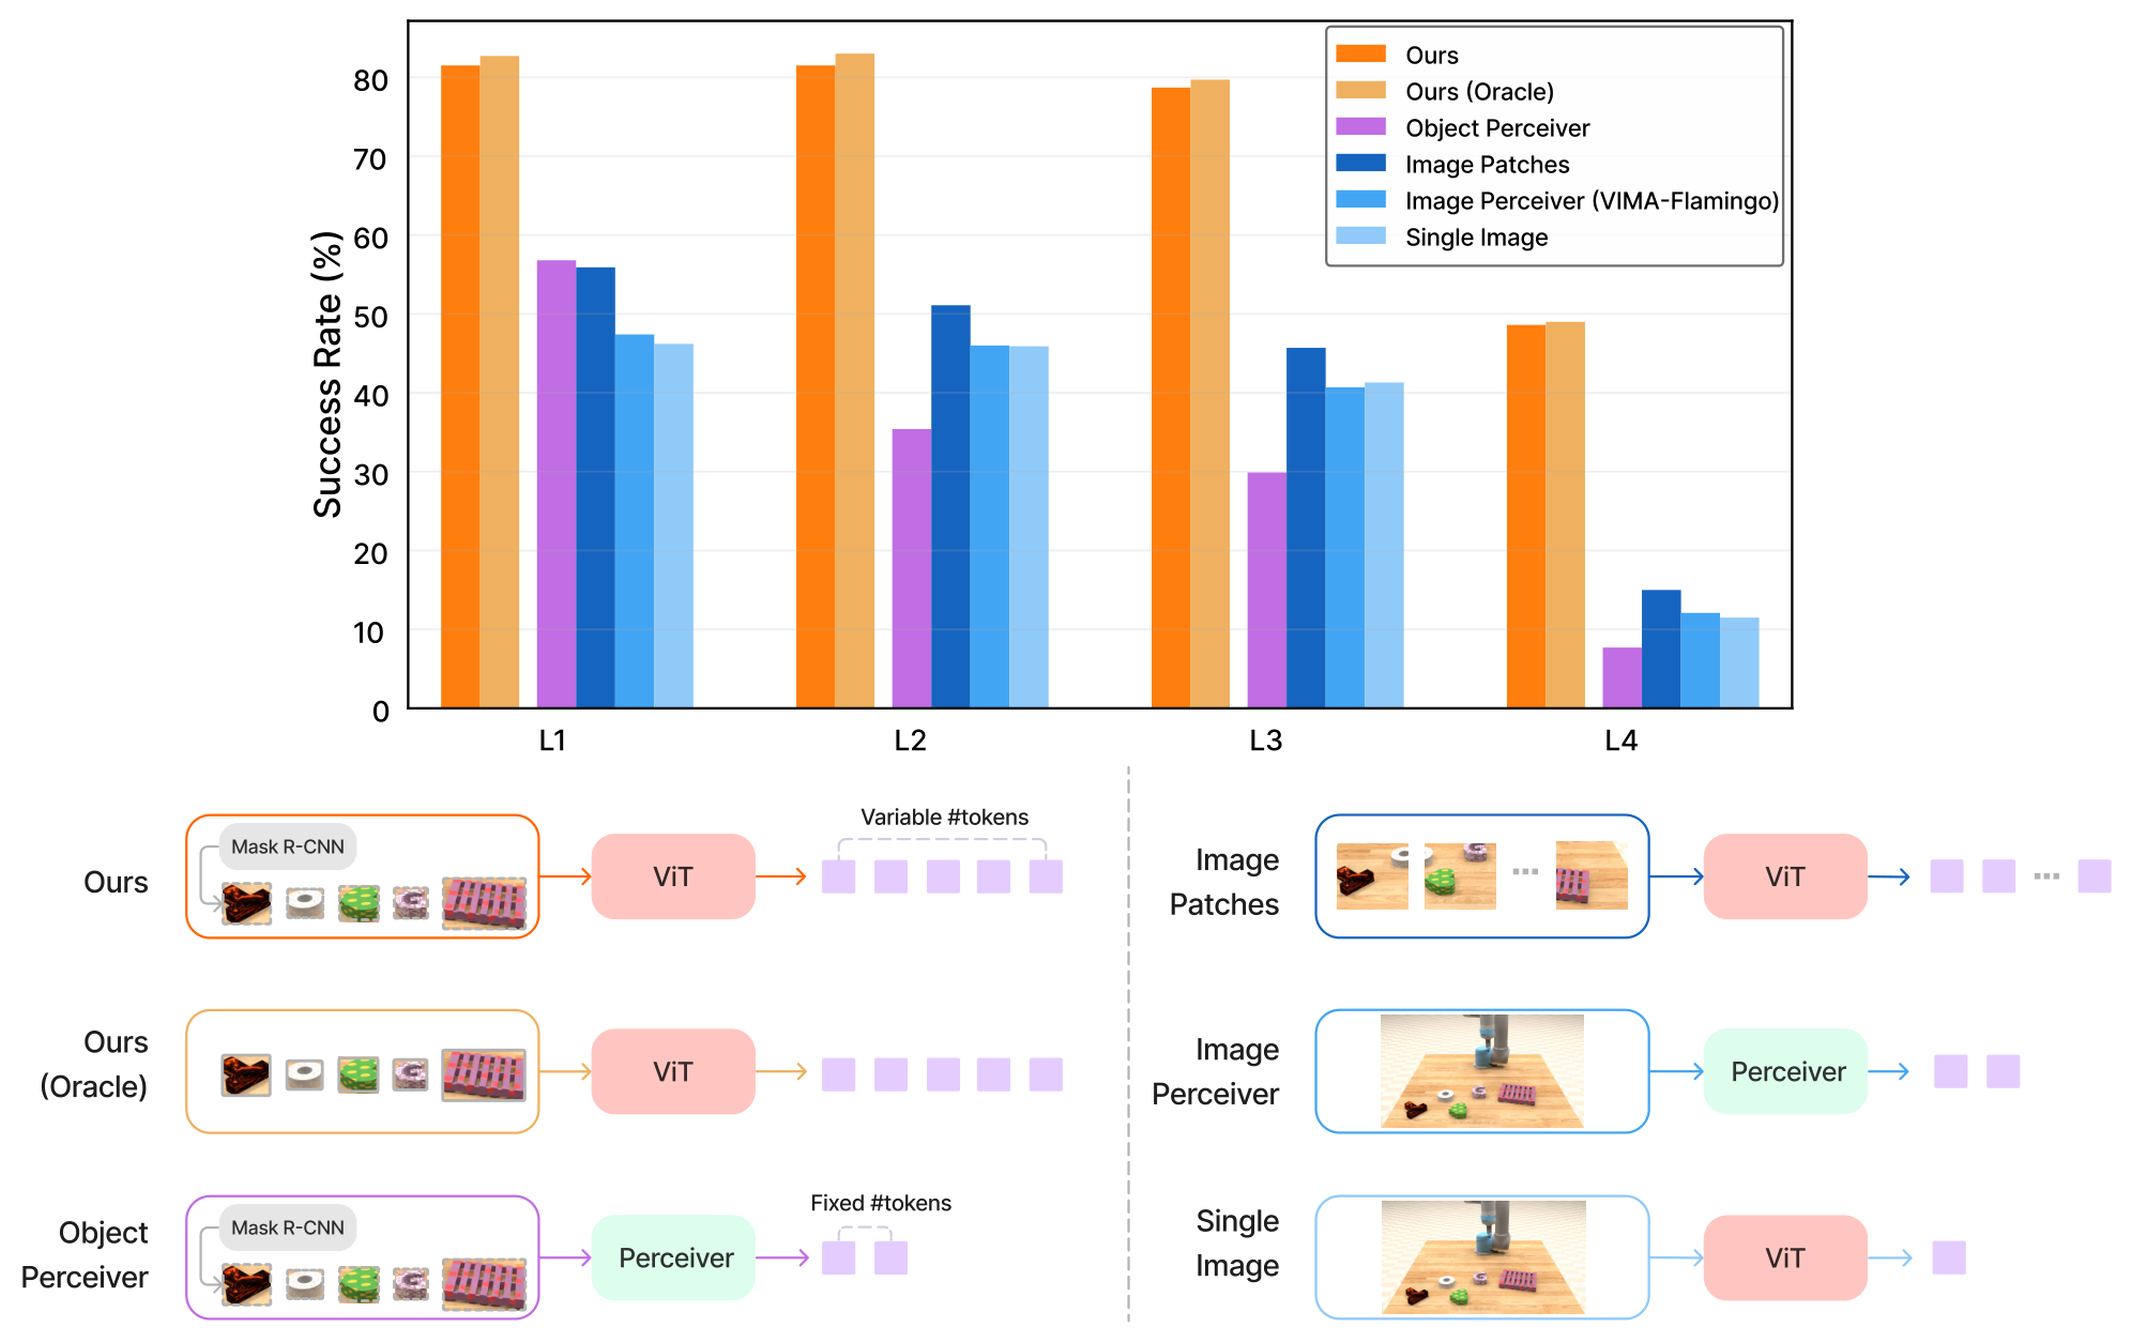
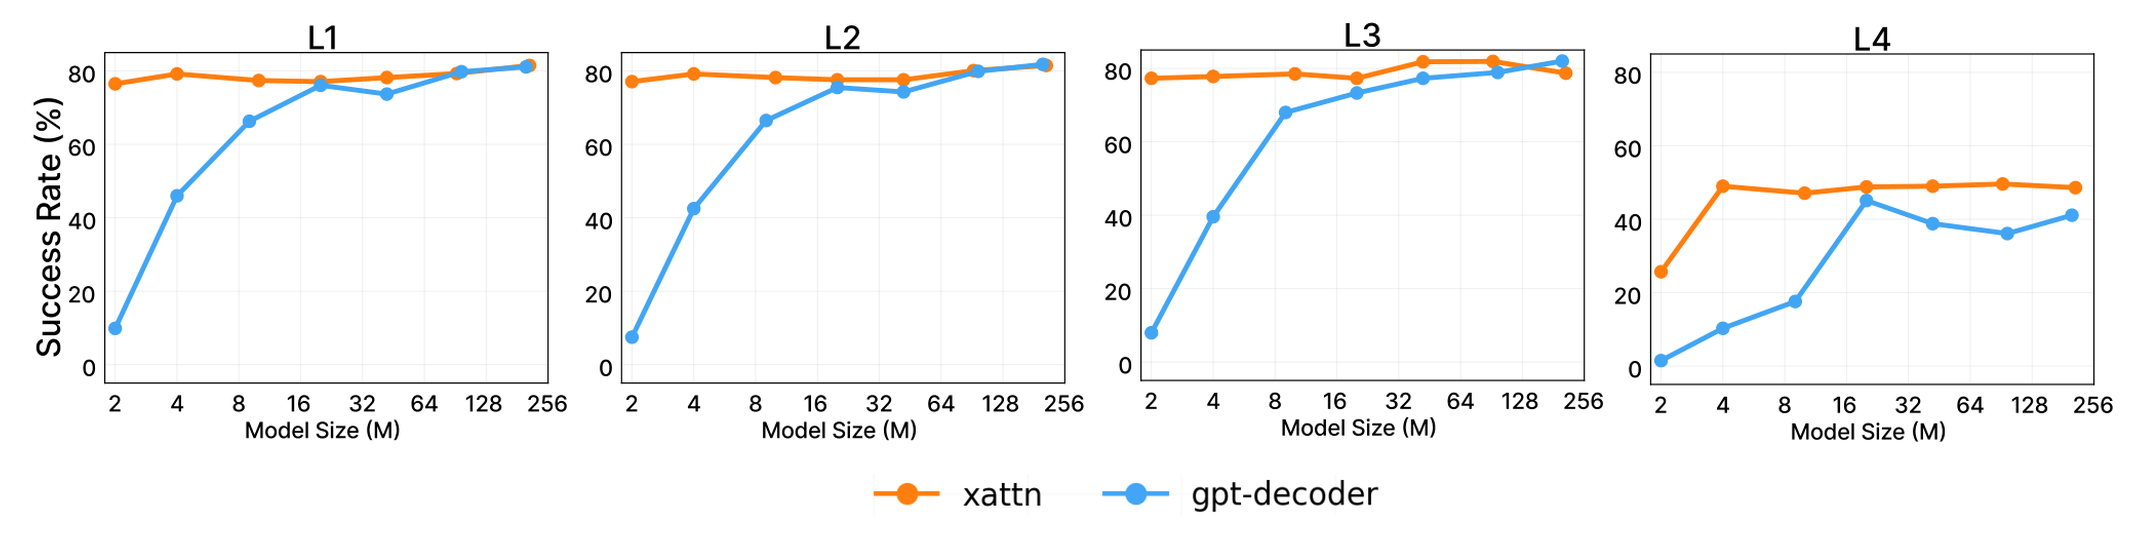
表19:L4成功并不均匀。 200M模型在四个留出模板08、10、13、14上分别为100%、0%、0%、94.5%,平均约48.6%。因此“接近一半的新任务成功”不能理解为所有新任务都完成了一半。这里有两种任务基本解决、两种任务完全未解决;扩展能力边界时这比总平均更重要。
以上定位对应原文正文及附录。这些是作者报告的实验,本文没有独立训练或复现。
五、检测器和动作原语限定现实迁移
作者在附录G承认对独立对象检测器的依赖、模拟器真实性和任务复杂度有限、动作原语受限。这些限制相互关联:原语承担接触执行,检测器承担对象分离,模板承担任务语法,策略专注于选择和组合。迁移到真实连续控制需要重新检查这三个边界,而不是只更换渲染器。
本文的进一步分析是:对象化既减少无关视觉变化,也可能丢弃接触面、柔性变形等重要信息。一个物体一个token对桌面选择很自然,对布料褶皱或螺纹啮合未必足够。此外,没有从失败中更新的离线策略仍可能积累闭环偏差;成功示范覆盖不等于错误恢复覆盖。
追问:对象检测漏掉干扰物时,增加提示长度能补救吗?
参考答案:如果当前观测表示已经删掉该物体,提示再完整也未必包含它在现实中的位置。应分别测试提示歧义、检测漏检和位置错误,记录任务选择与执行碰撞等不同后果。对象token的效率来自结构化筛选,也因此把检测覆盖变成策略的前置条件。
六、沿机制关系继续读
与One-Shot Imitation有教学联系:都把运行时上下文当任务说明,但本篇用多模态提示与对象表示;与RT-1是平行表示方案,检测槽位和软视觉token对错误来源有不同假设。
七、自测三题与参考答案
问题1:VIMA 的“零样本新任务”是否意味着没有使用任何机器人数据?
答案:不是。模型用大量机器人仿真示范训练,零样本指测试时对留出设置不再微调。还要进一步区分新摆放、新属性组合、新对象和新模板,四者的证据强度不同。
问题2:为什么对象 token 可能比图像 patch 更省示范,却未必省全部标注成本?
答案:对象表示把分割和定位的结构提前提供给策略,因此控制网络少学一部分视觉分解。但这些结构来自域内检测器及边界框标注。应把策略示范效率与整套系统监督成本分别核算。
问题3:L4平均48.6%能否证明四种新任务都有一定能力?
答案:不能。表19的200M结果为100%、0%、0%、94.5%。平均数反映这四项等权汇总,无法替代逐任务覆盖。若部署需要四类任务都可用,两项零成功是关键缺口;若只部署已成功的两类,则应进一步验证各自分布和执行边界。