076|Human2Humanoid:把人的全身运动映射到机器人
原论文:Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,Tairan He、Zhengyi Luo 等,2024,arXiv v1。论文。
先接住前作的问题
DeepMimic从姿态参考学物理反馈,但人体与真实人形的关节、质量和力矩不一致。Human2Humanoid先重定向,再用模拟跟踪筛选数据,追问形似动作怎样转成身体可执行的参考;不能把模拟角色结果直接当真机能力。
五个前置概念
五个前置概念:
- 运动重定向:把一个身体的动作映射到另一身体的可表达姿态。
- 正运动学:由关节角计算身体关键点位置。
- 特权信息:训练或筛选可用、部署不便获得的状态。
- 域随机化:在训练中变化动力学参数以提高迁移稳健性。
- MPJPE:关键点位置误差平均值,需注明坐标与单位。
一、问题设定:人类运动怎样变成机器人可跟踪的参考
人类动作捕捉中有大量走路、挥手和踢腿,但人体与人形机器人的质量、关节和力矩上限不同。直接把人体姿势变成机器人关节角,可能得到形似却会跌倒的动作。
H2O 是目标条件强化学习,动作目标来自人的姿态,低层关节目标由策略产生。人决定“做什么动作”,策略解决“在机器人动力学下怎样跟踪且不倒”。
训练在模拟中完成,使用 PPO 和动作跟踪奖励,再迁移真实 H1。19维动作是关节位置目标,PD控制器转换为力矩。它不是视觉语言模型,也不是直接从RGB图像端到端输出19个电机命令:先有人体姿态估计与几何表示。
机器人观察包含关节位置速度、根部速度与角速度、投影重力、上一动作。目标以选定身体关键点及相关差值、速度表达。训练时可使用更完整的身体真值计算奖励,部署策略输入不需要同样完整的真值。
终止条件包括躯干过低、倾斜过大或跟踪误差过大。奖励既鼓励动作相似,也惩罚越界、力矩、急剧变化与打滑;因此“模仿”不是纯监督回归,而是在环境中学习受动力学约束的行为。设定:§III、V。
二、分开形体重定向、可行性筛选与部署策略
H2O 先做运动重定向,再用模拟中的强跟踪策略筛掉难以执行的动作,最后训练能用真实传感器信息工作的全身跟踪策略。部署时人对着相机动作,机器人在线跟随。
1. 形体拟合与运动重定向
先调整 SMPL 人体形状,使对应关键点结构更接近 H1,再优化机器人姿态匹配选定人体点。教学形式为:
是机器人正运动学,是已调整形体后的参考点。它解决的是几何对应,不保证速度、力矩和接触可行。
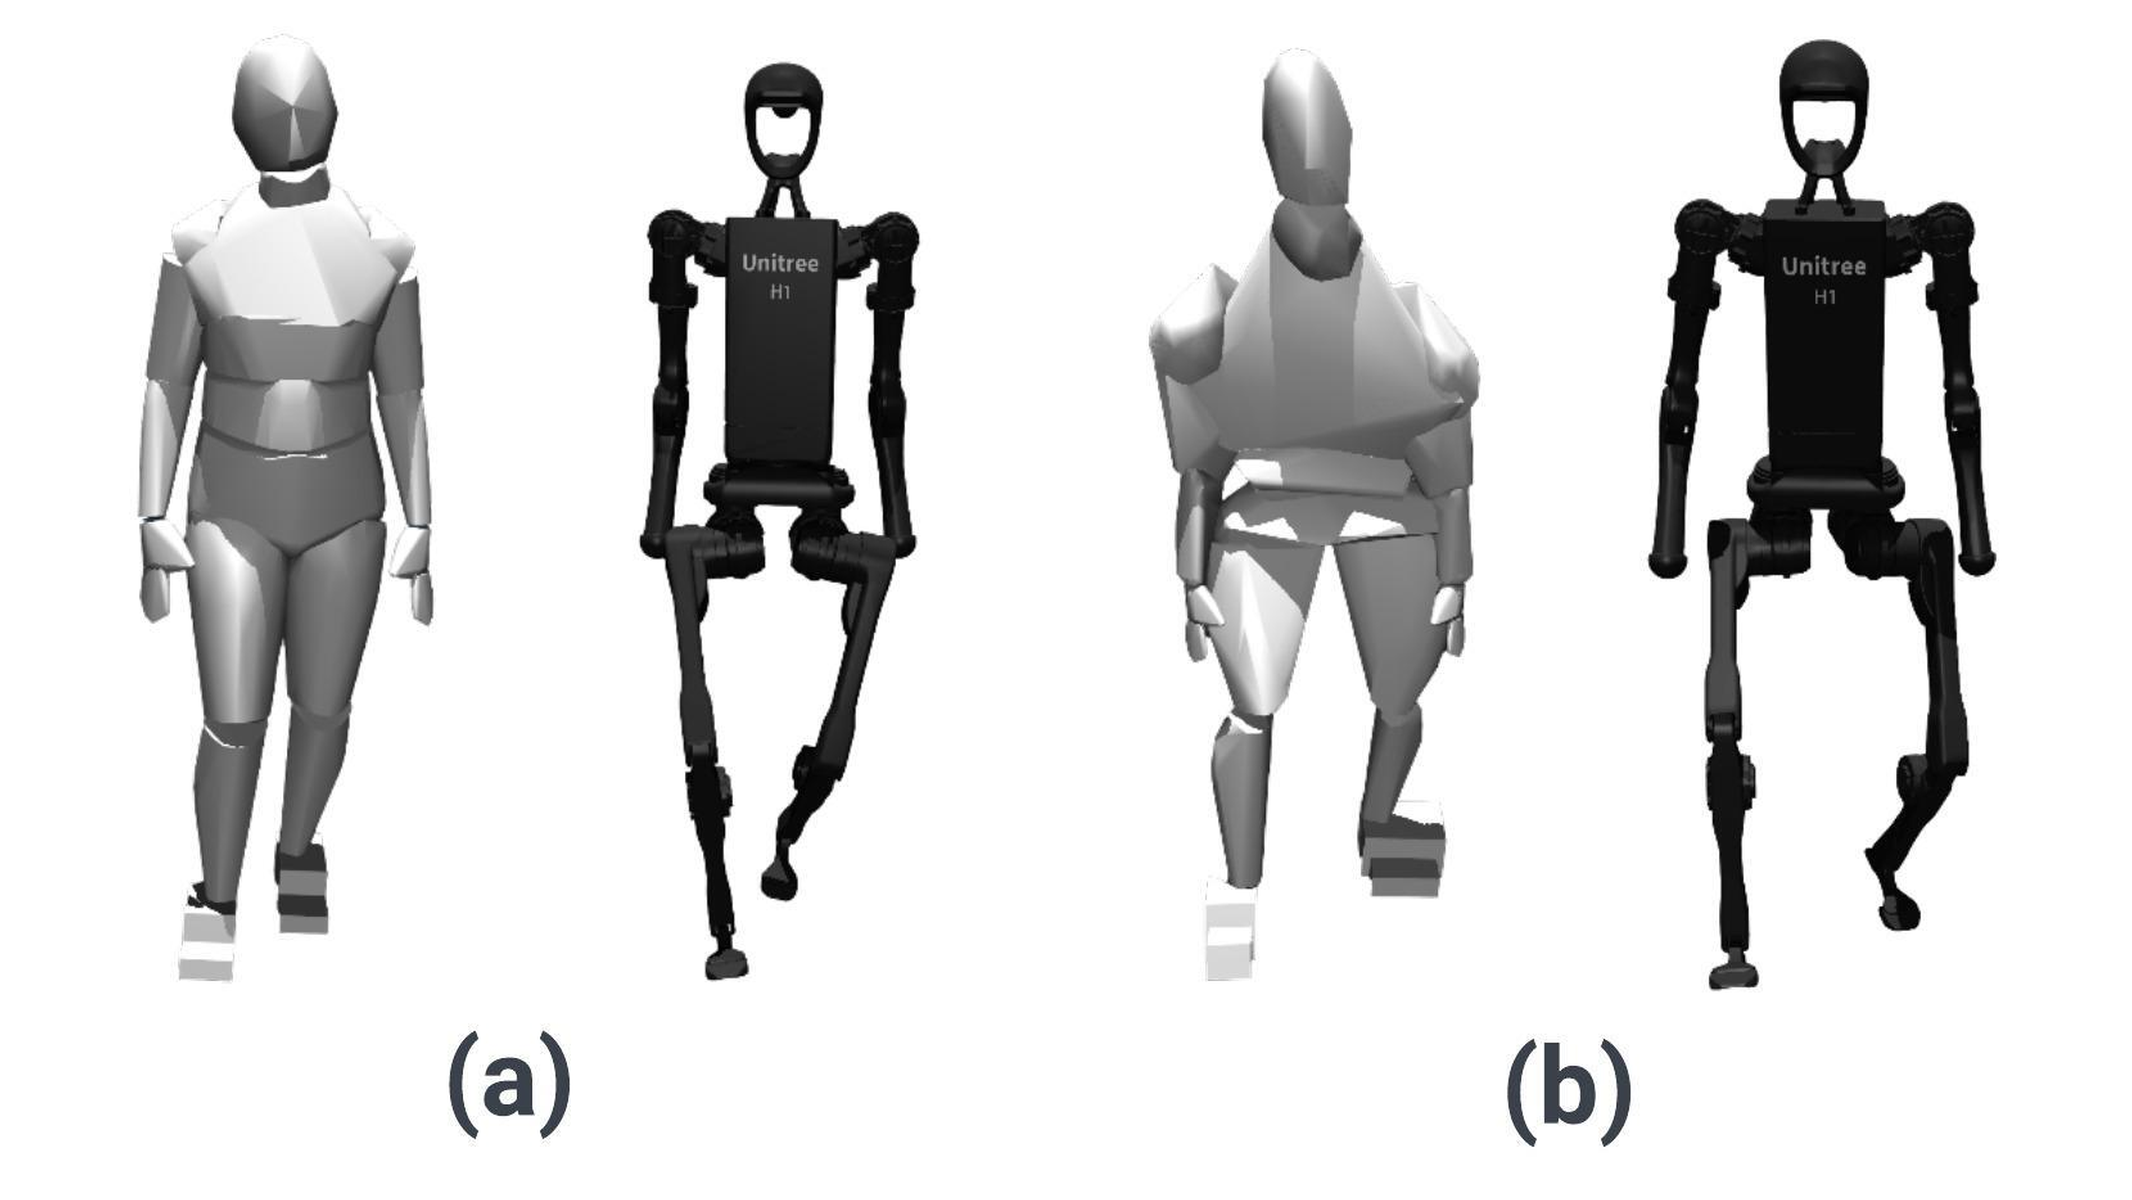
直接复制关节角的问题,在于两棵运动链的轴方向与长度不同。即使肩肘角相同,手可能落到不同位置;足部初始间距不合适,还可能产生内八姿态。
2. sim-to-data 的筛选器
一个有完整刚体状态、没有域随机化负担的特权策略,尝试跟踪重定向动作。失败片段被丢弃,留下较容易由该机器人执行的集合。
这不是教师动作蒸馏:特权策略主要用于判断哪些参考应保留;后续部署策略再通过 RL 训练跟踪这些参考。论文约1万条重定向序列保留约8500条。
作者将特权跟踪器视作性能上界。更谨慎的理解是它是一个较强的经验筛选器:优化失败不等于物理不可行,成功也不保证现实可行。数据清洗可能把真正困难但可实现的技能排除,这是一种能力与数据之间的循环依赖。
3. 面向实时部署的目标状态
完整部署目标使用肩、肘、手、踝共8点的参考位置、相对误差与参考速度。与只给位置的版本相比,这些量帮助区分“目标在哪里”和“目标正在往哪里走”。
PD形式为:
PPO优化:
例如动作变化惩罚鼓励平滑,但过强会延迟快速踢腿;跟踪与稳健之间确实有竞争关系。系数是工程选择,不是越大越好。
4. 域随机化解决另一种误差
训练随机化摩擦、质量、质心、PD增益和控制延迟,并施加扰动与不同地面。重定向解决人体—机器人几何差异,随机化解决模拟—现实动力学差异,二者不是同一类“泛化技巧”。
伪代码中的实时目标只有当前可获得信息;不能把模拟特权跟踪器访问的未来参考和完整全身速度照搬到现实策略。
过滤可执行动作也会改变技能频率。教学设原数据慢动作、快动作各50条,经验跟踪器分别保留45条与5条,留下的数据就有90%慢动作。后续在这批数据上成功率很高,可能同时来自策略改善和任务变容易,需对原始集合与过滤集合分别报告覆盖。
这不否定过滤价值:训练资源确实不应被明显超限动作耗尽。但“特权策略没学会”与“机器人绝无可能执行”不同。一个更强跟踪器、不同终止阈值或更长优化预算可能改变保留名单;因而筛选策略本身也是数据集定义的一部分。原文sim-to-data与特权跟踪器
自构例子与知识连接
教学例子,未运行。 人抬右脚踢球,人体较长的小腿让脚尖能到达某高度。机器人腿短,直接复制角度达不到;几何优化为了赶到该位置,可能要求极限关节角。再加入快速加速度,电机力矩可能不足。几何重定向、动态跟踪和现实执行依次增加约束。
若目标脚位置正在左移,仅给当前位置时,策略不知道下一瞬间该向哪边准备;加上速度有助于提前调整。但速度由有噪声视频差分得到,过度依赖也可能放大抖动。这解释了更丰富目标状态的收益与现实代价。
设身体各点相对根部姿势都正确,却整体向后漂了20厘米。根相对MPJPE可很小,全局MPJPE仍大。接触球或柜门时,全局位置比“动作看起来像”更关键。
三、先筛选重定向运动,再训练可部署跟踪
特权跟踪器先判断候选参考能否被当前流程执行,部署策略则只用允许的目标与本体信息。筛选成功不等于给真实机器人直接复制教师动作。
离线:
    使人体模型形体接近机器人
    重定向人体动作到机器人关键点与关节参考
    去除明显不适合的动作
    用完整模拟状态训练特权跟踪器
    用它过滤跟踪失败序列

部署策略训练:
    采样保留的参考动作
    随机化机器人与地面参数
    输入可部署本体状态和当前目标关键点信息
    用PPO优化跟踪、平滑、约束奖励
    发生跌倒或大误差时终止并重新采样

实时:
    RGB捕捉人 → 人体姿态估计 → 目标关键点
    机器人状态估计 + 目标 → 关节目标 → PD控制
四、从模拟跟踪逐级核对到真实展示
作者展示了真实 H1 的动态遥操作。这里“RGB相机”指捕捉操作者的入口;实际机器人线速度估计还使用外部动捕,并非整个系统只有一台相机。
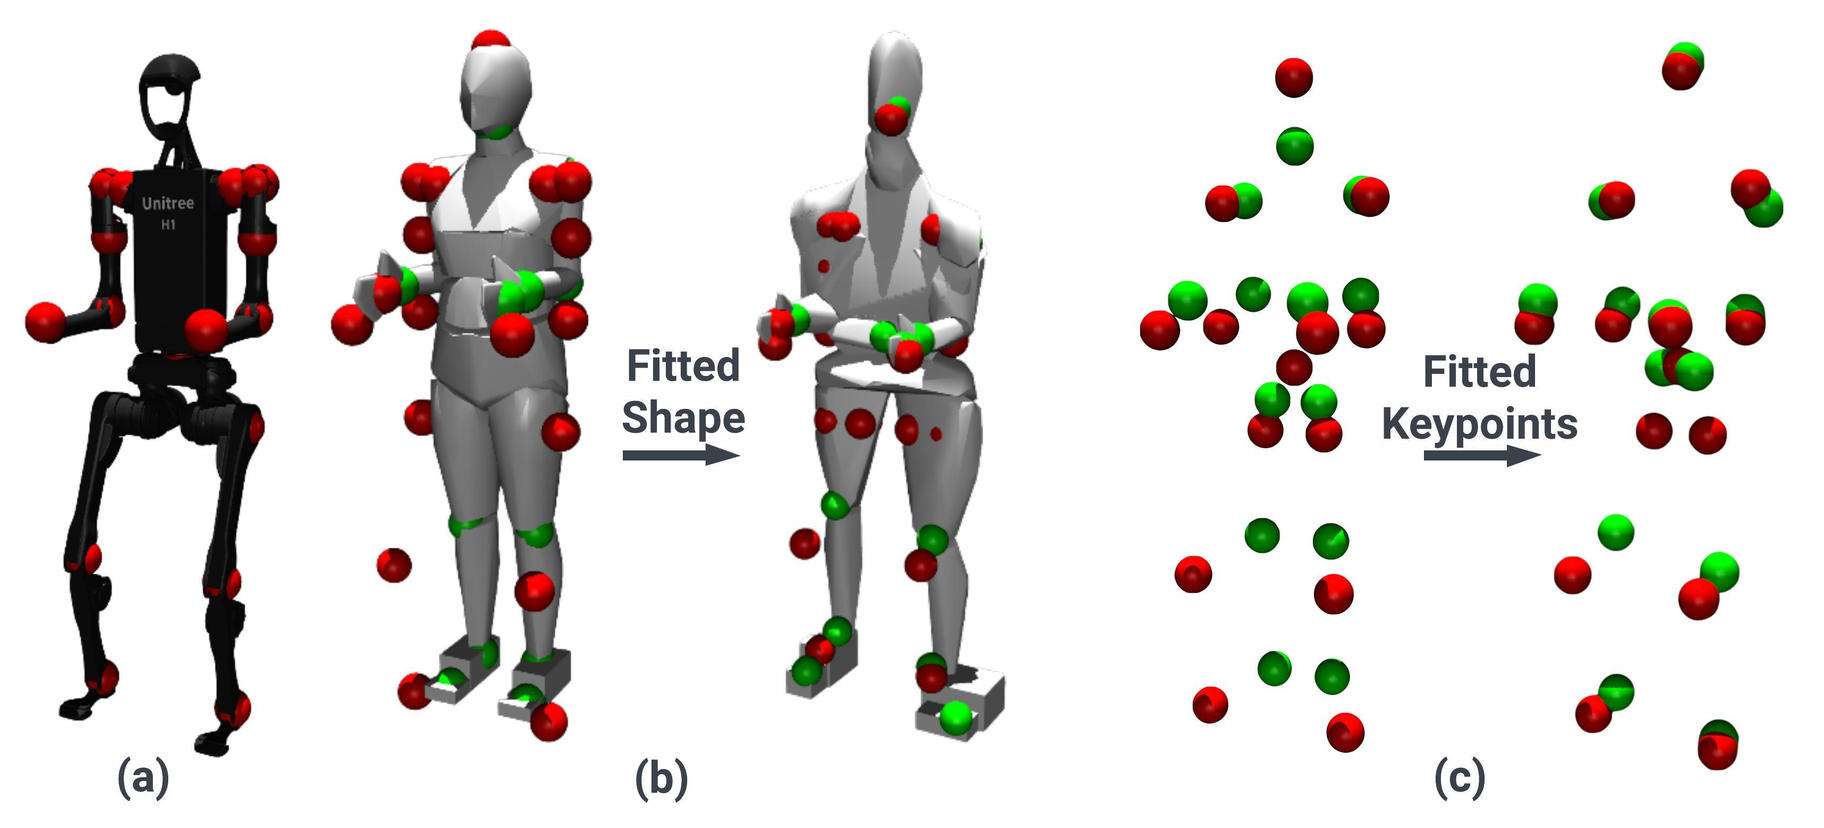
原图怎么读: 图2,原论文图注与图像。红点标出机器人关键点,绿色点与网格对应人体模型;比较拟合前后关键点关系,才能理解重定向怎样处理身体比例而非直接复制关节角。
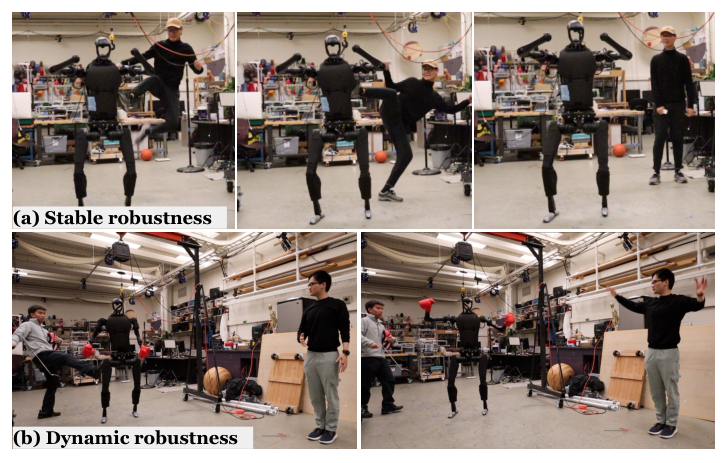
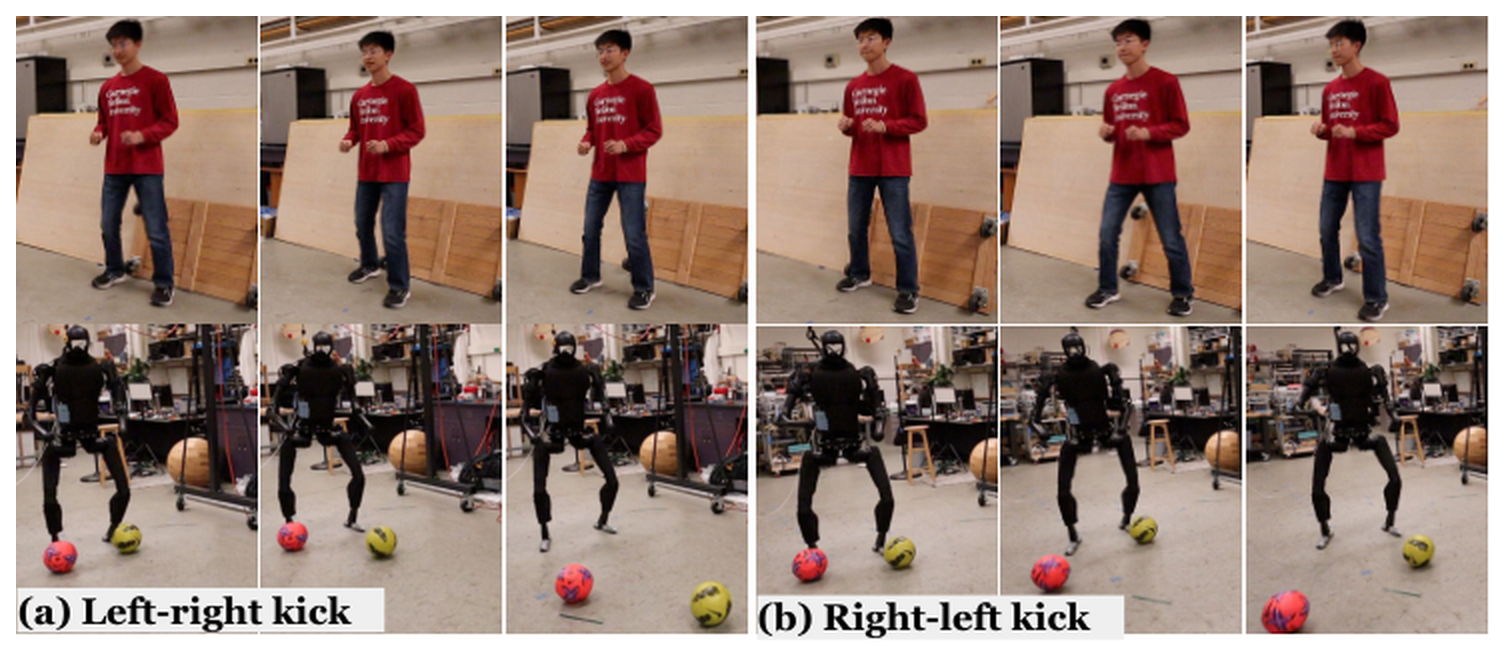
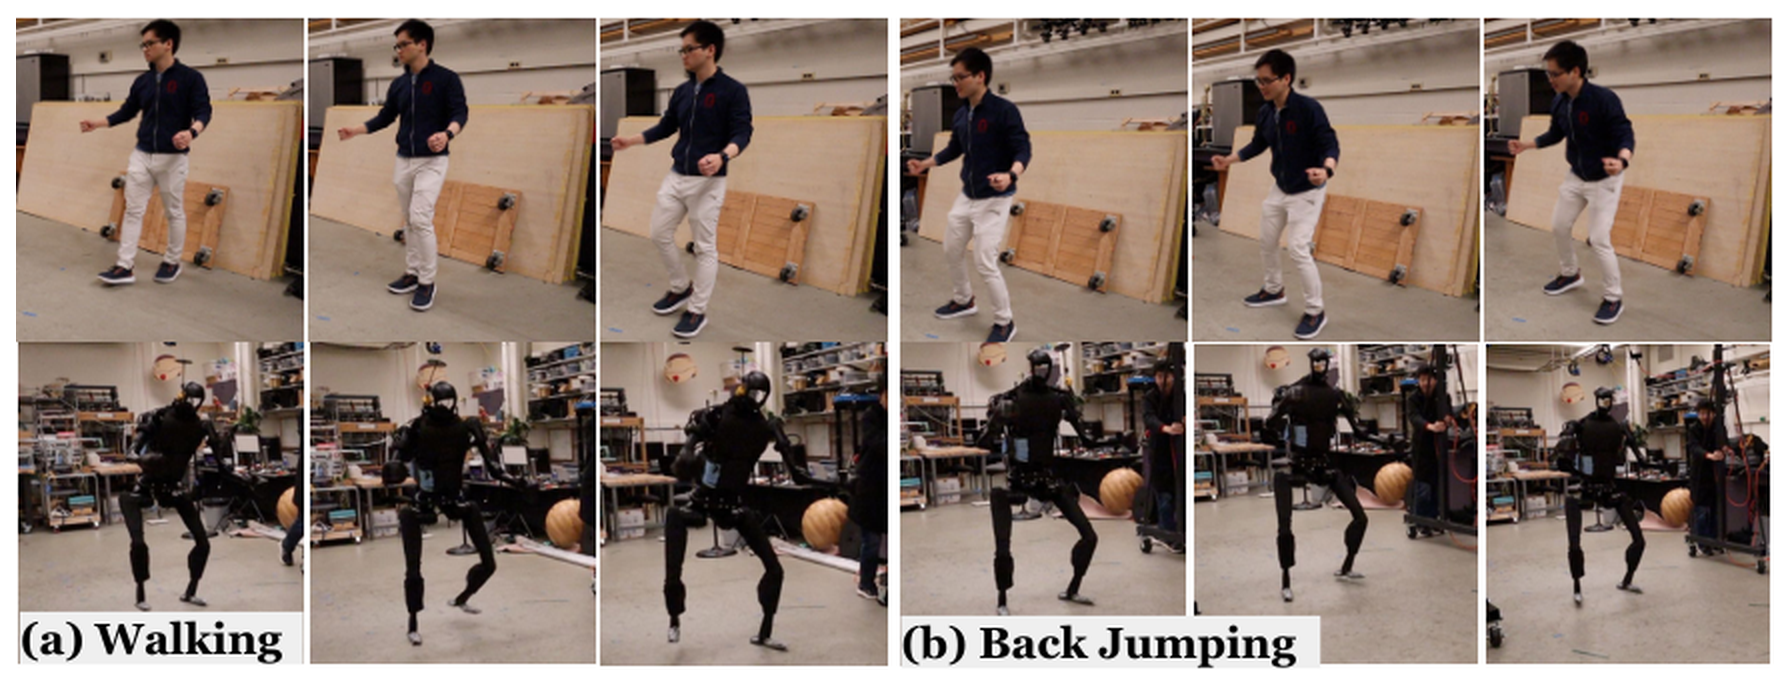
结果图怎么读: 图7补上真机受扰序列:沿踢击前、接触、恢复的连续帧看身体是否保持平衡,并区分静止和动态遥操作条件。它提供抗扰行为实例,没有给出可推广到任意冲击强度的成功率统计。
| 项目 | 原文设置 | 评价问题 |
|---|---|---|
| 人体来源 | AMASS,约1.3万原始序列,重定向约1万 | 动作库如何转为机器人参考 |
| 清洗后 | 约8500条 | 删去难跟踪动作是否帮助训练 |
| 模拟比较 | 特权策略、去清洗、简化目标、完整H2O | 状态设计与筛选的作用 |
| 评估集合 | 未清洗的重定向约1万条 | 不是仅在筛选成功集合上测试 |
| 成功条件 | 跟踪过程中身体平均位置误差不超过0.5米阈值 | 不是精细操作成功 |
| 误差 | 全局与根相对MPJPE,速度、加速度差 | 区分漂移与身体姿态误差 |
| 部署平台 | Unitree H1,RGB人体估计30Hz | 操作者视觉输入的频率 |
| 机器人估计 | 动捕线速度50Hz,其余内置传感器200Hz | 全系统并非纯RGB |
| 未逐项核实 | 总模拟步数、训练GPU时间、种子数、真实各动作重复次数 | 不推断统计稳定性或训练效率 |
表II 给出例如20–60ms控制延迟随机化。这个范围描述训练扰动,不等于实测端到端遥操作延迟。RGB估计频率也不能自动当作机器人底层伺服频率。
评估集合包含训练动作,因此总体成绩主要衡量大动作库覆盖与跟踪能力,并不是严格的全部未见动作测试。随机取小训练子集后的全库评估,才更接近部分未见参考的泛化问题,但仍不能替代明确的动作类别留出。
五处证据:从模拟跟踪到真实展示
证据1:图2/3的形体拟合。 调整人体形状后,重定向减少足部内八等异常。它支持几何对齐的重要性,但主要是例子,不是所有人体体型都适用的统计保证。
证据2:表III 的清洗消融。 完整 H2O 成功率72.5%,不清洗67.9%,增加4.6个百分点,相对约6.8%。评估仍用未清洗集合,这是有意义的控制条件:不是简单通过删除困难测试让分数变高。但数据量与数据难度一同改变,不能只说“数量越少越好”。
证据3:表III 的观察权限。 特权策略85.5%高于H2O,同时其输入778维,部署版本138维,且训练随机化条件不同。不能据此说部署版本算法更弱;现实可获取的信息和稳健要求改变了问题。简化目标版本53.2%也支持误差与速度信息有价值。
证据4:表IV 的规模。 从小比例动作到完整清洗库,成功率整体上升。它支持更多可用动作增加覆盖,却没有证明动作数与性能遵循固定规模定律;重复动作、多样性和训练预算都可能影响结果。
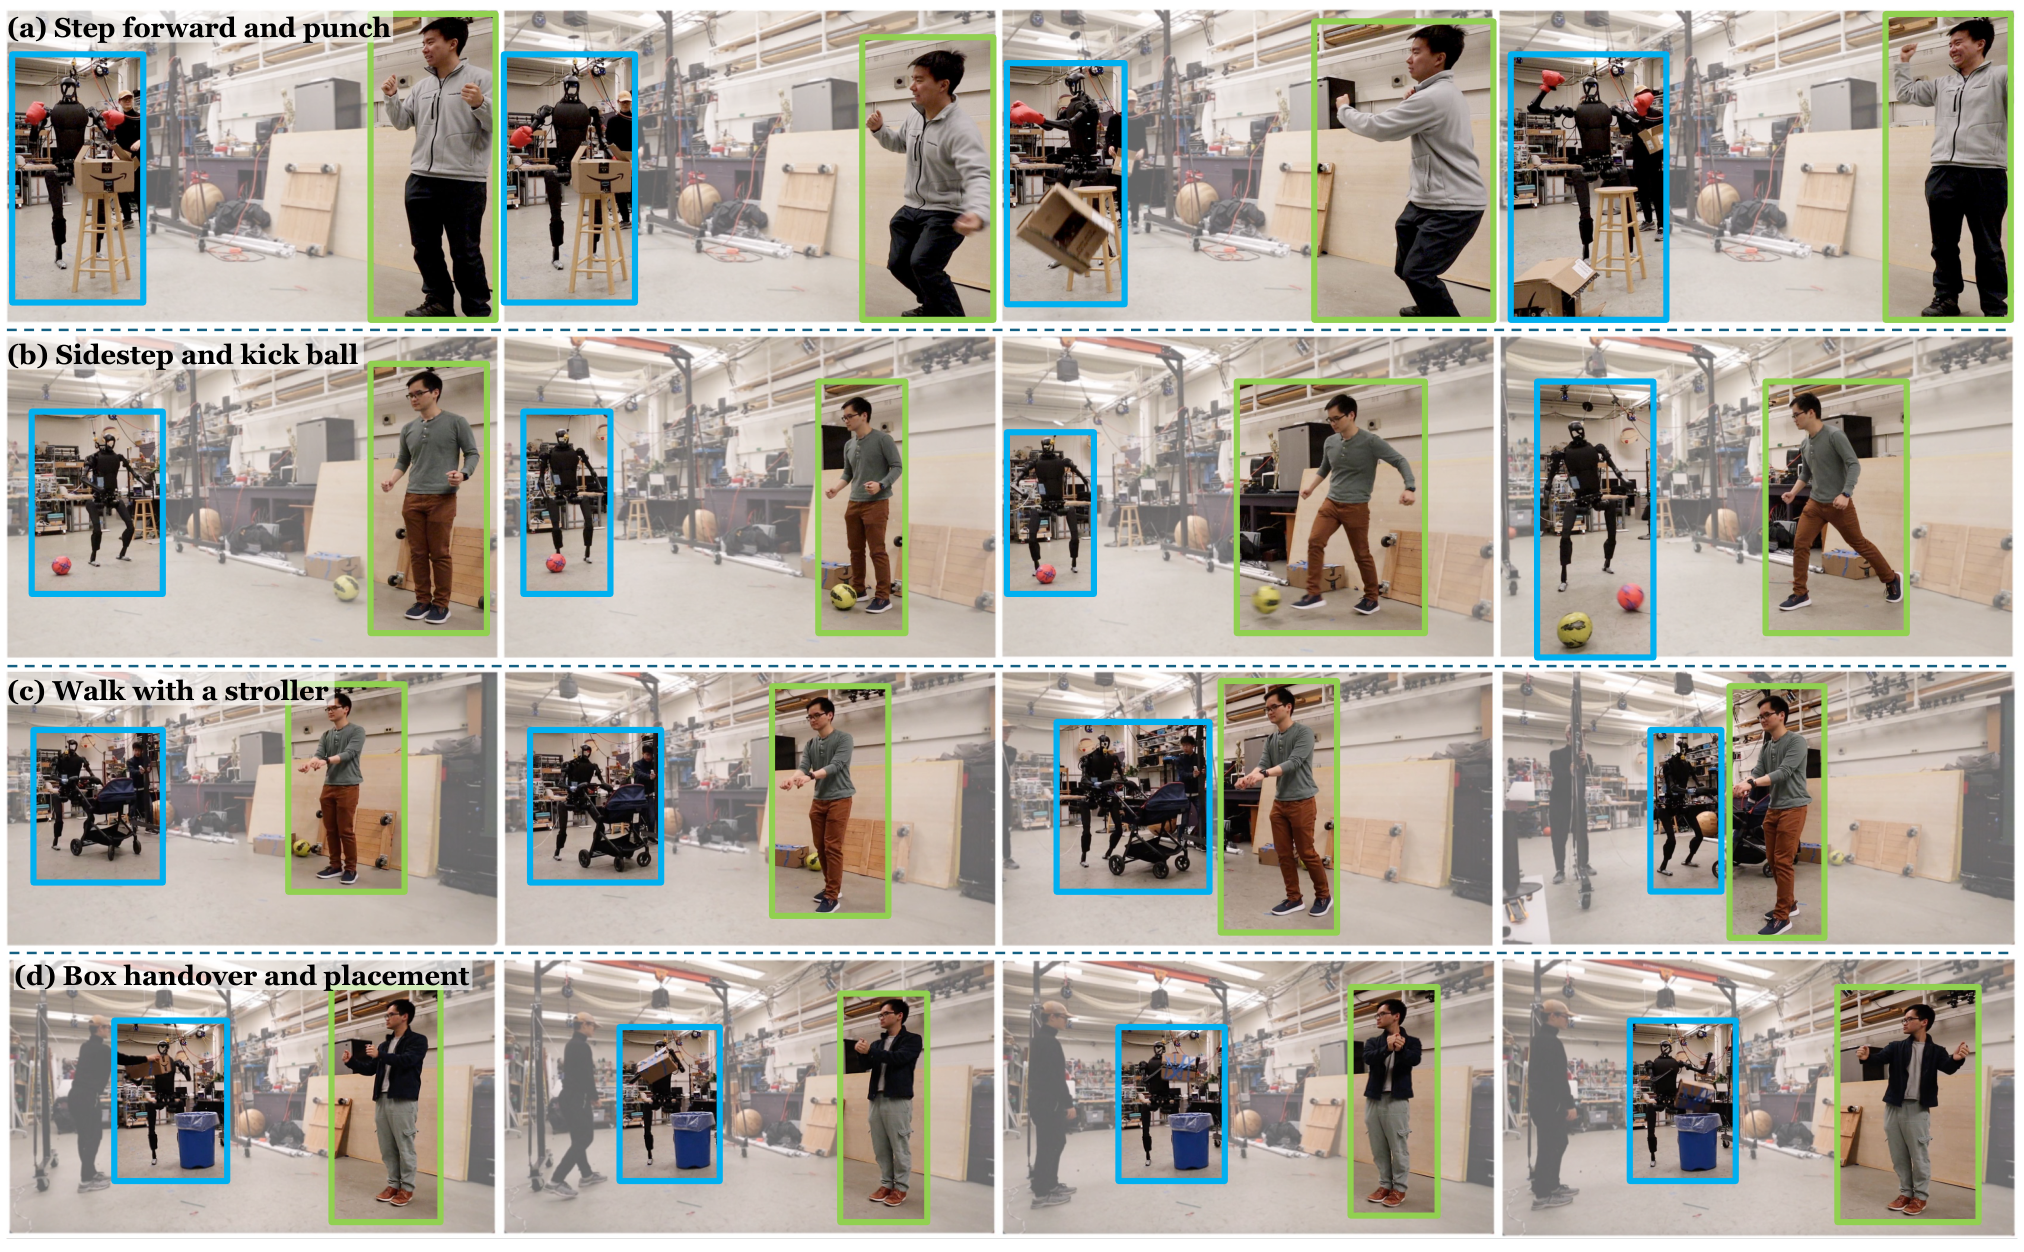
证据5:图1、5–7的真实遥操作。 展示踢球、行走、后跳以及扰动下保持平衡。它证明系统可在真机运行这些行为,但缺少逐任务大样本成功率时,不能给踢球或接箱等能力编出可靠率。真实物体任务由人提供实时目标,不是机器人自主视觉规划。结果与部署:§VI。
表中 MPJPE 的毫米与速度误差的毫米/帧不能混用。根相对误差小可能同时存在较大全局漂移,两个坐标指标必须一起看。
五、筛选器能力不等于身体可行性的全集
作者承认表示维数与学习难度、随机化与跟踪精度、人体姿态估计延迟与精度之间都有折中。实时人类反馈主要依赖视觉,缺乏细致力反馈,也会限制接触操作。
本文分析的另一点是:若筛选器从未学会高动态动作,就可能持续把这些动作视作不适合。要区分“物理不可能”与“训练尚未成功”,可以用不同优化方法、专门单动作训练或轨迹优化复核被删序列。现有实验不提供严格可行性证明。
“无需操作者穿戴标记”是准确的接口特点;“没有外部状态估计设备”则不符合部署段。作者提到机载视觉或激光里程计可替换动捕,是可探索方向,不是已经在本文验证的配置。
追问:筛选掉大量难动作后,平均跟踪误差下降应怎样解释?
参考答案:它可能来自评估集合更容易,而不只是控制器更好。应在共同动作集合上比较跟踪,并另报被筛除的比例、类型和原因。筛选器有局限时,被拒绝动作只表示当前流程未能处理,不证明机器人物理上不可能完成。数据覆盖与跟踪质量需要一起报告。
六、沿机制关系继续读
本篇与DeepMimic有历史关联,将参考动作跟踪问题推进到人形机器人,新增形体重定向与经验可行性过滤;后作ASAP继续处理实机动力学差距,两者不应合称同一种动作重定向。
七、自测三题与参考答案
问题1:H2O的特权策略是部署策略的动作教师吗?
答案:核心用途是筛选参考动作是否容易跟踪,之后部署策略用清洗后的参考重新做RL训练。不能把它简化成普通监督蒸馏;筛选对象主要是动作数据,而非只给学生每步动作标签。
问题2:一个动作被筛掉,是否证明H1物理上不可能完成?
答案:不证明。强跟踪器仍受模型、训练预算和优化限制。失败说明当前筛选条件下没跟上,可能是真实不可行,也可能只是策略尚未学会。需要额外可行性分析才能区分。
问题3:为什么“只用RGB遥操作”需要补充动捕条件?
答案:RGB用于估计人的动作;机器人还要知道自己的运动状态。本文用动捕估计机器人线速度,两者承担不同功能。说明这一点才能准确判断系统部署所需硬件,而不削弱它在人体输入接口上的贡献。