085|RDT-1B:双臂控制的扩散基础模型
原论文:RDT-1B: a Diffusion Foundation Model for Bimanual Manipulation,Songming Liu、Lingxuan Wu 等,2024。论文。
先接住前作的问题
Open X的共同格式仍保留动作语义差异;双臂生成还要保留两手之间的相关性。RDT把不同物理量放进明确槽位,用扩散Transformer学习动作块,研究怎样在共享经验中保留身体接口。
五个前置概念
五个前置概念:动作多模态表示一个状态下有多种合理行为;干净样本预测让扩散网络直接恢复动作;可用性掩码区分零值和缺失;交叉注意力让动作表示读取图像或语言;动作块吞吐统计生成动作条目,不能替代闭环频率。
一、问题设定:异构机器人经验怎样训练连续双臂动作
RDT-1B 想解决两类瓶颈。第一,双臂的可行动作常有多种模式,简单平均可能导致两只手都犹豫;第二,目标双臂数据少,但其他机器人的动作格式又不一样。
这是语言条件、视觉驱动的离线模仿学习。输入含两帧三视角图像、当前本体状态、语言和控制频率;输出为动作块。没有学习价值函数,没有通过在线环境奖励继续优化。
双臂动作维度大只是困难之一。真正棘手的是协作关系:一只手固定瓶子,另一只手拧盖,与两只手同时抢瓶子在局部位置上可能相近,任务意义却不同。
动作条件需要包含时间尺度。相同位移在 5 Hz 和 50 Hz 下意味着不同速度,控制频率输入使网络有机会区分数据来源。它不保证模型对任意频率都稳定,只是提供必要上下文。
二、对齐物理槽位并联合去噪动作块
它使用扩散 Transformer 生成连续动作块,并设计有物理含义的统一空间,让关节角、末端位移、速度等分别占据固定位置。先在多机器人数据预训练,再用目标双臂示范微调。
1. 统一格式不等于抹去物理意义
128 维向量为左右臂关节位置、关节速度、末端位置、旋转、速度、夹爪和底座等保留槽位。单臂映射到右臂部分;没有的变量填充,并附加可用性掩码。
为什么必须有掩码?“速度为零”和“没有速度传感器”不能用同一个零表达。编码前拼接 128 维可用性标记,能让模型区分缺失与静止。
论文统一米、弧度等单位,而非对每个数据集分别缩到相同区间。这保留跨数据集的尺度含义,但并没有自动对齐所有机器人的基座坐标与运动学。槽位语义一致是必要条件,不是完整的形态不变性证明。
2. 扩散直接预测干净动作
RDT 使用干净样本预测,而不是只预测噪声。教学形式为:
是动作块, 是噪声阶段, 是观测, 是语言, 是控制频率。虽然损失仍是 MSE,它与直接确定性回归不同:网络每次还条件于随机噪声样本,整体采样可以表示多个动作模式。
因此不能说“使用 MSE 就必然平均动作”。导致平均模式问题的是对多模态条件分布直接做单值预测,而不是所有出现平方误差的训练方法。
3. 不同模态怎样进入 Transformer
图像采用冻结 SigLIP,语言采用冻结 T5-XXL,低维状态、动作、频率经适配器编码。连续物理量使用包含 Fourier 特征的映射,旨在表示更细的变化。
网络交替在不同层注入图像和语言条件,避免图像 token 数量过多时语言被忽略。QK 归一化和 RMSNorm 用于数值稳定,输出端的非线性 MLP 把内部表示映射回动作。
这些设计有消融依据,但“没有 MLP 就无法描述非线性动力学”的表述过强:前面的 Transformer 本身已经非线性。更准确地说,是该实验配置的解码结构改变了学习效果。
4. 动作块与推理频率
模型一次产生 64 个未来动作,采样时使用 5 步 DPM-Solver++。报告的每秒动作数量是整块吞吐,不等于每秒获得同样数量的新视觉反馈。
如果每秒生成约 6 块,每块 64 动作,算术上就能达到约 384 个动作条目每秒。但只有在重新观察并生成新块时才发生新的闭环决策。动作吞吐与反馈频率不能混为一谈。
控制频率是动作语义的一部分。教学设同一个位移命令0.01米每步,在10Hz约对应0.1米/秒,在50Hz约对应0.5米/秒;若槽位存的是速度,换频率又应通过积分时长改变位移。不能只统一“米”这个单位就把两种接口视作相同。
同样,64步块在10Hz覆盖6.4秒,在50Hz只覆盖1.28秒,包含的任务进度也不同。RDT显式输入控制频率,让网络有机会处理这类差异,但不保证在没见过的频率或延迟下自动保持轨迹等价。实验中的动作吞吐仍应与新图像反馈频率分别报告。原文控制频率输入与推理
教学例子与五个前置概念
自构例子,未运行:两个机器人都报告速度 0.1,但一组单位是米每秒,另一组是厘米每秒。若直接混合,网络会学习冲突映射;统一单位可消除这个人为冲突。之后即便单位相同,臂长与负载仍可能不同,需要观测或平台数据帮助适配。
三、对齐物理动作槽位并预训双臂扩散头
统一向量中的位置承载具体物理语义,缺失维度靠约定与掩码处理。目标双臂微调仍不可省略,联合动作块再表达两手的时序关系。
把各数据集动作按物理量填入统一槽位
附加缺失掩码,统一单位和相机顺序
从多机器人混合数据中抽取动作块
编码两帧图像、语言、本体状态和控制频率
给动作块加噪,训练网络预测干净动作
在目标双臂示范上微调
部署时采样噪声,经少量去噪步骤生成动作块
按执行机制运行,再利用新观测更新
四、分开数据来源、吞吐与视觉反馈率
论文支持在特定双臂平台上的新物体、新房间和少样本任务适应。作者明确说明,目标是用多机器人数据改善目标双臂操作,而不是已经构建一个无需适配就控制所有机器人的模型。
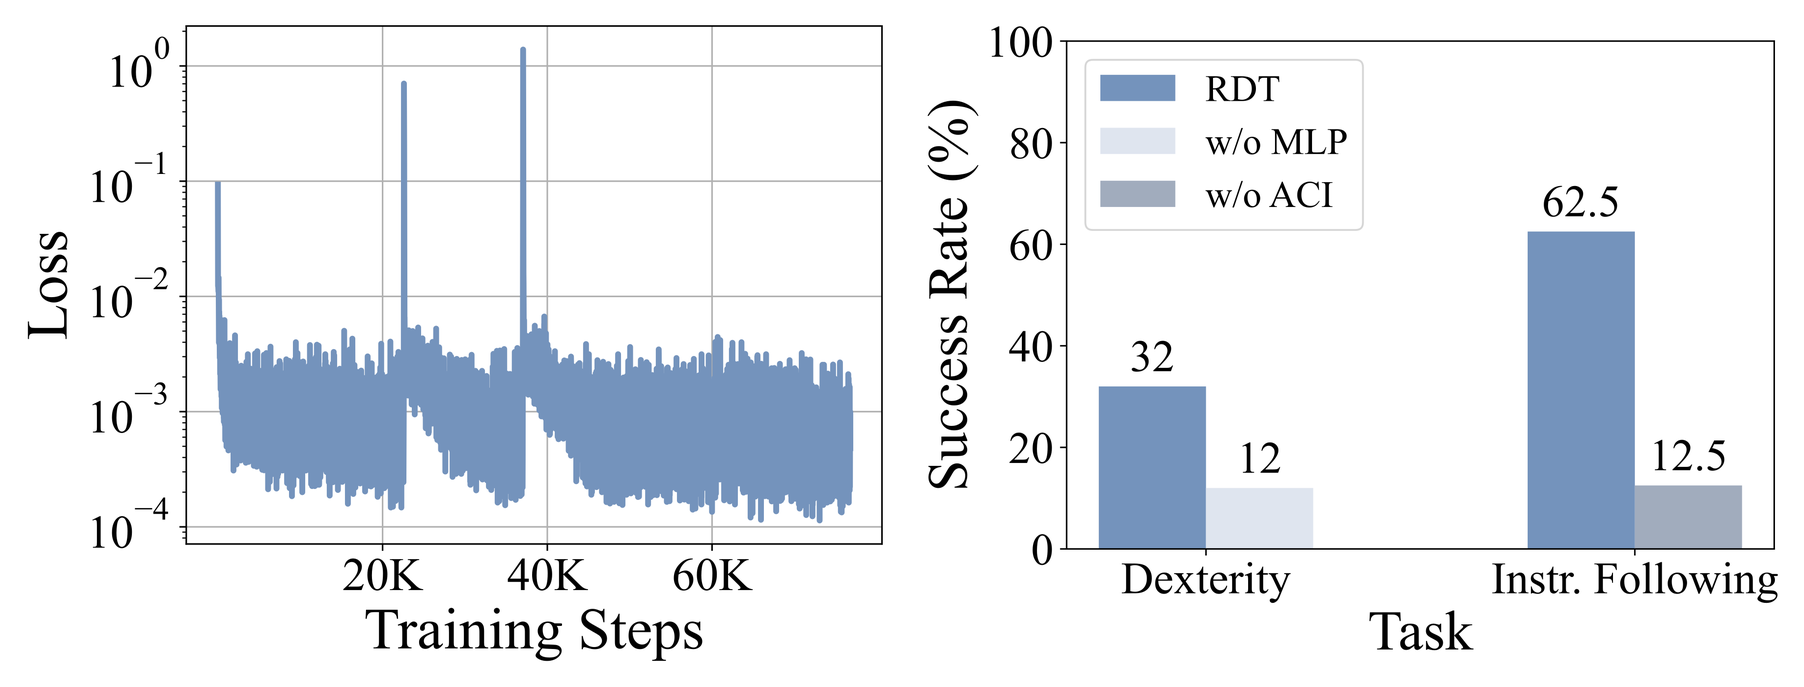
原图怎么读: 图4,原论文图注与图像。左侧是不使用归一化的训练损失,右侧是去掉解码器或动作条件插值的成功率;图注明确这些消融没有预训练,不能直接解释完整大规模预训练收益。
| 项目 | 论文内容 | 解释 |
|---|---|---|
| 上游数据 | 46 数据集,超过百万轨迹 | 含多种机器人与数据源 |
| 目标数据 | 超过 6k 轨迹、300 任务、15 个以上场景 | 目标双臂适配 |
| 预训练 | 48 H100,1M 更新,约一个月 | 不是低成本从零训练 |
| 微调 | 同样 GPU,130k 更新,约三天 | 使用 500k 预训练检查点起步 |
| 评价 | 7 类任务与多个子条件 | 不是完整 300 任务测试 |
| 少样本 | 交接 5 条、折短裤 1 条相关示范 | 仍利用大量其他任务数据 |
| 硬件 | Cobot Mobile ALOHA,双臂静态操作 | 没有自主移动训练或评价 |
| 重复 | 杯子/房间每条件 8 次;若干任务 25 次 | 小样本不确定性仍大 |
标题 1B 对应主策略约 1.2B 参数,冻结语言和视觉编码器也有计算成本。仅报可训练主干规模不能代表整个系统内存。
预训练跑到 1M 更新,但附录 H 明确微调采用 500k 检查点。这两句话描述不同阶段,不应把实际微调初始化写成最后预训练模型。训练扩散时间步附录为 1000;正文谈从较多采样步加速到 5 步,不能把训练噪声级数与推理迭代数统一成一个参数。
五组证据怎么理解
表3:新对象和场景。 洗杯子、在新房间倒水支持视觉条件变化下的迁移。每个条件只有少量重复,对“任意家庭环境”没有足够覆盖。所有实验先经过目标双臂数据微调,零样本指这些具体新元素没有额外示范。
表3:少样本。 折短裤为 68%,交接完整任务为 40%。它们支持相关任务示范很少时仍有适应能力,但不代表从一条轨迹、完全没有其他机器人经验,就能学会任意新技能。
表3 与附录 H:整体指标。 整体性能先平均完整任务和附加要求,再按能力维度平均。它不是简单统计所有尝试中完整任务成功的比例。以机器人狗任务为例,操作遥控器总分和“走直线”还有不同列;这里控制的是遥控器,不是学习四足步态。
表2:消融。 较小模型在某个新房间条件与大模型同为 62.5%,说明规模收益不是逐项严格增加。预训练、扩散与规模整体有帮助,但只测三个选定条件,无法证明每个组件在所有任务中都不可缺。
图4:结构选择。 归一化影响训练稳定,MLP 解码与交替条件注入影响所测子任务。部分结构消融使用无预训练模型,不能直接当作完整大规模系统上的全因子消融。
基线比较有重要条件:OpenVLA 和 Octo 最终采用各评价任务相关示范微调,因为全数据训练没有取得足够收敛;RDT 则使用大规模多任务适配。ACT 未加入语言条件,无法评价相同的指令跟随。它们是有实际意义的系统比较,却不是只替换动作分布的严格因果实验。
五、统一维度不等于未见身体可直接执行
成本包括数据清洗、语言扩写、单位和动作映射,以及长时间预训练。表面上“一条示范学折叠”背后有大量其他数据、强视觉语言编码器和目标平台适配,必须一起理解。
我的分析是,物理单位统一很有价值,但对跨形态规律的证据仍需更直接实验:例如固定训练量,对比单位一致、每源归一化和错误单位三种方案,在新臂长或新控制频率下测试。现有结果不能把“可解释接口”升级为“学到了可证明的统一物理模型”。
追问:两个手臂分开采样都合理,为什么合起来仍可能交接失败?
参考答案:交接需要左手释放与右手接稳在时间上配合,单手边缘分布正确不保证联合分布正确。应在同一任务上记录两手时序、相对位姿和持物状态,而不仅分别算动作误差。联合动作块提供表达相关性的机会,但是否学会仍取决于协调示范覆盖。
六、沿机制关系继续读
RDT组合Diffusion Policy式连续动作生成与多机器人数据,针对双臂接口和规模重新设计;与π0是平行基础策略,扩散Transformer和VLM动作专家的上游知识、计算路径不同。
七、自测三题与参考答案
问题1:使用 MSE 的扩散为什么不等于确定性动作平均?
答案:扩散网络条件于噪声级别和随机样本,逐步恢复分布中的不同模式;确定性回归只给一个输出。损失形式相似,不代表整个生成机制相同。
问题2:每秒约 381 个动作是不是 381 Hz 视觉闭环?
答案:不是。数字主要来自每块 64 个动作的吞吐,新的动作块约每秒生成数次。反馈更新率取决于重新观察、推理和执行机制。
问题3:统一成 128 维,是否就能直接控制没见过的机械臂?
答案:不能。它统一物理量槽位和单位,尚未自动消除运动学、坐标系、负载和控制器差异。论文目标是借其他机器人数据帮助目标双臂,目标平台仍经过微调。