088|DexMimicGen:从少量示范生成双臂灵巧数据
原论文:DexMimicGen: Automated Data Generation for Bimanual Dexterous Manipulation via Imitation Learning,Zhenyu Jiang、Yuqi Xie、Kevin Lin 等,2024首次公开,ICRA 2025。论文。
先接住前作的问题
MimicGen按物体关系变换单段动作,但双手各自正确移动仍可能因先后或同步错误而失败。DexMimicGen加入每手分段与双手时序约束,让生成器先处理协调,再把成功轨迹交给学习器。
五个前置概念
五个前置概念:SE(3)描述刚体位姿;物体中心表示用末端对物体的关系组织动作;异步队列允许两手独立推进片段;先决约束表示动作事件必须满足的前后关系;数字孪生提供与真实场景对应的模拟系统。
一、问题设定:双手示范怎样同时保留几何与时序关系
双手装配不能简单地把两条单手轨迹同时播放。左手可以先拿到零件、等待右手;两手抬托盘必须同时用力;倒完水之前,另一只手不能把碗搬走。DexMimicGen 的核心,就是把这些时间关系加入示范扩增。
最终策略属于离线模仿学习:输入视觉观测,输出机器人动作,训练时拟合成功演示。数据生成过程会在环境中执行轨迹,但它没有用奖励梯度优化一个探索策略。因此“在线生成数据”和“在线强化学习”并不是一回事。
生成器拥有比学习策略更多的信息。它需要源片段所关联的物体、片段边界、当前物体位姿以及成功检查器。最终 visuomotor policy 从观测预测动作,不必部署整套轨迹变换逻辑。评价时若只看策略输入而忽略生成器先验,就会低估取得数据的成本。
论文的主要假设包括:每只机械臂可接受末端位姿控制,手部接受开合或关节命令;任务能分成物体中心片段;接触前能够观察或估计目标物体位姿。Panda 用操作空间控制,人形平台使用 IK 处理联接到同一躯干的运动链,手指则用关节位置控制。
这些假设适合抓取、交接、装配等可局部重用的动作,但不是一般双手运动的完整描述。例如织物在拉扯后形状改变,靠一个刚体位姿就未必足以重新定位所有接触点。原文§III–V
二、按独立、同步与顺序子任务生成双臂轨迹
它沿用 MimicGen 的物体中心轨迹变换,但为每只手单独切分动作,并增加同步和先后约束。少量人类示范由此能在新的物体位置上重执行,成功轨迹留下用于模仿学习。
1. 保留与物体的关系,而非世界坐标
设 是源示范中物体的世界位姿, 是新场景位姿, 是末端轨迹。变换后的轨迹为:
因为
末端相对物体的姿态保持不变。这个等式解释了为什么物体换位置后仍可能抓得住;它没有证明机械臂一定够得着、路径不碰撞或接触力相同。实际轨迹要在物理模拟中执行,并按结果筛选。
手指命令沿用源示范的相对手部运动,不是为每个新对象重新求解最优灵巧抓取。因此“灵巧手适用”仍依赖原抓取模式可以迁移。
2. 三种子任务需要三种时序处理
并行子任务:每只手有独立队列,执行完自己当前片段即可加载下一个。两手各拿一个物体,不必强迫同时完成抓取。
协调子任务:两只手使用同一个空间变换,并按剩余动作数同步。这保证对应时刻的双手相对几何不会因各自独立变换而被破坏。某些交接任务使用 Replay,即不变换源交接动作,保持交接位置在可达区域;其他情形使用 Transform。
顺序子任务:给出先决关系。如果“倒入球”还没完成,另一只手的“移走碗”就等待。它表达的是事件依赖,不能用简单的固定延迟替代,因为前一段完成时间随初始位置变化。
同步与顺序有不同含义:同步要求一起做,顺序要求一个做完另一个才能做。若混淆,系统可能让两手永远互相等待,或过早开始操作。
3. 生成和学习是分开的算法
核心损失仍可概括为最大似然:
换成 Diffusion Policy 时采用相应生成训练,而不是把以上抽象似然式冒充其具体实现。方法优化的主要对象是资料覆盖和可用性;最终指标则是策略成功率,二者之间还隔着学习器拟合能力。
共同空间变换为何保留双手配合,可以直接验证。设源左右末端世界位姿为 ,两手共同左乘刚体变换 ,则新的相对位姿为 。若两手分别使用 ,结果变为 ,通常不再等于源关系。
教学上,抬托盘时左右手各自“跟随最近对象”可能把手间距拉开;共同变换能保留几何,却仍需同步时间才能在同一时刻共同承重。原文协调片段同时要求共享变换与末端时序对齐,这两条约束解决不同错误,不能任选其一。原文§IV-B
用一个例子建立理解
以下是未运行的教学例子。右手把球倒入左边的碗,左手随后把碗搬到垫上。换了碗的位置,右手倒球轨迹可以按碗位姿变换;左手抓碗轨迹也能变换。但若左手一抓到就离开,右手会把球倒在桌上。因此两个几何正确的局部动作,并不自动组成正确的联合任务。
先决约束是“倒球完成→移碗开始”。在两手抬托盘时则不同:要求同步抬起,且两手用共同变换,保留间距。一个是时间顺序,一个是共同运动,不能用同一条等待规则粗暴处理。
三、按双手时序约束重执行并筛选数据
独立子任务、同步子任务和先后依赖各采用对应处理。物体中心变换只解决空间关系,等待与切换规则决定两手能否共同完成接触。
为每条源示范:
    分别切分左右手的物体中心子任务
    标注协调片段、先决关系及参考物体

重复直到得到所需数量的成功轨迹:
    随机化场景,选择源片段
    给左右手维护独立动作队列
    当某手需要新片段:
        若先决子任务未结束,等待
        根据物体位姿变换末端轨迹并插入过渡动作
        协调片段使用共同变换或共同Replay方案
        对齐协调片段剩余步数
    并行执行左右手命令,记录实际观测与动作
    若完整任务成功,保留轨迹;否则丢弃

使用成功资料训练BC-RNN、BC-RNN-GMM或Diffusion Policy
在重新采样的初始条件中测试学习策略
四、区分扩展初态中的训练与零样本测试
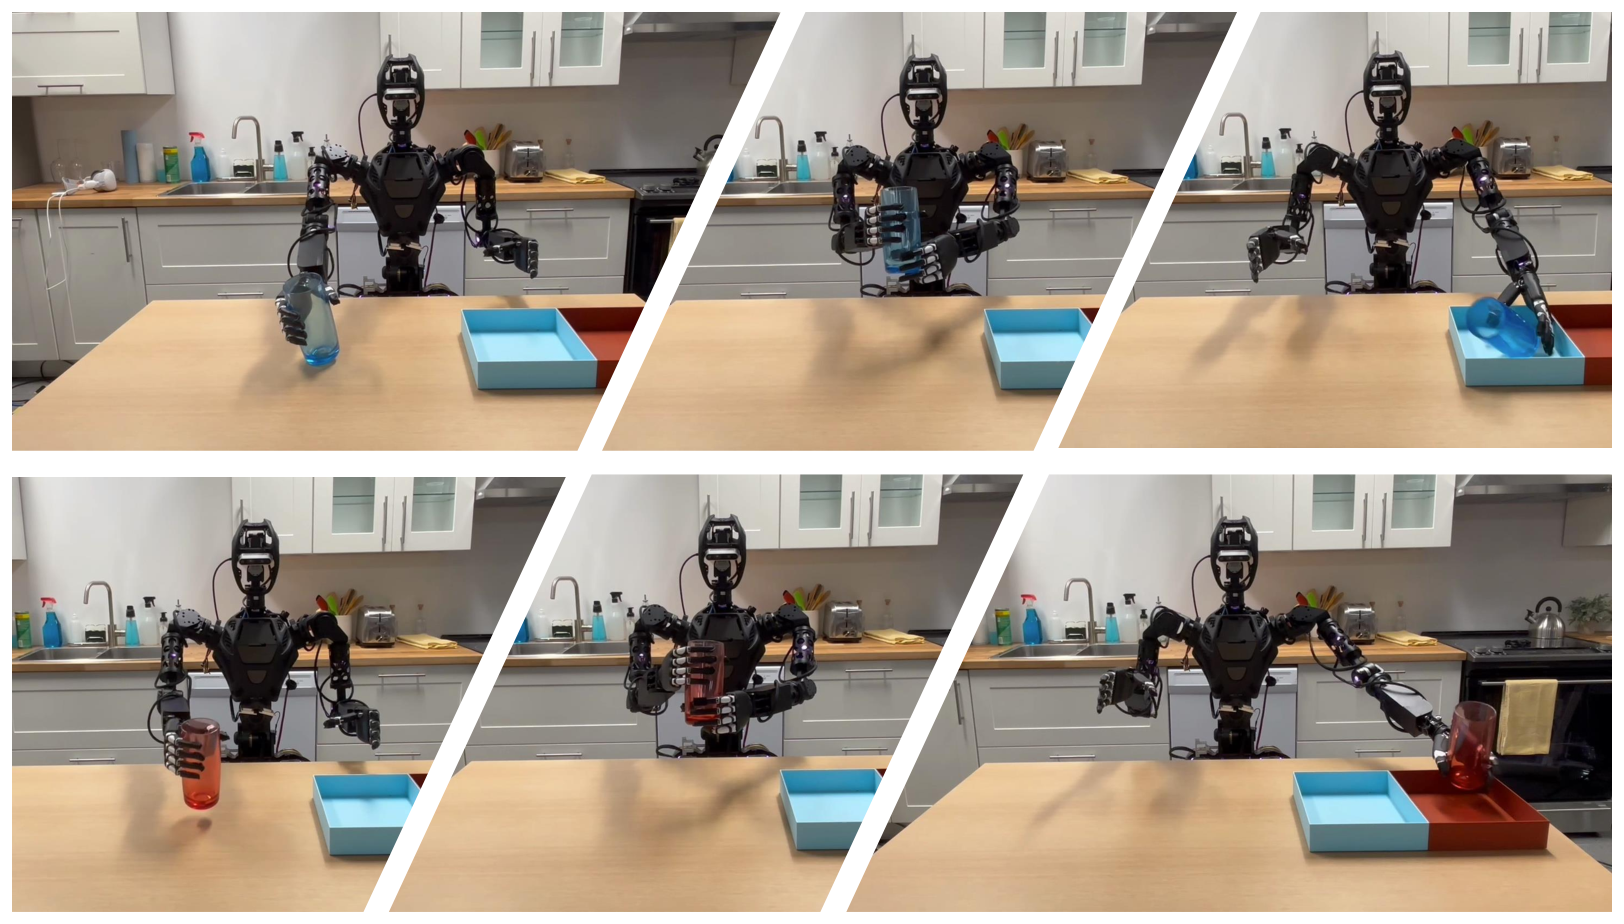
作者在九个主要仿真任务、三类双臂形态上验证生成资料的用途,并展示真实 GR-1 分拣。真机实验经过仿真检查后执行轨迹、收集真实数据,不应称为仅用模拟图像训练后零样本部署。
原图怎么读: 图6,原论文图注与图像。按真机执行序列检查双手同步与目标对象变化;这些是用真实收集资料训练后的策略展示,不应直接称为只用仿真数据的零样本迁移。
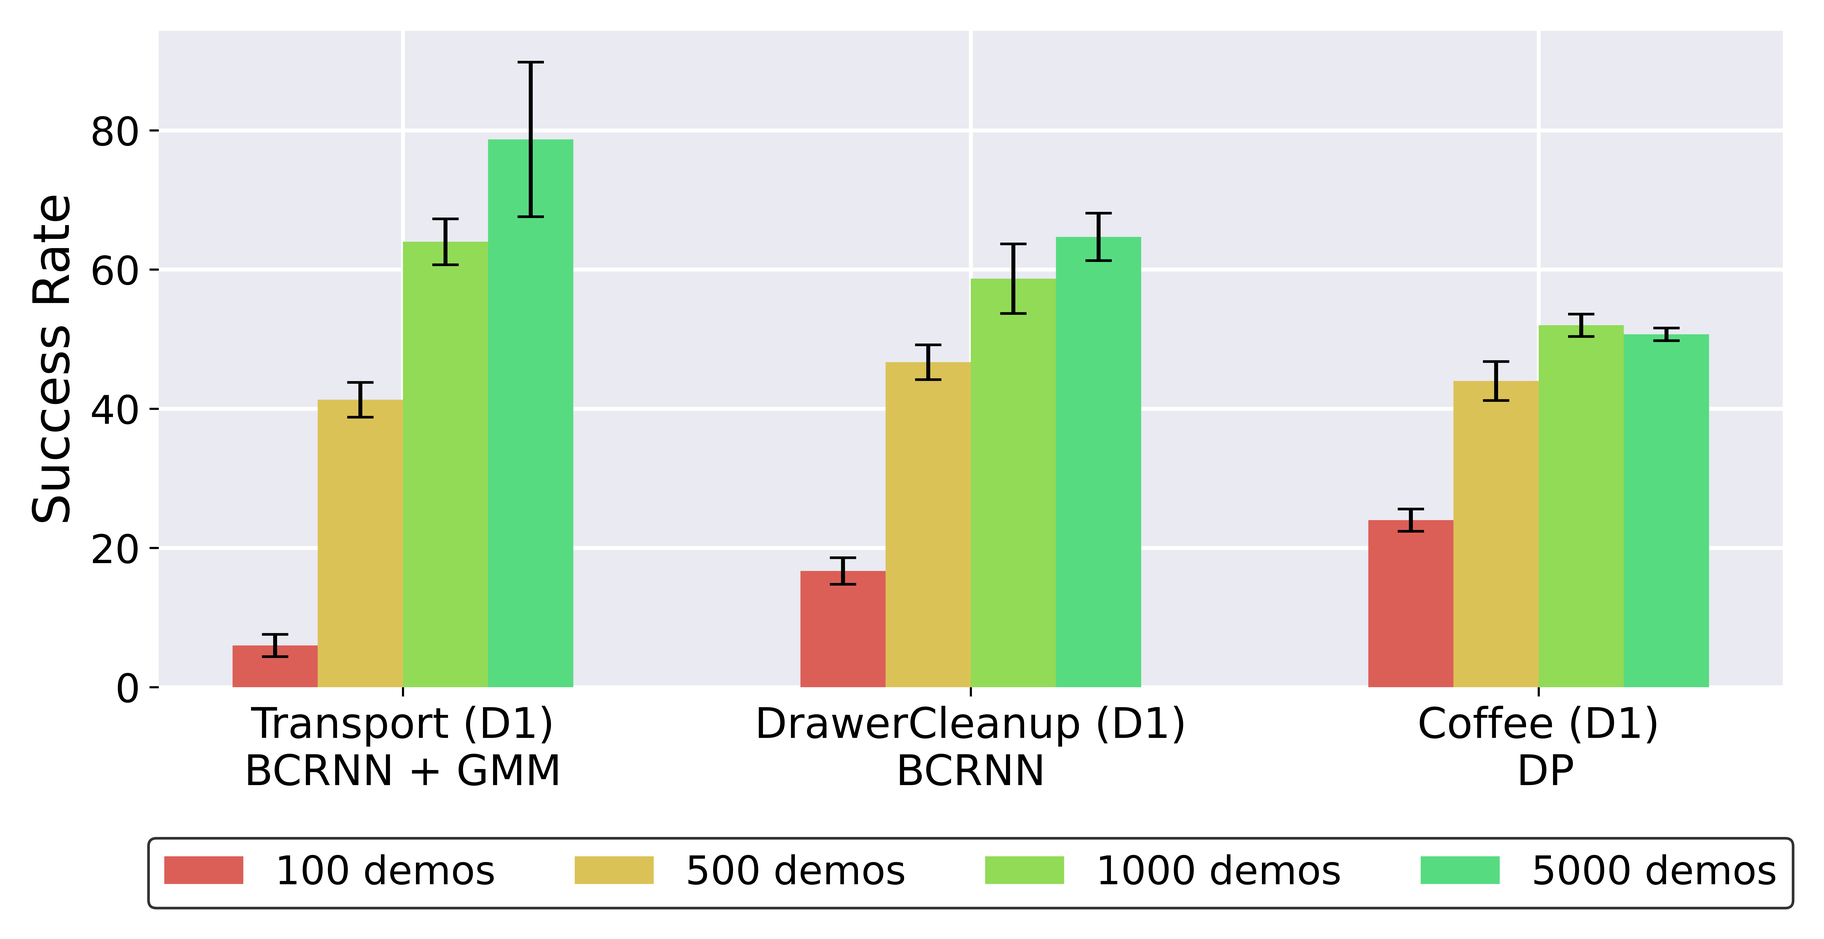
结果图怎么读: 图5固定各任务与学习流程,改变生成数据集规模。先看100到500或1000条的增益,再看继续扩到5000条是否仍改善;柱高的停滞说明生成数量不是唯一限制,不能把一次扩增的收益线性外推到任意更大数据集。
| 设计 | 原文设置 | 要回答的问题 |
|---|---|---|
| 主要仿真任务 | 三种形态各三任务:双Panda夹爪、双Panda灵巧手、GR-1灵巧手 | 不同协调要求下能否生成可用数据 |
| 人类源资料 | 夹爪任务各10条,灵巧手任务各5条,共60条 | 少量遥操作能否扩增 |
| 主策略资料 | 每任务1000条生成轨迹 | 对比仅源资料训练的效果 |
| 学习器 | BC-RNN-GMM、BC-RNN、DP | 数据收益是否只限一种架构 |
| 重复与选模 | 三种子,各种子取最大策略成功率 | 结果受检查点选择影响 |
| 广分布 | 从D0源资料生成D1/D2资料,再在对应分布训练与测试 | 生成器能否覆盖新初始位置 |
| 真机 | 四条源示范扩为40条成功真实轨迹,红蓝物体各10次测试 | 仿真检查辅助采集能否省遥操作 |
完整生成算力、训练更新预算和每个检查点测试次数在所读主文中未逐项核实。21K是跨设置生成量,不是九个主任务各有21K;主表明确使用各1000条。
只有成功轨迹留下,使数据更像可模仿专家,但也造成选择偏差:更难的初始状态若生成失败较多,最终资料可能低估它们。比较生成规模时还应记录尝试次数、成功留存率和初始状态覆盖。
结果:证据到底有多强
表I:资料扩增确实有用。 Drawer Cleanup 的 DP 从源资料0.7%升到生成资料76.0%,绝对提升75.3个百分点;Can Sorting 从0.7%到97.3%。这是在特定任务、资料与选模规程下的结果,不代表任何五条示范都能实现同样跃升。
表I也显示生成器和策略是不同维度:Box Cleanup 中 BC-RNN 为96.7%,DP为92.0%;Pouring中也是BC-RNN更高。数据方法有效,不意味着扩散架构每个任务都最好。GMM头在灵巧手任务的相对表现,也未延续所有早期单臂观察。
表II:扩大的是训练资料覆盖。 Piece Assembly 从D0条件74.0%到更难D2条件44.0%,Box Cleanup从96.7%到78.7%。生成器在广分布里确有用途,但复杂度增加仍导致下降。这里是分别用相应广分布生成资料再训练,不能写成“只在D0训练策略直接泛化D2”。
表III:几何重用优于简单加噪。 Tray Lift 中同样1000条资料,DemoNoise为16.7%,DexMimicGen为75.3%,相差58.6个百分点。Pouring相差52.6个百分点,因此不能把正文笼统的“58%”改写成所有任务至少58个百分点;相对和绝对增幅必须分开。
图5与§VI-C:扩增并非无限收益。 100到500/1000条的提升明显,1000到5000条未必继续提高。数据多样性、模式重复和学习器容量都可能影响边际效用,论文没有将所有原因完全分离。顺序约束在Pouring的比较为88.7%对76.7%,但在Drawer同源片段方案仍可更好,说明资料组合方式与约束要共同考虑。
图6、§VI-D:真机的90%对应什么。 四条人类示范先进入数字孪生;新轨迹在仿真成功后发送真机,再采集成功真实示范供DP训练。40条对四条资料得到90%对0%,红蓝两种物体各10次,即90%对应20次中18次成功。真实采集仍需复位,仿真只是一层可行性检查,不是物理安全证明。原文实验§VI
五、重执行成功不保证所有接触节奏可复用
工程代价包括仿真资产、物体位姿、子任务标注、控制器和成功筛选器。机器人动作所受的力学约束不会因为刚体变换保留几何关系而消失。数字孪生越不准确,仿真通过与真机完成之间的差距越大。
我的分析是,方法最适合“技能结构固定、初始几何变化丰富”的问题。若任务要求因突发事件切换全新策略,生成器仍受已有源片段限制。丢弃失败也意味着恢复策略覆盖可能不足,后续可考虑保留可恢复失败并补充纠正。
三种子取最高检查点体现可达到的性能,但比固定训练预算后的最终模型更乐观;这不否定相对比较,只要求复现时采用同一规程。真机只有一个分拣任务,无法由此推到所有仿真任务都能顺利迁移。
追问:人为延长一只手的等待段,会怎样影响生成率与学习质量?
参考答案:等待可能帮助另一只手完成前置条件,从而提高生成成功;也可能制造大量静止帧,使策略倾向停住或难以识别切换。应同时记录生成率、等待时长分布和最终策略的阶段转换表现。数据生产更稳与监督更容易学习并非同一目标。
六、沿机制关系继续读
本篇直接承接MimicGen的对象中心生成,新增双手队列、同步与事件先后;DexCap则是平行采集路线,人体示范重定向并不自动提供这里的仿真成功筛选。
七、自测三题与参考答案
问题1:为什么两只手都正确地跟随各自物体,仍可能做不成任务?
答案:局部几何正确不保证联合时间关系正确。两手可能抢先移动共享物体,或者交接时还没同时到位。必须额外表达同步或先决关系;这是从单臂扩增到双臂扩增的核心差异。
问题2:D1/D2实验是否证明策略能零样本外推到更宽位置分布?
答案:不是。源示范来自D0,但生成器在D1/D2产生新资料,策略又用这些资料训练。它证明少量源演示可以被加工成覆盖新分布的训练集;策略并没有完全不接触新分布。
问题3:真实90%能否称为纯仿真到真实迁移?
答案:不能。仿真生成的轨迹还在真机上执行并收集真实观测,最终策略使用40条成功真实资料。减少的是人持续遥操作的劳动,真实机器人执行与环境复位仍然存在。