088|Mamba-2:把递归状态写成结构化矩阵,找到更快的计算方式
论文:Tri Dao、Albert Gu,Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,2024,ICML。采用原文 v1;实现见官方 Mamba 仓库。
图表来源:Tri Dao、Albert Gu,2024,原文;CC BY 4.0。本篇展示做了图形区域裁切、PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
Mamba让输入选择性状态模型能够训练,但扫描并非都适合GPU矩阵单元。本篇直接承接这个执行瓶颈,用受约束的结构化矩阵连接递推与注意力;FlashAttention提供同函数改执行顺序的教学对照,不能据此宣称普通softmax注意力都等价。
五个前置概念
五个前置概念:线性递归通过状态累积历史;核注意力用特征内积构造匹配;半可分矩阵将跨区间作用限制为低秩结构;张量并行把一层运算分到多个设备;困惑度衡量模型对实际文本的平均预测不确定性。
一、问题设定:选择性递推怎样改排成适合GPU的块矩阵计算
函数决定序列到输出的映射,算法决定计算顺序,网络还含卷积、门控、投影与残差。本篇要先找递推映射的可分块结构,再配合硬件重排算法;核心算子变快不能预先替代完整模型的质量与时间实验。
同一个 SSD 函数可以逐步递归,也可以构造全矩阵,还可以分块计算。改变计算顺序不必改变数学输出。可是从 Mamba-1 改成 Mamba-2 不只是换计算顺序:它还将状态转移从一般对角形式限制成标量乘单位矩阵,并调整投影和头结构。因此不能把所有模型差异都归为一个无损内核替换。
这是一篇序列架构与计算方法论文,主训练仍是自回归下一 token 预测,没有策略奖励、环境探索或 actor–critic。状态空间模型的“状态”是压缩历史的隐藏表示,不是机器人世界状态的同义词。
二、在标量转移条件下展开历史并建立结构化对偶
1. 展开历史贡献
先考虑一个头,输入 ,状态 ,写入和读出向量 。简化后的离散递归是:
是该头的标量衰减,它同样作用于状态的各行。令初始状态为零,展开得:
空乘积为 1。旧输入贡献由“写入方向与当前读出方向的匹配”乘以“跨时间保留系数”决定。这个式子直接解释选择性:不同输入生成不同的读写和衰减参数,模型可以决定保留什么。
2. 对偶的是特殊注意力,不是任意 softmax
定义下三角矩阵 ,上三角为零,则:
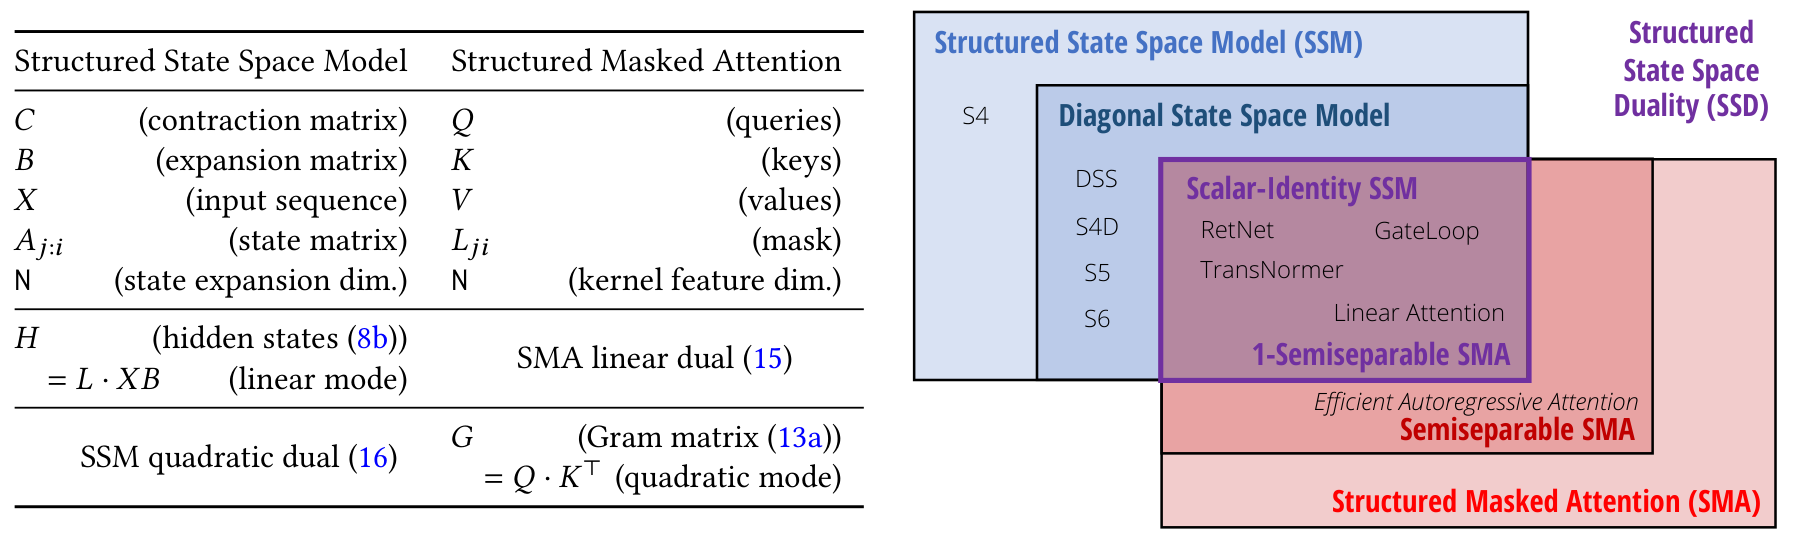
它看起来像注意力: 对应 query, 对应 key, 对应 value, 是结构化因果掩码。这里没有标准 softmax。不能把任意 直接用相同固定状态精确代替。
§5 的推论 5.1 给出标量单位阵 SSM 与 1-semiseparable masked attention 的对应。更一般的定理讨论特定结构化注意力和有界阶自回归表示,前提不能从标题中省略。
所谓半可分结构,可以先直观理解为:矩阵在对角线下方的适当子块具有低秩结构,历史到未来的信息通过有限维状态传递。整个矩阵并不因此都是低秩,特别是不能把它误读成对整个注意力矩阵做一次普通低秩近似。
跨越一个切分点,为什么信息只需经过有限维状态?
令切分点为 ,考虑所有过去位置 对未来位置 的作用。前述系数可拆成
因此这个“过去到未来”的矩形子块可写成两个矩阵的乘积,秩最多为状态维度 。 是输入 对输出 的线性混合系数;这一分解是在当前输入所确定的 固定后进行,不表示完整输入相关模型是全局线性函数。它精确说明历史为何能通过 的状态瓶颈传过块边界。
原创教学核算。 取 、、,在第2步后切分。位置1、2对位置3、4的系数矩阵是
行列式为0,秩为1;第一块只需传递 。但整个4步因果矩阵的对角线都是1,行列式为1,秩为4。于是“跨块低秩”与“整体低秩”可以同时一真一假,不能把SSD误读成把整个注意力矩阵压成一个秩1近似。
3. 块内并行,块间传状态
将长度 分成若干长度 的块。一个块的输出由两部分组成:块内输入在零初态下产生的输出,以及前面所有块留下的初态贡献。
块内部分用小型矩阵乘法计算;每块还计算自身的终态贡献。块间通过更短的递归合并这些终态,得到各块真实初态,再把初态映射成当前块的输出。最后两部分相加。
这是 §6 的原理改写,省略 batch、多头和数值稳定实现。不能在块间全部重置为零,否则模型只剩局部上下文;只有独立样本的边界才应阻断状态传播。
4. 网络结构也为并行重新安排
Mamba-2 从块输入直接并行生成数据依赖投影,而不是必须等待中间卷积结果再产生所有参数。这使每个设备可以处理自己的头或组,降低张量并行中的同步需求。额外归一化帮助训练稳定。
训练目标仍是交叉熵。机制变化在序列混合、参数结构和计算图;改善指标则包括困惑度、下游准确率、内核延迟和墙钟训练。理论证明保证对应条件下的映射等价,不能证明任何语料上的泛化成绩。
令 ,,每步 ,输入 ,初态为零。递归得到 ,,。对应矩阵为:
把前两项作为第一块,末状态为 5;第二块自己的局部贡献是 6,来自上一块的是 ,相加仍为 8.5。这个例子不是性能实验,只说明分块为什么不需要丢失跨块历史。
用非零块初态检验块间传递是否遗漏
前文前三步例中,第二块若误用零初态会输出6,而正确结果为8.5;只用首块或每块重置的数据测试,就发现不了这2.5的历史贡献。应把同一序列同时逐步递推、整矩阵计算和分块计算,对照所有位置,再单独测试独立样本边界是否正确清空状态。
三、块内矩阵乘、块间传状态并核对数值
输入:分头的 X、离散衰减 a、写入 B、读出 C、块长 Q
将序列切块
并行处理每块:
    计算块内衰减矩阵 L
    local_output = (L * (C @ B.T)) @ X
    local_end_state = 假设初态为零时的块末状态
    block_decay = 本块所有衰减的乘积
在块维度做状态扫描:
    real_end_state = block_decay * previous_state + local_end_state
并行处理每块:
    incoming_output = 将块初态衰减到各位置,再由 C 读出
    output = local_output + incoming_output
返回所有 output 和最终状态
四、分开核心算子、完整模型和混合注意力收益
等价推导先限定状态转移结构,再按序列长度和状态维度读内核图;混入注意力与MLP的完整模型还须另看。
| 实验 | 数据、模型与预算 | 对照和评价 | 主要问题 |
|---|---|---|---|
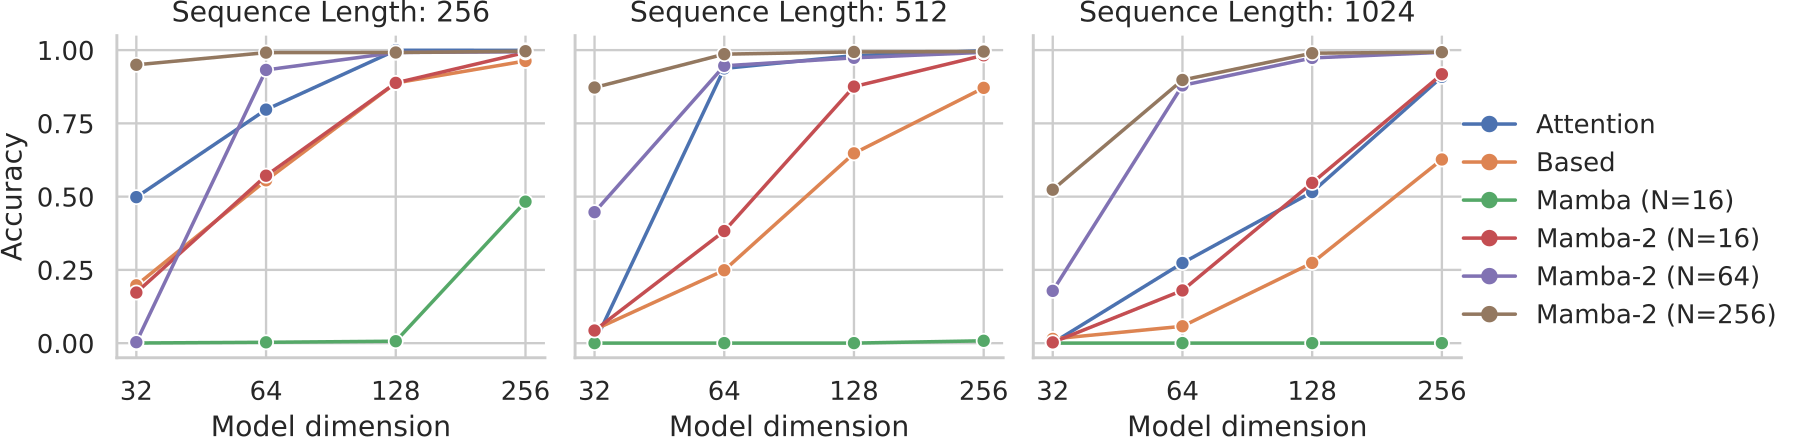
| 多查询关联回忆 MQAR | 长度 256/512/1024;词表 8192;两层小模型;状态维度 16/64/256 等 | Mamba-1、注意力、Based;关联检索准确率 | 更大的可用状态能否记住更多键值关系 |
| 规模规律 | Pile、GPT-2 tokenizer;约 125M–1.3B;2.5B–26B token | Mamba、Transformer++;困惑度、FLOPs、墙钟 | 同类训练预算下的质量效率关系 |
| 完整语言模型 | Pile 300B token;GPT-NeoX tokenizer;最大约 2.7B | Pythia、Mamba、RWKV 等;七项零样本准确率 | 架构能否支持自然语言任务 |
| 混合架构 | 350M/7B token;另有 2.7B/300B token | 相同数据顺序和超参数下混入注意力、MLP | 压缩记忆与显式检索是否互补 |
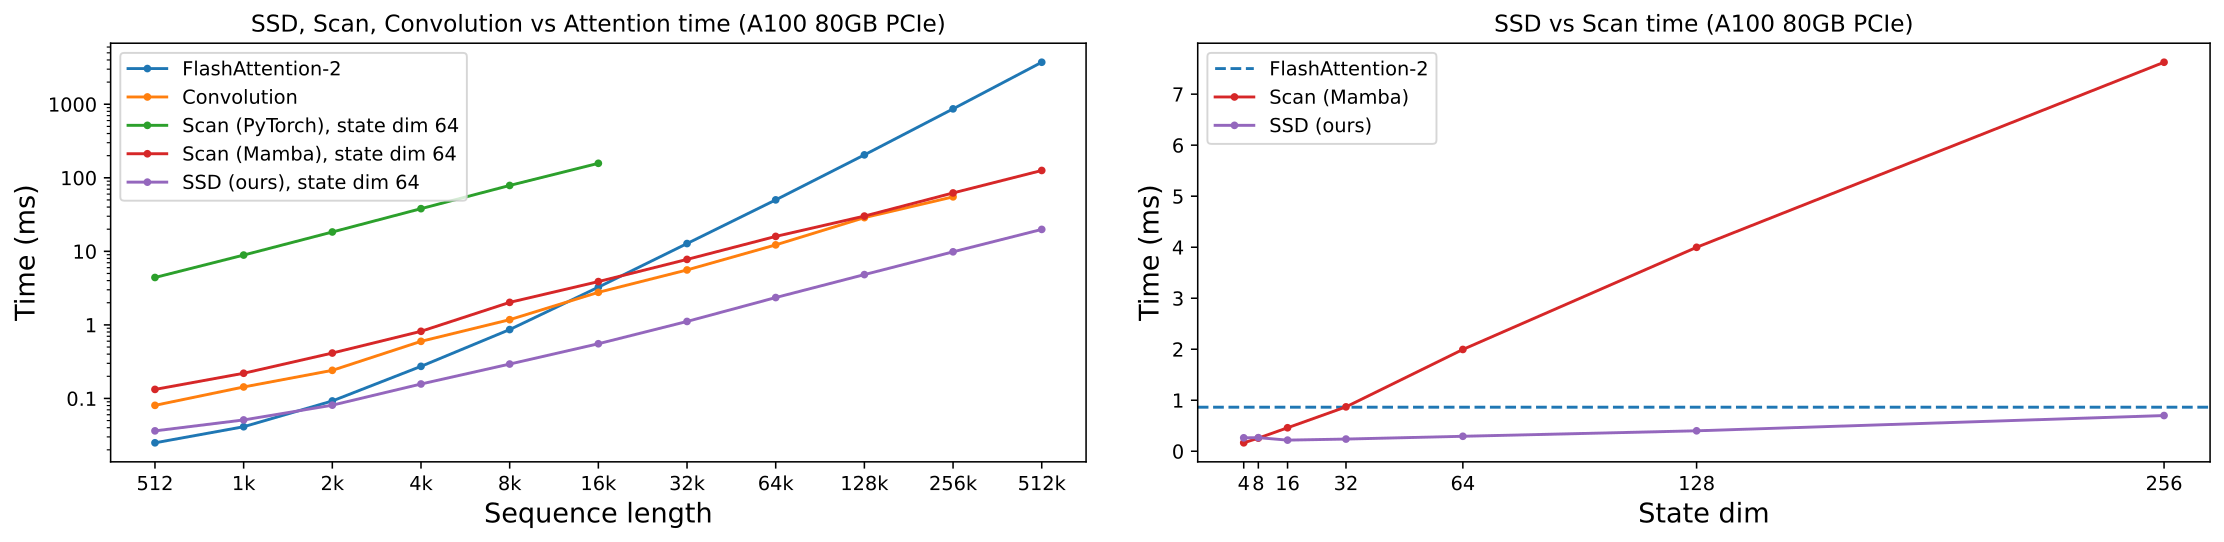
| 核心算子计时 | 不同序列长度和状态维度 | Mamba fused scan、FlashAttention-2;图10 | 矩阵化能否转化成实际内核收益 |
训练细节见附录 D:AdamW、梯度裁剪 1、权重衰减 0.1、无 dropout、预热与余弦衰减;下游模型学习率使用对应 GPT-3 配置的五倍。不同实验的 tokenizer 不同,因此不能跨两套分词直接比较困惑度。
主计时段未提供一个可无条件迁移到所有硬件的倍率;完整实验的多种子置信区间未统一报告。MQAR 附录的样本总数表述也不适合直接据以计算全书统一预算:应以实际课程循环、数据生成和实现配置复现,而不是将近似总数当作经过独立审计的算力账单。
证据一:§5、图4,确切等价有结构前提。 标量转移允许将历史衰减移到匹配分数之外,得到 。一般对角矩阵各状态维度衰减不同,不能直接做同样的标量拆分。这是数学推导支持的结论,与下游分数无关。 效率图左侧扫描序列长、右侧固定4K序列扫描状态维数;内核速度的适用条件不能被省略后写成完整模型的统一加速倍数。
证据二:图10 与 §9.3,核心算子效率提高。 SSD 对较大状态扩展下的 Mamba 扫描给出约 2–8 倍加速,并在约 2K 起超过所比较的 FlashAttention-2。作者紧接着说明:短序列时完整 Mamba-2 未必比 Transformer 更快,因为相同参数预算下,后者包含许多非常高效的 MLP 层。这是不能省略的性能边界。
证据三:表1,语言能力总体接近而非逐项统治。 2.7B Mamba-2 的 Pile 困惑度为 6.09,对比 2.8B Mamba 的 6.22;七任务平均准确率为 60.2% 对 59.9%。但 OpenBookQA 为 38.8% 对 39.6%,并非每个任务更好。该表包含额外任务,平均值也不能与上一代论文不同任务集合的平均分直接连线。
证据四:表2、表3,混合注意力仍有价值。 350M 配置中,48 层里加入 6 个注意力块,困惑度从纯 Mamba-2 的 8.60 降至 8.26;全注意力与 MLP 的 Transformer++ 为 8.68。2.7B 混合模型平均准确率 61.0%,纯 Mamba-2 和 Transformer++ 都为 60.2%。这支持互补性,不能证明 10% 是跨规模最优比例。
证据五:表4 与图8,收益不能只归于更大状态。 相同 SSD 内核下,顺序投影且无额外归一化的困惑度为 11.76,并行投影加归一化为 11.49。MQAR 中即使控制状态维度,Mamba-2 仍更好;作者明确不确定哪项架构变化主导这一差异。这一未知原因应保留,不能替作者补出确定解释。
五、结构限制与固定状态容量仍约束检索能力
它展示了一个研究顺序:先看计算对象有哪些结构,再选择适合硬件的分解,而不是只比较大 O。
固定状态节约长序列生成缓存,但容量有限。增加状态维度提升记忆,也增加每层每头的状态与计算,不能把“相对序列长度为常数”说成“内存几乎为零”。当 时,一个头的状态有 个数。
分块内核的浮点累积顺序与逐步递归不同,理论精确等价不等于数值逐位相同。实际实现要核对误差、混合精度、梯度及样本边界,尤其不能让独立文档通过缓存互相泄漏信息。
实测规模最大约 2.7B,尚不能单凭此文推断超大模型的知识、指令跟随、复杂推理或所有长上下文任务。论文提出的注意力核特征变体也并未稳定优于默认设计;统一框架提供候选方向,不保证每个组合都有效。
六、把结构化状态与注意力作为可组合模块
再回读Transformer与FlashAttention,用本篇函数—算法—网络三层区分,检查混合块究竟改变信息路径还是执行顺序;结构化对偶并不允许任意softmax骨干无损替换。
自测:能否说清“对偶”意味着什么
1. 能否把已经训练好的普通 softmax Transformer 无损换成 Mamba-2?
不能由本篇结论推出。精确对应的是具有特定结构掩码的核注意力和标量单位阵转移的 SSM。普通 softmax 的归一化与匹配矩阵不自动满足这些固定状态表示条件,网络层和投影也不同。标题概括理论联系,不是通用模型转换工具。
2. 为什么块内可以用二次计算,整体仍对序列长度线性?
固定块长 时,每块做 规模计算,总共有约 块,因此这部分对 是线性的;块间还通过固定维状态传递,而不是所有块两两显式注意。若让 随 一起增长直到整个序列一块,就会失去这个线性长度优势。
完整网络时间包括投影、门控、归一化、通信和不同类型的层。Transformer 的 MLP 本身高度适合 GPU;相同参数量不意味着相同 SSD 与注意力调用次数。混入 MLP 可能牺牲一点质量换取短序列效率,必须同时查看完整模型质量和墙钟,不能从局部内核推断全局最优。