089|Scaling Sparse Autoencoders:把隐藏激活拆成特征,也要检验解释是否完整
论文:Leo Gao、Tom Dupré la Tour 等,Scaling and evaluating sparse autoencoders,2024。采用原文 v1;代码见官方仓库。GPT-4 激活与完整底层训练资料并未全部开放,因此开放模型部分和闭源模型部分的可复现范围不同。
图表来源:Leo Gao、Tom Dupré la Tour 等,2024,原文;CC BY 4.0。本篇展示做了图形区域裁切、PNG格式转换、按原图面板顺序拼合,图中数据与标签未改动。
先接住前作的问题
Transformer提供残差流等内部表示,但直接读单个神经元常遇到混合响应。本篇在冻结模型之上训练分析字典;与Mixtral的Top-k只有教学对照关系,一个选择重建方向,一个选择模型执行专家。
五个前置概念
五个前置概念:残差流是多层不断读写的表示通道;字典学习用可复用方向组合表达数据;稀疏度 统计非零项数量;探针测量表示是否携带某种信息;消融干预主动改变内部量并观察输出变化。
一、问题设定:混合激活怎样分成稀疏且可检验的字典方向
一个概念可分散在多个坐标,一个坐标也可能混合多个概念。更宽字典可能将它们分开,却也容易退化成无意义的重建;本篇用稀疏选择限制表达,并追问重建、语义命名和行为因果证据是否一致。
二、区分TopK重建与死亡特征的残差学习
输入 是语言模型某层的激活,SAE 将它编码成 维向量 ,通常 大于 ,再线性解码为 。如果没有约束,只需要复制输入就可以重建,未必发现任何有意义结构。
稀疏约束让模型每次只能使用少量字典方向,从而鼓励不同输入共享可复用组件。这个动机来自“特征可能叠加在同一个表示空间”的假设,不是所有真实语义都严格稀疏、线性可分的证明。
被解释的语言模型在此固定。SAE 的训练是激活上的无监督重建,不是让 GPT-4 重新学习语言,也不是 RLHF。论文不优化模型回答的奖励,而是学习一个用于观察和干预内部表示的分析工具。
必须区分两个数量: 是字典总宽度, 是单个输入保留的潜变量数。增加 扩大可选字典;增加 放宽每次重建的信息通道。这两种扩展不能混成“更多特征一定更可解释”。
ReLU 基线为什么会缩小激活
传统 SAE 使用:
重建项希望系数足够大以表达输入; 项又持续把所有非零系数往零推。这不仅选择哪些特征活跃,还会扭曲活跃特征的幅值。调 也无法预先确定最终恰好有多少个非零潜变量。
先在一个维度上推导“缩小”,再看行为误差
上述 是固定语言模型的一次激活, 是预偏置, 是编码器, 是编码偏置, 的列是字典方向; 是稀疏系数。两种偏置所在的空间不同,不能交换。
原创标量推导。 暂设解码方向固定为1,输入为 ,只优化非负系数 。损失 对 求导得 ;考虑非负约束,最优 。例如 ,最优系数是2而非3,重建残差是1。若只限制这个方向被选中、删除幅值惩罚,同一子问题最优为3。这解释了 如何同时影响选择与幅值,不是对神经编码器全局最优的证明。
原文 §5.1 的检验很贴近这一步:先冻结解码器与活跃集合,再重新优化非零系数。ReLU系数倾向增大,TopK没有同样的系统偏向;但二者的重建都还能改善,说明“没有这一种缩小偏差”不等于“系数已最优”。
另外,令下游某个logit对激活的局部敏感方向为 ,两个重建误差分别为 、。它们的平方误差都为0.01,却造成近似logit变化 、。这项教学线性化解释为何还要把重建放回原模型测语言损失,不能用低MSE替代行为保真。
TopK 保留竞争赢家,训练重建幅值
论文改用:
主损失仅为平方重建误差。TopK 选数值最大的 项,不是绝对值最大的 项;代码还使用 ReLU 保证非负,因此严格说是至多 个非零。原文指出合理 下被选项几乎总为正,通常表现为恰好 个。
选择集合随输入变化。反向传播更新被选中的路径;没有选中的方向可能长期缺乏梯度。因此直接控制稀疏度解决了一个问题,也带来特征竞争和死亡问题。
让沉默特征学习“剩下没有解释的部分”
作者将编码器方向初始化为解码器的转置方向,训练后两者并不永久绑定。对于很久没有激活的潜变量,从中挑出一组候选,尝试解释当前主重建残差 :
这给尚未进入主 TopK 的方向一个学习入口。典型 ,辅助激活数按模型宽度选择;主 和辅助 不能混为一谈。所谓死亡也只是操作性定义:例如连续 1000 万 token 未激活,不表示这个特征在所有可能输入上永远无用。
这是原理伪代码,数值稳定、辅助损失归一化和稀疏内核应遵循原实现。输出是分析字典,不是已经获得验证的“模型全部概念清单”。
设一段代码激活可以写成“Python 语法方向”加“字符串内部方向”。一个神经元混合了两种信号,看它的高激活例子会觉得主题杂乱;SAE 可能把它们分成两个稀疏方向。
重建方向缩放会怎样影响稀疏约束
若把某解码方向乘10、对应潜变量除10,重建贡献可以不变;但潜变量幅度、TopK竞争或L1代价可能改变。约束字典方向尺度不是无关装饰,而是在固定表示的量纲,防止用任意缩放偷换稀疏比较。检查特征解释时还应保留预偏置和归一化的还原步骤。
三、提取冻结模型激活并维护字典训练状态
输入:固定语言模型、选定层、文本、字典宽度 n、稀疏度 k
提取所选层激活,按论文方式去均值并归一化
初始化解码字典及与其方向对应的编码器
for 激活批次:
    u = encoder(x - pre_bias)
    z = 非负 TopK(u, k)
    x_hat = decoder(z) + pre_bias
    residual = x - x_hat
    根据最近激活计数识别长期沉默潜变量
    用沉默潜变量的辅助 TopK 重建 residual
    更新 SAE,约束解码方向尺度并维护权重 EMA
评估:重建误差、非零数、替换激活后的语言损失
进一步评估:特征探针、解释精确率/召回率、消融效果
四、从重建误差走到行为损失、命名与消融
最大实验在 GPT-4 激活上训练约 1600 万潜变量的 SAE,使用 400 亿 token。
固定字典宽度或活跃数读重建前沿,再看替换激活后的损失与解释误报;坐标不同不能拼成单一解释性总分。
| 项目 | 设置 | 评价意图与限制 |
|---|---|---|
| 激活来源 | GPT-2 small 第 8 层;GPT-4 系列约五分之六深度;上下文 64 token | 选择较深但不过度专门化的表示;不覆盖所有层和长上下文 |
| 规模 | 最大 16M 潜变量、40B token | 验证可扩展性;附录 B.1 说明最大模型未训练到收敛 |
| 优化 | Adam,常数学习率;多数批量 131072 token;EMA 0.999 | 扩大并行度;学习率按字典规模调节 |
| 基线 | ReLU、Gated、ProLU 等,分别搜索稀疏和学习率超参数 | 对比重建—稀疏前沿,不能只比较不等的活跃数 |
| 已知特征 | 61 个二分类任务,每潜变量训练一维 logistic probe | 检查预期特征能否被单方向恢复;受人工选题偏好影响 |
| 解释评估 | N2G 的 n-gram/通配符规则;最多 16 个激活例构造解释,另 16 个评召回 | 同时检查精确率与召回率;解释语言本身表达力有限 |
| 行为干预 | 用 SAE 重建替换残差流;逐潜变量消融,观察后续 16 token logits | 检查行为保真与干预影响范围 |
设置依据 §2、§4、附录 A–D。最大字典使用 512 路切分,辅助损失增加约 10% 计算;这些是所用系统的报告,不能据此为任意 SAE 推导固定成本。底层 GPT-4 的完整激活数据和模型参数不公开,主图也没有统一的多种子误差条。
重建 MSE 按总是预测平均激活的误差归一化。行为损失则把重建激活放回语言模型继续前向,测量相对原始激活的交叉熵增加或输出 KL。前者检验几何近似,后者检验近似是否保留对语言预测重要的信息,二者不能互相替代。
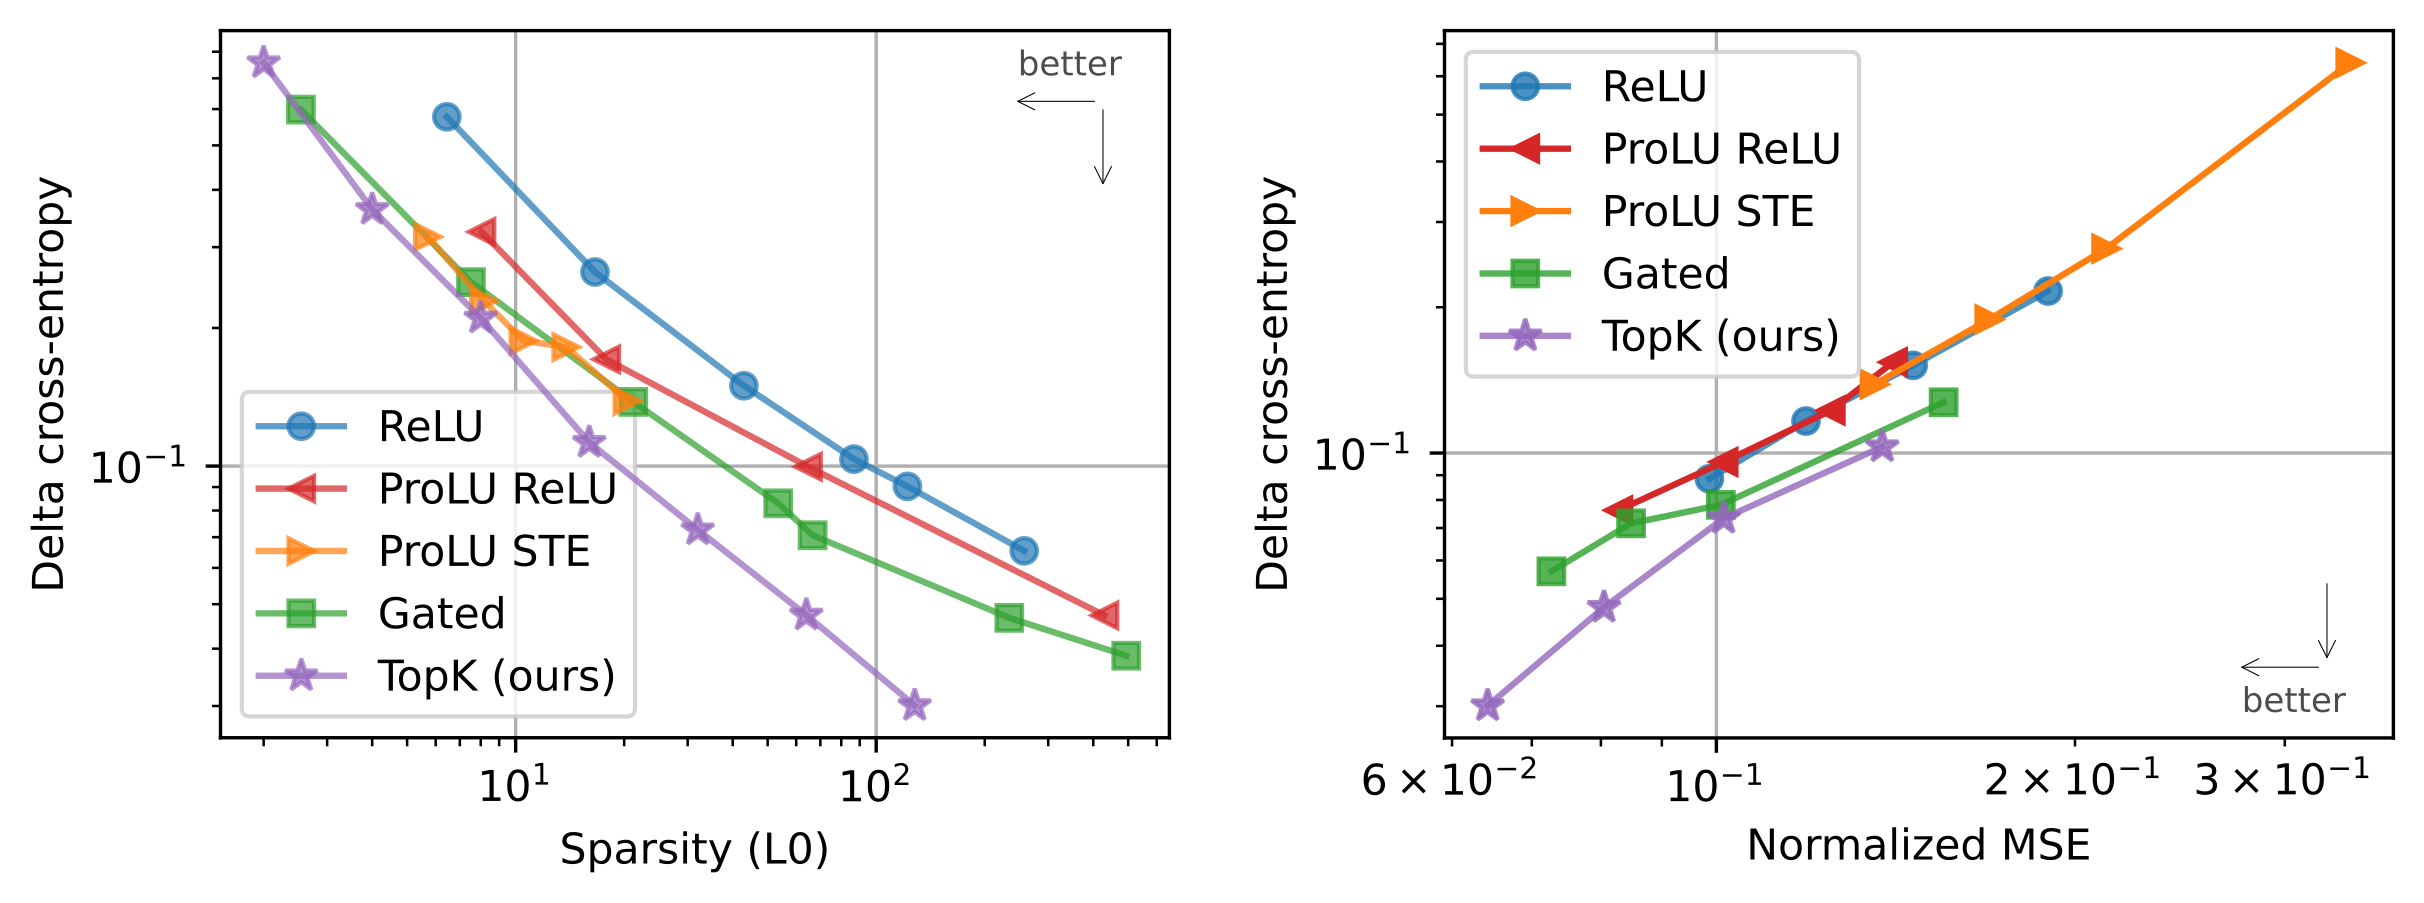
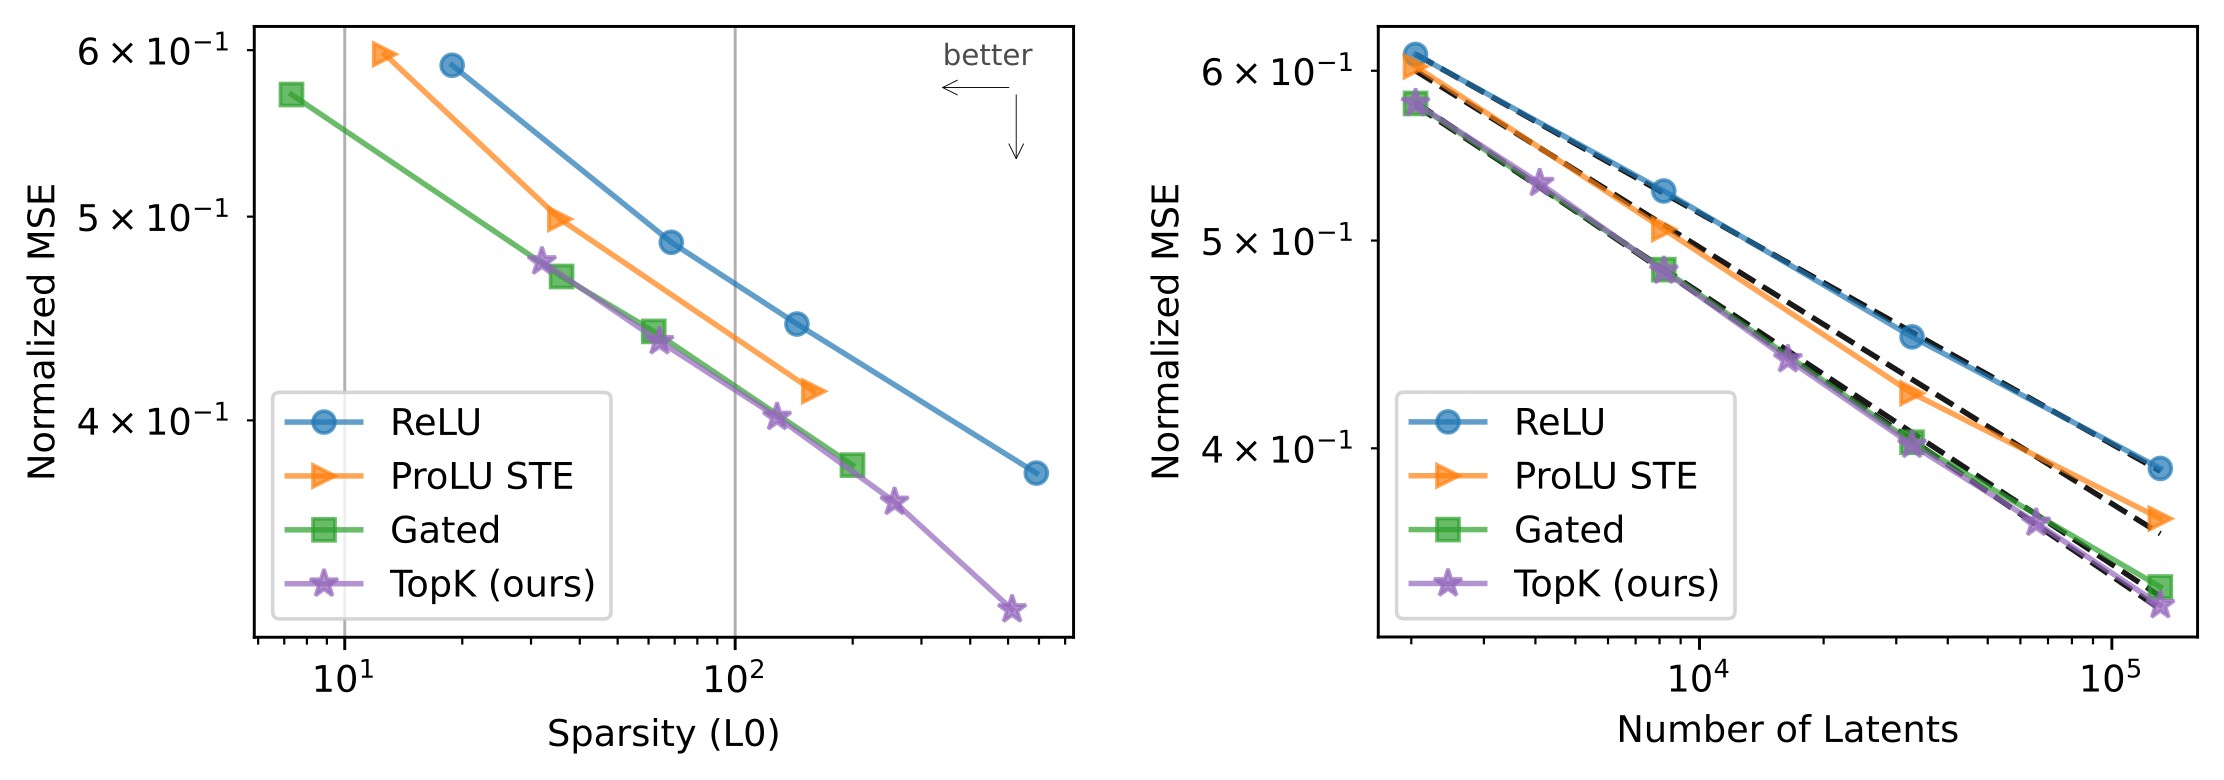
证据一:图2、图5,TopK 改善重建与行为保真。 固定字典宽度或固定活跃数的曲线比较中,TopK 优于 ReLU 的前沿,并且在相同 MSE 下也可能有更小的下游损失。后一个观察说明误差落在哪些方向很重要,不能仅凭平均欧氏误差判断行为是否保存。 总潜变量数 n 与每次活跃数 k 是不同坐标;重建误差、下游损失、解释 precision/recall 又是不同纵轴,改善一项不等于解释性全面改善。
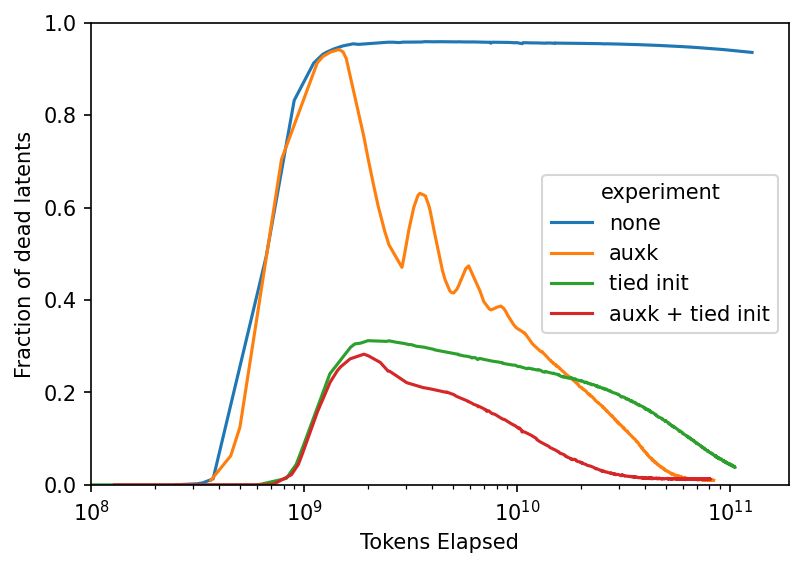
证据二:图15、§2.4,死亡特征并非不可避免。 绑定方向初始化与 AuxK 组合显著减少沉默特征;最大 16M SAE 仍有约 7% 死亡。它支持训练方案更能利用字典容量,但没有说明每个活跃方向都是独立、自然或有用的语义单位。
证据三:§4.1,高保真百分数可能让人过度乐观。 16M SAE 相对“把激活清零”的损失恢复指标达到 98.2%;可是将其重建放回 GPT-4 后,语言损失只对应作者规模曲线中约 10% 预训练计算量模型的水平。后者不是删除了 90% 知识的直接测量,而是另一种损失标尺;两者共同说明糟糕的零基线会把恢复率抬得很好看。
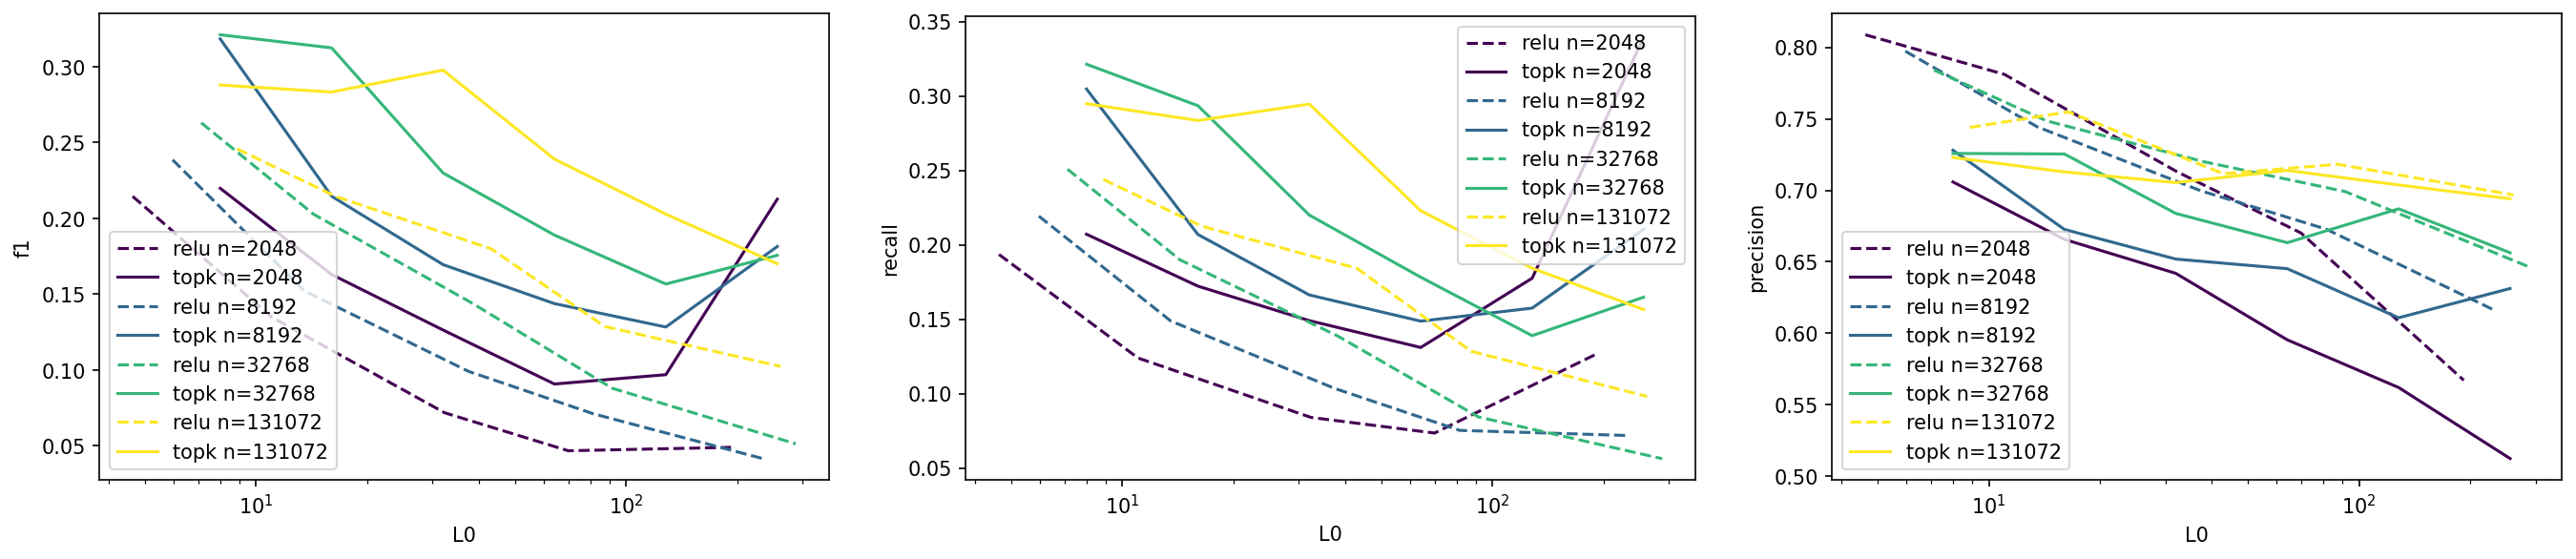
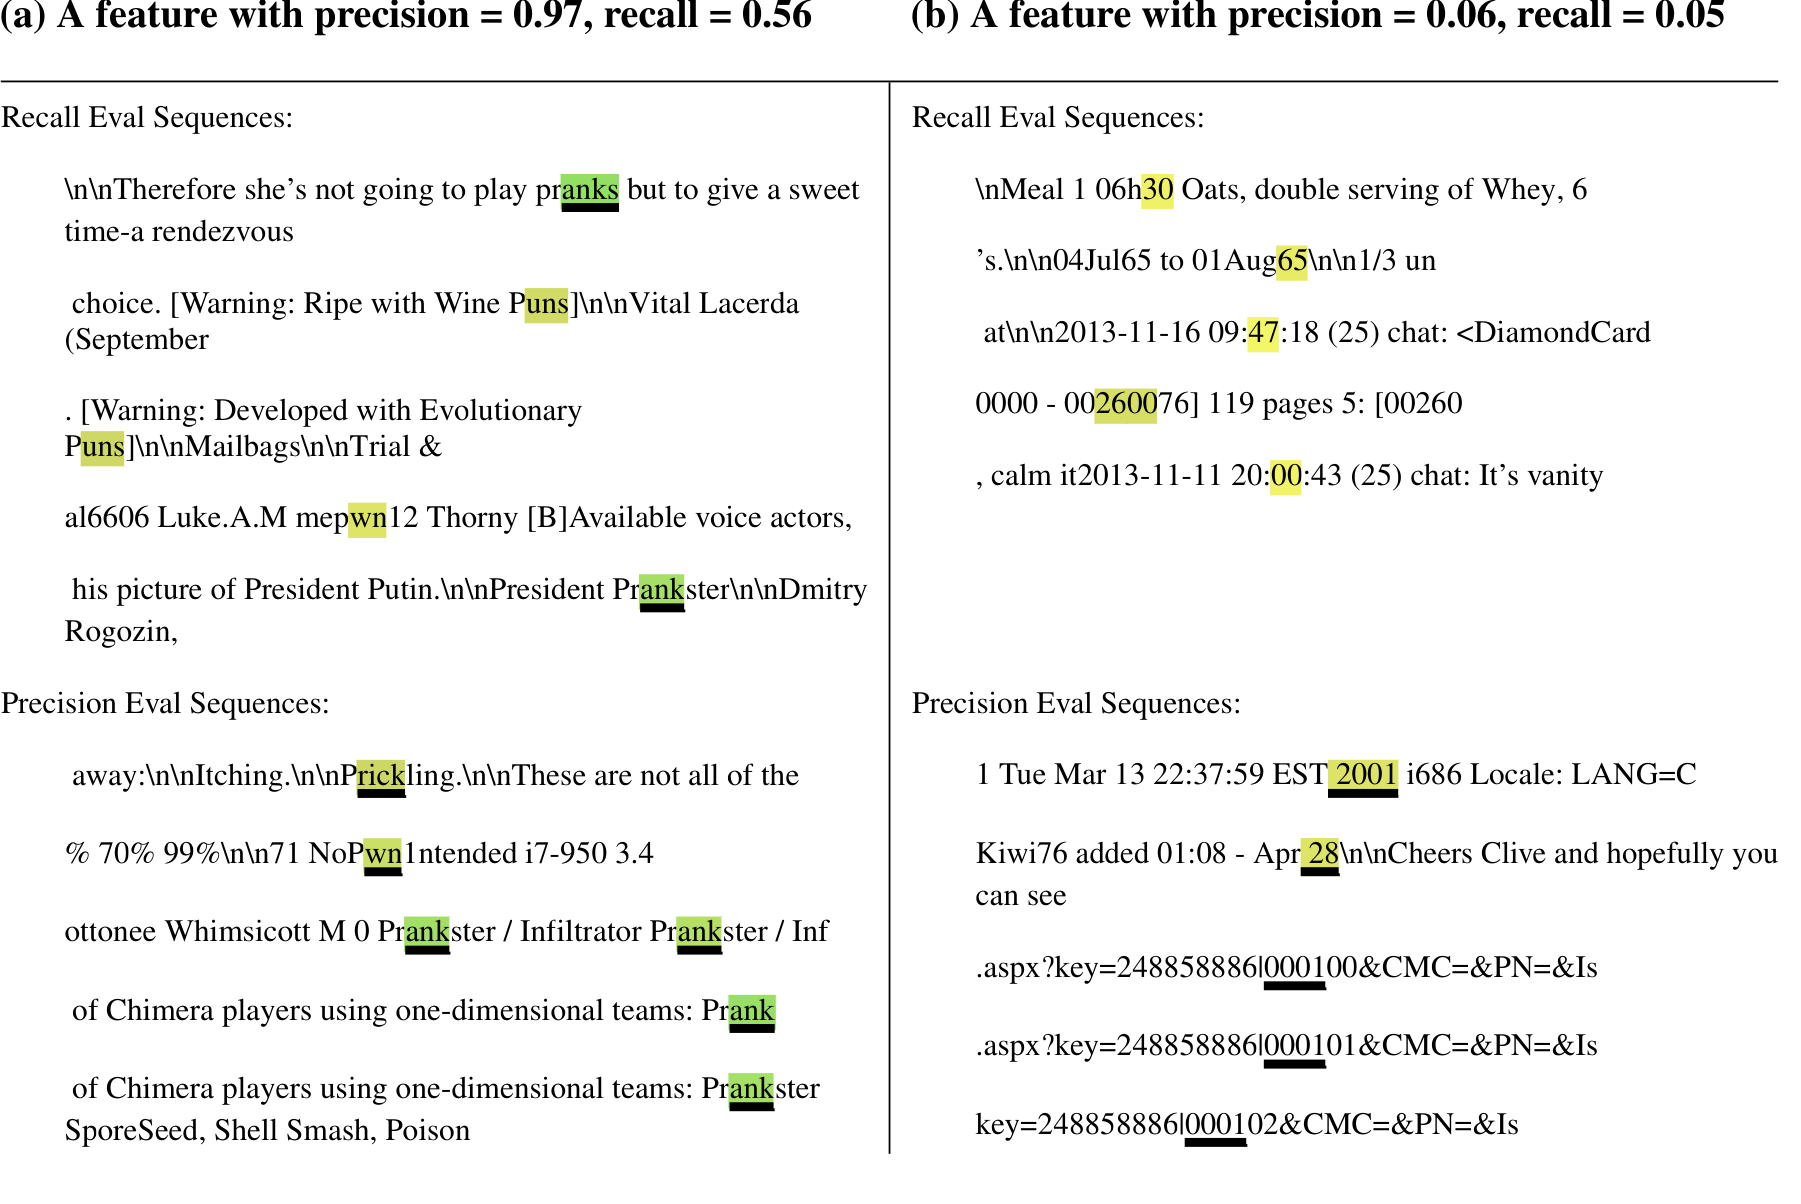
证据四:图6、图7、图8、图24,解释必须检查误报。 N2G 在相近稀疏度下,TopK 的召回相对 ReLU 超过 1.5 倍,精确率略低但超过其 0.9 倍。只看被挑选的强激活样本容易给出过宽解释;精确率要求解释预测会激活的地方也真的激活。规则解释重建后的语言损失进一步检验这些可读部分覆盖多少行为。
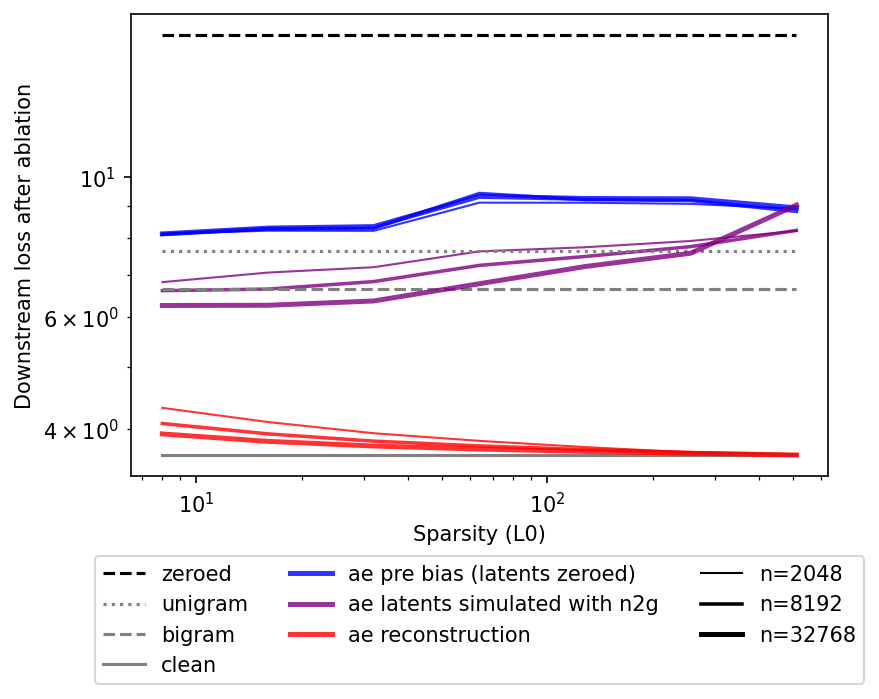
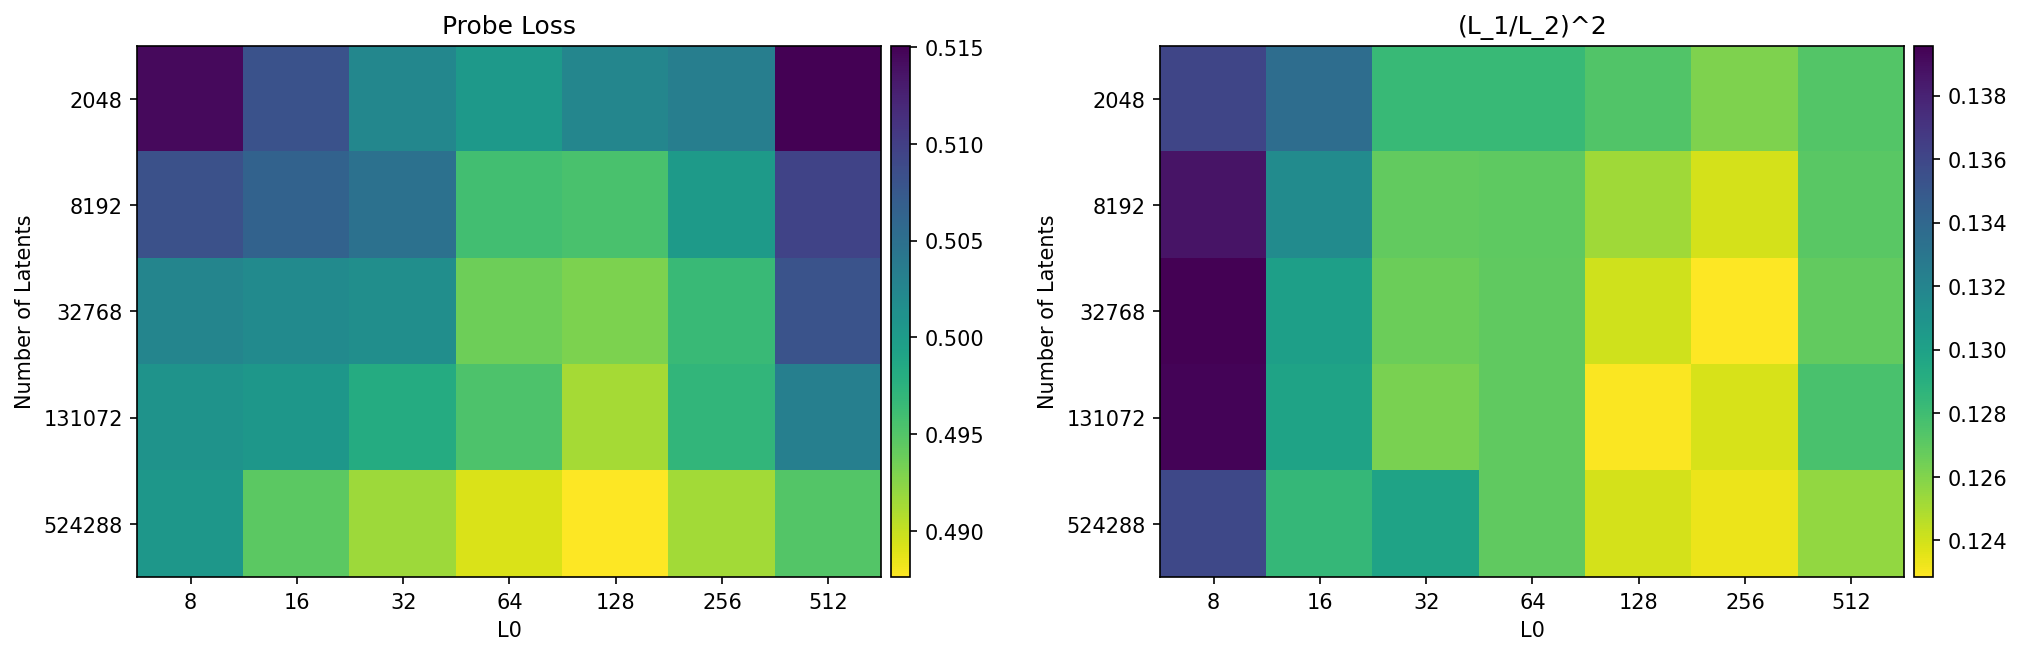
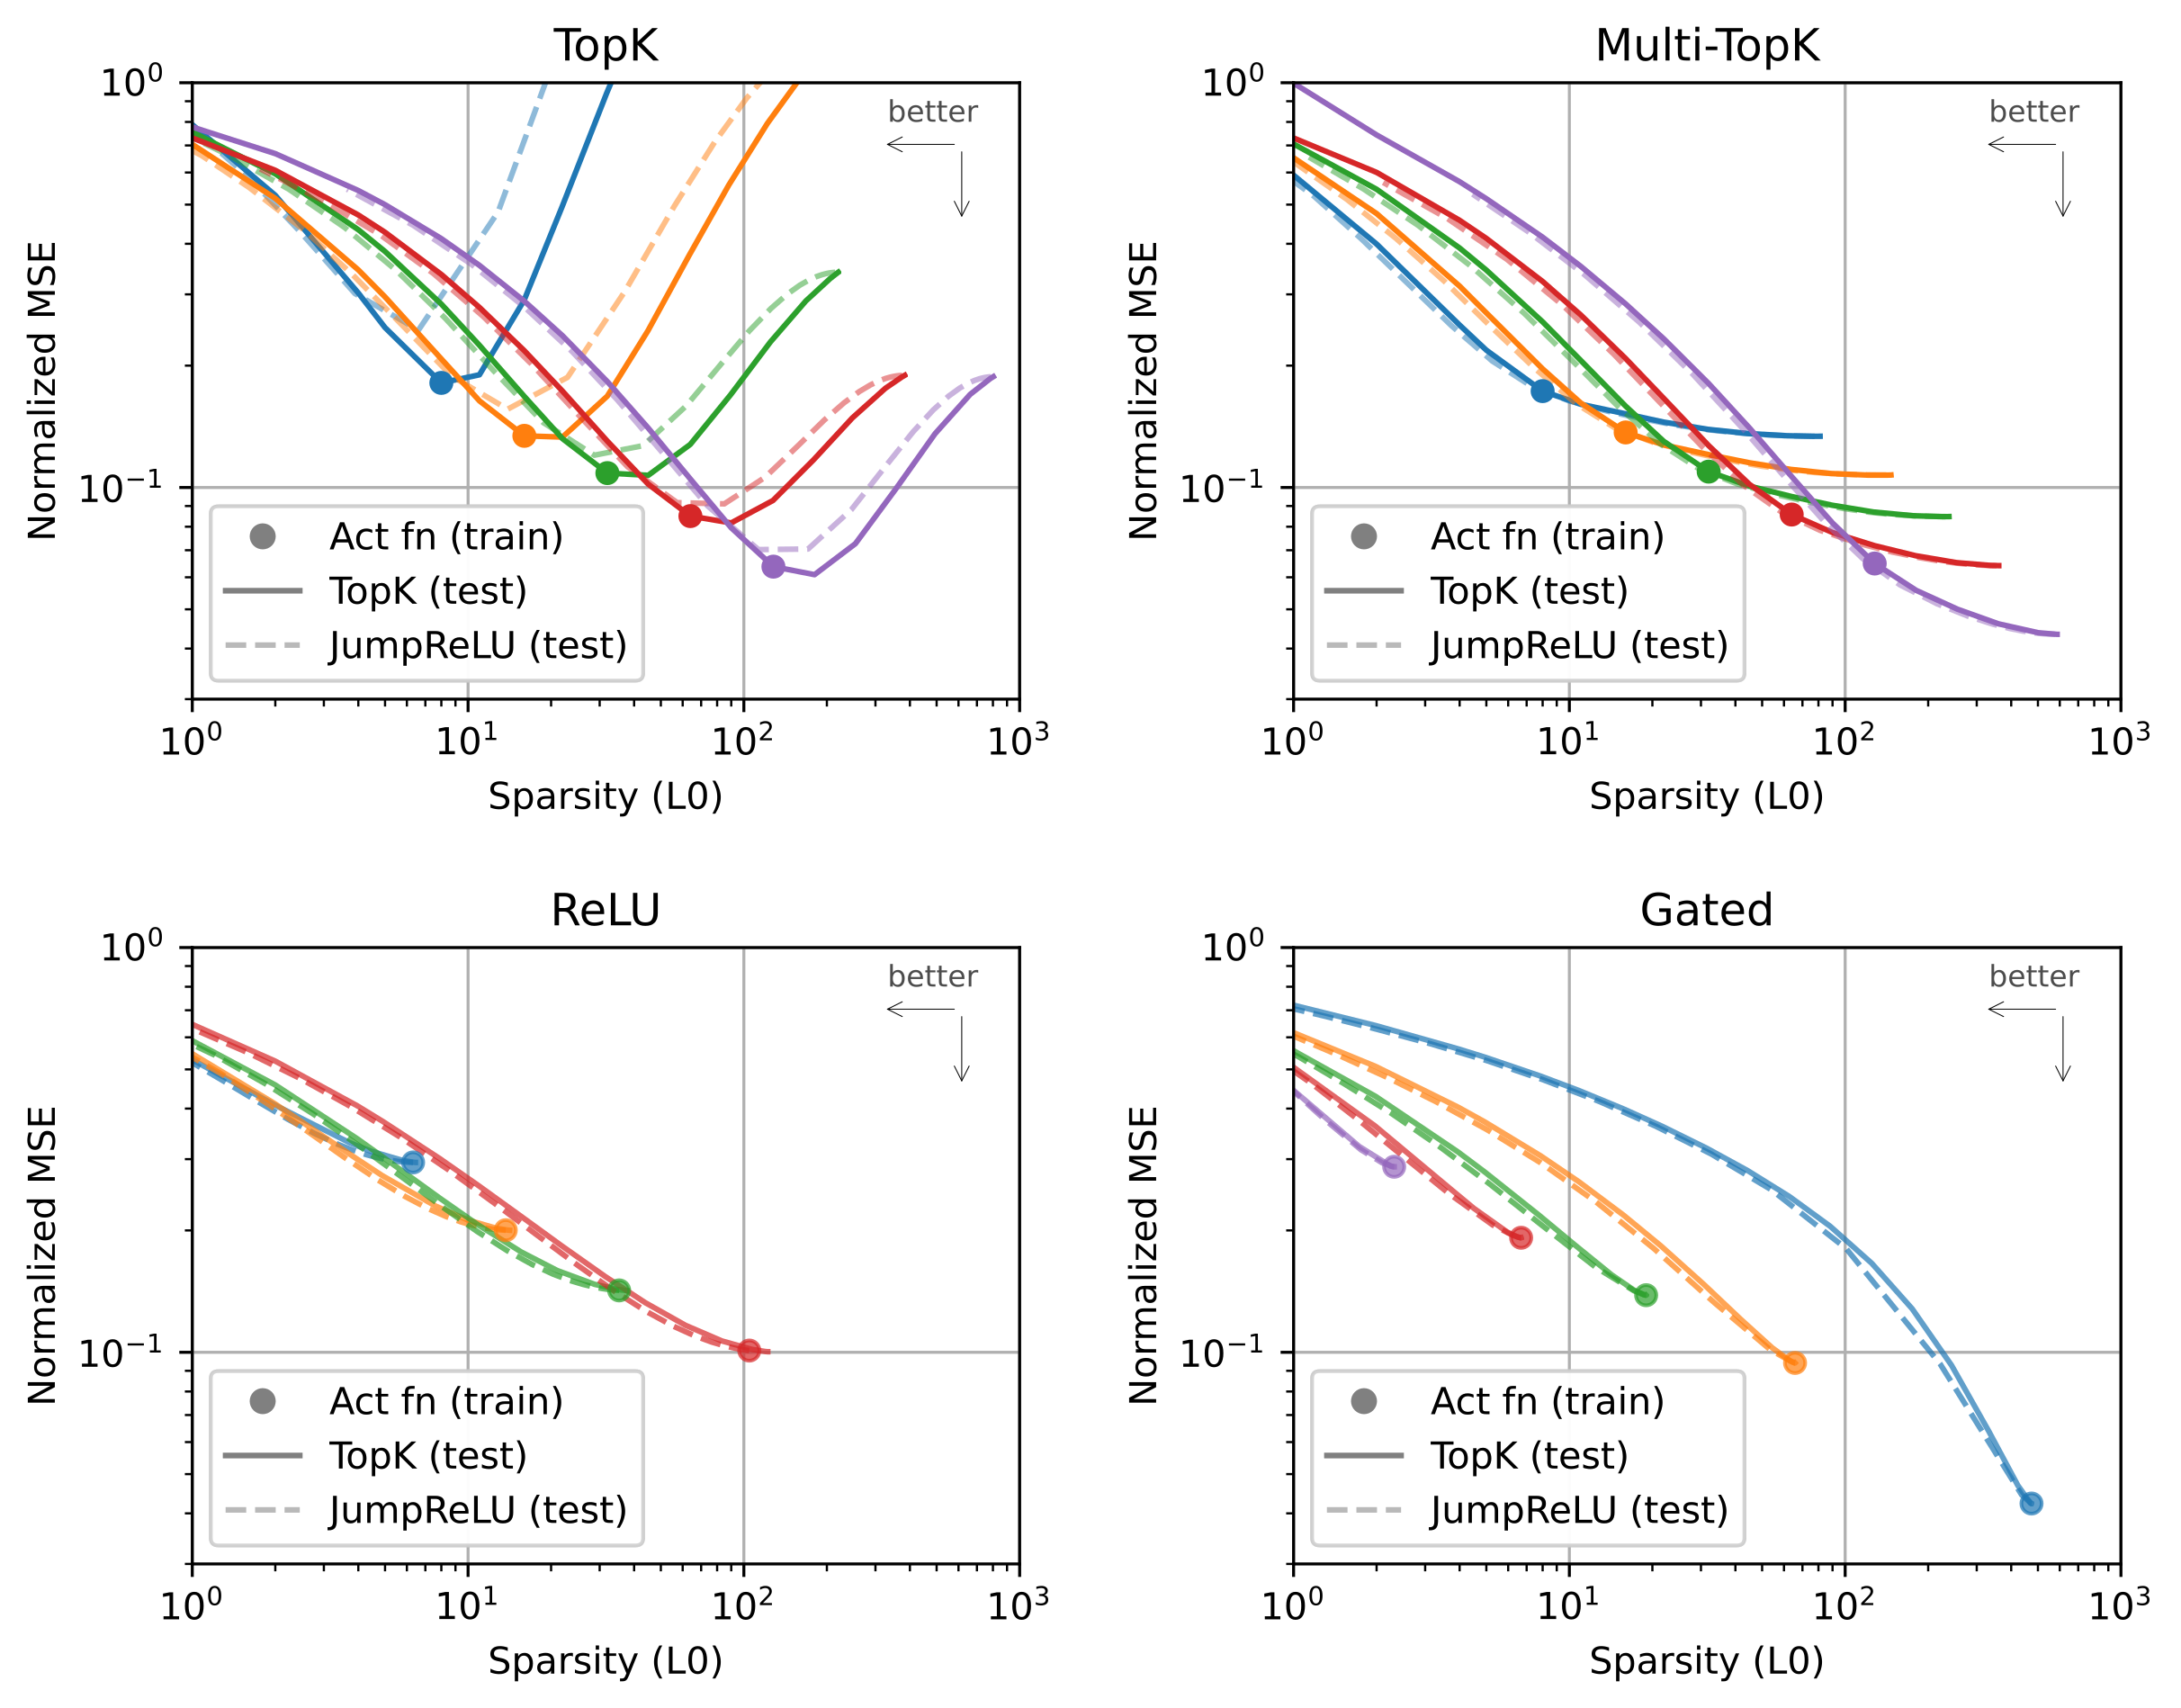
证据五:图10,测试时随意增大 k 可能反而变差。 TopK 在训练用的稀疏度附近工作较好,增加过多潜变量会让 MSE 恶化。未入选的系数不是训练好的残差信息,不能假设“保留更多数字必然更准确”。论文的 Multi-TopK 探索缓解了这种特定稀疏度适应。
五、可读方向和高恢复率仍不等于完整机制
现在给第二个方向命名为“字符串”。若它实际上只在双引号字符串的结尾激活,宽泛命名就会对单引号、字符串开头产生大量误报。漂亮的示例不能证明解释正确。
再把该方向删掉,若闭合引号的概率下降,这是行为影响证据;但还需要检查别的 token、不同输入和误差补偿,才能接近“它承担闭合字符串计算”的机制解释。
论文还给出字典宽度、稀疏度、被解释模型规模与重建误差的经验关系;这些是拟合规律,不是无限扩展时必然成立的定理。
低 MSE 和少量非零项仍不足以保证语义解释。极端宽的字典可以给几乎每个输入分配一个专用方向,重建很好却不形成可复用概念。作者在 §4 明确讨论这一退化情况。
单潜变量探针只证明某个标签可从该方向读出,不证明模型决策因果依赖该标签。消融提供更直接的干预证据,但人为删掉一个字典方向可能产生离开自然激活分布的状态,仍需结合更细的任务实验。
解释器也有偏好。N2G 擅长局部 token 模式,不擅长长距离或抽象条件。因此解释得差可能来自 SAE 特征复杂,也可能来自解释语言太弱。上下文仅 64 token 更限制了对长程功能的结论。
最后,固定 强制简单 token 和复杂 token 使用相似数量的特征,不一定符合真实计算的变动复杂度;而放大 又可能产生稠密、难解释方向。这是需要通过应用目标选择的取舍,不能用单一排行榜分数解决。
六、以冻结表示分析检验结构模型的内部行为
可回到Transformer逐层做表示干预,检查字典命名是否对应真实行为;与Mixtral的Top-k只作稀疏对象教学对照,专家路由频率不能充当本篇特征的因果证据。
自测:能否克制地解释一个特征
1. 把 n 从十万增到一百万,与把 k 从 32 增到 320,有什么不同?
前者扩大可选择的字典,但每次仍只用少数方向;后者允许单个输入通过更多信息,通常更容易重建,却可能减弱稀疏约束和可读性。比较字典质量应固定或明确报告两者,而不能把重建误差下降直接视为解释更好。
2. 为什么 98.2% 的损失恢复率仍不足以宣布几乎完全解释 GPT-4?
它依赖把激活清零这个非常差的基线,只表示相对该破坏性操作恢复了大部分损失。剩余误差仍可能损害重要行为,而且可重建的方向不一定都有正确解释。还需原模型下游损失差、解释覆盖率、误报和因果实验。
3. 一个潜变量能够高准确率预测“负面情绪”,是否证明模型用它判断情绪?
不能。它可能与负面情绪共同变化,但不是模型实际依赖的计算变量。应在匹配输入条件下干预这个方向,检查情绪相关输出是否按预期变化,同时排除一般激活破坏及其他语言行为变化。探针是信息存在证据,干预和机制追踪才进一步检验使用方式。