096|LLaDA:语言模型一定要从左到右生成吗
论文:Nie 等,Large Language Diffusion Models,2025。原文 · 正文 v1 · 作者项目页。
先接住前作的问题
BERT用双向掩码恢复学习表示,本篇把多噪声水平恢复组织为生成过程;这是历史教学联系,不是从BERT权重继续训练。Transformer的左到右分解是平行参照,比较时必须使用各自真实计算图。
五个前置概念
五个前置概念:联合分布 描述整段文本的概率;掩码扩散 通过随机遮挡与反向恢复建模;似然界 是可优化但不必等于真实似然的量;双向注意力 使用已观察到的左右信息;重掩码 决定哪些新预测暂不确定。
一、问题设定:不固定左到右顺序,怎样把掩码恢复变成生成模型
联合分布并不只允许从左到右生成。LLaDA从逐步遮挡与反向填空出发,要求训练的噪声条件、采样的揭示数量和最终无掩码边界一致;同时预测多个位置能否真正省时间,还需把每轮双向计算计入。
二、由破坏边际推导训练权重与反向揭示概率
自回归分解是 。这是一种方便计算联合概率的方式,但不是定义生成模型的唯一方式。LLaDA 用前向破坏与反向恢复来定义分布:前向随机把 token 变成掩码,反向逐渐填回内容。
设原始文本为 ,掩码比例为 。每个位置以概率 被替换为 M,得到 。当 时整段为空,当 时恢复完整文本。这里的时间是噪声水平,不是现实环境的时间步;训练也没有强化学习奖励。
与 BERT 的固定掩码比例相比,LLaDA 要覆盖从几乎完整到几乎全空的各种条件,并把这些预测组合成生成过程。双向注意力允许模型使用当前位置左右两侧已填内容,但未知位置仍然只是掩码,绝不是在推理时看到了真实答案。
只在掩码位置计算损失
论文式(3)为:
是序列长度, 从连续均匀分布采样,指示函数只选被遮住的位置。 调整不同掩码水平的贡献;它来自掩码扩散的概率推导,不能简单去掉后仍声称优化相同的似然界。连续分布下恰好采到零的概率为零,数值实现仍需注意边界。
论文引用已有理论,说明该目标是负对数似然的上界。这为生成提供概率依据,但“优化一个上界”不是已经精确求得似然,更不是有限数据、有限参数下的能力保证。理论的一致性通常需要无限数据、足够表达能力及理想优化条件。
SFT 保留问题部分不遮挡,仅随机遮住答案,并在答案的掩码位置计算同形式损失。短样本补 EOS,使模型学习不同长度;推理则去掉相应结束填充。本文模型只有 SFT,没有 RL 对齐。
迭代生成与低置信度重掩码
从时间 走向更小的 时,模型预测当前所有未知位置。理论上的随机反向过程,平均将这些新预测的 比例继续保持为掩码;其余成为下一轮可用上下文。
实际采样常优先保留置信度高的位置,把低置信度预测留到后面。它是有效的解码启发式,不能不加区分地称作与随机反向过程完全相同的抽样分布。指令模型还按块从左到右生成,块内使用扩散,因此整体可以兼具顺序与并行。
这里按“每轮增加已确定位置、最后全部确定”表达机制。v1 附录算法 5 将 定义为已揭示数量,却在后面用它指定重掩码数量,和 §2.4 的时间方向不一致;不能直接照抄这个变量用法。原文文字、概率定义和实现应交叉核对。
掩码概率和揭示数量,如何从训练接到采样?
设位置 的掩码指示为 ,在给定噪声水平 时,。于是 :单看位置权重, 补偿了较低噪声下被监督位置较少的问题。但每个位置的预测难度也依赖其他位置是否被遮住,不能进一步宣布不同 的期望损失完全相等。该权重的似然界依据仍来自论文引用的扩散推导,而不是这条计数直觉独立证明的。
在随机反向步骤中,已掩码位置继续掩码的概率必须是 。原因是前向边际在 时被遮住的概率为 ,再乘 才得到目标时间 的掩码边际;已经揭示的位置保持不变。这里 ,从大到小推进。
原创教学账本。 长度8,从 到 ,预期还留6个掩码;下一步从0.75到0.5,要对这6个位置以 继续遮挡,预期剩4个。若误把0.5当成本轮条件掩码概率,则只剩3个,已偏离所声明的时间表。低置信度方案可以确定性地选择保留哪些位置,但它保留的是数量安排与启发式排序,不是同一随机采样分布。
这提供了检查伪代码的简单不变量:终点 应无剩余掩码,且已经确定的位置不因时间推进大量倒退。v1算法5的 文字定义与重掩码用途矛盾,正应通过这个边界发现,不能因为公式出现在论文里就机械复制。
自构例子。 要补全“巴黎是法国的首都”,最初所有答案位置为空。某轮先确定“法国”和“首都”,下一轮可同时利用左右两侧信息填剩余部分。早期高置信度若错误地确定“德国”,后续也可能受它误导;因此固定位置的次序和纠错能力值得单独测量。
同一噪声水平下监督位置不是固定的一组
长度10、噪声率0.2时,期望有2个掩码,并非每次恰好遮2个。逐位置独立遮挡会有数量波动;固定遮2个则采用了另一种条件采样。两者平均数量相同也不能直接宣布训练分布相同,因为某位置的预测上下文取决于其它位置如何被遮住。
教法联系:Lilian Weng的What are Diffusion Models?。算例为本文自构。
三、按时间表迭代填空并区分随机与置信度重掩码
训练:
    采样文本 x0 与掩码概率 t
    独立遮住每个位置,得到 xt
    双向 Transformer 预测原 token
    只在被遮住的位置累加交叉熵,再乘 1/t 并更新
生成:
    输入题目;将预设答案长度 L 的位置全部设为 M
    对每个递减噪声水平 t → s:
        预测仍为空的位置及其置信度
        保留此前已确定的 token
        按本轮目标数量固定较高置信度的新 token
        其余未知位置继续设为 M
    删除结束填充,返回完整回答
四、对照同数据扩展、采样策略和方向任务
同数据的扩展曲线先检验可行性,再分别读取采样规则与反向补全;不同任务优势不能直接拼成全面质量或速度胜出。
| 项目 | 论文设置及比较范围 |
|---|---|
| 预训练 | 8B 从头训练,2.3T token,约 130K H800 GPU 小时;序列长度 4096 |
| 优化 | AdamW、权重衰减 0.1、批次 1280;预热 2000 步,分阶段稳定与降低学习率 |
| 重复次数 | 8B 预训练和 SFT 各执行一次,作者称未做超参数调优;这不适用于所有推理配置搜索 |
| SFT | 4.5M 问答对、三轮、批次 256,峰值学习率 |
| 受控扩展比较 | 1B 扩散与自回归共享结构和数据;更大比较为约 8B 与 7B,按估计 FLOPs 对齐,结构并不完全相同 |
| 外部主模型 | Llama 2/3 部分成绩按统一协议重测;Qwen 等部分成绩引用报告,训练数据和 shots 不全相同 |
| 采样消融 | GSM8K,答案长度 512、去噪 256 步,半自回归块长 32 |
| 主评估生成 | 基础模型部分生成任务长度和步数均为 1024;指令模型按任务配置,步数等于长度 |
| 选择题打分 | 基础模型部分任务以蒙特卡洛估计条件似然界;多 token 答案通常需 128 次估计 |
| 额外调参 | 部分基础选择题搜索 classifier-free guidance 强度 0—2;应计入评估与选择成本 |
| 反向任务 | 496 对中文名句,无额外微调,给下一句找上一句;不是新关系严格只见一个方向的纯合成试验 |
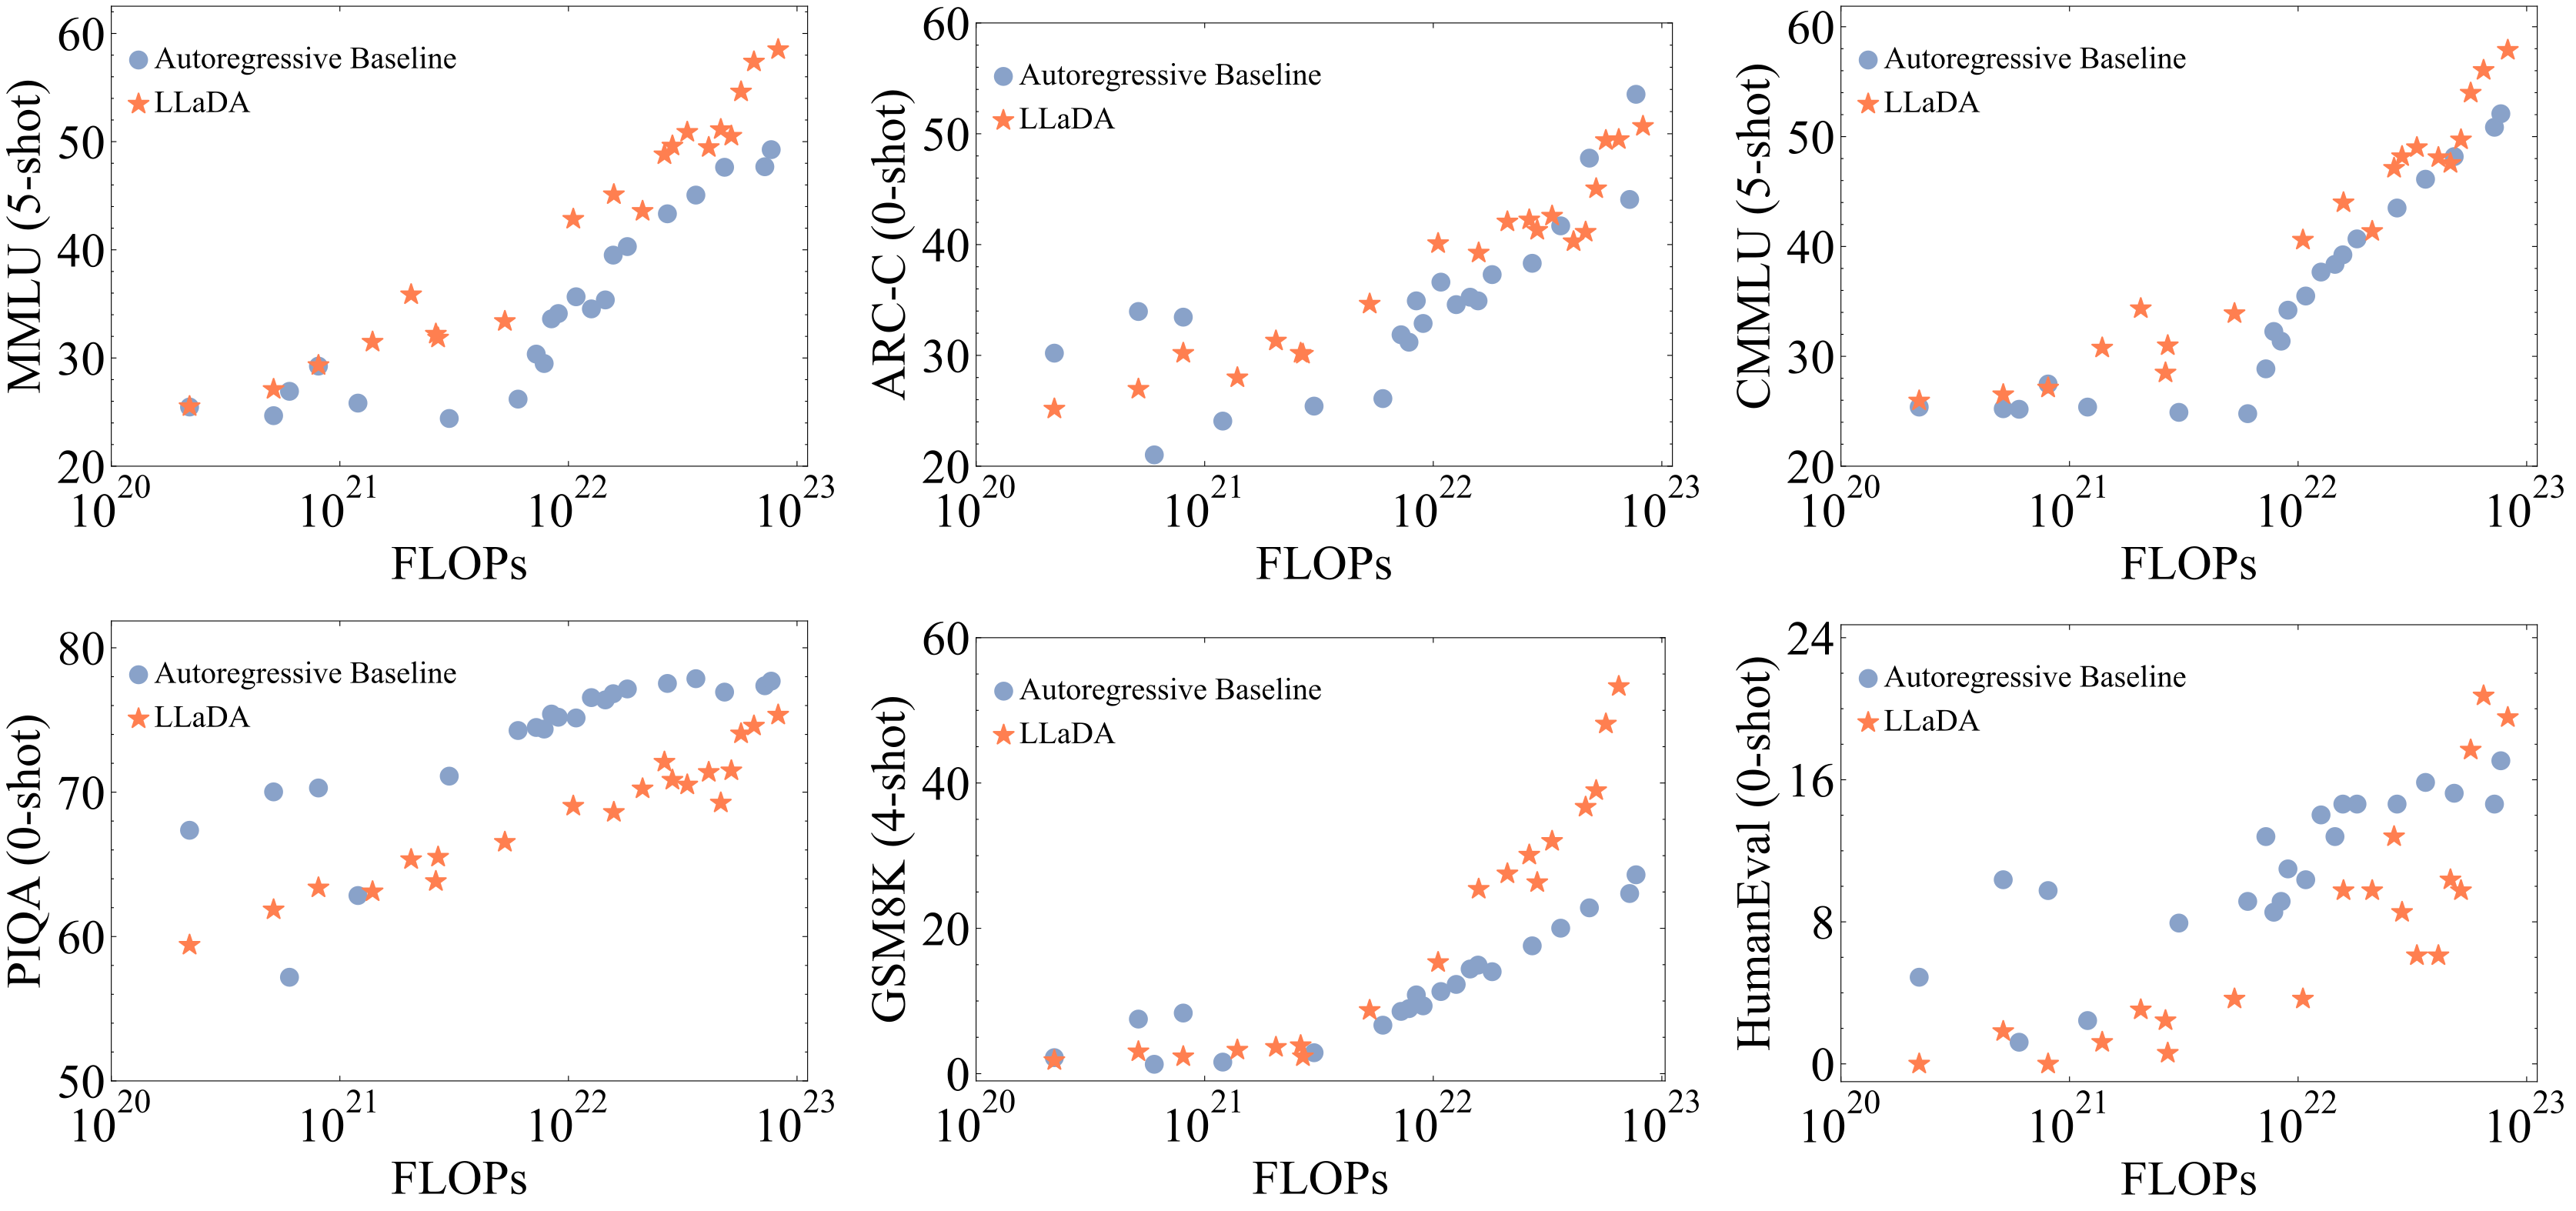
证据 1:图3,扩展趋势。 同数据对照中,扩散模型随计算增加在六项任务上呈现有竞争力的趋势。作者没有拟合定量幂律,以免离群点误导。这支持“可以扩展到较大规模”,不支持一个已确定的扩散优势指数。 规模图在同一训练数据下扫描计算 FLOPs,并比较六项任务;它提供给定架构与配方的经验曲线,不是扩散生成优于所有自回归模型的定理。
证据 2:表1,基础模型。 LLaDA 与重测 Llama 3 的 MMLU 为 65.9/65.4,GSM8K 为 70.7/53.1;PIQA 则为 74.4/80.6,HellaSwag 为 72.5/79.1。长处和短处并存,跨模型数据差异仍是重要解释,不能把所有分差都归给生成顺序。
证据 3:附录表6,采样策略。 基础模型随机重掩码 GSM8K 为 52.3,低置信度策略为 64.7;指令模型同样替换却从 72.0 降至 12.9,加上分块后恢复到 73.8。作者把问题与 SFT 中较多 EOS 填充相关联。这是非常强的提醒:训练目标没有变化,也可能因为推理规则不匹配出现灾难性退步。
证据 4:表3,反向诗句补全。 GPT-4o 正向/反向为 82.7/34.3,LLaDA 为 48.8/42.4。LLaDA 反向更好且两个方向更接近,但正向明显更弱。该结果支持较小方向不对称,不是已经彻底解决所有关系反转或证明更强的普遍推理。
证据 5:表2,SFT 之后。 LLaDA 指令模型 GSM8K 为 78.6,重测 Llama 3 为 78.3;HumanEval 为 47.6/59.8,MBPP 为 34.2/57.6。基础与指令模型的一些选择题还采用不同评价方式,因此不要把表1 到表2 的所有差值直接当成 SFT 的纯效果。
五、双向重算与单次大训练限制效率和稳定性外推
最重要的贡献是把掩码扩散推进到能够与语言模型同类任务比较的规模,使生成方式本身成为可以实证研究的变量。双向依赖和灵活填空为补全、编辑提供自然接口,但这不意味着完整系统已优化成熟。
原实现不兼容普通自回归 KV 缓存:新填位置可能改变其他位置的双向表示,每轮需要重新计算。虽然一轮能够决定多个 token,若使用很多轮或额外无条件 guidance,实际运算与延迟可能很高。主表里的质量成绩不能代替端到端速度测试。
训练数据并未完全公开,无法重建所有外部比较;8B 只有一次训练也限制了稳定性结论。论文以可扩展性、上下文学习和指令案例证明可行性,但没有证明所有这些能力只要满足生成建模原则就必然在现实训练中出现。这里应把概率理论、实验实例和宏观推断分开。
六、借用完整成本协议,但重建扩散自己的计算图
推理评估协议的完整成本原则仍适用,但自回归前缀树不能直接代替双向扩散计算图。应按每轮实际重算位置和采样规则记录成本,再比较编辑、补全与生成任务。
七、自测与答案
1. LLaDA 的双向注意力是否构成答案泄漏?
答:不构成。生成时未知位置是掩码,模型只能看到题目与已经生成的内容。训练时随机保留一些真实位置属于定义条件预测任务,并不意味着测试时获得同样的真实答案。
2. 为什么同时预测所有掩码位置,不等于一次前向就可靠生成整段答案?
答:同轮各位置基于相同的不完整上下文,预测之间可能不协调。多轮逐渐增加已确定内容,帮助后续条件化;轮数、置信度排序和错误固定都会影响质量与计算量。
3. 反向诗句比 GPT-4o 更好,能否推出总体诗歌知识更多?
答:不能。表中 LLaDA 正向明显更弱,两个模型的数据覆盖也未知。结果主要支持给定集合中方向不对称较小,必须同时比较正向、反向、训练曝光及新关系任务,才能分析知识与推理机制。