051|迭代 LQG:优化一条轨迹,也优化偏离轨迹后的修正
论文:Emanuel Todorov、Weiwei Li,A Generalized Iterative LQG Method for Locally-Optimal Feedback Control of Constrained Nonlinear Stochastic Systems,ACC 2005,300–306。作者实验室归档全文 · 会议论文副本。这篇讨论广义 ILQG,不能与作者此前的 ILQR 论文或后来控制受限 DDP 实现混为同一版本。
先接住前作的问题
动力学递推给定动作可以预测受力,最优反馈却不能轻易在整个状态空间求解。本篇沿名义轨迹反复构造局部LQG;CHOMP是不同局部优化路线,MPC可作滚动执行的教学对照。
五个前置概念
五个前置概念是:Bellman 递推把当前代价和未来代价连接起来;线性化近似局部状态变化;二次展开用曲率描述代价;仿射反馈同时包含前馈更新和状态纠偏;乘性噪声让不确定性幅度随动作或状态改变。
一、问题设定:非线性轨迹怎样同时配上偏离后的局部反馈
如果只算好一串电机命令,然后不看机器人是否偏离就照着执行,这是一种开环计划。真实运动会受噪声影响,尤其是动作越大、误差也越大的执行器。更好的结果不仅是一条轨迹,还包括偏离轨迹时怎样修正的反馈增益。
背景:为什么既不用全局网格,也不只做开环优化
全局动态规划原则上能描述每个状态应该采取什么动作,但状态维数一高,网格就迅速膨胀。仅在一条控制序列上做优化避开了状态网格,却未必直接给出附近状态的修正策略。DDP 一类方法在轨迹周围的一条“管道”内做动态规划,获得局部的反馈结构。
本篇的生物力学动机很具体:肌肉只能在规定范围内激活,动力学非线性,运动误差与激活强度相关,末端目标写回关节空间后代价也不再是简单二次函数。这些性质同样会出现在受限执行器机器人上,但论文的手臂实验是数值肌肉模型,不是仿生机械臂实机测试。
原问题写成
并最小化终端代价加沿途代价的期望:
是状态, 是控制, 是确定性动力学, 决定布朗噪声如何进入系统, 假设为凸控制集合。状态可直接观测是本文的前提;名字有 LQG,不代表已经实现带观测器的部分可观测控制,相关扩展留在第 IX 节。
二、沿轨迹线性化并反向递推控制律和值函数
方法:把局部模型、控制律和值函数同时说明白
当前名义状态与动作为 ,偏差为 。第 III 节把离散系统写成局部形式
每一列噪声系数为 。这里仅对控制方向展开噪声依赖,足以表达关注的乘性控制噪声;并未完整处理所有状态相关噪声。时间离散中噪声系数带 ,因为布朗增量方差与时间长度成正比,不能误写成普通确定性增量的 。
剩余代价近似为
在一步 Bellman 递推中,与控制相关的项可整理为
若没有约束且 正定,最小点是仿射反馈
改进名义序列, 修正状态偏差。两者缺一不可:如果初始偏差为零且没有 ,线性系统一直停留在零偏差,名义计划根本不会更新。
噪声怎样影响这个选择?第 IV 节式(6)的控制二次项含有
线性项也含有 。动作改变噪声幅度,就改变未来代价的期望,控制器可能主动少使用噪声代价高的动作方向。这与固定加性噪声不同:在本文二次近似和完全观测设定中,纯加性噪声主要影响值函数常数项,不改变控制律。不能把这个近似性质推广成“噪声永远不影响最优动作”。
配方一次平方,反馈项与前馈项就分开了
局部动作价值写成 。是相对当前轨迹的偏差,是相应一、二阶导数。当 正定且无活跃动作约束,驻点给 。
教学标量例取 ,便有 。轨迹自身可通过前馈−0.5改善;真实状态偏离0.2时,再反馈−0.15。若直接把结果截断到动作界,控制律的局部导数会改变,不能继续无条件沿用未约束的值函数递推。
原文第III–IV节明确在线性化偏差系统上求仿射控制律,并保留控制相关噪声。它与CHOMP是控制轨迹局部优化的平行路线;与Cheetah MPC是局部模型、有限时域求解的教学联系,后者凸化和接触假设不同。实验中的反馈抗扰价值不能由开环名义代价单独衡量。
约束和非凸性:不能把一个逆矩阵当成万能答案
一般代价局部二次展开后, 可能有负特征值。此时令梯度为零未必得到极小值。作者用类似 Levenberg–Marquardt 的办法,将负特征值截至零并加正则常数 ,得到正定矩阵来计算更新。
关键不只是修正矩阵,而是随后仍用实际选定的仿射控制律回代原来的局部代价,更新值函数。若一边改变控制律、一边沿用假设“已经精确最小化”的简化 Riccati 公式,递推可能不再自洽;这是本文强调的方法贡献。
第 V.B 节先求 时满足输入约束的 。早期可沿方向回退到可行区,精化阶段使用二次规划。若某个独立受限输入处于边界,原文将对应反馈增益行置零,避免局部反馈向边界外推动。它是一种局部近似,不是对任意大状态偏差都保证可行的仿射控制律。原文也直接指出,若要求对所有无界 保证有界输入,一般只能采取极保守的零反馈。
反向递推给出的反馈只有放回实际输入约束后才是同一控制律。下面检查前向更新与值函数处理,再用噪声执行比较开环和闭环。
三、更新名义轨迹,检查输入约束与控制相关噪声
输入:动力学和导数、代价、控制可行集合、初始状态、时间范围
选择可行的名义控制序列,积分无噪声系统得到名义轨迹
重复:
    沿轨迹线性化动力学和控制噪声,二次展开代价
    从终端向前递推:
        计算局部控制项 g、G、H
        修正 H 的特征值并加入正则量
        求满足输入限制的前馈修正 l
        求局部反馈 L,并按激活的输入边界修正
        将实际选定的 l、L 回代,更新值函数系数
    在局部线性系统中前向传播偏差,得到候选控制序列
    必要时重新保证候选输入可行
    用原问题评估候选表现:改善则接受并减小正则量
    否则增大正则量,再计算候选
直到更新足够小或到达计算预算
输出:名义轨迹、名义动作以及随时间变化的反馈增益
这是按原文第 VI 节整理的流程。现代实现常用不同的非线性闭环前向展开与线搜索,但不能反过来说那些实现细节都已经出现在这篇论文。原文对随机目标的数值评估细节没有展开成完整软件规范,复现应进一步核对所用代码版本。
自构例子:为什么“用力更大”未必更稳
设单步状态为 ,其中 均值零、方差一,目标是最小化 。展开可得
因此 。噪声随动作放大,等价增加了这个例子里的控制代价。这是自构一维解释,不是论文肌肉模型,也不意味着多步非线性系统只需调整一个能量权重。
四、读倒立摆和肌肉手臂的闭环对照
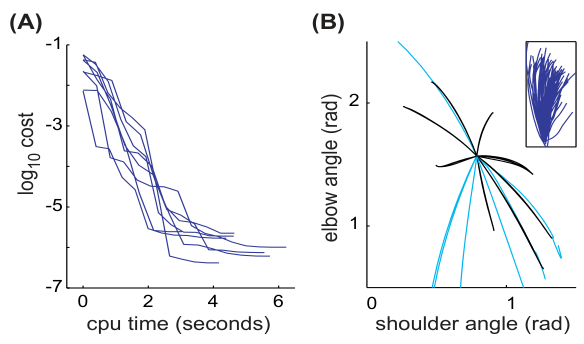
读图:A面板完整显示纵轴顶端−1刻度,成本随CPU计算时间下降;B面板保留随机初始控制的插图、黑色优化轨迹和青色差局部解,不能把每次优化都视为全局成功。
读图:左图以 CPU 时间而非迭代次数比较代价下降,右图展示不同初始化的路径。应同时看计算预算与最终代价,不能仅用一次迭代更快判断完整求解更快。
实验如何设计
确定性局部优化与随机系统近似的保证不同;作者在讨论中保留了这一差别,不能从递推形式相似推到同等最优性。
| 项目 | 原文设置 | 检验目的 |
|---|---|---|
| 倒立摆 | ,, | 非线性、输入受限的摆起和停稳 |
| 摆时间与参考 | 4 秒,10 毫秒步长;HJB 使用 状态网格 | 与数值全局解做低维对照 |
| 摆初值 | 常量控制 0、1、−1 三次重启,个别情况增加初值 | 局部极小值怎样影响结果 |
| 手臂 | 水平面两连杆、六肌肉、十维状态 | 较复杂动力学与激活约束 |
| 噪声 | 肌肉控制噪声标准差为控制信号的 20% | 显式考虑乘性噪声是否有益 |
| 反馈对照 | 开环、随机模型反馈、确定性模型反馈 | 区分反馈本身与噪声建模的贡献 |
| 初值实验 | 八个目标方向,每个十个随机初始序列 | 统计局部解的重复出现情况 |
| 计算资源 | MATLAB,3.2 GHz Pentium 4 | 报告这一实现的优化时间 |
没有强化学习训练集、环境交互预算或策略网络。优化需要可调用模型及其导数;手臂使用中心有限差分,论文称其为计算瓶颈。将“无需交互训练”理解成“没有计算成本”会遗漏这部分工作。
五组证据,以及它们不能证明的事情
图 1、第 VII 节:问题和代价。 倒立摆要求有限时间到达上方并停止,同时惩罚控制量;因此合理解既可能饱和,也可能连续改变力矩,并非纯时间最优的 bang-bang 控制。手臂终端位置和速度也进入代价,所以不能只观察路径弯不弯评价优化质量。
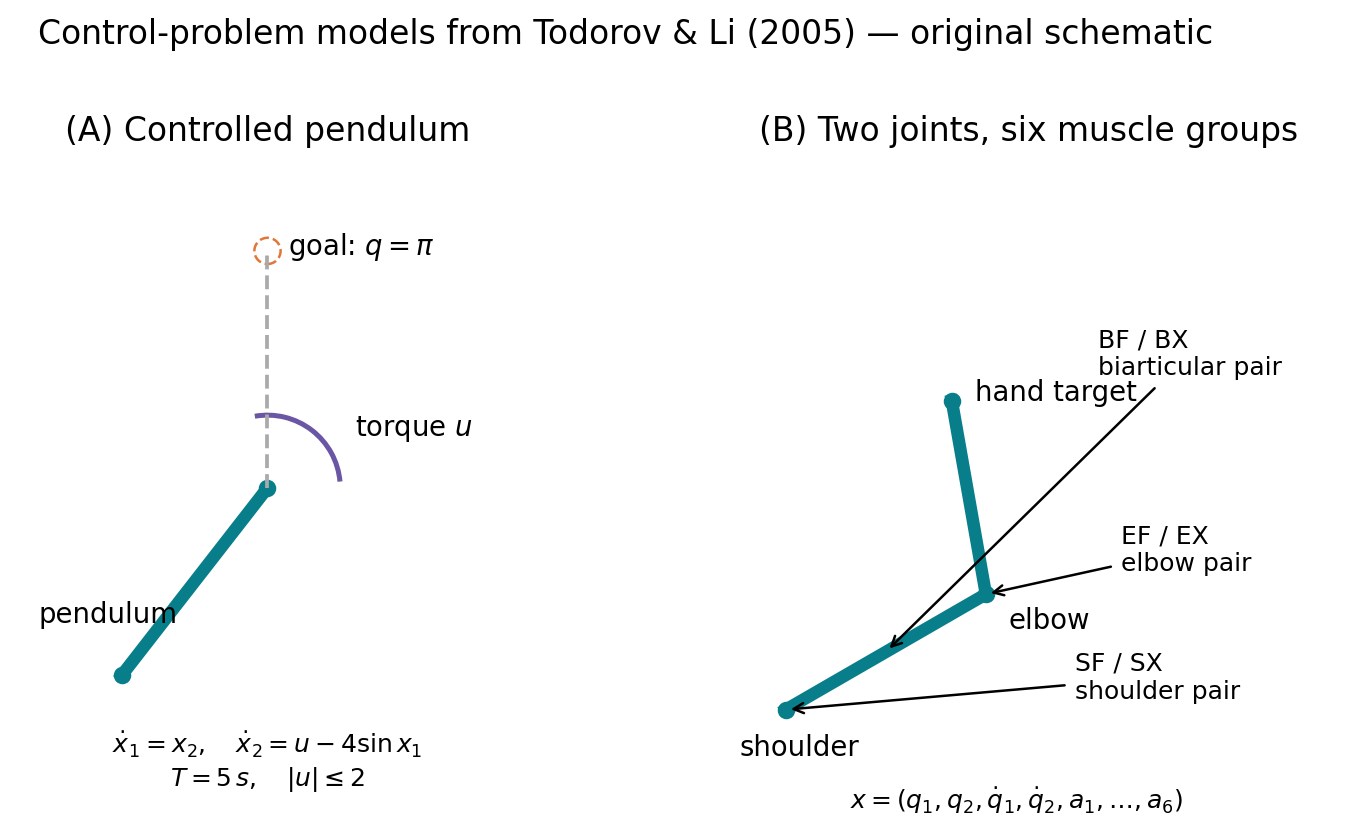
读图:左侧保留原文的摆方程、5秒时限与力矩界;右侧只画两关节与六个执行肌群的功能结构,不临摹人体外形。肌肉激活状态也属于控制状态,不能只凭末端路径评价总代价。
图 2:与 HJB 的对照。 多个起点上 ILQG 与离散 HJB 解接近;出现不符时,增加初始化可找到更好的局部解。这支持算法能找到好的候选,同时直接反驳“无需重启、必得全局最优”。HJB 本身也是有限网格数值参考,不是连续问题的精确解析真值。
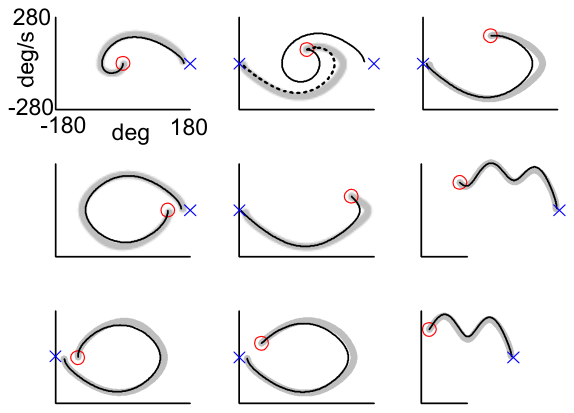
读图:九个相平面面板展示不同初态与轨迹形状;黑色轨迹可以绕行后再到目标,因此局部反馈优化不等于总沿最短几何路径运动。
图 3:手臂行为。 图中给出十六个方向的平均路径、速度和肌肉激活。作者认为这些形态与人类运动的一些特征相似,但明确没有在本篇详细论证运动控制学意义。它不能证明人脑执行了这套算法。
尚未内嵌:图 3。两种控制问题模型已独立重绘,相平面轨迹、噪声反馈和定量结果已展示;剩余为十六方向肌肉控制、速度和路径组成的大型复合实验图。缺少该次优化的完整数据,不能用任意仿真或教学线条替代。
图 4:反馈与噪声建模。 比较开环、按随机模型设计的反馈、按确定性模型设计的反馈,末端误差椭圆支持前两项设计因素的价值。图展示分布形状,正文没有给出可直接引用的统一误差缩减百分比,因此不从图片估造精确增益。
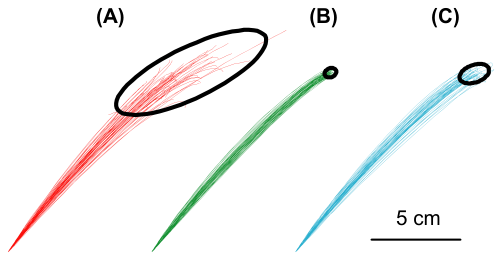
读图:三组轨迹末端的椭圆范围不同;相同目标附近的散布揭示反馈抗扰能力,而不是只比较一条无噪声名义轨迹。
图 5:速度和局部极小值。 文本报告手臂问题平均约 5 秒求得局部时变反馈。八十次初始化中七十三次接近各方向所找到的最好解,七次较差局部解。 是该初始化方案下接近已知最好解的比例,不是通用成功率,更不是已证明的全局最优概率。图 5A 横轴标 CPU 时间,不能只看正文“迭代下降”的描述便把它当作迭代次数。
五、保留初值、导数和局部近似的范围
这里的“全局收敛”涉及优化过程从较远初始化仍能受控地推进,不等于“收敛到全局最小值”。摘要同时写了局部最优,实验又显示局部极小值,二者并不矛盾。对于随机系统,第 IX 节进一步承认二次近似的最优性限制,不能只摘摘要里的保证词。
作者的贡献是让局部反馈优化在控制相关噪声、非二次代价和输入约束下更实用,并使值函数递推与实际控制律一致。本文不是一般状态安全约束方法:关节碰撞、接触互补、障碍距离等不自动包含在凸输入集合里。
由方法可推知,模型误差或大扰动可能把系统带离局部近似有效区域。高维模型的导数成本、有限差分精度和初始化会影响结果。作者提出结合状态估计、时间多分辨率和 MPC 等扩展,但不能把这些建议当作已经完成的实机系统。
六、追问:只比较无噪声名义轨迹代价,能否确认控制相关噪声处理有效?
只比较无噪声名义轨迹代价,能否确认控制相关噪声处理有效?
参考答案:不能,因为该比较可能根本没有激活所设计的噪声条件。应固定模型、初态和约束,在相同噪声协议下比较闭环与开环执行,并报告重复结果。局部反馈的收益也不能由一次成功轨迹推广为全局最优或任意扰动恢复。
七、比较轨迹平滑与滚动执行
- 平行路线:CHOMP:让整条轨迹一起绕开障碍。直接优化轨迹平滑与碰撞,目标和反馈组织不同。
- 教学联系:Cheetah 凸 MPC:用简化模型提前安排四足机器人的支撑力。比较局部反馈设计与每周期重解的滚动控制。
八、自测与参考答案
1.为什么既要 ,又要 ?
推动当前名义计划改进, 在实际或预测状态偏离名义轨迹时修正动作。只有反馈而从零偏差开始,局部系统不会自动生成名义更新;只有前馈则无法利用实时偏差纠错。
2.如果纯加性噪声不改变这里的反馈,是否可以忽略所有传感噪声?
不能。结论针对完全观测状态、局部二次值函数中的特定过程噪声项。传感噪声改变状态估计,部分可观测问题需要另外处理;一般非线性系统的高阶代价结构也可能让加性噪声影响最优策略。
3.输入边界上的反馈行设为零,是否保证强扰动下永不越界?
不能据此得到全局保证。它限制边界输入在局部状态变化下的响应,而未激活输入在大偏差时仍可能越界,模型也可能失真。实际执行仍需检查输入可行性,必要时重新优化或使用专门的约束控制方法。