052|AD*:先给有质量界的路线,再随时间和地图一起改进
论文:Maxim Likhachev、Dave Ferguson、Geoff Gordon、Anthony Stentz、Sebastian Thrun,Anytime Dynamic A*: An Anytime, Replanning Algorithm,ICAPS 2005,262–271。会议原文 · 作者证明技报 CMU-RI-TR-05-12。论文标题中的星号是算法名的一部分。
先接住前作的问题
D* Lite重用搜索状态,但严格最优解也可能来不及算。AD*把可改善的有界次优解与增量修复融合。
五个前置概念
五个前置概念是:一致启发式提供满足三角关系的下界;加权搜索用更激进排序交换解质量;一步前瞻检查邻接代价是否支持当前估计;增量搜索保留有效计算只修复受影响部分;次优界比较返回代价与当前模型的最优代价。
一、问题设定:既来不及求最优又遇地图变化时怎样保留可用路线
第一个来不及是地图太大,机器人等不到最优路线。第二个是刚算好路线,传感器又发现路被堵住。ARA* 关注前者:先交出有质量界的路线,再利用剩余时间改进。D* Lite 关注后者:地图变化时复用旧搜索,修复受影响的部分。
问题定义:质量界是相对于哪个最优解
设图有有限状态集 ,边代价为正。机器人当前状态为 ,目标为 。规划器寻找路径 ,在一次修复或改进过程正确结束时满足
是当前已知图中最便宜路径的代价, 是次优界。它不是碰撞概率,不是运行时间界,也不是相对于机器人尚未看到的真实世界最优路径。若新的障碍让旧路线失效,旧证书不能未经修复继续使用。
搜索使用一致启发式:它必须是相关最短路成本的下界,并满足相应三角条件。二维距离能否用于四维车辆规划,取决于它是否确实是放松问题的下界,不能把任意快算的距离都乘权重后宣称有保证。
输出是一条图上的动作或状态序列,不是强化学习策略。实际机器人如何构图、碰撞检查、感知障碍、跟踪轨迹,是外部系统的重要组成;AD* 不能修复漏检障碍或错误动力学边。
二、把随时改进与增量修复接到一致性状态
方法:保存两种代价,识别谁需要重算
沿用 D* Lite, 是保存的到目标代价, 是依据相邻状态做的一步更新:
目标状态的 为零。若 ,局部信息一致;若 ,发现了可能更便宜的路径;若 ,旧估计可能过于乐观,例如原通道被堵住。
AD* 管理三个集合:OPEN 放当前需要处理的状态,CLOSED 记录这一轮已处理的状态,INCONS 暂存这一轮处理后又变得不一致的状态。降低 后,INCONS 重新进入 OPEN,更新键值并清空这一轮的 CLOSED。它没有抛弃全部搜索成果。
最容易写错的细节是键值并非所有情况都用加权启发式。会议图 4 写成
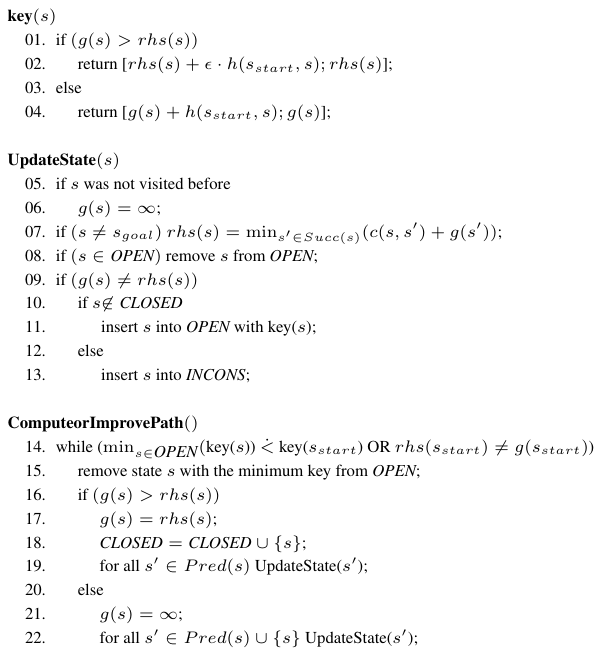
读图:图中把过一致与欠一致状态的键值分开,并用OPEN、CLOSED和INCONS保存不同状态;读循环时要同时检查g与rhs。
两个分量按字典序比较。对旧代价过低的状态不能简单放大启发式,否则会推迟传播使旧路径失效的消息。权重对“寻找改善”和“撤销错误旧信息”的作用不同,这是结合 ARA* 与 D* Lite 时不能省掉的设计。
处理 时将 降到 ,更新前驱;处理相反情况时先令 ,再更新自身及前驱,让旧的低代价失去支持。每一轮修复要满足队列和起点一致性的停止条件,才发布相应质量界。
质量界需要一份仍然有效的下界
用 表示当前完整可行路径代价,表示同一最新图上最优代价的合法下界,若已证明 ,才可推出 。这里 是该图最优代价。只给启发式乘 ,而没有完成相应的OPEN/INCONS一致性处理,并不会自动生成证书。
教学例:旧图上 ,界成立;地图变动若使这条路径含禁行边,其成本便不是12,而是不可行。若发现新捷径后实际 ,旧的 也不再是下界。两类变化分别破坏可行解和下界,说明“复用”必须带修复。
本篇直接把D* Lite的增量修复与anytime启发式搜索融合。与BIT*是教学联系:都在预算增加时改善解,但图的生成方式和渐近条件不同。原文第2节保留 与一致/不一致分类,故实验中应分开报告首解时间、截止时质量和每次变化后的恢复时间。
一个必须保留的版本说明
作者证明技报第 3 节明确把会议键值分支中的严格大于改成大于等于。技报同时将会议的 改名为 、 改名为 ,并改为前向搜索。原文脚注说明:原来的严格大于对返回路径及其 界仍然正确,但可能不满足关于其他某些状态值的更强定理主张。
因此,不能把这个修正夸大成“会议算法返回路径不正确”,也不能无声地将两版伪代码与定理交叉引用。上面的公式忠实解释会议版本;需要实现并使用更强状态值性质时,应完整采用证明技报对应版本及符号。这个区别展示了“输出正确”和“所有内部量都具有某个界”并非同一个命题。
放宽质量要求可以更快恢复可用路线,但地图改变后旧界可能失效。下面将修复和继续改进按时间预算分开执行,再读实际执行路径代价。
三、调节质量要求并修复路径,核对版本规则
输入:有限图、正边代价、一致启发式、起点、目标、初始 epsilon
初始化所有 g 为无穷,目标 rhs 为零,把目标放入 OPEN
重复进行规划轮次:
    当 OPEN 最小键优于起点键,或起点仍不一致:
        取出最小键状态 s
        若 g(s) > rhs(s):
            g(s) = rhs(s),记录到本轮 CLOSED
            对前驱重新计算 rhs 并维护 OPEN/INCONS
        否则:
            g(s) = 无穷
            对 s 及前驱重新计算 rhs 并维护 OPEN/INCONS
    若存在路径,发布本轮已验证的路径和 epsilon 界
    接收边变化,更新受影响状态
    若变化很大,按应用策略提高 epsilon 或重新开始搜索
    否则有额外预算时降低 epsilon
    合并 INCONS 到 OPEN,重算键值,清空本轮 CLOSED
伪代码是会议图 4–5 的教学组织,省略并发执行和移动起点的同步。不能在第一条路径尚未找到时随意中断,然后声称随时都有解;若旧路径因变化失效,也必须等待必要修复或由执行层采取安全动作。Anytime 描述可逐步改善的计算方式,并非硬实时操作系统保证。
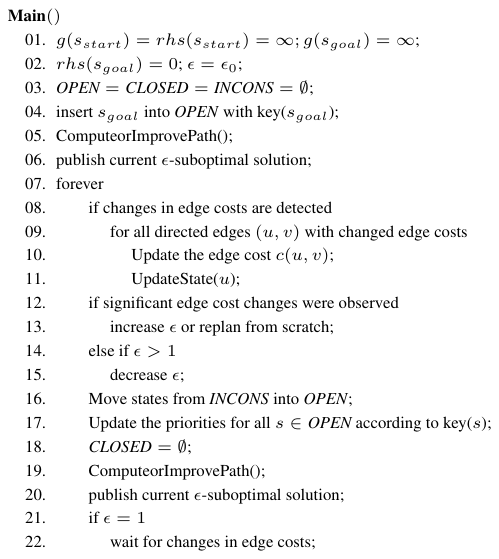
读图:主循环在有余裕时降低epsilon并重新安排队列,也在代价变化时更新受影响状态;持续改进与动态修复在同一流程中交替进行。
自构例子:一次变化可能使质量界暂时失效
假设当前图最短路代价 10,规划器以 返回代价 16,满足界。随后一条新通道打开,最优代价变为 5;旧路径仍能走,但 ,原来的质量界已经不适用。另一种情况是旧通道被堵,原路径连可行性都丢了。
这是自构例子。它解释了为何边代价降低也值得处理,以及为何“保留旧路径”不能代替一致性修复。如果预算紧,临时提高 是明确放宽质量要求;必须说明新的界对应当前图和已完成的计算。
四、读每步时间预算下的执行成本与质量界
读图:左侧给出机械臂与末端路径,右侧把环境变化概率与计算指标相连。变化越频繁时复用与重新改善解的权衡不同,不能将某一静态地图耗时概括为全部在线性能。
实验如何把时间和变化同时引入
会议稿使用反向搜索和 ,技报还涉及前向版本及键值修订。质量界必须绑定具体伪代码和该轮已完成的修复条件。
| 项目 | 原文设置 | 所验证的假设 |
|---|---|---|
| 机械臂 | 三自由度仿真,基座固定,连杆位于无障碍平面,末端向下进入杂乱空间 | 更新障碍后是否能廉价修复 |
| 地图规模 | 两种 地图,每种超过两百万状态 | 构型空间比末端二维图更复杂 |
| 边代价 | 从末端往基部的连杆运动代价分别为 1、4、9 | 最短末端距离未必最便宜 |
| 变化 | 每步有 0.04–0.2 的概率在路径上出现障碍 | 障碍出现频率对重规划的影响 |
| 预算 | 每走一步给予 1.0 秒规划时间 | 有限预算下最终执行代价 |
| 基线 | ARA* 初始权重 20,D* Lite 固定权重 20,AD* 初始权重 20 | 区分逐步改善与增量修复 |
| 统计 | 图 9–图 10 给 95% 置信区间 | 平均结果的波动范围 |
| 静态附加实验 | 障碍出现概率置零,其余每步预算不变 | 单独观察 anytime 改善 |
原文没有在所读实验描述中给出随机种子和置信区间对应的独立运行次数。这限制了统计复核,但不能因此说它完全没有不确定性报告。也不能把基线统称为“最优 D* Lite”:主要比较刻意采用固定膨胀系数 20,另有不限时、不膨胀的参考实验。
两种地图检验的东西不同。第一种基本只有一条路线,比较同一路线中关节动作的代价;第二种有短而窄、长而宽的路线,较长的末端路径可能让高代价连杆少动,从而整体更便宜。只比较路径几何长度会得出错误排名。
五组证据:不要把示例等同于普遍加速
图 6:小栅格中的计算复用。 教学地图前三个位置累计展开数为 AD* 20、ARA* 24、D* Lite 27、从头 A* 31。它清楚展示各类更新,但只是一个构造例子,不支持普遍的固定加速倍数;节点展开也不是完整耗时。
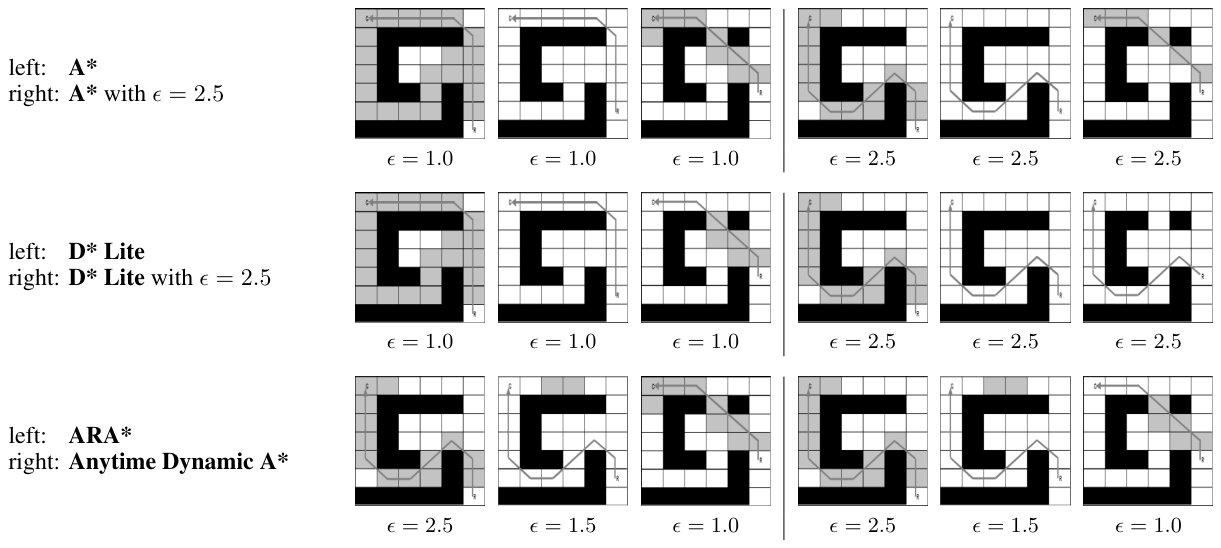
读图:三行图把A星、D星Lite及ARA星/AD星在相同障碍变化下并排比较,阴影是搜索工作,连线是路径;不能只按最后路径形状估计计算量。
理论性质一节:何时有质量界。 返回路径的次优性依赖一轮计算退出条件。单次调用内一个状态最多展开两次的性质支持终止分析,有限图、正代价和启发式条件不可删除。环境若无限快变化,或从不给足够计算时间,不能保证最终发布最优路线。更强内部状态值主张还需上面的版本修正。
图 7–8:真实平台应用。 ATRV 使用激光测距及惯性信息,规划状态含位置、朝向和速度;描述的图约两千万状态。Segway 平台也展示校园导航。这些证据支持系统集成的可行性,但没有提供跨平台的统计碰撞率、所有场景最坏延迟或独立安全认证。
尚未内嵌:图 8。已补 ATRV 平台及更新路径的三面板实证;剩余是静态 Segbot 平台照片,对搜索工作量和持续改进论证不增加独立数据,当前保留来源。
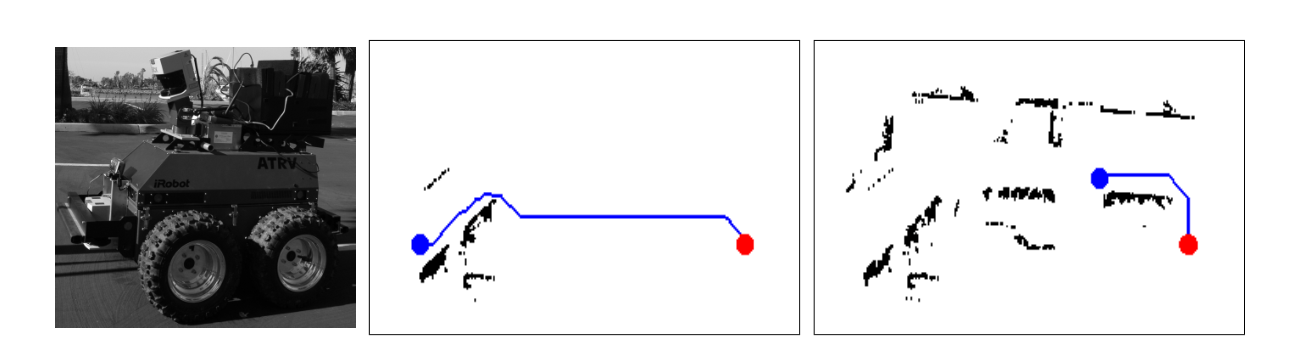
读图:蓝色路线随新障碍观测而更新,地图和平台同屏展示了集成设置;它不提供碰撞率或最坏延迟保证。
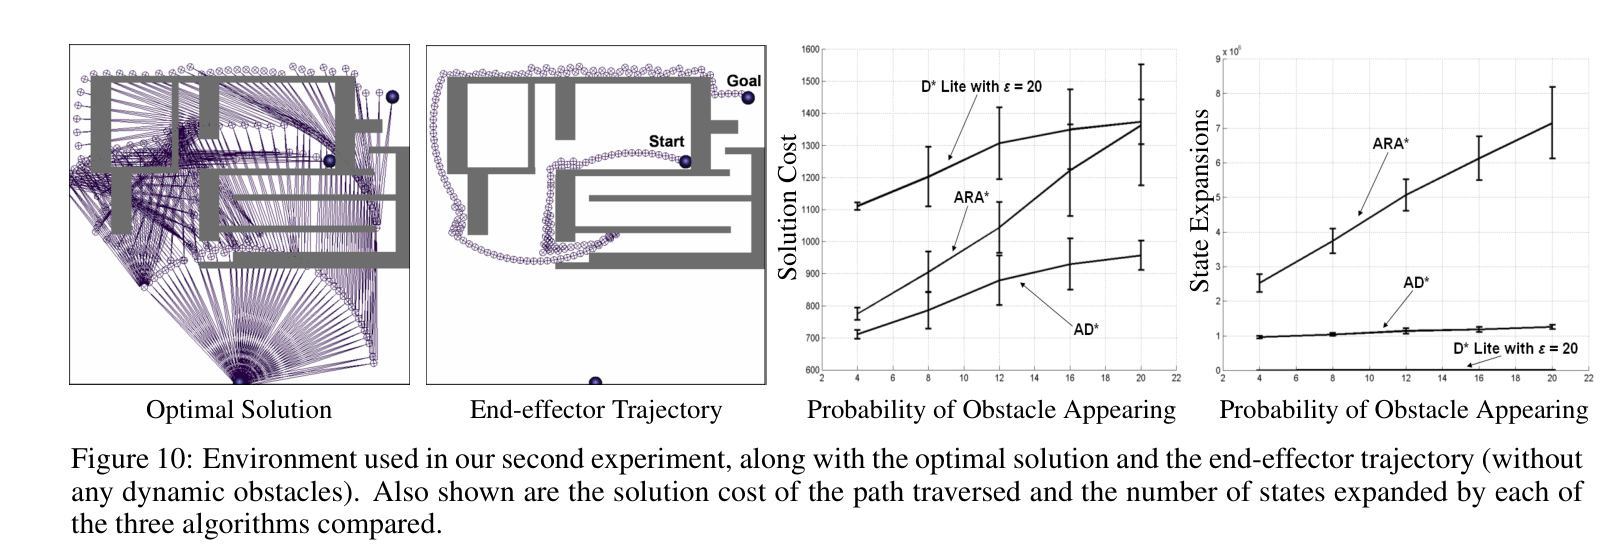
图 9–图 10:动态机械臂的质量与展开数。 AD* 相对 ARA* 的轨迹代价更好,展开更少;固定高权重 D* Lite 展开不多但路径质量较差。结果说明复用与改善的组合在所测任务中有用,不能据此否定不加权 D* Lite 的最优性,因为那不是同一预算与同一设置。
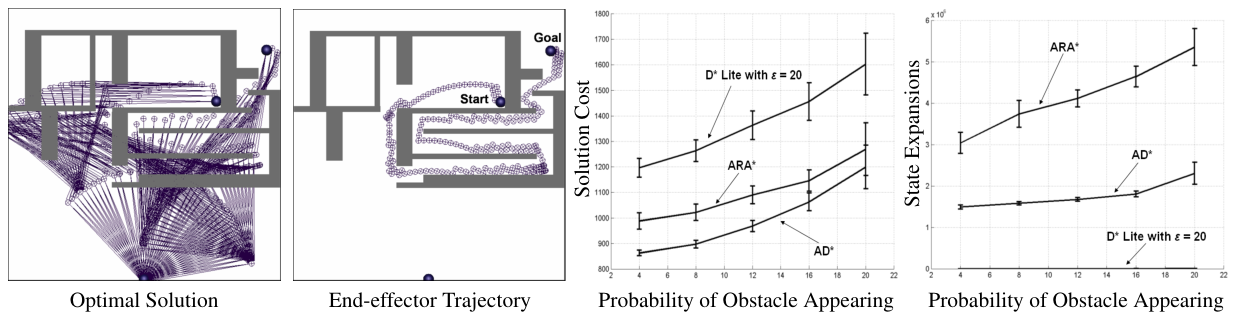
读图:左侧给出最优路线和末端轨迹,右侧分别比较解代价与状态展开;AD星的计算优势与结果次优性必须一起看。
图 11及附加参考实验:改善的是哪条路径。 横轴为已经走的步数,也等于规划轮次数;纵轴把已执行代价和当前剩余计划相加。静态实验前二十步内达到作者报告的最优水平。另一个动态参考中 AD* 平均约比不加权、不限时 D* Lite 的路径贵 10%。后者用了不同计算条件,不能当作公平的相同时限性能对照。
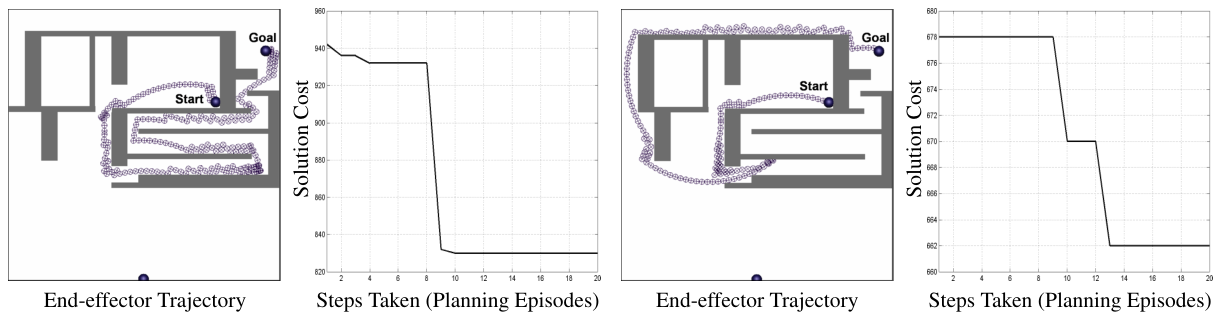
读图:每组场景后接代价曲线,横轴为规划轮次而非连续秒数;阶梯下降表明继续计算带来更低代价,但改善不是每一步都发生。
五、检查大变化、过时路径与状态维护成本
作者在讨论中直接承认,严重变化可能使修复比从头搜索更贵。怎样判断“严重”依赖应用:户外系统观察二维启发式成本变化,机械臂实验则始终能够在预算内增量修复。一个小物理障碍也可能影响大量高维构型,物理变化面积与搜索图受影响比例不是同一个量。
降低权重还需要重新排序 OPEN,这有额外成本。论文提出延迟重排等可能优化,但明确属于后续实现方向,不能当成实验已经使用的加速模块。
由算法机制可推知,若碰撞检测、图生成或启发式更新本身昂贵,只报节点展开会遗漏主要耗时。对移动机器人来说,图上包含速度也不意味着每条边自动满足执行器和地面附着条件;那些要由构图模型保证。AD* 的质量界评估规划代价,不直接保证任务安全或地图真实性。
六、追问:地图更新后,旧的质量界能否随旧路径直接展示给执行器?
地图更新后,旧的质量界能否随旧路径直接展示给执行器?
参考答案:不能自动沿用。边代价改变可能使旧路线失效,也可能改变用于界定次优性的参照。应完成相应修复并确认当前解与界的条件,再报告质量。正文的大变化例子说明,暂时放宽要求是计算策略,不是给过时结果保留原保证。
七、继续用启发信息分配采样预算
- 教学联系:BIT*:让随机采样按照值得尝试的顺序进行搜索。在采样图中同样按启发信息分配计算预算,但图构造与保证不同。
八、自测与参考答案
1. 是否意味着碰撞概率最多 50%?
完全不是。它说明在假设满足、该轮搜索完成时,路径成本不超过当前已知图最优成本的 1.5 倍。碰撞风险由地图、感知、构图和执行控制决定,不能从这个数推导。
2.为什么成本变大的状态不用同样的膨胀启发式?
这些状态的旧 可能低估真实代价,仍在支撑一条看似便宜的旧路径。若按膨胀启发式把它们排得很后,错误信息可能来不及传播到起点。修复旧错误和寻找新捷径的排序需求不同,所以算法区分处理。
3.“会议版键值有修正”是否等于原文路径质量保证被推翻?
不是。作者技报脚注明确区分:返回路径及其次优界仍正确,修正针对更强的其他状态值性质。正确做法是确认所使用的版本、搜索方向、变量含义和需要的定理,不能把一个限定范围的修正扩张为所有结论失效。