088|COLMAP 的 SfM 基础:重建质量取决于整条链,而不只取决于 BA
返回总览 · 上一篇:GPMP2 · 下一篇:ORB-SLAM2
论文:Johannes L. Schönberger、Jan-Michael Frahm,Structure-from-Motion Revisited,CVPR 2016。作者原文 · COLMAP 官方文档。
先接住前作的问题
SIFT和五点法提供可匹配特征与两视图几何,但大型增量重建还会因注册顺序和错误轨迹连锁失败;COLMAP 在这些模块上改进选图、三角化和 BA 组织。与同代ORB-SLAM2相比,本篇面向无序照片的离线完整性,两者共享几何模块而不构成前后直接替代。
五个前置概念
- 特征轨迹:多个图像观测被认为对应同一个物理点的集合。
- 三角化:由多条观察射线估计三维点,依赖基线和夹角。
- PnP:由已知三维点及二维观测估计相机位姿。
- Bundle Adjustment:联合优化相机和三维点以降低重投影误差。
- 退化几何:某些拍摄运动或点分布无法稳定决定待估参数。
一、问题设定:无序照片中的错误怎样避免沿增量重建连锁传播
给计算机几千张顺序混乱的景点照片,它需要推断每张照片在哪里拍,以及场景中的三维点在哪里。增量 SfM 从少数照片开始,一张张加入。难处是错误会传染:某个相机位置估错,三角化会错;错误三维点又会误导后续相机。
问题定义
输入是照片集合及可用的相机先验;输出是相机内外参和稀疏三维结构。它通常是离线几何重建,不是按视频时间执行的实时里程计,也不是强化学习。没有奖励、训练回合或控制动作。
SfM 的“运动”可以来自不同游客在不同时间拍摄,并不需要一个真实连续移动的机器人。无外部尺度参考时,重建通常只有相似变换意义上的唯一性。真实物体移动、季节变化、玻璃反射或重复纹理会破坏静态对应假设。
问题不仅是最后的 BA 是否收敛。图像之间匹配太稀可能使模型断开;纯旋转图像对不能稳定提供深度;错误匹配可以把两个物理点合成一条轨迹;选择病态的下一视图会导致后续连锁错误。本文把这些问题分别处理。
二、依次改进选图、三角化与束调整
1. 场景图中的边需要几何解释
第 4.1 节验证基础矩阵、单应性及有标定时的本质矩阵,区分一般场景、平面或全景式关系,并检查图像边缘的水印、时间戳等造成的假连接。
“照片有很多一致匹配”仍不足以初始化三维模型。如果相机只是绕光心转动,匹配可以很好,但缺少深度基线。系统用几何分类避免把这种连接误当成可靠三角化条件。
2. 下一张照片:不仅数点,还看分布
一张照片看见很多已知点,不代表位姿一定稳定。如果点都挤在角落,或集中在退化结构上,估计仍可能脆弱。论文以多层网格统计可见点覆盖,给更分散的观测更高分。
教学形式为:
同一格被占据一次后不会因为挤入许多点反复加分。粗层反映整体覆盖,细层反映数量。这是计算便宜的几何可靠性代理,不是精确协方差最小化,也不是机器人主动去拍摄新视角的完整策略。
这里的多尺度评分可以具体复算。按原文第 4.2 节,第 层每边有 个格子,层权重 。设 是该层被可见三维点占据的格数,那么 ; 数的是格子,不是匹配数。
原创教学构造。 只用两层: 与 。候选 A 有 100 个点,都落在同一个最细格中,因此 ,得分 。候选 B 只有 4 个点,各在一个不同粗象限中,也占据四个不同细格,因此得分 。只数点会优先 A,覆盖评分优先 B。四点在此只用于算分,不声称满足实际注册阈值;真实候选还必须通过足够对应数与几何验证。
评分仍不是严格信息矩阵。把一般重投影残差对相机参数的雅可比记为 ,局部信息近似为 , 是观测协方差。网格分散度只代理其中一部分几何条件,没有显式使用每个点的三维深度、观测噪声或共面性。因此图 5 的注册顺序实验支持“此代理在测试集上有帮助”,不证明得分高就一定有较小位姿方差;论文也明确把它作为完整协方差分析的高效近似。依据原文4.2节与第5节。
3. 一条错误合并的轨迹可能包含多个物理点
第 4.3 节采用基于 RANSAC 的鲁棒三角化。两视图样本要有足够夹角和正深度,再验证其余观测是否支持同一个点。找到一致集合后,把它移除并继续处理剩余观测,恢复错误合并轨迹中的其他点。
普通“所有观测一起最小二乘”可能被大比例外点拖走。递归方案允许一条输入轨迹被拆成多个三维解释。随机采样仍有概率与预算条件,“可处理高外点率”不能写成任意有限时间内百分之百恢复。
4. BA、过滤、再三角化形成循环
核心 BA 目标仍是熟悉的鲁棒重投影误差:
是相机参数, 是三维点, 是图像观测。新照片加入后做局部 BA;模型增长到一定程度再做全局 BA。姿态修正后,之前无法三角化的观测可能变得可用,所以再三角化、轨迹合并和外点过滤要重新检查。
这一设计不是简单放宽阈值以留下更多点。论文强调新增观测仍应符合过滤阈值,以增加冗余而非积累垃圾。非凸 BA 仍依赖初值;鲁棒损失也无法保证纠正所有错误关联。
5. 冗余视图分组
对已经较稳定、重叠很高的一小组照片,固定组内相对参数,优化共同组变换,减少全局 BA 的独立相机变量。最近受新观测影响的照片则保留独立调整能力。
这是近似计算取舍,不等于删掉所有相似照片,也不是所有视图都永久绑在一起。组越大、重叠门槛越宽松,可能更快,也可能牺牲精度。
数学目标主要是重投影一致性;机制改进涉及顺序、关联和变量组织;最终指标还有完整性和耗时。不能把低重投影误差当作唯一目标并通过大量删点“刷好看”。
新相机可能依赖旧三维点,旧点又要被新增视角修正。下面沿注册与重三角化检查这个循环,再分开评价覆盖、精度与时间。
三、注册相机并重检旧点,用局部错误检查传播
6. 教学伪代码
输入:照片、匹配、可用内参
几何验证图像对,标注退化类型并剔除伪连接
选择可三角化的初始图像对,建立初始相机和点
只要仍有可注册照片:
    根据可见三维点数量及多尺度覆盖选择下一张
    鲁棒估计相机位姿,验证注册质量
    对关联轨迹递归三角化,检查正深度与夹角
    局部 BA,过滤坏观测
    模型增长触发全局修正时:
        再三角化;BA;过滤;补全或合并轨迹
        必要时再次迭代,直到变化变小
        对稳定且高重叠视图使用分组参数化
输出:注册相机、内参、稀疏点及其观测轨迹
教学例子与前置概念
自构例子,未运行。 候选照片 A 看见 100 个点,全挤在左上角;B 看见 70 个点,分布在整幅图像。只数点会先选 A,多尺度覆盖可能更偏向 B。没有数值仿真时不能断言 B 一定误差更小,因为三维布局和基线同样重要。这个反例帮助理解“可靠性代理”与“保证”之间的距离。
四、分开读注册完整性、点数、误差与耗时
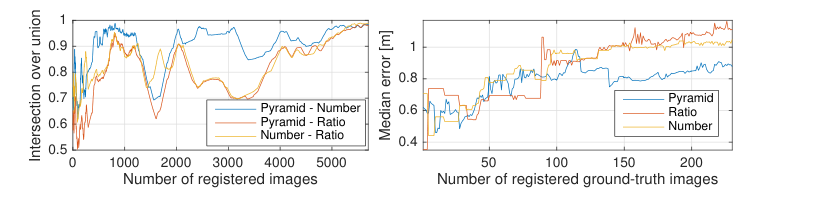
读图:两面板将注册数量与位置误差分开:注册集合相近仍可能得到不同精度。覆盖评分帮助选择注册顺序,但曲线并未证明该代理等于严格的位姿协方差。
实验设置与预算
本篇研究增量 SfM 稀疏重建;当前 COLMAP 的稠密立体及后续插件能力不能用来解释这篇原始结果。
| 项目 | 原文设置及含义 |
|---|---|
| 数据规模 | 17 个互联网照片集合,共 144,953 张;照片分布无序且视角密度不均 |
| 真值 | Quad 提供相机位置参考;其他集合不能一律宣称有完整三维真值 |
| 对照 | Bundler、VisualSFM、Theia 等;Theia 结果由其作者提供 |
| 匹配输入 | RootSIFT,每张匹配词汇树检索的 100 个近邻;词汇树在无关数据上训练 |
| 计时范围 | 2.7 GHz、256 GB RAM;不含对应搜索,不能称端到端全流程耗时 |
| 输出统计 | 每个集合报告最大重建连通分量,而不是所有成功子模型总和 |
| 模块实验 | 选视图、鲁棒三角化、分组 BA 的独立研究;随机种子与误差条未完整报告 |
五组结果怎样读
图 5:顺序影响精度。 在 Quad 上,不同策略最终注册集合接近,但本文顺序获得较低位置误差。这支持“注册数量相同也可能质量不同”,不能证明覆盖分数等于真实不确定性的精确排序。
表 2:递归恢复与计算预算。 非递归穷举得到 861,591 点、约 120.44M 样本;表中非递归 RANSAC 的一个配置得到同样点数、约 3.89M 样本。样本数量约减少 96.8%,并不是运行时间必然同比下降。递归 RANSAC 可恢复更多点,但平均轨迹长度略变,不能只挑点数讲胜利。该表与图 6 的置信参数标注并不完全相同,复现应核对具体配置而非混用。
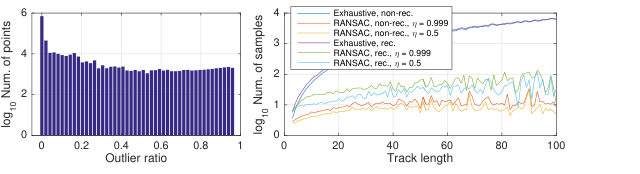
读图:左图是数据本身的外点分布,右图是不同策略的平均抽样数;两幅的横轴含义不同。
表 1:完整性改善。 Rome 74,394 张输入中,本文最大分量注册 20,918 张,VisualSFM 为 14,797 张。差值 6,121,按后者为基线约增加 41.4%;仍有大量照片未进入这一分量,所以不是“所有输入都重建成功”。本方法 10,912 s,VisualSFM 6,012 s,也不是速度全面领先。
Quad 的位置精度。 正文报告本方法 0.85 m、VisualSFM 0.89 m、Bundler 1.01 m。相对 VisualSFM 的差值为 0.04 m;不能把其他无真值集合的像素误差都称为厘米级空间精度。表 1 中某些数据的重投影误差也并非本方法最小。
图 8:分组有收益也有代价。 不同重叠阈值下,总耗时改善和重投影误差共同变化;论文举例从 0.26 px 到 0.27/0.28/0.29 px,对应不同压缩程度。Colosseum 的特定配置报告整条重建管线耗时下降 36%,不能推广到每个集合,也不能加上已排除的匹配阶段后仍照搬该比例。
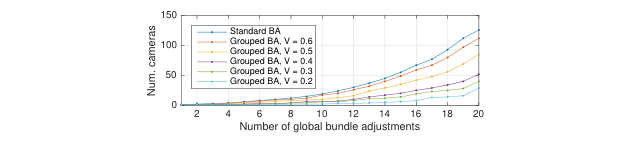
读图:纵轴是进入优化的相机数量;它解释工作量来源,却不是算法耗时的直接测量。
以上证据见原文第 5 节。重建更多照片与更长观测轨迹增强冗余,是合理解释;“一定更准确”仍需真值支持。
五、保留纹理、初始对与几何退化限制
论文的重要性在于系统工程与算法机制相互配合,缓解增量错误传播。它沿用经典匹配、PnP、三角化和 BA,新增的是更稳健的组织与修正策略,而非从零创造 SfM。
作者的实验证据主要是无序照片集合。我的分析是,它不直接覆盖动态场景、无纹理物体或在线控制延迟;大量 RAM 的实验也不能当成移动机器人板载实时方案。重复纹理仍可能生成几何自洽但物理错误的结构。使用当前 COLMAP 时应固定版本、相机模型、匹配方法与过滤阈值,现代默认选项不必与 2016 年一致。
六、追问:三角化点加入后,为什么后续视角可能迫使它被拆分或重建?
三角化点加入后,为什么后续视角可能迫使它被拆分或重建?
参考答案:早期少量视角只能对当前关联作局部几何解释,后来的观测可能揭露同一特征轨迹中混入了不同物理点。应检查哪些观测仍满足同一个三维点的重投影关系,而不是永久固定第一次三角化结果。重三角化改变的是错误传播链中的假设,不是单纯增加点数。
七、比较无序重建与时序SLAM
- 平行路线:ORB-SLAM2:把单目、双目和深度观测接入同一套 SLAM 后端。时序实时SLAM与无序离线SfM共享几何模块,但预算和完整性目标不同。
八、自测与参考答案
问题 1:为什么重投影误差更小不一定代表 SfM 更好?
答案: 大量删掉困难照片和点也能降低误差;错误但自洽的结构也可能残差小。应结合注册照片数、轨迹长度、空间真值和失败案例,且保证评估对象相当。
问题 2:一条特征轨迹为什么需要递归三角化?
答案: 错误匹配可能把不同物理点的观测合在一起。先找一个一致集合,只解释其中一个点;移除后继续处理剩余观测,才能恢复被误合并的其他点,而不是把它们全部当外点丢掉。
问题 3:论文的下一视图选择能否直接控制机器人去拍照?
答案: 不能直接等同。这里从已有照片集合中选择注册顺序;主动机器人还要选择可达相机位姿、考虑碰撞、运动成本和未知区域的信息收益。两者共享视图质量思想,但决策空间和约束不同。