093|OLMo 2:把语言模型的训练过程变成可以研究的对象
论文:OLMo Team 等,2 OLMo 2 Furious。原文 · 正文 v2 · 官方训练代码。首次提交时间为 2024 年 12 月 31 日;arXiv 编号以 2501 开头不意味着首次提交发生在 2025 年。
图表来源:OLMo Team 等,2024,原文;CC BY 4.0。本篇展示做了PNG格式转换,图中数据与标签未改动。
先接住前作的问题
Chinchilla强调模型、数据与计算共同决定结果,本篇进一步提供中间检查点和日志以审查形成过程。DeepSeekMath的领域训练是平行配方,后训练中的DPO则是明确组合的模块。
五个前置概念
五个前置概念:残差连接 将新计算加回已有表示;RMSNorm 根据均方根控制数值尺度;退火 逐步降低学习率;模型 soup 对兼容检查点的参数取平均;开发集 用于做研发选择,因此不同于最终盲测集。
一、问题设定:只有权重时无法归因,怎样观察稳定性与后期能力形成
OLMo 2是7B与13B稠密自回归解码器。预训练与中期训练都预测下一token,中期改变的是数据分布和学习率;指令后训练才引入示范、偏好与奖励。要解释尖峰和数学短板,需要观察这些阶段,而非只比较最终权重。
论文把超过九成预训练计算用于广泛网页等语料,再把较小比例预算分配给质量筛选和能力补足。高质量在这里是操作性定义:分类器分数、数学内容、参考文本、合成解题数据等,而不是对所有潜在用途都更优的标签。
尤其值得注意的是评估隔离。开发时作者监测指定任务,并只使用 GSM8K 的 200 道评估题作为 GSM* 开发子集;另外保留未用于研发决策的任务。剩余题可以提供更强的外推检查,但最终整个 GSM8K 得分并不是完全未参与开发的纯盲测。其他对照模型是否用过相同任务,论文也无法保证。
二、分开数值稳定、数据退火与兼容分支平均
控制残差分支和注意力数值尺度
常见预归一化先规范输入再计算子层。OLMo 2 将归一化放到注意力与 MLP 的输出、残差相加之前。按照 §3.3.2 的对照表,可写成:
是块输入, 是中间残差状态。注意这不等于把整个残差和再归一化的标准 post-norm。论文 §2.2 式(2)把 MLP 输入写为 ,与 §3.3.2 表格的 不一致;上式明确采用后者,实际复现应进一步固定代码版本核对。
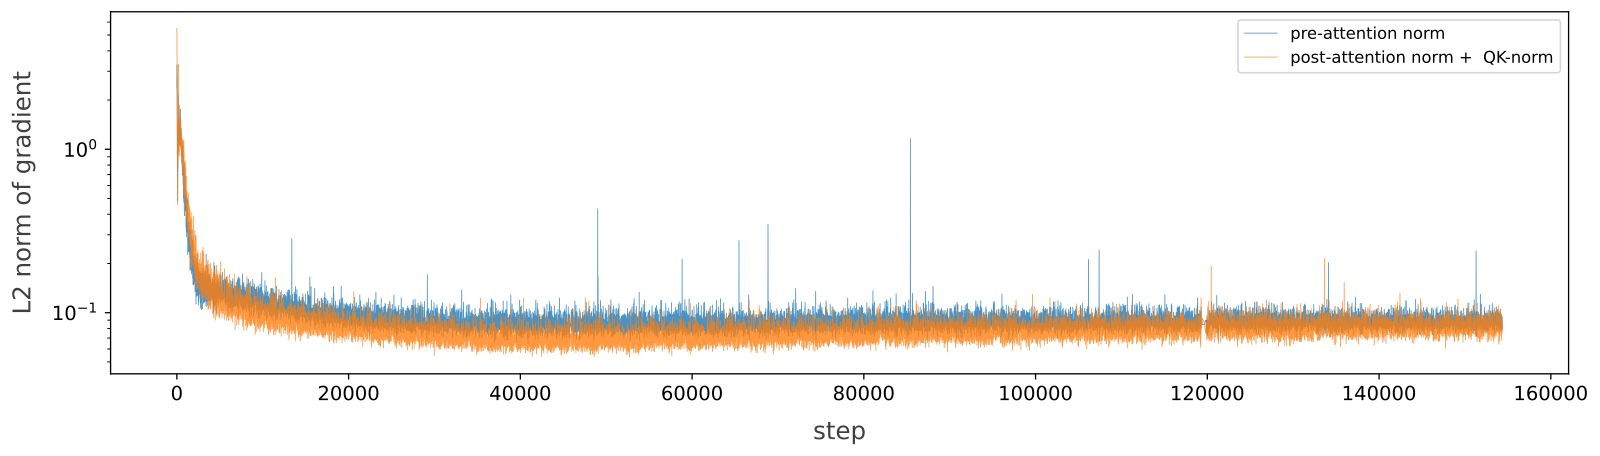
QK-norm 在点积前规范查询和键,避免注意力 logits 无限制增大;重排归一化控制注入残差流的子层输出。作者发现两者单独改变效果不理想,联合改变才减少梯度尖峰,因此不能把它们拆成互不依赖的万能技巧。
z-loss 的形式是 ,其中 , 为词表 logits。交叉熵主要约束相对概率,z-loss 额外约束归一化常数的尺度。系数存在原文口径差异:表3 写 ,§3.3.3 写 ;不能在没有代码配置证据时替作者选定一个“准确值”。
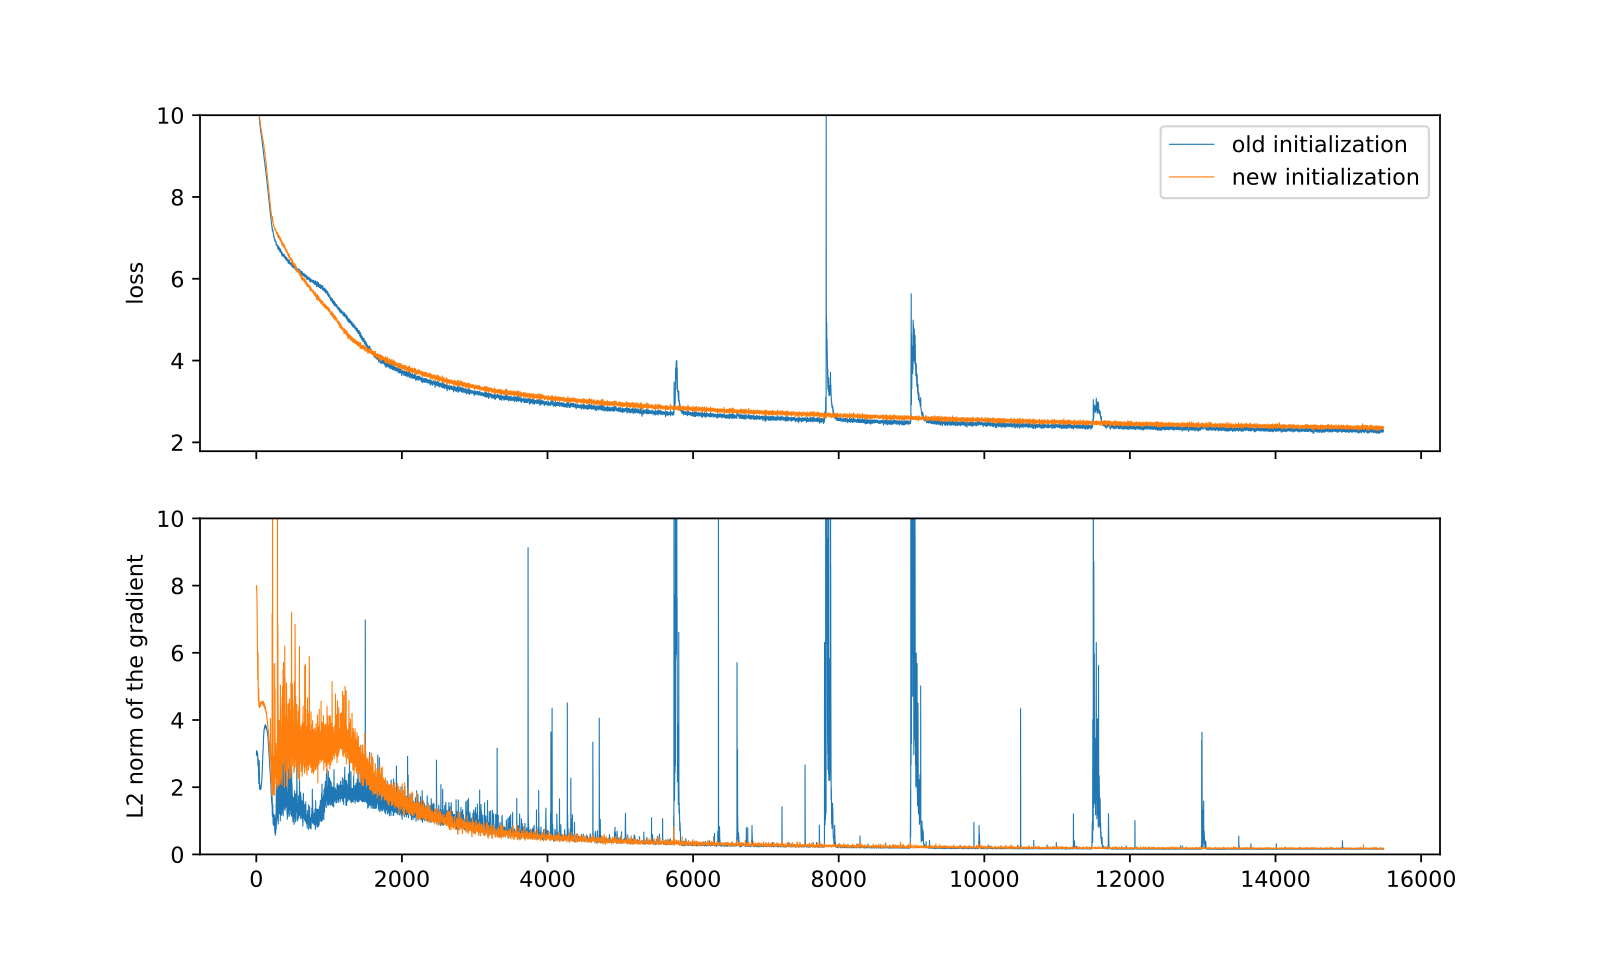
训练还改用标准差 0.02 的截断正态初始化,降低 AdamW 的 ,取消嵌入的权重衰减。这些修改主要改善优化轨迹,不应被描述成新的语言建模任务。
交叉熵看不见的整体平移,z-loss 为什么看得见?
令词表位置 的概率 ,,正确词下标为 。交叉熵为 。把所有logit同时加常数 后,归一化常数变成 ,所以 。训练预测质量相同,数值尺度却可能不同。
z-loss的导数则为
当 时,梯度下降倾向压低整体尺度;反之倾向抬高。它约束的是log-sum-exp,并非把每个logit的绝对值都压成零,也不能单独排除某些词具有很大的负logit。
原创教学例。 两个词的logits取 或 ,两种情况下概率都是 ,正确词交叉熵都是 ;z-loss却分别为 与 。若统一平移到 ,概率仍不变,而 、z-loss为0。这个例子明确了新增正则项到底约束哪个自由度。
它也解释为何“前向损失一样”不是实现等价的充分检查。§3.3.3 对两种z-loss实现记录到反向轨迹差异;复现需要比较梯度和数值精度。当前v2中表3与§3.3.3的系数、§2.2式2与§3.3.2的MLP输入仍各有不一致;上述机制推导对任意给定正系数都成立,但不能替代锁定训练配置与代码提交。
Microanneal:先用短训练评估数据来源
昂贵做法是对每种数据配方完整训练模型;论文从同一个成熟检查点出发,将某类数学数据与普通高质量文本混合,短程训练并让学习率线性降到零。这样可以较快观察某个来源是否值得进入最终混合。
退火可概括为 。 是这一分支的训练步数,不能让不同长度实验沿用同一个衰减终点,否则比较的不只是数据。作者共执行 19 次 microanneal、合计 130B token;这些探索费用应计入配方研发,而非只算最终的一条训练曲线。
权重平均是 ,不是每次回答运行 个模型再投票。它要求分支结构、参数坐标兼容;论文从共同检查点退火,并不能推出任意独立训练模型都能直接相加。
后训练的 RLVR 使用 PPO 和价值函数。验证奖励可以由数学答案或约束检查给出;价值函数用奖励模型初始化,这与“在线奖励必须来自那个奖励模型”是两件不同的事。13B 又按混合任务、GSM8K、MATH 分阶段训练,每阶段重新初始化价值函数。
权重平均前先检查参数坐标是否对应
两个同结构网络可以通过交换隐藏通道而实现同一函数,但直接平均对应数组未必保留该函数。共同检查点出发的退火分支更有理由保持坐标对齐,却仍要验证任务性能。因而模型soup的成本应算所有分支,收益应测平均后的单模型,不能当成无训练费用的输出集成。
三、从共同检查点试配方并保存完整训练轨迹
输入:预训练检查点 θ0、候选数据来源、固定开发评估
对每个候选来源:
    与普通文本组成短程混合,记录重复率和 token 总量
    从同一个 θ0 开始训练,并把学习率线性降至零
    评估 GSM* 与通用能力,剔除明显无效的来源
组合最终 Dolmino 数据混合
从 θ0 启动若干不同数据顺序的退火分支
对兼容分支的参数做平均,得到基础模型
执行监督微调 → 偏好 DPO → PPO 可验证奖励训练
在未用于选择配方的任务上评估,保留完整日志
输出:基础与指令模型,以及可追溯的训练材料
四、按尖峰、数据曝光和阶段能力读取对照
稳定性分数的基线不同,退火效果又同时改变数据与训练量;先保留各自实验口径,再判断哪种因果解释尚未成立。
| 项目 | 设置及比较含义 |
|---|---|
| 预训练数据池 | 表1 约 3.90T token,超过 95% 为网页;数据池大小不等于所有模型的累计 token 用量 |
| 架构与批次 | 7B 为 32 层、隐藏维 4096、批次 1024;13B 为 40 层、隐藏维 5120、批次 2048;序列长 4096 |
| 最终中期分支 | 7B 平均三个 50B 分支;13B 平均三个 100B 与一个 300B 分支;须区分单分支与总耗费 |
| 训练预算口径 | §2.1 与后续配方对 7B 的 3.9T/4T 使用了不同近似口径,表9 明确以 4T、5T 预训练检查点比较,不拼接成虚假的精确总量 |
| Microanneal | 共 19 次、130B token;表12 的各配方总量不同,不是统一预算控制实验 |
| SFT 与偏好 | 939,104 条 SFT 提示;DPO 提示约 366.7K/377.7K,包含本模型生成的回答及 GPT-4o 评价 |
| RLVR | 表18:PPO 每批四次更新,裁剪 0.2,生成上限 2048;7B/13B 最大 episode 数 100K/200K |
| 重复与选择 | 后训练调参采用一个或四个种子;权重平均使用不同数据排列;主榜不是所有结果均配置信区间的多次完整训练 |
| 计算设施 | §6 描述 H100 集群、网络与训练基础设施;集群总卡数不能当作每个消融实际占用卡数 |
自构例子。 一个学生会看程序计算结果,却不擅长用自然语言解释。把同一道题的程序轨迹改成逐步文字,可能更贴近目标考试;但改写后长度翻倍,训练时也看了更多 token。要验证“表达形式”本身,必须另做等 token 或等 FLOPs 对照,避免把多练习的收益全部算到改写上。
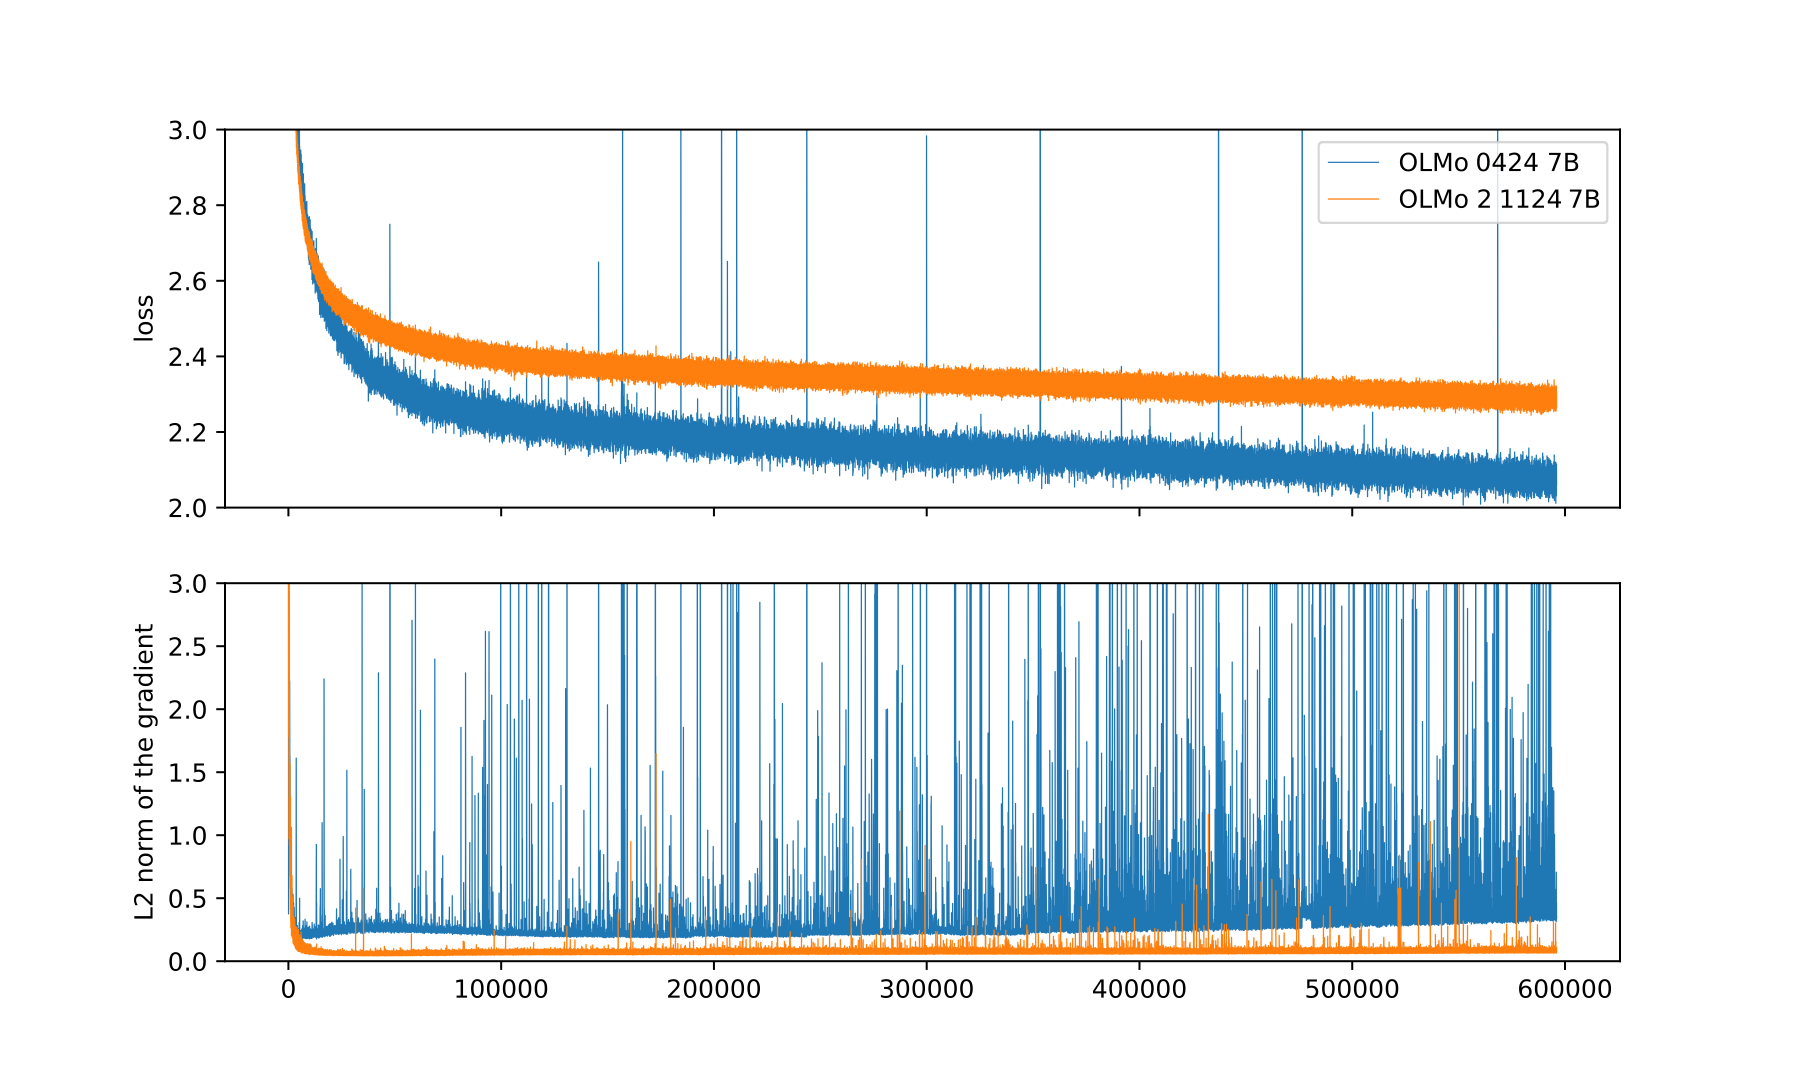
证据 1:图4、图7,稳定性。 初始化消融中梯度尖峰分数从 0.40 到 0.03;图7 的联合归一化修改从 0.108 到 0.069。尖峰分数是偏离过去 1000 个值滚动均值至少七个标准差的比例。两组不是同一基线,不能连乘成总降幅。图2 两代训练损失绝对高低还受语料改变影响,不能用它直接判断新模型更差。 训练损失与梯度范数分别成图;OLMo 2 更高的原始训练损失同时受数据变化影响,不能据此判定稳定化设计让语言建模退步。
证据 2:表9,中期训练。 7B 开发平均分从 50.6 到 61.2,GSM8K 从 24.1 到 67.5;13B 平均分从 56.5 到 66.8。这支持较晚阶段的数据课程能够补足能力。它没有把数据质量、退火、额外 token 和权重平均全部独立控制,无法给每项机制分配精确贡献。
证据 3:表12,数据形式。 TinyGSM-Inline 的 GSM* 为 25.0,MIND 改写版为 65.5;但前者使用 3.17B token,后者 6.40B。结果说明这套改写训练方案有效,不证明在严格等 token、等算力下差距依然是 40.5 个百分点。数学数据重复实验也同时改变总量和网页比例,不能简单得出“重复越多越好”。
证据 4:表14,权重平均的反例。 配方 B 的 GSM* 从最佳单分支 73.0 到平均模型 77.0;配方 E 却从 60.5 降到 43.0,虽然其通用平均指标改善。表题及正文的“始终相当或更好”不能按每个任务字面理解。选择平均模型仍然需要任务级检查。
证据 5:表16,后训练。 13B 从 SFT 到 DPO 再到 RLVR,GSM8K 为 76.3、82.3、87.4,MATH 为 29.5、35.2、39.2;Safety 则为 82.3、79.7、79.1。不同目标间存在折中,不能把平均性能提高等同于所有属性改善。表7 中 Qwen2.5 14B 的 MATH 为 70.6,也明显高于 OLMo 2 13B 的 39.2。
五、开放材料仍不消除配方选择与目标取舍
开放中间状态使研究者能提出因果问题:某段数据是不是触发尖峰,某项能力在何时出现,后训练改善有没有伴随退步。它的贡献既是模型配方,也是实验对象的可观察性;后者不是榜单分数能够概括的。
作者没有证明微型退火的数据排名一定迁移到更大模型或其他语言;合成数据也引入教师模型的偏差。针对数学开发集反复选择配方,使同分布数学成绩更难解释为广泛推理能力。代码不属于主要后训练目标,因此不能用缺少该类实验推断代码能力强弱。
本文的分析是:可复现材料让问题更容易定位,并不会自动消除问题。读者仍须处理版本、参数表、开发集接触和预算口径。面对表格反例,保留具体范围比重复摘要中的整体评价更有帮助。
六、用可追溯配方核对数据课程与偏好模块
开放日志可以帮助复查Chinchilla式预算问题,也能检查DPO模块前后的能力取舍。后继分析应利用真实阶段检查点,而不是凭最终分数猜测某条数据独自造成了提升。
七、自测与答案
1. 为什么开放权重不足以判断一项能力来自哪段训练?
答:终态参数把所有数据与更新历史混在一起。需要中间检查点、数据顺序、日志及受控分支,才能比较某次干预前后的变化;即便如此,同时改变多个条件时也不能直接归因。
2. TinyGSM 改写实验能否证明自然语言一定比代码更适合数学训练?
答:不能。该模型的原始训练代码占比较低,而且两种微型退火使用的 token 数不同。证据适用于给定模型和配方;要得到更一般结论,还应控制预算、教师质量和输出格式,并换不同代码基础的模型。
3. 权重平均没有增加推理时模型数,为什么仍要记录三条分支的预算?
答:最终部署只运行平均后的一个模型,但这个模型的研发已经消耗三次退火训练。推理效率和获得模型的成本是不同维度;只报单分支预算会低估实际投入,而且平均也可能损害某些任务。