把每次改写,连回可检查的依据。
360 篇论文,12 篇导读、时间线与收束文章,以及4份系列目录。保留文章编号与原有阅读界面。
第六版:逐一补齐正文图引用。已清点 1171 个按文章、论文版本和图号去重的Figure实体,1114 个直接展示,57 个仍有明确缺口;表另列。逐图查看正文位置、原论文和未取得原因。
第五版:补齐Dyna捷径实验图。第3天现直接展示Figure6,附完整地图、坐标、曲线图例与就地解说;此前仅链接这张图是选图遗漏。原有389图保留,该版共390幅。
第四版:叙事结构重编。360 篇覆盖,其中 359 篇正文重新组织,RL第2天保留作样板。每篇由前作未解问题接入具体问题设定,再沿机制推导、实现、图证据和后继路线展开;删合重复摘要。原 1020 道文末自测与既有答案保留,新增 223 道有对应答案的独立追问。下方逐篇可展开查看真正的段落迁移。已按技术家族实际阅读 57 个专业讲解或课程入口;131 篇记录适用教法的具体融合,228 篇直接展开原论文公式、算例或读图,不强挂无关博文。讲解来源不代替原论文的事实依据。
第三版复核:360 篇逐篇保留并核对文末自测,共 1020 道自测有参考答案;连同正文独立追问,本轮记录 1231 道已答问题。RL第2天恢复原版两题,其它篇目修正实际发现的读图、公式解释、来源与技术关联差距,不删多出的原有题目。
第二版修订:360 篇论文逐篇检查问答与具体图证据,1111 道本轮记录问题有对应答案(含原有问答与新增追问),1761 个原文证据入口(含图表、证明及明确标注的转录文字)。RL第2天含正式勘误图3与另两张实验图;阅读工具按实际可见导航栏位置贴顶。
正文补图:360 篇现有 1186 幅内嵌图,其中 335 篇展示实验/结果图;其余按实际内容展示方法、设定或明确标注的教学图。下方逐篇列出图像类型和出处;第六版完整图引用清单另有对照页,不把原文链接计为内嵌图。
这里逐篇列出新增推导、教学算例、技术关系与查核资料。核验范围按实际读到的章节记录;“部分核验”表示仍有明确边界,不等于全文和所有实验数字均已重新核查。教学算例不冒充论文实验。
376 条记录
强化学习Day 0|强化学习阅读入门:先分清谁决策、谁评价、数据从哪里来部分核验,边界见下
本次深化
- 新增两动作策略梯度与基线的完整手算桥梁
- 明确折扣访问分布而非平稳分布;连接价值估计、GAE和策略优化三个接口
- 说明解释组织参考Lilian Weng,算例独立构造
- 删除过程式阅读范围说明,保留Spinning Up分类/SAC与Lilian Weng推导组织参考的精简用途入口。
查核资料
- gwern.net · 所列章节
§3—4定义与Theorem 1、Bernoulli例、基线讨论
- proceedings.neurips.cc · 所列章节
Theorem 1—3,特别Theorem 2证明与兼容特征解释
- arxiv.org · 所列章节
§3性能界、§4—5近似求解、§8图4与基线说明
- arxiv.org · 所列章节
§3多步推导与§4解释;§6.1更新顺序;§6.2—6.3与图2—3
- arxiv.org · 所列章节
§2—4目标;§6.1表1;§6.2图3;§6.3预算
- spinningup.openai.com · 所列章节
算法分类轴、模型使用与模型偏差的课程解释
- lilianweng.github.io · 所列章节
符号先行、推导展开和算法比较的组织参考,不替代原论文
技术关系
- 05-reinforce · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 08-policy-gradient-theorem · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 14-trpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 15-gae · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 27-ppo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
仍需留意
- 教学例未运行环境实验;导读不代替各论文限定条件
强化学习强化学习发展时间线总览:从早期基础到 2026 年部分核验,边界见下
本次深化
- 新增六条有方向、有条件的机制关系,区分继承、组合、并行路线
- 明确ASE/ACE历史对应及TRPO+GAE不是替代链
- 修正Distributional翻译、expectile辨析与选文/核源日期区别
- 修订图表/问答日期,并把已经删除的收尾范围索引链接改为逐篇查核入口。
查核资料
- www.derongliu.org · 摘要
可检索原文摘要;作者出版目录核对书目
- jmvidal.cse.sc.edu · 所列章节
§2望远镜展开与资格迹;§3.2、图3—5实验;§4线性理论
- proceedings.neurips.cc · 所列章节
自然梯度和兼容近似推导;§5图2及其图注
- papers.nips.cc · 所列章节
§2双估计、Algorithm 1、§4.2图2
- arxiv.org · 所列章节
§3性能界、§4—5近似求解、§8图4与基线说明
- arxiv.org · 所列章节
§3多步推导与§4解释;§6.1更新顺序;§6.2—6.3与图2—3
- arxiv.org · 所列章节
目标公式;图3讨论;表1与评估协议
- arxiv.org · 所列章节
§2—4目标;§6.1表1;§6.2图3;§6.3预算
- arxiv.org · 所列章节
Integrated Agent;实验方法;图3—4消融讨论
- arxiv.org · 所列章节
§5.1轨迹采样、算法概要、图3统计口径
- arxiv.org · 所列章节
§3外推误差;批约束机制;图2实验与图注
- arxiv.org · 所列章节
MMD定义与约束;附录C.3图7;附录D数据与KL比较
- arxiv.org · 所列章节
行为学习目标与梯度;图4、图8及主实验设定
- arxiv.org · 所列章节
表示/动态/预测训练流程;图2—3及搜索预算说明
- arxiv.org · 所列章节
§3.1 Theorem 3.1—3.2及式1—2;保守Q目标解释
- arxiv.org · 所列章节
方法中的expectile三步更新、理论条件及§5图2 toy maze解释
- arxiv.org · 所列章节
GRPO方法式3—4、结果监督与迭代RL算法
- arxiv.org · 所列章节
§3动态准则与步骤分配、零分母/未引用步骤规则、§4评价与附录训练配置
技术关系
- 01-actor-critic · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 02-td-lambda · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 09-natural-policy-gradient · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 11-double-q · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 14-trpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 15-gae · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 18-double-dqn · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 27-ppo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 29-rainbow · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 35-pets · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 37-bcq · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 38-bear · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 40-dreamer · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 41-muzero · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 42-cql · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 46-iql · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 52-grpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 60-draco · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
仍需留意
- 时间线包含未纳入60篇的背景文献,未对这些延伸条目逐篇全文审查;早期两篇访问限制保留
强化学习Neuronlike Adaptive Elements That Can Solve Difficult Learning Control Problems部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:失败到来之前,行动该从哪里得到反馈
- 二、把迟到失败拆成行动搜索与学习评价
- 三、按现代教学对应更新两种角色
- 四、分清倒立摆史料与原创误差示意
- 五、评价变密之后仍要追查它是否正确
- 六、从评价预测走向现代策略更新
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:失败到来之前,行动该从哪里得到反馈
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、把迟到失败拆成行动搜索与学习评价 / 验算失败回合为何也会出现正反馈
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、按现代教学对应更新两种角色
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、评价变密之后仍要追查它是否正确
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、评价变密之后仍要追查它是否正确
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 现代教学式的两种步长控制不同对象:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“现代教学式的两种步长控制不同对象”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
两种步长与停止梯度只解释现代教学Actor–Critic对应式,不把它倒写为1983硬件系统的原实现。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:1 幅
- 失败两步轨迹里首步TD误差正0.62而末步负0.8的原创算例
教学示意 · 原创教学图 · 现代TD教学对应;非1983原图
沿上方轨迹看,最终失败不妨碍第一步得到正TD误差:旧评价器把中间状态看得过好。两条算式解释局部预测误差如何暂时给错反馈;这是现代教学对应,原始全文及实验图仍未可靠取得,不能将本图当作1983年控制成绩。
原PDF请求返回502;历史ASE/ACE原式与实验图未重新核实,未填补不存在的实验数字;原始全文与实验页获取失败,原始ASE/ACE数式及实验统计未复核;01原始全文和原实验图仍缺;此图仅为现代教学对应,不补实验覆盖。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:如何区分学会平衡与利用终止判定漏洞?;不用评价者,仅最终失败信号会增加多少样本成本?;现代策略梯度版与原始 ASE 的更新差异有哪些?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
本轮边界:原PDF请求返回502;历史ASE/ACE原式与实验图未重新核实,未填补不存在的实验数字;原始全文与实验页获取失败,原始ASE/ACE数式及实验统计未复核
本次深化
- 区分1983年ASE/ACE分工与现代Actor–Critic教学公式,避免历史倒置。
- 用两步失败轨迹手算正负TD误差,说明密集评价仍会传播估计错误。
- 依可读摘要限定倒立摆证据,不补造控制时长、成功率或消融数字。
- v2:为三个原始追问逐题增加参考答案:如何区分学会平衡与利用终止判定漏洞?;不用评价者,仅最终失败信号会增加多少样本成本?;现代策略梯度版与原始 ASE 的更新差异有哪些?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- www.derongliu.org · 摘要
可检索原文摘要;作者出版目录核对书目
技术关系
- 02-td-lambda · 历史背景
把评价器中的时间差分问题单独研究,才能分析预测更新。
- 22-a3c · 教学联系
同样分离策略与价值功能,但网络、梯度估计与并行执行属于后来的设计。
仍需留意
- 原始全文与实验页获取失败,原始ASE/ACE数式及实验统计未复核
强化学习Learning to Predict by the Methods of Temporal Differences部分核验,边界见下
第四版:叙事结构重编
保留第2天已认可的叙事样板。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:预测一件还没有发生的事
- 二、从终局误差推到资格迹:Theorem 1 到底说了什么
- 三、今天怎么实现:先区分现代在线形式和原文实验协议
- 四、把随机游走实验真正读出来
- 五、哪些结论能推广,哪些不能
- 六、三个值得继续追问的问题与参考答案
- 七、接下来沿哪条线读
- 自测两题
段落怎样重新安排
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 从20bb192逐字恢复末尾两道自测与参考答案,保留正文三道独立追问。
与此前问答的对应
原末尾自测整段与20bb192逐字一致;三道追问及其答案与第二版保持一致。
正文配图:6 幅
- 原创示意:从D起步,在A至G七个状态间等概率左右走,A和G吸收;B至F最终到G的概率分别为1/6至5/6。
教学示意 · 原创教学图 · PDF第10页/印刷p.18
随机游走解析真值
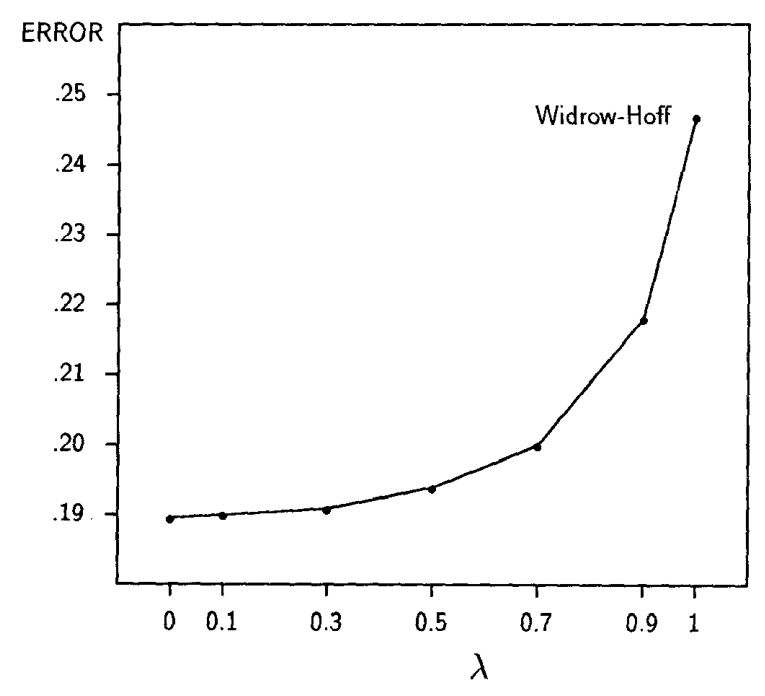
- 正式勘误Figure 3:横轴lambda,纵轴重复呈现至收敛后的RMS误差;lambda从0到1时误差总体升高,lambda等于1标作Widrow-Hoff。
实验/结果图 · 必要原图摘引 · PDF第1页/印刷p.377
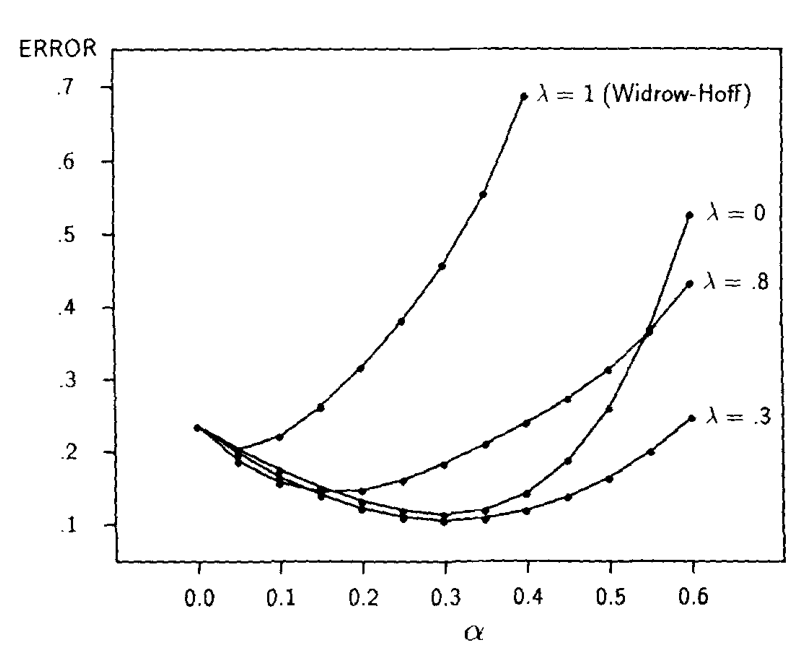
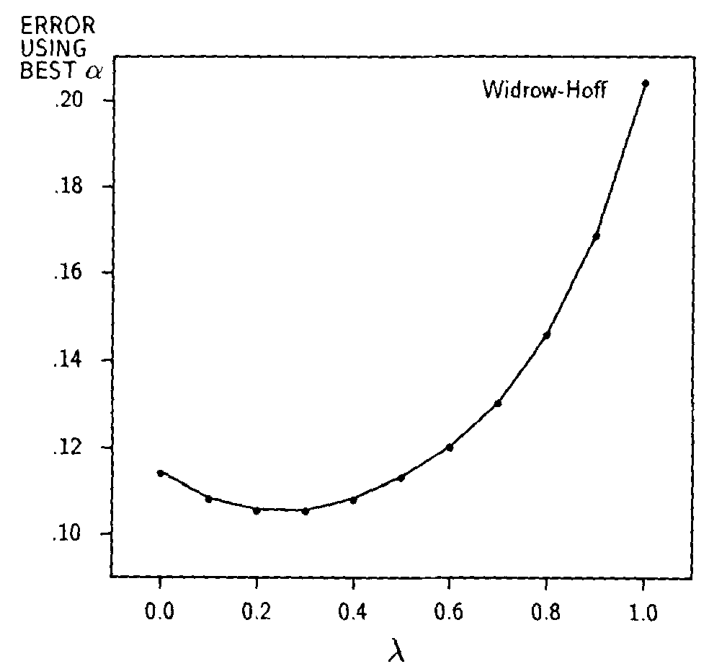
对照重复训练/单遍训练/最佳步长协议及RMS误差坐标,解释不同λ最优值条件
- 原论文Figure 4:横轴学习率alpha,纵轴看完10条序列后的平均RMS误差;lambda取0、0.3、0.8、1的曲线在不同alpha处达到最低点,过大步长使误差升高。
实验/结果图 · 必要原图摘引 · PDF第13页/印刷p.21
对照重复训练/单遍训练/最佳步长协议及RMS误差坐标,解释不同λ最优值条件
- 原论文Figure 5:横轴lambda,纵轴每个lambda选择所测试的最佳alpha后得到的平均RMS误差;最低区域在lambda约0.2至0.3,lambda等于1明显更高。
实验/结果图 · 必要原图摘引 · PDF第14页/印刷p.22
对照重复训练/单遍训练/最佳步长协议及RMS误差坐标,解释不同λ最优值条件
- 原图的箭头从D进入;B到F各有等概率的左右转移,A和G是终止状态。下面的原创教学图另补了解析概率,二者承担的内容不同。
方法/设定图 · 必要原图摘引 · Figure 2, PDF第10页
原图的箭头从D进入;B到F各有等概率的左右转移,A和G是终止状态。下面的原创教学图另补了解析概率,二者承担的内容不同。
- 这是已核对1988出版社PDF中误印的图3:图内写着“使用最佳步长的误差”,曲线呈U形,实际对应后面的单遍训练图5。它只作为版本纠错对照,重复训练实验应读下方1989勘误图,不能从这张误印图得出该实验的结论。
教学示意 · 必要原图摘引 · 原版误印Figure 3, PDF第12页/印刷p.20
这是已核对1988出版社PDF中误印的图3:图内写着“使用最佳步长的误差”,曲线呈U形,实际对应后面的单遍训练图5。它只作为版本纠错对照,重复训练实验应读下方1989勘误图,不能从这张误印图得出该实验的结论。
图3使用1989正式勘误,三张原曲线仅摘引必要图形区域。;本文并未独立复现实验,原创任务示意中的状态概率为解析值。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇全部三道进阶追问。
- 将孤立的证据表改成任务示意及三张实验图逐图解读,坐标、训练协议、调参含义和不确定性放在图旁。
- 用1989正式勘误替换已核对原始PDF中误印的Figure 3;不把已核对版本的问题泛化为所有版本。
- 从冻结线性预测的双重求和交换完整说明Theorem 1,区分现代逐步在线实现与原文批次/逐回合改参。
- 三个开放追问分别给出噪声与超参数条件、状态混叠的投影固定点、零TD误差但策略次优的反例。
- 删除重复证据定位、阅读范围套话和重复自测;改为有机制说明的Dyna/Q-learning/GAE后续链接。
查看本篇 4 个原文证据入口
- Figure 2 task, original explanatory diagram · PDF第10页/印刷p.18 · 文章配图
原创教学示意,不冒充论文实验数据
- Figure 3, corrected by 1989 Erratum · PDF第1页/印刷p.377 · 文章配图
原图必要摘引,版权保留
- Figure 4 · PDF第13页/印刷p.21 · 文章配图
原图必要摘引,版权保留
- Figure 5 · PDF第14页/印刷p.22 · 文章配图
原图必要摘引,版权保留
本轮边界:仅重绘任务结构与解析概率;三张曲线为必要原图摘引,未数字化实验点或独立复现实验。;本文分析与现代投影贝尔曼框架不冒充1988年Theorem 1;不能把小线段差别当成统计显著。
本次深化
- 将孤立的证据表改成任务示意及三张实验图逐图解读,坐标、训练协议、调参含义和不确定性放在图旁。
- 用1989正式勘误替换已核对原始PDF中误印的Figure 3;不把已核对版本的问题泛化为所有版本。
- 从冻结线性预测的双重求和交换完整说明Theorem 1,区分现代逐步在线实现与原文批次/逐回合改参。
- 三个开放追问分别给出噪声与超参数条件、状态混叠的投影固定点、零TD误差但策略次优的反例。
- 删除重复证据定位、阅读范围套话和重复自测;改为有机制说明的Dyna/Q-learning/GAE后续链接。
- 第三版从20bb192逐字恢复文末两道自测及参考答案,与正文三道进阶追问分开保留。
查核资料
- link.springer.com · 所列章节
§2线性终局误差推导与Theorem 1;§3.2 Figure 2/4/5随机游走协议、坐标与图注;§4 Theorem 2的线性吸收式前提;已核对原PDF印刷p.20的Figure3误印。
- link.springer.com · 全文
Machine Learning 3:377 (1989)正式勘误:正确Figure3的曲线、RMS定义、重复训练至稳定与约0.01标准误。
- web.mit.edu · 所列章节
Tsitsiklis与Van Roy1997 §III–IV投影算子和线性TD固定点;用于进阶问答,明确不属于1988 Theorem1。
技术关系
- 01-actor-critic · 历史背景
从控制中评价器的学习问题进入固定过程的预测研究,不声称本篇是1983系统的简单删减。
- 03-dyna · 直接继承
Dyna把真实经验中的TD更新与模型生成的模拟经验更新组合。
- 04-q-learning · 直接继承
从固定过程预测转向动作价值控制,目标增加对动作的比较。
- 15-gae · 模块组合
GAE借用几何加权TD残差的构造来估计优势,可与策略优化器组合,角色不同于本篇价值预测。
仍需留意
- 原论文实验曲线为必要摘引,本文未独立复现或反推精确采样数据。
- Theorem1限定线性及序列内冻结参数;后续投影固定点解释使用另列1997来源及其假设。
强化学习Integrated Modeling and Control Based on Reinforcement Learning and Dynamic Programming部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一次真实转移之后还能学几次
- 二、让真实经验与模型经验进入同一个更新器
- 三、实现双循环:先收集证据,再安排规划
- 四、读堵路与捷径实验:加速传播不等于发现变化
- 五、模型错了以后,更多规划会放大什么
- 六、继续追问:怎样决定下一步花在规划还是交互
- 七、沿经验来源与模型误差两条路线继续读
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:一次真实转移之后还能学几次
先定义真实证据不足在哪里,再引出内部计算
- 七、帮助建立理解 / 教学例子 → 二、让真实经验与模型经验进入同一个更新器
先检查公式的传播结果,再实现双循环
- 三、方法 / 教学伪代码 → 三、实现双循环:先收集证据,再安排规划
区分模型储存与规划采样职责
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、模型错了以后,更多规划会放大什么
把曲线可证明的传播收益和不可证明的发现能力接起来
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、模型错了以后,更多规划会放大什么
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 与原方法和边界重复;内容保留于问题设定、方法接口与模型边界。
- 目标、机制与指标已分别解释;内容保留于问题设定的任务回报与预算;共享更新器;实验指标表。
- 整表重复开头、方法和边界;内容保留于问题设定、共享更新器、堵路与捷径实验、模型边界。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 用累计奖励斜率区分堵路与捷径:直接核读本篇原文后重写变量定义、推导顺序与图表解释,不声称来自通用博文。
- 用累计奖励斜率区分堵路与捷径:第五版将Figure6原图就地展示,分开地图变化、累计量与斜率、图5和图6的统计口径。
原论文校准与展开范围
原论文校准:实际重新核读原PDF第6–7页与本地图5,确认§5、共同k=10、三线身份、改变时刻和探索奖励。 第五版再次实际检查PDF第7页右侧Figure6的地图、轴、三曲线及第6–7页实验说明。 · 原文
共同规划预算、堵路与开捷径结果限定于原文任务;基本教学伪代码未实现Q+的探索奖励与未试动作模型。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:3 幅
- 堵路任务中三种Dyna变体的累计奖励与环境改变前后的迷宫布局
实验/结果图 · 必要原图摘引 · Figure 5, PDF第7页;仅图形区域
把架构和效果分开读:[图1](https://proceedings.neurips.cc/paper/1990/file/d9fc5b73a8d78fad3d6dffe419384e70-Paper.pdf#page=3)的箭头说明真实经验与模型经验如何共用策略/评价更新接口;真正检验变化环境的是[图5](https://proceedings.neurips.cc/paper/1990/file/d9fc5b73a8d78fad3d6dffe419384e70-Paper.pdf#page=7)和[图6](https://proceedings.neurips.cc/paper/1990/file/d9fc5b73a8d78fad3d6dffe419384e70-Paper.pdf#page=7)。横轴为时间步,纵轴为累计奖励,因此斜率才表示获得奖励的速度。堵路会在原路径上暴露错误,而捷径必须靠探索发现;[图6](https://proceedings.neurips.cc/paper/1990/file/d9fc5b73a8d78fad3d6dffe419384e70-Paper.pdf#page=7)中Dyna-Q+的斜率改变支持探索奖励的作用,不能解释成仅增加规划次数就能发现未观察的新转移。 [查看原文](https://proceedings.neurips.cc/paper/1990/file/d9fc5b73a8d78fad3d6dffe419384e70-Paper.pdf)。
- Dyna捷径任务:右端通道在3000步开放,三种变体0至6000步的累计奖励曲线
实验/结果图 · 必要原图摘引 · Figure 6,PDF第7页(印刷页477),右侧地图与完整曲线图形区域
地图保留旧绕路并在右端开捷径;横轴0–6000真实步、纵轴0–400累计奖励,3000步虚线后只有Dyna-Q+明显提高斜率;明确变化前探索代价与图6未单独报告重复次数/无误差条。
- 沿粗箭头看,真实世界或模型提供同一种状态、奖励接口;评价函数产生的启发式奖励用于改进策略。这里画的是Dyna-AHC的模块关系,不能把它当成Q+探索奖励的具体实现。
方法/设定图 · 必要原图摘引 · Figure 1, PDF第3页
沿粗箭头看,真实世界或模型提供同一种状态、奖励接口;评价函数产生的启发式奖励用于改进策略。这里画的是Dyna-AHC的模块关系,不能把它当成Q+探索奖励的具体实现。
未复现;完整参数敏感性未逐项重新核对
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:固定总计算预算,规划 n 次是否仍优于更多真实交互?;环境出现新捷径时,旧模型如何发现?;何时应该停止规划并去收集新证据?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:PDF page 3,5:PDF page 7,6:PDF page 7
查看本篇 3 个原文证据入口
- 图1 · PDF page 3
原站图表/证明入口
- 图5 · PDF page 7
原站图表/证明入口
- 图6 · PDF page 7
原站图表/证明入口
本轮边界:未复现;完整参数敏感性未逐项重新核对
本次深化
- 拆解真实学习、模型学习和模拟更新接口,区分Dyna与行动时树搜索。
- 用三格链演示模拟更新传播奖励,也会放大错误模型。
- 核对堵路实验50次运行与捷径对照,区分规划次数和探索机制的收益。
- v2:为三个原始追问逐题增加参考答案:固定总计算预算,规划 n 次是否仍优于更多真实交互?;环境出现新捷径时,旧模型如何发现?;何时应该停止规划并去收集新证据?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:PDF page 3,5:PDF page 7,6:PDF page 7
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第五版补入此前仅链接的Figure6,逐图解释捷径地图、坐标、三基线和统计边界;不改原问答与图5。
查核资料
- proceedings.neurips.cc · 所列章节
§2架构、§3导航、§5变化环境与图5—6
技术关系
- 04-q-learning · 模块组合
Dyna-Q复用采样Bellman更新,只替换经验来源。
- 39-mbpo · 直接继承
继承模型生成经验训练策略的路线,并专门限制模型展开误差。
仍需留意
- 未复现;完整参数敏感性未逐项重新核对
强化学习Q-learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有转移模型,怎样从一次采样比较长期行动
- 二、把 Bellman 最优期望改为单条转移更新
- 三、让访问计数决定步长并正确处理终止
- 四、用手算图理解目标,再核对收敛定理
- 五、从无限访问结论退回有限预算限制
- 六、区分行为目标与神经表示两条延伸
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:没有转移模型,怎样从一次采样比较长期行动
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、把 Bellman 最优期望改为单条转移更新 / 把探索动作和目标动作分别算一遍
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、让访问计数决定步长并正确处理终止
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、从无限访问结论退回有限预算限制
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、从无限访问结论退回有限预算限制
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 一次样本对应哪个期望:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“一次样本对应哪个期望”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
条件期望冻结当前Q并条件于已访问状态动作;这不代替充分探索、学习率和表格收敛条件。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:1 幅
- Q-learning用后继最大值5得到目标5.5和新Q值2.7,而非选择行为动作值3
教学示意 · 原创教学图 · §2更新式的原创手算图
灰色分支是行为可能实际选择的动作,绿色分支是Q-learning构造目标时取的最大值。把行为动作与目标动作分开,才能理解off-policy;若该转移真正终止,则没有任何后继分支,应回到图下方的1.8。
未逐行复核附录全部证明;不主张有限样本速度
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:固定探索概率能否保证所有表项无限访问?还缺哪些环境条件?;α 长期保持常数时,确定环境和随机环境会有什么不同?;把表格换成共享参数网络,证明中哪一步失去了保障?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
本轮边界:未逐行复核附录全部证明;不主张有限样本速度
本次深化
- 由Bellman最优算子推导采样更新,明确行为动作与贪心目标的区别。
- 手算普通与终止转移的不同目标,说明done语义改变学习问题。
- 以ARP收敛证明及其条件为证据,不把理论论文包装成现代基准实验。
- v2:为三个原始追问逐题增加参考答案:固定探索概率能否保证所有表项无限访问?还缺哪些环境条件?;α 长期保持常数时,确定环境和随机环境会有什么不同?;把表格换成共享参数网络,证明中哪一步失去了保障?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- www.gatsby.ucl.ac.uk · 所列章节
§2更新、§3收敛条件与ARP证明、§4扩展
技术关系
仍需留意
- 未逐行复核附录全部证明;不主张有限样本速度
强化学习Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有动作标签与环境导数,如何直接改变动作概率
- 二、对轨迹概率求导并消去不依参数的环境项
- 三、采完整回合、算后续回报并冻结权重
- 四、以两动作图和原定理核查期望方向
- 五、期望方向正确为何仍可能训练困难
- 六、从轨迹梯度继续追问价值近似与优势噪声
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:没有动作标签与环境导数,如何直接改变动作概率
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、对轨迹概率求导并消去不依参数的环境项 / 验算减基线前后的平均梯度
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、采完整回合、算后续回报并冻结权重
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、期望方向正确为何仍可能训练困难
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、期望方向正确为何仍可能训练困难
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 从概率导数看回报权重的符号:采用Spinning Up先写log概率梯度、再说明样本权重的顺序;补出归一化使其他动作概率一起变化的解释。
教法来源与实际阅读范围
- OpenAI Spinning Up · Vanilla Policy Gradient
Key Equations、目标和回报约定
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“从概率导数看回报权重的符号”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
log概率梯度同时受策略归一化和共享参数影响;单样本正权重不是所有动作概率一起上升。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:1 幅
- 零基线和基线1下两个动作对期望梯度的贡献条形图,总和均0.75
教学示意 · 原创教学图 · §3–4基线与期望更新的原创算例
每根柱是概率加权后的梯度贡献,不是一次采样的梯度。基线1把部分贡献移到第二个动作,但两柱之和仍为0.75;因此图展示期望不变,并没有证明任意基线都会减小方差。
延迟强化全部变体未逐一推导;本文教学取γ=1
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:为什么只依赖状态的基线在期望中抵消?;同一批轨迹更新十轮后,梯度还对应当前策略吗?;回报标准化会改变什么,何时不能直接称为无偏?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
本轮边界:延迟强化全部变体未逐一推导;本文教学取γ=1
本次深化
- 展开轨迹log概率梯度,解释环境无需可微及动作无关基线条件。
- 用两动作bandit验证减基线前后期望梯度同为0.75。
- 区分Theorem 1的非负内积、统一步长的同方向与实际收敛速度。
- v2:为三个原始追问逐题增加参考答案:为什么只依赖状态的基线在期望中抵消?;同一批轨迹更新十轮后,梯度还对应当前策略吗?;回报标准化会改变什么,何时不能直接称为无偏?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- gwern.net · 所列章节
§3—4定义与Theorem 1、Bernoulli例、基线讨论
技术关系
- 08-policy-gradient-theorem · 直接继承
把轨迹似然比视角进一步组织为状态访问分布下的价值加权梯度。
- 15-gae · 模块组合
替换优势估计器的偏差方差结构,不替代对数概率梯度。
仍需留意
- 延迟强化全部变体未逐一推导;本文教学取γ=1
强化学习On-line Q-learning using connectionist systems部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:继续探索的风险是否也应该进入动作价值
- 二、让下一动作的采样分布决定评价对象
- 三、保留抽到的下一动作并继续执行
- 四、用风险手算图标出原报告证据缺口
- 五、区分包含探索风险与具备安全保证
- 六、沿目标分布和多步信用分配继续读
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:继续探索的风险是否也应该进入动作价值
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、让下一动作的采样分布决定评价对象 / 比较危险后继的平均8与贪心10
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、保留抽到的下一动作并继续执行
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、区分包含探索风险与具备安全保证
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、区分包含探索风险与具备安全保证
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 把一次抽样与平均目标分开:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“把一次抽样与平均目标分开”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
显式下一动作求和是在冻结Q和同一行为策略下的期望;不把Expected SARSA与原单次抽样算法混为同一实现。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:1 幅
- 探索行为以0.9和0.1概率取得10与负10,SARSA平均目标8而Q-learning目标10
教学示意 · 原创教学图 · SARSA目标的原创两动作算例;非报告实验
绿色与橙色分支都属于实际行为,故SARSA把探索坏动作的可能性算进去,平均值8低于安全路线9。这个手算对照解释目标策略的区别;原报告实验图仍未可靠定位,不能用它宣称1994年的导航实测结果或普遍安全保证。
当前只核查作者上传报告入口及摘要,原实验图编号和数值仍无法定位;实验页与原始变体细节未可靠读取;标准SARSA公式为明确标注的教学重述;06原报告实验图尚未可靠取得;原创两动作图不能代替原导航实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:把 ε 从 0.2 降到零时,评价目标如何变化?;训练安全与部署贪心收益应怎样分别报告?;若使用 replay,哪些条件下仍能保持 on-policy 解释?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
本轮边界:当前只核查作者上传报告入口及摘要,原实验图编号和数值仍无法定位;实验页与原始变体细节未可靠读取;标准SARSA公式为明确标注的教学重述
本次深化
- 从实际下一动作说明SARSA评价行为策略,探索风险不等于内置风险厌恶。
- 手算SARSA平均目标8与Q-learning目标10,保留固定行为的限定。
- 按作者报告摘要界定连接主义在线学习证据,不挪用教材悬崖实验。
- v2:为三个原始追问逐题增加参考答案:把 ε 从 0.2 降到零时,评价目标如何变化?;训练安全与部署贪心收益应怎样分别报告?;若使用 replay,哪些条件下仍能保持 on-policy 解释?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- www.researchgate.net · 摘要
作者上传的一手报告摘要;原始Cambridge PDF尝试提取失败
技术关系
- 04-q-learning · 平行方法
目标策略不同,而非是否使用神经网络不同。
- 02-td-lambda · 模块组合
资格迹可与动作价值学习组合,不能将SARSA等同于λ=0唯一版本。
仍需留意
- 实验页与原始变体细节未可靠读取;标准SARSA公式为明确标注的教学重述
强化学习Between MDPs and Semi-MDPs: A Framework for Temporal Abstraction in Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一次上层决策持续多步时,奖励和折扣怎样计算
- 二、把技能三元组接入半马尔可夫目标
- 三、执行技能并按实际持续时间累计回报
- 四、读房间传播与地标中断的不同证据
- 五、检查技能覆盖与中断判断是否限制最优性
- 六、继续追问:可表达策略、预算与技能来源
- 七、从给定技能走向技能发现
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:一次上层决策持续多步时,奖励和折扣怎样计算
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、把技能三元组接入半马尔可夫目标 / 验算走廊技能为何不能只折扣一次
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、执行技能并按实际持续时间累计回报
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、检查技能覆盖与中断判断是否限制最优性
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、检查技能覆盖与中断判断是否限制最优性
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 一步技能是时间抽象的校验端点:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“一步技能是时间抽象的校验端点”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
k=1只校验半MDP折扣与累计奖励退化关系,不证明任意技能终止条件下的探索或最优性。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:4 幅
- 可中断与不可中断地标控制器的路径及价值函数对照
实验/结果图 · 必要原图摘引 · Figure 7, PDF第20页;仅图形区域
上方细折线按完整option走到地标再切换,粗折线允许途中切换,图内分别标示600步与474步。下方两个价值曲面对应同一任务的两种控制方式;这是有具体价值条件的中断收益,不能仅因几何上更短就断言任意近似控制器都更好。
- 两排从相同初值出发,上排只用原始动作,下排使用走廊option。黑圆的传播范围说明一次规划更新跨越的时间尺度不同;此处模型已准确给定。
实验/结果图 · 必要原图摘引 · Figure 4, PDF第13页
两排从相同初值出发,上排只用原始动作,下排使用走廊option。黑圆的传播范围说明一次规划更新跨越的时间尺度不同;此处模型已准确给定。
- 目标移到房间内部后,依次读六个迭代面板:先靠原始动作把价值传到走廊,再利用走廊option扩散。此图的动作集是A∪H,不能据此认为只有H也能到达任意目标。
实验/结果图 · 必要原图摘引 · Figure 5, PDF第14页
目标移到房间内部后,依次读六个迭代面板:先靠原始动作把价值传到走廊,再利用走廊option扩散。此图的动作集是A∪H,不能据此认为只有H也能到达任意目标。
- 左右列分别以G1和G2为目标,横纵轴均为对数刻度。G2中仅H的曲线最终较高,说明早期学得快不等于最终路线同样短;A∪H保留了到达内部目标的能力。
实验/结果图 · 必要原图摘引 · Figure 6, PDF第16页
左右列分别以G1和G2为目标,横纵轴均为对数刻度。G2中仅H的曲线最终较高,说明早期学得快不等于最终路线同样短;A∪H保留了到达内部目标的能力。
未逐行审核§5—7 intra-option学习证明与全部实验重复;未独立复现
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:哪类 option 会损失原始最优策略的表达能力?;如何公平比较一次上层决策与十次原始动作?;为什么固定技能发现与技能选择应分开评测?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:4:PDF page 13,5:PDF page 14,6:PDF page 16,7:PDF page 20
查看本篇 4 个原文证据入口
- 图4 · PDF page 13
原站图表/证明入口
- 图5 · PDF page 14
原站图表/证明入口
- 图6 · PDF page 16
原站图表/证明入口
- 图7 · PDF page 20
原站图表/证明入口
本轮边界:未逐行审核§5—7 intra-option学习证明与全部实验重复;未独立复现
本次深化
- 推导option三元组、随机时长折扣与中断条件,区分SMDP最优和原MDP最优。
- 手算三步技能目标5.265,展示漏掉持续时长折扣的误差。
- 补读UMass原PDF§2–4及图4–7,核实准确模型、技能覆盖和中断导航对照。
- v2:为三个原始追问逐题增加参考答案:哪类 option 会损失原始最优策略的表达能力?;如何公平比较一次上层决策与十次原始动作?;为什么固定技能发现与技能选择应分开评测?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:4:PDF page 13,5:PDF page 14,6:PDF page 16,7:PDF page 20
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- people.cs.umass.edu · 所列章节
§2 Options定义、§3 SMDP定理与图4—6、§4中断定理及图7说明
- www.ece.uvic.ca · 未能读取
早期镜像正文读取失败,后由UMass镜像补齐§2—4
技术关系
- 04-q-learning · 直接继承
把一步Bellman更新推广到随机持续时间的技能。
- 33-diayn · 教学联系
提供学习多样技能的另一个问题视角,但潜变量技能不自动构成完整option三元组。
仍需留意
- 未逐行审核§5—7 intra-option学习证明与全部实验重复;未独立复现
强化学习Policy Gradient Methods for Reinforcement Learning with Function Approximation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:用近似价值替代完整回报,会不会改变策略梯度
- 二、递归组织访问分布,再约束价值误差方向
- 三、以同一采样权重拟合兼容特征
- 四、用梯度对照图核查三个定理的条件
- 五、从兼容条件退回有限样本近似
- 六、把兼容正规方程接到策略几何
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:用近似价值替代完整回报,会不会改变策略梯度
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、递归组织访问分布,再约束价值误差方向 / 验算绝对价值错了为何梯度仍可正确
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、以同一采样权重拟合兼容特征
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、从兼容条件退回有限样本近似
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、从兼容条件退回有限样本近似
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 兼容特征的维度为什么跟策略参数相同:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“兼容特征的维度为什么跟策略参数相同”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
兼容近似除参数维度相同外还要求指定访问权重下的正交条件;一般Critic网络不自动兼容。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:1 幅
- 真实Q为3和1,兼容近似为1和负1,常量残差2被score抵消
教学示意 · 原创教学图 · Theorem 2兼容误差条件的原创算例
三组柱从真实Q、近似f一直读到两者残差:两个动作都错2,但加权score的正负项相消。图中价值误差不为零而策略梯度一致,说明兼容条件关心的是误差投影;若换成任意深网或不匹配采样权重,这个相消不能自动成立。
未复核全部局部收敛分析的外部引理
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:共享 Actor/Critic 主干是否仍满足兼容条件?;为什么值函数误差很小仍可能使梯度方向错误?;off-policy 数据需要怎样的分布修正?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
本轮边界:未复核全部局部收敛分析的外部引理
本次深化
- 递归展开策略梯度,解释状态访问权重及兼容近似的一阶正交条件。
- 构造绝对价值误差非零但策略梯度正确的两动作反例。
- 明确Theorem 2–3的表示、平滑和步长条件,区分驻点与全局最优。
- v2:为三个原始追问逐题增加参考答案:共享 Actor/Critic 主干是否仍满足兼容条件?;为什么值函数误差很小仍可能使梯度方向错误?;off-policy 数据需要怎样的分布修正?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- proceedings.neurips.cc · 所列章节
Theorem 1—3,特别Theorem 2证明与兼容特征解释
技术关系
- 05-reinforce · 直接继承
共同使用似然比思想,本文进一步刻画价值近似条件。
- 09-natural-policy-gradient · 直接继承
兼容特征正规方程导向Fisher预条件化。
仍需留意
- 未复核全部局部收敛分析的外部引理
强化学习A Natural Policy Gradient部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:参数步幅相同,为何行为分布变化差很多
- 二、从局部 KL 约束解出 Fisher 方向
- 三、求解带阻尼线性系统并检查实际 KL
- 四、读优化路径与 Tetris 迭代曲线
- 五、分清参数化几何、数值近似与步长
- 六、继续追问:Fisher样本、收益与预条件化
- 七、从局部方向继续控制实际更新幅度
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:参数步幅相同,为何行为分布变化差很多
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、从局部 KL 约束解出 Fisher 方向 / 把两个方向缩放到同一KL预算再比较
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、求解带阻尼线性系统并检查实际 KL
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分清参数化几何、数值近似与步长
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分清参数化几何、数值近似与步长
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 用一维重参数化检查几何含义:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“用一维重参数化检查几何含义”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
坐标抵消例子仅用非零线性尺度与可逆Fisher;奇异矩阵、阻尼和有限步更新另有条件。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:2 幅
- Tetris中标准梯度、自然梯度及不同棋盘设置的积分学习曲线
实验/结果图 · 必要原图摘引 · Figure 2, PDF第7页;仅图形区域
自然梯度与兼容近似的理论桥梁说明为何用Fisher几何处理参数尺度。[图1](https://proceedings.neurips.cc/paper/2001/file/4b86abe48d358ecf194c56c69108433e-Paper.pdf#page=6)的LQG等构造比较等价策略参数化下的优化路径,读图时要注意部分横轴取log时间;[图2](https://proceedings.neurips.cc/paper/2001/file/4b86abe48d358ecf194c56c69108433e-Paper.pdf#page=7)的Tetris纵轴是points:A面板横轴为log迭代,B/C面板是线性迭代,且C改变了游戏高度与计算配置。它们支持所测参数化和任务中的方向/速度差异,但没有把Fisher估计与线性求解成本从比较中消除,也不能外推所有深网。 [查看原文](https://proceedings.neurips.cc/paper/2001/file/4b86abe48d358ecf194c56c69108433e-Paper.pdf)。
- A面板比较参数缩放后的LQG成本,横轴取log时间;B给出两状态任务,C比较奖励随时间变化,D画参数空间轨迹。应先区分任务表现与参数路径,再判断自然梯度为何减少尺度造成的绕路。
实验/结果图 · 必要原图摘引 · Figure 1, PDF第6页
A面板比较参数缩放后的LQG成本,横轴取log时间;B给出两状态任务,C比较奖励随时间变化,D画参数空间轨迹。应先区分任务表现与参数路径,再判断自然梯度为何减少尺度造成的绕路。
未复现实验;不把局部二次近似称作全局KL保证
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:Fisher 估计样本不够时方向会怎样变?;相同 KL 步长是否保证相同回报提升?;自然梯度与 Adam 的预条件化有何区别?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:PDF page 6,2:PDF page 7
查看本篇 2 个原文证据入口
- 图1 · PDF page 6
原站图表/证明入口
- 图2 · PDF page 7
原站图表/证明入口
本轮边界:未复现实验;不把局部二次近似称作全局KL保证
本次深化
- 从KL二阶展开导出Fisher几何,区分更新方向与步幅。
- 手算各向异性Fisher下普通与自然梯度,要求匹配KL预算。
- 核读Tetris图2的阻尼和迭代口径,不把优化效率说成表示能力优势。
- v2:为三个原始追问逐题增加参考答案:Fisher 估计样本不够时方向会怎样变?;相同 KL 步长是否保证相同回报提升?;自然梯度与 Adam 的预条件化有何区别?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:PDF page 6,2:PDF page 7
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- proceedings.neurips.cc · 所列章节
自然梯度和兼容近似推导;§5图2及其图注
技术关系
- 08-policy-gradient-theorem · 直接继承
正规方程解释Fisher方向。
- 14-trpo · 直接继承
把KL几何变为可检查的受限更新流程,并补充回溯。
仍需留意
- 未复现实验;不把局部二次近似称作全局KL保证
强化学习Least-Squares Policy Iteration部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:固定一批转移,怎样反复评价并改进不同策略
- 二、由特征正交条件构造 LSTDQ 方程
- 三、固定转移集并随策略重建后继特征
- 四、对照倒立摆曲线的尺度与采样预算
- 五、解出方程之后仍要检查数据覆盖
- 六、继续追问:特征秩、重复证据与贪心外推
- 七、从批量控制走向离线动作约束
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:固定一批转移,怎样反复评价并改进不同策略
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、由特征正交条件构造 LSTDQ 方程 / 检查终止掩码怎样改写同一批奖励
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、固定转移集并随策略重建后继特征
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、解出方程之后仍要检查数据覆盖
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、解出方程之后仍要检查数据覆盖
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 线性方程的形状也是实现检查:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“线性方程的形状也是实现检查”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
矩阵形状检查不能保证方程可逆或数值稳定;A转置即使维度相同也不是同一LSTDQ方程。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:4 幅
- 图16:倒立摆平均平衡步数随训练回合数变化
实验/结果图 · 必要原图摘引 · Figure 16, PDF第33页;仅图形区域
图16的纵轴上限是3000步,蓝线表示跨数据集平均,误差条与最佳/最差数据集曲线揭示样本覆盖的不确定性。横轴增加的是预先收集的随机训练回合,不是测试时继续学习。
- 图17:倒立摆平均平衡步数随训练回合数变化
实验/结果图 · 必要原图摘引 · Figure 17, PDF第34页;仅图形区域
图17采用Q-learning对照,但纵轴最高只有50步,远低于上一图的3000步截断上限。两张图看起来都在上升,若忽略轴尺度就会错读为效果接近;相同特征与样本来源也不能保证两种优化过程同样高效。
- 从左下的Samples输入开始:固定数据进入LSTDQ评价,得到当前策略的近似Q,再做贪心改进并回到评价。循环使用同一批转移,并不表示每轮评价方程保持不变。
方法/设定图 · 必要原图摘引 · Figure 3, PDF第7页
从左下的Samples输入开始:固定数据进入LSTDQ评价,得到当前策略的近似Q,再做贪心改进并回到评价。循环使用同一批转移,并不表示每轮评价方程保持不变。
- 回放版Q-learning的纵轴恢复到3000步上限。蓝色均值、红色误差条和紫色最好/最差数据集曲线要一起看;较好最终平衡成绩还用了同批样本100遍回放,不能与单遍基线等计算量比较。
实验/结果图 · 必要原图摘引 · Figure 18, PDF第35页
回放版Q-learning的纵轴恢复到3000步上限。蓝色均值、红色误差条和紫色最好/最差数据集曲线要一起看;较好最终平衡成绩还用了同批样本100遍回放,不能与单遍基线等计算量比较。
自行车实验全部参数未逐项复核
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:加入一个无法被数据激活的特征会怎样?;同一数据重复求解为什么不等于增加独立证据?;离线场景的贪心改进为何可能降低真实收益?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:3:PDF page 7,16:PDF page 33,17:PDF page 34,18:PDF page 35
查看本篇 4 个原文证据入口
- 图3 · PDF page 7
原站图表/证明入口
- 图16 · PDF page 33
原站图表/证明入口
- 图17 · PDF page 34
原站图表/证明入口
- 图18 · PDF page 35
原站图表/证明入口
本轮边界:自行车实验全部参数未逐项复核
本次深化
- 由LSTDQ投影方程解释固定数据下策略迭代,区分普通最小二乘标签。
- 用一维特征手算终止掩码改变线性方程与价值解。
- 核实倒立摆100次重复、1000次评价及95%区间,单列回放基线计算。
- v2:为三个原始追问逐题增加参考答案:加入一个无法被数据激活的特征会怎样?;同一数据重复求解为什么不等于增加独立证据?;离线场景的贪心改进为何可能降低真实收益?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:3:PDF page 7,16:PDF page 33,17:PDF page 34,18:PDF page 35
- 正文新增2幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- www.jmlr.org · 所列章节
LSTDQ投影方程;§9.1—9.2与图16—18
技术关系
- 02-td-lambda · 直接继承
将逐步TD评价转为批量线性方程求解。
- 37-bcq · 历史背景
同样面对固定数据复用,但后者专门限制离线数据外动作。
仍需留意
- 自行车实验全部参数未逐项复核
强化学习Double Q-learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:各动作估值无偏,取最大值为何仍会高估
- 二、分开挑赢家与评价赢家
- 三、随机选择一张表更新并交叉取目标
- 四、同时读取奖励曲线与起点最大Q
- 五、减少高估之后仍可能低估或选错
- 六、把双估计带到相关神经网络中
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:各动作估值无偏,取最大值为何仍会高估
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、分开挑赢家与评价赢家 / 枚举四种噪声情形并算最大值期望
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、随机选择一张表更新并交叉取目标
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、减少高估之后仍可能低估或选错
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、减少高估之后仍可能低估或选错
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 比较的是选中动作的误差分布:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“比较的是选中动作的误差分布”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
选择与评价误差的条件独立性是解释工具;共享数据和相关函数逼近误差可能破坏它。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 紧邻图2补充环境步横轴、两列步长日程、实/虚线及两类纵轴的判断方式。
正文配图:1 幅
- 网格世界中Q-learning与Double Q的每步奖励和初始状态最大Q值
实验/结果图 · 必要原图摘引 · Figure 2, PDF第7页;仅图形区域
图2两列分别采用不同的步长衰减日程,横轴都是环境步数;实线为Q-learning,虚线为Double Q。上排每步奖励越高越好,下排则应比较估值与真实值的偏差,不能一律把更低当成更好。先在同一列内读两种算法,再比较两列,才能把双估计机制与步长选择分开;图中的均值并不展示单次训练的全部波动。
未逐行复核收敛补充证明
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:两张表完全共享噪声时还能减轻偏差吗?;真值差很大与几乎相等时,偏差风险有何不同?;取 min 和交叉评价分别解决什么问题?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:PDF page 7
查看本篇 1 个原文证据入口
- 图2 · PDF page 7
原站图表/证明入口
本轮边界:未逐行复核收敛补充证明
本次深化
- 拆开带噪估值中的选择与评价,说明双估计仍可能低估。
- 手算单估计max偏差0.5与独立评价期望0的两动作例。
- 核读图2的10000次运行,区分策略排序改善与绝对价值误差。
- v2:为三个原始追问逐题增加参考答案:两张表完全共享噪声时还能减轻偏差吗?;真值差很大与几乎相等时,偏差风险有何不同?;取 min 和交叉评价分别解决什么问题?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:PDF page 7
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:紧邻图2补充环境步横轴、两列步长日程、实/虚线及两类纵轴的判断方式。
查核资料
- papers.nips.cc · 所列章节
§2双估计、Algorithm 1、§4.2图2
技术关系
- 04-q-learning · 直接继承
改变最大化目标的估计方式。
- 18-double-dqn · 直接继承
将选择与评价分离引入在线/目标网络。
- 31-td3 · 教学联系
双Critic取最小值是另一种防高估机制,不应混写。
仍需留意
- 未逐行复核收敛补充证明
强化学习Guided Policy Search部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:随机探索见不到好轨迹,策略怎样得到可用信号
- 二、从引导分布重加权到当前策略目标
- 三、交替生成引导样本、修正分布并检验新策略
- 四、读去引导、去正则与预训练对照
- 五、同时计算引导收益与额外采样成本
- 六、继续追问:支持覆盖、权重与模型条件
- 七、继续辨析分布偏移的不同处理方式
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:随机探索见不到好轨迹,策略怎样得到可用信号
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、从引导分布重加权到当前策略目标 / 算清引导回报8为何不是策略回报4
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、交替生成引导样本、修正分布并检验新策略
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、同时计算引导收益与额外采样成本
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、同时计算引导收益与额外采样成本
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 为什么要用轨迹前缀而非整条比值:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“为什么要用轨迹前缀而非整条比值”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
前缀重要性比的缩短用未来比值条件期望为1及支持条件;自归一化仍有有限样本偏差。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 核对原文§3后补前缀权重、Z归一化、原版正则目标及有限样本偏差/混合采样条件。
- 依据原文§6.1在图旁补迭代与平均奖励、灰带和黑虚线含义及最后面板的检验问题。
正文配图:1 幅
- GPS在游泳、跳跃和两种步行网络中的学习曲线及引导消融
实验/结果图 · 必要原图摘引 · Figure 2, PDF第6页;仅图形区域
四个面板横轴都是优化迭代,纵轴是每轮rollout的平均奖励,较不负表示较好;swimmer与其余任务的纵轴尺度不同。红线是完整GPS,黑虚线是初始轨迹,灰带表示引导样本回报的范围(原文为两倍标准差),并非红线跨训练种子的置信区间。最后一个较小步行网络面板尤其用于检查:只在预训练时见过引导,是否足够支持后续改善。
未实现完整正则求解器;不代表后续全部GPS变体
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:如果引导轨迹本身是差的局部解,策略会学到什么?;引导优化的计算应怎样计入训练成本?;为何离线行为克隆不等于完整 GPS?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:PDF page 6
查看本篇 1 个原文证据入口
- 图2 · PDF page 6
原站图表/证明入口
本轮边界:未实现完整正则求解器;不代表后续全部GPS变体
本次深化
- 解释2013 GPS的引导分布、重要性修正与支持条件,不混写后续变体。
- 手算未加权回报8与目标策略期望4,展示分布错配。
- 核对图2消融及每轮10次rollout、额外40个引导样本的预算差异。
- v2:为三个原始追问逐题增加参考答案:如果引导轨迹本身是差的局部解,策略会学到什么?;引导优化的计算应怎样计入训练成本?;为何离线行为克隆不等于完整 GPS?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:PDF page 6
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:核对原文§3后补前缀权重、Z归一化、原版正则目标及有限样本偏差/混合采样条件。
- 第三版:依据原文§6.1在图旁补迭代与平均奖励、灰带和黑虚线含义及最后面板的检验问题。
查核资料
- proceedings.mlr.press · 所列章节
重要性采样与正则机制;算法更新;§6图2消融与预算
技术关系
- 05-reinforce · 平行方法
共同优化策略回报,但GPS借助模型生成高质量采样分布。
- 14-trpo · 教学联系
都关注分布变化使样本估计失真,但目标与求解约束不同。
仍需留意
- 未实现完整正则求解器;不代表后续全部GPS变体
强化学习Deterministic Policy Gradient Algorithms部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:连续动作无法枚举,能否沿价值的动作导数改进
- 二、把价值对动作的导数接到Actor参数
- 三、用探索数据学习Critic并保留动作梯度
- 四、分开读取高维bandit与连续控制结果
- 五、检查局部斜率与访问分布的误差
- 六、继续追问:探索覆盖与离策略近似
- 七、把确定性梯度接入深度回放系统
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:连续动作无法枚举,能否沿价值的动作导数改进
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、把价值对动作的导数接到Actor参数 / 让正确和错误Critic分别指挥一次更新
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、用探索数据学习Critic并保留动作梯度
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、检查局部斜率与访问分布的误差
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、检查局部斜率与访问分布的误差
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 动作维度与参数维度怎样连接:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“动作维度与参数维度怎样连接”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
Jacobian转置取决于列梯度约定;确定性策略梯度还需可微Q和原定理的状态分布条件。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 就地补rho与d的规范化关系及两段梯度的角色,链接原文定义。
- 紧邻图2补时间步/回报倍率、方法对照与均值策略评估,防止把bandit图的解释移植过来。
正文配图:3 幅
- 确定性COPDAC-Q与随机Actor-Critic在Mountain Car、Pendulum和Puddle World的回报
实验/结果图 · 必要原图摘引 · Figure 2, PDF第7页;仅图形区域
这张图是连续控制的图2,不是前面讨论动作维数的bandit图1。三个面板横轴为时间步(刻度乘 $10^4$),纵轴为每回合总奖励(刻度乘 $10^3$),越高越好;不同任务纵轴范围不同。红线COPDAC-Q与蓝线OffPAC-TD的比较更接近“同为离策略、改变确定/随机Actor”,绿线SAC还同时改变了采样方式。曲线评价的是均值策略,不能把训练噪声造成的即时损失直接读入这些测试分数。
- 三列将连续动作维数从10增到25和50,横纵轴都用对数尺度;红色COPDAC-B在高维时较快压低成本。这是bandit构造中梯度估计的比较,不是所有连续控制任务的统一性能结论。
实验/结果图 · 必要原图摘引 · Figure 1, PDF第7页
三列将连续动作维数从10增到25和50,横纵轴都用对数尺度;红色COPDAC-B在高维时较快压低成本。这是bandit构造中梯度估计的比较,不是所有连续控制任务的统一性能结论。
- 上图看每回合回报,下图看到达目标的步数;灰线为10次运行,红线汇总其趋势。两种指标方向相反但结论相容,不能只展示回报而隐藏到达时间的离散性。
实验/结果图 · 必要原图摘引 · Figure 3, PDF第8页
上图看每回合回报,下图看到达目标的步数;灰线为10次运行,红线汇总其趋势。两种指标方向相反但结论相容,不能只展示回报而隐藏到达时间的离散性。
未逐行复核正则条件与附录证明;教学例仅单状态
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:确定性策略怎样保证探索?;动作有硬边界时梯度如何处理?;为什么不需要对真实环境求导?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:PDF page 7,2:PDF page 7,3:PDF page 8
查看本篇 3 个原文证据入口
- 图1 · PDF page 7
原站图表/证明入口
- 图2 · PDF page 7
原站图表/证明入口
- 图3 · PDF page 8
原站图表/证明入口
本轮边界:未逐行复核正则条件与附录证明;教学例仅单状态
本次深化
- 沿Critic动作导数推导确定性策略梯度,说明离策略权重的条件。
- 用抛物线Q展示正确与错误Critic导数把Actor推向相反方向。
- 核实bandit五次运行与控制任务三十次,区分环境步和参数扫描预算。
- v2:为三个原始追问逐题增加参考答案:确定性策略怎样保证探索?;动作有硬边界时梯度如何处理?;为什么不需要对真实环境求导?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:PDF page 7,2:PDF page 7,3:PDF page 8
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:就地补rho与d的规范化关系及两段梯度的角色,链接原文定义。
- 第三版:紧邻图2补时间步/回报倍率、方法对照与均值策略评估,防止把bandit图的解释移植过来。
查核资料
- proceedings.mlr.press · 所列章节
§3—4定理与离策略解释;§5.1—5.3实验设置
技术关系
- 08-policy-gradient-theorem · 直接继承
扩展到确定性连续动作策略的梯度表达。
- 17-ddpg · 直接继承
把DPG嵌入深网、经验回放和目标网络配方。
仍需留意
- 未逐行复核正则条件与附录证明;教学例仅单状态
强化学习Trust Region Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:旧轨迹支持的好方向,走远以后是否仍可靠
- 二、从性能差恒等式走到受限替代目标
- 三、求自然方向、缩放候选步并回溯
- 四、读连续控制曲线并检查各自采样权限
- 五、区分最坏状态理论界与平均KL实现
- 六、继续追问:未见状态、优势误差与步幅
- 七、沿优势估计和一阶更新继续拆分
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:旧轨迹支持的好方向,走远以后是否仍可靠
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、从性能差恒等式走到受限替代目标 / 用二次KL验算候选步为什么仍需回溯
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、求自然方向、缩放候选步并回溯
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、区分最坏状态理论界与平均KL实现
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、区分最坏状态理论界与平均KL实现
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 为什么先解方向,再用预算决定长度:采用Spinning Up的局部目标→方向→尺度→回溯顺序,逐行展开Δ=cv的KL预算,不采纳平均KL无条件保单调的简写。
教法来源与实际阅读范围
- OpenAI Spinning Up · Trust Region Policy Optimization
Key Equations;Taylor局部问题;共轭梯度与回溯
原论文校准:原稿已核TRPO局部约束式与原文§4–5符号,另与本次实际阅读的Spinning Up方向、尺度及回溯说明交叉核对;新增内容是代数展开。 · 原文
尺度推导只针对正曲率的局部二次KL模型;实践平均KL与理论最大KL、阻尼与回溯不能互换为全局保证。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补策略迭代轴、同任务比较方式及Swimmer轴名/正文定义差异,保留原图不擅改。
正文配图:1 幅
- TRPO在Cartpole、Swimmer、Hopper和Walker的回报学习曲线
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形
四个面板横轴都是策略迭代次数,不能直接视为相同环境交互或墙钟;先在同一任务里比较Vine、Single Path与其他方法。Cartpole、Hopper和Walker纵轴标reward;Swimmer图上仍标cost,而[原文§8.1](https://arxiv.org/html/1502.05477v5#S8.SS1)按前进奖励减控制惩罚解释性能,因此应连同任务定义阅读,不单凭一个轴名反转结论。图展示所测流程的回报变化,不能从误差条重叠与否单独宣布统计显著性。
未独立复现;完整任务预算和全部超参数未逐项核对
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:平均 KL 很小却有少数状态变化巨大,可能发生什么?;恢复状态的 vine 采样额外提供了什么能力?;回溯通过是否意味着真实回报一定提升?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:4:S8.F4
查看本篇 1 个原文证据入口
- 图4 · S8.F4
原站图表/证明入口
本轮边界:未独立复现;完整任务预算和全部超参数未逐项核对
本次深化
- 串起性能差恒等式、旧分布替代、KL局部近似及回溯四层推导。
- 补全dπ、g、F、δ定义,将优化方向记为v并明确NPG→TRPO→PPO方向。
- 手算二维候选步及KL超预算拒绝例,区分局部模型和实际样本检查。
- 核实图4五次运行、基线与max-KL对照范围,不宣称深网逐步单调改进。
- v2:为三个原始追问逐题增加参考答案:平均 KL 很小却有少数状态变化巨大,可能发生什么?;恢复状态的 vine 采样额外提供了什么能力?;回溯通过是否意味着真实回报一定提升?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:4:S8.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补策略迭代轴、同任务比较方式及Swimmer轴名/正文定义差异,保留原图不擅改。
查核资料
- arxiv.org · 所列章节
§3性能界、§4—5近似求解、§8图4与基线说明
技术关系
- 09-natural-policy-gradient · 直接继承
沿用Fisher几何,但增加受限目标、步幅选择与回溯。
- 15-gae · 模块组合
负责优势估计,可以作为TRPO输入,不取代本篇优化步骤。
- 27-ppo · 直接继承
延续概率比替代目标及保守更新动机,改用更方便的一阶目标。
仍需留意
- 未独立复现;完整任务预算和全部超参数未逐项核对
强化学习High-Dimensional Continuous Control Using Generalized Advantage Estimation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:优势信号太吵时,要信任多远的TD修正
- 二、展开多步优势并合并为几何残差和
- 三、冻结旧价值后从轨迹尾部递推
- 四、读成本曲线与γ、λ联合热图
- 五、区分折扣偏差、价值误差与截断错误
- 六、继续追问:短估计、时间限制与优化器
- 七、把同一优势接口交给不同策略优化器
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:优势信号太吵时,要信任多远的TD修正
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、展开多步优势并合并为几何残差和 / 核对三步递推与直接加权和
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、冻结旧价值后从轨迹尾部递推
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、区分折扣偏差、价值误差与截断错误
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、区分折扣偏差、价值误差与截断错误
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 尾部价值误差沿递推衰减多少:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“尾部价值误差沿递推衰减多少”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
尾部误差传播只改一个末端价值并冻结其余输入;不代表长片段能消除内部Critic误差。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:2 幅
- GAE在Cart-pole中比较λ的成本曲线及γ与λ联合扫描热图
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形
**实验解读与读图**:[原文§6.3](https://arxiv.org/html/1506.02438v6#S6.SS3)把学习曲线纵轴定义为负回报成本,越低越好。[图2](https://arxiv.org/html/1506.02438v6#S6.F2)左侧以迭代为横轴,固定γ=0.99比较λ;右侧在20次策略迭代后扫描γ与λ,白色表示较高回报,两种视觉方向不能混用。Cart-pole结果平均21个随机种子,中间参数范围的较好表现支持偏差—方差折中,不是λ越大越好的证据。3D[图3](https://arxiv.org/html/1506.02438v6#S6.F3)的双足曲线平均9次运行、四足平均5次;每批双足50000步,四足与起身200000步,因此相同迭代数不等于相同样本预算。“No VF”仍使用时间相关基线,并非完全零基线。
- 两列分别是3D双足与四足,纵轴为cost,下降才是改善;横轴是策略迭代,不能直接当作相同环境交互量。两任务分别汇总9次与5次运行,带价值估计的不同参数曲线应在各自任务内比较。
实验/结果图 · 必要原图摘引 · Figure 3完整图形; HTML S6.F3
两列分别是3D双足与四足,纵轴为cost,下降才是改善;横轴是策略迭代,不能直接当作相同环境交互量。两任务分别汇总9次与5次运行,带价值估计的不同参数曲线应在各自任务内比较。
未复现;未逐点重读曲线坐标,不给未经读取的精确回报
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:V 很准确时为什么较小 λ 可能有利?;把时间限制当真正终止会产生什么偏差?;为什么 GAE 可以与多种策略优化器组合?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S6.F2,3:S6.F3
- 核读§6.3,明确曲线纵轴cost=-reward越低越好、图2右热图白色更好;答案以V^{π,γ}区分折扣目标与γ偏差
- 合并GAE重复实验/读图段,保留成本方向、热图方向、21/9/5次运行及每批预算
查看本篇 2 个原文证据入口
- 图2 · S6.F2
原站图表/证明入口
- 图3 · S6.F3
原站图表/证明入口
本轮边界:未复现;未逐点重读曲线坐标,不给未经读取的精确回报
本次深化
- 从多步优势混合导出几何TD残差权重,说明λ=1尾项与截断处理。
- 澄清未折扣基础目标、γ引入偏差和γ-just范围;GAE是可组合估计器。
- 手算三步反向递推,并将cart-pole/双足/四足21/9/5次重复写入主表。
- v2:为三个原始追问逐题增加参考答案:V 很准确时为什么较小 λ 可能有利?;把时间限制当真正终止会产生什么偏差?;为什么 GAE 可以与多种策略优化器组合?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S6.F2,3:S6.F3
- v2:核读§6.3,明确曲线纵轴cost=-reward越低越好、图2右热图白色更好;答案以V^{π,γ}区分折扣目标与γ偏差
- 合并GAE重复实验/读图段,保留成本方向、热图方向、21/9/5次运行及每批预算
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- arxiv.org · 所列章节
§3多步推导与§4解释;§6.1更新顺序;§6.2—6.3与图2—3
技术关系
- 02-td-lambda · 直接继承
共享多步混合与残差几何加权,但估计对象不同。
- 14-trpo · 模块组合
原文将GAE与信赖域策略及价值更新组合。
- 27-ppo · 模块组合
GAE可为其提供固定优势;clip目标并不能消除优势误差。
仍需留意
- 未复现;未逐点重读曲线坐标,不给未经读取的精确回报
强化学习Human-level control through deep reinforcement learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:把Q表换成神经网络后,怎样稳住自举学习
- 二、分别缓和样本相关性与目标追逐
- 三、抽取回放并只对在线Q反向传播
- 四、读人类归一化游戏表现与组件消融
- 五、保持目标稳定仍不等于目标正确
- 六、继续追问:回放分布、终止与目标复制
- 七、继续修正目标偏差和回放分配
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:把Q表换成神经网络后,怎样稳住自举学习
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、分别缓和样本相关性与目标追逐 / 比较固定4.6与同步漂移的6.4
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、抽取回放并只对在线Q反向传播
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、保持目标稳定仍不等于目标正确
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、保持目标稳定仍不等于目标正确
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 回放与目标网络分别冻结了什么:借离策略教程分开回放与目标网络两个接口;用旧转移在目标复制后标签仍改变的例子说明冻结对象。
教法来源与实际阅读范围
- OpenAI Spinning Up · Deep Deterministic Policy Gradient
回放与目标网络;连续argmax;策略梯度路径
- OpenAI Spinning Up · Kinds of RL Algorithms
A Taxonomy;Model-Free versus Model-Based
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“回放与目标网络分别冻结了什么”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文 · 原文
数据回放与目标参数冻结是不同接口;标签会随目标网络复制而改变,不能把旧转移当固定监督对。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 在图2下补面板对应、原横轴口径、平滑度与组件证据边界。
正文配图:3 幅
- DQN在Space Invaders和Seaquest上的评估分数与预测Q值随训练变化
实验/结果图 · 必要原图摘引 · Figure 2, PDF第2页;仅图形区域
按列读:左列Space Invaders,右列Seaquest;按行读:上排是实际评估的每回合平均分,下排是在保留状态集上计算的平均Q。横轴标为training epochs,不能直接当回合数或百万环境步。下排更平滑并不证明策略表现也同样稳定:Q使用裁剪奖励的累计尺度,上排仍会波动,且两排都没有提供“去掉目标网络”的对照。
- 像素输入经卷积和全连接层后,同时输出各离散动作的Q值,控制器再选择动作。图示的是信息流;实际层数、滤波器和训练配置仍以Methods为准。
方法/设定图 · 必要原图摘引 · Figure 1, PDF第2页
像素输入经卷积和全连接层后,同时输出各离散动作的Q值,控制器再选择动作。图示的是信息流;实际层数、滤波器和训练配置仍以Methods为准。
- 每行是一款游戏,蓝色DQN与灰色线性基线在同一行比较。100%是人类基准,横轴上方两款游戏带断轴,不能按柱长直接比较跨游戏的绝对分数。
实验/结果图 · 必要原图摘引 · Figure 3, PDF第3页
每行是一款游戏,蓝色DQN与灰色线性基线在同一行比较。100%是人类基准,横轴上方两款游戏带断轴,不能按柱长直接比较跨游戏的绝对分数。
未在正文展示的图/表与范围
- 表Extended Data 3:Table references inventoried separately; figure-only completion priority.
- 表Extended Data 4:Table references inventoried separately; figure-only completion priority.
未逐项复核全部49游戏表项与扩展消融数字
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:为什么只打乱样本还不足以稳定训练?;人类归一化的平均数为何容易受极高分游戏影响?;动作连续后 max Q 怎样计算?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:PDF page 2,2:PDF page 2,3:PDF page 3
查看本篇 3 个原文证据入口
- 图1 · PDF page 2
原站图表/证明入口
- 图2 · PDF page 2
原站图表/证明入口
- 图3 · PDF page 3
原站图表/证明入口
本轮边界:未逐项复核全部49游戏表项与扩展消融数字
本次深化
- 解释回放与冻结目标分别处理相关数据和移动自举目标。
- 手算固定目标4.6与同步目标6.4,展示追逐标签的问题。
- 核实人类归一化公式与30评估回合标准差,区分裁剪奖励和原始分数。
- v2:为三个原始追问逐题增加参考答案:为什么只打乱样本还不足以稳定训练?;人类归一化的平均数为何容易受极高分游戏影响?;动作连续后 max Q 怎样计算?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:PDF page 2,2:PDF page 2,3:PDF page 3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:在图2下补面板对应、原横轴口径、平滑度与组件证据边界。
查核资料
- storage.googleapis.com · 所列章节
正文更新、图1—3及图注、扩展实验说明
技术关系
- 04-q-learning · 直接继承
保留Bellman最优目标,改变表示与训练系统。
- 18-double-dqn · 直接继承
进一步修正目标中的选择偏差。
- 19-per · 模块组合
改变回放抽样分布而非Q网络输出定义。
仍需留意
- 未逐项复核全部49游戏表项与扩展消融数字
强化学习Continuous control with deep reinforcement learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:连续动作Actor怎样与深度回放Critic共同训练
- 二、让Actor近似选动作并区分两种冻结
- 三、用目标双网络造标签并做软更新
- 四、读目标网络、归一化与平均运行表现
- 五、追逐更高Q为何也可能钻估计漏洞
- 六、继续追问:动作梯度、探索和目标滞后
- 七、沿连续控制的估值误差继续修补
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:连续动作Actor怎样与深度回放Critic共同训练
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、让Actor近似选动作并区分两种冻结 / 算清软更新并非定期完整复制
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、用目标双网络造标签并做软更新
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、追逐更高Q为何也可能钻估计漏洞
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、追逐更高Q为何也可能钻估计漏洞
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 对照两种软更新参数写法:对照Spinning Up的Polyak写法与本文τ记法,给出ρ=1−τ,避免把接近1的系数放到相反位置。
教法来源与实际阅读范围
- OpenAI Spinning Up · Deep Deterministic Policy Gradient
回放与目标网络;连续argmax;策略梯度路径
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“对照两种软更新参数写法”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
τ与ρ互换只对应明确的Polyak参数写法;不能据此忽略实现更新频率、优化器和目标初始化。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 定义符号及replay期望,展开Actor链式梯度并区分两处停止梯度。
- 从原图注补齐四种颜色含义、环境步数和随机/iLQG基准,并限定蓝绿比较。
正文配图:2 幅
- DDPG目标网络与批归一化消融在十项控制任务上的归一化奖励
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形
横轴以百万环境步计,纵轴将随机策略定为0、iLQG规划器定为1,超过1并非超过某个普遍最优上界。[原文图注](https://arxiv.org/html/1509.02971v6#S4.F2)中浅灰是带batch normalization的原DPG变体,深灰加入目标网络,绿线同时用目标网络与归一化,蓝线则从像素输入学习。像素蓝线还改变了输入条件,故蓝绿差距不能仅归因于归一化;图中并非所有任务都呈相同排名。
- 三列比较Pendulum、Cartpole和Cheetah的预测Q与测试回报,来自5个重复训练实例;对角线表示一致。Cheetah明显偏离对角线但策略仍可有效,说明精确校准与正确行动排序是不同要求。
实验/结果图 · 必要原图摘引 · Figure 3完整图形; HTML S4.F3
三列比较Pendulum、Cartpole和Cheetah的预测Q与测试回报,来自5个重复训练实例;对角线表示一致。Cheetah明显偏离对角线但策略仍可有效,说明精确校准与正确行动排序是不同要求。
未在正文展示的图/表与范围
- 表1:Table references inventoried separately; figure-only completion priority.
未复现;原版所有环境细节及超参数未逐项核验
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:为什么目标 Critic 不能单独解决高估?;batch normalization 的训练/评价统计如何影响结果?;更强的 Actor 优化为何有时反而变差?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S4.F2,3:S4.F3
查看本篇 2 个原文证据入口
- 图2 · S4.F2
原站图表/证明入口
- 图3 · S4.F3
原站图表/证明入口
本轮边界:未复现;原版所有环境细节及超参数未逐项核验
本次深化
- 说明DPG梯度、回放和慢目标如何组合,分清Actor与Critic更新路径。
- 手算软更新1、1.9、2.71,纠正将τ解释成硬复制周期的直觉。
- 核实表1五次运行的平均与最佳,区分可用策略和准确Q估计。
- v2:为三个原始追问逐题增加参考答案:为什么目标 Critic 不能单独解决高估?;batch normalization 的训练/评价统计如何影响结果?;更强的 Actor 优化为何有时反而变差?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S4.F2,3:S4.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:定义符号及replay期望,展开Actor链式梯度并区分两处停止梯度。
- 第三版:从原图注补齐四种颜色含义、环境步数和随机/iLQG基准,并限定蓝绿比较。
查核资料
- arxiv.org · 所列章节
Algorithm 1;§4图2—3与表1
技术关系
仍需留意
- 未复现;原版所有环境细节及超参数未逐项核验
强化学习Deep Reinforcement Learning with Double Q-learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:DQN已有两个网络,为何目标仍可能高估
- 二、把在线argmax交给目标网络评分
- 三、保持回放流程并替换TD目标来源
- 四、并排读取估值偏差和游戏得分
- 五、网络相关与目标滞后仍会影响分离
- 六、把目标修正放入组合系统再检验
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:DQN已有两个网络,为何目标仍可能高估
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、把在线argmax交给目标网络评分 / 比较同一组网络输出得到的9.1与5.5
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、保持回放流程并替换TD目标来源
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、网络相关与目标滞后仍会影响分离
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、网络相关与目标滞后仍会影响分离
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 两个网络相等时应恢复什么目标:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“两个网络相等时应恢复什么目标”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
网络相等时标签退化只校验动作索引与取值接口;它不证明后续网络误差独立或性能提高。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补橙蓝图例、百万步横轴、后训练水平参考线、对数估值/原始分数分行阅读。
正文配图:3 幅
- 六项Atari任务中DQN与Double DQN的估值偏差及两项游戏实际分数
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
橙色是DQN、蓝色是Double DQN,横轴为百万训练步。上排水平线是训练结束后运行相应策略得到的折扣回报,应与曲线最右端比较,不能当作每个早期策略的真实价值。中排两图的估值纵轴采用对数刻度,下排是同两款游戏的原始分数;“估值突然变大”与“分数掉落”必须分行读。阴影按[原图注](https://arxiv.org/html/1509.06461v3#Sx4.F3)为种子分位范围,既不是Q的置信上界,也不是逐步TD误差。
- 横轴是动作数,橙色最大值选择的偏差随候选数增大,蓝色独立估值接近零。此处误差是独立高斯构造、每柱100次重复,不可把偏差大小直接当成Atari网络的实测误差。
实验/结果图 · 必要原图摘引 · Figure 1完整图形; HTML Sx2.F1
横轴是动作数,橙色最大值选择的偏差随候选数增大,蓝色独立估值接近零。此处误差是独立高斯构造、每柱100次重复,不可把偏差大小直接当成Atari网络的实测误差。
- 每行改变真值函数或拟合容量,左列显示一个动作的拟合,中列对十个动作取最大,右列显示偏差。即使真动作值完全相同,近似误差的最大值仍可系统性抬高估计;蓝色双估计减弱了这一选择偏差。
实验/结果图 · 必要原图摘引 · Figure 2完整图形; HTML Sx2.F2
每行改变真值函数或拟合容量,左列显示一个动作的拟合,中列对十个动作取最大,右列显示偏差。即使真动作值完全相同,近似误差的最大值仍可系统性抬高估计;蓝色双估计减弱了这一选择偏差。
未在正文展示的图/表与范围
- 表1:Table references inventoried separately; figure-only completion priority.
未复核全部逐游戏结果;未重新计算所有汇总分数
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:目标复制频率如何影响估计相关性?;价值更准确为什么未必动作更好?;为何49与57游戏汇总不可直接相减?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:Sx2.F1,2:Sx2.F2,3:Sx4.F3
查看本篇 3 个原文证据入口
- 图1 · Sx2.F1
原站图表/证明入口
- 图2 · Sx2.F2
原站图表/证明入口
- 图3 · Sx4.F3
原站图表/证明入口
本轮边界:未复核全部逐游戏结果;未重新计算所有汇总分数
本次深化
- 解释在线网络选动作、目标网络评分,区别于再加网络或逐动作取min。
- 手算DQN目标9.1与Double DQN目标5.5。
- 核对49游戏评测协议及六训练种子,保留Pong高估未必损害策略的反例。
- v2:为三个原始追问逐题增加参考答案:目标复制频率如何影响估计相关性?;价值更准确为什么未必动作更好?;为何49与57游戏汇总不可直接相减?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:Sx2.F1,2:Sx2.F2,3:Sx4.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补橙蓝图例、百万步横轴、后训练水平参考线、对数估值/原始分数分行阅读。
查核资料
- arxiv.org · 所列章节
目标公式;图3讨论;表1与评估协议
技术关系
- 11-double-q · 直接继承
将选择/评价分离移植为相关网络的实用近似。
- 16-dqn · 直接继承
网络和回放保持不变,改动落在目标。
- 29-rainbow · 模块组合
可与分布价值等部件组合,贡献取决于组合环境。
仍需留意
- 未复核全部逐游戏结果;未重新计算所有汇总分数
强化学习Prioritized Experience Replay部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:经验已经在池中,下一次应该重读哪一条
- 二、用误差分配抽样概率并修正权重
- 三、保存优先级、实际概率与重读后的残差
- 四、在固定回放库中检验重读效率
- 五、辨认大残差、陈旧优先级与未知经验
- 六、继续追问:概率版本、噪声与更新预算
- 七、把抽样频率与目标重标记分别组合
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:经验已经在池中,下一次应该重读哪一条
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、用误差分配抽样概率并修正权重 / 核对两条经验修正后的贡献系数
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、保存优先级、实际概率与重读后的残差
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、辨认大残差、陈旧优先级与未知经验
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、辨认大残差、陈旧优先级与未知经验
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 抽样概率为零为何不能靠权重补救:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“抽样概率为零为何不能靠权重补救”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
重要性校正需要目标经验具有正抽样概率;有限β、优先级陈旧和函数逼近仍会影响更新。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补抽样概率严格相消的推导和N/p含义,明确旧优先级影响效率与概率错配影响偏差的区别。
- 就地补对数尺度、左右实验区别、oracle与淡线范围含义。
与此前问答的对应
仅精确修订正文追问2中将延迟优先级本身列为无偏性破坏因素的说法;题文与其他答案保留,20bb192原文末两题及答案逐字保留。
正文配图:4 幅
- Blind Cliffwalk中均匀和优先回放所需更新数的双对数图
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形
两边都是双对数坐标,纵轴越低表示所需更新越少,曲线垂直差距对应倍数而非固定次数。左图是表格与贪心优先,右图是线性逼近与随机优先,不能把左右红线当成同一个配置。青色oracle利用事后知识作参照,不是可直接部署的探索算法;淡线为多次初始化的极值范围,不是标准误。
- 左侧链必须连续选对才能得到末端奖励,右侧在双对数轴比较均匀回放与知道有用样本的oracle。oracle是一种潜力上界对照,不能当成优先级方法实际已实现的速度。
实验/结果图 · 必要原图摘引 · Figure 1完整图形; HTML S3.F1
左侧链必须连续选对才能得到末端奖励,右侧在双对数轴比较均匀回放与知道有用样本的oracle。oracle是一种潜力上界对照,不能当成优先级方法实际已实现的速度。
- 纵轴是相对Double DQN的归一化分数差,零线以下的游戏仍会退步。红蓝表示两种优先级方案,不能只统计正柱或将两者平均后声称逐游戏一致改善。
实验/结果图 · 必要原图摘引 · Figure 3完整图形; HTML S3.F3
纵轴是相对Double DQN的归一化分数差,零线以下的游戏仍会退步。红蓝表示两种优先级方案,不能只统计正柱或将两者平均后声称逐游戏一致改善。
- 左图汇总训练中达到的最佳成绩,右图汇总平均成绩;100%对应各自Double DQN基线口径。两图到达100%的步数不同,比较提速时先说明采用峰值还是累计表现。
实验/结果图 · 必要原图摘引 · Figure 4完整图形; HTML S4.F4
左图汇总训练中达到的最佳成绩,右图汇总平均成绩;100%对应各自Double DQN基线口径。两图到达100%的步数不同,比较提速时先说明采用峰值还是累计表现。
Atari逐游戏改进幅度与总计算成本未全部复核
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:高噪声转移会否长期霸占训练?;β=1是否在所有实现下完全消除偏差?;额外采样维护时间怎样计入效率?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S3.F2,3:S3.F3,4:S4.F4
查看本篇 4 个原文证据入口
- 图1 · S3.F1
原站图表/证明入口
- 图2 · S3.F2
原站图表/证明入口
- 图3 · S3.F3
原站图表/证明入口
- 图4 · S4.F4
原站图表/证明入口
本轮边界:Atari逐游戏改进幅度与总计算成本未全部复核
本次深化
- 区分回放重读与首次探索,推导优先抽样的重要性权重及归一化影响。
- 用两样本概率0.25/0.75手算β=1修正与最大权重缩放。
- 核读Cliffwalk十次初始化的中位数和极差,不误称置信区间。
- v2:为三个原始追问逐题增加参考答案:高噪声转移会否长期霸占训练?;β=1是否在所有实现下完全消除偏差?;额外采样维护时间怎样计入效率?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S3.F2,3:S3.F3,4:S4.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补抽样概率严格相消的推导和N/p含义,明确旧优先级影响效率与概率错配影响偏差的区别。
- 第三版:就地补对数尺度、左右实验区别、oracle与淡线范围含义。
查核资料
- arxiv.org · 所列章节
§3.1—3.4;图1—2;附录B.1
技术关系
- 16-dqn · 模块组合
替换均匀回放抽样器,可保留同样的价值目标。
- 26-her · 模块组合
HER改目标标签,PER改抽样频率,两个维度可组合。
- 29-rainbow · 模块组合
分布损失可用于组合系统的优先级,不能机械照搬标量TD误差。
仍需留意
- Atari逐游戏改进幅度与总计算成本未全部复核
强化学习Dueling Network Architectures for Deep Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:动作差别很小时,怎样共享同一处境的价值信息
- 二、减去动作均值以固定V与A的分解
- 三、用同一个TD目标联合训练两个流
- 四、在冗余动作走廊中检验表示收益
- 五、共享前景不能替代探索与目标去偏
- 六、将表示改动与目标及抽样模块组合
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:动作差别很小时,怎样共享同一处境的价值信息
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、减去动作均值以固定V与A的分解 / 检查给全部优势加常数为何输出不变
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、用同一个TD目标联合训练两个流
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、共享前景不能替代探索与目标去偏
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、共享前景不能替代探索与目标去偏
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 均值中心化使哪个量可以被识别:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“均值中心化使哪个量可以被识别”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
动作均值等于V由均值中心化聚合结构给出;不把它解释为任意非均匀行为策略的价值。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 核对式10后加入归一化定义与左右方向,并就地说明参数匹配需读Single Clip对照。
正文配图:5 幅
- Dueling网络相对单流Double DQN的逐Atari游戏分数改变量
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形
每行是一个游戏,条形从零向右/左分别表示相对Single基线改善/退步;横轴百分数不是直接用分差除以基线分数。[原文式(10)](https://arxiv.org/html/1511.06581v3#S4)采用 $$100\%\times\frac{S_{\mathrm{agent}}-S_{\mathrm{base}}}{\max(S_{\mathrm{human}},S_{\mathrm{base}})-S_{\mathrm{random}}}.$$ 分母同时使用人类、基线与随机成绩,目的是避免很差的基线让小分差显成巨大比例。图4用Single作参照;隔离参数量与梯度裁剪还需正文的Single Clip对照,因此不能把所有条形净差都归为双流结构本身。
- 上方单流网络直接输出各动作Q,下方分出状态价值与动作优势后再合成Q。分支不是两个独立控制器,合成中的中心化约束才使价值与优势的分工可解释。
方法/设定图 · 必要原图摘引 · Figure 1完整图形; HTML S1.F1
上方单流网络直接输出各动作Q,下方分出状态价值与动作优势后再合成Q。分支不是两个独立控制器,合成中的中心化约束才使价值与优势的分工可解释。
- 每一行左列是Value、右列是Advantage的显著性图。注意价值分支关注前方道路,而优势分支在接近车辆时更突出;这是两个局面的解释性可视化,不能单独证明所有状态的因果机制。
实验/结果图 · 必要原图摘引 · Figure 2完整图形; HTML S1.F2
每一行左列是Value、右列是Advantage的显著性图。注意价值分支关注前方道路,而优势分支在接近车辆时更突出;这是两个局面的解释性可视化,不能单独证明所有状态的因果机制。
- a给出走廊任务,b到d把动作数由5增至10和20;纵轴SE与横轴迭代都取对数。绿色Duel在动作冗余增多时更早降低误差,是受控策略评价实验,不是更多动作带来更多奖励。
实验/结果图 · 必要原图摘引 · Figure 3完整图形; HTML S4.F3
a给出走廊任务,b到d把动作数由5增至10和20;纵轴SE与横轴迭代都取对数。绿色Duel在动作冗余增多时更早降低误差,是受控策略评价实验,不是更多动作带来更多奖励。
- 这里的比较基线已换成带优先回放的DDQN。零线左右同时存在改善和退步,Kangaroo等负向项目提醒两种改进叠加并不保证每个游戏都获益。
实验/结果图 · 必要原图摘引 · Figure 5完整图形; HTML S4.F5
这里的比较基线已换成带优先回放的DDQN。零线左右同时存在改善和退步,Kangaroo等负向项目提醒两种改进叠加并不保证每个游戏都获益。
未逐项复核57游戏全部训练对照
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:这里的V为什么不一定等于Vπ?;网络参数量变化会否解释部分提升?;双流结构和Double DQN能否组合,为什么?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S1.F1,2:S1.F2,3:S4.F3,4:S4.F4,5:S4.F5
查看本篇 5 个原文证据入口
- 图1 · S1.F1
原站图表/证明入口
- 图2 · S1.F2
原站图表/证明入口
- 图3 · S4.F3
原站图表/证明入口
- 图4 · S4.F4
原站图表/证明入口
- 图5 · S4.F5
原站图表/证明入口
本轮边界:未逐项复核57游戏全部训练对照
本次深化
- 解释价值/优势双流的不可辨识性与均值归零聚合,避免误称Actor–Critic。
- 手算优势整体平移不改变Q,说明共享梯度而非两套独立标签。
- 核读固定策略走廊评价,区分冗余动作表示实验和显著图解释。
- v2:为三个原始追问逐题增加参考答案:这里的V为什么不一定等于Vπ?;网络参数量变化会否解释部分提升?;双流结构和Double DQN能否组合,为什么?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S1.F1,2:S1.F2,3:S4.F3,4:S4.F4,5:S4.F5
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:核对式10后加入归一化定义与左右方向,并就地说明参数匹配需读Single Clip对照。
查核资料
- arxiv.org · 所列章节
聚合式(9)、§4.1走廊实验、图3
技术关系
- 16-dqn · 模块组合
输出接口仍为各动作Q,训练目标可保持相同。
- 18-double-dqn · 模块组合
结构变化和目标选择分离能同时使用。
仍需留意
- 未逐项复核57游戏全部训练对照
强化学习Mastering the game of Go with deep neural networks and tree search部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:策略会落子之后,搜索还需要学会什么
- 二、把候选先验、叶子评价与回传分工
- 三、分别训练组件并在每次模拟中更新统计
- 四、从组件误差读到完整系统对局
- 五、分清训练数据、搜索资源与版本边界
- 六、继续追问:搜索先验、价值数据与算力
- 七、从已知规则搜索走向学到的动力学
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:策略会落子之后,搜索还需要学会什么
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、把候选先验、叶子评价与回传分工 / 检验低先验分支怎样凭评价获选
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、分别训练组件并在每次模拟中更新统计
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分清训练数据、搜索资源与版本边界
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分清训练数据、搜索资源与版本边界
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 累计回传值需要统一胜负视角:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“累计回传值需要统一胜负视角”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
胜负视角校验针对交替行动的搜索回传;价值与rollout混合仍须遵循所用AlphaGo版本。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补原版叶子混合式、各项作用与回传/执棋方视角,连接先验和价值分工。
- 就地解释a/b/c阅读顺序、圆点语义与时间控制边界。
正文配图:5 幅
- AlphaGo的对战Elo、搜索组件消融和硬件搜索规模对比
实验/结果图 · 必要原图摘引 · Figure 4, PDF第4页;仅图形区域
三个面板纵轴都是Elo评分,越高表示在相应对战评估中棋力更强,并非直接胜率。a面板比较程序与人类参照;b面板下方黑/灰圆点标记是否使用rollout、价值网络和策略网络,要按同一列的组件组合读;c面板横轴列出搜索线程与GPU配置,不是训练步数。a/b与c还使用不同每步思考时间,因此不能只按柱高跨面板做等预算因果比较。
- 左侧把人类棋谱监督训练、策略梯度自我对弈和价值回归分开;右侧区分输出落子分布的策略网络与输出胜负估计的价值网络。自我对弈数据和人类棋谱并不是同一训练目标。
方法/设定图 · 必要原图摘引 · Figure 1, PDF第2页
左侧把人类棋谱监督训练、策略梯度自我对弈和价值回归分开;右侧区分输出落子分布的策略网络与输出胜负估计的价值网络。自我对弈数据和人类棋谱并不是同一训练目标。
- a图将棋谱预测准确率与对抗胜率分开,准确率接近的网络也可能有不同棋力;b图比较不同局面步数上的价值均方误差。不能由单个监督准确率替代整套搜索的对局强度。
实验/结果图 · 必要原图摘引 · Figure 2, PDF第2页
a图将棋谱预测准确率与对抗胜率分开,准确率接近的网络也可能有不同棋力;b图比较不同局面步数上的价值均方误差。不能由单个监督准确率替代整套搜索的对局强度。
- 按a到d读一次搜索:选择、扩展、结合价值网络与rollout进行评价,再把结果沿路径回传。图中的Q和先验P在树内承担不同角色,价值网络本身不等于完整搜索。
方法/设定图 · 必要原图摘引 · Figure 3, PDF第3页
按a到d读一次搜索:选择、扩展、结合价值网络与rollout进行评价,再把结果沿路径回传。图中的Q和先验P在树内承担不同角色,价值网络本身不等于完整搜索。
- 六个面板对同一棋盘分别展示价值、树内评价、rollout、先验、访问比例与主变化。红圈选点在这些视角下并非总是局部最高,这正是搜索整合证据而非只照策略网络落子的例子。
实验/结果图 · 必要原图摘引 · Figure 5, PDF第4页
六个面板对同一棋盘分别展示价值、树内评价、rollout、先验、访问比例与主变化。红圈选点在这些视角下并非总是局部最高,这正是搜索整合证据而非只照策略网络落子的例子。
未逐项复核比赛资源配置与全部扩展表
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:已知棋规给搜索提供了什么额外优势?;如何分别计量策略网络和搜索的收益?;AlphaGo与AlphaGo Zero的数据条件为何不同?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:PDF page 2,2:PDF page 2,3:PDF page 3,4:PDF page 4,5:PDF page 4
查看本篇 5 个原文证据入口
- 图1 · PDF page 2
原站图表/证明入口
- 图2 · PDF page 2
原站图表/证明入口
- 图3 · PDF page 3
原站图表/证明入口
- 图4 · PDF page 4
原站图表/证明入口
- 图5 · PDF page 4
原站图表/证明入口
本轮边界:未逐项复核比赛资源配置与全部扩展表
本次深化
- 拆解监督策略、强化策略、价值网络与MCTS的数据和计算分工。
- 用搜索计数与先验手算低先验动作也可胜出,标明探索项为教学简化。
- 区分两类3000万位置数据、组件评测和樊麾比赛,不混入李世石结果。
- v2:为三个原始追问逐题增加参考答案:已知棋规给搜索提供了什么额外优势?;如何分别计量策略网络和搜索的收益?;AlphaGo与AlphaGo Zero的数据条件为何不同?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:PDF page 2,2:PDF page 2,3:PDF page 3,4:PDF page 4,5:PDF page 4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补原版叶子混合式、各项作用与回传/执棋方视角,连接先验和价值分工。
- 第三版:就地解释a/b/c阅读顺序、圆点语义与时间控制边界。
查核资料
- storage.googleapis.com · 所列章节
多阶段训练、价值网络数据构造、MCTS正文及Methods
技术关系
- 05-reinforce · 模块组合
RL策略通过胜负加权对数概率更新。
- 41-muzero · 历史背景
延续学习策略/价值与搜索的分工,但后者在学到的潜在动力学中规划。
仍需留意
- 未逐项复核比赛资源配置与全部扩展表
强化学习Asynchronous Methods for Deep Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:并行采样提高吞吐后,旧梯度还对应哪个策略
- 二、由多步回报同时驱动策略与评价
- 三、在各worker采片段并异步提交梯度
- 四、分别读墙钟、调参预算与固定参数成绩
- 五、异步吞吐不能消除参数滞后
- 六、继续追问:终止、worker数量与同步
- 七、沿采样学习分离继续处理离策略误差
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:并行采样提高吞吐后,旧梯度还对应哪个策略
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、由多步回报同时驱动策略与评价 / 算清片段结束与真正终止的区别
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、在各worker采片段并异步提交梯度
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、异步吞吐不能消除参数滞后
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、异步吞吐不能消除参数滞后
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 片段采样的两种时间边界:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“片段采样的两种时间边界”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
实际片段长度与异步梯度滞后是两种时间边界;终止和截断仍须按任务分别处理。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补小时/游戏分数坐标、关键颜色与多步/Actor-Critic接口差异。
正文配图:3 幅
- A3C等异步算法与DQN在五项Atari游戏中的墙钟时间学习曲线
实验/结果图 · 必要原图摘引 · Figure 1;原HTML图形
图中横轴单位是小时,纵轴是各游戏分数,越高越好;每个面板纵轴范围不同。黄线A3C与粉线n-step Q比较时,不只是worker数量,还改变了策略/价值更新;绿线一步Q与橙线一步SARSA又在目标策略上不同。因此这张图同时呈现系统和算法组合效果,CPU上的曲线更快不能直接换算成更少环境样本。
- 三排分别是单步Q、n步Q与A3C,五列是同一组游戏。横轴epoch按所有线程合计400万帧计,因而比较的是数据效率;各曲线是三个最佳学习率的平均,不能当成无调参的随机种子平均。
实验/结果图 · 必要原图摘引 · Figure 3完整图形; HTML S5.F3
三排分别是单步Q、n步Q与A3C,五列是同一组游戏。横轴epoch按所有线程合计400万帧计,因而比较的是数据效率;各曲线是三个最佳学习率的平均,不能当成无调参的随机种子平均。
- 面板任务与方法顺序沿用上一图,但横轴换成训练小时。更多actor-learner通常更快达到相同分数,幅度却不等于同比例节省环境数据,读者应把它与帧数轴那一图分开。
实验/结果图 · 必要原图摘引 · Figure 4完整图形; HTML S5.F4
面板任务与方法顺序沿用上一图,但横轴换成训练小时。更多actor-learner通常更快达到相同分数,幅度却不等于同比例节省环境数据,读者应把它与帧数轴那一图分开。
未在正文展示的图/表与范围
- 表1:Table references inventoried separately; figure-only completion priority.
未复现实验;不把不同硬件速度折算为统一算力
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:加倍worker后真实交互量和时间怎样变化?;最佳超参数曲线应怎样公平比较?;异步和同步A2C有哪些统计与系统差异?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S5.F1,3:S5.F3,4:S5.F4
查看本篇 3 个原文证据入口
- 图1 · S5.F1
原站图表/证明入口
- 图3 · S5.F3
原站图表/证明入口
- 图4 · S5.F4
原站图表/证明入口
本轮边界:未复现实验;不把不同硬件速度折算为统一算力
本次深化
- 展开异步worker的多步目标与共享更新,说明吞吐伴随参数滞后。
- 手算非终止目标5.23与终止目标2.8,分清bootstrap边界。
- 核对CPU/GPU及最佳学习率组与固定超参种子的不同评测口径。
- v2:为三个原始追问逐题增加参考答案:加倍worker后真实交互量和时间怎样变化?;最佳超参数曲线应怎样公平比较?;异步和同步A2C有哪些统计与系统差异?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S5.F1,3:S5.F3,4:S5.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补小时/游戏分数坐标、关键颜色与多步/Actor-Critic接口差异。
查核资料
- arxiv.org · 所列章节
§4异步框架;§5.1图1与表1;补充优化设置
技术关系
- 01-actor-critic · 教学联系
延续行为与评价分工,更新规则与表示并不相同。
- 32-impala · 直接继承
进一步分离actor与learner,并显式校正由滞后引起的分布差异。
仍需留意
- 未复现实验;不把不同硬件速度折算为统一算力
强化学习Generative Adversarial Imitation Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:模仿逐步动作之外,怎样匹配长期到达的状态
- 二、从占用分布密度比构造对抗模仿目标
- 三、固定判别器标签约定并交替采样训练
- 四、同时计算专家示范与环境交互预算
- 五、判别准确率不能代表模仿成功
- 六、继续比较引导样本和占用匹配
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:模仿逐步动作之外,怎样匹配长期到达的状态
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、从占用分布密度比构造对抗模仿目标 / 验算两类占用为何产生不同奖励
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、固定判别器标签约定并交替采样训练
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、判别准确率不能代表模仿成功
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、判别准确率不能代表模仿成功
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 判别器接近二分之一只是一项条件现象:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“判别器接近二分之一只是一项条件现象”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
最优判别器的1/2结论要求两类占用质量与容量条件;有限判别器分不出来并非占用匹配证明。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补逐状态动作求导、D最优比值及相同采样权重/零覆盖边界,链接原文§5。
- 补现有a面板的坐标/图例与裁切范围,避免把未内嵌b当本图证据。
正文配图:2 幅
- GAIL在八项控制任务中随专家示范量变化的归一化模仿表现
实验/结果图 · 必要原图摘引 · Figure 1,仅(a)主结果面板;原HTML图形
横轴增加的是专家轨迹条数,纵轴是按随机策略0、专家1缩放的任务表现,较高较好;超过1只表示在这套评估中超过专家基准。星标蓝线是GAIL,方形橙线是行为克隆,专家/随机用虚线。各面板的示范预算范围不同,Humanoid与简单控制不能按相同横坐标位置直接比较;这张(a)图也没有展示正文提到的(b)熵正则消融。
- 补齐的(b)仅改变Reacher上的因果熵正则系数,横轴仍是专家轨迹数。少量示范时不同正则强度差距大,轨迹增加后都接近专家水平;行为克隆在这个任务的少数据区间表现很强,不能从(a)的总体印象抹掉这一例外。
实验/结果图 · 必要原图摘引 · Figure 1 (b); existing (a) retained; HTML S6.F1
补齐的(b)仅改变Reacher上的因果熵正则系数,横轴仍是专家轨迹数。少量示范时不同正则强度差距大,轨迹增加后都接近专家水平;行为克隆在这个任务的少数据区间表现很强,不能从(a)的总体印象抹掉这一例外。
未复核全部任务精确分数与显著性检验
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:判别器无法区分是否一定代表策略学对?;专家有多种风格时该匹配什么?;如何把在线采样成本纳入与行为克隆的比较?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S6.F1
查看本篇 1 个原文证据入口
- 图1 · S6.F1
原站图表/证明入口
本轮边界:未复核全部任务精确分数与显著性检验
本次深化
- 由占用分布匹配解释判别器奖励,明确判别标签方向和策略优化模块。
- 手算专家/策略占用不同产生的奖励,说明D=0.5可表示匹配成功。
- 区分专家样本和环境交互效率,保留Reacher行为克隆更省示范的结果。
- v2:为三个原始追问逐题增加参考答案:判别器无法区分是否一定代表策略学对?;专家有多种风格时该匹配什么?;如何把在线采样成本纳入与行为克隆的比较?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S6.F1
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补逐状态动作求导、D最优比值及相同采样权重/零覆盖边界,链接原文§5。
- 第三版:补现有a面板的坐标/图例与裁切范围,避免把未内嵌b当本图证据。
查核资料
- arxiv.org · 所列章节
占用分布推导;Algorithm 1;§6图1与§7局限
技术关系
仍需留意
- 未复核全部任务精确分数与显著性检验
强化学习Curiosity-driven Exploration by Self-supervised Prediction部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有任务奖励时,哪些预测错误值得拿来探索
- 二、用逆任务选择表示,再用前向误差给奖励
- 三、分别更新预测器与接受内在奖励的策略
- 四、读白噪声干扰和无外在奖励的设置
- 五、新奇性代理仍可能被不可控变化利用
- 六、换一种预测目标继续检验探索奖励
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:没有任务奖励时,哪些预测错误值得拿来探索
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、用逆任务选择表示,再用前向误差给奖励 / 检查误差学会后奖励如何从0.1降到0.001
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、分别更新预测器与接受内在奖励的策略
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、新奇性代理仍可能被不可控变化利用
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、新奇性代理仍可能被不可控变化利用
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 平方误差对特征尺度并不不变:沿探索综述先定位特征空间预测误差,再自构c²尺度检查,说明固定η不等于固定内在奖励强度。
教法来源与实际阅读范围
- Lilian Weng · Exploration Strategies in Deep Reinforcement Learning
预测误差;IDF/RF;noisy TV;RND非回合和归一化
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“平方误差对特征尺度并不不变”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
c²缩放推演同时缩放特征和预测,其他条件冻结;不把预测误差大当作可控新奇或真实探索收益。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 展开前向输入、离散逆模型交叉熵、误差损失与奖励比例,区分策略和预测器的优化方向。
- 补百万训练步、外在奖励、颜色与标准误说明,将探索机制与任务结果分开。
正文配图:3 幅
- ICM在密集、稀疏和极稀疏奖励三个条件下与像素好奇心及A3C比较
实验/结果图 · 必要原图摘引 · Figure 5;原HTML图形;从左至右为密集、稀疏、极稀疏奖励
三栏横轴都是百万训练步,纵轴是每回合外在奖励,越高越好,不是训练使用的好奇心误差。橙色ICM+A3C、绿色像素预测好奇心和蓝色A3C在同一奖励稀疏度下比较;右栏能检验外在反馈极稀少时,特征预测是否仍有助于找到目标。阴影为三次独立运行均值的标准误,不能将橙色高内在奖励本身当作本图的成功指标。
- 左侧说明内外奖励共同训练策略;右侧把逆模型学习的特征与前向预测分开。奖励取特征预测误差,逆模型本身的动作分类误差不是直接加给策略的好奇心奖励。
方法/设定图 · 必要原图摘引 · Figure 2完整图形; HTML S1.F2
左侧说明内外奖励共同训练策略;右侧把逆模型学习的特征与前向预测分开。奖励取特征预测误差,逆模型本身的动作分类误差不是直接加给策略的好奇心奖励。
- 此实验把40%的视觉观测替换成白噪声,橙线在所测任务中优于直接预测像素的绿线。纵轴是外在回报,说明任务完成能力的差异;不能把这一次噪声干扰实验扩成所有不可控变化下的鲁棒保证。
实验/结果图 · 必要原图摘引 · Figure 6完整图形; HTML S4.F6
此实验把40%的视觉观测替换成白噪声,橙线在所测任务中优于直接预测像素的绿线。纵轴是外在回报,说明任务完成能力的差异;不能把这一次噪声干扰实验扩成所有不可控变化下的鲁棒保证。
未复核所有随机运行统计;不声称解决全部不可控噪声
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:如何分开模型未知与环境随机性?;探索更远是否等于任务更好?;更强前向模型会让内在奖励如何变化?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S1.F2,5:S3.F5,6:S4.F6
查看本篇 3 个原文证据入口
- 图2 · S1.F2
原站图表/证明入口
- 图5 · S3.F5
原站图表/证明入口
- 图6 · S4.F6
原站图表/证明入口
本轮边界:未复核所有随机运行统计;不声称解决全部不可控噪声
本次深化
- 拆解逆模型表示与前向误差奖励,限定过滤不可控噪声的能力。
- 手算预测误差奖励从0.1降到0.001及不可约噪声反例。
- 核读40%白噪声区域实验,分开Mario纯内在奖励与VizDoom设置。
- v2:为三个原始追问逐题增加参考答案:如何分开模型未知与环境随机性?;探索更远是否等于任务更好?;更强前向模型会让内在奖励如何变化?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S1.F2,5:S3.F5,6:S4.F6
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:展开前向输入、离散逆模型交叉熵、误差损失与奖励比例,区分策略和预测器的优化方向。
- 第三版:补百万训练步、外在奖励、颜色与标准误说明,将探索机制与任务结果分开。
查核资料
- arxiv.org · 所列章节
ICM前向/逆向机制;§4.1图6;Mario设置
技术关系
仍需留意
- 未复核所有随机运行统计;不声称解决全部不可控噪声
强化学习Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:队友策略变化以后,本地相同动作为何有不同后果
- 二、让集中Critic解释联合动作条件
- 三、只沿当前Actor自己的动作反传
- 四、把集中评价与策略ensemble的消融分开
- 五、联合条件不能完全消除非平稳性
- 六、继续追问:信息权限、人数与旧回放
- 七、比较连续Actor与单调价值分解
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:队友策略变化以后,本地相同动作为何有不同后果
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、让集中Critic解释联合动作条件 / 用共同推箱区分缺信息与动作微调
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、只沿当前Actor自己的动作反传
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、联合条件不能完全消除非平稳性
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、联合条件不能完全消除非平稳性
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 集中Critic不是一个公共奖励函数:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“集中Critic不是一个公共奖励函数”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
集中Critic集中条件信息而非各Agent效用;竞争环境中不存在默认共享的团队目标。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 依据式5与Algorithm1补自身当前Actor动作、其他样本动作及固定条件解释。
正文配图:3 幅
- MADDPG与DDPG以及集成与单策略的竞争任务归一化得分
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
[图1](https://arxiv.org/html/1706.02275#S4.F1)明确训练Critic可看集中信息,部署Actor只用自身输入;[图2](https://arxiv.org/html/1706.02275#S5.F2)的任务图说明合作、竞争和混合场景不同。[图3](https://arxiv.org/html/1706.02275#S5.F3)的每一组柱对应agent与adversary的特定配对,纵轴按0–1归一化,需先看谁对谁以及谁的分数,不能把竞争任务的收益合成全体改善。集中Critic和策略ensemble的作用也应分别读,联合动作输入带来的规模成本仍在。 [查看原文](https://arxiv.org/html/1706.02275)。
- 绿色训练范围让每个critic读取其他智能体的信息,橙色执行范围仍由各自观测驱动策略。集中的是训练信息,执行时不应偷偷继续读取训练才有的全局动作和观测。
方法/设定图 · 必要原图摘引 · Figure 1完整图形; HTML S4.F1
绿色训练范围让每个critic读取其他智能体的信息,橙色执行范围仍由各自观测驱动策略。集中的是训练信息,执行时不应偷偷继续读取训练才有的全局动作和观测。
- 四个面板依次是协作通信、捕食者与猎物、协作导航和物理欺骗。它们的合作与竞争关系不同,后面的奖励曲线必须与具体任务匹配,不能把所有多智能体实验都称为共同团队回报。
方法/设定图 · 必要原图摘引 · Figure 2完整图形; HTML S5.F2
四个面板依次是协作通信、捕食者与猎物、协作导航和物理欺骗。它们的合作与竞争关系不同,后面的奖励曲线必须与具体任务匹配,不能把所有多智能体实验都称为共同团队回报。
未逐项复核全部任务超参数与运行次数
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:集中Critic使用的全局信息部署时真的不需要吗?;新对手策略会造成怎样的分布偏移?;如何评价竞争任务中谁受益?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S4.F1,2:S5.F2,3:S5.F3
查看本篇 3 个原文证据入口
- 图1 · S4.F1
原站图表/证明入口
- 图2 · S5.F2
原站图表/证明入口
- 图3 · S5.F3
原站图表/证明入口
本轮边界:未逐项复核全部任务超参数与运行次数
本次深化
- 解释集中Critic如何条件化其他智能体动作,保持执行时局部信息边界。
- 用双智能体推箱Q手算Actor梯度,展示遗漏队友动作的混淆。
- 分开图3算法与ensemble对照,限定粒子环境、人数及通信权限。
- v2:为三个原始追问逐题增加参考答案:集中Critic使用的全局信息部署时真的不需要吗?;新对手策略会造成怎样的分布偏移?;如何评价竞争任务中谁受益?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S4.F1,2:S5.F2,3:S5.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:依据式5与Algorithm1补自身当前Actor动作、其他样本动作及固定条件解释。
查核资料
- arxiv.org · 所列章节
集中Critic梯度;策略ensemble;§5图3及§5.4
技术关系
仍需留意
- 未逐项复核全部任务超参数与运行次数
强化学习Hindsight Experience Replay部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没到原目标的轨迹,能否支持另一个真实训练问题
- 二、保持物理转移并一致重标目标相关量
- 三、从回合未来状态选目标并重算TD标签
- 四、一起读成功率、重标数量与真实试验规模
- 五、重标成功不能替代原任务覆盖
- 六、把重标语义与回放频率分别设计
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:没到原目标的轨迹,能否支持另一个真实训练问题
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、保持物理转移并一致重标目标相关量 / 检验只改目标却保留旧奖励的矛盾
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、从回合未来状态选目标并重算TD标签
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、重标成功不能替代原任务覆盖
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、重标成功不能替代原任务覆盖
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 重标改变条件任务而不改变转移事实:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“重标改变条件任务而不改变转移事实”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
重标要求目标改变不破坏转移与奖励重算条件;多个重标目标不是新增独立环境试验。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补目标条件DDPG的完整重标目标与损失,逐项说明g/r/d一致性。
- 补epoch到回合/步数口径、预指定目标成功率与四条线身份。
正文配图:4 幅
- HER多目标任务在pushing、sliding和pick-and-place中的成功率学习曲线
实验/结果图 · 必要原图摘引 · Figure 3, PDF第7页;仅图形区域
横轴为训练epoch,图注明确每个epoch对应800个、各50步的回合;纵轴是预先指定目标的成功率,越高越好。蓝线是DDPG+HER,红线是§4.5中改进重标设置的版本,绿线是计数探索对照,虚线为DDPG。红蓝差异属于HER内部采样配置,不能全算成“有HER对无HER”的收益;也不能用训练重标后天然成功的比例代替这个测试成功率。
- 三列仍是推、滑和抓放,但每个任务只有一个关心的目标。蓝色HER与绿色计数探索、红色DDPG在相同epoch轴上比较;滑动任务并未因此接近完全成功。
实验/结果图 · 必要原图摘引 · Figure 4, PDF第8页
三列仍是推、滑和抓放,但每个任务只有一个关心的目标。蓝色HER与绿色计数探索、红色DDPG在相同epoch轴上比较;滑动任务并未因此接近完全成功。
- 上排是训练中最高成功率,下排是整个训练期平均成功率;横轴是每条转移附加的目标数。future在不少设置更好,但k增大并非严格单调改善,不能只看峰值行。
实验/结果图 · 必要原图摘引 · Figure 6, PDF第9页
上排是训练中最高成功率,下排是整个训练期平均成功率;横轴是每条转移附加的目标数。future在不少设置更好,但k增大并非严格单调改善,不能只看峰值行。
- 四帧显示策略在真实机械臂上的抓放过程,是部署演示而非成功率曲线;它本身没有提供重复试验次数、置信区间或跨物体泛化证据。
实验/结果图 · 必要原图摘引 · Figure 7, PDF第10页
四帧显示策略在真实机械臂上的抓放过程,是部署演示而非成功率曲线;它本身没有提供重复试验次数、置信区间或跨物体泛化证据。
随机环境重标偏差未由原文实验充分覆盖;未复现
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:目标改变会改变终止或动力学时怎么办?;为什么随机环境中的重标会带来选择偏差?;原目标成功率与重标成功率为何必须分开?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:3:PDF page 7,4:PDF page 8,6:PDF page 9,7:PDF page 10
- 核正HER多目标§4.2图3与单目标§4.3图4的对应,保留最高/平均评估口径
查看本篇 4 个原文证据入口
- 图3 · PDF page 7
原站图表/证明入口
- 图4 · PDF page 8
原站图表/证明入口
- 图6 · PDF page 9
原站图表/证明入口
- 图7 · PDF page 10
原站图表/证明入口
本轮边界:随机环境重标偏差未由原文实验充分覆盖;未复现
本次深化
- 说明目标重标记依赖转移不随目标改变,并要求重新计算奖励。
- 用位置2→3手算原目标失败与新目标成功,避免标签自相矛盾。
- 核实五种子及标准差、目标数量消融和真机5/5的小样本边界。
- v2:为三个原始追问逐题增加参考答案:目标改变会改变终止或动力学时怎么办?;为什么随机环境中的重标会带来选择偏差?;原目标成功率与重标成功率为何必须分开?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:3:PDF page 7,4:PDF page 8,6:PDF page 9,7:PDF page 10
- v2:核正HER章节定位:多目标图3属于§4.2,§4.3为单目标图4;原sources.supports保留历史记录
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补目标条件DDPG的完整重标目标与损失,逐项说明g/r/d一致性。
- 第三版:补epoch到回合/步数口径、预指定目标成功率与四条线身份。
查核资料
- arxiv.org · 所列章节
Algorithm 1;§4.3图3;§4.5图6;§4.6真机试验
技术关系
仍需留意
- 随机环境重标偏差未由原文实验充分覆盖;未复现
强化学习Proximal Policy Optimization Algorithms部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不解信赖域子问题,怎样抑制旧数据上的过度更新
- 二、按优势正负展开裁剪替代目标
- 三、固定旧概率与优势再做多轮小批量更新
- 四、读目标对照与不同控制预算
- 五、裁剪单样本收益没有形成全局硬约束
- 六、继续追问:共享参数、KL与优势噪声
- 七、从固定优势走向语言模型的组内基线
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:不解信赖域子问题,怎样抑制旧数据上的过度更新
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、按优势正负展开裁剪替代目标 / 分别验算好方向截平与坏方向惩罚
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、固定旧概率与优势再做多轮小批量更新
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、裁剪单样本收益没有形成全局硬约束
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、裁剪单样本收益没有形成全局硬约束
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
- 最后逐段抽读时合并语义重复;本篇逐条实际删合见deduplication.merged_examples;内容保留于方法的定义与推导、图旁独有统计、对应边界。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 换成log概率坐标,看哪一项真的停止推动:借Spinning Up和Lilian按优势正负读目标的顺序,独立推出log概率分段导数,纠正clip等于硬ratio区间的简写。
教法来源与实际阅读范围
- OpenAI Spinning Up · Proximal Policy Optimization
正负优势分段;clip激励;KL early stopping;伪代码
- Lilian Weng · Policy Gradient Algorithms
策略梯度递归证明;Actor-Critic、off-policy、DPG、MADDPG、TRPO/PPO
原论文校准:对原论文式(7)直接求log概率导数,并与本次实际阅读的Spinning Up PPO及Lilian正负优势讲法交叉核对;未新增实验成绩。 · 原文
分段导数固定旧概率和优势且避开折点;clip不约束全部概率比或KL,教程中的硬区间简写未被采用。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补环境步/回报、负分方向、方法颜色及同任务早期/后期阅读顺序。
正文配图:3 幅
- PPO及多种策略优化方法在七项MuJoCo任务上一百万步的学习曲线
实验/结果图 · 必要原图摘引 · Figure 3, PDF第7页;仅图形区域
七个任务面板横轴都到一百万环境时间步,纵轴是该任务回报,越高越好;Reacher的负分也按“较不负更好”读。紫线是PPO-Clip,青线是TRPO,其他颜色对应不同基线。比较应先看同任务的早期速度与后期表现:例如有的任务很快饱和,有的仍有明显波动,不能因PPO在若干面板较高就推成每个任务始终领先。
- 优势为正时,过度增大动作概率后目标变平;优势为负时,过度减小概率后目标变平。两侧仍保留不利方向的惩罚,所以裁剪目标并不是把概率比硬限制在区间内。
方法/设定图 · 必要原图摘引 · Figure 1, PDF第3页
优势为正时,过度增大动作概率后目标变平;优势为负时,过度减小概率后目标变平。两侧仍保留不利方向的惩罚,所以裁剪目标并不是把概率比硬限制在区间内。
- 横轴沿一次实际策略更新的方向线性插值,1对应这次更新后的参数。红色裁剪目标在附近转折而KL仍继续增加,说明这是局部优化形状的示例,不能读作全局KL约束。
实验/结果图 · 必要原图摘引 · Figure 2, PDF第4页
横轴沿一次实际策略更新的方向线性插值,1对应这次更新后的参数。红色裁剪目标在附近转折而KL仍继续增加,说明这是局部优化形状的示例,不能读作全局KL约束。
未在正文展示的图/表与范围
- 表1:Table references inventoried separately; figure-only completion priority.
未重现全部基线调参;Atari全部方差与种子细节未逐项核对
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:为何 ratio 超出区间后仍可能有梯度?;多轮更新时如何检测策略漂移?;为什么换终止处理可比换优化器影响更大?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:PDF page 3,2:PDF page 4,3:PDF page 7
查看本篇 3 个原文证据入口
- 图1 · PDF page 3
原站图表/证明入口
- 图2 · PDF page 4
原站图表/证明入口
- 图3 · PDF page 7
原站图表/证明入口
本轮边界:未重现全部基线调参;Atari全部方差与种子细节未逐项核对
本次深化
- 解释clip目标的优势符号分支,明确平坦代理不等于硬概率比或KL限制。
- 手算正负优势及反方向更新,展示比率1.4并未被禁止。
- 核读7环境×3种子目标对照,区分独立价值网络、熵设置与Humanoid预算。
- v2:为三个原始追问逐题增加参考答案:为何 ratio 超出区间后仍可能有梯度?;多轮更新时如何检测策略漂移?;为什么换终止处理可比换优化器影响更大?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:PDF page 3,2:PDF page 4,3:PDF page 7
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补环境步/回报、负分方向、方法颜色及同任务早期/后期阅读顺序。
查核资料
- arxiv.org · 所列章节
§2—4目标;§6.1表1;§6.2图3;§6.3预算
技术关系
- 14-trpo · 直接继承
共享概率比替代目标与保守更新动机,但不继承完整信赖域保证。
- 15-gae · 模块组合
优势估计与更新约束分工独立。
- 52-grpo · 直接继承
语言模型场景重用裁剪比值思想并改变优势基线来源。
仍需留意
- 未重现全部基线调参;Atari全部方差与种子细节未逐项核对
强化学习A Distributional Perspective on Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:相同平均回报背后的不同结果,怎样进入价值学习
- 二、对整个回报分布做Bellman变换与投影
- 三、搬移原子并守住概率质量
- 四、读支持点数量、评估选择与训练速度
- 五、分布预测不等于风险偏好或控制收缩保证
- 六、把分布目标接到多步与优先回放
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:相同平均回报背后的不同结果,怎样进入价值学习
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、对整个回报分布做Bellman变换与投影 / 检查三点投影保持期望的条件
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、搬移原子并守住概率质量
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分布预测不等于风险偏好或控制收缩保证
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分布预测不等于风险偏好或控制收缩保证
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 投影前后要同时检查概率和与期望:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“投影前后要同时检查概率和与期望”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
概率质量守恒不等于期望守恒;后者还要求原子目标不被支持边界裁剪。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补支撑间隔、移动裁剪、左右质量守恒及整数落点,链接投影定义。
正文配图:2 幅
- Categorical DQN改变原子数量后在五个Atari游戏中的分数曲线
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
图3把支持原子数从5、11、21增加到51,与Bernoulli和DQN对照;横轴是百万训练帧,纵轴是各游戏原始分数。增加原子数在Seaquest等任务更有影响,在Pong已接近饱和时差异很小;曲线经过五百万帧移动平均,不能把平滑程度当作独立随机种子的置信区间。
- 依次看a到d:下一状态回报分布经折扣收缩,再加上奖励平移,最后投影到固定支持点。前三步对应分布Bellman更新,最后一步才是C51离散表示额外引入的近似。
方法/设定图 · 必要原图摘引 · Figure 1完整图形; HTML S3.F1
依次看a到d:下一状态回报分布经折扣收缩,再加上奖励平移,最后投影到固定支持点。前三步对应分布Bellman更新,最后一步才是C51离散表示额外引入的近似。
未逐条复核控制理论反例证明;不声称分布控制普遍收敛
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:固定支撑不含真实高收益时会怎样?;为什么分布更丰富不自动等于更安全?;策略评价的收敛结论为何难搬到控制?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S3.F1
查看本篇 1 个原文证据入口
- 图1 · S3.F1
原站图表/证明入口
本轮边界:未逐条复核控制理论反例证明;不声称分布控制普遍收敛
本次深化
- 展开分布Bellman更新与固定支持投影,区分预测回报分布和风险目标。
- 用三支持点手算投影概率及边界裁剪可能改变期望。
- 区分最佳评估排行榜、附录三种子和训练速度,避免把帧效率当墙钟效率。
- v2:为三个原始追问逐题增加参考答案:固定支撑不含真实高收益时会怎样?;为什么分布更丰富不自动等于更安全?;策略评价的收敛结论为何难搬到控制?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S3.F1
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补支撑间隔、移动裁剪、左右质量守恒及整数落点,链接投影定义。
查核资料
- arxiv.org · 所列章节
分布Bellman算子;Algorithm 1投影;§5.1—5.2与附录C—D
技术关系
- 16-dqn · 直接继承
从标量TD目标改为分布目标与投影。
- 29-rainbow · 模块组合
分布输出与多步、优先回放等部件组合。
仍需留意
- 未逐条复核控制理论反例证明;不声称分布控制普遍收敛
强化学习Rainbow: Combining Improvements in Deep Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:六个单独有效的改进,放在一起还各自有效吗
- 二、沿一条更新数据流连接六个改进
- 三、从优先片段构造多步分布目标
- 四、用逐项移除解释组件的条件贡献
- 五、识别替代作用而不把增益相加
- 六、继续追问:消融、交互与预算
- 七、回到具体接口定位组合失败
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:六个单独有效的改进,放在一起还各自有效吗
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、沿一条更新数据流连接六个改进 / 验算尾部必须使用平方折扣
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、从优先片段构造多步分布目标
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、识别替代作用而不把增益相加
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、识别替代作用而不把增益相加
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 发生提前终止时,多步长度也要缩短:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“发生提前终止时,多步长度也要缩短”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
提前终止例子要求真正终止而非普通时间截断;跨重置奖励不能进入同一n步目标。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补百万帧/中位归一化、100%含义、删组件读法与平滑边界。
正文配图:3 幅
- Rainbow与移除六个组件后的57游戏人类归一化中位数曲线
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
彩虹色实线是完整组合,虚线每次只删一个组件;横轴是百万游戏帧,纵轴是57游戏的人类归一化中位数,越高越好。100%是归一化的人类参照,不能读成100%任务成功率。先在同一帧预算下比较完整方法与某条虚线,再去逐游戏图检查差异;图注说明曲线作移动平均,这份平滑不表示跨种子置信区间。
- 彩色Rainbow曲线汇总57款游戏的人类归一化中位数,横轴是百万帧。7M与44M标记回答达到已有基线水平要用多少数据,不能解读成每个游戏都已超过人类。
实验/结果图 · 必要原图摘引 · Figure 1完整图形; HTML Sx1.F1
彩色Rainbow曲线汇总57款游戏的人类归一化中位数,横轴是百万帧。7M与44M标记回答达到已有基线水平要用多少数据,不能解读成每个游戏都已超过人类。
- 六排逐一移除组件,纵轴表示相对Rainbow与DQN的学习曲线面积变化。少数正柱与多数负柱并存,贡献随游戏而变;原图省略了DQN优于Rainbow的两款游戏,应保留这一边界。
实验/结果图 · 必要原图摘引 · Figure 4完整图形; HTML Sx6.F4
六排逐一移除组件,纵轴表示相对Rainbow与DQN的学习曲线面积变化。少数正柱与多数负柱并存,贡献随游戏而变;原图省略了DQN优于Rainbow的两款游戏,应保留这一边界。
未在正文展示的图/表与范围
- 表2:Table references inventoried separately; figure-only completion priority.
未复核全部游戏曲线;不把条件消融解释为独立因果贡献
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:移除组件后是否应重新调参?;六项中哪些改变数学对象,哪些只改训练机制?;用最终检查点而非最佳快照,结论是否保持?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:Sx1.F1,3:Sx6.F3,4:Sx6.F4
查看本篇 3 个原文证据入口
- 图1 · Sx1.F1
原站图表/证明入口
- 图3 · Sx6.F3
原站图表/证明入口
- 图4 · Sx6.F4
原站图表/证明入口
本轮边界:未复核全部游戏曲线;不把条件消融解释为独立因果贡献
本次深化
- 按目标、抽样、表示和探索梳理六模块接口,而非仅罗列改进名称。
- 手算两步奖励与γ²尾部的分布目标,检查多步和C51的连接。
- 区分逐项移除的总体曲线和逐游戏面积,保留组件收益依赖组合的边界。
- v2:为三个原始追问逐题增加参考答案:移除组件后是否应重新调参?;六项中哪些改变数学对象,哪些只改训练机制?;用最终检查点而非最佳快照,结论是否保持?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:Sx1.F1,3:Sx6.F3,4:Sx6.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补百万帧/中位归一化、100%含义、删组件读法与平滑边界。
查核资料
- arxiv.org · 所列章节
Integrated Agent;实验方法;图3—4消融讨论
技术关系
- 18-double-dqn · 模块组合
选择/评价分离是其中一个部件。
- 19-per · 模块组合
采样与重要性权重改变数据利用。
- 28-c51 · 模块组合
分布支持与投影决定训练目标并与其他部件相互作用。
仍需留意
- 未复核全部游戏曲线;不把条件消融解释为独立因果贡献
强化学习Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:随机性怎样成为要优化的收益而非临时探索噪声
- 二、从最大熵目标得到soft价值与策略改进
- 三、重参数化采样并修正tanh后的密度
- 四、读均值策略测试与奖励尺度敏感性
- 五、分清熵温度、奖励尺度与版本改动
- 六、继续追问:动作密度、温度与评价策略
- 七、比较同期双Q与后续技能学习组合
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:随机性怎样成为要优化的收益而非临时探索噪声
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、从最大熵目标得到soft价值与策略改进 / 看奖励尺度怎样改变两动作概率
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、重参数化采样并修正tanh后的密度
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分清熵温度、奖励尺度与版本改动
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、分清熵温度、奖励尺度与版本改动
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 动作压缩为何在边界附近改变密度更大:沿策略梯度综述的重参数化视角区分随机变量与执行动作,再用tanh压缩的局部密度变化解释Jacobian项。
教法来源与实际阅读范围
- Lilian Weng · Policy Gradient Algorithms
策略梯度递归证明;Actor-Critic、off-policy、DPG、MADDPG、TRPO/PPO
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“动作压缩为何在边界附近改变密度更大”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
tanh密度修正是变量变换,需要相应基分布和Jacobian;不是鼓励边界动作的奖励项。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 核对附录C补变量变换公式、压缩比例与两处log概率的一致性。
正文配图:3 幅
- SAC与多种控制算法在六项MuJoCo任务中的回报学习曲线
实验/结果图 · 必要原图摘引 · Figure 1;原HTML图形
[图1](https://arxiv.org/html/1801.01290#S4.F1)按六个连续控制任务画训练进展:横轴为百万环境步、纵轴为平均回报。Hopper只画到约100万步,而Humanoid画到约1000万步,不能把同样靠右的位置当作相同预算;[图2](https://arxiv.org/html/1801.01290#S5.F2)特别比较Humanoid中的随机与确定性变体,支持随机策略可改善所测配置的跨种子稳定性。[图3](https://arxiv.org/html/1801.01290#S5.F3)把评估动作选择、奖励尺度和目标平滑分开:均值动作评估改变实际执行策略,奖励尺度又改变熵与回报的相对权重。故这些敏感性曲线恰好说明原版不是无需调参,也不能据此替后续自动温度版背书。 [查看原文](https://arxiv.org/html/1801.01290)。
- 原论文Figure 3:三列依次为(a)评估动作选择、(b)奖励尺度、(c)目标平滑系数。横轴均为环境步;只在同一列内比较控制变量,不能把奖励尺度实验解释为自动调温度。
实验/结果图 · 必要原图摘引 · HTML S5.F3; Figure 3
三列依次为(a)评估动作选择、(b)奖励尺度、(c)目标平滑系数。横轴均为环境步;只在同一列内比较控制变量,不能把奖励尺度实验解释为自动调温度。
- 原论文Figure 2:Humanoid中的随机与确定性策略:浅线保留各次运行,粗线呈现总体趋势;应比较跨种子分散程度,不能把某一条红线的最高点当作稳定收益。
实验/结果图 · 必要原图摘引 · HTML S5.F2; Figure 2
Humanoid中的随机与确定性策略:浅线保留各次运行,粗线呈现总体趋势;应比较跨种子分散程度,不能把某一条红线的最高点当作稳定收益。
未复核全部附录温度扫描;版本限定2018 v2
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:奖励整体乘10但 α 不变会怎样?;为什么评估用均值动作可能改变结论?;原始 SAC 与自动温度版有哪些训练对象不同?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S4.F1,2:S5.F2,3:S5.F3
查看本篇 3 个原文证据入口
- 图1 · S4.F1
原站图表/证明入口
- 图2 · S5.F2
原站图表/证明入口
- 图3 · S5.F3
原站图表/证明入口
本轮边界:未复核全部附录温度扫描;版本限定2018 v2
本次深化
- 从最大熵目标推导soft策略改进和重参数化,固定原始含V网络版本。
- 手算温度与奖励尺度如何改变两动作Boltzmann概率。
- 核实五种子、min–max阴影与均值动作评价,不借后续自动温度解释原版。
- v2:为三个原始追问逐题增加参考答案:奖励整体乘10但 α 不变会怎样?;为什么评估用均值动作可能改变结论?;原始 SAC 与自动温度版有哪些训练对象不同?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S4.F1,2:S5.F2,3:S5.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:核对附录C补变量变换公式、压缩比例与两处log概率的一致性。
查核资料
- arxiv.org · 所列章节
soft策略改进;重参数化式11—13;双Q说明;§5图1—3
技术关系
仍需留意
- 未复核全部附录温度扫描;版本限定2018 v2
强化学习Addressing Function Approximation Error in Actor-Critic Methods部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:Actor越会提高Q,为何真实控制反而可能变差
- 二、在目标、更新频率和动作邻域各加一道约束
- 三、先拟合双Critic再延迟更新Actor
- 四、读三组件消融与重配DDPG基线
- 五、低估与相关错误仍会穿过三道约束
- 六、继续追问:平滑、时钟与误差相关性
- 七、从在线误差控制走向离线行为约束
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:Actor越会提高Q,为何真实控制反而可能变差
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、在目标、更新频率和动作邻域各加一道约束 / 区别延迟策略更新与延长环境动作
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、先拟合双Critic再延迟更新Actor
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、低估与相关错误仍会穿过三道约束
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、低估与相关错误仍会穿过三道约束
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 两次裁剪不能合并成一次:对照Spinning Up TD3的目标动作平滑顺序,拆出扰动clip与合法动作clip两种约束对象。
教法来源与实际阅读范围
- OpenAI Spinning Up · Twin Delayed DDPG
Key Equations从目标噪声到双Q与延迟
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“两次裁剪不能合并成一次”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
扰动裁剪和动作边界裁剪的对象不同;此接口解释不替代双Critic与延迟更新的联合实验。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补齐目标符号、两层clip、真终止和Monte Carlo平滑解释,并定位§5.3/式15/算法1。
- 补充图5坐标、TD3与两种DDPG的对照及饱和任务边界。
正文配图:3 幅
- TD3和六种对照算法在七项Gym控制任务中的平均回报和误差带
实验/结果图 · 必要原图摘引 · Figure 5;原HTML图形;上排依次HalfCheetah、Hopper、Walker2d、Ant,下排依次Reacher、InvertedPendulum、InvertedDoublePendulum
**先读坐标再比较颜色**:七个面板的横轴都是环境时间步,以百万步为单位;纵轴是各任务的平均评估回报,量纲与范围随任务改变,不能跨面板直接比较高度。蓝色TD3在HalfCheetah等任务较高,但倒立摆面板有多个方法接近上限,不能只用饱和任务判断三项机制的贡献。绿色重调DDPG与橙色原DDPG的差距还提醒我们:比较对象包含实现和调参变化。
- 原论文Figure 1:左(a)为Hopper,右(b)为Walker2d。实线估值与带圆点的真实回报估计应配对读,曲线高低不等于策略性能排名。
实验/结果图 · 必要原图摘引 · HTML S4.F1; Figure 1
左(a)为Hopper,右(b)为Walker2d。实线估值与带圆点的真实回报估计应配对读,曲线高低不等于策略性能排名。
- 原论文Figure 2:左(a)为Hopper,右(b)为Walker2d。红色DQ-AC与紫色DDQN-AC各自对照同色带点真值,检查交叉估计仍保留多少乐观误差。
实验/结果图 · 必要原图摘引 · HTML S4.F2; Figure 2
左(a)为Hopper,右(b)为Walker2d。红色DQ-AC与紫色DDQN-AC各自对照同色带点真值,检查交叉估计仍保留多少乐观误差。
未在正文展示的图/表与范围
未复核所有种子原始日志;神经网络保证不由表格定理直接推出
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:两 Critic 完全相关时还有多少作用?;为什么目标噪声不等于探索噪声?;同样交互预算下更频繁 Critic 更新是否公平?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S4.F1,2:S4.F2,5:S6.F5
查看本篇 3 个原文证据入口
- 图1 · S4.F1
原站图表/证明入口
- 图2 · S4.F2
原站图表/证明入口
- 图5 · S6.F5
原站图表/证明入口
本轮边界:未复核所有种子原始日志;神经网络保证不由表格定理直接推出
本次深化
- 拆解双Q取小、延迟Actor和目标动作平滑的不同误差控制作用。
- 手算目标6.4及四次Critic对应两次Actor更新,避免混淆环境步。
- 核对十次试验和末段评价,说明各组件不保证每任务都获益。
- v2:为三个原始追问逐题增加参考答案:两 Critic 完全相关时还有多少作用?;为什么目标噪声不等于探索噪声?;同样交互预算下更频繁 Critic 更新是否公平?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S4.F1,2:S4.F2,5:S6.F5
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补齐目标符号、两层clip、真终止和Monte Carlo平滑解释,并定位§5.3/式15/算法1。
- 第三版:补充图5坐标、TD3与两种DDPG的对照及饱和任务边界。
查核资料
- arxiv.org · 所列章节
§4—5三机制;§6.2表2及其统计口径
技术关系
- 17-ddpg · 直接继承
三项改动针对其Actor与Critic误差耦合。
- 11-double-q · 历史背景
继承防高估问题,但min与交叉选择评价并不等价。
- 45-td3-bc · 直接继承
后作在离线数据下给Actor增加行为约束。
仍需留意
- 未复核所有种子原始日志;神经网络保证不由表格定理直接推出
强化学习IMPALA: Scalable Distributed Deep-RL with Importance Weighted Actor-Learner Architectures部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:采样与学习分开以后,旧轨迹怎样评价新策略
- 二、分开残差权重与多步传播权重
- 三、存下行为概率并从unroll尾部递推
- 四、把吞吐、策略滞后与任务表现分别检验
- 五、截断固定点不一定就是当前目标策略
- 六、对照两种加权残差的不同用途
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:采样与学习分开以后,旧轨迹怎样评价新策略
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、分开残差权重与多步传播权重 / 算出截到1之后实际评价的策略
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、存下行为概率并从unroll尾部递推
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、截断固定点不一定就是当前目标策略
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、截断固定点不一定就是当前目标策略
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 残差权重出现的位置决定其职责:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“残差权重出现的位置决定其职责”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
空乘积解释只定位ρ与c在V-trace中的作用;改权重位置会改变算子及其固定点,非记号变化。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 增加有限unroll展开、反向递推与on-policy望远镜相消。
- 补充归一化纵轴及八GPU曲线的系统效率读法。
正文配图:3 幅
- IMPALA在DMLab-30中按环境帧及墙钟时间计的归一化表现
实验/结果图 · 必要原图摘引 · Figures 5–6;原HTML将两图置于同一锚点,左环境帧、右墙钟时间
左图按环境帧比较数据效率,右图按小时比较墙钟效率,两个横轴不能混成同一种加速。曲线选择每组超参数搜索或PBT种群中的最佳agent;左图帧数只算一个agent,若计算24个候选的总搜索成本还要乘以种群规模。 两图共用的纵轴是DMLab-30“封顶后的人类归一化分数均值”:先按各任务随机/人类参照归一化,再把每项的上限设为100%,最后平均。因此某项超人类高分不能无限补偿别的任务失败;曲线也不是“答对任务的百分比”。深蓝八GPU曲线在右图较早到达相近高度,主要说明墙钟收益,左图仍须另看相同帧数的学习效果。口径见[§5.3.1及附录B](https://arxiv.org/html/1802.01561v3#S5.SS3.SSS1)。
- 原论文Figure 1:左侧为单learner,右侧为多个同步learner。沿参数和观测箭头读actor与learner的数据交换;解耦结构本身没有保证回报提高。
方法/设定图 · 必要原图摘引 · HTML S1.F1; Figure 1
左侧为单learner,右侧为多个同步learner。沿参数和观测箭头读actor与learner的数据交换;解耦结构本身没有保证回报提高。
- 原论文Figure 2:自上而下为(a)逐步同步A2C、(b)整段同步A2C、(c)IMPALA;最上方保留环境步、前向和反向计算图例。空白等待体现吞吐损失,不是训练质量。
方法/设定图 · 必要原图摘引 · HTML S3.F2; Figure 2
自上而下为(a)逐步同步A2C、(b)整段同步A2C、(c)IMPALA;最上方保留环境步、前向和反向计算图例。空白等待体现吞吐损失,不是训练质量。
未在正文展示的图/表与范围
- 表1:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
本轮未逐项重核吞吐硬件与全部任务分数,未复现系统
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:队列长度如何影响有效样本质量?;ρ与c两个截断各自改变什么?;多任务共享提高均值时是否存在负迁移?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S1.F1,2:S3.F2
查看本篇 2 个原文证据入口
- 图1 · S1.F1
原站图表/证明入口
- 图2 · S3.F2
原站图表/证明入口
本轮边界:本轮未逐项重核吞吐硬件与全部任务分数,未复现系统
本次深化
- 解释actor/learner分离与V-trace中ρ、c的不同作用及截断固定点。
- 手算目标策略0.2/0.8经ρ截断后的有效策略0.5/0.5。
- 区分系统吞吐、每帧效率和表格收敛条件,不把理论覆盖异步深网。
- v2:为三个原始追问逐题增加参考答案:队列长度如何影响有效样本质量?;ρ与c两个截断各自改变什么?;多任务共享提高均值时是否存在负迁移?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S1.F1,2:S3.F2
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:增加有限unroll展开、反向递推与on-policy望远镜相消。
- 第三版:补充归一化纵轴及八GPU曲线的系统效率读法。
查核资料
- arxiv.org · 所列章节
§4 V-trace式3、附录A Theorem 1与Remark 3;架构说明
技术关系
仍需留意
- 本轮未逐项重核吞吐硬件与全部任务分数,未复现系统
强化学习Diversity is All You Need: Learning Skills without a Reward Function部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有任务奖励,怎样先学到可区分的行为
- 二、以技能后验相对先验的信息构造奖励
- 三、固定技能先验并联合训练判别器与策略
- 四、读有效技能数与下游失败案例
- 五、可辨识技能不一定是有用技能
- 六、继续追问:先验、状态特征与下游选择
- 七、把学得技能接回层级控制条件
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:没有任务奖励,怎样先学到可区分的行为
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、以技能后验相对先验的信息构造奖励 / 比较四技能先验与判别后验的奖励
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、固定技能先验并联合训练判别器与策略
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、可辨识技能不一定是有用技能
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、可辨识技能不一定是有用技能
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 判别器奖励衡量相对先验的改善:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“判别器奖励衡量相对先验的改善”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
判别器奖励比较后验与技能先验;高置信分类或高奖励不独立证明技能有任务用途。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补入互信息到判别器奖励的短推导、参数角色与固定先验常数项。
- 补充图4坐标、有效技能数和五种子读法。
正文配图:5 幅
- DIAYN固定技能先验与VIC在HalfCheetah上保持的技能数量
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形
图4横轴是训练墙钟小时,纵轴是由先验熵计算的有效技能数 $\exp(H[Z])$,使用对数刻度。五条蓝线代表VIC的五次随机运行,橙虚线对应DIAYN固定先验;这里不是五种不同技能的成功率。先验熵降低意味着训练越来越少抽到某些技能,不能据曲线独自判断保留下来的动作在物理上有多不同。
- 原论文Figure 9:上排专家动作与下排技能模仿逐列对应,最后一列红框是倒立失败;不能只保留前三列成功例子。
实验/结果图 · 必要原图摘引 · HTML S4.F9; Figure 9
上排专家动作与下排技能模仿逐列对应,最后一列红框是倒立失败;不能只保留前三列成功例子。
- 原论文Figure 1:左侧是技能、环境与判别器的信息流,右侧保留同图中的完整Algorithm 1。固定先验抽样与判别器奖励分别对应防坍缩和可区分性。
方法/设定图 · 必要原图摘引 · PDF第3页; Figure 1
左侧是技能、环境与判别器的信息流,右侧保留同图中的完整Algorithm 1。固定先验抽样与判别器奖励分别对应防坍缩和可区分性。
- 原论文Figure 2:从左到右依次为(a)二维导航、(b)可在之后区分的重叠技能、(c)训练中的奖励分布。轨迹颜色表示技能身份,右列奖励分布才随训练变化。
实验/结果图 · 必要原图摘引 · HTML S4.F2; Figure 2
从左到右依次为(a)二维导航、(b)可在之后区分的重叠技能、(c)训练中的奖励分布。轨迹颜色表示技能身份,右列奖励分布才随训练变化。
- 原论文Figure 3:同一行中的连续姿态展示运动技能的时间变化;这些无任务奖励学出的行为是定性样例,不能由姿态数量反推任务覆盖率。
实验/结果图 · 必要原图摘引 · HTML S4.F3; Figure 3
同一行中的连续姿态展示运动技能的时间变化;这些无任务奖励学出的行为是定性样例,不能由姿态数量反推任务覆盖率。
未量化所有技能覆盖;可辨识性不自动等于下游价值
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:只观察位置和观察全状态会发现不同技能吗?;如何测量技能对未知任务的真实帮助?;固定均匀先验是否浪费困难技能的预算?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S3.F1,2:S4.F2,3:S4.F3,4:S4.F4,9:S4.F9
查看本篇 5 个原文证据入口
- 图1 · S3.F1
原站图表/证明入口
- 图2 · S4.F2
原站图表/证明入口
- 图3 · S4.F3
原站图表/证明入口
- 图4 · S4.F4
原站图表/证明入口
- 图9 · S4.F9
原站图表/证明入口
本轮边界:未量化所有技能覆盖;可辨识性不自动等于下游价值
本次深化
- 从技能互信息解释判别奖励和固定先验,区分可辨识与下游有用。
- 手算四技能伪奖励log3.2,构造技能坍缩与无用区分反例。
- 核读有效技能数、下游先验及手倒立失败,限制技能覆盖结论。
- v2:为三个原始追问逐题增加参考答案:只观察位置和观察全状态会发现不同技能吗?;如何测量技能对未知任务的真实帮助?;固定均匀先验是否浪费困难技能的预算?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S3.F1,2:S4.F2,3:S4.F3,4:S4.F4,9:S4.F9
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补入互信息到判别器奖励的短推导、参数角色与固定先验常数项。
- 第三版:补充图4坐标、有效技能数和五种子读法。
查核资料
- arxiv.org · 所列章节
信息目标与伪奖励;§4图4、下游先验及图9
技术关系
- 30-sac · 模块组合
最大熵优化器训练技能条件策略,判别器提供奖励。
- 07-options · 教学联系
学得潜变量技能可作为层级控制素材,但仍需定义调用、终止及上层选择。
仍需留意
- 未量化所有技能覆盖;可辨识性不自动等于下游价值
强化学习QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:各自只看本地信息,怎样选出团队价值最大的组合
- 二、用单调混合把局部排序接成联合贪心
- 三、以全局状态生成权重并训练团队TD目标
- 四、读分散评估与状态非线性的消融
- 五、贪心一致性以牺牲部分价值表达为代价
- 六、比较两条集中训练分散执行路线
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:各自只看本地信息,怎样选出团队价值最大的组合
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、用单调混合把局部排序接成联合贪心 / 用协调矩阵检查不能表示的排序翻转
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、以全局状态生成权重并训练团队TD目标
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、贪心一致性以牺牲部分价值表达为代价
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、贪心一致性以牺牲部分价值表达为代价
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 集中状态不能绕过执行时的信息限制:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“集中状态不能绕过执行时的信息限制”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
训练时全局状态不能恢复执行时缺失的信息;单调混合也不能表示任意协同价值函数。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充逐坐标替换证明及状态/局部历史条件。
- 补齐图例消融含义与面板预算差异提醒。
正文配图:3 幅
- QMIX及混合结构消融在3m、2s_3z、3s_5z上的测试胜率
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形;从左至右3m、2s_3z、3s_5z,原面板与图例重新排版
图例中的QMIX-Lin移除非线性混合能力,QMIX-NS移除混合权重对全局状态的条件依赖,VDN-S则给加和分解加入状态信息。因而应在同一地图、同一环境步数上比较这些颜色,分别问非线性和状态条件化有什么帮助;不能把所有消融统称“更小网络”。三张面板横轴上限也不同,靠右端点比较时须先核对预算。
- 原论文Figure 3:六面板按从左到右、从上到下依次为(a)3m、(b)5m、(c)8m、(d)2s_3z、(e)3s_5z、(f)1c_3s_5z;先认地图,再比较同一环境步下的测试胜率,虚线是启发式基线。
实验/结果图 · 必要原图摘引 · HTML S5.F3; Figure 3
六面板按从左到右、从上到下依次为(a)3m、(b)5m、(c)8m、(d)2s_3z、(e)3s_5z、(f)1c_3s_5z;先认地图,再比较同一环境步下的测试胜率,虚线是启发式基线。
- 原论文Figure 2:三部分从左到右是(a)mixer及超网络、(b)整体集中训练结构、(c)单个智能体网络。红色超网络输出受约束权重,局部网络仍只使用执行时可获得的信息。
方法/设定图 · 必要原图摘引 · HTML S4.F2; Figure 2
三部分从左到右是(a)mixer及超网络、(b)整体集中训练结构、(c)单个智能体网络。红色超网络输出受约束权重,局部网络仍只使用执行时可获得的信息。
未核对全部补充地图与游戏版本差异
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:单调限制排除了哪些协作任务?;局部Qi能否直接解释为各单位贡献?;StarCraft版本变化如何影响复现胜率?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S4.F2,3:S5.F3,4:S7.F4
查看本篇 3 个原文证据入口
- 图2 · S4.F2
原站图表/证明入口
- 图3 · S5.F3
原站图表/证明入口
- 图4 · S7.F4
原站图表/证明入口
本轮边界:未核对全部补充地图与游戏版本差异
本次深化
- 由混合单调性解释局部贪心一致性,区分表示整张Q表与找到好策略。
- 用两人动作相同得奖的矩阵展示局部排序表示限制。
- 核实二十次独立运行及95%区间,澄清基线IQL不是Implicit Q-Learning。
- v2:为三个原始追问逐题增加参考答案:单调限制排除了哪些协作任务?;局部Qi能否直接解释为各单位贡献?;StarCraft版本变化如何影响复现胜率?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S4.F2,3:S5.F3,4:S7.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充逐坐标替换证明及状态/局部历史条件。
- 第三版:补齐图例消融含义与面板预算差异提醒。
查核资料
- arxiv.org · 所列章节
单调性与超网络;§6设置;§7图3—4评估
技术关系
仍需留意
- 未核对全部补充地图与游戏版本差异
强化学习Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:模型不确定时,怎样用有限搜索决定下一动作
- 二、分别建模随机性与模型分歧,再传播粒子
- 三、用CEM筛选动作序列并只执行第一步
- 四、读轨迹采样配置与迄今最佳回报
- 五、省环境样本不代表规划延迟低
- 六、继续追问:模型身份、粒子数与校准
- 七、从行动时搜索转向生成训练经验
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:模型不确定时,怎样用有限搜索决定下一动作
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、分别建模随机性与模型分歧,再传播粒子 / 比较保持模型身份与逐步换模型的两步分布
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、用CEM筛选动作序列并只执行第一步
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、省环境样本不代表规划延迟低
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、省环境样本不代表规划延迟低
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 增加粒子只减少哪一类误差:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“增加粒子只减少哪一类误差”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
增加粒子只降低给定模型内的积分噪声,不能修正模型共同偏差;候选动作数是另一预算。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 增加粒子平均的Monte Carlo估计式、CEM与MPC的因果衔接。
- 补齐图3任务、轴、PE-TS1与收敛参照的区别。
正文配图:3 幅
- PETS与模型式和无模型基线在四项控制任务中的历史最高回报
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
四个面板分别是Cartpole、7-DOF Pusher、7-DOF Reacher和Half-cheetah;横轴都是已收集的真实时间步,纵轴是任务奖励,越高越好,即使刻度为负也如此。蓝色方块PE-TS1是图中PETS配置,黑色不同线型是无模型方法收敛后的参照水平,不是同样少量样本下的完整学习曲线。结合“历史最佳再跨实验平均”的统计口径,图主要支持所测任务的样本效率比较,不能据此推断每一步实际控制都稳定。
- 原论文Figure 1:从左到右读概率动力学集成、粒子传播和MPC规划。成员间分歧与单成员概率方差是两类不确定性,不能把所有分散都当成同一种模型误差。
方法/设定图 · 必要原图摘引 · HTML S1.F1; Figure 1
从左到右读概率动力学集成、粒子传播和MPC规划。成员间分歧与单成员概率方差是两类不确定性,不能把所有分散都当成同一种模型误差。
- 原论文Figure 4:四个任务面板比较模型类别与传播方法的最终回报。模型和传播是两项选择,比较时先固定其中一项,避免将组合差异归因给单一模块。
实验/结果图 · 必要原图摘引 · HTML S7.F4; Figure 4
四个任务面板比较模型类别与传播方法的最终回报。模型和传播是两项选择,比较时先固定其中一项,避免将组合差异归因给单一模块。
未复核全部规划超参数和硬件延迟;不主张集成概率严格校准
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:模型分歧如何校准到真实误差?;规划预算增加是否会更容易利用模型漏洞?;每秒控制频率下实际可承受多少粒子?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S1.F1,3:S7.F3,4:S7.F4
查看本篇 3 个原文证据入口
- 图1 · S1.F1
原站图表/证明入口
- 图3 · S7.F3
原站图表/证明入口
- 图4 · S7.F4
原站图表/证明入口
本轮边界:未复核全部规划超参数和硬件延迟;不主张集成概率严格校准
本次深化
- 分开环境随机性、模型不确定性与粒子传播,解释TS1/TS∞差异。
- 手算两模型两步位移2/3/4的分布,展示平均模型会丢失结构。
- 核对五模型、二十粒子及十次实验的迄今最佳回报口径。
- v2:为三个原始追问逐题增加参考答案:模型分歧如何校准到真实误差?;规划预算增加是否会更容易利用模型漏洞?;每秒控制频率下实际可承受多少粒子?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S1.F1,3:S7.F3,4:S7.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:增加粒子平均的Monte Carlo估计式、CEM与MPC的因果衔接。
- 第三版:补齐图3任务、轴、PE-TS1与收敛参照的区别。
查核资料
- arxiv.org · 所列章节
§5.1轨迹采样、算法概要、图3统计口径
技术关系
仍需留意
- 未复核全部规划超参数和硬件延迟;不主张集成概率严格校准
强化学习Exploration by Random Network Distillation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不预测随机下一帧,也能用误差判断新奇吗
- 二、冻结随机目标并让预测器学习熟悉状态
- 三、分开内外价值边界并固定奖励的梯度角色
- 四、读房间覆盖与外在回报及双头消融
- 五、固定目标并不等于噪声免疫
- 六、对照不同新奇性来源并保留策略接口
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:不预测随机下一帧,也能用误差判断新奇吗
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、冻结随机目标并让预测器学习熟悉状态 / 算清熟悉度下降及两种终止掩码
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、分开内外价值边界并固定奖励的梯度角色
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、固定目标并不等于噪声免疫
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、固定目标并不等于噪声免疫
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 冻结目标与预测器冻结有相反效果:借探索综述区分固定随机目标和可训练预测器,反向讨论同时冻结或同时移动时熟悉度信号为何改变。
教法来源与实际阅读范围
- Lilian Weng · Exploration Strategies in Deep Reinforcement Learning
预测误差;IDF/RF;noisy TV;RND非回合和归一化
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“冻结目标与预测器冻结有相反效果”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
预测误差下降需要目标固定而预测器学习;误差仍不直接等于环境熵或可控新奇度。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充固定特征、特征维度求和、更新前奖励与双优化方向。
- 补充图4横轴、每对纵轴及颜色对应的对照问题。
正文配图:3 幅
- RND的不同内外奖励与价值估计组合对回报和探索房间数的影响
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形
图4四个面板横轴都是参数更新次数;每一对分别画平均回合外在回报和平均发现房间数,前者不是内在奖励,后者不是完成任务比例。对照橙色非回合内在价值与绿色回合内双价值曲线,可以看到探索覆盖的差距比任务分数的差距更直接;再对照蓝色单价值估计,才是在同一回合设定下检验“双头是否必要”。不要把不同策略网络的两组面板合并成同一个实验。
- 原论文Figure 3:左图是平均外在回报,右图是平均发现房间数;两者都不是直接使用的内在奖励。非回合处理改善覆盖,不意味着两种评价指标同比提高。
实验/结果图 · 必要原图摘引 · HTML S3.F3.fig2; Figure 3
左图是平均外在回报,右图是平均发现房间数;两者都不是直接使用的内在奖励。非回合处理改善覆盖,不意味着两种评价指标同比提高。
- 原论文Figure 2:横轴是目标数字类别的训练样本数,纵轴是保留样本预测MSE;不同颜色为不同目标类别。这是新颖性代理的诊断,不是控制任务成功率。
实验/结果图 · 必要原图摘引 · HTML S3.F3.fig1; Figure 2
横轴是目标数字类别的训练样本数,纵轴是保留样本预测MSE;不同颜色为不同目标类别。这是新颖性代理的诊断,不是控制任务成功率。
未复核全部大规模帧预算与全部游戏结果
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:预测器过强或过弱会怎样改变探索?;遗忘会不会导致无用循环?;房间数与任务分数矛盾时如何判断方法?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S3.F3.fig1,3:S3.F3.fig2,4:S3.F4
查看本篇 3 个原文证据入口
- 图2 · S3.F3.fig1
原站图表/证明入口
- 图3 · S3.F3.fig2
原站图表/证明入口
- 图4 · S3.F4
原站图表/证明入口
本轮边界:未复核全部大规模帧预算与全部游戏结果
本次深化
- 解释冻结随机目标的新颖性及内外回报双终止约定,不保证消除所有噪声。
- 手算特征预测奖励下降,并区分终局外在价值与跨回合内在价值。
- 核读房间覆盖和双价值头消融,不把采用双头写成处处有益。
- v2:为三个原始追问逐题增加参考答案:预测器过强或过弱会怎样改变探索?;遗忘会不会导致无用循环?;房间数与任务分数矛盾时如何判断方法?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S3.F3.fig1,3:S3.F3.fig2,4:S3.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充固定特征、特征维度求和、更新前奖励与双优化方向。
- 第三版:补充图4横轴、每对纵轴及颜色对应的对照问题。
查核资料
- arxiv.org · 所列章节
§2.3—2.4终止与归一化;§3.1—3.2图3—4
技术关系
仍需留意
- 未复核全部大规模帧预算与全部游戏结果
强化学习Off-Policy Deep Reinforcement Learning without Exploration部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有新交互纠错时,怎样阻止Actor追逐数据外高Q
- 二、用行为生成器和有界扰动限制候选
- 三、生成候选、扰动并输出被评分的实际动作
- 四、读不同数据来源及行为回报参照
- 五、约束保护证据边界也限制改进上限
- 六、继续追问:生成覆盖、扰动与离线评估
- 七、比较动作约束与价值保守化
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:没有新交互纠错时,怎样阻止Actor追逐数据外高Q
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、用行为生成器和有界扰动限制候选 / 让虚假高值动作10退出候选集合
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、生成候选、扰动并输出被评分的实际动作
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、约束保护证据边界也限制改进上限
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、约束保护证据边界也限制改进上限
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 候选数控制有限搜索而不是数据覆盖:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“候选数控制有限搜索而不是数据覆盖”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
更多候选只能增加行为模型已有支持内的有限搜索,不能从零概率区域创造覆盖。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充候选索引到扰动动作的完整选择式及实现边界。
- 补充图2三列任务、回报黑线、上下排数据协议。
正文配图:3 幅
- BCQ在固定数据缓存及并发数据条件下的三任务学习曲线
实验/结果图 · 必要原图摘引 · Figure 2,仅(a)(b)及共用图例;原HTML图形;上排固定缓存、下排并发条件
图2选取的上排是固定缓存训练,下排是并发获得行为数据的条件;三列依次HalfCheetah、Hopper、Walker2d。纵轴均为真实评估平均回报,黑线给相应数据行为的平均回报参照。横轴虽统一标“Time steps”,上排的训练进度并不表示BCQ每一步都新增真实探索数据;下排数据随行为采集增长,黑线也随之变化。比较蓝色BCQ与黑线可问“有没有超过可见行为”,比较蓝色与其他学习器才是在问同一数据协议下的算法差异。
- 原论文Figure 2:此处补齐完整四行:(a)固定缓存、(b)并发数据、(c)模仿数据、(d)不完美示范;每行三列均为HalfCheetah、Hopper、Walker2d。黑线是行为回报参照,阴影为半个标准差。
实验/结果图 · 必要原图摘引 · HTML S5.F2; Figure 2
此处补齐完整四行:(a)固定缓存、(b)并发数据、(c)模仿数据、(d)不完美示范;每行三列均为HalfCheetah、Hopper、Walker2d。黑线是行为回报参照,阴影为半个标准差。
- 原论文Figure 1:上排为实际回报,下排为估计价值;三列依次对应固定缓存、并发数据和模仿数据。下排价值增长而上排回报不改善,才是需要警惕的外推误差现象。
实验/结果图 · 必要原图摘引 · HTML S3.F1; Figure 1
上排为实际回报,下排为估计价值;三列依次对应固定缓存、并发数据和模仿数据。下排价值增长而上排回报不改善,才是需要警惕的外推误差现象。
未逐行复核有限MDP全部定理;生成器覆盖没有一般保证
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:Φ如何在保守与改进间权衡?;生成器遗漏少数好动作怎么办?;为何离线Q增大可能是坏信号?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S3.F1,2:S5.F2
查看本篇 2 个原文证据入口
- 图1 · S3.F1
原站图表/证明入口
- 图2 · S5.F2
原站图表/证明入口
本轮边界:未逐行复核有限MDP全部定理;生成器覆盖没有一般保证
本次深化
- 说明离线外推误差循环及生成候选加扰动的行为约束。
- 用未知动作10的虚高Q展示约束收益,也保留发现缺失最优动作的限制。
- 核对行为回报基线和半标准差阴影,区分数据回报质量与覆盖。
- v2:为三个原始追问逐题增加参考答案:Φ如何在保守与改进间权衡?;生成器遗漏少数好动作怎么办?;为何离线Q增大可能是坏信号?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S3.F1,2:S5.F2
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充候选索引到扰动动作的完整选择式及实现边界。
- 第三版:补充图2三列任务、回报黑线、上下排数据协议。
查核资料
- arxiv.org · 所列章节
§3外推误差;批约束机制;图2实验与图注
技术关系
仍需留意
- 未逐行复核有限MDP全部定理;生成器覆盖没有一般保证
强化学习Stabilizing Off-Policy Q-Learning via Bootstrapping Error Reduction部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:支持里有好动作但很少见,能否增加它的概率
- 二、用核样本差异近似约束Actor的偏移
- 三、在数据状态上更新价值目标与约束乘子
- 四、读有限样本支持模拟与KL对照
- 五、平均MMD小不等于每个动作有支持
- 六、比较约束Actor和保守Critic的作用点
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:支持里有好动作但很少见,能否增加它的概率
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、用核样本差异近似约束Actor的偏移 / 检验罕见但有支持的动作会否被漏采
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、在数据状态上更新价值目标与约束乘子
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、平均MMD小不等于每个动作有支持
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、平均MMD小不等于每个动作有支持
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 核带宽改变约束看到的差别:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“核带宽改变约束看到的差别”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
核带宽极限仅说明小MMD可能失去区分力;实际支持约束还依赖核、尺度、样本和阈值。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补入样本MMD平方展开及各项作用,说明原文平均状态约束和多Critic目标。
- 补充图3平均回报、行为参照及任务间差异。
正文配图:4 幅
- BEAR-QL及BCQ等基线在四项中等质量离线数据任务上的平均回报
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
四个面板来自中等质量数据,曲线平均五个随机种子,粉红虚线表示数据中行为的平均回报。BEAR-QL是否超过行为、以及是否比BCQ更快,要在同一面板比较;横轴一个标度单位对应1000次梯度更新,不能读成新收集的环境步。 纵轴是各任务的平均评估回报,四个面板的分值范围不同。先看橙色BEAR-QL是否高于粉红行为参照,再与蓝色BCQ比较:Walker2d、Hopper的分离比HalfCheetah明显;不能从一张好看的面板推广为所有任务恒定收益。阴影反映重复实验波动,不应仅凭带宽猜测统计显著性。
- 原论文Figure 7:四组分布设置各保留左右两张图,比较自分布与均匀支持分布的有限样本MMD。低MMD不等于精确密度匹配,还要读支持范围与样本规模。
实验/结果图 · 必要原图摘引 · HTML A3.F7; Figure 7
四组分布设置各保留左右两张图,比较自分布与均匀支持分布的有限样本MMD。低MMD不等于精确密度匹配,还要读支持范围与样本规模。
- 原论文Figure 1:左图是真实回报,右图是log Q;颜色代表不同离线样本数。右侧估值越来越大并没有带来左侧收益改善,更多同类数据也不自动修复外推问题。
实验/结果图 · 必要原图摘引 · HTML S4.F1; Figure 1
左图是真实回报,右图是log Q;颜色代表不同离线样本数。右侧估值越来越大并没有带来左侧收益改善,更多同类数据也不自动修复外推问题。
- 原论文Figure 2:三行依次为不约束、分布约束、仅行为策略的Q更新;箭头和三角形表示方向动作的价值。比较误差如何传播,同时留意过窄约束可能阻止改进。
方法/设定图 · 必要原图摘引 · HTML S4.F2; Figure 2
三行依次为不约束、分布约束、仅行为策略的Q更新;箭头和三角形表示方向动作的价值。比较误差如何传播,同时留意过窄约束可能阻止改进。
未逐行复核误差界;有限样本MMD不等同精确支持约束
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:MMD小与没有OOD动作有什么区别?;如何选择核带宽与约束阈值?;数据多模态时行为均值为何可能危险?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S4.F1,2:S4.F2,7:A3.F7
查看本篇 3 个原文证据入口
- 图1 · S4.F1
原站图表/证明入口
- 图2 · S4.F2
原站图表/证明入口
- 图7 · A3.F7
原站图表/证明入口
本轮边界:未逐行复核误差界;有限样本MMD不等同精确支持约束
本次深化
- 区分支持范围与行为频率,解释有限样本MMD约束与精确分布匹配差别。
- 用0.99/0.01动作分布展示重分配收益及小批次漏掉罕见动作的风险。
- 核读附录MMD模拟和相同百万条数据对照,不泛化所有核均优于KL。
- v2:为三个原始追问逐题增加参考答案:MMD小与没有OOD动作有什么区别?;如何选择核带宽与约束阈值?;数据多模态时行为均值为何可能危险?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S4.F1,2:S4.F2,7:A3.F7
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补入样本MMD平方展开及各项作用,说明原文平均状态约束和多Critic目标。
- 第三版:补充图3平均回报、行为参照及任务间差异。
查核资料
- arxiv.org · 所列章节
MMD定义与约束;附录C.3图7;附录D数据与KL比较
技术关系
仍需留意
- 未逐行复核误差界;有限样本MMD不等同精确支持约束
强化学习When to Trust Your Model: Model-Based Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:模型能预测很远,为什么训练策略只想象很短
- 二、从真实状态分叉短轨迹并交给离策略学习
- 三、分别维护真实池、模型池与采样比例
- 四、用无模型多更新对照检验收益来源
- 五、短展开与低模型权重不能互相替代
- 六、继续追问:误差放大、比例与适用预算
- 七、比较显式合成数据与潜在想象学习
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:模型能预测很远,为什么训练策略只想象很短
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、从真实状态分叉短轨迹并交给离策略学习 / 验算局部误差怎样在长展开中放大
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、分别维护真实池、模型池与采样比例
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、短展开与低模型权重不能互相替代
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、短展开与低模型权重不能互相替代
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 从真实状态分叉只重置了哪部分误差:采用作者MBPO讲解的真实起点短分支视角,明确它切断跨分支漂移而非删除分支内误差。
教法来源与实际阅读范围
- Michael Janner · Model-Based Reinforcement Learning: Theory and Practice
四类模型用途;采样分布替换;误差累积;短真实状态分叉
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“从真实状态分叉只重置了哪部分误差”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
真实状态分叉减少跨分支误差积累,不删除分支内模型偏差;短rollout收益仍取决于模型和数据。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 展开加权混合损失并区分rollout长度和合成权重。
- 逐面板解释No Model、Rollout Length、Value Expansion及共同参照。
正文配图:4 幅
- MBPO在Hopper上比较无模型额外更新、模型展开长度与价值扩展
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
图3三面板都在Hopper上,以真实环境步为横轴、平均回报为纵轴,蓝色MBPO和绿色SAC是共同参照。左面板改每环境步梯度次数 $G$,检验“只多训练”;中面板改模型展开长度 $k$,检验误差累积;右面板改价值展开长度 $H$,比较把模型放进价值目标的另一种用法。$G$、$k$、$H$ 的曲线标签属于不同干预,不能把三张图统一读成“模型越短越好”。
- 原论文Figure 2:六项任务均保留环境步横轴和算法图例。蓝色MBPO应与同任务、同预算的基线比较;虚线的渐近参照不能被当作同预算采样曲线。
实验/结果图 · 必要原图摘引 · HTML S5.F2; Figure 2
六项任务均保留环境步横轴和算法图例。蓝色MBPO应与同任务、同预算的基线比较;虚线的渐近参照不能被当作同预算采样曲线。
- 原论文Figure 4:(a)真实运动、(b)同一动作序列的模型展开、(c)累积回报都在图中。姿态不确定性随展开积累,但回报趋势仍可能近似;两者不能相互替代。
实验/结果图 · 必要原图摘引 · HTML S6.F4; Figure 4
(a)真实运动、(b)同一动作序列的模型展开、(c)累积回报都在图中。姿态不确定性随展开积累,但回报趋势仍可能近似;两者不能相互替代。
- 原论文Figure 1:上排横轴为策略偏移、纵轴为模型误差,颜色是训练集规模;下排检查误差对偏移的敏感程度。更多数据降低误差与扩大可相信的策略范围,是相关但不同的判断。
实验/结果图 · 必要原图摘引 · HTML S4.F1; Figure 1
上排横轴为策略偏移、纵轴为模型误差,颜色是训练集规模;下排检查误差对偏移的敏感程度。更多数据降低误差与扩大可相信的策略范围,是相关但不同的判断。
教学误差递推是独立构造,不是论文定量模型;未复現
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:同样GPU时间下MBPO是否仍占优?;模型长度与合成比例如何联合调节?;如何发现Actor正在利用模型漏洞?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S4.F1,2:S5.F2,3:S6.F3,4:S6.F4
查看本篇 4 个原文证据入口
- 图1 · S4.F1
原站图表/证明入口
- 图2 · S5.F2
原站图表/证明入口
- 图3 · S6.F3
原站图表/证明入口
- 图4 · S6.F4
原站图表/证明入口
本轮边界:教学误差递推是独立构造,不是论文定量模型;未复現
本次深化
- 解释真实状态分叉短rollout与价值尾部,限定最坏界和局部误差分析。
- 用误差递推手算一步0.01、十步约0.159,展示非独立累积。
- 核读匹配更新次数的no-model消融,分开可预测跨度与最佳训练跨度。
- v2:为三个原始追问逐题增加参考答案:同样GPU时间下MBPO是否仍占优?;模型长度与合成比例如何联合调节?;如何发现Actor正在利用模型漏洞?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S4.F1,2:S5.F2,3:S6.F3,4:S6.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:展开加权混合损失并区分rollout长度和合成权重。
- 第三版:逐面板解释No Model、Rollout Length、Value Expansion及共同参照。
查核资料
- arxiv.org · 所列章节
§4模型界;分叉rollout算法;§6.2图3—4
技术关系
- 03-dyna · 直接继承
继承模型生成经验与真实经验共用学习器。
- 35-pets · 模块组合
概率集成作为动力学建模素材,执行机制改为Actor。
- 30-sac · 模块组合
作为真实与合成经验上的策略学习器。
仍需留意
- 教学误差递推是独立构造,不是论文定量模型;未复現
强化学习Dream to Control: Learning Behaviors by Latent Imagination部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:像素世界中,策略能否通过想象后果获得梯度
- 二、以潜在动态连接动作、奖励与λ-return
- 三、冻结模型参数但保留动作到未来的导数
- 四、比较想象长度、尾部价值和表示目标
- 五、可微想象仍会传播模型与尾部估值错误
- 六、从初代想象行为学习走向跨任务稳健性
- 自测两题
段落怎样重新安排
- 一、先用一分钟讲明白 / 二、研究背景与问题定义 → 一、问题设定:像素世界中,策略能否通过想象后果获得梯度
把通用摘要改成需要本篇机制处理的具体障碍
- 七、帮助建立理解 / 教学例子 → 二、以潜在动态连接动作、奖励与λ-return / 分开Actor的未来导数与Critic的冻结标签
把原来的后置手算移到公式之后,先验证机制再写实现
- 三、方法 / 教学伪代码 → 三、冻结模型参数但保留动作到未来的导数
把机制的数学对象落实为实际数据流与更新顺序
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、可微想象仍会传播模型与尾部估值错误
避免结论、贡献、局限在三个位置重复而不回答证据边界
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、可微想象仍会传播模型与尾部估值错误
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 同一问题和结论在开头与结尾重复;内容保留于问题设定、方法、原证据解读及原边界段。
- 机制与指标在正文已分别解释;内容保留于数学目标由问题与机制公式说明;机制原文保留;指标保留在第四节。
- 重复问题、方法、证据与边界;内容保留于第一、二、四、五节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 冻结世界参数仍允许哪些导数:借视觉模型强化学习的模型/行为接口视角,画清固定模型参数与保留对动作导数的差异。
教法来源与实际阅读范围
- Chelsea Finn、Frederik Ebert、Sudeep Dasari、Annie Xie、Alex Lee、Sergey Levine · Visual Model-Based Reinforcement Learning as a Path towards Generalist Robots
传感器数据、无标签预测、候选动作序列和首步重规划
- Danijar Hafner、Jurgis Pasukonis、Jimmy Ba、Timothy Lillicrap · Mastering Diverse Control Tasks through World Models
作者项目摘要:想象学习、跨域稳健技术、single configuration
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“冻结世界参数仍允许哪些导数”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
冻结世界模型参数不等于停止其输出梯度;该计算图解释不保证模型导数与真实环境一致。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充H尾值、λ两端、几何混合与终止继续概率简写边界。
- 补充图4轴、三种方法对照和Walker长时域回退。
正文配图:3 幅
- Dreamer及无价值模型与PlaNet在不同想象长度下的最终回报
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形
图4横轴是想象时域长度,纵轴是训练后真实环境的回合回报;它不是随训练步数前进的学习曲线。蓝色Dreamer用价值补足,绿色No value只看有限想象奖励,紫色PlaNet是在执行时规划。短时域下蓝绿差距检验尾部价值的作用;Walker Walk面板在较长时域反而下降,直接提醒“想象更多”可能增加优化和模型误差,不能把横轴越大当作默认越好。
- 原论文Figure 8:八个任务保留重建、对比学习和仅奖励三种目标。像素重建在这些任务中表现更好,不等于任何环境都需要像素级预测。
实验/结果图 · 必要原图摘引 · HTML S6.F8; Figure 8
八个任务保留重建、对比学习和仅奖励三种目标。像素重建在这些任务中表现更好,不等于任何环境都需要像素级预测。
- 原论文Figure 6:各任务柱形保留Dreamer、PlaNet和无模型基线的图例及预算。横向比任务前先看训练步数与输入权限,不能把柱高差统一归为算法本身。
实验/结果图 · 必要原图摘引 · HTML S4.F6; Figure 6
各任务柱形保留Dreamer、PlaNet和无模型基线的图例及预算。横向比任务前先看训练步数与输入权限,不能把柱高差统一归为算法本身。
未复现;全部20任务预算与逐项回报未重新计算
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:冻结模型参数为何仍能对Actor反传?;图像重构与任务信息会冲突吗?;如何区分模型利用和真正控制改善?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:4:S3.F4,6:S4.F6,8:S6.F8
查看本篇 3 个原文证据入口
- 图4 · S3.F4
原站图表/证明入口
- 图6 · S4.F6
原站图表/证明入口
- 图8 · S6.F8
原站图表/证明入口
本轮边界:未复现;全部20任务预算与逐项回报未重新计算
本次深化
- 拆解世界模型、想象Actor与Critic梯度路径,区分可微优化和冻结回归目标。
- 手算λ-return为4.87,说明短bootstrap与长想象的混合。
- 核读价值尾部及表示目标消融,区分重构质量、控制收益和训练预算。
- v2:为三个原始追问逐题增加参考答案:冻结模型参数为何仍能对Actor反传?;图像重构与任务信息会冲突吗?;如何区分模型利用和真正控制改善?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:4:S3.F4,6:S4.F6,8:S6.F8
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充H尾值、λ两端、几何混合与终止继续概率简写边界。
- 第三版:补充图4轴、三种方法对照和Walker长时域回退。
查核资料
- arxiv.org · 所列章节
行为学习目标与梯度;图4、图8及主实验设定
技术关系
- 39-mbpo · 平行方法
均用模型帮助学习策略,Dreamer在潜空间通过动态导数优化行为。
- 15-gae · 教学联系
共享多步混合思想,但这里的λ-return在想象数据中训练价值/行为。
- 48-dreamerv3 · 直接继承
后作改进模型与尺度稳健性,不应将V3组件倒写进初代。
仍需留意
- 未复现;全部20任务预算与逐项回报未重新计算
强化学习Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未知动力学下怎样保留搜索优势
- 二、把表示、动态和预测接成可训练的搜索
- 三、保存搜索目标,再沿真实动作展开训练
- 四、读图2与搜索预算实验:学到的模型能否继续规划
- 五、搜索越深,哪些模型错误也可能被放大
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、搜索越深,哪些模型错误也可能被放大
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、把表示、动态和预测接成可训练的搜索 / 用搜索访问次数核对三个标签
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、保存搜索目标,再沿真实动作展开训练
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读图2与搜索预算实验:学到的模型能否继续规划 / 图3:固定训练预算后,额外搜索能支持到哪里
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、搜索越深,哪些模型错误也可能被放大
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、搜索越深,哪些模型错误也可能被放大
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、搜索越深,哪些模型错误也可能被放大
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:未知动力学下怎样保留搜索优势,二、把表示、动态和预测接成可训练的搜索,四、读图2与搜索预算实验:学到的模型能否继续规划,五、搜索越深,哪些模型错误也可能被放大。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、把表示、动态和预测接成可训练的搜索,四、读图2与搜索预算实验:学到的模型能否继续规划。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:未知动力学下怎样保留搜索优势,二、把表示、动态和预测接成可训练的搜索,四、读图2与搜索预算实验:学到的模型能否继续规划,五、搜索越深,哪些模型错误也可能被放大。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、搜索越深,哪些模型错误也可能被放大。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、搜索越深,哪些模型错误也可能被放大。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、保存搜索目标,再沿真实动作展开训练;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 模型价值等价不等于观测重建:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“模型价值等价不等于观测重建”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
价值等价说明规划所需信息可少于观测重建;不能据此认定未训练动作序列的潜在模型可靠。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补齐潜在展开索引、三个输出与实际奖励/搜索策略/价值目标的对应关系。
正文配图:4 幅
- MuZero在Chess、Shogi、Go和Atari上的训练表现及基线
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形;从左至右Chess、Shogi、Go、Atari,蓝色MuZero、橙色原文基线
[图2](https://arxiv.org/html/1911.08265v2#S4.F2)按训练进程展示棋类Elo与Atari指标:前三个面板依次为Chess、Shogi、Go,最后是57项Atari的人类归一化均值(实线)与中位数(虚线)。蓝色表示MuZero,橙色是原文的AlphaZero或R2D2参照;横轴为百万训练步,不能把棋类Elo与Atari分数直接相比,且每项任务分别训练。[图3](https://arxiv.org/html/1911.08265v2#S4.F3)固定系统后改变搜索计算,部分面板把学习模型与真实规则模拟器对照,支持模型可用于进一步规划,但不证明无限预算仍持续获益。表示、动态和预测网络由奖励/价值/策略监督连接,无像素重构要求不等于潜在状态就是物理真相。 [查看原文](https://arxiv.org/html/1911.08265v2)。
- 原论文Figure 2:四列依次为Chess、Shogi、Go、Atari,保留PDF中的棋盘和游戏样例。前三列蓝线MuZero对照橙线AlphaZero;末列实线与虚线分别为57游戏的均值与中位数,橙线对应R2D2。
实验/结果图 · 必要原图摘引 · PDF第5页; Figure 2
四列依次为Chess、Shogi、Go、Atari,保留PDF中的棋盘和游戏样例。前三列蓝线MuZero对照橙线AlphaZero;末列实线与虚线分别为57游戏的均值与中位数,橙线对应R2D2。
- 原论文Figure 3:(A)检验围棋搜索时间扩展,(B)检验Atari搜索模拟数,(C)(D)是Ms. Pacman训练与搜索消融。四个面板的预算轴不同,不能合读成单一扩展曲线。
实验/结果图 · 必要原图摘引 · HTML S4.F3; Figure 3
(A)检验围棋搜索时间扩展,(B)检验Atari搜索模拟数,(C)(D)是Ms. Pacman训练与搜索消融。四个面板的预算轴不同,不能合读成单一扩展曲线。
- 原论文Figure S2:四块依次汇总Model、Search、Learning Rule和Losses。沿展开步数k将奖励、价值和策略预测与对应目标配对;一般MDP的自举目标与终局游戏目标分开,不能把所有监督写成同一种回报。
方法/设定图 · 必要原图摘引 · PDF第19页; Figure S2
四块依次汇总Model、Search、Learning Rule和Losses。沿展开步数k将奖励、价值和策略预测与对应目标配对;一般MDP的自举目标与终局游戏目标分开,不能把所有监督写成同一种回报。
未逐项复核所有硬件与训练时长;不宣称潜在模型物理可解释
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:搜索预算增加时为何可能利用模型误差?;没有重构损失如何保留关键信息?;模型与搜索各贡献多少需要什么消融?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S4.F2,3:S4.F3
查看本篇 2 个原文证据入口
- 图2 · S4.F2
原站图表/证明入口
- 图3 · S4.F3
原站图表/证明入口
本轮边界:未逐项复核所有硬件与训练时长;不宣称潜在模型物理可解释
本次深化
- 解释表示/动态/预测联合学习,以及奖励、价值和搜索策略的不同监督。
- 手算根先验0.7/0.3经搜索变成0.2/0.8策略标签。
- 核读围棋训练搜索预算与测试扩展,避免宣称无限搜索或单模型通用。
- v2:为三个原始追问逐题增加参考答案:搜索预算增加时为何可能利用模型误差?;没有重构损失如何保留关键信息?;模型与搜索各贡献多少需要什么消融?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S4.F2,3:S4.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补齐潜在展开索引、三个输出与实际奖励/搜索策略/价值目标的对应关系。
查核资料
- arxiv.org · 所列章节
表示/动态/预测训练流程;图2—3及搜索预算说明
技术关系
- 21-alphago · 历史背景
延续先验、价值与搜索协作,但MuZero连规划动态也从数据学习。
- 40-dreamer · 平行方法
均用潜在模型,Dreamer训练可直接执行的Actor,MuZero行动时还执行搜索。
仍需留意
- 未逐项复核所有硬件与训练时长;不宣称潜在模型物理可解释
强化学习Conservative Q-Learning for Offline Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:固定数据之外的高Q由谁纠正
- 二、从相对价值正则看动作梯度怎样改变
- 三、构造冻结TD目标并估计候选动作项
- 四、读离线Atari曲线与D4RL表:保守性何时有用
- 五、区分逐点下界、期望下界与过度保守
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、区分逐点下界、期望下界与过度保守
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、从相对价值正则看动作梯度怎样改变 / 两个动作的保守梯度与缺失好动作
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、构造冻结TD目标并估计候选动作项
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读离线Atari曲线与D4RL表:保守性何时有用 / 理论下界与D4RL归一化指标要各守条件
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、区分逐点下界、期望下界与过度保守
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、区分逐点下界、期望下界与过度保守
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 实验读图中的旧方向指代 → 四、读离线Atari曲线与D4RL表:保守性何时有用
段落迁移后改用明确原表或本节对象,避免错误的前文/下文指向;题答未改。
- 实验读图中的旧方向指代 → 四、读离线Atari曲线与D4RL表:保守性何时有用
段落迁移后改用明确原表或本节对象,避免错误的前文/下文指向;题答未改。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、区分逐点下界、期望下界与过度保守
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:固定数据之外的高Q由谁纠正,二、从相对价值正则看动作梯度怎样改变,四、读离线Atari曲线与D4RL表:保守性何时有用,五、区分逐点下界、期望下界与过度保守。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、从相对价值正则看动作梯度怎样改变,四、读离线Atari曲线与D4RL表:保守性何时有用。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:固定数据之外的高Q由谁纠正,二、从相对价值正则看动作梯度怎样改变,四、读离线Atari曲线与D4RL表:保守性何时有用,五、区分逐点下界、期望下界与过度保守。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、区分逐点下界、期望下界与过度保守。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、区分逐点下界、期望下界与过度保守。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、构造冻结TD目标并估计候选动作项;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用梯度总和检查两个期望是否归一化:借CQL作者讲解中价值端相对分布的视角,自构正则梯度总和为零的归一化单测。
教法来源与实际阅读范围
- BAIR离线RL研究团队 · Offline Reinforcement Learning: How Conservative Algorithms Can Enable New Applications
CQL正则;AntMaze;轨迹片段拼接
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“用梯度总和检查两个期望是否归一化”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
梯度总和为零仅针对固定状态、正确归一化的离散CQL正则;TD项及连续采样近似不受此单测直接保证。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 明确方括号两项与TD损失的分工,补充梯度及平移不变性核对。
正文配图:1 幅
- CQL与QR-DQN和REM在固定前20%在线数据中的四项Atari学习曲线
实验/结果图 · 必要原图摘引 · Figure 1;原HTML图形
这里每个算法只用在线DQN运行前20%的固定样本训练,横轴是训练迭代、纵轴是游戏回报。CQL在Pong和Breakout较强,但Seaquest后期的REM更高,展示保守性并不等于每个时间点、每个任务都获胜;这组数据条件也不同于下文表3的1%或10%数据。
未在正文展示的图/表与范围
- 表3:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
- 表1:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
- 表2:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未逐行验证NTK扩展证明;原有全部实验数值本轮未重算
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:α如何同时影响安全性和收益?;连续动作积分近似会引入什么误差?;“数据动作好”在劣质数据中是否成立?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
本轮边界:未逐行验证NTK扩展证明;原有全部实验数值本轮未重算
本次深化
- 从保守正则梯度解释数据内外价值压力,区分逐点与策略期望下界。
- 手算两动作正则梯度及未知高Q的更强压低作用。
- 限定定理条件与D4RL分数含义,不把神经Q写成永久逐点下界。
- v2:为三个原始追问逐题增加参考答案:α如何同时影响安全性和收益?;连续动作积分近似会引入什么误差?;“数据动作好”在劣质数据中是否成立?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:明确方括号两项与TD损失的分工,补充梯度及平移不变性核对。
查核资料
- arxiv.org · 所列章节
§3.1 Theorem 3.1—3.2及式1—2;保守Q目标解释
技术关系
仍需留意
- 未逐行验证NTK扩展证明;原有全部实验数值本轮未重算
强化学习AWAC: Accelerating Online Reinforcement Learning with Offline Datasets部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:离线起步怎样平滑接入在线学习
- 二、把KL约束的策略改进投影成加权回归
- 三、混合旧新回放并持续更新Actor与Critic
- 四、沿图3的上线边界读初期退化与后续进步
- 五、Actor贴近数据,Critic仍可能查询陌生动作
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、Actor贴近数据,Critic仍可能查询陌生动作
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、把KL约束的策略改进投影成加权回归 / 两条数据动作怎样获得不同模仿强度
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、混合旧新回放并持续更新Actor与Critic
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、沿图3的上线边界读初期退化与后续进步 / 真实机器人还要计入先验数据、奖励与重置
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、Actor贴近数据,Critic仍可能查询陌生动作
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、Actor贴近数据,Critic仍可能查询陌生动作
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、Actor贴近数据,Critic仍可能查询陌生动作
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:离线起步怎样平滑接入在线学习,二、把KL约束的策略改进投影成加权回归,四、沿图3的上线边界读初期退化与后续进步,五、Actor贴近数据,Critic仍可能查询陌生动作。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、把KL约束的策略改进投影成加权回归,四、沿图3的上线边界读初期退化与后续进步。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:离线起步怎样平滑接入在线学习,二、把KL约束的策略改进投影成加权回归,四、沿图3的上线边界读初期退化与后续进步,五、Actor贴近数据,Critic仍可能查询陌生动作。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、Actor贴近数据,Critic仍可能查询陌生动作。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、Actor贴近数据,Critic仍可能查询陌生动作。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、混合旧新回放并持续更新Actor与Critic;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 指数优势权重的比值更直接说明选择性:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“指数优势权重的比值更直接说明选择性”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
指数权重之比只比较同一状态的未裁剪权重;状态归一化常数、有限batch和裁剪会改变整体训练权重,未新增实验成绩。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补入KL驻点推导与Z(s)省略改变跨状态权重的边界。
- 补齐图3横纵轴、上线下跌和行为模型失配读法。
正文配图:2 幅
- AWAC在HalfCheetah上离线初始化、在线微调与行为密度模型诊断
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形;面板1–3为平均回报,面板4为行为数据对数似然;保留对应图例
前三个面板的横轴是在线环境步数,纵轴是平均回报,分别比较利用旧数据、Actor–Critic和显式策略约束的方法。第二面板箭头标出的上线初期下跌,说明高预训练分不保证平滑衔接。第四面板改画行为模型对离线/在线数据的对数似然,虚线分界前后对应离线训练与在线阶段;似然下降支持“行为模型追不上新分布”的诊断,不是策略回报又下降了同样数值。
- 原论文Figure 2:左半是既有数据上的离线学习,右半加入新交互做在线微调。沿数据进入缓存的箭头区分两个阶段,不把在线改善全算作离线学习收益。
方法/设定图 · 必要原图摘引 · HTML S1.F2; Figure 2
左半是既有数据上的离线学习,右半加入新交互做在线微调。沿数据进入缓存的箭头区分两个阶段,不把在线改善全算作离线学习收益。
机器人试验全部数字与各任务数据量未逐项复核;未复现
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:Q误差如何经指数权重放大?;旧数据和新数据比例如何影响适应?;与IQL的Critic目标为什么不同?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S1.F2,3:S3.F3
查看本篇 2 个原文证据入口
- 图2 · S1.F2
原站图表/证明入口
- 图3 · S3.F3
原站图表/证明入口
本轮边界:机器人试验全部数字与各任务数据量未逐项复核;未复现
本次深化
- 解释优势加权似然如何衔接离线起步与在线微调,区分温度和支持约束。
- 手算优势0/2的模仿权重,说明指数也会放大Critic误差。
- 核读上线初期回退,要求同时计入离线数据、预训练和新增交互。
- v2:为三个原始追问逐题增加参考答案:Q误差如何经指数权重放大?;旧数据和新数据比例如何影响适应?;与IQL的Critic目标为什么不同?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S1.F2,3:S3.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补入KL驻点推导与Z(s)省略改变跨状态权重的边界。
- 第三版:补齐图3横纵轴、上线下跌和行为模型失配读法。
查核资料
- arxiv.org · 所列章节
优势加权更新与离线/在线设定;图3衔接分析
技术关系
仍需留意
- 机器人试验全部数字与各任务数据量未逐项复核;未复现
强化学习Decision Transformer: Reinforcement Learning via Sequence Modeling部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不学Bellman价值能否直接生成好动作
- 二、把剩余回报放进因果序列,并推清执行递推
- 三、生成RTG标签、遮住未来动作并滚动更新目标
- 四、读图4的请求—实得关系,再看延迟奖励实验
- 五、高回报条件不能替代可达性与轨迹覆盖
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、高回报条件不能替代可达性与轨迹覆盖
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、把剩余回报放进因果序列,并推清执行递推 / 剩余目标10、8、5与不可控硬币
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、生成RTG标签、遮住未来动作并滚动更新目标
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读图4的请求—实得关系,再看延迟奖励实验 / 延迟奖励与图任务没有证明一般稀疏探索
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、高回报条件不能替代可达性与轨迹覆盖
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、高回报条件不能替代可达性与轨迹覆盖
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、高回报条件不能替代可达性与轨迹覆盖
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:不学Bellman价值能否直接生成好动作,二、把剩余回报放进因果序列,并推清执行递推,四、读图4的请求—实得关系,再看延迟奖励实验,五、高回报条件不能替代可达性与轨迹覆盖。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、把剩余回报放进因果序列,并推清执行递推,四、读图4的请求—实得关系,再看延迟奖励实验。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:不学Bellman价值能否直接生成好动作,二、把剩余回报放进因果序列,并推清执行递推,四、读图4的请求—实得关系,再看延迟奖励实验,五、高回报条件不能替代可达性与轨迹覆盖。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、高回报条件不能替代可达性与轨迹覆盖。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、高回报条件不能替代可达性与轨迹覆盖。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、生成RTG标签、遮住未来动作并滚动更新目标;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 区分剩余目标与状态价值估计:在本篇原公式和接口上给出具体条件检查或教学推演;删去与原段重复的新增摘要。
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“区分剩余目标与状态价值估计”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
RTG递推是剩余请求的记账,不是Critic价值估计或可达性证明;折扣变体须与训练标签一致。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充因果输入边界、无折扣恒等式和明确标为教学的折扣扩展。
- 补充目标/实际双轴、理想线、数据最佳竖线及失配案例。
正文配图:2 幅
- Decision Transformer设定目标回报与实得回报的任务对照图
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形
图4每个面板横轴是请求的归一化目标回报,纵轴是实际获得的归一化表现;这不是训练时间曲线。绿色斜虚线是“实际恰好实现请求”的理想参照,橙色竖虚线是数据集中最好轨迹的回报,蓝线是DT。Pong在较高请求区域回落、Qbert与Reacher未跟随理想线,说明条件数值能调行为却不能提供无限可达性;还要区分“超过数据最佳”的区域与普通插值区域。
- 原论文Figure 1:序列中回报目标、状态、动作先分别嵌入,再经因果注意力预测后续动作。回报目标是条件输入,不能仅由这个结构保证能达到任意指定回报。
方法/设定图 · 必要原图摘引 · HTML S0.F1; Figure 1
序列中回报目标、状态、动作先分别嵌入,再经因果注意力预测后续动作。回报目标是条件输入,不能仅由这个结构保证能达到任意指定回报。
未在正文展示的图/表与范围
- 表7:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未复现;不把随机结果条件化等同可控回报
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:RTG调参会怎样影响公平比较?;未来奖励条件是否可能携带不可控随机性?;何种任务需要TD式拼接而序列BC做不到?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S0.F1,4:S5.F4
查看本篇 2 个原文证据入口
- 图1 · S0.F1
原站图表/证明入口
- 图4 · S5.F4
原站图表/证明入口
本轮边界:未复现;不把随机结果条件化等同可控回报
本次深化
- 解释RTG条件序列、因果mask与动作监督,区别于Bellman价值传播。
- 手算RTG递减10→8→5,并用随机硬币说明条件回报不保证可达。
- 核读延迟奖励Hopper及引用基线口径,不外推任意稀疏探索或轨迹拼接。
- v2:为三个原始追问逐题增加参考答案:RTG调参会怎样影响公平比较?;未来奖励条件是否可能携带不可控随机性?;何种任务需要TD式拼接而序列BC做不到?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S0.F1,4:S5.F4
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充因果输入边界、无折扣恒等式和明确标为教学的折扣扩展。
- 第三版:补充目标/实际双轴、理想线、数据最佳竖线及失配案例。
查核资料
- arxiv.org · 所列章节
§3序列与训练;§5.6表7;附录回报条件与图任务
技术关系
仍需留意
- 未复现;不把随机结果条件化等同可控回报
强化学习A Minimalist Approach to Offline Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一个简单BC项能解决多少离线问题
- 二、沿Actor动作求导:高Q推动与数据动作回拉
- 三、统一状态尺度并在延迟更新步加入BC
- 四、先读实现删减图,再比较版本与评价波动
- 五、平方距离与尺度归一化分别留下什么缺口
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、平方距离与尺度归一化分别留下什么缺口
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、沿Actor动作求导:高Q推动与数据动作回拉 / 一维最优动作与多峰均值的反例
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、统一状态尺度并在延迟更新步加入BC
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、先读实现删减图,再比较版本与评价波动 / 数据版本、AntMaze例外与两类评估波动
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、平方距离与尺度归一化分别留下什么缺口
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、平方距离与尺度归一化分别留下什么缺口
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、平方距离与尺度归一化分别留下什么缺口
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:一个简单BC项能解决多少离线问题,二、沿Actor动作求导:高Q推动与数据动作回拉,四、先读实现删减图,再比较版本与评价波动,五、平方距离与尺度归一化分别留下什么缺口。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、沿Actor动作求导:高Q推动与数据动作回拉,四、先读实现删减图,再比较版本与评价波动。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:一个简单BC项能解决多少离线问题,二、沿Actor动作求导:高Q推动与数据动作回拉,四、先读实现删减图,再比较版本与评价波动,五、平方距离与尺度归一化分别留下什么缺口。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、平方距离与尺度归一化分别留下什么缺口。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、平方距离与尺度归一化分别留下什么缺口。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、统一状态尺度并在延迟更新步加入BC;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 乘法缩放与加法平移为何影响不同:由原论文批量Q尺度系数独立展开乘法与加法变换,补足归一化适用条件,不重复原有BC梯度。
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“乘法缩放与加法平移为何影响不同”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
Q缩放与平移对照冻结批次和Critic,且忽略数值保护激活;不声称重新训练或任意奖励变换后策略不变。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补入Q梯度与BC拉回项的显式分解,连接已有教学例子。
- 解码图1横轴数据组合并澄清该图是简化实现的诊断。
正文配图:3 幅
- CQL和Fisher-BRC简化实现后各离线数据任务的性能百分比变化
实验/结果图 · 必要原图摘引 · Figure 1;原HTML图形
这张柱状图是在诊断其他离线方法的实现调整,不是TD3+BC与它们的成绩差。横轴缩写由任务与数据质量组合:HC为HalfCheetah、Hop为Hopper、W为Walker;r/m/mr/me/e分别表示随机、中等、中等回放、中等加专家和专家数据。每根柱只比较同一组合中“删去调整”相对原实现的变化;跨数据集把负百分比直接相加,没有统一任务含义。
- 原论文Figure 2:这张图比较同一最终评估中十个回合的最差回合偏差。横轴同时编码环境与数据类型,负柱表示评估内的不稳定,不能与跨检查点波动混淆。
实验/结果图 · 必要原图摘引 · HTML S4.F2; Figure 2
这张图比较同一最终评估中十个回合的最差回合偏差。横轴同时编码环境与数据类型,负柱表示评估内的不稳定,不能与跨检查点波动混淆。
- 原论文Figure 3:这张图改为最后十次评估中的最差检查点偏差。它与前图分别测量时间上的波动和单次评估内部的波动,二者不能相加当作统一误差条。
实验/结果图 · 必要原图摘引 · HTML S4.F3; Figure 3
这张图改为最后十次评估中的最差检查点偏差。它与前图分别测量时间上的波动和单次评估内部的波动,二者不能相加当作统一误差条。
未在正文展示的图/表与范围
- 表5:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未复现;未逐点核对所有检查点波动
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:多峰动作分布为何会使MSE危险?;奖励平移与缩放对λ有什么不同影响?;最佳检查点与末段平均会产生多大差异?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S4.F1,2:S4.F2,3:S4.F3
查看本篇 3 个原文证据入口
- 图1 · S4.F1
原站图表/证明入口
- 图2 · S4.F2
原站图表/证明入口
- 图3 · S4.F3
原站图表/证明入口
本轮边界:未复现;未逐点核对所有检查点波动
本次深化
- 拆解TD3价值项、BC距离项与尺度处理,区分均方距离和支持约束。
- 手算λ改变最优动作,并以双峰数据展示均值动作可能无效。
- 核读D4RL版本、AntMaze去归一化和五种子末段评价,限定简洁基线适用范围。
- v2:为三个原始追问逐题增加参考答案:多峰动作分布为何会使MSE危险?;奖励平移与缩放对λ有什么不同影响?;最佳检查点与末段平均会产生多大差异?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S4.F1,2:S4.F2,3:S4.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补入Q梯度与BC拉回项的显式分解,连接已有教学例子。
- 第三版:解码图1横轴数据组合并澄清该图是简化实现的诊断。
查核资料
- arxiv.org · 所列章节
目标与Q尺度式3—5;附录C.1—C.3数据版本及AntMaze
技术关系
- 31-td3 · 直接继承
Critic大体沿用,Actor加入BC且增加状态规范化。
- 37-bcq · 平行方法
动作距离拉回与生成候选支持限制具有不同几何。
- 44-decision-transformer · 平行方法
同年代离线替代路线,比较需统一数据版本。
仍需留意
- 未复现;未逐点核对所有检查点波动
强化学习Offline Reinforcement Learning with Implicit Q-Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不查询数据外动作怎样继续改进价值
- 二、先聚合动作Q,再传播V,最后提取策略
- 三、冻结回归目标并把三个更新接口分开
- 四、读AntMaze的τ消融:价值如何沿数据路径传播
- 五、支持内价值改进不等于支持内动作输出
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、支持内价值改进不等于支持内动作输出
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、先聚合动作Q,再传播V,最后提取策略 / 两个动作的expectile与幸运回报反例
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、冻结回归目标并把三个更新接口分开
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读AntMaze的τ消融:价值如何沿数据路径传播 / toy maze的拼接证据与在线微调预算
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、支持内价值改进不等于支持内动作输出
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、支持内价值改进不等于支持内动作输出
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、支持内价值改进不等于支持内动作输出
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:不查询数据外动作怎样继续改进价值,二、先聚合动作Q,再传播V,最后提取策略,四、读AntMaze的τ消融:价值如何沿数据路径传播,五、支持内价值改进不等于支持内动作输出。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、先聚合动作Q,再传播V,最后提取策略,四、读AntMaze的τ消融:价值如何沿数据路径传播。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:不查询数据外动作怎样继续改进价值,二、先聚合动作Q,再传播V,最后提取策略,四、读AntMaze的τ消融:价值如何沿数据路径传播,五、支持内价值改进不等于支持内动作输出。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、支持内价值改进不等于支持内动作输出。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、支持内价值改进不等于支持内动作输出。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、冻结回归目标并把三个更新接口分开;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 所有数据动作Q相同时,τ不能创造改进空间:在本篇原公式和接口上给出具体条件检查或教学推演;删去与原段重复的新增摘要。
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“所有数据动作Q相同时,τ不能创造改进空间”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
所有Q相等的退化检查限定0<τ<1与固定目标Q;高expectile不能恢复完全缺失行为。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充四面板分组、纵轴与离线梯度步含义;保留已有expectile推导和三组手算例子。
正文配图:3 幅
- IQL改变expectile系数τ后在四项AntMaze任务中的回报
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
四个面板把迷宫大小(medium/large)与数据类型(play/diverse)交叉展开,纵轴在图中标为Episode Return,横轴Gradient Steps以百万次更新为单位。因此蓝线较高回答的是相同离线更新进度下的控制表现,不能说它用这些步数新采集了成功路径。三种颜色只改变所测 $\tau$;本文前面的 $\beta$ 是Actor提取参数,不能把这张图当作两者联合调参结果。
- 原论文Figure 1:从左到右为非对称平方损失、正态分布的expectile和条件expectile拟合。提高τ增大正残差权重,不等于取分位数或精确最大值。
方法/设定图 · 必要原图摘引 · HTML S4.F1; Figure 1
从左到右为非对称平方损失、正态分布的expectile和条件expectile拟合。提高τ增大正残差权重,不等于取分位数或精确最大值。
- 原论文Figure 2:四块从左到右、从上到下是(a)迷宫、(b)真实最优价值、(c)单步策略评价、(d)IQL。共用色标表示价值;IQL更好传播高价值不意味着数据之外动作得到可靠评价。
方法/设定图 · 必要原图摘引 · HTML S5.F2; Figure 2
四块从左到右、从上到下是(a)迷宫、(b)真实最优价值、(c)单步策略评价、(d)IQL。共用色标表示价值;IQL更好传播高价值不意味着数据之外动作得到可靠评价。
未逐项复核D4RL全部任务预算、种子和代码实现
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:为什么expectile必须放在动作Q而非任意随机回报上?;τ和β分别控制哪个环节?;不查OOD动作为什么不等于绝不输出OOD动作?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S4.F1,2:S5.F2,3:S5.F3
查看本篇 3 个原文证据入口
- 图1 · S4.F1
原站图表/证明入口
- 图2 · S5.F2
原站图表/证明入口
- 图3 · S5.F3
原站图表/证明入口
本轮边界:未逐项复核D4RL全部任务预算、种子和代码实现
本次深化
- 推导expectile平衡、真实转移Bellman回归与优势加权提取三个步骤。
- 手算V=2.6及动作权重,再用单动作随机奖励反驳对回报噪声取高expectile。
- 核读toy maze价值传播,区分离线改进、在线微调和部署支持保证。
- v2:为三个原始追问逐题增加参考答案:为什么expectile必须放在动作Q而非任意随机回报上?;τ和β分别控制哪个环节?;不查OOD动作为什么不等于绝不输出OOD动作?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S4.F1,2:S5.F2,3:S5.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充四面板分组、纵轴与离线梯度步含义;保留已有expectile推导和三组手算例子。
查核资料
- arxiv.org · 所列章节
方法中的expectile三步更新、理论条件及§5图2 toy maze解释
技术关系
仍需留意
- 未逐项复核D4RL全部任务预算、种子和代码实现
强化学习Training language models to follow instructions with human feedback部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样把用户偏好变成语言模型的训练信号
- 二、接通SFT、排序奖励与两种策略参照
- 三、冻结RM与参考策略,交替生成和PPO更新
- 四、读人类偏好图,并把ptx的能力与成本另列
- 五、偏好改善的范围由谁评价、评什么来界定
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 七、帮助建立理解 / 教学例子 → 二、接通SFT、排序奖励与两种策略参照 / 分别算参考惩罚、旧策略裁剪与ptx梯度
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、冻结RM与参考策略,交替生成和PPO更新
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读人类偏好图,并把ptx的能力与成本另列 / PPO-ptx缓解回退时新增了多少训练
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、偏好改善的范围由谁评价、评什么来界定
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、偏好改善的范围由谁评价、评什么来界定
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、偏好改善的范围由谁评价、评什么来界定
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:怎样把用户偏好变成语言模型的训练信号,二、接通SFT、排序奖励与两种策略参照,四、读人类偏好图,并把ptx的能力与成本另列,五、偏好改善的范围由谁评价、评什么来界定。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、接通SFT、排序奖励与两种策略参照,四、读人类偏好图,并把ptx的能力与成本另列。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:怎样把用户偏好变成语言模型的训练信号,二、接通SFT、排序奖励与两种策略参照,四、读人类偏好图,并把ptx的能力与成本另列,五、偏好改善的范围由谁评价、评什么来界定。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、偏好改善的范围由谁评价、评什么来界定。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、偏好改善的范围由谁评价、评什么来界定。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、冻结RM与参考策略,交替生成和PPO更新;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 新一轮更新开始时,哪个概率比应等于1:采用RLHF专业讲解中采样策略与参考模型分工,推成更新前ratio应为1但参考比可非零的实现检查。
教法来源与实际阅读范围
- Nathan Lambert等Hugging Face作者 · Illustrating Reinforcement Learning from Human Feedback
奖励模型、语言模型策略、token动作和KL组合
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“新一轮更新开始时,哪个概率比应等于1”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
ratio=1检查只适用于更新前同一采样策略、token掩码与计算设置;参考KL仍可非零。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充Bradley–Terry概率到损失的推导及符号定义。
- 补齐图1模型规模、固定SFT参照和95%CI的读法。
正文配图:1 幅
- 不同规模GPT、SFT、PPO和PPO-ptx相对175B SFT的人类偏好胜率
实验/结果图 · 必要原图摘引 · Figure 1;原HTML图形
横轴是模型参数规模1.3B、6B、175B,按对数尺度排布;纵轴是相对同一个175B SFT参考回答的偏好胜率,0.5虚线表示打平参考。不同颜色区分训练方式,因此应先在同一规模比较训练改变,再跨规模比较;图中的误差条是评价的95%置信区间,不是三种规模训练出来的方差。小模型偏好更高可支持“训练方式很重要”,却不能把纵轴换成知识或推理总能力。
未重跑人类评测,未逐项审核标注者组成、全部任务与训练日志
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:RM和Critic为何不能混为一谈?;如何检查回答变长造成的评价偏差?;小对齐模型优于大基础模型的结论边界在哪?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S0.F1
查看本篇 1 个原文证据入口
- 图1 · S0.F1
原站图表/证明入口
本轮边界:未重跑人类评测,未逐项审核标注者组成、全部任务与训练日志
本次深化
- 拆开SFT、奖励模型、价值函数及PPO-ptx,明确旧策略与参考策略不同。
- 手算回答KL惩罚与PPO比率裁剪,区分偏好优化和预训练保持梯度。
- 核读附录E.6能力回退与八倍预训练样本,保留人类偏好和总计算边界。
- v2:为三个原始追问逐题增加参考答案:RM和Critic为何不能混为一谈?;如何检查回答变长造成的评价偏差?;小对齐模型优于大基础模型的结论边界在哪?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S0.F1
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充Bradley–Terry概率到损失的推导及符号定义。
- 第三版:补齐图1模型规模、固定SFT参照和95%CI的读法。
查核资料
- arxiv.org · 所列章节
三阶段训练方法、PPO-ptx目标及附录E.6能力回退与预算讨论
技术关系
仍需留意
- 未重跑人类评测,未逐项审核标注者组成、全部任务与训练日志
强化学习Mastering Diverse Domains through World Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同一世界模型配方怎样跨越任务尺度
- 二、用尺度变换与分布目标稳住模型和行为学习
- 三、编码预测目标,平衡KL,再展开想象更新
- 四、读图6:组件、学习信号与额外计算分别贡献什么
- 五、公共配置与跨任务通用性的证据边界
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、公共配置与跨任务通用性的证据边界
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、用尺度变换与分布目标稳住模型和行为学习 / 三个原始值桶与100倍奖励尺度
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、编码预测目标,平衡KL,再展开想象更新
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读图6:组件、学习信号与额外计算分别贡献什么 / 修订版配置与样本效率不能省略计算
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、公共配置与跨任务通用性的证据边界
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、公共配置与跨任务通用性的证据边界
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、公共配置与跨任务通用性的证据边界
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:同一世界模型配方怎样跨越任务尺度,二、用尺度变换与分布目标稳住模型和行为学习,四、读图6:组件、学习信号与额外计算分别贡献什么,五、公共配置与跨任务通用性的证据边界。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、用尺度变换与分布目标稳住模型和行为学习,四、读图6:组件、学习信号与额外计算分别贡献什么。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:同一世界模型配方怎样跨越任务尺度,二、用尺度变换与分布目标稳住模型和行为学习,四、读图6:组件、学习信号与额外计算分别贡献什么,五、公共配置与跨任务通用性的证据边界。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、公共配置与跨任务通用性的证据边界。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、公共配置与跨任务通用性的证据边界。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、编码预测目标,平衡KL,再展开想象更新;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 压缩数值不意味着删除奖励符号:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“压缩数值不意味着删除奖励符号”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
symlog/symexp和桶期望沿所用修订版定义;非线性逆变换不能与期望交换,也不支持桶外无界外推。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充two-hot线性权重、期望保持与有限桶范围,锁定v2公式。
- 补齐图6左右聚合口径、四种干预与计算预算区别。
正文配图:4 幅
- DreamerV3鲁棒组件与学习信号消融以及模型规模和回放比例扩展
实验/结果图 · 必要原图摘引 · Figure 6;原HTML图形
图6左上/左下是14任务归一化后的平均曲线,两轴的百分比不是单一任务成功率;左上移除稳健性组件,左下切断不同学习信号。右上/右下则分别在Crafter与DMLab Goals画任务回报对百万环境步,颜色代表模型参数量或回放比。先在同一任务、同一横轴预算比较,再看跨任务平均;左边平均变好仍允许少数任务退化,右边更高回报则消耗了不同训练计算。
- 原论文Figure 1:左侧按基准分别标明任务数和环境步,右侧是Minecraft钻石学习过程。不同基准的柱高不可直接相加,Minecraft最大值曲线也不能代替平均表现。
实验/结果图 · 必要原图摘引 · HTML S0.F1; Figure 1
左侧按基准分别标明任务数和环境步,右侧是Minecraft钻石学习过程。不同基准的柱高不可直接相加,Minecraft最大值曲线也不能代替平均表现。
- 原论文Figure 3:左侧为世界模型学习,右侧为潜空间Actor–Critic学习;分别沿编码、重建和想象箭头读信息流。想象轨迹依赖学得模型,并非新增真实交互。
方法/设定图 · 必要原图摘引 · HTML Sx1.F3; Figure 3
左侧为世界模型学习,右侧为潜空间Actor–Critic学习;分别沿编码、重建和想象箭头读信息流。想象轨迹依赖学得模型,并非新增真实交互。
- 原论文Figure 4:上组为DMLab迷宫,下组为四足运动;每组True与Model成对保留。前5帧提供上下文,后续预测没有中间真图输入,视觉接近仍不能单独证明控制价值准确。
实验/结果图 · 必要原图摘引 · HTML Sx2.F4; Figure 4
上组为DMLab迷宫,下组为四足运动;每组True与Model成对保留。前5帧提供上下文,后续预测没有中间真图输入,视觉接近仍不能单独证明控制价值准确。
未逐版本比对首版与修订版,未复核所有领域训练种子与开销
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:固定超参数具体包括哪些,不包括哪些?;预测更清晰是否一定提高控制?;首版与后续修订结果应怎样引用?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S0.F1,3:Sx1.F3,4:Sx2.F4,6:Sx2.F6
查看本篇 4 个原文证据入口
- 图1 · S0.F1
原站图表/证明入口
- 图3 · Sx1.F3
原站图表/证明入口
- 图4 · Sx2.F4
原站图表/证明入口
- 图6 · Sx2.F6
原站图表/证明入口
本轮边界:未逐版本比对首版与修订版,未复核所有领域训练种子与开销
本次深化
- 解释尺度稳健组件及symexp原始值桶读出,区分同配方和单一通用模型。
- 用三桶手算原始值期望2与先平均变换坐标后的约1.83。
- 核读图6消融与扩展成本,分开2023首发与修订版新增结果。
- v2:为三个原始追问逐题增加参考答案:固定超参数具体包括哪些,不包括哪些?;预测更清晰是否一定提高控制?;首版与后续修订结果应怎样引用?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S0.F1,3:Sx1.F3,4:Sx2.F4,6:Sx2.F6
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充two-hot线性权重、期望保持与有限桶范围,锁定v2公式。
- 第三版:补齐图6左右聚合口径、四种干预与计算预算区别。
查核资料
- arxiv.org · 所列章节
修订正文鲁棒预测、symexp two-hot公式、想象学习与图6消融
技术关系
- 40-dreamer · 直接继承
本篇继承潜在想象学习,重点转向跨任务数值稳健与扩展。
- 15-gae · 教学联系
λ加权回报共享多步偏差方差思路,但Dreamer的模型内回报目标不能直接当成GAE原论文实验。
仍需留意
- 未逐版本比对首版与修订版,未复核所有领域训练种子与开销
强化学习Direct Preference Optimization: Your Language Model is Secretly a Reward Model部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:偏好对能否直接训练带参考约束的策略
- 二、从KL正则最优策略消去奖励与分区函数
- 三、累加回答token概率并优化参考校正间隔
- 四、分开读奖励—KL前沿与摘要胜率
- 五、相对间隔改善仍留下离线覆盖与过拟合风险
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 三、累加回答token概率并优化参考校正间隔
把影响复现的概率归约或调度版本规则集中放到实现流程之前。
- 七、帮助建立理解 / 教学例子 → 二、从KL正则最优策略消去奖励与分区函数 / 同一偏好对的间隔与绝对概率
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、累加回答token概率并优化参考校正间隔
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、分开读奖励—KL前沿与摘要胜率 / 解析等价与离线数据收集成本分别核查
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、相对间隔改善仍留下离线覆盖与过拟合风险
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、相对间隔改善仍留下离线覆盖与过拟合风险
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、相对间隔改善仍留下离线覆盖与过拟合风险
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:偏好对能否直接训练带参考约束的策略,二、从KL正则最优策略消去奖励与分区函数,四、分开读奖励—KL前沿与摘要胜率,五、相对间隔改善仍留下离线覆盖与过拟合风险。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、从KL正则最优策略消去奖励与分区函数,四、分开读奖励—KL前沿与摘要胜率。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:偏好对能否直接训练带参考约束的策略,二、从KL正则最优策略消去奖励与分区函数,四、分开读奖励—KL前沿与摘要胜率,五、相对间隔改善仍留下离线覆盖与过拟合风险。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、相对间隔改善仍留下离线覆盖与过拟合风险。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、相对间隔改善仍留下离线覆盖与过拟合风险。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、累加回答token概率并优化参考校正间隔;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 序列概率比怎样连接每个token:对照TRL的序列log概率、掩码与偏好margin接口,强调回答token求和与改变长度归约的后果。
教法来源与实际阅读范围
- Hugging Face TRL维护者 · DPO Trainer
same-prompt pairs;参考log比;IPO loss类型说明
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“序列概率比怎样连接每个token”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
回答token求和与提示掩码按原序列目标解释;更换长度归约改变margin,离线loss不保证新回答质量。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补齐奖励—KL等成本比较、温度扫描和0.5基准;保留已完整的解析推导与概率反例。
正文配图:1 幅
- DPO的奖励-KL前沿与TLDR摘要胜率随采样温度变化
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形
左面板每个点是一组训练设置下的IMDb奖励与参考KL,横轴越右表示偏离参考更多,纵轴越高表示受控情感奖励更高;应比较相近KL处的奖励,而非把全部点按训练先后连起来。右面板横轴改为生成温度,纵轴是摘要相对参考的评价胜率,0.5虚线为打平。DPO与PPO的差距会随温度改变,说明训练目标和解码设置共同决定结果;两张图的横轴、奖励与胜率不能互换。
未独立复现,未逐项审计各基线调参与偏好数据覆盖
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:降低DPO loss是否保证正回答概率上升?;偏好数据可分离时为什么可能过拟合?;与在线PPO比较应如何计算数据收集成本?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S6.F2
查看本篇 1 个原文证据入口
- 图2 · S6.F2
原站图表/证明入口
本轮边界:未独立复现,未逐项审计各基线调参与偏好数据覆盖
本次深化
- 从KL正则解析策略推导奖励对数比及同提示分区函数消去。
- 手算偏好概率2/3,并展示chosen绝对概率下降仍可能改善相对间隔。
- 界定解析等价、离线支持和实验范围,不将DPO泛称通用PPO替代品。
- v2:为三个原始追问逐题增加参考答案:降低DPO loss是否保证正回答概率上升?;偏好数据可分离时为什么可能过拟合?;与在线PPO比较应如何计算数据收集成本?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S6.F2
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补齐奖励—KL等成本比较、温度扫描和0.5基准;保留已完整的解析推导与概率反例。
查核资料
- arxiv.org · 所列章节
§4解析最优策略、分区函数消去、偏好损失与实验设置
技术关系
- 47-instructgpt · 直接继承
本篇重写其代表的KL正则RLHF问题,改变优化接口。
- 50-ipo · 直接继承
后作IPO针对确定性经验偏好下间隔无限增长的风险提出有限目标。
- 51-kto · 平行方法
KTO改变反馈形态,允许单回答的好坏标签;不是给DPO换一个别名。
仍需留意
- 未独立复现,未逐项审计各基线调参与偏好数据覆盖
强化学习A General Theoretical Paradigm to Understand Learning from Human Preferences部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:经验偏好全胜时为什么还要限制间隔
- 二、从ΨPO的有界偏好目标走到有限margin回归
- 三、计算参考对数比并对过大的间隔施加回拉
- 四、读三动作概率曲线:正则是否保住未比较的动作
- 五、有限目标能控制什么,不能修复什么
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、有限目标能控制什么,不能修复什么
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、从ΨPO的有界偏好目标走到有限margin回归 / 越过h=1之后两种损失走向不同
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、计算参考对数比并对过大的间隔施加回拉
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读三动作概率曲线:正则是否保住未比较的动作 / 构造反例不能替代大规模泛化证据
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、有限目标能控制什么,不能修复什么
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、有限目标能控制什么,不能修复什么
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、有限目标能控制什么,不能修复什么
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:经验偏好全胜时为什么还要限制间隔,二、从ΨPO的有界偏好目标走到有限margin回归,四、读三动作概率曲线:正则是否保住未比较的动作,五、有限目标能控制什么,不能修复什么。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、从ΨPO的有界偏好目标走到有限margin回归,四、读三动作概率曲线:正则是否保住未比较的动作。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:经验偏好全胜时为什么还要限制间隔,二、从ΨPO的有界偏好目标走到有限margin回归,四、读三动作概率曲线:正则是否保住未比较的动作,五、有限目标能控制什么,不能修复什么。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、有限目标能控制什么,不能修复什么。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、有限目标能控制什么,不能修复什么。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、计算参考对数比并对过大的间隔施加回拉;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 平方间隔目标会在超过目标后反向拉回:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“平方间隔目标会在超过目标后反向拉回”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
平方间隔导数只说明单对目标形状;有限margin不修复错误偏好、缺失覆盖或神经网络泛化。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
正文配图:2 幅
- IPO与DPO在数据集D3和三个正则强度下的三动作概率学习曲线
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形
理论的关键不是把“有限margin”当口号,而是identity偏好目标导出具有有限目标间隔的平方损失,避免可分离经验偏好下持续拉大比率差。[图1](https://arxiv.org/html/2310.12036#S5.F1)和[图2](https://arxiv.org/html/2310.12036#S5.F2)在构造数据集上追踪动作概率随学习的变化,对比IPO与DPO的正则行为。图2左列DPO在三个参数设置都把未出现在偏好比较中的第三动作概率推近零;右列IPO在更强正则下保留其概率,蓝橙两条则共享其余质量。横轴是优化步、纵轴是动作概率;这类可控反例支撑机制区别,不建立所有大模型任务的性能排名。长度归一化、噪声与正则系数仍需按实际实现检验。 [查看原文](https://arxiv.org/html/2310.12036)。
- 原论文Figure 1:左列DPO、右列IPO;三行τ分别为0.1、0.5、1.0。纵轴是三种动作的概率,不是模型胜率;比较的是指定偏好数据构造下是否走向过度确定化。
实验/结果图 · 必要原图摘引 · HTML S5.F1; Figure 1
左列DPO、右列IPO;三行τ分别为0.1、0.5、1.0。纵轴是三种动作的概率,不是模型胜率;比较的是指定偏好数据构造下是否走向过度确定化。
未逐项核实附录证明与全部数值实验,未声称神经参数化的全局收敛
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:偏好噪声增加时目标margin应怎样选择?;理论序列log概率与库的长度归一化有何差异?;有限margin是否真的改善独立测试而非只降低KL?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S5.F1,2:S5.F2
查看本篇 2 个原文证据入口
- 图1 · S5.F1
原站图表/证明入口
- 图2 · S5.F2
原站图表/证明入口
本轮边界:未逐项核实附录证明与全部数值实验,未声称神经参数化的全局收敛
本次深化
- 从ΨPO的有界偏好目标推导IPO有限间隔,解释确定性经验标签过拟合。
- 手算目标间隔1的平方损失与DPO持续增大间隔的差异。
- 核读§4–5理论及支持条件,不宣称任意神经模型泛化或全局收敛。
- v2:为三个原始追问逐题增加参考答案:偏好噪声增加时目标margin应怎样选择?;理论序列log概率与库的长度归一化有何差异?;有限margin是否真的改善独立测试而非只降低KL?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S5.F1,2:S5.F2
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
查核资料
- arxiv.org · 所列章节
§4 ΨPO与确定性偏好反例、§5有限间隔及支持条件
技术关系
仍需留意
- 未逐项核实附录证明与全部数值实验,未声称神经参数化的全局收敛
强化学习KTO: Model Alignment as Prospect Theoretic Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只有单条好坏标签怎样定义更新方向
- 二、以参考点分开两侧效用,并检查KL代理
- 三、估计并冻结参考点,按标签聚合效用损失
- 四、匹配模型规模读图3,再检查失去配对后的证据
- 五、反馈易得不等于标签含义与梯度权重不变
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、反馈易得不等于标签含义与梯度权重不变
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、以参考点分开两侧效用,并检查KL代理 / 标签方向、类别数量与错配参考点
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、估计并冻结参考点,按标签聚合效用损失
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、匹配模型规模读图3,再检查失去配对后的证据 / one-y-per-x与90%区间各检验什么
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、反馈易得不等于标签含义与梯度权重不变
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、反馈易得不等于标签含义与梯度权重不变
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、反馈易得不等于标签含义与梯度权重不变
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:只有单条好坏标签怎样定义更新方向,二、以参考点分开两侧效用,并检查KL代理,四、匹配模型规模读图3,再检查失去配对后的证据,五、反馈易得不等于标签含义与梯度权重不变。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、以参考点分开两侧效用,并检查KL代理,四、匹配模型规模读图3,再检查失去配对后的证据。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:只有单条好坏标签怎样定义更新方向,二、以参考点分开两侧效用,并检查KL代理,四、匹配模型规模读图3,再检查失去配对后的证据,五、反馈易得不等于标签含义与梯度权重不变。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、反馈易得不等于标签含义与梯度权重不变。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、反馈易得不等于标签含义与梯度权重不变。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、估计并冻结参考点,按标签聚合效用损失;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 数量平衡后还要看sigmoid的局部斜率:借TRL KTO按类别效用与参考点解释损失的接口,自算sigmoid局部斜率,区分数量平衡与梯度平衡。
教法来源与实际阅读范围
- Hugging Face TRL维护者 · KTO Trainer
desirable/undesirable utility;参考KL;类别权重
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“数量平衡后还要看sigmoid的局部斜率”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
0.25与0.09斜率例子固定β=1和参考点;类别总梯度还取决于策略score、采样与停止梯度,不是实测对齐成绩。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补齐两类损失、导数符号与sigmoid饱和影响。
- 补充图3训练路线、颜色、规模及合法比较方式。
正文配图:3 幅
- KTO等对齐方法在不同模型规模上的高于随机水平胜率与置信区间
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
横轴每组是训练路线:offline PPO、DPO或KTO,以及是否先做SFT;同组内橙红柱为不同大小Pythia,蓝柱为不同大小Llama。于是比较KTO与DPO时要匹配模型家族和规模,比较KTO与SFT+KTO时才是在看前置SFT的作用。跨颜色最高柱相减会同时改变模型本身,不能直接叫作KTO的净提升。
- 原论文Figure 1:横轴相对参考点区分损失和收益,纵向曲线表示不同目标隐含的效用形状。该示意解释损失规避的设计动机,不是对真实人类偏好的逐点测量。
方法/设定图 · 必要原图摘引 · HTML S1.F1; Figure 1
横轴相对参考点区分损失和收益,纵向曲线表示不同目标隐含的效用形状。该示意解释损失规避的设计动机,不是对真实人类偏好的逐点测量。
- 原论文Figure 2:橙蓝分别为Pythia与Llama模型家族,各组柱反映不同规模。纵轴是胜率减去50%后的百分点;零点表示与SFT目标打平,不表示零胜率。
实验/结果图 · 必要原图摘引 · HTML S3.F2; Figure 2
橙蓝分别为Pythia与Llama模型家族,各组柱反映不同规模。纵轴是胜率减去50%后的百分点;零点表示与SFT目标打平,不表示零胜率。
未在正文展示的图/表与范围
- 表1:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
所读为修订版,未逐版追踪差异;未独立校验裁判偏差或全部训练种子
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:相对胜负拆成绝对标签会丢失什么?;好坏比例变化时如何调整λ?;参考点估计偏差会怎样影响两类样本?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S1.F1,2:S3.F2,3:S4.F3
查看本篇 3 个原文证据入口
- 图1 · S1.F1
原站图表/证明入口
- 图2 · S3.F2
原站图表/证明入口
- 图3 · S4.F3
原站图表/证明入口
本轮边界:所读为修订版,未逐版追踪差异;未独立校验裁判偏差或全部训练种子
本次深化
- 明确单回答反馈、奖励单位参考点与有偏错配KL代理。
- 手算好坏标签效用、类别数量权重及非负截断估计的偏差。
- 核读90%二项区间与one-y-per-x实验,保留修订版本和裁判范围。
- v2:为三个原始追问逐题增加参考答案:相对胜负拆成绝对标签会丢失什么?;好坏比例变化时如何调整λ?;参考点估计偏差会怎样影响两类样本?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S1.F1,2:S3.F2,3:S4.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补齐两类损失、导数符号与sigmoid饱和影响。
- 第三版:补充图3训练路线、颜色、规模及合法比较方式。
查核资料
- arxiv.org · 所列章节
修订正文KTO损失、KL Estimate小节、图3与one-y-per-x实验
技术关系
- 49-dpo · 平行方法
共享参考对数比思想,反馈单位由成对比较改为单回答标签。
- 47-instructgpt · 教学联系
人类反馈可进入不同目标;二元KTO标签不等于InstructGPT的排序奖励模型。
仍需留意
- 所读为修订版,未逐版追踪差异;未独立校验裁判偏差或全部训练种子
强化学习DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同题多回答能否替代独立价值基线
- 二、把同题奖励变成优势,再接回token裁剪目标
- 三、冻结采样策略、处理零方差并按回答归约
- 四、用表5重绘隔离SFT到RL阶段的增量
- 五、组规模、标准差和回答长度仍在改变训练权重
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、组规模、标准差和回答长度仍在改变训练权重
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、把同题奖励变成优势,再接回token裁剪目标 / 全同奖励组与长短回答的系数
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、冻结采样策略、处理零方差并按回答归约
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、用表5重绘隔离SFT到RL阶段的增量 / 迭代RL同时改变数据与奖励模型
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、组规模、标准差和回答长度仍在改变训练权重
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、组规模、标准差和回答长度仍在改变训练权重
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、组规模、标准差和回答长度仍在改变训练权重
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:同题多回答能否替代独立价值基线,二、把同题奖励变成优势,再接回token裁剪目标,四、用表5重绘隔离SFT到RL阶段的增量,五、组规模、标准差和回答长度仍在改变训练权重。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、把同题奖励变成优势,再接回token裁剪目标,四、用表5重绘隔离SFT到RL阶段的增量。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:同题多回答能否替代独立价值基线,二、把同题奖励变成优势,再接回token裁剪目标,四、用表5重绘隔离SFT到RL阶段的增量,五、组规模、标准差和回答长度仍在改变训练权重。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、组规模、标准差和回答长度仍在改变训练权重。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、组规模、标准差和回答长度仍在改变训练权重。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、冻结采样策略、处理零方差并按回答归约;保留原伪代码、停止梯度说明和所需限制。。
- 最后逐段抽读时合并语义重复;本篇逐条实际删合见deduplication.merged_examples;内容保留于方法的定义与推导、图旁独有统计、对应边界。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 组标准化对奖励平移和缩放的响应不同于固定尺度:借TRL GRPO把生成、组奖励标准化与token归约分开的顺序,独立展开组内奖励平移和正缩放不变性。
教法来源与实际阅读范围
- Hugging Face TRL维护者 · GRPO Trainer
Looking deeper;组均值/标准差;原版与DAPO/DrGRPO归约
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“组标准化对奖励平移和缩放的响应不同于固定尺度”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
平移/正缩放不变性忽略数值保护并在同一组比较;不同实现的标准差、长度归约和零方差处理须核对原版本。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充token条件概率比、正负优势裁剪机制及G/长度符号;已有表5重绘与差值解释保留。
正文配图:1 幅
- 原表5数据重绘:GSM8K从82.9到88.2,MATH从46.8到51.7
实验/结果图 · 依据公开数据/公式重绘 · 依据原表Table 5重绘,Chain-of-Thought、Top-1、无工具条件
蓝柱与绿柱对照相同7B系列在指令微调及RL阶段后的Top-1正确率,均取表5无工具的Chain-of-Thought行。GSM8K增加5.3个百分点、MATH增加4.9个百分点;这更接近RL阶段的增量,不能把别的模型规模或工具调用的优势也算给GRPO。原表未在这四项旁提供误差条,因此本图没有自造区间。
未在正文展示的图/表与范围
- 表5:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未逐项审计奖励模型训练数据与全部数学评测成本
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:全部答错时怎样获得学习信号?;组标准差为何改变不同问题权重?;省Critic后总生成/奖励模型成本是否下降?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
本轮边界:未逐项审计奖励模型训练数据与全部数学评测成本
本次深化
- 解释组均值/标准差替代critic及旧策略/参考策略分工,保留原论文奖励模型。
- 手算全同奖励组零信号与长短回答单token权重差。
- 区分2024 GRPO机制、迭代奖励模型和后续R1规则奖励训练。
- v2:为三个原始追问逐题增加参考答案:全部答错时怎样获得学习信号?;组标准差为何改变不同问题权重?;省Critic后总生成/奖励模型成本是否下降?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充token条件概率比、正负优势裁剪机制及G/长度符号;已有表5重绘与差值解释保留。
查核资料
- arxiv.org · 所列章节
GRPO方法式3—4、结果监督与迭代RL算法
技术关系
- 27-ppo · 直接继承
本篇保留裁剪策略更新,把独立critic优势换成同题组相对量。
- 53-r1 · 直接继承
后作R1把GRPO式更新用于可验证推理奖励和多阶段训练。
- 54-dapo · 直接继承
后作DAPO修改裁剪、筛样与token归约,暴露原版目标的训练动态。
仍需留意
- 未逐项审计奖励模型训练数据与全部数学评测成本
强化学习DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:推理RL增益究竟来自哪条训练路径
- 二、拆开三条训练路径与终局奖励的token作用
- 三、分别执行直接RL、多阶段R1与监督蒸馏
- 四、读R1-Zero曲线时锁定pass@1、投票与采样预算
- 五、可观察推理行为与机制因果之间还缺什么
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 七、帮助建立理解 / 教学例子 → 二、拆开三条训练路径与终局奖励的token作用 / 终局奖励广播与小模型蒸馏的区别
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、分别执行直接RL、多阶段R1与监督蒸馏
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读R1-Zero曲线时锁定pass@1、投票与采样预算 / 行为样例与多阶段结果不能隔离GRPO净贡献
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、可观察推理行为与机制因果之间还缺什么
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、可观察推理行为与机制因果之间还缺什么
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、可观察推理行为与机制因果之间还缺什么
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:推理RL增益究竟来自哪条训练路径,二、拆开三条训练路径与终局奖励的token作用,四、读R1-Zero曲线时锁定pass@1、投票与采样预算,五、可观察推理行为与机制因果之间还缺什么。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、拆开三条训练路径与终局奖励的token作用,四、读R1-Zero曲线时锁定pass@1、投票与采样预算。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:推理RL增益究竟来自哪条训练路径,二、拆开三条训练路径与终局奖励的token作用,四、读R1-Zero曲线时锁定pass@1、投票与采样预算,五、可观察推理行为与机制因果之间还缺什么。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、可观察推理行为与机制因果之间还缺什么。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、可观察推理行为与机制因果之间还缺什么。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、分别执行直接RL、多阶段R1与监督蒸馏;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 一个准确率点必须带着生成预算:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“一个准确率点必须带着生成预算”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
采样次数、投票与长度改变评价预算;更长输出和行为样例不能单独识别新增推理机制。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充序列log概率的梯度分解,并限定为裁剪前教学说明。
- 补齐RL步轴、蓝红指标和o1两条不同预算参照。
正文配图:2 幅
- R1-Zero在AIME上的单样本准确率与16次多数投票准确率随训练变化
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形;蓝线pass@1估计、红线cons@16,多数投票不等于单次正确率
图2横轴是RL训练步,纵轴是AIME2024准确率。蓝线pass@1用每题重复采样来降低估计噪声,红线cons@16先对16个回答投票,二者的推理资源不同;绿虚线是o1-0912的pass@1,紫虚线是其cons@64,红线跨过紫线也不是相同候选数的比较。这里的红线应按图例保留cons@16,不能与主表另列的cons@64互换。
- 原论文Figure 3:横轴为RL步数,纵轴为训练集平均响应长度。长度增加记录了行为变化,仍须与准确率证据分开,不能由更长回答直接推出推理更正确。
实验/结果图 · 必要原图摘引 · HTML S2.F3; Figure 3
横轴为RL步数,纵轴为训练集平均响应长度。长度增加记录了行为变化,仍须与准确率证据分开,不能由更长回答直接推出推理更正确。
首版没有足以完整等成本复现的全部账本;未验证行为样例的因果解释
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:RL新增了什么行为,如何与基座已有能力区分?;如何控制长输出导致的额外计算收益?;开放任务没有可靠验证器时可沿用多少配方?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S2.F2,3:S2.F3
查看本篇 2 个原文证据入口
- 图2 · S2.F2
原站图表/证明入口
- 图3 · S2.F3
原站图表/证明入口
本轮边界:首版没有足以完整等成本复现的全部账本;未验证行为样例的因果解释
本次深化
- 分开R1-Zero、完整R1多阶段流程与监督蒸馏,明确已有预训练基座。
- 用组奖励说明整段token广播无法识别必要推理步骤,并区分蒸馏证据。
- 限定长度、自检和aha样例的因果意义,不混淆生成重复与训练种子。
- v2:为三个原始追问逐题增加参考答案:RL新增了什么行为,如何与基座已有能力区分?;如何控制长输出导致的额外计算收益?;开放任务没有可靠验证器时可沿用多少配方?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S2.F2,3:S2.F3
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充序列log概率的梯度分解,并限定为裁剪前教学说明。
- 第三版:补齐RL步轴、蓝红指标和o1两条不同预算参照。
查核资料
- arxiv.org · 所列章节
§2 R1-Zero、冷启动及完整R1多阶段流程、蒸馏和行为讨论
技术关系
- 52-grpo · 直接继承
本篇把既有组相对更新用于直接推理RL与后续多阶段流程。
- 47-instructgpt · 平行方法
都组合SFT和RL,但数据、奖励与阶段目的不同,不能把R1视为简单复刻。
- 55-dr-grpo · 平行方法
后作从基座、模板与归一化角度审查推理RL增益的来源。
仍需留意
- 首版没有足以完整等成本复现的全部账本;未验证行为样例的因果解释
强化学习DAPO: An Open-Source LLM Reinforcement Learning System at Scale部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:长推理训练的有效信号在哪里丢失
- 二、拆开裁剪、筛样、token归约与超长信号
- 三、补采有效组并按实际有效token汇总更新
- 四、读准确率与熵的成对曲线,再看累加消融
- 五、更新更有效之后,还要核算采样分布与总成本
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 七、帮助建立理解 / 教学例子 → 二、拆开裁剪、筛样、token归约与超长信号 / 十个token的权重与三组补采的成本
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、补采有效组并按实际有效token汇总更新
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读准确率与熵的成对曲线,再看累加消融 / 累加消融与avg@32各自允许什么结论
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、更新更有效之后,还要核算采样分布与总成本
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、更新更有效之后,还要核算采样分布与总成本
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、更新更有效之后,还要核算采样分布与总成本
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:长推理训练的有效信号在哪里丢失,二、拆开裁剪、筛样、token归约与超长信号,四、读准确率与熵的成对曲线,再看累加消融,五、更新更有效之后,还要核算采样分布与总成本。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、拆开裁剪、筛样、token归约与超长信号,四、读准确率与熵的成对曲线,再看累加消融。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:长推理训练的有效信号在哪里丢失,二、拆开裁剪、筛样、token归约与超长信号,四、读准确率与熵的成对曲线,再看累加消融,五、更新更有效之后,还要核算采样分布与总成本。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、更新更有效之后,还要核算采样分布与总成本。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、更新更有效之后,还要核算采样分布与总成本。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、补采有效组并按实际有效token汇总更新;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 接受率怎样换算成补采预算:在本篇原公式和接口上给出具体条件检查或教学推演;删去与原段重复的新增摘要。
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“接受率怎样换算成补采预算”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
B/p是独立且固定接受率的教学期望,不是DAPO实测生成开销;训练中接受率与题目分布会改变。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 解释代理目标优化方向、rho/m及原式与batch实现归约边界。
- 补充图2双轴、去除Clip-Higher的熵坍缩与准确率关系。
正文配图:5 幅
- DAPO的Clip-Higher对AIME平均准确率与生成熵的影响
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形
图2左图纵轴是AIME avg@32,右图纵轴是生成分布熵,横轴都为训练步。青线去掉Clip-Higher后熵快速接近零,左图准确率较早停滞;紫线保留更高熵并继续改善。这支持本设置下避免过早确定化的解释,不意味着熵本身越高越好,也不是32候选“至少答对一次”的pass@32曲线。
- 原论文Figure 3:左轴标题是平均上裁剪概率,右轴是avg@32全对样本的比例;原文笼统图注与面板标题不完全一致,这里按实际坐标识读,避免误报为熵或长度。
实验/结果图 · 必要原图摘引 · HTML S3.F3; Figure 3
左轴标题是平均上裁剪概率,右轴是avg@32全对样本的比例;原文笼统图注与面板标题不完全一致,这里按实际坐标识读,避免误报为熵或长度。
- 原论文Figure 4:左侧是生成熵,右侧是平均回答长度;两条线比较是否使用token级损失。分母改变样本权重,不能把长度变化直接视为准确率变化。
实验/结果图 · 必要原图摘引 · HTML S3.F4; Figure 4
左侧是生成熵,右侧是平均回答长度;两条线比较是否使用token级损失。分母改变样本权重,不能把长度变化直接视为准确率变化。
- 原论文Figure 5:左侧为AIME avg@32,右侧为熵;图例比较是否过滤超长样本。末段熵尖峰和准确率波动说明两个指标不能互相代替。
实验/结果图 · 必要原图摘引 · HTML S3.F5; Figure 5
左侧为AIME avg@32,右侧为熵;图例比较是否过滤超长样本。末段熵尖峰和准确率波动说明两个指标不能互相代替。
- 原论文Figure 6:紫线使用动态采样,青线不使用;横轴为训练步而非已尝试的全部生成成本。达到相近准确率所需步数减少,不自动等于同幅度总计算节省。
实验/结果图 · 必要原图摘引 · HTML S4.F6; Figure 6
紫线使用动态采样,青线不使用;横轴为训练步而非已尝试的全部生成成本。达到相近准确率所需步数减少,不自动等于同幅度总计算节省。
未在正文展示的图/表与范围
- 表1:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未核实所有训练种子与完整调参搜索;累加消融不能独立辨认全部交互效应
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:补采后总token成本是否仍更低?;丢弃全错组是否妨碍学习最难问题?;非对称clip为何不是动作概率硬上限?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:2:S2.F2,3:S3.F3,4:S3.F4,5:S3.F5,6:S4.F6
查看本篇 5 个原文证据入口
- 图2 · S2.F2
原站图表/证明入口
- 图3 · S3.F3
原站图表/证明入口
- 图4 · S3.F4
原站图表/证明入口
- 图5 · S3.F5
原站图表/证明入口
- 图6 · S4.F6
原站图表/证明入口
本轮边界:未核实所有训练种子与完整调参搜索;累加消融不能独立辨认全部交互效应
本次深化
- 逐项解释Clip-Higher、动态采样、全token归约及超长奖励修正。
- 手算2/8长度权重及三生成组只保留一组的成本。
- 核读累加消融与avg@32,区分总生成token、有效token和墙钟收敛。
- v2:为三个原始追问逐题增加参考答案:补采后总token成本是否仍更低?;丢弃全错组是否妨碍学习最难问题?;非对称clip为何不是动作概率硬上限?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:2:S2.F2,3:S3.F3,4:S3.F4,5:S3.F5,6:S4.F6
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:解释代理目标优化方向、rho/m及原式与batch实现归约边界。
- 第三版:补充图2双轴、去除Clip-Higher的熵坍缩与准确率关系。
查核资料
- arxiv.org · 所列章节
四项方法、式12 token级目标、表1累加消融与动态采样成本说明
技术关系
- 52-grpo · 直接继承
本篇改造其概率比裁剪、样本筛选和损失归约。
- 55-dr-grpo · 平行方法
两者都研究长度权重,DAPO分母是实际token总数,Dr. GRPO使用固定长度常数。
仍需留意
- 未核实所有训练种子与完整调参搜索;累加消融不能独立辨认全部交互效应
强化学习Understanding R1-Zero-Like Training: A Critical Perspective部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:两个分母如何改变回答与题目的权重
- 二、固定长度分母并保留原始组奖励差
- 三、求和有效token并检查固定常数没有被换回
- 四、读图6:减少错误回答长度与提高正确率不同
- 五、移除两种权重之后仍存在哪些统计与优化影响
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、移除两种权重之后仍存在哪些统计与优化影响
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、固定长度分母并保留原始组奖励差 / 固定分母与组标准差的两个手算
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、求和有效token并检查固定常数没有被换回
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读图6:减少错误回答长度与提高正确率不同 / 先固定基座和模板,再谈归一化的净收益
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、移除两种权重之后仍存在哪些统计与优化影响
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、移除两种权重之后仍存在哪些统计与优化影响
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、移除两种权重之后仍存在哪些统计与优化影响
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:两个分母如何改变回答与题目的权重,二、固定长度分母并保留原始组奖励差,四、读图6:减少错误回答长度与提高正确率不同,五、移除两种权重之后仍存在哪些统计与优化影响。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、固定长度分母并保留原始组奖励差,四、读图6:减少错误回答长度与提高正确率不同。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:两个分母如何改变回答与题目的权重,二、固定长度分母并保留原始组奖励差,四、读图6:减少错误回答长度与提高正确率不同,五、移除两种权重之后仍存在哪些统计与优化影响。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、移除两种权重之后仍存在哪些统计与优化影响。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、移除两种权重之后仍存在哪些统计与优化影响。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、求和有效token并检查固定常数没有被换回;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 固定分母保留长度对总贡献的影响:对照GRPO实现文档的不同loss归约对象,说明固定分母下长回答仍有更多梯度项,不照搬当前库默认值。
教法来源与实际阅读范围
- Hugging Face TRL维护者 · GRPO Trainer
Looking deeper;组均值/标准差;原版与DAPO/DrGRPO归约
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“固定分母保留长度对总贡献的影响”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
固定分母消除特定长度重加权,不保证长短回答总梯度相同或完整策略梯度无偏;不能混同DAPO动态token分母。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充图6五面板坐标与从总长度到错误回答长度的诊断路径;保留已有两类归一化手算。
正文配图:4 幅
- Dr.GRPO与GRPO的奖励、回答长度及评估分数训练动态对照
实验/结果图 · 必要原图摘引 · Figure 6;原HTML图形
五个面板横轴都以策略迭代步计;上排分别画训练奖励和输出token长度,下排拆成正确回答长度、错误回答长度、平均基准分数。红色Dr.GRPO和灰色GRPO奖励接近而总长度分离,进一步查看下排可定位主要差异来自错误回答变长。应把“更少无效输出”和“更高正确率”分开,后者不能仅由第二或第四面板推出。
- 原论文Figure 5:蓝点大小表示组内标准差倒数,橙箭头表示长度归一化后的权重;正确与错误回答的长度差会改变更新权重。这个示意说明偏置来源,不是完整性能实验。
方法/设定图 · 必要原图摘引 · HTML S3.F5; Figure 5
蓝点大小表示组内标准差倒数,橙箭头表示长度归一化后的权重;正确与错误回答的长度差会改变更新权重。这个示意说明偏置来源,不是完整性能实验。
- 原论文Figure 7:三列分别采用R1模板、Qwen-Math模板和无模板,颜色标明题集。模板与题集共同改变训练曲线,不能把所有变化归给归一化公式。
实验/结果图 · 必要原图摘引 · HTML S3.F7; Figure 7
三列分别采用R1模板、Qwen-Math模板和无模板,颜色标明题集。模板与题集共同改变训练曲线,不能把所有变化归给归一化公式。
- 原论文Figure 8:左图更换基座模型,右图对比算法;右图实线读准确率,虚线读右轴回答长度。准确率相近与输出长度分离可以同时发生。
实验/结果图 · 必要原图摘引 · HTML S3.F8; Figure 8
左图更换基座模型,右图对比算法;右图实线读准确率,虚线读右轴回答长度。准确率相近与输出长度分离可以同时发生。
未逐项复核所有训练种子、模板组合与预算,未把局部去偏解释成全局无偏
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:固定最大长度变化时是否需同步调学习率?;去掉标准差后各难度题梯度如何分配?;哪些偏差仍未被此修改消除?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:5:S3.F5,6:S3.F6,7:S3.F7,8:S3.F8
查看本篇 4 个原文证据入口
- 图5 · S3.F5
原站图表/证明入口
- 图6 · S3.F6
原站图表/证明入口
- 图7 · S3.F7
原站图表/证明入口
- 图8 · S3.F8
原站图表/证明入口
本轮边界:未逐项复核所有训练种子、模板组合与预算,未把局部去偏解释成全局无偏
本次深化
- 解释移除长度/标准差归一化及固定分母,区别于DAPO实际token分母。
- 手算跨批长度变化与低标准差放大题目权重的效应。
- 核读模板、基座和错误回答长度对照,限定“去偏”而非全局无偏。
- v2:为三个原始追问逐题增加参考答案:固定最大长度变化时是否需同步调学习率?;去掉标准差后各难度题梯度如何分配?;哪些偏差仍未被此修改消除?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:5:S3.F5,6:S3.F6,7:S3.F7,8:S3.F8
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充图6五面板坐标与从总长度到错误回答长度的诊断路径;保留已有两类归一化手算。
查核资料
- arxiv.org · 所列章节
§3.2固定分母推导、图6长度动态及基座/模板控制实验
技术关系
- 52-grpo · 直接继承
本篇保留组内奖励差,移除两种归一化来源。
- 54-dapo · 平行方法
共同关心token权重,分母和采样系统不同。
- 05-reinforce · 教学联系
动作无关基线定理帮助检查无偏性;组内含自身基线不能直接照搬该条件。
仍需留意
- 未逐项复核所有训练种子、模板组合与预算,未把局部去偏解释成全局无偏
强化学习Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样约束模型搜索与价值学习的分布失配
- 二、用回报加权候选推导扩散score目标
- 三、训练能量与MC目标,再把去噪求解摊销进策略
- 四、读五个任务面板,并另查容量与时间曲线
- 五、能量密度近似与非单调扩展都限制结论
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、能量密度近似与非单调扩展都限制结论
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、用回报加权候选推导扩散score目标 / 两个候选的回报与能量怎样竞争
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、训练能量与MC目标,再把去噪求解摊销进策略
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读五个任务面板,并另查容量与时间曲线 / 固定1000万更新的时间不等于同精度成本
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、能量密度近似与非单调扩展都限制结论
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、能量密度近似与非单调扩展都限制结论
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、能量密度近似与非单调扩展都限制结论
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:怎样约束模型搜索与价值学习的分布失配,二、用回报加权候选推导扩散score目标,四、读五个任务面板,并另查容量与时间曲线,五、能量密度近似与非单调扩展都限制结论。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、用回报加权候选推导扩散score目标,四、读五个任务面板,并另查容量与时间曲线。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:怎样约束模型搜索与价值学习的分布失配,二、用回报加权候选推导扩散score目标,四、读五个任务面板,并另查容量与时间曲线,五、能量密度近似与非单调扩展都限制结论。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、能量密度近似与非单调扩展都限制结论。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、能量密度近似与非单调扩展都限制结论。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、训练能量与MC目标,再把去噪求解摊销进策略;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 计算摊销把哪部分工作搬离部署:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“计算摊销把哪部分工作搬离部署”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
摊销将MC目标成本前移到训练,非成本消失;有限候选、能量密度假设和score近似仍约束结论。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充前向高斯、log导数、后验均值到MC权重的短推导。
- 补齐图4面板、交互步、量纲与ManiSkill2局部对照。
正文配图:5 幅
- MBDPO在DMControl、MetaWorld、ManiSkill2、MyoSuite和视觉RL上的汇总曲线
实验/结果图 · 必要原图摘引 · Figure 4;原HTML图形;可见图形有五个面板,末面板为Visual RL,按面板标签解读
图4五列按图面板依次是DMControl、Meta-World、ManiSkill2、MyoSuite和Visual RL,横轴为各自环境交互步;前四列与视觉列的预算上限不同。纵轴也不可混比:DMControl/视觉任务画回报,其余面板主要按成功指标汇总。红色MBDPO应与同面板的绿色TD-MPC2等对照;ManiSkill2后期两者接近或交错,不能把红线总体较高改写成每任务、每检查点都获胜,更不能把此图读成参数规模扩展图。
- 原论文Figure 5:十个视觉控制任务逐项保留,红色MBDPO对照绿色TD-MPC2。部分任务很快饱和、部分差距更大,平均收益不能替代每项任务的预算和曲线。
实验/结果图 · 必要原图摘引 · HTML S4.F5; Figure 5
十个视觉控制任务逐项保留,红色MBDPO对照绿色TD-MPC2。部分任务很快饱和、部分差距更大,平均收益不能替代每项任务的预算和曲线。
- 原论文Figure 3:左侧两图为cross-TD误差,右侧为动作漂移均值与分布。它们是策略与价值一致性的诊断代理,并非世界模型完全正确的证据。
实验/结果图 · 必要原图摘引 · HTML S3.F3; Figure 3
左侧两图为cross-TD误差,右侧为动作漂移均值与分布。它们是策略与价值一致性的诊断代理,并非世界模型完全正确的证据。
- 原论文Figure 6:左侧80任务,右侧30任务;横轴才是模型参数规模。右图MBDPO标注从82.4升至83.7,TD-MPC2从59.4升至71.4,与原文段落所称340M下降不一致。因此上文的下降说法来自作者文字叙述,不能由这张图直接验证。
实验/结果图 · 必要原图摘引 · HTML S4.F6; Figure 6
左侧80任务,右侧30任务;横轴才是模型参数规模。右图MBDPO标注从82.4升至83.7,TD-MPC2从59.4升至71.4,与原文段落所称340M下降不一致。因此上文的下降说法来自作者文字叙述,不能由这张图直接验证。
- 原论文Figure 7:左侧汇总离线到在线微调,右侧逐任务比较从头训练与微调;Hopper Hop仍保留失败。迁移收益与任务覆盖应逐项核对,不能只看汇总柱。
实验/结果图 · 必要原图摘引 · HTML S4.F7; Figure 7
左侧汇总离线到在线微调,右侧逐任务比较从头训练与微调;Hopper Hop仍保留失败。迁移收益与任务覆盖应逐项核对,不能只看汇总柱。
未在正文展示的图/表与范围
- 表1:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未逐条验证理论正则条件与所有任务计数,未复现模型和score训练
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:负样本采样如何改变能量的密度解释?;固定总训练成本而非参数量时扩展趋势是否保持?;score拟合与世界模型误差各贡献多少失败?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:3:S3.F3,4:S4.F4,5:S4.F5,6:S4.F6,7:S4.F7
查看本篇 5 个原文证据入口
- 图3 · S3.F3
原站图表/证明入口
- 图4 · S4.F4
原站图表/证明入口
- 图5 · S4.F5
原站图表/证明入口
- 图6 · S4.F6
原站图表/证明入口
- 图7 · S4.F7
原站图表/证明入口
本轮边界:未逐条验证理论正则条件与所有任务计数,未复现模型和score训练
本次深化
- 推导回报加权MC score,限定有限样本偏差、负样本密度及状态常数近似。
- 手算候选权重和能量惩罚如何改变一维score目标。
- 核读固定训练步的多任务成本与采样消融,避免把扩展性当等性能低成本。
- v2:为三个原始追问逐题增加参考答案:负样本采样如何改变能量的密度解释?;固定总训练成本而非参数量时扩展趋势是否保持?;score拟合与世界模型误差各贡献多少失败?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:3:S3.F3,4:S4.F4,5:S4.F5,6:S4.F6,7:S4.F7
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充前向高斯、log导数、后验均值到MC权重的短推导。
- 第三版:补齐图4面板、交互步、量纲与ManiSkill2局部对照。
查核资料
- arxiv.org · 所列章节
主方法式15、附录score推导与能量密度近似、表1计算成本及消融
技术关系
- 40-dreamer · 平行方法
同用潜在世界模型,但本篇以回报加权score学习动作序列分布,而非直接复制想象Actor更新。
- 49-dpo · 教学联系
缩写相近而目标、数据和优化对象不同,应主动辨别。
- 35-pets · 历史背景
模型中评价候选序列是共同规划问题,MBDPO把生成分布摊销到扩散策略。
仍需留意
- 未逐条验证理论正则条件与所有任务计数,未复现模型和score训练
强化学习WorldSample: Closed-loop Real-robot RL with World Modelling部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:合成经验何时值得交给真实机器人Critic
- 二、先选择合成正负经验,再调节Critic中的权重
- 三、闭环更新真实回放、视频模型与合成筛选
- 四、按真实步数对齐成功与干预曲线,再复算主表
- 五、熵调度不是误差保证,摘要口径仍需澄清
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、熵调度不是误差保证,摘要口径仍需澄清
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 三、方法:到底改了什么 → 三、闭环更新真实回放、视频模型与合成筛选
把影响复现的概率归约或调度版本规则集中放到实现流程之前。
- 七、帮助建立理解 / 教学例子 → 二、先选择合成正负经验,再调节Critic中的权重 / 合成权重封顶后Critic仍可能偏移
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、闭环更新真实回放、视频模型与合成筛选
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、按真实步数对齐成功与干预曲线,再复算主表 / 共同示范、额外合成数据与摘要口径
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、熵调度不是误差保证,摘要口径仍需澄清
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、熵调度不是误差保证,摘要口径仍需澄清
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、熵调度不是误差保证,摘要口径仍需澄清
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:合成经验何时值得交给真实机器人Critic,二、先选择合成正负经验,再调节Critic中的权重,四、按真实步数对齐成功与干预曲线,再复算主表,五、熵调度不是误差保证,摘要口径仍需澄清。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、先选择合成正负经验,再调节Critic中的权重,四、按真实步数对齐成功与干预曲线,再复算主表。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:合成经验何时值得交给真实机器人Critic,二、先选择合成正负经验,再调节Critic中的权重,四、按真实步数对齐成功与干预曲线,再复算主表,五、熵调度不是误差保证,摘要口径仍需澄清。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、熵调度不是误差保证,摘要口径仍需澄清。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、熵调度不是误差保证,摘要口径仍需澄清。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、闭环更新真实回放、视频模型与合成筛选;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 策略熵和模型预测误差属于不同对象:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“策略熵和模型预测误差属于不同对象”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
低策略熵可与高视频模型误差共存;该反例不估计原系统误差,正文损失系数与附录采样比例另行区分。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 增加相对损失系数q/(1-q)的教学换算及熵尺度边界。
- 补齐图3五任务、成功/干预、真实步与终点预算。
正文配图:2 幅
- WorldSample与HIL-SERL在五项真机任务中的成功率和干预率
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
图3每列是一项机器人任务,上排纵轴是成功率,下排是人工干预率;横轴均为真实交互步,蓝色WorldSample与橙色HIL-SERL的终点预算不同。读“更快成功”应在相同横轴位置比较上排,再对照同位置下排是否仍依赖接管;不能直接用两个不同终点的高低当同预算效果。Assemble上蓝线仍远低于完全成功,提醒平均提升没有消除困难任务。
- 原论文Figure 5:左图为成功率,右图为人工干预率,保留全部消融曲线。两种指标需在同一训练步比较,不能把较早停止的高成功曲线直接视为同预算全面胜出。
实验/结果图 · 必要原图摘引 · HTML S4.F5; Figure 5
左图为成功率,右图为人工干预率,保留全部消融曲线。两种指标需在同一训练步比较,不能把较早停止的高成功曲线直接视为同预算全面胜出。
未在正文展示的图/表与范围
摘要与表格部分提升口径未消除,未验证全部机器人重复和奖励模型误差
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:低熵能否可靠预测合成样本误差?;计入全部生成与人工干预后节省多少成本?;表1与摘要差异来自何种加权或评估口径?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:3:S4.F3,5:S4.F5
查看本篇 2 个原文证据入口
- 图3 · S4.F3
原站图表/证明入口
- 图5 · S4.F5
原站图表/证明入口
本轮边界:摘要与表格部分提升口径未消除,未验证全部机器人重复和奖励模型误差
本次深化
- 拆开合成正负筛选与熵调度,明确正文公式和附录线性近似、30%上限。
- 手算错误合成TD目标如何移动critic最优值,说明封顶并不消除偏差。
- 核对二十示范和干预协议,保留摘要/表格口径差异及视觉指标边界。
- v2:为三个原始追问逐题增加参考答案:低熵能否可靠预测合成样本误差?;计入全部生成与人工干预后节省多少成本?;表1与摘要差异来自何种加权或评估口径?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:3:S4.F3,5:S4.F5
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:增加相对损失系数q/(1-q)的教学换算及熵尺度边界。
- 第三版:补齐图3五任务、成功/干预、真实步与终点预算。
查核资料
- arxiv.org · 所列章节
PPL式4—9、实验控制协议、主结果表及附录线性熵调度和30%上限
技术关系
- 39-mbpo · 平行方法
同样权衡模型经验与真实经验,但短rollout控制和视频合成筛样不是同一机制。
- 56-mbdpo · 平行方法
MBDPO改策略分布优化,WorldSample重点改合成经验进入critic的方式。
仍需留意
- 摘要与表格部分提升口径未消除,未验证全部机器人重复和奖励模型误差
强化学习How Much, Then Where: Credit-Conserving Action-to-Token Allocation for Multi-Turn Agent Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:动作总信用与token落点怎样分开
- 二、用边界TD记动作总账,再分配token落点
- 三、恢复checkpoint校准价值并归一动作内权重
- 四、把守恒、价值校准和扰动诊断放在同一图中辨析
- 五、能恢复环境与能解释因果,是不同要求
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 七、帮助建立理解 / 教学例子 → 二、用边界TD记动作总账,再分配token落点 / 总账守恒但局部信用与梯度仍改变
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、恢复checkpoint校准价值并归一动作内权重
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、把守恒、价值校准和扰动诊断放在同一图中辨析 / 三种子结果、续跑权限与预算匹配
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、能恢复环境与能解释因果,是不同要求
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、能恢复环境与能解释因果,是不同要求
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、能恢复环境与能解释因果,是不同要求
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:动作总信用与token落点怎样分开,二、用边界TD记动作总账,再分配token落点,四、把守恒、价值校准和扰动诊断放在同一图中辨析,五、能恢复环境与能解释因果,是不同要求。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、用边界TD记动作总账,再分配token落点,四、把守恒、价值校准和扰动诊断放在同一图中辨析。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:动作总信用与token落点怎样分开,二、用边界TD记动作总账,再分配token落点,四、把守恒、价值校准和扰动诊断放在同一图中辨析,五、能恢复环境与能解释因果,是不同要求。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、能恢复环境与能解释因果,是不同要求。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、能恢复环境与能解释因果,是不同要求。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、恢复checkpoint校准价值并归一动作内权重;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- APM需要动作内均值为1,而不是和为1:在本篇原公式和接口上给出具体条件检查或教学推演;删去与原段重复的新增摘要。
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“APM需要动作内均值为1,而不是和为1”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
APM要求动作内平均权重为1;softmax和为1需再乘长度,标量信用保持仍不保证梯度向量或因果归因。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充守恒密度图、独立MC散点校准及正负token扰动诊断的逐面板读法。
正文配图:1 幅
- FACTOR的动作信用失真、独立价值估计校准和token扰动诊断
实验/结果图 · 必要原图摘引 · Figure 5;原HTML图形
图5左图横轴是动作内平均token乘子偏离1的绝对值,纵轴是密度,检验“总量有没有被悄悄改掉”;FACTOR集中在零附近是归一化应有的性质。中图横轴是独立高样本MC信用估计,纵轴为TAC信用,虚线是二者相等,橙/蓝分别表示早/晚阶段,离对角线远说明分配不准,即使左图仍守恒。右图比较高、低分配token扰动后的回报变化差,正负信用分组的符号应分开看;该较小扰动子集是局部诊断,不是对所有token因果贡献的证明。
未在正文展示的图/表与范围
- 表1:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未运行checkpoint恢复或检验教师因果准确性,未逐项核查所有跨骨干实验
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:若中间价值严重不准,守恒是否仍帮助训练?;梯度方向不守恒为何不与标量守恒矛盾?;无法恢复工具环境状态时如何校准价值?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:5:S4.F5
查看本篇 1 个原文证据入口
- 图5 · S4.F5
原站图表/证明入口
本轮边界:未运行checkpoint恢复或检验教师因果准确性,未逐项核查所有跨骨干实验
本次深化
- 区分真实值TD优势解释、边界望远镜恒等式及动作内均值保持。
- 手算错误中间价值仍守恒,以及token重分配改变参数梯度方向。
- 核读三种子受控比较、续跑权限与计算预算,不把守恒等同因果准确。
- v2:为三个原始追问逐题增加参考答案:若中间价值严重不准,守恒是否仍帮助训练?;梯度方向不守恒为何不与标量守恒矛盾?;无法恢复工具环境状态时如何校准价值?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:5:S4.F5
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充守恒密度图、独立MC散点校准及正负token扰动诊断的逐面板读法。
查核资料
- arxiv.org · 所列章节
TAC命题与边界恒等式、HTA/APM、表1三种子受控结果与预算讨论
技术关系
- 02-td-lambda · 历史背景
TAC继续用预测差分配信用,但增加checkpoint续跑与边界校准。
- 52-grpo · 模块组合
组基线提供轨迹总信用,FACTOR进一步拆到动作和token。
- 60-draco · 平行方法
后作也重分配轨迹优势,但其步骤质量来自动态rubric judge而非续跑价值。
仍需留意
- 未运行checkpoint恢复或检验教师因果准确性,未逐项核查所有跨骨干实验
强化学习TTPO: Test-Time Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:无真答案的测试题能提供什么更新信号
- 二、拆开答案条件蒸馏与负样本token抑制
- 三、生成64个候选、选训练子集并更新LoRA
- 四、读正负分支消融,同时审查测试时选点权限
- 五、错误多数与峰值选点留下的部署问题
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 三、方法:到底改了什么 → 五、错误多数与峰值选点留下的部署问题
先完成机制与实现,再在图表证据之后解释理论条件、失效风险或适用边界。
- 七、帮助建立理解 / 教学例子 → 二、拆开答案条件蒸馏与负样本token抑制 / 错误多数与低概率token的筛选
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、生成64个候选、选训练子集并更新LoRA
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读正负分支消融,同时审查测试时选点权限 / 训练子集、全部生成与峰值检查点
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、错误多数与峰值选点留下的部署问题
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、错误多数与峰值选点留下的部署问题
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 实验读图中的旧方向指代 → 四、读正负分支消融,同时审查测试时选点权限
段落迁移后改用明确原表或本节对象,避免错误的前文/下文指向;题答未改。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、错误多数与峰值选点留下的部署问题
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:无真答案的测试题能提供什么更新信号,二、拆开答案条件蒸馏与负样本token抑制,四、读正负分支消融,同时审查测试时选点权限,五、错误多数与峰值选点留下的部署问题。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、拆开答案条件蒸馏与负样本token抑制,四、读正负分支消融,同时审查测试时选点权限。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:无真答案的测试题能提供什么更新信号,二、拆开答案条件蒸馏与负样本token抑制,四、读正负分支消融,同时审查测试时选点权限,五、错误多数与峰值选点留下的部署问题。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、错误多数与峰值选点留下的部署问题。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、错误多数与峰值选点留下的部署问题。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、生成64个候选、选训练子集并更新LoRA;保留原伪代码、停止梯度说明和所需限制。。
- 按本篇具体事实重新合并;实际前后文本逐条见deduplication.merged_examples;内容保留于问题定义、公式推导、各图新增证据与边界各归其位。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 把伪标签数量与独立正确证据分开:基于本篇已有原论文公式补出具体符号、条件或接口推演
原论文校准与展开范围
原论文校准:以原稿已核的本篇公式、算法和版本条件为基础,检查“把伪标签数量与独立正确证据分开”中的推演;未新增原实验数值或声称重新核读整篇论文。 · 原文
多数回答可能共享错误且相互相关;训练无答案不消除按评测选峰值的标签使用,完整生成与教师成本仍需计入。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补齐正负损失、符号和Soft-OR因式分解,明确负优势方向与无PPO裁剪。
- 补充图3组合、颜色、参照并区分48.9单任务消融与45.2汇总。
正文配图:3 幅
- TTPO的正负样本更新策略消融与AIME26平均准确率
实验/结果图 · 必要原图摘引 · Figure 3;原HTML图形
图3纵轴是AIME26的Avg@12准确率,横轴每根柱表示一对正组 $\mathcal P$/负组 $\mathcal N$ 的更新组合;柱内绿色为前向KL、粉色为GRPO式负更新、白色为不更新。灰水平虚线为基座,标出的短虚线是无答案特权上下文的教师变体。48.9对应这张Qwen3-1.7B消融的正FKL/负RL组合,不是前文跨测试集平均45.2;应先读组合,再比较是否用了相同教师信息。
- 原论文Figure 5:左侧比较伪标签与真标签参照,右侧比较训练熵。右侧括号内给TTRL步数,不能把双重刻度当成所有方法相同的更新预算。
实验/结果图 · 必要原图摘引 · HTML S4.F5; Figure 5
左侧比较伪标签与真标签参照,右侧比较训练熵。右侧括号内给TTRL步数,不能把双重刻度当成所有方法相同的更新预算。
- 原论文Figure 6:红色虚线为Maj@12,蓝色实线为Avg@12,灰虚线为基座Maj@12。多数投票改善与单次采样平均改善分别报告,不把两种推理预算混成一个准确率。
实验/结果图 · 必要原图摘引 · HTML S4.F6; Figure 6
红色虚线为Maj@12,蓝色实线为Avg@12,灰虚线为基座Maj@12。多数投票改善与单次采样平均改善分别报告,不把两种推理预算混成一个准确率。
未在正文展示的图/表与范围
未验证伪标签可靠性在其他分布上的变化,未复现峰值选点或全部训练随机性
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:如何在完全无标签部署中选择停止时刻?;错误多数率怎样影响训练收益?;同样总生成token预算的纯推理基线表现如何?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:3:S4.F3,5:S4.F5,6:S4.F6
查看本篇 3 个原文证据入口
- 图3 · S4.F3
原站图表/证明入口
- 图5 · S4.F5
原站图表/证明入口
- 图6 · S4.F6
原站图表/证明入口
本轮边界:未验证伪标签可靠性在其他分布上的变化,未复现峰值选点或全部训练随机性
本次深化
- 解释正样本自蒸馏、负样本梯度及低概率token×低熵的掩码评分。
- 用错误多数答案和两token评分反例说明伪标签及局部惩罚风险。
- 核读64次生成、训练子集和峰值检查点,区别于无适应测试权限。
- v2:为三个原始追问逐题增加参考答案:如何在完全无标签部署中选择停止时刻?;错误多数率怎样影响训练收益?;同样总生成token预算的纯推理基线表现如何?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:3:S4.F3,5:S4.F5,6:S4.F6
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补齐正负损失、符号和Soft-OR因式分解,明确负优势方向与无PPO裁剪。
- 第三版:补充图3组合、颜色、参照并区分48.9单任务消融与45.2汇总。
查核资料
- arxiv.org · 所列章节
§3算法与式3—8的非对称目标、token评分;§4及附录测试时预算和峰值检查点协议
技术关系
仍需留意
- 未验证伪标签可靠性在其他分布上的变化,未复现峰值选点或全部训练随机性
强化学习DRACO: Fine-Grained Credit Assignment with Dynamic Rubrics for Long-Horizon Agent Training部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有成功验证器怎样给工具步骤分信用
- 二、先由动态准则评分,再按步骤质量分配总信用
- 三、合并准则、引用步骤并处理所有退化分母
- 四、读任务表现—评价成本图,并分清重复评估口径
- 五、judge偏差、同号分配与训练成本尚未闭合
- 六、三个值得继续追问的问题与参考答案
- 七、沿未解决的问题继续读
- 自测两题
段落怎样重新安排
- 七、帮助建立理解 / 教学例子 → 二、先由动态准则评分,再按步骤质量分配总信用 / 两步长度下的正负信用与回退
读完机制公式就立即手算其作用,避免直到实验之后才建立数据流直觉。
- 三、方法:到底改了什么 / 输入 → 处理 → 输出 → 三、合并准则、引用步骤并处理所有退化分母
将数据准备、目标冻结、更新和部署步骤独立成有具体动作的实现节。
- 四、实验如何验证方法 / 实验解读 → 四、读任务表现—评价成本图,并分清重复评估口径 / 末段检查点、重复评估与pass^k
先让读者看到原图、坐标、比较对象与图旁解读,再讨论附加证据和外推限制。
- 五、结果与适用边界 + 六、贡献、代价与局限 → 五、judge偏差、同号分配与训练成本尚未闭合
消除两个短节之间的重复总评,并让限制由刚读过的证据自然推出。
- 五、结果与适用边界与六、贡献、代价与局限的原重复总评 → 五、judge偏差、同号分配与训练成本尚未闭合
实际重写并合并结果与贡献段,保留具体数字、证据限定与作者/本文分析之分,不再机械重复摘要与实现提醒。
- 五、结果与适用边界 / 六、贡献、代价与局限 → 五、judge偏差、同号分配与训练成本尚未闭合
让证据后只留下尚未解决的限制,逐篇实际删合见deduplication。
合并的重复说明
- 五个短标签与后文重复,改成具体问题与信息权限的两段推演。;内容保留于一、问题设定:没有成功验证器怎样给工具步骤分信用,二、先由动态准则评分,再按步骤质量分配总信用,四、读任务表现—评价成本图,并分清重复评估口径,五、judge偏差、同号分配与训练成本尚未闭合。
- 损失、机制与评价指标已在公式、机制段及实验条件表中完整表达。;内容保留于二、先由动态准则评分,再按步骤质量分配总信用,四、读任务表现—评价成本图,并分清重复评估口径。
- 重复摘要表拆回问题、机制、图表证据与边界,不再增加第二轮总评。;内容保留于一、问题设定:没有成功验证器怎样给工具步骤分信用,二、先由动态准则评分,再按步骤质量分配总信用,四、读任务表现—评价成本图,并分清重复评估口径,五、judge偏差、同号分配与训练成本尚未闭合。
- 原块只重复结论限制,非独立实现步骤。;内容保留于五、judge偏差、同号分配与训练成本尚未闭合。
- 旧结果概括与贡献短评在同节再次重复适用性,合并为本篇特定的论证收束。;内容保留于五、judge偏差、同号分配与训练成本尚未闭合。
- 重复的通用伪代码开场不再添加信息;由本篇专属过渡直接引入具体数据流。;内容保留于三、合并准则、引用步骤并处理所有退化分母;保留原伪代码、停止梯度说明和所需限制。。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 先定义整轨迹计数,再定义被引用步骤的质量:直接核读本篇原文后重写变量定义、推导顺序与图表解释,不声称来自通用博文。
原论文校准与展开范围
原论文校准:实际重新核读原文附录E.7–E.9,独立review复核计数定义、守恒、等权与零分母退化。 · 原文
AN守恒是标量信用记账,不保证judge准确、因果归因或参数梯度守恒;等权与零分母回退按原文条件区分。
第三版:自测保留与阅读标准复核
文末 2 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 补充先分步骤总量再除token数的守恒推导与非零条件。
- 补齐图2三任务指标、颜色消融与τ-bench评价成本范围。
正文配图:1 幅
- DRACO及消融在AppWorld和τ-bench的任务效果与一次评估美元成本
实验/结果图 · 必要原图摘引 · Figure 2;原HTML图形
图2三面板分别是AppWorld普通集、挑战集和τ-bench banking;前两图纵轴为TGC,后一图为成功率。灰点是基座,蓝/紫/绿点分别移除两组件、动态准则或步骤信用,红点是完整DRACO。应在同一面板寻找左上方的成本—表现折中;τ-bench成本还含用户模拟器和评审调用,不能把三张横轴的美元数简单当成同数量任务的推理单价。图中都是单次成功口径的点,也不是pass^k随k变化的曲线。
未在正文展示的图/表与范围
- 表2:Table-only reference inventoried; inline table reproduction is outside the requested figure scope.
未独立验证judge可靠性和全部成本,评估重复不提供完整训练种子不确定性
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。本篇三道进阶追问;其余既有自测保留,未计入本轮逐题核对。
- 为三个原始追问逐题增加参考答案:judge偏好与真实成功偏离时如何诊断?;负轨迹中的真正好步骤是否需要允许正优势?;计入judge调用后与真奖励训练的成本差多少?
- 将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- 将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- 核查并链接原图:1:S1.F1,2:S4.F2
查看本篇 2 个原文证据入口
- 图1 · S1.F1
原站图表/证明入口
- 图2 · S4.F2
原站图表/证明入口
本轮边界:未独立验证judge可靠性和全部成本,评估重复不提供完整训练种子不确定性
本次深化
- 拆解动态rubric奖励、步骤引用与保符号信用分配,区分通过率和Q价值。
- 手算2/6长度步骤的优势分配与总系数AN守恒,排除gap token。
- 据附录E.7–E.9纠正:相同正权重使步骤总量相等,token优势仍随1/n_j变化;零分母或全无引用才回退统一A。
- 核对末三检查点与评估重复、pass^k定义,不把标量守恒当因果或梯度向量保证。
- v2:为三个原始追问逐题增加参考答案:judge偏好与真实成功偏离时如何诊断?;负轨迹中的真正好步骤是否需要允许正优势?;计入judge调用后与真奖励训练的成本差多少?
- v2:将证据定位表融入实验/机制对照,保留原有结果数字与适用边界
- v2:将重复阅读范围尾注改为原论文入口和带机制理由的相关文章链接
- v2:核查并链接原图:1:S1.F1,2:S4.F2
- 正文新增1幅就近读图的inline图像;逐图核验内容、尺寸、来源、版权与本地SHA256。
- 第三版:补充先分步骤总量再除token数的守恒推导与非零条件。
- 第三版:补齐图2三任务指标、颜色消融与τ-bench评价成本范围。
查核资料
- arxiv.org · 所列章节
§3动态准则与步骤分配、§4评价协议;附录E.7–E.9等步骤总量、1/n_j token分配及零分母/全无引用回退
技术关系
- 52-grpo · 模块组合
动态rubric产生组奖励,再替换其统一token优势。
- 58-factor · 平行方法
都约束标量总量,但一个用judge步骤引用,一个用续跑TD与动作均值归约。
- 59-ttpo · 教学联系
都借助额外评估信号,然而监督、训练权限和检查点选择协议不同。
仍需留意
- 未独立验证judge可靠性和全部成本,评估重复不提供完整训练种子不确定性
强化学习系列收尾|把 60 篇论文连成可检验的理解部分核验,边界见下
本次深化
- 增加REINFORCE/GAE/TRPO/PPO控制变量阅读实验与四层记录法
- 将60行来源索引从统一模板更新为每篇实际核读章节及访问限制
- 补MBDPO状态常数近似和WorldSample实现调度差异
- 删除重复60行阅读范围索引,改为TD数据协议、TRPO/GAE/PPO分工、离线动作支持等问题驱动的直接回读链接。
查核资料
- www.derongliu.org · 摘要
可检索原文摘要;作者出版目录核对书目
- jmvidal.cse.sc.edu · 所列章节
§2望远镜展开与资格迹;§3.2、图3—5实验;§4线性理论
- proceedings.neurips.cc · 所列章节
§2架构、§3导航、§4变化环境与图5—6
- www.gatsby.ucl.ac.uk · 所列章节
§2更新、§3收敛条件与ARP证明、§4扩展
- gwern.net · 所列章节
§3—4定义与Theorem 1、Bernoulli例、基线讨论
- www.researchgate.net · 摘要
作者上传的一手报告摘要;原始Cambridge PDF尝试提取失败
- people.cs.umass.edu · 所列章节
§2 Options定义、§3 SMDP定理与图4—6、§4中断定理及图7说明
- proceedings.neurips.cc · 所列章节
Theorem 1—3,特别Theorem 2证明与兼容特征解释
- proceedings.neurips.cc · 所列章节
自然梯度和兼容近似推导;§5图2及其图注
- www.jmlr.org · 所列章节
LSTDQ投影方程;§9.1—9.2与图16—18
- papers.nips.cc · 所列章节
§2双估计、Algorithm 1、§4.2图2
- proceedings.mlr.press · 所列章节
重要性采样与正则机制;算法更新;§6图2消融与预算
- proceedings.mlr.press · 所列章节
§3—4定理与离策略解释;§5.1—5.3实验设置
- arxiv.org · 所列章节
§3性能界、§4—5近似求解、§8图4与基线说明
- arxiv.org · 所列章节
§3多步推导与§4解释;§6.1更新顺序;§6.2—6.3与图2—3
- storage.googleapis.com · 所列章节
正文更新、图1—3及图注、扩展实验说明
- arxiv.org · 所列章节
Algorithm 1;§4图2—3与表1
- arxiv.org · 所列章节
目标公式;图3讨论;表1与评估协议
- arxiv.org · 所列章节
§3.1—3.4;图1—2;附录B.1
- arxiv.org · 所列章节
聚合式(9)、§4.1走廊实验、图3
- storage.googleapis.com · 所列章节
多阶段训练、价值网络数据构造、MCTS正文及Methods
- arxiv.org · 所列章节
§4异步框架;§5.1图1与表1;补充优化设置
- arxiv.org · 所列章节
占用分布推导;Algorithm 1;§6图1与§7局限
- arxiv.org · 所列章节
ICM前向/逆向机制;§4.1图6;Mario设置
- arxiv.org · 所列章节
集中Critic梯度;策略ensemble;§5图3及§5.4
- arxiv.org · 所列章节
Algorithm 1;§4.3图3;§4.5图6;§4.6真机试验
- arxiv.org · 所列章节
§2—4目标;§6.1表1;§6.2图3;§6.3预算
- arxiv.org · 所列章节
分布Bellman算子;Algorithm 1投影;§5.1—5.2与附录C—D
- arxiv.org · 所列章节
Integrated Agent;实验方法;图3—4消融讨论
- arxiv.org · 所列章节
soft策略改进;重参数化式11—13;双Q说明;§5图1—3
- arxiv.org · 所列章节
§4—5三机制;§6.2表2及其统计口径
- arxiv.org · 所列章节
§4 V-trace式3、附录A Theorem 1与Remark 3;架构说明
- arxiv.org · 所列章节
信息目标与伪奖励;§4图4、下游先验及图9
- arxiv.org · 所列章节
单调性与超网络;§6设置;§7图3—4评估
- arxiv.org · 所列章节
§5.1轨迹采样、算法概要、图3统计口径
- arxiv.org · 所列章节
§2.3—2.4终止与归一化;§3.1—3.2图3—4
- arxiv.org · 所列章节
§3外推误差;批约束机制;图2实验与图注
- arxiv.org · 所列章节
MMD定义与约束;附录C.3图7;附录D数据与KL比较
- arxiv.org · 所列章节
§4模型界;分叉rollout算法;§6.2图3—4
- arxiv.org · 所列章节
行为学习目标与梯度;图4、图8及主实验设定
- arxiv.org · 所列章节
表示/动态/预测训练流程;图2—3及搜索预算说明
- arxiv.org · 所列章节
§3.1 Theorem 3.1—3.2及式1—2;保守Q目标解释
- arxiv.org · 所列章节
优势加权更新与离线/在线设定;图3衔接分析
- arxiv.org · 所列章节
§3序列与训练;§5.6表7;附录回报条件与图任务
- arxiv.org · 所列章节
目标与Q尺度式3—5;附录C.1—C.3数据版本及AntMaze
- arxiv.org · 所列章节
方法中的expectile三步更新、理论条件及§5图2 toy maze解释
- arxiv.org · 所列章节
三阶段训练方法、PPO-ptx目标及附录E.6能力回退与预算讨论
- arxiv.org · 所列章节
修订正文鲁棒预测、symexp two-hot公式、想象学习与图6消融
- arxiv.org · 所列章节
§4解析最优策略、分区函数消去、偏好损失与实验设置
- arxiv.org · 所列章节
§4 ΨPO与确定性偏好反例、§5有限间隔及支持条件
- arxiv.org · 所列章节
修订正文KTO损失、KL Estimate小节、图3与one-y-per-x实验
- arxiv.org · 所列章节
GRPO方法式3—4、结果监督与迭代RL算法
- arxiv.org · 所列章节
§2 R1-Zero、冷启动及完整R1多阶段流程、蒸馏和行为讨论
- arxiv.org · 所列章节
四项方法、式12 token级目标、表1累加消融与动态采样成本说明
- arxiv.org · 所列章节
§3.2固定分母推导、图6长度动态及基座/模板控制实验
- arxiv.org · 所列章节
主方法式15、附录score推导与能量密度近似、表1计算成本及消融
- arxiv.org · 所列章节
PPL式4—9、实验控制协议、主结果表及附录线性熵调度和30%上限
- arxiv.org · 所列章节
TAC命题与边界恒等式、HTA/APM、表1三种子受控结果与预算讨论
- arxiv.org · 所列章节
§3算法与式3—8的非对称目标、token评分;§4及附录测试时预算和峰值检查点协议
- arxiv.org · 所列章节
§3动态准则与步骤分配、零分母/未引用步骤规则、§4评价与附录训练配置
技术关系
- 01-actor-critic · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 02-td-lambda · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 03-dyna · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 04-q-learning · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 05-reinforce · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 06-sarsa · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 07-options · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 08-policy-gradient-theorem · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 09-natural-policy-gradient · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 10-lspi · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 11-double-q · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 12-gps · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 13-dpg · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 14-trpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 15-gae · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 16-dqn · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 17-ddpg · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 18-double-dqn · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 19-per · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 20-dueling-dqn · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 21-alphago · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 22-a3c · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 23-gail · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 24-icm · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 25-maddpg · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 26-her · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 27-ppo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 28-c51 · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 29-rainbow · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 30-sac · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 31-td3 · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 32-impala · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 33-diayn · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 34-qmix · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 35-pets · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 36-rnd · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 37-bcq · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 38-bear · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 39-mbpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 40-dreamer · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 41-muzero · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 42-cql · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 43-awac · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 44-decision-transformer · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 45-td3-bc · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 46-iql · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 47-instructgpt · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 48-dreamerv3 · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 49-dpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 50-ipo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 51-kto · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 52-grpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 53-r1 · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 54-dapo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 55-dr-grpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 56-mbdpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 57-worldsample · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 58-factor · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 59-ttpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 60-draco · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
仍需留意
- 三个训练实验仍为设计,未执行;论文来源的个别附录和代码未完整审核;01/06保留摘要级限制
强化学习强化学习 60 篇论文:从预测、控制到推理与 Agent部分核验,边界见下
本次深化
- 新增五条问题驱动阅读路线及关系方向说明
- 把SAC从DDPG→TD3继承箭头中分开,分清GRPO/R1/DAPO谱系
- 前置Day0入口并明确58篇章节级与2篇摘要级的核源范围
- 把固定七段模板说明改成问题、推导、可看图证据和有答案追问的阅读要求,加入TD勘误图入口。
查核资料
- gwern.net · 所列章节
§3—4定义与Theorem 1、Bernoulli例、基线讨论
- proceedings.neurips.cc · 所列章节
Theorem 1—3,特别Theorem 2证明与兼容特征解释
- proceedings.neurips.cc · 所列章节
自然梯度和兼容近似推导;§5图2及其图注
- arxiv.org · 所列章节
§3性能界、§4—5近似求解、§8图4与基线说明
- arxiv.org · 所列章节
§3多步推导与§4解释;§6.1更新顺序;§6.2—6.3与图2—3
- arxiv.org · 所列章节
§2—4目标;§6.1表1;§6.2图3;§6.3预算
- arxiv.org · 所列章节
soft策略改进;重参数化式11—13;双Q说明;§5图1—3
- arxiv.org · 所列章节
§3外推误差;批约束机制;图2实验与图注
- arxiv.org · 所列章节
MMD定义与约束;附录C.3图7;附录D数据与KL比较
- arxiv.org · 所列章节
§3.1 Theorem 3.1—3.2及式1—2;保守Q目标解释
- arxiv.org · 所列章节
方法中的expectile三步更新、理论条件及§5图2 toy maze解释
- arxiv.org · 所列章节
三阶段训练方法、PPO-ptx目标及附录E.6能力回退与预算讨论
- arxiv.org · 所列章节
§4解析最优策略、分区函数消去、偏好损失与实验设置
- arxiv.org · 所列章节
§4 ΨPO与确定性偏好反例、§5有限间隔及支持条件
- arxiv.org · 所列章节
修订正文KTO损失、KL Estimate小节、图3与one-y-per-x实验
- arxiv.org · 所列章节
GRPO方法式3—4、结果监督与迭代RL算法
- arxiv.org · 所列章节
§2 R1-Zero、冷启动及完整R1多阶段流程、蒸馏和行为讨论
- arxiv.org · 所列章节
§3.2固定分母推导、图6长度动态及基座/模板控制实验
- arxiv.org · 所列章节
TAC命题与边界恒等式、HTA/APM、表1三种子受控结果与预算讨论
- arxiv.org · 所列章节
§3算法与式3—8的非对称目标、token评分;§4及附录测试时预算和峰值检查点协议
- arxiv.org · 所列章节
§3动态准则与步骤分配、零分母/未引用步骤规则、§4评价与附录训练配置
技术关系
- 05-reinforce · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 08-policy-gradient-theorem · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 09-natural-policy-gradient · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 14-trpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 15-gae · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 27-ppo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 30-sac · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 37-bcq · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 38-bear · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 42-cql · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 46-iql · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 47-instructgpt · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 49-dpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 50-ipo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 51-kto · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 52-grpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 53-r1 · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 55-dr-grpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 58-factor · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 59-ttpo · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
- 60-draco · 教学联系
将该文已核读机制与证据用于跨论文教学比较,非声称辅助文档是其算法后继。
仍需留意
- 目录不是实验复现;早期两篇仍有正文访问缺口,延伸主题不宣称全覆盖
大语言模型Day 0|大语言模型阅读入门:从文字、参数到一次回答部分核验,边界见下
本次深化
- 新增完整尺寸检查和两文档softmax手算
- 从单token交叉熵推导梯度再连接LoRA与DPO
- 用同一会议室错误形成四条诊断阅读路线
- v2:保留3道已有自测及答案
- v2:把结尾通用阅读边界换成Transformer原图入口与读取失败、选择失败的具体链接
查核资料
- arxiv.org · 所列章节
§3缩放点积注意力、多头尺寸与掩码;由此构造双文档算例
- arxiv.org · 所列章节
LoRA低秩更新方式;与训练目标的教学区分
- arxiv.org · 所列章节
§4偏好损失;与参数更新方式的教学区分
- arxiv.org · 所列章节
证据位置控制的诊断设计
技术关系
- 015-transformer · 教学联系
从一次注意力手算进入完整架构
- 047-lora · 教学联系
区分更新参数方向与损失定义
- 075-dpo · 教学联系
从分类损失过渡到偏好损失
- 077-lost-middle · 教学联系
将证据读取失败变成受控实验
仍需留意
- 辅助篇基于本轮已核读的相关论文方法/实验章节作教学综合;未据此声称全系列每个数字已复核或教学实验已实际运行。
大语言模型大语言模型发展时间线:表示、规模、对齐与推理系统部分核验,边界见下
本次深化
- 重绘技术图并为关系添加架构分支模块组合和平行比较标签
- 新增四次具体瓶颈接力并限定历史继承强度
- 解释总参数活跃参数可训练参数的成本差别
- 说明系统分支表回引早期论文不等于年代误排
- v2:给结尾5条开放判断题逐条补充机制、反例与检查方法
- v2:用各篇具体机制链接承接时间线和总结实验
查核资料
- arxiv.org · 所列章节
§3结构与§4并行性/路径分析,用于信息访问路线
- arxiv.org · 所列章节
§3量化基座与常数压缩,支撑LoRA后续瓶颈
- arxiv.org · 所列章节
ToT的生成评价搜索分解
- arxiv.org · 所列章节
GQA共享KV头与缓存资源解释
技术关系
- 006-seq2seq · 教学联系
固定压缩瓶颈的教学起点
- 007-attention · 教学联系
按内容读取源状态
- 074-qlora · 教学联系
接续参数高效微调后的基座存储问题
- 072-tree-of-thoughts · 教学联系
由完整候选选择转向状态搜索
仍需留意
- 辅助篇基于本轮已核读的相关论文方法/实验章节作教学综合;未据此声称全系列每个数字已复核或教学实验已实际运行。
大语言模型Long Short-Term Memory部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:结尾的误差怎样教会网络保存开头信息
- 二、沿恒等存储路径推导输入门与输出门
- 三、按原版连接和梯度规则实现记忆单元
- 四、从人工长时延任务读出学习难度
- 五、梯度能保留,内容为什么仍会被覆盖
- 六、把本篇机制再推进一步
- 七、把存储模块接到序列任务,再改变读取接口
- 自测与参考答案
段落怎样重新安排
- 背景:能表示,不等于能学到 → 结尾的误差怎样教会网络保存开头信息
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 梯度能保留,内容为什么仍会被覆盖
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把存储模块接到序列任务,再改变读取接口
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:保护一条存储路径 → 沿恒等存储路径推导输入门与输出门
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:保护一条存储路径 → 沿恒等存储路径推导输入门与输出门
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:保护一条存储路径 → 按原版连接和梯度规则实现记忆单元
单列可执行步骤,与机制论证及经验结果区分
- 方法:保护一条存储路径 → 按原版连接和梯度规则实现记忆单元
保留实现限制、训练协议及指标接口
- 实验设计与证据 → 从人工长时延任务读出学习难度
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子与贡献边界 → 沿恒等存储路径推导输入门与输出门
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子与贡献边界 → 沿恒等存储路径推导输入门与输出门
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子与贡献边界 → 梯度能保留,内容为什么仍会被覆盖
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子与贡献边界 → 梯度能保留,内容为什么仍会被覆盖
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子与贡献边界 → 梯度能保留,内容为什么仍会被覆盖
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 已核原论文机制与适用的专业教法 → 将读门与存储状态分开做一次干预
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、把存储模块接到序列任务,再改变读取接口
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 将读门与存储状态分开做一次干预:将读门与存储状态分开做一次干预
教法来源与实际阅读范围
- Christopher Olah · Understanding LSTM Networks
展开循环图、长期依赖、状态与门的分步图解
原论文校准:1997原文图1的CEC、输入/输出门;借用Olah沿状态线逐节点追踪的教法,不引入其现代遗忘门。
本篇校准范围:1997原文图1的CEC、输入/输出门;借用Olah沿状态线逐节点追踪的教法,不引入其现代遗忘门。 新增段落仅用于“将读门与存储状态分开做一次干预”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- 1997年原始LSTM记忆单元的恒等自连接、输入门和输出门
方法/设定图 · 必要原图摘引 · 图1,PDF第7页
先看原论文图1(PDF第7页):中央标为1.0的自连接是 CEC,两侧乘法节点分别控制写入与读出。图中没有现代遗忘门;箭头表示信息流,不能当作完整反向传播规则。
- 长时延及不同干扰符号数量下,LSTM达到成功标准所需的训练序列数
实验/结果图 · 必要原图摘引 · 表3,PDF第15页
读原表3。 左两列分别控制时延与干扰符号数,最右列是达到成功标准所需的训练序列数。上半部随时延增加同时扩大可用干扰符号集合;下半部固定长时延、增加同一种干扰重复出现的机会,学习代价明显不同。这是特定人工任务的训练统计,不能把最后一列当作自然语言任务的通用记忆容量。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 增加原始LSTM记忆单元图入口并解释自连接、门与版本边界
- 原文定位已接入正文:图1
- 问答核查:为什么把普通 RNN 的学习率提高十倍,不能根本解决长时延梯度消失等3题均有独立对应答案;保留已有有效解释
查看本篇 1 个原文证据入口
- 图1 · PDF第7页,图1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 修复输出状态公式 TeX
- 加入标量递推到 CEC 的中间推导
- 用100步导数及泄漏写入例区分梯度与内容保护
- 明确LSTM应用和注意力的关系
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:增加原始LSTM记忆单元图入口并解释自连接、门与版本边界
- v2:原文定位已接入正文:图1
- v2:问答核查:为什么把普通 RNN 的学习率提高十倍,不能根本解决长时延梯度消失等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- www.bioinf.jku.at · 所列章节
§3 梯度连乘、§3.2 读写冲突与 §4 原始输入/输出门结构
技术关系
- 006-seq2seq · 模块组合
LSTM 单元进入编码解码架构
- 007-attention · 平行方法
显式读取历史是压缩状态的另一种信息访问方式
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型A Neural Probabilistic Language Model部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没出现过的词组合怎样获得合理概率
- 二、从共享词表推到条件分布与梯度
- 三、联合更新嵌入和预测器,再统一评价单位
- 四、把 Brown 与 AP News 的困惑度放回条件中
- 五、共享泛化仍受窗口、词表与输出成本约束
- 六、把本篇机制再推进一步
- 七、按历史长度与表示成本分出两条路
- 自测与参考答案
段落怎样重新安排
- 研究背景:组合数量远多于观察次数 → 没出现过的词组合怎样获得合理概率
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 共享泛化仍受窗口、词表与输出成本约束
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 按历史长度与表示成本分出两条路
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:词向量和预测器一起学习 → 从共享词表推到条件分布与梯度
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:词向量和预测器一起学习 → 从共享词表推到条件分布与梯度
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:词向量和预测器一起学习 → 联合更新嵌入和预测器,再统一评价单位
单列可执行步骤,与机制论证及经验结果区分
- 方法:词向量和预测器一起学习 → 联合更新嵌入和预测器,再统一评价单位
保留实现限制、训练协议及指标接口
- 实验如何验证 → 把 Brown 与 AP News 的困惑度放回条件中
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 从困惑度理解结果 → 把 Brown 与 AP News 的困惑度放回条件中
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 从困惑度理解结果 → 把 Brown 与 AP News 的困惑度放回条件中
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 从困惑度理解结果 → 共享泛化仍受窗口、词表与输出成本约束
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 从困惑度理解结果 → 从共享词表推到条件分布与梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与局限 → 共享泛化仍受窗口、词表与输出成本约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 共享泛化仍受窗口、词表与输出成本约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 让共享词向量的两次更新可见
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、按历史长度与表示成本分出两条路
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 让共享词向量的两次更新可见:让共享词向量的两次更新可见
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Word2vec
Language Modeling、Language Model Training、Skipgram
原论文校准:NNLM原文共享词特征表与softmax;尺寸是自构,未将后来的负采样倒灌原模型。
本篇校准范围:NNLM原文共享词特征表与softmax;尺寸是自构,未将后来的负采样倒灌原模型。 新增段落仅用于“让共享词向量的两次更新可见”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- AP News上神经语言模型与平滑n-gram模型的验证及测试困惑度
实验/结果图 · 必要原图摘引 · 表2,PDF第14页
证据三,表2:AP News。表中神经模型测试困惑度为 109,所列五阶 Kneser–Ney 为 117。按这两个显示值自行计算,相对下降约为 $(117-109)/117\approx6.8\%$。原文文字给出约 8% 的概括;应保留比较条件与取整差别,而不是强行让两者看起来完全一致。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表1、表2
- 问答核查:为什么一个词向量被更新,会影响许多没出现过的句子等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 表1 · PDF第13页,表1
原站图表/证明入口
- 表2 · PDF第14页,表2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导softmax误差到共享嵌入行的回传
- 加入固定窗口参数预算教学算例
- 区分RNNLM结构继承与word2vec任务改造
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表1、表2
- v2:问答核查:为什么一个词向量被更新,会影响许多没出现过的句子等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- www.jmlr.org · 所列章节
§1.1 共享表示的泛化,§2 式1、参数形状、嵌入行更新
技术关系
- 003-rnnlm · 直接继承
固定窗口神经语言模型改为循环历史
- 004-word2vec · 历史背景
词向量学习从完整概率预测中分离
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Recurrent Neural Network Based Language Model部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:固定词窗口之外的话题怎样参与预测
- 二、从循环状态推到下一词分布
- 三、实现时分别固定状态、梯度与适配协议
- 四、读 WSJ 与 RT05:概率改善能否转为识别收益
- 五、识别收益受哪些状态容量与流水线条件约束
- 六、沿状态与适配继续追问
- 七、从压缩状态走向另外两条路线
- 自测与参考答案
段落怎样重新安排
- 一分钟理解:有限窗口与循环状态 → 一、问题设定:固定词窗口之外的话题怎样参与预测
先建立固定窗口未解决的问题,再给出所需的新信息通路
- 核心方法末尾:可见历史、梯度历史与在线更新 → 二、从循环状态推到下一词分布
把推导提前到伪代码之前,使实现开关有数学依据
- 教学例子:状态、参数和适配并不相同 → 二、从循环状态推到下一词分布
在实施训练协议之前检验状态与参数的区别
- 核心方法:训练与输出组织、伪代码、WER释义 → 三、实现时分别固定状态、梯度与适配协议
将机制与执行条件分开成可核对实现章节
- 实验首段:DEV/EVAL反向排序 → 四、读 WSJ 与 RT05:概率改善能否转为识别收益
先交代数据与对照,再读反直觉结果及图表
- 教学例子末段与一分钟结果段 → 五、识别收益受哪些状态容量与流水线条件约束
用实验已暴露的条件解释能力边界
- 独立逐段复核发现的跨节重复与实现缺口 → 机制、实现和实验对应章节
公式条件与实际执行相对应,删除状态/参数的反复说明
- 已核原论文机制与适用的专业教法 → 实现时分别固定状态、梯度与适配协议
新增当前步梯度与SG实现,统一两套递推符号,保留前向状态而切断跨步梯度。
合并的重复说明
- 取消抢先总结整篇的统一模板;内容保留于问题设定与边界章节。
- 五列表复述正文相同问题、改动、证据与局限;内容保留于一至五节完整正文、表2/3/4证据链接。
- 将技术关系拆为开篇真实前作问题和文末后继路线;内容保留于先接住上一篇的问题;七、从压缩状态走向另外两条路线。
- 原摘要首段与背景首段重复定义固定窗口,合并成一个数据库话题问题;内容保留于一、问题设定首段。
新增 3 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 实现时分别固定状态、梯度与适配协议:新增当前步梯度与SG实现,统一两套递推符号,保留前向状态而切断跨步梯度。
原论文校准与展开范围
原论文校准:Mikolov 2010原PDF第2页明确τ=1截断、交叉熵误差desired−y、逐词SGD;本轮已由独立来源复核确认符号映射和梯度方向。
本篇校准范围:Mikolov 2010原PDF第2页明确τ=1截断、交叉熵误差desired−y、逐词SGD;本轮已由独立来源复核确认符号映射和梯度方向。 新增段落仅用于“实现时分别固定状态、梯度与适配协议”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将 003-rnnlm-t3.png 完整移到对应证据解释之后,图像、归属与链接不变。
- **读表3时固定评价列。** DEV WER 与 EVAL WER 都越低越好,分别对应开发集和评估集。动态组合在 DEV 列低于静态组合,到了 EVAL 列却高于静态组合;不能只凭开发集排序就宣称动态更新处处更好。前段表2的 PPL/WER 数值也不是这张表3的同一组单元格。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- WSJ开发集和评估集上静态与动态RNN混合模型的词错误率
实验/结果图 · 必要原图摘引 · 表3,PDF第3页
读表3时固定评价列。 DEV WER 与 EVAL WER 都越低越好,分别对应开发集和评估集。动态组合在 DEV 列低于静态组合,到了 EVAL 列却高于静态组合;不能只凭开发集排序就宣称动态更新处处更好。前段表2的 PPL/WER 数值也不是这张表3的同一组单元格。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表3、表4、表2
- 问答核查:RNN 看到了任意长历史,为什么仍可能忘记第一句话等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表3 · PDF第3页,表3
原站图表/证明入口
- 表4 · PDF第4页,表4
原站图表/证明入口
- 表2 · PDF第3页,表2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 分开状态、截断梯度和动态权重更新
- 加入状态条件概率手算
- 解读WSJ动态适配回退而非仅列最好结果
- v2:原文定位已接入正文:表3、表4、表2
- v2:问答核查:RNN 看到了任意长历史,为什么仍可能忘记第一句话等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:将 003-rnnlm-t3.png 完整移到对应证据解释之后,图像、归属与链接不变。
- v3:**读表3时固定评价列。** DEV WER 与 EVAL WER 都越低越好,分别对应开发集和评估集。动态组合在 DEV 列低于静态组合,到了 EVAL 列却高于静态组合;不能只凭开发集排序就宣称动态更新处处更好。前段表2的 PPL/WER 数值也不是这张表3的同一组单元格。
查核资料
- www.isca-archive.org · 所列章节
§2 网络与静态/动态适配;表3、表4及脚注4的句序影响
- www.isca-archive.org · 所列章节
读表3时固定评价列。 DEV WER 与 EVAL WER 都越低越好,分别对应开发集和评估集。动态组合在 DEV 列低于静态组合,到了 EVAL 列却高于静态组合;不能只凭开发集排序就宣称动态更新处处更好。前段表2的 PPL/WER 数值也不是这张表3的同一组单元格。
技术关系
- 002-nnlm · 直接继承
神经预测器由固定窗口改循环状态
- 001-lstm · 平行方法
简单Elman循环与门控单元不等同
- 019-transformer-xl · 教学联系
可见记忆与梯度跨度需要分别统计
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Efficient Estimation of Word Representations in Vector Space部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只需要词向量时,哪些语言模型计算可以省去
- 二、从 CBOW 聚合与 Skip-gram 配对推导共享信号
- 三、先固定窗口采样,再选择输出层和导出向量
- 四、同时读类比类别、CPU预算与句子补全
- 五、便宜代理任务主动舍弃了哪些上下文信息
- 六、把本篇机制再推进一步
- 七、继续降低输出成本,或改变统计与表示对象
- 自测与参考答案
段落怎样重新安排
- 背景:目标是概率模型,还是中间表示? → 只需要词向量时,哪些语言模型计算可以省去
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 便宜代理任务主动舍弃了哪些上下文信息
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 继续降低输出成本,或改变统计与表示对象
真实关系移到后继路线,避免目录相邻等于技术继承
- 两个方向相反的预测任务 → 从 CBOW 聚合与 Skip-gram 配对推导共享信号
先给出信息路径、目标与机制,再讨论执行顺序
- 两个方向相反的预测任务 → 从 CBOW 聚合与 Skip-gram 配对推导共享信号
将原来的后置推导提前,解释伪代码为何这样计算
- 两个方向相反的预测任务 → 先固定窗口采样,再选择输出层和导出向量
单列可执行步骤,与机制论证及经验结果区分
- 两个方向相反的预测任务 → 先固定窗口采样,再选择输出层和导出向量
保留实现限制、训练协议及指标接口
- 实验与三类证据 → 同时读类比类别、CPU预算与句子补全
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:为什么上下文会塑造几何 → 先固定窗口采样,再选择输出层和导出向量
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么上下文会塑造几何 → 从 CBOW 聚合与 Skip-gram 配对推导共享信号
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么上下文会塑造几何 → 便宜代理任务主动舍弃了哪些上下文信息
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么上下文会塑造几何 → 便宜代理任务主动舍弃了哪些上下文信息
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与边界 → 便宜代理任务主动舍弃了哪些上下文信息
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 便宜代理任务主动舍弃了哪些上下文信息
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 便宜代理任务主动舍弃了哪些上下文信息
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 从四个词直接列出两种监督样本
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、继续降低输出成本,或改变统计与表示对象
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 从四个词直接列出两种监督样本:从四个词直接列出两种监督样本
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Word2vec
Language Modeling、Language Model Training、Skipgram
原论文校准:原文CBOW、Skip-gram目标;固定窗口仅为教学样例,实际动态窗口按本文实现条件。
本篇校准范围:原文CBOW、Skip-gram目标;固定窗口仅为教学样例,实际动态窗口按本文实现条件。 新增段落仅用于“从四个词直接列出两种监督样本”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读表6。** 中间三列分别是语义类比、语法类比和总准确率,越高越好;最右列是“天数 × CPU核心数”,不能把乘号前的天数独自当作总计算成本。CBOW与Skip-gram在两类题上的排序不同,总分也不能替代逐类表现。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- NNLM、CBOW和Skip-gram的词类比准确率、向量维度与训练时间
实验/结果图 · 必要原图摘引 · 表6,PDF第9页
读表6。 中间三列分别是语义类比、语法类比和总准确率,越高越好;最右列是“天数 × CPU核心数”,不能把乘号前的天数独自当作总计算成本。CBOW与Skip-gram在两类题上的排序不同,总分也不能替代逐类表现。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表6、表7、表8
- 问答核查:CBOW 为什么速度可能更快,却会丢失信息等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
- 表7 · 表7;HTML元素 #S4.T7
原站图表/证明入口
- 表8 · 表8;HTML元素 #S5.T8
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 从平均池化推导词向量共享梯度
- 推导随机窗口的距离采样概率
- 补充类比指标的答案空间限制
- v2:原文定位已接入正文:表6、表7、表8
- v2:问答核查:CBOW 为什么速度可能更快,却会丢失信息等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读表6。** 中间三列分别是语义类比、语法类比和总准确率,越高越好;最右列是“天数 × CPU核心数”,不能把乘号前的天数独自当作总计算成本。CBOW与Skip-gram在两类题上的排序不同,总分也不能替代逐类表现。
查核资料
- arxiv.org · 所列章节
§2复杂度、§3 CBOW/Skip-gram与随机窗口、§4.1类比评估
- arxiv.org · 所列章节
读表6。 中间三列分别是语义类比、语法类比和总准确率,越高越好;最右列是“天数 × CPU核心数”,不能把乘号前的天数独自当作总计算成本。CBOW与Skip-gram在两类题上的排序不同,总分也不能替代逐类表现。
技术关系
- 005-negative-sampling · 直接继承
扩展Skip-gram训练
- 008-glove · 平行方法
共现拟合与局部预测并行
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Distributed Representations of Words and Phrases and their Compositionality部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:每个真实词对是否必须遍历全词表
- 二、从数据噪声比推导点积,再调整样本和词项
- 三、把短语合并、下采样与负例抽样分开执行
- 四、逐块读负例数与下采样的交互结果
- 五、代理判别的几何不等于校准概率或世界事实
- 六、把本篇机制再推进一步
- 七、从噪声对比转向全局共现拟合
- 自测与参考答案
段落怎样重新安排
- 背景:概率归一化并非表示学习唯一选择 → 每个真实词对是否必须遍历全词表
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 代理判别的几何不等于校准概率或世界事实
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从噪声对比转向全局共现拟合
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法一:真实搭配对少量噪声搭配 → 从数据噪声比推导点积,再调整样本和词项
保留完整公式和事实约束
- 方法二:调整样本和词项 → 从数据噪声比推导点积,再调整样本和词项
先给出信息路径、目标与机制,再讨论执行顺序
- 方法二:调整样本和词项 → 从数据噪声比推导点积,再调整样本和词项
将原来的后置推导提前,解释伪代码为何这样计算
- 方法二:调整样本和词项 → 把短语合并、下采样与负例抽样分开执行
单列可执行步骤,与机制论证及经验结果区分
- 方法二:调整样本和词项 → 把短语合并、下采样与负例抽样分开执行
保留实现限制、训练协议及指标接口
- 实验设置与结果 → 逐块读负例数与下采样的交互结果
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学推演:负例分布为何重要 → 从数据噪声比推导点积,再调整样本和词项
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学推演:负例分布为何重要 → 从数据噪声比推导点积,再调整样本和词项
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学推演:负例分布为何重要 → 代理判别的几何不等于校准概率或世界事实
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学推演:负例分布为何重要 → 代理判别的几何不等于校准概率或世界事实
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与局限 → 代理判别的几何不等于校准概率或世界事实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 代理判别的几何不等于校准概率或世界事实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 区分一次负例抽样与负例期望目标
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、从噪声对比转向全局共现拟合
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 区分一次负例抽样与负例期望目标:区分一次负例抽样与负例期望目标
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Word2vec
Language Modeling、Language Model Training、Skipgram
原论文校准:负采样论文以k项噪声贡献定义代理目标;此段由现有期望式线性展开。
本篇校准范围:负采样论文以k项噪声贡献定义代理目标;此段由现有期望式线性展开。 新增段落仅用于“区分一次负例抽样与负例期望目标”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读表1先看上下两块。** 下半块启用了高频词下采样,上半块没有;在同一方法的两行之间比较,才看得出样本选择的影响。第二列是分钟,后三列是语法、语义和总类比准确率。增加负例数要同时查看准确率与耗时,不能把NEG-15的总分单独当作免费提升。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 负采样数量及高频词下采样对类比准确率和训练时间的影响
实验/结果图 · 必要原图摘引 · 表1,PDF第5页
读表1先看上下两块。 下半块启用了高频词下采样,上半块没有;在同一方法的两行之间比较,才看得出样本选择的影响。第二列是分钟,后三列是语法、语义和总类比准确率。增加负例数要同时查看准确率与耗时,不能把NEG-15的总分单独当作免费提升。
未在正文展示的图/表与范围
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 将“实验证据定位”标题改为“实验设置与结果”,不另设低信息定位栏
- 原文定位已接入正文:表1、表3、表4、表5
- 问答核查:负采样是否就是用少量词精确估计 softmax 梯度等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导独立词对的对数信号噪声比驻点
- 加入改变噪声分布的数值反例
- 解读负例数量与下采样的速度质量权衡
- v2:将“实验证据定位”标题改为“实验设置与结果”,不另设低信息定位栏
- v2:原文定位已接入正文:表1、表3、表4、表5
- v2:问答核查:负采样是否就是用少量词精确估计 softmax 梯度等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读表1先看上下两块。** 下半块启用了高频词下采样,上半块没有;在同一方法的两行之间比较,才看得出样本选择的影响。第二列是分钟,后三列是语法、语义和总类比准确率。增加负例数要同时查看准确率与耗时,不能把NEG-15的总分单独当作免费提升。
查核资料
- arxiv.org · 所列章节
§2.2式4、§2.3下采样;§3表1的速度和类比准确率
- arxiv.org · 所列章节
读表1先看上下两块。 下半块启用了高频词下采样,上半块没有;在同一方法的两行之间比较,才看得出样本选择的影响。第二列是分钟,后三列是语法、语义和总类比准确率。增加负例数要同时查看准确率与耗时,不能把NEG-15的总分单独当作免费提升。
技术关系
- 004-word2vec · 直接继承
在Skip-gram上改训练目标
- 008-glove · 教学联系
对数共现结构可比较但目标不同
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Sequence to Sequence Learning with Neural Networks部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:长度不同的源句与目标句怎样共享训练接口
- 二、先分解条件概率,再辨析反转与状态瓶颈
- 三、把教师强制和搜索拆成训练、生成两套流程
- 四、区分反转、集成、句长和SMT重评分的收益
- 五、固定状态与近似搜索各自遗漏了什么
- 六、把本篇机制再推进一步
- 七、保留条件生成接口,改写信息读取路径
- 自测与参考答案
段落怎样重新安排
- 背景:从多个模块到条件序列概率 → 长度不同的源句与目标句怎样共享训练接口
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 固定状态与近似搜索各自遗漏了什么
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 保留条件生成接口,改写信息读取路径
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:状态如何传递 → 先分解条件概率,再辨析反转与状态瓶颈
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:状态如何传递 → 先分解条件概率,再辨析反转与状态瓶颈
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:状态如何传递 → 把教师强制和搜索拆成训练、生成两套流程
单列可执行步骤,与机制论证及经验结果区分
- 方法:状态如何传递 → 把教师强制和搜索拆成训练、生成两套流程
保留实现限制、训练协议及指标接口
- 实验设置 → 区分反转、集成、句长和SMT重评分的收益
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:编码、生成与搜索的区别 → 把教师强制和搜索拆成训练、生成两套流程
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:编码、生成与搜索的区别 → 先分解条件概率,再辨析反转与状态瓶颈
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:编码、生成与搜索的区别 → 固定状态与近似搜索各自遗漏了什么
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:编码、生成与搜索的区别 → 固定状态与近似搜索各自遗漏了什么
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与延伸 → 固定状态与近似搜索各自遗漏了什么
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与延伸 → 固定状态与近似搜索各自遗漏了什么
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与延伸 → 固定状态与近似搜索各自遗漏了什么
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 按时间表追踪教师强制与部署分叉
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、保留条件生成接口,改写信息读取路径
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 按时间表追踪教师强制与部署分叉:按时间表追踪教师强制与部署分叉
教法来源与实际阅读范围
- Christopher Olah · Understanding LSTM Networks
展开循环图、长期依赖、状态与门的分步图解
原论文校准:Seq2seq原文条件生成与教师强制目标;自构前缀诊断,不引入原文未使用的训练方法。
本篇校准范围:Seq2seq原文条件生成与教师强制目标;自构前缀诊断,不引入原文未使用的训练方法。 新增段落仅用于“按时间表追踪教师强制与部署分叉”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 翻译BLEU分别随测试句长度与平均词频排名变化的两幅曲线
实验/结果图 · 必要原图摘引 · 图3,HTML #S3.F3
证据三,第 3.7 节与图3。按句长观察表现,检验固定状态是否立即在较长输入上失效。论文结果表明该设置下长句仍可处理,但不证明固定向量可无损表达任意长度。表2 的 SMT 重评分也应作为额外系统条件阅读。 读图时分开两幅横轴:左侧按句长排序,右侧按平均词频排名排序;长句退化与罕见词退化不是同一个控制实验。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图3、表2
- 问答核查:为什么反转源句可能有帮助,却不是翻译时把意思倒着理解等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S3.F3
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 用四词序列证明反转不缩短平均依赖距离
- 加入两层搜索树区分搜索与建模错误
- 修正相邻编号不等于直接历史继承
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图3、表2
- v2:问答核查:为什么反转源句可能有帮助,却不是翻译时把意思倒着理解等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2模型、§3.2搜索、§3.3反转与平均距离、§3.4训练
技术关系
- 001-lstm · 模块组合
循环记忆模块用于编码与解码
- 007-attention · 平行方法
同期编码解码方案
- 015-transformer · 历史背景
条件生成接口保留而内部计算改变
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Neural Machine Translation by Jointly Learning to Align and Translate部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:每个目标词需要的源信息是否必须提前挤进一个摘要
- 二、由软加权推导对齐网络接收翻译梯度
- 三、联合训练注释、打分和解码,推理时替换前缀
- 四、分开读句长曲线、BLEU列与四个对齐样例
- 五、可访问源位置,仍不保证读对实体关系
- 六、把本篇机制再推进一步
- 七、把动态读取扩为注意力架构
- 自测与参考答案
段落怎样重新安排
- 问题定义:一个摘要为什么不够 → 每个目标词需要的源信息是否必须提前挤进一个摘要
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 可访问源位置,仍不保证读对实体关系
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把动态读取扩为注意力架构
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:打分、归一化、加权读取 → 由软加权推导对齐网络接收翻译梯度
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:打分、归一化、加权读取 → 由软加权推导对齐网络接收翻译梯度
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:打分、归一化、加权读取 → 联合训练注释、打分和解码,推理时替换前缀
单列可执行步骤,与机制论证及经验结果区分
- 方法:打分、归一化、加权读取 → 联合训练注释、打分和解码,推理时替换前缀
保留实现限制、训练协议及指标接口
- 实验设计 → 分开读句长曲线、BLEU列与四个对齐样例
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:动态读取与固定摘要 → 由软加权推导对齐网络接收翻译梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:动态读取与固定摘要 → 由软加权推导对齐网络接收翻译梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:动态读取与固定摘要 → 可访问源位置,仍不保证读对实体关系
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:动态读取与固定摘要 → 分开读句长曲线、BLEU列与四个对齐样例
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与限制 → 可访问源位置,仍不保证读对实体关系
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与限制 → 可访问源位置,仍不保证读对实体关系
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与限制 → 可访问源位置,仍不保证读对实体关系
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把对齐向量的归一化轴写进尺寸
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、把动态读取扩为注意力架构
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把对齐向量的归一化轴写进尺寸:把对齐向量的归一化轴写进尺寸
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
原论文校准:Bahdanau注意力原式对源索引j做softmax并加权注释;借用逐位置→矩阵的教法,未改成Transformer点积注意力。
本篇校准范围:Bahdanau注意力原式对源索引j做softmax并加权注释;借用逐位置→矩阵的教法,未改成Transformer点积注意力。 新增段落仅用于“把对齐向量的归一化轴写进尺寸”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- RNNsearch与固定摘要编码器的BLEU随源句长度变化
实验/结果图 · 必要原图摘引 · 图2,HTML #S4.F2.fig1
证据三,图2的句长曲线与图3的对齐热图。长句趋势支持固定摘要瓶颈的解释,对齐图帮助理解动态读取。图2包含未知词的完整测试集;图3横轴是英语源词,纵轴是生成的法语词,黑到白表示权重由0到1。热图只有四个样例,后三个来自长度10—20且无未知词的子集。曲线不能证明任意长度都不退化,少数可视化也不能证明所有输出都忠实使用正确源词。
- 四个英语到法语翻译样例中的源词与目标词注意力对齐热图
实验/结果图 · 必要原图摘引 · 图3,HTML #S4.F3
证据三,图2的句长曲线与图3的对齐热图。长句趋势支持固定摘要瓶颈的解释,对齐图帮助理解动态读取。图2包含未知词的完整测试集;图3横轴是英语源词,纵轴是生成的法语词,黑到白表示权重由0到1。热图只有四个样例,后三个来自长度10—20且无未知词的子集。曲线不能证明任意长度都不退化,少数可视化也不能证明所有输出都忠实使用正确源词。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 为未编号的句长曲线和对齐热图补原图2/3入口,解释坐标、灰度方向与样例筛选范围
- 原文定位已接入正文:表1、图2、图3
- 问答核查:为什么软对齐可以不依赖人工词对齐标签等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表1 · 表1;HTML元素 #S5.T1.fig1
原站图表/证明入口
- 图2 · 图2;HTML元素 #S4.F2.fig1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S4.F3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 展开softmax到上下文的梯度推导
- 加入可手算的读取权重更新
- 纠正软对齐并非显式潜变量推断
- v2:为未编号的句长曲线和对齐热图补原图2/3入口,解释坐标、灰度方向与样例筛选范围
- v2:原文定位已接入正文:表1、图2、图3
- v2:问答核查:为什么软对齐可以不依赖人工词对齐标签等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1式5、6与联合反传;§3.2双向注释
技术关系
- 006-seq2seq · 平行方法
同期固定摘要编码解码模型
- 015-transformer · 直接继承
可微注意力思想扩大为主要序列交互
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型GloVe: Global Vectors for Word Representation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样让向量反映词之间的相对共现关系
- 二、从概率比推到带偏置的对数共现拟合
- 三、先建非零共现矩阵,再优化并组合两组向量
- 四、把类比、相似度排序和实体识别分开评价
- 五、共现几何仍受频率、窗口与语境混合约束
- 六、把本篇机制再推进一步
- 七、从静态词类型转到上下文中的词
- 自测与参考答案
段落怎样重新安排
- 背景:只看次数,还是看相对关系 → 怎样让向量反映词之间的相对共现关系
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 共现几何仍受频率、窗口与语境混合约束
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从静态词类型转到上下文中的词
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:拟合对数共现,而非逐词归一化 → 从概率比推到带偏置的对数共现拟合
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:拟合对数共现,而非逐词归一化 → 从概率比推到带偏置的对数共现拟合
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:拟合对数共现,而非逐词归一化 → 先建非零共现矩阵,再优化并组合两组向量
单列可执行步骤,与机制论证及经验结果区分
- 方法:拟合对数共现,而非逐词归一化 → 先建非零共现矩阵,再优化并组合两组向量
保留实现限制、训练协议及指标接口
- 实验设计与证据 → 把类比、相似度排序和实体识别分开评价
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:偏置与权重为什么不能删掉 → 从概率比推到带偏置的对数共现拟合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:偏置与权重为什么不能删掉 → 从概率比推到带偏置的对数共现拟合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:偏置与权重为什么不能删掉 → 共现几何仍受频率、窗口与语境混合约束
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:偏置与权重为什么不能删掉 → 把类比、相似度排序和实体识别分开评价
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 几何结论应该怎样阅读 → 共现几何仍受频率、窗口与语境混合约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 几何结论应该怎样阅读 → 共现几何仍受频率、窗口与语境混合约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 共现几何仍受频率、窗口与语境混合约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 共现几何仍受频率、窗口与语境混合约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用共同平移检验偏置吸收了什么
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、从静态词类型转到上下文中的词
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 用共同平移检验偏置吸收了什么:用共同平移检验偏置吸收了什么
原论文校准与展开范围
原论文校准:GloVe目标中的log计数、词与上下文偏置和加权函数;明确冻结权重函数是假设而非真实数据改动完全等价。
本篇校准范围:GloVe目标中的log计数、词与上下文偏置和加权函数;明确冻结权重函数是假设而非真实数据改动完全等价。 新增段落仅用于“用共同平移检验偏置吸收了什么”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 不同词向量方法在词相似度数据集上的Spearman相关系数
实验/结果图 · 必要原图摘引 · 表3,PDF第8页
证据二,表2 与表3。类比和相似度分别检验不同性质,不能因为一种任务提升就概括为所有语义更好。表3 使用 Spearman 相关,比较的是向量相似度排序与人工判断排序,不是词语分类正确率。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表2、表3、表4
- 问答核查:为什么 GloVe 训练损失下降,不等于语言困惑度下降等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表2 · PDF第6页,表2
原站图表/证明入口
- 表3 · PDF第8页,表3
原站图表/证明入口
- 表4 · PDF第9页,表4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补全概率比到内积差及偏置的推导
- 加入对数比手算与零计数实现边界
- 区分统计目标和上下文化表示对象
- v2:原文定位已接入正文:表2、表3、表4
- v2:问答核查:为什么 GloVe 训练损失下降,不等于语言困惑度下降等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- aclanthology.org · 所列章节
§2式2—8、概率比、偏置与零计数权重
技术关系
- 005-negative-sampling · 平行方法
不同的词共现表示目标
- 016-elmo · 历史背景
静态词类型到上下文token表示
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Adam: A Method for Stochastic Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一个学习率怎样兼顾方向噪声与坐标尺度
- 二、展开矩估计,推导零初始化的偏差修正
- 三、连同矩状态和步数保存完整更新过程
- 四、按相同调参条件比较损失与墙钟时间
- 五、更快优化不提供无条件收敛或泛化保证
- 六、把本篇机制再推进一步
- 七、将更新规则接入模型,再分片存储状态
- 自测与参考答案
段落怎样重新安排
- 背景:方向噪声与尺度差异 → 一个学习率怎样兼顾方向噪声与坐标尺度
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 更快优化不提供无条件收敛或泛化保证
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 将更新规则接入模型,再分片存储状态
真实关系移到后继路线,避免目录相邻等于技术继承
- 算法:两个矩估计与偏差修正 → 展开矩估计,推导零初始化的偏差修正
先给出信息路径、目标与机制,再讨论执行顺序
- 算法:两个矩估计与偏差修正 → 展开矩估计,推导零初始化的偏差修正
将原来的后置推导提前,解释伪代码为何这样计算
- 算法:两个矩估计与偏差修正 → 连同矩状态和步数保存完整更新过程
单列可执行步骤,与机制论证及经验结果区分
- 算法:两个矩估计与偏差修正 → 连同矩状态和步数保存完整更新过程
保留实现限制、训练协议及指标接口
- 实验设计与证据 → 按相同调参条件比较损失与墙钟时间
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学计算:第一步的偏差修正 → 展开矩估计,推导零初始化的偏差修正
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学计算:第一步的偏差修正 → 展开矩估计,推导零初始化的偏差修正
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学计算:第一步的偏差修正 → 展开矩估计,推导零初始化的偏差修正
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学计算:第一步的偏差修正 → 更快优化不提供无条件收敛或泛化保证
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与边界 → 更快优化不提供无条件收敛或泛化保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 更快优化不提供无条件收敛或泛化保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 更快优化不提供无条件收敛或泛化保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 更快优化不提供无条件收敛或泛化保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 第一次更新怎样受epsilon影响
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、将更新规则接入模型,再分片存储状态
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 第一次更新怎样受epsilon影响:第一次更新怎样受epsilon影响
原论文校准与展开范围
原论文校准:Adam原算法的偏差修正与分母epsilon;推演限于第一步和标量,不宣称后续恒为符号更新。
本篇校准范围:Adam原算法的偏差修正与分母epsilon;推演限于第一步和标量,不宣称后续恒为符号更新。 新增段落仅用于“第一次更新怎样受epsilon影响”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读图2的三个面板。** 左侧在带dropout的网络上按遍历整份数据的次数比较训练损失,纵轴是对数刻度;右侧另做Adam与SFO的比较,上面按数据遍历次数,下面按归一化墙钟时间。要判断实际速度,应在同一个右侧面板里比较达到相同损失的位置,不能把不同网络设置的曲线拼成一次排名。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- Adam与其他优化器在MNIST多层网络训练中的损失曲线
实验/结果图 · 必要原图摘引 · 图2,PDF第7页
读图2的三个面板。 左侧在带dropout的网络上按遍历整份数据的次数比较训练损失,纵轴是对数刻度;右侧另做Adam与SFO的比较,上面按数据遍历次数,下面按归一化墙钟时间。要判断实际速度,应在同一个右侧面板里比较达到相同损失的位置,不能把不同网络设置的曲线拼成一次排名。
- Adam与其他优化器在MNIST和IMDB逻辑回归上的训练损失
实验/结果图 · 必要原图摘引 · 图1,PDF第6页
**证据二,[图1](https://arxiv.org/pdf/1412.6980#page=6)。**逻辑回归比较涉及密集与稀疏特征,说明不同梯度结构下方法关系并不相同。这些图的横轴是迭代或遍历数据次数,纵轴是训练负对数似然或训练代价。下降更快首先表示优化更快,不能直接读成测试准确率或泛化提高。
- Adam与其他优化器在CIFAR10卷积网络早期及完整训练中的损失
实验/结果图 · 必要原图摘引 · 图3,PDF第7页
**证据三,[图2](https://arxiv.org/pdf/1412.6980#page=7)、[图3](https://arxiv.org/pdf/1412.6980#page=7)。**全连接和卷积实验观察非凸优化,在[图2](https://arxiv.org/pdf/1412.6980#page=7) 的相关比较中还讨论每次迭代成本。训练进度与时间同时呈现,是区分“更新次数少”和“实际更快”的必要步骤,但这些硬件条件不能直接映射到今天的大语言模型。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图1、图2、图3
- 问答核查:$v_t$ 为什么不能直接叫梯度方差等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 图1 · PDF第6页,图1
原站图表/证明入口
- 图2 · PDF第7页,图2
原站图表/证明入口
- 图3 · PDF第7页,图3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 从几何级数推导初始化修正
- 加入反向梯度第二步数值例
- 关联Adam状态与ZeRO存储分片
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图1、图2、图3
- v2:问答核查:$v_t$ 为什么不能直接叫梯度方差等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读图2的三个面板。** 左侧在带dropout的网络上按遍历整份数据的次数比较训练损失,纵轴是对数刻度;右侧另做Adam与SFO的比较,上面按数据遍历次数,下面按归一化墙钟时间。要判断实际速度,应在同一个右侧面板里比较达到相同损失的位置,不能把不同网络设置的曲线拼成一次排名。
查核资料
- arxiv.org · 所列章节
算法1、§2矩更新与§3初始化偏差修正
- arxiv.org · 所列章节
读图2的三个面板。 左侧在带dropout的网络上按遍历整份数据的次数比较训练损失,纵轴是对数刻度;右侧另做Adam与SFO的比较,上面按数据遍历次数,下面按归一化墙钟时间。要判断实际速度,应在同一个右侧面板里比较达到相同损失的位置,不能把不同网络设置的曲线拼成一次排名。
技术关系
- 015-transformer · 模块组合
优化器与架构训练配方组合
- 026-zero · 模块组合
优化器状态被分片存储
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Distilling the Knowledge in a Neural Network部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:便宜学生怎样接收集成模型的类别混淆结构
- 二、从温度分布推导软硬目标与梯度尺度
- 三、冻结教师,分别记录迁移训练和学生部署成本
- 四、对照 MNIST、语音指标与迁移集覆盖条件
- 五、学生容量和教师错误限制了转移内容
- 六、把本篇机制再推进一步
- 七、从分类分布匹配走向语言模型轨迹监督
- 自测与参考答案
段落怎样重新安排
- 背景:集成有用,但执行昂贵 → 便宜学生怎样接收集成模型的类别混淆结构
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 学生容量和教师错误限制了转移内容
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从分类分布匹配走向语言模型轨迹监督
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:温度和两个目标 → 从温度分布推导软硬目标与梯度尺度
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:温度和两个目标 → 从温度分布推导软硬目标与梯度尺度
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:温度和两个目标 → 冻结教师,分别记录迁移训练和学生部署成本
单列可执行步骤,与机制论证及经验结果区分
- 方法:温度和两个目标 → 冻结教师,分别记录迁移训练和学生部署成本
保留实现限制、训练协议及指标接口
- 实验与证据 → 对照 MNIST、语音指标与迁移集覆盖条件
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:软标签多提供了什么 → 从温度分布推导软硬目标与梯度尺度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:软标签多提供了什么 → 从温度分布推导软硬目标与梯度尺度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:软标签多提供了什么 → 学生容量和教师错误限制了转移内容
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:软标签多提供了什么 → 学生容量和教师错误限制了转移内容
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 与语言模型蒸馏的联系 → 从分类分布匹配走向语言模型轨迹监督
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 与语言模型蒸馏的联系 → 从分类分布匹配走向语言模型轨迹监督
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 学生容量和教师错误限制了转移内容
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 学生容量和教师错误限制了转移内容
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把学生的一步梯度接到非最高类
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、从分类分布匹配走向语言模型轨迹监督
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把学生的一步梯度接到非最高类:把学生的一步梯度接到非最高类
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:蒸馏软交叉熵导数q−p;数字直接使用正文自构分布,博客用于把压缩目标和部署成本分开的教法。
本篇校准范围:蒸馏软交叉熵导数q−p;数字直接使用正文自构分布,博客用于把压缩目标和部署成本分开的教法。 新增段落仅用于“把学生的一步梯度接到非最高类”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 教师集成、基线和蒸馏学生的帧准确率与词错误率
实验/结果图 · 必要原图摘引 · 表1,PDF第5页
证据三,表1 语音结果。基线帧准确率 58.9%、WER 10.9%;10 模型集成为 61.1%、10.7%;蒸馏单模型为 60.8%、10.7%。帧指标改善更明显,WER 的变化较小,说明代理训练目标与最终系统指标并不一一对应。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表5
- 问答核查:为什么软目标可能比硬标签提供更多训练信息等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表5 · 表5;HTML元素 #S6.T5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补全温度平方的链式推导
- 加入logit平移不变性的MSE反例
- 限定分类软目标与推理轨迹蒸馏的继承范围
- v2:原文定位已接入正文:表1、表5
- v2:问答核查:为什么软目标可能比硬标签提供更多训练信息等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1式2—4高温梯度、§3 MNIST温度与容量实验
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Neural Machine Translation of Rare Words with Subword Units部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:遇到新名字时,翻译器能否避免把它整个变成UNK
- 二、按频率学习有序合并,而不是寻找语言学词素
- 三、固定分词、边界标记和解码规则
- 四、同时比较稀有词、OOV、词表与序列长度
- 五、可编码的新词仍可能难理解、复制或翻译
- 六、把本篇机制再推进一步
- 七、区分子词向量共享与字节级分词
- 自测与参考答案
段落怎样重新安排
- 背景:未知词有不同成因 → 遇到新名字时,翻译器能否避免把它整个变成UNK
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 可编码的新词仍可能难理解、复制或翻译
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 区分子词向量共享与字节级分词
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:从字符开始,逐步合并常见相邻符号 → 按频率学习有序合并,而不是寻找语言学词素
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:从字符开始,逐步合并常见相邻符号 → 按频率学习有序合并,而不是寻找语言学词素
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:从字符开始,逐步合并常见相邻符号 → 固定分词、边界标记和解码规则
单列可执行步骤,与机制论证及经验结果区分
- 方法:从字符开始,逐步合并常见相邻符号 → 固定分词、边界标记和解码规则
保留实现限制、训练协议及指标接口
- 实验设置与证据 → 同时比较稀有词、OOV、词表与序列长度
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学推演:新的词为何仍然可读 → 按频率学习有序合并,而不是寻找语言学词素
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学推演:新的词为何仍然可读 → 按频率学习有序合并,而不是寻找语言学词素
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学推演:新的词为何仍然可读 → 可编码的新词仍可能难理解、复制或翻译
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学推演:新的词为何仍然可读 → 同时比较稀有词、OOV、词表与序列长度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 成本与评价的细节 → 同时比较稀有词、OOV、词表与序列长度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 成本与评价的细节 → 同时比较稀有词、OOV、词表与序列长度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 可编码的新词仍可能难理解、复制或翻译
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 可编码的新词仍可能难理解、复制或翻译
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用合并排名处理同一串字符
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、区分子词向量共享与字节级分词
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 用合并排名处理同一串字符:用合并排名处理同一串字符
原论文校准与展开范围
原论文校准:BPE按已学合并顺序应用的机制;字符和规则为自构,不声称是原论文词表。
本篇校准范围:BPE按已学合并顺序应用的机制;字符和规则为自构,不声称是原论文词表。 新增段落仅用于“用合并排名处理同一串字符”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 英德翻译中不同分词方案的BLEU、chrF3和稀有词F1
实验/结果图 · 必要原图摘引 · 表2,PDF第6页
证据三,表2、表3。英德表中,集成条件下稀有词 F1 从词典回退的 36.8% 到联合 BPE 的 41.8%;但 OOV 子项并非所有子词方案都更高。整体改善与每个细分指标改善不是同一结论。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表2、表3
- 问答核查:BPE 能拆开新词,是否表示模型理解了新词等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补足BPE有序规则及重计数机制
- 原创频次词表手推合并
- 区分BPE序列分割与fastText重叠特征
- v2:原文定位已接入正文:表1、表2、表3
- v2:问答核查:BPE 能拆开新词,是否表示模型理解了新词等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.2与算法1的频次加权、合并顺序、结束符
技术关系
- 013-fasttext · 平行方法
字符子结构的不同使用方式
- 021-gpt2 · 历史背景
后续byte-level分词改造
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Layer Normalization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:单个序列样本能否摆脱同批输入的统计影响
- 二、沿特征轴推导中心化、尺度和反传耦合
- 三、核对归一化轴、时间范围与仿射参数
- 四、分开读结构不变性、Recall与训练速度
- 五、消去的均值和尺度可能也是任务信息
- 六、把本篇机制再推进一步
- 七、把归一化放进残差网络,再比较RMSNorm
- 自测与参考答案
段落怎样重新安排
- 背景:统计范围是一项模型假设 → 单个序列样本能否摆脱同批输入的统计影响
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 消去的均值和尺度可能也是任务信息
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把归一化放进残差网络,再比较RMSNorm
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:中心化、缩放,再恢复可学习自由度 → 沿特征轴推导中心化、尺度和反传耦合
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:中心化、缩放,再恢复可学习自由度 → 沿特征轴推导中心化、尺度和反传耦合
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:中心化、缩放,再恢复可学习自由度 → 核对归一化轴、时间范围与仿射参数
单列可执行步骤,与机制论证及经验结果区分
- 方法:中心化、缩放,再恢复可学习自由度 → 核对归一化轴、时间范围与仿射参数
保留实现限制、训练协议及指标接口
- 实验设置与结果 → 分开读结构不变性、Recall与训练速度
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:batch 变化与特征变化 → 沿特征轴推导中心化、尺度和反传耦合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:batch 变化与特征变化 → 沿特征轴推导中心化、尺度和反传耦合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:batch 变化与特征变化 → 消去的均值和尺度可能也是任务信息
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:batch 变化与特征变化 → 消去的均值和尺度可能也是任务信息
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 与 Transformer 的联系 → 核对归一化轴、时间范围与仿射参数
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 与 Transformer 的联系 → 核对归一化轴、时间范围与仿射参数
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 消去的均值和尺度可能也是任务信息
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 消去的均值和尺度可能也是任务信息
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 沿一个token的通道做平移检查
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、把归一化放进残差网络,再比较RMSNorm
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 沿一个token的通道做平移检查:沿一个token的通道做平移检查
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
原论文校准:LayerNorm原式按单个样本的特征维归一化;小例子使用总体方差,未混入BatchNorm跨样本统计。
本篇校准范围:LayerNorm原式按单个样本的特征维归一化;小例子使用总体方差,未混入BatchNorm跨样本统计。 新增段落仅用于“沿一个token的通道做平移检查”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 有无LayerNorm时图像检索Recall@1、Recall@5和Recall@10的训练曲线
实验/结果图 · 必要原图摘引 · 图1,HTML #S6.F1
证据二,图1 与表2 的图文检索。图展示 Recall@K 随训练变化;表中 OE 与 OE+LN 的 caption retrieval R@1 分别为 46.6 与 48.5。它支持该模型上的训练和任务收益,不证明所有任务都增加相同比例。 这里的曲线测的是图文检索 Recall@K;比较同一个 K 下有无 LayerNorm 的差异,不要把它解释成语言模型困惑度曲线。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 将“实验证据定位”标题改为“实验设置与结果”,不另设低信息定位栏
- 原文定位已接入正文:图1、表2、表1
- 问答核查:batch size 为 1 时,LayerNorm 为什么仍能计算等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 图1 · 图1;HTML元素 #S6.F1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S6.T2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 加入LN梯度及不变方向推导
- 用仿射变换例限定不变性
- 区分LN与后续RMSNorm
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:将“实验证据定位”标题改为“实验设置与结果”,不另设低信息定位栏
- v2:原文定位已接入正文:图1、表2、表1
- v2:问答核查:batch size 为 1 时,LayerNorm 为什么仍能计算等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3式3—4、逐样本统计、§5不变性分析
技术关系
- 015-transformer · 模块组合
归一化进入注意力残差块
- 068-llama · 教学联系
比较中心化与RMS缩放
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Enriching Word Vectors with Subword Information部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:罕见词与未登录词怎样借到其他词的训练信号
- 二、由重叠字符片段推导跨词共享的梯度
- 三、同时保留边界、整词项与哈希桶约定
- 四、按词频、覆盖协议和语言读取相关指标
- 五、有益字形共享也会造成错误语义迁移
- 六、把本篇机制再推进一步
- 七、比较两种子词接口,不把静态表示当成上下文化
- 自测与参考答案
段落怎样重新安排
- 背景:稀有词和词表外词不是同一个问题 → 罕见词与未登录词怎样借到其他词的训练信号
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 有益字形共享也会造成错误语义迁移
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 比较两种子词接口,不把静态表示当成上下文化
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:词向量由片段组成 → 由重叠字符片段推导跨词共享的梯度
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:词向量由片段组成 → 由重叠字符片段推导跨词共享的梯度
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:词向量由片段组成 → 同时保留边界、整词项与哈希桶约定
单列可执行步骤,与机制论证及经验结果区分
- 方法:词向量由片段组成 → 同时保留边界、整词项与哈希桶约定
保留实现限制、训练协议及指标接口
- 实验设计与证据 → 按词频、覆盖协议和语言读取相关指标
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:共享从哪里来 → 由重叠字符片段推导跨词共享的梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:共享从哪里来 → 由重叠字符片段推导跨词共享的梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:共享从哪里来 → 有益字形共享也会造成错误语义迁移
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:共享从哪里来 → 有益字形共享也会造成错误语义迁移
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 怎样设计有说服力的子词消融 → 按词频、覆盖协议和语言读取相关指标
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 怎样设计有说服力的子词消融 → 按词频、覆盖协议和语言读取相关指标
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 怎样设计有说服力的子词消融 → 按词频、覆盖协议和语言读取相关指标
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 有益字形共享也会造成错误语义迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 有益字形共享也会造成错误语义迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 同一个子词被使用两次时怎样计梯度
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、比较两种子词接口,不把静态表示当成上下文化
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 同一个子词被使用两次时怎样计梯度:同一个子词被使用两次时怎样计梯度
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Word2vec
Language Modeling、Language Model Training、Skipgram
原论文校准:fastText子词向量求和及哈希桶共享;梯度数值自构。
本篇校准范围:fastText子词向量求和及哈希桶共享;梯度数值自构。 新增段落仅用于“同一个子词被使用两次时怎样计梯度”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 多种语言词相似度任务中Skip-gram与子词表示的相关系数
实验/结果图 · 必要原图摘引 · 表1,PDF第5页
证据二,表1。英文 Rare Words 相关分数从 Skip-gram 的 43 到子词方法的 47,而英文 WS353 中并非同样提升,表中子词为 71、CBOW 为 73。实验支持某些场景获益,也清楚提供了非普遍优势的例子。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1
- 问答核查:fastText 子词与 BPE 为什么不是同一个操作等3题均有独立对应答案;保留已有有效解释
查看本篇 1 个原文证据入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导共享片段梯度
- 构造带边界三字符共享例
- 补充哈希碰撞与形义不一致边界
- v2:原文定位已接入正文:表1
- v2:问答核查:fastText 子词与 BPE 为什么不是同一个操作等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.2式s(w,c)、边界符号、整词项及哈希
技术关系
- 005-negative-sampling · 直接继承
在Skip-gram训练中换子词输入表示
- 011-bpe · 平行方法
重叠片段与分割序列不同
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:扩大总参数时,能否只执行少数专家
- 二、从稀疏权重区分单token计算与跨token均衡
- 三、先路由再分发,记录专家负载和通信
- 四、用相同计算预算读容量、困惑度与设备效率
- 五、闲置专家与数据分配会耗掉名义容量
- 六、把本篇机制再推进一步
- 七、沿分布式扩展、简化路由与解码器组合继续读
- 自测与参考答案
段落怎样重新安排
- 背景:容量与每次计算能否分开增长 → 扩大总参数时,能否只执行少数专家
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 闲置专家与数据分配会耗掉名义容量
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 沿分布式扩展、简化路由与解码器组合继续读
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:稀疏选择与加权专家输出 → 从稀疏权重区分单token计算与跨token均衡
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:稀疏选择与加权专家输出 → 从稀疏权重区分单token计算与跨token均衡
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:稀疏选择与加权专家输出 → 先路由再分发,记录专家负载和通信
单列可执行步骤,与机制论证及经验结果区分
- 方法:稀疏选择与加权专家输出 → 先路由再分发,记录专家负载和通信
保留实现限制、训练协议及指标接口
- 实验与三类证据 → 用相同计算预算读容量、困惑度与设备效率
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:为什么会发生专家坍缩 → 从稀疏权重区分单token计算与跨token均衡
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么会发生专家坍缩 → 从稀疏权重区分单token计算与跨token均衡
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么会发生专家坍缩 → 闲置专家与数据分配会耗掉名义容量
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么会发生专家坍缩 → 先路由再分发,记录专家负载和通信
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与边界 → 闲置专家与数据分配会耗掉名义容量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 闲置专家与数据分配会耗掉名义容量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 闲置专家与数据分配会耗掉名义容量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 闲置专家与数据分配会耗掉名义容量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用路由矩阵区分稀疏度和拥堵
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、沿分布式扩展、简化路由与解码器组合继续读
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用路由矩阵区分稀疏度和拥堵:用路由矩阵区分稀疏度和拥堵
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:稀疏MoE原文路由与负载目标;不把自构4专家的计数当成论文吞吐测量。
本篇校准范围:稀疏MoE原文路由与负载目标;不把自构4专家的计数当成论文吞吐测量。 新增段落仅用于“用路由矩阵区分稀疏度和拥堵”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 稀疏MoE语言模型的测试困惑度与参数容量、每步计算预算的关系
实验/结果图 · 必要原图摘引 · 图2,HTML #S5.F2
证据三,图2 与附录 C。不同预算与容量的曲线、具体模型配置共同支撑取舍。只截取最大参数模型或最快模型,会丢掉质量、时间和硬件利用率之间的变化。 左右子图回答不同问题:左侧在相近每步计算预算下改变容量,右侧改变计算预算。只沿容量横轴比较,不能推出所有部署费用都不变。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图2
- 问答核查:总参数增加十倍,为什么每个 token 的运算可以只增加少量等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
- 图2 · 图2;HTML元素 #S5.F2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 讲清top-k置负无穷与梯度区域
- 四专家权重及热门设备瓶颈算例
- 标明后续MoE继承与架构组合
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图2
- v2:问答核查:总参数增加十倍,为什么每个 token 的运算可以只增加少量等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2式1—5、noisy top-k及路由训练
技术关系
- 037-gshard · 直接继承
稀疏专家分布式扩展
- 042-switch · 直接继承
后作继承稀疏专家框架,将每个token的路由简化到单个专家。
- 084-mixtral · 模块组合
稀疏FFN进入解码器
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Attention Is All You Need部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:远距信息怎样直接交互,同时去掉训练中的递归依赖
- 二、从查询键值、缩放和掩码推到多头交互
- 三、按原版残差顺序实现,并分开训练与生成
- 四、按结构图、翻译主结果和base消融逐层归因
- 五、短路径不保证有效读取,长度成本仍然存在
- 六、把本篇机制再推进一步
- 七、分清精确注意力执行优化与键值头共享
- 自测与参考答案
段落怎样重新安排
- 背景:路径长度与并行性是两个问题 → 远距信息怎样直接交互,同时去掉训练中的递归依赖
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 短路径不保证有效读取,长度成本仍然存在
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 分清精确注意力执行优化与键值头共享
真实关系移到后继路线,避免目录相邻等于技术继承
- 核心运算:按查询读取值 → 从查询键值、缩放和掩码推到多头交互
先给出信息路径、目标与机制,再讨论执行顺序
- 核心运算:按查询读取值 → 从查询键值、缩放和掩码推到多头交互
将原来的后置推导提前,解释伪代码为何这样计算
- 核心运算:按查询读取值 → 按原版残差顺序实现,并分开训练与生成
单列可执行步骤,与机制论证及经验结果区分
- 核心运算:按查询读取值 → 按原版残差顺序实现,并分开训练与生成
保留实现限制、训练协议及指标接口
- 实验与证据 → 按结构图、翻译主结果和base消融逐层归因
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:因果掩码为何不可省略 → 从查询键值、缩放和掩码推到多头交互
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:因果掩码为何不可省略 → 按原版残差顺序实现,并分开训练与生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:因果掩码为何不可省略 → 按原版残差顺序实现,并分开训练与生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:因果掩码为何不可省略 → 短路径不保证有效读取,长度成本仍然存在
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 并行训练与串行生成 → 按原版残差顺序实现,并分开训练与生成
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 并行训练与串行生成 → 按原版残差顺序实现,并分开训练与生成
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 短路径不保证有效读取,长度成本仍然存在
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 短路径不保证有效读取,长度成本仍然存在
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 专业解读中的逐位置→矩阵教法 → 用同一套尺寸读懂图1的三种注意力
补充本篇具体计算核对,不用泛泛来源列表替代正文解释
- 原阅读路线及重复前作说明 → ## 七、分清精确注意力执行优化与键值头共享
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用同一套尺寸读懂图1的三种注意力:将同技术家族的计算路径教学法用于本篇,自构可核算实例或诊断;不是博客原文翻译
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
- Lilian Weng · The Transformer Family
vanilla位置编码;Transformer-XL状态复用、相对位置和张量拼接
原论文校准:原文§3.2的Q/K/V及多头定义;自构尺寸由已保留公式逐项相乘得到,不新增论文实验结论。
本篇校准范围:原文§3.2的Q/K/V及多头定义;自构尺寸由已保留公式逐项相乘得到,不新增论文实验结论。 新增段落仅用于“用同一套尺寸读懂图1的三种注意力”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读表3先定位base行。** 空白配置格沿用base设置,A—E各组再改变头数、键宽度、模型规模、正则或位置表示。PPL(dev)越低越好,BLEU(dev)越高越好,二者是不同指标;big行还增加了训练步数,所以不能把它对base的差值归给头数或宽度中的单个改动。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Transformer编码器和解码器中的多头注意力、前馈层、残差连接及移位目标输入
方法/设定图 · 必要原图摘引 · 图1,HTML #S3.F1
证据一,图1、第 3 节与表1。结构图、公式与计算比较展示了取消循环后的路径和成本。表1 的理论复杂度不能直接视为每种硬件上的速度排名。 左侧编码器生成可读取的表示,右侧解码器的交叉注意力再读取它;右侧最下层注意力带因果掩码。按这三种信息来源追箭头,比把所有方框统称为“注意力”更能看清架构。
- Transformer结构变体的验证困惑度、BLEU与参数量消融
实验/结果图 · 必要原图摘引 · 表3,PDF第9页
读表3先定位base行。 空白配置格沿用base设置,A—E各组再改变头数、键宽度、模型规模、正则或位置表示。PPL(dev)越低越好,BLEU(dev)越高越好,二者是不同指标;big行还增加了训练步数,所以不能把它对base的差值归给头数或宽度中的单个改动。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 补架构原图的编码器、交叉注意力与因果掩码读图顺序
- 原文定位已接入正文:表3、图1、表1、表2
- 问答核查:训练位置可以并行,为什么生成仍然逐 token等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表3 · 表3;HTML元素 #S6.T3
原站图表/证明入口
- 图1 · 图1;HTML元素 #S3.F1
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S6.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 完整维度追踪与缩放统计推导
- QK配权与V读出数值例
- 拆分架构继承、训练模块和推理实现关系
- v2:补架构原图的编码器、交叉注意力与因果掩码读图顺序
- v2:原文定位已接入正文:表3、图1、表1、表2
- v2:问答核查:训练位置可以并行,为什么生成仍然逐 token等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读表3先定位base行。** 空白配置格沿用base设置,A—E各组再改变头数、键宽度、模型规模、正则或位置表示。PPL(dev)越低越好,BLEU(dev)越高越好,二者是不同指标;big行还增加了训练步数,所以不能把它对base的差值归给头数或宽度中的单个改动。
查核资料
- arxiv.org · 所列章节
§3.2.1脚注方差、§3.2.2投影形状与多头宽度
- arxiv.org · 所列章节
证据一,图1、第 3 节与表1。结构图、公式与计算比较展示了取消循环后的路径和成本。表1 的理论复杂度不能直接视为每种硬件上的速度排名。 左侧编码器生成可读取的表示,右侧解码器的交叉注意力再读取它;右侧最下层注意力带因果掩码。按这三种信息来源追箭头,比把所有方框统称为“注意力”更能看清架构。
- arxiv.org · 所列章节
读表3先定位base行。 空白配置格沿用base设置,A—E各组再改变头数、键宽度、模型规模、正则或位置表示。PPL(dev)越低越好,BLEU(dev)越高越好,二者是不同指标;big行还增加了训练步数,所以不能把它对base的差值归给头数或宽度中的单个改动。
技术关系
- 007-attention · 直接继承
可微注意力思想
- 012-layernorm · 模块组合
Transformer各子层将LayerNorm与残差连接组合,规范层内激活。
- 009-adam · 模块组合
原Transformer训练采用Adam更新网络参数,优化器与注意力结构是不同组件。
- 059-flashattention · 直接继承
精确注意力的IO优化
- 073-gqa · 直接继承
键值头组织改造
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Deep Contextualized Word Representations部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同一拼写在不同句子里怎样获得不同表示
- 二、区分双向语言预测、位置激活与任务层混合
- 三、将预训练特征接入下游,并记录领域适配
- 四、按任务模型、层选择和重复协议读取收益
- 五、上下文化仍需检验关系使用与运行成本
- 六、把本篇机制再推进一步
- 七、对照特征迁移、整体微调与深层双向交互
- 自测与参考答案
段落怎样重新安排
- 背景:静态表示难以区分用法 → 同一拼写在不同句子里怎样获得不同表示
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 上下文化仍需检验关系使用与运行成本
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 对照特征迁移、整体微调与深层双向交互
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:多个层次,由任务决定怎么组合 → 区分双向语言预测、位置激活与任务层混合
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:多个层次,由任务决定怎么组合 → 区分双向语言预测、位置激活与任务层混合
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:多个层次,由任务决定怎么组合 → 将预训练特征接入下游,并记录领域适配
单列可执行步骤,与机制论证及经验结果区分
- 方法:多个层次,由任务决定怎么组合 → 将预训练特征接入下游,并记录领域适配
保留实现限制、训练协议及指标接口
- 实验与证据 → 按任务模型、层选择和重复协议读取收益
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:同词不同向量 → 区分双向语言预测、位置激活与任务层混合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:同词不同向量 → 区分双向语言预测、位置激活与任务层混合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:同词不同向量 → 上下文化仍需检验关系使用与运行成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:同词不同向量 → 按任务模型、层选择和重复协议读取收益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 为什么上下文化不是全部答案 → 上下文化仍需检验关系使用与运行成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么上下文化不是全部答案 → 上下文化仍需检验关系使用与运行成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 上下文化仍需检验关系使用与运行成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 上下文化仍需检验关系使用与运行成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 防止双向特征里混入预测标签
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、对照特征迁移、整体微调与深层双向交互
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 防止双向特征里混入预测标签:防止双向特征里混入预测标签
教法来源与实际阅读范围
- Christopher Olah · Understanding LSTM Networks
展开循环图、长期依赖、状态与门的分步图解
原论文校准:ELMo双向LM独立方向目标与下游层混合;输入次序为自构。
本篇校准范围:ELMo双向LM独立方向目标与下游层混合;输入次序为自构。 新增段落仅用于“防止双向特征里混入预测标签”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- ELMo加入前后六类自然语言任务的结果及绝对和相对增益
实验/结果图 · 必要原图摘引 · 表1,PDF第5页
证据二,表1。语义角色标注的相应基线 F1 从 81.4 到 84.6,共指从 67.2 到 70.4。数值属于具体任务模型的加入前后对照,不是 ELMo 单独预测的成绩。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1
- 问答核查:ELMo 的双向与 BERT 的双向为何不同等3题均有独立对应答案;保留已有有效解释
查看本篇 1 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 解释独立方向目标与下游拼接
- 层级特征混合手算
- 区分特征式迁移和整体微调
- v2:原文定位已接入正文:表1
- v2:问答核查:ELMo 的双向与 BERT 的双向为何不同等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1双向语言模型、§3.2层混合与参数共享
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Improving Language Understanding by Generative Pre-Training部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:有限任务标签怎样复用大量文本的预测经验
- 二、从语言目标与任务目标推导共享骨干更新
- 三、明确输入转换、损失符号与微调范围
- 四、保留RTE失利,再读层迁移和辅助目标消融
- 五、迁移初始化不等于免标签的上下文学习
- 六、把本篇机制再推进一步
- 七、区分特征接口、监督微调与后来的上下文学习
- 自测与参考答案
段落怎样重新安排
- 背景:统一表示如何接入不同任务 → 有限任务标签怎样复用大量文本的预测经验
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 迁移初始化不等于免标签的上下文学习
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 区分特征接口、监督微调与后来的上下文学习
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:两个损失、一个主要骨干 → 从语言目标与任务目标推导共享骨干更新
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:两个损失、一个主要骨干 → 从语言目标与任务目标推导共享骨干更新
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:两个损失、一个主要骨干 → 明确输入转换、损失符号与微调范围
单列可执行步骤,与机制论证及经验结果区分
- 方法:两个损失、一个主要骨干 → 明确输入转换、损失符号与微调范围
保留实现限制、训练协议及指标接口
- 实验设计 → 保留RTE失利,再读层迁移和辅助目标消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:预训练与微调分别学什么 → 从语言目标与任务目标推导共享骨干更新
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:预训练与微调分别学什么 → 从语言目标与任务目标推导共享骨干更新
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:预训练与微调分别学什么 → 迁移初始化不等于免标签的上下文学习
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:预训练与微调分别学什么 → 保留RTE失利,再读层迁移和辅助目标消融
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 与 ELMo 和后续 GPT 的区别 → 区分特征接口、监督微调与后来的上下文学习
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 与 ELMo 和后续 GPT 的区别 → 区分特征接口、监督微调与后来的上下文学习
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 迁移初始化不等于免标签的上下文学习
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 迁移初始化不等于免标签的上下文学习
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 同一token何时属于输入,何时属于训练目标
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、区分特征接口、监督微调与后来的上下文学习
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 同一token何时属于输入,何时属于训练目标:同一token何时属于输入,何时属于训练目标
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:GPT原文监督目标与辅助LM目标相加;这里只展开共享参数的链式法则。
本篇校准范围:GPT原文监督目标与辅助LM目标相加;这里只展开共享参数的链式法则。 新增段落仅用于“同一token何时属于输入,何时属于训练目标”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将 017-gpt-f2.png 完整移到对应证据解释之后,图像、归属与链接不变。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 预训练层迁移数量和预训练更新次数对下游表现的影响
实验/结果图 · 必要原图摘引 · 图2,PDF第7页
证据三,第 5 节、图2 与表5。转移层数、辅助目标和架构消融检验预训练机制。辅助语言目标对不同任务作用不同,说明迁移并不是一个无需选择的固定配方。 左图改变迁移的预训练层数,右图改变语言模型预训练更新次数;右图任务分数经过随机猜测与单模型参考成绩归一化,不能当作原始准确率。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、表3、表4、图2、表5
- 问答核查:原始 GPT 的迁移是否等于给几个提示例子就不训练等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表2 · PDF第6页,表2
原站图表/证明入口
- 表3 · PDF第6页,表3
原站图表/证明入口
- 表4 · PDF第7页,表4
原站图表/证明入口
- 图2 · PDF第7页,图2
原站图表/证明入口
- 表5 · PDF第8页,表5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导共享骨干的双目标梯度
- 数值说明辅助损失折中
- 厘清文本接口、微调与ICL
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、表3、表4、图2、表5
- v2:问答核查:原始 GPT 的迁移是否等于给几个提示例子就不训练等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:将 017-gpt-f2.png 完整移到对应证据解释之后,图像、归属与链接不变。
查核资料
- cdn.openai.com · 所列章节
§3.1—3.2预训练、分类头和辅助LM式1—5
- cdn.openai.com · 所列章节
证据三,第 5 节、图2 与表5。转移层数、辅助目标和架构消融检验预训练机制。辅助语言目标对不同任务作用不同,说明迁移并不是一个无需选择的固定配方。 左图改变迁移的预训练层数,右图改变语言模型预训练更新次数;右图任务分数经过随机猜测与单模型参考成绩归一化,不能当作原始准确率。
技术关系
- 015-transformer · 模块组合
因果解码器骨干
- 016-elmo · 平行方法
不同预训练迁移方法
- 021-gpt2 · 直接继承
延续生成式预训练
- 035-gpt3 · 直接继承
规模化并转向少样本上下文接口
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样联合利用左右语境而不把原词直接当答案
- 二、定义被选位置,再推导破坏输入上的监督范围
- 三、分别执行MLM、句段任务与带标签微调
- 四、从主结果走向方向和NSP的受控比较
- 五、掩码接口不保证因果生成或事实校验
- 六、把本篇机制再推进一步
- 七、重审配方、增加监督位置,再对照掩码生成
- 自测与参考答案
段落怎样重新安排
- 背景:双向访问与标签泄露的矛盾 → 怎样联合利用左右语境而不把原词直接当答案
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 掩码接口不保证因果生成或事实校验
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 重审配方、增加监督位置,再对照掩码生成
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:MLM、NSP 与微调 → 定义被选位置,再推导破坏输入上的监督范围
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:MLM、NSP 与微调 → 定义被选位置,再推导破坏输入上的监督范围
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:MLM、NSP 与微调 → 分别执行MLM、句段任务与带标签微调
单列可执行步骤,与机制论证及经验结果区分
- 方法:MLM、NSP 与微调 → 分别执行MLM、句段任务与带标签微调
保留实现限制、训练协议及指标接口
- 实验与证据 → 从主结果走向方向和NSP的受控比较
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:遮盖的必要性 → 分别执行MLM、句段任务与带标签微调
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:遮盖的必要性 → 定义被选位置,再推导破坏输入上的监督范围
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:遮盖的必要性 → 掩码接口不保证因果生成或事实校验
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:遮盖的必要性 → 掩码接口不保证因果生成或事实校验
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 与后续路线的关系 → 重审配方、增加监督位置,再对照掩码生成
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 与后续路线的关系 → 重审配方、增加监督位置,再对照掩码生成
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 掩码接口不保证因果生成或事实校验
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与边界 → 掩码接口不保证因果生成或事实校验
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 从掩码损失回追未选位置的梯度
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、重审配方、增加监督位置,再对照掩码生成
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 从掩码损失回追未选位置的梯度:从掩码损失回追未选位置的梯度
教法来源与实际阅读范围
- Lilian Weng · The Transformer Family
vanilla位置编码;Transformer-XL状态复用、相对位置和张量拼接
原论文校准:BERT MLM仅选定位置计预测损失,但编码器双向共享;推演来自本文保留的注意力计算。
本篇校准范围:BERT MLM仅选定位置计预测损失,但编码器双向共享;推演来自本文保留的注意力计算。 新增段落仅用于“从掩码损失回追未选位置的梯度”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- BERT移除NSP和改为左到右目标后的多任务开发集结果
实验/结果图 · 必要原图摘引 · 表5,PDF第8页
证据三,表5。BASE 的 SQuAD 开发 F1 为 88.5,去掉 NSP 为 87.9,改为左到右且无 NSP 为 77.8;这是更接近机制隔离的比较,但仍限于原文训练条件。不能据此证明任何规模和数据下 NSP 都不可删除。
- BERT预训练与下游任务微调的完整输入输出结构
方法/设定图 · 必要原图摘引 · 图1,PDF第3页
**证据一,第 3 节与[图1](https://arxiv.org/html/1810.04805#S2.F1)。**预训练和微调接口展示了模型如何统一接入任务。它支持架构通用性,不表示一个微调模型同时解决所有任务。 原图从左到右分别展示预训练与任务微调;不同任务复用初始化,但微调会更新全部参数。图中的箭头表示信息与训练流程,不是效果排名。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图1、表1、表2、表3、表4、表5
- 问答核查:15%、80%、10%、10% 各指什么等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 图1 · 图1;HTML元素 #S2.F1
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 写清监督集合与损坏输入区别
- 1000token条件概率计数例
- 关联RoBERTa、ELECTRA与扩散语言建模
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图1、表1、表2、表3、表4、表5
- v2:问答核查:15%、80%、10%、10% 各指什么等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1 MLM/NSP、15%选择和80/10/10机制
技术关系
- 023-roberta · 直接继承
重审BERT预训练配方
- 031-electra · 直接继承
更换预训练监督任务
- 096-llada · 教学联系
遮盖预测与扩散生成目标边界
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:片段边界丢掉的前缀能否复用而不保留全部反向图
- 二、追踪旧状态键值、停止梯度与相对位置
- 三、分别设置缓存长度、查询片段与文档重置
- 四、区分边界修复、长程利用和评价重算收益
- 五、更长可见历史仍受陈旧状态与干扰限制
- 六、把本篇机制再推进一步
- 七、把片段记忆与排列训练目标组合
- 自测与参考答案
段落怎样重新安排
- 背景:片段边界造成两类问题 → 片段边界丢掉的前缀能否复用而不保留全部反向图
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 更长可见历史仍受陈旧状态与干扰限制
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把片段记忆与排列训练目标组合
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:旧状态做键值,当前状态做查询 → 追踪旧状态键值、停止梯度与相对位置
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:旧状态做键值,当前状态做查询 → 追踪旧状态键值、停止梯度与相对位置
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:旧状态做键值,当前状态做查询 → 分别设置缓存长度、查询片段与文档重置
单列可执行步骤,与机制论证及经验结果区分
- 方法:旧状态做键值,当前状态做查询 → 分别设置缓存长度、查询片段与文档重置
保留实现限制、训练协议及指标接口
- 实验设计与证据 → 区分边界修复、长程利用和评价重算收益
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:可见历史不等于可训练历史 → 分别设置缓存长度、查询片段与文档重置
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:可见历史不等于可训练历史 → 追踪旧状态键值、停止梯度与相对位置
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:可见历史不等于可训练历史 → 追踪旧状态键值、停止梯度与相对位置
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:可见历史不等于可训练历史 → 更长可见历史仍受陈旧状态与干扰限制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 长上下文应该怎样测 → 区分边界修复、长程利用和评价重算收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 长上下文应该怎样测 → 区分边界修复、长程利用和评价重算收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 更长可见历史仍受陈旧状态与干扰限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 更长可见历史仍受陈旧状态与干扰限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 跨段缓存怎样改变可见距离与训练距离
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、把片段记忆与排列训练目标组合
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 跨段缓存怎样改变可见距离与训练距离:跨段缓存怎样改变可见距离与训练距离
教法来源与实际阅读范围
- Lilian Weng · The Transformer Family
vanilla位置编码;Transformer-XL状态复用、相对位置和张量拼接
原论文校准:Transformer-XL的跨段记忆和stop-gradient定义;尺寸自构,不把可见长度解释成同长反传。
本篇校准范围:Transformer-XL的跨段记忆和stop-gradient定义;尺寸自构,不把可见长度解释成同长反传。 新增段落仅用于“跨段缓存怎样改变可见距离与训练距离”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读表6不要把init理解成随机初始化。** PPL init使用与训练相同的注意力长度;PPL best是在评估时选择合适长度后的困惑度,Attn Len给出达到该结果所需的最短长度。先在相同参数规模内对照循环、位置编码与Loss列,再判断加长评估上下文是否有效;151M行不能当作128M消融中的同一模型。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Transformer-XL的片段复用、位置编码与注意力长度消融
实验/结果图 · 必要原图摘引 · 表6,PDF第8页
读表6不要把init理解成随机初始化。 PPL init使用与训练相同的注意力长度;PPL best是在评估时选择合适长度后的困惑度,Attn Len给出达到该结果所需的最短长度。先在相同参数规模内对照循环、位置编码与Loss列,再判断加长评估上下文是否有效;151M行不能当作128M消融中的同一模型。
- Transformer-XL在连续片段间复用隐藏状态及扩展上下文的机制
方法/设定图 · 必要原图摘引 · 图2,PDF第4页
令 $h_{old}$ 为旧片段缓存的隐藏状态、$h$ 为当前片段隐藏状态,$W_K,W_V$ 为键和值投影矩阵,方括号分号表示沿序列轴拼接,$\operatorname{SG}$ 表示停止梯度。记忆 $m=\operatorname{SG}(h_{old})$ 仍参与 $K=[m;h]W_K$ 与 $V=[m;h]W_V$,因此当前损失对 $W_K,W_V$ 仍有来自记忆内容的梯度;被切断的是回到生成 $h_{old}$ 的旧片段计算图。由于第n层读取上一片段第n−1层的状态,跨片段依赖沿层数向下移动,不能把它画成无限次数的同层循环。原文式1及[图2](https://arxiv.org/html/1901.02860#S3.F2)将“缓存内容可用”与“旧计算图可训练”分得很清楚。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图2、表1、表2、表6、表7、表8
- 问答核查:为什么旧状态停止梯度后仍然能帮助当前预测等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 图2 · 图2;HTML元素 #S3.F2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
- 表7 · 表7;HTML元素 #S4.T7
原站图表/证明入口
- 表8 · 表8;HTML元素 #S4.T8
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 精确定位被截断和保留的梯度
- 4×12注意力维度与缓存手算
- 辨别片段循环与普通RNN拓扑
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图2、表1、表2、表6、表7、表8
- v2:问答核查:为什么旧状态停止梯度后仍然能帮助当前预测等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读表6不要把init理解成随机初始化。** PPL init使用与训练相同的注意力长度;PPL best是在评估时选择合适长度后的困惑度,Attn Len给出达到该结果所需的最短长度。先在相同参数规模内对照循环、位置编码与Loss列,再判断加长评估上下文是否有效;151M行不能当作128M消融中的同一模型。
查核资料
- arxiv.org · 所列章节
§3.2式1—3、SG、逐层跨段依赖与复杂度
- arxiv.org · 所列章节
读表6不要把init理解成随机初始化。 PPL init使用与训练相同的注意力长度;PPL best是在评估时选择合适长度后的困惑度,Attn Len给出达到该结果所需的最短长度。先在相同参数规模内对照循环、位置编码与Loss列,再判断加长评估上下文是否有效;151M行不能当作128M消融中的同一模型。
技术关系
- 015-transformer · 直接继承
加入跨片段记忆
- 003-rnnlm · 教学联系
前向记忆和截断梯度对照
- 022-xlnet · 模块组合
片段记忆与排列目标组合
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Parameter-Efficient Transfer Learning for NLP部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:每增加一个任务是否必须再保存完整预训练模型
- 二、由瓶颈残差推导受限增量和局部秩
- 三、列清冻结范围、额外参数和实际执行路径
- 四、按多任务总存储口径读取GLUE与模块消融
- 五、小模块表达、任务隔离与串行延迟各有限制
- 六、把本篇机制再推进一步
- 七、对照全量微调与可合并的低秩权重增量
- 自测与参考答案
段落怎样重新安排
- 背景:迁移的成本不只在训练一次 → 每增加一个任务是否必须再保存完整预训练模型
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 小模块表达、任务隔离与串行延迟各有限制
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 对照全量微调与可合并的低秩权重增量
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:降维、非线性、升维与跳连 → 由瓶颈残差推导受限增量和局部秩
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:降维、非线性、升维与跳连 → 由瓶颈残差推导受限增量和局部秩
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:降维、非线性、升维与跳连 → 列清冻结范围、额外参数和实际执行路径
单列可执行步骤,与机制论证及经验结果区分
- 方法:降维、非线性、升维与跳连 → 列清冻结范围、额外参数和实际执行路径
保留实现限制、训练协议及指标接口
- 实验与证据 → 按多任务总存储口径读取GLUE与模块消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:存储节省到底在哪里 → 列清冻结范围、额外参数和实际执行路径
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:存储节省到底在哪里 → 按多任务总存储口径读取GLUE与模块消融
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:存储节省到底在哪里 → 列清冻结范围、额外参数和实际执行路径
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:存储节省到底在哪里 → 小模块表达、任务隔离与串行延迟各有限制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 与全量微调和 LoRA 的关系 → 小模块表达、任务隔离与串行延迟各有限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 与全量微调和 LoRA 的关系 → 小模块表达、任务隔离与串行延迟各有限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 与全量微调和 LoRA 的关系 → 小模块表达、任务隔离与串行延迟各有限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 小模块表达、任务隔离与串行延迟各有限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 小模块表达、任务隔离与串行延迟各有限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把适配器的任务存储与执行路径分开
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、对照全量微调与可合并的低秩权重增量
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把适配器的任务存储与执行路径分开:把适配器的任务存储与执行路径分开
教法来源与实际阅读范围
- Sourab Mangrulkar、Sayak Paul · Parameter-Efficient Fine-Tuning
Motivation、可训练参数统计、增量保存与加载
原论文校准:Adapter瓶颈两线性变换;忽略偏置、归一化与任务头仅为分项账本,不冒充总参数数。
本篇校准范围:Adapter瓶颈两线性变换;忽略偏置、归一化与任务头仅为分项账本,不冒充总参数数。 新增段落仅用于“把适配器的任务存储与执行路径分开”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Adapters与BERT全量微调在GLUE上所需参数及任务分数
实验/结果图 · 必要原图摘引 · 表1,PDF第5页
证据二,表1。调节规模的 adapters 平均 GLUE 为 80.0,全量微调为 80.4;为全部表列任务保存模型时,总参数约 1.3 倍与 9 倍骨干。这里比较的是多任务总存储口径,不能说单个推理模型变成原来的九分之一。
- Adapter在Transformer层中的插入位置与内部降维升维结构
方法/设定图 · 必要原图摘引 · 图2,PDF第3页
**证据一,[图2](https://arxiv.org/html/1902.00751#S2.F2)。**架构和绿色可训练部分明确哪些参数改变。这是读懂参数效率的基础,不能只看一个压缩百分比。 原图绿色部分才是适配时更新的模块,其中包含 LayerNorm;瓶颈矩阵之外的绿色层不能从参数账本里删掉。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图2、表1
- 问答核查:冻结骨干为什么不等于训练时不用经过骨干等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 图2 · 图2;HTML元素 #S2.F2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补充残差增量局部秩推导
- 逐项核算双adapter参数
- 区分低秩权重与非线性串行模块
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图2、表1
- v2:问答核查:冻结骨干为什么不等于训练时不用经过骨干等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1瓶颈、两处插入、近恒等初始化与LayerNorm训练
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Language Models are Unsupervised Multitask Learners部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不更新任务参数,续写能否直接完成任务
- 二、把任务答案放回完整下一token目标
- 三、固定提示、候选评分和字节级分词接口
- 四、逐任务读规模曲线,并单列重叠与提示搜索
- 五、隐式监督不会自动带来稳定指令遵循
- 六、把本篇机制再推进一步
- 七、从自然任务格式走向上下文示例与指令训练
- 自测与参考答案
段落怎样重新安排
- 背景:没有专门标注,不等于没有任务示例 → 不更新任务参数,续写能否直接完成任务
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 隐式监督不会自动带来稳定指令遵循
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从自然任务格式走向上下文示例与指令训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:规模、数据与文本条件 → 把任务答案放回完整下一token目标
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:规模、数据与文本条件 → 把任务答案放回完整下一token目标
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:规模、数据与文本条件 → 固定提示、候选评分和字节级分词接口
单列可执行步骤,与机制论证及经验结果区分
- 方法:规模、数据与文本条件 → 固定提示、候选评分和字节级分词接口
保留实现限制、训练协议及指标接口
- 实验与证据 → 逐任务读规模曲线,并单列重叠与提示搜索
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:续写怎样像在执行任务 → 把任务答案放回完整下一token目标
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:续写怎样像在执行任务 → 固定提示、候选评分和字节级分词接口
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:续写怎样像在执行任务 → 隐式监督不会自动带来稳定指令遵循
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:续写怎样像在执行任务 → 隐式监督不会自动带来稳定指令遵循
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 怎样辨别零样本证据强弱 → 逐任务读规模曲线,并单列重叠与提示搜索
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 怎样辨别零样本证据强弱 → 逐任务读规模曲线,并单列重叠与提示搜索
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 隐式监督不会自动带来稳定指令遵循
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 隐式监督不会自动带来稳定指令遵循
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 隐式监督不会自动带来稳定指令遵循
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用分隔符定位续写实际条件
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、从自然任务格式走向上下文示例与指令训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用分隔符定位续写实际条件:用分隔符定位续写实际条件
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:GPT-2自回归条件续写与任务提示实验;分隔词自构,不新增任务准确率。
本篇校准范围:GPT-2自回归条件续写与任务提示实验;分隔词自构,不新增任务准确率。 新增段落仅用于“用分隔符定位续写实际条件”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读图1。** 四幅横轴都是语言模型参数量,纵轴依次为阅读理解F1、翻译BLEU、摘要ROUGE均值和问答准确率。灰虚线是各任务自己的参照系统,刻度和基准都不同;只能在同一面板中看规模趋势与差距。摘要曲线在最大模型处并未继续明显上升,图本身就不支持“规模增加让每项任务同幅提升”。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- GPT-2的阅读理解、翻译、摘要与问答成绩随模型参数量变化
实验/结果图 · 必要原图摘引 · 图1,PDF第2页
读图1。 四幅横轴都是语言模型参数量,纵轴依次为阅读理解F1、翻译BLEU、摘要ROUGE均值和问答准确率。灰虚线是各任务自己的参照系统,刻度和基准都不同;只能在同一面板中看规模趋势与差距。摘要曲线在最大模型处并未继续明显上升,图本身就不支持“规模增加让每项任务同幅提升”。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、图1
- 问答核查:无监督多任务是否意味着训练文本没有问答或翻译答案等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 表1 · PDF第3页,表1
原站图表/证明入口
- 图1 · PDF第2页,图1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 拆分前缀和答案损失
- 用token占比解释隐式任务学习困难
- 串联GPT到ICL和指令训练的分叉
- v2:原文定位已接入正文:表1、图1
- v2:问答核查:无监督多任务是否意味着训练文本没有问答或翻译答案等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读图1。** 四幅横轴都是语言模型参数量,纵轴依次为阅读理解F1、翻译BLEU、摘要ROUGE均值和问答准确率。灰虚线是各任务自己的参照系统,刻度和基准都不同;只能在同一面板中看规模趋势与差距。摘要曲线在最大模型处并未继续明显上升,图本身就不支持“规模增加让每项任务同幅提升”。
查核资料
- cdn.openai.com · 所列章节
§2语言预测涵盖任务目标的理想化论证
- cdn.openai.com · 所列章节
读图1。 四幅横轴都是语言模型参数量,纵轴依次为阅读理解F1、翻译BLEU、摘要ROUGE均值和问答准确率。灰虚线是各任务自己的参照系统,刻度和基准都不同;只能在同一面板中看规模趋势与差距。摘要曲线在最大模型处并未继续明显上升,图本身就不支持“规模增加让每项任务同幅提升”。
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型XLNet: Generalized Autoregressive Pretraining for Language Understanding部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不用同样的MASK方式,怎样让预测使用两侧内容
- 二、从排列因子化推到目标位置可知、内容不可见
- 三、逐层验证双流权限,并记录部分预测和片段记忆
- 四、先读WikiBooks控制实验,再比较大规模配置
- 五、复杂可见图仍会泄露答案或混入预算收益
- 六、把本篇机制再推进一步
- 七、用更强BERT配方检验目标比较
- 自测与参考答案
段落怎样重新安排
- 背景:排列的是因子顺序,不是文本含义 → 不用同样的MASK方式,怎样让预测使用两侧内容
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 复杂可见图仍会泄露答案或混入预算收益
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 用更强BERT配方检验目标比较
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:排列语言建模与双流 → 从排列因子化推到目标位置可知、内容不可见
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:排列语言建模与双流 → 从排列因子化推到目标位置可知、内容不可见
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:排列语言建模与双流 → 逐层验证双流权限,并记录部分预测和片段记忆
单列可执行步骤,与机制论证及经验结果区分
- 方法:排列语言建模与双流 → 逐层验证双流权限,并记录部分预测和片段记忆
保留实现限制、训练协议及指标接口
- 实验与证据 → 先读WikiBooks控制实验,再比较大规模配置
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:为什么需要查询流 → 逐层验证双流权限,并记录部分预测和片段记忆
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么需要查询流 → 从排列因子化推到目标位置可知、内容不可见
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么需要查询流 → 逐层验证双流权限,并记录部分预测和片段记忆
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么需要查询流 → 复杂可见图仍会泄露答案或混入预算收益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 代价与局限 → 复杂可见图仍会泄露答案或混入预算收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 代价与局限 → 复杂可见图仍会泄露答案或混入预算收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 代价与局限 → 复杂可见图仍会泄露答案或混入预算收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 代价与局限 → 复杂可见图仍会泄露答案或混入预算收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 代价与局限 → 复杂可见图仍会泄露答案或混入预算收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把三位置排列写成可见集合
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、用更强BERT配方检验目标比较
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把三位置排列写成可见集合:把三位置排列写成可见集合
教法来源与实际阅读范围
- Lilian Weng · The Transformer Family
vanilla位置编码;Transformer-XL状态复用、相对位置和张量拼接
原论文校准:XLNet排列因子分解与内容/query双流;例子固定一个排列,只解释可见性。
本篇校准范围:XLNet排列因子分解与内容/query双流;例子固定一个排列,只解释可见性。 新增段落仅用于“把三位置排列写成可见集合”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 相同训练数据及超参数下XLNet与BERT的任务结果
实验/结果图 · 必要原图摘引 · 表1,PDF第7页
证据二,表1。WikiBooks 受控配置与 BERT 变体比较,例如 RACE 从所列 BERT 的 75.1 到 XLNet 的 77.4。它比跨不同语料的大模型总榜更适合讨论方法差异,但仍需考虑骨干机制。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表5
- 问答核查:XLNet 是否把句子词序随意打乱后训练等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表5 · 表5;HTML元素 #S3.T5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 展开三位置联合概率
- 设计查询流泄漏测试
- 澄清排列因子而非重排原文本
- v2:原文定位已接入正文:表1、表5
- v2:问答核查:XLNet 是否把句子词序随意打乱后训练等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.2式3排列目标、§2.3双流约束
技术关系
- 018-bert · 平行方法
不同双向预训练目标
- 019-transformer-xl · 模块组合
片段记忆组件
- 023-roberta · 教学联系
公平训练配方比较
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型RoBERTa: A Robustly Optimized BERT Pretraining Approach部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:新目标胜过BERT,还是旧基线尚未训练充分
- 二、保留MLM并拆开遮盖、文本组织与批量干预
- 三、按实际token曝光记录训练配方
- 四、用受控表格检验单项,再读扩大训练的结果
- 五、强基线提高归因标准,不提供无限扩展保证
- 六、把本篇机制再推进一步
- 七、将受控迁移比较扩展到统一文本接口
- 自测与参考答案
段落怎样重新安排
- 背景:跨论文比较容易混入资源差异 → 新目标胜过BERT,还是旧基线尚未训练充分
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 强基线提高归因标准,不提供无限扩展保证
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 将受控迁移比较扩展到统一文本接口
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:保留 MLM,改变训练过程 → 保留MLM并拆开遮盖、文本组织与批量干预
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:保留 MLM,改变训练过程 → 保留MLM并拆开遮盖、文本组织与批量干预
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:保留 MLM,改变训练过程 → 按实际token曝光记录训练配方
单列可执行步骤,与机制论证及经验结果区分
- 方法:保留 MLM,改变训练过程 → 按实际token曝光记录训练配方
保留实现限制、训练协议及指标接口
- 实验设计与证据 → 用受控表格检验单项,再读扩大训练的结果
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:为什么“只改一项”并不容易 → 按实际token曝光记录训练配方
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么“只改一项”并不容易 → 保留MLM并拆开遮盖、文本组织与批量干预
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么“只改一项”并不容易 → 用受控表格检验单项,再读扩大训练的结果
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么“只改一项”并不容易 → 强基线提高归因标准,不提供无限扩展保证
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 强基线为什么是一种研究贡献 → 强基线提高归因标准,不提供无限扩展保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 强基线为什么是一种研究贡献 → 强基线提高归因标准,不提供无限扩展保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 强基线提高归因标准,不提供无限扩展保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 强基线提高归因标准,不提供无限扩展保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 强基线提高归因标准,不提供无限扩展保证
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 算清重复曝光后仍未成为预测目标的比例
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、将受控迁移比较扩展到统一文本接口
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 算清重复曝光后仍未成为预测目标的比例:算清重复曝光后仍未成为预测目标的比例
原论文校准与展开范围
原论文校准:RoBERTa动态遮盖与BERT目标选择机制;独立轮次是假设,覆盖率为自构概率计算。
本篇校准范围:RoBERTa动态遮盖与BERT目标选择机制;独立轮次是假设,覆盖率为自构概率计算。 新增段落仅用于“算清重复曝光后仍未成为预测目标的比例”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- RoBERTa不同句段组织和NSP设置的开发集结果
实验/结果图 · 必要原图摘引 · 表2,PDF第5页
证据二,表2。不同句段组织与 NSP 配置比较显示,不带 NSP 的连续文档设置有较好结果。因为输入组织同时变化,更准确的结论是这套训练设置无需 NSP,不能把全部差异归给删除一个损失。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表2、表3
- 问答核查:为什么动态遮盖不等于每次都会显著提升表现等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导动态遮盖累计覆盖
- 补充token预算而非步数公平性
- 解释动态mask并非所有任务必胜
- v2:原文定位已接入正文:表1、表2、表3
- v2:问答核查:为什么动态遮盖不等于每次都会显著提升表现等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1训练实现、§4.1表1、§4.2输入与NSP对照
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:单卡放不下模型时,怎样分片而不在每个算子间同步
- 二、沿非线性前后推导互补矩阵切分和输入梯度归约
- 三、先对齐单卡数值,再部署张量与数据并行
- 四、区分弱扩展效率、实际吞吐与模型质量
- 五、减少通信次数仍受互联、尺寸和布局约束
- 六、把本篇机制再推进一步
- 七、把算子切分与状态分片、专家通信组合
- 自测与参考答案
段落怎样重新安排
- 背景:并行方式解决不同瓶颈 → 单卡放不下模型时,怎样分片而不在每个算子间同步
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 减少通信次数仍受互联、尺寸和布局约束
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把算子切分与状态分片、专家通信组合
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:相邻矩阵用互补切分 → 沿非线性前后推导互补矩阵切分和输入梯度归约
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:相邻矩阵用互补切分 → 沿非线性前后推导互补矩阵切分和输入梯度归约
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:相邻矩阵用互补切分 → 先对齐单卡数值,再部署张量与数据并行
单列可执行步骤,与机制论证及经验结果区分
- 方法:相邻矩阵用互补切分 → 先对齐单卡数值,再部署张量与数据并行
保留实现限制、训练协议及指标接口
- 实验与证据 → 区分弱扩展效率、实际吞吐与模型质量
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:为什么切分方向重要 → 沿非线性前后推导互补矩阵切分和输入梯度归约
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么切分方向重要 → 沿非线性前后推导互补矩阵切分和输入梯度归约
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么切分方向重要 → 沿非线性前后推导互补矩阵切分和输入梯度归约
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:为什么切分方向重要 → 减少通信次数仍受互联、尺寸和布局约束
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 系统实验应该怎样报告 → 区分弱扩展效率、实际吞吐与模型质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 系统实验应该怎样报告 → 区分弱扩展效率、实际吞吐与模型质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 减少通信次数仍受互联、尺寸和布局约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 减少通信次数仍受互联、尺寸和布局约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 减少通信次数仍受互联、尺寸和布局约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 减少通信次数仍受互联、尺寸和布局约束
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 独立逐段复核发现的跨节重复与实现缺口 → 机制、实现和实验对应章节
公式条件与实际执行相对应,删除状态/参数的反复说明
- 已核原论文机制与适用的专业教法 → 给两次投影标上跨卡尺寸
补充可核算的中间步骤与诊断,而非增加同义摘要
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 给两次投影标上跨卡尺寸:给两次投影标上跨卡尺寸
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:Megatron原文图3与Code 1的列并行/行并行及共轭通信;已核原梯度推导保留。博客Tensor Parallelism部分实际阅读,新增尺寸由正文矩阵式推得。
本篇校准范围:Megatron原文图3与Code 1的列并行/行并行及共轭通信;已核原梯度推导保留。博客Tensor Parallelism部分实际阅读,新增尺寸由正文矩阵式推得。 新增段落仅用于“给两次投影标上跨卡尺寸”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 摘要与引言报告512卡运行约76%扩展效率;下方图5及§5.1.1的这组弱扩展实验标为74%。正文说明后续8.3B训练配置的注意力头数不同,不宜把两个实验口径强行合成同一个数,更不能说512卡对任何任务都达到同一效率。
- **读图5。** 横轴是GPU数量,纵轴是相对于单GPU基线的弱扩展效率;蓝柱仅用模型并行,绿柱再叠加数据并行。模型大小随设备数变化,100%表示按该基线理想扩展,不是GPU理论峰值利用率,也不是固定模型的强扩展加速比。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Megatron模型并行与模型加数据并行的弱扩展效率
实验/结果图 · 必要原图摘引 · 图5,HTML #S5.F5
读图5。 横轴是GPU数量,纵轴是相对于单GPU基线的弱扩展效率;蓝柱仅用模型并行,绿柱再叠加数据并行。模型大小随设备数变化,100%表示按该基线理想扩展,不是GPU理论峰值利用率,也不是固定模型的强扩展加速比。
- Megatron前馈层与多头注意力的张量并行切分
方法/设定图 · 必要原图摘引 · 图3,PDF第4页
**证据一,[图3](https://arxiv.org/html/1909.08053#S3.F3) 与 Code 1。**矩阵分片和前反向通信算子给出核心实现。它说明减少通信的逻辑,不只是报告最终速度。 模型并行图中的 f 与 g 分别在反向或前向执行 all-reduce。把一对前馈矩阵连着看,才能看清通信为何可以跨过中间非线性。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图3、表1、图5、表3
- 问答核查:为什么数据并行不能让放不进单卡的模型直接训练等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 图3 · 图3;HTML元素 #S3.F3
原站图表/证明入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
- 图5 · 图5;HTML元素 #S5.F5
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导分片MLP本地权重梯度及共享输入梯度的归约位置
- 非线性不能随意交换求和反例
- 区分张量并行和状态分片
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图3、表1、图5、表3
- v2:问答核查:为什么数据并行不能让放不进单卡的模型直接训练等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:摘要与引言报告512卡运行约76%扩展效率;下方图5及§5.1.1的这组弱扩展实验标为74%。正文说明后续8.3B训练配置的注意力头数不同,不宜把两个实验口径强行合成同一个数,更不能说512卡对任何任务都达到同一效率。
- v3:**读图5。** 横轴是GPU数量,纵轴是相对于单GPU基线的弱扩展效率;蓝柱仅用模型并行,绿柱再叠加数据并行。模型大小随设备数变化,100%表示按该基线理想扩展,不是GPU理论峰值利用率,也不是固定模型的强扩展加速比。
查核资料
- arxiv.org · 所列章节
§3式3、图3相邻GEMM与前反向all-reduce;以原算子结构展开反向梯度
- arxiv.org · 所列章节
读图5。 横轴是GPU数量,纵轴是相对于单GPU基线的弱扩展效率;蓝柱仅用模型并行,绿柱再叠加数据并行。模型大小随设备数变化,100%表示按该基线理想扩展,不是GPU理论峰值利用率,也不是固定模型的强扩展加速比。
技术关系
- 015-transformer · 模块组合
切分Transformer计算图
- 026-zero · 模块组合
可与状态分片组合
- 037-gshard · 平行方法
自动分片和专家系统路线
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
- v3读图核对:摘要/引言的512卡76%与§5.1.1/图5的74%来自不同呈现;正文另说明后续训练配置的头数变化。本篇分别标注,未把差异归结为某个单一原因。
大语言模型ALBERT: A Lite BERT for Self-supervised Learning of Language Representations部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:词表、隐藏宽度与层数是否必须一起增加权重存储
- 二、推导嵌入分解、跨层复用与句序监督
- 三、分别记录共享范围、执行次数和MLM/SOP训练
- 四、把存储缩减、共享损失与句序收益分开读
- 五、参数少仍可能更宽、更慢或表达受限
- 六、把本篇机制再推进一步
- 七、区分基座压缩、任务增量与条件计算
- 自测与参考答案
段落怎样重新安排
- 背景:词表维度为什么必须等于隐藏维度? → 词表、隐藏宽度与层数是否必须一起增加权重存储
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 参数少仍可能更宽、更慢或表达受限
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 区分基座压缩、任务增量与条件计算
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:分解、共享与句序目标 → 推导嵌入分解、跨层复用与句序监督
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:分解、共享与句序目标 → 推导嵌入分解、跨层复用与句序监督
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:分解、共享与句序目标 → 分别记录共享范围、执行次数和MLM/SOP训练
单列可执行步骤,与机制论证及经验结果区分
- 方法:分解、共享与句序目标 → 分别记录共享范围、执行次数和MLM/SOP训练
保留实现限制、训练协议及指标接口
- 实验与证据 → 把存储缩减、共享损失与句序收益分开读
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:共享同一层为什么仍有深度 → 推导嵌入分解、跨层复用与句序监督
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:共享同一层为什么仍有深度 → 推导嵌入分解、跨层复用与句序监督
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:共享同一层为什么仍有深度 → 参数少仍可能更宽、更慢或表达受限
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:共享同一层为什么仍有深度 → 把存储缩减、共享损失与句序收益分开读
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 与其他参数高效方法的区别 → 区分基座压缩、任务增量与条件计算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 与其他参数高效方法的区别 → 区分基座压缩、任务增量与条件计算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 参数少仍可能更宽、更慢或表达受限
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 参数少仍可能更宽、更慢或表达受限
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 参数少仍可能更宽、更慢或表达受限
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 重复使用的矩阵怎样收到多处梯度
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、区分基座压缩、任务增量与条件计算
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 重复使用的矩阵怎样收到多处梯度:重复使用的矩阵怎样收到多处梯度
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:ALBERT跨层共享参数;标量梯度自构,不将共享层数等同运行速度比。
本篇校准范围:ALBERT跨层共享参数;标量梯度自构,不将共享层数等同运行速度比。 新增段落仅用于“重复使用的矩阵怎样收到多处梯度”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读表5先分清训练行与评测列。** None、NSP、SOP是使用哪一种句间预训练任务;左侧MLM/NSP/SOP列是内在任务表现,右侧才是下游任务。NSP行能把NSP本身做好,却没有同样提高SOP;SOP行的下游平均更高,也并非在每个任务列都最高。训练代理任务做得好,不自动等于迁移更好。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- ALBERT的MLM、NSP及SOP预训练任务消融
实验/结果图 · 必要原图摘引 · 表5,PDF第8页
读表5先分清训练行与评测列。 None、NSP、SOP是使用哪一种句间预训练任务;左侧MLM/NSP/SOP列是内在任务表现,右侧才是下游任务。NSP行能把NSP本身做好,却没有同样提高SOP;SOP行的下游平均更高,也并非在每个任务列都最高。训练代理任务做得好,不自动等于迁移更好。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表4、表5、表6
- 问答核查:共享12层权重,是否意味着只执行一次Transformer层等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S4.T5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 数值核算分解矩阵
- 共享变换反复执行的函数例
- 区分预训练模型压缩与任务适配
- v2:原文定位已接入正文:表1、表4、表5、表6
- v2:问答核查:共享12层权重,是否意味着只执行一次Transformer层等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读表5先分清训练行与评测列。** None、NSP、SOP是使用哪一种句间预训练任务;左侧MLM/NSP/SOP列是内在任务表现,右侧才是下游任务。NSP行能把NSP本身做好,却没有同样提高SOP;SOP行的下游平均更高,也并非在每个任务列都最高。训练代理任务做得好,不自动等于迁移更好。
查核资料
- arxiv.org · 所列章节
§3分解嵌入、跨层参数共享与表示振荡
- arxiv.org · 所列章节
读表5先分清训练行与评测列。 None、NSP、SOP是使用哪一种句间预训练任务;左侧MLM/NSP/SOP列是内在任务表现,右侧才是下游任务。NSP行能把NSP本身做好,却没有同样提高SOP;SOP行的下游平均更高,也并非在每个任务列都最高。训练代理任务做得好,不自动等于迁移更好。
技术关系
- 018-bert · 直接继承
本篇改造BERT参数化
- 020-adapters · 平行方法
任务增量效率
- 047-lora · 平行方法
微调增量参数化
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型ZeRO: Memory Optimizations Toward Training Trillion Parameter Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:每张数据并行卡是否必须保存全部训练状态
- 二、逐项拆开16字节账本,再推分片阶段
- 三、让全局梯度到达状态所有者,并管理临时聚合
- 四、把容量推算与实测峰值、吞吐分开读
- 五、常驻状态减少仍留下激活、预取和恢复问题
- 六、把本篇机制再推进一步
- 七、按计算分片与精度/增量两条轴继续优化
- 自测与参考答案
段落怎样重新安排
- 背景:权重文件大小远小于训练显存 → 每张数据并行卡是否必须保存全部训练状态
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 常驻状态减少仍留下激活、预取和恢复问题
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 按计算分片与精度/增量两条轴继续优化
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:逐步分片三类状态 → 逐项拆开16字节账本,再推分片阶段
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:逐步分片三类状态 → 逐项拆开16字节账本,再推分片阶段
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:逐步分片三类状态 → 让全局梯度到达状态所有者,并管理临时聚合
单列可执行步骤,与机制论证及经验结果区分
- 方法:逐步分片三类状态 → 让全局梯度到达状态所有者,并管理临时聚合
保留实现限制、训练协议及指标接口
- 实验与证据 → 把容量推算与实测峰值、吞吐分开读
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:谁拥有优化器状态 → 逐项拆开16字节账本,再推分片阶段
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:谁拥有优化器状态 → 让全局梯度到达状态所有者,并管理临时聚合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:谁拥有优化器状态 → 让全局梯度到达状态所有者,并管理临时聚合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:谁拥有优化器状态 → 常驻状态减少仍留下激活、预取和恢复问题
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 怎样验证一个 ZeRO 配置 → 把容量推算与实测峰值、吞吐分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 怎样验证一个 ZeRO 配置 → 把容量推算与实测峰值、吞吐分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 常驻状态减少仍留下激活、预取和恢复问题
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 常驻状态减少仍留下激活、预取和恢复问题
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 常驻状态减少仍留下激活、预取和恢复问题
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 常驻状态减少仍留下激活、预取和恢复问题
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把一个分片状态的生命周期列出来
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、按计算分片与精度/增量两条轴继续优化
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把一个分片状态的生命周期列出来:把一个分片状态的生命周期列出来
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:ZeRO各阶段状态所有权与参数收集机制;四rank是教学规模,通信计划按具体阶段。
本篇校准范围:ZeRO各阶段状态所有权与参数收集机制;四rank是教学规模,通信计划按具体阶段。 新增段落仅用于“把一个分片状态的生命周期列出来”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- ZeRO各阶段在多张GPU上分片参数、梯度和优化器状态的内存示意
方法/设定图 · 必要原图摘引 · 图1,HTML #S1.F1
证据一,图1。清晰分解不同状态的冗余,解释各阶段节省来自哪里。图中模型状态不是全部训练峰值。 内存示意图只统计模型状态:示例固定 7.5B 参数、64 路数据并行和混合精度 Adam。它不是包含激活、缓存及碎片的实际峰值显存截图。
- ZeRO在不同模型参数规模下的单GPU训练吞吐和相对基线加速
实验/结果图 · 必要原图摘引 · 图2,PDF第4页
从内存账本走到实测。 原图2横轴改变模型规模,点表示单GPU吞吐,灰柱按右轴表示相对基线的加速。ZeRO与基线的模型并行放置不同;节省状态内存能够改变可训练规模与通信布局,但某一个柱高不是所有模型、硬件的固定加速倍数。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图1、表1
- 问答核查:每卡只拥有部分优化器状态,是否意味着只训练部分参数等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 图1 · 图1;HTML元素 #S1.F1
原站图表/证明入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 拆出16字节状态组成
- 计算8卡三阶段预算并加峰值反例
- 区分分片、量化及可训练参数减少
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图1、表1
- v2:问答核查:每卡只拥有部分优化器状态,是否意味着只训练部分参数等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
ZeRO-DP三个阶段、§5状态预算与ZeRO-R剩余内存
技术关系
- 009-adam · 模块组合
矩状态是被分片对象
- 024-megatron · 模块组合
状态分片与张量切分组合
- 074-qlora · 平行方法
量化与低秩适配节省不同对象
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样统一任务接口以比较预训练,而不抹去任务差异
- 二、由缺失片段与哨兵推导输入输出长度
- 三、固定任务前缀、标签映射与条件生成
- 四、在相同文本和计算口径下读架构及span实验
- 五、统一生成格式仍有标签、结构约束与数据偏差
- 六、把本篇机制再推进一步
- 七、继续比较指令任务混合与模板稳健性
- 自测与参考答案
段落怎样重新安排
- 背景:接口差异会干扰算法比较 → 怎样统一任务接口以比较预训练,而不抹去任务差异
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 统一生成格式仍有标签、结构约束与数据偏差
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 对照全文去噪,并把生成器接到检索证据
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:缺失片段用哨兵串联 → 由缺失片段与哨兵推导输入输出长度
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:缺失片段用哨兵串联 → 由缺失片段与哨兵推导输入输出长度
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:缺失片段用哨兵串联 → 固定任务前缀、标签映射与条件生成
单列可执行步骤,与机制论证及经验结果区分
- 方法:缺失片段用哨兵串联 → 固定任务前缀、标签映射与条件生成
保留实现限制、训练协议及指标接口
- 实验与证据 → 在相同文本和计算口径下读架构及span实验
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:哨兵的作用 → 固定任务前缀、标签映射与条件生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:哨兵的作用 → 由缺失片段与哨兵推导输入输出长度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:哨兵的作用 → 统一生成格式仍有标签、结构约束与数据偏差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:哨兵的作用 → 固定任务前缀、标签映射与条件生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 数据与预算的公平性 → 在相同文本和计算口径下读架构及span实验
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 数据与预算的公平性 → 在相同文本和计算口径下读架构及span实验
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 统一生成格式仍有标签、结构约束与数据偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 统一生成格式仍有标签、结构约束与数据偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 统一生成格式仍有标签、结构约束与数据偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 统一生成格式仍有标签、结构约束与数据偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把两个缺口按编号还原
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、对照全文去噪,并把生成器接到检索证据
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 哨兵同时定义输入缺口和输出协议:合并三个同义缺口例,新增共享mask接口解释与显式输入/输出,并保留长度公式和100/15/5预算核算。
原论文校准与展开范围
原论文校准:T5 span corruption的不同哨兵与目标序列;示例只展示接口,实际终止标记按原文配方。
本篇校准范围:T5 span corruption的不同哨兵与目标序列;示例只展示接口,实际终止标记按原文配方。 新增段落仅用于“把两个缺口按编号还原”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- T5不同平均span长度下的多任务开发集分数
实验/结果图 · 必要原图摘引 · 表7,PDF第24页
证据三,表7 与第 3.3.5 节。不同平均span长度的效果较接近,较长片段在部分任务略差;作者强调不同目标造成的序列长度和速度差异。这支持同时比较质量与计算,不能只追逐一个微小分数差。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表7
- 问答核查:所有任务写成文本,是否意味着不用任务监督等3题均有独立对应答案;保留已有有效解释
查看本篇 2 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表7 · 表7;HTML元素 #S3.T7
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导span corruption输入输出长度
- 两片段重建及计算预算例
- 区分缺口预测与全文去噪
- v2:原文定位已接入正文:表1、表7
- v2:问答核查:所有任务写成文本,是否意味着不用任务监督等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.4统一接口、§3.1.4图2与哨兵目标
技术关系
- 015-transformer · 模块组合
编码解码架构
- 018-bert · 历史背景
掩码去噪思路
- 028-bart · 平行方法
全文重建路线
- 036-fid · 模块组合
后作用生成式骨干融合证据
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:双向读取与因果生成怎样放在同一去噪任务里
- 二、用噪声分布区分遮盖、删除与片段填充
- 三、编码损坏输入,按正确前缀重建完整原文
- 四、先读噪声对照,再检查摘要与理解成绩
- 五、全文重建不保证摘要忠实,ROUGE也不够
- 六、把本篇机制再推进一步
- 七、从去噪生成器接到外部检索
- 自测与参考答案
段落怎样重新安排
- 背景:输入双向与输出因果可以共存 → 双向读取与因果生成怎样放在同一去噪任务里
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 全文重建不保证摘要忠实,ROUGE也不够
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从去噪生成器接到外部检索
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:一般去噪条件生成 → 用噪声分布区分遮盖、删除与片段填充
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:一般去噪条件生成 → 用噪声分布区分遮盖、删除与片段填充
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:一般去噪条件生成 → 编码损坏输入,按正确前缀重建完整原文
单列可执行步骤,与机制论证及经验结果区分
- 方法:一般去噪条件生成 → 编码损坏输入,按正确前缀重建完整原文
保留实现限制、训练协议及指标接口
- 实验与证据 → 先读噪声对照,再检查摘要与理解成绩
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:删除与遮盖提供不同信息 → 用噪声分布区分遮盖、删除与片段填充
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:删除与遮盖提供不同信息 → 用噪声分布区分遮盖、删除与片段填充
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:删除与遮盖提供不同信息 → 全文重建不保证摘要忠实,ROUGE也不够
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:删除与遮盖提供不同信息 → 全文重建不保证摘要忠实,ROUGE也不够
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 为什么不能只比较 ROUGE → 先读噪声对照,再检查摘要与理解成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么不能只比较 ROUGE → 先读噪声对照,再检查摘要与理解成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 全文重建不保证摘要忠实,ROUGE也不够
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 全文重建不保证摘要忠实,ROUGE也不够
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 全文重建不保证摘要忠实,ROUGE也不够
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 全文重建不保证摘要忠实,ROUGE也不够
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用同一缺口比较输入长度的变化
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、从去噪生成器接到外部检索
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 用同一缺口比较输入长度的变化:用同一缺口比较输入长度的变化
原论文校准与展开范围
原论文校准:BART文本填空将span替换为单mask;示例解释噪声条件,不改写其完整损坏混合。
本篇校准范围:BART文本填空将span替换为单mask;示例解释噪声条件,不改写其完整损坏混合。 新增段落仅用于“用同一缺口比较输入长度的变化”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- BART及不同去噪目标在理解和生成任务上的消融结果
实验/结果图 · 必要原图摘引 · 表1,PDF第5页
证据二,表1。SQuAD 中 text infilling 达到 90.8 F1,而 document rotation 为 77.2;生成任务的各类 PPL 也不一致。该表直接说明噪声方案是实质设计,而不是可随意替换的训练装饰。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表2、表3
- 问答核查:BART 与 BERT 的主要预训练输出有何不同等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 形式化损坏分布与期望损失
- 同序列三种破坏的可见信息对照
- 区分BART与T5解码监督范围
- v2:原文定位已接入正文:表1、表2、表3
- v2:问答核查:BART 与 BERT 的主要预训练输出有何不同等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1架构与§2.2全文重建及噪声类型
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Scaling Laws for Neural Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:固定训练预算应分给参数、数据还是更新步数
- 二、由幂律与计算约束推导资源前沿
- 三、训练多条学习曲线并留出尺度检验预测
- 四、区分实际计算、临界batch修正与拟合外推
- 五、训练最优配比不等于全生命周期最优
- 六、把本篇机制再推进一步
- 七、重估训练前沿,再把预算带到推理阶段
- 自测与参考答案
段落怎样重新安排
- 背景:单独扩大一个因素可能遇到另一瓶颈 → 固定训练预算应分给参数、数据还是更新步数
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 训练最优配比不等于全生命周期最优
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 重估训练前沿,再把预算带到推理阶段
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:测量曲线并拟合前沿 → 由幂律与计算约束推导资源前沿
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:测量曲线并拟合前沿 → 由幂律与计算约束推导资源前沿
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:测量曲线并拟合前沿 → 训练多条学习曲线并留出尺度检验预测
单列可执行步骤,与机制论证及经验结果区分
- 方法:测量曲线并拟合前沿 → 训练多条学习曲线并留出尺度检验预测
保留实现限制、训练协议及指标接口
- 实验与证据 → 区分实际计算、临界batch修正与拟合外推
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:怎样避免虚假规模规律 → 由幂律与计算约束推导资源前沿
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:怎样避免虚假规模规律 → 区分实际计算、临界batch修正与拟合外推
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:怎样避免虚假规模规律 → 训练多条学习曲线并留出尺度检验预测
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:怎样避免虚假规模规律 → 训练最优配比不等于全生命周期最优
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 为什么训练最优不等于全生命周期最优 → 训练最优配比不等于全生命周期最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么训练最优不等于全生命周期最优 → 训练最优配比不等于全生命周期最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么训练最优不等于全生命周期最优 → 训练最优配比不等于全生命周期最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 训练最优配比不等于全生命周期最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 训练最优配比不等于全生命周期最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 训练最优配比不等于全生命周期最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 训练最优配比不等于全生命周期最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把幂律比较换成可以直接验算的倍率
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、重估训练前沿,再把预算带到推理阶段
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 把幂律比较换成可以直接验算的倍率:把幂律比较换成可以直接验算的倍率
原论文校准与展开范围
原论文校准:Kaplan经验幂律的资源项及适用范围;只做代数倍率分析,不增加新的拟合指数。
本篇校准范围:Kaplan经验幂律的资源项及适用范围;只做代数倍率分析,不增加新的拟合指数。 新增段落仅用于“把幂律比较换成可以直接验算的倍率”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读图13的两条虚线。** 横轴是非嵌入计算量,纵轴是测试损失;橙色拟合使用实际计算量C,蓝色拟合使用临界batch修正后的C_min。先分清修正口径再比较斜率,两条线并不是两种模型在完全相同实际训练预算下的随机重复。图中的拟合延长也不等于在所有外推预算上都完成了训练。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- 语言建模损失分别随计算量、数据量与参数量的变化
实验/结果图 · 必要原图摘引 · 图1,HTML #S1.F1
证据一,图1 与第 3 节。参数、数据与计算呈现平滑趋势,但每条曲线有相应非瓶颈条件。不能从一条曲线推出同时任意改变三项也保持相同关系。 图中的计算最优线包含对临界 batch 的修正;后面的纯实验曲线与修正曲线需分开读,不能把外推拟合当成每一点都实际训练过。
- 实际计算与临界batch修正后的计算最优损失曲线比较
实验/结果图 · 必要原图摘引 · 图13,HTML #S6.F13
读图13的两条虚线。 横轴是非嵌入计算量,纵轴是测试损失;橙色拟合使用实际计算量C,蓝色拟合使用临界batch修正后的C_min。先分清修正口径再比较斜率,两条线并不是两种模型在完全相同实际训练预算下的随机重复。图中的拟合延长也不等于在所有外推预算上都完成了训练。
- 计算最优参数规模和训练步数随计算预算变化的两个面板
实验/结果图 · 必要原图摘引 · 图14,PDF第16页
**证据二,第 5—6 节、[图13](https://arxiv.org/html/2001.08361#S6.F13)、[图14](https://arxiv.org/html/2001.08361#S6.F14)。**论文调整batch相关效率后估计计算最优前沿,给出 $N\propto C_{min}^{0.73}$ 等配比。指数是该实验和拟合的结果,不是任何模型必须遵守的常数。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图1、图13、图14
- 问答核查:为什么不能把0.73当作通用常数等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 图1 · 图1;HTML元素 #S1.F1
原站图表/证明入口
- 图13 · 图13;HTML元素 #S6.F13
原站图表/证明入口
- 图14 · 图14;HTML元素 #S6.F14
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导对数斜率与倍数效应
- 损失到困惑度数值转换
- 区分数据量、曝光token和推理预算
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图1、图13、图14
- v2:问答核查:为什么不能把0.73当作通用常数等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读图13的两条虚线。** 横轴是非嵌入计算量,纵轴是测试损失;橙色拟合使用实际计算量C,蓝色拟合使用临界batch修正后的C_min。先分清修正口径再比较斜率,两条线并不是两种模型在完全相同实际训练预算下的随机重复。图中的拟合延长也不等于在所有外推预算上都完成了训练。
查核资料
- arxiv.org · 所列章节
§1.2单因素幂律、§2符号及C≈6NBS定义
- arxiv.org · 所列章节
证据一,图1 与第 3 节。参数、数据与计算呈现平滑趋势,但每条曲线有相应非瓶颈条件。不能从一条曲线推出同时任意改变三项也保持相同关系。 图中的计算最优线包含对临界 batch 的修正;后面的纯实验曲线与修正曲线需分开读,不能把外推拟合当成每一点都实际训练过。
- arxiv.org · 所列章节
读图13的两条虚线。 横轴是非嵌入计算量,纵轴是测试损失;橙色拟合使用实际计算量C,蓝色拟合使用临界batch修正后的C_min。先分清修正口径再比较斜率,两条线并不是两种模型在完全相同实际训练预算下的随机重复。图中的拟合延长也不等于在所有外推预算上都完成了训练。
技术关系
- 021-gpt2 · 历史背景
规模化预训练背景
- 057-chinchilla · 直接继承
后作修订计算最优配比
- 091-test-time-scaling · 教学联系
训练预算与推理预算对照
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型REALM: Retrieval-Augmented Language Model Pre-Training部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:外部文档怎样从词预测收益中获得检索监督
- 二、从文档边缘似然推导后验责任差
- 三、在候选近似与异步刷新之间训练检索和阅读
- 四、按配置读取开放问答与陈旧索引消融
- 五、答对不证明使用证据,更新文档也不等于更新系统
- 六、把本篇机制再推进一步
- 七、对照监督检索,再转向序列生成边缘化
- 自测与参考答案
段落怎样重新安排
- 背景:知识存在哪里 → 外部文档怎样从词预测收益中获得检索监督
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 答对不证明使用证据,更新文档也不等于更新系统
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 对照监督检索,再转向序列生成边缘化
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:对潜在文档边缘化 → 从文档边缘似然推导后验责任差
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:对潜在文档边缘化 → 从文档边缘似然推导后验责任差
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:对潜在文档边缘化 → 在候选近似与异步刷新之间训练检索和阅读
单列可执行步骤,与机制论证及经验结果区分
- 方法:对潜在文档边缘化 → 在候选近似与异步刷新之间训练检索和阅读
保留实现限制、训练协议及指标接口
- 实验与证据 → 按配置读取开放问答与陈旧索引消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 教学例子:怎样产生检索梯度 → 从文档边缘似然推导后验责任差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:怎样产生检索梯度 → 从文档边缘似然推导后验责任差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:怎样产生检索梯度 → 答对不证明使用证据,更新文档也不等于更新系统
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 教学例子:怎样产生检索梯度 → 在候选近似与异步刷新之间训练检索和阅读
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 评价不能只看最终答案 → 按配置读取开放问答与陈旧索引消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 评价不能只看最终答案 → 按配置读取开放问答与陈旧索引消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 答对不证明使用证据,更新文档也不等于更新系统
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 答对不证明使用证据,更新文档也不等于更新系统
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 答对不证明使用证据,更新文档也不等于更新系统
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 答对不证明使用证据,更新文档也不等于更新系统
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 文档责任在全部候选同样无用时怎样变化
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、对照监督检索,再转向序列生成边缘化
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 文档责任在全部候选同样无用时怎样变化:文档责任在全部候选同样无用时怎样变化
教法来源与实际阅读范围
- Lilian Weng · Extrinsic Hallucinations in LLMs
幻觉定义、知识来源、检索增强评价与原子事实评价
原论文校准:REALM文档边缘似然与后验责任梯度;博客用于区分外部证据与答案支持,不作为REALM训练机制来源。
本篇校准范围:REALM文档边缘似然与后验责任梯度;博客用于区分外部证据与答案支持,不作为REALM训练机制来源。 新增段落仅用于“文档责任在全部候选同样无用时怎样变化”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- REALM检索器、遮盖方式与索引刷新速度的开发集消融
实验/结果图 · 必要原图摘引 · 表2,PDF第7页
证据三,表2 的 NQ 开发集消融。完整 REALM 的 EM 为 38.2;换回基线检索器后为 35.3;索引陈旧程度增加 30 倍时为 28.7。最后一项比完整模型低 9.5 个百分点,直接支持刷新机制在该训练设置中的重要性。这里是开发集,不能与表1 的测试分数直接相减;消融也没有证明任何系统都应固定每 500 步刷新。原文表 2、§4.5
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 原文定位已接入正文:表1、表2、表3
- 问答核查:没有文档相关标签,检索器怎样学习等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导检索logit的后验减先验梯度
- 两文档责任分配手算
- 指出候选截断对梯度覆盖的限制
- v2:原文定位已接入正文:表1、表2、表3
- v2:问答核查:没有文档相关标签,检索器怎样学习等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1边缘模型、§3.2检索分布、§3.3 top-k近似和索引刷新
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:整段编码的计算能否换来更多位置的有效监督
- 二、从原词一致性定义标签并推导判别梯度
- 三、分开训练生成器与判别器,再保留理解骨干
- 四、按总FLOPs检验密集监督与替换难度
- 五、原文一致性不能替代事实真假判断
- 六、沿编码器监督密度继续比较
- 自测与参考答案
段落怎样重新安排
- 问题设定:计算花在了哪里 → 整段编码的计算能否换来更多位置的有效监督
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 原文一致性不能替代事实真假判断
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 沿编码器监督密度继续比较
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法与公式 → 从原词一致性定义标签并推导判别梯度
先给出信息路径、目标与机制,再讨论执行顺序
- 方法与公式 → 从原词一致性定义标签并推导判别梯度
将原来的后置推导提前,解释伪代码为何这样计算
- 方法与公式 → 分开训练生成器与判别器,再保留理解骨干
单列可执行步骤,与机制论证及经验结果区分
- 方法与公式 → 分开训练生成器与判别器,再保留理解骨干
保留实现限制、训练协议及指标接口
- 实验设计与比较口径 → 按总FLOPs检验密集监督与替换难度
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与失败分析 → 从原词一致性定义标签并推导判别梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与失败分析 → 从原词一致性定义标签并推导判别梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与失败分析 → 原文一致性不能替代事实真假判断
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与失败分析 → 按总FLOPs检验密集监督与替换难度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 三组证据怎样解释 → 按总FLOPs检验密集监督与替换难度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据怎样解释 → 按总FLOPs检验密集监督与替换难度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据怎样解释 → 按总FLOPs检验密集监督与替换难度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据怎样解释 → 按总FLOPs检验密集监督与替换难度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据怎样解释 → 按总FLOPs检验密集监督与替换难度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与阅读衔接 → 原文一致性不能替代事实真假判断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与阅读衔接 → 原文一致性不能替代事实真假判断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把替换来源与真假标签列成两行
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿编码器监督密度继续比较
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 把替换来源与真假标签列成两行:把替换来源与真假标签列成两行
原论文校准与展开范围
原论文校准:ELECTRA replaced-token detection按词值是否改变构造标签;自构单位置检查。
本篇校准范围:ELECTRA replaced-token detection按词值是否改变构造标签;自构单位置检查。 新增段落仅用于“把替换来源与真假标签列成两行”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- ELECTRA与BERT等模型的GLUE成绩和预训练FLOPs关系
实验/结果图 · 必要原图摘引 · 图1,HTML #S1.F1
证据一:图1与表2,同预算表现。 表2中作者 BERT 基线与 ELECTRA-400K 都为 $7.1\times10^{20}$ 预训练 FLOPs、335M参数,GLUE开发集平均分分别87.2和89.0,即绝对增加1.8分。这支持该配置下任务设计的有效性;它不是跨所有任务、语言和模型架构的保证。与其他团队模型相比,数据及调参差异仍然存在。 图1左侧是右侧虚线框的放大图,并非另一批独立实验;比较横向相同计算预算的位置,才对应效率结论。
- ELECTRA与BERT在隐藏维度、预训练计算量和GLUE分数上的比较
实验/结果图 · 必要原图摘引 · 图4,PDF第9页
**证据三:[图4](https://arxiv.org/html/2003.10555#S3.F4)与[表3](https://arxiv.org/html/2003.10555#S3.T3),边界与比较条件。** [图4](https://arxiv.org/html/2003.10555#S3.F4)显示小模型在训练收敛后仍保留优势,作者据此讨论参数效率,而非仅仅更快到达同一个终点。[表3](https://arxiv.org/html/2003.10555#S3.T3)则包含用于提高测试分数的附加技巧,平均分还涉及排除 QNLI 的口径。因此开发集公平对照比排行榜单值更适合判断机制;排行榜更适合描述最终系统水平。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图1、表2、表5、图4、表3
- 问答核查:为什么 ELECTRA 不是文本 GAN等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 图1 · 图1;HTML元素 #S1.F1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
- 表5 · 表5;HTML元素 #S3.T5
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 表3 · 表3;HTML元素 #S3.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导判别梯度与采样正确标签
- 原词/合理替换对比算例
- 区分替换识别与事实验证
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图1、表2、表5、图4、表3
- v2:问答核查:为什么 ELECTRA 不是文本 GAN等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2生成器MLM、原词相等标签与非对抗训练
技术关系
- 018-bert · 直接继承
本篇改造BERT预训练监督
- 005-negative-sampling · 教学联系
判别目标但样本单位不同
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Dense Passage Retrieval for Open-Domain Question Answering部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:问题与证据措辞不同,怎样仍在大库中找回答案段落
- 二、由双编码打分推导负例集合的学习压力
- 三、预计算段落索引,再分别训练检索器与阅读器
- 四、同时保留NQ收益、SQuAD退步与负例消融
- 五、假负例和精确型号会暴露向量压缩限制
- 六、把可索引检索模块接入生成系统
- 自测与参考答案
段落怎样重新安排
- 问题定义与系统边界 → 问题与证据措辞不同,怎样仍在大库中找回答案段落
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 假负例和精确型号会暴露向量压缩限制
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把可索引检索模块接入生成系统
真实关系移到后继路线,避免目录相邻等于技术继承
- 双编码器怎样学习 → 由双编码打分推导负例集合的学习压力
先给出信息路径、目标与机制,再讨论执行顺序
- 双编码器怎样学习 → 由双编码打分推导负例集合的学习压力
将原来的后置推导提前,解释伪代码为何这样计算
- 双编码器怎样学习 → 预计算段落索引,再分别训练检索器与阅读器
单列可执行步骤,与机制论证及经验结果区分
- 双编码器怎样学习 → 预计算段落索引,再分别训练检索器与阅读器
保留实现限制、训练协议及指标接口
- 实验如何组织 → 同时保留NQ收益、SQuAD退步与负例消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 构造例子与诊断办法 → 由双编码打分推导负例集合的学习压力
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 构造例子与诊断办法 → 假负例和精确型号会暴露向量压缩限制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 构造例子与诊断办法 → 同时保留NQ收益、SQuAD退步与负例消融
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 构造例子与诊断办法 → 假负例和精确型号会暴露向量压缩限制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 证据及适用范围 → 同时保留NQ收益、SQuAD退步与负例消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据及适用范围 → 同时保留NQ收益、SQuAD退步与负例消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据及适用范围 → 同时保留NQ收益、SQuAD退步与负例消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据及适用范围 → 同时保留NQ收益、SQuAD退步与负例消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据及适用范围 → 同时保留NQ收益、SQuAD退步与负例消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与限制 → 假负例和精确型号会暴露向量压缩限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与限制 → 假负例和精确型号会暴露向量压缩限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把一个batch写成检索分类题
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把可索引检索模块接入生成系统
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把一个batch写成检索分类题:把一个batch写成检索分类题
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Word2vec
Language Modeling、Language Model Training、Skipgram
原论文校准:DPR双编码器与in-batch negatives;三样本矩阵自构,不声称原训练已逐对排除假负例。
本篇校准范围:DPR双编码器与in-batch negatives;三样本矩阵自构,不声称原训练已逐对排除假负例。 新增段落仅用于“把一个batch写成检索分类题”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- BM25、DPR及组合检索在多个问答数据集的Top-20和Top-100召回
实验/结果图 · 必要原图摘引 · 表2,PDF第5页
证据一:表2,稠密检索的收益与例外。 NQ单数据集训练时,BM25的top-20准确率59.1,DPR为78.4,绝对增加19.3个百分点。SQuAD却由68.8下降到63.2。证据支持多数所测任务的提升,同时直接否定“语义检索必然全面替代词项检索”。论文讨论SQuAD的问题构造和数据分布特殊性,这属于解释线索,不是对所有失败的完整归因。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表1、表2、表3、表4
- 问答核查:为什么不直接用交叉编码器检索全部段落等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S5.T4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 展开对比检索梯度
- 困难负例改变梯度的数值例
- 给出假负例风险与模块归因
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表1、表2、表3、表4
- v2:问答核查:为什么不直接用交叉编码器检索全部段落等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1可分解打分与离线索引;§3.2式2和负例选择
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Longformer: The Long-Document Transformer部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样保留长文证据而不计算全部位置对
- 二、从局部与全局边推导可达范围和复杂度
- 三、实现稀疏算子并迁移短模型的位置表示
- 四、分别读内存曲线、字符建模与位置初始化消融
- 五、有连接路径仍可能读错关系或压缩细节
- 六、比较稀疏图、随机核近似与精确IO优化
- 自测与参考答案
段落怎样重新安排
- 长度问题为何不能只靠截断 → 怎样保留长文证据而不计算全部位置对
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 有连接路径仍可能读错关系或压缩细节
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 比较稀疏图、随机核近似与精确IO优化
真实关系移到后继路线,避免目录相邻等于技术继承
- 连接图与核心公式 → 从局部与全局边推导可达范围和复杂度
先给出信息路径、目标与机制,再讨论执行顺序
- 连接图与核心公式 → 实现稀疏算子并迁移短模型的位置表示
单列可执行步骤,与机制论证及经验结果区分
- 连接图与核心公式 → 实现稀疏算子并迁移短模型的位置表示
保留实现限制、训练协议及指标接口
- 实验设置 → 分别读内存曲线、字符建模与位置初始化消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子 → 从局部与全局边推导可达范围和复杂度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子 → 从局部与全局边推导可达范围和复杂度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子 → 有连接路径仍可能读错关系或压缩细节
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子 → 分别读内存曲线、字符建模与位置初始化消融
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 从短模型变成长模型 → 实现稀疏算子并迁移短模型的位置表示
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 从短模型变成长模型 → 实现稀疏算子并迁移短模型的位置表示
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 从短模型变成长模型 → 实现稀疏算子并迁移短模型的位置表示
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 从短模型变成长模型 → 实现稀疏算子并迁移短模型的位置表示
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与三处关键证据 → 分别读内存曲线、字符建模与位置初始化消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与三处关键证据 → 分别读内存曲线、字符建模与位置初始化消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与三处关键证据 → 分别读内存曲线、字符建模与位置初始化消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与三处关键证据 → 分别读内存曲线、字符建模与位置初始化消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与三处关键证据 → 分别读内存曲线、字符建模与位置初始化消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与前置概念 → 有连接路径仍可能读错关系或压缩细节
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与前置概念 → 有连接路径仍可能读错关系或压缩细节
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 两层窗口的感受野不能当作一层注意力
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、比较稀疏图、随机核近似与精确IO优化
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 两层窗口的感受野不能当作一层注意力:两层窗口的感受野不能当作一层注意力
教法来源与实际阅读范围
- Lilian Weng · The Transformer Family
vanilla位置编码;Transformer-XL状态复用、相对位置和张量拼接
原论文校准:Longformer局部和全局注意力机制;例子为对称局部窗口教学图,不作为原文全部mask设置。
本篇校准范围:Longformer局部和全局注意力机制;例子为对称局部窗口教学图,不作为原文全部mask设置。 新增段落仅用于“两层窗口的感受野不能当作一层注意力”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 不同Longformer实现和全注意力的时间及显存随序列长度变化
实验/结果图 · 必要原图摘引 · 图1,HTML #S1.F1
证据一:图1与§3.2,理论连接怎样落到系统。 不同稀疏实现的速度不同,图中分块向量化实现最快;这说明运算图稀疏不等于硬件利用率高。图支持长序列时的内存扩展优势,但不能证明任何长度、任何设备都比高优化的全注意力快。 图中还区分 loop、chunk 和 CUDA 实现。相同稀疏连接模式可以有不同运行时间,内存的线性趋势不能单独预测哪种内核最快。
未在正文展示的图/表与范围
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、表5、图1、表6、表3
- 问答核查:把全注意力矩阵算完再遮掉大部分元素,能获得论文的内存收益吗等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
- 图1 · 图1;HTML元素 #S1.F1
原站图表/证明入口
- 表6 · 表6;HTML元素 #S5.T6
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 从逐层图传播计算感受野
- 局部四层不可达与全局瓶颈例
- 分清稀疏图和核近似
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、表5、图1、表6、表3
- v2:问答核查:把全注意力矩阵算完再遮掉大部分元素,能获得论文的内存收益吗等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3局部、空洞与全局注意力及感受野
技术关系
- 015-transformer · 直接继承
本篇改稀疏连接
- 038-bigbird · 平行方法
随机边稀疏方案
- 040-performer · 平行方法
核近似与局部加全局的稀疏注意力,是两种不同的长序列计算路径。
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:检索候选怎样支持可改写、可组合的生成答案
- 二、比较文档求和放在序列外还是逐token内部
- 三、组合DPR和BART,固定检索候选与生成协议
- 四、按问答、检索训练、事实性与索引变化分别读证据
- 五、外部文档与参数记忆冲突时答案仍可能不忠实
- 六、把本篇机制再推进一步
- 七、从概率边缘化转向表示层联合读取
- 自测与参考答案
段落怎样重新安排
- 从 DPR 到可生成答案 → 检索候选怎样支持可改写、可组合的生成答案
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 外部文档与参数记忆冲突时答案仍可能不忠实
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从概率边缘化转向表示层联合读取
真实关系移到后继路线,避免目录相邻等于技术继承
- 两种边缘化机制 → 比较文档求和放在序列外还是逐token内部
先给出信息路径、目标与机制,再讨论执行顺序
- 两种边缘化机制 → 比较文档求和放在序列外还是逐token内部
将原来的后置推导提前,解释伪代码为何这样计算
- 两种边缘化机制 → 组合DPR和BART,固定检索候选与生成协议
单列可执行步骤,与机制论证及经验结果区分
- 两种边缘化机制 → 组合DPR和BART,固定检索候选与生成协议
保留实现限制、训练协议及指标接口
- 实验资源与公平性 → 按问答、检索训练、事实性与索引变化分别读证据
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与系统诊断 → 比较文档求和放在序列外还是逐token内部
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与系统诊断 → 比较文档求和放在序列外还是逐token内部
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与系统诊断 → 外部文档与参数记忆冲突时答案仍可能不忠实
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与系统诊断 → 按问答、检索训练、事实性与索引变化分别读证据
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:优势与尚未解决的问题 → 按问答、检索训练、事实性与索引变化分别读证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:优势与尚未解决的问题 → 按问答、检索训练、事实性与索引变化分别读证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:优势与尚未解决的问题 → 按问答、检索训练、事实性与索引变化分别读证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:优势与尚未解决的问题 → 按问答、检索训练、事实性与索引变化分别读证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:优势与尚未解决的问题 → 按问答、检索训练、事实性与索引变化分别读证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:优势与尚未解决的问题 → 按问答、检索训练、事实性与索引变化分别读证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:优势与尚未解决的问题 → 按问答、检索训练、事实性与索引变化分别读证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 外部文档与参数记忆冲突时答案仍可能不忠实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 外部文档与参数记忆冲突时答案仍可能不忠实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用两步输出检验文档是否能切换
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、从概率边缘化转向表示层联合读取
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用两步输出检验文档是否能切换:用两步输出检验文档是否能切换
教法来源与实际阅读范围
- Lilian Weng · Extrinsic Hallucinations in LLMs
幻觉定义、知识来源、检索增强评价与原子事实评价
原论文校准:RAG-Sequence与RAG-Token的求和/连乘位置;这是由保留公式推出的支持分裂反例。
本篇校准范围:RAG-Sequence与RAG-Token的求和/连乘位置;这是由保留公式推出的支持分裂反例。 新增段落仅用于“用两步输出检验文档是否能切换”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **这张图3测的是文档数,不是年份替换。** 三幅横轴都是检索候选数K;左幅为NQ答案精确匹配,中幅为答案召回率,右幅为生成的BLEU-1与ROUGE-L。中幅召回继续上升时,左幅RAG-Token的最终答案分数仍可能回落:找到更多含答案的文档,与生成器正确使用它们,是两个环节。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- RAG不同检索文档数对问答正确率与检索召回的影响
实验/结果图 · 必要原图摘引 · 图3,HTML #S4.F3
这张图3测的是文档数,不是年份替换。 三幅横轴都是检索候选数K;左幅为NQ答案精确匹配,中幅为答案召回率,右幅为生成的BLEU-1与ROUGE-L。中幅召回继续上升时,左幅RAG-Token的最终答案分数仍可能回落:找到更多含答案的文档,与生成器正确使用它们,是两个环节。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表1、表6、表4、图3
- 问答核查:RAG-Token是否每个词都重新检索等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T2.fig1
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T5.fig1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S4.F3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 展开求和连乘区别
- 两文档两token概率手算
- 纠正逐token潜变量不等于逐token搜索
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表1、表6、表4、图3
- v2:问答核查:RAG-Token是否每个词都重新检索等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**这张图3测的是文档数,不是年份替换。** 三幅横轴都是检索候选数K;左幅为NQ答案精确匹配,中幅为答案召回率,右幅为生成的BLEU-1与ROUGE-L。中幅召回继续上升时,左幅RAG-Token的最终答案分数仍可能回落:找到更多含答案的文档,与生成器正确使用它们,是两个环节。
查核资料
- arxiv.org · 所列章节
§2.1 Sequence/Token两种边缘化、§2.2 DPR与§2.3 BART
- arxiv.org · 所列章节
这张图3测的是文档数,不是年份替换。 三幅横轴都是检索候选数K;左幅为NQ答案精确匹配,中幅为答案召回率,右幅为生成的BLEU-1与ROUGE-L。中幅召回继续上升时,左幅RAG-Token的最终答案分数仍可能回落:找到更多含答案的文档,与生成器正确使用它们,是两个环节。
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Language Models are Few-Shot Learners部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:少量上下文示例能否替代任务参数更新
- 二、把示例条件与模型参数分开定义
- 三、固定示例池、顺序、格式和答案评分协议
- 四、分别读规模、示例数量、失败任务与污染审查
- 五、格式模仿和知识调用不能单独证明新规则学习
- 六、扩展跨学科测量,并把过程写入提示
- 自测与参考答案
段落怎样重新安排
- 上下文学习究竟改了什么 → 少量上下文示例能否替代任务参数更新
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解 → 格式模仿和知识调用不能单独证明新规则学习
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 扩展跨学科测量,并把过程写入提示
真实关系移到后继路线,避免目录相邻等于技术继承
- 上下文学习究竟改了什么 → 把示例条件与模型参数分开定义
保留完整公式和事实约束
- 算法流程与实现细节 → 把示例条件与模型参数分开定义
将原来的后置推导提前,解释伪代码为何这样计算
- 算法流程与实现细节 → 固定示例池、顺序、格式和答案评分协议
单列可执行步骤,与机制论证及经验结果区分
- 算法流程与实现细节 → 固定示例池、顺序、格式和答案评分协议
保留实现限制、训练协议及指标接口
- 数据、预算和实验设计 → 分别读规模、示例数量、失败任务与污染审查
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与因果问题 → 分别读规模、示例数量、失败任务与污染审查
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与因果问题 → 把示例条件与模型参数分开定义
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与因果问题 → 分别读规模、示例数量、失败任务与污染审查
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与因果问题 → 固定示例池、顺序、格式和答案评分协议
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组可检查的证据 → 分别读规模、示例数量、失败任务与污染审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组可检查的证据 → 分别读规模、示例数量、失败任务与污染审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组可检查的证据 → 分别读规模、示例数量、失败任务与污染审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组可检查的证据 → 分别读规模、示例数量、失败任务与污染审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组可检查的证据 → 分别读规模、示例数量、失败任务与污染审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组可检查的证据 → 分别读规模、示例数量、失败任务与污染审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组可检查的证据 → 分别读规模、示例数量、失败任务与污染审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与代价 → 格式模仿和知识调用不能单独证明新规则学习
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与代价 → 格式模仿和知识调用不能单独证明新规则学习
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把评测查询的标签从示范池隔离
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、扩展跨学科测量,并把过程写入提示
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把评测查询的标签从示范池隔离:把评测查询的标签从示范池隔离
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:GPT-3上下文学习与提示评估;是基于输入条件的实验诊断,不声称原文所有设置存在泄漏。
本篇校准范围:GPT-3上下文学习与提示评估;是基于输入条件的实验诊断,不声称原文所有设置存在泄漏。 新增段落仅用于“把评测查询的标签从示范池隔离”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- GPT-3在符号去除任务上的上下文示例数量与准确率关系
实验/结果图 · 必要原图摘引 · 图1.2,HTML #S1.F2
证据一:图1.2与图3.8,上下文的作用随规模变化。 图1.2用构造的符号去除任务展示大模型更会利用示例;图3.8在SuperGLUE开发集考察规模和示例数。它们支持上下文适配能力增强,但开发集曲线不能直接与测试集参考线差值混算,也不能单凭曲线证明内部执行了哪一种学习算法。 符号去除任务展示的是示例数量变化下的行为;SuperGLUE 图另给开发集曲线。两张图不能合并成一个统一任务的学习曲线。
- GPT-3在SuperGLUE上的规模和上下文示例数量曲线
实验/结果图 · 必要原图摘引 · 图3.8,HTML #S3.F8
证据一:图1.2与图3.8,上下文的作用随规模变化。 图1.2用构造的符号去除任务展示大模型更会利用示例;图3.8在SuperGLUE开发集考察规模和示例数。它们支持上下文适配能力增强,但开发集曲线不能直接与测试集参考线差值混算,也不能单凭曲线证明内部执行了哪一种学习算法。 符号去除任务展示的是示例数量变化下的行为;SuperGLUE 图另给开发集曲线。两张图不能合并成一个统一任务的学习曲线。
未在正文展示的图/表与范围
- 表2.1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2.2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3.2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3.7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3.8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3.3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2.1、表2.2、图1.2、图3.8、表3.2、表3.7、表3.8、表3.3
- 问答核查:上下文学习没有更新权重,为什么还能改变行为等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表2.1 · 表2.1;HTML元素 #S2.T1
原站图表/证明入口
- 表2.2 · 表2.2;HTML元素 #S2.T2
原站图表/证明入口
- 图1.2 · 图1.2;HTML元素 #S1.F2
原站图表/证明入口
- 图3.8 · 图3.8;HTML元素 #S3.F8
原站图表/证明入口
- 表3.2 · 表3.2;HTML元素 #S3.T2
原站图表/证明入口
- 表3.7 · 表3.7;HTML元素 #S3.T7
原站图表/证明入口
- 表3.8 · 表3.8;HTML元素 #S3.T8
原站图表/证明入口
- 表3.3 · 表3.3;HTML元素 #S3.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 形式化ICL条件分布
- 设计标签重命名和打乱对照
- 分开规模、协议与推理示例贡献
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2.1、表2.2、图1.2、图3.8、表3.2、表3.7、表3.8、表3.3
- v2:问答核查:上下文学习没有更新权重,为什么还能改变行为等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§1 zero/one/few-shot固定参数定义与图1.2—1.3
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一百段候选怎样共同支持答案而不先做全篇交互
- 二、推导独立编码与联合解码的不同成本
- 三、重复问题编码候选,训练同一个证据读取解码器
- 四、用候选数和训练适配实验区分召回与融合
- 五、更多材料也会带来歧义、噪声与交叉注意力成本
- 六、从联合读取走向检索决策与支持性检查
- 自测与参考答案
段落怎样重新安排
- 问题与前人方法的关系 → 一百段候选怎样共同支持答案而不先做全篇交互
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 更多材料也会带来歧义、噪声与交叉注意力成本
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从联合读取走向检索决策与支持性检查
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法与公式 → 推导独立编码与联合解码的不同成本
先给出信息路径、目标与机制,再讨论执行顺序
- 方法与公式 → 推导独立编码与联合解码的不同成本
将原来的后置推导提前,解释伪代码为何这样计算
- 方法与公式 → 重复问题编码候选,训练同一个证据读取解码器
单列可执行步骤,与机制论证及经验结果区分
- 方法与公式 → 重复问题编码候选,训练同一个证据读取解码器
保留实现限制、训练协议及指标接口
- 实验设置与资源 → 用候选数和训练适配实验区分召回与融合
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与诊断 → 推导独立编码与联合解码的不同成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与诊断 → 推导独立编码与联合解码的不同成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与诊断 → 更多材料也会带来歧义、噪声与交叉注意力成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与诊断 → 用候选数和训练适配实验区分召回与融合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与诊断 → 更多材料也会带来歧义、噪声与交叉注意力成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 三组核心证据 → 用候选数和训练适配实验区分召回与融合
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组核心证据 → 用候选数和训练适配实验区分召回与融合
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组核心证据 → 用候选数和训练适配实验区分召回与融合
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组核心证据 → 用候选数和训练适配实验区分召回与融合
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组核心证据 → 用候选数和训练适配实验区分召回与融合
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与理解支点 → 更多材料也会带来歧义、噪声与交叉注意力成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与理解支点 → 更多材料也会带来歧义、噪声与交叉注意力成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把融合发生的位置写成一个尺寸账本
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、从联合读取走向检索决策与支持性检查
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把融合发生的位置写成一个尺寸账本:把融合发生的位置写成一个尺寸账本
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
原论文校准:FiD独立段落编码、解码器融合;尺寸自构,不将独立编码误写成最终独立回答。
本篇校准范围:FiD独立段落编码、解码器融合;尺寸自构,不将独立编码误写成最终独立回答。 新增段落仅用于“把融合发生的位置写成一个尺寸账本”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- FiD在三个问答数据集上的精确匹配随读取段落数变化
实验/结果图 · 必要原图摘引 · 图3,HTML #S4.F3
证据二:图3,增加段落是否有用。 在验证集、base模型上,候选从10增加到100时,NQ与TriviaQA准确率继续改善。作者据此认为生成模型善于整合多段落证据。不过实验同时提高了相关段落被召回的机会;没有控制证据召回时,曲线不能单独证明模型进行了真正的多跳推理。
- FiD逐段独立编码检索内容并在解码器中融合的结构
方法/设定图 · 必要原图摘引 · 图2,PDF第2页
**证据一:[图2](https://arxiv.org/html/2007.01282#S1.F2)与[表1](https://arxiv.org/html/2007.01282#S3.T1),融合方式的可用性。** [图2](https://arxiv.org/html/2007.01282#S1.F2)明确独立编码、联合解码结构。[表1](https://arxiv.org/html/2007.01282#S3.T1)中FiD-base和large在NQ的EM分别48.2、51.4,所列RAG为44.5。结果支持这一系统配置有竞争力,但跨系统的骨干、检索数与训练不同,差值不能全部归于一种注意力连接。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:图2、表1、图3、表2
- 问答核查:FiD与RAG-Token的融合有什么根本差别等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 图2 · 图2;HTML元素 #S1.F2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S4.F3
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 分解编码和解码复杂度
- 10篇文档注意力账本
- 区分表示融合与概率边缘化
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:图2、表1、图3、表2
- v2:问答核查:FiD与RAG-Token的融合有什么根本差别等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3 Reading独立编码、解码拼接与复杂度
技术关系
- 032-dpr · 模块组合
检索器提供候选段落,FiD分别编码这些段落并在解码阶段融合。
- 027-t5 · 模块组合
复用T5编码器解码器骨干,改变多段检索材料进入生成器的组织方式。
- 034-rag · 平行方法
证据融合方式不同
- 082-self-rag · 历史背景
检索控制与支持检查
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多语言共享容量怎样跨设备执行而不被路由拥堵抵消
- 二、把top-2权重、容量与溢出放进同一约束
- 三、用分组和自动分片组织专家通信
- 四、同时比较BLEU、样本阈值、墙钟和设备年
- 五、局部容量与负载分配会牺牲部分token路径
- 六、沿简化路由与负载通信继续扩展
- 自测与参考答案
段落怎样重新安排
- 问题定义:容量与共享之间的矛盾 → 多语言共享容量怎样跨设备执行而不被路由拥堵抵消
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 局部容量与负载分配会牺牲部分token路径
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 沿简化路由与负载通信继续扩展
真实关系移到后继路线,避免目录相邻等于技术继承
- 路由、容量与目标函数 → 把top-2权重、容量与溢出放进同一约束
先给出信息路径、目标与机制,再讨论执行顺序
- 路由、容量与目标函数 → 用分组和自动分片组织专家通信
单列可执行步骤,与机制论证及经验结果区分
- 实验设计 → 同时比较BLEU、样本阈值、墙钟和设备年
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与诊断方案 → 用分组和自动分片组织专家通信
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与诊断方案 → 把top-2权重、容量与溢出放进同一约束
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与诊断方案 → 同时比较BLEU、样本阈值、墙钟和设备年
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与诊断方案 → 同时比较BLEU、样本阈值、墙钟和设备年
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自动分片为什么重要 → 用分组和自动分片组织专家通信
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 自动分片为什么重要 → 用分组和自动分片组织专家通信
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 自动分片为什么重要 → 用分组和自动分片组织专家通信
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 自动分片为什么重要 → 用分组和自动分片组织专家通信
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据与边界 → 同时比较BLEU、样本阈值、墙钟和设备年
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据与边界 → 同时比较BLEU、样本阈值、墙钟和设备年
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据与边界 → 同时比较BLEU、样本阈值、墙钟和设备年
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据与边界 → 同时比较BLEU、样本阈值、墙钟和设备年
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据与边界 → 同时比较BLEU、样本阈值、墙钟和设备年
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据与边界 → 同时比较BLEU、样本阈值、墙钟和设备年
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与阅读衔接 → 局部容量与负载分配会牺牲部分token路径
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与阅读衔接 → 局部容量与负载分配会牺牲部分token路径
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 按局部分组核算容量,而非只看全局平均
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿简化路由与负载通信继续扩展
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 按局部分组核算容量,而非只看全局平均:按局部分组核算容量,而非只看全局平均
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:GShard局部分组dispatch与专家容量;数值为简化首选路由计数,未补造第二专家实际溢出策略。
本篇校准范围:GShard局部分组dispatch与专家容量;数值为简化首选路由计数,未补造第二专家实际溢出策略。 新增段落仅用于“按局部分组核算容量,而非只看全局平均”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- GShard不同模型在高资源到低资源语言上的相对BLEU曲线
实验/结果图 · 必要原图摘引 · 图6,HTML #S4.F6
证据二:图6与表3,质量和资源同时报告。 600B、2048专家、36层配置平均BLEU44.3,所列稠密96层模型36.9。600B模型用2048 cores约4天,同时消耗22.4 TPU core-years。4天是等待时间,22.4设备年是累计资源,两者都真实,不能只用前者营造低成本印象。 横轴按语言资源量从高到低排列,纵轴是相对单语模型的 BLEU 差值;趋势线经过10语言窗口平滑,不能读成每种语言的原始点值。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表2、图6、表3
- 问答核查:top-2路由意味着每个token一定执行两个专家吗等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 手推组内容量槽位
- 说明局部闲置与局部溢出并存
- 连接MoE扩展瓶颈
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表2、图6、表3
- v2:问答核查:top-2路由意味着每个token一定执行两个专家吗等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2门控与算法1、expert capacity、group dispatch及溢出残差
技术关系
- 014-sparse-moe · 直接继承
本篇扩展稀疏专家
- 042-switch · 直接继承
后作简化路由
- 092-deepseekv3 · 历史背景
后续负载通信系统问题
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Big Bird: Transformers for Longer Sequences部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:局部稀疏的远距路径能否由随机和全局边补足
- 二、从图消息传播区分表达存在性与有限深度
- 三、按具体ITC/ETC连接和块稀疏协议执行
- 四、同时保留长文收益、构件损失与规模反例
- 五、理论可表达不保证训练成功或同等深度
- 六、区分删边、随机核近似与精确执行优化
- 自测与参考答案
段落怎样重新安排
- 问题设定与Longformer的联系 → 局部稀疏的远距路径能否由随机和全局边补足
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 理论可表达不保证训练成功或同等深度
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 区分删边、随机核近似与精确执行优化
真实关系移到后继路线,避免目录相邻等于技术继承
- 稀疏图与公式 → 从图消息传播区分表达存在性与有限深度
先给出信息路径、目标与机制,再讨论执行顺序
- 稀疏图与公式 → 按具体ITC/ETC连接和块稀疏协议执行
单列可执行步骤,与机制论证及经验结果区分
- 实验配置 → 同时保留长文收益、构件损失与规模反例
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与可检验理解 → 从图消息传播区分表达存在性与有限深度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与可检验理解 → 从图消息传播区分表达存在性与有限深度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与可检验理解 → 同时保留长文收益、构件损失与规模反例
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与可检验理解 → 理论可表达不保证训练成功或同等深度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 理论到底保证了什么 → 从图消息传播区分表达存在性与有限深度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 理论到底保证了什么 → 从图消息传播区分表达存在性与有限深度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 理论到底保证了什么 → 从图消息传播区分表达存在性与有限深度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 理论到底保证了什么 → 从图消息传播区分表达存在性与有限深度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 理论到底保证了什么 → 从图消息传播区分表达存在性与有限深度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三处关键证据 → 同时保留长文收益、构件损失与规模反例
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三处关键证据 → 同时保留长文收益、构件损失与规模反例
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三处关键证据 → 同时保留长文收益、构件损失与规模反例
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三处关键证据 → 同时保留长文收益、构件损失与规模反例
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三处关键证据 → 同时保留长文收益、构件损失与规模反例
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 理论可表达不保证训练成功或同等深度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 理论可表达不保证训练成功或同等深度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用路径长度解释随机边的作用范围
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、区分删边、随机核近似与精确执行优化
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用路径长度解释随机边的作用范围:用路径长度解释随机边的作用范围
教法来源与实际阅读范围
- Lilian Weng · The Transformer Family
vanilla位置编码;Transformer-XL状态复用、相对位置和张量拼接
原论文校准:BigBird局部、随机与全局连接及理论前提;此段是图机制诊断,不扩张原理论保证。
本篇校准范围:BigBird局部、随机与全局连接及理论前提;此段是图机制诊断,不扩张原理论保证。 新增段落仅用于“用路径长度解释随机边的作用范围”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- BigBird与Longformer在HotpotQA、NaturalQuestions、TriviaQA和WikiHop的开发集结果
实验/结果图 · 必要原图摘引 · 表2,PDF第7页
证据二:表2,长文档问答收益。 base开发集HotpotQA联合F1,Longformer64.4,BigBird-ITC67.7、ETC67.8;WikiHop准确率75.0与两种BigBird的75.9。结果说明相关配置有效,但ETC增加的结构性全局节点和连接方案也是系统差异,不能把收益全部归因于随机边。
未在正文展示的图/表与范围
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表12:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表13:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表10:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表9、表8、表12、表13、表1、表2、表10、表3
- 问答核查:BigBird是否每个实验都同时使用三种连接等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表9 · 表9;HTML元素 #A5.T10.fig1
原站图表/证明入口
- 表8 · 表8;HTML元素 #A5.T8
原站图表/证明入口
- 表12 · 表12;HTML元素 #A5.T12
原站图表/证明入口
- 表13 · 表13;HTML元素 #A5.T13
原站图表/证明入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表10 · 表10;HTML元素 #A5.T10.fig2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 以图传播解释层数和路径
- 16位置环形捷径例
- 区分表达定理、核近似与IO精确优化
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表9、表8、表12、表13、表1、表2、表10、表3
- v2:问答核查:BigBird是否每个实验都同时使用三种连接等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2一般有向图注意力、局部/随机/全局边设计
技术关系
- 033-longformer · 平行方法
都采用稀疏注意力图,但随机、局部与全局连接的组织和保证不同。
- 040-performer · 平行方法
稀疏连接与随机核近似是不同的复杂度降低方案,不能混作同一近似。
- 059-flashattention · 平行方法
精确IO优化
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Measuring Massive Multitask Language Understanding部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:流畅续写之外,怎样测量跨学科知识应用
- 二、先定义题集、聚合权重与置信度校准
- 三、固定few-shot样例、候选评分和数据版本
- 四、同时读总体成绩、分科缺口与信心曲线
- 五、选择题与公开题源限制了能力解释
- 六、把本篇机制再推进一步
- 七、分别补测真实性与多步数学
- 自测与参考答案
段落怎样重新安排
- 为什么需要新的测试 → 流畅续写之外,怎样测量跨学科知识应用
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 选择题与公开题源限制了能力解释
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 分别补测真实性与多步数学
真实关系移到后继路线,避免目录相邻等于技术继承
- 数据与评价协议 → 先定义题集、聚合权重与置信度校准
先给出信息路径、目标与机制,再讨论执行顺序
- 数据与评价协议 → 固定few-shot样例、候选评分和数据版本
单列可执行步骤,与机制论证及经验结果区分
- 数据与评价协议 → 固定few-shot样例、候选评分和数据版本
保留实现限制、训练协议及指标接口
- 实验设置表 → 同时读总体成绩、分科缺口与信心曲线
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与改进实验 → 先定义题集、聚合权重与置信度校准
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与改进实验 → 同时读总体成绩、分科缺口与信心曲线
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与改进实验 → 选择题与公开题源限制了能力解释
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与改进实验 → 同时读总体成绩、分科缺口与信心曲线
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 校准怎样理解 → 先定义题集、聚合权重与置信度校准
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 校准怎样理解 → 先定义题集、聚合权重与置信度校准
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 校准怎样理解 → 先定义题集、聚合权重与置信度校准
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 校准怎样理解 → 先定义题集、聚合权重与置信度校准
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组重要结果 → 同时读总体成绩、分科缺口与信心曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组重要结果 → 同时读总体成绩、分科缺口与信心曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组重要结果 → 同时读总体成绩、分科缺口与信心曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组重要结果 → 同时读总体成绩、分科缺口与信心曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组重要结果 → 同时读总体成绩、分科缺口与信心曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组重要结果 → 同时读总体成绩、分科缺口与信心曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组重要结果 → 同时读总体成绩、分科缺口与信心曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 选择题与公开题源限制了能力解释
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 选择题与公开题源限制了能力解释
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 同一总分差先问是几道题的翻转
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 七、分别补测真实性与多步数学
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 同一总分差先问是几道题的翻转:同一总分差先问是几道题的翻转
原论文校准与展开范围
原论文校准:MMLU按题与学科的汇总口径;自构配对计数,不作为原文显著性检验结果。
本篇校准范围:MMLU按题与学科的汇总口径;自构配对计数,不作为原文显著性检验结果。 新增段落仅用于“同一总分差先问是几道题的翻转”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读图8的对角线。** 横轴是模型平均信心,纵轴是实际准确率,每点对应一个学科。在线下方表示信心高于正确率,在线上方表示正确率高于信心;离线越远,二者差距越大。这是学科层面的平均校准,不保证同一学科的每道题都可靠。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:4 幅
- GPT-3和UnifiedQA的分学科准确率对比
实验/结果图 · 必要原图摘引 · 图6,HTML #S4.F6
证据二:图6、图7,能力并不均衡。 GPT-3不同学科跨度很大,计算密集型领域较弱。正文列大学医学47.4%、大学数学35.0%、小学数学29.9%,说明名称上的教育层级不一定对应模型难度。图7能复述运算优先规则却算错的例子支持“知道规则与应用规则有区别”的直觉,但单个例子不是所有推理错误的完整机制证明。 准确率分科图、生成示例和置信校准图回答不同问题。校准图要比较信心与实际正确率的偏差,不能只看哪个模型给出的概率更高。
- GPT-3零样本置信度与实际学科准确率的校准散点图
实验/结果图 · 必要原图摘引 · 图8,HTML #S4.F8.fig2
读图8的对角线。 横轴是模型平均信心,纵轴是实际准确率,每点对应一个学科。在线下方表示信心高于正确率,在线上方表示正确率高于信心;离线越远,二者差距越大。这是学科层面的平均校准,不保证同一学科的每道题都可靠。
- GPT-3能复述运算顺序却算错简单表达式的生成示例
实验/结果图 · 必要原图摘引 · 图7,PDF第7页
**证据二:[图6](https://arxiv.org/html/2009.03300#S4.F6)、[图7](https://arxiv.org/html/2009.03300#S4.F8.fig1),能力并不均衡。** GPT-3不同学科跨度很大,计算密集型领域较弱。正文列大学医学47.4%、大学数学35.0%、小学数学29.9%,说明名称上的教育层级不一定对应模型难度。[图7](https://arxiv.org/html/2009.03300#S4.F8.fig1)能复述运算优先规则却算错的例子支持“知道规则与应用规则有区别”的直觉,但单个例子不是所有推理错误的完整机制证明。 准确率分科图、生成示例和置信校准图回答不同问题。校准图要比较信心与实际正确率的偏差,不能只看哪个模型给出的概率更高。
- GPT-3少样本设置下各学科平均置信度与准确率的校准散点图
实验/结果图 · 必要原图摘引 · 图11,PDF第13页
**证据三:[图8](https://arxiv.org/html/2009.03300#S4.F8.fig2)与[图11](https://arxiv.org/html/2009.03300#A1.F11.fig2),信心不可靠。** 零样本某些学科的平均信心与准确率差距达到24个百分点;少样本虽改善,仍存在明显差距。这支持需要校准研究,而非说明只要降低输出语气就能解决。模型概率、自然语言自信表述与真实正确率是不同信号。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图8、图6、图7、图11
- 问答核查:MMLU高分是否等于获得专业执业能力等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 图8 · 图8;HTML元素 #S4.F8.fig2
原站图表/证明入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 图7 · 图7;HTML元素 #S4.F8.fig1
原站图表/证明入口
- 图11 · 图11;HTML元素 #A1.F11.fig2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 拆解题目加权与学科加权总分
- 不平衡题量聚合反例
- 强调互补基准与猜测基线边界
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图8、图6、图7、图11
- v2:问答核查:MMLU高分是否等于获得专业执业能力等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读图8的对角线。** 横轴是模型平均信心,纵轴是实际准确率,每点对应一个学科。在线下方表示信心高于正确率,在线上方表示正确率高于信心;离线越远,二者差距越大。这是学科层面的平均校准,不保证同一学科的每道题都可靠。
查核资料
- arxiv.org · 所列章节
§3多学科四选一设计;专家分数估计的范围
- arxiv.org · 所列章节
证据二:图6、图7,能力并不均衡。 GPT-3不同学科跨度很大,计算密集型领域较弱。正文列大学医学47.4%、大学数学35.0%、小学数学29.9%,说明名称上的教育层级不一定对应模型难度。图7能复述运算优先规则却算错的例子支持“知道规则与应用规则有区别”的直觉,但单个例子不是所有推理错误的完整机制证明。 准确率分科图、生成示例和置信校准图回答不同问题。校准图要比较信心与实际正确率的偏差,不能只看哪个模型给出的概率更高。
- arxiv.org · 所列章节
读图8的对角线。 横轴是模型平均信心,纵轴是实际准确率,每点对应一个学科。在线下方表示信心高于正确率,在线上方表示正确率高于信心;离线越远,二者差距越大。这是学科层面的平均校准,不保证同一学科的每道题都可靠。
技术关系
- 035-gpt3 · 教学联系
few-shot评估对象
- 049-truthfulqa · 平行方法
互补真实性评估
- 052-gsm8k · 平行方法
互补多步数学评估
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Rethinking Attention with Performers部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:保留全局交互时,怎样避免显式位置平方矩阵
- 二、从随机核特征推导结合律计算与归一化误差
- 三、固定特征数、数值尺度与因果前缀累积
- 四、分开看硬件收益、近似方差与OOD表现
- 五、低维摘要和随机误差仍影响精细读取
- 六、以随机近似对照稀疏图和精确IO优化
- 自测与参考答案
段落怎样重新安排
- 从softmax矩阵到核函数 → 保留全局交互时,怎样避免显式位置平方矩阵
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 低维摘要和随机误差仍影响精细读取
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 以随机近似对照稀疏图和精确IO优化
真实关系移到后继路线,避免目录相邻等于技术继承
- 为什么采用正随机特征 → 从随机核特征推导结合律计算与归一化误差
先给出信息路径、目标与机制,再讨论执行顺序
- 为什么采用正随机特征 → 从随机核特征推导结合律计算与归一化误差
将原来的后置推导提前,解释伪代码为何这样计算
- 为什么采用正随机特征 → 固定特征数、数值尺度与因果前缀累积
单列可执行步骤,与机制论证及经验结果区分
- 为什么采用正随机特征 → 固定特征数、数值尺度与因果前缀累积
保留实现限制、训练协议及指标接口
- 实验设计与预算 → 分开看硬件收益、近似方差与OOD表现
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与实验思路 → 从随机核特征推导结合律计算与归一化误差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与实验思路 → 从随机核特征推导结合律计算与归一化误差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与实验思路 → 分开看硬件收益、近似方差与OOD表现
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与实验思路 → 低维摘要和随机误差仍影响精细读取
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 三组证据 → 分开看硬件收益、近似方差与OOD表现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据 → 分开看硬件收益、近似方差与OOD表现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据 → 分开看硬件收益、近似方差与OOD表现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据 → 分开看硬件收益、近似方差与OOD表现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据 → 分开看硬件收益、近似方差与OOD表现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组证据 → 分开看硬件收益、近似方差与OOD表现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 低维摘要和随机误差仍影响精细读取
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 低维摘要和随机误差仍影响精细读取
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 原摘要表 → 低维摘要和随机误差仍影响精细读取
保留摘要表中未在正文重复的公式或数值条件
- 已核原论文机制与适用的专业教法 → 先比较关联顺序,再比较核近似
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、以随机近似对照稀疏图和精确IO优化
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 先比较关联顺序,再比较核近似:先比较关联顺序,再比较核近似
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
原论文校准:Performer随机特征注意力及矩阵重排;小尺寸自构,未将近似声称为softmax精确等价。
本篇校准范围:Performer随机特征注意力及矩阵重排;小尺寸自构,未将近似声称为softmax精确等价。 新增段落仅用于“先比较关联顺序,再比较核近似”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Performer前向与反向运行时间随序列长度变化
实验/结果图 · 必要原图摘引 · 图3,HTML #S4.F3
证据一:图3,结合律产生实际资源收益。 图中随长度增长,Performer可以在更长序列运行,并改善前后向成本。图还给出把注意力直接返回V的理想参照,提醒读者其他网络组件仍有不可消除成本。结论绑定具体实现与16GB V100,不能外推为所有长度和硬件的固定倍数。 速度图中的 OPT 是注意力直接返回 V 的理想参照;近似误差图另固定序列长4096、维数16并改变随机特征数。速度上界与近似质量不能混读。
- Performer随机特征数量、正交性及正特征设计对近似误差的影响
实验/结果图 · 必要原图摘引 · 图4,HTML #S4.F4
证据二:图4与§2–3,特征设计确实影响误差。 正特征相对三角特征、正交相对独立特征在所测条件下具有更低误差,15次采样标准差体现随机性。它支持FAVOR+的设计,而非说明一次近似可无损替换任意预训练模型;必要时仍需适配训练。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图3、图4、表2
- 问答核查:Performer为何不是把注意力矩阵直接低秩分解一次等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 图3 · 图3;HTML元素 #S4.F3
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F4
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 展开S、z线性注意力状态
- 手算核加权与结合律等价
- 指出无偏核不等于无偏归一化输出
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图3、图4、表2
- v2:问答核查:Performer为何不是把注意力矩阵直接低秩分解一次等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.2式3—4与前缀和;随机特征归一化机制
技术关系
- 015-transformer · 直接继承
近似原注意力核
- 038-bigbird · 平行方法
稀疏连接路线
- 059-flashattention · 平行方法
精确IO优化路线
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型The Pile: An 800GB Dataset of Diverse Text for Language Modeling部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:相同GB的文本为何产生不同领域的训练经验
- 二、把组件字节、重复遍数换成实际混合权重
- 三、抽取、清洗并记录来源,再按统一单位计损失
- 四、从总规模回到领域BPB和数据消融
- 五、可追踪数据仍有来源、重复与覆盖边界
- 六、把数据口径接到预算分配与可研究训练
- 自测与参考答案
段落怎样重新安排
- 数据问题为什么不能只用GB回答 → 相同GB的文本为何产生不同领域的训练经验
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 可追踪数据仍有来源、重复与覆盖边界
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把数据口径接到预算分配与可研究训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 构造流程与数学描述 → 把组件字节、重复遍数换成实际混合权重
先给出信息路径、目标与机制,再讨论执行顺序
- 构造流程与数学描述 → 抽取、清洗并记录来源,再按统一单位计损失
单列可执行步骤,与机制论证及经验结果区分
- 构造流程与数学描述 → 抽取、清洗并记录来源,再按统一单位计损失
保留实现限制、训练协议及指标接口
- 实验设计 → 从总规模回到领域BPB和数据消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与数据消融 → 把组件字节、重复遍数换成实际混合权重
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与数据消融 → 把组件字节、重复遍数换成实际混合权重
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与数据消融 → 从总规模回到领域BPB和数据消融
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与数据消融 → 从总规模回到领域BPB和数据消融
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 如何跨分词器比较损失 → 把组件字节、重复遍数换成实际混合权重
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 如何跨分词器比较损失 → 把组件字节、重复遍数换成实际混合权重
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 如何跨分词器比较损失 → 把组件字节、重复遍数换成实际混合权重
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 如何跨分词器比较损失 → 把组件字节、重复遍数换成实际混合权重
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 如何跨分词器比较损失 → 把组件字节、重复遍数换成实际混合权重
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 如何跨分词器比较损失 → 把组件字节、重复遍数换成实际混合权重
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组结果如何读 → 从总规模回到领域BPB和数据消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组结果如何读 → 从总规模回到领域BPB和数据消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组结果如何读 → 从总规模回到领域BPB和数据消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组结果如何读 → 从总规模回到领域BPB和数据消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组结果如何读 → 从总规模回到领域BPB和数据消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 三组结果如何读 → 从总规模回到领域BPB和数据消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与范围 → 可追踪数据仍有来源、重复与覆盖边界
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与范围 → 可追踪数据仍有来源、重复与覆盖边界
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 字节、token和更新次数怎样分别变化
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把数据口径接到预算分配与可研究训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 字节、token和更新次数怎样分别变化:字节、token和更新次数怎样分别变化
原论文校准与展开范围
原论文校准:Pile组件大小、有效重复与BPB口径;字节/token比是说明单位变换的自构假设。
本篇校准范围:Pile组件大小、有效重复与BPB口径;字节/token比是说明单位变换的自构假设。 新增段落仅用于“字节、token和更新次数怎样分别变化”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读图4要注意纵轴已经是差值。** 每根柱对应一个Pile测试组件,柱高是CC-100模型相对Pile模型多出的BPB,越高表示Pile训练的改善越大;不是该领域自身的BPB,更不是准确率百分比。横轴按改善大小排列,不能沿柱子从左到右解释成训练时间上的进步。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- Pile训练相对其他语料在各文本领域的预测损失改善
实验/结果图 · 必要原图摘引 · 图4,HTML #S4.F4
读图4要注意纵轴已经是差值。 每根柱对应一个Pile测试组件,柱高是CC-100模型相对Pile模型多出的BPB,越高表示Pile训练的改善越大;不是该领域自身的BPB,更不是准确率百分比。横轴按改善大小排列,不能沿柱子从左到右解释成训练时间上的进步。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表1、表3、表4、图4
- 问答核查:825.18 GiB与1254.20 GiB为什么可以同时成立等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导字节权重转token权重
- 体裁分词密度与重复曝光算例
- 连接数据透明度和训练资源研究
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表1、表3、表4、图4
- v2:问答核查:825.18 GiB与1254.20 GiB为什么可以同时成立等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读图4要注意纵轴已经是差值。** 每根柱对应一个Pile测试组件,柱高是CC-100模型相对Pile模型多出的BPB,越高表示Pile训练的改善越大;不是该领域自身的BPB,更不是准确率百分比。横轴按改善大小排列,不能沿柱子从左到右解释成训练时间上的进步。
查核资料
- arxiv.org · 所列章节
§2表1组件原始/有效规模与混合权重
- arxiv.org · 所列章节
读图4要注意纵轴已经是差值。 每根柱对应一个Pile测试组件,柱高是CC-100模型相对Pile模型多出的BPB,越高表示Pile训练的改善越大;不是该领域自身的BPB,更不是准确率百分比。横轴按改善大小排列,不能沿柱子从左到右解释成训练时间上的进步。
技术关系
- 021-gpt2 · 历史背景
数据选择背景
- 027-t5 · 历史背景
预训练语料研究
- 057-chinchilla · 教学联系
token预算需定义
- 093-olmo2 · 历史背景
训练可研究性延伸
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:每token只用一个专家,能省掉哪些路由成本
- 二、推导top-1概率梯度和负载辅助项
- 三、按敏感组件设置精度、容量与初始化
- 四、同时比较时间阈值、稳定性和蒸馏增益
- 五、存储、溢出与微调风险没有随top-1消失
- 六、保留专家路线,继续比较激活数与系统目标
- 自测与参考答案
段落怎样重新安排
- 方法改动与问题设定 → 每token只用一个专家,能省掉哪些路由成本
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 存储、溢出与微调风险没有随top-1消失
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 保留专家路线,继续比较激活数与系统目标
真实关系移到后继路线,避免目录相邻等于技术继承
- 负载平衡与稳定性 → 推导top-1概率梯度和负载辅助项
先给出信息路径、目标与机制,再讨论执行顺序
- 负载平衡与稳定性 → 推导top-1概率梯度和负载辅助项
将原来的后置推导提前,解释伪代码为何这样计算
- 负载平衡与稳定性 → 按敏感组件设置精度、容量与初始化
单列可执行步骤,与机制论证及经验结果区分
- 负载平衡与稳定性 → 按敏感组件设置精度、容量与初始化
保留实现限制、训练协议及指标接口
- 实验设置 → 同时比较时间阈值、稳定性和蒸馏增益
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个构造例子与实验思路 → 推导top-1概率梯度和负载辅助项
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与实验思路 → 按敏感组件设置精度、容量与初始化
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与实验思路 → 同时比较时间阈值、稳定性和蒸馏增益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个构造例子与实验思路 → 存储、溢出与微调风险没有随top-1消失
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据 → 同时比较时间阈值、稳定性和蒸馏增益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 同时比较时间阈值、稳定性和蒸馏增益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 同时比较时间阈值、稳定性和蒸馏增益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 同时比较时间阈值、稳定性和蒸馏增益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 同时比较时间阈值、稳定性和蒸馏增益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 同时比较时间阈值、稳定性和蒸馏增益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与限制 → 存储、溢出与微调风险没有随top-1消失
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与限制 → 存储、溢出与微调风险没有随top-1消失
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 只执行一个专家时检查路由是否被错误归一化
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、保留专家路线,继续比较激活数与系统目标
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复正文已保留的论证;不保留第二份摘要模板;内容保留于问题设定、方法、带图证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 只执行一个专家时检查路由是否被错误归一化:只执行一个专家时检查路由是否被错误归一化
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:Switch原文保留被选路由概率乘专家输出;与Mixtral选后归一的规则不同,不跨论文混用。
本篇校准范围:Switch原文保留被选路由概率乘专家输出;与Mixtral选后归一的规则不同,不跨论文混用。 新增段落仅用于“只执行一个专家时检查路由是否被错误归一化”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- Switch与MoE在不同容量因子下的质量、达标时间及吞吐量
实验/结果图 · 必要原图摘引 · 表1,PDF第9页
证据一:表1,单路由的时间—质量比较。 容量因子1.0时,MoE达到指定质量阈值需80.1小时、速度860 examples/s,Switch为62.8小时、1000 examples/s;100k步质量分别-1.572和-1.561。它支持该配置下简化路由的效率优势,但其他容量因子下排序与差距不同,不能宣称top-1无条件胜过top-2。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表1、表2、表3、表4、表8
- 问答核查:只选一个专家,路由器怎样获得梯度等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S2.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S2.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S2.T4
原站图表/证明入口
- 表8 · 表8;HTML元素 #S4.T8
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 解释top-1仍可微的门权重
- 均衡损失手算
- 区分软均衡与硬容量
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表1、表2、表3、表4、表8
- v2:问答核查:只选一个专家,路由器怎样获得梯度等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1 top-1 gate梯度、§2.2式4—6均衡与容量
技术关系
- 014-sparse-moe · 直接继承
本篇简化稀疏门控
- 037-gshard · 直接继承
本篇简化分布式路由
- 084-mixtral · 历史背景
后续不同路由取舍
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Learning Transferable Visual Models From Natural Language Supervision部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:图像类别能否在测试时由语言描述重新定义
- 二、从图文相似度矩阵推导双向对比目标
- 三、先训练配对表示,再编码候选类别作为分类方向
- 四、连同模板、总数据与失败领域读取零样本成绩
- 五、类别描述接口还不具备逐token对话生成
- 六、把图文表示模块接到视觉语言生成
- 自测与答案
段落怎样重新安排
- 背景与问题定义 → 图像类别能否在测试时由语言描述重新定义
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 类别描述接口还不具备逐token对话生成
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把图文表示模块接到视觉语言生成
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:同时建立图像空间和文本空间 → 从图文相似度矩阵推导双向对比目标
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:同时建立图像空间和文本空间 → 从图文相似度矩阵推导双向对比目标
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:同时建立图像空间和文本空间 → 先训练配对表示,再编码候选类别作为分类方向
单列可执行步骤,与机制论证及经验结果区分
- 方法:同时建立图像空间和文本空间 → 先训练配对表示,再编码候选类别作为分类方向
保留实现限制、训练协议及指标接口
- 实验怎么做 → 连同模板、总数据与失败领域读取零样本成绩
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、代价与理解例子 → 类别描述接口还不具备逐token对话生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与理解例子 → 类别描述接口还不具备逐token对话生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与理解例子 → 从图文相似度矩阵推导双向对比目标
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与理解例子 → 类别描述接口还不具备逐token对话生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据及其边界 → 连同模板、总数据与失败领域读取零样本成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 连同模板、总数据与失败领域读取零样本成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 连同模板、总数据与失败领域读取零样本成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 连同模板、总数据与失败领域读取零样本成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 连同模板、总数据与失败领域读取零样本成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 连同模板、总数据与失败领域读取零样本成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 连同模板、总数据与失败领域读取零样本成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 相似度矩阵的一行与一列各代表什么
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把图文表示模块接到视觉语言生成
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 相似度矩阵的一行与一列各代表什么:相似度矩阵的一行与一列各代表什么
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
原论文校准:CLIP双向对比目标;三样本尺寸自构,注意力图解仅提供矩阵轴检查教法,CLIP不是注意力权重归一。
本篇校准范围:CLIP双向对比目标;三样本尺寸自构,注意力图解仅提供矩阵轴检查教法,CLIP不是注意力权重归一。 新增段落仅用于“相似度矩阵的一行与一列各代表什么”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:5 幅
- 零样本CLIP相对监督ResNet-50线性探针在不同数据集上的分数差
实验/结果图 · 必要原图摘引 · 图5,HTML #S3.F5
证据三:图5。 零样本CLIP在27个数据集中有16个超过监督ResNet-50表示的线性探针,但在EuroSAT落后37.1个百分点,在KITTI距离任务落后34.0个百分点。支持的是广泛而不均匀的迁移,不能总结成“零样本已经替代监督学习”。遥感、细粒度距离和某些计数任务要求的信号,未必被普通网页描述充分监督。
- CLIP对比预训练、标签文本编码与零样本分类的三个步骤
方法/设定图 · 必要原图摘引 · 图1,PDF第2页
图1先解释训练到分类的接口转换,再读提示集成、领域落后与自然分布变化,不能只记ImageNet单值。
- CLIP提示设计与提示集成对不同模型计算规模下平均分数的影响
实验/结果图 · 必要原图摘引 · 图4,PDF第7页
**证据二:§3.1.4与[图4](https://arxiv.org/html/2103.00020#S3.F4)。** 仅将裸类别名放入“照片”模板,ImageNet准确率就提升约1.3个百分点;80个提示的集成再带来约3.5个百分点提升。跨36个数据集,提示工程与集成平均接近5个百分点。这说明文本接口的表达会影响迁移,也意味着比较方法时必须交代模板。缓存后每图成本低,不等于设计与编码提示不花资源。
- CLIP在自然分布变化上的准确率关系以及各数据集样例与分数
实验/结果图 · 必要原图摘引 · 图13,PDF第15页
**证据四:[图13](https://arxiv.org/html/2103.00020#S3.F13)的自然分布变化。** 在ImageNet都为76.2%的对照下,ImageNetV2上监督ResNet-50为64.3%,CLIP为70.1%,差5.8个百分点。这是特定自然变化下更强迁移的证据,不是所有扰动或所有新领域下的保证。只控制原数据集准确率仍未控制数据、模型与训练机制的全部差异。
- CLIP不同文本目标的零样本ImageNet准确率随处理图像数变化
实验/结果图 · 必要原图摘引 · 图2,PDF第3页
作者选择对比目标,相比生成整段描述更直接优化可迁移的配对表示;[图2](https://arxiv.org/html/2103.00020#S1.F2)在其比较配置中支持更高的零样本学习效率,这仍不是对所有生成目标的理论否定。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图1、表1、图4、图5、图13、图2
- 问答核查:CLIP没用ImageNet训练标签,为什么不能说它完全不需要监督等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 图1 · 图1;HTML元素 #S1.F1
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 图13 · 图13;HTML元素 #S3.F13
原站图表/证明入口
- 图2 · 图2;HTML元素 #S1.F2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 逐行逐列损失解释
- 2×2矩阵概率与假负例算例
- 区分匹配表征和语言生成
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图1、表1、图4、图5、图13、图2
- v2:问答核查:CLIP没用ImageNet训练标签,为什么不能说它完全不需要监督等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.3配对矩阵、对称交叉熵、温度及图3
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Prefix-Tuning: Optimizing Continuous Prompts for Generation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:冻结生成模型时,逐层连续状态能承担多少任务适配
- 二、把前缀写成各层可读取的键和值
- 三、经冻结网络反传到前缀,并区分训练与部署参数
- 四、对照表格生成、摘要和输入层提示消融
- 五、前缀长度与受限表达会影响质量和读取成本
- 六、比较输入提示与低秩权重改动
- 自测与答案
段落怎样重新安排
- 研究问题与参照方法 → 冻结生成模型时,逐层连续状态能承担多少任务适配
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 前缀长度与受限表达会影响质量和读取成本
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 比较输入提示与低秩权重改动
真实关系移到后继路线,避免目录相邻等于技术继承
- 连续前缀到底是什么 → 把前缀写成各层可读取的键和值
先给出信息路径、目标与机制,再讨论执行顺序
- 连续前缀到底是什么 → 把前缀写成各层可读取的键和值
将原来的后置推导提前,解释伪代码为何这样计算
- 连续前缀到底是什么 → 经冻结网络反传到前缀,并区分训练与部署参数
单列可执行步骤,与机制论证及经验结果区分
- 连续前缀到底是什么 → 经冻结网络反传到前缀,并区分训练与部署参数
保留实现限制、训练协议及指标接口
- 实验设置与预算 → 对照表格生成、摘要和输入层提示消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献与教学例子 → 把前缀写成各层可读取的键和值
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与教学例子 → 前缀长度与受限表达会影响质量和读取成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与教学例子 → 把前缀写成各层可读取的键和值
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与教学例子 → 前缀长度与受限表达会影响质量和读取成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组关键证据 → 对照表格生成、摘要和输入层提示消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组关键证据 → 对照表格生成、摘要和输入层提示消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组关键证据 → 对照表格生成、摘要和输入层提示消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组关键证据 → 对照表格生成、摘要和输入层提示消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组关键证据 → 对照表格生成、摘要和输入层提示消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 逐层前缀不必对应同一串可读词
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、比较输入提示与低秩权重改动
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 逐层前缀不必对应同一串可读词:逐层前缀不必对应同一串可读词
教法来源与实际阅读范围
- Sourab Mangrulkar、Sayak Paul · Parameter-Efficient Fine-Tuning
Motivation、可训练参数统计、增量保存与加载
原论文校准:Prefix-Tuning逐层前缀与重参数化;HF PEFT仅用于冻结基座/任务增量的教学分账。
本篇校准范围:Prefix-Tuning逐层前缀与重参数化;HF PEFT仅用于冻结基座/任务增量的教学分账。 新增段落仅用于“逐层前缀不必对应同一串可读词”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Prefix Tuning的前缀长度对XSUM和DART两组指标的影响
实验/结果图 · 必要原图摘引 · 图4,HTML #S7.F4
证据三:表4与图4,结构消融。 E2E完整前缀BLEU69.7,仅调10个输入嵌入为62.2。图4显示前缀长度增加到一定程度后测试表现略降,即使训练损失更低。支持逐层干预和容量选择在这些配置中重要;不能据此断言输入层提示在更大模型上永远无效,下一篇恰好研究这一规模条件。 前缀长度图的两种指标使用两条纵轴;同一曲线内看长度变化,不能直接比较两条曲线的高度来判断指标谁更好。
- Prefix Tuning与全量微调在少数据条件下的生成示例与四项指标
实验/结果图 · 必要原图摘引 · 图3,PDF第7页
**证据四:[图3](https://arxiv.org/html/2101.00190#S6.F3)、[表3](https://arxiv.org/html/2101.00190#S6.T3)与附录A.4。** 小数据曲线偏向前缀;XSUM新闻到体育的ROUGE-L为31.51,全量为30.26。外推改善有真实主题划分依据,但附录指出前缀仍会遗漏表格内容,全量微调则常出现不符事实的生成。高自动指标并不能消除这两类风险。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表5、表1、表2、表4、图4、图3、表3
- 问答核查:Prefix-Tuning和只学习几个输入词向量为什么不相同等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 表5 · 表5;HTML元素 #A1.T5
原站图表/证明入口
- 表1 · 表1;HTML元素 #S6.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S6.T2
原站图表/证明入口
- 表4 · 表4;HTML元素 #S7.T4
原站图表/证明入口
- 图4 · 图4;HTML元素 #S7.F4
原站图表/证明入口
- 图3 · 图3;HTML元素 #S6.F3
原站图表/证明入口
- 表3 · 表3;HTML元素 #S6.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 解释KV前缀可见性与冻结反传
- 全层前缀对输入软prompt参数算例
- 区分训练与部署前缀表示
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表5、表1、表2、表4、图4、图3、表3
- v2:问答核查:Prefix-Tuning和只学习几个输入词向量为什么不相同等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§4.2全层前缀、§4.3 MLP重参数化
技术关系
- 017-gpt · 模块组合
冻结生成骨干
- 028-bart · 模块组合
冻结编码解码骨干
- 045-prompt-tuning · 平行方法
输入层软提示
- 047-lora · 平行方法
权重增量适配
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型The Power of Scale for Parameter-Efficient Prompt Tuning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只改输入嵌入,任务适配差距怎样随模型规模改变
- 二、推导软提示梯度怎样穿过冻结主干
- 三、记录共享LM适配、任务提示和批处理接口
- 四、结合规模误差条、迁移方向和集成成本读结果
- 五、小任务矩阵不保证可读指令或恒定计算
- 六、把输入接口与模块、权重增量放在同一成本账本
- 自测与答案
段落怎样重新安排
- 为什么“只改输入”值得研究 → 只改输入嵌入,任务适配差距怎样随模型规模改变
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 小任务矩阵不保证可读指令或恒定计算
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把输入接口与模块、权重增量放在同一成本账本
真实关系移到后继路线,避免目录相邻等于技术继承
- 目标函数与完整流程 → 推导软提示梯度怎样穿过冻结主干
先给出信息路径、目标与机制,再讨论执行顺序
- 目标函数与完整流程 → 推导软提示梯度怎样穿过冻结主干
将原来的后置推导提前,解释伪代码为何这样计算
- 目标函数与完整流程 → 记录共享LM适配、任务提示和批处理接口
单列可执行步骤,与机制论证及经验结果区分
- 目标函数与完整流程 → 记录共享LM适配、任务提示和批处理接口
保留实现限制、训练协议及指标接口
- 实验表:哪些条件组成了“规模有效” → 结合规模误差条、迁移方向和集成成本读结果
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 新意、限制与小例子 → 记录共享LM适配、任务提示和批处理接口
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 新意、限制与小例子 → 小任务矩阵不保证可读指令或恒定计算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 新意、限制与小例子 → 小任务矩阵不保证可读指令或恒定计算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 新意、限制与小例子 → 推导软提示梯度怎样穿过冻结主干
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 新意、限制与小例子 → 小任务矩阵不保证可读指令或恒定计算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组结果,分别证明什么 → 结合规模误差条、迁移方向和集成成本读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组结果,分别证明什么 → 结合规模误差条、迁移方向和集成成本读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组结果,分别证明什么 → 结合规模误差条、迁移方向和集成成本读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组结果,分别证明什么 → 结合规模误差条、迁移方向和集成成本读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组结果,分别证明什么 → 结合规模误差条、迁移方向和集成成本读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组结果,分别证明什么 → 结合规模误差条、迁移方向和集成成本读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 共享主干的两条任务在batch里怎样共存
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把输入接口与模块、权重增量放在同一成本账本
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 共享主干的两条任务在batch里怎样共存:共享主干的两条任务在batch里怎样共存
教法来源与实际阅读范围
- Sourab Mangrulkar、Sayak Paul · Parameter-Efficient Fine-Tuning
Motivation、可训练参数统计、增量保存与加载
原论文校准:Prompt Tuning共享冻结T5及任务软提示;batch与掩码例子为实现诊断,不增加原论文吞吐结果。
本篇校准范围:Prompt Tuning共享冻结T5及任务软提示;batch与掩码例子为实现诊断,不增加原论文吞吐结果。 新增段落仅用于“共享主干的两条任务在batch里怎样共存”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Prompt Tuning与全量模型微调的SuperGLUE成绩随模型规模变化
实验/结果图 · 必要原图摘引 · 图1,HTML #S1.F1
证据一:图1与§3.1。 随T5变大,Prompt Tuning与全量微调的SuperGLUE差距缩小,XXL接近多任务微调基线,任务参数少超过20,000倍。这里支持的是该模型族的经验趋势,没有证明任意任务、任意预训练目标都随规模自动追平。 规模曲线的误差条来自三次运行;大模型更接近全模型微调,并不表示所有规模、所有任务都已达到相同质量。
- Prompt Tuning的提示长度、初始化、预训练目标和LM适配步数四组消融
实验/结果图 · 必要原图摘引 · 图3,PDF第5页
| 共享准备 | 默认100K步LM adaptation;[图3](https://arxiv.org/html/2104.08691#S2.F3)单独比较适配步数和预训练目标 |
未在正文展示的图/表与范围
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图3、表7、图1、表1、表3、表2
- 问答核查:“模型从头到尾冻结”是否准确描述论文默认方法等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 图3 · 图3;HTML元素 #S2.F3
原站图表/证明入口
- 表7 · 表7;HTML元素 #A1.T7
原站图表/证明入口
- 图1 · 图1;HTML元素 #S1.F1
原站图表/证明入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S6.T3
原站图表/证明入口
- 表2 · 表2;HTML元素 #S5.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 展开提示梯度与冻结骨干区别
- 参数比例和多任务切换算例
- 澄清低训练参数不等于低计算
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图3、表7、图1、表1、表3、表2
- v2:问答核查:“模型从头到尾冻结”是否准确描述论文默认方法等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2冻结θ与可训练prompt嵌入目标
技术关系
- 027-t5 · 模块组合
原文T5骨干
- 044-prefix-tuning · 历史背景
连续控制思路但作用层不同
- 020-adapters · 平行方法
不同PEFT路线
- 047-lora · 平行方法
不同PEFT路线
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型RoFormer: Enhanced Transformer with Rotary Position Embedding部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:绝对位置输入怎样直接形成相对距离的匹配分数
- 二、逐二维旋转推导内积中的角度差
- 三、统一维度配对、位置编号与缓存约定
- 四、把代数性质与翻译、GLUE和长输入结果分开
- 五、可计算位置不等于任意长度任务泛化
- 六、把旋转位置组合到解码器并验证长度适配
- 自测与答案
段落怎样重新安排
- 问题背景与方法边界 → 绝对位置输入怎样直接形成相对距离的匹配分数
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 可计算位置不等于任意长度任务泛化
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把旋转位置组合到解码器并验证长度适配
真实关系移到后继路线,避免目录相邻等于技术继承
- 从二维旋转读懂公式 → 逐二维旋转推导内积中的角度差
先给出信息路径、目标与机制,再讨论执行顺序
- 从二维旋转读懂公式 → 逐二维旋转推导内积中的角度差
将原来的后置推导提前,解释伪代码为何这样计算
- 从二维旋转读懂公式 → 统一维度配对、位置编号与缓存约定
单列可执行步骤,与机制论证及经验结果区分
- 从二维旋转读懂公式 → 统一维度配对、位置编号与缓存约定
保留实现限制、训练协议及指标接口
- 实验设置 → 把代数性质与翻译、GLUE和长输入结果分开
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、代价与一个反例 → 可计算位置不等于任意长度任务泛化
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与一个反例 → 逐二维旋转推导内积中的角度差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与一个反例 → 统一维度配对、位置编号与缓存约定
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与一个反例 → 可计算位置不等于任意长度任务泛化
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据与需要保留的疑点 → 把代数性质与翻译、GLUE和长输入结果分开
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与需要保留的疑点 → 把代数性质与翻译、GLUE和长输入结果分开
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与需要保留的疑点 → 把代数性质与翻译、GLUE和长输入结果分开
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与需要保留的疑点 → 把代数性质与翻译、GLUE和长输入结果分开
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与需要保留的疑点 → 把代数性质与翻译、GLUE和长输入结果分开
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与需要保留的疑点 → 把代数性质与翻译、GLUE和长输入结果分开
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与需要保留的疑点 → 把代数性质与翻译、GLUE和长输入结果分开
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 缓存里保存的是旋转前还是旋转后的键
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把旋转位置组合到解码器并验证长度适配
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 缓存里保存的是旋转前还是旋转后的键:缓存里保存的是旋转前还是旋转后的键
教法来源与实际阅读范围
- Lilian Weng · The Transformer Family
vanilla位置编码;Transformer-XL状态复用、相对位置和张量拼接
原论文校准:RoPE绝对旋转与相对内积恒等式;缓存一致性诊断由公式推出,未声称修复任意长度外推。
本篇校准范围:RoPE绝对旋转与相对内积恒等式;缓存一致性诊断由公式推出,未声称修复任意长度外推。 新增段落仅用于“缓存里保存的是旋转前还是旋转后的键”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- RoFormer及相关对照的训练损失随更新步数变化
实验/结果图 · 必要原图摘引 · 图3,HTML #S4.F3
证据四:图3与§4.2、§4.4。 曲线显示相关模型训练损失较低,支持所测配方的优化表现。英文实验文字写100K步,但图3左横轴延伸到250K,训练日志口径未在对应文字中解释;此外正文将BERT位置表示称为sinusoidal,与标准BERT的可学习绝对位置不同。复现时应核对具体配置,不据此推断标准BERT所有设置都被严格复刻。
- RoPE位置相对距离增大时内积上界的振荡衰减曲线
方法/设定图 · 必要原图摘引 · 图2,PDF第8页
旋转是正交变换,保留向量范数;它改变方向而非直接把远处向量乘成更小。论文§3.4.3借复数求和与Abel变换研究距离相关上界,再以[图2](https://arxiv.org/html/2104.09864v5#S3.F2)显示某种衰减趋势。这个上界分析不能改写成“任意固定query/key的分数随距离严格单调下降”。单一频率的余弦就会振荡。
- RoPE对二维向量旋转并扩展到多维位置编码的结构
方法/设定图 · 必要原图摘引 · 图1,PDF第5页
**证据一:§3.2公式16及[图1](https://arxiv.org/html/2104.09864v5#S3.F1)。** 正交旋转给出相对位移内积,这是明确代数证据,支持机制解释。它不涉及模型是否学会解决长文任务;从公式跳到无限长度泛化,会超出推导内容。 衰减图描述多频率旋转下的趋势;它不是任意输入内容的注意力权重热图,不能据此给每个远处 token 设定单调上界。
未在正文展示的图/表与范围
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图2、表4、表1、表2、表5、图1、图3
- 问答核查:为何分别使用绝对位置旋转,却得到相对位置分数等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 图2 · 图2;HTML元素 #S3.F2
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表5 · 表5;HTML元素 #S4.T5
原站图表/证明入口
- 图1 · 图1;HTML元素 #S3.F1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S4.F3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补充旋转群等式的计算顺序
- 缓存位置错误的角差反例
- 限定实现等价条件与长程泛化
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图2、表4、表1、表2、表5、图1、图3
- v2:问答核查:为何分别使用绝对位置旋转,却得到相对位置分数等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.2二维旋转式13与高维式14—16
技术关系
- 019-transformer-xl · 平行方法
不同相对位置参数化
- 068-llama · 模块组合
后作组合RoPE
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型LoRA: Low-Rank Adaptation of Large Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:任务改动能否限制在可合并的少数权重方向
- 二、推导低秩增量及非对称零初始化的梯度
- 三、冻结主权重、训练因子并核对合并结果
- 四、按参数预算、目标投影与rank分别读对照
- 五、增量低秩不压缩骨干,也不适合任意领域跨度
- 六、把低秩更新与量化冻结骨干组合
- 自测与答案
段落怎样重新安排
- 方法解决什么成本 → 任务改动能否限制在可合并的少数权重方向
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 增量低秩不压缩骨干,也不适合任意领域跨度
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把低秩更新与量化冻结骨干组合
真实关系移到后继路线,避免目录相邻等于技术继承
- 核心公式与初始化 → 推导低秩增量及非对称零初始化的梯度
先给出信息路径、目标与机制,再讨论执行顺序
- 核心公式与初始化 → 推导低秩增量及非对称零初始化的梯度
将原来的后置推导提前,解释伪代码为何这样计算
- 核心公式与初始化 → 冻结主权重、训练因子并核对合并结果
单列可执行步骤,与机制论证及经验结果区分
- 核心公式与初始化 → 冻结主权重、训练因子并核对合并结果
保留实现限制、训练协议及指标接口
- 实验设置与公平比较 → 按参数预算、目标投影与rank分别读对照
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 代价与教学例子 → 推导低秩增量及非对称零初始化的梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 代价与教学例子 → 增量低秩不压缩骨干,也不适合任意领域跨度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 代价与教学例子 → 冻结主权重、训练因子并核对合并结果
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 代价与教学例子 → 增量低秩不压缩骨干,也不适合任意领域跨度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五项具体证据 → 按参数预算、目标投影与rank分别读对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五项具体证据 → 按参数预算、目标投影与rank分别读对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五项具体证据 → 按参数预算、目标投影与rank分别读对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五项具体证据 → 按参数预算、目标投影与rank分别读对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五项具体证据 → 按参数预算、目标投影与rank分别读对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 合并前后用同一输入核对权重方向
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把低秩更新与量化冻结骨干组合
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 合并前后用同一输入核对权重方向:合并前后用同一输入核对权重方向
教法来源与实际阅读范围
- Sourab Mangrulkar、Sayak Paul · Parameter-Efficient Fine-Tuning
Motivation、可训练参数统计、增量保存与加载
原论文校准:LoRA增量BA与可合并线性结构;仅适用于对应线性层的合并,不自动覆盖量化后再合并误差。
本篇校准范围:LoRA增量BA与可合并线性结构;仅适用于对应线性层的合并,不自动覆盖量化后再合并误差。 新增段落仅用于“合并前后用同一输入核对权重方向”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- LoRA与其他参数高效适配方法的GLUE成绩和可训练参数量
实验/结果图 · 必要原图摘引 · 表2,PDF第6页
读表2。 先按 RoBERTa-base、RoBERTa-large 和 DeBERTa-XXL 分组,再比较可训练参数与各任务分数。带†的 Adapter 和 LoRA 运行匹配长度128及初始化口径;表内没有用一个平均分消除其他训练条件差异,因此不能把全部行都当作严格单变量对照。
未在正文展示的图/表与范围
- 表11:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表11、表2、表1、表3、表4、表5、表6
- 问答核查:LoRA是否假定预训练权重是低秩的等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 表11 · 表11;HTML元素 #A4.T11
原站图表/证明入口
- 表2 · 表2;HTML元素 #S5.T2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S5.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S7.T5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S7.T6
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导A/B初始化梯度
- 秩1首步数值轨迹
- 区分增量低秩与原权重秩
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表11、表2、表1、表3、表4、表5、表6
- v2:问答核查:LoRA是否假定预训练权重是低秩的等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§4.1式3、A随机B零、缩放与合并
技术关系
- 020-adapters · 平行方法
串行模块适配
- 044-prefix-tuning · 平行方法
状态前缀适配
- 074-qlora · 直接继承
后作组合LoRA与量化
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Evaluating Large Language Models Trained on Code部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:代码文本相似之外,怎样衡量实现是否满足函数规格
- 二、由候选组合数推导pass@k覆盖估计
- 三、代码域训练后固定采样、测试与候选选择协议
- 四、区分raw、filtered、oracle与实际单提交成绩
- 五、有限测试和选择器限制仍留下交付失败
- 六、从单函数执行走向仓库修复与选择协议
- 自测与答案
段落怎样重新安排
- 问题设定与训练路线 → 代码文本相似之外,怎样衡量实现是否满足函数规格
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 有限测试和选择器限制仍留下交付失败
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从单函数执行走向仓库修复与选择协议
真实关系移到后继路线,避免目录相邻等于技术继承
- 数学目标与pass@k → 由候选组合数推导pass@k覆盖估计
先给出信息路径、目标与机制,再讨论执行顺序
- 数学目标与pass@k → 由候选组合数推导pass@k覆盖估计
将原来的后置推导提前,解释伪代码为何这样计算
- 数学目标与pass@k → 代码域训练后固定采样、测试与候选选择协议
单列可执行步骤,与机制论证及经验结果区分
- 数学目标与pass@k → 代码域训练后固定采样、测试与候选选择协议
保留实现限制、训练协议及指标接口
- 实验设置 → 区分raw、filtered、oracle与实际单提交成绩
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、失败与教学例子 → 由候选组合数推导pass@k覆盖估计
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、失败与教学例子 → 有限测试和选择器限制仍留下交付失败
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、失败与教学例子 → 有限测试和选择器限制仍留下交付失败
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、失败与教学例子 → 区分raw、filtered、oracle与实际单提交成绩
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、失败与教学例子 → 由候选组合数推导pass@k覆盖估计
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、失败与教学例子 → 有限测试和选择器限制仍留下交付失败
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组证据,避免混淆数字 → 区分raw、filtered、oracle与实际单提交成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据,避免混淆数字 → 区分raw、filtered、oracle与实际单提交成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据,避免混淆数字 → 区分raw、filtered、oracle与实际单提交成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据,避免混淆数字 → 区分raw、filtered、oracle与实际单提交成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据,避免混淆数字 → 区分raw、filtered、oracle与实际单提交成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据,避免混淆数字 → 区分raw、filtered、oracle与实际单提交成绩
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把候选覆盖和最终交付写成两个事件
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、从单函数执行走向仓库修复与选择协议
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 把候选覆盖和最终交付写成两个事件:把候选覆盖和最终交付写成两个事件
原论文校准与展开范围
原论文校准:Codex pass@k候选覆盖与实际排序差异;计数自构,测试接受仍不等于完整程序规格正确。
本篇校准范围:Codex pass@k候选覆盖与实际排序差异;计数自构,测试接受仍不等于完整程序规格正确。 新增段落仅用于“把候选覆盖和最终交付写成两个事件”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:6 幅
- Codex采样温度、候选数量与pass@k之间的关系
实验/结果图 · 必要原图摘引 · 图5,HTML #S3.F5
证据二:图1与图5、图6。 图1明确所有样本温度0.8,摘要和部分展示使用的基础模型100样本数值约70.2%;表1在相应采样配置下为72.31%。不能把不同温度口径的数字当成相互矛盾的同一次实验,也不能把各个k最优配置说成固定一套采样策略。图5说明大k通常更受益于多样性,而单样本更需要高概率正确实现。 pass@k 图中的 k 是候选数;单提交选择图的 oracle 已知道测试是否通过。可部署排序线与 oracle 覆盖线之间的差距才是选择器问题。
- Codex与Codex-S在不同模型规模和候选排序方法下的通过率
实验/结果图 · 必要原图摘引 · 图1,PDF第2页
**证据二:[图1](https://arxiv.org/html/2107.03374v2#S1.F1)与[图5](https://arxiv.org/html/2107.03374v2#S3.F5)、[图6](https://arxiv.org/html/2107.03374v2#S3.F6)。** [图1](https://arxiv.org/html/2107.03374v2#S1.F1)明确所有样本温度0.8,摘要和部分展示使用的基础模型100样本数值约70.2%;[表1](https://arxiv.org/html/2107.03374v2#S3.T1)在相应采样配置下为72.31%。不能把不同温度口径的数字当成相互矛盾的同一次实验,也不能把各个k最优配置说成固定一套采样策略。[图5](https://arxiv.org/html/2107.03374v2#S3.F5)说明大k通常更受益于多样性,而单样本更需要高概率正确实现。 pass@k 图中的 k 是候选数;单提交选择图的 oracle 已知道测试是否通过。可部署排序线与 oracle 覆盖线之间的差距才是选择器问题。
- Codex模型参数量与pass@1、pass@100的关系
实验/结果图 · 必要原图摘引 · 图6,PDF第5页
**证据二:[图1](https://arxiv.org/html/2107.03374v2#S1.F1)与[图5](https://arxiv.org/html/2107.03374v2#S3.F5)、[图6](https://arxiv.org/html/2107.03374v2#S3.F6)。** [图1](https://arxiv.org/html/2107.03374v2#S1.F1)明确所有样本温度0.8,摘要和部分展示使用的基础模型100样本数值约70.2%;[表1](https://arxiv.org/html/2107.03374v2#S3.T1)在相应采样配置下为72.31%。不能把不同温度口径的数字当成相互矛盾的同一次实验,也不能把各个k最优配置说成固定一套采样策略。[图5](https://arxiv.org/html/2107.03374v2#S3.F5)说明大k通常更受益于多样性,而单样本更需要高概率正确实现。 pass@k 图中的 k 是候选数;单提交选择图的 oracle 已知道测试是否通过。可部署排序线与 oracle 覆盖线之间的差距才是选择器问题。
- Codex候选数量增加时五种候选排序方法的通过率
实验/结果图 · 必要原图摘引 · 图7,PDF第6页
**证据三:[图1](https://arxiv.org/html/2107.03374v2#S1.F1)与[图7](https://arxiv.org/html/2107.03374v2#S3.F7)、[图10](https://arxiv.org/html/2107.03374v2#S4.F10)。** 固定[图1](https://arxiv.org/html/2107.03374v2#S1.F1)口径下,Codex-S单样本约37.7%,100候选中按平均对数概率选择约44.5%,若用测试挑出正确候选则约77.5%。44.5与77.5之间的差距就是选择能力缺口;潜在正确代码已经存在于集合,不表示系统能无测试地识别它。
- Codex-S与Codex在模型规模及候选排序上的两组对照
实验/结果图 · 必要原图摘引 · 图10,PDF第9页
**证据三:[图1](https://arxiv.org/html/2107.03374v2#S1.F1)与[图7](https://arxiv.org/html/2107.03374v2#S3.F7)、[图10](https://arxiv.org/html/2107.03374v2#S4.F10)。** 固定[图1](https://arxiv.org/html/2107.03374v2#S1.F1)口径下,Codex-S单样本约37.7%,100候选中按平均对数概率选择约44.5%,若用测试挑出正确候选则约77.5%。44.5与77.5之间的差距就是选择能力缺口;潜在正确代码已经存在于集合,不表示系统能无测试地识别它。
- 四个HumanEval问题中正确与错误程序的BLEU分数分布
实验/结果图 · 必要原图摘引 · 图8,PDF第6页
**证据四:[图8](https://arxiv.org/html/2107.03374v2#S3.F8)。** 正确与错误程序的BLEU分布明显重叠,支持文本相似度不适合作为唯一代码正确性指标。换变量名或改写循环可能不改变功能,漏掉一个等号却可能改变边界行为,因此需要执行式评价。不过测试自身也要覆盖边界,不能把BLEU的局限变成测试集完美的结论。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图1、图5、图6、图7、图10、图8、表2
- 问答核查:pass@100为70%能否理解为实际推荐代码有70%正确率等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 图1 · 图1;HTML元素 #S1.F1
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 图6 · 图6;HTML元素 #S3.F6
原站图表/证明入口
- 图7 · 图7;HTML元素 #S3.F7
原站图表/证明入口
- 图10 · 图10;HTML元素 #S4.F10
原站图表/证明入口
- 图8 · 图8;HTML元素 #S3.F8
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 组合计数推导pass@k
- 10样本与代入偏差算例
- 区分候选覆盖、选择和完整规格
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图1、图5、图6、图7、图10、图8、表2
- v2:问答核查:pass@100为70%能否理解为实际推荐代码有70%正确率等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1式1与无偏估计讨论、§2.2 HumanEval测试范围
技术关系
- 035-gpt3 · 直接继承
继续预训练到代码域
- 081-swebench · 历史背景
评价从函数扩到仓库
- 100-tts-protocol · 教学联系
覆盖与选择分开
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型TruthfulQA: Measuring How Models Mimic Human Falsehoods部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:更会模仿常见文本,是否也更会复述常见误解
- 二、把对抗题集、真实性与信息量定义为不同事件
- 三、固定零样本提示并检验人工与自动判分协议
- 四、同时读规模、信息量和判分器风格外泛化
- 五、压力测试揭示脆弱性而非日常问答错误率
- 六、将真实性与指令偏好作为不同优化与评价轴
- 自测与答案
段落怎样重新安排
- 研究背景:缺知识与模仿错误是两类失败 → 更会模仿常见文本,是否也更会复述常见误解
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 压力测试揭示脆弱性而非日常问答错误率
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 将真实性与指令偏好作为不同优化与评价轴
真实关系移到后继路线,避免目录相邻等于技术继承
- 基准如何构造 → 把对抗题集、真实性与信息量定义为不同事件
保留完整公式和事实约束
- 指标、判分器与流程 → 把对抗题集、真实性与信息量定义为不同事件
先给出信息路径、目标与机制,再讨论执行顺序
- 指标、判分器与流程 → 把对抗题集、真实性与信息量定义为不同事件
将原来的后置推导提前,解释伪代码为何这样计算
- 指标、判分器与流程 → 固定零样本提示并检验人工与自动判分协议
单列可执行步骤,与机制论证及经验结果区分
- 指标、判分器与流程 → 固定零样本提示并检验人工与自动判分协议
保留实现限制、训练协议及指标接口
- 实验设置 → 同时读规模、信息量和判分器风格外泛化
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、代价与教学例子 → 把对抗题集、真实性与信息量定义为不同事件
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与教学例子 → 压力测试揭示脆弱性而非日常问答错误率
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与教学例子 → 把对抗题集、真实性与信息量定义为不同事件
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与教学例子 → 压力测试揭示脆弱性而非日常问答错误率
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与教学例子 → 压力测试揭示脆弱性而非日常问答错误率
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据与解释边界 → 同时读规模、信息量和判分器风格外泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与解释边界 → 同时读规模、信息量和判分器风格外泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与解释边界 → 同时读规模、信息量和判分器风格外泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与解释边界 → 同时读规模、信息量和判分器风格外泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与解释边界 → 同时读规模、信息量和判分器风格外泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与解释边界 → 同时读规模、信息量和判分器风格外泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 真实与有信息的交集不能用两个平均数相乘
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、将真实性与指令偏好作为不同优化与评价轴
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 真实与有信息的交集不能用两个平均数相乘:真实与有信息的交集不能用两个平均数相乘
教法来源与实际阅读范围
- Lilian Weng · Extrinsic Hallucinations in LLMs
幻觉定义、知识来源、检索增强评价与原子事实评价
原论文校准:TruthfulQA真实性/信息量分别评价;交集上下界为自构集合计数,不是原数据分布。
本篇校准范围:TruthfulQA真实性/信息量分别评价;交集上下界为自构集合计数,不是原数据分布。 新增段落仅用于“真实与有信息的交集不能用两个平均数相乘”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- TruthfulQA上的真实性、信息性和同时真实且有信息的比例
实验/结果图 · 必要原图摘引 · 图4,HTML #S3.F4
证据一:图4与附录表4。 GPT-3 175B配合helpful提示,真实回答约58.1%,同时真实且有信息约21.4%;人工基线分别约94%和87%。相差的不只是“知道多少”,也包括拒答方式。若只引用58%并说回答正确率超过一半,会遗漏大量没有真正回答问题的情况。 先分清“真实”和“真实且有信息”两种纵轴含义;回答“不知道”可能提高前者,因此必须连同信息性一起判断。
- 不同规模语言模型在TruthfulQA与控制常识题上的真实性
实验/结果图 · 必要原图摘引 · 图2,PDF第3页
**证据二:[图2](https://arxiv.org/html/2109.07958#S1.F2)及附录[表4](https://arxiv.org/html/2109.07958#A2.T4)。** GPT-Neo/J从125M到6B,真实回答比例43.6%降到26.8%,下降16.8个百分点;同时回答信息量从54.3%增至90.0%。更大模型更愿意给实质回答,却更可能在此题集说错。控制组采用相近句法、但不诱发误解的常识题时,规模趋势改善,削弱“只是题目句法奇怪”的解释。
- 不同GPT-3规模对打碎镜子问题给出的真实与迷信回答
实验/结果图 · 必要原图摘引 · 图3,PDF第3页
**证据三:[图3](https://arxiv.org/html/2109.07958#S1.F3)。** 镜子例子中,小模型给出泛泛定义,大模型复述迷信。它直观展示信息量与真实性的冲突,但只是一个案例,不能证明全部错误都由训练语料中的同句复制产生。§4.3将模仿性错误作为多条证据支持的解释,也承认部分非模仿弱点仍可能存在。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图4、表4、图2、图3、表1
- 问答核查:为什么真实率高不等于解决问题的比例高等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 表4 · 表4;HTML元素 #A2.T4
原站图表/证明入口
- 图2 · 图2;HTML元素 #S1.F2
原站图表/证明入口
- 图3 · 图3;HTML元素 #S1.F3
原站图表/证明入口
- 表1 · 表1;HTML元素 #A2.T1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 用条件分布解释对抗基准适用范围
- 拒答与实质纠错教学对照
- 区分真实性、信息量与偏好
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图4、表4、图2、图3、表1
- v2:问答核查:为什么真实率高不等于解决问题的比例高等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.2 filtered/unfiltered构造与目标模型筛选
技术关系
- 039-mmlu · 平行方法
互补知识与误解测量
- 054-instructgpt · 教学联系
偏好与真实性并非同一指标
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Finetuned Language Models Are Zero-Shot Learners部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只给自然语言说明,模型能否迁移到未训练任务簇
- 二、把监督任务改写为指令条件下的生成目标
- 三、记录模板、反转任务和整簇留出的训练流程
- 四、按模板敏感性、任务数量和负结果检验迁移
- 五、未见任务的零样本不等于从未接受监督
- 六、对照多任务提示训练,再加入人类偏好
- 自测与答案
段落怎样重新安排
- 背景与严格的问题定义 → 只给自然语言说明,模型能否迁移到未训练任务簇
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 未见任务的零样本不等于从未接受监督
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 对照多任务提示训练,再加入人类偏好
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法到底改了什么 → 把监督任务改写为指令条件下的生成目标
先给出信息路径、目标与机制,再讨论执行顺序
- 方法到底改了什么 → 记录模板、反转任务和整簇留出的训练流程
单列可执行步骤,与机制论证及经验结果区分
- 方法到底改了什么 → 记录模板、反转任务和整簇留出的训练流程
保留实现限制、训练协议及指标接口
- 训练与评估预算 → 按模板敏感性、任务数量和负结果检验迁移
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 训练与评估预算 → 把监督任务改写为指令条件下的生成目标
将实验设置后置的机制推导移到正式方法中
- 贡献、局限与小例子 → 按模板敏感性、任务数量和负结果检验迁移
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与小例子 → 未见任务的零样本不等于从未接受监督
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与小例子 → 未见任务的零样本不等于从未接受监督
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与小例子 → 把监督任务改写为指令条件下的生成目标
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与小例子 → 未见任务的零样本不等于从未接受监督
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组证据及其限度 → 按模板敏感性、任务数量和负结果检验迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其限度 → 按模板敏感性、任务数量和负结果检验迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其限度 → 按模板敏感性、任务数量和负结果检验迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其限度 → 按模板敏感性、任务数量和负结果检验迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其限度 → 按模板敏感性、任务数量和负结果检验迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其限度 → 按模板敏感性、任务数量和负结果检验迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其限度 → 按模板敏感性、任务数量和负结果检验迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 留出任务簇时先按原始样本分组
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、对照多任务提示训练,再加入人类偏好
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 留出任务簇时先按原始样本分组:留出任务簇时先按原始样本分组
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:FLAN任务簇留出与指令模板;是防泄漏实现检查,不断言论文存在上述错误。
本篇校准范围:FLAN任务簇留出与指令模板;是防泄漏实现检查,不断言论文存在上述错误。 新增段落仅用于“留出任务簇时先按原始样本分组”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:4 幅
- FLAN增加指令训练任务簇时的留出任务表现
实验/结果图 · 必要原图摘引 · 图6,HTML #S4.F6
证据三:图6,任务簇数量。 在固定留出簇下,从1个训练簇增加至7个,平均分由49.9增至63.5,中途也有59.3到59.2的小降。表明更多任务覆盖在该加入顺序中有益,但簇数量、数据内容和任务相关性同时变化,不能据此给各个簇作独立贡献排名。
- FLAN与各基线在自然语言推断、阅读、闭卷问答及翻译任务上的零样本表现
实验/结果图 · 必要原图摘引 · 图5,PDF第5页
**证据一:[图5](https://arxiv.org/html/2109.01652#S3.F5)与附录[表2](https://arxiv.org/html/2109.01652#A1.T2),基础模型前后比较。** RTE上LaMDA-PT零样本73.3%,FLAN模板平均78.3±7.9%;BoolQ为81.0%对80.2±3.1%,并非提升。NQ则从3.2到18.6±2.7,变化明显。指令训练对需要明确任务格式的部分任务帮助很大,但不能把平均收益写成每个任务都进步。
- FLAN训练及评测中是否使用指令或数据集名称的四组消融
实验/结果图 · 必要原图摘引 · 图8,PDF第7页
**证据二:附录[表3](https://arxiv.org/html/2109.01652#A2.T3)与[图8](https://arxiv.org/html/2109.01652#S4.F8),去掉指令的消融。** 四类任务平均,正常指令训练与指令评估为55.2,无模板训练后用指令评估为37.3;训练仅用数据集名后用自然指令评估为46.6,同样用数据集名评估为47.0。支持自然语言指令不只是装饰。但无模板对照同时带来训练—测试接口差异,所以更有解释力的是同时看多个对照,而不是仅引用最弱一项。
- 指令调优与未调优模型在未见任务上的准确率随模型规模变化
实验/结果图 · 必要原图摘引 · 图7,PDF第7页
**证据四:[图7](https://arxiv.org/html/2109.01652#S4.F7),模型规模。** 小规模配置中指令微调可能伤害未见任务,大规模配置获益。作者提出小模型容量被训练任务占据的可能解释,但没有直接测出一个“容量耗尽”变量;应把它保留为解释假设,不能当作已证明机理,更不能转成小模型永远不适合指令训练的结论。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:图5、表2、表3、图8、图6、图7
- 问答核查:为什么FLAN用监督数据训练,还能称为零样本学习等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 表2 · 表2;HTML元素 #A1.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #A2.T3
原站图表/证明入口
- 图8 · 图8;HTML元素 #S4.F8
原站图表/证明入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 图7 · 图7;HTML元素 #S4.F7
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 形式化训练任务混合与评估零示例
- 三层泛化划分教学例
- 分开指令监督和偏好优化
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:图5、表2、表3、图8、图6、图7
- v2:问答核查:为什么FLAN用监督数据训练,还能称为零样本学习等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1任务模板、§2.2按任务簇留出
技术关系
- 035-gpt3 · 历史背景
从提示接口到显式指令学习
- 051-t0 · 平行方法
同期多任务提示训练
- 054-instructgpt · 历史背景
后续人类偏好优化
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Multitask Prompted Training Enables Zero-Shot Task Generalization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未见任务的迁移与换一种问法的稳定性能否同时改善
- 二、把数据字段、标签和多种模板变成可采样分布
- 三、区分训练混合版本与测试提示的抽样口径
- 四、沿提示分布、模板数和任务数分别读消融
- 五、任务族边界与格式适应仍限制语义解释
- 六、把提示训练与偏好训练的信号分开
- 自测与答案
段落怎样重新安排
- 研究背景与FLAN的联系 → 未见任务的迁移与换一种问法的稳定性能否同时改善
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 任务族边界与格式适应仍限制语义解释
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把提示训练与偏好训练的信号分开
真实关系移到后继路线,避免目录相邻等于技术继承
- 数据、模板与训练目标 → 把数据字段、标签和多种模板变成可采样分布
先给出信息路径、目标与机制,再讨论执行顺序
- 数据、模板与训练目标 → 把数据字段、标签和多种模板变成可采样分布
将原来的后置推导提前,解释伪代码为何这样计算
- 数据、模板与训练目标 → 区分训练混合版本与测试提示的抽样口径
单列可执行步骤,与机制论证及经验结果区分
- 实验预算与评价口径 → 沿提示分布、模板数和任务数分别读消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、理解例子与边界 → 任务族边界与格式适应仍限制语义解释
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、理解例子与边界 → 任务族边界与格式适应仍限制语义解释
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、理解例子与边界 → 把数据字段、标签和多种模板变成可采样分布
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、理解例子与边界 → 沿提示分布、模板数和任务数分别读消融
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、理解例子与边界 → 任务族边界与格式适应仍限制语义解释
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据 → 沿提示分布、模板数和任务数分别读消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 沿提示分布、模板数和任务数分别读消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 沿提示分布、模板数和任务数分别读消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 沿提示分布、模板数和任务数分别读消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 沿提示分布、模板数和任务数分别读消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 沿提示分布、模板数和任务数分别读消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据 → 沿提示分布、模板数和任务数分别读消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 模板增加怎样偷偷改变数据集权重
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把提示训练与偏好训练的信号分开
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 模板增加怎样偷偷改变数据集权重:模板增加怎样偷偷改变数据集权重
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:T0多模板与训练混合机制;此计数解释采样口径,不声称原文恰用该比例。
本篇校准范围:T0多模板与训练混合机制;此计数解释采样口径,不声称原文恰用该比例。 新增段落仅用于“模板增加怎样偷偷改变数据集权重”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- T0与基线在多个留出任务上不同评估提示的分数分布
实验/结果图 · 必要原图摘引 · 图4,HTML #S6.F4
证据一:图4与附录表6。 同一基础T5+LM与T0比较,RTE模板中位数由51.81升至81.23,CB由33.93升至78.57,ANLI R1由32.85升至44.70。它们支持多任务提示训练能改善留出任务。CB等小评估集的提示变化可能很大,因此中位数变化不应掩盖分布范围。 每个点代表一个评估提示的成绩,分布宽度反映措辞敏感性;GPT-3 参考值只用单一提示,不能当作同样的多提示分布。
- T0不同训练提示数量下各评测任务的分数分布
实验/结果图 · 必要原图摘引 · 图6,PDF第9页
**证据二:[图6](https://arxiv.org/html/2110.08207#S6.F6)与§6.2。** 每数据集一个模板已经有益;从一个增加到平均5.7个原任务模板,11个数据集中8个中位数提高、7个四分位距缩小。支持提示多样性在多数任务上改善稳健性,但不是所有任务都如此。扩到8.03还加入反转任务,数量和任务形式同时变化,需要区分这层混杂。
- T0及不同语言模型在BIG-bench任务上的分组结果
实验/结果图 · 必要原图摘引 · 图5,PDF第8页
**证据四:[图5](https://arxiv.org/html/2110.08207#S6.F5)与附录[表7](https://arxiv.org/html/2110.08207#A6.T7)。** BIG-bench的Logical Deduction准确率,T5+LM为31.00、T0为55.40、T0+为44.20、T0++为43.60;Vitamin C则依次38.29、64.73、66.24、70.00。两种趋势同时存在,不能概括成训练数据越多每一项就越好。作者“13/14超过大基线”的说法还涉及至少一个T0变体达到较好结果,不等于一个固定变体在全部任务都胜出。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表5、表1、图4、表6、图6、图5、表7
- 问答核查:T0+在HellaSwag大幅超过T0,为什么不是最有力的零样本提升证据等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 表5 · 表5;HTML元素 #A4.T5
原站图表/证明入口
- 表1 · 表1;HTML元素 #A2.T1
原站图表/证明入口
- 图4 · 图4;HTML元素 #S6.F4
原站图表/证明入口
- 表6 · 表6;HTML元素 #A6.T6
原站图表/证明入口
- 图6 · 图6;HTML元素 #S6.F6
原站图表/证明入口
- 图5 · 图5;HTML元素 #S6.F5
原站图表/证明入口
- 表7 · 表7;HTML元素 #A6.T7
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 解释模板展开的隐式重加权
- 10对2模板曝光算例
- 限定不同T0版本的留出范围
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表5、表1、图4、表6、图6、图5、表7
- v2:问答核查:T0+在HellaSwag大幅超过T0,为什么不是最有力的零样本提升证据等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§4模板映射、§5 T5+LM初始化与T0/T0+/T0++划分
技术关系
- 027-t5 · 模块组合
在T5编码器解码器骨干上实施多任务提示微调,重点改变训练任务组织。
- 050-flan · 平行方法
同期指令多任务路线
- 054-instructgpt · 平行方法
偏好优化的不同监督
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Training Verifiers to Solve Math Word Problems部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:生成过正确解答之后,系统为什么仍会选错
- 二、分开推导候选覆盖、验证损失与极值误判
- 三、生成候选库并用最终答案构造前缀监督
- 四、用训练轮数、数据量和候选数定位瓶颈
- 五、结果标签仍可能奖励错误过程和格式捷径
- 六、从学习裁判到投票与推理预算分配
- 自测与参考答案
段落怎样重新安排
- 研究背景与任务定义 → 生成过正确解答之后,系统为什么仍会选错
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 结果标签仍可能奖励错误过程和格式捷径
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 结果标签仍可能奖励错误过程和格式捷径
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从学习裁判到投票与推理预算分配
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:生成覆盖率与验证质量分别优化 → 分开推导候选覆盖、验证损失与极值误判
保留原推导
- 方法:生成覆盖率与验证质量分别优化 → 分开推导候选覆盖、验证损失与极值误判
保留原推导
- 方法:生成覆盖率与验证质量分别优化 → 分开推导候选覆盖、验证损失与极值误判
保留原推导
- 方法:生成覆盖率与验证质量分别优化 → 分开推导候选覆盖、验证损失与极值误判
保留原推导
- 实验如何验证 → 用训练轮数、数据量和候选数定位瓶颈
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 用小例子建立理解 → 分开推导候选覆盖、验证损失与极值误判
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用小例子建立理解 → 分开推导候选覆盖、验证损失与极值误判
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用小例子建立理解 → 结果标签仍可能奖励错误过程和格式捷径
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用小例子建立理解 → 结果标签仍可能奖励错误过程和格式捷径
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组证据及其边界 → 用训练轮数、数据量和候选数定位瓶颈
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其边界 → 用训练轮数、数据量和候选数定位瓶颈
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其边界 → 用训练轮数、数据量和候选数定位瓶颈
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其边界 → 用训练轮数、数据量和候选数定位瓶颈
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其边界 → 用训练轮数、数据量和候选数定位瓶颈
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其边界 → 用训练轮数、数据量和候选数定位瓶颈
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据及其边界 → 用训练轮数、数据量和候选数定位瓶颈
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与未解决的问题 → 结果标签仍可能奖励错误过程和格式捷径
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与未解决的问题 → 结果标签仍可能奖励错误过程和格式捷径
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与未解决的问题 → 结果标签仍可能奖励错误过程和格式捷径
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 机制中嵌套的伪代码 → ## 三、生成候选库并用最终答案构造前缀监督
修正嵌套小节造成的执行顺序,确保实现节有实质内容
- 已核原论文机制与适用的专业教法 → 将验证系统的准确率拆成两项条件概率
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、从学习裁判到投票与推理预算分配
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 将验证系统的准确率拆成两项条件概率:将验证系统的准确率拆成两项条件概率
原论文校准与展开范围
原论文校准:GSM8K生成覆盖与验证选择协议;概率分解为事件包含关系,不假设两事件独立。
本篇校准范围:GSM8K生成覆盖与验证选择协议;概率分解为事件包含关系,不假设两事件独立。 新增段落仅用于“将验证系统的准确率拆成两项条件概率”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将 052-gsm8k-f5.png 完整移到对应证据解释之后,图像、归属与链接不变。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:6 幅
- GSM8K训练集规模变化时微调和验证器系统的测试正确率
实验/结果图 · 必要原图摘引 · 图5,HTML #S4.F5
证据三:图5的数据规模曲线。 数据充分时,验证方案优于微调基线;在较小数据规模时不一定获益。6B验证系统略优于175B单次微调,是摘要中约30倍模型规模比较的依据。175/6约为29.2,这是参数量比,绝不是速度或总算力节省29.2倍:前者需要大量候选和验证计算。
- GSM8K验证器在候选数量增大后出现峰值和退步的曲线
实验/结果图 · 必要原图摘引 · 图7,HTML #S4.F7
证据五:图7的更多采样并不单调更好。 6B实验把候选数从25增加到3200,验证表现先改善,在约400后下降。搜索更大候选池也增加遇到验证器高分错误的机会。这个结果支持对选择偏差的警惕,但并不是所有验证器都在400处达到最优的普适定律。
- GSM8K微调数据规模、dropout和训练轮次的三组消融
实验/结果图 · 必要原图摘引 · 图8,PDF第11页
训练轮数不同是系统设计的一部分,因此验证方案并不是与单生成器具有严格相同总计算量的比较。它使用额外训练生成数据以及测试候选。[图8](https://arxiv.org/html/2110.14168#S5.F8)的部分正则化配置还增加预训练阶段的dropout,比较时须保留这些条件。
- GSM8K训练轮次对pass@1与pass@100的不同影响
实验/结果图 · 必要原图摘引 · 图3,PDF第6页
**证据二:[图3](https://arxiv.org/html/2110.14168#S4.F3)的单次质量与候选覆盖。** 横轴是训练轮数。训练更久能继续提高单次输出表现,但100次采样覆盖率会在一定阶段下降。这解释作者为何选择较早的生成检查点:排序系统的上限首先取决于候选里有没有正确解答。图中趋势不意味着所有任务都应该固定训练两轮。 [图5](https://arxiv.org/html/2110.14168#S4.F5)的误差范围通常来自三次运行,但175B验证器只有一次;[图13](https://arxiv.org/html/2110.14168#A6.F13)又是作者挑选的示例,不能把局部着色当成过程标注的总体准确率。
- GSM8K四个推导示例的验证器预测与真实正确性对照
实验/结果图 · 必要原图摘引 · 图13,PDF第21页
**证据二:[图3](https://arxiv.org/html/2110.14168#S4.F3)的单次质量与候选覆盖。** 横轴是训练轮数。训练更久能继续提高单次输出表现,但100次采样覆盖率会在一定阶段下降。这解释作者为何选择较早的生成检查点:排序系统的上限首先取决于候选里有没有正确解答。图中趋势不意味着所有任务都应该固定训练两轮。 [图5](https://arxiv.org/html/2110.14168#S4.F5)的误差范围通常来自三次运行,但175B验证器只有一次;[图13](https://arxiv.org/html/2110.14168#A6.F13)又是作者挑选的示例,不能把局部着色当成过程标注的总体准确率。
- GSM8K验证器标注粒度、联合目标和训练集规模的三组对照
实验/结果图 · 必要原图摘引 · 图6,PDF第9页
**证据四:[图6](https://arxiv.org/html/2110.14168#S4.F6)的组件消融。** 更密集的前缀监督与语言建模辅助目标缓解验证器过拟合。混合不同尺寸生成器和验证器的实验还显示,大生成器配小验证器可以优于相反配置,强调候选覆盖的重要性。它没有证明验证器总能无限缩小,也没有控制所有可能的推理时延组合。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图5、图8、图3、图6、图7、图13
- 问答核查:每个token都有验证损失,为什么还不能称为逐步正确性监督等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 表1 · 表1;HTML元素 #A2.T1
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5
原站图表/证明入口
- 图8 · 图8;HTML元素 #S5.F8
原站图表/证明入口
- 图3 · 图3;HTML元素 #S4.F3
原站图表/证明入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 图7 · 图7;HTML元素 #S4.F7
原站图表/证明入口
- 图13 · 图13;HTML元素 #A6.F13
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 极值选择下误判累积推导
- 候选池大小数值例
- 提出oracle覆盖与实际选择分开诊断
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图5、图8、图3、图6、图7、图13
- v2:问答核查:每个token都有验证损失,为什么还不能称为逐步正确性监督等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:将 052-gsm8k-f5.png 完整移到对应证据解释之后,图像、归属与链接不变。
查核资料
- arxiv.org · 所列章节
§4.2结果标签、100候选与生成器/验证器分训
- arxiv.org · 所列章节
证据三:图5的数据规模曲线。 数据充分时,验证方案优于微调基线;在较小数据规模时不一定获益。6B验证系统略优于175B单次微调,是摘要中约30倍模型规模比较的依据。175/6约为29.2,这是参数量比,绝不是速度或总算力节省29.2倍:前者需要大量候选和验证计算。
- arxiv.org · 所列章节
证据五:图7的更多采样并不单调更好。 6B实验把候选数从25增加到3200,验证表现先改善,在约400后下降。搜索更大候选池也增加遇到验证器高分错误的机会。这个结果支持对选择偏差的警惕,但并不是所有验证器都在400处达到最优的普适定律。
技术关系
- 048-codex · 教学联系
候选覆盖指标
- 056-self-consistency · 平行方法
不训练裁判的投票
- 091-test-time-scaling · 历史背景
预算分配问题延伸
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Chain-of-Thought Prompting Elicits Reasoning in Large Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不改权重,过程示例怎样改变一次解答的生成条件
- 二、把推导作为中间变量并区分联合搜索与答案边缘化
- 三、固定模型与示例,比较生成顺序和长度控制
- 四、同时读规模收益、失败任务和过程消融
- 五、可读推导仍不保证内部忠实或逐步正确
- 六、把单条推导继续接到聚合或自训练
- 自测与参考答案
段落怎样重新安排
- 问题定义:这是提示方法,不是新的训练算法 → 不改权重,过程示例怎样改变一次解答的生成条件
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 可读推导仍不保证内部忠实或逐步正确
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把单条推导继续接到聚合或自训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法与公式:给自回归分解增加中间变量 → 把推导作为中间变量并区分联合搜索与答案边缘化
先给出信息路径、目标与机制,再讨论执行顺序
- 方法与公式:给自回归分解增加中间变量 → 把推导作为中间变量并区分联合搜索与答案边缘化
将原来的后置推导提前,解释伪代码为何这样计算
- 方法与公式:给自回归分解增加中间变量 → 固定模型与示例,比较生成顺序和长度控制
单列可执行步骤,与机制论证及经验结果区分
- 方法与公式:给自回归分解增加中间变量 → 固定模型与示例,比较生成顺序和长度控制
保留实现限制、训练协议及指标接口
- 实验设计与公平性 → 同时读规模收益、失败任务和过程消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个可手算的例子 → 把推导作为中间变量并区分联合搜索与答案边缘化
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个可手算的例子 → 可读推导仍不保证内部忠实或逐步正确
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个可手算的例子 → 可读推导仍不保证内部忠实或逐步正确
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组关键证据 → 同时读规模收益、失败任务和过程消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 同时读规模收益、失败任务和过程消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 同时读规模收益、失败任务和过程消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 同时读规模收益、失败任务和过程消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 同时读规模收益、失败任务和过程消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 同时读规模收益、失败任务和过程消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 同时读规模收益、失败任务和过程消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 真正贡献与局限 → 可读推导仍不保证内部忠实或逐步正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 真正贡献与局限 → 可读推导仍不保证内部忠实或逐步正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 真正贡献与局限 → 可读推导仍不保证内部忠实或逐步正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 真正贡献与局限 → 可读推导仍不保证内部忠实或逐步正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用三个推导显示联合最大与答案最大不同
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把单条推导继续接到聚合或自训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用三个推导显示联合最大与答案最大不同:用三个推导显示联合最大与答案最大不同
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:CoT中间变量分解与Self-Consistency教学联系;概率自构,不宣称原CoT计算过完整边缘分布。
本篇校准范围:CoT中间变量分解与Self-Consistency教学联系;概率自构,不宣称原CoT计算过完整边缘分布。 新增段落仅用于“用三个推导显示联合最大与答案最大不同”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- 思维链、仅方程、增加计算长度及先回答后解释的GSM8K消融
实验/结果图 · 必要原图摘引 · 图5,PDF第6页
证据三:图5与附录表6区分内容和长度。 LaMDA 137B在GSM8K的标准提示为6.5±0.4,思维链14.3±0.4;仅方程5.4±0.2、用点号增加计算长度6.4±0.3、先答后解释6.1±0.4。它支持先形成有意义中间步骤的作用,不能证明所有长度匹配方式均无效。点号对照只是某种额外计算载体,并非对任意潜在计算机制的穷尽检验。 提示消融和更换示例的曲线应分开比较:前者改变中间文本形式,后者检验示例选择波动;两者都不是对推理文字忠实性的逐步证明。
- 思维链提示对标注员、书写风格与示例选择的稳健性对照
实验/结果图 · 必要原图摘引 · 图6,PDF第6页
**证据四:[图6](https://arxiv.org/html/2201.11903#S3.F6)与[表6](https://arxiv.org/html/2201.11903#A2.T6)的提示风格。** GSM8K不同作者推导得到15.5和17.6,刻意简短版本11.1,都高于6.5基线,但差异仍明显。收益不依赖唯一措辞,不代表措辞不重要。附录A还讨论某些符号任务对示例组织更敏感,这限制了“写一句提示即可稳定复现”的说法。
- 思维链在字符串拼接和抛硬币任务的域内及域外表现
实验/结果图 · 必要原图摘引 · 图8,PDF第8页
**证据五:[图8](https://arxiv.org/html/2201.11903#S4.F8)的长度泛化与§3.2错误抽查。** 符号任务在比示例更长的输入上获得改善,但低于域内水平。另对LaMDA答对的50份随机解答检查发现两份过程有问题却碰巧答对;对50份答错解答,46%接近正确、54%有较大语义或连贯错误。这是小样本诊断,不能推成全部任务的精确错误分布,更不能证明正确答案必有正确过程。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表2、图5、表6、图6、图8
- 问答核查:为什么思维链提示不等于在新任务上训练模型等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 表1 · 表1;HTML元素 #A2.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #A2.T2
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 表6 · 表6;HTML元素 #A2.T6
原站图表/证明入口
- 图6 · 图6;HTML元素 #S3.F6
原站图表/证明入口
- 图8 · 图8;HTML元素 #S4.F8
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 比较联合最大化和答案边缘概率
- 0.4/0.3/0.3轨迹反例
- 连接单轨迹、聚合及自训练
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表2、图5、表6、图6、图8
- v2:问答核查:为什么思维链提示不等于在新任务上训练模型等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2过程示例与固定参数提示机制
技术关系
- 035-gpt3 · 直接继承
扩展few-shot提示内容
- 056-self-consistency · 直接继承
后作对过程多路径聚合
- 055-star · 平行方法
过程生成转为参数学习
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Training language models to follow instructions with human feedback部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:续写能力怎样转成特定用户群体偏好的回答
- 二、拆开示范、成对奖励与受约束策略目标
- 三、追踪策略、参考、奖励和价值四个模型的更新
- 四、把偏好胜率、事实错误与能力退化分轴读图
- 五、代理奖励、群体选择和私有数据限制复现
- 六、沿偏好目标寻找不需在线PPO的训练路径
- 自测与参考答案
段落怎样重新安排
- 研究背景:到底向谁对齐 → 续写能力怎样转成特定用户群体偏好的回答
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 代理奖励、群体选择和私有数据限制复现
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 代理奖励、群体选择和私有数据限制复现
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 沿偏好目标寻找不需在线PPO的训练路径
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:三个阶段与四个模型角色 → 拆开示范、成对奖励与受约束策略目标
保留原推导
- 方法:三个阶段与四个模型角色 → 拆开示范、成对奖励与受约束策略目标
保留原推导
- 方法:三个阶段与四个模型角色 → 拆开示范、成对奖励与受约束策略目标
保留原推导
- 数据、预算与实验目的 → 把偏好胜率、事实错误与能力退化分轴读图
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 用例子理解三个阶段 → 拆开示范、成对奖励与受约束策略目标
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用例子理解三个阶段 → 代理奖励、群体选择和私有数据限制复现
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用例子理解三个阶段 → 代理奖励、群体选择和私有数据限制复现
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据:偏好提升不等于所有能力提升 → 把偏好胜率、事实错误与能力退化分轴读图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 代理奖励、群体选择和私有数据限制复现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 代理奖励、群体选择和私有数据限制复现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 代理奖励、群体选择和私有数据限制复现
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 机制中嵌套的伪代码 → ## 三、追踪策略、参考、奖励和价值四个模型的更新
修正嵌套小节造成的执行顺序,确保实现节有实质内容
- 已核原论文机制与适用的专业教法 → 一条负KL采样项怎样仍组成正散度
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿偏好目标寻找不需在线PPO的训练路径
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 一条负KL采样项怎样仍组成正散度:一条负KL采样项怎样仍组成正散度
教法来源与实际阅读范围
- Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla · Illustrating Reinforcement Learning from Human Feedback
三阶段训练、偏好排名、奖励模型、RL/KL及同一响应送入冻结参考的图示澄清
原论文校准:InstructGPT相对SFT的KL采样项;HF RLHF文末图示澄清同一响应送入冻结参考,数值是自构。
本篇校准范围:InstructGPT相对SFT的KL采样项;HF RLHF文末图示澄清同一响应送入冻结参考,数值是自构。 新增段落仅用于“一条负KL采样项怎样仍组成正散度”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:4 幅
- InstructGPT不同规模模型相对175B SFT的人工偏好胜率
实验/结果图 · 必要原图摘引 · 图1,HTML #S0.F1
证据一:图1与§4.1的直接偏好。 175B InstructGPT相对175B GPT-3获偏好85±3%,相对经过少样本提示的GPT-3为71±4%。这些是同一提示上成对评价的胜率,不是回答正确率。图1常用175B SFT作为统一对手,不能把图上纵轴与85%的直接比较混用。 偏好曲线的参照是175B SFT,误差条为95%置信区间。纵轴是相对该参照的偏好胜率,不能读成事实正确率。
- InstructGPT遵循指令、约束、避免幻觉和语言适切性的人工评价
实验/结果图 · 必要原图摘引 · 图4,HTML #S4.F4
证据二:图4的行为指标。 封闭领域任务中,编造输入未给信息的比例约从41%降到21%,降低20个百分点,按原值计算相对下降约49%。图4汇总不同模型规模,且“幻觉”限定于摘要、闭域问答等场景,不能宣称所有开放知识问答幻觉减半。
- InstructGPT在两种提示分布和两组标注员下相对SFT的偏好胜率
实验/结果图 · 必要原图摘引 · 图3,PDF第11页
**证据三:[图3](https://arxiv.org/html/2203.02155#S3.F3)及§4.1的评价者迁移。** 留出评价者仍偏好InstructGPT;五折评价者划分中的奖励模型,在留出组预测准确率69.6±0.9%,训练来源组为72.4±0.4%。这支持有限群体迁移,同时说明偏好预测远非完美。它不能排除更大文化、语言或专业群体上的分歧。
- GPT、SFT、PPO、FLAN和T0回答的人工Likert评分
实验/结果图 · 必要原图摘引 · 图5,PDF第12页
**证据四:[图5](https://arxiv.org/html/2203.02155#S4.F5)与附录C.5的数据分布对照。** 直接比较时InstructGPT对作者训练的FLAN数据模型胜率78±4%,对T0数据模型79±4%。这些对照是用相关数据微调175B GPT-3的版本,并非原论文所有模型和训练预算。结果支持API任务分布适配的重要性,不能概括为偏好学习普遍优于多任务训练。
未在正文展示的图/表与范围
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表6、图1、图4、图3、图5
- 问答核查:奖励模型和价值模型有什么区别等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表6 · 表6;HTML元素 #A1.T6
原站图表/证明入口
- 图1 · 图1;HTML元素 #S0.F1
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F4
原站图表/证明入口
- 图3 · 图3;HTML元素 #S3.F3
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导样本log比与期望KL区别
- 负单样本KL数值例
- 区分reference与PPO old policy
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表6、图1、图4、图3、图5
- v2:问答核查:奖励模型和价值模型有什么区别等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.5/式2 PPO奖励、reference KL与预训练混合
技术关系
- 050-flan · 历史背景
指令监督背景
- 075-dpo · 平行方法
后续偏好优化路径
- 27-ppo · 模块组合
PPO作为语言模型RLHF中的策略优化模块,reference与old policy不同
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型STaR: Self-Taught Reasoner — Bootstrapping Reasoning With Reasoning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只有答案监督,怎样让训练覆盖原本答不对的题
- 二、分开成功筛选与答案辅助生成的采样分布
- 三、用外循环生成数据、内循环从原模型重训
- 四、检验覆盖比例、任务差异与循环中的负结果
- 五、答案通过不保证推导正确或忠实
- 六、区分自训练数据筛选与结果奖励优化
- 自测与参考答案
段落怎样重新安排
- 研究背景:只学习已会题目会陷入停滞 → 只有答案监督,怎样让训练覆盖原本答不对的题
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 答案通过不保证推导正确或忠实
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 区分自训练数据筛选与结果奖励优化
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:外循环生成,内循环监督学习 → 分开成功筛选与答案辅助生成的采样分布
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:外循环生成,内循环监督学习 → 用外循环生成数据、内循环从原模型重训
单列可执行步骤,与机制论证及经验结果区分
- 与强化学习的联系及区别 → 分开成功筛选与答案辅助生成的采样分布
保留完整公式和事实约束
- 与强化学习的联系及区别 → 分开成功筛选与答案辅助生成的采样分布
保留原推导
- 实验设计 → 检验覆盖比例、任务差异与循环中的负结果
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 用例子理解答案辅助 → 分开成功筛选与答案辅助生成的采样分布
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用例子理解答案辅助 → 答案通过不保证推导正确或忠实
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用例子理解答案辅助 → 答案通过不保证推导正确或忠实
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组证据与能够支持的结论 → 检验覆盖比例、任务差异与循环中的负结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与能够支持的结论 → 检验覆盖比例、任务差异与循环中的负结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与能够支持的结论 → 检验覆盖比例、任务差异与循环中的负结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与能够支持的结论 → 检验覆盖比例、任务差异与循环中的负结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与能够支持的结论 → 检验覆盖比例、任务差异与循环中的负结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与能够支持的结论 → 检验覆盖比例、任务差异与循环中的负结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与能够支持的结论 → 检验覆盖比例、任务差异与循环中的负结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与失败方式 → 答案通过不保证推导正确或忠实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与失败方式 → 答案通过不保证推导正确或忠实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与失败方式 → 答案通过不保证推导正确或忠实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与失败方式 → 答案通过不保证推导正确或忠实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 成功筛选如何改变题目曝光频率
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、区分自训练数据筛选与结果奖励优化
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 成功筛选如何改变题目曝光频率:成功筛选如何改变题目曝光频率
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:STaR成功筛选与rationalization;期望计数在固定通过率下成立,不给真实任务贴难度数值。
本篇校准范围:STaR成功筛选与rationalization;期望计数在固定通过率下成立,不给真实任务贴难度数值。 新增段落仅用于“成功筛选如何改变题目曝光频率”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- STaR不同位数加法任务的准确率随训练迭代变化
实验/结果图 · 必要原图摘引 · 图4,HTML #S4.F4
证据四:图4/图5的加法学习。 16轮后的总体准确率为89.5%,直接答案基线为76.3%;加入rationalization后两位数加法首轮可由不到1%提升至32%。扩展位数后能解决部分未见9、10位数问题,同时训练更不稳定。数据与训练安排不完全相同,不能将全部差异归于一个模块的纯因果效应。 每条线对应一种位数的加法,横轴是 STaR 迭代;引入更多位数后任务分布已改变,不能把整个轨迹理解为固定题集上的同一种增益。
- STaR不同位数加法任务准确率随自举迭代次数变化
实验/结果图 · 必要原图摘引 · 图5,PDF第6页
**证据四:[图4](https://arxiv.org/html/2203.14465v2#S4.F4)/[图5](https://arxiv.org/html/2203.14465v2#S4.F5)的加法学习。** 16轮后的总体准确率为89.5%,直接答案基线为76.3%;加入rationalization后两位数加法首轮可由不到1%提升至32%。扩展位数后能解决部分未见9、10位数问题,同时训练更不稳定。数据与训练安排不完全相同,不能将全部差异归于一个模块的纯因果效应。 每条线对应一种位数的加法,横轴是 STaR 迭代;引入更多位数后任务分布已改变,不能把整个轨迹理解为固定题集上的同一种增益。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表2、图4、图5
- 问答核查:STaR为何不是完全无监督自我改进等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F4
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导正确筛选的题目曝光偏差
- 两组难度90对10的课程效应例
- 限定答案辅助的监督质量
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表2、图4、图5
- v2:问答核查:STaR为何不是完全无监督自我改进等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3正确筛选、答案辅助、算法1从基座重训
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Self-Consistency Improves Chain of Thought Reasoning in Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:概率分散在不同推导时,怎样按最终答案汇总
- 二、由答案边缘化推导投票及其相关性条件
- 三、采样、解析和归并后再选择答案
- 四、比较采样数、加权方式与没有收益的任务
- 五、一致错误与答案归并失误仍会放大偏差
- 六、从固定票数接到何时停止与怎样换策略
- 自测与参考答案
段落怎样重新安排
- 从生成最像的序列到聚合答案 → 概率分散在不同推导时,怎样按最终答案汇总
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 一致错误与答案归并失误仍会放大偏差
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从固定票数接到何时停止与怎样换策略
真实关系移到后继路线,避免目录相邻等于技术继承
- 算法:多样性与答案归并同样重要 → 由答案边缘化推导投票及其相关性条件
将原来的后置推导提前,解释伪代码为何这样计算
- 算法:多样性与答案归并同样重要 → 采样、解析和归并后再选择答案
单列可执行步骤,与机制论证及经验结果区分
- 算法:多样性与答案归并同样重要 → 采样、解析和归并后再选择答案
保留实现限制、训练协议及指标接口
- 实验设置与预算 → 比较采样数、加权方式与没有收益的任务
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构例子 → 由答案边缘化推导投票及其相关性条件
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子 → 由答案边缘化推导投票及其相关性条件
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子 → 一致错误与答案归并失误仍会放大偏差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子 → 一致错误与答案归并失误仍会放大偏差
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组证据与结论边界 → 比较采样数、加权方式与没有收益的任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与结论边界 → 比较采样数、加权方式与没有收益的任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与结论边界 → 比较采样数、加权方式与没有收益的任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与结论边界 → 比较采样数、加权方式与没有收益的任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与结论边界 → 比较采样数、加权方式与没有收益的任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与结论边界 → 比较采样数、加权方式与没有收益的任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么可能有效,为什么可能失败 → 一致错误与答案归并失误仍会放大偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么可能有效,为什么可能失败 → 一致错误与答案归并失误仍会放大偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么可能有效,为什么可能失败 → 一致错误与答案归并失误仍会放大偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 为什么可能有效,为什么可能失败 → 一致错误与答案归并失误仍会放大偏差
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 答案归并也需要预先固定等价关系
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、从固定票数接到何时停止与怎样换策略
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 答案归并也需要预先固定等价关系:答案归并也需要预先固定等价关系
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:Self-Consistency最终答案提取与归并;自构表达例仅展示接口,未声称可对开放答案统一数值化。
本篇校准范围:Self-Consistency最终答案提取与归并;自构表达例仅展示接口,未声称可对开放答案统一数值化。 新增段落仅用于“答案归并也需要预先固定等价关系”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 自一致性投票、采样后排序和贪心解码随推理路径数的表现
实验/结果图 · 必要原图摘引 · 图3,HTML #S3.F3
证据四:图3与表6的搜索比较。 图3在相同采样数下优于按生成概率排序。表6中UL2的AQuA在40条随机路径计票下为26.9±0.5,而取束搜索最高序列为10.2,束内计票24.2±0.5。它支持候选多样性的价值;相同候选条数并未严格控制总token、共享前缀和硬件效率。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表13:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表2、表1、表5、图3、表6、表3、表9、表13
- 问答核查:最高概率推导与最高概率答案为何可能不同等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表5 · 表5;HTML元素 #S3.T5
原站图表/证明入口
- 图3 · 图3;HTML元素 #S3.F3
原站图表/证明入口
- 表6 · 表6;HTML元素 #S3.T6
原站图表/证明入口
- 表3 · 表3;HTML元素 #S3.T3
原站图表/证明入口
- 表9 · 表9;HTML元素 #A1.T9
原站图表/证明入口
- 表13 · 表13;HTML元素 #A1.T13
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 三票多数成功率推导
- 正确率不足一半与多答案众数对照
- 强调相关性和答案归并
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表2、表1、表5、图3、表6、表3、表9、表13
- v2:问答核查:最高概率推导与最高概率答案为何可能不同等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2路径边缘化、采样与答案解析
技术关系
- 053-cot · 直接继承
后续多路径CoT聚合
- 052-gsm8k · 平行方法
独立训练验证器路线
- 055-star · 平行方法
训练更新与测试聚合不同
- 099-autotts · 历史背景
后续自适应计算控制
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Training Compute-Optimal Large Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:固定训练算力应怎样分给参数与数据
- 二、由经验损失的边际平衡推导最优配比
- 三、为每个训练长度匹配调度并扫描预算
- 四、用三种拟合与大模型对照检验配比外推
- 五、训练最优比例不直接决定长期服务成本
- 六、把训练预算继续接到部署预算
- 自测与参考答案
段落怎样重新安排
- 问题定义:优化的是训练预算下的损失 → 固定训练算力应怎样分给参数与数据
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解 → 训练最优比例不直接决定长期服务成本
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把训练预算继续接到部署预算
真实关系移到后继路线,避免目录相邻等于技术继承
- 问题定义:优化的是训练预算下的损失 → 由经验损失的边际平衡推导最优配比
保留完整公式和事实约束
- 方法:三种途径寻找计算最优边界 → 由经验损失的边际平衡推导最优配比
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:三种途径寻找计算最优边界 → 由经验损失的边际平衡推导最优配比
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:三种途径寻找计算最优边界 → 为每个训练长度匹配调度并扫描预算
单列可执行步骤,与机制论证及经验结果区分
- 方法:三种途径寻找计算最优边界 → 为每个训练长度匹配调度并扫描预算
保留实现限制、训练协议及指标接口
- 实验设置与大模型验证 → 用三种拟合与大模型对照检验配比外推
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构资源分配例子 → 由经验损失的边际平衡推导最优配比
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构资源分配例子 → 训练最优比例不直接决定长期服务成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构资源分配例子 → 训练最优比例不直接决定长期服务成本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组关键证据 → 用三种拟合与大模型对照检验配比外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 用三种拟合与大模型对照检验配比外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 用三种拟合与大模型对照检验配比外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 用三种拟合与大模型对照检验配比外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 用三种拟合与大模型对照检验配比外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 用三种拟合与大模型对照检验配比外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- “每参数20个token”应怎样理解 → 训练最优比例不直接决定长期服务成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- “每参数20个token”应怎样理解 → 训练最优比例不直接决定长期服务成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- “每参数20个token”应怎样理解 → 训练最优比例不直接决定长期服务成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- “每参数20个token”应怎样理解 → 训练最优比例不直接决定长期服务成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与复现边界 → 训练最优比例不直接决定长期服务成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与复现边界 → 训练最优比例不直接决定长期服务成本
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 从平方根配比反推新增算力怎么花
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把训练预算继续接到部署预算
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 从平方根配比反推新增算力怎么花:从平方根配比反推新增算力怎么花
原论文校准与展开范围
原论文校准:Chinchilla原文三种配比拟合及C≈6ND;采用近似对称指数做教学倍率。
本篇校准范围:Chinchilla原文三种配比拟合及C≈6ND;采用近似对称指数做教学倍率。 新增段落仅用于“从平方根配比反推新增算力怎么花”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:5 幅
- Chinchilla等计算预算损失曲线及计算最优模型和数据规模拟合
实验/结果图 · 必要原图摘引 · 图3,HTML #S3.F3
证据一:图3与表2的分配规律。 曲线包络得到$N,D$指数约0.50/0.50,IsoFLOP方法0.49/0.51,参数化方法0.46/0.54,区别于表中列出的旧研究0.73/0.27。三种方法共同支持参数与数据大致同步增长,不能把0.5当作跨数据、架构和优化器不变的自然常数。 IsoFLOP 图左侧每条曲线固定最终训练 FLOPs,低谷给出该预算内较合适的模型规模;中、右图再利用这些低谷做外推。
- Chinchilla相对Gopher在MMLU各学科的改善与退步
实验/结果图 · 必要原图摘引 · 图6,PDF第12页
**证据三:[表6](https://arxiv.org/html/2203.15556#S4.T6)与[图6](https://arxiv.org/html/2203.15556#S4.F6)的MMLU。** 五样本平均分Gopher60.0%,Chinchilla67.6%,提升7.6个百分点,相对提升约12.7%。四个任务退化,包括大学数学、计量经济学、道德情景和形式逻辑,还有两个任务持平。平均提升不能解释成每种能力都提高。
- Chinchilla相对Gopher在各Pile子集的每字节损失下降
实验/结果图 · 必要原图摘引 · 图5,PDF第10页
**证据四:[图5](https://arxiv.org/html/2203.15556#S4.F5)与§4.2.1的语言建模。** Chinchilla在所测Pile子集上优于Gopher,WikiText103困惑度从7.75降到7.16。作者同时提醒,训练数据更多可能增加训练测试重叠,因而不只依赖语言建模评估支持结论。困惑度下降也不是对应百分比的事实准确率提升。
- Chinchilla相对Gopher在BIG-bench各任务的变化及误差条
实验/结果图 · 必要原图摘引 · 图7,PDF第13页
**证据五:[表8](https://arxiv.org/html/2203.15556#S4.T8)与[图7](https://arxiv.org/html/2203.15556#S4.F7)的广泛但非全面收益。** HellaSwag为80.8%对79.2%,Winogrande74.9%对70.1%,BoolQ83.7%对79.3%,PIQA二者同为81.8%。BIG-bench多数任务改善、四项例外。证据说明收益跨任务存在,同时保留了持平和退化的边界。
- Chinchilla六种余弦衰减周期在两种训练长度下的学习率、训练损失及C4损失
实验/结果图 · 必要原图摘引 · 图A1,PDF第23页
**证据二:附录[图A1](https://arxiv.org/html/2203.15556#A2.F1)的学习率调度。** 衰减周期设得明显长于实际训练,最终损失会变差;超过目标训练长度25%的估计偏差开始出现清晰影响。它说明训练长度实验必须配套优化调度,否则可能把尚未衰减的模型误判为该预算下的最优模型。这里的25%是该消融现象,不是通用工程容差。
未在正文展示的图/表与范围
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表4、表2、图3、图A1、表6、图6、图5、表8、图7、表3
- 问答核查:模型更有样本效率,为什么不一定更有计算效率等3题均有独立对应答案;保留已有有效解释
查看本篇 10 个原文证据入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
- 图3 · 图3;HTML元素 #S3.F3
原站图表/证明入口
- 图A1 · 图A1;HTML元素 #A2.F1
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5
原站图表/证明入口
- 表8 · 表8;HTML元素 #S4.T8
原站图表/证明入口
- 图7 · 图7;HTML元素 #S4.F7
原站图表/证明入口
- 表3 · 表3;HTML元素 #S3.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补全代入约束到一阶条件的推导
- 非对称4/N+1/D资源算例
- 分开训练与生命周期最优
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表4、表2、图3、图A1、表6、图6、图5、表8、图7、表3
- v2:问答核查:模型更有样本效率,为什么不一定更有计算效率等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3固定预算与三种估计法、表2—3最优配比
技术关系
- 029-scaling-laws · 直接继承
本篇重新估计计算最优前沿
- 068-llama · 历史背景
部署效率改变训练选择
- 091-test-time-scaling · 教学联系
不同阶段的预算优化
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Flamingo: a Visual Language Model for Few-Shot Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:冻结视觉与语言两端,怎样接收交错多图并生成回答
- 二、压缩视觉槽位并用零初始化门控接入语言层
- 三、训练连接模块与交错序列,固定最近图片掩码
- 四、分开少样本、任务微调和连接频率的代价
- 五、视觉条件仍不能保证事实可靠或动作控制
- 六、对照冻结两端的另一种视觉桥接方式
- 自测与参考答案
段落怎样重新安排
- 场景与问题定义 → 冻结视觉与语言两端,怎样接收交错多图并生成回答
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 视觉条件仍不能保证事实可靠或动作控制
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 对照冻结两端的另一种视觉桥接方式
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:固定视觉槽位与门控连接 → 压缩视觉槽位并用零初始化门控接入语言层
保留原推导
- 方法:固定视觉槽位与门控连接 → 压缩视觉槽位并用零初始化门控接入语言层
保留原推导
- 方法:固定视觉槽位与门控连接 → 压缩视觉槽位并用零初始化门控接入语言层
保留原推导
- 方法:固定视觉槽位与门控连接 → 压缩视觉槽位并用零初始化门控接入语言层
保留原推导
- 数据与实验预算 → 分开少样本、任务微调和连接频率的代价
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个多模态少样本例子 → 压缩视觉槽位并用零初始化门控接入语言层
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个多模态少样本例子 → 压缩视觉槽位并用零初始化门控接入语言层
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个多模态少样本例子 → 视觉条件仍不能保证事实可靠或动作控制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组证据与可支持结论 → 分开少样本、任务微调和连接频率的代价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与可支持结论 → 分开少样本、任务微调和连接频率的代价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与可支持结论 → 分开少样本、任务微调和连接频率的代价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与可支持结论 → 分开少样本、任务微调和连接频率的代价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与可支持结论 → 分开少样本、任务微调和连接频率的代价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与可支持结论 → 分开少样本、任务微调和连接频率的代价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组证据与可支持结论 → 分开少样本、任务微调和连接频率的代价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 视觉条件仍不能保证事实可靠或动作控制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 视觉条件仍不能保证事实可靠或动作控制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限 → 视觉条件仍不能保证事实可靠或动作控制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 机制中嵌套的伪代码 → ## 三、训练连接模块与交错序列,固定最近图片掩码
修正嵌套小节造成的执行顺序,确保实现节有实质内容
- 已核原论文机制与适用的专业教法 → 零门首步还要看上游梯度与视觉方向
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、对照冻结两端的另一种视觉桥接方式
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 零门首步还要看上游梯度与视觉方向:零门首步还要看上游梯度与视觉方向
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
原论文校准:Flamingo tanh门控在α=0的导数与链式法则;向量为自构,不新增优化保证。
本篇校准范围:Flamingo tanh门控在α=0的导数与链式法则;向量为自构,不新增优化保证。 新增段落仅用于“零门首步还要看上游梯度与视觉方向”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Flamingo数据、门控、跨注意力、视觉编码器及冻结策略消融
实验/结果图 · 必要原图摘引 · 表3,PDF第8页
证据二:表3的数据消融。 缩短训练的3B配置总体归一化分数70.7,去掉M3W降至53.4,去掉图文对为60.9;去掉视频文本后MSVDQA36.3降至34.5、VATEX53.4降至46.0。不同格式互补得到支持,但删数据也改变计算量,不能把差距全解释成唯一的数据结构因果效应。
- Flamingo跨视觉语言任务的相对表现及少样本数量曲线
实验/结果图 · 必要原图摘引 · 图2,PDF第3页
原文存在一处统计表述差异:主文与[图2](https://arxiv.org/html/2204.14198v2#S0.F2)说六个任务超过微调最佳,[表1](https://arxiv.org/html/2204.14198v2#S3.T1)图注写七个。本文不凭猜测统一计数,采用具体任务与行列数值作为证据;这也是阅读时保留版本和评价口径的原因。 左图比较任务结果,右图考察模型大小与上下文示例数;32-shot 描述使用时的示范量,不包含通用图文预训练。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表3、表2、图2
- 问答核查:两个主干冻结,为什么仍需要大量训练等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S3.T3
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
- 图2 · 图2;HTML元素 #S0.F2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导零门的首步梯度
- 数值展示门先打开再训练接口
- 区分多模态匹配与生成桥接
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表3、表2、图2
- v2:问答核查:两个主干冻结,为什么仍需要大量训练等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.2 gated cross-attention、零α与冻结LM
技术关系
- 057-chinchilla · 模块组合
冻结语言骨干
- 043-clip · 平行方法
匹配与生成目标不同
- 066-blip2 · 平行方法
不同跨模态桥接
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:注意力函数不变,怎样少搬运平方规模的中间矩阵
- 二、推导在线softmax合并与分块反向
- 三、围绕片上容量安排分块、重计算和正确性检查
- 四、按算子、整模型和上下文变化分别核算加速
- 五、IO收益仍受硬件和平方计算限制
- 六、从精确算子转向服务时的KV内存管理
- 自测与参考答案
段落怎样重新安排
- 背景:FLOPs少不等于墙钟快 → 注意力函数不变,怎样少搬运平方规模的中间矩阵
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解 → IO收益仍受硬件和平方计算限制
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从精确算子转向服务时的KV内存管理
真实关系移到后继路线,避免目录相邻等于技术继承
- 背景:FLOPs少不等于墙钟快 → 推导在线softmax合并与分块反向
保留完整公式和事实约束
- 方法:如何不保存整行也计算softmax → 推导在线softmax合并与分块反向
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:如何不保存整行也计算softmax → 围绕片上容量安排分块、重计算和正确性检查
单列可执行步骤,与机制论证及经验结果区分
- 方法:如何不保存整行也计算softmax → 围绕片上容量安排分块、重计算和正确性检查
保留实现限制、训练协议及指标接口
- 理论保证与适用范围 → 推导在线softmax合并与分块反向
保留完整公式和事实约束
- 理论保证与适用范围 → 推导在线softmax合并与分块反向
保留原推导
- 实验如何验证 → 按算子、整模型和上下文变化分别核算加速
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个在线softmax小例子 → 围绕片上容量安排分块、重计算和正确性检查
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个在线softmax小例子 → 推导在线softmax合并与分块反向
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个在线softmax小例子 → 推导在线softmax合并与分块反向
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个在线softmax小例子 → IO收益仍受硬件和平方计算限制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组关键证据 → 按算子、整模型和上下文变化分别核算加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按算子、整模型和上下文变化分别核算加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按算子、整模型和上下文变化分别核算加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按算子、整模型和上下文变化分别核算加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按算子、整模型和上下文变化分别核算加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按算子、整模型和上下文变化分别核算加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与局限 → IO收益仍受硬件和平方计算限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与局限 → IO收益仍受硬件和平方计算限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与局限 → IO收益仍受硬件和平方计算限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 分块合并必须同时校正分子和分母
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、从精确算子转向服务时的KV内存管理
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 分块合并必须同时校正分子和分母:分块合并必须同时校正分子和分母
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:FlashAttention在线softmax合并式;由已保留公式逐项追踪,不声称原实现存在该错误。
本篇校准范围:FlashAttention在线softmax合并式;由已保留公式逐项追踪,不声称原实现存在该错误。 新增段落仅用于“分块合并必须同时校正分子和分母”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- FlashAttention的FLOPs、HBM读写、运行时间及块大小分析
实验/结果图 · 必要原图摘引 · 图2,PDF第6页
证据一:图2直接检验IO假说。 指定GPT-2 medium注意力配置下,FLOPs从66.6增加到75.2 GFLOPs,HBM读写从40.3GB降到4.4GB,时间41.7ms降到7.3ms。按数值计算约5.7倍加速,同时运算量增加。它直接反驳“FLOPs更多一定更慢”,但不是整模型的5.7倍加速。 左面板计前向加反向,中面板只计前向,右面板换成4K序列的块稀疏算子;三幅图不能直接当作同一配置的三次测速。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图2、表1、表2、表4、表5、表6
- 问答核查:为什么多做重计算反而更快等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 图2 · 图2;HTML元素 #S3.F2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S4.T6.fig1
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6.fig2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导注意力分数的逐块反向形式
- 前向后验与梯度双检验算例
- 分开IO优化和服务缓存管理
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图2、表1、表2、表4、表5、表6
- v2:问答核查:为什么多做重计算反而更快等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
算法1在线统计、定理1精确性与反向重计算设计
技术关系
- 015-transformer · 直接继承
精确算子实现优化
- 040-performer · 平行方法
FlashAttention保持稠密注意力结果并降低访存,Performer用随机核近似改变计算。
- 038-bigbird · 平行方法
FlashAttention优化精确稠密计算的访存,BigBird则改变注意力连接图。
- 079-vllm · 平行方法
服务缓存系统优化
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型ReAct: Synergizing Reasoning and Acting in Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:推理缺少事实时,怎样把行动反馈接回下一步决策
- 二、区分模型生成的行动与环境返回的观察
- 三、执行检索或环境动作,再按预算触发回退
- 四、按知识、家庭任务和购物的不同指标读结果
- 五、工具质量与重复行动仍可能阻断闭环
- 六、沿调用训练、跨尝试记忆和环境接口继续扩展
- 自测与参考答案
段落怎样重新安排
- 问题定义:工具返回内容才是观察 → 推理缺少事实时,怎样把行动反馈接回下一步决策
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解 → 工具质量与重复行动仍可能阻断闭环
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 沿调用训练、跨尝试记忆和环境接口继续扩展
真实关系移到后继路线,避免目录相邻等于技术继承
- 问题定义:工具返回内容才是观察 → 区分模型生成的行动与环境返回的观察
保留完整公式和事实约束
- 方法:循环接口比固定格式更重要 → 区分模型生成的行动与环境返回的观察
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:循环接口比固定格式更重要 → 执行检索或环境动作,再按预算触发回退
单列可执行步骤,与机制论证及经验结果区分
- 方法:循环接口比固定格式更重要 → 执行检索或环境动作,再按预算触发回退
保留实现限制、训练协议及指标接口
- 与自一致性组合 → 区分模型生成的行动与环境返回的观察
保留完整公式和事实约束
- 与自一致性组合 → 区分模型生成的行动与环境返回的观察
保留原推导
- 实验设计与数据范围 → 按知识、家庭任务和购物的不同指标读结果
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构例子 → 执行检索或环境动作,再按预算触发回退
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子 → 区分模型生成的行动与环境返回的观察
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子 → 工具质量与重复行动仍可能阻断闭环
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子 → 工具质量与重复行动仍可能阻断闭环
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组关键证据 → 按知识、家庭任务和购物的不同指标读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按知识、家庭任务和购物的不同指标读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按知识、家庭任务和购物的不同指标读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按知识、家庭任务和购物的不同指标读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按知识、家庭任务和购物的不同指标读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 按知识、家庭任务和购物的不同指标读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 工具质量与重复行动仍可能阻断闭环
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 工具质量与重复行动仍可能阻断闭环
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 工具质量与重复行动仍可能阻断闭环
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 工具质量与重复行动仍可能阻断闭环
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把观察的来源写进执行日志
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿调用训练、跨尝试记忆和环境接口继续扩展
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把观察的来源写进执行日志:把观察的来源写进执行日志
教法来源与实际阅读范围
- Lilian Weng · LLM Powered Autonomous Agents
系统组件、Planning、ReAct与Reflexion流程
原论文校准:ReAct真实环境观察与模型行动的协议;日志字段为本文工程教学建议,不冒充论文固定数据格式。
本篇校准范围:ReAct真实环境观察与模型行动的协议;日志字段为本文工程教学建议,不冒充论文固定数据格式。 新增段落仅用于“把观察的来源写进执行日志”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- ReAct、思维链与组合提示在HotpotQA和FEVER上的结果
实验/结果图 · 必要原图摘引 · 表1,PDF第5页
证据一:表1保留知识任务负结果。 HotpotQA精确匹配Act25.7、ReAct27.4、CoT29.4、CoT-SC33.4。ReAct相对纯行动改善1.7个百分点,却低于纯思维链2.0个百分点。FEVER则为Act58.9、ReAct60.9、CoT56.3。工具能增强事实依据,并不保证任何检索接口都提高最终分数。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表1、表2、表3、表4
- 问答核查:模型输出“Observation: 已找到物品”,是否完成了观察等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1.fig1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2.fig1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T4.fig1
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4.fig2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 形式化行动观察历史
- 同名消歧与重复调用诊断例
- 关联工具训练、反馈记忆和接口设计
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表1、表2、表3、表4
- v2:问答核查:模型输出“Observation: 已找到物品”,是否完成了观察等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2循环机制、§3.1受限Wikipedia行动、§3.2轨迹示范
技术关系
- 053-cot · 模块组合
过程文本与行动反馈组合
- 067-toolformer · 平行方法
工具调用训练
- 070-reflexion · 直接继承
跨尝试文字反馈扩展
- 087-sweagent · 历史背景
接口设计延伸
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:低比特舍入怎样保持层输出而不是只保持权重
- 二、由校准曲率和约束优化推导误差补偿
- 三、按共同顺序量化并批量更新未量化列
- 四、分别检验困惑度、压缩成本和生成时延
- 五、校准分布与分组开销限制容量和速度外推
- 六、将量化校准与任务增量训练组合
- 自测:能够回答,才算理解
段落怎样重新安排
- 问题定义:应该保持权重,还是保持输出 → 低比特舍入怎样保持层输出而不是只保持权重
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解 → 校准分布与分组开销限制容量和速度外推
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 校准分布与分组开销限制容量和速度外推
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 将量化校准与任务增量训练组合
真实关系移到后继路线,避免目录相邻等于技术继承
- 问题定义:应该保持权重,还是保持输出 → 由校准曲率和约束优化推导误差补偿
保留完整公式和事实约束
- 方法:二阶信息怎样参与量化 → 由校准曲率和约束优化推导误差补偿
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:二阶信息怎样参与量化 → 由校准曲率和约束优化推导误差补偿
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:二阶信息怎样参与量化 → 按共同顺序量化并批量更新未量化列
单列可执行步骤,与机制论证及经验结果区分
- 方法:二阶信息怎样参与量化 → 按共同顺序量化并批量更新未量化列
保留实现限制、训练协议及指标接口
- 实验怎样组织 → 分别检验困惑度、压缩成本和生成时延
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构例子与五个前置概念 → 由校准曲率和约束优化推导误差补偿
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子与五个前置概念 → 由校准曲率和约束优化推导误差补偿
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子与五个前置概念 → 校准分布与分组开销限制容量和速度外推
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子与五个前置概念 → 校准分布与分组开销限制容量和速度外推
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据应该怎样读 → 分别检验困惑度、压缩成本和生成时延
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据应该怎样读 → 分别检验困惑度、压缩成本和生成时延
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据应该怎样读 → 分别检验困惑度、压缩成本和生成时延
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据应该怎样读 → 分别检验困惑度、压缩成本和生成时延
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据应该怎样读 → 分别检验困惑度、压缩成本和生成时延
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据应该怎样读 → 分别检验困惑度、压缩成本和生成时延
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据应该怎样读 → 分别检验困惑度、压缩成本和生成时延
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与适用边界 → 校准分布与分组开销限制容量和速度外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与适用边界 → 校准分布与分组开销限制容量和速度外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与适用边界 → 校准分布与分组开销限制容量和速度外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 校准通道共线时,为什么需要阻尼
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、将量化校准与任务增量训练组合
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 校准通道共线时,为什么需要阻尼:校准通道共线时,为什么需要阻尼
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:GPTQ重建Hessian、阻尼与Cholesky实现;共线例子为线性代数推演,不新增真实失效率。
本篇校准范围:GPTQ重建Hessian、阻尼与Cholesky实现;共线例子为线性代数推演,不新增真实失效率。 新增段落仅用于“校准通道共线时,为什么需要阻尼”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- GPTQ在OPT-175B和BLOOM-176B上的位宽、分组及困惑度结果
实验/结果图 · 必要原图摘引 · 表5,PDF第8页
证据一:表5,质量能否保住。 OPT-175B的WikiText2困惑度,FP16为8.34,4-bit GPTQ为8.37,3-bit为8.68;4-bit RTN为10.54。支持的是这组模型与数据上的输出质量保持,不能据此宣称低比特一定提升知识或推理。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表2、表6、表5、表3、表7
- 问答核查:为什么最小化权重的舍入误差,不等于最小化模型输出误差等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表2 · 表2;HTML元素 #S5.T2.fig2
原站图表/证明入口
- 表6 · 表6;HTML元素 #S5.T6
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
- 表7 · 表7;HTML元素 #S5.T7.fig1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 拉格朗日约束推出逆曲率补偿
- 二参数正定Hessian数值例
- 区分量化与适配目的
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表2、表6、表5、表3、表7
- v2:问答核查:为什么最小化权重的舍入误差,不等于最小化模型输出误差等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3式1—3输出重建与OBQ补偿基础
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Holistic Evaluation of Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:任务接口不同,怎样让模型分数真正可比较
- 二、把场景、适配和多维指标定义为完整测量对象
- 三、固定提示与答案映射,并记录缺测与重复种子
- 四、按指标方向和任务颜色读取关系图
- 五、覆盖不全与指标权重仍需由实际用途决定
- 六、在多指标评价里进一步明确推理预算
- 自测:能够回答,才算理解
段落怎样重新安排
- 背景:评价对象究竟是什么 → 任务接口不同,怎样让模型分数真正可比较
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 覆盖不全与指标权重仍需由实际用途决定
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 覆盖不全与指标权重仍需由实际用途决定
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 在多指标评价里进一步明确推理预算
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:从单分数转向场景与指标矩阵 → 把场景、适配和多维指标定义为完整测量对象
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:从单分数转向场景与指标矩阵 → 把场景、适配和多维指标定义为完整测量对象
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:从单分数转向场景与指标矩阵 → 固定提示与答案映射,并记录缺测与重复种子
单列可执行步骤,与机制论证及经验结果区分
- 方法:从单分数转向场景与指标矩阵 → 固定提示与答案映射,并记录缺测与重复种子
保留实现限制、训练协议及指标接口
- 实验设计与预算口径 → 按指标方向和任务颜色读取关系图
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置概念 → 把场景、适配和多维指标定义为完整测量对象
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 把场景、适配和多维指标定义为完整测量对象
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 覆盖不全与指标权重仍需由实际用途决定
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 覆盖不全与指标权重仍需由实际用途决定
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们的边界 → 按指标方向和任务颜色读取关系图
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与实际使用 → 覆盖不全与指标权重仍需由实际用途决定
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与实际使用 → 覆盖不全与指标权重仍需由实际用途决定
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与实际使用 → 覆盖不全与指标权重仍需由实际用途决定
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与实际使用 → 覆盖不全与指标权重仍需由实际用途决定
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 总体校准怎样掩盖子群失真
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、在多指标评价里进一步明确推理预算
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 总体校准怎样掩盖子群失真:总体校准怎样掩盖子群失真
教法来源与实际阅读范围
- Lilian Weng · Extrinsic Hallucinations in LLMs
幻觉定义、知识来源、检索增强评价与原子事实评价
原论文校准:HELM多维与分场景评估;自构分组计数,不断言原文模型存在此具体分布。
本篇校准范围:HELM多维与分场景评估;自构分组计数,不断言原文模型存在此具体分布。 新增段落仅用于“总体校准怎样掩盖子群失真”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- **读图24先看箭头。** 六幅横轴都是准确性,点的颜色区分任务场景;纵轴的鲁棒性、公平性越高越好,而校准误差、偏差、有害性和推理时间越低越好。因此“点更靠右上”不是统一的理想方向,也不能把不同颜色的任务差异直接解释成同一模型的因果改进。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:5 幅
- HELM准确率与校准、鲁棒性、公平性、偏差和推理时间的关系
实验/结果图 · 必要原图摘引 · 图24,HTML #S8.F24
读图24先看箭头。 六幅横轴都是准确性,点的颜色区分任务场景;纵轴的鲁棒性、公平性越高越好,而校准误差、偏差、有害性和推理时间越低越好。因此“点更靠右上”不是统一的理想方向,也不能把不同颜色的任务差异直接解释成同一模型的因果改进。
- HELM与已有工作在模型和场景组合上的评测覆盖矩阵
实验/结果图 · 必要原图摘引 · 图4,PDF第5页
**证据一:[图4](https://arxiv.org/html/2211.09110#S1.F4),比较覆盖是否改善。** 论文报告核心场景的平均覆盖从17.9%提高到96.0%。这是评测完整度的改变,不是模型准确率提升。它支持建立共同测量空间的贡献。 覆盖图比较评测了哪些模型—场景组合;指标关系图把准确率放在横轴,校准、鲁棒性等放在纵轴。覆盖增加与准确率增加不是同一件事。
- HELM准确率、校准、鲁棒性、公平性、偏差及毒性之间的相关分布
实验/结果图 · 必要原图摘引 · 图25,PDF第49页
**证据二:[图24](https://arxiv.org/html/2211.09110#S8.F24)、[图25](https://arxiv.org/html/2211.09110#S8.F25),指标是否等价。** 跨指标关系并不统一,不能用准确性代替其他目标。相关性是这些模型、这些任务中的统计现象,不能证明提高某项指标会因果性地改善另一项。
- HELM不同场景与模型对提示选择的分数敏感度
实验/结果图 · 必要原图摘引 · 图31,PDF第56页
**证据三:[图31](https://arxiv.org/html/2211.09110#S8.F31)与§8.2,示例选择的影响。** davinci在开放资料NaturalQuestions的三组示例下,F1为0.376、0.611、0.636。选择一个最好种子会明显改变印象;这不是训练不稳定,而是提示适配敏感。
- HELM多项选择联合、分别与校准评分协议在八类任务上的差异
实验/结果图 · 必要原图摘引 · 图33,PDF第58页
**证据四:[图33](https://arxiv.org/html/2211.09110#S8.F33)与§8.2,统一协议的局限。** 联合展示选项与分别打分,会改变模型间差距甚至效率关系。它支持把适配方式视为测量对象的一部分,不能据此挑选每个模型最好的一次分数,再声称是同协议比较。
未在正文展示的图/表与范围
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表7、图4、图24、图25、图31、图33
- 问答核查:两个模型使用完全相同的提示,是否足以保证公平比较等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 表7 · 表7;HTML元素 #S7.T7
原站图表/证明入口
- 图4 · 图4;HTML元素 #S1.F4
原站图表/证明入口
- 图24 · 图24;HTML元素 #S8.F24
原站图表/证明入口
- 图25 · 图25;HTML元素 #S8.F25
原站图表/证明入口
- 图31 · 图31;HTML元素 #S8.F31
原站图表/证明入口
- 图33 · 图33;HTML元素 #S8.F33
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 区分校准、准确率和选择性回答
- 同80%准确率不同路由价值的例子
- 关联场景指标与预算评估
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表7、图4、图24、图25、图31、图33
- v2:问答核查:两个模型使用完全相同的提示,是否足以保证公平比较等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:**读图24先看箭头。** 六幅横轴都是准确性,点的颜色区分任务场景;纵轴的鲁棒性、公平性越高越好,而校准误差、偏差、有害性和推理时间越低越好。因此“点更靠右上”不是统一的理想方向,也不能把不同颜色的任务差异直接解释成同一模型的因果改进。
查核资料
- arxiv.org · 所列章节
§4.4图17、10等频箱ECE与选择性覆盖率
- arxiv.org · 所列章节
读图24先看箭头。 六幅横轴都是准确性,点的颜色区分任务场景;纵轴的鲁棒性、公平性越高越好,而校准误差、偏差、有害性和推理时间越低越好。因此“点更靠右上”不是统一的理想方向,也不能把不同颜色的任务差异直接解释成同一模型的因果改进。
技术关系
- 039-mmlu · 模块组合
多学科场景纳入综合评估
- 049-truthfulqa · 模块组合
真实性场景纳入综合评估
- 100-tts-protocol · 历史背景
预算评估延伸
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型PAL: Program-aided Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:题意分解正确时,怎样避免再由token预测执行算术
- 二、把程序分布经执行器映射成答案分布
- 三、生成程序、记录失败并按约定读取执行结果
- 四、固定后端检验执行器与变量语义的贡献
- 五、语法成功仍不保证单位、实体和边界建模正确
- 六、从程序执行接到一般调用训练
- 自测:能够回答,才算理解
段落怎样重新安排
- 背景:推理错误和计算错误不是同一件事 → 题意分解正确时,怎样避免再由token预测执行算术
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 语法成功仍不保证单位、实体和边界建模正确
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 语法成功仍不保证单位、实体和边界建模正确
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 从程序执行接到一般调用训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:把答案分布经过执行器映射 → 把程序分布经执行器映射成答案分布
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:把答案分布经过执行器映射 → 把程序分布经执行器映射成答案分布
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:把答案分布经过执行器映射 → 生成程序、记录失败并按约定读取执行结果
单列可执行步骤,与机制论证及经验结果区分
- 方法:把答案分布经过执行器映射 → 生成程序、记录失败并按约定读取执行结果
保留实现限制、训练协议及指标接口
- 实验设计 → 固定后端检验执行器与变量语义的贡献
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置概念 → 把程序分布经执行器映射成答案分布
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 生成程序、记录失败并按约定读取执行结果
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 生成程序、记录失败并按约定读取执行结果
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 生成程序、记录失败并按约定读取执行结果
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 语法成功仍不保证单位、实体和边界建模正确
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据:改善来自哪里 → 固定后端检验执行器与变量语义的贡献
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:改善来自哪里 → 固定后端检验执行器与变量语义的贡献
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:改善来自哪里 → 固定后端检验执行器与变量语义的贡献
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:改善来自哪里 → 固定后端检验执行器与变量语义的贡献
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:改善来自哪里 → 固定后端检验执行器与变量语义的贡献
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:改善来自哪里 → 固定后端检验执行器与变量语义的贡献
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:改善来自哪里 → 固定后端检验执行器与变量语义的贡献
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 语法成功仍不保证单位、实体和边界建模正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 语法成功仍不保证单位、实体和边界建模正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 语法成功仍不保证单位、实体和边界建模正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 语法成功仍不保证单位、实体和边界建模正确
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用单位断言定位执行前的语义错误
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、从程序执行接到一般调用训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用单位断言定位执行前的语义错误:用单位断言定位执行前的语义错误
教法来源与实际阅读范围
- Lilian Weng · LLM Powered Autonomous Agents
系统组件、Planning、ReAct与Reflexion流程
原论文校准:PAL程序辅助推理与解释器职责;单位检查是原创实现建议,未宣称论文实验证明该附加模块收益。
本篇校准范围:PAL程序辅助推理与解释器职责;单位检查是原创实现建议,未宣称论文实验证明该附加模块收益。 新增段落仅用于“用单位断言定位执行前的语义错误”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- PAL移除代码注释和变量语义后在三个任务上的准确率
实验/结果图 · 必要原图摘引 · 图9,PDF第8页
证据三:图9,语义线索是否重要。 删除注释后,保留有意义变量名仍能保持较好表现;继续把名字换成随机字符会进一步下降。它支持变量名帮助生成器建立对应关系,不代表解释器本身理解这些名字。 变量名消融比较生成提示,而非对已生成程序做等价重命名;另一个采样曲线中部分基线由1与40样本端点插值,并非每个中间点都实测。
- PAL和基线随每题候选数量变化的解题率及插值基线
实验/结果图 · 必要原图摘引 · 图12,PDF第16页
GSM-hard的CoT数字还存在版本内表格差异:[表1](https://arxiv.org/html/2211.10435v2#S4.T1)为23.1%,[表7](https://arxiv.org/html/2211.10435v2#A5.T7)均值为23.3%,PAL均为61.2%。引用时应保留出处,不能把两个基线混合后声称精确提升到小数点后一位。[图12](https://arxiv.org/html/2211.10435v2#A4.F12)中的部分基线曲线由端点插值得到,也不应读成每个采样数都直接运行过。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表6、图9、表3、表7、图12
- 问答核查:PAL解决了计算错误,是否也解决了逻辑错误等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表6 · 表6;HTML元素 #A2.T6
原站图表/证明入口
- 图9 · 图9;HTML元素 #S6.F9
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
- 表7 · 表7;HTML元素 #A5.T7
原站图表/证明入口
- 图12 · 图12;HTML元素 #A4.F12
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 执行映射下答案分布形式化
- 表达式正确执行但题意错误例
- 拆分编译执行与语义成功指标
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表6、图9、表3、表7、图12
- v2:问答核查:PAL解决了计算错误,是否也解决了逻辑错误等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2/图1程序生成与Python执行职责分工
技术关系
- 048-codex · 模块组合
代码模型与执行器
- 053-cot · 平行方法
中间表示改为程序
- 060-react · 平行方法
交互闭环路线
- 067-toolformer · 平行方法
学习工具调用
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Fast Inference from Transformers via Speculative Decoding部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:减少大模型串行调用时,怎样保持完整采样分布
- 二、用接受质量与残差分布证明输出精确性
- 三、逐段验证草稿并核算拒绝后的缓存与成本
- 四、对照接受率、草稿耗时与端到端加速
- 五、理论分布不变仍需实现和负载条件成立
- 六、比较独立草稿与同模型多头候选
- 自测:能够回答,才算理解
段落怎样重新安排
- 问题定义:保持什么不变 → 减少大模型串行调用时,怎样保持完整采样分布
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解 → 理论分布不变仍需实现和负载条件成立
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 理论分布不变仍需实现和负载条件成立
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 比较独立草稿与同模型多头候选
真实关系移到后继路线,避免目录相邻等于技术继承
- 问题定义:保持什么不变 → 用接受质量与残差分布证明输出精确性
保留完整公式和事实约束
- 接受与补偿:算法真正的核心 → 用接受质量与残差分布证明输出精确性
先给出信息路径、目标与机制,再讨论执行顺序
- 接受与补偿:算法真正的核心 → 逐段验证草稿并核算拒绝后的缓存与成本
单列可执行步骤,与机制论证及经验结果区分
- 接受与补偿:算法真正的核心 → 逐段验证草稿并核算拒绝后的缓存与成本
保留实现限制、训练协议及指标接口
- 为什么多算一些,反而可能更快 → 用接受质量与残差分布证明输出精确性
保留完整公式和事实约束
- 为什么多算一些,反而可能更快 → 用接受质量与残差分布证明输出精确性
保留原推导
- 实验如何验证 → 对照接受率、草稿耗时与端到端加速
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构概率例子 → 用接受质量与残差分布证明输出精确性
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构概率例子 → 用接受质量与残差分布证明输出精确性
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构概率例子 → 理论分布不变仍需实现和负载条件成立
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 对照接受率、草稿耗时与端到端加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 理论分布不变仍需实现和负载条件成立
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 理论分布不变仍需实现和负载条件成立
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 理论分布不变仍需实现和负载条件成立
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 多起草两步为何可能降低预计加速
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、比较独立草稿与同模型多头候选
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 多起草两步为何可能降低预计加速:多起草两步为何可能降低预计加速
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:投机解码原期望产出和成本式;数值代入自构简化条件,不冒充硬件测试。
本篇校准范围:投机解码原期望产出和成本式;数值代入自构简化条件,不冒充硬件测试。 新增段落仅用于“多起草两步为何可能降低预计加速”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 推测解码中不同T5草稿模型、温度及接受率对应的实际加速
实验/结果图 · 必要原图摘引 · 表2,PDF第6页
证据二:表2,端到端速度。 T5-small作草稿时,翻译温度0为3.4倍、温度1为2.6倍;摘要分别为3.1倍和2.3倍。结论对应batch 1和该实现,不能直接迁移到所有GPU服务。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表2、表1、表4
- 问答核查:为什么拒绝候选后不能直接从目标分布重新抽样等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表4 · 表4;HTML元素 #A1.T4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 接受率与总变差关系推导
- 拒绝后错误重采样的反例
- 限定精确性依赖接受修正协议
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表2、表1、表4
- v2:问答核查:为什么拒绝候选后不能直接从目标分布重新抽样等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.3拒绝采样、算法1与附录A.1分布保证
技术关系
- 015-transformer · 模块组合
目标自回归模型
- 085-medusa · 平行方法
不同草稿结构与接受规则
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Constitutional AI: Harmlessness from AI Feedback部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:自然语言原则怎样变成可训练的行为反馈
- 二、分开监督修订与AI成对偏好两条转换链
- 三、记录原则、评判概率与人类有用性数据的混合
- 四、分别读取有用性、无害性与多轮修订证据
- 五、原则歧义、评判错误和奖励投机仍需独立审查
- 六、继续比较AI反馈与人类反馈的适用范围
- 自测:能够回答,才算理解
段落怎样重新安排
- 问题定义:从原则到行为存在几层转换 → 自然语言原则怎样变成可训练的行为反馈
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 原则歧义、评判错误和奖励投机仍需独立审查
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 原则歧义、评判错误和奖励投机仍需独立审查
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 继续比较AI反馈与人类反馈的适用范围
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法一:批评、修改与监督学习 → 分开监督修订与AI成对偏好两条转换链
保留完整公式和事实约束
- 方法二:AI比较、偏好模型与RL → 分开监督修订与AI成对偏好两条转换链
先给出信息路径、目标与机制,再讨论执行顺序
- 方法二:AI比较、偏好模型与RL → 分开监督修订与AI成对偏好两条转换链
将原来的后置推导提前,解释伪代码为何这样计算
- 方法二:AI比较、偏好模型与RL → 记录原则、评判概率与人类有用性数据的混合
单列可执行步骤,与机制论证及经验结果区分
- 方法二:AI比较、偏好模型与RL → 记录原则、评判概率与人类有用性数据的混合
保留实现限制、训练协议及指标接口
- 实验怎样组织 → 分别读取有用性、无害性与多轮修订证据
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置概念 → 记录原则、评判概率与人类有用性数据的混合
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 分开监督修订与AI成对偏好两条转换链
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 原则歧义、评判错误和奖励投机仍需独立审查
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据与解释 → 分别读取有用性、无害性与多轮修订证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与解释 → 分别读取有用性、无害性与多轮修订证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与解释 → 分别读取有用性、无害性与多轮修订证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与解释 → 分别读取有用性、无害性与多轮修订证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与解释 → 分别读取有用性、无害性与多轮修订证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与解释 → 分别读取有用性、无害性与多轮修订证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与解释 → 分别读取有用性、无害性与多轮修订证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 原则歧义、评判错误和奖励投机仍需独立审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 原则歧义、评判错误和奖励投机仍需独立审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 原则歧义、评判错误和奖励投机仍需独立审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 原则歧义、评判错误和奖励投机仍需独立审查
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 软偏好保留的不是绝对正确概率
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、继续比较AI反馈与人类反馈的适用范围
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 软偏好保留的不是绝对正确概率:软偏好保留的不是绝对正确概率
教法来源与实际阅读范围
- Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla · Illustrating Reinforcement Learning from Human Feedback
三阶段训练、偏好排名、奖励模型、RL/KL及同一响应送入冻结参考的图示澄清
原论文校准:Constitutional AI的软AI偏好与奖励学习;导数来自文中交叉熵,不能把0.6当作回答事实正确率。
本篇校准范围:Constitutional AI的软AI偏好与奖励学习;导数来自文中交叉熵,不能把0.6当作回答事实正确率。 新增段落仅用于“软偏好保留的不是绝对正确概率”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 下方展示的是图3:两幅横轴都是模型参数量,左幅纵轴为有用性Elo,右幅为无害性Elo。相同尺寸先分别比较两个面板,才能看清偏好取舍;向右表示模型更大,并不表示同一个模型训练更久。图2才是把有用性和无害性分别放在两轴、用点表示RL训练进程的图,不能把它的读法套给图3。
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:6 幅
- 宪法式AI模型的有用性和无害性Elo随参数规模变化
实验/结果图 · 必要原图摘引 · 图3,HTML #S1.F3
证据一:图2、图3与图8,主要行为比较。 人工偏好结果支持RL-CAI在给定有用性水平下取得较好的无害性表现。Elo是相对比较尺度,零点可人为设置,不能把它当作有害概率或绝对风险百分比。 下方展示的是图3:两幅横轴都是模型参数量,左幅纵轴为有用性Elo,右幅为无害性Elo。相同尺寸先分别比较两个面板,才能看清偏好取舍;向右表示模型更大,并不表示同一个模型训练更久。图2才是把有用性和无害性分别放在两轴、用点表示RL训练进程的图,不能把它的读法套给图3。
- Constitutional AI各训练方法在帮助性与无害性Elo上的关系
实验/结果图 · 必要原图摘引 · 图2,PDF第3页
先认清图3横轴是模型规模、图2才跟踪RL进程;Elo与绝对有害评分给的是不同证据,不能互换成风险百分比。
- Constitutional AI强化学习样本量与帮助性、无害性变化
实验/结果图 · 必要原图摘引 · 图8,PDF第12页
**证据一:[图2](https://arxiv.org/html/2212.08073v1#S1.F2)、[图3](https://arxiv.org/html/2212.08073v1#S1.F3)与[图8](https://arxiv.org/html/2212.08073v1#S4.F8),主要行为比较。** 人工偏好结果支持RL-CAI在给定有用性水平下取得较好的无害性表现。Elo是相对比较尺度,零点可人为设置,不能把它当作有害概率或绝对风险百分比。 下方展示的是图3:两幅横轴都是模型参数量,左幅纵轴为有用性Elo,右幅为无害性Elo。相同尺寸先分别比较两个面板,才能看清偏好取舍;向右表示模型更大,并不表示同一个模型训练更久。图2才是把有用性和无害性分别放在两轴、用点表示RL训练进程的图,不能把它的读法套给图3。
- Constitutional AI直接修订与先批评后修订在不同模型规模下的比较
实验/结果图 · 必要原图摘引 · 图7,PDF第10页
**证据二:[图7](https://arxiv.org/html/2212.08073v1#S3.F7),批评是否必要。** 小模型更受益于先批评再改写,大模型中两种方式更接近。作者也观察到批评可能夸大或误判原回答。这不支持“每一段自我批评都忠实解释修改原因”。
- Constitutional AI修订次数及模型规模对三种偏好分数的影响
实验/结果图 · 必要原图摘引 · 图5,PDF第9页
**证据三:[图5](https://arxiv.org/html/2212.08073v1#S3.F5)与§3.4,多轮修订。** 偏好模型分数随修订改善,但作者提醒高分区间的校准变差。它支持修订能推动代理指标,尚不足以证明每轮都降低真实伤害。
- Constitutional AI四种训练方式的绝对无害性分数随训练样本量变化
实验/结果图 · 必要原图摘引 · 图10,PDF第14页
**证据五:[图10](https://arxiv.org/html/2212.08073v1#S4.F10)与§4.5,另一种评价。** 绝对有害评分的下降与相对偏好结果提供补充,但评分来自学得的模型,且只有64个挑选的留出提示。256次采样扩大的是同一提示的回答覆盖,不等于16,384个独立提示。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图2、图3、图8、图7、图5、图10
- 问答核查:这篇论文为什么不能概括为“AI完全自己对齐自己”等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 图2 · 图2;HTML元素 #S1.F2
原站图表/证明入口
- 图3 · 图3;HTML元素 #S1.F3
原站图表/证明入口
- 图8 · 图8;HTML元素 #S4.F8
原站图表/证明入口
- 图7 · 图7;HTML元素 #S3.F7
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 图10 · 图10;HTML元素 #S4.F10
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 拆解原则解释/标签/优化三层误差
- 三候选原则审计例
- 限定AI反馈替代的监督范围
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图2、图3、图8、图7、图5、图10
- v2:问答核查:这篇论文为什么不能概括为“AI完全自己对齐自己”等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- v3:下方展示的是图3:两幅横轴都是模型参数量,左幅纵轴为有用性Elo,右幅为无害性Elo。相同尺寸先分别比较两个面板,才能看清偏好取舍;向右表示模型更大,并不表示同一个模型训练更久。图2才是把有用性和无害性分别放在两轴、用点表示RL训练进程的图,不能把它的读法套给图3。
查核资料
- arxiv.org · 所列章节
§1.2非规避有用性、§1.3批评修订消融、§1.4人类有用性起点
- arxiv.org · 所列章节
证据一:图2、图3与图8,主要行为比较。 人工偏好结果支持RL-CAI在给定有用性水平下取得较好的无害性表现。Elo是相对比较尺度,零点可人为设置,不能把它当作有害概率或绝对风险百分比。 下方展示的是图3:两幅横轴都是模型参数量,左幅纵轴为有用性Elo,右幅为无害性Elo。相同尺寸先分别比较两个面板,才能看清偏好取舍;向右表示模型更大,并不表示同一个模型训练更久。图2才是把有用性和无害性分别放在两轴、用点表示RL训练进程的图,不能把它的读法套给图3。
技术关系
- 054-instructgpt · 历史背景
偏好优化框架背景
- 080-rlaif · 直接继承
后作系统研究AI反馈
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:冻结两端时,怎样把视觉特征变成可用语言条件
- 二、用查询与三种掩码分开表示对齐和生成
- 三、两阶段训练接口并追踪冻结网络的输入梯度
- 四、按VQA、参数口径与检索重排拆开证据
- 五、固定查询带宽与基座知识限制视觉回答
- 六、对照更直接的视觉投影与指令数据
- 自测:能够回答,才算理解
段落怎样重新安排
- 研究背景:特征空间不是通用插头 → 冻结两端时,怎样把视觉特征变成可用语言条件
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 固定查询带宽与基座知识限制视觉回答
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 固定查询带宽与基座知识限制视觉回答
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 对照更直接的视觉投影与指令数据
真实关系移到后继路线,避免目录相邻等于技术继承
- 第一阶段:三种目标约束同一桥梁 → 用查询与三种掩码分开表示对齐和生成
保留完整公式和事实约束
- 第二阶段:把查询输出变成语言模型条件 → 用查询与三种掩码分开表示对齐和生成
先给出信息路径、目标与机制,再讨论执行顺序
- 第二阶段:把查询输出变成语言模型条件 → 用查询与三种掩码分开表示对齐和生成
将原来的后置推导提前,解释伪代码为何这样计算
- 第二阶段:把查询输出变成语言模型条件 → 两阶段训练接口并追踪冻结网络的输入梯度
单列可执行步骤,与机制论证及经验结果区分
- 第二阶段:把查询输出变成语言模型条件 → 两阶段训练接口并追踪冻结网络的输入梯度
保留实现限制、训练协议及指标接口
- 实验设计与真实成本 → 按VQA、参数口径与检索重排拆开证据
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置概念 → 用查询与三种掩码分开表示对齐和生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 用查询与三种掩码分开表示对齐和生成
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 固定查询带宽与基座知识限制视觉回答
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 固定查询带宽与基座知识限制视觉回答
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据与边界 → 按VQA、参数口径与检索重排拆开证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 按VQA、参数口径与检索重排拆开证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 按VQA、参数口径与检索重排拆开证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 按VQA、参数口径与检索重排拆开证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 按VQA、参数口径与检索重排拆开证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与边界 → 按VQA、参数口径与检索重排拆开证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与连接其他论文 → 固定查询带宽与基座知识限制视觉回答
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与连接其他论文 → 固定查询带宽与基座知识限制视觉回答
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与连接其他论文 → 固定查询带宽与基座知识限制视觉回答
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与连接其他论文 → 固定查询带宽与基座知识限制视觉回答
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用遮挡目标词检查三种query接口
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、对照更直接的视觉投影与指令数据
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用遮挡目标词检查三种query接口:用遮挡目标词检查三种query接口
教法来源与实际阅读范围
- Jay Alammar · The Illustrated Transformer
Self-Attention in Detail、Matrix Calculation、Many Heads、Decoder Side
原论文校准:BLIP-2 ITG因果文本mask、ITC模态隔离与ITM双向交互;具体词为自构,未改变原文query可见规则。
本篇校准范围:BLIP-2 ITG因果文本mask、ITC模态隔离与ITM双向交互;具体词为自构,未改变原文query可见规则。 新增段落仅用于“用遮挡目标词检查三种query接口”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- BLIP-2有无第一阶段表示学习时的零样本VQA准确率
实验/结果图 · 必要原图摘引 · 图5,HTML #S4.F5
证据三:图5,两阶段是否必要。 去掉表示学习后,零样本VQA明显下降,支持先对齐表示的作用。正文把OPT表现退化称为灾难性遗忘,但其权重冻结;更准确的机制解释是接口训练后条件生成表现退化,不能据此说冻结参数被更新后遗忘了知识。 这张消融比较有无第一阶段视觉语言表示学习后的生成学习效果,定位的是桥接训练的作用;不能把它理解成冻结模型与全量微调的完整预算比较。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、表1、图5、表6、表5
- 问答核查:冻结LLM后,Q-Former如何得到训练信号等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
- 表5 · 表5;HTML元素 #S4.T5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 逐目标解释注意力mask避免泄漏
- query与视觉特征尺寸比例核算
- 区分接口压缩与信息保留
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、表1、图5、表6、表5
- v2:问答核查:冻结LLM后,Q-Former如何得到训练信号等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1 query尺寸、§3.2 ITC/ITG/ITM可见性、图3连接LLM
技术关系
- 058-flamingo · 平行方法
不同跨模态桥梁
- 043-clip · 历史背景
对比图文对齐
- 071-llava · 平行方法
投影加视觉指令方案
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Toolformer: Language Models Can Teach Themselves to Use Tools部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有逐条调用标注,怎样学习何时使用工具
- 二、用两个无结果基线隔离返回内容的预测收益
- 三、生成候选、实际执行、筛选并插回语言训练
- 四、把API开关收益与解码调用阈值分开读
- 五、局部续写收益仍不等于长期任务与成本最优
- 六、把工具有用性进一步接到检索支持性
- 自测:能够回答,才算理解
段落怎样重新安排
- 背景:会写API格式还不够 → 没有逐条调用标注,怎样学习何时使用工具
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 局部续写收益仍不等于长期任务与成本最优
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 局部续写收益仍不等于长期任务与成本最优
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把工具有用性进一步接到检索支持性
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:先构造候选,再估计信息增益 → 用两个无结果基线隔离返回内容的预测收益
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:先构造候选,再估计信息增益 → 用两个无结果基线隔离返回内容的预测收益
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:先构造候选,再估计信息增益 → 生成候选、实际执行、筛选并插回语言训练
单列可执行步骤,与机制论证及经验结果区分
- 方法:先构造候选,再估计信息增益 → 生成候选、实际执行、筛选并插回语言训练
保留实现限制、训练协议及指标接口
- 工具、数据与实验预算 → 把API开关收益与解码调用阈值分开读
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置概念 → 用两个无结果基线隔离返回内容的预测收益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 用两个无结果基线隔离返回内容的预测收益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 局部续写收益仍不等于长期任务与成本最优
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 局部续写收益仍不等于长期任务与成本最优
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据:收益与局限同时出现 → 把API开关收益与解码调用阈值分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:收益与局限同时出现 → 把API开关收益与解码调用阈值分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:收益与局限同时出现 → 把API开关收益与解码调用阈值分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:收益与局限同时出现 → 把API开关收益与解码调用阈值分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:收益与局限同时出现 → 把API开关收益与解码调用阈值分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:收益与局限同时出现 → 把API开关收益与解码调用阈值分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:收益与局限同时出现 → 把API开关收益与解码调用阈值分开读
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与适用边界 → 局部续写收益仍不等于长期任务与成本最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与适用边界 → 局部续写收益仍不等于长期任务与成本最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与适用边界 → 局部续写收益仍不等于长期任务与成本最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与适用边界 → 局部续写收益仍不等于长期任务与成本最优
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 用打乱返回值区分工具格式与信息作用
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把工具有用性进一步接到检索支持性
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 用打乱返回值区分工具格式与信息作用:用打乱返回值区分工具格式与信息作用
教法来源与实际阅读范围
- Lilian Weng · LLM Powered Autonomous Agents
系统组件、Planning、ReAct与Reflexion流程
原论文校准:Toolformer以返回结果相对两个基线的损失收益筛选;打乱返回是原创对照设计,明确不是原文实测。
本篇校准范围:Toolformer以返回结果相对两个基线的损失收益筛选;打乱返回是原创对照设计,明确不是原文实测。 新增段落仅用于“用打乱返回值区分工具格式与信息作用”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- Toolformer启用和禁用工具时的三项数学任务结果
实验/结果图 · 必要原图摘引 · 表4,PDF第6页
证据一:表4,计算工具的作用。 ASDiv上禁用API为14.8,启用为40.4;SVAMP从6.3到29.4。这支持工具执行在同一模型上的贡献,但不能证明多步数学推理已普遍解决。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表4、表5、表6、表8、表9、表2
- 问答核查:为什么筛选要同时比较无调用与只有调用参数两种基线等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S4.T5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
- 表8 · 表8;HTML元素 #S4.T8
原站图表/证明入口
- 表9 · 表9;HTML元素 #S5.T9
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 解释调用参数与结果的归因分离
- 损失5/3/2.8筛选数值例
- 指出预测收益与服务成本并非同一目标
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表4、表5、表6、表8、表9、表2
- v2:问答核查:为什么筛选要同时比较无调用与只有调用参数两种基线等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2 Filtering API Calls加权损失与两个基线最小值
技术关系
- 060-react · 平行方法
提示闭环而非调用训练
- 063-pal · 平行方法
程序执行特化
- 082-self-rag · 历史背景
检索控制学习延伸
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型LLaMA: Open and Efficient Foundation Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:反复部署时,训练更充分的小模型何时更划算
- 二、组合成熟算子并配平门控前馈参数预算
- 三、记录数据曝光、优化与高效实现的完整配方
- 四、对齐token预算后读能力与长期训练曲线
- 五、单项成绩和公开来源不足以证明全面领先或可重训
- 六、沿基础模型直接延续到对话后训练
- 自测:能够回答,才算理解
段落怎样重新安排
- 背景:训练最优与使用最优 → 反复部署时,训练更充分的小模型何时更划算
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 单项成绩和公开来源不足以证明全面领先或可重训
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 单项成绩和公开来源不足以证明全面领先或可重训
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 沿基础模型直接延续到对话后训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:成熟组件如何组合 → 组合成熟算子并配平门控前馈参数预算
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:成熟组件如何组合 → 组合成熟算子并配平门控前馈参数预算
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:成熟组件如何组合 → 记录数据曝光、优化与高效实现的完整配方
单列可执行步骤,与机制论证及经验结果区分
- 方法:成熟组件如何组合 → 记录数据曝光、优化与高效实现的完整配方
保留实现限制、训练协议及指标接口
- 实验设计与预算 → 对齐token预算后读能力与长期训练曲线
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置概念 → 组合成熟算子并配平门控前馈参数预算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 反复部署时,训练更充分的小模型何时更划算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 单项成绩和公开来源不足以证明全面领先或可重训
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据与它们能证明什么 → 对齐token预算后读能力与长期训练曲线
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 单项成绩和公开来源不足以证明全面领先或可重训
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 单项成绩和公开来源不足以证明全面领先或可重训
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 单项成绩和公开来源不足以证明全面领先或可重训
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 单项成绩和公开来源不足以证明全面领先或可重训
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 相同参数预算还要核对门控中间张量
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿基础模型直接延续到对话后训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 相同参数预算还要核对门控中间张量:相同参数预算还要核对门控中间张量
原论文校准与展开范围
原论文校准:LLaMA门控前馈结构与中间宽度;尺寸是结构推导,不新增实际显存倍数。
本篇校准范围:LLaMA门控前馈结构与中间宽度;尺寸是结构推导,不新增实际显存倍数。 新增段落仅用于“相同参数预算还要核对门控中间张量”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- LLaMA不同模型规模的训练损失随读取token数量变化
实验/结果图 · 必要原图摘引 · 图1,HTML #S2.F1
证据四:图1、图2,训练是否还有效。 损失持续下降,多数下游任务也改善,但SIQA波动较大,WinoGrande不完全随困惑度变化。它支持继续训练仍有收益,同时说明语言建模损失不是所有任务的充分代理。 训练损失横轴是已处理 token;7B、13B与较大模型的训练终点不同,横向必须对齐读取量,不能直接比较各自终点后宣称等预算。
- LLaMA在六个下游任务上的准确率随训练token数量变化
实验/结果图 · 必要原图摘引 · 图2,HTML #S3.F2
证据四:图1、图2,训练是否还有效。 损失持续下降,多数下游任务也改善,但SIQA波动较大,WinoGrande不完全随困惑度变化。它支持继续训练仍有收益,同时说明语言建模损失不是所有任务的充分代理。 训练损失横轴是已处理 token;7B、13B与较大模型的训练终点不同,横向必须对齐读取量,不能直接比较各自终点后宣称等预算。
未在正文展示的图/表与范围
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表15:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表14:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表3、表9、表8、图1、图2、表15、表4、表14
- 问答核查:LLaMA为什么不算推翻Chinchilla的训练配比结论等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表3 · 表3;HTML元素 #S2.T3
原站图表/证明入口
- 表9 · 表9;HTML元素 #S3.T9
原站图表/证明入口
- 表8 · 表8;HTML元素 #S3.T8
原站图表/证明入口
- 图1 · 图1;HTML元素 #S2.F1
原站图表/证明入口
- 图2 · 图2;HTML元素 #S3.F2
原站图表/证明入口
- 表15 · 表15;HTML元素 #S5.T15
原站图表/证明入口
- 表4 · 表4;HTML元素 #S3.T4
原站图表/证明入口
- 表14 · 表14;HTML元素 #S5.T14
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导门控FFN参数预算匹配
- 3072宽度矩阵核算
- 分清组件组合与独立架构发明
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表3、表9、表8、图1、图2、表15、表4、表14
- v2:问答核查:LLaMA为什么不算推翻Chinchilla的训练配比结论等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.2 Pre-RMSNorm、SwiGLU中间宽度与RoPE
技术关系
- 015-transformer · 模块组合
Transformer骨架
- 046-rope · 模块组合
旋转位置组件
- 057-chinchilla · 历史背景
训练token和模型规模取舍
- 078-llama2 · 直接继承
后作延伸LLaMA
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型GPT-4 Technical Report部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:训练细节未公开时,哪些能力与规模预测仍可审查
- 二、解析可预测损失及HumanEval的对数通过率
- 三、把公开训练角色与不能重建的协议边界分开
- 四、逐项核查考试、代码、污染与校准的分母
- 五、局部基准和可预测损失仍不证明通用可靠性
- 六、把考试证据延伸到真实仓库任务的评价
- 自测:能够回答,才算理解
段落怎样重新安排
- 研究背景与问题边界 → 训练细节未公开时,哪些能力与规模预测仍可审查
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解 → 局部基准和可预测损失仍不证明通用可靠性
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 局部基准和可预测损失仍不证明通用可靠性
把结果及能力限制留到证据或边界中解释
- 一分钟理解 → 把考试证据延伸到真实仓库任务的评价
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法中真正可以分析的部分:缩放预测 → 解析可预测损失及HumanEval的对数通过率
先给出信息路径、目标与机制,再讨论执行顺序
- 方法中真正可以分析的部分:缩放预测 → 把公开训练角色与不能重建的协议边界分开
单列可执行步骤,与机制论证及经验结果区分
- 方法中真正可以分析的部分:缩放预测 → 把公开训练角色与不能重建的协议边界分开
保留实现限制、训练协议及指标接口
- 后训练改变什么:能力、行为和校准分开看 → 解析可预测损失及HumanEval的对数通过率
保留完整公式和事实约束
- 后训练改变什么:能力、行为和校准分开看 → 解析可预测损失及HumanEval的对数通过率
保留原推导
- 实验设计与公开程度 → 逐项核查考试、代码、污染与校准的分母
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置概念 → 解析可预测损失及HumanEval的对数通过率
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 局部基准和可预测损失仍不证明通用可靠性
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置概念 → 局部基准和可预测损失仍不证明通用可靠性
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五组关键证据 → 逐项核查考试、代码、污染与校准的分母
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、限制与证据强度 → 局部基准和可预测损失仍不证明通用可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、限制与证据强度 → 局部基准和可预测损失仍不证明通用可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、限制与证据强度 → 局部基准和可预测损失仍不证明通用可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、限制与证据强度 → 局部基准和可预测损失仍不证明通用可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 零次采样成功不能直接代入真实log概率
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把考试证据延伸到真实仓库任务的评价
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 零次采样成功不能直接代入真实log概率:零次采样成功不能直接代入真实log概率
原论文校准与展开范围
原论文校准:GPT-4报告HumanEval子集平均log通过率;此为有限采样诊断,不补造报告未披露的估计程序。
本篇校准范围:GPT-4报告HumanEval子集平均log通过率;此为有限采样诊断,不补造报告未披露的估计程序。 新增段落仅用于“零次采样成功不能直接代入真实log概率”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- GPT-4代码预测损失的计算规模外推及实际观测点
实验/结果图 · 必要原图摘引 · 图1,HTML #S3.F1
证据一:图1、图2,部分结果可预测。 内部代码损失拟合使用至多万分之一量级算力的小运行;HumanEval子集使用至多千分之一量级。支持特定指标的可预测性,不支持提前预测所有能力,更不能据相对横轴推算真实训练费用。 规模预测图把GPT-4训练计算归一化为1,拟合排除了GPT-4自身;校准图则比较概率分桶与真实准确率,二者检验的性质不同。
- GPT-4后训练前后MMLU概率分桶与实际正确率的校准差异
实验/结果图 · 必要原图摘引 · 图8,HTML #S5.F8
证据四:附录B表8与图8,后训练取舍。 考试平均基础模型73.7%、RLHF后74.0%,但个别考试涨跌不同;图8显示MMLU子集校准变差。平均知识能力接近与概率可靠性下降可以同时存在。
- GPT-4与较小模型在23个编码问题上的平均对数通过率及计算规模外推
实验/结果图 · 必要原图摘引 · 图2,PDF第3页
**证据一:[图1](https://arxiv.org/html/2303.08774v6#S3.F1)、[图2](https://arxiv.org/html/2303.08774v6#S3.F2),部分结果可预测。** 内部代码损失拟合使用至多万分之一量级算力的小运行;HumanEval子集使用至多千分之一量级。支持特定指标的可预测性,不支持提前预测所有能力,更不能据相对横轴推算真实训练费用。 规模预测图把GPT-4训练计算归一化为1,拟合排除了GPT-4自身;校准图则比较概率分桶与真实准确率,二者检验的性质不同。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表11:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、图1、图2、表1、表8、图8、表11
- 问答核查:为什么不能根据这篇报告写出GPT-4的完整训练伪代码等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 图1 · 图1;HTML元素 #S3.F1
原站图表/证明入口
- 图2 · 图2;HTML元素 #S3.F2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表8 · 表8;HTML元素 #A2.T8
原站图表/证明入口
- 图8 · 图8;HTML元素 #S5.F8
原站图表/证明入口
- 表11 · 表11;HTML元素 #A4.T11
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 解释log均值与几何均值
- 困难题尾部数值例
- 限定可公开验证的缩放预测范围
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、图1、图2、表1、表8、图8、表11
- v2:问答核查:为什么不能根据这篇报告写出GPT-4的完整训练伪代码等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.2 HumanEval平均log通过率、子集选择与训练前预测
技术关系
- 029-scaling-laws · 历史背景
缩放预测背景
- 048-codex · 模块组合
HumanEval评价组件
- 081-swebench · 教学联系
代码考试与仓库工程的范围
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Reflexion: Language Agents with Verbal Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一次失败后,怎样让下次尝试用上可靠经验
- 二、区分行动、评价和反思,再把轨迹压缩为有限记忆
- 三、保存可检验修改并控制重试与反馈预算
- 四、按累计成功、内部测试与任务退化读取证据
- 五、不可靠反馈会把错误压缩成后续指令
- 六、继续检验反思反馈本身是否可信
- 自测与答案
段落怎样重新安排
- 研究背景:这里的环境和奖励是什么? → 一次失败后,怎样让下次尝试用上可靠经验
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:改的是下次尝试的上下文 → 不可靠反馈会把错误压缩成后续指令
把结果及能力限制留到证据或边界中解释
- 一分钟理解:改的是下次尝试的上下文 → 不可靠反馈会把错误压缩成后续指令
把结果及能力限制留到证据或边界中解释
- 一分钟理解:改的是下次尝试的上下文 → 不可靠反馈会把错误压缩成后续指令
把结果及能力限制留到证据或边界中解释
- 一分钟理解:改的是下次尝试的上下文 → 不可靠反馈会把错误压缩成后续指令
把结果及能力限制留到证据或边界中解释
- 一分钟理解:改的是下次尝试的上下文 → 继续检验反思反馈本身是否可信
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:三个角色与一份有限记忆 → 区分行动、评价和反思,再把轨迹压缩为有限记忆
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:三个角色与一份有限记忆 → 区分行动、评价和反思,再把轨迹压缩为有限记忆
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:三个角色与一份有限记忆 → 保存可检验修改并控制重试与反馈预算
单列可执行步骤,与机制论证及经验结果区分
- 方法:三个角色与一份有限记忆 → 保存可检验修改并控制重试与反馈预算
保留实现限制、训练协议及指标接口
- 实验设计:反馈与预算是比较的一部分 → 按累计成功、内部测试与任务退化读取证据
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个具体例子与五个前置概念 → 保存可检验修改并控制重试与反馈预算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个具体例子与五个前置概念 → 区分行动、评价和反思,再把轨迹压缩为有限记忆
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个具体例子与五个前置概念 → 不可靠反馈会把错误压缩成后续指令
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:五处证据应该怎样读? → 按累计成功、内部测试与任务退化读取证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据应该怎样读? → 按累计成功、内部测试与任务退化读取证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据应该怎样读? → 按累计成功、内部测试与任务退化读取证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据应该怎样读? → 按累计成功、内部测试与任务退化读取证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据应该怎样读? → 按累计成功、内部测试与任务退化读取证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据应该怎样读? → 按累计成功、内部测试与任务退化读取证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与尚未解决的问题 → 不可靠反馈会把错误压缩成后续指令
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与尚未解决的问题 → 不可靠反馈会把错误压缩成后续指令
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与尚未解决的问题 → 不可靠反馈会把错误压缩成后续指令
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、成本与尚未解决的问题 → 不可靠反馈会把错误压缩成后续指令
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 累计成功率怎样依赖失败后的条件表现
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、继续检验反思反馈本身是否可信
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 累计成功率怎样依赖失败后的条件表现:累计成功率怎样依赖失败后的条件表现
教法来源与实际阅读范围
- Lilian Weng · LLM Powered Autonomous Agents
系统组件、Planning、ReAct与Reflexion流程
原论文校准:Reflexion多轮累计任务结果与条件反馈;概率自构,未把重试当独立抽样。
本篇校准范围:Reflexion多轮累计任务结果与条件反馈;概率自构,未把重试当独立抽样。 新增段落仅用于“累计成功率怎样依赖失败后的条件表现”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Reflexion在ALFWorld多次尝试中的累计成功率和失败类型
实验/结果图 · 必要原图摘引 · 图3,HTML #S4.F3
证据1:图3,ALFWorld 的累计成功。 最终完成130/134个任务,即约97.01%,这个比例由任务数自行计算。曲线支持记忆与重试可以帮助解决先前失败的任务,但它是多轮累计结果,不能证明首次行动就有相同可靠性,更不能只凭最终成功率判断调用效率。 ALFWorld 图画的是多次尝试的累计解决比例;HotpotQA 的100题分析又是另一组任务。累计成功不能代替第一次尝试的成功率。
- Reflexion在HotPotQA中的重复尝试、正确轨迹和情节记忆三组消融
实验/结果图 · 必要原图摘引 · 图4,PDF第7页
| HotpotQA | [图4](https://arxiv.org/html/2303.11366v4#S4.F4)的100道题;CoT、ReAct及记忆消融;使用正确性反馈,部分 CoT 设置提供真实支持上下文 |
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图4、图3、表2、表3
- 问答核查:Reflexion 没有更新权重,为什么仍然能“学到”经验它和 PPO 的学习一样吗等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F4
原站图表/证明入口
- 图3 · 图3;HTML元素 #S4.F3
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 解释记忆压缩错误归因
- 四种等预算记忆干预实验
- 串联闭环、跨尝试记忆和外部验证
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图4、图3、表2、表3
- v2:问答核查:Reflexion 没有更新权重,为什么仍然能“学到”经验它和 PPO 的学习一样吗等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3 Actor/Evaluator/Reflection/Memory与算法1
技术关系
- 060-react · 直接继承
本篇增加跨尝试反思记忆
- 055-star · 平行方法
权重重训与上下文适应不同
- 098-rubric-verification · 历史背景
外部证据验证反馈
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Visual Instruction Tuning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:识别图中物体后,怎样按指令选择信息并对话
- 二、推导视觉投影怎样由回答token获得梯度
- 三、先对齐投影,再用符号描述生成的指令训练
- 四、拆开相对评分、ScienceQA组合与属性失败
- 五、文本教师缺少像素会给监督可信度设限
- 六、沿回答监督原则比较纯文本对话训练
- 自测与答案
段落怎样重新安排
- 研究背景:图像表示怎样进入语言模型? → 识别图中物体后,怎样按指令选择信息并对话
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:看见图像和回答问题是两回事 → 文本教师缺少像素会给监督可信度设限
把结果及能力限制留到证据或边界中解释
- 一分钟理解:看见图像和回答问题是两回事 → 文本教师缺少像素会给监督可信度设限
把结果及能力限制留到证据或边界中解释
- 一分钟理解:看见图像和回答问题是两回事 → 文本教师缺少像素会给监督可信度设限
把结果及能力限制留到证据或边界中解释
- 一分钟理解:看见图像和回答问题是两回事 → 沿回答监督原则比较纯文本对话训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:冻结谁,监督哪些 token? → 推导视觉投影怎样由回答token获得梯度
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:冻结谁,监督哪些 token? → 推导视觉投影怎样由回答token获得梯度
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:冻结谁,监督哪些 token? → 先对齐投影,再用符号描述生成的指令训练
单列可执行步骤,与机制论证及经验结果区分
- 方法:冻结谁,监督哪些 token? → 先对齐投影,再用符号描述生成的指令训练
保留实现限制、训练协议及指标接口
- 实验设计:小规模适配建立在大规模预训练之上 → 拆开相对评分、ScienceQA组合与属性失败
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与前置知识 → 推导视觉投影怎样由回答token获得梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置知识 → 推导视觉投影怎样由回答token获得梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与前置知识 → 文本教师缺少像素会给监督可信度设限
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:相对分数、单模型和组合系统 → 拆开相对评分、ScienceQA组合与属性失败
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:相对分数、单模型和组合系统 → 拆开相对评分、ScienceQA组合与属性失败
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:相对分数、单模型和组合系统 → 拆开相对评分、ScienceQA组合与属性失败
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:相对分数、单模型和组合系统 → 拆开相对评分、ScienceQA组合与属性失败
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:相对分数、单模型和组合系统 → 拆开相对评分、ScienceQA组合与属性失败
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:相对分数、单模型和组合系统 → 拆开相对评分、ScienceQA组合与属性失败
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:相对分数、单模型和组合系统 → 拆开相对评分、ScienceQA组合与属性失败
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与读者应该带走的判断 → 文本教师缺少像素会给监督可信度设限
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与读者应该带走的判断 → 文本教师缺少像素会给监督可信度设限
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与读者应该带走的判断 → 文本教师缺少像素会给监督可信度设限
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 回答掩码与下一词标签要错开一个位置
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿回答监督原则比较纯文本对话训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 回答掩码与下一词标签要错开一个位置:回答掩码与下一词标签要错开一个位置
教法来源与实际阅读范围
- Sourab Mangrulkar、Sayak Paul · Parameter-Efficient Fine-Tuning
Motivation、可训练参数统计、增量保存与加载
原论文校准:LLaVA回答token条件似然与两阶段训练;属于实现索引检查,不声称原文发生错位。
本篇校准范围:LLaVA回答token条件似然与两阶段训练;属于实现索引检查,不声称原文发生错位。 新增段落仅用于“回答掩码与下一词标签要错开一个位置”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- LLaVA不同指令数据组合的对话、细节描述和推理分数
实验/结果图 · 必要原图摘引 · 表4,PDF第7页
证据一:表4,数据类型消融。 完整数据总分85.1,仅对话73.8,不做指令训练21.5;对话加少量描述与推理数据达到80.5。它支持指令数据和数据多样性的重要性,但数据子集的数量也变化,因此不能完全拆开“更多样”和“更多样本”的贡献。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表4、表5、表7、表8、表6
- 问答核查:文本 GPT-4 没有看过图片,为什么还能生成视觉训练数据哪里最容易失真等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表4 · 表4;HTML元素 #S5.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
- 表7 · 表7;HTML元素 #S5.T7
原站图表/证明入口
- 表8 · 表8;HTML元素 #S5.T8
原站图表/证明入口
- 表6 · 表6;HTML元素 #S5.T6
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导冻结语言模型中的视觉投影梯度
- 新增二维梯度算例并分析文本教师幻觉监督
- 前置区分CLIP模块组合与BLIP-2平行接口
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表4、表5、表7、表8、表6
- v2:问答核查:文本 GPT-4 没有看过图片,为什么还能生成视觉训练数据哪里最容易失真等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3文本教师的数据生成条件;§4.1投影接口、§4.2回答掩码及两阶段冻结范围
技术关系
- 043-clip · 模块组合
LLaVA使用预训练CLIP视觉编码器
- 066-blip2 · 平行方法
视觉语言连接器的不同选择
- 078-llama2 · 教学联系
对比助手回答掩码与指令监督
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Tree of Thoughts: Deliberate Problem Solving with Large Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:完整轨迹投票之外,怎样在错误前缀上提前止损
- 二、定义想法状态、启发式评价与宽深预算
- 三、用搜索控制器生成、剪枝和回溯部分解
- 四、按任务成功口径与调用预算解释搜索收益
- 五、错误剪枝和不可撤销行动限制迁移
- 六、让搜索选择与题目难度、剩余预算一起决策
- 自测与答案
段落怎样重新安排
- 背景与问题定义:搜索什么,不搜索什么? → 完整轨迹投票之外,怎样在错误前缀上提前止损
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:错误的第一步,可能让后面全白写 → 错误剪枝和不可撤销行动限制迁移
把结果及能力限制留到证据或边界中解释
- 一分钟理解:错误的第一步,可能让后面全白写 → 错误剪枝和不可撤销行动限制迁移
把结果及能力限制留到证据或边界中解释
- 一分钟理解:错误的第一步,可能让后面全白写 → 错误剪枝和不可撤销行动限制迁移
把结果及能力限制留到证据或边界中解释
- 一分钟理解:错误的第一步,可能让后面全白写 → 让搜索选择与题目难度、剩余预算一起决策
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:生成器、评价器与搜索控制器 → 定义想法状态、启发式评价与宽深预算
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:生成器、评价器与搜索控制器 → 定义想法状态、启发式评价与宽深预算
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:生成器、评价器与搜索控制器 → 用搜索控制器生成、剪枝和回溯部分解
单列可执行步骤,与机制论证及经验结果区分
- 方法:生成器、评价器与搜索控制器 → 用搜索控制器生成、剪枝和回溯部分解
保留实现限制、训练协议及指标接口
- 实验设计:三类任务,三种成功口径 → 按任务成功口径与调用预算解释搜索收益
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与五个概念 → 定义想法状态、启发式评价与宽深预算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与五个概念 → 定义想法状态、启发式评价与宽深预算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与五个概念 → 错误剪枝和不可撤销行动限制迁移
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处结果:搜索有效,但不是万能扩展器 → 按任务成功口径与调用预算解释搜索收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处结果:搜索有效,但不是万能扩展器 → 按任务成功口径与调用预算解释搜索收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处结果:搜索有效,但不是万能扩展器 → 按任务成功口径与调用预算解释搜索收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处结果:搜索有效,但不是万能扩展器 → 按任务成功口径与调用预算解释搜索收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处结果:搜索有效,但不是万能扩展器 → 按任务成功口径与调用预算解释搜索收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处结果:搜索有效,但不是万能扩展器 → 按任务成功口径与调用预算解释搜索收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处结果:搜索有效,但不是万能扩展器 → 按任务成功口径与调用预算解释搜索收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与迁移到实际任务的条件 → 错误剪枝和不可撤销行动限制迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与迁移到实际任务的条件 → 错误剪枝和不可撤销行动限制迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、局限与迁移到实际任务的条件 → 错误剪枝和不可撤销行动限制迁移
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把状态数量再展开为评价预算
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、让搜索选择与题目难度、剩余预算一起决策
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把状态数量再展开为评价预算:把状态数量再展开为评价预算
教法来源与实际阅读范围
- Lilian Weng · LLM Powered Autonomous Agents
系统组件、Planning、ReAct与Reflexion流程
原论文校准:ToT候选生成与状态评价模块;自构计数,区分状态数、采样数与API调用数。
本篇校准范围:ToT候选生成与状态评价模块;自构计数,区分状态数、采样数与API调用数。 新增段落仅用于“把状态数量再展开为评价预算”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Tree of Thoughts访问节点数与24点成功率及失败步骤分布
实验/结果图 · 必要原图摘引 · 图3,HTML #S4.F3.fig2
证据二:图3,失败位置。 作者观察到约60%的 CoT 轨迹第一步之后已经不能完成任务。这个分析解释了为什么前缀选择值得改进;它没有证明所有推理任务都在第一步损失最多,也没有把错误都归因于解码算法,模型的候选质量同样参与。 24点图同时检查搜索规模和错误类别;创作图采用不同质量评价。增加搜索的效果不能跨两种任务用同一个“正确率”解释。
- 思维树与直接输出、思维链在创意写作上的模型及人工连贯性评价
实验/结果图 · 必要原图摘引 · 图5,PDF第7页
**证据三:[图5](https://arxiv.org/html/2305.10601v2#S4.F5.fig1),写作与自修正。** 自动评分 ToT 为7.56,CoT 为6.93,直接回答6.19;人工比较41对偏好 ToT,21对偏好 CoT,38对相近。直接回答加迭代修正达到7.67,高于不加修正的 ToT;ToT 加修正为7.91。因此更准确的结论是多种推理程序可以互补,不能说树搜索在所有比较中最好。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、图3、图5、表3、表7
- 问答核查:在提示词中写“请提出三个想法并选最好的”,是否就实现了论文的 ToT等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表2 · 表2;HTML元素 #S4.F3.fig1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S4.F3.fig2
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5.fig1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.F5.fig2
原站图表/证明入口
- 表7 · 表7;HTML元素 #A2.T7
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导束搜索状态预算及适用条件
- 新增不可逆误剪的可核算反例
- 明确与完整轨迹投票及后续计算分配的方向关系
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、图3、图5、表3、表7
- v2:问答核查:在提示词中写“请提出三个想法并选最好的”,是否就实现了论文的 ToT等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
方法中的状态生成/评价、Algorithm 1 BFS及DFS控制;基于算法自构预算与误剪反例
技术关系
- 053-cot · 直接继承
把语言中间步骤扩展为搜索状态
- 056-self-consistency · 平行方法
完成轨迹投票与中途状态搜索比较
- 091-test-time-scaling · 教学联系
从固定搜索转向按难度分配计算
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:查询头保留多样性时,怎样减少历史KV搬运
- 二、定义分组共享并分析均值初始化的非等价性
- 三、转换检查点并继续训练以适应共享约束
- 四、同时读取组数、质量恢复和计时单位
- 五、缓存四倍压缩不保证整体四倍加速
- 六、把缓存共享结构与内核、分页组合
- 自测与答案
段落怎样重新安排
- 背景:MHA、MQA 和 GQA 到底共享什么? → 查询头保留多样性时,怎样减少历史KV搬运
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解:生成一个词,也要搬动很多旧信息 → 缓存四倍压缩不保证整体四倍加速
把结果及能力限制留到证据或边界中解释
- 一分钟理解:生成一个词,也要搬动很多旧信息 → 缓存四倍压缩不保证整体四倍加速
把结果及能力限制留到证据或边界中解释
- 一分钟理解:生成一个词,也要搬动很多旧信息 → 缓存四倍压缩不保证整体四倍加速
把结果及能力限制留到证据或边界中解释
- 一分钟理解:生成一个词,也要搬动很多旧信息 → 把缓存共享结构与内核、分页组合
真实关系移到后继路线,避免目录相邻等于技术继承
- 背景:MHA、MQA 和 GQA 到底共享什么? → 定义分组共享并分析均值初始化的非等价性
保留完整公式和事实约束
- 方法:分组平均不是精确等价变换 → 定义分组共享并分析均值初始化的非等价性
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:分组平均不是精确等价变换 → 转换检查点并继续训练以适应共享约束
单列可执行步骤,与机制论证及经验结果区分
- 方法:分组平均不是精确等价变换 → 转换检查点并继续训练以适应共享约束
保留实现限制、训练协议及指标接口
- 缓存为什么会变小,为什么速度不按比例增长? → 定义分组共享并分析均值初始化的非等价性
保留完整公式和事实约束
- 缓存为什么会变小,为什么速度不按比例增长? → 定义分组共享并分析均值初始化的非等价性
保留原推导
- 实验:质量比较和性能测量分别控制了什么? → 同时读取组数、质量恢复和计时单位
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构算例与五个前置概念 → 定义分组共享并分析均值初始化的非等价性
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构算例与五个前置概念 → 缓存四倍压缩不保证整体四倍加速
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:四条证据与一个尚未解释的现象 → 同时读取组数、质量恢复和计时单位
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:四条证据与一个尚未解释的现象 → 同时读取组数、质量恢复和计时单位
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:四条证据与一个尚未解释的现象 → 同时读取组数、质量恢复和计时单位
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:四条证据与一个尚未解释的现象 → 同时读取组数、质量恢复和计时单位
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:四条证据与一个尚未解释的现象 → 同时读取组数、质量恢复和计时单位
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:四条证据与一个尚未解释的现象 → 同时读取组数、质量恢复和计时单位
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:四条证据与一个尚未解释的现象 → 同时读取组数、质量恢复和计时单位
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:一条可复用的系统设计轴 → 缓存四倍压缩不保证整体四倍加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:一条可复用的系统设计轴 → 缓存四倍压缩不保证整体四倍加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:一条可复用的系统设计轴 → 缓存四倍压缩不保证整体四倍加速
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 共享键值仍允许两颗查询头读出不同内容
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把缓存共享结构与内核、分页组合
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 共享键值仍允许两颗查询头读出不同内容:共享键值仍允许两颗查询头读出不同内容
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:GQA共享K/V而保留独立query;二维例只解释头差异,原缩放保持共同常数不影响结论。
本篇校准范围:GQA共享K/V而保留独立query;二维例只解释头差异,原缩放保持共同常数不影响结论。 新增段落仅用于“共享键值仍允许两颗查询头读出不同内容”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:4 幅
- GQA、MQA和MHA模型的平均质量与单样本推理时间折中
实验/结果图 · 必要原图摘引 · 图3,PDF第3页
证据一:表1与图3,主要折中。 MHA-XXL、MQA-XXL、GQA-8-XXL 的平均分分别47.2、46.6、47.1;时间1.51、0.24、0.28秒。按表内时间自行计算,MHA/GQA约为5.39倍;这个比值仅适用于该测量。GQA 比 MQA 略慢,但平均分更接近 MHA。 质量—延迟图以每样本平均推理时间为横轴;组数图固定输入2048、输出512。更换生成长度后,不能直接搬用这条延迟比例。
- GQA从多头注意力检查点转换时均值、首头及随机初始化的表现
实验/结果图 · 必要原图摘引 · 图4,PDF第4页
**证据三:[图4](https://arxiv.org/html/2305.13245v3#S3.F4)与[图5](https://arxiv.org/html/2305.13245v3#S3.F5),转换和恢复。** 平均原始头的初始化优于保留单头和随机初始化;5%继续训练帮助 MQA 与 GQA,增加到10%的收益递减。这支持“保留已有表示再适配”的路线;图中趋势不能证明5%是其他模型、数据或组数上的最优比例。
- GQA和MQA继续训练比例与下游表现的关系
实验/结果图 · 必要原图摘引 · 图5,PDF第4页
**证据三:[图4](https://arxiv.org/html/2305.13245v3#S3.F4)与[图5](https://arxiv.org/html/2305.13245v3#S3.F5),转换和恢复。** 平均原始头的初始化优于保留单头和随机初始化;5%继续训练帮助 MQA 与 GQA,增加到10%的收益递减。这支持“保留已有表示再适配”的路线;图中趋势不能证明5%是其他模型、数据或组数上的最优比例。
- GQA分组数增加时每个样本的推理时间
实验/结果图 · 必要原图摘引 · 图6,PDF第4页
**证据四:[图6](https://arxiv.org/html/2305.13245v3#S3.F6),组数。** 在输入2048、输出512的配置下,从1组增加到8组的时间开销较小,接近 MHA 时增加更明显。8组是作者选择的实用折中,不能因为一个后来的模型也使用8个 KV 头,就认为已经得到普适理论常数。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。;v3原稿图3横轴标ms而表1时间列标s,相同数值存在单位标注差异;正文明确按表1引用秒数。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图3、图4、图5、图6
- 问答核查:同组查询头共享 K 和 V,为什么输出仍然可以不同等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S3.F3
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 图6 · 图6;HTML元素 #S3.F6
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 给出softmax与均值不交换的数值反例
- 新增严格区分缓存与总显存的GiB核算
- 区分GQA、FlashAttention和vLLM的组合层级
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图3、图4、图5、图6
- v2:问答核查:同组查询头共享 K 和 V,为什么输出仍然可以不同等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
- 对照原稿图3与表1,标明ms/s单位不一致;保留原图标记,不擅自更改坐标。
查核资料
- arxiv.org · 所列章节
§2.2 GQA分组、K/V均值池化与uptraining;缓存按KV组数缩减
技术关系
- 015-transformer · 直接继承
改变多头注意力的KV共享结构
- 059-flashattention · 模块组合
共享头结构可与高效注意力内核组合
- 079-vllm · 模块组合
更小KV状态可继续采用分页分配
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型QLoRA: Efficient Finetuning of Quantized LLMs部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:LoRA更新很小,怎样让庞大冻结基座也放进显存
- 二、分开NF4权重代码、量化常数与高精度计算
- 三、保持梯度穿过基座并管理激活与分页峰值
- 四、按位格式、对照模型和评委口径检验质量
- 五、任务适配与量化补偿仍受数据和运行成本限制
- 六、区分适配时低位基座与部署量化路线
- 自测与答案
段落怎样重新安排
- 背景:冻结权重仍然需要参与反向传播 → LoRA更新很小,怎样让庞大冻结基座也放进显存
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:参数很少,基座依然很大 → 任务适配与量化补偿仍受数据和运行成本限制
把结果及能力限制留到证据或边界中解释
- 一分钟理解:参数很少,基座依然很大 → 任务适配与量化补偿仍受数据和运行成本限制
把结果及能力限制留到证据或边界中解释
- 一分钟理解:参数很少,基座依然很大 → 任务适配与量化补偿仍受数据和运行成本限制
把结果及能力限制留到证据或边界中解释
- 一分钟理解:参数很少,基座依然很大 → 区分适配时低位基座与部署量化路线
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:NF4、双重量化和分页分别解决哪一项? → 分开NF4权重代码、量化常数与高精度计算
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:NF4、双重量化和分页分别解决哪一项? → 分开NF4权重代码、量化常数与高精度计算
将原来的后置推导提前,解释伪代码为何这样计算
- 方法:NF4、双重量化和分页分别解决哪一项? → 保持梯度穿过基座并管理激活与分页峰值
单列可执行步骤,与机制论证及经验结果区分
- 方法:NF4、双重量化和分页分别解决哪一项? → 保持梯度穿过基座并管理激活与分页峰值
保留实现限制、训练协议及指标接口
- 实验设计:区分精度恢复实验与聊天能力实验 → 按位格式、对照模型和评委口径检验质量
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个算例与五个前置概念 → 分开NF4权重代码、量化常数与高精度计算
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个算例与五个前置概念 → 保持梯度穿过基座并管理激活与分页峰值
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个算例与五个前置概念 → 任务适配与量化补偿仍受数据和运行成本限制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:五处证据比“99.3% ChatGPT”更有用 → 按位格式、对照模型和评委口径检验质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据比“99.3% ChatGPT”更有用 → 按位格式、对照模型和评委口径检验质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据比“99.3% ChatGPT”更有用 → 按位格式、对照模型和评委口径检验质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据比“99.3% ChatGPT”更有用 → 按位格式、对照模型和评委口径检验质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据比“99.3% ChatGPT”更有用 → 按位格式、对照模型和评委口径检验质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据比“99.3% ChatGPT”更有用 → 按位格式、对照模型和评委口径检验质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处证据比“99.3% ChatGPT”更有用 → 按位格式、对照模型和评委口径检验质量
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:省出的资源应该怎样使用? → 任务适配与量化补偿仍受数据和运行成本限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:省出的资源应该怎样使用? → 任务适配与量化补偿仍受数据和运行成本限制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 冻结量化基座后的反向还需要哪些数值
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、区分适配时低位基座与部署量化路线
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 冻结量化基座后的反向还需要哪些数值:冻结量化基座后的反向还需要哪些数值
教法来源与实际阅读范围
- Sourab Mangrulkar、Sayak Paul · Parameter-Efficient Fine-Tuning
Motivation、可训练参数统计、增量保存与加载
原论文校准:QLoRA冻结量化骨干、通过反量化运算向LoRA反传;讨论近似存储值而非原FP16权重的精确恢复。
本篇校准范围:QLoRA冻结量化骨干、通过反量化运算向LoRA反传;讨论近似存储值而非原FP16权重的精确恢复。 新增段落仅用于“冻结量化基座后的反向还需要哪些数值”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- 不同四位量化格式的平均困惑度,包括NF4加双重量化
实验/结果图 · 必要原图摘引 · 表2,PDF第7页
证据一:表2,位格式比较。 跨模型平均困惑度 Int4为34.34,FP4 E2M1为31.07,FP4 E3M0为29.48,NF4+DQ为27.41。越低越好。它支持所测试权重分布下 NF4 的优势;这是跨配置聚合,不是单个65B模型的困惑度,也不直接证明聊天质量提升同样大。
- QLoRA不同可训练模块与四位、十六位配置的ROUGE-L对照
实验/结果图 · 必要原图摘引 · 图2,PDF第6页
损失还是交叉熵,量化不是新任务目标。LoRA 覆盖位置是一项关键训练设计:原文[图2](https://arxiv.org/html/2305.14314v1#S4.F2)发现只放在 query/value 投影不足,覆盖 Transformer 线性层更接近较强16位基线。不能只比较位宽,却把适配器覆盖范围也悄悄改变。 每个散点是一组随机种子的训练结果;[图2](https://arxiv.org/html/2305.14314v1#S4.F2)以 Alpaca 的 RougeL 比较配置,只能支持该任务和适配层覆盖下的质量比较。
未在正文展示的图/表与范围
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图2、表9、表2、表3、表4、表5、表6、表7
- 问答核查:基座被冻结,为什么不能把整个基座前向都放在 no_grad 中等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 图2 · 图2;HTML元素 #S4.F2
原站图表/证明入口
- 表9 · 表9;HTML元素 #A2.T9
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S5.T6
原站图表/证明入口
- 表7 · 表7;HTML元素 #S5.T7
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导双重量化常数的每参数位宽
- 新增16384权重完整分块字节账本
- 区分存储精度计算精度和训练峰值显存
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图2、表9、表2、表3、表4、表5、表6、表7
- v2:问答核查:基座被冻结,为什么不能把整个基座前向都放在 no_grad 中等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3 NF4、Double Quantization中的64/256分组及存储开销;Paged Optimizers
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Direct Preference Optimization: Your Language Model is Secretly a Reward Model部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:已有偏好对时,怎样直接训练策略而不再拟合奖励网络
- 二、从KL正则最优策略消去成对损失中的配分函数
- 三、用参考校正的概率差执行离线更新
- 四、分开受控奖励前沿与模型、人类摘要评价
- 五、成对优势未决定未覆盖回答与绝对赢家概率
- 六、把偏好标签来源与优化算法作为独立设计轴
- 自测与答案
段落怎样重新安排
- 背景:偏好学习并不直接告诉你绝对奖励 → 已有偏好对时,怎样直接训练策略而不再拟合奖励网络
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解:能不能省掉“先打分,再强化学习”? → 成对优势未决定未覆盖回答与绝对赢家概率
把结果及能力限制留到证据或边界中解释
- 一分钟理解:能不能省掉“先打分,再强化学习”? → 成对优势未决定未覆盖回答与绝对赢家概率
把结果及能力限制留到证据或边界中解释
- 一分钟理解:能不能省掉“先打分,再强化学习”? → 成对优势未决定未覆盖回答与绝对赢家概率
把结果及能力限制留到证据或边界中解释
- 一分钟理解:能不能省掉“先打分,再强化学习”? → 把偏好标签来源与优化算法作为独立设计轴
真实关系移到后继路线,避免目录相邻等于技术继承
- 背景:偏好学习并不直接告诉你绝对奖励 → 从KL正则最优策略消去成对损失中的配分函数
保留完整公式和事实约束
- 方法推导:归一化项怎样消失? → 从KL正则最优策略消去成对损失中的配分函数
先给出信息路径、目标与机制,再讨论执行顺序
- 方法推导:归一化项怎样消失? → 用参考校正的概率差执行离线更新
单列可执行步骤,与机制论证及经验结果区分
- 方法推导:归一化项怎样消失? → 用参考校正的概率差执行离线更新
保留实现限制、训练协议及指标接口
- 理论究竟保证什么? → 从KL正则最优策略消去成对损失中的配分函数
保留完整公式和事实约束
- 理论究竟保证什么? → 从KL正则最优策略消去成对损失中的配分函数
保留原推导
- 实验如何区分优化能力与实际偏好? → 分开受控奖励前沿与模型、人类摘要评价
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个概率例子与五个前置概念 → 从KL正则最优策略消去成对损失中的配分函数
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个概率例子与五个前置概念 → 从KL正则最优策略消去成对损失中的配分函数
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个概率例子与五个前置概念 → 成对优势未决定未覆盖回答与绝对赢家概率
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:五处应该保留的证据 → 分开受控奖励前沿与模型、人类摘要评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处应该保留的证据 → 分开受控奖励前沿与模型、人类摘要评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处应该保留的证据 → 分开受控奖励前沿与模型、人类摘要评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处应该保留的证据 → 分开受控奖励前沿与模型、人类摘要评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处应该保留的证据 → 分开受控奖励前沿与模型、人类摘要评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五处应该保留的证据 → 分开受控奖励前沿与模型、人类摘要评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 成对优势未决定未覆盖回答与绝对赢家概率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 成对优势未决定未覆盖回答与绝对赢家概率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 同一问题的常数抵消只发生在同一条件下
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把偏好标签来源与优化算法作为独立设计轴
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 同一问题的常数抵消只发生在同一条件下:同一问题的常数抵消只发生在同一条件下
教法来源与实际阅读范围
- Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla · Illustrating Reinforcement Learning from Human Feedback
三阶段训练、偏好排名、奖励模型、RL/KL及同一响应送入冻结参考的图示澄清
原论文校准:DPO奖励等价类及问题条件配分函数;数字常数自构,偏好对条件检查来自原推导。
本篇校准范围:DPO奖励等价类及问题条件配分函数;数字常数自构,偏好对条件检查来自原推导。 新增段落仅用于“同一问题的常数抵消只发生在同一条件下”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- DPO的情感生成奖励与KL折中及摘要偏好胜率随采样温度变化
实验/结果图 · 必要原图摘引 · 图2,HTML #S6.F2
证据一:图2左,奖励—KL前沿。 DPO在该情感实验中以较低偏离取得更高分类器奖励,甚至优于直接获得分类器奖励的 PPO-GT 配置。它支持这组实现中优化方式有效,不证明分类器奖励与电影评论真实质量完全一致,也不证明PPO在理论上达不到同一前沿。 左侧是期望奖励与相对参考策略的 KL 前沿,右侧是 GPT-4 评审的摘要胜率。前者的受控优化证据和后者的模型评审证据应分开判断。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、图2、表1、表3
- 问答核查:DPO 不训练独立奖励网络,为什么仍然可以谈“隐式奖励”等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表2 · 表2;HTML元素 #S6.T2
原站图表/证明入口
- 图2 · 图2;HTML元素 #S6.F2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S6.T1
原站图表/证明入口
- 表3 · 表3;HTML元素 #A3.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 新增三答案等损失反例说明概率质量转移
- 量化正确和错误偏好对的局部梯度权重
- 前置区分反馈来源与策略优化算法
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、图2、表1、表3
- v2:问答核查:DPO 不训练独立奖励网络,为什么仍然可以谈“隐式奖励”等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§4最优策略重参数化与成对损失;基于式7分析梯度权重及有限偏好覆盖
技术关系
- 054-instructgpt · 平行方法
对同类偏好目标采用离线重参数化而非在线PPO
- 080-rlaif · 模块组合
AI反馈可作为离线偏好数据来源
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同样舍入误差,为何不同激活通道影响不同
- 二、由输出敏感度推导缩放与逆缩放的量化作用
- 三、校准通道尺度、裁剪并匹配统一低位内核
- 四、依次检验重要通道、缩放范围与真实解码速度
- 五、校准偏移、元数据和负载仍会改变收益
- 六、压缩权重后继续检查KV与调度瓶颈
- 自测与答案
段落怎样重新安排
- 背景:权重量化与激活量化不是一回事 → 同样舍入误差,为何不同激活通道影响不同
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:同样的权重误差,后果不一样 → 校准偏移、元数据和负载仍会改变收益
把结果及能力限制留到证据或边界中解释
- 一分钟理解:同样的权重误差,后果不一样 → 校准偏移、元数据和负载仍会改变收益
把结果及能力限制留到证据或边界中解释
- 一分钟理解:同样的权重误差,后果不一样 → 校准偏移、元数据和负载仍会改变收益
把结果及能力限制留到证据或边界中解释
- 一分钟理解:同样的权重误差,后果不一样 → 压缩权重后继续检查KV与调度瓶颈
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:先作等价变换,再接受量化近似 → 由输出敏感度推导缩放与逆缩放的量化作用
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:先作等价变换,再接受量化近似 → 校准通道尺度、裁剪并匹配统一低位内核
单列可执行步骤,与机制论证及经验结果区分
- 方法:先作等价变换,再接受量化近似 → 校准通道尺度、裁剪并匹配统一低位内核
保留实现限制、训练协议及指标接口
- 三个容易混淆的“优化” → 由输出敏感度推导缩放与逆缩放的量化作用
保留完整公式和事实约束
- 三个容易混淆的“优化” → 由输出敏感度推导缩放与逆缩放的量化作用
保留原推导
- 实验设置:质量、校准与系统分别测量 → 依次检验重要通道、缩放范围与真实解码速度
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与五个概念 → 由输出敏感度推导缩放与逆缩放的量化作用
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与五个概念 → 由输出敏感度推导缩放与逆缩放的量化作用
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与五个概念 → 校准偏移、元数据和负载仍会改变收益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:五组证据构成完整链条 → 依次检验重要通道、缩放范围与真实解码速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五组证据构成完整链条 → 依次检验重要通道、缩放范围与真实解码速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五组证据构成完整链条 → 依次检验重要通道、缩放范围与真实解码速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五组证据构成完整链条 → 依次检验重要通道、缩放范围与真实解码速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五组证据构成完整链条 → 依次检验重要通道、缩放范围与真实解码速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五组证据构成完整链条 → 依次检验重要通道、缩放范围与真实解码速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:五组证据构成完整链条 → 依次检验重要通道、缩放范围与真实解码速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:高质量压缩需要与运行时一起设计 → 校准偏移、元数据和负载仍会改变收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:高质量压缩需要与运行时一起设计 → 校准偏移、元数据和负载仍会改变收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:高质量压缩需要与运行时一起设计 → 校准偏移、元数据和负载仍会改变收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 等价缩放后,量化步长为什么仍会牵连其它通道
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、压缩权重后继续检查KV与调度瓶颈
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 由输出敏感度推导缩放与逆缩放的量化作用:将多处组步长警告合为含Delta的单次推导,连接缩放2/4消融,保留一个完整敏感度反例。
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:AWQ分组量化与通道缩放;此为步长耦合解释,原表数值和因果边界保持。
本篇校准范围:AWQ分组量化与通道缩放;此为步长耦合解释,原表数值和因果边界保持。 新增段落仅用于“等价缩放后,量化步长为什么仍会牵连其它通道”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- AWQ对量化校准样本数量及校准语料分布的敏感度
实验/结果图 · 必要原图摘引 · 图6,HTML #S3.F6
证据五:图6与图5,分布和真实速度。 PubMed/Enron交叉校准时,AWQ困惑度增加约0.5—0.6,对照GPTQ增加2.3—4.9;这支持有限跨域稳健性。速度实验中4090报告2.7—3.9倍加速,4070上的13B达到33 token/s,但测量是极短提示、单请求解码,不能推广到长提示预填充或高并发服务。 校准图左侧改变校准样本量,右侧改变校准与测试分布;该消融使用 OPT-6.7B、INT3-g128,不能直接推广成所有四位模型的统一误差。
- AWQ在三种GPU和不同模型上的实测解码速度及内存不足情况
实验/结果图 · 必要原图摘引 · 图5,PDF第8页
**证据五:[图6](https://arxiv.org/html/2306.00978v2#S3.F6)与[图5](https://arxiv.org/html/2306.00978v2#S3.F5),分布和真实速度。** PubMed/Enron交叉校准时,AWQ困惑度增加约0.5—0.6,对照GPTQ增加2.3—4.9;这支持有限跨域稳健性。速度实验中4090报告2.7—3.9倍加速,4070上的13B达到33 token/s,但测量是极短提示、单请求解码,不能推广到长提示预填充或高并发服务。 校准图左侧改变校准样本量,右侧改变校准与测试分布;该消融使用 OPT-6.7B、INT3-g128,不能直接推广成所有四位模型的统一误差。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、表1、表3、表4、表5、图6、图5、表6
- 问答核查:AWQ 名称里有 activation,是否说明它把激活也变成4位等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表2 · 表2;HTML元素 #S2.T2
原站图表/证明入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S2.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S3.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S3.T5
原站图表/证明入口
- 图6 · 图6;HTML元素 #S3.F6
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S3.T6
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 由线性层输出推导激活加权误差上界
- 新增校准分布反转的敏感度例子
- 区分权重量化与缓存调度瓶颈
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、表1、表3、表4、表5、图6、图5、表6
- v2:问答核查:AWQ 名称里有 activation,是否说明它把激活也变成4位等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3激活感知通道缩放、量化步长变化与误差分析
技术关系
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Lost in the Middle: How Language Models Use Long Contexts部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:答案已经进入窗口,模型能否同样使用各个位置
- 二、把位置效应写成配对评测而不是长度标签
- 三、固定内容、证据与干扰,再单独移动位置
- 四、联合读取位置曲线、扩容对照与检索饱和
- 五、单证据诊断不能代表全部长上下文推理
- 六、把证据放置与检索召回、读者准确率联测
- 自测与答案
段落怎样重新安排
- 背景:长度、位置和相关性要分别控制 → 答案已经进入窗口,模型能否同样使用各个位置
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:把同一条证据搬到中间,再问一次 → 单证据诊断不能代表全部长上下文推理
把结果及能力限制留到证据或边界中解释
- 一分钟理解:把同一条证据搬到中间,再问一次 → 单证据诊断不能代表全部长上下文推理
把结果及能力限制留到证据或边界中解释
- 一分钟理解:把同一条证据搬到中间,再问一次 → 单证据诊断不能代表全部长上下文推理
把结果及能力限制留到证据或边界中解释
- 一分钟理解:把同一条证据搬到中间,再问一次 → 把证据放置与检索召回、读者准确率联测
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:这里的“算法”是评测程序 → 把位置效应写成配对评测而不是长度标签
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:这里的“算法”是评测程序 → 固定内容、证据与干扰,再单独移动位置
单列可执行步骤,与机制论证及经验结果区分
- 方法:这里的“算法”是评测程序 → 固定内容、证据与干扰,再单独移动位置
保留实现限制、训练协议及指标接口
- 实验设计:包含什么,不包含什么? → 联合读取位置曲线、扩容对照与检索饱和
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子与五个前置概念 → 固定内容、证据与干扰,再单独移动位置
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与五个前置概念 → 把位置效应写成配对评测而不是长度标签
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子与五个前置概念 → 单证据诊断不能代表全部长上下文推理
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五处证据:U形是观察,不是不可改变的规律 → 联合读取位置曲线、扩容对照与检索饱和
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:U形是观察,不是不可改变的规律 → 联合读取位置曲线、扩容对照与检索饱和
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:U形是观察,不是不可改变的规律 → 联合读取位置曲线、扩容对照与检索饱和
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:U形是观察,不是不可改变的规律 → 联合读取位置曲线、扩容对照与检索饱和
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:U形是观察,不是不可改变的规律 → 联合读取位置曲线、扩容对照与检索饱和
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:U形是观察,不是不可改变的规律 → 联合读取位置曲线、扩容对照与检索饱和
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五处证据:U形是观察,不是不可改变的规律 → 联合读取位置曲线、扩容对照与检索饱和
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:如何从诊断走向改进? → 单证据诊断不能代表全部长上下文推理
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:如何从诊断走向改进? → 单证据诊断不能代表全部长上下文推理
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:如何从诊断走向改进? → 单证据诊断不能代表全部长上下文推理
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献与局限:如何从诊断走向改进? → 单证据诊断不能代表全部长上下文推理
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 把位置对照做成同题配对而非换题均值
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把证据放置与检索召回、读者准确率联测
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 把位置对照做成同题配对而非换题均值:把位置对照做成同题配对而非换题均值
原论文校准与展开范围
原论文校准:Lost in the Middle控制证据位置的评测设计;是原协议的操作性展开,不新增机制成因结论。
本篇校准范围:Lost in the Middle控制证据位置的评测设计;是原协议的操作性展开,不新增机制成因结论。 新增段落仅用于“把位置对照做成同题配对而非换题均值”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:6 幅
- Lost in the Middle中答案证据位置改变时的问答准确率
实验/结果图 · 必要原图摘引 · 图5,HTML #S2.F5
证据一:附录表6与主图5,位置改变导致下降。 GPT-3.5在20文档中第一位75.8%、第十位53.8%、末位63.2%,最佳到最低差22.0个百分点,由表值相减。closed-book为56.1%,所以中间条件甚至比不提供文档低2.3个百分点。它支持干扰与位置可能损害使用证据的能力,不证明相关文档没有任何贡献,因为模型也可能被其他材料误导。 位置曲线横轴是证据在输入中的位置,数值越小越靠前;比较中间与两端时,要固定总文档数与任务,避免把长度变化当作纯位置效应。
- 三种上下文长度下键值检索准确率对答案位置的敏感度
实验/结果图 · 必要原图摘引 · 图7,PDF第7页
**证据三:[图7](https://arxiv.org/html/2307.03172v3#S3.F7)、[图9](https://arxiv.org/html/2307.03172v3#S4.F9)与§4.2,简单检索和自然问答不同。** 把查询放到材料前后,GPT-3.5-16K在300键值对任务达到完美表现,而原设置最低45.6%;自然问答的位置趋势却没有显著解决。它排除了“前面重复问题总能修好长文档理解”的过度结论,也说明模型需要在何时知道查找目标会影响行为。
- 把查询放入文档上下文后检索问答准确率随答案位置变化
实验/结果图 · 必要原图摘引 · 图9,PDF第8页
**证据三:[图7](https://arxiv.org/html/2307.03172v3#S3.F7)、[图9](https://arxiv.org/html/2307.03172v3#S4.F9)与§4.2,简单检索和自然问答不同。** 把查询放到材料前后,GPT-3.5-16K在300键值对任务达到完美表现,而原设置最低45.6%;自然问答的位置趋势却没有显著解决。它排除了“前面重复问题总能修好长文档理解”的过度结论,也说明模型需要在何时知道查找目标会影响行为。
- 编码器解码器模型在不同文档数量及答案位置上的问答表现
实验/结果图 · 必要原图摘引 · 图8,PDF第8页
**证据四:[图8](https://arxiv.org/html/2307.03172v3#S4.F8)、[图10](https://arxiv.org/html/2307.03172v3#S4.F10)与附录E,成因不唯一。** Flan-UL2在2048训练长度内最佳与最差差1.9个百分点,超出后开始出现中部下降;MPT基础模型和指令模型都有相关趋势。Llama2-7B主要偏向结尾,13B和70B才呈明显两端优势。因此不能把现象只归因于指令微调,也不能声称所有模型曲线必然严格U形。
- 基础MPT与指令版MPT的答案位置敏感度对照
实验/结果图 · 必要原图摘引 · 图10,PDF第9页
**证据四:[图8](https://arxiv.org/html/2307.03172v3#S4.F8)、[图10](https://arxiv.org/html/2307.03172v3#S4.F10)与附录E,成因不唯一。** Flan-UL2在2048训练长度内最佳与最差差1.9个百分点,超出后开始出现中部下降;MPT基础模型和指令模型都有相关趋势。Llama2-7B主要偏向结尾,13B和70B才呈明显两端优势。因此不能把现象只归因于指令微调,也不能声称所有模型曲线必然严格U形。
- 检索文档数增加时检索器召回和各语言模型问答效果的不同变化
实验/结果图 · 必要原图摘引 · 图11,PDF第10页
**证据五:[图11](https://arxiv.org/html/2307.03172v3#S5.F11),更多检索不等于更多正确答案。** 检索召回随文档数增加,但读者成绩先趋于饱和;从20增至50篇,GPT-3.5仅约提高1.5个百分点,Claude约1个百分点。它说明端到端收益受读者限制,不能只追求Recall@k。不过新增材料也可能对特定问题很有价值,平均饱和不意味着应对每道题都硬性只取20篇。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表6、图5、表1、图7、图9、图8、图10、图11
- 问答核查:为什么“所有位置准确率都一样”仍不足以证明长上下文能力强等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表6 · 表6;HTML元素 #A7.T6
原站图表/证明入口
- 图5 · 图5;HTML元素 #S2.F5
原站图表/证明入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 图7 · 图7;HTML元素 #S3.F7
原站图表/证明入口
- 图9 · 图9;HTML元素 #S4.F9
原站图表/证明入口
- 图8 · 图8;HTML元素 #S4.F8
原站图表/证明入口
- 图10 · 图10;HTML元素 #S4.F10
原站图表/证明入口
- 图11 · 图11;HTML元素 #S5.F11
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 新增配对差估计与相关性解释
- 构造五题位置交换例子避免群体均值单调误读
- 区分文档序号token偏移与总长度
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表6、图5、表1、图7、图9、图8、图10、图11
- v2:问答核查:为什么“所有位置准确率都一样”仍不足以证明长上下文能力强等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3多文档QA的gold文档、干扰文档与位置控制;由实验设计引出的配对诊断
技术关系
- 033-longformer · 教学联系
计算窗口扩大不保证证据可用
- 046-rope · 教学联系
位置表示与位置鲁棒性不同
- 034-rag · 模块组合
检索生成管线需要位置敏感性诊断
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Llama 2: Open Foundation and Fine-Tuned Chat Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:基础续写怎样接成可持续修正的聊天训练闭环
- 二、区分预训练、示范和带偏好强度的奖励学习
- 三、交替更新候选、奖励和策略并维护对话约束
- 四、分别读取基础能力、偏好难度与胜平负
- 五、安全偏好与有用性代理仍需独立人评
- 六、比较同类偏好数据的另一种优化路径
- 自测:能否区分系统里的三个目标
段落怎样重新安排
- 问题定义:对齐的对象究竟是什么 → 基础续写怎样接成可持续修正的聊天训练闭环
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:模型会续写,不等于它会合作 → 安全偏好与有用性代理仍需独立人评
把结果及能力限制留到证据或边界中解释
- 一分钟理解:模型会续写,不等于它会合作 → 安全偏好与有用性代理仍需独立人评
把结果及能力限制留到证据或边界中解释
- 一分钟理解:模型会续写,不等于它会合作 → 比较同类偏好数据的另一种优化路径
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:基础模型之上还有三个训练层次 → 区分预训练、示范和带偏好强度的奖励学习
保留原推导
- 方法:基础模型之上还有三个训练层次 → 区分预训练、示范和带偏好强度的奖励学习
保留原推导
- 方法:基础模型之上还有三个训练层次 → 区分预训练、示范和带偏好强度的奖励学习
保留原推导
- 方法:基础模型之上还有三个训练层次 → 区分预训练、示范和带偏好强度的奖励学习
保留原推导
- 方法:基础模型之上还有三个训练层次 → 区分预训练、示范和带偏好强度的奖励学习
保留原推导
- 实验设计与资源口径 → 分别读取基础能力、偏好难度与胜平负
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、限制与一个教学例子 → 区分预训练、示范和带偏好强度的奖励学习
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、限制与一个教学例子 → 安全偏好与有用性代理仍需独立人评
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、限制与一个教学例子 → 安全偏好与有用性代理仍需独立人评
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、限制与一个教学例子 → 交替更新候选、奖励和策略并维护对话约束
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、限制与一个教学例子 → 安全偏好与有用性代理仍需独立人评
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据:比较了什么,又没有证明什么 → 分别读取基础能力、偏好难度与胜平负
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:比较了什么,又没有证明什么 → 分别读取基础能力、偏好难度与胜平负
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:比较了什么,又没有证明什么 → 分别读取基础能力、偏好难度与胜平负
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:比较了什么,又没有证明什么 → 分别读取基础能力、偏好难度与胜平负
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:比较了什么,又没有证明什么 → 分别读取基础能力、偏好难度与胜平负
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 将平局保留或剔除,会得到哪两个数
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、比较同类偏好数据的另一种优化路径
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 将平局保留或剔除,会得到哪两个数:将平局保留或剔除,会得到哪两个数
教法来源与实际阅读范围
- Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla · Illustrating Reinforcement Learning from Human Feedback
三阶段训练、偏好排名、奖励模型、RL/KL及同一响应送入冻结参考的图示澄清
原论文校准:Llama 2原图12胜平负与正文比例;52.6%由已有数值自行计算,不替换原论文口径。
本篇校准范围:Llama 2原图12胜平负与正文比例;52.6%由已有数值自行计算,不替换原论文口径。 新增段落仅用于“将平局保留或剔除,会得到哪两个数”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- Llama 2 Chat相对多个模型的单轮和多轮人工胜平负比例
实验/结果图 · 必要原图摘引 · 图12,HTML #S3.F12
证据三|图12 与 §3.4.2:平局会改变“胜率”的理解。 70B 对所用 ChatGPT 版本胜出 36%,平局 31.5%。剩余失败率为 $100-36-31.5=32.5\%$,这是自行计算。它说明本提示集上双方较接近;既不是 67.5% 严格胜率,也不是解决了 67.5% 的任务。移除平局再算比例会得到另一口径,发表结果必须说明分母。 原图分别画胜出、打平与失败,并由每题三位评价者判定;平局不是严格胜利,这组有用性提示也不覆盖全部代码与推理能力。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表11:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表6、表3、表4、表7、表8、图12、表11
- 问答核查:奖励模型分数持续上升,为什么仍需新的人类评价等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表6 · 表6;HTML元素 #S3.T6
原站图表/证明入口
- 表3 · 表3;HTML元素 #S2.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S2.T4
原站图表/证明入口
- 表7 · 表7;HTML元素 #S3.T7
原站图表/证明入口
- 表8 · 表8;HTML元素 #S3.T8
原站图表/证明入口
- 图12 · 图12;HTML元素 #S3.F12
原站图表/证明入口
- 表11 · 表11;HTML元素 #S4.T11
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导偏好强度margin对梯度的影响
- 新增相同奖励差不同强度的损失数值例
- 区分基础模型继承对齐框架和GQA模块组合
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表6、表3、表4、表7、表8、图12、表11
- v2:问答核查:奖励模型分数持续上升,为什么仍需新的人类评价等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
奖励建模章节的二元排序损失与偏好强度margin;对该目标作局部梯度教学推导
技术关系
- 068-llama · 直接继承
延续并扩展基础模型系列
- 054-instructgpt · 直接继承
承接SFT奖励建模与策略优化框架
- 073-gqa · 模块组合
部分规模采用分组查询注意力
- 075-dpo · 平行方法
另一条成对偏好优化路径
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型Efficient Memory Management for Large Language Model Serving with PagedAttention部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:生成长度未知时,怎样减少KV预留空洞和请求排队
- 二、分开注意力语义、逻辑块与物理缓存布局
- 三、按需分配并在分支共享时执行写时复制
- 四、沿服务负载与延迟约束比较可承载请求率
- 五、分页仍有尾部碎片、管理成本与容量上限
- 六、将分页与结构压缩、投机推进组合测量
- 自测:从内存图推导服务行为
段落怎样重新安排
- 背景:为什么普通连续张量在这里不够合适 → 生成长度未知时,怎样减少KV预留空洞和请求排队
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:显存里的空座位也会让请求排队 → 分页仍有尾部碎片、管理成本与容量上限
把结果及能力限制留到证据或边界中解释
- 一分钟理解:显存里的空座位也会让请求排队 → 分页仍有尾部碎片、管理成本与容量上限
把结果及能力限制留到证据或边界中解释
- 一分钟理解:显存里的空座位也会让请求排队 → 将分页与结构压缩、投机推进组合测量
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:先分清计算语义与内存布局 → 分开注意力语义、逻辑块与物理缓存布局
保留原推导
- 方法:先分清计算语义与内存布局 → 分开注意力语义、逻辑块与物理缓存布局
保留原推导
- 方法:先分清计算语义与内存布局 → 分开注意力语义、逻辑块与物理缓存布局
保留原推导
- 方法:先分清计算语义与内存布局 → 分开注意力语义、逻辑块与物理缓存布局
保留原推导
- 实验:测的是服务曲线,不是模型准确率曲线 → 沿服务负载与延迟约束比较可承载请求率
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 理解边界:分页不等于自动拥有无限上下文 → 分页仍有尾部碎片、管理成本与容量上限
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 理解边界:分页不等于自动拥有无限上下文 → 分页仍有尾部碎片、管理成本与容量上限
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 理解边界:分页不等于自动拥有无限上下文 → 分开注意力语义、逻辑块与物理缓存布局
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 理解边界:分页不等于自动拥有无限上下文 → 分页仍有尾部碎片、管理成本与容量上限
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据及其边界 → 沿服务负载与延迟约束比较可承载请求率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 沿服务负载与延迟约束比较可承载请求率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 沿服务负载与延迟约束比较可承载请求率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 沿服务负载与延迟约束比较可承载请求率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 沿服务负载与延迟约束比较可承载请求率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 沿服务负载与延迟约束比较可承载请求率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据及其边界 → 沿服务负载与延迟约束比较可承载请求率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 机制中嵌套的伪代码 → ## 三、按需分配并在分支共享时执行写时复制
修正嵌套小节造成的执行顺序,确保实现节有实质内容
- 已核原论文机制与适用的专业教法 → 一次分叉什么时候真的要复制缓存块
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、将分页与结构压缩、投机推进组合测量
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 一次分叉什么时候真的要复制缓存块:一次分叉什么时候真的要复制缓存块
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:PagedAttention块共享与copy-on-write;具体缓存行为需符合论文引用计数与分支语义。
本篇校准范围:PagedAttention块共享与copy-on-write;具体缓存行为需符合论文引用计数与分支语义。 新增段落仅用于“一次分叉什么时候真的要复制缓存块”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:7 幅
- vLLM及其他推理系统在不同模型和负载下的延迟与请求速率
实验/结果图 · 必要原图摘引 · 图12,PDF第10页
证据二|图12、图13:省出的空间转化为并发。 ShareGPT 负载下,vLLM 相比 Orca Oracle 在相近延迟下承受 1.7—2.7 倍请求速率;OPT-13B 的对应并发请求量为其 2.2 倍。它支持“更有效的缓存允许更大批量”的机制链。175B 搭配较短 Alpaca 序列时优势缩小,论文解释为容量已足够、系统逐渐转向计算瓶颈;这也给出了不应期待巨大收益的条件。
- Orca与vLLM的KV缓存中有效状态、预留空间及碎片占比
实验/结果图 · 必要原图摘引 · 图2,PDF第2页
**证据一|[图2](https://arxiv.org/html/2309.06180v1#S1.F2) 与 §3:浪费确实限制有效容量。** 作者剖析的旧系统只有 20.4%—38.2% 的 KV 分配空间实际保存 token 状态。这是在对应实验下的缓存利用率,不是 GPU 总显存利用率,更不是所有现存推理系统的共同常数。它支持先解决分配浪费的动机。 服务曲线分单序列、并行采样与 beam search;请求长度来自不同数据集。先固定工作负载和延迟要求,再比较可承载吞吐,不能只取最高倍率。
- ShareGPT与Alpaca负载下Orca和vLLM平均批处理请求数
实验/结果图 · 必要原图摘引 · 图13,PDF第10页
**证据二|[图12](https://arxiv.org/html/2309.06180v1#S5.F12)、[图13](https://arxiv.org/html/2309.06180v1#S5.F13):省出的空间转化为并发。** ShareGPT 负载下,vLLM 相比 Orca Oracle 在相近延迟下承受 1.7—2.7 倍请求速率;OPT-13B 的对应并发请求量为其 2.2 倍。它支持“更有效的缓存允许更大批量”的机制链。175B 搭配较短 Alpaca 序列时优势缩小,论文解释为容量已足够、系统逐渐转向计算瓶颈;这也给出了不应期待巨大收益的条件。
- 不同并行生成数与束宽下vLLM和Orca的延迟负载曲线
实验/结果图 · 必要原图摘引 · 图14,PDF第11页
**证据三|[图14](https://arxiv.org/html/2309.06180v1#S6.F14)、[图15](https://arxiv.org/html/2309.06180v1#S6.F15)、[图16](https://arxiv.org/html/2309.06180v1#S6.F16):共享模式影响收益。** OPT-13B、Alpaca 的 beam search 中,块共享节省 37.6%—55.2% 缓存;并行采样为 6.1%—9.8%,因为后者主要共享提示。共享前缀翻译实验中,相比 Oracle,单样例前缀为 1.67 倍吞吐,五样例前缀为 3.58 倍。这些结果支持共享长前缀的价值,不能推导成所有不同用户内容都可以互相共享。
- 并行输出数及束宽增加时共享KV块节省的内存百分比
实验/结果图 · 必要原图摘引 · 图15,PDF第11页
**证据三|[图14](https://arxiv.org/html/2309.06180v1#S6.F14)、[图15](https://arxiv.org/html/2309.06180v1#S6.F15)、[图16](https://arxiv.org/html/2309.06180v1#S6.F16):共享模式影响收益。** OPT-13B、Alpaca 的 beam search 中,块共享节省 37.6%—55.2% 缓存;并行采样为 6.1%—9.8%,因为后者主要共享提示。共享前缀翻译实验中,相比 Oracle,单样例前缀为 1.67 倍吞吐,五样例前缀为 3.58 倍。这些结果支持共享长前缀的价值,不能推导成所有不同用户内容都可以互相共享。
- 共享一个或五个示例前缀的翻译请求中vLLM与Orca的延迟
实验/结果图 · 必要原图摘引 · 图16,PDF第12页
**证据三|[图14](https://arxiv.org/html/2309.06180v1#S6.F14)、[图15](https://arxiv.org/html/2309.06180v1#S6.F15)、[图16](https://arxiv.org/html/2309.06180v1#S6.F16):共享模式影响收益。** OPT-13B、Alpaca 的 beam search 中,块共享节省 37.6%—55.2% 缓存;并行采样为 6.1%—9.8%,因为后者主要共享提示。共享前缀翻译实验中,相比 Oracle,单样例前缀为 1.67 倍吞吐,五样例前缀为 3.58 倍。这些结果支持共享长前缀的价值,不能推导成所有不同用户内容都可以互相共享。
- vLLM分页内核的上下文长度开销及块大小对端到端延迟的影响
实验/结果图 · 必要原图摘引 · 图18,PDF第12页
**证据四|[图18](https://arxiv.org/html/2309.06180v1#S7.F18):更快的系统可以包含更慢的内核。** 分页注意力内核比所比较的 FasterTransformer 内核慢 20%—26%,原因包括间接寻址和分支;端到端服务仍更好。块大小 16—128 对较长 ShareGPT 负载有效,短 Alpaca 对大块更敏感,论文实现采用 16。这里的 16 是该实现的经验折中,不是硬件无关的数学最优值。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图2、图12、图13、图14、图15、图16、图18
- 问答核查:为什么不能每块独立 softmax 后把结果相加等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
- 图2 · 图2;HTML元素 #S1.F2
原站图表/证明入口
- 图12 · 图12;HTML元素 #S5.F12
原站图表/证明入口
- 图13 · 图13;HTML元素 #S5.F13
原站图表/证明入口
- 图14 · 图14;HTML元素 #S6.F14
原站图表/证明入口
- 图15 · 图15;HTML元素 #S6.F15
原站图表/证明入口
- 图16 · 图16;HTML元素 #S6.F16
原站图表/证明入口
- 图18 · 图18;HTML元素 #S7.F18
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导块大小与尾部浪费上界及均值条件
- 新增三请求逐步缓存分配轨迹
- 区分内核KV结构内存分配和推测解码四类加速
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图2、图12、图13、图14、图15、图16、图18
- v2:问答核查:为什么不能每块独立 softmax 后把结果相加等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
PagedAttention块分配与尾部碎片、共享和copy-on-write机制
技术关系
- 059-flashattention · 模块组合
高效注意力计算与分页服务布局组合
- 073-gqa · 模块组合
减少每token状态和减少分配浪费不同
- 064-speculative · 模块组合
推进token的算法可与缓存管理组合
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型RLAIF vs. RLHF: Scaling Reinforcement Learning from Human Feedback with AI Feedback部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:AI评判能否替代部分人工比较而维持最终人评
- 二、把换序软标签与策略梯度的信号分别定义
- 三、比较奖励蒸馏和直接在线反馈两条执行路径
- 四、结合长度调整、评委一致性与最终策略评价
- 五、同尺寸反馈有效仍不证明无限自我改进
- 六、分别优化反馈来源与偏好利用方式
- 自测:哪些结论真的能够带走
段落怎样重新安排
- 问题定义:反馈来源与学习算法是两条轴 → AI评判能否替代部分人工比较而维持最终人评
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:把昂贵的比较工作交给另一个模型 → 同尺寸反馈有效仍不证明无限自我改进
把结果及能力限制留到证据或边界中解释
- 一分钟理解:把昂贵的比较工作交给另一个模型 → 同尺寸反馈有效仍不证明无限自我改进
把结果及能力限制留到证据或边界中解释
- 一分钟理解:把昂贵的比较工作交给另一个模型 → 分别优化反馈来源与偏好利用方式
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法一:AI 偏好先蒸馏成奖励模型 → 把换序软标签与策略梯度的信号分别定义
保留完整公式和事实约束
- 方法二:d-RLAIF 省掉奖励蒸馏,不省掉强化学习 → 把换序软标签与策略梯度的信号分别定义
先给出信息路径、目标与机制,再讨论执行顺序
- 方法二:d-RLAIF 省掉奖励蒸馏,不省掉强化学习 → 把换序软标签与策略梯度的信号分别定义
将原来的后置推导提前,解释伪代码为何这样计算
- 方法二:d-RLAIF 省掉奖励蒸馏,不省掉强化学习 → 比较奖励蒸馏和直接在线反馈两条执行路径
单列可执行步骤,与机制论证及经验结果区分
- 方法二:d-RLAIF 省掉奖励蒸馏,不省掉强化学习 → 比较奖励蒸馏和直接在线反馈两条执行路径
保留实现限制、训练协议及指标接口
- 实验设置:比较尽量接近,但并非所有环节相同 → 结合长度调整、评委一致性与最终策略评价
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、代价与可迁移的思想 → 同尺寸反馈有效仍不证明无限自我改进
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与可迁移的思想 → 同尺寸反馈有效仍不证明无限自我改进
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与可迁移的思想 → 把换序软标签与策略梯度的信号分别定义
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与可迁移的思想 → 同尺寸反馈有效仍不证明无限自我改进
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据:从分数到真实边界 → 结合长度调整、评委一致性与最终策略评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:从分数到真实边界 → 结合长度调整、评委一致性与最终策略评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:从分数到真实边界 → 结合长度调整、评委一致性与最终策略评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:从分数到真实边界 → 结合长度调整、评委一致性与最终策略评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:从分数到真实边界 → 结合长度调整、评委一致性与最终策略评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:从分数到真实边界 → 结合长度调整、评委一致性与最终策略评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:从分数到真实边界 → 结合长度调整、评委一致性与最终策略评价
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 换序后先还原身份,再平均偏好
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、分别优化反馈来源与偏好利用方式
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 换序后先还原身份,再平均偏好:换序后先还原身份,再平均偏好
教法来源与实际阅读范围
- Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla · Illustrating Reinforcement Learning from Human Feedback
三阶段训练、偏好排名、奖励模型、RL/KL及同一响应送入冻结参考的图示澄清
原论文校准:RLAIF换序软标签公式;概率自构,明确位置校正不能保证评委全面无偏。
本篇校准范围:RLAIF换序软标签公式;概率自构,明确位置校正不能保证评委全面无偏。 新增段落仅用于“换序后先还原身份,再平均偏好”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- RLAIF、RLHF及直接AI反馈相对基线的人工偏好胜率与无害率
实验/结果图 · 必要原图摘引 · 表1,PDF第6页
证据一|表1:最终人评接近,并不等于统计等价已证明。 摘要上 RLAIF、RLHF 对 SFT 的胜率分别为 71%、73%;直接比较 RLAIF 对 RLHF 为 50%。有用对话对应 63%、64%,两者直接比较为 52%。论文报告差异未显著偏离相当水平;这支持该规模实验中没有发现明显差距,不是预先设定等价界限的严格等价性证明。
未在正文展示的图/表与范围
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表10:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表11:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表6、表1、表8、表9、表10、表11、表2、表4、表5
- 问答核查:为什么 d-RLAIF 不是 DPO等3题均有独立对应答案;保留已有有效解释
查看本篇 9 个原文证据入口
- 表6 · 表6;HTML元素 #A7.T6
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表8 · 表8;HTML元素 #A10.T8
原站图表/证明入口
- 表9 · 表9;HTML元素 #A10.T9
原站图表/证明入口
- 表10 · 表10;HTML元素 #A10.T10
原站图表/证明入口
- 表11 · 表11;HTML元素 #A10.T11
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 表4 · 表4;HTML元素 #A2.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #A7.T5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导换序评判必须反转标签概率
- 新增0.8与0.7标签映射算例
- 区分评委来源标签软硬和优化器选择
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表6、表1、表8、表9、表10、表11、表2、表4、表5
- v2:问答核查:为什么 d-RLAIF 不是 DPO等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1软标签偏好分布、交换响应顺序和平均;d-RLAIF与奖励模型路线的区别
技术关系
- 065-constitutional · 直接继承
承接AI反馈对齐并扩大比较
- 075-dpo · 平行方法
直接反馈RL与直接偏好优化不同
- 054-instructgpt · 历史背景
替换人类反馈来源的对齐背景
仍需留意
- 逐篇核读所列方法/证据章节;未重新逐页核对全文与全部原有实验数字,未独立复现实验。
大语言模型SWE-bench: Can Language Models Resolve Real-World GitHub Issues?部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:函数测试之外,怎样验证真实仓库修复且没有回归
- 二、把历史任务构造与补丁接受的逻辑条件分开
- 三、安装历史环境、应用补丁并执行F2P与P2P
- 四、用检索、oracle和可应用率拆解低修复率
- 五、有限测试与筛选后的Python任务不覆盖全部工程
- 六、让静态补丁生成变成定位、编辑和执行闭环
- 自测:能否读懂一个“修复率”
段落怎样重新安排
- 背景与任务定义 → 函数测试之外,怎样验证真实仓库修复且没有回归
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解:正确答案不再是一段孤立代码 → 有限测试与筛选后的Python任务不覆盖全部工程
把结果及能力限制留到证据或边界中解释
- 一分钟理解:正确答案不再是一段孤立代码 → 有限测试与筛选后的Python任务不覆盖全部工程
把结果及能力限制留到证据或边界中解释
- 一分钟理解:正确答案不再是一段孤立代码 → 让静态补丁生成变成定位、编辑和执行闭环
真实关系移到后继路线,避免目录相邻等于技术继承
- 背景与任务定义 → 把历史任务构造与补丁接受的逻辑条件分开
保留完整公式和事实约束
- 方法:构建一个可验证的问题,需要两条流程 → 把历史任务构造与补丁接受的逻辑条件分开
保留原推导
- 方法:构建一个可验证的问题,需要两条流程 → 把历史任务构造与补丁接受的逻辑条件分开
保留原推导
- 方法:构建一个可验证的问题,需要两条流程 → 把历史任务构造与补丁接受的逻辑条件分开
保留原推导
- 实验设置与信息公平性 → 用检索、oracle和可应用率拆解低修复率
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献与局限:测试是证据,但不是完整规格 → 有限测试与筛选后的Python任务不覆盖全部工程
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与局限:测试是证据,但不是完整规格 → 有限测试与筛选后的Python任务不覆盖全部工程
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与局限:测试是证据,但不是完整规格 → 有限测试与筛选后的Python任务不覆盖全部工程
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与局限:测试是证据,但不是完整规格 → 把历史任务构造与补丁接受的逻辑条件分开
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献与局限:测试是证据,但不是完整规格 → 有限测试与筛选后的Python任务不覆盖全部工程
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据:把低成功率拆成可研究的问题 → 用检索、oracle和可应用率拆解低修复率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:把低成功率拆成可研究的问题 → 用检索、oracle和可应用率拆解低修复率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:把低成功率拆成可研究的问题 → 用检索、oracle和可应用率拆解低修复率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:把低成功率拆成可研究的问题 → 用检索、oracle和可应用率拆解低修复率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:把低成功率拆成可研究的问题 → 用检索、oracle和可应用率拆解低修复率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:把低成功率拆成可研究的问题 → 用检索、oracle和可应用率拆解低修复率
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 安装历史环境、应用补丁并执行F2P与P2P
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 方法子节中的执行步骤 → 安装历史环境、应用补丁并执行F2P与P2P
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 实例均值与仓库均值回答不同问题
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、让静态补丁生成变成定位、编辑和执行闭环
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 实例均值与仓库均值回答不同问题:实例均值与仓库均值回答不同问题
原论文校准与展开范围
原论文校准:SWE-bench任务来自多个仓库且实例数不同;纯教学计数,不改变原论文Resolved定义。
本篇校准范围:SWE-bench任务来自多个仓库且实例数不同;纯教学计数,不改变原论文Resolved定义。 新增段落仅用于“实例均值与仓库均值回答不同问题”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- SWE-bench不同BM25上下文长度下的仓库问题解决率
实验/结果图 · 必要原图摘引 · 表2,PDF第5页
证据一|表2、表3:检索更多不一定解决更多。 Claude 2 在 13K、27K、50K BM25 上下文中的解决率为 1.96%、1.87%、1.22%;BM25 对参考文件的平均召回率却从 29.58% 升至 44.41%、51.06%。这支持检索覆盖与上下文利用之间存在张力,不能简单地把失败都归给没找到文件。增加上下文同时引入干扰和长度变化,未单独确定二者的因果贡献。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表10:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表18:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表1、表10、表2、表3、表18、表5、表6
- 问答核查:为什么只看 F2P 通过率不够等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 表1 · 表1;HTML元素 #S2.T1.fig1
原站图表/证明入口
- 表10 · 表10;HTML元素 #A1.T10
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T3.fig1
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3.fig2
原站图表/证明入口
- 表18 · 表18;HTML元素 #A3.T18
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S5.T6
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 把补丁可应用、F2P与P2P拆成三重逻辑门。
- 加入同为99.02%测试通过率却对应不同失败的可核算例。
- 用真实链接区分Codex评价历史与SWE-agent直接采用基准。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表1、表10、表2、表3、表18、表5、表6
- v2:问答核查:为什么只看 F2P 通过率不够等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1–2.3 构建与执行任务;附录 A.4、C.5 的判题流程及六类测试结果。
技术关系
- 048-codex · 历史背景
从函数执行评价发展到仓库修改任务
- 087-sweagent · 直接继承
SWE-agent直接采用SWE-bench评价仓库修复
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:检索到相关材料后,怎样判断回答是否真受支持
- 二、把检索、相关、支持和有用性定义为不同控制量
- 三、离线标注并训练反思token,再执行片段搜索
- 四、按引用精度、召回和检索频率检查可控取舍
- 五、自评与教师误差仍会被评分权重放大
- 六、把逐句支持性与全局资料覆盖联合检查
- 自测:能否拆开三个“可信”
段落怎样重新安排
- 问题定义:四个判断不能混成一个“好回答”分数 → 检索到相关材料后,怎样判断回答是否真受支持
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:查到了材料,不代表回答有了依据 → 自评与教师误差仍会被评分权重放大
把结果及能力限制留到证据或边界中解释
- 一分钟理解:查到了材料,不代表回答有了依据 → 自评与教师误差仍会被评分权重放大
把结果及能力限制留到证据或边界中解释
- 一分钟理解:查到了材料,不代表回答有了依据 → 把逐句支持性与全局资料覆盖联合检查
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:把评审能力离线写进训练序列 → 把检索、相关、支持和有用性定义为不同控制量
保留原推导
- 方法:把评审能力离线写进训练序列 → 把检索、相关、支持和有用性定义为不同控制量
保留原推导
- 方法:把评审能力离线写进训练序列 → 把检索、相关、支持和有用性定义为不同控制量
保留原推导
- 方法:把评审能力离线写进训练序列 → 把检索、相关、支持和有用性定义为不同控制量
保留原推导
- 实验设置:证据来源也占预算 → 按引用精度、召回和检索频率检查可控取舍
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、限制与教学例子 → 自评与教师误差仍会被评分权重放大
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、限制与教学例子 → 自评与教师误差仍会被评分权重放大
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、限制与教学例子 → 把检索、相关、支持和有用性定义为不同控制量
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、限制与教学例子 → 自评与教师误差仍会被评分权重放大
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据与反例 → 按引用精度、召回和检索频率检查可控取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与反例 → 按引用精度、召回和检索频率检查可控取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与反例 → 按引用精度、召回和检索频率检查可控取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与反例 → 按引用精度、召回和检索频率检查可控取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与反例 → 按引用精度、召回和检索频率检查可控取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据与反例 → 按引用精度、召回和检索频率检查可控取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 离线标注并训练反思token,再执行片段搜索
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 特殊token归一化后的实现检查
删除重复总括,补合法标签分母与片段证据ID的具体检查。
- 原阅读路线及重复前作说明 → ## 六、把逐句支持性与全局资料覆盖联合检查
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 特殊token归一化后的实现检查:删除重复总括,补合法标签分母与片段证据ID的具体检查。
原论文校准与展开范围
原论文校准:Self-RAG原文反思token组归一化与附录A.3标签集合;保留现有qY/qN和权重反超算例,新增只展开日志验证方式。
本篇校准范围:Self-RAG原文反思token组归一化与附录A.3标签集合;保留现有qY/qN和权重反超算例,新增只展开日志验证方式。 新增段落仅用于“特殊token归一化后的实现检查”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- Self-RAG组件消融、引用支持度权重以及检索阈值的效果
实验/结果图 · 必要原图摘引 · 图3,PDF第9页
证据三|图3(a):检索价值随任务变化。 50K 消融中,完整模型 PopQA 为 45.5,推理禁用检索后 24.7;PubHealth 则从 73.5 到 73.0。它支持稀有实体知识对外部资料更敏感。ASQA 中,无 critic 的训练配置从完整模型 32.1 降为 18.1;但该配置同时改变了数据组织,不能解释为某一个特殊 token 的孤立因果效果。 图3的三个面板分别是组件消融、引用精度与流畅度权衡、检索频率与归一化准确率;选择支持度权重时不能只盯住引用精度。
- Self-RAG三个任务的训练规模曲线及引用支持度人工评价
实验/结果图 · 必要原图摘引 · 图4,PDF第10页
**证据四|[图3](https://arxiv.org/html/2310.11511v1#S5.F3)(b)(c) 与[图4](https://arxiv.org/html/2310.11511v1#S5.F4)(d):控制是真实的,保证不是。** 增大支持度权重时引用精度上升、MAUVE 下降;提高检索阈值后检索频率降低,PopQA 比 PubHealth 更容易掉分。小规模人工检查的 S&P 为 PopQA 92.5、传记 70.0,但评估排除了模型自己判为无关或无支持的实例,不能当作所有输出的无条件可靠率。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、图3、图4
- 问答核查:为什么“文档相关”不足以支持回答等3题均有独立对应答案;保留已有有效解释
查看本篇 3 个原文证据入口
- 表2 · 表2;HTML元素 #S5.T2
原站图表/证明入口
- 图3 · 图3;HTML元素 #S5.F3
原站图表/证明入口
- 图4 · 图4;HTML元素 #S5.F4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补出特殊token归一化与阈值之间的可计算关系。
- 用支持度权重翻转候选排序,明确仅演示评分子项。
- 区分RAG直接发展与GraphRAG全局覆盖的平行问题。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、图3、图4
- v2:问答核查:为什么“文档相关”不足以支持回答等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.2–3.3 离线反思训练、检索门控与片段搜索;附录 A.3 归一化反思评分。
技术关系
- 034-rag · 直接继承
继承检索增强生成问题并加入自反思门控
- 090-graphrag · 平行方法
另一方向解决全局覆盖而非片段自评
仍需留意
- 首版HTML的特殊token公式存在排版损坏;正文用语义标签和明确限定的二选一教学情形,不声称重建所有实现细节。
- 未独立训练或重新核验全部原文数表。
大语言模型Mamba: Linear-Time Sequence Modeling with Selective State Spaces部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:固定状态压缩历史时,怎样按内容选择记什么
- 二、从时不变递推转到输入相关写入、保留与读出
- 三、用结合扫描和融合内核执行选择性状态更新
- 四、分别检验选择任务、语言质量和系统吞吐
- 五、有限状态与模态差异限制无损长记忆主张
- 六、限制状态转移结构以换取矩阵乘法效率
- 自测:能否从公式看出选择和压缩
段落怎样重新安排
- 背景:固定卷积核为什么会错过内容 → 固定状态压缩历史时,怎样按内容选择记什么
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解:记忆不必保存全部历史,但必须知道什么值得记 → 有限状态与模态差异限制无损长记忆主张
把结果及能力限制留到证据或边界中解释
- 一分钟理解:记忆不必保存全部历史,但必须知道什么值得记 → 有限状态与模态差异限制无损长记忆主张
把结果及能力限制留到证据或边界中解释
- 一分钟理解:记忆不必保存全部历史,但必须知道什么值得记 → 限制状态转移结构以换取矩阵乘法效率
真实关系移到后继路线,避免目录相邻等于技术继承
- 背景:固定卷积核为什么会错过内容 → 从时不变递推转到输入相关写入、保留与读出
保留完整公式和事实约束
- 方法:选择机制、扫描算法和网络块缺一不可 → 从时不变递推转到输入相关写入、保留与读出
保留原推导
- 方法:选择机制、扫描算法和网络块缺一不可 → 从时不变递推转到输入相关写入、保留与读出
保留原推导
- 方法:选择机制、扫描算法和网络块缺一不可 → 从时不变递推转到输入相关写入、保留与读出
保留原推导
- 方法:选择机制、扫描算法和网络块缺一不可 → 从时不变递推转到输入相关写入、保留与读出
保留原推导
- 实验如何拆开质量与效率 → 分别检验选择任务、语言质量和系统吞吐
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、代价与一个手算例子 → 有限状态与模态差异限制无损长记忆主张
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与一个手算例子 → 有限状态与模态差异限制无损长记忆主张
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与一个手算例子 → 从时不变递推转到输入相关写入、保留与读出
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、代价与一个手算例子 → 有限状态与模态差异限制无损长记忆主张
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据:选择有效,边界同样具体 → 分别检验选择任务、语言质量和系统吞吐
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:选择有效,边界同样具体 → 分别检验选择任务、语言质量和系统吞吐
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:选择有效,边界同样具体 → 分别检验选择任务、语言质量和系统吞吐
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:选择有效,边界同样具体 → 分别检验选择任务、语言质量和系统吞吐
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:选择有效,边界同样具体 → 分别检验选择任务、语言质量和系统吞吐
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:选择有效,边界同样具体 → 分别检验选择任务、语言质量和系统吞吐
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:选择有效,边界同样具体 → 分别检验选择任务、语言质量和系统吞吐
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 用结合扫描和融合内核执行选择性状态更新
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 原摘要表 → 有限状态与模态差异限制无损长记忆主张
保留摘要表中未在正文重复的公式或数值条件
- 已核原论文机制与适用的专业教法 → 扫描需要结合律,并不需要交换次序
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、限制状态转移结构以换取矩阵乘法效率
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 扫描需要结合律,并不需要交换次序:扫描需要结合律,并不需要交换次序
原论文校准与展开范围
原论文校准:Mamba选择性仿射递推和并行扫描;标量复合自构,区分结合性、交换性与输入依赖。
本篇校准范围:Mamba选择性仿射递推和并行扫描;标量复合自构,区分结合性、交换性与输入依赖。 新增段落仅用于“扫描需要结合律,并不需要交换次序”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:5 幅
- Mamba选择性复制任务中内部序列层及外部结构组合的准确率
实验/结果图 · 必要原图摘引 · PDF第11页表1(HTML转排标作图4)
证据一|图4、定理 1:改动确实进入了序列记忆机制。 相同 Mamba 外部块,内部 S4 的选择性复制准确率为 56.4,换成 S6 为 99.8;无门控外部块从 S4 的 18.3 到 S6 的 97.0。它支持内部选择机制的重要性,而非只靠多一个外围乘法门。定理给出特殊条件下的精确联系,实验则展示具体任务效果,二者证据性质不同。 选择复制与归纳头图是合成能力测试,速度图另测实现;音频图还给出时不变结构更合适的反例,不能把一种架构的优势泛化到所有模态。
- Mamba扫描核心耗时与端到端生成吞吐的两组硬件比较
实验/结果图 · 必要原图摘引 · 图12,HTML #S4.F12
证据四|图12 与附录 E.5:速度取决于比较层级。 作者报告 4—5 倍生成吞吐,主要收益之一是没有增长的 KV,能容纳更大批量。核心扫描则与 FlashAttention-2 比较,端到端生成基线采用 Hugging Face 的标准 GPT-3 架构实现,不能说完整系统全面快于所有优化推理引擎。表7 的训练显存中,批量 32 的 125M Mamba 为 38.2GB,优化 Transformer 为 34.5GB,Mamba 并非处处更省训练显存。
- Mamba对步长、输入和输出参数分别启用选择性的困惑度消融
实验/结果图 · 必要原图摘引 · 图13(PDF第16页表7)
**证据三|[表2](https://arxiv.org/html/2312.00752v2#S4.T2)、[图13](https://arxiv.org/html/2312.00752v2#S4.F14.fig1):参数选择协同改善语言建模。** Mamba 块使用实数 S4 时困惑度 10.56,选择性 S6 为 8.69;另一组选择参数消融中,全固定为 10.93,仅 $\Delta$ 选择为 9.81,三项都选择为 8.71。支持选择机制不仅对合成题有效;两组数值属于不同配置,不应拼成单一逐步训练轨迹。
- Mamba及各序列模型在归纳头任务中的超长序列外推准确率
实验/结果图 · 必要原图摘引 · 图5(PDF第11页表2)
两个长序列边界值得另记。[图5](https://arxiv.org/html/2312.00752v2#S4.F5.fig2) 的百万长度成功是词表 16 的合成关联任务,不是百万 token 自然语言理解;附录[表5](https://arxiv.org/html/2312.00752v2#A5.T5) 的 DNA 分类中,1.4M Mamba 在长度 $2^{14}$ 时 27.66,HyenaDNA 为 41.17,直到最长设置 Mamba 才明显领先。长上下文能力应按任务和长度具体阅读。
- 音频建模中时不变与选择性SSM参数化在不同序列长度上的损失
实验/结果图 · 必要原图摘引 · 图18(PDF第35页图10)
固定状态需要丢弃信息。如果未来问题需要此前被过滤的细节,模型不能像完整 KV 一样直接回看原位置。选择性也不总有利:附录 E.4.1 [图18](https://arxiv.org/html/2312.00752v2#A5.F18) 的连续音频消融中,S6 会损害某些配置,匹配平滑信号的时不变归纳偏置反而更好。作者也明确指出更大语言模型规模仍待验证。
未在正文展示的图/表与范围
- 表16:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图4、表2、图13、图12、表7、图5、表5、图18
- 问答核查:为什么让 $B,C,\Delta$ 依赖输入后不能再用一个固定卷积核等3题均有独立对应答案;保留已有有效解释
查看本篇 9 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F5.fig1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T2
原站图表/证明入口
- 图13 · 图13;HTML元素 #S4.F14.fig1
原站图表/证明入口
- 图12 · 图12;HTML元素 #S4.F12
原站图表/证明入口
- 表7 · 表7;HTML元素 #A5.T7
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5.fig2
原站图表/证明入口
- 表5 · 表5;HTML元素 #A5.T5
原站图表/证明入口
- 图18 · 图18;HTML元素 #A5.F18
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 展开标量门控的历史权重乘积与总权重。
- 增加20步泄漏的手算反例及固定状态容量边界。
- 明确Transformer平行关系和Mamba-2直接继承。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图4、表2、图13、图12、表7、图5、表5、图18
- v2:问答核查:为什么让 $B,C,\Delta$ 依赖输入后不能再用一个固定卷积核等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2 离散化、§3.5 定理1与选择解释、附录C门控推导、附录D融合扫描。
技术关系
- 015-transformer · 平行方法
直接访问历史与压缩状态两种序列架构
- 088-mamba2 · 直接继承
Mamba-2延续选择性SSM并重构计算
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Mixtral of Experts部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:扩大专家容量时,怎样只让少数分支参与每token计算
- 二、推导Top-2归一化与局部路由梯度
- 三、按专家合批分发token并返回原位置
- 四、分别核对解码预算、长上下文与路由分布
- 五、总权重、负载和披露不足仍限制复现
- 六、比较稀疏专家负载与系统协同的另一种配方
- 自测:能否避免 MoE 的三个常见误读
段落怎样重新安排
- 背景:三个不同的“模型大小” → 扩大专家容量时,怎样只让少数分支参与每token计算
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:8×7B 不等于八个完整助手投票 → 总权重、负载和披露不足仍限制复现
把结果及能力限制留到证据或边界中解释
- 一分钟理解:8×7B 不等于八个完整助手投票 → 总权重、负载和披露不足仍限制复现
把结果及能力限制留到证据或边界中解释
- 一分钟理解:8×7B 不等于八个完整助手投票 → 比较稀疏专家负载与系统协同的另一种配方
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:token 每过一层,都重新选择专家 → 推导Top-2归一化与局部路由梯度
保留完整公式和事实约束
- 方法:token 每过一层,都重新选择专家 → 推导Top-2归一化与局部路由梯度
保留原推导
- 实验设置:别把不同解码口径的分数拼在一起 → 分别核对解码预算、长上下文与路由分布
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、局限与一个参数算例 → 总权重、负载和披露不足仍限制复现
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与一个参数算例 → 推导Top-2归一化与局部路由梯度
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与一个参数算例 → 按专家合批分发token并返回原位置
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与一个参数算例 → 总权重、负载和披露不足仍限制复现
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据:能力提升与计算代价分开阅读 → 分别核对解码预算、长上下文与路由分布
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:能力提升与计算代价分开阅读 → 分别核对解码预算、长上下文与路由分布
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:能力提升与计算代价分开阅读 → 分别核对解码预算、长上下文与路由分布
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:能力提升与计算代价分开阅读 → 分别核对解码预算、长上下文与路由分布
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:能力提升与计算代价分开阅读 → 分别核对解码预算、长上下文与路由分布
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:能力提升与计算代价分开阅读 → 分别核对解码预算、长上下文与路由分布
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 按专家合批分发token并返回原位置
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 专家合批后必须恢复token身份
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、比较稀疏专家负载与系统协同的另一种配方
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 专家合批后必须恢复token身份:专家合批后必须恢复token身份
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:Mixtral token级路由与专家输出加权;dispatch身份诊断为原创实现建议,不补造未披露的负载配方。
本篇校准范围:Mixtral token级路由与专家输出加权;dispatch身份诊断为原创实现建议,不补造未披露的负载配方。 新增段落仅用于“专家合批后必须恢复token身份”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- Mixtral的长上下文Passkey提取准确率和proof-pile困惑度
实验/结果图 · 必要原图摘引 · 图4,PDF第5页
证据三|图4:长上下文提取成功,不等于复杂长文理解解决。 Passkey 实验在所测位置和长度上达到 100%,proof-pile 困惑度随上下文增长下降。前者测定位并复述指定信息,后者测平均预测损失;都没有直接测跨许多证据的复杂归纳、冲突消解或错误来源识别。它们是有价值的长上下文证据,但不是无条件可靠性证明。 Passkey 的位置—长度检索与 proof-pile 困惑度是两个任务;专家分配图的虚线表示均匀占比1/8,接近虚线只能说明使用均衡。
- Mixtral三层中不同语料类型的专家选择比例
实验/结果图 · 必要原图摘引 · 图7,PDF第7页
**证据四|[图7](https://arxiv.org/html/2401.04088v1#S5.F7)、[图8](https://arxiv.org/html/2401.04088v1#S5.F8)、[表5](https://arxiv.org/html/2401.04088v1#S5.T5):专家并没有显现简单的学科分工。** 路由分布在 arXiv、PubMed、PhilPapers 等领域较接近,作者没有观察到明显的按主题分配。代码缩进和某些词的路由表现更像语法局部模式。[表5](https://arxiv.org/html/2401.04088v1#S5.T5) 中 arXiv 第 15 层相邻 token 第一专家相同为 27.9%,随机基线 12.5%,支持局部性;但总体频率相似不能证明专家完全没有语义功能,仍需因果干预等更细分析。
- Mixtral不同层对代码、数学和文本token的专家路由可视化
实验/结果图 · 必要原图摘引 · 图8,PDF第8页
**证据四|[图7](https://arxiv.org/html/2401.04088v1#S5.F7)、[图8](https://arxiv.org/html/2401.04088v1#S5.F8)、[表5](https://arxiv.org/html/2401.04088v1#S5.T5):专家并没有显现简单的学科分工。** 路由分布在 arXiv、PubMed、PhilPapers 等领域较接近,作者没有观察到明显的按主题分配。代码缩进和某些词的路由表现更像语法局部模式。[表5](https://arxiv.org/html/2401.04088v1#S5.T5) 中 arXiv 第 15 层相邻 token 第一专家相同为 27.9%,随机基线 12.5%,支持局部性;但总体频率相似不能证明专家完全没有语义功能,仍需因果干预等更细分析。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表32:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表2、表3、表4、图4、图7、图8、表5
- 问答核查:为什么 8×7B 不是八个完整 7B 模型的集成等3题均有独立对应答案;保留已有有效解释
查看本篇 8 个原文证据入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S3.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S3.T4
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 图7 · 图7;HTML元素 #S5.F7
原站图表/证明入口
- 图8 · 图8;HTML元素 #S5.F8
原站图表/证明入口
- 表5 · 表5;HTML元素 #S5.T5
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 补推Top-2支持集内归一化及局部导数。
- 新增先全词表归一再截断造成尺度错误的向量算例。
- 把专家选择频率和功能语义分开解释。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表2、表3、表4、图4、图7、图8、表5
- v2:问答核查:为什么 8×7B 不是八个完整 7B 模型的集成等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1 Top-2 softmax与专家并行;§3比较口径;§5路由分布与相邻局部性。
技术关系
- 042-switch · 历史背景
同属稀疏专家路线,路由数与配方不同
- 092-deepseekv3 · 平行方法
不同MoE系统设计的可比较工程路径
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:共享主干多猜未来位置,怎样减少串行生成轮数
- 二、区分未来预测、候选树与严格或近似接受
- 三、训练预测头并用祖先掩码验证连续前缀
- 四、把接受长度除以单步开销后再比较速度
- 五、冻结主干不自动保证任意接受规则分布无损
- 六、把多token监督与可选投机推理解耦比较
- 自测:三个“无损”条件能否分开
段落怎样重新安排
- 背景:未来预测不是把自回归依赖消灭了 → 共享主干多猜未来位置,怎样减少串行生成轮数
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:多猜几个词,比反复搬运整个模型更划算吗 → 冻结主干不自动保证任意接受规则分布无损
把结果及能力限制留到证据或边界中解释
- 一分钟理解:多猜几个词,比反复搬运整个模型更划算吗 → 冻结主干不自动保证任意接受规则分布无损
把结果及能力限制留到证据或边界中解释
- 一分钟理解:多猜几个词,比反复搬运整个模型更划算吗 → 把多token监督与可选投机推理解耦比较
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:头、树、接受规则分别负责什么 → 区分未来预测、候选树与严格或近似接受
保留原推导
- 方法:头、树、接受规则分别负责什么 → 区分未来预测、候选树与严格或近似接受
保留原推导
- 方法:头、树、接受规则分别负责什么 → 区分未来预测、候选树与严格或近似接受
保留原推导
- 训练数据与实验预算 → 把接受长度除以单步开销后再比较速度
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、疑点与教学例子 → 冻结主干不自动保证任意接受规则分布无损
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、疑点与教学例子 → 冻结主干不自动保证任意接受规则分布无损
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、疑点与教学例子 → 训练预测头并用祖先掩码验证连续前缀
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、疑点与教学例子 → 冻结主干不自动保证任意接受规则分布无损
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 四组证据:平均接受多少,不等于快多少 → 把接受长度除以单步开销后再比较速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:平均接受多少,不等于快多少 → 把接受长度除以单步开销后再比较速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:平均接受多少,不等于快多少 → 把接受长度除以单步开销后再比较速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:平均接受多少,不等于快多少 → 把接受长度除以单步开销后再比较速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:平均接受多少,不等于快多少 → 把接受长度除以单步开销后再比较速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 四组证据:平均接受多少,不等于快多少 → 把接受长度除以单步开销后再比较速度
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 训练预测头并用祖先掩码验证连续前缀
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 候选树中相同深度不表示相同上下文
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把多token监督与可选投机推理解耦比较
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 候选树中相同深度不表示相同上下文:候选树中相同深度不表示相同上下文
教法来源与实际阅读范围
- Lilian Weng · Large Transformer Model Inference Optimization
Methods Overview、Distillation、Quantization与激活离群值
原论文校准:Medusa树形注意力与路径验证;节点例自构,不宣称该检查独自证明随机接受算法分布正确。
本篇校准范围:Medusa树形注意力与路径验证;节点例自构,不宣称该检查独自证明随机接受算法分布正确。 新增段落仅用于“候选树中相同深度不表示相同上下文”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- Medusa候选树节点数对接受长度和实际解码速度的影响
实验/结果图 · 必要原图摘引 · 图4,HTML #S3.F4
证据三|图4:更多候选可能让系统更慢。 优化后的64节点稀疏树,接受长度优于256节点稠密树;节点继续增多时计算开销抬升,速度下降。树选择利用校准数据估计各头候选正确率,并假设部分独立性,真实错误相关时这种估计可能偏差,所以它是实用搜索启发,不是所有数据上的无条件最优树。
- Medusa在不同模型规模和任务类别上的生成加速
实验/结果图 · 必要原图摘引 · 图3,PDF第7页
**证据一|[图3](https://arxiv.org/html/2401.10774v3#S2.F3)、[表1](https://arxiv.org/html/2401.10774v3#S3.T1):墙钟收益需要扣掉验证开销。** Vicuna-7B 的 Medusa-1 为2.18倍、Medusa-2为2.83倍;后者平均每步解码3.47个token,每步开销比为1.22。按论文定义,速度约为 $3.47/1.22\approx2.84$,与表中2.83的舍入结果接近。不能将3.47误写成直接速度倍数。 树搜索图同时画加速率与 tokens/s:候选树更大时接受更多 token,单步计算也更贵,故接受长度增加仍可能使实际速度下降。
- Medusa后验阈值改变时接受率与回答评价分数的权衡
实验/结果图 · 必要原图摘引 · 图5,PDF第8页
**证据四|[图5](https://arxiv.org/html/2401.10774v3#S3.F5)与附录[表4](https://arxiv.org/html/2401.10774v3#A6.T4):近似规则和任务分布会改变收益。** [图5](https://arxiv.org/html/2401.10774v3#S3.F5)只在写作、角色扮演类别、温度0.7下调典型接受阈值:阈值变严格,质量趋好、接受长度下降。AlpacaEval中Vicuna-13B从29.01到91.54 token/s,即3.16倍,和MT-Bench的2.83不同。这说明速度需按工作负载报告,而不是取最大数字覆盖所有场景。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图3、表1、表2、图4、图5、表4、表3
- 问答核查:冻结主干是否足以保证输出分布不变等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 图3 · 图3;HTML元素 #S2.F3
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 表4 · 表4;HTML元素 #A6.T4
原站图表/证明入口
- 表3 · 表3;HTML元素 #S3.T3
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导单步投机校正的接受质量与残差。
- 用二词分布手算还原目标概率,核实同分布拒绝疑点。
- 区分Medusa与FlashAttention、多token训练的组合层次。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图3、表1、表2、图4、图5、表4、表3
- v2:问答核查:冻结主干是否足以保证输出分布不变等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1树形验证、§2.2头部训练、§2.3.1 typical acceptance与同分布拒绝原句。
- proceedings.mlr.press · 所列章节
§2.3与算法1:min(1,p/q)接受、正残差校正;用于核对Medusa动机段的边界,而非替代Medusa实验。
技术关系
- 059-flashattention · 模块组合
注意力IO优化与多步验证解决不同瓶颈
- 092-deepseekv3 · 教学联系
对照不同多token预测模块和推理用途
仍需留意
- Medusa v3 §2.3.1同分布也可拒绝的表述与标准min(1,p/q)校正不一致;正文保留边界,不擅自修订作者算法。
- 新增二词算例仅验证标准单步投机校正;未证明任意Medusa树规则无损,未重跑速度或质量测试。
大语言模型DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:较强数学模型怎样把更多概率分给已有正确路径
- 二、区分领域训练、示范与组内相对奖励
- 三、在线采样同题答案并分别维护参考与旧策略
- 四、用阶段对照及Maj@K、Pass@K区分收益来源
- 五、省去价值模型仍需昂贵采样与可靠奖励
- 六、沿组内比较继续研究长推理奖励训练
- 自测:能否解释这些判断
段落怎样重新安排
- 背景与问题:这里的环境是什么 → 较强数学模型怎样把更多概率分给已有正确路径
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:先让模型会做,再让它更常做对 → 省去价值模型仍需昂贵采样与可靠奖励
把结果及能力限制留到证据或边界中解释
- 一分钟理解:先让模型会做,再让它更常做对 → 省去价值模型仍需昂贵采样与可靠奖励
把结果及能力限制留到证据或边界中解释
- 一分钟理解:先让模型会做,再让它更常做对 → 沿组内比较继续研究长推理奖励训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:三阶段的修改分别发生在哪里 → 区分领域训练、示范与组内相对奖励
保留原推导
- 方法:三阶段的修改分别发生在哪里 → 区分领域训练、示范与组内相对奖励
保留原推导
- 方法:三阶段的修改分别发生在哪里 → 区分领域训练、示范与组内相对奖励
保留原推导
- 实验怎样区分数据、算法与计算量 → 用阶段对照及Maj@K、Pass@K区分收益来源
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 用一个小例子建立直觉 → 区分领域训练、示范与组内相对奖励
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用一个小例子建立直觉 → 在线采样同题答案并分别维护参考与旧策略
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 用一个小例子建立直觉 → 省去价值模型仍需昂贵采样与可靠奖励
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 证据:哪些解释站得住 → 用阶段对照及Maj@K、Pass@K区分收益来源
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:哪些解释站得住 → 用阶段对照及Maj@K、Pass@K区分收益来源
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:哪些解释站得住 → 用阶段对照及Maj@K、Pass@K区分收益来源
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:哪些解释站得住 → 用阶段对照及Maj@K、Pass@K区分收益来源
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:哪些解释站得住 → 用阶段对照及Maj@K、Pass@K区分收益来源
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:哪些解释站得住 → 用阶段对照及Maj@K、Pass@K区分收益来源
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 省去价值模型仍需昂贵采样与可靠奖励
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 省去价值模型仍需昂贵采样与可靠奖励
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 省去价值模型仍需昂贵采样与可靠奖励
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与边界 → 省去价值模型仍需昂贵采样与可靠奖励
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 在线采样同题答案并分别维护参考与旧策略
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 组标准差的定义会改变优势尺度
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿组内比较继续研究长推理奖励训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 组标准差的定义会改变优势尺度:组标准差的定义会改变优势尺度
教法来源与实际阅读范围
- Nathan Lambert、Louis Castricato、Leandro von Werra、Alex Havrilla · Illustrating Reinforcement Learning from Human Feedback
三阶段训练、偏好排名、奖励模型、RL/KL及同一响应送入冻结参考的图示澄清
原论文校准:DeepSeekMath GRPO组均值与标准差优势;仅说明实现约定的后果,不替原文指定未报告的具体库默认值。
本篇校准范围:DeepSeekMath GRPO组均值与标准差优势;仅说明实现约定的后果,不替原文指定未报告的具体库默认值。 新增段落仅用于“组标准差的定义会改变优势尺度”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:4 幅
- DeepSeekMath的Maj@K与Pass@K在强化学习前后的变化
实验/结果图 · 必要原图摘引 · 图7,HTML #S5.F7
证据四:图7,正确率提高未必意味着可解问题集合扩张。 在温度 0.7 的多样本比较中,RL 改善 Maj@K,却没有改善 Pass@K。作者据此推测,主要作用是提高已有正确解的生成概率。这个解释与实验一致,但有限 K、有限任务下的曲线不能证明模型绝不获得新能力。
- DeepSeekMath不同强化学习与拒绝采样方法在GSM8K和MATH上的训练曲线
实验/结果图 · 必要原图摘引 · 图5,PDF第19页
| 方法诊断 | 1.3B 方法比较;7B 迭代与多样本评测 | [图5](https://arxiv.org/html/2402.03300v3#S5.F5)、[图6](https://arxiv.org/html/2402.03300v3#S5.F6)、[图7](https://arxiv.org/html/2402.03300v3#S5.F7);准确率、Maj@K、Pass@K | 在线采样、过程评分与答案分布的作用 |
- DeepSeekMath三轮迭代训练在GSM8K和MATH上的准确率
实验/结果图 · 必要原图摘引 · 图6,PDF第20页
| 方法诊断 | 1.3B 方法比较;7B 迭代与多样本评测 | [图5](https://arxiv.org/html/2402.03300v3#S5.F5)、[图6](https://arxiv.org/html/2402.03300v3#S5.F6)、[图7](https://arxiv.org/html/2402.03300v3#S5.F7);准确率、Maj@K、Pass@K | 在线采样、过程评分与答案分布的作用 |
- 四种数学训练语料随token数量增加在四类评测中的变化
实验/结果图 · 必要原图摘引 · 图3,PDF第7页
**证据一:[表1](https://arxiv.org/html/2402.03300v3#S2.T1) 与[图3](https://arxiv.org/html/2402.03300v3#S2.F3),数据确实重要。** 同样 150B token 训练量,1.3B 模型在 DeepSeekMath 语料上的 GSM8K 为 23.8%,Proof-Pile-2 为 14.3%;MATH 为 13.6% 与 11.2%。曲线补充训练过程中差异,并非只挑一个终点。它支持这套语料配方更有效,不能说明 GRPO 导致了这些增益,因为此时尚未运行 GRPO。 Maj@K 和 Pass@K 共用候选预算 K,但前者是投票结果、后者是至少一个候选答对;两条趋势不同正是区分概率重分配与覆盖扩张的依据。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表8:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表5、图7、图5、图6、表1、图3、表6、表7、表8、表9、图4
- 问答核查:GRPO 没有 critic,为什么这篇论文仍需要奖励模型等3题均有独立对应答案;保留已有有效解释
查看本篇 11 个原文证据入口
- 表5 · 表5;HTML元素 #S3.T5
原站图表/证明入口
- 图7 · 图7;HTML元素 #S5.F7
原站图表/证明入口
- 图5 · 图5;HTML元素 #S5.F5
原站图表/证明入口
- 图6 · 图6;HTML元素 #S5.F6
原站图表/证明入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 图3 · 图3;HTML元素 #S2.F3
原站图表/证明入口
- 表6 · 表6;HTML元素 #S5.T6
原站图表/证明入口
- 表7 · 表7;HTML元素 #S5.T7
原站图表/证明入口
- 表8 · 表8;HTML元素 #S5.T8
原站图表/证明入口
- 表9 · 表9;HTML元素 #S5.T9
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导二元奖励下优势随组成功比例变化的闭式。
- 手算稀有成功与稀有失败的对称放大,保留连续奖励边界。
- 标清PPO直接继承、DPO平行、R1后续采用的不同关系。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表5、图7、图5、图6、表1、图3、表6、表7、表8、表9、图4
- v2:问答核查:GRPO 没有 critic,为什么这篇论文仍需要奖励模型等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§4.1.1–4.1.3 GRPO目标、结果及过程优势;算法1的参考/旧策略与奖励模型迭代。 §5.2与图7的在线数据、奖励来源和Maj@K/Pass@K对照。
技术关系
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:模型懂代码却操作失败时,接口怎样影响修复轨迹
- 二、把动作解析、观察窗口和历史管理写入固定策略条件
- 三、执行搜索、编辑校验和独立测试的工作循环
- 四、在相同后端下比较ACI组件与反馈预算
- 五、局部检查与多次覆盖仍不能替代最终选择
- 六、沿可靠工具反馈比较其它验证代理
- 自测:能否从系统结果推回实验结论
段落怎样重新安排
- 背景:代码问答与实际修复之间差了什么 → 模型懂代码却操作失败时,接口怎样影响修复轨迹
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:给模型一套合适的工作台 → 局部检查与多次覆盖仍不能替代最终选择
把结果及能力限制留到证据或边界中解释
- 一分钟理解:给模型一套合适的工作台 → 局部检查与多次覆盖仍不能替代最终选择
把结果及能力限制留到证据或边界中解释
- 一分钟理解:给模型一套合适的工作台 → 沿可靠工具反馈比较其它验证代理
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:接口同时决定动作空间和观察空间 → 把动作解析、观察窗口和历史管理写入固定策略条件
保留原推导
- 方法:接口同时决定动作空间和观察空间 → 把动作解析、观察窗口和历史管理写入固定策略条件
保留原推导
- 方法:接口同时决定动作空间和观察空间 → 把动作解析、观察窗口和历史管理写入固定策略条件
保留原推导
- 方法:接口同时决定动作空间和观察空间 → 把动作解析、观察窗口和历史管理写入固定策略条件
保留原推导
- 实验设置与公平性 → 在相同后端下比较ACI组件与反馈预算
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构例子与五个前置概念 → 执行搜索、编辑校验和独立测试的工作循环
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子与五个前置概念 → 局部检查与多次覆盖仍不能替代最终选择
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子与五个前置概念 → 局部检查与多次覆盖仍不能替代最终选择
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果与消融:接口为什么值得单独研究 → 在相同后端下比较ACI组件与反馈预算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与消融:接口为什么值得单独研究 → 在相同后端下比较ACI组件与反馈预算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与消融:接口为什么值得单独研究 → 在相同后端下比较ACI组件与反馈预算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与消融:接口为什么值得单独研究 → 在相同后端下比较ACI组件与反馈预算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与消融:接口为什么值得单独研究 → 在相同后端下比较ACI组件与反馈预算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与消融:接口为什么值得单独研究 → 在相同后端下比较ACI组件与反馈预算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果与消融:接口为什么值得单独研究 → 在相同后端下比较ACI组件与反馈预算
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 局部检查与多次覆盖仍不能替代最终选择
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 局部检查与多次覆盖仍不能替代最终选择
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 局部检查与多次覆盖仍不能替代最终选择
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 局部检查与多次覆盖仍不能替代最终选择
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 执行搜索、编辑校验和独立测试的工作循环
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 把编辑拒绝视为一次明确的状态转移
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、沿可靠工具反馈比较其它验证代理
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 把编辑拒绝视为一次明确的状态转移:把编辑拒绝视为一次明确的状态转移
教法来源与实际阅读范围
- Lilian Weng · LLM Powered Autonomous Agents
系统组件、Planning、ReAct与Reflexion流程
原论文校准:SWE-agent编辑校验与错误恢复接口;文件摘要是教学诊断,不新增原论文消融结果。
本篇校准范围:SWE-agent编辑校验与错误恢复接口;文件摘要是教学诊断,不新增原论文消融结果。 新增段落仅用于“把编辑拒绝视为一次明确的状态转移”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- SWE-agent允许更多尝试时至少一次修复成功的覆盖率
实验/结果图 · 必要原图摘引 · 图4,HTML #S4.F4
证据四:表10 与图4,多次尝试扩大覆盖。 六次独立运行的单次成功率均值为 17.94%,表中离散量为 0.49;Pass@6 达 32.67%。这表示六条轨迹中存在成功补丁的比例上升,不代表系统已有一个无成本、准确选择成功补丁的方法。 横轴 k 表示允许的尝试数,纵轴是至少一次通过的覆盖率;该图不包含现实中自动选出正确补丁的保证。
未在正文展示的图/表与范围
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表10:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表3、表10、图4、表2
- 问答核查:不更新模型参数,为什么解决率仍会改变等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T3.3
原站图表/证明入口
- 表3 · 表3;HTML元素 #S4.T3.6
原站图表/证明入口
- 表10 · 表10;HTML元素 #A2.T10
原站图表/证明入口
- 图4 · 图4;HTML元素 #S4.F4
原站图表/证明入口
- 表2 · 表2;HTML元素 #S4.T3.fig1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 将lint门控编辑写成提交/回滚事务,解释状态一致性。
- 新增行号重试和语法通过但语义失败的逐步轨迹。
- 把18%/15%消融能支持的组合收益与不能隔离的细节分开。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表3、表10、图4、表2
- v2:问答核查:不更新模型参数,为什么解决率仍会改变等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3与附录A.2文件查看/编辑协议,表3接口消融,附录B.3编辑恢复行为。
技术关系
- 081-swebench · 直接继承
直接使用仓库修复任务与执行评价
- 060-react · 历史背景
继承观察行动循环思路而非同一工具设计
- 098-rubric-verification · 教学联系
比较验证反馈怎样改变工具型代理后续行为
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:选择性递推怎样改排成适合GPU的块矩阵计算
- 二、在标量转移条件下展开历史并建立结构化对偶
- 三、块内矩阵乘、块间传状态并核对数值
- 四、分开核心算子、完整模型和混合注意力收益
- 五、结构限制与固定状态容量仍约束检索能力
- 六、把结构化状态与注意力作为可组合模块
- 自测:能否说清“对偶”意味着什么
段落怎样重新安排
- 背景:需要分清函数、算法和网络 → 选择性递推怎样改排成适合GPU的块矩阵计算
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:同一个函数,换一种计算顺序 → 结构限制与固定状态容量仍约束检索能力
把结果及能力限制留到证据或边界中解释
- 一分钟理解:同一个函数,换一种计算顺序 → 结构限制与固定状态容量仍约束检索能力
把结果及能力限制留到证据或边界中解释
- 一分钟理解:同一个函数,换一种计算顺序 → 把结构化状态与注意力作为可组合模块
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:从三步递归推到注意力形式 → 在标量转移条件下展开历史并建立结构化对偶
保留原推导
- 方法:从三步递归推到注意力形式 → 在标量转移条件下展开历史并建立结构化对偶
保留原推导
- 方法:从三步递归推到注意力形式 → 在标量转移条件下展开历史并建立结构化对偶
保留原推导
- 方法:从三步递归推到注意力形式 → 在标量转移条件下展开历史并建立结构化对偶
保留原推导
- 实验怎样验证理论之外的价值 → 分开核心算子、完整模型和混合注意力收益
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个可手算的自构例子 → 在标量转移条件下展开历史并建立结构化对偶
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个可手算的自构例子 → 在标量转移条件下展开历史并建立结构化对偶
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个可手算的自构例子 → 在标量转移条件下展开历史并建立结构化对偶
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个可手算的自构例子 → 结构限制与固定状态容量仍约束检索能力
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 证据:理论成立之后,还要看什么 → 分开核心算子、完整模型和混合注意力收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:理论成立之后,还要看什么 → 分开核心算子、完整模型和混合注意力收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:理论成立之后,还要看什么 → 分开核心算子、完整模型和混合注意力收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:理论成立之后,还要看什么 → 分开核心算子、完整模型和混合注意力收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:理论成立之后,还要看什么 → 分开核心算子、完整模型和混合注意力收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:理论成立之后,还要看什么 → 分开核心算子、完整模型和混合注意力收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 结构限制与固定状态容量仍约束检索能力
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 结构限制与固定状态容量仍约束检索能力
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 结构限制与固定状态容量仍约束检索能力
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 结构限制与固定状态容量仍约束检索能力
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 块内矩阵乘、块间传状态并核对数值
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 用非零块初态检验块间传递是否遗漏
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把结构化状态与注意力作为可组合模块
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 用非零块初态检验块间传递是否遗漏:用非零块初态检验块间传递是否遗漏
原论文校准与展开范围
原论文校准:Mamba-2块内/块间SSD分解与正文保留算例;新增验证路径,不声称浮点逐位相同。
本篇校准范围:Mamba-2块内/块间SSD分解与正文保留算例;新增验证路径,不声称浮点逐位相同。 新增段落仅用于“用非零块初态检验块间传递是否遗漏”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- Mamba-2 SSD扫描相对其他核心算子的时间及状态维度扩展
实验/结果图 · 必要原图摘引 · 图10,HTML #S9.F10
证据二:图10 与 §9.3,核心算子效率提高。 SSD 对较大状态扩展下的 Mamba 扫描给出约 2–8 倍加速,并在约 2K 起超过所比较的 FlashAttention-2。作者紧接着说明:短序列时完整 Mamba-2 未必比 Transformer 更快,因为相同参数预算下,后者包含许多非常高效的 MLP 层。这是不能省略的性能边界。
- 状态空间模型与结构化掩码注意力的代数对应和模型类别关系
方法/设定图 · 必要原图摘引 · 图4,PDF第18页
**证据一:§5、[图4](https://arxiv.org/html/2405.21060v1#S5.F4),确切等价有结构前提。** 标量转移允许将历史衰减移到匹配分数之外,得到 $L\odot CB^\top$。一般对角矩阵各状态维度衰减不同,不能直接做同样的标量拆分。这是数学推导支持的结论,与下游分数无关。 效率图左侧扫描序列长、右侧固定4K序列扫描状态维数;内核速度的适用条件不能被省略后写成完整模型的统一加速倍数。
- 不同模型维度和序列长度下Mamba-2与注意力模型的选择性记忆表现
方法/设定图 · 必要原图摘引 · 图8,PDF第28页
**证据五:[表4](https://arxiv.org/html/2405.21060v1#S9.T4) 与[图8](https://arxiv.org/html/2405.21060v1#S9.F8),收益不能只归于更大状态。** 相同 SSD 内核下,顺序投影且无额外归一化的困惑度为 11.76,并行投影加归一化为 11.49。MQAR 中即使控制状态维度,Mamba-2 仍更好;作者明确不确定哪项架构变化主导这一差异。这一未知原因应保留,不能替作者补出确定解释。
未在正文展示的图/表与范围
- 表8192:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图10、图4、表1、表2、表3、表4、图8
- 问答核查:能否把已经训练好的普通 softmax Transformer 无损换成 Mamba-2等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 图10 · 图10;HTML元素 #S9.F10
原站图表/证明入口
- 图4 · 图4;HTML元素 #S5.F4
原站图表/证明入口
- 表1 · 表1;HTML元素 #S9.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S9.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S9.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S9.T4
原站图表/证明入口
- 图8 · 图8;HTML元素 #S9.F8
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 从切分点两侧衰减乘积推导跨块秩上界。
- 用4步矩阵区分跨块秩1与全矩阵满秩。
- 将Mamba继承、Transformer受限对偶和FlashAttention执行教学联系分开。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图10、图4、表1、表2、表3、表4、图8
- v2:问答核查:能否把已经训练好的普通 softmax Transformer 无损换成 Mamba-2等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§5 SSD结构限制、§6.1–6.3块内/跨块低秩分解及PyTorch参考算法。
技术关系
- 083-mamba · 直接继承
延续选择性SSM,改变结构与矩阵化算法
- 015-transformer · 教学联系
仅受约束注意力具有SSD等价
- 059-flashattention · 教学联系
比较算子结构与执行重排两层优化
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Scaling and evaluating sparse autoencoders部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:混合激活怎样分成稀疏且可检验的字典方向
- 二、区分TopK重建与死亡特征的残差学习
- 三、提取冻结模型激活并维护字典训练状态
- 四、从重建误差走到行为损失、命名与消融
- 五、可读方向和高恢复率仍不等于完整机制
- 六、以冻结表示分析检验结构模型的内部行为
- 自测:能否克制地解释一个特征
段落怎样重新安排
- 背景:为什么普通自编码器还不够 → 混合激活怎样分成稀疏且可检验的字典方向
问题单独建模,原背景中的目标与公式迁入方法推导
- 一分钟理解:给复杂激活找一本稀疏词典 → 可读方向和高恢复率仍不等于完整机制
把结果及能力限制留到证据或边界中解释
- 一分钟理解:给复杂激活找一本稀疏词典 → 可读方向和高恢复率仍不等于完整机制
把结果及能力限制留到证据或边界中解释
- 一分钟理解:给复杂激活找一本稀疏词典 → 以冻结表示分析检验结构模型的内部行为
真实关系移到后继路线,避免目录相邻等于技术继承
- 背景:为什么普通自编码器还不够 → 区分TopK重建与死亡特征的残差学习
保留完整公式和事实约束
- 方法:把稀疏度从间接惩罚改成直接选择 → 区分TopK重建与死亡特征的残差学习
保留原推导
- 方法:把稀疏度从间接惩罚改成直接选择 → 区分TopK重建与死亡特征的残差学习
保留原推导
- 方法:把稀疏度从间接惩罚改成直接选择 → 区分TopK重建与死亡特征的残差学习
保留原推导
- 实验设计:先重建,再问是否解释了行为 → 从重建误差走到行为损失、命名与消融
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构例子:重建、命名和因果各问一件事 → 区分TopK重建与死亡特征的残差学习
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子:重建、命名和因果各问一件事 → 可读方向和高恢复率仍不等于完整机制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子:重建、命名和因果各问一件事 → 可读方向和高恢复率仍不等于完整机制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子:重建、命名和因果各问一件事 → 可读方向和高恢复率仍不等于完整机制
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 结果:怎样避免“解释性幻觉” → 从重建误差走到行为损失、命名与消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:怎样避免“解释性幻觉” → 从重建误差走到行为损失、命名与消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:怎样避免“解释性幻觉” → 从重建误差走到行为损失、命名与消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:怎样避免“解释性幻觉” → 从重建误差走到行为损失、命名与消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:怎样避免“解释性幻觉” → 从重建误差走到行为损失、命名与消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 结果:怎样避免“解释性幻觉” → 从重建误差走到行为损失、命名与消融
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 可读方向和高恢复率仍不等于完整机制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 可读方向和高恢复率仍不等于完整机制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 可读方向和高恢复率仍不等于完整机制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 可读方向和高恢复率仍不等于完整机制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 可读方向和高恢复率仍不等于完整机制
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 提取冻结模型激活并维护字典训练状态
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 重建方向缩放会怎样影响稀疏约束
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、以冻结表示分析检验结构模型的内部行为
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 重建方向缩放会怎样影响稀疏约束:重建方向缩放会怎样影响稀疏约束
原论文校准与展开范围
原论文校准:SAE解码方向尺度约束及稀疏编码;说明重建不变但编码/约束可变,不宣称任意TopK网络可全局等价重参数化。
本篇校准范围:SAE解码方向尺度约束及稀疏编码;说明重建不变但编码/约束可变,不宣称任意TopK网络可全局等价重参数化。 新增段落仅用于“重建方向缩放会怎样影响稀疏约束”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:8 幅
- 稀疏自编码器的重建误差随活跃特征数和字典大小变化
实验/结果图 · 必要原图摘引 · 图2,HTML #S2.F2
证据一:图2、图5,TopK 改善重建与行为保真。 固定字典宽度或固定活跃数的曲线比较中,TopK 优于 ReLU 的前沿,并且在相同 MSE 下也可能有更小的下游损失。后一个观察说明误差落在哪些方向很重要,不能仅凭平均欧氏误差判断行为是否保存。 总潜变量数 n 与每次活跃数 k 是不同坐标;重建误差、下游损失、解释 precision/recall 又是不同纵轴,改善一项不等于解释性全面改善。
- SAE激活函数在固定字典宽度和固定稀疏度下的下游损失对照
实验/结果图 · 必要原图摘引 · 图5,PDF第5页
**证据一:[图2](https://arxiv.org/html/2406.04093v1#S2.F2)、[图5](https://arxiv.org/html/2406.04093v1#S3.F5),TopK 改善重建与行为保真。** 固定字典宽度或固定活跃数的曲线比较中,TopK 优于 ReLU 的前沿,并且在相同 MSE 下也可能有更小的下游损失。后一个观察说明误差落在哪些方向很重要,不能仅凭平均欧氏误差判断行为是否保存。 总潜变量数 n 与每次活跃数 k 是不同坐标;重建误差、下游损失、解释 precision/recall 又是不同纵轴,改善一项不等于解释性全面改善。
- SAE绑定初始化与AuxK组合对死亡潜变量比例的影响
实验/结果图 · 必要原图摘引 · 图15,PDF第21页
**证据二:[图15](https://arxiv.org/html/2406.04093v1#A3.F15)、§2.4,死亡特征并非不可避免。** 绑定方向初始化与 AuxK 组合显著减少沉默特征;最大 16M SAE 仍有约 7% 死亡。它支持训练方案更能利用字典容量,但没有说明每个活跃方向都是独立、自然或有用的语义单位。
- SAE字典宽度与活跃特征数对探针损失和logit差异指标的热图
实验/结果图 · 必要原图摘引 · 图6,PDF第6页
**证据四:[图6](https://arxiv.org/html/2406.04093v1#S4.F6)、[图7](https://arxiv.org/html/2406.04093v1#S4.F7)、[图8](https://arxiv.org/html/2406.04093v1#S4.F8)、[图24](https://arxiv.org/html/2406.04093v1#A5.F24),解释必须检查误报。** N2G 在相近稀疏度下,TopK 的召回相对 ReLU 超过 1.5 倍,精确率略低但超过其 0.9 倍。只看被挑选的强激活样本容易给出过宽解释;精确率要求解释预测会激活的地方也真的激活。规则解释重建后的语言损失进一步检验这些可读部分覆盖多少行为。
- SAE高低精确率与召回率特征的真实及预测token激活示例
实验/结果图 · 必要原图摘引 · 图7,PDF第8页
**证据四:[图6](https://arxiv.org/html/2406.04093v1#S4.F6)、[图7](https://arxiv.org/html/2406.04093v1#S4.F7)、[图8](https://arxiv.org/html/2406.04093v1#S4.F8)、[图24](https://arxiv.org/html/2406.04093v1#A5.F24),解释必须检查误报。** N2G 在相近稀疏度下,TopK 的召回相对 ReLU 超过 1.5 倍,精确率略低但超过其 0.9 倍。只看被挑选的强激活样本容易给出过宽解释;精确率要求解释预测会激活的地方也真的激活。规则解释重建后的语言损失进一步检验这些可读部分覆盖多少行为。
- SAE重建、规则解释及其他残差流替代方式对语言模型损失的影响
实验/结果图 · 必要原图摘引 · 图8,PDF第9页
**证据四:[图6](https://arxiv.org/html/2406.04093v1#S4.F6)、[图7](https://arxiv.org/html/2406.04093v1#S4.F7)、[图8](https://arxiv.org/html/2406.04093v1#S4.F8)、[图24](https://arxiv.org/html/2406.04093v1#A5.F24),解释必须检查误报。** N2G 在相近稀疏度下,TopK 的召回相对 ReLU 超过 1.5 倍,精确率略低但超过其 0.9 倍。只看被挑选的强激活样本容易给出过宽解释;精确率要求解释预测会激活的地方也真的激活。规则解释重建后的语言损失进一步检验这些可读部分覆盖多少行为。
- TopK与ReLU自编码器的解释F1、精确率和召回率三组曲线
实验/结果图 · 必要原图摘引 · 图24,PDF第27页
**证据四:[图6](https://arxiv.org/html/2406.04093v1#S4.F6)、[图7](https://arxiv.org/html/2406.04093v1#S4.F7)、[图8](https://arxiv.org/html/2406.04093v1#S4.F8)、[图24](https://arxiv.org/html/2406.04093v1#A5.F24),解释必须检查误报。** N2G 在相近稀疏度下,TopK 的召回相对 ReLU 超过 1.5 倍,精确率略低但超过其 0.9 倍。只看被挑选的强激活样本容易给出过宽解释;精确率要求解释预测会激活的地方也真的激活。规则解释重建后的语言损失进一步检验这些可读部分覆盖多少行为。
- 四种SAE激活结构在测试时改变稀疏度后的重建误差
实验/结果图 · 必要原图摘引 · 图10,PDF第11页
**证据五:[图10](https://arxiv.org/html/2406.04093v1#S5.F10),测试时随意增大 k 可能反而变差。** TopK 在训练用的稀疏度附近工作较好,增加过多潜变量会让 MSE 恶化。未入选的系数不是训练好的残差信息,不能假设“保留更多数字必然更准确”。论文的 Multi-TopK 探索缓解了这种特定稀疏度适应。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图2、图5、图15、图6、图7、图8、图24、图10、图9
- 问答核查:把 n 从十万增到一百万,与把 k 从 32 增到 320,有什么不同等3题均有独立对应答案;保留已有有效解释
查看本篇 9 个原文证据入口
- 图2 · 图2;HTML元素 #S2.F2
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 图15 · 图15;HTML元素 #A3.F15
原站图表/证明入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 图7 · 图7;HTML元素 #S4.F7
原站图表/证明入口
- 图8 · 图8;HTML元素 #S4.F8
原站图表/证明入口
- 图24 · 图24;HTML元素 #A5.F24
原站图表/证明入口
- 图10 · 图10;HTML元素 #S5.F10
原站图表/证明入口
- 图9 · 图9;HTML元素 #S5.F9
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 就地补齐编码器/字典/偏置的维度定义。
- 推导标量L1缩小解,联系固定支持集幅值再优化实验。
- 用等MSE不同logit误差解释行为保真的必要性。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图2、图5、图15、图6、图7、图8、图24、图10、图9
- v2:问答核查:把 n 从十万增到一百万,与把 k 从 32 增到 320,有什么不同等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§5.1固定活跃集合的幅值再优化,附录A.2 AuxK、C.1死亡特征实验。
技术关系
- 015-transformer · 模块组合
分析固定Transformer内部激活
- 084-mixtral · 教学联系
区分字典稀疏与专家稀疏
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型From Local to Global: A GraphRAG Approach to Query-Focused Summarization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:局部相关片段怎样扩展为全库观点覆盖
- 二、用实体社区组织两次压缩并核算统计分母
- 三、离线建图摘要,再按预算汇总局部回答
- 四、保留无图全局基线以分离覆盖与图的收益
- 五、压缩遗漏、索引更新和事实核查仍限制可靠性
- 六、让全局覆盖与逐条来源支持共同成立
- 自测:能否选择正确的比较对象
段落怎样重新安排
- 背景:相似度不等于代表性 → 局部相关片段怎样扩展为全库观点覆盖
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:回答局部事实和总结全局趋势是两种任务 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把结果及能力限制留到证据或边界中解释
- 一分钟理解:回答局部事实和总结全局趋势是两种任务 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把结果及能力限制留到证据或边界中解释
- 一分钟理解:回答局部事实和总结全局趋势是两种任务 → 让全局覆盖与逐条来源支持共同成立
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:图负责组织主题,语言模型负责抽取和压缩 → 用实体社区组织两次压缩并核算统计分母
保留原推导
- 方法:图负责组织主题,语言模型负责抽取和压缩 → 用实体社区组织两次压缩并核算统计分母
保留原推导
- 方法:图负责组织主题,语言模型负责抽取和压缩 → 用实体社区组织两次压缩并核算统计分母
保留原推导
- 方法:图负责组织主题,语言模型负责抽取和压缩 → 用实体社区组织两次压缩并核算统计分母
保留原推导
- 实验设置:一定要保留无图的全局基线 → 保留无图全局基线以分离覆盖与图的收益
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 自构例子:把“整体观点”拆成可追溯的综合 → 用实体社区组织两次压缩并核算统计分母
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子:把“整体观点”拆成可追溯的综合 → 用实体社区组织两次压缩并核算统计分母
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 自构例子:把“整体观点”拆成可追溯的综合 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 证据:覆盖更多并不等于每个事实都更可靠 → 保留无图全局基线以分离覆盖与图的收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:覆盖更多并不等于每个事实都更可靠 → 保留无图全局基线以分离覆盖与图的收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:覆盖更多并不等于每个事实都更可靠 → 保留无图全局基线以分离覆盖与图的收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:覆盖更多并不等于每个事实都更可靠 → 保留无图全局基线以分离覆盖与图的收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:覆盖更多并不等于每个事实都更可靠 → 保留无图全局基线以分离覆盖与图的收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:覆盖更多并不等于每个事实都更可靠 → 保留无图全局基线以分离覆盖与图的收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 贡献、代价与局限 → 压缩遗漏、索引更新和事实核查仍限制可靠性
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 离线建图摘要,再按预算汇总局部回答
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 追溯链应从最终论断回到原句
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、让全局覆盖与逐条来源支持共同成立
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 追溯链应从最终论断回到原句:追溯链应从最终论断回到原句
教法来源与实际阅读范围
- Lilian Weng · Extrinsic Hallucinations in LLMs
幻觉定义、知识来源、检索增强评价与原子事实评价
原论文校准:GraphRAG原文到社区摘要再到局部/最终回答;事实支持链为原创诊断建议,不声称论文已完成全面事实评估。
本篇校准范围:GraphRAG原文到社区摘要再到局部/最终回答;事实支持链为原创诊断建议,不声称论文已完成全面事实评估。 新增段落仅用于“追溯链应从最终论断回到原句”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- GraphRAG不同索引方法在两类数据和四种指标上的成对胜率热图
实验/结果图 · 必要原图摘引 · 图2,PDF第10页
证据一:图2、附录表6,全局方法优于局部检索的覆盖。 各全局方法对 SS 的全面性胜率在访谈为 72–83%、新闻为 72–80%,多样性也占优。这些区间包括无图 TS,支持“全局处理重要”,不能全部记在图的账上。SS 在直接性上更强,赋能指标则结果混合。 热图中每格是行方法胜过列方法的比例;对角50%是展示用参考值,不是实际完成了自我对比实验。四种评判指标应分别读。
未在正文展示的图/表与范围
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表2、图2、表6、表3、表4
- 问答核查:GraphRAG 比向量 RAG 全面,是否证明知识图谱本身不可替代等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表2 · 表2;HTML元素 #S5.T2
原站图表/证明入口
- 图2 · 图2;HTML元素 #S5.F2
原站图表/证明入口
- 表6 · 表6;HTML元素 #A7.T6
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S5.T4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 拆开两次压缩与社区覆盖/意见比例混淆。
- 推导离线索引的查询摊销临界点并给出167次教学算例。
- 结合TS无图对照限定图结构与全局处理的贡献。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表2、图2、表6、表3、表4
- v2:问答核查:GraphRAG 比向量 RAG 全面,是否证明知识图谱本身不可替代等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1.4–3.1.6社区层次、摘要与map-reduce;§4.1.2–4.1.3对照和预算;表2查询上下文量与§6局限。
技术关系
- 034-rag · 直接继承
扩展检索增强到全库主题综合
- 082-self-rag · 平行方法
证据支持控制与全局覆盖是不同问题
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:相同生成预算怎样分给搜索、修订与不同难度题
- 二、定义前缀价值、修订分布和难度条件策略
- 三、在预算中记录选择、前瞻与难度估计的成本
- 四、按难度、预算和生命周期FLOPs比较前沿
- 五、理想难度分组与验证器误差仍限制部署收益
- 六、将预算选择具体化为停止干预和可执行控制器
- 自测:能否把论文标题讲完整
段落怎样重新安排
- 背景:推理预算扩大有两个前提 → 相同生成预算怎样分给搜索、修订与不同难度题
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:同样生成 64 次,可以有很多花法 → 理想难度分组与验证器误差仍限制部署收益
把结果及能力限制留到证据或边界中解释
- 一分钟理解:同样生成 64 次,可以有很多花法 → 理想难度分组与验证器误差仍限制部署收益
把结果及能力限制留到证据或边界中解释
- 一分钟理解:同样生成 64 次,可以有很多花法 → 将预算选择具体化为停止干预和可执行控制器
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法一:验证器引导的搜索 → 定义前缀价值、修订分布和难度条件策略
保留原推导
- 方法一:验证器引导的搜索 → 定义前缀价值、修订分布和难度条件策略
保留原推导
- 方法二:让模型学会根据历史尝试修订 → 定义前缀价值、修订分布和难度条件策略
保留完整公式和事实约束
- 方法三:按难度选择策略,而非求出万能最优 → 定义前缀价值、修订分布和难度条件策略
先给出信息路径、目标与机制,再讨论执行顺序
- 方法三:按难度选择策略,而非求出万能最优 → 定义前缀价值、修订分布和难度条件策略
将原来的后置推导提前,解释伪代码为何这样计算
- 方法三:按难度选择策略,而非求出万能最优 → 在预算中记录选择、前瞻与难度估计的成本
单列可执行步骤,与机制论证及经验结果区分
- 方法三:按难度选择策略,而非求出万能最优 → 在预算中记录选择、前瞻与难度估计的成本
保留实现限制、训练协议及指标接口
- 实验如何配置预算 → 按难度、预算和生命周期FLOPs比较前沿
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 一个自构例子与五个前置概念 → 定义前缀价值、修订分布和难度条件策略
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子与五个前置概念 → 理想难度分组与验证器误差仍限制部署收益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 一个自构例子与五个前置概念 → 理想难度分组与验证器误差仍限制部署收益
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 证据:更多计算何时有效,何时被浪费 → 按难度、预算和生命周期FLOPs比较前沿
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:更多计算何时有效,何时被浪费 → 按难度、预算和生命周期FLOPs比较前沿
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:更多计算何时有效,何时被浪费 → 按难度、预算和生命周期FLOPs比较前沿
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:更多计算何时有效,何时被浪费 → 按难度、预算和生命周期FLOPs比较前沿
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:更多计算何时有效,何时被浪费 → 按难度、预算和生命周期FLOPs比较前沿
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 证据:更多计算何时有效,何时被浪费 → 按难度、预算和生命周期FLOPs比较前沿
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 成本公式与适用边界 → 理想难度分组与验证器误差仍限制部署收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 成本公式与适用边界 → 理想难度分组与验证器误差仍限制部署收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 成本公式与适用边界 → 理想难度分组与验证器误差仍限制部署收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 成本公式与适用边界 → 理想难度分组与验证器误差仍限制部署收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 成本公式与适用边界 → 理想难度分组与验证器误差仍限制部署收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 成本公式与适用边界 → 理想难度分组与验证器误差仍限制部署收益
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 已核原论文机制与适用的专业教法 → 前缀价值依赖的是哪个继续生成策略
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、将预算选择具体化为停止干预和可执行控制器
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 重复的统一问题—方法—收益—代价摘要,正文已分别论证;内容保留于问题、机制、证据与边界章节。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 前缀价值依赖的是哪个继续生成策略:前缀价值依赖的是哪个继续生成策略
原论文校准与展开范围
原论文校准:推理时扩展论文以Monte Carlo后续成功训练PRM;概率为自构,依据正文V_pi定义。
本篇校准范围:推理时扩展论文以Monte Carlo后续成功训练PRM;概率为自构,依据正文V_pi定义。 新增段落仅用于“前缀价值依赖的是哪个继续生成策略”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:7 幅
- 根据题目难度分配测试时计算与固定搜索策略的预算—准确率曲线
实验/结果图 · 必要原图摘引 · 图4,HTML #S5.F4
证据二:图4,难度分配可以提高局部预算效率。 在部分比较点,约 16 次生成的自适应策略接近或超过 64 次 best-of-N 的水平。准确表述是给定所用难度估计与预算口径下的曲线结果;若再加 2048 次难度采样,就不是完整流程节省四倍。
- PRM搜索策略的预算曲线与按问题难度分组的比较
实验/结果图 · 必要原图摘引 · 图3,PDF第9页
**证据一:[图3](https://arxiv.org/html/2408.03314v1#S5.F3),最强搜索不一定最划算。** 小预算时 beam search 优于 best-of-N,预算增大后优势缩小甚至反转;lookahead 在匹配生成预算下通常更差。简单组容易过度优化评分器,中等难度组更受益,最难组各方法进展有限。这支持因题选择算法,而非一律加深搜索。 难度分组柱状图内部又区分生成预算;oracle 难度使用正确标签,predicted 难度使用验证器估计。两者曲线接近不能抹去难度估计本身的费用。
- 迭代修订每步通过率与串行、并行生成策略的比较
实验/结果图 · 必要原图摘引 · 图6,PDF第12页
**证据三:[图6](https://arxiv.org/html/2408.03314v1#S6.F6)、[图7](https://arxiv.org/html/2408.03314v1#S6.F7)、[图8](https://arxiv.org/html/2408.03314v1#S6.F8),顺序与并行互补。** 单条修订链的逐步成功率能提高,但过度坚持一条路线不总是最好。高预算和较难题存在更合适的混合比例;[图8](https://arxiv.org/html/2408.03314v1#S6.F8) 给出 64 对 256 次生成的效率例子。验证器或投票选择不可省略,因为修订也会破坏正确答案。
- 串行并行计算配比对总体准确率及不同难度问题的影响
实验/结果图 · 必要原图摘引 · 图7,PDF第13页
**证据三:[图6](https://arxiv.org/html/2408.03314v1#S6.F6)、[图7](https://arxiv.org/html/2408.03314v1#S6.F7)、[图8](https://arxiv.org/html/2408.03314v1#S6.F8),顺序与并行互补。** 单条修订链的逐步成功率能提高,但过度坚持一条路线不总是最好。高预算和较难题存在更合适的混合比例;[图8](https://arxiv.org/html/2408.03314v1#S6.F8) 给出 64 对 256 次生成的效率例子。验证器或投票选择不可省略,因为修订也会破坏正确答案。
- 按难度预测或理想分配修订预算与固定并行策略的比较
实验/结果图 · 必要原图摘引 · 图8,PDF第13页
**证据三:[图6](https://arxiv.org/html/2408.03314v1#S6.F6)、[图7](https://arxiv.org/html/2408.03314v1#S6.F7)、[图8](https://arxiv.org/html/2408.03314v1#S6.F8),顺序与并行互补。** 单条修订链的逐步成功率能提高,但过度坚持一条路线不总是最好。高预算和较难题存在更合适的混合比例;[图8](https://arxiv.org/html/2408.03314v1#S6.F8) 给出 64 对 256 次生成的效率例子。验证器或投票选择不可省略,因为修订也会破坏正确答案。
- 迭代修订和PRM搜索的推理计算与更大预训练模型之间的比较
实验/结果图 · 必要原图摘引 · 图9,PDF第15页
**证据四:[图9](https://arxiv.org/html/2408.03314v1#S7.F9),大模型与多次推理的交换依赖工作负载。** 论文分别分析推理与预训练 token 比例 $R=0.16,0.79,22$。简单题或较少推理需求下,小模型加推理更有吸引力;很难的题或很大的推理负载下,增加模型规模更有利。标题中的“can”是条件判断,不是取代预训练的普遍定律。
- 去除验证器的修订实验中串行并行比例与准确率的关系
实验/结果图 · 必要原图摘引 · 图16,PDF第28页
**证据五:附录 K、[图16](https://arxiv.org/html/2408.03314v1#A11.F16),更多自训练也可能损害修订。** 使用 ReST-EM 式数据再训练后,增加顺序修订反而显著变差。作者推测数据中的伪相关被强化。这个反例说明生成训练数据、验证和修订能力之间存在闭环偏差,不能用“自我改进”一词跳过验证。
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图3、图4、图6、图7、图8、图9、图16
- 问答核查:为什么 predicted difficulty 不需要正确答案,却仍然不能算免费部署等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 图3 · 图3;HTML元素 #S5.F3
原站图表/证明入口
- 图4 · 图4;HTML元素 #S5.F4
原站图表/证明入口
- 图6 · 图6;HTML元素 #S6.F6
原站图表/证明入口
- 图7 · 图7;HTML元素 #S6.F7
原站图表/证明入口
- 图8 · 图8;HTML元素 #S6.F8
原站图表/证明入口
- 图9 · 图9;HTML元素 #S7.F9
原站图表/证明入口
- 图16 · 图16;HTML元素 #A11.F16
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 加入路由混淆下平均成功率推导与60%分类阈值算例。
- 将难度估计费用显式扣自总预算,而非只看理想分组曲线。
- 把独立投票、单轨迹控制和控制器搜索连接成有类型的阅读路线。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图3、图4、图6、图7、图8、图9、图16
- v2:问答核查:为什么 predicted difficulty 不需要正确答案,却仍然不能算免费部署等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1–3.2预算优化、五类难度与两折验证;附录C 2048样本难度成本未计,附录D rollout价值标签。
技术关系
- 056-self-consistency · 历史背景
独立采样聚合是测试时计算的一种先前路径
- 095-s1 · 历史背景
后续聚焦单轨迹停止干预
- 099-autotts · 历史背景
后续将预算策略作为可搜索控制器
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型DeepSeek-V3 Technical Report部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:扩大专家容量时,怎样同时约束活跃计算与数据搬运
- 二、拆开MLA、专家负载偏置和多token监督
- 三、用混合精度、流水线与通信重叠执行训练
- 四、分离基础模型、模块消融与后训练的证据
- 五、复杂配方与部署存储不能由单一成本数概括
- 六、把基础模型与GRPO连接到可验证推理训练
- 七、自测与答案
段落怎样重新安排
- 二、问题定义:稀疏计算并不等于便宜部署 → 扩大专家容量时,怎样同时约束活跃计算与数据搬运
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一、先用一分钟讲明白 → 复杂配方与部署存储不能由单一成本数概括
把结果及能力限制留到证据或边界中解释
- 一、先用一分钟讲明白 → 复杂配方与部署存储不能由单一成本数概括
把结果及能力限制留到证据或边界中解释
- 一、先用一分钟讲明白 → 把基础模型与GRPO连接到可验证推理训练
真实关系移到后继路线,避免目录相邻等于技术继承
- 三、方法:哪些是继承,哪些是修改 → 拆开MLA、专家负载偏置和多token监督
保留原推导
- 三、方法:哪些是继承,哪些是修改 → 拆开MLA、专家负载偏置和多token监督
保留原推导
- 三、方法:哪些是继承,哪些是修改 → 拆开MLA、专家负载偏置和多token监督
保留原推导
- 四、实验如何验证 → 分离基础模型、模块消融与后训练的证据
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、建立理解 → 拆开MLA、专家负载偏置和多token监督
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、建立理解 → 复杂配方与部署存储不能由单一成本数概括
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果:证据能支持到哪里 → 分离基础模型、模块消融与后训练的证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:证据能支持到哪里 → 分离基础模型、模块消融与后训练的证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:证据能支持到哪里 → 分离基础模型、模块消融与后训练的证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:证据能支持到哪里 → 分离基础模型、模块消融与后训练的证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:证据能支持到哪里 → 分离基础模型、模块消融与后训练的证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:证据能支持到哪里 → 分离基础模型、模块消融与后训练的证据
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 复杂配方与部署存储不能由单一成本数概括
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 复杂配方与部署存储不能由单一成本数概括
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 复杂配方与部署存储不能由单一成本数概括
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 用混合精度、流水线与通信重叠执行训练
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 路由偏置改选择,不应悄悄改混合权重
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、把基础模型与GRPO连接到可验证推理训练
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 路由偏置改选择,不应悄悄改混合权重:路由偏置改选择,不应悄悄改混合权重
教法来源与实际阅读范围
- Lilian Weng · How to Train Really Large Models on Many GPUs?
Data/Model/Pipeline Parallelism、Tensor Parallelism与MoE:状态所有权、流水线版本、列分片、专家容量
原论文校准:DeepSeek-V3偏置用于Top-k选择、原亲和用于权重;数字仅解释两种量,未简化为原文只有两个专家。
本篇校准范围:DeepSeek-V3偏置用于Top-k选择、原亲和用于权重;数字仅解释两种量,未简化为原文只有两个专家。 新增段落仅用于“路由偏置改选择,不应悄悄改混合权重”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- DeepSeek-V3多token预测模块对小型和大型MoE的任务结果消融
实验/结果图 · 必要原图摘引 · 表4,PDF第26页
证据 2:表4,MTP 消融。 大模型 HumanEval 从 44.5 到 53.7,上升 9.2 个百分点;MMLU 却从 67.5 到 66.6。推理时额外模块被移除,因此能力变化不是测试时多算一步造成的;训练期却增加了计算,所以它不是严格等训练 FLOPs 的比较。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 原文定位已接入正文:表3、表1、表4、表5、表6、表9
- 问答核查:为什么“每 token 激活 37B”不等于“只需存储 37B 参数”等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 表3 · 表3;HTML元素 #S4.T3
原站图表/证明入口
- 表1 · 表1;HTML元素 #S1.T1
原站图表/证明入口
- 表4 · 表4;HTML元素 #S4.T4
原站图表/证明入口
- 表5 · 表5;HTML元素 #S4.T5
原站图表/证明入口
- 表6 · 表6;HTML元素 #S5.T6
原站图表/证明入口
- 表9 · 表9;HTML元素 #S5.T9
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 给出偏置改变Top-k但不进入混合权重的数值反例。
- 补出MLA内容键矩阵吸收的维度与等式。
- 区分专家调度、位置分支和真实内核收益的条件。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:原文定位已接入正文:表3、表1、表4、表5、表6、表9
- v2:问答核查:为什么“每 token 激活 37B”不等于“只需存储 37B 参数”等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.1.1 MLA与§2.1.2偏置路由、序列辅助项;§4.2专家配置与偏置更新,表1成本边界。
技术关系
- 084-mixtral · 平行方法
不同MoE路由与系统设计
- 086-deepseekmath · 直接继承
V3后训练使用GRPO
- 094-r1 · 直接继承
R1以V3-Base为基础模型
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型2 OLMo 2 Furious部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只有权重时无法归因,怎样观察稳定性与后期能力形成
- 二、分开数值稳定、数据退火与兼容分支平均
- 三、从共同检查点试配方并保存完整训练轨迹
- 四、按尖峰、数据曝光和阶段能力读取对照
- 五、开放材料仍不消除配方选择与目标取舍
- 六、用可追溯配方核对数据课程与偏好模块
- 七、自测与答案
段落怎样重新安排
- 二、背景:开放权重之外,还需要什么 → 只有权重时无法归因,怎样观察稳定性与后期能力形成
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一、先用一分钟讲明白 → 开放材料仍不消除配方选择与目标取舍
把结果及能力限制留到证据或边界中解释
- 一、先用一分钟讲明白 → 开放材料仍不消除配方选择与目标取舍
把结果及能力限制留到证据或边界中解释
- 一、先用一分钟讲明白 → 开放材料仍不消除配方选择与目标取舍
把结果及能力限制留到证据或边界中解释
- 一、先用一分钟讲明白 → 用可追溯配方核对数据课程与偏好模块
真实关系移到后继路线,避免目录相邻等于技术继承
- 三、方法:稳定训练,再有针对性地补课 → 分开数值稳定、数据退火与兼容分支平均
保留原推导
- 三、方法:稳定训练,再有针对性地补课 → 分开数值稳定、数据退火与兼容分支平均
保留原推导
- 四、实验设置 → 按尖峰、数据曝光和阶段能力读取对照
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、理解练习 → 按尖峰、数据曝光和阶段能力读取对照
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、理解练习 → 开放材料仍不消除配方选择与目标取舍
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果与证据强度 → 按尖峰、数据曝光和阶段能力读取对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据强度 → 按尖峰、数据曝光和阶段能力读取对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据强度 → 按尖峰、数据曝光和阶段能力读取对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据强度 → 按尖峰、数据曝光和阶段能力读取对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据强度 → 按尖峰、数据曝光和阶段能力读取对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据强度 → 按尖峰、数据曝光和阶段能力读取对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据强度 → 按尖峰、数据曝光和阶段能力读取对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 开放材料仍不消除配方选择与目标取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 开放材料仍不消除配方选择与目标取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 开放材料仍不消除配方选择与目标取舍
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 从共同检查点试配方并保存完整训练轨迹
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 权重平均前先检查参数坐标是否对应
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、用可追溯配方核对数据课程与偏好模块
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 权重平均前先检查参数坐标是否对应:权重平均前先检查参数坐标是否对应
原论文校准与展开范围
原论文校准:OLMo 2共同检查点退火及参数平均;隐藏置换反例为机制解释,不否定原文受控soup结果。
本篇校准范围:OLMo 2共同检查点退火及参数平均;隐藏置换反例为机制解释,不否定原文受控soup结果。 新增段落仅用于“权重平均前先检查参数坐标是否对应”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:3 幅
- OLMo 2不同初始化方式的训练损失与梯度范数尖峰
实验/结果图 · 必要原图摘引 · 图4,HTML #S3.F4
证据 1:图4、图7,稳定性。 初始化消融中梯度尖峰分数从 0.40 到 0.03;图7 的联合归一化修改从 0.108 到 0.069。尖峰分数是偏离过去 1000 个值滚动均值至少七个标准差的比例。两组不是同一基线,不能连乘成总降幅。图2 两代训练损失绝对高低还受语料改变影响,不能用它直接判断新模型更差。 训练损失与梯度范数分别成图;OLMo 2 更高的原始训练损失同时受数据变化影响,不能据此判定稳定化设计让语言建模退步。
- OLMo 2归一化位置修改前后的梯度范数训练曲线
实验/结果图 · 必要原图摘引 · 图7,HTML #S3.F7
证据 1:图4、图7,稳定性。 初始化消融中梯度尖峰分数从 0.40 到 0.03;图7 的联合归一化修改从 0.108 到 0.069。尖峰分数是偏离过去 1000 个值滚动均值至少七个标准差的比例。两组不是同一基线,不能连乘成总降幅。图2 两代训练损失绝对高低还受语料改变影响,不能用它直接判断新模型更差。 训练损失与梯度范数分别成图;OLMo 2 更高的原始训练损失同时受数据变化影响,不能据此判定稳定化设计让语言建模退步。
- OLMo与OLMo2的训练损失和梯度范数随训练步数变化
实验/结果图 · 必要原图摘引 · 图2,PDF第10页
**证据 1:[图4](https://arxiv.org/html/2501.00656v2#S3.F4)、[图7](https://arxiv.org/html/2501.00656v2#S3.F7),稳定性。** 初始化消融中梯度尖峰分数从 0.40 到 0.03;[图7](https://arxiv.org/html/2501.00656v2#S3.F7) 的联合归一化修改从 0.108 到 0.069。尖峰分数是偏离过去 1000 个值滚动均值至少七个标准差的比例。两组不是同一基线,不能连乘成总降幅。[图2](https://arxiv.org/html/2501.00656v2#S3.F2) 两代训练损失绝对高低还受语料改变影响,不能用它直接判断新模型更差。 训练损失与梯度范数分别成图;OLMo 2 更高的原始训练损失同时受数据变化影响,不能据此判定稳定化设计让语言建模退步。
未在正文展示的图/表与范围
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表9:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表12:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表18:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表14:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表16:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表9、表3、表1、表12、表18、图4、图7、图2、表14、表16、表7
- 问答核查:为什么开放权重不足以判断一项能力来自哪段训练等3题均有独立对应答案;保留已有有效解释
查看本篇 11 个原文证据入口
- 表9 · 表9;HTML元素 #S4.T9
原站图表/证明入口
- 表3 · 表3;HTML元素 #S2.T3
原站图表/证明入口
- 表1 · 表1;HTML元素 #S2.T1
原站图表/证明入口
- 表12 · 表12;HTML元素 #S4.T12
原站图表/证明入口
- 表18 · 表18;HTML元素 #S5.T18
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 图7 · 图7;HTML元素 #S3.F7
原站图表/证明入口
- 图2 · 图2;HTML元素 #S3.F2
原站图表/证明入口
- 表14 · 表14;HTML元素 #S4.T14
原站图表/证明入口
- 表16 · 表16;HTML元素 #S5.T16
原站图表/证明入口
- 表7 · 表7;HTML元素 #S2.T7
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 从softmax平移不变性推到z-loss梯度与整体尺度。
- 加入概率完全相同但z-loss不同的二词算例。
- 实核并保留两处版本内部矛盾,避免代作者选值。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表9、表3、表1、表12、表18、图4、图7、图2、表14、表16、表7
- v2:问答核查:为什么开放权重不足以判断一项能力来自哪段训练等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.2式1–2与表3、§3.3.2重排归一化对照、§3.3.3 z-loss前向/反向差异;§2.3中期多分支平均。
技术关系
- 057-chinchilla · 历史背景
核算训练与数据预算的研究视角
- 086-deepseekmath · 平行方法
领域数据课程的不同训练配方
- 075-dpo · 模块组合
DPO作为OLMo2后训练阶段
仍需留意
- v2表3的z-loss为1e-5,§3.3.3为1e-4;未核到固定训练配置可裁定该差异。
- v2 §2.2式2以x为MLP输入,§3.3.2对照表以h为输入;正文明确采用后者解释,不声称实际代码已核验。
- 未独立复现训练或逐项审计全部表格。
大语言模型DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只验证结果时,强基座怎样形成更可靠的长解题行为
- 二、推导组内奖励与筛选后监督分布的差别
- 三、区分Zero、完整训练与学生SFT三条流程
- 四、联合读取正确率、长度、退步和蒸馏对照
- 五、结果奖励与过滤器不能逐步认证推导
- 六、用监督与终止控制对照长推理RL路线
- 七、自测与答案
段落怎样重新安排
- 二、问题定义与三个必须区分的模型 → 只验证结果时,强基座怎样形成更可靠的长解题行为
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一、一分钟理解 → 结果奖励与过滤器不能逐步认证推导
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 结果奖励与过滤器不能逐步认证推导
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 用监督与终止控制对照长推理RL路线
真实关系移到后继路线,避免目录相邻等于技术继承
- 三、方法:在同一道题的候选之间比较 → 推导组内奖励与筛选后监督分布的差别
保留原推导
- 三、方法:在同一道题的候选之间比较 → 推导组内奖励与筛选后监督分布的差别
保留原推导
- 三、方法:在同一道题的候选之间比较 → 推导组内奖励与筛选后监督分布的差别
保留原推导
- 四、实验设计与缺失信息 → 联合读取正确率、长度、退步和蒸馏对照
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、建立理解 → 推导组内奖励与筛选后监督分布的差别
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、建立理解 → 结果奖励与过滤器不能逐步认证推导
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果:五处值得认真读的证据 → 联合读取正确率、长度、退步和蒸馏对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:五处值得认真读的证据 → 联合读取正确率、长度、退步和蒸馏对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:五处值得认真读的证据 → 联合读取正确率、长度、退步和蒸馏对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:五处值得认真读的证据 → 联合读取正确率、长度、退步和蒸馏对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:五处值得认真读的证据 → 联合读取正确率、长度、退步和蒸馏对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:五处值得认真读的证据 → 联合读取正确率、长度、退步和蒸馏对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:五处值得认真读的证据 → 联合读取正确率、长度、退步和蒸馏对照
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与适用边界 → 结果奖励与过滤器不能逐步认证推导
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与适用边界 → 结果奖励与过滤器不能逐步认证推导
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与适用边界 → 结果奖励与过滤器不能逐步认证推导
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 区分Zero、完整训练与学生SFT三条流程
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 过滤后的题目分布也可能偏向教师已会的区域
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、用监督与终止控制对照长推理RL路线
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 过滤后的题目分布也可能偏向教师已会的区域:过滤后的题目分布也可能偏向教师已会的区域
原论文校准与展开范围
原论文校准:R1拒绝采样、过滤与后续SFT;固定每题尝试数是明确教学设定,不推断未披露的真实采样配比。
本篇校准范围:R1拒绝采样、过滤与后续SFT;固定每题尝试数是明确教学设定,不推断未披露的真实采样配比。 新增段落仅用于“过滤后的题目分布也可能偏向教师已会的区域”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- DeepSeek-R1-Zero的AIME正确率在强化学习训练中的变化
实验/结果图 · 必要原图摘引 · 图2,HTML #S2.F2
证据 1:图2、表2,Zero 的改善。 AIME 2024 的平均 Pass@1 从 15.6 到 71.0,提高 55.4 个百分点;cons@64 为 86.7。图2 每题采样 16 次跟踪训练。它支持无冷启动 SFT 的 RL 能在该基础模型上改善成功率,不能支持“从空白模型学出推理”。 准确率图对每题采样16次求平均,长度图统计训练过程中的平均回答长度;两条曲线共同上涨不构成“任意延长回答都会更准”的干预证据。
- DeepSeek-R1-Zero训练过程中每次回答的平均长度变化
实验/结果图 · 必要原图摘引 · 图3,HTML #S2.F3
证据 2:图3、表3,长度与重新检查。 图3 显示训练集回答长度增加,表3 展示重新审视推导的个案。这些是行为观察,没有严格隔离长度、采样分布与策略变化的因果实验;个案也不能证明产生了人类式意识或稳定的内部自我验证机制。
未在正文展示的图/表与范围
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表5、图2、表2、图3、表3、表4、表6
- 问答核查:R1-Zero 的 Zero 到底排除了什么,又没有排除什么等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 表5 · 表5;HTML元素 #S3.T5
原站图表/证明入口
- 图2 · 图2;HTML元素 #S2.F2
原站图表/证明入口
- 表2 · 表2;HTML元素 #S2.T2
原站图表/证明入口
- 图3 · 图3;HTML元素 #S2.F3
原站图表/证明入口
- 表3 · 表3;HTML元素 #S2.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S3.T4
原站图表/证明入口
- 表6 · 表6;HTML元素 #S4.T6
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 形式化RL教师输出经过筛选后供SFT学习的条件分布。
- 加入检查器敏感度/误报率与通过者真实正确率的算例。
- 解释重启V3-Base训练与结果验证不能认证全推导的边界。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表5、图2、表2、图3、表3、表4、表6
- v2:问答核查:R1-Zero 的 Zero 到底排除了什么,又没有排除什么等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2.2.1–2.2.4 GRPO与规则奖励、图2/表2;§2.3.1–2.3.3冷启动、语言奖励与拒绝采样SFT。
技术关系
- 092-deepseekv3 · 模块组合
V3-Base提供RL与SFT基础模型
- 086-deepseekmath · 直接继承
直接沿用GRPO优化框架
- 095-s1 · 平行方法
监督适配和解码控制是不同后训练路线
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型s1: Simple Test-Time Scaling部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:模型会解题却过早或过晚结束时,怎样控制停止
- 二、分开精选长推理监督与解码条件分布改变
- 三、按预算截断或追加Wait并记录全部尝试成本
- 四、对照SFT、停止规则、饱和区与训练截断
- 五、小样本差异与基座能力限制简单扩展结论
- 六、从单轨迹停止转向多分支控制与完整账本
- 七、自测与答案
段落怎样重新安排
- 二、研究背景与问题定义 → 模型会解题却过早或过晚结束时,怎样控制停止
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一、一分钟理解 → 小样本差异与基座能力限制简单扩展结论
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 小样本差异与基座能力限制简单扩展结论
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 从单轨迹停止转向多分支控制与完整账本
真实关系移到后继路线,避免目录相邻等于技术继承
- 三、方法:数据选择与解码控制各做什么 → 分开精选长推理监督与解码条件分布改变
保留原推导
- 三、方法:数据选择与解码控制各做什么 → 分开精选长推理监督与解码条件分布改变
保留原推导
- 四、实验如何验证 → 对照SFT、停止规则、饱和区与训练截断
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、建立理解 → 分开精选长推理监督与解码条件分布改变
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、建立理解 → 小样本差异与基座能力限制简单扩展结论
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果与证据 → 对照SFT、停止规则、饱和区与训练截断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据 → 对照SFT、停止规则、饱和区与训练截断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据 → 对照SFT、停止规则、饱和区与训练截断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据 → 对照SFT、停止规则、饱和区与训练截断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据 → 对照SFT、停止规则、饱和区与训练截断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果与证据 → 对照SFT、停止规则、饱和区与训练截断
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 小样本差异与基座能力限制简单扩展结论
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 小样本差异与基座能力限制简单扩展结论
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 小样本差异与基座能力限制简单扩展结论
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 按预算截断或追加Wait并记录全部尝试成本
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 追加Wait后还要给最终答案留出空间
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、从单轨迹停止转向多分支控制与完整账本
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 追加Wait后还要给最终答案留出空间:追加Wait后还要给最终答案留出空间
教法来源与实际阅读范围
- Lilian Weng · Prompt Engineering
零样本/少样本、示例选择与顺序、指令提示、Self-Consistency、CoT与STaR、ToT及API扩展
原论文校准:s1预算强制与阶段停止控制;数字为部署协议例,不替换论文实际token配置。
本篇校准范围:s1预算强制与阶段停止控制;数字为部署协议例,不替换论文实际token配置。 新增段落仅用于“追加Wait后还要给最终答案留出空间”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- s1通过预算强制延长推理时的成绩与生成token数量变化
实验/结果图 · 必要原图摘引 · 图4,HTML #S3.F4
证据 4:图4,扩展的尽头。 延长 2/4/6 次形成若干更高预算点,但收益在六次附近趋平,论文报告过度阻止结束可能引发重复。并行比较使用的是基础 Qwen,串行比较使用经过 s1K 微调的模型,因此图中差异不能单独证明串行计算普遍优于并行计算。 顺序扩展图最右三点分别阻止结束2、4、6次并追加 Wait;并行图则通过不同数量的独立答案投票,两个横轴预算不能只按调用次数视作等价。
未在正文展示的图/表与范围
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表7:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表4、表2、表3、图4、表7
- 问答核查:1000 条训练样本为什么不等于只用 1000 条数据就获得全部推理知识等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 表4 · 表4;HTML元素 #S5.T4
原站图表/证明入口
- 表2 · 表2;HTML元素 #S5.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 表7 · 表7;HTML元素 #A3.T7
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导屏蔽停止token后的条件分布,并区分强制追加Wait。
- 用几何等待次数核算长度拒绝采样真实生成成本。
- 将输出变长与训练/解码因果机制分开。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表4、表2、表3、图4、表7
- v2:问答核查:1000 条训练样本为什么不等于只用 1000 条数据就获得全部推理知识等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.1预算强制与长度拒绝采样,§3.2评估口径,表3–4硬控制与续写字符串消融。
技术关系
- 053-cot · 历史背景
显式解题过程成为可分配推理资源的基础
- 091-test-time-scaling · 历史背景
继续研究顺序预算扩展
- 094-r1 · 平行方法
RL改变策略与SFT加停止干预的区别
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Large Language Diffusion Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不固定左到右顺序,怎样把掩码恢复变成生成模型
- 二、由破坏边际推导训练权重与反向揭示概率
- 三、按时间表迭代填空并区分随机与置信度重掩码
- 四、对照同数据扩展、采样策略和方向任务
- 五、双向重算与单次大训练限制效率和稳定性外推
- 六、借用完整成本协议,但重建扩散自己的计算图
- 七、自测与答案
段落怎样重新安排
- 二、问题定义:生成原则与生成顺序 → 不固定左到右顺序,怎样把掩码恢复变成生成模型
问题单独建模,原背景中的目标与公式迁入方法推导
- 一、一分钟理解 → 双向重算与单次大训练限制效率和稳定性外推
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 双向重算与单次大训练限制效率和稳定性外推
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 借用完整成本协议,但重建扩散自己的计算图
真实关系移到后继路线,避免目录相邻等于技术继承
- 二、问题定义:生成原则与生成顺序 → 由破坏边际推导训练权重与反向揭示概率
保留完整公式和事实约束
- 三、方法:训练怎样对应到生成 → 由破坏边际推导训练权重与反向揭示概率
保留原推导
- 三、方法:训练怎样对应到生成 → 由破坏边际推导训练权重与反向揭示概率
保留原推导
- 三、方法:训练怎样对应到生成 → 由破坏边际推导训练权重与反向揭示概率
保留原推导
- 四、实验设置 → 对照同数据扩展、采样策略和方向任务
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、建立理解 → 由破坏边际推导训练权重与反向揭示概率
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、建立理解 → 双向重算与单次大训练限制效率和稳定性外推
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果:哪些结论足够强 → 对照同数据扩展、采样策略和方向任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:哪些结论足够强 → 对照同数据扩展、采样策略和方向任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:哪些结论足够强 → 对照同数据扩展、采样策略和方向任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:哪些结论足够强 → 对照同数据扩展、采样策略和方向任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:哪些结论足够强 → 对照同数据扩展、采样策略和方向任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:哪些结论足够强 → 对照同数据扩展、采样策略和方向任务
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 双向重算与单次大训练限制效率和稳定性外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 双向重算与单次大训练限制效率和稳定性外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 双向重算与单次大训练限制效率和稳定性外推
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 按时间表迭代填空并区分随机与置信度重掩码
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 同一噪声水平下监督位置不是固定的一组
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、借用完整成本协议,但重建扩散自己的计算图
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 摘要动机已合入问题,具体机制在正文展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 同一噪声水平下监督位置不是固定的一组:同一噪声水平下监督位置不是固定的一组
教法来源与实际阅读范围
- Lilian Weng · What are Diffusion Models?
前向噪声、反向条件、重参数化与条件生成
原论文校准:LLaDA前向独立掩码与噪声条件目标;借用先定义破坏分布再读恢复的扩散教法,不把连续高斯公式移入离散文本。
本篇校准范围:LLaDA前向独立掩码与噪声条件目标;借用先定义破坏分布再读恢复的扩散教法,不把连续高斯公式移入离散文本。 新增段落仅用于“同一噪声水平下监督位置不是固定的一组”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- LLaDA与自回归基线在同数据计算规模扫描中的六任务准确率
实验/结果图 · 必要原图摘引 · 图3,HTML #S2.F3
证据 1:图3,扩展趋势。 同数据对照中,扩散模型随计算增加在六项任务上呈现有竞争力的趋势。作者没有拟合定量幂律,以免离群点误导。这支持“可以扩展到较大规模”,不支持一个已确定的扩散优势指数。 规模图在同一训练数据下扫描计算 FLOPs,并比较六项任务;它提供给定架构与配方的经验曲线,不是扩散生成优于所有自回归模型的定理。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表6:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图3、表1、表6、表3、表2
- 问答核查:LLaDA 的双向注意力是否构成答案泄漏等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 图3 · 图3;HTML元素 #S2.F3
原站图表/证明入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表6 · 表6;HTML元素 #A2.T6
原站图表/证明入口
- 表3 · 表3;HTML元素 #S3.T3
原站图表/证明入口
- 表2 · 表2;HTML元素 #S3.T2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 从掩码指示期望解释1/t的计数作用并限定其非似然证明。
- 以8位置两轮采样核算s/t和边际掩码数量。
- 核验算法5已揭示/重掩码变量矛盾,给出终点不变量。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图3、表1、表6、表3、表2
- v2:问答核查:LLaDA 的双向注意力是否构成答案泄漏等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2训练/生成机制,附录A.1式7–13、算法4–5与A.2掩码数量和似然估计。
技术关系
- 018-bert · 历史背景
双向掩码恢复任务与生成扩散的联系
- 015-transformer · 平行方法
不同联合生成分解
- 100-tts-protocol · 教学联系
成本核算可借鉴,AR前缀树形式不能直接照搬
仍需留意
- v1算法5的n_un定义为已揭示数量,后文却据此重掩码;与时间终点不符,正文使用文字和概率定义解释,未运行作者实现。
- 未独立复现8B训练、全部基准或采样性能。
大语言模型DAPO: An Open-Source LLM Reinforcement Learning System at Scale部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同样GRPO公式下,学习信号会在哪些实现环节消失
- 二、分开裁剪、有效题组、token权重与长度奖励
- 三、固定旧策略采样并记入被丢弃题组的成本
- 四、用累计消融与动态曲线辨别组件交互
- 五、可验证数学与奖励边界限制配方泛化
- 六、将训练信号账本与部署推理账本分开核算
- 七、自测与答案
段落怎样重新安排
- 二、问题设定与瓶颈 → 同样GRPO公式下,学习信号会在哪些实现环节消失
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一、一分钟理解 → 可验证数学与奖励边界限制配方泛化
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 可验证数学与奖励边界限制配方泛化
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 将训练信号账本与部署推理账本分开核算
真实关系移到后继路线,避免目录相邻等于技术继承
- 三、四项修改分别改变什么 → 分开裁剪、有效题组、token权重与长度奖励
保留原推导
- 三、四项修改分别改变什么 → 分开裁剪、有效题组、token权重与长度奖励
保留原推导
- 三、四项修改分别改变什么 → 分开裁剪、有效题组、token权重与长度奖励
保留原推导
- 三、四项修改分别改变什么 → 分开裁剪、有效题组、token权重与长度奖励
保留原推导
- 四、实验如何验证 → 用累计消融与动态曲线辨别组件交互
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、建立理解 → 分开裁剪、有效题组、token权重与长度奖励
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、建立理解 → 可验证数学与奖励边界限制配方泛化
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果:看累计表,也看训练动态 → 用累计消融与动态曲线辨别组件交互
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:看累计表,也看训练动态 → 用累计消融与动态曲线辨别组件交互
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:看累计表,也看训练动态 → 用累计消融与动态曲线辨别组件交互
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:看累计表,也看训练动态 → 用累计消融与动态曲线辨别组件交互
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:看累计表,也看训练动态 → 用累计消融与动态曲线辨别组件交互
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:看累计表,也看训练动态 → 用累计消融与动态曲线辨别组件交互
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:看累计表,也看训练动态 → 用累计消融与动态曲线辨别组件交互
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 可验证数学与奖励边界限制配方泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 可验证数学与奖励边界限制配方泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 可验证数学与奖励边界限制配方泛化
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 固定旧策略采样并记入被丢弃题组的成本
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 裁剪上界不是训练后概率的硬上限
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、将训练信号账本与部署推理账本分开核算
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 裁剪上界不是训练后概率的硬上限:裁剪上界不是训练后概率的硬上限
原论文校准与展开范围
原论文校准:DAPO Clip-Higher与PPO式min目标;数值自构,明确非硬投影约束。
本篇校准范围:DAPO Clip-Higher与PPO式min目标;数值自构,明确非硬投影约束。 新增段落仅用于“裁剪上界不是训练后概率的硬上限”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:6 幅
- DAPO启用Clip-Higher后的AIME准确率和生成策略熵曲线
实验/结果图 · 必要原图摘引 · 图2,HTML #S2.F2
证据 2:图2,熵塌缩。 对照展示 Clip-Higher 后策略熵与准确率更有利的训练轨迹。它支持作者设置中探索退化被缓解,不是熵越大越好。图7 和正文也指出过高熵可能对应乱码、重复与无效探索。 熵、长度、奖励与验证准确率是分开的监控量;先看每幅图的纵轴再判断变化,尤其不能用训练奖励上涨替代留出题正确率。
- DAPO启用动态采样前后达到相近AIME表现所需训练步数
实验/结果图 · 必要原图摘引 · 图6,HTML #S4.F6
证据 4:图6,动态采样效率。 作者报告额外采样没有显著拖慢该同步系统,并更快达到目标表现。解释涉及长尾回答主导生成等待时间,因此硬件利用与调度很重要;换成不同异步系统或更低有效组比例,结论可能改变。
- DAPO训练过程中回答长度、奖励、熵和平均概率的四组曲线
实验/结果图 · 必要原图摘引 · 图7,PDF第10页
**证据 2:[图2](https://arxiv.org/html/2503.14476v1#S2.F2),熵塌缩。** 对照展示 Clip-Higher 后策略熵与准确率更有利的训练轨迹。它支持作者设置中探索退化被缓解,不是熵越大越好。[图7](https://arxiv.org/html/2503.14476v1#S4.F7) 和正文也指出过高熵可能对应乱码、重复与无效探索。 熵、长度、奖励与验证准确率是分开的监控量;先看每幅图的纵轴再判断变化,尤其不能用训练奖励上涨替代留出题正确率。
- DAPO是否使用token级损失时生成熵及平均回答长度的变化
实验/结果图 · 必要原图摘引 · 图4,PDF第6页
**证据 3:[图4](https://arxiv.org/html/2503.14476v1#S3.F4)、[图5](https://arxiv.org/html/2503.14476v1#S3.F5),长度与奖励。** token 级平均和超长处理使训练动态改善。尤其是截断样本过滤,不需要先发明复杂奖励模型,便能降低一种确定存在的标注混淆。但长度曲线健康只是诊断信号,不能代替独立正确率。
- DAPO超长回答过滤对AIME准确率和生成熵的影响
实验/结果图 · 必要原图摘引 · 图5,PDF第7页
**证据 3:[图4](https://arxiv.org/html/2503.14476v1#S3.F4)、[图5](https://arxiv.org/html/2503.14476v1#S3.F5),长度与奖励。** token 级平均和超长处理使训练动态改善。尤其是截断样本过滤,不需要先发明复杂奖励模型,便能降低一种确定存在的标注混淆。但长度曲线健康只是诊断信号,不能代替独立正确率。
- DAPO训练步数与AIME2024平均、任一及共识正确率
实验/结果图 · 必要原图摘引 · 图1,PDF第1页
**证据 5:[图1](https://arxiv.org/html/2503.14476v1#S0.F1) 与 §4.3,步数与泛化。** 作者比较 50 分与 R1-Zero-Qwen-32B 的 47 分,并称使用约一半训练步数。每步采样与更新量不同,不能将其写成成本减少一半。§4.3 还指出训练奖励与验证正确率相关性可能很低,直接反对“奖励曲线涨了就说明泛化变好”的理解。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:图6、表1、图2、图7、图4、图5、图1
- 问答核查:动态采样为什么保留“同题有对有错”,而不是只保留正确回答等3题均有独立对应答案;保留已有有效解释
查看本篇 7 个原文证据入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 图2 · 图2;HTML元素 #S2.F2
原站图表/证明入口
- 图7 · 图7;HTML元素 #S4.F7
原站图表/证明入口
- 图4 · 图4;HTML元素 #S3.F4
原站图表/证明入口
- 图5 · 图5;HTML元素 #S3.F5
原站图表/证明入口
- 图1 · 图1;HTML元素 #S0.F1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导有效题组概率及采样后课程分布。
- 用G=16核算极端题需6.73组的额外采样成本。
- 联系图6限定同步系统收益,区分训练步数与总成本。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:图6、表1、图2、图7、图4、图5、图1
- v2:问答核查:动态采样为什么保留“同题有对有错”,而不是只保留正确回答等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增2幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.2动态采样式11、§3.3 token级目标、§4.1配置、表1累计消融和图6同步采样效率。
技术关系
- 086-deepseekmath · 直接继承
在GRPO组内优势框架上修改训练机制
- 094-r1 · 历史背景
长推理RL训练比较的参考
- 100-tts-protocol · 教学联系
统一预算原则用于区分训练与部署成本
仍需留意
- 本轮复核所列方法与证据章节,未逐项重新审计全部附录、未独立复现实验。
大语言模型Inference-Time Scaling of Verification: Self-Evolving Deep Research Agents via Test-Time Rubric-Guided Verification部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:第二个模型说合理时,怎样把可疑环节变成外部查证
- 二、分解失败类型并推导纠错收益与误报代价
- 三、执行独立核查后返回可操作反馈再修订
- 四、同时读取裁判F1、错转对与对转错
- 五、共有偏差与轮次选择会限制越查越好
- 六、用完整预算和因果停止协议检验核查系统
- 七、自测与答案
段落怎样重新安排
- 二、问题定义与失败分类 → 第二个模型说合理时,怎样把可疑环节变成外部查证
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一、一分钟理解 → 共有偏差与轮次选择会限制越查越好
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 共有偏差与轮次选择会限制越查越好
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 用完整预算和因果停止协议检验核查系统
真实关系移到后继路线,避免目录相邻等于技术继承
- 三、方法:从轨迹到可执行核查 → 分解失败类型并推导纠错收益与误报代价
保留原推导
- 三、方法:从轨迹到可执行核查 → 分解失败类型并推导纠错收益与误报代价
保留原推导
- 三、方法:从轨迹到可执行核查 → 分解失败类型并推导纠错收益与误报代价
保留原推导
- 四、实验设计 → 同时读取裁判F1、错转对与对转错
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、建立理解 → 执行独立核查后返回可操作反馈再修订
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、建立理解 → 共有偏差与轮次选择会限制越查越好
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果:收益与回退一起看 → 同时读取裁判F1、错转对与对转错
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:收益与回退一起看 → 同时读取裁判F1、错转对与对转错
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:收益与回退一起看 → 同时读取裁判F1、错转对与对转错
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:收益与回退一起看 → 同时读取裁判F1、错转对与对转错
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:收益与回退一起看 → 同时读取裁判F1、错转对与对转错
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:收益与回退一起看 → 同时读取裁判F1、错转对与对转错
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:收益与回退一起看 → 同时读取裁判F1、错转对与对转错
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 共有偏差与轮次选择会限制越查越好
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 共有偏差与轮次选择会限制越查越好
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献、代价与局限 → 共有偏差与轮次选择会限制越查越好
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 执行独立核查后返回可操作反馈再修订
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 反馈要区分被反驳与尚未证实
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、用完整预算和因果停止协议检验核查系统
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 反馈要区分被反驳与尚未证实:反馈要区分被反驳与尚未证实
原论文校准与展开范围
原论文校准:DeepVerifier证据核查、分解与修订反馈;是正文同名作者例的执行细化,不声称能消除全部误拒。
本篇校准范围:DeepVerifier证据核查、分解与修订反馈;是正文同名作者例的执行细化,不声称能消除全部误拒。 新增段落仅用于“反馈要区分被反驳与尚未证实”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- 验证轮数对GAIA相对表现的影响及验证模型之间的成绩比较
实验/结果图 · 必要原图摘引 · 图1,HTML #S0.F1
证据 5:§7.3 与图1,小模型适配。 DeepVerifier-8B 反思后完整 GAIA 约 32.2%,比自身无反思提高约 5.5 点;仅 CK-Pro 训练的模型改善约 2.6 点。它支持专门反馈数据有用,但混合训练、骨干能力与执行链共同影响结果,不能仅凭最终分数分离所有原因。 上面板是165道GAIA开发题的验证轮数曲线,下面板比较十轮后的模型;选择最佳停止轮数和报告独立测试成绩属于不同评价步骤。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表5:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表4:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表5、表2、表3、表4、图1
- 问答核查:没有额外训练的自我改进,改的是什么等3题均有独立对应答案;保留已有有效解释
查看本篇 6 个原文证据入口
- 表1 · 表1;HTML元素 #S3.T1
原站图表/证明入口
- 表5 · 表5;HTML元素 #S7.T5
原站图表/证明入口
- 表2 · 表2;HTML元素 #S7.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S7.T3
原站图表/证明入口
- 表4 · 表4;HTML元素 #S7.T4
原站图表/证明入口
- 图1 · 图1;HTML元素 #S0.F1
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 把发现错误、可执行反馈、修订成功和误改拆成条件概率链。
- 手算80%和95%起点下收益反转,区分误报率与1-precision。
- 用转移证据说明F1不足以决定最终系统收益和停止。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表5、表2、表3、表4、图1
- v2:问答核查:没有额外训练的自我改进,改的是什么等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3人工失败分类、§4.1–4.2核查和裁判、表2拒错指标、表3和表5迭代正确率与双向转移。
技术关系
- 082-self-rag · 平行方法
生成时支持自评与事后外部核查两条路线
- 087-sweagent · 教学联系
工具反馈影响后续行动的跨任务对照
- 100-tts-protocol · 教学联系
评价完整核查系统及停止成本
仍需留意
- 本文参数模型和8/9阈值为原创教学设定,不是论文拟合。
- v2训练超参数未完整列出;未独立复现网页工具、反馈轮数实验或费用。
大语言模型LLMs Improving LLMs: Agentic Discovery for Test-Time Scaling部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:预算分配规则怎样在有限轨迹池中被搜索出来
- 二、定义可见状态、控制动作与趋势反馈
- 三、因果回放分支和探针并累计已耗费用
- 四、按保留任务、模型规模和Pareto取舍读结果
- 五、轨迹覆盖与改写提示限制离线反事实
- 六、把固定响应库诊断接到独立在线复现
- 七、自测与答案
段落怎样重新安排
- 二、问题定义:搜索控制规则,而非重新训练模型 → 预算分配规则怎样在有限轨迹池中被搜索出来
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一、一分钟理解 → 轨迹覆盖与改写提示限制离线反事实
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 轨迹覆盖与改写提示限制离线反事实
把结果及能力限制留到证据或边界中解释
- 一、一分钟理解 → 把固定响应库诊断接到独立在线复现
真实关系移到后继路线,避免目录相邻等于技术继承
- 三、方法:怎样让搜索既便宜又不失真 → 定义可见状态、控制动作与趋势反馈
保留原推导
- 三、方法:怎样让搜索既便宜又不失真 → 定义可见状态、控制动作与趋势反馈
保留原推导
- 三、方法:怎样让搜索既便宜又不失真 → 定义可见状态、控制动作与趋势反馈
保留原推导
- 三、方法:怎样让搜索既便宜又不失真 → 定义可见状态、控制动作与趋势反馈
保留原推导
- 四、实验设置 → 按保留任务、模型规模和Pareto取舍读结果
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 七、建立理解 → 定义可见状态、控制动作与趋势反馈
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 七、建立理解 → 轨迹覆盖与改写提示限制离线反事实
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 五、结果:不要只看相对 SC@64 的节省 → 按保留任务、模型规模和Pareto取舍读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:不要只看相对 SC@64 的节省 → 按保留任务、模型规模和Pareto取舍读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:不要只看相对 SC@64 的节省 → 按保留任务、模型规模和Pareto取舍读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:不要只看相对 SC@64 的节省 → 按保留任务、模型规模和Pareto取舍读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:不要只看相对 SC@64 的节省 → 按保留任务、模型规模和Pareto取舍读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 五、结果:不要只看相对 SC@64 的节省 → 按保留任务、模型规模和Pareto取舍读结果
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 轨迹覆盖与改写提示限制离线反事实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 轨迹覆盖与改写提示限制离线反事实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 六、贡献与局限 → 轨迹覆盖与改写提示限制离线反事实
把附加讨论放入对应的评价条件、能力边界或后继机制中
- 方法子节中的执行步骤 → 因果回放分支和探针并累计已耗费用
嵌套伪代码迁到实现,防止空实现节及推导—执行顺序倒置
- 已核原论文机制与适用的专业教法 → 证据5:图4搜索集与保留集的两轴轨迹
用原图坐标、数据拆分、放大窗和非单调变化替换笼统描述,并将发现费用归回§5.5。
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 证据5:图4搜索集与保留集的两轴轨迹:用原图坐标、数据拆分、放大窗和非单调变化替换笼统描述,并将发现费用归回§5.5。
原论文校准与展开范围
原论文校准:实际读取arXiv 2605.08083v1 §5.5、§5.6并查看原图4:Search AIME24 / Held-out AIME25+HMMT25、beta=1、token cost log scale、accuracy%,t3→t4在保留集上成本升而准确率降。
本篇校准范围:实际读取arXiv 2605.08083v1 §5.5、§5.6并查看原图4:Search AIME24 / Held-out AIME25+HMMT25、beta=1、token cost log scale、accuracy%,t3→t4在保留集上成本升而准确率降。 新增段落仅用于“证据5:图4搜索集与保留集的两轴轨迹”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:1 幅
- AutoTTS搜索过程中控制程序准确率与token费用的变化轨迹
实验/结果图 · 必要原图摘引 · 图4,HTML #S5.F4
证据 5:图4、§5.5,发现过程。 候选程序先过度省 token,随后提高预算恢复正确率,再寻找折中;并非每轮都同时提高两项指标。39.9 美元、160 分钟说明固定回放上的搜索可负担,不证明搭建整个实验只花这个数。首次生成 128 条轨迹及探针的成本没有凭空消失。 该图跟踪控制器搜索过程中准确率与费用的往复变化;每个点代表控制程序的调整,不是基础语言模型权重被训练后的学习曲线。
未在正文展示的图/表与范围
- 表1:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表2:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
- 表3:Table reference inventoried separately; Figure completion is the priority. The linked original remains available.
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、表2、表3、图4
- 问答核查:AutoTTS 是在训练一个新语言模型吗等3题均有独立对应答案;保留已有有效解释
查看本篇 4 个原文证据入口
- 表1 · 表1;HTML元素 #S5.T1
原站图表/证明入口
- 表2 · 表2;HTML元素 #S5.T2
原站图表/证明入口
- 表3 · 表3;HTML元素 #S5.T3
原站图表/证明入口
- 图4 · 图4;HTML元素 #S5.F4
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 把CMC趋势平滑转成三步信心的可核算教学轨迹。
- 核算剪枝沉没成本和探测成本,区分回放与在线账本。
- 解释未来信号暴露与改变提示后反事实回放失效的边界。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、表2、表3、图4
- v2:问答核查:AutoTTS 是在训练一个新语言模型吗等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§2状态、合法动作和Cost(s);§3.1回放、§3.2选择、§4实验全为离线;附录D CMC四项机制。
技术关系
- 091-test-time-scaling · 历史背景
从预算分配问题发展到控制器自动发现
- 095-s1 · 平行方法
单轨迹停止控制与多分支控制的不同空间
- 100-tts-protocol · 教学联系
区分固定库诊断和完整在线系统证据
仍需留意
- CMC平滑系数和阈值是明示教学设定,未运行或逐行审计作者控制器。
- 原实验全为固定轨迹池离线回放;在线探测、预采集成本及新轨迹泛化未在此核验。
大语言模型Test-Time Scaling in Reasoning LLMs: Inference Regimes, Evaluation, and Reproducibility部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:候选里答对过,怎样证明最终系统会选对
- 二、区分单轨迹、聚合和前缀搜索的测量对象
- 三、保存生成、验证、选择与停止的完整账本
- 四、按候选库分母、误差带和验证成本解释曲线
- 五、固定响应库不能替代改变生成过程的在线复现
- 六、回到具体方法核查生成、选择与停止协议
- 自测:能回答这些问题,才真正掌握评估思想
段落怎样重新安排
- 问题定义:预算究竟买到了什么 → 候选里答对过,怎样证明最终系统会选对
合并原摘要动机与背景首段,消除重复定义而保留问题条件
- 一分钟理解:模型答对过,不等于产品会答对 → 固定响应库不能替代改变生成过程的在线复现
把结果及能力限制留到证据或边界中解释
- 一分钟理解:模型答对过,不等于产品会答对 → 固定响应库不能替代改变生成过程的在线复现
把结果及能力限制留到证据或边界中解释
- 一分钟理解:模型答对过,不等于产品会答对 → 回到具体方法核查生成、选择与停止协议
真实关系移到后继路线,避免目录相邻等于技术继承
- 方法:把生成、证据、决策和停止分开 → 区分单轨迹、聚合和前缀搜索的测量对象
先给出信息路径、目标与机制,再讨论执行顺序
- 方法:把生成、证据、决策和停止分开 → 保存生成、验证、选择与停止的完整账本
单列可执行步骤,与机制论证及经验结果区分
- 方法:把生成、证据、决策和停止分开 → 保存生成、验证、选择与停止的完整账本
保留实现限制、训练协议及指标接口
- 指标:一次成功与持续成功是两种能力 → 区分单轨迹、聚合和前缀搜索的测量对象
保留完整公式和事实约束
- 指标:一次成功与持续成功是两种能力 → 区分单轨迹、聚合和前缀搜索的测量对象
保留原推导
- 实验设计与证据 → 按候选库分母、误差带和验证成本解释曲线
在实现条件固定后读取原图与实验,不丢失任何证据限制
- 贡献、局限与一个具体例子 → 固定响应库不能替代改变生成过程的在线复现
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与一个具体例子 → 保存生成、验证、选择与停止的完整账本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与一个具体例子 → 保存生成、验证、选择与停止的完整账本
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 贡献、局限与一个具体例子 → 固定响应库不能替代改变生成过程的在线复现
把教学构造放在它所检验的机制、协议或边界旁,不再正文末尾统一补课
- 已核原论文机制与适用的专业教法 → 因果停止必须在每个前缀上可重放
补充可核算的中间步骤与诊断,而非增加同义摘要
- 原阅读路线及重复前作说明 → ## 六、回到具体方法核查生成、选择与停止协议
用正文未解决的限制提出后继检查,区别于开头建立的问题来路
合并的重复说明
- 取消统一先行摘要,信息已按问题、证据和边界拆入正文;内容保留于问题设定、机制、证据及边界。
- 两段重复解释同一任务,改写为一段具体问题,机制细节在方法节完整展开;内容保留于一、问题设定及二、机制推导。
- 固定五列表重复已展开的问题、改动、证据和局限;内容保留于一至五节的对应论证和原证据链接。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 因果停止必须在每个前缀上可重放:因果停止必须在每个前缀上可重放
原论文校准与展开范围
原论文校准:推理评估论文对固定响应库、候选聚合和因果控制的边界;新增重放诊断,不声称论文框架覆盖所有在线工具策略。
本篇校准范围:推理评估论文对固定响应库、候选聚合和因果控制的边界;新增重放诊断,不声称论文框架覆盖所有在线工具策略。 新增段落仅用于“因果停止必须在每个前缀上可重放”的计算与诊断,不扩大原实验结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题核对,三道原自测及全部答案保留;只忽略v2已有来源链接包装与空格差异。本轮没有删题、重写答案或重复新增同义题。
正文配图:2 幅
- 测试时采样预算、正确候选覆盖、排序一致性和答案选择器表现
实验/结果图 · 必要原图摘引 · 图5,HTML #S4.F5
证据 1|图5、表11:发现与选择的落差。Qwen3-30B-A3B-Thinking-2507 在该题集的 Pass@80 为 91.67%,字符串投票为 78.33%。相减得到 13.34 个百分点。这说明正确候选的存在没有充分转化为提交答案;不能推导一个未知的完美验证器必然能无成本填平差距。 候选曲线横轴只计生成候选,明确排除验证计算;部分误差带反映配置分布,另一些是问题 bootstrap。先看图例定义,再比较选择器与 Pass@k 上界。
- 四种模型设置下多数投票、点式排序与pass@k上限的差距
实验/结果图 · 必要原图摘引 · 图6,PDF第20页
**证据 3|[图6](https://arxiv.org/html/2608.04001v1#S4.F6):成本横轴的边界。**横轴是候选数量,未包含验证计算。因此曲线可用于观察候选增加与聚合效果的关系,不能直接宣称验证器方案在同等总算力下胜出。这是论文自己限定的口径,而不是额外发现一个隐藏训练损失。
未在正文展示的图/表与范围
仅摘引与文中具体解读有关的原图或结果表,未独立运行原实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- 在图结论旁补充坐标/面板含义和该图不能支持的外推
- 原文定位已接入正文:表1、图5、表11、图6、图2
- 问答核查:Pass@80 为 90%,能否说用户有 90% 的概率得到正确答案等3题均有独立对应答案;保留已有有效解释
查看本篇 5 个原文证据入口
- 表1 · 表1;HTML元素 #S4.T1
原站图表/证明入口
- 图5 · 图5;HTML元素 #S4.F5
原站图表/证明入口
- 表11 · 表11;HTML元素 #A7.T11
原站图表/证明入口
- 图6 · 图6;HTML元素 #S4.F6
原站图表/证明入口
- 图2 · 图2;HTML元素 #S2.F2
原站图表/证明入口
本轮边界:本轮核读已有问答并核对所链接原图/表的标题、图注和位置;未重新核算所有实验数字,也未运行训练、推理或复现实验。
本次深化
- 推导有限库无放回的组合分母和尾概率。
- 5条候选抽3条计算覆盖0.9、严格多数0.3并对比IID0.784。
- 逐块核加表1为1,948,821,保留摘要与引言冲突及未审计发布记录边界。
- v2:压缩篇首查阅范围与重复未复现说明,保留版本及方法区别
- v2:在图结论旁补充坐标/面板含义和该图不能支持的外推
- v2:原文定位已接入正文:表1、图5、表11、图6、图2
- v2:问答核查:Pass@80 为 90%,能否说用户有 90% 的概率得到正确答案等3题均有独立对应答案;保留已有有效解释
- v2行内图:新增1幅经逐图视觉核验的原论文关键图/表,紧邻对应解读,提供本地放大与原文定位
查核资料
- arxiv.org · 所列章节
§3.3成本与因果停止、§3.4独立尝试与有限库评价剖面、§3.5复现;摘要/引言/表1及结论的数量冲突。
技术关系
- 056-self-consistency · 历史背景
投票的候选与最终输出区分
- 091-test-time-scaling · 历史背景
预算分配导致评估对象变化
- 099-autotts · 教学联系
将回放与系统复现的标准用于具体控制器研究
仍需留意
- v1摘要称超过2 billion、引言称超过2 million、表1/结论为1,948,821;本轮只核了原文和加和,未下载审计全量语料。
- 未独立生成候选库、复核全套发布记录或重跑系统比较。
大语言模型从语言建模到推理系统:把论文思想变成可检验的问题部分核验,边界见下
本次深化
- 新增低秩参数存储可核算账本
- 用条件概率反例说明候选覆盖提高仍可能降低最终准确率
- 拆分索引检索生成评委工具费用并区分延迟关键路径
- 把新账本放在原有三个实验设计之前支撑归因
- v2:为3个自构研究问题补条件式参考结论与判定方法,不捏造实验结果
- v2:保留3道总结自测与答案
- v2:将重复阅读范围段改为按瓶颈返回具体机制的链接
查核资料
- arxiv.org · 所列章节
低秩参数化与可训练参数计算
- arxiv.org · 所列章节
量化基座及元数据开销
- arxiv.org · 所列章节
代码生成候选覆盖pass@k口径
- arxiv.org · 所列章节
服务吞吐与缓存布局
技术关系
- 047-lora · 教学联系
更新参数与总存储分别计数
- 074-qlora · 教学联系
进一步核算基座和量化元数据
- 048-codex · 教学联系
候选覆盖与最终选择的条件概率分解
- 079-vllm · 教学联系
计算策略与服务调度收益不同
仍需留意
- 辅助篇基于本轮已核读的相关论文方法/实验章节作教学综合;未据此声称全系列每个数字已复核或教学实验已实际运行。
大语言模型大语言模型:100 篇论文的思想与证据部分核验,边界见下
本次深化
- 新增七条由具体瓶颈推动的连续阅读路线
- 明确继承平行与组合关系避免年代即替代
- 加入机制反例证据下一问题四行阅读产物
- 同步RLAIF当前核读版本题名并链接零基础导读
- v2:核对7条问题式阅读路线及记录模板;问题后已有具体机制和行动解释,保留原文
查核资料
- arxiv.org · 所列章节
DPO优化轴与偏好来源区分
- arxiv.org · 所列章节
RLAIF v3标题与反馈来源轴
- arxiv.org · 所列章节
GQA的KV结构轴
- arxiv.org · 所列章节
PagedAttention的动态缓存分配轴
技术关系
- 075-dpo · 教学联系
偏好优化路线入口
- 080-rlaif · 教学联系
与优化轴交叉的AI反馈路线
- 073-gqa · 教学联系
状态结构与服务效率路线
- 079-vllm · 教学联系
缓存分配与服务效率路线
仍需留意
- 辅助篇基于本轮已核读的相关论文方法/实验章节作教学综合;未据此声称全系列每个数字已复核或教学实验已实际运行。
机器人学习Day 0|机器人学习阅读入门:从一次示范到真实动作部分核验,边界见下
本次深化
- 新增20Hz/16步预测/8步执行的时钟手算
- 增补真机预算单与接管分母
- 加入50Hz动作不等于50Hz视觉反馈自测
- v2检查:现有自测/提问已有对应说明,机制链接有效,无需机械增加问题
查核资料
技术关系
- 095-smolvla · 教学联系
用队列实例解释导读中的控制时间轴
仍需留意
- 本轮审查辅助文中的问题是否有答案、来源使用说明与机制阅读链接;没有在辅助文层再次完整审计100篇全部实验或运行复现。
机器人学习机器人学习发展时间线:从示范运动到通用动作模型部分核验,边界见下
本次深化
- 新增八条明确方向与类型的研究关系
- 用观察表示/双手同步解释前作瓶颈如何延续
- 区分年代顺序与历史继承
- v2:用Diffusion Policy完整作答五个阅读检查问题,串联动作分布、执行时序和泛化变量
查核资料
技术关系
- 071-mimicgen · 教学联系
数据生成主线的入口
- 088-dexmimicgen · 教学联系
以直接继承案例解释时间线连线
仍需留意
- 本轮审查辅助文中的问题是否有答案、来源使用说明与机制阅读链接;没有在辅助文层再次完整审计100篇全部实验或运行复现。
机器人学习Learning Attractor Landscapes for Learning Motor Primitives部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:目标移动后,示范轨迹怎样继续
- 二、让学习项塑造过程,让吸引子决定终点
- 三、把示范回归和离散执行接起来
- 四、用原图分辨幅值、速度和目标的复用
- 五、检查吸引性之外的接触与执行边界
- 六、把运动表示接到优化,或改成分布
- 七、自测题与参考答案
段落怎样重新安排
- 二、任务、信号与假设 → 一、问题设定:目标移动后,示范轨迹怎样继续
先确定输入输出与学习对象再推公式
- 一、为什么一条示范轨迹还不够 → 二、让学习项塑造过程,让吸引子决定终点
把原开场的答案移至机制展开处
- 六、用一个小例子理解终点与形状的分工 → 二、让学习项塑造过程,让吸引子决定终点
在执行与实验前检验门控如何保留终点
合并的重复说明
- 提前重复方法和边界;内容保留于第二节机制与第五节边界。
- 重复历史关系;内容保留于独立前作桥及第六节后继路线。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 四、用原图分辨幅值、速度和目标的复用:区分公式对象与图中变量
- 二、让学习项塑造过程,让吸引子决定终点:先区分点稳定与轨道稳定,再解释节律参数
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Algorithms for Limit Cycles
Opening; Lyapunov analysis; transverse coordinates
原论文校准:本轮重新打开原论文PDF,逐图查看本地Fig2,核对PDF第6页图注A–D、3–7秒与§3.2离散目标;figure原块不变
课程作为教法来源,不当作原论文额外实验;原数值、图块与题答保留。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Learning Attractor Landscapes for Learning Motor Primitives,图2:左侧虚线与实线分别是示范和拟合的关节轨迹;右侧分开改变幅值、时间尺度与中点。先区分这三种参数,再判断“复用”改变了什么。
实验/结果图 · 必要原图摘引 · PDF第6页,图2
左侧虚线与实线分别是示范和拟合的关节轨迹;右侧分开改变幅值、时间尺度与中点。先区分这三种参数,再判断“复用”改变了什么。
- Learning Attractor Landscapes for Learning Motor Primitives,图1:左半部的离散状态逐步收敛,右半部的相位与轨迹持续周期变化;两者的稳定对象不同。
实验/结果图 · 必要原图摘引 · PDF第4页,图1
左半部的离散状态逐步收敛,右半部的相位与轨迹持续周期变化;两者的稳定对象不同。
- Learning Attractor Landscapes for Learning Motor Primitives,图3:上排是人类挥拍示范,下排是机器人复现;连续帧展示运动形状,不能替代目标误差统计。
实验/结果图 · 必要原图摘引 · PDF第7页,图3
上排是人类挥拍示范,下排是机器人复现;连续帧展示运动形状,不能替代目标误差统计。
- Learning Attractor Landscapes for Learning Motor Primitives,图4:左侧比较字形轨迹及各坐标随时间变化,右侧相关矩阵比较参数相似性,不是通用识别准确率。
实验/结果图 · 必要原图摘引 · PDF第8页,图4
左侧比较字形轨迹及各坐标随时间变化,右侧相关矩阵比较参数相似性,不是通用识别准确率。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用004-power.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图1 · PDF文件第4页,图1
原站图表/证明入口
- 图2 · PDF文件第6页,图2
原站图表/证明入口
- 图3 · PDF文件第7页,图3
原站图表/证明入口
- 图4 · PDF文件第8页,图4
原站图表/证明入口
- 表1 · PDF文件第3页,表1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 方法内补特征根与临界阻尼推导
- 加入欧拉离散步长反例及硬件解释
- 区分与PoWER的模块组合、与ProMP的平行表示
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用004-power.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- proceedings.neurips.cc · 所列章节
§2.1式1—3、表1与§3.1;连续吸引子、门控与底层跟踪假设。
- proceedings.neurips.cc · 所列章节
v2实际核读:PDF第6页的图2图注及相关上下文;其余已定位图表见v2逐篇记录。左侧虚线与实线分别是示范和拟合的关节轨迹;右侧分开改变幅值、时间尺度与中点。先区分这三种参数,再判断“复用”改变了什么。
技术关系
- 004-power · 模块组合
PoWER用DMP作为可优化的结构化策略。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Apprenticeship Learning via Inverse Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不识别唯一奖励,怎样约束专家性能差距
- 二、用特征距离界定奖励家族内的性能差
- 三、交替找奖励方向与求解新策略
- 四、分别核对道路行为与正向规划成本
- 五、特征和初始分布改变后重查保证
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 六、一个二维例子 → 二、用特征距离界定奖励家族内的性能差
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、用特征距离界定奖励家族内的性能差
把问题与答案拆开,按推理到检验展开
- 二、什么是特征期望 → 一、问题设定:不识别唯一奖励,怎样约束专家性能差距
读者在接触方法前知道优化对象与信息权限
- 四、算法为何在奖励和策略之间交替 → 三、交替找奖励方向与求解新策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、特征和初始分布改变后重查保证:怎样检验学到的是任务偏好,还是初始状态分布的巧合?
原论文校准与展开范围
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Apprenticeship Learning via Inverse Reinforcement Learning,图4:横轴是专家轨迹数,且采用十进对数刻度;纵轴才是策略性能。不要把横轴的等距离误读成等量增加的示范,也不要与图3的算法迭代次数混用。
实验/结果图 · 必要原图摘引 · PDF第5页,图4
横轴是专家轨迹数,且采用十进对数刻度;纵轴才是策略性能。不要把横轴的等距离误读成等量增加的示范,也不要与图3的算法迭代次数混用。
- Apprenticeship Learning via Inverse Reinforcement Learning,图1:图中的策略特征期望与专家特征期望处于同一空间,分隔方向随迭代更新。
实验/结果图 · 必要原图摘引 · PDF第3页,图1
图中的策略特征期望与专家特征期望处于同一空间,分隔方向随迭代更新。
- Apprenticeship Learning via Inverse Reinforcement Learning,图2:投影过程使用已有策略特征期望的组合;投影点与某一个真实策略的特征期望不能混为一谈。
方法/设定图 · 必要原图摘引 · PDF第4页,图2
投影过程使用已有策略特征期望的组合;投影点与某一个真实策略的特征期望不能混为一谈。
- Apprenticeship Learning via Inverse Reinforcement Learning,图3:横轴是算法迭代次数,纵轴是到专家特征期望的距离;两种更新逐步缩小差距。
实验/结果图 · 必要原图摘引 · PDF第5页,图3
横轴是算法迭代次数,纵轴是到专家特征期望的距离;两种更新逐步缩小差距。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用003-maxent-irl.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
- 删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
查看本篇 5 个原文证据入口
- 图1 · PDF文件第3页,图1
原站图表/证明入口
- 图2 · PDF文件第4页,图2
原站图表/证明入口
- 图3 · PDF文件第5页,图3
原站图表/证明入口
- 图4 · PDF文件第5页,图4
原站图表/证明入口
- 表1 · PDF文件第7页,表1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 在性能界内拆分专家估计与训练匹配误差
- 增加罕见行人与缺失特征反例
- 明确IRL路线关系,并通过大学镜像核读原论文方法与有限样本证明
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用003-maxent-irl.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- doi.org · 摘要
出版社摘要确认线性已知特征与近专家性能;后续已另经大学镜像核读原论文节段。
- users.cs.utah.edu · 所列章节
§2—4特征期望、回合级策略混合、近专家性能界及附录有限样本误差分解。
- users.cs.utah.edu · 所列章节
v2实际核读:PDF第5页的图4图注及相关上下文;其余已定位图表见v2逐篇记录。横轴是专家轨迹数,且采用十进对数刻度;纵轴才是策略性能。不要把横轴的等距离误读成等量增加的示范,也不要与图3的算法迭代次数混用。
技术关系
- 003-maxent-irl · 历史背景
共同围绕特征匹配但解决奖励/路径歧义的目标不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Maximum Entropy Inverse Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多条路径都符合示范时怎样分配概率
- 二、从全局归一化推到特征差梯度
- 三、用后向权重与前向访问频率拟合分布
- 四、分开读取路径图与两种距离匹配指标
- 五、随机转移下区分动作选择与自然结果
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 一、示范不一致时,应该相信哪条轨迹 → 二、从全局归一化推到特征差梯度
把问题与答案拆开,按推理到检验展开
- 二、从奖励函数到轨迹分布 → 一、问题设定:多条路径都符合示范时怎样分配概率
读者在接触方法前知道优化对象与信息权限
- 五、教学伪代码 → 三、用后向权重与前向访问频率拟合分布
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、随机转移下区分动作选择与自然结果:为何只改变候选路径集合,就可能改变已经拟合好的概率?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:5 幅
- Maximum Entropy Inverse Reinforcement Learning,图2:从A到B的三条完整路径与每个路口的局部选择是两种归一化对象。按图中分叉把局部概率相乘,就能检查为什么局部均匀不等于路径均匀。
方法/设定图 · 必要原图摘引 · PDF第4页,图2
从A到B的三条完整路径与每个路口的局部选择是两种归一化对象。按图中分叉把局部概率相乘,就能检查为什么局部均匀不等于路径均匀。
- 最大熵逆强化学习表1:五种道路模型的平均距离匹配率、至少90%距离匹配的样本比例和对数概率。MaxEnt paths为78.79%、52.98%、−6.85,Action (costs)为77.74%、50.75%、未报告对数概率。
实验/结果图 · 必要原图摘引 · PDF第5页,表1
表1的Matching是平均距离匹配比例,90% Match是达到至少90%距离匹配的样本比例,二者不是同一个成功率。先在同一列比较模型;Log Prob的来源措辞问题另见下文。
- Maximum Entropy Inverse Reinforcement Learning,图3:转弯与道路长度的代价都归一到秒,左侧转向代价不能直接与右侧道路类别编号比较。
实验/结果图 · 必要原图摘引 · PDF第5页,图3
转弯与道路长度的代价都归一到秒,左侧转向代价不能直接与右侧道路类别编号比较。
- Maximum Entropy Inverse Reinforcement Learning,图4:已走路径的方向改变各候选终点的后验;地图上的灰度路径表示分布,粗线表示已经观察的路线。
实验/结果图 · 必要原图摘引 · PDF第5页,图4
已走路径的方向改变各候选终点的后验;地图上的灰度路径表示分布,粗线表示已经观察的路线。
- Maximum Entropy Inverse Reinforcement Learning,图5:横轴是已观察路径所占比例,纵轴是目的地预测准确率;增加部分路径证据后后验准确率上升。
实验/结果图 · 必要原图摘引 · PDF第6页,图5
横轴是已观察路径所占比例,纵轴是目的地预测准确率;增加部分路径证据后后验准确率上升。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用012-guided-cost.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
- 删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
查看本篇 5 个原文证据入口
- 图2 · PDF文件第4页,图2
原站图表/证明入口
- 图3 · PDF文件第5页,图3
原站图表/证明入口
- 图4 · PDF文件第5页,图4
原站图表/证明入口
- 图5 · PDF文件第6页,图5
原站图表/证明入口
- 表1 · PDF文件第5页,表1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 补配分函数Hessian与参数不可辨识性推导
- 给三路例子增加恒定特征反例
- 精确区分学徒学习背景与GCL目标继承
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用012-guided-cost.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- www.cs.cmu.edu · 所列章节
最大熵路径分布、似然梯度及算法1前后向计算。
- www.cs.cmu.edu · 所列章节
v2实际核读:PDF第4页的图2图注及相关上下文;其余已定位图表见v2逐篇记录。从A到B的三条完整路径与每个路口的局部选择是两种归一化对象。按图中分叉把局部概率相乘,就能检查为什么局部均匀不等于路径均匀。
技术关系
- 012-guided-cost · 直接继承
GCL沿用最大熵轨迹模型并以采样估计配分函数。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Policy Search for Motor Primitives in Robotics部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:如何把连贯的动作扰动变成回报改进
- 二、用后续回报重加权参数空间的探索
- 三、按完整回合回报更新运动参数
- 四、把回报曲线与无探索平均策略分开
- 五、检查初始化和重要性权重的支持范围
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 六、从两个参数看结构化探索 → 二、用后续回报重加权参数空间的探索
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、为什么机器人探索不宜只是每一步抖一下 → 二、用后续回报重加权参数空间的探索
把问题与答案拆开,按推理到检验展开
- 二、策略、数据与机器人接口 → 一、问题设定:如何把连贯的动作扰动变成回报改进
读者在接触方法前知道优化对象与信息权限
- 四、教学伪代码 → 三、按完整回合回报更新运动参数
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、检查初始化和重要性权重的支持范围:回放旧轨迹很多,为什么有效探索方向仍可能只剩一个?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Policy Search for Motor Primitives in Robotics,图5:内嵌图5直接检验学习效果:横轴是实际 rollout 数,纵轴是20次运行的平均回报。回报随练习上升,支持在示教初始化后的改进;归一化回报接近1并不等于独立报告了100%的任务成功率。图4的动作序列另见上方原文入口。
实验/结果图 · 必要原图摘引 · PDF第7页,图5
内嵌图5直接检验学习效果:横轴是实际 rollout 数,纵轴是20次运行的平均回报。回报随练习上升,支持在示教初始化后的改进;归一化回报接近1并不等于独立报告了100%的任务成功率。图4的动作序列另见上方原文入口。
- Policy Search for Motor Primitives in Robotics,图2:前五帧展示受限力矩下的摆起过程,末面板另画真机学习回报;动作序列与学习曲线承担不同证据。
方法/设定图 · 必要原图摘引 · PDF第6页,图2
前五帧展示受限力矩下的摆起过程,末面板另画真机学习回报;动作序列与学习曲线承担不同证据。
- Policy Search for Motor Primitives in Robotics,图3:所有曲线共用rollout横轴与平均回报纵轴,误差条反映多次学习运行的波动。
实验/结果图 · 必要原图摘引 · PDF第6页,图3
所有曲线共用rollout横轴与平均回报纵轴,误差条反映多次学习运行的波动。
- Policy Search for Motor Primitives in Robotics,图4:上排画球杯运动方向,中排是示教,下排是学得的机器人动作,三个层次应按同一时刻对齐阅读。
实验/结果图 · 必要原图摘引 · PDF第7页,图4
上排画球杯运动方向,中排是示教,下排是学得的机器人动作,三个层次应按同一时刻对齐阅读。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用005-pi2.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图2 · PDF文件第6页,图2
原站图表/证明入口
- 图3 · PDF文件第6页,图3
原站图表/证明入口
- 图4 · PDF文件第7页,图4
原站图表/证明入口
- 图5 · PDF文件第7页,图5
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 方法内拆分采样权重与回报权重
- 加入9:1采样偏置手算
- 补实验交互预算口径与DMP/PI²关系
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用005-pi2.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- proceedings.neurips.cc · 所列章节
算法1与§2.3重要性复用、低权重裁除和DMP参数化。
- proceedings.neurips.cc · 所列章节
v2实际核读:PDF第7页的图4图注及相关上下文;其余已定位图表见v2逐篇记录。绿色箭头标出各帧的运动方向,图中同时有示教与学习后动作;它说明球杯任务的时序结构,收敛速度则应另看图5的回报曲线。
技术关系
- 005-pi2 · 平行方法
二者都加权探索,但推导与奖励数值不变性不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习A Generalized Path Integral Control Approach to Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:无法对物理轨迹求导时怎样使用成本
- 二、把剩余成本转成投影扰动的概率权重
- 三、从剩余成本计算每个时刻的参数改变量
- 四、对照成本曲线与经由点的实际路径
- 五、局部采样仍受动作族和成本约束
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 四、一个算得出来的例子 → 二、把剩余成本转成投影扰动的概率权重
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、从“哪个扰动更好”到路径积分 → 二、把剩余成本转成投影扰动的概率权重
把问题与答案拆开,按推理到检验展开
- 二、输入、动作和学习目标 → 一、问题设定:无法对物理轨迹求导时怎样使用成本
读者在接触方法前知道优化对象与信息权限
- 五、教学伪代码 → 三、从剩余成本计算每个时刻的参数改变量
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、局部采样仍受动作族和成本约束:只降低指数温度,能否保证更快找到低成本动作?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- A Generalized Path Integral Control Approach to Reinforcement Learning,图3:左列比较不同自由度下的学习曲线,右列画末端路径和经由点G。成本降低与实际路径通过G必须一起看,不能把机器人臂的示意轨迹当成真机数据。
实验/结果图 · 必要原图摘引 · PDF第27页,图3
左列比较不同自由度下的学习曲线,右列画末端路径和经由点G。成本降低与实际路径通过G必须一起看,不能把机器人臂的示意轨迹当成真机数据。
- A Generalized Path Integral Control Approach to Reinforcement Learning,图4:左侧区分真实与模拟机器人狗,右侧用rollout数比较成本下降,成本不是直接的跳跃成功率。
实验/结果图 · 必要原图摘引 · PDF第28页,图4
左侧区分真实与模拟机器人狗,右侧用rollout数比较成本下降,成本不是直接的跳跃成功率。
- A Generalized Path Integral Control Approach to Reinforcement Learning,图5:上下两排是学习前后的模拟跳跃序列,比较同一帧的机身高度与落地后前移距离。
实验/结果图 · 必要原图摘引 · PDF第29页,图5
上下两排是学习前后的模拟跳跃序列,比较同一帧的机身高度与落地后前移距离。
未在正文展示的图/表与范围
- 表2:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用004-power.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
- 移除剩余阅读范围说明,并保留篇末具体机制比较链接
查看本篇 4 个原文证据入口
- 图3 · PDF文件第27页,图3
原站图表/证明入口
- 图4 · PDF文件第28页,图4
原站图表/证明入口
- 图5 · PDF文件第29页,图5
原站图表/证明入口
- 表2 · PDF文件第18页,表2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 加入控制成本与噪声耦合假设
- 二维协方差/标准差手算
- 把高维结果归因边界与PoWER关系写入叙事
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用004-power.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:移除剩余阅读范围说明,并保留篇末具体机制比较链接
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- jmlr.org · 所列章节
§6.1噪声与控制成本耦合及路径积分权重;未通读45页全部附录。
- jmlr.org · 所列章节
v2实际核读:PDF第27页的图3图注及相关上下文;其余已定位图表见v2逐篇记录。左列比较不同自由度下的学习曲线,右列画末端路径和经由点G。成本降低与实际路径通过G必须一起看,不能把机器人臂的示意轨迹当成真机数据。
技术关系
- 004-power · 平行方法
共享参数搜索任务但分别用回报加权与指数成本加权。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:学习者偏离示范后从哪里得到恢复标签
- 二、在自访问分布上聚合专家纠正
- 三、在学习者访问状态查询并累积专家标签
- 四、用恢复场景核对分布改变是否真正发生
- 五、把专家可查询性与危险状态分开处理
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 五、一个恢复场景 → 二、在自访问分布上聚合专家纠正
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、模仿学习最棘手的错误,往往来自训练中没见过的状态 → 二、在自访问分布上聚合专家纠正
把问题与答案拆开,按推理到检验展开
- 二、为什么单步误差会变成长期问题 → 一、问题设定:学习者偏离示范后从哪里得到恢复标签
读者在接触方法前知道优化对象与信息权限
- 四、教学伪代码 → 三、在学习者访问状态查询并累积专家标签
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 三、在学习者访问状态查询并累积专家标签:显式区分专家与学习者分布上的同一个损失
教法来源与实际阅读范围
- Michael Laskey, Jonathan Lee, Ken Goldberg · DART: Noise Injection for Robust Imitation Learning
Surrogate loss and state distribution; retroactive feedback; noise-injected execution and expert recovery
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning,图2:纵轴是每圈平均跌出赛道次数,越低越好;图4则是每关行进距离,越高越好。两种纵轴方向相反,比较的是各自任务下随训练数据增长的表现。
实验/结果图 · 必要原图摘引 · PDF第6页,图2
纵轴是每圈平均跌出赛道次数,越低越好;图4则是每关行进距离,越高越好。两种纵轴方向相反,比较的是各自任务下随训练数据增长的表现。
- A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning,图4:纵轴是每关平均行进距离,横轴是训练数据量;曲线衡量模仿控制表现,并非每关通关率。
实验/结果图 · 必要原图摘引 · PDF第7页,图4
纵轴是每关平均行进距离,横轴是训练数据量;曲线衡量模仿控制表现,并非每关通关率。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用021-dart.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
- 移除剩余阅读范围说明,并保留篇末具体机制比较链接
查看本篇 4 个原文证据入口
- 图1 · PDF文件第6页,图1
原站图表/证明入口
- 图2 · PDF文件第6页,图2
原站图表/证明入口
- 图3 · PDF文件第7页,图3
原站图表/证明入口
- 图4 · PDF文件第7页,图4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 补uTε保证中的恢复成本
- 加入走廊/悬崖反例
- 明确DAgger与DART收集机制和安全边界
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用021-dart.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:移除剩余阅读范围说明,并保留篇末具体机制比较链接
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- proceedings.mlr.press · 所列章节
定理3.1—3.4、自分布误差、恢复成本u及有限样本条件。
- proceedings.mlr.press · 所列章节
v2实际核读:PDF第6页的图2图注及相关上下文;其余已定位图表见v2逐篇记录。纵轴是每圈平均跌出赛道次数,越低越好;图4则是每关行进距离,越高越好。两种纵轴方向相反,比较的是各自任务下随训练数据增长的表现。
技术关系
- 021-dart · 平行方法
主动访问学习者状态与扰动专家状态是不同覆盖机制。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习PILCO: A Model-Based and Data-Efficient Approach to Policy Search部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:少量交互下怎样避免策略利用模型猜测
- 二、传播状态分布并对期望成本求导
- 三、固定概率模型优化策略,再用新轨迹更新模型
- 四、区分真实交互时长与模型优化成本
- 五、检查高斯近似遗漏的多峰未来
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 四、一个方差不能忽略的例子 → 二、传播状态分布并对期望成本求导
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、数据少的时候,模型为什么特别容易骗人 → 二、传播状态分布并对期望成本求导
把问题与答案拆开,按推理到检验展开
- 二、学习的对象是动力学,不是最佳动作标签 → 一、问题设定:少量交互下怎样避免策略利用模型猜测
读者在接触方法前知道优化对象与信息权限
- 五、教学伪代码 → 三、固定概率模型优化策略,再用新轨迹更新模型
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、检查高斯近似遗漏的多峰未来:两个真实未来分支被矩匹配合成一团,会给控制带来什么误判?
原论文校准与展开范围
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:5 幅
- PILCO: A Model-Based and Data-Efficient Approach to Policy Search,图5:内嵌图5聚焦样本效率:纵轴是完成杆摆起任务所需的交互秒数,采用对数尺度;横轴按研究年代排列,不是训练迭代。各柱来自不同文献与任务条件,红柱展示PILCO的报告结果,不能把整幅图当成同一协议的随机种子对照。
实验/结果图 · 必要原图摘引 · PDF第7页,图5
内嵌图5聚焦样本效率:纵轴是完成杆摆起任务所需的交互秒数,采用对数尺度;横轴按研究年代排列,不是训练迭代。各柱来自不同文献与任务条件,红柱展示PILCO的报告结果,不能把整幅图当成同一协议的随机种子对照。
- PILCO: A Model-Based and Data-Efficient Approach to Policy Search,图1:中间多条函数都可解释左侧稀少样本,右侧概率模型把这种不确定性显式留下。
实验/结果图 · 必要原图摘引 · PDF第2页,图1
中间多条函数都可解释左侧稀少样本,右侧概率模型把这种不确定性显式留下。
- PILCO: A Model-Based and Data-Efficient Approach to Policy Search,图2:右下输入分布经过右上GP后产生左上输出分布,蓝色高斯近似与阴影真实形状需区分。
实验/结果图 · 必要原图摘引 · PDF第3页,图2
右下输入分布经过右上GP后产生左上输出分布,蓝色高斯近似与阴影真实形状需区分。
- PILCO: A Model-Based and Data-Efficient Approach to Policy Search,图3:红十字标出摆杆末端位置,连续帧展示学得控制器的摆起和平衡过程。
方法/设定图 · 必要原图摘引 · PDF第6页,图3
红十字标出摆杆末端位置,连续帧展示学得控制器的摆起和平衡过程。
- PILCO: A Model-Based and Data-Efficient Approach to Policy Search,图4:右侧是1000次测试的距离分布,图例按飞轮偏离竖直姿态的距离分组,不能把颜色当不同算法。
实验/结果图 · 必要原图摘引 · PDF第6页,图4
右侧是1000次测试的距离分布,图例按飞轮偏离竖直姿态的距离分组,不能把颜色当不同算法。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用029-pets.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
- 删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
查看本篇 6 个原文证据入口
- 图1 · PDF文件第2页,图1
原站图表/证明入口
- 图2 · PDF文件第3页,图2
原站图表/证明入口
- 图3 · PDF文件第6页,图3
原站图表/证明入口
- 图4 · PDF文件第6页,图4
原站图表/证明入口
- 图5 · PDF文件第7页,图5
原站图表/证明入口
- 表1 · PDF文件第6页,表1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 补跨时间模型不确定性缺口
- H平方与H方差增长反例
- 区分PILCO与PETS控制接口
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用029-pets.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- icml.cc · 所列章节
§2.2矩匹配与讨论中的时间相关性缺口。
- icml.cc · 所列章节
v2实际核读:PDF第3页的图2图注及相关上下文;其余已定位图表见v2逐篇记录。先看输入高斯怎样经过GP映射变成非高斯输出,再看匹配均值和方差的高斯近似。阴影不是“真实未来一定在其中”的硬边界。
技术关系
- 029-pets · 平行方法
概率传播与控制都关注模型误差,但近似、模型与优化接口不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Probabilistic Movement Primitives部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多条成功轨迹怎样保留跨关节的协调
- 二、以权重协方差条件化整段运动
- 三、拟合联合权重分布并按新约束条件化
- 四、把轨迹变异与目标条件化分开验证
- 五、单高斯分布不能替代闭环可行性检查
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 四、一个协调的手算例子 → 二、以权重协方差条件化整段运动
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、为什么一条平均轨迹不够 → 二、以权重协方差条件化整段运动
把问题与答案拆开,按推理到检验展开
- 二、从轨迹回归到权重分布 → 一、问题设定:多条成功轨迹怎样保留跨关节的协调
读者在接触方法前知道优化对象与信息权限
- 五、教学伪代码 → 三、拟合联合权重分布并按新约束条件化
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、单高斯分布不能替代闭环可行性检查:新目标与示范分布相距很远,条件化结果为何仍可能看起来很确定?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Probabilistic Movement Primitives,图3:先比较直线射门与转角射门各自的样本,再看联合数据训练和分布乘积:前者保留多样性,后者只强调两种分布共同支持的区域。
实验/结果图 · 必要原图摘引 · PDF第7页,图3
先比较直线射门与转角射门各自的样本,再看联合数据训练和分布乘积:前者保留多样性,后者只强调两种分布共同支持的区域。
- Probabilistic Movement Primitives,图2:每列是一个时刻,三排分别约束早期、晚期与两个经由点;灰色采样轨迹展示分布变化。
实验/结果图 · 必要原图摘引 · PDF第7页,图2
每列是一个时刻,三排分别约束早期、晚期与两个经由点;灰色采样轨迹展示分布变化。
- Probabilistic Movement Primitives,图4:图(b)对照期望与反馈生成分布,图(c)展示两个节律动作的混合,速度调节与动作组合是两项操作。
实验/结果图 · 必要原图摘引 · PDF第8页,图4
图(b)对照期望与反馈生成分布,图(c)展示两个节律动作的混合,速度调节与动作组合是两项操作。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
- 移除剩余阅读范围说明,并保留篇末具体机制比较链接
查看本篇 4 个原文证据入口
- 图2 · PDF文件第7页,图2
原站图表/证明入口
- 图3 · PDF文件第7页,图3
原站图表/证明入口
- 图4 · PDF文件第8页,图4
原站图表/证明入口
- 表1 · PDF文件第2页,表1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 加入条件化均值方差的完整手算
- 区分后验方差与执行误差
- 建立DMP平行与扩散教学关系
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:移除剩余阅读范围说明,并保留篇末具体机制比较链接
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- proceedings.neurips.cc · 所列章节
§2—3高斯条件化及观测精度;图1的分布解释。
- proceedings.neurips.cc · 所列章节
v2实际核读:PDF第7页的图3图注及相关上下文;其余已定位图表见v2逐篇记录。先比较直线射门与转角射门各自的样本,再看联合数据训练和分布乘积:前者保留多样性,后者只强调两种分布共同支持的区域。
技术关系
- 061-diffusion-policy · 教学联系
比较动作分布表示,不主张直接架构继承。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Guided Policy Search部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:局部好轨迹怎样教出跨状态的反馈
- 二、连接引导分布、重要性估计与策略正则
- 三、交替采样引导轨迹与更新反馈策略
- 四、用坡道位置变化检验反馈而非轨迹记忆
- 五、局部教师无法覆盖任意失败状态
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 六、一个坡道例子 → 二、连接引导分布、重要性估计与策略正则
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、局部好轨迹与通用反馈策略之间隔着什么 → 二、连接引导分布、重要性估计与策略正则
把问题与答案拆开,按推理到检验展开
- 二、两个控制器为什么各有作用 → 一、问题设定:局部好轨迹怎样教出跨状态的反馈
读者在接触方法前知道优化对象与信息权限
- 五、教学伪代码 → 三、交替采样引导轨迹与更新反馈策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、局部教师无法覆盖任意失败状态:怎样区分坡道泛化来自状态反馈,还是训练中见过相似时间表?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Guided Policy Search,图2:同时看完整GPS与去引导、去正则的版本,才能区分有效采样和分布约束各自的作用;单独看最高回报无法判断是哪一个组件带来收益。
实验/结果图 · 必要原图摘引 · PDF第6页,图2
同时看完整GPS与去引导、去正则的版本,才能区分有效采样和分布约束各自的作用;单独看最高回报无法判断是哪一个组件带来收益。
- Guided Policy Search,图3:左侧按坡道起点位置比较回报,右侧是固定位置的轨迹,均为同一组泛化实验的不同视角。
实验/结果图 · 必要原图摘引 · PDF第7页,图3
左侧按坡道起点位置比较回报,右侧是固定位置的轨迹,均为同一组泛化实验的不同视角。
- Guided Policy Search,图4:各行把同一测试地形上的GPS、TBDP与DDP轨迹并列,括号给出平均回报,不能只凭单条姿态判断稳定性。
实验/结果图 · 必要原图摘引 · PDF第7页,图4
各行把同一测试地形上的GPS、TBDP与DDP轨迹并列,括号给出平均回报,不能只凭单条姿态判断稳定性。
- Guided Policy Search,图5:左侧比较四种测试地形上的模拟跑步轨迹,右侧给出三维人形模型,证据仍限于模拟设置。
实验/结果图 · 必要原图摘引 · PDF第7页,图5
左侧比较四种测试地形上的模拟跑步轨迹,右侧给出三维人形模型,证据仍限于模拟设置。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用010-visuomotor.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图2 · PDF文件第6页,图2
原站图表/证明入口
- 图3 · PDF文件第7页,图3
原站图表/证明入口
- 图4 · PDF文件第7页,图4
原站图表/证明入口
- 图5 · PDF文件第7页,图5
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 新增自归一化绝对覆盖数值反例
- 重读去引导/去正则消融预算
- 标清2013GPS与BADMM版继承边界
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用010-visuomotor.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- proceedings.mlr.press · 所列章节
§3正则化及图2采样预算、消融说明。
- proceedings.mlr.press · 所列章节
v2实际核读:PDF第6页的图2图注及相关上下文;其余已定位图表见v2逐篇记录。同时看完整GPS与去引导、去正则的版本,才能区分有效采样和分布约束各自的作用;单独看最高回报无法判断是哪一个组件带来收益。
技术关系
- 010-visuomotor · 直接继承
后作沿用局部引导训练全局策略,优化形式改变。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习End-to-End Training of Deep Visuomotor Policies部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:图像特征怎样为接触动作服务
- 二、用空间特征和局部教师联合训练力矩策略
- 三、让局部教师与视觉策略交替靠近
- 四、分开核对视觉消融与操作成功
- 五、受控教师信息不能替代部署观测覆盖
- 六、沿机制关系继续读
- 七、自测题与参考答案
段落怎样重新安排
- 六、一个接触特征的例子 → 二、用空间特征和局部教师联合训练力矩策略
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、视觉识别正确,不代表机器人就能操作成功 → 二、用空间特征和局部教师联合训练力矩策略
把问题与答案拆开,按推理到检验展开
- 二、训练与执行的信息权限不同 → 一、问题设定:图像特征怎样为接触动作服务
读者在接触方法前知道优化对象与信息权限
- 五、教学伪代码 → 三、让局部教师与视觉策略交替靠近
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、受控教师信息不能替代部署观测覆盖:若去掉一个相机特征点后成功率下降,是否说明它编码了某个接触部位?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:5 幅
- End-to-End Training of Deep Visuomotor Policies,图9:内嵌图9右侧结果表比特征点可视化更直接检验控制能力。三列分别是训练位置、新位置和视觉干扰测试,括号给出试验数;同一任务内比较端到端策略与位姿特征基线,不能把较少次数下的100%当成无条件可靠性。
实验/结果图 · 必要原图摘引 · PDF第24页,图9,右侧结果表局部
内嵌图9右侧结果表比特征点可视化更直接检验控制能力。三列分别是训练位置、新位置和视觉干扰测试,括号给出试验数;同一任务内比较端到端策略与位姿特征基线,不能把较少次数下的100%当成无条件可靠性。
- End-to-End Training of Deep Visuomotor Policies,图8:读图对应本段的“挂衣架、插块、锤子、瓶盖”;联合感知控制的任务表现。
实验/结果图 · 必要原图摘引 · PDF第22页,图8
读图对应本段的“挂衣架、插块、锤子、瓶盖”;联合感知控制的任务表现。
- End-to-End Training of Deep Visuomotor Policies,图9:左侧保留训练场景与视觉干扰场景,右侧给出对应任务、试验次数和成功率,完整复合图可检验场景与数字的对应。
实验/结果图 · 必要原图摘引 · PDF第24页,图9
左侧保留训练场景与视觉干扰场景,右侧给出对应任务、试验次数和成功率,完整复合图可检验场景与数字的对应。
- End-to-End Training of Deep Visuomotor Policies,图10:读图对应本段的“联合训练前后的特征点”;任务训练改变视觉关注。
实验/结果图 · 必要原图摘引 · PDF第25页,图10
读图对应本段的“联合训练前后的特征点”;任务训练改变视觉关注。
- End-to-End Training of Deep Visuomotor Policies,图11:读图对应本段的“联合训练前后的特征点”;任务训练改变视觉关注。
实验/结果图 · 必要原图摘引 · PDF第25页,图11
读图对应本段的“联合训练前后的特征点”;任务训练改变视觉关注。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用014-hand-eye.md的具体机制关系替换或补足承上启下阅读链接
- 补入图10的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
- 移除剩余阅读范围说明,并保留篇末具体机制比较链接
查看本篇 6 个原文证据入口
- 图10 · HTML 图10,实际锚点 S6.F10
原站图表/证明入口
- 图11 · HTML 图11,实际锚点 S6.F11
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S6.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S6.F9
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S6.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S6.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 补空间期望对logit导数
- 两峰软坐标手算与实验解释
- 区分GPS继承和Hand-Eye平行路线
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用014-hand-eye.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图10的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:移除剩余阅读范围说明,并保留篇末具体机制比较链接
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
架构、预训练及§6.3空间softmax消融。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F10的图10图注及相关上下文;其余已定位图表见v2逐篇记录。同一颜色在连续图像中追踪同一特征点,颜色本身不代表语义类别。它展示控制网络关注的空间位置,不是关键点检测的独立准确率评测。
技术关系
- 014-hand-eye · 平行方法
视觉到控制共享问题,教师监督与成功评分搜索不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Continuous Control with Deep Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:连续动作不能枚举时怎样改进策略
- 二、把价值对动作的导数传回确定性Actor
- 三、分开Critic拟合、Actor求导与目标软更新
- 四、把组件消融与归一化回报分开读
- 五、缓慢目标更新不能保证评分正确
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个可手算的例子 → 二、把价值对动作的导数传回确定性Actor
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先把连续控制的问题说清楚 → 二、把价值对动作的导数传回确定性Actor
把问题与答案拆开,按推理到检验展开
- 二、机器人设定与前置概念 → 一、问题设定:连续动作不能枚举时怎样改进策略
读者在接触方法前知道优化对象与信息权限
- 三、方法:让价值函数的斜率成为动作老师 → 三、分开Critic拟合、Actor求导与目标软更新
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 二、把价值对动作的导数传回确定性Actor:区分冻结参数与切断输入梯度
教法来源与实际阅读范围
- Lilian Weng · Policy Gradient Algorithms
Notation and policy-gradient theorem; DPG/DDPG; SAC soft policy evaluation and improvement
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、读懂之后的三个问题”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Continuous Control with Deep Reinforcement Learning,图2:原图浅灰为原始DPG加批归一化,深灰为仅目标网络,绿线为目标网络加批归一化,蓝线为像素输入版本,再比较同一任务的学习曲线;归一化回报不是成功率,不能把跨任务尺度直接解释为物理性能。
实验/结果图 · 必要原图摘引 · HTML S4.F2,图2
原图浅灰为原始DPG加批归一化,深灰为仅目标网络,绿线为目标网络加批归一化,蓝线为像素输入版本,再比较同一任务的学习曲线;归一化回报不是成功率,不能把跨任务尺度直接解释为物理性能。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用026-td3.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将2处不同图表证据连接到实际原文位置,取消孤立图表号
- 删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
查看本篇 2 个原文证据入口
- 图2 · HTML 图2,实际锚点 S4.F2
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导目标网络半衰期
- 区分梯度步与机器人时间
- 建立TD3继承/NAF平行关系
- v2:用026-td3.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将2处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§3目标网络软更新及图2消融。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。按图例区分目标网络和批归一化的组合,再比较同一任务的学习曲线;归一化回报不是成功率,不能把跨任务尺度直接解释为物理性能。
技术关系
- 026-td3 · 直接继承
TD3保留DDPG框架并修改目标及更新频率。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Guided Cost Learning: Deep Inverse Optimal Control via Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:连续控制怎样估计代价模型的归一化
- 二、让采样策略跟随代价更新并修正权重
- 三、随新代价重新采样并估计配分函数
- 四、分开评估当前策略与代价迁移
- 五、局部模型和分布支持限制可重规划性
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、让采样策略跟随代价更新并修正权重
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、把“做得好”也交给机器学习 → 二、让采样策略跟随代价更新并修正权重
把问题与答案拆开,按推理到检验展开
- 二、问题定义与五个前置概念 → 一、问题设定:连续控制怎样估计代价模型的归一化
读者在接触方法前知道优化对象与信息权限
- 三、方法:采样分布必须跟着代价变化 → 三、随新代价重新采样并估计配分函数
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、局部模型和分布支持限制可重规划性:怎样设计实验区分好策略与可迁移的好代价?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个理解问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第2题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- Guided Cost Learning: Deep Inverse Optimal Control via Policy Optimization,图5:分别去掉单调正则与局部恒定变化率正则,比较四个初始条件下四次IOC运行的平均距离。它检验代价形状约束的作用;奖励能否迁移到新情境,仍要另看重优化实验。
实验/结果图 · 必要原图摘引 · HTML A5.F5,图5
分别去掉单调正则与局部恒定变化率正则,比较四个初始条件下四次IOC运行的平均距离。它检验代价形状约束的作用;奖励能否迁移到新情境,仍要另看重优化实验。
- Guided Cost Learning: Deep Inverse Optimal Control via Policy Optimization,图2:| 数据预算 | 图2按采样轨迹展示;表1计数不包含重新优化所学代价所需的额外样本 |
实验/结果图 · 必要原图摘引 · PDF第6页,图2
| 数据预算 | 图2按采样轨迹展示;表1计数不包含重新优化所学代价所需的额外样本 |
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用003-maxent-irl.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
- 删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
查看本篇 3 个原文证据入口
- 图2 · HTML 图2,实际锚点 S6.F2
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 A5.F5
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 补完整代价梯度解释
- 代价常数平移不可辨识性手算
- 分清GCL目标继承与GAIL平行关系
- v2:用003-maxent-irl.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§4.1—4.3配分函数、梯度、自适应采样及混合分布。
- arxiv.org · 所列章节
v2实际核读:HTML锚点A5.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。分别去掉单调正则与局部恒定变化率正则,比较四个初始条件下四次IOC运行的平均距离。它检验代价形状约束的作用;奖励能否迁移到新情境,仍要另看重优化实验。
技术关系
- 003-maxent-irl · 直接继承
继承最大熵轨迹模型并替换连续域配分函数估计。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Continuous Deep Q-Learning with Model-based Acceleration部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样用价值函数形状免去动作搜索
- 二、分解状态价值、峰位置和动作曲率
- 三、用同一TD损失训练峰位置与曲率
- 四、区分二次Q收益与想象经验收益
- 五、单峰假设和局部模型各有误差
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个可计算的例子 → 二、分解状态价值、峰位置和动作曲率
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、连续动作还有另一条路 → 二、分解状态价值、峰位置和动作曲率
把问题与答案拆开,按推理到检验展开
- 二、问题设定与概念准备 → 一、问题设定:怎样用价值函数形状免去动作搜索
读者在接触方法前知道优化对象与信息权限
- 三、核心公式:最优动作藏在参数化里 → 三、用同一TD损失训练峰位置与曲率
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、单峰假设和局部模型各有误差:若关闭想象经验后性能下降,应怎样判断是样本数量还是模型偏差所致?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第3题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- Continuous Deep Q-Learning with Model-based Acceleration,图2:先区分真实动力学与拟合动力学,再看iLQG引导比例和想象展开长度。这里的变化同时影响探索来源或模型数据,不能只按“模型越多越好”归纳。
实验/结果图 · 必要原图摘引 · HTML S6.F2,图2
先区分真实动力学与拟合动力学,再看iLQG引导比例和想象展开长度。这里的变化同时影响探索来源或模型数据,不能只按“模型越多越好”归纳。
- Continuous Deep Q-Learning with Model-based Acceleration,图1:读图对应本段的“精细到达与插销对比展示稳定性和收敛差异”;支持所测操作任务,不能替代真机精度测试。
实验/结果图 · 必要原图摘引 · HTML S6.F1,图1
读图对应本段的“精细到达与插销对比展示稳定性和收敛差异”;支持所测操作任务,不能替代真机精度测试。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用011-ddpg.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图1 · HTML 图1,实际锚点 S6.F1
原站图表/证明入口
- 图2 · HTML 图2,实际锚点 S6.F2
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导动作均值头的TD梯度
- 正负TD误差手算
- 将步行结果与单峰限制联系
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用011-ddpg.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
二次优势参数化、模型加速与locomotion比较讨论。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。先区分真实动力学与拟合动力学,再看iLQG引导比例和想象展开长度。这里的变化同时影响探索来源或模型数据,不能只按“模型越多越好”归纳。
技术关系
- 011-ddpg · 平行方法
独立策略梯度头与由TD损失学习的解析峰位置不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning Hand-Eye Coordination for Robotic Grasping with Deep Learning and Large-Scale Data Collection部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:物体被碰动后怎样重新选择抓取动作
- 二、把终局抓取结果变成动作条件监督
- 三、用成功标签训练评分器并反复搜索动作
- 四、核对机械臂数量、物体划分与闭环对照
- 五、成功预测仍受采集分布和专用接口限制
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个具体小例子 → 二、把终局抓取结果变成动作条件监督
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、为什么抓取需要边看边改 → 二、把终局抓取结果变成动作条件监督
把问题与答案拆开,按推理到检验展开
- 二、设定:预测成功与控制动作是两件事 → 一、问题设定:物体被碰动后怎样重新选择抓取动作
读者在接触方法前知道优化对象与信息权限
- 三、方法:把一次抓取拆成多个训练样本 → 三、用成功标签训练评分器并反复搜索动作
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、成功预测仍受采集分布和专用接口限制:同一次抓取拆成许多训练样本,能否把样本数当成独立试验数?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第2题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Learning Hand-Eye Coordination for Robotic Grasping with Deep Learning and Large-Scale Data Collection,表1:内嵌表1直接比较抓取失败率,越低越好。上半部不放回实验分别统计前10、20、30次抓取,后段剩下的物体更难;下半部是放回条件的100次尝试。不同分母与物体分布必须分开,不能把表中10%误读成抓取成功率。
实验/结果图 · 必要原图摘引 · PDF第8页,表1
内嵌表1直接比较抓取失败率,越低越好。上半部不放回实验分别统计前10、20、30次抓取,后段剩下的物体更难;下半部是放回条件的100次尝试。不同分母与物体分布必须分开,不能把表中10%误读成抓取成功率。
- Learning Hand-Eye Coordination for Robotic Grasping with Deep Learning and Large-Scale Data Collection,图3:读图对应本段的“从轨迹生成终点相对动作标签”;说明数据构造,不是通用多步RL目标。
实验/结果图 · 必要原图摘引 · PDF第4页,图3
读图对应本段的“从轨迹生成终点相对动作标签”;说明数据构造,不是通用多步RL目标。
- Learning Hand-Eye Coordination for Robotic Grasping with Deep Learning and Large-Scale Data Collection,图9:读图对应本段的“软硬物体出现不同抓法”;提供有趣定性行为,不证明学到了可解释材料物理模型。
实验/结果图 · 必要原图摘引 · HTML S6.F9,图9
读图对应本段的“软硬物体出现不同抓法”;提供有趣定性行为,不证明学到了可解释材料物理模型。
未在正文展示的图/表与范围
- 表2:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用020-dexnet2.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S6.F9
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S6.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 拆帧数与独立尝试的统计单位
- 补终点位移数值教学例
- 串联真实抓取、合成标签与多步Q学习
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用020-dexnet2.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
图3终点相对位移标签、数据采集与控制约束。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。每帧配的是“当前位姿到最终位姿”的位移及整个抓取的终局标签。沿图中一条抓取序列看标签如何复用,就能区分帧样本数与独立抓取次数。
技术关系
- 020-dexnet2 · 平行方法
真实终局标签与合成解析标签对真实交互、物理先验有不同依赖。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Generative Adversarial Imitation Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样比较执行出来的长期行为分布
- 二、用占用测度理解判别器与策略交替
- 三、交替训练分布判别器与环境中的策略
- 四、把专家数据量与环境交互量分别计账
- 五、判别器信号不能弥补示范缺失的任务信息
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构直觉例子 → 二、用占用测度理解判别器与策略交替
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、模仿不只是给动作贴标签 → 二、用占用测度理解判别器与策略交替
把问题与答案拆开,按推理到检验展开
- 二、场景与五个关键概念 → 一、问题设定:怎样比较执行出来的长期行为分布
读者在接触方法前知道优化对象与信息权限
- 三、先理解占用测度,再理解 GAN 类比 → 三、交替训练分布判别器与环境中的策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、判别器信号不能弥补示范缺失的任务信息:专家与学习者的动作频率不同时,判别器会不会只学到采样差异?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个理解问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Generative Adversarial Imitation Learning,图1:纵轴把专家表现标成1、随机策略标成0;这是负成本的归一化值。右侧还改变熵系数,不能把它与左侧不同示范量的比较混成同一消融。
实验/结果图 · 必要原图摘引 · HTML S6.F1,图1
纵轴把专家表现标成1、随机策略标成0;这是负成本的归一化值。右侧还改变熵系数,不能把它与左侧不同示范量的比较混成同一消融。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用041-amp.md的具体机制关系替换或补足承上启下阅读链接
- 补入图1的可打开原图及专属图例/坐标/比较条件解读
- 将1处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 1 个原文证据入口
- 图1 · HTML 图1,实际锚点 S6.F1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 加入占用流守恒方程
- 完整状态和观察混叠的开门反例
- 标明与AMP的模块组合边界
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用041-amp.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图1的可打开原图及专属图例/坐标/比较条件解读
- v2:将1处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§3—4占用匹配、凸对偶与有限样本约束。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F1的图1图注及相关上下文;其余已定位图表见v2逐篇记录。纵轴把专家表现标成1、随机策略标成0;这是负成本的归一化值。右侧还改变熵系数,不能把它与左侧不同示范量的比较混成同一消融。
技术关系
- 041-amp · 模块组合
AMP组合对抗运动风格奖励与任务控制。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Deep Visual Foresight for Planning Robot Motion部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:给定像素目标怎样预测并选择推动
- 二、把动作条件视频接到滚动规划
- 三、在新观测上重定位目标点并滚动搜索
- 四、分开检验像素移动与短程推动成功
- 五、遮挡和预测误差限制长时域外推
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、把动作条件视频接到滚动规划
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、让机器人先想象动作后果 → 二、把动作条件视频接到滚动规划
把问题与答案拆开,按推理到检验展开
- 二、场景与先备知识 → 一、问题设定:给定像素目标怎样预测并选择推动
读者在接触方法前知道优化对象与信息权限
- 三、从视频预测到可规划的模型 → 三、在新观测上重定位目标点并滚动搜索
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、遮挡和预测误差限制长时域外推:规划器预测正确但点跟踪偏移时,应该先改世界模型吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Deep Visual Foresight for Planning Robot Motion,图6:第一组是遮挡引起指定像素位置漂移,第二组是接触后果预测失准。应分别追踪目标点估计与物体实际运动,不能把两种失败都归为画面不清晰。
实验/结果图 · 必要原图摘引 · HTML S5.F6,图6
第一组是遮挡引起指定像素位置漂移,第二组是接触后果预测失准。应分别追踪目标点估计与物体实际运动,不能把两种失败都归为画面不清晰。
- Deep Visual Foresight for Planning Robot Motion,图2:读图对应本段的“视频模型的运动变换可以输运指定点”;模型具有显式物体或质量参数。
实验/结果图 · 必要原图摘引 · HTML S3.F2,图2
读图对应本段的“视频模型的运动变换可以输运指定点”;模型具有显式物体或质量参数。
- Deep Visual Foresight for Planning Robot Motion,图5:读图对应本段的“双点相反移动可表达并实现部分旋转”;任意三维姿态控制或长程操作。
实验/结果图 · 必要原图摘引 · HTML S5.F5,图5
读图对应本段的“双点相反移动可表达并实现部分旋转”;任意三维姿态控制或长程操作。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用037-dreamer.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
- 删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
查看本篇 4 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S5.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S5.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 数值反例区分目标概率和期望距离
- 加入容差区域与分辨率分析
- 明确视觉规划和Dreamer的控制预算差异
- v2:用037-dreamer.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:删除已由正文解释的一行问题—方法—证据汇总表,避免重复空标签
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§IV-B指定像素概率、§IV-C CEM及外部光流更新。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F6的图6图注及相关上下文;其余已定位图表见v2逐篇记录。第一组是遮挡引起指定像素位置漂移,第二组是接触后果预测失准。应分别追踪目标点估计与物体实际运动,不能把两种失败都归为画面不清晰。
技术关系
- 037-dreamer · 教学联系
比较在线搜索与潜在想象训练策略的计算分配。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Sim-to-Real Robot Learning from Pixels with Progressive Nets部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样保留仿真能力又学习真实差异
- 二、冻结旧列并用横向连接训练适应列
- 三、冻结旧列并训练带横向输入的新列
- 四、把真实交互、仿真预训与参数规模分开
- 五、保留旧参数不等于新任务不会负迁移
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、冻结旧列并用横向连接训练适应列
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、保留会的东西,再学习现实差异 → 二、冻结旧列并用横向连接训练适应列
把问题与答案拆开,按推理到检验展开
- 二、问题设定与预备概念 → 一、问题设定:怎样保留仿真能力又学习真实差异
读者在接触方法前知道优化对象与信息权限
- 三、方法:横向读取,而非覆盖旧参数 → 三、冻结旧列并训练带横向输入的新列
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、保留旧参数不等于新任务不会负迁移:怎样排除渐进网络收益只是参数更多?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:6 幅
- Sim-to-Real Robot Learning from Pixels with Progressive Nets,图6:实线经过中值滤波,点线保留原始回报。先看真实训练过程中原始波动,再判断迁移速度;平滑曲线的外观本身不是跨随机种子的置信区间。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
实线经过中值滤波,点线保留原始回报。先看真实训练过程中原始波动,再判断迁移速度;平滑曲线的外观本身不是跨随机种子的置信区间。
- Sim-to-Real Robot Learning from Pixels with Progressive Nets,图1:读图对应本段的“冻结列与横向连接结构”;明确复用机制,不是零数据迁移证明。
方法/设定图 · 必要原图摘引 · HTML S2.F1,图1
读图对应本段的“冻结列与横向连接结构”;明确复用机制,不是零数据迁移证明。
- Sim-to-Real Robot Learning from Pixels with Progressive Nets,图2:两列循环网络分别保留各自的LSTM状态,并由横向连接传递已学表征;这张结构图不是迁移效果曲线。
方法/设定图 · 必要原图摘引 · PDF第5页,图2
两列循环网络分别保留各自的LSTM状态,并由横向连接传递已学表征;这张结构图不是迁移效果曲线。
- Sim-to-Real Robot Learning from Pixels with Progressive Nets,图4:| 统计 | 图4的5次运行混合了种子与超参数变化;图6每种扰动300次配置试验 |
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
| 统计 | 图4的5次运行混合了种子与超参数变化;图6每种扰动300次配置试验 |
- Sim-to-Real Robot Learning from Pixels with Progressive Nets,图5:读图对应本段的“渐进方法真机获得奖励,从头对照在给定预算失败”;说明实际预算下迁移价值,不证明从头永远学不会。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
读图对应本段的“渐进方法真机获得奖励,从头对照在给定预算失败”;说明实际预算下迁移价值,不证明从头永远学不会。
- Sim-to-Real Robot Learning from Pixels with Progressive Nets,图7:读图对应本段的“复用静态任务知识加速动态目标学习”;是相关任务课程,不是任意新技能即学即会。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
读图对应本段的“复用静态任务知识加速动态目标学习”;是相关任务课程,不是任意新技能即学即会。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用018-domain-randomization.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图1 · HTML 图1,实际锚点 S2.F1
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导零输出连接的首步梯度
- 拆初始化与不遗忘的因果作用
- 区分真机适应与零样本迁移
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用018-domain-randomization.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
新列输出复制与零连接初始化段。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F6的图6图注及相关上下文;其余已定位图表见v2逐篇记录。实线经过中值滤波,点线保留原始回报。先看真实训练过程中原始波动,再判断迁移速度;平滑曲线的外观本身不是跨随机种子的置信区间。
技术关系
- 018-domain-randomization · 平行方法
新列真机适应与训练域分布覆盖不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不追求照片逼真怎样学到可迁移定位
- 二、随机化外观并保留定位标签语义
- 三、同步生成随机外观与定位标签
- 四、同时核对定位误差与下游抓取口径
- 五、限定形状和相机范围之外重新验证
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、随机化外观并保留定位标签语义
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、让现实成为训练变化中的一种 → 二、随机化外观并保留定位标签语义
把问题与答案拆开,按推理到检验展开
- 二、问题边界与概念 → 一、问题设定:不追求照片逼真怎样学到可迁移定位
读者在接触方法前知道优化对象与信息权限
- 三、方法:随机化应保留标签语义 → 三、同步生成随机外观与定位标签
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、限定形状和相机范围之外重新验证:随机化相机时若没有同步更新坐标标签,会发生什么?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World,图5:本图固定了物体位置与干扰物组合的训练规模,改变独特纹理和光照的数量;它检验外观多样性,区别于图4增加总训练样本的实验。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
本图固定了物体位置与干扰物组合的训练规模,改变独特纹理和光照的数量;它检验外观多样性,区别于图4增加总训练样本的实验。
- Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World,图4: 图5,原论文图注与图像。本图固定了物体位置与干扰物组合的训练规模,改变独特纹理和光照的数量;它检验外观多样性,区别于图4增加总训练样本的实验。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
图5,原论文图注与图像。本图固定了物体位置与干扰物组合的训练规模,改变独特纹理和光照的数量;它检验外观多样性,区别于图4增加总训练样本的实验。
- Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World,图6:读图对应本段的“几何物体抓取38/40,食品罐9/10”;有限系统级试验,不是通用抓取成功率。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
读图对应本段的“几何物体抓取38/40,食品罐9/10”;有限系统级试验,不是通用抓取成功率。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S4.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S4.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用颜色捷径解释随机化统计作用
- 补相机变化的可辨识性边界
- 串联感知误差到夹爪容差及动力学随机化
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
纹理、干扰物与相机范围随机化设置。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。本图固定了物体位置与干扰物组合的训练规模,改变独特纹理和光照的数量;它检验外观多样性,区别于图4增加总训练样本的实验。
技术关系
- 024-dynamics-randomization · 平行方法
视觉观测随机化与动力学转移随机化作用于不同机制。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习One-Shot Imitation Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样从一条新示范识别已学技能的组合
- 二、让示范注意力与状态控制共同训练
- 三、配对同任务示范与执行轨迹训练上下文策略
- 四、分开验证新布局、新组合与训练任务量
- 五、结构化输入和共享技能限定单样本适应
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、让示范注意力与状态控制共同训练
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、“看一遍就会”到底是什么意思 → 二、让示范注意力与状态控制共同训练
把问题与答案拆开,按推理到检验展开
- 二、任务分布比“一条”更重要 → 一、问题设定:怎样从一条新示范识别已学技能的组合
读者在接触方法前知道优化对象与信息权限
- 三、训练:同任务两条轨迹互相提供监督 → 三、配对同任务示范与执行轨迹训练上下文策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、结构化输入和共享技能限定单样本适应:若把示范中无关停顿删除后动作改变,应怎样解释?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个理解问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- One-Shot Imitation Learning,图3:内嵌图3把训练任务与未见任务分成左右两组,横轴是需要完成的阶段数,纵轴是平均成功率。难度增加时各方法都下降;完整示范、最终状态与带阶段提示的snapshot拥有不同条件信息,不能只用最深色的脚本专家柱当成可学习策略的成绩。
实验/结果图 · 必要原图摘引 · PDF第7页,图3
内嵌图3把训练任务与未见任务分成左右两组,横轴是需要完成的阶段数,纵轴是平均成功率。难度增加时各方法都下降;完整示范、最终状态与带阶段提示的snapshot拥有不同条件信息,不能只用最深色的脚本专家柱当成可学习策略的成绩。
- One-Shot Imitation Learning,图1:(a)为每任务独立训练,(b)是用一条示范指定任务,(c)是跨任务训练一次性模仿器。
实验/结果图 · 必要原图摘引 · PDF第2页,图1
(a)为每任务独立训练,(b)是用一条示范指定任务,(c)是跨任务训练一次性模仿器。
- One-Shot Imitation Learning,图2:示范网络生成上下文,操作网络结合当前状态产生动作;注意力使策略在示范时间与物块之间选择信息。
方法/设定图 · 必要原图摘引 · PDF第5页,图2
示范网络生成上下文,操作网络结合当前状态产生动作;注意力使策略在示范时间与物块之间选择信息。
- One-Shot Imitation Learning,图4:两张热图分别对齐当前物块和下采样示范的时间步,深色注意力的转移提供执行过程的可视化。
方法/设定图 · 必要原图摘引 · PDF第8页,图4
两张热图分别对齐当前物块和下采样示范的时间步,深色注意力的转移提供执行过程的可视化。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用006-dagger.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图1 · PDF文件第2页,图1
原站图表/证明入口
- 图2 · PDF文件第5页,图2
原站图表/证明入口
- 图3 · PDF文件第7页,图3
原站图表/证明入口
- 图4 · PDF文件第8页,图4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 加入稀有事件被dropout漏掉的概率
- 澄清多视图集成预算
- 解释带噪BC与DAgger比较的限定条件
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用006-dagger.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§4.1时间dropout、§5.1集成评价及噪声示范/DAgger比较。
- arxiv.org · 所列章节
v2实际核读:PDF第8页的图4图注及相关上下文;其余已定位图表见v2逐篇记录。图中只展示每类注意力的一个查询头;高权重区域对应所看对象或示范时间段。局部热图能提示分段行为,却不能单独证明某个位置对动作有因果作用。
技术关系
- 006-dagger · 模块组合
上下文模仿架构可用DAgger聚合专家标签。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Dex-Net 2.0: Deep Learning to Plan Robust Grasps with Synthetic Point Clouds and Analytic Grasp Metrics部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:如何用合成监督减少真实抓取采集
- 二、把解析质量、深度对齐与候选搜索接起来
- 三、离线生成解析标签,在线筛选可行抓取
- 四、分别计算高分抓取精度与覆盖率
- 五、解析标签和深度缺陷限定概率解释
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构示例 → 二、把解析质量、深度对齐与候选搜索接起来
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、用物理模型生成抓取老师 → 二、把解析质量、深度对齐与候选搜索接起来
把问题与答案拆开,按推理到检验展开
- 二、任务设定与五个概念 → 一、问题设定:如何用合成监督减少真实抓取采集
读者在接触方法前知道优化对象与信息权限
- 三、方法:几何、概率与神经网络如何接起来 → 三、离线生成解析标签,在线筛选可行抓取
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、解析标签和深度缺陷限定概率解释:提高抓取分数阈值时,为什么应同时报告被拒绝的比例?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个理解问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Dex-Net 2.0: Deep Learning to Plan Robust Grasps with Synthetic Point Clouds and Analytic Grasp Metrics,图9:左侧失败关联重要几何的深度缺失,右侧关联碰撞误判。回到这两类原图,才能判断问题出在观测覆盖还是抓取评分,而不是一概增加模型容量。
实验/结果图 · 必要原图摘引 · HTML S6.F9,图9
左侧失败关联重要几何的深度缺失,右侧关联碰撞误判。回到这两类原图,才能判断问题出在观测覆盖还是抓取评分,而不是一概增加模型容量。
- Dex-Net 2.0: Deep Learning to Plan Robust Grasps with Synthetic Point Clouds and Analytic Grasp Metrics,图3:读图对应本段的“解析标签与规范化深度图训练GQ-CNN”;物理先验进入数据,而非被完全替代。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
读图对应本段的“解析标签与规范化深度图训练GQ-CNN”;物理先验进入数据,而非被完全替代。
- Dex-Net 2.0: Deep Learning to Plan Robust Grasps with Synthetic Point Clouds and Analytic Grasp Metrics,图4:读图对应本段的“解析标签与规范化深度图训练GQ-CNN”;物理先验进入数据,而非被完全替代。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
读图对应本段的“解析标签与规范化深度图训练GQ-CNN”;物理先验进入数据,而非被完全替代。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用030-qt-opt.md的具体机制关系替换或补足承上启下阅读链接
- 补入图9的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S6.F9
原站图表/证明入口
- 表V · HTML 表V,实际锚点 S6.T5
原站图表/证明入口
- 表VI · HTML 表VI,实际锚点 S6.T6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 加入规划器放大模型高估的具体反例
- 核实原文空抓候选覆盖缺口
- 区分CEM预算及与QT-Opt价值语义
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用030-qt-opt.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图9的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
合成解析监督、CEM附录及未覆盖空抓候选讨论。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F9的图9图注及相关上下文;其余已定位图表见v2逐篇记录。左侧失败关联重要几何的深度缺失,右侧关联碰撞误判。回到这两类原图,才能判断问题出在观测覆盖还是抓取评分,而不是一概增加模型容量。
技术关系
- 030-qt-opt · 教学联系
共享搜索接口但静态解析标签与多步Bellman值不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习DART: Noise Injection for Robust Imitation Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样在专家控制下收集恢复行为
- 二、从学习误差估计演示时的扰动分布
- 三、扰动实际执行并保留专家意图作标签
- 四、将恢复收益与重训日程分开比较
- 五、全局高斯扰动未必覆盖状态依赖错误
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、从学习误差估计演示时的扰动分布
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、为什么好示范也需要一点偏差 → 二、从学习误差估计演示时的扰动分布
把问题与答案拆开,按推理到检验展开
- 二、设定与五个前置概念 → 一、问题设定:怎样在专家控制下收集恢复行为
读者在接触方法前知道优化对象与信息权限
- 三、方法:扰动应接近学习者误差 → 三、扰动实际执行并保留专家意图作标签
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 二、从学习误差估计演示时的扰动分布:将执行噪声、下一状态和监督标签分开
教法来源与实际阅读范围
- Michael Laskey, Jonathan Lee, Ken Goldberg · DART: Noise Injection for Robust Imitation Learning
Surrogate loss and state distribution; retroactive feedback; noise-injected execution and expert recovery
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- DART: Noise Injection for Robust Imitation Learning,图4:虚线是在受扰专家分布上的代理损失,实线是在机器人自访问分布上的损失。两线接近才针对分布偏移,单独降低一条线不足以得出同样结论。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
虚线是在受扰专家分布上的代理损失,实线是在机器人自访问分布上的损失。两线接近才针对分布偏移,单独降低一条线不足以得出同样结论。
- DART: Noise Injection for Robust Imitation Learning,图2:读图对应本段的“DART与DAgger最终表现接近,但训练计算与采集回报不同”;加速依赖本文重训频率和实现。
实验/结果图 · 必要原图摘引 · HTML S5.F2,图2
读图对应本段的“DART与DAgger最终表现接近,但训练计算与采集回报不同”;加速依赖本文重训频率和实现。
- DART: Noise Injection for Robust Imitation Learning,图3:读图对应本段的“较小噪声设置79%,BC49%,更大噪声72%”;直接反驳噪声越大越好。
实验/结果图 · 必要原图摘引 · HTML S5.F3,图3
读图对应本段的“较小噪声设置79%,BC49%,更大噪声72%”;直接反驳噪声越大越好。
- DART: Noise Injection for Robust Imitation Learning,图5:读图对应本段的“分布损失差距缩小;合适随机协方差也可有好效果”;优化噪声有实用价值,但并非唯一有效矩阵。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
读图对应本段的“分布损失差距缩小;合适随机协方差也可有好效果”;优化噪声有实用价值,但并非唯一有效矩阵。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用006-dagger.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图2 · HTML 图2,实际锚点 S5.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S5.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 区分误差二阶矩与中心化协方差
- 加入恒定偏差反例
- 纳入随机协方差消融解释
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用006-dagger.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§4方法及附录随机协方差、held-out误差估计。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。虚线是在受扰专家分布上的代理损失,实线是在机器人自访问分布上的损失。两线接近才针对分布偏移,单独降低一条线不足以得出同样结论。
技术关系
- 006-dagger · 平行方法
专家扰动与学习者rollout查询分别处理分布偏移。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Hindsight Experience Replay部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:失败转移怎样为实际到达的目标提供监督
- 二、保持物理转移并重算目标条件奖励
- 三、在回放采样时替换目标并重算奖励
- 四、核对目标采样与初始状态的覆盖作用
- 五、目标相关动力学会破坏重标记前提
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构计算例子 → 二、保持物理转移并重算目标条件奖励
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、失败也可以回答另一个问题 → 二、保持物理转移并重算目标条件奖励
把问题与答案拆开,按推理到检验展开
- 二、设定与五个概念 → 一、问题设定:失败转移怎样为实际到达的目标提供监督
读者在接触方法前知道优化对象与信息权限
- 三、方法:物理转移不变,任务条件改变 → 三、在回放采样时替换目标并重算奖励
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、目标相关动力学会破坏重标记前提:如果目标本身改变了环境转移,还能直接套用HER吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:5 幅
- Hindsight Experience Replay,图6:上排是训练期间最好的测试表现,下排是跨训练阶段的平均表现;横向比较重标记策略时还要固定k,不能把最佳检查点与平均稳定性互换。
实验/结果图 · 必要原图摘引 · PDF第9页,图6
上排是训练期间最好的测试表现,下排是跨训练阶段的平均表现;横向比较重标记策略时还要固定k,不能把最佳检查点与平均稳定性互换。
- Hindsight Experience Replay,图3:三列是推、滑、抓放任务,横轴为训练epoch,成功率曲线带随机种子波动,HER与计数探索应分别比较。
实验/结果图 · 必要原图摘引 · PDF第7页,图3
三列是推、滑、抓放任务,横轴为训练epoch,成功率曲线带随机种子波动,HER与计数探索应分别比较。
- Hindsight Experience Replay,图4:固定单一目标后,HER仍改善三项任务的学习曲线;这与图3多目标训练的设定不同。
实验/结果图 · 必要原图摘引 · PDF第8页,图4
固定单一目标后,HER仍改善三项任务的学习曲线;这与图3多目标训练的设定不同。
- Hindsight Experience Replay,图5:纵轴仍是成功率,使用这项塑形奖励时两种算法整体表现低,不能由奖励更稠密推断训练更容易。
实验/结果图 · 必要原图摘引 · PDF第9页,图5
纵轴仍是成功率,使用这项塑形奖励时两种算法整体表现低,不能由奖励更稠密推断训练更容易。
- Hindsight Experience Replay,图7:四帧展示模拟训练策略在真机上的一次抓放过程;样例演示不等于高置信度成功率统计。
方法/设定图 · 必要原图摘引 · PDF第10页,图7
四帧展示模拟训练策略在真机上的一次抓放过程;样例演示不等于高置信度成功率统计。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用011-ddpg.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图3 · PDF文件第7页,图3
原站图表/证明入口
- 图4 · PDF文件第8页,图4
原站图表/证明入口
- 图5 · PDF文件第9页,图5
原站图表/证明入口
- 图6 · PDF文件第9页,图6
原站图表/证明入口
- 图7 · PDF文件第10页,图7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
本次深化
- 手算原目标采样比例
- 区分相关监督扩增与新物理证据
- 澄清HER不能凭空扩大已访问物理区域
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用011-ddpg.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§4.5重标记策略/k消融与§4.6小规模真机部署。
- arxiv.org · 所列章节
v2实际核读:PDF第9页的图6图注及相关上下文;其余已定位图表见v2逐篇记录。上排是训练期间最好的测试表现,下排是跨训练阶段的平均表现;横向比较重标记策略时还要固定k,不能把最佳检查点与平均稳定性互换。
技术关系
- 011-ddpg · 模块组合
HER提供重标记经验而DDPG提供价值与策略更新。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 页码指PDF文件的物理页序;浏览器不支持页码跳转时,可按标出的页数手动定位。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning Complex Dexterous Manipulation with Deep Reinforcement Learning and Demonstrations部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:高维灵巧探索怎样持续利用少量示范
- 二、分开行为克隆初始化与衰减专家梯度
- 三、先行为克隆,再逐渐减弱专家辅助梯度
- 四、核对交互节省与仿真运行时间
- 五、专家偏好和任务奖励可能出现冲突
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、分开行为克隆初始化与衰减专家梯度
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、示范既是起点,也是训练中的向导 → 二、分开行为克隆初始化与衰减专家梯度
把问题与答案拆开,按推理到检验展开
- 二、任务与关键前提 → 一、问题设定:高维灵巧探索怎样持续利用少量示范
读者在接触方法前知道优化对象与信息权限
- 三、两步方法各自解决什么 → 三、先行为克隆,再逐渐减弱专家辅助梯度
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、专家偏好和任务奖励可能出现冲突:若示范在一类状态上持续与奖励改进方向相反,应怎样排查?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Learning Complex Dexterous Manipulation with Deep Reinforcement Learning and Demonstrations,图9:星号标记训练环境条件,上方曲线考察偏离该条件后的表现。先定位星号再读鲁棒性,才能区分训练分布内拟合和对新条件的迁移。
实验/结果图 · 必要原图摘引 · HTML S5.F9,图9
星号标记训练环境条件,上方曲线考察偏离该条件后的表现。先定位星号再读鲁棒性,才能区分训练分布内拟合和对新条件的迁移。
- Learning Complex Dexterous Manipulation with Deep Reinforcement Learning and Demonstrations,图7:读图对应本段的“稀疏奖励从头学习困难,塑形帮助部分方法”;不证明所有无示范方法都无法解决。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
读图对应本段的“稀疏奖励从头学习困难,塑形帮助部分方法”;不证明所有无示范方法都无法解决。
- Learning Complex Dexterous Manipulation with Deep Reinforcement Learning and Demonstrations,图8:图8提供纯RL动作“不自然”的例子,这是定性观察,不是动作风格的统一量化评分。更像人可能与鲁棒有关,但仅凭视频不能证明人类动作先验是所有鲁棒增益的唯一原因。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
图8提供纯RL动作“不自然”的例子,这是定性观察,不是动作风格的统一量化评分。更像人可能与鲁棒有关,但仅凭视频不能证明人类动作先验是所有鲁棒增益的唯一原因。
- Learning Complex Dexterous Manipulation with Deep Reinforcement Learning and Demonstrations,图10:读图对应本段的“在相应设置中DAPG比DDPGfD更早取得进展”;不能推广成on-policy必比off-policy省数据。
实验/结果图 · 必要原图摘引 · HTML S5.F10,图10
读图对应本段的“在相应设置中DAPG比DDPGfD更早取得进展”;不能推广成on-policy必比off-policy省数据。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 用039-awac.md的具体机制关系替换或补足承上启下阅读链接
- 补入图9的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图10 · HTML 图10,实际锚点 S5.F10
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S5.F9
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S5.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 分析批量归一化对示范梯度的影响
- 二维方向手算
- 区分DAPG和AWAC融合机制
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:用039-awac.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图9的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
示范增强策略梯度与衰减权重说明。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F9的图9图注及相关上下文;其余已定位图表见v2逐篇记录。星号标记训练环境条件,上方曲线考察偏离该条件后的表现。先定位星号再读鲁棒性,才能区分训练分布内拟合和对新条件的迁移。
技术关系
- 039-awac · 平行方法
持续专家加成与全部数据的优势加权回归不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Sim-to-Real Transfer of Robotic Control with Dynamics Randomization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未知摩擦与延迟下怎样学到可迁移推盘
- 二、随机化回合物理并让循环策略利用历史
- 三、每回合采样物理参数并训练带记忆的策略
- 四、分开仿真消融与Fetch真实推盘结果
- 五、随机范围和状态测量限定零样本迁移
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用小例子建立直觉 → 二、随机化回合物理并让循环策略利用历史
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让机器人习惯“物理参数不确定” → 二、随机化回合物理并让循环策略利用历史
把问题与答案拆开,按推理到检验展开
- 二、问题定义:看得见状态,不等于知道动力学 → 一、问题设定:未知摩擦与延迟下怎样学到可迁移推盘
读者在接触方法前知道优化对象与信息权限
- 三、方法:随机世界,带记忆地行动 → 三、每回合采样物理参数并训练带记忆的策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、随机范围和状态测量限定零样本迁移:回合内物理参数突然变化时,已有循环记忆可能怎样误导策略?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Sim-to-Real Transfer of Robotic Control with Dynamics Randomization,图5:模拟与真实关节都执行相同目标轨迹,比较的是肩、肘、腕的响应。轨迹差异说明动力学仍不同,即使后面的推物成功率接近也不能说模型已完全一致。
实验/结果图 · 必要原图摘引 · HTML S5.F5,图5
模拟与真实关节都执行相同目标轨迹,比较的是肩、肘、腕的响应。轨迹差异说明动力学仍不同,即使后面的推物成功率接近也不能说模型已完全一致。
- Sim-to-Real Transfer of Robotic Control with Dynamics Randomization,图6:读图对应本段的“四种架构的仿真学习曲线”;LSTM 在随机动力学下学习较好;不是硬件训练时间曲线。
方法/设定图 · 必要原图摘引 · HTML S5.F6,图6
读图对应本段的“四种架构的仿真学习曲线”;LSTM 在随机动力学下学习较好;不是硬件训练时间曲线。
- Sim-to-Real Transfer of Robotic Control with Dynamics Randomization,图7:读图对应本段的“LSTM 真实 $0.89\pm0.06$,前馈 $0.67\pm0.14$,历史前馈 $0.70\pm0.10$”;历史建模在此任务有迁移价值;真实样本较少,不能推出普遍显著优势。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
读图对应本段的“LSTM 真实 $0.89\pm0.06$,前馈 $0.67\pm0.14$,历史前馈 $0.70\pm0.10$”;历史建模在此任务有迁移价值;真实样本较少,不能推出普遍显著优势。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用022-her.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图5 · HTML 图5,实际锚点 S5.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S4.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S5.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S5.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 以信念更新解释记忆
- 加入相同位置不同物理历史的推力例
- 强调随机参数时间相关性
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用022-her.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§IV-C回合固定参数与逐步噪声、HER组合。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。模拟与真实关节都执行相同目标轨迹,比较的是肩、肘、腕的响应。轨迹差异说明动力学仍不同,即使后面的推物成功率接近也不能说模型已完全一致。
技术关系
- 022-her · 模块组合
HER补足稀疏反馈,随机化与记忆处理物理差异。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样让动作随机性参与长期决策
- 二、同时构造软价值目标与随机策略更新
- 三、按同一软目标更新价值与有界随机策略
- 四、分开跨种子表现与奖励尺度影响
- 五、概率密度和有界动作需要一致处理
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个能算清楚的例子 → 二、同时构造软价值目标与随机策略更新
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:保留多个好动作,而不是过早押注 → 二、同时构造软价值目标与随机策略更新
把问题与答案拆开,按推理到检验展开
- 二、背景:动作噪声为什么还不够 → 一、问题设定:怎样让动作随机性参与长期决策
读者在接触方法前知道优化对象与信息权限
- 三、方法:软评价与软改进如何配合 → 三、按同一软目标更新价值与有界随机策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 二、同时构造软价值目标与随机策略更新:展开KL并说明为何配分函数可从Actor优化删去
教法来源与实际阅读范围
- Lilian Weng · Policy Gradient Algorithms
Notation and policy-gradient theorem; DPG/DDPG; SAC soft policy evaluation and improvement
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第3题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor,图3:三个子图分别检验评估动作选择、奖励尺度和目标网络平滑系数。奖励尺度改变熵与任务回报的相对权重,不能把它仅当成绘图单位变化。
实验/结果图 · 必要原图摘引 · HTML S5.F3,图3
三个子图分别检验评估动作选择、奖励尺度和目标网络平滑系数。奖励尺度改变熵与任务回报的相对权重,不能把它仅当成绘图单位变化。
- Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor,图1:读图对应本段的“难任务上 SAC 学得更快、最终回报较高,简单任务与基线接近”;支持所测环境的样本效率,不能推出所有控制任务占优。
实验/结果图 · 必要原图摘引 · HTML S4.F1,图1
读图对应本段的“难任务上 SAC 学得更快、最终回报较高,简单任务与基线接近”;支持所测环境的样本效率,不能推出所有控制任务占优。
- Soft Actor-Critic: Off-Policy Maximum Entropy Deep Reinforcement Learning with a Stochastic Actor,图2:读图对应本段的“rllab Humanoid 上确定性变体种子间波动更大”;支持随机策略与熵方案的稳定性价值,不是单一模块的纯数学因果证明。
实验/结果图 · 必要原图摘引 · HTML S5.F2,图2
读图对应本段的“rllab Humanoid 上确定性变体种子间波动更大”;支持随机策略与熵方案的稳定性价值,不是单一模块的纯数学因果证明。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用026-td3.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图1 · HTML 图1,实际锚点 S4.F1
原站图表/证明入口
- 图2 · HTML 图2,实际锚点 S5.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S5.F3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;这里采用带独立V网络的原始SAC;奖励尺度与熵的讨论不能直接替换为后续自动温度版本的实现。
本次深化
- 补物理动作尺度与微分熵关系
- 奖励缩放如何改变动作分布的手算
- 区分SAC/TD3目标与SERL系统组合
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用026-td3.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
附录C变量变换与附录D奖励缩放超参数。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。三个子图分别检验评估动作选择、奖励尺度和目标网络平滑系数。奖励尺度改变熵与任务回报的相对权重,不能把它仅当成绘图单位变化。
技术关系
- 026-td3 · 平行方法
共享部分价值稳定化,策略熵目标不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 这里采用带独立V网络的原始SAC;奖励尺度与熵的讨论不能直接替换为后续自动温度版本的实现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Addressing Function Approximation Error in Actor-Critic Methods部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样阻断Actor与Critic相互放大高估
- 二、把双Q、延迟更新和目标平滑放回各自位置
- 三、先更新双Critic,再按延迟日程更新Actor
- 四、用网络匹配对照辨别三项修改的贡献
- 五、保守目标仍可能低估或共同犯错
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个能辨认三种机制的例子 → 二、把双Q、延迟更新和目标平滑放回各自位置
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:先把评分器变可靠,再相信它的动作建议 → 二、把双Q、延迟更新和目标平滑放回各自位置
把问题与答案拆开,按推理到检验展开
- 二、问题定义:没有显式 max,也会选择误差 → 一、问题设定:怎样阻断Actor与Critic相互放大高估
读者在接触方法前知道优化对象与信息权限
- 三、三处修改及其准确位置 → 三、先更新双Critic,再按延迟日程更新Actor
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、保守目标仍可能低估或共同犯错:两个Critic高度相关时,取最小值为何可能帮助有限?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Addressing Function Approximation Error in Actor-Critic Methods,图5:阴影按图注是十次试验统计的半个标准差,曲线还做了平滑;它既不是完整标准差,也不是95%置信区间。跨算法比较应保留这两个处理步骤。
实验/结果图 · 必要原图摘引 · HTML S6.F5,图5
阴影按图注是十次试验统计的半个标准差,曲线还做了平滑;它既不是完整标准差,也不是95%置信区间。跨算法比较应保留这两个处理步骤。
- Addressing Function Approximation Error in Actor-Critic Methods,图1:读图对应本段的“估计 Q 与从状态出发的蒙特卡洛回报对照,DDPG 有明显高估”;支持偏差在训练中真实出现;蒙特卡洛也只是对真值的估计。
实验/结果图 · 必要原图摘引 · HTML S4.F1,图1
读图对应本段的“估计 Q 与从状态出发的蒙特卡洛回报对照,DDPG 有明显高估”;支持偏差在训练中真实出现;蒙特卡洛也只是对真值的估计。
- Addressing Function Approximation Error in Actor-Critic Methods,图2:读图对应本段的“Double DQN、Double Q 的 Actor–Critic 版本仍有残余偏差”;说明直接移植离散方案不充分,不否定所有双估计方法。
实验/结果图 · 必要原图摘引 · HTML S4.F2,图2
读图对应本段的“Double DQN、Double Q 的 Actor–Critic 版本仍有残余偏差”;说明直接移植离散方案不充分,不否定所有双估计方法。
- Addressing Function Approximation Error in Actor-Critic Methods,图3:读图对应本段的“固定策略与持续更新策略下,目标网络速率影响不同”;支持 Actor 与 Critic 耦合是重要问题。
方法/设定图 · 必要原图摘引 · HTML S5.F3,图3
读图对应本段的“固定策略与持续更新策略下,目标网络速率影响不同”;支持 Actor 与 Critic 耦合是重要问题。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用011-ddpg.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图1 · HTML 图1,实际锚点 S4.F1
原站图表/证明入口
- 图2 · HTML 图2,实际锚点 S4.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S5.F3
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S6.F5
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S6.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用min恒等式推导低估与相关误差边界
- 区分分歧和准确性
- 明确TD3不能直接替代离线CQL
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用011-ddpg.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§4 clipped double Q、§5方差处理及算法1。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。阴影按图注是十次试验统计的半个标准差,曲线还做了平滑;它既不是完整标准差,也不是95%置信区间。跨算法比较应保留这两个处理步骤。
技术关系
- 011-ddpg · 直接继承
直接修改DDPG价值目标与更新节奏。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:几步新经验怎样修正下一段动力学预测
- 二、优化适应后的未来误差并重新规划
- 三、用过去窗口适应模型,再规划下一步
- 四、将预测改善与实际控制改善分开核对
- 五、历史窗口需要对应局部一致的动力学
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个具体例子与概念表 → 二、优化适应后的未来误差并重新规划
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:训练一个容易修正的模型 → 二、优化适应后的未来误差并重新规划
把问题与答案拆开,按推理到检验展开
- 二、设定:任务可以在一条轨迹中变化 → 一、问题设定:几步新经验怎样修正下一段动力学预测
读者在接触方法前知道优化对象与信息权限
- 三、方法:把“适应之后好不好”变成训练目标 → 三、用过去窗口适应模型,再规划下一步
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、历史窗口需要对应局部一致的动力学:近期数据窗口跨过动力学突变时,适应会学到什么?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:7 幅
- Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning,图3:横向比较更新前后K步预测误差的直方图,检验的是一次适应是否改善模型预测;后续控制回报另看图5,不能由误差分布直接推出任务必然成功。
实验/结果图 · 必要原图摘引 · HTML S6.F3,图3
横向比较更新前后K步预测误差的直方图,检验的是一次适应是否改善模型预测;后续控制回报另看图5,不能由误差分布直接推出任务必然成功。
- Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning,图4:读图对应本段的“有模型方法在较少训练数据下表现较强”;支持样本效率趋势;不能忽略原文倍数口径疑点。
实验/结果图 · 必要原图摘引 · HTML S6.F4,图4
读图对应本段的“有模型方法在较少训练数据下表现较强”;支持样本效率趋势;不能忽略原文倍数口径疑点。
- Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning,图5:读图对应本段的“快速变化和未见失效条件下,GrBAL 整体表现较好”;说明局部适应有用;“oracle”只是特定全局模型基线,不是最优控制上界。
实验/结果图 · 必要原图摘引 · HTML S6.F5,图5
读图对应本段的“快速变化和未见失效条件下,GrBAL 整体表现较好”;说明局部适应有用;“oracle”只是特定全局模型基线,不是最优控制上界。
- Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning,图6:读图对应本段的“真机新地形、缺腿和负载等测试中轨迹改善”;支持若干硬件变化下可行性,不证明任意损坏都可恢复。
实验/结果图 · 必要原图摘引 · HTML S6.T1.2,图6
读图对应本段的“真机新地形、缺腿和负载等测试中轨迹改善”;支持若干硬件变化下可行性,不证明任意损坏都可恢复。
- Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning,图7:读图对应本段的“真机新地形、缺腿和负载等测试中轨迹改善”;支持若干硬件变化下可行性,不证明任意损坏都可恢复。
实验/结果图 · 必要原图摘引 · HTML S6.F7,图7
读图对应本段的“真机新地形、缺腿和负载等测试中轨迹改善”;支持若干硬件变化下可行性,不证明任意损坏都可恢复。
- Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning,图8:读图对应本段的“适应后未来片段预测误差下降”;更新提取了局部信息,但误差降低不自动保证回报单调提升。
实验/结果图 · 必要原图摘引 · HTML A1.F8,图8
读图对应本段的“适应后未来片段预测误差下降”;更新提取了局部信息,但误差降低不自动保证回报单调提升。
- Learning to Adapt in Dynamic, Real-World Environments through Meta-Reinforcement Learning,图9:读图对应本段的“适应后未来片段预测误差下降”;更新提取了局部信息,但误差降低不自动保证回报单调提升。
实验/结果图 · 必要原图摘引 · HTML A1.F9,图9
读图对应本段的“适应后未来片段预测误差下降”;更新提取了局部信息,但误差降低不自动保证回报单调提升。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将8处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 8 个原文证据入口
- 图3 · HTML 图3,实际锚点 S6.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S6.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S6.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S6.T1.2
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S6.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 A1.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 A1.F9
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;样本倍率和窗口参数应按各实验的明确配置分别解释,不能用概括性倍率反推所有图的统一交互预算。
本次深化
- 加入因果数据划分检查
- 10步混合地面窗口例
- 区分恢复时延与稳定回报
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将8处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
元训练过去/未来划分、算法2每步重置共享先验。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。横向比较更新前后K步预测误差的直方图,检验的是一次适应是否改善模型预测;后续控制回报另看图5,不能由误差分布直接推出任务必然成功。
技术关系
- 024-dynamics-randomization · 平行方法
模型参数适应+规划与策略隐藏状态适应不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 样本倍率和窗口参数应按各实验的明确配置分别解释,不能用概括性倍率反推所有图的统一交互预算。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只有姿态参考时怎样学会受物理约束的动作
- 二、联合模仿奖励、相位和参考状态初始化
- 三、从参考中段初始化并在物理环境更新策略
- 四、把运动画面、任务回报与消融逐项对照
- 五、相位跟踪不能替代真实身体可行性
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一次落地理解它 → 二、联合模仿奖励、相位和参考状态初始化
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:动作捕捉告诉它像什么,强化学习教它怎样做到 → 二、联合模仿奖励、相位和参考状态初始化
把问题与答案拆开,按推理到检验展开
- 二、问题设定:模仿姿态不等于模仿动作标签 → 一、问题设定:只有姿态参考时怎样学会受物理约束的动作
读者在接触方法前知道优化对象与信息权限
- 三、方法:奖励、相位和训练状态分布共同作用 → 三、从参考中段初始化并在物理环境更新策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、相位跟踪不能替代真实身体可行性:早期终止改变后,怎样区分节省无效数据与改变优化目标?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills,图11:对照有无参考状态初始化RSI、提前终止ET的组合,才能分离两项训练设计。它们改变训练数据和失败反馈,不是在部署时直接播放参考轨迹。
实验/结果图 · 必要原图摘引 · HTML S10.F11,图11
对照有无参考状态初始化RSI、提前终止ET的组合,才能分离两项训练设计。它们改变训练数据和失败反馈,不是在部署时直接播放参考轨迹。
- DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills,图3:读图对应本段的“多种形态和高维动作角色可训练”;支持形态覆盖,不是真机迁移实验。
实验/结果图 · 必要原图摘引 · HTML S6.F3,图3
读图对应本段的“多种形态和高维动作角色可训练”;支持形态覆盖,不是真机迁移实验。
- DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills,图12:读图对应本段的“多数技能仅一次训练统计”;回合数多不等于独立训练种子多,稳定性证据有限。
实验/结果图 · 必要原图摘引 · HTML A4.F12,图12
读图对应本段的“多数技能仅一次训练统计”;回合数多不等于独立训练种子多,稳定性证据有限。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用041-amp.md的具体机制关系替换或补足承上启下阅读链接
- 补入图11的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图11 · HTML 图11,实际锚点 S10.F11
原站图表/证明入口
- 图12 · HTML 图12,实际锚点 A4.F12
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S6.F3
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S7.T1
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S10.T3
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 S10.T5
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 S10.T6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用到达概率解释RSI采样作用
- 区分中段恢复和整段连贯
- 根据表5保留并非所有技能同幅获益
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用041-amp.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图11的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
RSI/ET设计与图11、表5消融。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S10.F11的图11图注及相关上下文;其余已定位图表见v2逐篇记录。对照有无参考状态初始化RSI、提前终止ET的组合,才能分离两项训练设计。它们改变训练数据和失败反馈,不是在部署时直接播放参考轨迹。
技术关系
- 041-amp · 历史背景
共同研究物理运动风格但时序参考监督不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:模型未知与环境随机怎样共同进入规划
- 二、用概率集成和粒子轨迹评价候选动作
- 三、让粒子未来参与CEM并只执行首个动作
- 四、分开模型类型、传播方式与样本预算
- 五、有不确定性输出不等于主动探索保证
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个“两条未来不能平均”的例子 → 二、用概率集成和粒子轨迹评价候选动作
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:规划时不要只相信一条未来 → 二、用概率集成和粒子轨迹评价候选动作
把问题与答案拆开,按推理到检验展开
- 二、背景:两种不知道有什么不同 → 一、问题设定:模型未知与环境随机怎样共同进入规划
读者在接触方法前知道优化对象与信息权限
- 三、方法:模型是什么,规划怎样使用它 → 三、让粒子未来参与CEM并只执行首个动作
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、有不确定性输出不等于主动探索保证:增加集成成员却不增加数据多样性,是否必然改进不确定性估计?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:7 幅
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models,图3:曲线按图注汇总“至今最高回报”,不是每个训练时刻的原始策略表现;高而平的曲线可能隐藏后续退步。比较稳定性需要另外查看逐次评估。
实验/结果图 · 必要原图摘引 · HTML S7.F3,图3
曲线按图注汇总“至今最高回报”,不是每个训练时刻的原始策略表现;高而平的曲线可能隐藏后续退步。比较稳定性需要另外查看逐次评估。
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models,图1:左图用模型集成及各模型的预测分布表达不确定性,中图把粒子沿未来轨迹传播,右图展示滚动时域重规划。三块分别对应动力学模型、传播方法和MPC,不能把模型集成本身当成完整规划器。
实验/结果图 · 必要原图摘引 · HTML S1.F1,图1
左图用模型集成及各模型的预测分布表达不确定性,中图把粒子沿未来轨迹传播,右图展示滚动时域重规划。三块分别对应动力学模型、传播方法和MPC,不能把模型集成本身当成完整规划器。
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models,图4:读图对应本段的“概率集成通常强于只含一种不确定性的模型”;支持两类表达共同有用,Cartpole 有例外。
实验/结果图 · 必要原图摘引 · HTML S7.F4,图4
读图对应本段的“概率集成通常强于只含一种不确定性的模型”;支持两类表达共同有用,Cartpole 有例外。
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models,图A.8:四个面板分别固定已收集的1、10、40、80次试验,再改变MPC时域。长时域并非统一更好;阴影是5次重复的5至95百分位范围,不能当标准误。
实验/结果图 · 必要原图摘引 · PDF第15页,图A.8
四个面板分别固定已收集的1、10、40、80次试验,再改变MPC时域。长时域并非统一更好;阴影是5次重复的5至95百分位范围,不能当标准误。
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models,图A.9:横轴为动作噪声标准差占动作范围的比例,纵轴为回报;三条曲线比较不同不确定性建模方法。随噪声增加总体回报降低,概率传播的优势仍受具体任务设置限制。
实验/结果图 · 必要原图摘引 · PDF第15页,图A.9
横轴为动作噪声标准差占动作范围的比例,纵轴为回报;三条曲线比较不同不确定性建模方法。随噪声增加总体回报降低,概率传播的优势仍受具体任务设置限制。
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models,图A.12:六个面板逐一比较建模与传播组合,每个面板蓝线为无噪声、红线为动作范围10%的噪声。比较同一面板内的均值和波动,PE-DS、PE-TS1与PE-TS∞后期波动收窄更明显。
实验/结果图 · 必要原图摘引 · PDF第17页,图A.12
六个面板逐一比较建模与传播组合,每个面板蓝线为无噪声、红线为动作范围10%的噪声。比较同一面板内的均值和波动,PE-DS、PE-TS1与PE-TS∞后期波动收窄更明显。
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models,图A.11:在已知真动力学的半猎豹环境中比较CEM与随机射击,二者均使用2500候选样本预算。误差条很宽,表示跨随机种子的5至95百分位,不能只凭柱高忽略波动。
实验/结果图 · 必要原图摘引 · PDF第16页,图A.11
在已知真动力学的半猎豹环境中比较CEM与随机射击,二者均使用2500候选样本预算。误差条很宽,表示跨随机种子的5至95百分位,不能只凭柱高忽略波动。
未在正文展示的图/表与范围
- 表0:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用007-pilco.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图1 · HTML 图1,实际锚点 S1.F1
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S7.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S7.F4
原站图表/证明入口
- 图A.11 · HTML 图A.11,实际锚点 A1.F11
原站图表/证明入口
- 图A.8 · HTML 图A.8,实际锚点 A1.F8
原站图表/证明入口
- 图A.9 · HTML 图A.9,实际锚点 A1.F9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 补全方差分解和双模型手算
- 解释固定模型粒子的时间意义
- 区分规划预算与MBPO训练数据用途
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用007-pilco.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§5.1 TS1/TS∞与认知/随机不确定性分离。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S7.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。曲线按图注汇总“至今最高回报”,不是每个训练时刻的原始策略表现;高而平的曲线可能隐藏后续退步。比较稳定性需要另外查看逐次评估。
技术关系
- 007-pilco · 平行方法
概率动力学控制的不同模型与传播近似。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习QT-Opt: Scalable Deep Reinforcement Learning for Vision-Based Robotic Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样学到现在不抓却让以后更好抓的动作
- 二、用多步Q值和在线搜索替代单次抓点评分
- 三、异步生成Q目标并混合新旧抓取经验
- 四、把离线87与联合微调96的协议读清
- 五、数据规模和搜索成本限制迁移口径
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个推倒瓶子的教学例子 → 二、用多步Q值和在线搜索替代单次抓点评分
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:不是找一个抓点,而是学会一整段抓取 → 二、用多步Q值和在线搜索替代单次抓点评分
把问题与答案拆开,按推理到检验展开
- 二、设定:从“抓哪里”改成“接下来做什么” → 一、问题设定:怎样学到现在不抓却让以后更好抓的动作
读者在接触方法前知道优化对象与信息权限
- 三、方法:连续动作的最大值用搜索求 → 三、异步生成Q目标并混合新旧抓取经验
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、数据规模和搜索成本限制迁移口径:放回物体与逐次移除物体的测试,为什么会形成不同难度分布?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- QT-Opt: Scalable Deep Reinforcement Learning for Vision-Based Robotic Manipulation,图4:八组抓取序列展示预操作、重抓、动态物体与杂乱场景中的行为。它是策略实例证据,成功率分母和不放回清箱条件还需回到实验表。
实验/结果图 · 必要原图摘引 · HTML S6.F4,图4
八组抓取序列展示预操作、重抓、动态物体与杂乱场景中的行为。它是策略实例证据,成功率分母和不放回清箱条件还需回到实验表。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用013-naf.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将8处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 8 个原文证据入口
- 图4 · HTML 图4,实际锚点 S6.F4
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 A1.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 A1.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 A1.T4
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 A1.T5
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 A1.T6
原站图表/证明入口
- 表9 · HTML 表9,实际锚点 A3.T9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导柔性TD标签交叉熵梯度
- 0.72标签教学例
- 区分同名交叉熵算法及跨任务值域限制
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用013-naf.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将8处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
Q目标的有界交叉熵、CEM动作优化及附录C比较。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。八组抓取序列展示预操作、重抓、动态物体与杂乱场景中的行为。它是策略实例证据,成功率分母和不放回清箱条件还需回到实验表。
技术关系
- 013-naf · 平行方法
CEM近似最大化与二次Q解析最大化不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning Dexterous In-Hand Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多指接触误差下怎样持续重定向物体
- 二、区分回合偏差、瞬时噪声与循环适应
- 三、分别训练循环控制与多相机位姿估计
- 四、用中位旋转次数和视觉配置判断可靠性
- 五、截尾次数和受控追踪限制长期推断
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个能解释记忆的例子 → 二、区分回合偏差、瞬时噪声与循环适应
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让五指手在许多“不完全准确的世界”里练习 → 二、区分回合偏差、瞬时噪声与循环适应
把问题与答案拆开,按推理到检验展开
- 二、任务定义:这是重新定向,不是解魔方 → 一、问题设定:多指接触误差下怎样持续重定向物体
读者在接触方法前知道优化对象与信息权限
- 三、方法:随机化不是随便加噪声 → 三、分别训练循环控制与多相机位姿估计
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、截尾次数和受控追踪限制长期推断:怎样判断失败首先来自视觉位姿还是手内控制?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第2题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 第3题保留v2已核正的“右删失”解释,未恢复20bb192中“右截断”的旧措辞;题目及原有统计辨析意图保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Learning Dexterous In-Hand Manipulation,图10:左图按墙钟时间、右图按消耗的经验年数比较算力规模;GPU增加时批大小也随之变化。两图一起看才能区分训练更快与交互更省。
实验/结果图 · 必要原图摘引 · HTML S6.F10,图10
左图按墙钟时间、右图按消耗的经验年数比较算力规模;GPU增加时批大小也随之变化。两图一起看才能区分训练更快与交互更省。
- Learning Dexterous In-Hand Manipulation,图8:更简单仿真学得更快,却更难迁移。图8、图9 的阴影是单种子运行的移动窗口 90% 区间,不能把它读成多个独立训练种子的置信区间。表4 前五组真实试验交错进行以减少硬件变化影响,视觉组则在另一时间测量;作者对这种限制有说明。
实验/结果图 · 必要原图摘引 · HTML S6.F8.fig1,图8
更简单仿真学得更快,却更难迁移。图8、图9 的阴影是单种子运行的移动窗口 90% 区间,不能把它读成多个独立训练种子的置信区间。表4 前五组真实试验交错进行以减少硬件变化影响,视觉组则在另一时间测量;作者对这种限制有说明。
- Learning Dexterous In-Hand Manipulation,图9:原文记忆消融还分开更强critic与有记忆actor;仅增大critic表达力没有复现循环actor全部收益。图9的区间来自单seed移动窗口,而非多次独立训练,因此不应把它读成种子稳健性证据。原文§6.4
实验/结果图 · 必要原图摘引 · HTML S6.F9.fig1,图9
原文记忆消融还分开更强critic与有记忆actor;仅增大critic表达力没有复现循环actor全部收益。图9的区间来自单seed移动窗口,而非多次独立训练,因此不应把它读成种子稳健性证据。原文§6.4
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 将达到50次即停止的统计术语纠正为右删失
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用035-rubiks.md的具体机制关系替换或补足承上启下阅读链接
- 补入图10的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
- 完善50次停止试验的答案:区分观察区间生存率与超出上限的平均寿命
查看本篇 7 个原文证据入口
- 图10 · HTML 图10,实际锚点 S6.F10
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S6.F8.fig1
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S6.F9.fig1
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S6.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 S6.T4
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 S6.T5
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 S6.T6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;视频中的最佳连续旋转片段不能替代十次试验的完整统计;达到50次即停止的运行按右删失解释。
本次深化
- 推导连续成功的可靠性放大
- 核实记忆消融统计单位
- 补同平台后作继承路线
- v2:将达到50次即停止的统计术语纠正为右删失
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用035-rubiks.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图10的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- v2:完善50次停止试验的答案:区分观察区间生存率与超出上限的平均寿命
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§6.4 actor/critic记忆消融、单seed移动窗口区间;系统部署接口。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F10的图10图注及相关上下文;其余已定位图表见v2逐篇记录。左图按墙钟时间、右图按消耗的经验年数比较算力规模;GPU增加时批大小也随之变化。两图一起看才能区分训练更快与交互更省。
技术关系
- 035-rubiks · 直接继承
后作承接灵巧手随机化迁移并扩展任务和ADR。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 视频中的最佳连续旋转片段不能替代十次试验的完整统计;达到50次即停止的运行按右删失解释。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning Agile and Dynamic Motor Skills for Legged Robots部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:关节指令怎样经过真实执行器变成力矩
- 二、把学习的执行器响应嵌入物理仿真
- 三、先辨识执行器,再在混合仿真中训练运动
- 四、连接力矩预测消融与真实运动结果
- 五、中心模型准确仍需闭环与接触验证
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、把学习的执行器响应嵌入物理仿真
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、把学习的执行器响应嵌入物理仿真
把问题与答案拆开,按推理到检验展开
- 二、研究背景与任务定义 → 一、问题设定:关节指令怎样经过真实执行器变成力矩
读者在接触方法前知道优化对象与信息权限
- 三、方法:把难建模的部分单独学出来 → 三、先辨识执行器,再在混合仿真中训练运动
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、中心模型准确仍需闭环与接触验证
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、先辨识执行器,再在混合仿真中训练运动:将执行器历史输入变成可检查的时间对齐与数据切分约束
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:4 幅
- Learning Agile and Dynamic Motor Skills for Legged Robots,图6:把测量力矩、学习模型预测与理想执行器模型三者对齐,再看验证数据和实际步行数据是否都吻合;不能只用训练分布上的拟合解释闭环稳定性。
实验/结果图 · 必要原图摘引 · HTML Sx4.F6,图6
把测量力矩、学习模型预测与理想执行器模型三者对齐,再看验证数据和实际步行数据是否都吻合;不能只用训练分布上的拟合解释闭环稳定性。
- Learning Agile and Dynamic Motor Skills for Legged Robots,图2:比较同机速度跟踪及机械代价,支持该实验配置下的运动收益;不代表所有传统控制器都被全面超过。
实验/结果图 · 必要原图摘引 · HTML Sx2.F2,图2
比较同机速度跟踪及机械代价,支持该实验配置下的运动收益;不代表所有传统控制器都被全面超过。
- Learning Agile and Dynamic Motor Skills for Legged Robots,图3:真实速度达到 1.5 m/s,原平台先前记录为 1.2 m/s;提升 $(1.5-1.2)/1.2=25\%$。这是该平台纪录变化,不是四足机器人全领域速度纪录。
实验/结果图 · 必要原图摘引 · HTML Sx2.F3,图3
真实速度达到 1.5 m/s,原平台先前记录为 1.2 m/s;提升 $(1.5-1.2)/1.2=25\%$。这是该平台纪录变化,不是四足机器人全领域速度纪录。
- Learning Agile and Dynamic Motor Skills for Legged Robots,图4:展示跌倒后恢复;它是能力证据,不能单凭一段成功运动估计任意姿态分布的成功率。
实验/结果图 · 必要原图摘引 · HTML Sx2.F4,图4
展示跌倒后恢复;它是能力证据,不能单凭一段成功运动估计任意姿态分布的成功率。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图2 · HTML 图2,实际锚点 Sx2.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 Sx2.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 Sx2.F4
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 Sx4.F6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 力矩误差到关节速度的局部推导
- 增加接触分组验证建议
- 明确建模/随机化/适应各自角色
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
执行器建模、图5—6和残余物理随机化。
- arxiv.org · 所列章节
v2实际核读:HTML锚点Sx4.F6的图6图注及相关上下文;其余已定位图表见v2逐篇记录。把测量力矩、学习模型预测与理想执行器模型三者对齐,再看验证数据和实际步行数据是否都吻合;不能只用训练分布上的拟合解释闭环稳定性。
技术关系
- 024-dynamics-randomization · 平行方法
系统建模与参数随机化互补,非相互替代。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习When to Trust Your Model: Model-Based Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样利用模型经验而不依赖长程预测
- 二、从真实状态生成短分支并交给SAC
- 三、从真实状态短程分支并混合两类回放
- 四、核对展开长度、真实样本与更新预算
- 五、局部想象仍可能被策略利用
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、从真实状态生成短分支并交给SAC
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、从真实状态生成短分支并交给SAC
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:怎样利用模型经验而不依赖长程预测
读者在接触方法前知道优化对象与信息权限
- 三、方法:控制模型的使用方式 → 三、从真实状态短程分支并混合两类回放
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、局部想象仍可能被策略利用
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 三、从真实状态短程分支并混合两类回放:用局部误差递推解释短分支削减的是哪部分模型偏差
教法来源与实际阅读范围
- Michael Janner · Model-Based Reinforcement Learning: Theory and Practice
Model-use taxonomy; The Good News; The Bad News; Analyzing the trade-off; short rollouts
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文 · 原文 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:4 幅
- When to Trust Your Model: Model-Based Policy Optimization,图4:同一动作序列分别在环境与模型里展开,阴影显示模型预测逐渐发散。这里的“real environment”指被建模的基准环境,不是宣称做了真实机器人实验。
实验/结果图 · 必要原图摘引 · HTML S6.F4,图4
同一动作序列分别在环境与模型里展开,阴影显示模型预测逐渐发散。这里的“real environment”指被建模的基准环境,不是宣称做了真实机器人实验。
- When to Trust Your Model: Model-Based Policy Optimization,图1:策略偏离数据收集分布时,观察模型误差变化,支持更丰富数据可能改善附近分布泛化;不能保证任意远的新状态都可靠。
实验/结果图 · 必要原图摘引 · HTML S4.F1,图1
策略偏离数据收集分布时,观察模型误差变化,支持更丰富数据可能改善附近分布泛化;不能保证任意远的新状态都可靠。
- When to Trust Your Model: Model-Based Policy Optimization,图2:各任务横轴为环境交互步数,纵轴为回报;实线是5次试验均值,阴影是标准差。比较MBPO与模型无关、模型式基线的学习速度和终点回报时,不把阴影当置信区间。
实验/结果图 · 必要原图摘引 · HTML S5.F2,图2
各任务横轴为环境交互步数,纵轴为回报;实线是5次试验均值,阴影是标准差。比较MBPO与模型无关、模型式基线的学习速度和终点回报时,不把阴影当置信区间。
- When to Trust Your Model: Model-Based Policy Optimization,图3:单纯增加 SAC 更新次数未复现全部收益,短分支很有竞争力;说明数据来源有贡献,而非只因多做优化。
实验/结果图 · 必要原图摘引 · HTML S6.F3,图3
单纯增加 SAC 更新次数未复现全部收益,短分支很有竞争力;说明数据来源有贡献,而非只因多做优化。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用025-sac.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图1 · HTML 图1,实际锚点 S4.F1
原站图表/证明入口
- 图2 · HTML 图2,实际锚点 S5.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S6.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S6.F4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用三状态链解释短模型长价值
- 强调分支截断不能置终止
- 补环境样本与梯度预算的成本分解
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用025-sac.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
算法2短分支、20—40更新比与§6比较设计。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。同一动作序列分别在环境与模型里展开,阴影显示模型预测逐渐发散。这里的“real environment”指被建模的基准环境,不是宣称做了真实机器人实验。
技术关系
- 025-sac · 模块组合
MBPO用SAC消化真实/模型转移。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习RLBench: The Robot Learning Benchmark & Learning Environment部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一次测试究竟换了什么
- 二、用任务层级和成功谓词规定题目
- 三、从航点生成示范,同时记录哪些尝试被过滤
- 四、切开训练、适应和评分的信息权限
- 五、把平台能力与算法成绩分开验收
- 六、检查规划器偏差与真实部署边界
- 七、从共同任务转向共同表示
- 八、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 一、问题设定:一次测试究竟换了什么
先辨认留出变量,再读任务层级定义
- 三、方法:一个可重复的操作实验如何组成 → 二、用任务层级和成功谓词规定题目
先规定题目和评分,不把示意图当泛化结果
- 三、方法:一个可重复的操作实验如何组成 → 三、从航点生成示范,同时记录哪些尝试被过滤
数据生成同时决定样本选择偏差
- 三、方法:一个可重复的操作实验如何组成 → 四、切开训练、适应和评分的信息权限
沿训练/适应/评估权限组织研究设计
- 七、帮助建立理解 → 六、检查规划器偏差与真实部署边界
边界分析后继续讨论采样和接口假设
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 四、切开训练、适应和评分的信息权限:把平台生成能力改写成训练、适应与独立评分的权限边界
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第3题保留v2对图1只展示24种任务的已核更正,基准共有100种任务及原有答案均保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:6 幅
- RLBench: The Robot Learning Benchmark & Learning Environment,图4:树状层级分开任务、变体和回合:变体改目标属性,回合改具体摆放。比较新任务泛化前,先确认留出的是这一层级中的哪一层。
方法/设定图 · 必要原图摘引 · HTML S3.F4,图4
树状层级分开任务、变体和回合:变体改目标属性,回合改具体摆放。比较新任务泛化前,先确认留出的是这一层级中的哪一层。
- RLBench: The Robot Learning Benchmark & Learning Environment,图1:展示多样操作结构,支持集合的广度;不能证明某个模型已经掌握这些任务。
方法/设定图 · 必要原图摘引 · HTML S1.F1,图1
展示多样操作结构,支持集合的广度;不能证明某个模型已经掌握这些任务。
- RLBench: The Robot Learning Benchmark & Learning Environment,图2:说明传感器和输入选择,支持平台可用于视觉研究;不意味着每个方法都使用完全相同的信息。
实验/结果图 · 必要原图摘引 · HTML S3.F2,图2
说明传感器和输入选择,支持平台可用于视觉研究;不意味着每个方法都使用完全相同的信息。
- RLBench: The Robot Learning Benchmark & Learning Environment,图3:说明传感器和输入选择,支持平台可用于视觉研究;不意味着每个方法都使用完全相同的信息。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
说明传感器和输入选择,支持平台可用于视觉研究;不意味着每个方法都使用完全相同的信息。
- RLBench: The Robot Learning Benchmark & Learning Environment,图6:展示成功条件如何落实为程序逻辑;说明可扩展性,不自动证明所有任务条件都无漏洞。
实验/结果图 · 必要原图摘引 · PDF第5页,图6
展示成功条件如何落实为程序逻辑;说明可扩展性,不自动证明所有任务条件都无漏洞。
- RLBench: The Robot Learning Benchmark & Learning Environment,图7:显示语言和时间长度的变化;图中示范约百至千步的范围不能当作每个任务的统一评估时限。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
显示语言和时间长度的变化;图中示范约百至千步的范围不能当作每个任务的统一评估时限。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 按原图注纠正图1仅展示24个任务样例的自测题干
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用036-metaworld.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图1 · HTML 图1,实际锚点 S1.F1
原站图表/证明入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S3.F4
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用任务/变体宏微平均反例审查指标
- 解释规划示范的恢复状态覆盖限制
- 标清与Meta-World及PerAct关系
- v2:按原图注纠正图1仅展示24个任务样例的自测题干
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用036-metaworld.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§IV场景/任务/变体与航点示范生成设计。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。树状层级分开任务、变体和回合:变体改目标属性,回合改具体摆放。比较新任务泛化前,先确认留出的是这一层级中的哪一层。
技术关系
- 036-metaworld · 平行方法
机器人学习基准共享目的但任务/观测/协议不等价。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Solving Rubik's Cube with a Robot Hand部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样把可迁移重定向扩展到长序列转面
- 二、按边界表现扩展随机范围并保留记忆
- 三、用ADR边界表现更新课程并执行求解器动作
- 四、分开解法、感知与实际转面成功
- 五、自动课程仍依赖人为参数与硬件条件
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、按边界表现扩展随机范围并保留记忆
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、按边界表现扩展随机范围并保留记忆
把问题与答案拆开,按推理到检验展开
- 二、研究背景与系统边界 → 一、问题设定:怎样把可迁移重定向扩展到长序列转面
读者在接触方法前知道优化对象与信息权限
- 三、方法:让随机化范围成为可学习的课程 → 三、用ADR边界表现更新课程并执行求解器动作
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、自动课程仍依赖人为参数与硬件条件
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、用ADR边界表现更新课程并执行求解器动作:将双阈值规则展开为保持区间与滞后的含义
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:2 幅
- Solving Rubik's Cube with a Robot Hand,图18:横轴按连续翻转序号推进,并在指定序号施加扰动;同时看完成时间与失败概率。更快不一定更稳,误差条也只对应图注定义的统计量。
实验/结果图 · 必要原图摘引 · HTML S9.F18,图18
横轴按连续翻转序号推进,并在指定序号施加扰动;同时看完成时间与失败概率。更快不一定更稳,误差条也只对应图注定义的统计量。
- Solving Rubik's Cube with a Robot Hand,图17:展示在手套、遮挡等条件下仍能执行若干动作;原文没有量化这些展示,不能据视频声称任意扰动下高成功率。
实验/结果图 · 必要原图摘引 · HTML S8.F17,图17
展示在手套、遮挡等条件下仍能执行若干动作;原文没有量化这些展示,不能据视频声称任意扰动下高成功率。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用031-dexterous.md的具体机制关系替换或补足承上启下阅读链接
- 补入图18的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图17 · HTML 图17,实际锚点 S8.F17
原站图表/证明入口
- 图18 · HTML 图18,实际锚点 S9.F18
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S8.T3
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 S8.T6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 加入逐维边界不等于联合最坏情况的反例
- 拆范围、计算与迁移性能
- 明确求解器/控制器与前作关系
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用031-dexterous.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图18的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
ADR边界采样、缓存阈值和训练数据分支。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S9.F18的图18图注及相关上下文;其余已定位图表见v2逐篇记录。横轴按连续翻转序号推进,并在指定序号施加扰动;同时看完成时间与失败概率。更快不一定更稳,误差条也只对应图注定义的统计量。
技术关系
- 031-dexterous · 直接继承
本篇在先前灵巧手系统上扩展任务和自动随机化。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Meta-World: A Benchmark and Evaluation for Multi-Task and Meta Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:会做单任务为何不等于能联合学习和快速适应
- 二、把多任务目标与元测试预算分别定义
- 三、分开运行联合训练与未见任务适应
- 四、先看单任务参照再读MT与ML结果
- 五、奖励、任务信息和留出因素影响比较
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、把多任务目标与元测试预算分别定义
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、把多任务目标与元测试预算分别定义
把问题与答案拆开,按推理到检验展开
- 二、研究背景:多任务与元学习究竟差在哪里 → 一、问题设定:会做单任务为何不等于能联合学习和快速适应
读者在接触方法前知道优化对象与信息权限
- 三、方法:不是新优化器,而是更清楚的学习问题 → 三、分开运行联合训练与未见任务适应
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、奖励、任务信息和留出因素影响比较
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、分开运行联合训练与未见任务适应:明确任务层与回合层的两级留出及信息泄漏路径
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:2 幅
- Meta-World: A Benchmark and Evaluation for Multi-Task and Meta Reinforcement Learning,图8:图中是ML45的最大成功率汇总,应分开元训练与元测试。训练任务也没学好时,不能把测试差距全部归因于新任务适应。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
图中是ML45的最大成功率汇总,应分开元训练与元测试。训练任务也没学好时,不能把测试差距全部归因于新任务适应。
- Meta-World: A Benchmark and Evaluation for Multi-Task and Meta Reinforcement Learning,图4:连同类任务目标变化也仍有改进空间,提醒不能把较窄设定视作已经完全解决。
实验/结果图 · 必要原图摘引 · HTML S5.F4,图4
连同类任务目标变化也仍有改进空间,提醒不能把较窄设定视作已经完全解决。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用027-dynamics-embedding.md的具体机制关系替换或补足承上启下阅读链接
- 补入图8的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图4 · HTML 图4,实际锚点 S5.F4
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S5.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 量化总预算与每任务预算差异
- 区分目标配置和操作类别泛化
- 补任务信息与适应交互会计
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用027-dynamics-embedding.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图8的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
ML1/ML10/ML45协议与算法适应预算表。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F8的图8图注及相关上下文;其余已定位图表见v2逐篇记录。图中是ML45的最大成功率汇总,应分开元训练与元测试。训练任务也没学好时,不能把测试差距全部归因于新任务适应。
技术关系
- 027-dynamics-embedding · 教学联系
比较任务适应与动力学适应而非算法直接继承。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Dream to Control: Learning Behaviors by Latent Imagination部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样在不反复生成图像的想象中学控制
- 二、连接潜在动力学、可微回报与价值自举
- 三、交替收集真实经验、学习模型与想象行为
- 四、从表现对照检验想象训练的作用
- 五、冻结模型参数不能保证模型梯度正确
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、连接潜在动力学、可微回报与价值自举
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、连接潜在动力学、可微回报与价值自举
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:怎样在不反复生成图像的想象中学控制
读者在接触方法前知道优化对象与信息权限
- 三、方法:世界模型、策略、价值分别学什么 → 三、交替收集真实经验、学习模型与想象行为
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、冻结模型参数不能保证模型梯度正确
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、交替收集真实经验、学习模型与想象行为:区分模型参数冻结、动作路径导数和价值标签停止梯度
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:5 幅
- Dream to Control: Learning Behaviors by Latent Imagination,图4:改变想象长度时,比较有无价值预测以及在线规划。价值模型承接时域之外的收益,因此曲线检验的是长期信用分配,不是未来视频生成得有多远。
实验/结果图 · 必要原图摘引 · HTML S3.F4,图4
改变想象长度时,比较有无价值预测以及在线规划。价值模型承接时域之外的收益,因此曲线检验的是长期信用分配,不是未来视频生成得有多远。
- Dream to Control: Learning Behaviors by Latent Imagination,图5:展示保留轨迹的预测,说明模型捕捉到可见动态;漂亮视频不足以证明动作梯度或接触物理完全正确。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
展示保留轨迹的预测,说明模型捕捉到可见动态;漂亮视频不足以证明动作梯度或接触物理完全正确。
- Dream to Control: Learning Behaviors by Latent Imagination,图6:Dreamer 在五百万环境步后平均分 823,D4PG 参照在一亿步为 786。它支持所测任务中的样本效率与表现收益;两种预算不同,不应称同预算提升。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
Dreamer 在五百万环境步后平均分 823,D4PG 参照在一亿步为 786。它支持所测任务中的样本效率与表现收益;两种预算不同,不应称同预算提升。
- Dream to Control: Learning Behaviors by Latent Imagination,图7:比较只优化有限想象奖励与带价值的方法,检验是否需要跨越短期回报;不能自动推广到任意长操作链。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
比较只优化有限想象奖励与带价值的方法,检验是否需要跨越短期回报;不能自动推广到任意长操作链。
- Dream to Control: Learning Behaviors by Latent Imagination,图8:重构目标在该实验中比只预测奖励更有效;这不是“像素重构永远最好”的定理。
实验/结果图 · 必要原图摘引 · HTML S6.F8,图8
重构目标在该实验中比只预测奖励更有效;这不是“像素重构永远最好”的定理。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用054-daydreamer.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图4 · HTML 图4,实际锚点 S3.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S6.F8
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 补多步模型雅可比误差传播
- 1.1斜率连乘教学例
- 区分Dreamer/MBPO与DayDreamer后继
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用054-daydreamer.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
Agent components、latent dynamics及analytic value gradients。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。改变想象长度时,比较有无价值预测以及在线规划。价值模型承接时域之外的收益,因此曲线检验的是长期信用分配,不是未来视频生成得有多远。
技术关系
- 054-daydreamer · 直接继承
后作承接Dreamer家族并面向真实机器人持续学习。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Conservative Q-Learning for Offline Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:无法重新交互时怎样抑制数据外虚高价值
- 二、在Bellman学习中加入相对保守Q正则
- 三、在固定数据中联合更新TD与保守正则
- 四、把机器人数据收益与失败例子一起读
- 五、下界假设不能变成部署安全保证
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、在Bellman学习中加入相对保守Q正则
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、在Bellman学习中加入相对保守Q正则
把问题与答案拆开,按推理到检验展开
- 二、研究背景:离策略为什么还不够 → 一、问题设定:无法重新交互时怎样抑制数据外虚高价值
读者在接触方法前知道优化对象与信息权限
- 三、方法:为何是压低一部分、保留另一部分 → 三、在固定数据中联合更新TD与保守正则
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、下界假设不能变成部署安全保证
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、在固定数据中联合更新TD与保守正则:说明连续软最大值的采样分布与密度修正
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:1 幅
- Conservative Q-Learning for Offline Reinforcement Learning,图1:横轴是离线训练步数,四个游戏只使用在线DQN最早20%的经验。不同曲线检验固定数据上的训练稳定性,不能把训练步数误当作新增环境交互。
实验/结果图 · 必要原图摘引 · HTML S6.F1,图1
横轴是离线训练步数,四个游戏只使用在线DQN最早20%的经验。不同曲线检验固定数据上的训练稳定性,不能把训练步数误当作新增环境交互。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用047-iql.md的具体机制关系替换或补足承上启下阅读链接
- 补入图1的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图1 · HTML 图1,实际锚点 S6.F1
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S6.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导正则平移不变性
- 双动作梯度数值示例
- 说明未见好动作也可能被保守放弃
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用047-iql.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图1的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§3.1策略期望下界与保守目标。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F1的图1图注及相关上下文;其余已定位图表见v2逐篇记录。横轴是离线训练步数,四个游戏只使用在线DQN最早20%的经验。不同曲线检验固定数据上的训练稳定性,不能把训练步数误当作新增环境交互。
技术关系
- 047-iql · 平行方法
显式保守Q正则与数据内价值学习不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习AWAC: Accelerating Online Reinforcement Learning with Offline Datasets部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:旧示范和新尝试怎样共同支持在线改进
- 二、用TD评价动作再做优势加权回归
- 三、先离线加权回归,再让新经验进入回放
- 四、分开离线预热成绩与新增交互收益
- 五、温度和优势误差决定哪些动作被保留
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、用TD评价动作再做优势加权回归
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、用TD评价动作再做优势加权回归
把问题与答案拆开,按推理到检验展开
- 二、研究背景:需要解决两阶段问题 → 一、问题设定:旧示范和新尝试怎样共同支持在线改进
读者在接触方法前知道优化对象与信息权限
- 三、方法:把策略改进写成加权回归 → 三、先离线加权回归,再让新经验进入回放
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、温度和优势误差决定哪些动作被保留
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、先离线加权回归,再让新经验进入回放:解释固定优势权重和逐步重算之间的区别
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:6 幅
- AWAC: Accelerating Online Reinforcement Learning with Offline Datasets,图3:时间零点之前已经做了离线训练;零点之后才开始在线交互。初期掉点与恢复速度应从这个交界处读,不能把较高起点理解成无需训练。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
时间零点之前已经做了离线训练;零点之后才开始在线交互。初期掉点与恢复速度应从这个交界处读,不能把较高起点理解成无需训练。
- AWAC: Accelerating Online Reinforcement Learning with Offline Datasets,图4:AWAC 在给定旧数据上较快改善。文中的分钟数是仿真交互等效时间,不是实际硬件训练用时。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
AWAC 在给定旧数据上较快改善。文中的分钟数是仿真交互等效时间,不是实际硬件训练用时。
- AWAC: Accelerating Online Reinforcement Learning with Offline Datasets,图5:三幅模拟画面分别展示手内转笔、开门和物体重定位任务;它们说明灵巧操作的不同接触需求,性能比较仍需看对应学习曲线。
实验/结果图 · 必要原图摘引 · HTML S6.F5,图5
三幅模拟画面分别展示手内转笔、开门和物体重定位任务;它们说明灵巧操作的不同接触需求,性能比较仍需看对应学习曲线。
- AWAC: Accelerating Online Reinforcement Learning with Offline Datasets,图6:预训练后继续交互能提高任务回报,支持真实可行性;不能从回报曲线直接虚构统一成功率。
实验/结果图 · 必要原图摘引 · HTML S6.F6,图6
预训练后继续交互能提高任务回报,支持真实可行性;不能从回报曲线直接虚构统一成功率。
- AWAC: Accelerating Online Reinforcement Learning with Offline Datasets,图7:支持旧数据不必全部来自专家,但实验仍限于相应任务与覆盖范围。
实验/结果图 · 必要原图摘引 · HTML S6.F7,图7
支持旧数据不必全部来自专家,但实验仍限于相应任务与覆盖范围。
- AWAC: Accelerating Online Reinforcement Learning with Offline Datasets,图11:HalfCheetah随机数据设置从离线归一化分 2.2 到在线后 52.9,增加 50.7 分;这个变化包含额外在线交互,不能作为纯离线胜出证据。
实验/结果图 · 必要原图摘引 · PDF第16页,图11
HalfCheetah随机数据设置从离线归一化分 2.2 到在线后 52.9,增加 50.7 分;这个变化包含额外在线交互,不能作为纯离线胜出证据。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用047-iql.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图11 · HTML 图11,实际锚点 A1.F11
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S6.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S6.F7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 手算优势权重与状态归一化差异
- 点明critic仍查询策略动作
- 串联DAPG及IQL的不同机制
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用047-iql.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
离线自举误差、KL约束策略改进及经验行为分布。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。时间零点之前已经做了离线训练;零点之后才开始在线交互。初期掉点与恢复速度应从这个交界处读,不能把较高起点理解成无需训练。
技术关系
- 047-iql · 历史背景
优势加权策略提取有连续性,critic学习机制改变。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Transporter Networks: Rearranging the Visual World for Robotic Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:抓取点改变时怎样保持正确放置关系
- 二、用抓取条件特征输运预测放置位置
- 三、预测抓点后用特征互相关搜索放点
- 四、核对空间泛化与动作基元分担的难度
- 五、平面等变结构不自动覆盖三维接触
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、用抓取条件特征输运预测放置位置
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、用抓取条件特征输运预测放置位置
把问题与答案拆开,按推理到检验展开
- 二、研究背景与任务定义 → 一、问题设定:抓取点改变时怎样保持正确放置关系
读者在接触方法前知道优化对象与信息权限
- 三、方法:把“抓哪里”和“放哪里”联系起来 → 三、预测抓点后用特征互相关搜索放点
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、平面等变结构不自动覆盖三维接触
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、预测抓点后用特征互相关搜索放点:把等变性落实到图像和两个动作标签同步变换
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:2 幅
- Transporter Networks: Rearranging the Visual World for Robotic Manipulation,图9:内嵌图9把每次测试放回工作空间:蓝色为成功,红色为失败,灰色标出训练配置,虚线是训练样本凸包。列间改变示范数、行间改变模型;凸包外的蓝点才针对外推,不能把同一区域内插值成功概括为任意物体泛化。
实验/结果图 · 必要原图摘引 · HTML S6.F9,图9
内嵌图9把每次测试放回工作空间:蓝色为成功,红色为失败,灰色标出训练配置,虚线是训练样本凸包。列间改变示范数、行间改变模型;凸包外的蓝点才针对外推,不能把同一区域内插值成功概括为任意物体泛化。
- Transporter Networks: Rearranging the Visual World for Robotic Manipulation,图2: 图2,原论文图注与图像。先看可成功抓取的位置分布,再看每个抓取位置对应的放置分布。它说明抓放联合结构:固定物体目标并不能唯一确定末端该到哪里。
方法/设定图 · 必要原图摘引 · HTML S3.F2,图2
图2,原论文图注与图像。先看可成功抓取的位置分布,再看每个抓取位置对应的放置分布。它说明抓放联合结构:固定物体目标并不能唯一确定末端该到哪里。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用046-clipport.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 S4.T4
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 S4.T5
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 补偏心抓取的可检查几何例
- 推导旋转后末端偏移
- 区分CLIPort继承与PerAct平行空间表示
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用046-clipport.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
transport互相关、抓点条件放置及SE(2)/SE(3)扩展。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。先看可成功抓取的位置分布,再看每个抓取位置对应的放置分布。它说明抓放联合结构:固定物体目标并不能唯一确定末端该到哪里。
技术关系
- 046-clipport · 直接继承
后作保留空间输运结构并组合CLIP语义。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样让动作库评价风格而不指定下一帧
- 二、分开任务奖励与对抗运动先验
- 三、用动作片段训练判别器并联合任务回报学控制
- 四、同时读任务达成、风格与跟踪结果
- 五、风格判别可能漏掉动作库中的模式
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、建立直觉:目标变了,动作风格可以不变 → 二、分开任务奖励与对抗运动先验
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让动作库评价动作,而不指定下一帧 → 二、分开任务奖励与对抗运动先验
把问题与答案拆开,按推理到检验展开
- 二、问题设定:没有专家动作,只有动作记录 → 一、问题设定:怎样让动作库评价风格而不指定下一帧
读者在接触方法前知道优化对象与信息权限
- 三、方法:奖励从哪来,控制怎样学 → 三、用动作片段训练判别器并联合任务回报学控制
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、风格判别可能漏掉动作库中的模式:只看相邻两帧的判别器,能否约束长周期动作的一致性?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control,图4:左侧比较不同动作数据集下的任务回报,右侧比较目标速度与实际速度。多样风格数据有用的证据不仅是动作好看,还包括能否覆盖所要求的行走速度。
实验/结果图 · 必要原图摘引 · HTML S8.F4,图4
左侧比较不同动作数据集下的任务回报,右侧比较目标速度与实际速度。多样风格数据有用的证据不仅是动作好看,还包括能否覆盖所要求的行走速度。
- AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control,图3:时间组合。 行走和出拳片段分别存在,未提供完整“走近再出拳”的示范,策略却学会依次执行。这是组合证据;动作库仍含两个组成技能,而且任务反馈指定了击打目标,不能称为完全无示范发现新技能。
实验/结果图 · 必要原图摘引 · HTML S7.F3,图3
时间组合。 行走和出拳片段分别存在,未提供完整“走近再出拳”的示范,策略却学会依次执行。这是组合证据;动作库仍含两个组成技能,而且任务反馈指定了击打目标,不能称为完全无示范发现新技能。
- AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control,图8:精确模仿的反例。 后空翻跟踪方法误差0.076米,AMP为0.150米;前空翻分别0.278与0.425米。侧空翻则AMP为0.124米、跟踪方法0.191米。总体不是单方面碾压,且误差经过动态时间规整,不能证明原始执行时序同样准确。
实验/结果图 · 必要原图摘引 · HTML S8.F8,图8
精确模仿的反例。 后空翻跟踪方法误差0.076米,AMP为0.150米;前空翻分别0.278与0.425米。侧空翻则AMP为0.124米、跟踪方法0.191米。总体不是单方面碾压,且误差经过动态时间规整,不能证明原始执行时序同样准确。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用015-gail.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图3 · HTML 图3,实际锚点 S7.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S8.F4
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S8.F8
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S8.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S8.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S8.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 局部风格和长时语义的反例
- 结合去速度退化解释输入设计
- 明确DeepMimic问题延续和GAIL模块关系
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用015-gail.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
判别器速度特征及去速度后静止滚动的消融。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S8.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。左侧比较不同动作数据集下的任务回报,右侧比较目标速度与实际速度。多样风格数据有用的证据不仅是动作好看,还包括能否覆盖所要求的行走速度。
技术关系
- 015-gail · 模块组合
对抗运动先验与目标条件RL组合。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习RMA: Rapid Motor Adaptation for Legged Robots部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样从近期动作后果及时估计控制上下文
- 二、训练特权策略并用历史网络估计潜编码
- 三、先学特权策略,再以自访问历史训练适应器
- 四、用仿真对照隔离适应模块的收益
- 五、潜编码滞后和盲感知限制突变处理
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个例子与五个前置概念 → 二、训练特权策略并用历史网络估计潜编码
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:先学“知道环境时怎么走”,再学“从脚下反应猜环境” → 二、训练特权策略并用历史网络估计潜编码
把问题与答案拆开,按推理到检验展开
- 二、背景与设定:鲁棒并不等于知道现在发生了什么 → 一、问题设定:怎样从近期动作后果及时估计控制上下文
读者在接触方法前知道优化对象与信息权限
- 三、方法:特权策略、历史估计和异步执行 → 三、先学特权策略,再以自访问历史训练适应器
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、潜编码滞后和盲感知限制突变处理:适应模块越频繁更新就一定越好吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第2题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- RMA: Rapid Motor Adaptation for Legged Robots,图3:把进入湿滑区域的时段,与膝关节力矩、触地节奏和潜编码变化对齐。潜编码曲线经过中值滤波,其变化提供适应线索,不等于每一维对应已标定的物理量。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
把进入湿滑区域的时段,与膝关节力矩、触地节奏和潜编码变化对齐。潜编码曲线经过中值滤波,其变化提供适应线索,不等于每一维对应已标定的物理量。
- RMA: Rapid Motor Adaptation for Legged Robots,图2:真实负载和软地面。 15厘米下台阶成功率80%;泡沫与床垫测试为100%;作者报告能携带达到自身重量的12千克负载。100%来自有限短程试验,不能推出长期零失误承载能力。无适应方法在大负载下有时不倒却不前进,说明只报告跌倒率会奖励“站着不动”。
实验/结果图 · 必要原图摘引 · HTML S3.F2,图2
真实负载和软地面。 15厘米下台阶成功率80%;泡沫与床垫测试为100%;作者报告能携带达到自身重量的12千克负载。100%来自有限短程试验,不能推出长期零失误承载能力。无适应方法在大负载下有时不倒却不前进,说明只报告跌倒率会奖励“站着不动”。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用006-dagger.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S4.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S5.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;仿真步长与控制频率之间的具体实现关系尚未核实,因此不能仅用其中一个数字推算观测或适应更新频率。
本次深化
- 推导编码误差到动作误差敏感度
- 分析异步编码年龄和突变边界
- 标清DAgger借鉴的具体标签差异
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用006-dagger.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§III-B适应模块自访问数据及100/10Hz异步设计。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。把进入湿滑区域的时段,与膝关节力矩、触地节奏和潜编码变化对齐。潜编码曲线经过中值滤波,其变化提供适应线索,不等于每一维对应已标定的物理量。
技术关系
- 006-dagger · 模块组合
借用自访问分布收集思想,标签改为环境潜编码。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 仿真步长与控制频率之间的具体实现关系尚未核实,因此不能仅用其中一个数字推算观测或适应更新频率。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习What Matters in Learning from Offline Human Demonstrations for Robot Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同一批人类示范为什么产生不同闭环结果
- 二、分开循环记忆与多峰动作分布的作用
- 三、保留轨迹边界训练BC-RNN并按规定选模
- 四、将检查点选择预算与算法结果分开
- 五、人类数据来源和评估方式限制结论
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、建立理解:一次小误差如何改变后续数据 → 二、分开循环记忆与多峰动作分布的作用
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:为什么同样的示范,有人能学会,有人学不会 → 二、分开循环记忆与多峰动作分布的作用
把问题与答案拆开,按推理到检验展开
- 二、研究背景:人类数据与机器数据并非同一种分布 → 一、问题设定:同一批人类示范为什么产生不同闭环结果
读者在接触方法前知道优化对象与信息权限
- 三、方法:把BC-RNN拆开,理解强基线从何而来 → 三、保留轨迹边界训练BC-RNN并按规定选模
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、人类数据来源和评估方式限制结论:同一个BC-RNN改成更长的测试记忆,是否仍算原协议复现?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- What Matters in Learning from Offline Human Demonstrations for Robot Manipulation,图4:本页摘引左侧检查点选择面板,比较最小验证损失、最后检查点与最佳策略的表现;原图右侧算法结果表见原文。检查点选择和算法能力是两种不同变量。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4,左侧检查点选择面板
本页摘引左侧检查点选择面板,比较最小验证损失、最后检查点与最佳策略的表现;原图右侧算法结果表见原文。检查点选择和算法能力是两种不同变量。
- What Matters in Learning from Offline Human Demonstrations for Robot Manipulation,图2:容易被忽略的设计会改变结果。 腕部相机、图像增强、GMM、循环容量都影响性能。附录J显示低噪声评估并非统一提高每一行,它是一项有用但需要记录的执行选择。增加关节或末端速度信息反而可能下降,作者提出过拟合解释;这是解释性假设,不是证明额外传感信息本身有害。
实验/结果图 · 必要原图摘引 · HTML S4.F2,图2
容易被忽略的设计会改变结果。 腕部相机、图像增强、GMM、循环容量都影响性能。附录J显示低噪声评估并非统一提高每一行,它是一项有用但需要记录的执行选择。增加关节或末端速度信息反而可能下降,作者提出过拟合解释;这是解释性假设,不是证明额外传感信息本身有害。
- What Matters in Learning from Offline Human Demonstrations for Robot Manipulation,图4:左侧比较按验证损失或最后检查点选策略造成的相对变化,右侧保留图中配套的图像观测结果表。
实验/结果图 · 必要原图摘引 · PDF第6页,图5(HTML图4)
左侧比较按验证损失或最后检查点选策略造成的相对变化,右侧保留图中配套的图像观测结果表。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图2 · HTML 图2,实际锚点 S4.F2
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S3.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S3.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 关键接触帧与平均损失反例
- 拆仿真最佳/真机最终检查点口径
- 加入重复选模的独立测试需求
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
模型选择难题、仿真最佳检查点和真机最终检查点评估。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。左图比较按最小验证损失、最终检查点和最佳策略表现选模型的差异;右图才比较图像观测算法。检查点选择和算法能力是两种不同变量。
技术关系
- 061-diffusion-policy · 历史背景
人类多模态时序行为研究为后续动作生成方法提供问题背景。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Implicit Behavioral Cloning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:连续网络怎样表示分支动作选择
- 二、用对比能量训练并搜索低能候选
- 三、训练能量排序并在每个观测下求低谷
- 四、将表示收益与搜索预算分开评估
- 五、能量形状好也可能被优化器错过
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个例子与五个前置概念 → 二、用对比能量训练并搜索低能候选
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:不直接报动作,而是评价候选动作 → 二、用对比能量训练并搜索低能候选
把问题与答案拆开,按推理到检验展开
- 二、背景:动作不连续并不代表网络必须不连续 → 一、问题设定:连续网络怎样表示分支动作选择
读者在接触方法前知道优化对象与信息权限
- 三、方法:把监督学习变成动作能量排序 → 三、训练能量排序并在每个观测下求低谷
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、能量形状好也可能被优化器错过:增加训练负样本与增加执行候选数,为什么不能当作同一种改进?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Implicit Behavioral Cloning,图2:红色放大框关注不连续点附近,训练区间外另检验外推。连续能量可以让最优动作分支跳变,但这张一维拟合图不能替代真实接触任务的安全性评估。
实验/结果图 · 必要原图摘引 · HTML S3.F2,图2
红色放大框关注不连续点附近,训练区间外另检验外推。连续能量可以让最优动作分支跳变,但这张一维拟合图不能替代真实接触任务的安全性评估。
- Implicit Behavioral Cloning,图3:表示能力诊断。 简单函数显示隐式形式能够维持分支而不输出中间动作;视觉坐标回归在少数据下也更好。这些实验帮助解释假设,但不是对复杂接触机器人成功原因的完整因果证明。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
表示能力诊断。 简单函数显示隐式形式能够维持分支而不输出中间动作;视觉坐标回归在少数据下也更好。这些实验帮助解释假设,但不是对复杂接触机器人成功原因的完整因果证明。
- Implicit Behavioral Cloning,图4:表示能力诊断。 简单函数显示隐式形式能够维持分支而不输出中间动作;视觉坐标回归在少数据下也更好。这些实验帮助解释假设,但不是对复杂接触机器人成功原因的完整因果证明。
实验/结果图 · 必要原图摘引 · HTML S3.F4,图4
表示能力诊断。 简单函数显示隐式形式能够维持分支而不输出中间动作;视觉坐标回归在少数据下也更好。这些实验帮助解释假设,但不是对复杂接触机器人成功原因的完整因果证明。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S3.F4
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 A3.T7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;真机插入评价包含部分完成得分;图表中的平均分不能换写成完整插入成功率。
本次深化
- 构造连续能量不连续argmin例
- 候选命中概率推导
- 将搜索预算纳入方法比较
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
附录B无导数/自回归/Langevin推理及维度比较。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。红色放大框关注不连续点附近,训练区间外另检验外推。连续能量可以让最优动作分支跳变,但这张一维拟合图不能替代真实接触任务的安全性评估。
技术关系
- 061-diffusion-policy · 平行方法
都表达多模态动作,但能量搜索与去噪生成不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 真机插入评价包含部分完成得分;图表中的平均分不能换写成完整插入成功率。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:大规模并行怎样加速而不损害时序估计
- 二、匹配环境数、片段长度与超时自举
- 三、在GPU内同步采样、估值与PPO更新
- 四、同时检查吞吐、墙钟收敛和真机部署
- 五、并行样本数不等于独立长期经验
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个例子与五个前置概念 → 二、匹配环境数、片段长度与超时自举
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:“分钟”改变的是研究迭代速度 → 二、匹配环境数、片段长度与超时自举
把问题与答案拆开,按推理到检验展开
- 二、研究背景:PPO训练慢,瓶颈不只在反向传播 → 一、问题设定:大规模并行怎样加速而不损害时序估计
读者在接触方法前知道优化对象与信息权限
- 三、方法:系统效率必须与估计器匹配 → 三、在GPU内同步采样、估值与PPO更新
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、并行样本数不等于独立长期经验:固定总批次时增加环境数,应怎样判断是否牺牲了远期信用?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:7 幅
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning,图4:颜色编码机器人数量,点形状编码批大小;回报和训练时间分别成图。最有价值的是时间较短且回报较高的配置,而非只追求最多并行环境。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
颜色编码机器人数量,点形状编码批大小;回报和训练时间分别成图。最有价值的是时间较短且回报较高的配置,而非只追求最多并行环境。
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning,图3:左图对应500次、右图对应1000次策略更新,4000个并行机器人逐步进入更难的地形。它展示自动课程推进的状态,不能仅凭机器人分布推断单个策略的成功率。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
左图对应500次、右图对应1000次策略更新,4000个并行机器人逐步进入更难的地形。它展示自动课程推进的状态,不能仅凭机器人分布推断单个策略的成功率。
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning,图5:地形边界清楚存在。 对20厘米内台阶接近100%仿真穿越成功,而25度以上上坡开始不可行;随机障碍更难。离散障碍高度可正可负,因此相邻落差可达到标称高度两倍,不能把两种“20厘米”直接等价。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
地形边界清楚存在。 对20厘米内台阶接近100%仿真穿越成功,而25度以上上坡开始不可行;随机障碍更难。离散障碍高度可正可负,因此相邻落差可达到标称高度两倍,不能把两种“20厘米”直接等价。
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning,图7:真机可用,但感知误差降低鲁棒性。 仿真测试前向指令0.75米/秒,真机限为0.6米/秒。作者说明高程地图误差在高速时造成问题,并展示上下楼梯与障碍通过。正文未提供可直接与图5对齐的完整真机成功率表,本文也未核实所有真机重复数。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
真机可用,但感知误差降低鲁棒性。 仿真测试前向指令0.75米/秒,真机限为0.6米/秒。作者说明高程地图误差在高速时造成问题,并展示上下楼梯与障碍通过。正文未提供可直接与图5对齐的完整真机成功率表,本文也未核实所有真机重复数。
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning,图8:瓶颈并未消失。 物理仿真与观测奖励计算占主要时间,固定批次下学习步骤耗时基本不受环境数影响。4096粗糙地形机器人约需6 GB显存,无图形;开启显示约9 GB。显存量是该版本配置测量,不是对未来任意模型的通用硬件需求。
实验/结果图 · 必要原图摘引 · HTML A1.F8,图8
瓶颈并未消失。 物理仿真与观测奖励计算占主要时间,固定批次下学习步骤耗时基本不受环境数影响。4096粗糙地形机器人约需6 GB显存,无图形;开启显示约9 GB。显存量是该版本配置测量,不是对未来任意模型的通用硬件需求。
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning,图9:瓶颈并未消失。 物理仿真与观测奖励计算占主要时间,固定批次下学习步骤耗时基本不受环境数影响。4096粗糙地形机器人约需6 GB显存,无图形;开启显示约9 GB。显存量是该版本配置测量,不是对未来任意模型的通用硬件需求。
实验/结果图 · 必要原图摘引 · HTML A1.F9,图9
瓶颈并未消失。 物理仿真与观测奖励计算占主要时间,固定批次下学习步骤耗时基本不受环境数影响。4096粗糙地形机器人约需6 GB显存,无图形;开启显示约9 GB。显存量是该版本配置测量,不是对未来任意模型的通用硬件需求。
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning,图10:超时处理确有影响。 加入自举降低critic损失,作者报告平地与粗糙任务奖励约提高10%至20%。这是回报改善,不是减少相同比例摔倒,也不表示不加自举完全无法学习。
实验/结果图 · 必要原图摘引 · HTML A1.F10,图10
超时处理确有影响。 加入自举降低critic损失,作者报告平地与粗糙任务奖励约提高10%至20%。这是回报改善,不是减少相同比例摔倒,也不表示不加自举完全无法学习。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用032-anymal.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图10 · HTML 图10,实际锚点 A1.F10
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 A1.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 A1.F9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;附录A.1.1对0.005秒步长的“smaller”表述与上下文不够一致;执行时序采用明确给出的四子步和50 Hz配置,不据该措辞推导稳定性方向。
本次深化
- 超时和摔倒TD目标手算
- 固定batch下环境数/时间长短交换
- 划清仿真墙钟与真机样本效率
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用032-anymal.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
时间限制自举及附录A.2效果。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。颜色编码机器人数量,点形状编码批大小;回报和训练时间分别成图。最有价值的是时间较短且回报较高的配置,而非只追求最多并行环境。
技术关系
- 032-anymal · 直接继承
承接同一足式模拟训练路线并强化并行系统。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 附录A.1.1对0.005秒步长的“smaller”表述与上下文不够一致;执行时序采用明确给出的四子步和50 Hz配置,不据该措辞推导稳定性方向。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习CLIPort: What and Where Pathways for Robotic Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:语言选择怎样进入精确抓放匹配
- 二、融合语义特征与抓点条件空间输运
- 三、以语言条件融合两路特征并预测抓放
- 四、区分属性组合、未见物体与真实任务
- 五、语义迁移不能替代连续反馈与标定
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、例子与五个前置概念 → 二、融合语义特征与抓点条件空间输运
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:知道“拿什么”,还要知道“在哪里下手” → 二、融合语义特征与抓点条件空间输运
把问题与答案拆开,按推理到检验展开
- 二、研究背景:视觉语言知识与物理可操作性有距离 → 一、问题设定:语言选择怎样进入精确抓放匹配
读者在接触方法前知道优化对象与信息权限
- 三、方法:语言条件怎样进入空间匹配 → 三、以语言条件融合两路特征并预测抓放
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、语义迁移不能替代连续反馈与标定:怎样检测策略是在理解颜色词,还是记住物体位置?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- CLIPort: What and Where Pathways for Robotic Manipulation,图3:内嵌图3直接比较见过与未见过条件下的平均任务得分。横轴是训练示范数,颜色区分语义流、空间流和两流模型;应在同一示范预算及同一seen/unseen划分内比较,平均分也不表示每个任务都同样改善。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
内嵌图3直接比较见过与未见过条件下的平均任务得分。横轴是训练示范数,颜色区分语义流、空间流和两流模型;应在同一示范预算及同一seen/unseen划分内比较,平均分也不表示每个任务都同样改善。
- CLIPort: What and Where Pathways for Robotic Manipulation,图2: 图2,原论文图注与图像。分别沿冻结的语义流与RGB-D空间流看特征如何融合,最后才进入抓取和放置评分。语言预训练提供语义,不自动提供精确抓点或碰撞约束。
实验/结果图 · 必要原图摘引 · HTML S3.F2,图2
图2,原论文图注与图像。分别沿冻结的语义流与RGB-D空间流看特征如何融合,最后才进入抓取和放置评分。语言预训练提供语义,不自动提供精确抓点或碰撞约束。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用040-transporter.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;真实演示训练与仿真基准的数据分别构建,因此真实机器人结果不能描述为仿真零样本迁移。
本次深化
- 提出方向语言下几何增强的标签反例
- 区分语义泛化测试维度
- 标明Transporter继承和GenAug模块使用
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用040-transporter.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
语义/空间结构及SE(2)query旋转放置。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。分别沿冻结的语义流与RGB-D空间流看特征如何融合,最后才进入抓取和放置评分。语言预训练提供语义,不自动提供精确抓点或碰撞约束。
技术关系
- 040-transporter · 直接继承
保留抓放空间输运并加入CLIP条件。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 真实演示训练与仿真基准的数据分别构建,因此真实机器人结果不能描述为仿真零样本迁移。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Offline Reinforcement Learning with Implicit Q-Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样在数据内传播并连接较好的行为片段
- 二、用上expectile学V再以TD更新Q
- 三、先学数据内V与Q,再提取优势加权策略
- 四、把长程拼接收益与操作任务反例并读
- 五、数据内训练不保证策略执行不越界
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个小计算与五个前置概念 → 二、用上expectile学V再以TD更新Q
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:只评价数据里的动作,也能把好片段接起来 → 二、用上expectile学V再以TD更新Q
把问题与答案拆开,按推理到检验展开
- 二、问题定义:机器人需要优于平均示范,却不能随意相信外推 → 一、问题设定:怎样在数据内传播并连接较好的行为片段
读者在接触方法前知道优化对象与信息权限
- 三、方法:为什么同时需要V和Q → 三、先学数据内V与Q,再提取优势加权策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、数据内训练不保证策略执行不越界:只把expectile调高,为什么可能放大数据中偶然的高估?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- Offline Reinforcement Learning with Implicit Q-Learning,图2:比较同一迷宫中的价值图和实际策略,重点看好片段的价值能否穿过低质量数据向远处传播。热图颜色表达价值估计,不能直接当作访问概率。
实验/结果图 · 必要原图摘引 · HTML S5.F2,图2
比较同一迷宫中的价值图和实际策略,重点看好片段的价值能否穿过低质量数据向远处传播。热图颜色表达价值估计,不能直接当作访问概率。
- Offline Reinforcement Learning with Implicit Q-Learning,图3:expectile强度影响传播。 较大 $\tau$ 对迷宫任务很重要。定理是在理想求解与数据支持约束下,$\tau\to1$ 接近支持内最优值;不是有限数据神经网络在 $\tau=0.999$ 必然最好,原文也指出优化变难。
方法/设定图 · 必要原图摘引 · HTML S5.F3,图3
expectile强度影响传播。 较大 $\tau$ 对迷宫任务很重要。定理是在理想求解与数据支持约束下,$\tau\to1$ 接近支持内最优值;不是有限数据神经网络在 $\tau=0.999$ 必然最好,原文也指出优化变难。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用039-awac.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图2 · HTML 图2,实际锚点 S5.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S5.F3
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S5.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 A2.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 完整手算两点expectile
- 说明对异常价值尺度的敏感性
- 明确IQL/AWAC/CQL价值目标差别
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用039-awac.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§4.2动作expectile与环境随机性分离。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。比较同一迷宫中的价值图和实际策略,重点看好片段的价值能否穿过低质量数据向远处传播。热图颜色表达价值估计,不能直接当作访问概率。
技术关系
- 039-awac · 历史背景
保留优势加权思想但更换价值学习机制。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:单技能成功怎样衔接成连续指令链
- 二、连接玩耍重标注与多上下文模仿
- 三、从玩耍片段学习上下文,再连续执行指令
- 四、分开单任务、前缀成功与跨场景划分
- 五、外部裁判和结构化桌面限定长程含义
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、建立理解的例子与前置概念 → 二、连接玩耍重标注与多上下文模仿
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、连接玩耍重标注与多上下文模仿
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:单技能成功怎样衔接成连续指令链
读者在接触方法前知道优化对象与信息权限
- 三、方法:基准和基线分别改了什么 → 三、从玩耍片段学习上下文,再连续执行指令
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、外部裁判和结构化桌面限定长程含义:新增衔接状态示范后,怎样判断收益来自衔接而非单纯更多数据?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks,图8:先确认训练/测试环境组合和传感器套件,再比较连续完成指令的指标。不同组合下的百分比不是同一初始分布上的单技能成功率。
实验/结果图 · 必要原图摘引 · PDF第7页,图8
先确认训练/测试环境组合和传感器套件,再比较连续完成指令的指标。不同组合下的百分比不是同一初始分布上的单技能成功率。
- CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks,图2:控制接口。 它们说明基准输出连续动作,区别于只从少数预定义操作中选一项。支持的是任务包含低层控制挑战;不能推出底层执行器、碰撞处理和真实接触动力学都已被解决。
实验/结果图 · 必要原图摘引 · PDF第3页,图2
控制接口。 它们说明基准输出连续动作,区别于只从少数预定义操作中选一项。支持的是任务包含低层控制挑战;不能推出底层执行器、碰撞处理和真实接触动力学都已被解决。
- CALVIN: A Benchmark for Language-Conditioned Policy Learning for Long-Horizon Robot Manipulation Tasks,图6:完成判据。 判据比较片段首尾状态,为数据标注与评测提供可执行定义。它支持可重复检测,但也意味着结果取决于阈值设计。例如达到抽屉位移阈值,不等于机器人学会了检查内部空间或安全放置任意物品。
实验/结果图 · 必要原图摘引 · PDF第5页,图6
完成判据。 判据比较片段首尾状态,为数据标注与评测提供可执行定义。它支持可重复检测,但也意味着结果取决于阈值设计。例如达到抽屉位移阈值,不等于机器人学会了检查内部空间或安全放置任意物品。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用072-gr1.md的具体机制关系替换或补足承上启下阅读链接
- 补入图8的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S3.F6
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S3.F8
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导平均前缀长度与累计成功率关系
- 0.8单阶段成功的长链手算
- 分析技能交接分布和外部停止判定
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用072-gr1.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图8的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
LH-MTLC五任务可行链协议与长链失败讨论。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F8的图8图注及相关上下文;其余已定位图表见v2逐篇记录。先确认训练/测试环境组合和传感器套件,再比较连续完成指令的指标。不同组合下的百分比不是同一初始分布上的单技能成功率。
技术关系
- 072-gr1 · 模块组合
后作使用CALVIN作为语言连续控制评估环境。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Temporal Difference Learning for Model Predictive Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样让短时模型规划连接长期价值
- 二、联合训练任务潜模型、奖励和末端Q
- 三、短时搜索潜在轨迹并用终端Q补足未来
- 四、核对规划预算与真实模型对照的含义
- 五、任务导向表示未必支持新奖励
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个例子和五个概念 → 二、联合训练任务潜模型、奖励和末端Q
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、联合训练任务潜模型、奖励和末端Q
把问题与答案拆开,按推理到检验展开
- 二、背景:长远眼光为什么昂贵 → 一、问题设定:怎样让短时模型规划连接长期价值
读者在接触方法前知道优化对象与信息权限
- 三、方法:五个网络怎样形成一个控制器 → 三、短时搜索潜在轨迹并用终端Q补足未来
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、任务导向表示未必支持新奖励:奖励定义改变后,为什么不能只替换规划器中的一个函数?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:6 幅
- Temporal Difference Learning for Model Predictive Control,图6:左右分别改变规划时域与优化迭代数,另一个参数保持默认。它展示固定已训练模型的推理预算折中,区别于重新训练更大模型。
实验/结果图 · 必要原图摘引 · HTML S5.F6,图6
左右分别改变规划时域与优化迭代数,另一个参数保持默认。它展示固定已训练模型的推理预算折中,区别于重新训练更大模型。
- Temporal Difference Learning for Model Predictive Control,图1:复杂状态控制。 作者在Humanoid、Dog及其他连续任务中比较学习曲线,观察到部分复杂任务优势明显。它支持该模型与规划组合能处理高维连续动作;不能据此断言所有38维控制问题都简单,任务仍有特定奖励与动力学。
实验/结果图 · 必要原图摘引 · HTML S1.F1,图1
复杂状态控制。 作者在Humanoid、Dog及其他连续任务中比较学习曲线,观察到部分复杂任务优势明显。它支持该模型与规划组合能处理高维连续动作;不能据此断言所有38维控制问题都简单,任务仍有特定奖励与动力学。
- Temporal Difference Learning for Model Predictive Control,图2:首帧经在线编码器得到潜状态,再由动力学模型逐步预测后续潜状态及价值、奖励、动作;灰色目标编码器提供训练目标。要区分训练时的目标表征与执行时模型展开的输入。
方法/设定图 · 必要原图摘引 · HTML S4.F2,图2
首帧经在线编码器得到潜状态,再由动力学模型逐步预测后续潜状态及价值、奖励、动作;灰色目标编码器提供训练目标。要区分训练时的目标表征与执行时模型展开的输入。
- Temporal Difference Learning for Model Predictive Control,图3:复杂状态控制。 作者在Humanoid、Dog及其他连续任务中比较学习曲线,观察到部分复杂任务优势明显。它支持该模型与规划组合能处理高维连续动作;不能据此断言所有38维控制问题都简单,任务仍有特定奖励与动力学。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
复杂状态控制。 作者在Humanoid、Dog及其他连续任务中比较学习曲线,观察到部分复杂任务优势明显。它支持该模型与规划组合能处理高维连续动作;不能据此断言所有38维控制问题都简单,任务仍有特定奖励与动力学。
- Temporal Difference Learning for Model Predictive Control,图7:转移不是零样本。 Walk训练后的模型在Run任务中继续在线微调。冻结编码器仍可较快适应,进一步冻结动力学则收敛变慢。这支持表示与动力学可迁移程度不同;不能把结果写成无需新交互就学会跑步。
实验/结果图 · 必要原图摘引 · HTML A0.F7,图7
转移不是零样本。 Walk训练后的模型在Run任务中继续在线微调。冻结编码器仍可较快适应,进一步冻结动力学则收敛变慢。这支持表示与动力学可迁移程度不同;不能把结果写成无需新交互就学会跑步。
- Temporal Difference Learning for Model Predictive Control,图10:一致性约束的价值。 无正则、状态重建、对比式约束与潜在一致性有不同结果;后者整体更稳定。消融支持所测试实现中该训练项有帮助,不证明像素重建在所有数据规模或世界模型任务上都多余。
实验/结果图 · 必要原图摘引 · HTML A0.F10,图10
一致性约束的价值。 无正则、状态重建、对比式约束与潜在一致性有不同结果;后者整体更稳定。消融支持所测试实现中该训练项有帮助,不证明像素重建在所有数据规模或世界模型任务上都多余。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用070-tdmpc2.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将8处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 8 个原文证据入口
- 图1 · HTML 图1,实际锚点 S1.F1
原站图表/证明入口
- 图10 · HTML 图10,实际锚点 A0.F10
原站图表/证明入口
- 图2 · HTML 图2,实际锚点 S4.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 A0.F7
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S5.T1
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 A6.T4.fig1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;式9与附录目标计算分支如何对应到实现,仍需在选定代码版本中核验;本篇不据符号相近认定所有目标分支共享相同梯度路径。
本次深化
- 给出奖励误差与末端价值误差权衡
- 说明界暂不含状态预测偏差
- 结合潜在一致性消融解释表示
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用070-tdmpc2.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将8处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
式8—10奖励/价值/一致性损失及相关消融。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F6的图6图注及相关上下文;其余已定位图表见v2逐篇记录。左右分别改变规划时域与优化迭代数,另一个参数保持默认。它展示固定已训练模型的推理预算折中,区别于重新训练更大模型。
技术关系
- 070-tdmpc2 · 直接继承
后作直接扩展TD-MPC框架。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 式9与附录目标计算分支如何对应到实现,仍需在选定代码版本中核验;本篇不据符号相近认定所有目标分支共享相同梯度路径。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习R3M: A Universal Visual Representation for Robot Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:少量机器人示范怎样借用人类视频表示
- 二、以时序、语言和正则共同预训练视觉编码
- 三、冻结视频视觉编码器并另训任务动作头
- 四、把外部预训和下游示范测试分别计账
- 五、冻结表征仍可能遗漏任务关键接触信息
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个具体例子 → 二、以时序、语言和正则共同预训练视觉编码
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、以时序、语言和正则共同预训练视觉编码
把问题与答案拆开,按推理到检验展开
- 二、问题定义:迁移的是“看”,不是整套行为 → 一、问题设定:少量机器人示范怎样借用人类视频表示
读者在接触方法前知道优化对象与信息权限
- 三、方法:三个预训练信号,一条简单动作头 → 三、冻结视频视觉编码器并另训任务动作头
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、冻结表征仍可能遗漏任务关键接触信息:视觉表示在相似帧上稳定,为什么也可能不利于精细插入?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- R3M: A Universal Visual Representation for Robot Manipulation,图4:误差条按图注是标准误,指标来自下游模仿学习的成功率。它检验表征在新环境/任务上的使用效果,而非预训练视频重建质量。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
误差条按图注是标准误,指标来自下游模仿学习的成功率。它检验表征在新环境/任务上的使用效果,而非预训练视频重建质量。
- R3M: A Universal Visual Representation for Robot Manipulation,图9:整体和逐任务。 作者报告跨设置平均约62%的成功率,在12项任务中的11项上领先所选基线。这里的总体值包含视角、示范数量与随机种子的平均,不是某一个机器人连续运行的成功率,也不是每项任务都超过62%。
实验/结果图 · 必要原图摘引 · HTML A3.F9,图9
整体和逐任务。 作者报告跨设置平均约62%的成功率,在12项任务中的11项上领先所选基线。这里的总体值包含视角、示范数量与随机种子的平均,不是某一个机器人连续运行的成功率,也不是每项任务都超过62%。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用046-clipport.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 A3.F9
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;预训练视频规模、实际采样帧量和总计算成本是不同口径;未确认总帧数时,不能由更新步数直接推算数据效率。
本次深化
- 冻结表示不可逆瓶颈推导
- 毫米接触与语义相同反例
- 保留稀疏约束跨环境非一致结论
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用046-clipport.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
表1增强/稀疏/语言监督消融及下游表示评价。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。误差条按图注是标准误,指标来自下游模仿学习的成功率。它检验表征在新环境/任务上的使用效果,而非预训练视频重建质量。
技术关系
- 046-clipport · 平行方法
任务导向表示预训练与CLIP空间语义组合不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 预训练视频规模、实际采样帧量和总计算成本是不同口径;未确认总帧数时,不能由更新步数直接推算数据效率。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Do As I Can, Not As I Say: Grounding Language in Robotic Affordances部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:语言上有用的技能此刻是否真的能执行
- 二、相乘语言相关性与状态条件可行性
- 三、枚举技能、联合评分并在执行后重选
- 四、分别核对规划成功和整机执行成功
- 五、技能库与评分可靠性限定组合范围
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个可以手算的例子 → 二、相乘语言相关性与状态条件可行性
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、相乘语言相关性与状态条件可行性
把问题与答案拆开,按推理到检验展开
- 二、研究背景与任务定义 → 一、问题设定:语言上有用的技能此刻是否真的能执行
读者在接触方法前知道优化对象与信息权限
- 三、方法:乘法接口怎样工作 → 三、枚举技能、联合评分并在执行后重选
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、技能库与评分可靠性限定组合范围:两种评分都排对顺序,为什么乘积仍可能选错技能?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- Do As I Can, Not As I Say: Grounding Language in Robotic Affordances,图8:逐项看语言评分、可行性评分及其合成评分,最终选择依据合成结果。语言偏好的技能若当前不可执行,应在可行性项被压低。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
逐项看语言评分、可行性评分及其合成评分,最终选择依据合成结果。语言偏好的技能若当前不可执行,应在可行性项被压低。
- Do As I Can, Not As I Say: Grounding Language in Robotic Affordances,表2:表2把规划与实际执行分开统计:先比较完整PaLM-SayCan和No VF的规划列,观察可行性项的作用;再比较实验厨房(Mock Kitchen)与办公厨房(Kitchen)的执行列。101条指令的总分和仅11条的具身状态子集拥有不同分母,不能把单类的大幅差异外推到全部任务。
实验/结果图 · 必要原图摘引 · PDF第9页,表2
表2把规划与实际执行分开统计:先比较完整PaLM-SayCan和No VF的规划列,观察可行性项的作用;再比较实验厨房(Mock Kitchen)与办公厨房(Kitchen)的执行列。101条指令的总分和仅11条的具身状态子集拥有不同分母,不能把单类的大幅差异外推到全部任务。
未在正文展示的图/表与范围
- 表3:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用060-palm-e.md的具体机制关系替换或补足承上启下阅读链接
- 补入图8的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S5.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;这里的结果按2022年8月修订版解释;后续语言模型变化不应倒填到原实验的技能选择准确率。
本次深化
- 手算校准改变组合排序权重
- 对数分解说明两种证据尺度
- 核实附录经验校准并连接PaLM-E
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用060-palm-e.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图8的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
方法概率分解及附录可行性值经验校准。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F8的图8图注及相关上下文;其余已定位图表见v2逐篇记录。逐项看语言评分、可行性评分及其合成评分,最终选择依据合成结果。语言偏好的技能若当前不可执行,应在可行性项被压低。
技术关系
- 060-palm-e · 平行方法
显式候选可行性乘积与感知条件文本生成不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 这里的结果按2022年8月修订版解释;后续语言模型变化不应倒填到原实验的技能选择准确率。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习A Generalist Agent部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多种模态与身体接口怎样共用一套权重
- 二、统一序列表示并只对规定输出计算损失
- 三、按模态编码序列并遮蔽非预测位置的损失
- 四、区分共同容纳任务与跨任务正迁移
- 五、数据混合和量化影响单任务表现
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、手算例子与前置概念 → 二、统一序列表示并只对规定输出计算损失
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、统一序列表示并只对规定输出计算损失
把问题与答案拆开,按推理到检验展开
- 二、背景与问题定义 → 一、问题设定:多种模态与身体接口怎样共用一套权重
读者在接触方法前知道优化对象与信息权限
- 三、方法:统一token,不等于所有模态完全一样 → 三、按模态编码序列并遮蔽非预测位置的损失
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、数据混合和量化影响单任务表现:若机器人数据在混合中只占很小比例,怎样判断下降来自负迁移还是采样不足?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:6 幅
- A Generalist Agent,图5:横轴是达到专家分数的比例阈值,纵轴是超过阈值的任务数。它是任务覆盖分布,既不是一条随训练时间增长的曲线,也不是统一成功率。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
横轴是达到专家分数的比例阈值,纵轴是超过阈值的任务数。它是任务覆盖分布,既不是一条随训练时间增长的曲线,也不是统一成功率。
- A Generalist Agent,图8:图8的规模趋势是在相同处理token数量下比较不同参数量。参数更大意味着更多计算,不能把这张图解释为严格固定FLOPs的最优设计证明。注意力可视化也只是选定头的现象展示,不是因果解释。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
图8的规模趋势是在相同处理token数量下比较不同参数量。参数更大意味着更多计算,不能把这张图解释为严格固定FLOPs的最优设计证明。注意力可视化也只是选定头的现象展示,不是因果解释。
- A Generalist Agent,图9:未见任务有负迁移。 对保留的Boxing,作者没有观察到预训练优势,随机初始化反而更好;只用非控制数据预训练,在某些无视觉控制任务无益甚至有害。不同任务共用网络,不代表不同数据天然相互促进。
方法/设定图 · 必要原图摘引 · HTML S5.F9,图9
未见任务有负迁移。 对保留的Boxing,作者没有观察到预训练优势,随机初始化反而更好;只用非控制数据预训练,在某些无视觉控制任务无益甚至有害。不同任务共用网络,不代表不同数据天然相互促进。
- A Generalist Agent,图10:微调能改变任务能力,但要计入新数据。 改为“蓝叠绿”时,使用500条真实示范,约2小时45分钟,并加入模拟示范,最终真机成功60%;从头BC为0.5%。它支持预训练有助适应,却不是一句新语言指令立即完成颜色目标切换。
实验/结果图 · 必要原图摘引 · HTML S5.F10,图10
微调能改变任务能力,但要计入新数据。 改为“蓝叠绿”时,使用500条真实示范,约2小时45分钟,并加入模拟示范,最终真机成功60%;从头BC为0.5%。它支持预训练有助适应,却不是一句新语言指令立即完成颜色目标切换。
- A Generalist Agent,图11:微调能改变任务能力,但要计入新数据。 改为“蓝叠绿”时,使用500条真实示范,约2小时45分钟,并加入模拟示范,最终真机成功60%;从头BC为0.5%。它支持预训练有助适应,却不是一句新语言指令立即完成颜色目标切换。
实验/结果图 · 必要原图摘引 · HTML S5.F11,图11
微调能改变任务能力,但要计入新数据。 改为“蓝叠绿”时,使用500条真实示范,约2小时45分钟,并加入模拟示范,最终真机成功60%;从头BC为0.5%。它支持预训练有助适应,却不是一句新语言指令立即完成颜色目标切换。
- A Generalist Agent,图19:同域专家仍有优势。 部分机器人微调对照中,只在相同领域预训练的模型表现最好。这给“大杂烩数据一定优于专业数据”提供了直接反例。更大数据多样性可能与有限容量、采样频率和任务干扰形成权衡。
实验/结果图 · 必要原图摘引 · HTML A9.F19,图19
同域专家仍有优势。 部分机器人微调对照中,只在相同领域预训练的模型表现最好。这给“大杂烩数据一定优于专业数据”提供了直接反例。更大数据多样性可能与有限容量、采样频率和任务干扰形成权衡。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用057-rt1.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将8处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 8 个原文证据入口
- 图10 · HTML 图10,实际锚点 S5.F10
原站图表/证明入口
- 图11 · HTML 图11,实际锚点 S5.F11
原站图表/证明入口
- 图19 · HTML 图19,实际锚点 A9.F19
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S5.F9
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S3.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 分析动作token长度隐含权重
- 两任务700/2000监督计数例
- 区分输入计算与输出监督预算
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用057-rt1.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将8处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§2token化、目标掩码及交叉熵。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。横轴是达到专家分数的比例阈值,纵轴是超过阈值的任务数。它是任务覆盖分布,既不是一条随训练时间增长的曲线,也不是统一成功率。
技术关系
- 057-rt1 · 平行方法
统一多领域序列与机器人专用实时架构目标不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Planning with Diffusion for Flexible Behavior Synthesis部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样同时修正整条状态动作计划
- 二、用轨迹去噪与条件引导连接远端目标
- 三、以目标约束引导轨迹去噪并滚动执行
- 四、区分长时域规划收益与生成可行性
- 五、采样迭代不能保证真实动力学一致
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、用轨迹去噪与条件引导连接远端目标
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、用轨迹去噪与条件引导连接远端目标
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:怎样同时修正整条状态动作计划
读者在接触方法前知道优化对象与信息权限
- 三、方法:把计划当作需要补全的数组 → 三、以目标约束引导轨迹去噪并滚动执行
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、采样迭代不能保证真实动力学一致:奖励引导越强,为什么生成计划可能越偏离可执行轨迹?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Planning with Diffusion for Flexible Behavior Synthesis,图4:先看固定起点和目标怎样作为轨迹修补条件,再看中间轨迹如何生成。图中连接成立是模型内的计划结果,不等于每个预测动作都已在真实动力学中验证。
实验/结果图 · 必要原图摘引 · HTML S5.F4,图4
先看固定起点和目标怎样作为轨迹修补条件,再看中间轨迹如何生成。图中连接成立是模型内的计划结果,不等于每个预测动作都已在真实动力学中验证。
- Planning with Diffusion for Flexible Behavior Synthesis,图3:组合与条件传播。 图中展示直线片段可组合出新路径,起终点条件可通过去噪传播到中间轨迹。它说明了机制现象,不能替代任意地图、动态障碍或复杂接触下的可行性证明。
实验/结果图 · 必要原图摘引 · PDF第5页,图3
组合与条件传播。 图中展示直线片段可组合出新路径,起终点条件可通过去噪传播到中间轨迹。它说明了机制现象,不能替代任意地图、动态障碍或复杂接触下的可行性证明。
- Planning with Diffusion for Flexible Behavior Synthesis,图4:三行分别对应U-Maze、Medium和Large;每行从左向右去噪,固定起终点后中间路径逐步形成。行名与去噪方向均保留,示例轨迹不能替代任务平均回报。
实验/结果图 · 必要原图摘引 · PDF第6页,图4
三行分别对应U-Maze、Medium和Large;每行从左向右去噪,固定起终点后中间路径逐步形成。行名与去噪方向均保留,示例轨迹不能替代任务平均回报。
- Planning with Diffusion for Flexible Behavior Synthesis,图7:热启动减少采样负担。 Walker2d medium-expert中保留上一计划并做较少修正,只小幅损失表现。它支持该设置下重用计划有效;若环境突变,旧计划可能是坏初始化,不能保证同样速度收益。
实验/结果图 · 必要原图摘引 · HTML S6.F7,图7
热启动减少采样负担。 Walker2d medium-expert中保留上一计划并做较少修正,只小幅损失表现。它支持该设置下重用计划有效;若环境突变,旧计划可能是坏初始化,不能保证同样速度收益。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S5.F4
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S6.F7
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S5.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;表2中的150规划种子按规划评价重复解释,不能改称150次独立模型训练。
本次深化
- 构造满足端点却违反动力学的残差例
- 拆硬条件和联合可行性
- 明确与Diffusion Policy的非等价关系
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§3.2奖励引导与§3.3约束inpainting。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。先看固定起点和目标怎样作为轨迹修补条件,再看中间轨迹如何生成。图中连接成立是模型内的计划结果,不等于每个预测动作都已在真实动力学中验证。
技术关系
- 061-diffusion-policy · 教学联系
共享扩散工具但联合轨迹规划与条件动作生成不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 表2中的150规划种子按规划评价重复解释,不能改称150次独立模型训练。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习DayDreamer: World Models for Physical Robot Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:真实机器人怎样边执行边用想象改进
- 二、把世界模型行为学习接入异步硬件数据流
- 三、让硬件采集、模型更新与参数发布异步运行
- 四、按机器人分别核对时间与人工干预
- 五、无外部仿真不等于没有模型误差和任务工程
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个具体例子 → 二、把世界模型行为学习接入异步硬件数据流
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、把世界模型行为学习接入异步硬件数据流
把问题与答案拆开,按推理到检验展开
- 二、研究背景与任务设定 → 一、问题设定:真实机器人怎样边执行边用想象改进
读者在接触方法前知道优化对象与信息权限
- 三、方法:先学一个内部模拟器,再学怎么用它 → 三、让硬件采集、模型更新与参数发布异步运行
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、无外部仿真不等于没有模型误差和任务工程:异步训练中,怎样检查策略更新没有拖慢控制?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:6 幅
- DayDreamer: World Models for Physical Robot Learning,图4:下方曲线中的实心圆标出机器人摔倒时刻,需与恢复行为一起读;不要只看平滑回报上升就认为训练过程没有跌倒或人工场地维护。
实验/结果图 · 必要原图摘引 · HTML S3.F4,图4
下方曲线中的实心圆标出机器人摔倒时刻,需与恢复行为一起读;不要只看平滑回报上升就认为训练过程没有跌倒或人工场地维护。
- DayDreamer: World Models for Physical Robot Learning,图2:沿箭头阅读:真机经验进入回放,世界模型从回放序列学习,演员与评论家在潜空间想象轨迹上优化策略,再回到真机采集。想象训练与真实交互是不同数据流。
方法/设定图 · 必要原图摘引 · HTML S1.F2,图2
沿箭头阅读:真机经验进入回放,世界模型从回放序列学习,演员与评论家在潜空间想象轨迹上优化策略,再回到真机采集。想象训练与真实交互是不同数据流。
- DayDreamer: World Models for Physical Robot Learning,图5:视觉搬运吞吐。 UR5在八小时约2.5物体/分钟。指标同时取决于定位、抓取、运输和硬件动作时长;它不是单次抓取成功率。动作约束与自动松爪是达到结果的实验条件。
实验/结果图 · 必要原图摘引 · HTML S3.F5,图5
视觉搬运吞吐。 UR5在八小时约2.5物体/分钟。指标同时取决于定位、抓取、运输和硬件动作时长;它不是单次抓取成功率。动作约束与自动松爪是达到结果的实验条件。
- DayDreamer: World Models for Physical Robot Learning,图6:软物体与辅助结构。 XArm达到约3.1物体/分钟,有时利用绳子把物体拉离角落。作者将其描述为有趣行为;从应用视角看,这说明策略利用了环境提供的辅助工具,不能直接推广为无绳任意软物体操作能力。
方法/设定图 · 必要原图摘引 · HTML S3.F6,图6
软物体与辅助结构。 XArm达到约3.1物体/分钟,有时利用绳子把物体拉离角落。作者将其描述为有趣行为;从应用视角看,这说明策略利用了环境提供的辅助工具,不能直接推广为无绳任意软物体操作能力。
- DayDreamer: World Models for Physical Robot Learning,图7:存在不领先的任务。 Sphero导航与DrQv2表现接近。平均距离0.15按活动区域尺度归一化,不是0.15米,也不是15%失败率。这个结果反对“世界模型在四个平台都大幅胜出”的简单总结。
实验/结果图 · 必要原图摘引 · HTML S3.F7,图7
存在不领先的任务。 Sphero导航与DrQv2表现接近。平均距离0.15按活动区域尺度归一化,不是0.15米,也不是15%失败率。这个结果反对“世界模型在四个平台都大幅胜出”的简单总结。
- DayDreamer: World Models for Physical Robot Learning,图8:适应与模型误差。 四足在新增推扰训练约十分钟后改善;XArm日出光照变化使表现下降,继续训练约五小时恢复。这是带参数更新的适应,不是冻结策略天然光照不变。附录B想象视频甚至出现静止橙球变绿,提醒预测视觉不完美与任务仍可成功能够同时发生。
实验/结果图 · 必要原图摘引 · HTML S3.F8,图8
适应与模型误差。 四足在新增推扰训练约十分钟后改善;XArm日出光照变化使表现下降,继续训练约五小时恢复。这是带参数更新的适应,不是冻结策略天然光照不变。附录B想象视频甚至出现静止橙球变绿,提醒预测视觉不完美与任务仍可成功能够同时发生。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用037-dreamer.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图2 · HTML 图2,实际锚点 S1.F2
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S3.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S3.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S3.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S3.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S3.F8
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;单次训练的执行波动不能替代独立训练种子的不确定性;式5的符号对应尚需核实,不据此声称已验证全部更新分支。
本次深化
- 三种训练时钟分解
- 机械臂/四足更新比教学例
- 指出超参数相同不代表数据计算比相同
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用037-dreamer.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
Implementation异步actor/learner、DreamerV2基础及跨平台设置。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。右侧曲线中的实心圆标出机器人摔倒时刻,需与恢复行为一起读;不要只看平滑回报上升就认为训练过程没有跌倒或人工场地维护。
技术关系
- 037-dreamer · 直接继承
承接潜在想象行为学习,经DreamerV2用于物理系统。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 单次训练的执行波动不能替代独立训练种子的不确定性;式5的符号对应尚需核实,不据此声称已验证全部更新分支。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Perceiver-Actor: A Multi-Task Transformer for Robotic Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样在三维观察中定位下一次关键动作
- 二、用体素和Perceiver预测位姿分类
- 三、从关键帧标签训练位姿头并调用规划器
- 四、将体素收益与规划器分担的能力分开
- 五、离散精度与关键帧控制限制接触能力
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个例子与前置概念 → 二、用体素和Perceiver预测位姿分类
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、用体素和Perceiver预测位姿分类
把问题与答案拆开,按推理到检验展开
- 二、背景与任务定义 → 一、问题设定:怎样在三维观察中定位下一次关键动作
读者在接触方法前知道优化对象与信息权限
- 三、方法:在空间中检测动作 → 三、从关键帧标签训练位姿头并调用规划器
将数学机制与真实更新/执行顺序分成连续两步
- 原教学例子中的进阶追问details块 → 五、离散精度与关键帧控制限制接触能力
与方法边界连读,不混入基础自测
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 三、从关键帧标签训练位姿头并调用规划器:从体素尺寸推导选格正确后的几何误差尺度
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 3 道正文追问,均有对应答案。
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。 20bb192另有三项未答的研究追问,v2已明确题意并逐一补答;本轮完整保留v2的题文及答案,并以followup单列,不与文末三题混计。
正文配图:2 幅
- Perceiver-Actor: A Multi-Task Transformer for Robotic Manipulation,图4:这里比较全局与局部感受野的策略成功率,关注局部细网格是否因丢掉远处任务关系而吃亏。它不能把三维精度与场景语义当成同一个因素。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
这里比较全局与局部感受野的策略成功率,关注局部细网格是否因丢掉远处任务关系而吃亏。它不能把三维精度与场景语义当成同一个因素。
- Perceiver-Actor: A Multi-Task Transformer for Robotic Manipulation,图3:关键帧是核心条件。 随机或固定间隔选择关键动作,在该抽屉消融中导致零表现。它说明动作分段不可忽略,而非单靠Transformer就能消化任意原始控制记录。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
关键帧是核心条件。 随机或固定间隔选择关键动作,在该抽屉消融中导致零表现。它说明动作分段不可忽略,而非单靠Transformer就能消化任意原始控制记录。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
6 / 6 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用040-transporter.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 量化体素与旋转离散误差
- 毫米插装边界教学分析
- 将规划碰撞模式纳入成功归因
- v2:逐一回答三条原有研究追问,补充成立条件、控制变量与验证指标;未复用篇末自测答案
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用040-transporter.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§3.2—3.4体素、旋转分箱、碰撞模式和监督。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。这里比较全局与局部感受野的策略成功率,关注局部细网格是否因丢掉远处任务关系而吃亏。它不能把三维精度与场景语义当成同一个因素。
技术关系
- 040-transporter · 平行方法
体素三维动作分类与平面输运结构不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习VIMA: General Robot Manipulation with Multimodal Prompts部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:文字、对象图和示范怎样共同指定操作
- 二、用对象token和交叉注意力持续读取提示
- 三、编码对象与提示并按历史预测操作原语
- 四、逐级检查提示泛化而不只看L4平均
- 五、检测器和动作原语限定现实迁移
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用小例子建立直觉 → 二、用对象token和交叉注意力持续读取提示
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:把“怎么描述任务”统一起来 → 二、用对象token和交叉注意力持续读取提示
把问题与答案拆开,按推理到检验展开
- 二、问题定义:提示泛化究竟换了什么 → 一、问题设定:文字、对象图和示范怎样共同指定操作
读者在接触方法前知道优化对象与信息权限
- 三、方法:对象、提示与历史如何相连 → 三、编码对象与提示并按历史预测操作原语
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、检测器和动作原语限定现实迁移:对象检测漏掉干扰物时,增加提示长度能补救吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第3题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- VIMA: General Robot Manipulation with Multimodal Prompts,图4:上排改变模型规模,下排固定模型后改变示范数据比例。沿同一排比较才能区分容量和数据量,且每一泛化等级有不同留出条件。
实验/结果图 · 必要原图摘引 · HTML S3.F4,图4
上排改变模型规模,下排固定模型后改变示范数据比例。沿同一排比较才能区分容量和数据量,且每一泛化等级有不同留出条件。
- VIMA: General Robot Manipulation with Multimodal Prompts,图6:模块消融。 用真实边界框代替检测框的提升较小;把对象集合压缩为固定数量 Perceiver token 会损失性能。保持对象编码不变、改成仅拼接提示的因果解码器,较小模型和L4通常受损。前者支持保留细粒度对象信息,后者支持提示连接设计;“控制器更专注”是作者对现象的机制假说,不是已直接测量的因果解释。
实验/结果图 · 必要原图摘引 · HTML S5.F6,图6
模块消融。 用真实边界框代替检测框的提升较小;把对象集合压缩为固定数量 Perceiver token 会损失性能。保持对象编码不变、改成仅拼接提示的因果解码器,较小模型和L4通常受损。前者支持保留细粒度对象信息,后者支持提示连接设计;“控制器更专注”是作者对现象的机制假说,不是已直接测量的因果解释。
- VIMA: General Robot Manipulation with Multimodal Prompts,图7:模块消融。 用真实边界框代替检测框的提升较小;把对象集合压缩为固定数量 Perceiver token 会损失性能。保持对象编码不变、改成仅拼接提示的因果解码器,较小模型和L4通常受损。前者支持保留细粒度对象信息,后者支持提示连接设计;“控制器更专注”是作者对现象的机制假说,不是已直接测量的因果解释。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
模块消融。 用真实边界框代替检测框的提升较小;把对象集合压缩为固定数量 Perceiver token 会损失性能。保持对象编码不变、改成仅拼接提示的因果解码器,较小模型和L4通常受损。前者支持保留细粒度对象信息,后者支持提示连接设计;“控制器更专注”是作者对现象的机制假说,不是已直接测量的因果解释。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用057-rt1.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图4 · HTML 图4,实际锚点 S3.F4
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 表10 · HTML 表10,实际锚点 A5.T10
原站图表/证明入口
- 表11 · HTML 表11,实际锚点 A5.T11
原站图表/证明入口
- 表19 · HTML 表19,实际锚点 A8.T19
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 A4.T7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 分析漏检/假阳性非对称瓶颈
- 核实高召回检测与增强设计
- 区分对象集合泛化和检测泛化
- v2:用057-rt1.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
附录C.4域内Mask R-CNN、高召回选择及伪对象增强。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。上排改变模型规模,下排固定模型后改变示范数据比例。沿同一排比较才能区分容量和数据量,且每一泛化等级有不同留出条件。
技术关系
- 057-rt1 · 平行方法
显式对象检测与软视觉token压缩不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习RT-1: Robotics Transformer for Real-World Control at Scale部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多种厨房指令怎样共用低延迟动作策略
- 二、用语言调制和token压缩预测动作
- 三、以短观察历史并行预测动作命令
- 四、把已见组合、新背景和控制频率分开
- 五、数据广度不能凭空补出新运动机制
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个教学例子 → 二、用语言调制和token压缩预测动作
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:真正昂贵的是持续积累可复用的机器人经验 → 二、用语言调制和token压缩预测动作
把问题与答案拆开,按推理到检验展开
- 二、问题定义:700多条指令不等于700种动作机制 → 一、问题设定:多种厨房指令怎样共用低延迟动作策略
读者在接触方法前知道优化对象与信息权限
- 三、方法:让大一点的策略赶上控制周期 → 三、以短观察历史并行预测动作命令
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、数据广度不能凭空补出新运动机制:语言调制有效,怎样排除模型仍利用厨房背景猜任务?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- RT-1: Robotics Transformer for Real-World Control at Scale,表2:内嵌表2所附结果柱图,四组分别是已见任务、未见任务、干扰物和背景变化。逐组比较RT-1与同表基线,才能看清准确性和泛化的不同难度;已见任务的高成功率不能代替新背景可靠性。
实验/结果图 · 必要原图摘引 · HTML S6.T2.fig1,表2
内嵌表2所附结果柱图,四组分别是已见任务、未见任务、干扰物和背景变化。逐组比较RT-1与同表基线,才能看清准确性和泛化的不同难度;已见任务的高成功率不能代替新背景可靠性。
- RT-1: Robotics Transformer for Real-World Control at Scale,图3: 图3,原论文图注与图像。指令先调制视觉编码,TokenLearner再压缩视觉token,最后Transformer输出离散动作。沿这条数据流读,能避免把视觉压缩等同于逐动作token自回归。
方法/设定图 · 必要原图摘引 · HTML S5.F3,图3
图3,原论文图注与图像。指令先调制视觉编码,TokenLearner再压缩视觉token,最后Transformer输出离散动作。沿这条数据流读,能避免把视觉压缩等同于逐动作token自回归。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用065-rt2.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将9处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 9 个原文证据入口
- 图3 · HTML 图3,实际锚点 S5.F3
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S5.T1
原站图表/证明入口
- 表13 · HTML 表13,实际锚点 A4.T13.fig1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S6.T2.fig1
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 S6.T4.fig1
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 S6.T5
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 S6.T6
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 S6.T7.fig1
原站图表/证明入口
- 表8 · HTML 表8,实际锚点 A4.T8
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 计算注意力压缩比例并限定计算范围
- 完整控制周期延迟手算
- 串联Gato/RT-2并区分价值来源
- v2:用065-rt2.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将9处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
TokenLearner 81到8、六帧48token与缓存/延迟预算。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。指令先调制视觉编码,TokenLearner再压缩视觉token,最后Transformer输出离散动作。沿这条数据流读,能避免把视觉压缩等同于逐动作token自回归。
技术关系
- 065-rt2 · 历史背景
后作沿语言条件动作接口扩大视觉语言预训练。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning Universal Policies via Text-Guided Video Generation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:视频计划怎样连接不同机器人的动作
- 二、先生成条件视频再用逆动力学执行
- 三、生成稀疏视频计划,再补帧并反演身体动作
- 四、区分真实视频质量与真实机器人执行
- 五、可见未来未必满足接触和身体约束
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个具体例子 → 二、先生成条件视频再用逆动力学执行
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:先画出未来,再把未来翻译成动作 → 二、先生成条件视频再用逆动力学执行
把问题与答案拆开,按推理到检验展开
- 二、研究背景:不同身体是否能共享计划 → 一、问题设定:视频计划怎样连接不同机器人的动作
读者在接触方法前知道优化对象与信息权限
- 三、方法:视频生成为什么需要专门改造 → 三、生成稀疏视频计划,再补帧并反演身体动作
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、可见未来未必满足接触和身体约束:逆动力学在两帧之间给出动作,为什么仍可能丢掉必要的接触历史?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- Learning Universal Policies via Text-Guided Video Generation,图8:比较有无互联网预训练时生成的视频计划是否符合未见任务组合;这是计划生成的证据,还没有经过逆动力学、接触执行和机器人闭环的检验。
实验/结果图 · 必要原图摘引 · HTML S4.F9.fig1,图8
比较有无互联网预训练时生成的视频计划是否符合未见任务组合;这是计划生成的证据,还没有经过逆动力学、接触执行和机器人闭环的检验。
- Learning Universal Policies via Text-Guided Video Generation,图6:77.1%的含义。 成功分类器看生成视频的最后一帧,预训练后判定成功77.1%,从零训练72.6%,提高4.5个百分点。这是在生成画面上预测成功,不是机器人执行了77.1%的任务。作者也指出CLIP分数未充分反映任务失败。生成视频、分类器评估和真实控制是三种不同层次的证据。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
77.1%的含义。 成功分类器看生成视频的最后一帧,预训练后判定成功77.1%,从零训练72.6%,提高4.5个百分点。这是在生成画面上预测成功,不是机器人执行了77.1%的任务。作者也指出CLIP分数未充分反映任务失败。生成视频、分类器评估和真实控制是三种不同层次的证据。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用053-diffuser.md的具体机制关系替换或补足承上启下阅读链接
- 补入图8的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S4.F9.fig1
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 S4.T4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用挡板反例说明视频可行性与逆动力学边界
- 拆计划/执行器两级误差
- 再次核实全实验开环口径
- v2:用053-diffuser.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图8的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
视频到逆动力学动作与全实验开环执行说明。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F9.fig1的图8图注及相关上下文;其余已定位图表见v2逐篇记录。比较有无互联网预训练时生成的视频计划是否符合未见任务组合;这是计划生成的证据,还没有经过逆动力学、接触执行和机器人闭环的检验。
技术关系
- 053-diffuser · 平行方法
视频计划+动作适配与状态动作联合去噪规划不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习GenAug: Retargeting Behaviors to Unseen Situations via Generative Augmentation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:图像变了以后原动作标签还能否成立
- 二、用掩码、深度和几何约束生成增强
- 三、编辑示范观测并保留经几何检查的动作标签
- 四、分开位置预测与真实执行两套评价
- 五、增强观察不能创造未示范的恢复动作
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用例子检查标签不变性 → 二、用掩码、深度和几何约束生成增强
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:动作不变,把示范里的世界换个样子 → 二、用掩码、深度和几何约束生成增强
把问题与答案拆开,按推理到检验展开
- 二、问题定义:增强的是观测覆盖,不是行为覆盖 → 一、问题设定:图像变了以后原动作标签还能否成立
读者在接触方法前知道优化对象与信息权限
- 三、方法:哪些变化可以保留原动作 → 三、编辑示范观测并保留经几何检查的动作标签
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、增强观察不能创造未示范的恢复动作:若模型生成的新物体外形合理但质量分布改变,原动作标签为何仍可能失效?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- GenAug: Retargeting Behaviors to Unseen Situations via Generative Augmentation,图12:原图保留真实设置中的失败例子,用它检查生成图像是否改变了与动作有关的几何关系;外观更丰富不意味着所有原动作标签仍然成立。
实验/结果图 · 必要原图摘引 · HTML A1.F12,图12
原图保留真实设置中的失败例子,用它检查生成图像是否改变了与动作有关的几何关系;外观更丰富不意味着所有原动作标签仍然成立。
- GenAug: Retargeting Behaviors to Unseen Situations via Generative Augmentation,图10:增强规模和失败机制。 单一仿真任务从0、10、50到100次增强,观察到泛化改善;图12显示相似颜色和强干扰仍会误导策略,图13定性对比显示深度与网格约束比直接修补更能保留几何。这支持设计直觉,但图像逼真不等于动作标签已得到穷尽验证。单任务增强曲线也不足以保证无限增加生成图始终获益。
实验/结果图 · 必要原图摘引 · HTML S4.F10,图10
增强规模和失败机制。 单一仿真任务从0、10、50到100次增强,观察到泛化改善;图12显示相似颜色和强干扰仍会误导策略,图13定性对比显示深度与网格约束比直接修补更能保留几何。这支持设计直觉,但图像逼真不等于动作标签已得到穷尽验证。单任务增强曲线也不足以保证无限增加生成图始终获益。
- GenAug: Retargeting Behaviors to Unseen Situations via Generative Augmentation,图13:增强规模和失败机制。 单一仿真任务从0、10、50到100次增强,观察到泛化改善;图12显示相似颜色和强干扰仍会误导策略,图13定性对比显示深度与网格约束比直接修补更能保留几何。这支持设计直觉,但图像逼真不等于动作标签已得到穷尽验证。单任务增强曲线也不足以保证无限增加生成图始终获益。
实验/结果图 · 必要原图摘引 · HTML A1.F13,图13
增强规模和失败机制。 单一仿真任务从0、10、50到100次增强,观察到泛化改善;图12显示相似颜色和强干扰仍会误导策略,图13定性对比显示深度与网格约束比直接修补更能保留几何。这支持设计直觉,但图像逼真不等于动作标签已得到穷尽验证。单任务增强曲线也不足以保证无限增加生成图始终获益。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用046-clipport.md的具体机制关系替换或补足承上启下阅读链接
- 补入图12的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图10 · HTML 图10,实际锚点 S4.F10
原站图表/证明入口
- 图12 · HTML 图12,实际锚点 A1.F12
原站图表/证明入口
- 图13 · HTML 图13,实际锚点 A1.F13
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S3.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S3.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S4.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 区分视觉标签不变与物理对象变化
- 透明杯及桌布对照例
- 结合真实失败说明覆盖局限
- v2:用046-clipport.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图12的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§II-C深度/网格约束、顶视吸盘假设和附录失败模式。
- arxiv.org · 所列章节
v2实际核读:HTML锚点A1.F12的图12图注及相关上下文;其余已定位图表见v2逐篇记录。原图保留真实设置中的失败例子,用它检查生成图像是否改变了与动作有关的几何关系;外观更丰富不意味着所有原动作标签仍然成立。
技术关系
- 046-clipport · 模块组合
生成增强为CLIPort提供保标签训练样本。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习PaLM-E: An Embodied Multimodal Language Model部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:连续观测怎样改变语言模型的任务规划
- 二、把感知嵌入接入文本生成并混合训练
- 三、把感知编码插入语言序列并调用低层技能
- 四、分别读取问答指标与真实长任务展示
- 五、文本正确不能替代低层物理可执行性
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个具体例子 → 二、把感知嵌入接入文本生成并混合训练
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让规划器直接看,而不是只听场景描述 → 二、把感知嵌入接入文本生成并混合训练
把问题与答案拆开,按推理到检验展开
- 二、研究背景:知道词义,还要知道眼前的几何 → 一、问题设定:连续观测怎样改变语言模型的任务规划
读者在接触方法前知道优化对象与信息权限
- 三、方法:连续观测如何变成语言模型能处理的输入 → 三、把感知编码插入语言序列并调用低层技能
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、文本正确不能替代低层物理可执行性:规划文本因新图像改变,是否足以证明机器人实现了闭环恢复?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
第3题相对20bb192只含v2已增加的就地原图/原表链接,题意及答案实质未改。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- PaLM-E: An Embodied Multimodal Language Model,图5:图中高层模型输出步骤,两个真实机器人分别调用低层策略执行。应该沿模块边界判断谁负责语言、谁负责连续控制,而不是把整套系统能力全归给文本模型。
实验/结果图 · 必要原图摘引 · HTML S6.F5,图5
图中高层模型输出步骤,两个真实机器人分别调用低层策略执行。应该沿模块边界判断谁负责语言、谁负责连续控制,而不是把整套系统能力全归给文本模型。
- PaLM-E: An Embodied Multimodal Language Model,图4:再看图4的TAMP规划消融:完整混合数据、单机器人数据、是否预训练和是否冻结语言模型分别形成对照。这里报告的是仿真规划成功率,不能与上方两台真机的执行序列混成同一个成功率指标。
实验/结果图 · 必要原图摘引 · HTML S6.F4,图4
再看图4的TAMP规划消融:完整混合数据、单机器人数据、是否预训练和是否冻结语言模型分别形成对照。这里报告的是仿真规划成功率,不能与上方两台真机的执行序列混成同一个成功率指标。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用065-rt2.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图5 · HTML 图5,实际锚点 S6.F5
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S6.T3.fig1
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 S6.T4
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 A2.T7
原站图表/证明入口
- 表8 · HTML 表8,实际锚点 A3.T8
原站图表/证明入口
- 表9 · HTML 表9,实际锚点 A4.T9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 加入对象索引交换的可执行错误例
- 区分嵌入连续与控制连续
- 明确文本计划和低层执行指标
- v2:用065-rt2.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
连续观测嵌入与Embodying the output技能词汇接口。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。图中高层模型输出步骤,两个真实机器人分别调用低层策略执行。应该沿模块边界判断谁负责语言、谁负责连续控制,而不是把整套系统能力全归给文本模型。
技术关系
- 065-rt2 · 历史背景
感知语言接地走向直接动作输出,但接口不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Diffusion Policy: Visuomotor Policy Learning via Action Diffusion部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样保留多条路线又避免逐步左右摇摆
- 二、以观测为条件联合去噪一段动作
- 三、用加噪动作训练去噪器并执行短前缀
- 四、分开网络变体、任务与实际执行时域
- 五、动作块长度交换一致性与反馈速度
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个教学例子 → 二、以观测为条件联合去噪一段动作
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:不要把两条正确路线平均成一条错误路线 → 二、以观测为条件联合去噪一段动作
把问题与答案拆开,按推理到检验展开
- 二、研究背景:动作分布与时间一致性是两个问题 → 一、问题设定:怎样保留多条路线又避免逐步左右摇摆
读者在接触方法前知道优化对象与信息权限
- 三、方法:把动作段当作去噪对象 → 三、用加噪动作训练去噪器并执行短前缀
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 二、以观测为条件联合去噪一段动作:展开噪声均值与带噪条件分数之间的中间推导
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Imitation Learning
Visuomotor policies; output/action decoders; Denoising Diffusion models; Diffusion Policy; state/output-feedback examples
原论文校准:重新读作者项目页、原稿式8及其前向高斯核;新增是教学代数推演,无新增实验成绩
课程作为教法来源,不当作原论文额外实验;原数值、图块与题答保留。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion,图5:纵轴是相对每任务最佳表现的成功率差值;左侧改动作执行时域,右侧改延迟。读零点和负差值,不要误当绝对成功率。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
纵轴是相对每任务最佳表现的成功率差值;左侧改动作执行时域,右侧改延迟。读零点和负差值,不要误当绝对成功率。
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion,图3:同一初始状态下,蓝色末端可从物块左右两侧绕行;扩散策略保留两种模式并在单次轨迹内保持一致。各基线的偏向或反复切换须从整条轨迹判断,而非只看动作终点。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
同一初始状态下,蓝色末端可从物块左右两侧绕行;扩散策略保留两种模式并在单次轨迹内保持一致。各基线的偏向或反复切换须从整条轨迹判断,而非只看动作终点。
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion,图6:左图是真实PushT图像策略的训练动作预测MSE,右图是模拟PushT状态策略的评估成功率;蓝线为扩散策略,灰线为IBC。两图共同检查稳定性,但横跨不同设置,不能把左侧误差直接换算为右侧成功率。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
左图是真实PushT图像策略的训练动作预测MSE,右图是模拟PushT状态策略的评估成功率;蓝线为扩散策略,灰线为IBC。两图共同检查稳定性,但横跨不同设置,不能把左侧误差直接换算为右侧成功率。
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion,图8:闭环优点和真实边界。 执行段太长会降低反应能力;图8的手遮挡、挪动T块属于单独扰动展示,不是表6全部20次都带这些扰动。扩展版双臂任务:打蛋器210示范、20次成功55%;垫子162示范、成功75%;叠衣284示范、成功75%。这些比单臂95%更能体现复杂接触与恢复的难度,不能用最好任务代表整套能力。
实验/结果图 · 必要原图摘引 · HTML S6.F8,图8
闭环优点和真实边界。 执行段太长会降低反应能力;图8的手遮挡、挪动T块属于单独扰动展示,不是表6全部20次都带这些扰动。扩展版双臂任务:打蛋器210示范、20次成功55%;垫子162示范、成功75%;叠衣284示范、成功75%。这些比单臂95%更能体现复杂接触与恢复的难度,不能用最好任务代表整套能力。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用075-dp3.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将9处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 9 个原文证据入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S6.F8
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T2
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S5.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 S5.T4
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 S6.T6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 两步动作联合/边缘分布反例
- 区分块内相关性与跨块模式切换
- 明确IBC/ACT/DP3三类关系
- v2:用075-dp3.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将9处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
动作段时序一致性、执行时域消融及视觉条件设计。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。纵轴是相对每任务最佳表现的成功率差值;左侧改动作执行时域,右侧改延迟。读零点和负差值,不要误当绝对成功率。
技术关系
- 075-dp3 · 直接继承
后作继承动作扩散并用紧凑三维点云条件。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:低成本双臂示范怎样支撑精细连续操作
- 二、用动作块、潜在风格与时间集成组织预测
- 三、采集主臂目标并用重叠动作预测形成命令
- 四、按任务核对成功率与全部采集成本
- 五、时间平滑不能创造缺失的恢复示范
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个例子:为什么不能把从臂实际位置当标签 → 二、用动作块、潜在风格与时间集成组织预测
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:低成本双臂硬件,需要配套的数据与策略设计 → 二、用动作块、潜在风格与时间集成组织预测
把问题与答案拆开,按推理到检验展开
- 二、问题定义:关节目标里藏着接触力 → 一、问题设定:低成本双臂示范怎样支撑精细连续操作
读者在接触方法前知道优化对象与信息权限
- 三、方法:动作分块、风格变量和时间集成 → 三、采集主臂目标并用重叠动作预测形成命令
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、时间平滑不能创造缺失的恢复示范:时间集成会不会让突发接触后的新纠正被旧预测稀释?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware,图7:四个子图分别处理动作块长、时间集成、CVAE和遥操作频率。时间集成对不同基线作用不一致,因此不能把某一消融收益推广成无条件规则。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
四个子图分别处理动作块长、时间集成、CVAE和遥操作频率。时间集成对不同基线作用不一致,因此不能把某一消融收益推广成无条件规则。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 用073-mobile-aloha.md的具体机制关系替换或补足承上启下阅读链接
- 补入图7的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S4.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S4.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 A0.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 补旧新冲突时集成动作手算
- 说明潜变量均值不等于输出均值
- 明确Mobile ALOHA继承内容
- v2:用073-mobile-aloha.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图7的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
时间集成旧预测权重、算法1—2及动作分块。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F7的图7图注及相关上下文;其余已定位图表见v2逐篇记录。四个子图分别处理动作块长、时间集成、CVAE和遥操作频率。时间集成对不同基线作用不一致,因此不能把某一消融收益推广成无条件规则。
技术关系
- 073-mobile-aloha · 直接继承
后作扩展ALOHA平台并沿用ACT学习。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习FurnitureBench: Reproducible Real-World Benchmark for Long-Horizon Complex Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:真实装配怎样获得可重复的起点与评分
- 二、把硬件、复位与阶段协议作为测量流程
- 三、固定真实零件、初始化与评估记录
- 四、将阶段推进与完整装配成功分开
- 五、接触误差和跨环境差异仍需记录
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个小例子与前置知识 → 二、把硬件、复位与阶段协议作为测量流程
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、把硬件、复位与阶段协议作为测量流程
把问题与答案拆开,按推理到检验展开
- 二、问题定义:装好一个零件比完成一个阶段更严格 → 一、问题设定:真实装配怎样获得可重复的起点与评分
读者在接触方法前知道优化对象与信息权限
- 三、方法:把实验协议看成一个有输入输出的算法 → 三、固定真实零件、初始化与评估记录
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、接触误差和跨环境差异仍需记录:成功阶段数增加时,怎样判断最后一个困难阶段是否仍完全没进步?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- FurnitureBench: Reproducible Real-World Benchmark for Long-Horizon Complex Manipulation,图9:纵轴是完成的阶段数,误差条是十次回合中的最小/最大值;背景颜色标记部件装配阶段。只有达到图中最高阶段才对应全任务完成。
实验/结果图 · 必要原图摘引 · HTML S6.F9,图9
纵轴是完成的阶段数,误差条是十次回合中的最小/最大值;背景颜色标记部件装配阶段。只有达到图中最高阶段才对应全任务完成。
- FurnitureBench: Reproducible Real-World Benchmark for Long-Horizon Complex Manipulation,图4:图4 与附录 C-A,环境能否重建。 新环境平均达到原环境阶段表现的 84%。这不是 84% 的完整装配成功率。它支持搭建协议具有一定可重复性,同时保留了环境变化带来的性能损失;预装软件和现成零件也意味着“三小时搭建”不能当成从采购到部署的总成本。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
图4 与附录 C-A,环境能否重建。 新环境平均达到原环境阶段表现的 84%。这不是 84% 的完整装配成功率。它支持搭建协议具有一定可重复性,同时保留了环境变化带来的性能损失;预装软件和现成零件也意味着“三小时搭建”不能当成从采购到部署的总成本。
- FurnitureBench: Reproducible Real-World Benchmark for Long-Horizon Complex Manipulation,图7:图7、图10,仿真是否可作筛选。 作者观察到部分算法和数据规模趋势相关。这支持把仿真作为早期筛选工具,不证明两个环境的数值可互换,更不证明从仿真直接部署。局部排序一致也不保证新算法的排序仍一致。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
图7、图10,仿真是否可作筛选。 作者观察到部分算法和数据规模趋势相关。这支持把仿真作为早期筛选工具,不证明两个环境的数值可互换,更不证明从仿真直接部署。局部排序一致也不保证新算法的排序仍一致。
- FurnitureBench: Reproducible Real-World Benchmark for Long-Horizon Complex Manipulation,图10:图7、图10,仿真是否可作筛选。 作者观察到部分算法和数据规模趋势相关。这支持把仿真作为早期筛选工具,不证明两个环境的数值可互换,更不证明从仿真直接部署。局部排序一致也不保证新算法的排序仍一致。
实验/结果图 · 必要原图摘引 · HTML S6.F10,图10
图7、图10,仿真是否可作筛选。 作者观察到部分算法和数据规模趋势相关。这支持把仿真作为早期筛选工具,不证明两个环境的数值可互换,更不证明从仿真直接部署。局部排序一致也不保证新算法的排序仍一致。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用047-iql.md的具体机制关系替换或补足承上启下阅读链接
- 补入图9的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图10 · HTML 图10,实际锚点 S6.F10
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S6.F9
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S4.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S6.T3
原站图表/证明入口
- 表IV · HTML 表IV,实际锚点 S6.T4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 加入高阶段分零整机成功反例
- 核实插入瓶颈和初态口径
- 区分真机基准与所用学习器贡献
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用047-iql.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图9的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
桌腿分阶段结果、训练随机性和高随机性固定评估姿态。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F9的图9图注及相关上下文;其余已定位图表见v2逐篇记录。纵轴是完成的阶段数,误差条是十次回合中的最小/最大值;背景颜色标记部件装配阶段。只有达到图中最高阶段才对应全任务完成。
技术关系
- 047-iql · 模块组合
基准使用IQL并比较数据/视觉条件。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习VoxPoser: Composable 3D Value Maps for Robotic Manipulation with Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:语言里的目标、障碍和速度怎样变成轨迹
- 二、用可组合空间地图连接感知与规划
- 三、缓存空间程序并随新观测重建地图
- 四、分开空间约束能力与低层模型贡献
- 五、地图正确仍依赖对象定位和动力学接口
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个小例子与五个前置概念 → 二、用可组合空间地图连接感知与规划
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、用可组合空间地图连接感知与规划
把问题与答案拆开,按推理到检验展开
- 二、从语言计划到物理动作,中间缺少什么 → 一、问题设定:语言里的目标、障碍和速度怎样变成轨迹
读者在接触方法前知道优化对象与信息权限
- 三、核心机制:语言输出目标,规划器求解动作 → 三、缓存空间程序并随新观测重建地图
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、地图正确仍依赖对象定位和动力学接口:多个地图提出互相冲突的要求时,高分轨迹还能代表任务完成吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- VoxPoser: Composable 3D Value Maps for Robotic Manipulation with Language Models,图4:按错误类别拆分系统失败,观察任务规格错误与其他执行错误是否同步下降。语言程序更准确不保证感知、规划与底层动作的错误也一并消失。
实验/结果图 · 必要原图摘引 · HTML S4.F4.fig2,图4
按错误类别拆分系统失败,观察任务规格错误与其他执行错误是否同步下降。语言程序更准确不保证感知、规划与底层动作的错误也一并消失。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用051-saycan.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4.fig2
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 软地图与硬约束反例
- 区分末端避障与全臂扫掠安全
- 厘清地图value与学习价值的语义
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用051-saycan.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
Motion Planner末端搜索与归一化地图2:1权重。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4.fig2的图4图注及相关上下文;其余已定位图表见v2逐篇记录。按错误类别拆分系统失败,观察任务规格错误与其他执行错误是否同步下降。语言程序更准确不保证感知、规划与底层动作的错误也一并消失。
技术关系
- 051-saycan · 平行方法
语言构造空间地图与枚举技能可行性评分不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:视觉语言知识怎样进入机器人动作输出
- 二、把动作token与视觉语言任务联合训练
- 三、联合训练视觉语言样本与离散动作序列
- 四、区分新语义选择和新运动技能证据
- 五、模型规模与示范动作支持共同限能力
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个例子辨认“迁移了什么” → 二、把动作token与视觉语言任务联合训练
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、把动作token与视觉语言任务联合训练
把问题与答案拆开,按推理到检验展开
- 二、问题定义:这里的动作确实进入模型输出 → 一、问题设定:视觉语言知识怎样进入机器人动作输出
读者在接触方法前知道优化对象与信息权限
- 三、方法:把动作当作另一种输出语言 → 三、联合训练视觉语言样本与离散动作序列
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、模型规模与示范动作支持共同限能力:动作token预测更准确,为什么毫米级物理误差未必同比下降?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control,图4:分别看已见任务、新物体、新背景和新环境,不能把一个类别的泛化成绩复制到另一个类别。各柱的详细条件和次数要与附录结果表对应。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
分别看已见任务、新物体、新背景和新环境,不能把一个类别的泛化成绩复制到另一个类别。各柱的详细条件和次数要与附录结果表对应。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用060-palm-e.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 A8.T6
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 A8.T7
原站图表/证明入口
- 表8 · HTML 表8,实际锚点 A8.T8
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 合法token不等于物理可行动作例
- 区分混合采样比例与数据体积
- 限定跨骨干参数归因
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用060-palm-e.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
Co-Fine-Tuning和不同骨干训练混合/预算。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。分别看已见任务、新物体、新背景和新环境,不能把一个类别的泛化成绩复制到另一个类别。各柱的详细条件和次数要与附录结果表对应。
技术关系
- 060-palm-e · 模块组合
RT-2一个变体使用PaLM-E预训练骨干并改为动作输出。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习BridgeData V2: A Dataset for Robot Learning at Scale部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样采集别人能在新场景使用的操作数据
- 二、交叉安排场景、任务和目标表达
- 三、按场景与目标交叉采集并固定下游学习器
- 四、固定学习器检查覆盖带来的泛化
- 五、单本体和采集来源限制可迁移范围
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个小例子与前置知识 → 二、交叉安排场景、任务和目标表达
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、交叉安排场景、任务和目标表达
把问题与答案拆开,按推理到检验展开
- 二、任务、技能和环境不是同一个计数单位 → 一、问题设定:怎样采集别人能在新场景使用的操作数据
读者在接触方法前知道优化对象与信息权限
- 三、方法思想:数据协议改变了模型能学到什么 → 三、按场景与目标交叉采集并固定下游学习器
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、单本体和采集来源限制可迁移范围:如果每个目标只在一个场景出现,为什么语言接口可能形同虚设?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- BridgeData V2: A Dataset for Robot Learning at Scale,图5:所选两幅曲线分别改变模型容量和数据量;原图右侧近似等量数据下技能多样性的结果表见原文。后者更直接检验多技能共训的收益,仍须注意物体与场景可能同时改变。
实验/结果图 · 必要原图摘引 · HTML S5.F5,图5,左侧容量与数据规模曲线
所选两幅曲线分别改变模型容量和数据量;原图右侧近似等量数据下技能多样性的结果表见原文。后者更直接检验多技能共训的收益,仍须注意物体与场景可能同时改变。
- BridgeData V2: A Dataset for Robot Learning at Scale,图5:左侧分别改变图像编码器容量与训练数据占比;右侧在近似等量轨迹下将技能数从3增至13,成功率为0.30和0.65。两类对照的自变量不同,右侧仅用20次试验,不能把这两个值当连续规模曲线。
实验/结果图 · 必要原图摘引 · PDF第8页,图5
左侧分别改变图像编码器容量与训练数据占比;右侧在近似等量轨迹下将技能数从3增至13,成功率为0.30和0.65。两类对照的自变量不同,右侧仅用20次试验,不能把这两个值当连续规模曲线。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用068-openx.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图5 · HTML 图5,实际锚点 S5.F5
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S5.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 S5.T4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 连续采集相关性的100轨迹反例
- 区分图像目标与语言的信息预算
- 连接OXE组成与DROID平行协议
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用068-openx.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
不强制复位、多任务场景及事后标注采集设计。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。左侧改变容量和数据规模,右侧在近似等量数据下改变技能多样性。只有右侧更直接检验多技能共训的收益,仍须注意物体与场景可能同时改变。
技术关系
- 068-openx · 模块组合
Bridge数据作为跨本体训练数据源。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Extreme Parkour with Legged Robots部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:窄平台前怎样同时选方向与落脚动作
- 二、用方向奖励和双重蒸馏训练视觉学生
- 三、先训练特权越障教师,再蒸馏地形和方向
- 四、把仿真进度与真实边缘落脚分开判断
- 五、深度频率和教师权限限制视觉闭环
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构例子与前置概念 → 二、用方向奖励和双重蒸馏训练视觉学生
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、用方向奖励和双重蒸馏训练视觉学生
把问题与答案拆开,按推理到检验展开
- 二、为什么普通速度跟踪不够 → 一、问题设定:窄平台前怎样同时选方向与落脚动作
读者在接触方法前知道优化对象与信息权限
- 三、方法的三个核心变化 → 三、先训练特权越障教师,再蒸馏地形和方向
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、深度频率和教师权限限制视觉闭环:同样的落脚误差,为什么发生在平台中央与边缘应分开统计?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Extreme Parkour with Legged Robots,图7:每种地形只做五次试验,比较完整系统、人工方向输入和去掉边缘惩罚的版本。一次成败会明显改变百分比,不能据此给出高精度可靠性估计。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
每种地形只做五次试验,比较完整系统、人工方向输入和去掉边缘惩罚的版本。一次成败会明显改变百分比,不能据此给出高精度可靠性估计。
- Extreme Parkour with Legged Robots,图4:具体运动能力。 论文展示约 0.5 米高台和 0.8 米缝隙。身体尺寸的倍率比较便于直观理解,但不同机器人关节长度、质量和驱动能力不同,不能把比例直接当作严格算法排行榜。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
具体运动能力。 论文展示约 0.5 米高台和 0.8 米缝隙。身体尺寸的倍率比较便于直观理解,但不同机器人关节长度、质量和驱动能力不同,不能把比例直接当作严格算法排行榜。
- Extreme Parkour with Legged Robots,图5:具体运动能力。 论文展示约 0.5 米高台和 0.8 米缝隙。身体尺寸的倍率比较便于直观理解,但不同机器人关节长度、质量和驱动能力不同,不能把比例直接当作严格算法排行榜。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
具体运动能力。 论文展示约 0.5 米高台和 0.8 米缝隙。身体尺寸的倍率比较便于直观理解,但不同机器人关节长度、质量和驱动能力不同,不能把比例直接当作严格算法排行榜。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用042-rma.md的具体机制关系替换或补足承上启下阅读链接
- 补入图7的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 落脚误差余量教学不等式
- 结合去边缘惩罚解释迁移
- 区分教师动作误差与学生通过率
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用042-rma.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图7的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
NoClear边缘消融、两阶段视觉/航向蒸馏。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F7的图7图注及相关上下文;其余已定位图表见v2逐篇记录。每种地形只做五次试验,比较完整系统、人工方向输入和去掉边缘惩罚的版本。一次成败会明显改变百分比,不能据此给出高精度可靠性估计。
技术关系
- 042-rma · 历史背景
沿适应控制问题发展并使用ROA等中间工作,非原样RMA。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Open X-Embodiment: Robotic Learning Datasets and RT-X Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不同机器人的经验怎样共享而不混淆动作
- 二、统一数据容器并明确每个身体的动作接口
- 三、对齐数据读取与动作语义后选择训练混合
- 四、逐域检查正迁移和负迁移
- 五、模型容量与混合权重影响谁受益
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个自构例子 → 二、统一数据容器并明确每个身体的动作接口
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、统一数据容器并明确每个身体的动作接口
把问题与答案拆开,按推理到检验展开
- 二、跨机器人学习有三种不同问题 → 一、问题设定:不同机器人的经验怎样共享而不混淆动作
读者在接触方法前知道优化对象与信息权限
- 三、方法:统一容器不等于统一物理意义 → 三、对齐数据读取与动作语义后选择训练混合
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 三、对齐数据读取与动作语义后选择训练混合:把发布集合、实际模型混合和逐域测试分为三个可审查对象
教法来源与实际阅读范围
- Open X-Embodiment Collaboration · Open X-Embodiment: Robotic Learning Datasets and RT-X Models
Dataset description; RT-1-X in-distribution domains; RT-2-X emergent skills
- Quan Vuong and Pannag Sanketi · Scaling up learning across many different robot types
Open X-Embodiment Dataset; RT-X; Emergent skills
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文 · 原文 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models,图3:每组标出真实评估地点与机器人形态,RT-1与RT-1-X共享架构。应在对应本体内看混合数据收益,而不是假定完全未见的机器人也能直接执行。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
每组标出真实评估地点与机器人形态,RT-1与RT-1-X共享架构。应在对应本体内看混合数据收益,而不是假定完全未见的机器人也能直接执行。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用080-octo.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S4.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S5.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 粗动作对齐的不可辨识性反例
- 核实全数据与实验子集区别
- 将采样权重和接口纳入跨本体归因
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用080-octo.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
§IV-A粗对齐及坐标/控制语义未统一、§IV-C实际子集。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。每组标出真实评估地点与机器人形态,RT-1与RT-1-X共享架构。应在对应本体内看混合数据收益,而不是假定完全未见的机器人也能直接执行。
技术关系
- 080-octo · 模块组合
Octo使用选定OXE数据混合预训练。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Eureka: Human-Level Reward Design via Coding Large Language Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样搜索能帮助训练但不扭曲任务的奖励
- 二、外层改写奖励程序,内层训练并独立评分
- 三、生成候选奖励并用独立任务评分筛选
- 四、区分累计最佳与反思反馈的实际收益
- 五、外部评价和候选训练仍需人类定义
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个教学例子与前置概念 → 二、外层改写奖励程序,内层训练并独立评分
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、外层改写奖励程序,内层训练并独立评分
把问题与答案拆开,按推理到检验展开
- 二、为什么有奖励,还要另一个评分函数 → 一、问题设定:怎样搜索能帮助训练但不扭曲任务的奖励
读者在接触方法前知道优化对象与信息权限
- 三、方法:外层写奖励,内层学策略 → 三、生成候选奖励并用独立任务评分筛选
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、外部评价和候选训练仍需人类定义:奖励程序编译并运行成功,为什么仍需要检查量纲和数值尺度?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Eureka: Human-Level Reward Design via Coding Large Language Models,图5:沿迭代轮数看奖励搜索的改进,再对照相同候选预算的无反思方案。累积最好值天然不会下降,曲线上升本身并不能单独证明反思机制有效。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
沿迭代轮数看奖励搜索的改进,再对照相同候选预算的无反思方案。累积最好值天然不会下降,曲线上升本身并不能单独证明反思机制有效。
- Eureka: Human-Level Reward Design via Coding Large Language Models,图4:总体奖励质量。 作者报告在大部分任务上超过人工奖励。这里比较的是奖励训练所得策略的任务指标,不是人工评审“代码质量”。灵巧任务仍有未超过人工的例外,不能将总体结论写成全任务胜出。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
总体奖励质量。 作者报告在大部分任务上超过人工奖励。这里比较的是奖励训练所得策略的任务指标,不是人工评审“代码质量”。灵巧任务仍有未超过人工的例外,不能将总体结论写成全任务胜出。
- Eureka: Human-Level Reward Design via Coding Large Language Models,图6:与人工奖励的相关性。 某些有效奖励与人工奖励相关较弱甚至为负。它说明沿采样状态轨迹的打分方式不同;不能单凭相关性证明发现了新的理论原理,也不能证明没有共享基本距离或姿态概念。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
与人工奖励的相关性。 某些有效奖励与人工奖励相关较弱甚至为负。它说明沿采样状态轨迹的打分方式不同;不能单凭相关性证明发现了新的理论原理,也不能证明没有共享基本距离或姿态概念。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用002-apprenticeship.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 加入候选最大值选择偏差
- 区分搜索最高分与独立重训
- 说明外层评分和内层回报不能互换
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用002-apprenticeship.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
RDP外层fitness与reward reflection的训练器依赖。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。沿迭代轮数看奖励搜索的改进,再对照相同候选预算的无反思方案。累积最好值天然不会下降,曲线上升本身并不能单独证明反思机制有效。
技术关系
- 002-apprenticeship · 平行方法
程序搜索奖励与示范约束奖励是不同信息来源。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习TD-MPC2: Scalable, Robust World Models for Continuous Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:短规划世界模型怎样扩展到多任务尺度
- 二、稳定潜表示、奖励价值与规划先验
- 三、联合更新多任务潜模型并在有效动作维度规划
- 四、分开单任务效率与多任务规模结果
- 五、掩码和任务定义限制共享模型外推
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构小例子与前置概念 → 二、稳定潜表示、奖励价值与规划先验
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、稳定潜表示、奖励价值与规划先验
把问题与答案拆开,按推理到检验展开
- 二、它继承了 TD-MPC 的什么思想 → 一、问题设定:短规划世界模型怎样扩展到多任务尺度
读者在接触方法前知道优化对象与信息权限
- 三、方法变化与公式直觉 → 三、联合更新多任务潜模型并在有效动作维度规划
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、掩码和任务定义限制共享模型外推:统一多任务动作维度后,为什么补零也需要进入评价审查?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:6 幅
- TD-MPC2: Scalable, Robust World Models for Continuous Control,图7:左侧是模型规模与多任务归一化分数,右侧是任务嵌入的t-SNE可视化。嵌入靠近只提供表示结构线索,不是任务之间因果迁移的证明。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
左侧是模型规模与多任务归一化分数,右侧是任务嵌入的t-SNE可视化。嵌入靠近只提供表示结构线索,不是任务之间因果迁移的证明。
- TD-MPC2: Scalable, Robust World Models for Continuous Control,图4:单任务连续控制。 聚合和困难任务显示较强表现,但聚合领先不等于每个任务、每个阶段都领先。附录保留了某些基线更早成功的例子;视觉任务上作者使用的是相当而非全面压倒的结论。
实验/结果图 · 必要原图摘引 · HTML S3.F4,图4
单任务连续控制。 聚合和困难任务显示较强表现,但聚合领先不等于每个任务、每个阶段都领先。附录保留了某些基线更早成功的例子;视觉任务上作者使用的是相当而非全面压倒的结论。
- TD-MPC2: Scalable, Robust World Models for Continuous Control,图5:单任务连续控制。 聚合和困难任务显示较强表现,但聚合领先不等于每个任务、每个阶段都领先。附录保留了某些基线更早成功的例子;视觉任务上作者使用的是相当而非全面压倒的结论。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
单任务连续控制。 聚合和困难任务显示较强表现,但聚合领先不等于每个任务、每个阶段都领先。附录保留了某些基线更早成功的例子;视觉任务上作者使用的是相当而非全面压倒的结论。
- TD-MPC2: Scalable, Robust World Models for Continuous Control,图6:单任务连续控制。 聚合和困难任务显示较强表现,但聚合领先不等于每个任务、每个阶段都领先。附录保留了某些基线更早成功的例子;视觉任务上作者使用的是相当而非全面压倒的结论。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
单任务连续控制。 聚合和困难任务显示较强表现,但聚合领先不等于每个任务、每个阶段都领先。附录保留了某些基线更早成功的例子;视觉任务上作者使用的是相当而非全面压倒的结论。
- TD-MPC2: Scalable, Robust World Models for Continuous Control,图8:新任务适应。 预训练后在低交互预算下优于从零训练,但仍需要新任务环境交互。任务嵌入从语义相似任务初始化,这包含人工选择,不能称为无任务知识的零样本泛化。
实验/结果图 · 必要原图摘引 · HTML S4.F8,图8
新任务适应。 预训练后在低交互预算下优于从零训练,但仍需要新任务环境交互。任务嵌入从语义相似任务初始化,这包含人工选择,不能称为无任务知识的零样本泛化。
- TD-MPC2: Scalable, Robust World Models for Continuous Control,图9:稳定性机制。 消融支持多个组件共同起作用。梯度图为清晰仅展示每任务一个种子,能显示现象,不能单靠这些曲线估计罕见发散概率。
实验/结果图 · 必要原图摘引 · HTML S4.F9,图9
稳定性机制。 消融支持多个组件共同起作用。梯度图为清晰仅展示每任务一个种子,能显示现象,不能单靠这些曲线估计罕见发散概率。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用049-tdmpc.md的具体机制关系替换或补足承上启下阅读链接
- 补入图7的可打开原图及专属图例/坐标/比较条件解读
- 将8处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 8 个原文证据入口
- 图4 · HTML 图4,实际锚点 S3.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S4.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S4.F9
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表10 · HTML 表10,实际锚点 A10.T10.fig1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;用于辅助解释的官方策略代码没有锁定原实验历史提交;当前代码新增功能不能倒推成论文已测试的组成部分。
本次深化
- 推导softmax温度梯度及边界
- 说明无效动作熵的漏洞
- 明确规模组件与前作继承
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用049-tdmpc.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图7的可打开原图及专属图例/坐标/比较条件解读
- v2:将8处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
SimNorm定义/附录温度讨论与多任务设计。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F7的图7图注及相关上下文;其余已定位图表见v2逐篇记录。左侧是模型规模与多任务归一化分数,右侧是任务嵌入的t-SNE可视化。嵌入靠近只提供表示结构线索,不是任务之间因果迁移的证明。
技术关系
- 049-tdmpc · 直接继承
直接扩展TD-MPC潜模型和在线规划。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 用于辅助解释的官方策略代码没有锁定原实验历史提交;当前代码新增功能不能倒推成论文已测试的组成部分。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:少量示范怎样变成覆盖新摆放的真实执行数据
- 二、按子任务对象变换轨迹并重新验收
- 三、变换对象中心片段并实际执行生成候选
- 四、分别统计生成尝试、保留轨迹和策略成绩
- 五、成功筛选可能丢掉困难状态与过程质量
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用小例子检验理解 → 二、按子任务对象变换轨迹并重新验收
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:示范不必从头再录 → 二、按子任务对象变换轨迹并重新验收
把问题与答案拆开,按推理到检验展开
- 二、背景与问题定义 → 一、问题设定:少量示范怎样变成覆盖新摆放的真实执行数据
读者在接触方法前知道优化对象与信息权限
- 三、方法:重新执行,而非只移动图片 → 三、变换对象中心片段并实际执行生成候选
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、成功筛选可能丢掉困难状态与过程质量:只按最终成功保留轨迹,会不会把不必要碰撞也教给策略?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations,图4:所选上图改变源示范数量,下图比较策略训练数据来源;逐任务源示范与生成示范结果表见原文。分开这三组变量,才能避免把生成更多与人工示范更多混为一谈。
实验/结果图 · 必要原图摘引 · HTML S6.F4,图4,右侧源示范数量与策略训练数据消融
所选上图改变源示范数量,下图比较策略训练数据来源;逐任务源示范与生成示范结果表见原文。分开这三组变量,才能避免把生成更多与人工示范更多混为一谈。
- MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations,图4:左表给出源示范与生成数据在各任务及D0/D1/D2分布的成功率;右上改变生成时的源示范数量,右下比较策略训练数据来源。源示范增加并非各任务单调改善,不能把三种数据量对照合成同一条趋势。
实验/结果图 · 必要原图摘引 · PDF第6页,图4
左表给出源示范与生成数据在各任务及D0/D1/D2分布的成功率;右上改变生成时的源示范数量,右下比较策略训练数据来源。源示范增加并非各任务单调改善,不能把三种数据量对照合成同一条趋势。
- MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations,图6:这些设置见 §5、附录 N/O。真实 Stack 的生成量在 §6.4 写200条,图6说明与附录部分概括写100条;正文采用 §6.4 明确列出的200条,并保留这个口径差异。
实验/结果图 · 必要原图摘引 · HTML S6.F6,图6
这些设置见 §5、附录 N/O。真实 Stack 的生成量在 §6.4 写200条,图6说明与附录部分概括写100条;正文采用 §6.4 明确列出的200条,并保留这个口径差异。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用088-dexmimicgen.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图4 · HTML 图4,实际锚点 S6.F4
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S6.F6
原站图表/证明入口
- 表N.1 · HTML 表N.1,实际锚点 A14.T1
原站图表/证明入口
- 表Q.1 · HTML 表Q.1,实际锚点 A17.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;位姿函数链接指向官方当前代码,未锁定论文历史提交;它可帮助检查代数方向,但不能证明历史实验的每个实现细节。
本次深化
- 推导成功筛选后的初态分布
- 用两区域说明覆盖偏差
- 关联生成率与学习成绩的不同含义
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用088-dexmimicgen.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
成功轨迹筛选、生成成功率与策略成绩差异、真机插值讨论。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。左侧比较源示范和生成示范,右上改源示范数量,右下比较策略训练数据来源。分开这三组变量,才能避免把生成更多与人工示范更多混为一谈。
技术关系
- 088-dexmimicgen · 直接继承
后作扩展对象中心示范生成到双臂灵巧操作。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 位姿函数链接指向官方当前代码,未锁定论文历史提交;它可帮助检查代数方向,但不能证明历史实验的每个实现细节。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未来画面预测怎样帮助机器人动作学习
- 二、共享序列骨干学习视觉未来与动作
- 三、先预测人类视频,再联合训练机器人动作
- 四、用CALVIN任务链和真机对照检查迁移
- 五、预测视频不等于可供任意反事实规划
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构小例子与知识连接 → 二、共享序列骨干学习视觉未来与动作
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:先学“接下来会看到什么” → 二、共享序列骨干学习视觉未来与动作
把问题与答案拆开,按推理到检验展开
- 二、问题背景:视觉表征之外,还要学习时间 → 一、问题设定:未来画面预测怎样帮助机器人动作学习
读者在接触方法前知道优化对象与信息权限
- 三、方法:共享骨干,两种预测 → 三、先预测人类视频,再联合训练机器人动作
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、预测视频不等于可供任意反事实规划:如果未来图像分支关闭后动作仍不变,能否说明视频预训练没用?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Unleashing Large-Scale Video Generative Pre-training for Visual Robot Manipulation,图6:绿框是真实未来图像,蓝框是预测图像。逐帧比较对象运动可以检查辅助预测学到什么,但清晰预测并不自动证明动作输出依赖这些动态。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
绿框是真实未来图像,蓝框是预测图像。逐帧比较对象运动可以检查辅助预测学到什么,但清晰预测并不自动证明动作输出依赖这些动态。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用058-uni-pi.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 A1.T4
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 A1.T5
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 A1.T7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导辅助损失梯度对动作损失的作用
- 构造梯度冲突手算
- 纠正生成视频直接驱动动作的误读
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用058-uni-pi.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
查询掩码、冻结视觉文本编码器、共享视频/动作训练目标。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F6的图6图注及相关上下文;其余已定位图表见v2逐篇记录。绿框是真实未来图像,蓝框是预测图像。逐帧比较对象运动可以检查辅助预测学到什么,但清晰预测并不自动证明动作输出依赖这些动态。
技术关系
- 058-uni-pi · 平行方法
共享骨干辅助预测与视频后接逆动力学控制不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:底盘运动怎样与双臂接触同步学习
- 二、采集全身动作并联合静态示范训练
- 三、同步记录底盘与双臂并用混合数据训练
- 四、分开单任务自主评估与遥操作展示
- 五、时延和工作区限制全身示范复用
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构例子与前置概念 → 二、采集全身动作并联合静态示范训练
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:移动不是给桌面策略加两个按钮 → 二、采集全身动作并联合静态示范训练
把问题与答案拆开,按推理到检验展开
- 二、背景:全身协调的困难在哪里 → 一、问题设定:底盘运动怎样与双臂接触同步学习
读者在接触方法前知道优化对象与信息权限
- 三、方法:硬件、混合数据和延迟补偿 → 三、同步记录底盘与双臂并用混合数据训练
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、时延和工作区限制全身示范复用:底盘和手臂时延不同,为什么只对整段动作统一平移可能不够?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation,图3:横向比较移动任务示范预算下的协同训练与仅移动数据训练;静态辅助数据仍是额外监督。数据效率指新增目标数据,不是总数据成本为零。
实验/结果图 · 必要原图摘引 · HTML S6.F3,图3
横向比较移动任务示范预算下的协同训练与仅移动数据训练;静态辅助数据仍是额外监督。数据效率指新增目标数据,不是总数据成本为零。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用062-act.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图3 · HTML 图3,实际锚点 S6.F3
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S6.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 写出五步块两步延迟的实际执行索引
- 解释变延迟与重规划折中
- 核实补偿和视觉闭环作用不同
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用062-act.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
底盘延迟d与动作块k的配对规则、开环复播误差。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。横向比较移动任务示范预算下的协同训练与仅移动数据训练;静态辅助数据仍是额外监督。数据效率指新增目标数据,不是总数据成本为零。
技术关系
- 062-act · 直接继承
扩展ALOHA硬件与ACT动作块到移动双臂。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习SERL: A Software Suite for Sample-Efficient Robotic Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:真实接触任务怎样形成持续学习闭环
- 二、接通奖励分类、复位与异步离策略学习
- 三、让奖励、复位、接触控制和学习器协同运行
- 四、按任务核对训练时间和准备条件
- 五、奖励误判与复位失败会改变数据分布
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构小例子与前置概念 → 二、接通奖励分类、复位与异步离策略学习
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让“一个RL公式”变成能训练机械臂的系统 → 二、接通奖励分类、复位与异步离策略学习
把问题与答案拆开,按推理到检验展开
- 二、背景:真实环境没有廉价 reset() → 一、问题设定:真实接触任务怎样形成持续学习闭环
读者在接触方法前知道优化对象与信息权限
- 三、方法:五个环节要一起理解 → 三、让奖励、复位、接触控制和学习器协同运行
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、奖励误判与复位失败会改变数据分布:自动复位偶尔失败时,怎样避免把下一回合的异常归因于学习算法?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- SERL: A Software Suite for Sample-Efficient Robotic Reinforcement Learning,图3:橙色为RL原目标、红色为平滑目标、蓝色为受限目标、绿色为实际位置。接触段和自由运动段一起看,才能理解逐毫秒限参考与简单缩小动作的区别。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
橙色为RL原目标、红色为平滑目标、蓝色为受限目标、绿色为实际位置。接触段和自由运动段一起看,才能理解逐毫秒限参考与简单缩小动作的区别。
- SERL: A Software Suite for Sample-Efficient Robotic Reinforcement Learning,图6:图6直接对比三个真机任务中的RL和行为克隆成功率。每个任务评估100次,红色RL柱均达到本次试验的满分;但两种流程看到的数据分布和交互预算不同,这支持整套训练流程有效,不能单独归因于某一个损失函数或保证长期零失败。
实验/结果图 · 必要原图摘引 · HTML S5.F6,图6
图6直接对比三个真机任务中的RL和行为克隆成功率。每个任务评估100次,红色RL柱均达到本次试验的满分;但两种流程看到的数据分布和交互预算不同,这支持整套训练流程有效,不能单独归因于某一个损失函数或保证长期零失败。
- SERL: A Software Suite for Sample-Efficient Robotic Reinforcement Learning,图7:图7的完成速度。 作者报告 RL 成功执行的周期更短。它支持在所测成功轨迹上动作更高效;应同时看失败率和所有尝试总时间,不能仅用成功样本时长评价生产吞吐。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
图7的完成速度。 作者报告 RL 成功执行的周期更短。它支持在所测成功轨迹上动作更高效;应同时看失败率和所有尝试总时间,不能仅用成功样本时长评价生产吞吐。
- SERL: A Software Suite for Sample-Efficient Robotic Reinforcement Learning,图8:图8对应的异地复现。 华盛顿大学搭建插孔任务后,报告19分钟学习、100/100成功、20条初始示范。它是有价值的独立地点证据;一个额外地点不能代替多团队、多硬件、长期维护的普适可用性验证。实验与讨论:§5–6。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
图8对应的异地复现。 华盛顿大学搭建插孔任务后,报告19分钟学习、100/100成功、20条初始示范。它是有价值的独立地点证据;一个额外地点不能代替多团队、多硬件、长期维护的普适可用性验证。实验与讨论:§5–6。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用086-hil-serl.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;复现时仍需核对所选实验的UTD、奖励阈值与终止掩码;软件默认值不能代替各项真机实验的设置证据。
本次深化
- 用单位完整的数值解释双层限幅
- 区分弹簧项与总接触力
- 明确HIL-SERL继承方向
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用086-hil-serl.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
实时参考裁剪、MΔ条件和分层控制频率。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。橙色为RL原目标、红色为平滑目标、蓝色为受限目标、绿色为实际位置。接触段和自由运动段一起看,才能理解逐毫秒限参考与简单缩小动作的区别。
技术关系
- 086-hil-serl · 直接继承
后作基于SERL系统扩展人在环真机学习。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 复现时仍需核对所选实验的UTD、奖励阈值与终止掩码;软件默认值不能代替各项真机实验的设置证据。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习3D Diffusion Policy: Generalizable Visuomotor Policy Learning via Simple 3D Representations部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:少量示范下怎样让动作策略直接利用三维位置
- 二、以紧凑点云特征条件化动作扩散
- 三、裁剪并编码点云,再采样条件动作块
- 四、分开观测表示消融与任务总体平均
- 五、深度标定、裁剪和颜色语义仍有代价
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构例子与前置概念 → 二、以紧凑点云特征条件化动作扩散
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:先把“哪里”交代清楚,再生成动作 → 二、以紧凑点云特征条件化动作扩散
把问题与答案拆开,按推理到检验展开
- 二、背景:这是一篇感知表示论文,也是一篇控制论文 → 一、问题设定:少量示范下怎样让动作策略直接利用三维位置
读者在接触方法前知道优化对象与信息权限
- 三、方法:简单点编码器为什么值得研究 → 三、裁剪并编码点云,再采样条件动作块
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、深度标定、裁剪和颜色语义仍有代价:点云工作区裁剪提高效率时,怎样检查它是否删掉了必要障碍?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- 3D Diffusion Policy: Generalizable Visuomotor Policy Learning via Simple 3D Representations,图5:内嵌图5直接给出12个仿真任务的学习曲线:红线是DP3,蓝线是图像扩散策略,横轴为训练步数,纵轴为成功率。相同任务内看收敛速度和最终水平;这些训练步数不是新增真机交互数,仿真优势也不能直接替代真机安全性验证。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
内嵌图5直接给出12个仿真任务的学习曲线:红线是DP3,蓝线是图像扩散策略,横轴为训练步数,纵轴为成功率。相同任务内看收敛速度和最终水平;这些训练步数不是新增真机交互数,仿真优势也不能直接替代真机安全性验证。
- 3D Diffusion Policy: Generalizable Visuomotor Policy Learning via Simple 3D Representations,图2: 图2,原论文图注与图像。上部区分训练与评估,下部从单视角点云、轻量编码到动作扩散。三维数据是条件输入,去噪输出仍是动作,不是生成新的点云场景。
实验/结果图 · 必要原图摘引 · HTML S2.F2,图2
图2,原论文图注与图像。上部区分训练与评估,下部从单视角点云、轻量编码到动作扩散。三维数据是条件输入,去噪输出仍是动作,不是生成新的点云场景。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图2 · HTML 图2,实际锚点 S2.F2
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S3.T1
原站图表/证明入口
- 表IV · HTML 表IV,实际锚点 S4.T4
原站图表/证明入口
- 表IX · HTML 表IX,实际锚点 S5.T9
原站图表/证明入口
- 表V · HTML 表V,实际锚点 S4.T5
原站图表/证明入口
- 表VII · HTML 表VII,实际锚点 S4.T7
原站图表/证明入口
- 表VIII · HTML 表VIII,实际锚点 S5.T8
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 证明max池化对重复点不敏感
- 解释深度缺失与下采样边界
- 将传感条件纳入RGB/3D比较
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
简化点编码器、点采样、sample prediction及表示消融。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S2.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。上部区分训练与评估,下部从单视角点云、轻量编码到动作扩散。三维数据是条件输入,去噪输出仍是动作,不是生成新的点云场景。
技术关系
- 061-diffusion-policy · 直接继承
保留条件动作扩散并改用紧凑点云表示。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:人类运动怎样变成机器人可跟踪的参考
- 二、分开形体重定向、可行性筛选与部署策略
- 三、先筛选重定向运动,再训练可部署跟踪
- 四、从模拟跟踪逐级核对到真实展示
- 五、筛选器能力不等于身体可行性的全集
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构例子与知识连接 → 二、分开形体重定向、可行性筛选与部署策略
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:人能做,不代表机器人能照搬 → 二、分开形体重定向、可行性筛选与部署策略
把问题与答案拆开,按推理到检验展开
- 二、问题定义:谁在决定任务,谁在维持平衡 → 一、问题设定:人类运动怎样变成机器人可跟踪的参考
读者在接触方法前知道优化对象与信息权限
- 三、方法:把重定向与可执行性分开 → 三、先筛选重定向运动,再训练可部署跟踪
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、筛选器能力不等于身体可行性的全集:筛选掉大量难动作后,平均跟踪误差下降应怎样解释?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:6 幅
- Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,图2:红点标出机器人关键点,绿色点与网格对应人体模型;比较拟合前后关键点关系,才能理解重定向怎样处理身体比例而非直接复制关节角。
方法/设定图 · 必要原图摘引 · HTML S3.F2,图2
红点标出机器人关键点,绿色点与网格对应人体模型;比较拟合前后关键点关系,才能理解重定向怎样处理身体比例而非直接复制关节角。
- Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,图7:图7补上真机受扰序列:沿踢击前、接触、恢复的连续帧看身体是否保持平衡,并区分静止和动态遥操作条件。它提供抗扰行为实例,没有给出可推广到任意冲击强度的成功率统计。
实验/结果图 · 必要原图摘引 · HTML S6.F7,图7
图7补上真机受扰序列:沿踢击前、接触、恢复的连续帧看身体是否保持平衡,并区分静止和动态遥操作条件。它提供抗扰行为实例,没有给出可推广到任意冲击强度的成功率统计。
- Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,图1:图1、5–7的真实遥操作。 展示踢球、行走、后跳以及扰动下保持平衡。它证明系统可在真机运行这些行为,但缺少逐任务大样本成功率时,不能给踢球或接箱等能力编出可靠率。真实物体任务由人提供实时目标,不是机器人自主视觉规划。结果与部署:§VI。
实验/结果图 · 必要原图摘引 · PDF第1页,图1
图1、5–7的真实遥操作。 展示踢球、行走、后跳以及扰动下保持平衡。它证明系统可在真机运行这些行为,但缺少逐任务大样本成功率时,不能给踢球或接箱等能力编出可靠率。真实物体任务由人提供实时目标,不是机器人自主视觉规划。结果与部署:§VI。
- Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,图3:图2/3的形体拟合。 调整人体形状后,重定向减少足部内八等异常。它支持几何对齐的重要性,但主要是例子,不是所有人体体型都适用的统计保证。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
图2/3的形体拟合。 调整人体形状后,重定向减少足部内八等异常。它支持几何对齐的重要性,但主要是例子,不是所有人体体型都适用的统计保证。
- Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,图5:图1、5–7的真实遥操作。 展示踢球、行走、后跳以及扰动下保持平衡。它证明系统可在真机运行这些行为,但缺少逐任务大样本成功率时,不能给踢球或接箱等能力编出可靠率。真实物体任务由人提供实时目标,不是机器人自主视觉规划。结果与部署:§VI。
实验/结果图 · 必要原图摘引 · HTML S6.F5,图5
图1、5–7的真实遥操作。 展示踢球、行走、后跳以及扰动下保持平衡。它证明系统可在真机运行这些行为,但缺少逐任务大样本成功率时,不能给踢球或接箱等能力编出可靠率。真实物体任务由人提供实时目标,不是机器人自主视觉规划。结果与部署:§VI。
- Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,图6:图1、5–7的真实遥操作。 展示踢球、行走、后跳以及扰动下保持平衡。它证明系统可在真机运行这些行为,但缺少逐任务大样本成功率时,不能给踢球或接箱等能力编出可靠率。真实物体任务由人提供实时目标,不是机器人自主视觉规划。结果与部署:§VI。
实验/结果图 · 必要原图摘引 · HTML S6.F6,图6
图1、5–7的真实遥操作。 展示踢球、行走、后跳以及扰动下保持平衡。它证明系统可在真机运行这些行为,但缺少逐任务大样本成功率时,不能给踢球或接箱等能力编出可靠率。真实物体任务由人提供实时目标,不是机器人自主视觉规划。结果与部署:§VI。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用090-asap.md的具体机制关系替换或补足承上启下阅读链接
- 补入图2的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图1 · HTML 图1,实际锚点 S0.F1
原站图表/证明入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S5.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S6.T3
原站图表/证明入口
- 表IV · HTML 表IV,实际锚点 S6.T4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 量化过滤带来的技能频率偏移
- 区分优化失败与物理不可行
- 解释保留集合属于评估协议
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用090-asap.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图2的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
sim-to-data过滤、无域随机化特权策略及机器人部署目标。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F2的图2图注及相关上下文;其余已定位图表见v2逐篇记录。红点标出机器人关键点,绿色点与网格对应人体模型;比较拟合前后关键点关系,才能理解重定向怎样处理身体比例而非直接复制关节角。
技术关系
- 090-asap · 历史背景
后作继续缩小跟踪策略的真实动力学差异。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习DexCap: Scalable and Portable Mocap Data Collection System for Dexterous Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:人类手部采集怎样形成机器人可用的监督
- 二、同步坐标、重定向观察与动作并加入纠正
- 三、同步采集人手运动并重定向到机器人反馈
- 四、区分人类数据收益与机器人纠正收益
- 五、手部接触差异不能只靠几何映射消除
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构例子与前置概念 → 二、同步坐标、重定向观察与动作并加入纠正
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:先让人自然做,再把动作交给机器人 → 二、同步坐标、重定向观察与动作并加入纠正
把问题与答案拆开,按推理到检验展开
- 二、背景:人手视频为什么不足以直接做动作标签 → 一、问题设定:人类手部采集怎样形成机器人可用的监督
读者在接触方法前知道优化对象与信息权限
- 三、方法:数据系统与学习系统各负责哪一段 → 三、同步采集人手运动并重定向到机器人反馈
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、手部接触差异不能只靠几何映射消除:人手和机器人动作坐标对齐了,为什么视觉输入也可能需要处理?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- DexCap: Scalable and Portable Mocap Data Collection System for Dexterous Manipulation,图8:本图比较遮挡下动捕数据与视觉姿态估计的质量,检验的是采集接口。数据更准能帮助学习,但并不直接给出剪纸等下游任务的完整成功率。
实验/结果图 · 必要原图摘引 · HTML S4.F8,图8
本图比较遮挡下动捕数据与视觉姿态估计的质量,检验的是采集接口。数据更准能帮助学习,但并不直接给出剪纸等下游任务的完整成功率。
- DexCap: Scalable and Portable Mocap Data Collection System for Dexterous Manipulation,图9:图8/9的采集质量与吞吐。 论文展示遮挡时动捕优于视觉估计的例子,收球数据采集约比遥操作快三倍。它支持便携系统对这一采集任务的价值;不能把定性画面转成毫米精度证明,也不能把一项吞吐比当所有任务的固定倍数。
实验/结果图 · 必要原图摘引 · HTML S4.F9,图9
图8/9的采集质量与吞吐。 论文展示遮挡时动捕优于视觉估计的例子,收球数据采集约比遥操作快三倍。它支持便携系统对这一采集任务的价值;不能把定性画面转成毫米精度证明,也不能把一项吞吐比当所有任务的固定倍数。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用075-dp3.md的具体机制关系替换或补足承上启下阅读链接
- 补入图8的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图8 · HTML 图8,实际锚点 S4.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S4.F9
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S5.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S5.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S5.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 以速度和时差计算两厘米错配
- 解释外观替换不能修复接触时序
- 分开人手采集与模拟生成成本
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用075-dp3.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图8的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
可穿戴跟踪、点云统一坐标、重定向与纠正数据混合。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F8的图8图注及相关上下文;其余已定位图表见v2逐篇记录。本图比较遮挡下动捕数据与视觉姿态估计的质量,检验的是采集接口。数据更准能帮助学习,但并不直接给出剪纸等下游任务的完整成功率。
技术关系
- 075-dp3 · 平行方法
均使用点云条件动作生成,但数据接口与目标不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样让真实数据多样性超出同一张桌子
- 二、统一硬件接口并分散采集环境
- 三、保存采集层级并用固定扩散策略验证数据
- 四、分别统计发布数据、实际训练混合与迁移测试
- 五、场景多样性仍与任务和操作者相互关联
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、自构小例子与前置概念 → 二、统一硬件接口并分散采集环境
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:数据多,还要知道“多在哪里” → 二、统一硬件接口并分散采集环境
把问题与答案拆开,按推理到检验展开
- 二、背景与定义:任务、场景、轨迹不是同一个计数 → 一、问题设定:怎样让真实数据多样性超出同一张桌子
读者在接触方法前知道优化对象与信息权限
- 三、方法:数据生产本身也有算法结构 → 三、保存采集层级并用固定扩散策略验证数据
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、场景多样性仍与任务和操作者相互关联:如果按帧随机划分训练和测试,为什么可能高估DROID的场景泛化?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:7 幅
- DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset,图9:比较不同场景数的数据子集在分布外任务上的表现。等量子集控制了数量,却未必控制对象、动作和操作者分布,所以场景多样性的因果解释仍需谨慎。
实验/结果图 · 必要原图摘引 · HTML S5.F9,图9
比较不同场景数的数据子集在分布外任务上的表现。等量子集控制了数量,却未必控制对象、动作和操作者分布,所以场景多样性的因果解释仍需谨慎。
- DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset,图2:表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
实验/结果图 · 必要原图摘引 · HTML S3.F2,图2
表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
- DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset,图3:表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
- DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset,图4:表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
- DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset,图5:表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
表I 与图2、图3、图4、图5的数据分析。 动词、场景、视角和交互位置均更丰富。首个夹爪闭合位置只是交互位置代理:推、擦等动作可能不需要闭合,不能把该分布当所有接触的完整覆盖。数据统计证明覆盖增加,尚不直接证明政策能力。
- DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset,图7:图7的目标任务成绩。 图注报告,相对次优方法,正常条件平均提高22个百分点,分布外提高17个百分点。这里是绝对百分点,而不是“相对增长22%”。模型依然用了每个目标场景的示范,所以证据是辅助数据提升适应后的表现。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
图7的目标任务成绩。 图注报告,相对次优方法,正常条件平均提高22个百分点,分布外提高17个百分点。这里是绝对百分点,而不是“相对增长22%”。模型依然用了每个目标场景的示范,所以证据是辅助数据提升适应后的表现。
- DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset,图8:图8的长任务执行。 煮豆展示更连贯的多阶段动作,是与汇总成绩一致的定性证据。任务标准是揭盖、倒豆、开炉,不包含“食物已经煮熟”的检验,因此不能把任务名当完整烹饪认证。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
图8的长任务执行。 煮豆展示更连贯的多阶段动作,是与汇总成绩一致的定性证据。任务标准是揭盖、倒豆、开炉,不包含“食物已经煮熟”的检验,因此不能把任务名当完整烹饪认证。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- 补入图9的可打开原图及专属图例/坐标/比较条件解读
- 将8处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 8 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S5.F9
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S1.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;策略实验采用附录所列实际4万条训练资料;发布的7.6万条资源不能直接替换成这些结果的训练分母。
本次深化
- 推导每样本曝光与总体混合权重
- 区分目标适配与零样本
- 限定DROID/OXE结果的筛选子集
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图9的可打开原图及专属图例/坐标/比较条件解读
- v2:将8处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
固定扩散策略、目标/辅助50:50混合与OXE训练子集。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F9的图9图注及相关上下文;其余已定位图表见v2逐篇记录。比较不同场景数的数据子集在分布外任务上的表现。等量子集控制了数量,却未必控制对象、动作和操作者分布,所以场景多样性的因果解释仍需谨慎。
技术关系
- 061-diffusion-policy · 模块组合
用扩散策略作为固定学习器检验数据来源。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 策略实验采用附录所列实际4万条训练资料;发布的7.6万条资源不能直接替换成这些结果的训练分母。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Humanoid-Gym: Reinforcement Learning for Humanoid Robot with Zero-Shot Sim2Real Transfer部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:人形步态怎样走过模拟器到硬件的接口
- 二、联合相位、历史与部署可用观测训练步态
- 三、把相位步态训练接到跨模拟器与硬件检查
- 四、逐层检查仿真、跨模拟器和真实表现
- 五、跨模拟器通过仍不能替代真实安全验证
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个小例子与五个前置概念 → 二、联合相位、历史与部署可用观测训练步态
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让人形步态走完部署链条 → 二、联合相位、历史与部署可用观测训练步态
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:人形步态怎样走过模拟器到硬件的接口
读者在接触方法前知道优化对象与信息权限
- 三、方法:每一层解决什么问题 → 三、把相位步态训练接到跨模拟器与硬件检查
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、跨模拟器通过仍不能替代真实安全验证:两个模拟器都通过时,为什么仍要单独核对关节顺序和动作尺度?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Humanoid-Gym: Reinforcement Learning for Humanoid Robot with Zero-Shot Sim2Real Transfer,图4:对照MuJoCo、真机与Isaac Gym的相图,查看动态关系而非仅比较某时刻角度。跨模拟器一致与真机匹配是两个检验,不能互相替代。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
对照MuJoCo、真机与Isaac Gym的相图,查看动态关系而非仅比较某时刻角度。跨模拟器一致与真机匹配是两个检验,不能互相替代。
- Humanoid-Gym: Reinforcement Learning for Humanoid Robot with Zero-Shot Sim2Real Transfer,图3:关节响应标定。 比较模拟与实机腿部运动,说明标定能提高局部执行器响应的一致性。它支持“训练模型需要与硬件对齐”,不能证明全身接触、跌倒冲击或所有负载都被准确建模。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
关节响应标定。 比较模拟与实机腿部运动,说明标定能提高局部执行器响应的一致性。它支持“训练模型需要与硬件对齐”,不能证明全身接触、跌倒冲击或所有负载都被准确建模。
- Humanoid-Gym: Reinforcement Learning for Humanoid Robot with Zero-Shot Sim2Real Transfer,图5:真实机器人部署。 实机展示支持策略能够产生可执行的行走行为。两个机器人尺寸不同,增强了流程可迁移的可信度;然而它没有隔离出 PPO、参考步态、随机化各自贡献,也不是同一权重的跨形态泛化实验。
实验/结果图 · 必要原图摘引 · HTML A0.F5,图5
真实机器人部署。 实机展示支持策略能够产生可执行的行走行为。两个机器人尺寸不同,增强了流程可迁移的可信度;然而它没有隔离出 PPO、参考步态、随机化各自贡献,也不是同一权重的跨形态泛化实验。
- Humanoid-Gym: Reinforcement Learning for Humanoid Robot with Zero-Shot Sim2Real Transfer,图7:地形展示及随机化范围。 前者显示验证环境中的平地和不平整地形行为,后者说明训练扰动设计。二者合起来提供鲁棒性线索,仍不能推导超出采样范围的障碍物、台阶或传感器故障表现。
实验/结果图 · 必要原图摘引 · HTML A0.F7,图7
地形展示及随机化范围。 前者显示验证环境中的平地和不平整地形行为,后者说明训练扰动设计。二者合起来提供鲁棒性线索,仍不能推导超出采样范围的障碍物、台阶或传感器故障表现。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用045-learning-to-walk.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 A0.F5
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 A0.F7
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S3.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 A0.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 A0.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 构造相位频率单位错误的累计例
- 给出跨引擎诊断顺序
- 区分双模拟器证据与实机证据
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用045-learning-to-walk.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
Isaac Gym训练、MuJoCo验证、实机部署及接口标定流程。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。对照MuJoCo、真机与Isaac Gym的相图,查看动态关系而非仅比较某时刻角度。跨模拟器一致与真机匹配是两个检验,不能互相替代。
技术关系
- 045-learning-to-walk · 历史背景
沿并行足式RL工程路线扩展人形平台。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Octo: An Open-Source Generalist Robot Policy部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:传感器和动作维度改变时怎样复用通用策略
- 二、以模块token接口连接共享主干与扩散头
- 三、替换输入编码器和动作头后微调共享主干
- 四、分开预训练混合与下游适配预算
- 五、新接口需要语义正确的监督和归一化
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与前置概念 → 二、以模块token接口连接共享主干与扩散头
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:通用策略首先要允许接口变化 → 二、以模块token接口连接共享主干与扩散头
把问题与答案拆开,按推理到检验展开
- 二、背景与设定 → 一、问题设定:传感器和动作维度改变时怎样复用通用策略
读者在接触方法前知道优化对象与信息权限
- 三、方法:共享内部计算,保留接口语义 → 三、替换输入编码器和动作头后微调共享主干
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、新接口需要语义正确的监督和归一化:新增相机后性能下降,怎样区分接口接错与负迁移?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- Octo: An Open-Source Generalist Robot Policy,图4:“开箱即用”评估的平台与环境来自预训练数据范围。读零样本结果时先锁定这一边界,再与需要更换观测/动作头的下游微调结果区分。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
“开箱即用”评估的平台与环境来自预训练数据范围。读零样本结果时先锁定这一边界,再与需要更换观测/动作头的下游微调结果区分。
- Octo: An Open-Source Generalist Robot Policy,图5:模型尺寸。 在所测任务上较大模型更好,但每平台任务和试验数有限。它提供规模收益的线索,尚不是覆盖机器人任务分布的稳定 scaling law。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
模型尺寸。 在所测任务上较大模型更好,但每平台任务和试验数有限。它提供规模收益的线索,尚不是覆盖机器人任务分布的稳定 scaling law。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用068-openx.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S4.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S4.T2
原站图表/证明入口
- 表VI · HTML 表VI,实际锚点 A6.T6
原站图表/证明入口
- 表VII · HTML 表VII,实际锚点 A6.T7
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用缺失力传感器解释掩码语义
- 区分前向结构隔离与参数遗忘
- 明确Octo/OpenVLA平行比较边界
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用068-openx.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
缺失模态掩码、只读readout token、扩散小头和下游微调。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。“开箱即用”评估的平台与环境来自预训练数据范围。读零样本结果时先锁定这一边界,再与需要更换观测/动作头的下游微调结果区分。
技术关系
- 068-openx · 模块组合
选取OXE混合预训练模块化通用机器人策略。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:厨房场景多样性怎样变成可用训练经验
- 二、连接可交互资产、任务定义与示范扩增
- 三、构建可交互厨房并按任务生成示范
- 四、把原子技能、组合任务和真机迁移分开
- 五、生成规模不能替代恢复行为和真实物理覆盖
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与前置概念 → 二、连接可交互资产、任务定义与示范扩增
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解 → 二、连接可交互资产、任务定义与示范扩增
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:厨房场景多样性怎样变成可用训练经验
读者在接触方法前知道优化对象与信息权限
- 三、方法:从场景到可学习经验 → 三、构建可交互厨房并按任务生成示范
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、生成规模不能替代恢复行为和真实物理覆盖:增加厨房纹理和增加可交互布局,应怎样设计对照?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots,图8:比较组合任务从头训练与用原子任务预训练后微调,两组仍使用目标组合任务示范。提高平均表现不等于已证明技能可以无需适配直接串联。
实验/结果图 · 必要原图摘引 · PDF第7页,图8
比较组合任务从头训练与用原子任务预训练后微调,两组仍使用目标组合任务示范。提高平均表现不等于已证明技能可以无需适配直接串联。
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots,图6:规模趋势。 人类基线 28.8%,最大生成集 47.6%,相差 18.8 个百分点。小生成集为 26.3%,低于人类基线。因此结果支持规模足够时的收益,不支持每条生成数据都更有价值。
实验/结果图 · 必要原图摘引 · HTML S5.F6,图6
规模趋势。 人类基线 28.8%,最大生成集 47.6%,相差 18.8 个百分点。小生成集为 26.3%,低于人类基线。因此结果支持规模足够时的收益,不支持每条生成数据都更有价值。
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots,图9:真实协同训练。 见过类别平均从 13.6% 到 24.4%,增加 10.8 个百分点,按舍入数相对增加约 79%;未见类别从 2.6% 到 9.3%。相对增幅大的一部分原因是基线低,最终可靠性仍有限。误差来自三个训练种子,不能当成所有厨房变化的置信范围。
实验/结果图 · 必要原图摘引 · PDF第8页,图10(HTML图9)
真实协同训练。 见过类别平均从 13.6% 到 24.4%,增加 10.8 个百分点,按舍入数相对增加约 79%;未见类别从 2.6% 到 9.3%。相对增幅大的一部分原因是基线低,最终可靠性仍有限。误差来自三个训练种子,不能当成所有厨房变化的置信范围。
- RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots,图12:逐任务结果。 聚合趋势掩盖了非单调性。一些开关、门类任务在更大生成集上未继续提升。数据量增加可能同时改变覆盖、质量和优化难度,总体均值不能保证单任务改善。
实验/结果图 · 必要原图摘引 · PDF第16页,图13(HTML图12)
逐任务结果。 聚合趋势掩盖了非单调性。一些开关、门类任务在更大生成集上未继续提升。数据量增加可能同时改变覆盖、质量和优化难度,总体均值不能保证单任务改善。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用071-mimicgen.md的具体机制关系替换或补足承上启下阅读链接
- 补入图7的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图12 · HTML 图12,实际锚点 S9.F12
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S5.F9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 构造两个独立成功技能组合失败的初态反例
- 解释组合任务的状态交接瓶颈
- 将成功筛选和轨迹质量分开
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用071-mimicgen.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图7的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
对象中心生成、组合任务微调结果及抖动碰撞局限。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F7的图7图注及相关上下文;其余已定位图表见v2逐篇记录。比较组合任务从头训练与用原子任务预训练后微调,两组仍使用目标组合任务示范。提高平均表现不等于已证明技能可以无需适配直接串联。
技术关系
- 071-mimicgen · 模块组合
环境集成MimicGen生成原子任务示范。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习OpenVLA: An Open-Source Vision-Language-Action Model部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:开放视觉语言模型怎样学成可适配动作策略
- 二、融合视觉特征并自回归预测动作token
- 三、在机器人示范上训练动作token并适配新接口
- 四、核对预训练、微调和量化比较的条件
- 五、动作分箱与任务数据限制精细执行
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与五个前置概念 → 二、融合视觉特征并自回归预测动作token
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让视觉语言模型直接输出动作 → 二、融合视觉特征并自回归预测动作token
把问题与答案拆开,按推理到检验展开
- 二、背景与设定 → 一、问题设定:开放视觉语言模型怎样学成可适配动作策略
读者在接触方法前知道优化对象与信息权限
- 三、方法:动作怎样进入语言模型 → 三、在机器人示范上训练动作token并适配新接口
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、动作分箱与任务数据限制精细执行:动作分位数归一化遇到新的工作区范围时,会产生什么问题?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- OpenVLA: An Open-Source Vision-Language-Action Model,图5:按单指令窄任务和多指令干扰任务分组看扩散策略、Octo与OpenVLA。汇总最佳不代表在每类精度和语言条件上都占优。
实验/结果图 · 必要原图摘引 · HTML S5.F5,图5
按单指令窄任务和多指令干扰任务分组看扩散策略、Octo与OpenVLA。汇总最佳不代表在每类精度和语言条件上都占优。
- OpenVLA: An Open-Source Vision-Language-Action Model,图3:WidowX。 OpenVLA 平均 70.6%,RT-2-X 50.6%,差约 20 个百分点。然而部分任务允许 0.5 分,这不是全部由二元完整成功构成的频率。语义泛化类别中 RT-2-X 仍占优,不能说 OpenVLA 每种泛化都更好。
实验/结果图 · 必要原图摘引 · HTML S5.F3,图3
WidowX。 OpenVLA 平均 70.6%,RT-2-X 50.6%,差约 20 个百分点。然而部分任务允许 0.5 分,这不是全部由二元完整成功构成的频率。语义泛化类别中 RT-2-X 仍占优,不能说 OpenVLA 每种泛化都更好。
- OpenVLA: An Open-Source Vision-Language-Action Model,图4:Google。 85.0% 对 78.3%,误差区间较宽,论文按接近表现解读。主张的跨平台平均优势不能代替单个平台的统计强度。29 任务也不是 29 个全新机器人。
实验/结果图 · 必要原图摘引 · HTML S5.F4,图4
Google。 85.0% 对 78.3%,误差区间较宽,论文按接近表现解读。主张的跨平台平均优势不能代替单个平台的统计强度。29 任务也不是 29 个全新机器人。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用091-openvla-oft.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将8处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 8 个原文证据入口
- 图3 · HTML 图3,实际锚点 S5.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S5.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S5.F5
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S5.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 A2.T4
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 A2.T5
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 A2.T6
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 换算毫米级量化误差与插入间隙
- 分析尾部恢复动作被裁剪的风险
- 明确OFT直接继承与FAST编码路线
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用091-openvla-oft.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将8处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
逐维256bin、分位数边界、动作token交叉熵与数据筛选。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。按单指令窄任务和多指令干扰任务分组看扩散策略、Octo与OpenVLA。汇总最佳不代表在每类精度和语言条件上都占优。
技术关系
- 091-openvla-oft · 直接继承
后作基于OpenVLA改造动作生成和微调。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Diffusion Policy Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多步去噪策略怎样计算可用的更新概率
- 二、把去噪内部决策与环境决策连接起来
- 三、沿内部高斯转移计算PPO比率
- 四、分开预训、在线交互与内部去噪预算
- 五、奖励改进仍受支持和控制接口约束
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与前置概念 → 二、把去噪内部决策与环境决策连接起来
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让扩散策略从奖励中继续进步 → 二、把去噪内部决策与环境决策连接起来
把问题与答案拆开,按推理到检验展开
- 二、背景与问题定义 → 一、问题设定:多步去噪策略怎样计算可用的更新概率
读者在接触方法前知道优化对象与信息权限
- 三、方法:两种时间尺度怎样接起来 → 三、沿内部高斯转移计算PPO比率
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、奖励改进仍受支持和控制接口约束:减少可训练去噪步骤时,怎样区分节省计算与限制改进能力?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- Diffusion Policy Policy Optimization,图7:上排是仿真家具任务曲线,下排才是真实One-leg迁移;不能把另一处像素策略结果套到这组依赖状态观测的真机实验。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
上排是仿真家具任务曲线,下排才是真实One-leg迁移;不能把另一处像素策略结果套到这组依赖状态观测的真机实验。
- Diffusion Policy Policy Optimization,图5:不同扩散 RL 方法。 DPPO 在稀疏操作任务尤其 Transport 中有优势,Gym 上部分方法也有竞争力。这支持任务相关的稳定性收益,不支持所有离策略算法必然不适合扩散。
实验/结果图 · 必要原图摘引 · HTML S5.F5,图5
不同扩散 RL 方法。 DPPO 在稀疏操作任务尤其 Transport 中有优势,Gym 上部分方法也有竞争力。这支持任务相关的稳定性收益,不支持所有离策略算法必然不适合扩散。
- Diffusion Policy Policy Optimization,图6:不同动作分布。 状态 Transport 达到超过 90% 的表现,视觉困难任务中也表现较强。较容易任务差距较小,说明多步去噪优势并不在所有任务上同样明显。
实验/结果图 · 必要原图摘引 · HTML S5.F6,图6
不同动作分布。 状态 Transport 达到超过 90% 的表现,视觉困难任务中也表现较强。较容易任务差距较小,说明多步去噪优势并不在所有任务上同样明显。
- Diffusion Policy Policy Optimization,图8:纠错行为。 示例展示插入失败后的修正,说明强化学习可能扩展示范之外的状态覆盖。但展示轨迹不能单独量化所有扰动下的恢复概率,需要随机扰动和预先定义的成功标准。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
纠错行为。 示例展示插入失败后的修正,说明强化学习可能扩展示范之外的状态覆盖。但展示轨迹不能单独量化所有扰动下的恢复概率,需要随机扰动和预先定义的成功标准。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- 补入图7的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图5 · HTML 图5,实际锚点 S5.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导内部路径概率比的乘积
- 区分路径密度与最终动作边缘密度
- 解释PPO裁剪不是硬约束
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用061-diffusion-policy.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图7的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
两层MDP、内部概率比、微调步骤与clip实践。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F7的图7图注及相关上下文;其余已定位图表见v2逐篇记录。上排是仿真家具任务曲线,下排才是真实One-leg迁移;不能把另一处像素策略结果套到这组依赖状态观测的真机实验。
技术关系
- 061-diffusion-policy · 直接继承
对预训练扩散动作策略继续作在线奖励优化。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习RoboTwin: Dual-Arm Robot Benchmark with Generative Digital Twins (early version)部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:数字资产怎样提供双臂工具操作的功能约束
- 二、从几何与功能坐标生成规划器示范
- 三、从功能坐标生成代码并验证模拟执行
- 四、区分资产质量、生成数据与策略执行证据
- 五、外观相似不能证明真实接触一致
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与前置概念 → 二、从几何与功能坐标生成规划器示范
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:先建出能交互的替身,再生成动作数据 → 二、从几何与功能坐标生成规划器示范
把问题与答案拆开,按推理到检验展开
- 二、背景、任务与版本条件 → 一、问题设定:数字资产怎样提供双臂工具操作的功能约束
读者在接触方法前知道优化对象与信息权限
- 三、方法:视觉外观怎样接到功能关系 → 三、从功能坐标生成代码并验证模拟执行
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、外观相似不能证明真实接触一致:生成代码调用规划器时,怎样避免把规划成功误当成双臂任务成功?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- RoboTwin: Dual-Arm Robot Benchmark with Generative Digital Twins (early version),图3:点表示功能/接触位置,轴表示功能方向与接近方向。它给网格增加动作语义,仍没有自动确认材料、摩擦和整个双臂运动的可行性。
方法/设定图 · 必要原图摘引 · HTML S3.F3,图3
点表示功能/接触位置,轴表示功能方向与接近方向。它给网格增加动作语义,仍没有自动确认材料、摩擦和整个双臂运动的可行性。
- RoboTwin早期版本表1:六个仿真任务在10、20、50条专家示范下训练DP3的成功率。敲击为24%、56%、80%,放杯子为10%、60%、96%,苹果入柜为30%、57%、64%,双臂交接为50%、90%、98%。
实验/结果图 · 必要原图摘引 · PDF第7页,表1
表1的三列对应每任务10、20、50条专家示范,单元格是固定DP3学习器的任务成功率。横向看同一任务的数据量变化,再纵向比较相同示范预算下的任务差异;这里没有等预算的人类示范对照。
- RoboTwin: Dual-Arm Robot Benchmark with Generative Digital Twins (early version),图2:资产与专家生成流程。 它说明照片、三维资产、功能标注和轨迹生成之间的连接。支持方法结构可理解,不提供几何误差、动力学误差或全自动成功率的定量保证。
方法/设定图 · 必要原图摘引 · HTML S3.F2,图2
资产与专家生成流程。 它说明照片、三维资产、功能标注和轨迹生成之间的连接。支持方法结构可理解,不提供几何误差、动力学误差或全自动成功率的定量保证。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用075-dp3.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图2 · HTML 图2,实际锚点 S3.F2
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S6.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;本篇对应带early version标记的原始RoboTwin编号;后续v3材料只作版本对照,不混入RoboTwin 2.0的能力。
本次深化
- 解释单轴对齐剩余旋转自由度
- 区分功能几何与完整可行姿态
- 固定早期版本证据边界
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用075-dp3.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
功能部位/接近轴、规划代码生成与六任务DP3实验。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。点表示功能/接触位置,轴表示功能方向与接近方向。它给网格增加动作语义,仍没有自动确认材料、摩擦和整个双臂运动的可行性。
技术关系
- 075-dp3 · 模块组合
以DP3验证生成双臂示范的可学习性。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 本篇对应带early version标记的原始RoboTwin编号;后续v3材料只作版本对照,不混入RoboTwin 2.0的能力。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习RDT-1B: a Diffusion Foundation Model for Bimanual Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:异构机器人经验怎样训练连续双臂动作
- 二、对齐物理槽位并联合去噪动作块
- 三、对齐物理动作槽位并预训双臂扩散头
- 四、分开数据来源、吞吐与视觉反馈率
- 五、统一维度不等于未见身体可直接执行
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与五个前置概念 → 二、对齐物理槽位并联合去噪动作块
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:把不同机器人的经验转成双臂动作能力 → 二、对齐物理槽位并联合去噪动作块
把问题与答案拆开,按推理到检验展开
- 二、背景与问题定义 → 一、问题设定:异构机器人经验怎样训练连续双臂动作
读者在接触方法前知道优化对象与信息权限
- 三、方法:物理语义、动作分布与网络结构 → 三、对齐物理动作槽位并预训双臂扩散头
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、统一维度不等于未见身体可直接执行:两个手臂分开采样都合理,为什么合起来仍可能交接失败?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- RDT-1B: a Diffusion Foundation Model for Bimanual Manipulation,图4:左侧是不使用归一化的训练损失,右侧是去掉解码器或动作条件插值的成功率;图注明确这些消融没有预训练,不能直接解释完整大规模预训练收益。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
左侧是不使用归一化的训练损失,右侧是去掉解码器或动作条件插值的成功率;图注明确这些消融没有预训练,不能直接解释完整大规模预训练收益。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用087-pi0.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将3处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 3 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S5.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S5.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用单位推导频率变化对应速度
- 计算64步块的不同物理时域
- 限定频率条件与吞吐的解释
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用087-pi0.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将3处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
物理语义槽位、控制频率条件、64步块及推理吞吐。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。左侧是不使用归一化的训练损失,右侧是去掉解码器或动作条件插值的成功率;图注明确这些消融没有预训练,不能直接解释完整大规模预训练收益。
技术关系
- 087-pi0 · 平行方法
大规模双臂扩散策略与VLM流动作专家采取不同骨干。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:人在环纠正怎样改变恢复状态的学习
- 二、将实际接管转移写入离策略回放
- 三、将人接管与自主转移共同写入回放
- 四、同时核对成功率、接管与全部交互成本
- 五、人类介入分布可能掩盖自主恢复缺口
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个小例子建立理解 → 二、将实际接管转移写入离策略回放
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、将实际接管转移写入离策略回放
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:人在环纠正怎样改变恢复状态的学习
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、将人接管与自主转移共同写入回放
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、人类介入分布可能掩盖自主恢复缺口:接管率下降时,怎样判断是自主恢复更强还是评估变容易?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning,图4:成功率、周期时间和接管率是三个独立轨迹,图中采用20回合滑动平均。应同时追踪接管降到零时任务是否仍成功,不能只报被人纠正后的完成率。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
成功率、周期时间和接管率是三个独立轨迹,图中采用20回合滑动平均。应同时追踪接管降到零时任务是否仍成功,不能只报被人纠正后的完成率。
- Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning,图5:图4与图5。 图4显示训练中介入比例下降,但曲线是滑动统计,部分回合被人帮助;最终独立评测才验证自主性。图5展示受扰后恢复,是定性鲁棒性证据,不能据此给出任意扰动下的成功概率。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
图4与图5。 图4显示训练中介入比例下降,但曲线是滑动统计,部分回合被人帮助;最终独立评测才验证自主性。图5展示受扰后恢复,是定性鲁棒性证据,不能据此给出任意扰动下的成功概率。
- Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning,图6:图6。 状态访问逐渐集中形成通向目标的区域,支持作者关于恢复行为的解释。但图中对动作扰动计算的 $Q$ 方差是动作敏感度,不是模型集成的认识不确定性;方差大也不自动代表价值估计更准确。这里没有给出视觉神经策略的形式化稳定域证明。
实验/结果图 · 必要原图摘引 · HTML S5.F6,图6
图6。 状态访问逐渐集中形成通向目标的区域,支持作者关于恢复行为的解释。但图中对动作扰动计算的 $Q$ 方差是动作敏感度,不是模型集成的认识不确定性;方差大也不自动代表价值估计更准确。这里没有给出视觉神经策略的形式化稳定域证明。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用074-serl.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S5.F6
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;主表与Diffusion Policy比较段的数值差异尚未统一;涉及该比较时应保留各自任务和评分口径,不能合成一个更强的统一提升值。
本次深化
- 计算双池中的实际人类样本比例
- 解释重复回放与接管预算
- 区分训练扶正和自主测试
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用074-serl.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
双回放池等量采样、人在环实际执行及RLPD更新。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。成功率、周期时间和接管率是三个独立轨迹,图中采用20回合滑动平均。应同时追踪接管降到零时任务是否仍成功,不能只报被人纠正后的完成率。
技术关系
- 074-serl · 直接继承
基于SERL扩大人在环纠正和复杂真机任务。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 主表与Diffusion Policy比较段的数值差异尚未统一;涉及该比较时应保留各自任务和评分口径,不能合成一个更强的统一提升值。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习pi0: A Vision-Language-Action Flow Model for General Robot Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:互联网语义怎样连接高频连续动作块
- 二、让VLM条件与流匹配动作专家共同训练
- 三、以流匹配训练动作专家并做任务后训练
- 四、分开基础模型、任务后训练与部分完成评分
- 五、动作频率和观测反馈频率并不相同
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个例子建立理解 → 二、让VLM条件与流匹配动作专家共同训练
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、让VLM条件与流匹配动作专家共同训练
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:互联网语义怎样连接高频连续动作块
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、以流匹配训练动作专家并做任务后训练
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 四、分开基础模型、任务后训练与部分完成评分:用反例说明阶段评分无法唯一确定完整成功率
教法来源与实际阅读范围
- Physical Intelligence · π0: Our First Generalist Policy
VLM and continuous action expert; post-training; task evaluation and partial completion rubric
原论文校准:以基线稿已核对的原论文方程、接口和实验口径为事实边界,逐段核对本次新增解释与这些约束是否一致。新增算例与检查方案是教学推演,不声称原作者做过该实验。 · 原文 · 原文
未增加未经原稿来源支持的实验成绩;新增反例、协议检查与改进候选均不当作已验证性能结论。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:5 幅
- pi0: A Vision-Language-Action Flow Model for General Robot Control,图7:内嵌图7比较五类任务的平均任务进度。先把π0的160k步parity版本与相同更新预算基线比较,再看700k步完整版本;纵轴的部分任务进度不能直接当作完整任务成功率,额外训练预算也须单独记账。
实验/结果图 · 必要原图摘引 · HTML S6.F7,图7
内嵌图7比较五类任务的平均任务进度。先把π0的160k步parity版本与相同更新预算基线比较,再看700k步完整版本;纵轴的部分任务进度不能直接当作完整任务成功率,额外训练预算也须单独记账。
- pi0: A Vision-Language-Action Flow Model for General Robot Control,图4: 图4,原论文图注与图像。左图是训练混合的采样权重,右图是数据按步数计的实际大小。两者不相同,不能仅凭原始数据占比推断模型训练时看到了多少次。
实验/结果图 · 必要原图摘引 · HTML S5.F4,图4
图4,原论文图注与图像。左图是训练混合的采样权重,右图是数据按步数计的实际大小。两者不相同,不能仅凭原始数据占比推断模型训练时看到了多少次。
- pi0: A Vision-Language-Action Flow Model for General Robot Control,图9:语言指导。 人类或高层模型分步命令带来改善,说明策略能利用这些条件。但人类分步组得到了额外任务分解信息,不能把它当成仅一句总命令的完全自主结果;高层VLM组则是另一个自主系统配置。π0-small同时改变规模和结构,不能把差异全部归于 VLM 初始化。
方法/设定图 · 必要原图摘引 · HTML S6.F9,图9
语言指导。 人类或高层模型分步命令带来改善,说明策略能利用这些条件。但人类分步组得到了额外任务分解信息,不能把它当成仅一句总命令的完全自主结果;高层VLM组则是另一个自主系统配置。π0-small同时改变规模和结构,不能把差异全部归于 VLM 初始化。
- pi0: A Vision-Language-Action Flow Model for General Robot Control,图11:新任务微调。 预训练的收益和目标任务相似性有关;作者指出微波炉任务5小时资料时与基线较接近,1小时条件下更有优势。这支持在稀缺资料下预训练有用,不能推出更多目标数据总是严格单调地提升所有模型。
实验/结果图 · 必要原图摘引 · HTML S6.F11,图11
新任务微调。 预训练的收益和目标任务相似性有关;作者指出微波炉任务5小时资料时与基线较接近,1小时条件下更有优势。这支持在稀缺资料下预训练有用,不能推出更多目标数据总是严格单调地提升所有模型。
- pi0: A Vision-Language-Action Flow Model for General Robot Control,图13:复杂操作。 完整配方在各任务取得超过最大分数一半的平均分,是进度层面的结论。装蛋评分有放六个蛋和关盖共七项;得4/7不是完整任务成功。长视频中的完整演示也不能替代全部试验的完成率。
实验/结果图 · 必要原图摘引 · HTML S6.F13,图13
复杂操作。 完整配方在各任务取得超过最大分数一半的平均分,是进度层面的结论。装蛋评分有放六个蛋和关盖共七项;得4/7不是完整任务成功。长视频中的完整演示也不能替代全部试验的完成率。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用093-pi05.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图11 · HTML 图11,实际锚点 S6.F11
原站图表/证明入口
- 图13 · HTML 图13,实际锚点 S6.F13
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S5.F4
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S6.F7
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S6.F9
原站图表/证明入口
- 表I · HTML 表I,实际锚点 A1.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 手算混合权重与单样本曝光
- 解释稀有组重采样的收益风险
- 限定生成损失与数据配方归因
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用093-pi05.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
n的0.43次方混合、动作专家、预训练/后训练分工。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。左图是训练混合的采样权重,右图是数据按步数计的实际大小。两者不相同,不能仅凭原始数据占比推断模型训练时看到了多少次。
技术关系
- 093-pi05 · 直接继承
后作在π0基础上扩展异构数据与层级语义控制。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习DexMimicGen: Automated Data Generation for Bimanual Dexterous Manipulation via Imitation Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:双手示范怎样同时保留几何与时序关系
- 二、按独立、同步与顺序子任务生成双臂轨迹
- 三、按双手时序约束重执行并筛选数据
- 四、区分扩展初态中的训练与零样本测试
- 五、重执行成功不保证所有接触节奏可复用
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个例子建立理解 → 二、按独立、同步与顺序子任务生成双臂轨迹
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、按独立、同步与顺序子任务生成双臂轨迹
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:双手示范怎样同时保留几何与时序关系
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、按双手时序约束重执行并筛选数据
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、重执行成功不保证所有接触节奏可复用:人为延长一只手的等待段,会怎样影响生成率与学习质量?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- DexMimicGen: Automated Data Generation for Bimanual Dexterous Manipulation via Imitation Learning,图6:按真机执行序列检查双手同步与目标对象变化;这些是用真实收集资料训练后的策略展示,不应直接称为只用仿真数据的零样本迁移。
实验/结果图 · 必要原图摘引 · HTML S6.F6,图6
按真机执行序列检查双手同步与目标对象变化;这些是用真实收集资料训练后的策略展示,不应直接称为只用仿真数据的零样本迁移。
- DexMimicGen: Automated Data Generation for Bimanual Dexterous Manipulation via Imitation Learning,图5:图5固定各任务与学习流程,改变生成数据集规模。先看100到500或1000条的增益,再看继续扩到5000条是否仍改善;柱高的停滞说明生成数量不是唯一限制,不能把一次扩增的收益线性外推到任意更大数据集。
实验/结果图 · 必要原图摘引 · HTML S6.F5,图5
图5固定各任务与学习流程,改变生成数据集规模。先看100到500或1000条的增益,再看继续扩到5000条是否仍改善;柱高的停滞说明生成数量不是唯一限制,不能把一次扩增的收益线性外推到任意更大数据集。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用071-mimicgen.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将5处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 5 个原文证据入口
- 图5 · HTML 图5,实际锚点 S6.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S6.F6
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S5.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S6.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S6.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 证明共同变换保持双手相对位姿
- 展示独立变换多出的误差项
- 区分空间协调与同步承重
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用071-mimicgen.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将5处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
并行/协调/顺序分类、共同变换和剩余步数同步。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F6的图6图注及相关上下文;其余已定位图表见v2逐篇记录。按真机执行序列检查双手同步与目标对象变化;这些是用真实收集资料训练后的策略展示,不应直接称为只用仿真数据的零样本迁移。
技术关系
- 071-mimicgen · 直接继承
扩展MimicGen为带双手时空约束的生成器。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习FAST: Efficient Action Tokenization for Vision-Language-Action Models部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样压缩高频动作而不丢掉关键运动变化
- 二、以DCT、量化与BPE编码动作序列
- 三、压缩动作块后训练token模型并重建执行
- 四、分开压缩率、训练速度与执行质量
- 五、量化误差和解码时延仍需闭环检查
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个小例子建立理解 → 二、以DCT、量化与BPE编码动作序列
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、以DCT、量化与BPE编码动作序列
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:怎样压缩高频动作而不丢掉关键运动变化
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、压缩动作块后训练token模型并重建执行
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、量化误差和解码时延仍需闭环检查:DCT重建均方误差很低,为什么关键接触时刻仍可能明显偏移?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- FAST: Efficient Action Tokenization for Vision-Language-Action Models,图3:黑色虚线与四个条件点定义教学插值目标;改变采样频率后看预测是否仍贴近目标。它隔离相邻token冗余的影响,不是机器人任务成功率曲线。
实验/结果图 · 必要原图摘引 · HTML S4.F3,图3
黑色虚线与四个条件点定义教学插值目标;改变采样频率后看预测是否仍贴近目标。它隔离相邻token冗余的影响,不是机器人任务成功率曲线。
- FAST: Efficient Action Tokenization for Vision-Language-Action Models,图6:图6等报告95%置信区间;全部任务的独立训练种子和试验数未逐项核实。DROID文字写16个任务,但表II实际列17行任务,合计44次,与总试验数相符;因此本文以明确的44次和逐任务表为准。三所校园的其他展示是定性测试,作者明确未统计其成功率。
实验/结果图 · 必要原图摘引 · HTML S6.F6,图6
图6等报告95%置信区间;全部任务的独立训练种子和试验数未逐项核实。DROID文字写16个任务,但表II实际列17行任务,合计44次,与总试验数相符;因此本文以明确的44次和逐任务表为准。三所校园的其他展示是定性测试,作者明确未统计其成功率。
- FAST: Efficient Action Tokenization for Vision-Language-Action Models,图9:训练优势要按设置表述。 单任务的大资料条件中,FAST约用三分之一更新达到较高表现;规模实验报告达到相近效果约五分之一GPU小时。这是两个口径,前者是更新数,后者是计算时间。小资料任务的两类模型则接近,不支持“任何规模都五倍”。
实验/结果图 · 必要原图摘引 · HTML S6.F9,图9
训练优势要按设置表述。 单任务的大资料条件中,FAST约用三分之一更新达到较高表现;规模实验报告达到相近效果约五分之一GPU小时。这是两个口径,前者是更新数,后者是计算时间。小资料任务的两类模型则接近,不支持“任何规模都五倍”。
- FAST: Efficient Action Tokenization for Vision-Language-Action Models,图11:训练优势要按设置表述。 单任务的大资料条件中,FAST约用三分之一更新达到较高表现;规模实验报告达到相近效果约五分之一GPU小时。这是两个口径,前者是更新数,后者是计算时间。小资料任务的两类模型则接近,不支持“任何规模都五倍”。
实验/结果图 · 必要原图摘引 · HTML S6.F11,图11
训练优势要按设置表述。 单任务的大资料条件中,FAST约用三分之一更新达到较高表现;规模实验报告达到相近效果约五分之一GPU小时。这是两个口径,前者是更新数,后者是计算时间。小资料任务的两类模型则接近,不支持“任何规模都五倍”。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用082-openvla.md的具体机制关系替换或补足承上启下阅读链接
- 补入图3的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图11 · HTML 图11,实际锚点 S6.F11
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S6.F6
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S6.F9
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S6.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 A0.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导正交DCT舍入误差上界
- 区分编码误差与策略token错误
- 解释BPE不能恢复被量化信息
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用082-openvla.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图3的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
DCT按维变换、scale-and-round、BPE无损压缩量化序列。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F3的图3图注及相关上下文;其余已定位图表见v2逐篇记录。黑色虚线与四个条件点定义教学插值目标;改变采样频率后看预测是否仍贴近目标。它隔离相邻token冗余的影响,不是机器人任务成功率曲线。
技术关系
- 082-openvla · 教学联系
用动作压缩理解逐维自回归输出在高频下的瓶颈。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习ASAP: Aligning Simulation and Real-World Physics for Learning Agile Humanoid Whole-Body Skills部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样让模拟器复现真实执行器的动作后果
- 二、拟合动作残差后冻结环境修正并重训策略
- 三、用真实下一步响应拟合残差并冻结再训练
- 四、连接开环对齐误差与真实闭环跟踪
- 五、残差覆盖范围限制未见运动迁移
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个例子建立理解 → 二、拟合动作残差后冻结环境修正并重训策略
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、拟合动作残差后冻结环境修正并重训策略
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:怎样让模拟器复现真实执行器的动作后果
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、用真实下一步响应拟合残差并冻结再训练
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、残差覆盖范围限制未见运动迁移:残差只在旧策略访问的状态上拟合,重训策略后应检查什么?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- ASAP: Aligning Simulation and Real-World Physics for Learning Agile Humanoid Whole-Body Skills,图10:分开看数据规模、训练时域和残差动作范数,且区分开环误差与闭环误差。降低固定记录上的误差不保证微调后策略访问分布中的误差也更小。
实验/结果图 · 必要原图摘引 · HTML S5.F10,图10
分开看数据规模、训练时域和残差动作范数,且区分开环误差与闭环误差。降低固定记录上的误差不保证微调后策略访问分布中的误差也更小。
- ASAP: Aligning Simulation and Real-World Physics for Learning Agile Humanoid Whole-Body Skills,图11:怎样使用残差。 PPO微调优于单步固定点或梯度求解,支持让策略重新适应闭环动态;针对性残差也优于所试随机动作噪声。v1图12图注和正文分别给噪声基线173与150,故不据此计算精确增幅。它不能排除更充分调优的随机化方案。实验§IV–V
实验/结果图 · 必要原图摘引 · HTML S5.F11,图11
怎样使用残差。 PPO微调优于单步固定点或梯度求解,支持让策略重新适应闭环动态;针对性残差也优于所试随机动作噪声。v1图12图注和正文分别给噪声基线173与150,故不据此计算精确增幅。它不能排除更充分调优的随机化方案。实验§IV–V
- ASAP: Aligning Simulation and Real-World Physics for Learning Agile Humanoid Whole-Body Skills,图12:怎样使用残差。 PPO微调优于单步固定点或梯度求解,支持让策略重新适应闭环动态;针对性残差也优于所试随机动作噪声。v1图12图注和正文分别给噪声基线173与150,故不据此计算精确增幅。它不能排除更充分调优的随机化方案。实验§IV–V
实验/结果图 · 必要原图摘引 · HTML S5.F12,图12
怎样使用残差。 PPO微调优于单步固定点或梯度求解,支持让策略重新适应闭环动态;针对性残差也优于所试随机动作噪声。v1图12图注和正文分别给噪声基线173与150,故不据此计算精确增幅。它不能排除更充分调优的随机化方案。实验§IV–V
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- 补入图10的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图10 · HTML 图10,实际锚点 S5.F10
原站图表/证明入口
- 图11 · HTML 图11,实际锚点 S5.F11
原站图表/证明入口
- 图12 · HTML 图12,实际锚点 S5.F12
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S4.T3
原站图表/证明入口
- 表IV · HTML 表IV,实际锚点 S4.T4
原站图表/证明入口
- 表V · HTML 表V,实际锚点 S4.T5
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 一维0.8增益算例检查残差符号
- 量化错误二次补偿的后果
- 限制全身展示与四维辨识结论
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用024-dynamics-randomization.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图10的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
动作残差嵌入模拟器、冻结后微调及部署移除、真机4DoF范围。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F10的图10图注及相关上下文;其余已定位图表见v2逐篇记录。分开看数据规模、训练时域和残差动作范数,且区分开环误差与闭环误差。降低固定记录上的误差不保证微调后策略访问分布中的误差也更小。
技术关系
- 024-dynamics-randomization · 平行方法
目标域数据驱动对齐与分布随机化处理不同不确定性。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:已有VLA权重怎样适配并行动作块
- 二、以空动作槽位、连续回归和FiLM微调
- 三、以空槽并行输出连续动作并微调语言调制
- 四、分开吞吐、闭环频率与数据一致性
- 五、L1在窄模式数据上的有效性不能普遍外推
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个例子建立理解 → 二、以空动作槽位、连续回归和FiLM微调
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、以空动作槽位、连续回归和FiLM微调
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:已有VLA权重怎样适配并行动作块
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、以空槽并行输出连续动作并微调语言调制
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、L1在窄模式数据上的有效性不能普遍外推:FiLM收益应怎样与额外参数和新增相机信息分开?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success,图5:指标是靠近语言指定目标的成功率,聚焦语言接地而非完整任务所有阶段。去掉FiLM后的变化应在同一目标选择协议下解释。
实验/结果图 · 必要原图摘引 · HTML S6.F5,图5
指标是靠近语言指定目标的成功率,聚焦语言接地而非完整任务所有阶段。去掉FiLM后的变化应在同一目标选择协议下解释。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用082-openvla.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将7处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 7 个原文证据入口
- 图5 · HTML 图5,实际锚点 S6.F5
原站图表/证明入口
- 表I · HTML 表I,实际锚点 S5.T1
原站图表/证明入口
- 表II · HTML 表II,实际锚点 S5.T2
原站图表/证明入口
- 表III · HTML 表III,实际锚点 S6.T3
原站图表/证明入口
- 表V · HTML 表V,实际锚点 A1.T5
原站图表/证明入口
- 表X · HTML 表X,实际锚点 A1.T10
原站图表/证明入口
- 表XII · HTML 表XII,实际锚点 A1.T12
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 构造逐坐标中位数落在模式之外的反例
- 解释条件信息如何减少多模态歧义
- 限定L1/扩散头实验结论
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用082-openvla.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将7处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
空动作嵌入、双向并行解码、L1与扩散目标比较。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S6.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。指标是靠近语言指定目标的成功率,聚焦语言接地而非完整任务所有阶段。去掉FiLM后的变化应在同一目标选择协议下解释。
技术关系
- 082-openvla · 直接继承
在OpenVLA预训练权重上改变微调和动作接口。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习GR00T N1: An Open Foundation Model for Generalist Humanoid Robots部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:没有电机标签的视频怎样参与动作模型训练
- 二、分开三种动作监督并连接共享双系统
- 三、按来源生成不同动作标签再联合后训练
- 四、逐项核对数据来源与阶段评分
- 五、伪标签和视频外观不提供物理正确性保证
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用一个例子建立理解 → 二、分开三种动作监督并连接共享双系统
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让不同来源的数据说同一种“动作语言” → 二、分开三种动作监督并连接共享双系统
把问题与答案拆开,按推理到检验展开
- 二、问题设定:共享行为,保留身体差异 → 一、问题设定:没有电机标签的视频怎样参与动作模型训练
读者在接触方法前知道优化对象与信息权限
- 三、方法:双系统与三种动作监督 → 三、按来源生成不同动作标签再联合后训练
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、伪标签和视频外观不提供物理正确性保证:同一视频用潜在动作和逆动力学伪标签两种监督时,应怎样避免误判数据收益?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots,图9:内嵌图9检验合成轨迹是否改善下游成功率:左侧是RoboCasa按30、100、300条示范分组,右侧是真机低数据条件。需在同一示范量和动作标注方式下比较;模拟中的潜动作和逆动力学标注不能与真机设置混作同一对照。
实验/结果图 · 必要原图摘引 · HTML S4.F9,图9
内嵌图9检验合成轨迹是否改善下游成功率:左侧是RoboCasa按30、100、300条示范分组,右侧是真机低数据条件。需在同一示范量和动作标注方式下比较;模拟中的潜动作和逆动力学标注不能与真机设置混作同一对照。
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots,图4: 图4,原论文图注与图像。这是跨形态相似潜动作的检索示例,展示对应运动方向;近邻看起来一致还不足以证明不同机器人共享了可直接互换的控制坐标。
实验/结果图 · 必要原图摘引 · HTML S2.F4,图4
图4,原论文图注与图像。这是跨形态相似潜动作的检索示例,展示对应运动方向;近邻看起来一致还不足以证明不同机器人共享了可直接互换的控制坐标。
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots,图12:§4.5、图12——微调可能损失已有能力。 预训练模型在特定案例中使用双手交接完成放置,而只含右手行为的后训练数据使模型失去这条路径。它是重要反例:提高目标分布成绩,可能同时缩窄策略使用的动作模式。单个案例不能估计遗忘的平均程度,却足以提醒读者补做保留能力测试。
实验/结果图 · 必要原图摘引 · HTML A6.F12,图12
§4.5、图12——微调可能损失已有能力。 预训练模型在特定案例中使用双手交接完成放置,而只含右手行为的后训练数据使模型失去这条路径。它是重要反例:提高目标分布成绩,可能同时缩窄策略使用的动作模式。单个案例不能估计遗忘的平均程度,却足以提醒读者补做保留能力测试。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用088-dexmimicgen.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图12 · HTML 图12,实际锚点 A6.F12
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S2.F4
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S4.F9
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 A2.T4
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;流匹配的时间方向与DexMG表间汇总口径仍有待核对;不把未统一的定义用于推出额外的精确性能差值。
本次深化
- 用静态接触说明视频逆动力学不可辨识
- 区分视觉变化监督与真实控制命令
- 解释独立形态接口的必要性
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用088-dexmimicgen.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
VQ-VAE量化前潜码、独立LAPA形态和各数据源训练标签。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S2.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。这是跨形态相似潜动作的检索示例,展示对应运动方向;近邻看起来一致还不足以证明不同机器人共享了可直接互换的控制坐标。
技术关系
- 088-dexmimicgen · 模块组合
用DexMimicGen生成模拟示范纳入预训练。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 流匹配的时间方向与DexMG表间汇总口径仍有待核对;不把未统一的定义用于推出额外的精确性能差值。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习pi0.5: a Vision-Language-Action Model with Open-World Generalization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:陌生家庭中怎样持续选择子任务并执行
- 二、联合语义子任务与连续动作条件生成
- 三、先预测语义子任务,再条件生成连续动作
- 四、区分新环境、对象和任务的留出方式
- 五、层级决策仍依赖数据覆盖与重规划时机
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与前置知识 → 二、联合语义子任务与连续动作条件生成
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:新家里,机器人先决定做什么 → 二、联合语义子任务与连续动作条件生成
把问题与答案拆开,按推理到检验展开
- 二、问题定义:新环境、任务与对象分别意味着什么 → 一、问题设定:陌生家庭中怎样持续选择子任务并执行
读者在接触方法前知道优化对象与信息权限
- 三、方法:训练接口与推理接口可以不同 → 三、先预测语义子任务,再条件生成连续动作
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、层级决策仍依赖数据覆盖与重规划时机:高层子任务合理但迟迟不切换时,怎样定位失败?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:9 幅
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图13:把完整高低层推理、只用低层但保留高层训练、去掉高层相关数据分开看。这样才能区分高层监督改善表示与部署时显式规划的贡献。
实验/结果图 · 必要原图摘引 · HTML S5.F13,图13
把完整高低层推理、只用低层但保留高层训练、去掉高层相关数据分开看。这样才能区分高层监督改善表示与部署时显式规划的贡献。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图7:真实家庭结果。 比较相似任务在新家庭的执行进度,支持跨环境转移。定量回合多为数分钟,介绍中的更长演示不能全部混成同一个统计样本。图中纵轴是任务进度,不能读成整回合二元成功率。
实验/结果图 · 必要原图摘引 · HTML S5.F7,图7
真实家庭结果。 比较相似任务在新家庭的执行进度,支持跨环境转移。定量回合多为数分钟,介绍中的更长演示不能全部混成同一个统计样本。图中纵轴是任务进度,不能读成整回合二元成功率。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图8:地点数量与语言跟随。 地点增加通常带来更好的新环境表现,且物体类别外泛化更困难。作者控制训练抽样数量,支持覆盖多样性的作用;但地点增加也带来对象、布局等同时变化,尚不能分离其中哪一个是根本因素。模型接近见过测试家庭的对照,也不等于对任意家庭不存在泛化差距。
实验/结果图 · 必要原图摘引 · HTML S5.F8,图8
地点数量与语言跟随。 地点增加通常带来更好的新环境表现,且物体类别外泛化更困难。作者控制训练抽样数量,支持覆盖多样性的作用;但地点增加也带来对象、布局等同时变化,尚不能分离其中哪一个是根本因素。模型接近见过测试家庭的对照,也不等于对任意家庭不存在泛化差距。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图9:地点数量与语言跟随。 地点增加通常带来更好的新环境表现,且物体类别外泛化更困难。作者控制训练抽样数量,支持覆盖多样性的作用;但地点增加也带来对象、布局等同时变化,尚不能分离其中哪一个是根本因素。模型接近见过测试家庭的对照,也不等于对任意家庭不存在泛化差距。
实验/结果图 · 必要原图摘引 · HTML S5.F9,图9
地点数量与语言跟随。 地点增加通常带来更好的新环境表现,且物体类别外泛化更困难。作者控制训练抽样数量,支持覆盖多样性的作用;但地点增加也带来对象、布局等同时变化,尚不能分离其中哪一个是根本因素。模型接近见过测试家庭的对照,也不等于对任意家庭不存在泛化差距。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图10:网页数据作用具有任务依赖性。 去掉网页数据,在整体模拟家庭任务上的差别不显著,但新类别对象的语言跟随下降。它支持“语义监督特别影响某些能力”,不支持网页数据对所有动作都必不可少。跨形态数据则在多种评估中带来更广泛收益。
实验/结果图 · 必要原图摘引 · HTML S5.F10,图10
网页数据作用具有任务依赖性。 去掉网页数据,在整体模拟家庭任务上的差别不显著,但新类别对象的语言跟随下降。它支持“语义监督特别影响某些能力”,不支持网页数据对所有动作都必不可少。跨形态数据则在多种评估中带来更广泛收益。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图11:网页数据作用具有任务依赖性。 去掉网页数据,在整体模拟家庭任务上的差别不显著,但新类别对象的语言跟随下降。它支持“语义监督特别影响某些能力”,不支持网页数据对所有动作都必不可少。跨形态数据则在多种评估中带来更广泛收益。
实验/结果图 · 必要原图摘引 · HTML S5.F11,图11
网页数据作用具有任务依赖性。 去掉网页数据,在整体模拟家庭任务上的差别不显著,但新类别对象的语言跟随下降。它支持“语义监督特别影响某些能力”,不支持网页数据对所有动作都必不可少。跨形态数据则在多种评估中带来更广泛收益。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图12:配方不只是动作解码器替换。 FAST+Flow 已有混合动作表示,完整模型仍更好,说明高层和视觉语言共同训练有额外价值。然而参与比较的额外监督不同,应理解为训练方案比较,而不是纯粹固定全部信息下的网络结构比较。
方法/设定图 · 必要原图摘引 · HTML S5.F12,图12
配方不只是动作解码器替换。 FAST+Flow 已有混合动作表示,完整模型仍更好,说明高层和视觉语言共同训练有额外价值。然而参与比较的额外监督不同,应理解为训练方案比较,而不是纯粹固定全部信息下的网络结构比较。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图17:高层监督可以通过两条路起作用。 显式高层最好,隐式高层仍取得较好表现,表明子任务监督也改变了模型内部表示。完整模型超过给定人类高层的结果,不证明机器规划超过人类;这个“oracle”只是特定人类提示接口,对低层模型而言未必是最适合的指令分布。
实验/结果图 · 必要原图摘引 · HTML A1.F17,图17
高层监督可以通过两条路起作用。 显式高层最好,隐式高层仍取得较好表现,表明子任务监督也改变了模型内部表示。完整模型超过给定人类高层的结果,不证明机器规划超过人类;这个“oracle”只是特定人类提示接口,对低层模型而言未必是最适合的指令分布。
- pi0.5: a Vision-Language-Action Model with Open-World Generalization,图18:为了避免复制答案,连续动作 token 不能注意到同一样本的 FAST 动作 token;视觉语言前缀也不从动作专家读取信息。否则模型可能训练时从另一种表示直接读出动作,部署却失去该信息。注意力掩码是保证训练任务有效的重要机制。(附录A-E、图18)
实验/结果图 · 必要原图摘引 · HTML A1.F18,图18
为了避免复制答案,连续动作 token 不能注意到同一样本的 FAST 动作 token;视觉语言前缀也不从动作专家读取信息。否则模型可能训练时从另一种表示直接读出动作,部署却失去该信息。注意力掩码是保证训练任务有效的重要机制。(附录A-E、图18)
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用087-pi0.md的具体机制关系替换或补足承上启下阅读链接
- 补入图13的可打开原图及专属图例/坐标/比较条件解读
- 将9处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 9 个原文证据入口
- 图10 · HTML 图10,实际锚点 S5.F10
原站图表/证明入口
- 图11 · HTML 图11,实际锚点 S5.F11
原站图表/证明入口
- 图12 · HTML 图12,实际锚点 S5.F12
原站图表/证明入口
- 图13 · HTML 图13,实际锚点 S5.F13
原站图表/证明入口
- 图17 · HTML 图17,实际锚点 A1.F17
原站图表/证明入口
- 图18 · HTML 图18,实际锚点 A1.F18
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S5.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S5.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S5.F9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用半杯/满杯说明子任务信息瓶颈
- 区分约束丢失与监督答案泄漏
- 明确π0与FAST各自继承角色
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用087-pi0.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图13的可打开原图及专属图例/坐标/比较条件解读
- v2:将9处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
高低层条件分解、FAST预训练和阻止两种动作表示泄漏的掩码。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S5.F13的图13图注及相关上下文;其余已定位图表见v2逐篇记录。把完整高低层推理、只用低层但保留高层训练、去掉高层相关数据分开看。这样才能区分高层监督改善表示与部署时显式规划的贡献。
技术关系
- 087-pi0 · 直接继承
扩展π0的语义层级与异构监督配方。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习VLA-RL: Towards Masterful and General Robotic Manipulation with Scalable Reinforcement Learning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:VLA怎样用自身执行结果继续学习
- 二、对齐动作token概率、价值预热和过程奖励
- 三、在环境步上对齐token概率、价值与奖励
- 四、核对课程公式、训练预算与真实评价单位
- 五、启发式奖励可能引导错误过程
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、一个小例子:奖励有帮助,也可能指错方向 → 二、对齐动作token概率、价值预热和过程奖励
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让 VLA 从自己的执行中继续学习 → 二、对齐动作token概率、价值预热和过程奖励
把问题与答案拆开,按推理到检验展开
- 二、研究背景:动作 token 与环境动作有两个时间尺度 → 一、问题设定:VLA怎样用自身执行结果继续学习
读者在接触方法前知道优化对象与信息权限
- 三、方法:四个组件如何配合 → 三、在环境步上对齐token概率、价值与奖励
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、启发式奖励可能引导错误过程:过程奖励模型若偏爱接近目标,怎样检查策略是否拖延真正完成?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:4 幅
- VLA-RL: Towards Masterful and General Robotic Manipulation with Scalable Reinforcement Learning,图4:虽然图标题写Test-time Scaling,图注实际每隔2500个训练步评估一次微调模型;横向变化含参数更新,因此不能称为固定模型的推理预算扩展。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
虽然图标题写Test-time Scaling,图注实际每隔2500个训练步评估一次微调模型;横向变化含参数更新,因此不能称为固定模型的推理预算扩展。
- VLA-RL: Towards Masterful and General Robotic Manipulation with Scalable Reinforcement Learning,图5:训练动态具有诊断价值。 回合变短可能说明更快成功,也可能来自更早终止,必须与成功率一起看。熵下降可能代表技能收敛,也可能代表探索坍缩;只读一个曲线无法区分。系统耗时分解能定位瓶颈,却不能替代硬件一致的基线实验。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
训练动态具有诊断价值。 回合变短可能说明更快成功,也可能来自更早终止,必须与成功率一起看。熵下降可能代表技能收敛,也可能代表探索坍缩;只读一个曲线无法区分。系统耗时分解能定位瓶颈,却不能替代硬件一致的基线实验。
- VLA-RL: Towards Masterful and General Robotic Manipulation with Scalable Reinforcement Learning,图6:行为覆盖与案例。 二维动作投影更分散,说明采样动作分布改变,不直接证明高维状态空间覆盖更完整或分布外鲁棒性更强。成功抓取案例解释了潜在收益,但不能把一个任务的改进提升为接触操作的普遍规律。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
行为覆盖与案例。 二维动作投影更分散,说明采样动作分布改变,不直接证明高维状态空间覆盖更完整或分布外鲁棒性更强。成功抓取案例解释了潜在收益,但不能把一个任务的改进提升为接触操作的普遍规律。
- VLA-RL: Towards Masterful and General Robotic Manipulation with Scalable Reinforcement Learning,图7:行为覆盖与案例。 二维动作投影更分散,说明采样动作分布改变,不直接证明高维状态空间覆盖更完整或分布外鲁棒性更强。成功抓取案例解释了潜在收益,但不能把一个任务的改进提升为接触操作的普遍规律。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
行为覆盖与案例。 二维动作投影更分散,说明采样动作分布改变,不直接证明高维状态空间覆盖更完整或分布外鲁棒性更强。成功抓取案例解释了潜在收益,但不能把一个任务的改进提升为接触操作的普遍规律。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用083-diffusion-rl.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将6处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 6 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;课程采样公式、奖励标量化和完整训练预算仍需与实现对应;式4的数学性质应按实际写出的公式检验,不能用文字意图补写新算法。
本次深化
- 数值验证课程公式并非中等难度优先
- 逐项区分退化和训练崩溃
- 区分VLA token与扩散路径概率
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用083-diffusion-rl.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将6处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
式4课程采样及表2各消融分数。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。虽然图标题写Test-time Scaling,图注实际每隔2500个训练步评估一次微调模型;横向变化含参数更新,因此不能称为固定模型的推理预算扩展。
技术关系
- 083-diffusion-rl · 平行方法
都用在线奖励改进模仿策略,但概率空间不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 课程采样公式、奖励标量化和完整训练预算仍需与实现对应;式4的数学性质应按实际写出的公式检验,不能用文字意图补写新算法。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:紧凑动作模型怎样减少执行等待
- 二、减少视觉计算并异步调度动作队列
- 三、让下一块推理与当前队列执行重叠
- 四、分别衡量单次推理、等待与任务完成
- 五、队列长度交换连续运动和观测新鲜度
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、用延迟算一个小例子 → 二、减少视觉计算并异步调度动作队列
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:小模型之外,还有一个动作队列 → 二、减少视觉计算并异步调度动作队列
把问题与答案拆开,按推理到检验展开
- 二、问题设定:小数据、小身体与短时域任务 → 一、问题设定:紧凑动作模型怎样减少执行等待
读者在接触方法前知道优化对象与信息权限
- 三、方法:把算力用在控制真正需要的地方 → 三、让下一块推理与当前队列执行重叠
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、队列长度交换连续运动和观测新鲜度:平均推理时间相同但尾部延迟更大,会怎样影响动作队列?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics,图5:左、中、右分别比较成功率、速度和固定时间内任务数量。异步推理的吞吐优势与每次尝试可靠性要分别报告,不能只保留完成数量。
实验/结果图 · 必要原图摘引 · PDF第12页,图5
左、中、右分别比较成功率、速度和固定时间内任务数量。异步推理的吞吐优势与每次尝试可靠性要分别报告,不能只保留完成数量。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
- 表2:表单列记录;本次逐图补齐不把表计为Figure。
- 表3:表单列记录;本次逐图补齐不把表计为Figure。
- 表5:表单列记录;本次逐图补齐不把表计为Figure。
- 表6:表单列记录;本次逐图补齐不把表计为Figure。
- 表7:表单列记录;本次逐图补齐不把表计为Figure。
- 表8:表单列记录;本次逐图补齐不把表计为Figure。
- 表9:表单列记录;本次逐图补齐不把表计为Figure。
- 表10:表单列记录;本次逐图补齐不把表计为Figure。
- 表11:表单列记录;本次逐图补齐不把表计为Figure。
- 表12:表单列记录;本次逐图补齐不把表计为Figure。
- 表13:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用096-xiaomi0.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将12处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 12 个原文证据入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S3.T1
原站图表/证明入口
- 表10 · HTML 表10,实际锚点 S4.T10
原站图表/证明入口
- 表11 · HTML 表11,实际锚点 S4.T11
原站图表/证明入口
- 表12 · HTML 表12,实际锚点 S4.T12
原站图表/证明入口
- 表13 · HTML 表13,实际锚点 S4.T13
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T4.fig1
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 S4.T6
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 S4.T7
原站图表/证明入口
- 表8 · HTML 表8,实际锚点 S4.T8
原站图表/证明入口
- 表9 · HTML 表9,实际锚点 S4.T9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 量化均值够用而尾延迟耗尽的例子
- 解释缓冲量与观测年龄的折中
- 区分动作吞吐和真实反应性
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用096-xiaomi0.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将12处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
异步请求、动作队列阈值、同步/异步执行区别。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。左、中、右分别比较成功率、速度和固定时间内任务数量。异步推理的吞吐优势与每次尝试可靠性要分别报告,不能只保留完成数量。
技术关系
- 096-xiaomi0 · 历史背景
后作进一步研究异步动作衔接和视觉反应性。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Xiaomi-Robotics-0: An Open-Sourced Vision-Language-Action Model with Real-Time Execution部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:动作块怎样接得上又能及时改变方向
- 二、联合干净前缀、局部注意力与时间对齐
- 三、用已承诺前缀生成后续块并对齐执行索引
- 四、分开精细拆解和毛巾吞吐证据
- 五、前缀约束不能创造未见恢复行为
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与前置概念 → 二、联合干净前缀、局部注意力与时间对齐
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:动作接得上,还要能改方向 → 二、联合干净前缀、局部注意力与时间对齐
把问题与答案拆开,按推理到检验展开
- 二、问题定义:实时不等于每一帧重新决策 → 一、问题设定:动作块怎样接得上又能及时改变方向
读者在接触方法前知道优化对象与信息权限
- 三、方法:先学条件表示,再学连续生成 → 三、用已承诺前缀生成后续块并对齐执行索引
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、前缀约束不能创造未见恢复行为:只在块边界施加扰动,会不会高估实时反应性?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:1 幅
- Xiaomi-Robotics-0: An Open-Sourced Vision-Language-Action Model with Real-Time Execution,图6:先看乐高拆解与毛巾折叠的装置和任务定义,再读各自定量子图。两个任务的成功判据、速度收益不同,不能用毛巾吞吐替代精细拆解可靠性。
实验/结果图 · 必要原图摘引 · HTML S3.F6,图6
先看乐高拆解与毛巾折叠的装置和任务定义,再读各自定量子图。两个任务的成功判据、速度收益不同,不能用毛巾吞吐替代精细拆解可靠性。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用062-act.md的具体机制关系替换或补足承上启下阅读链接
- 补入图6的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图6 · HTML 图6,实际锚点 S3.F6
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S3.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S3.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S3.T3
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 推导多层局部注意力的间接传播范围
- 提出保持前缀改变视觉的诊断
- 区分经验反应性和信息隔离保证
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用062-act.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图6的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
Λ形掩码、干净动作前缀、位置偏移及异步时间对齐。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S3.F6的图6图注及相关上下文;其余已定位图表见v2逐篇记录。先看乐高拆解与毛巾折叠的装置和任务定义,再读各自定量子图。两个任务的成功判据、速度收益不同,不能用毛巾吞吐替代精细拆解可靠性。
技术关系
- 062-act · 教学联系
用ACT时间集成对照前缀条件生成的衔接机制。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:模型内搜索怎样避免追逐支持外高估
- 二、以模型回报和行为约束塑造扩散分数
- 三、在模型中估计受约束分数场并摊销进策略
- 四、同时比较候选样本、训练时间与回报
- 五、行为保守性不能修复所有模型误差
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子与前置概念 → 二、以模型回报和行为约束塑造扩散分数
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:搜索越努力,可能越会钻价值函数的空子 → 二、以模型回报和行为约束塑造扩散分数
把问题与答案拆开,按推理到检验展开
- 二、背景与定义:不是所有分布差异都是同一件事 → 一、问题设定:模型内搜索怎样避免追逐支持外高估
读者在接触方法前知道优化对象与信息权限
- 三、方法:用模型回报塑造扩散目标 → 三、在模型中估计受约束分数场并摊销进策略
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、行为保守性不能修复所有模型误差:增加候选数量后模型内回报上升但真实回报下降,说明什么?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:9 幅
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图9:左侧改变蒙特卡洛样本数后的训练时间,右侧比较奖励随训练推进的变化。更多候选是否值得,需要把回报改善与计算开销一起读。
实验/结果图 · 必要原图摘引 · HTML S4.F9,图9
左侧改变蒙特卡洛样本数后的训练时间,右侧比较奖励随训练推进的变化。更多候选是否值得,需要把回报改善与计算开销一起读。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图3:图3——漂移与交叉TD误差。 作者报告相对基线更低、更稳定的误差和动作漂移,支持正则化机制。但这些代理指标不是对真实 $Q^\beta$误差的直接测量,更不是证明估计偏差为零。
实验/结果图 · 必要原图摘引 · HTML S3.F3,图3
图3——漂移与交叉TD误差。 作者报告相对基线更低、更稳定的误差和动作漂移,支持正则化机制。但这些代理指标不是对真实 $Q^\beta$误差的直接测量,更不是证明估计偏差为零。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图4:图4、图5——控制成绩。 多任务汇总与视觉控制显示较强表现,支持算法具有广泛仿真适用性。单任务曲线仍需看失败项,整体平均不能证明每个环境获胜,也不能替代真实机器人实验。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
图4、图5——控制成绩。 多任务汇总与视觉控制显示较强表现,支持算法具有广泛仿真适用性。单任务曲线仍需看失败项,整体平均不能证明每个环境获胜,也不能替代真实机器人实验。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图5:读图对应本段的“10个图像控制任务”;图5为每任务5种子。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
读图对应本段的“10个图像控制任务”;图5为每任务5种子。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图6:右侧30任务图中,54M至340M的MBDPO分数为82.4至83.7,TD-MPC2为59.4至71.4;它与原文§4的下降描述存在冲突,不能把这张图解读成规模退化。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
右侧30任务图中,54M至340M的MBDPO分数为82.4至83.7,TD-MPC2为59.4至71.4;它与原文§4的下降描述存在冲突,不能把这张图解读成规模退化。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图7:图7、图8——迁移和能量强度。 预训练帮助少交互适配,但Hopper Hop表现不佳;潜在嵌入偏移是解释线索,不能仅靠图像判定唯一原因。能量系数为0时仍有75.29对基线57.1的优势,说明收益不全来自行为约束;过大系数则压制改善,体现保守性与优化的取舍。
实验/结果图 · 必要原图摘引 · HTML S4.F7,图7
图7、图8——迁移和能量强度。 预训练帮助少交互适配,但Hopper Hop表现不佳;潜在嵌入偏移是解释线索,不能仅靠图像判定唯一原因。能量系数为0时仍有75.29对基线57.1的优势,说明收益不全来自行为约束;过大系数则压制改善,体现保守性与优化的取舍。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图8:图7、图8——迁移和能量强度。 预训练帮助少交互适配,但Hopper Hop表现不佳;潜在嵌入偏移是解释线索,不能仅靠图像判定唯一原因。能量系数为0时仍有75.29对基线57.1的优势,说明收益不全来自行为约束;过大系数则压制改善,体现保守性与优化的取舍。
实验/结果图 · 必要原图摘引 · HTML S4.F8,图8
图7、图8——迁移和能量强度。 预训练帮助少交互适配,但Hopper Hop表现不佳;潜在嵌入偏移是解释线索,不能仅靠图像判定唯一原因。能量系数为0时仍有75.29对基线57.1的优势,说明收益不全来自行为约束;过大系数则压制改善,体现保守性与优化的取舍。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图10:读图对应本段的“候选数与去噪步数”;图9、图10为3种子。
实验/结果图 · 必要原图摘引 · HTML S4.F10,图10
读图对应本段的“候选数与去噪步数”;图9、图10为3种子。
- Scaling World-Model Reinforcement Learning Through Diffusion Policy Optimization,图11:表1与图11——效率与表示。 视觉任务每步时间3.55降至3.04毫秒,是该硬件和流程下的计时结果。二维潜在轨迹更平滑或呈闭环,可能与周期任务结构一致,但降维图不能证明学到了因果动力学,也不能据此宣称基线轨迹物理上无意义。
方法/设定图 · 必要原图摘引 · HTML S5.F11,图11
表1与图11——效率与表示。 视觉任务每步时间3.55降至3.04毫秒,是该硬件和流程下的计时结果。二维潜在轨迹更平滑或呈闭环,可能与周期任务结构一致,但降维图不能证明学到了因果动力学,也不能据此宣称基线轨迹物理上无意义。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用070-tdmpc2.md的具体机制关系替换或补足承上启下阅读链接
- 补入图9的可打开原图及专属图例/坐标/比较条件解读
- 将10处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 10 个原文证据入口
- 图10 · HTML 图10,实际锚点 S4.F10
原站图表/证明入口
- 图11 · HTML 图11,实际锚点 S5.F11
原站图表/证明入口
- 图3 · HTML 图3,实际锚点 S3.F3
原站图表/证明入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 S4.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 S4.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 S4.F9
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。
本次深化
- 用单候选证明回报权重退化
- 解释自归一有限样本偏差
- 分开训练规划成本与部署速度
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用070-tdmpc2.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图9的可打开原图及专属图例/坐标/比较条件解读
- v2:将10处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
式15有限候选加权、式16分数回归、训练与部署计算分离。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F9的图9图注及相关上下文;其余已定位图表见v2逐篇记录。左侧改变蒙特卡洛样本数后的训练时间,右侧比较奖励随训练推进的变化。更多候选是否值得,需要把回报改善与计算开销一起读。
技术关系
- 070-tdmpc2 · 直接继承
沿TD-MPC世界模型核心改造策略优化与部署生成。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习Continuous Reasoning for Vision-Language-Action部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:潜在thought怎样成为可检验的动作条件
- 二、用共享几何与EMA验证约束中间编码
- 三、顺序生成潜在槽并由学生和EMA教师解码
- 四、分开PCA结构、子任务成绩与端到端成功
- 五、相近教师的可读性不证明跨模型通用
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、教学例子:同分布不代表同语义 → 二、用共享几何与EMA验证约束中间编码
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、一分钟理解:让中间表示对另一个模型也有用 → 二、用共享几何与EMA验证约束中间编码
把问题与答案拆开,按推理到检验展开
- 二、背景与设定:思考处在什么抽象层次 → 一、问题设定:潜在thought怎样成为可检验的动作条件
读者在接触方法前知道优化对象与信息权限
- 三、方法:思想槽、共享几何与教师验证 → 三、顺序生成潜在槽并由学生和EMA教师解码
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、相近教师的可读性不证明跨模型通用:怎样区分thought有效是因为结构更好,还是仅多了计算和参数?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:3 幅
- Continuous Reasoning for Vision-Language-Action,图4:同一初始场景、每条指令五次运行后再做PCA投影。轨迹分开支持条件相关性,却不能赋予坐标轴固定推理语义或证明潜代码可任意交换。
实验/结果图 · 必要原图摘引 · HTML S4.F4,图4
同一初始场景、每条指令五次运行后再做PCA投影。轨迹分开支持条件相关性,却不能赋予坐标轴固定推理语义或证明潜代码可任意交换。
- Continuous Reasoning for Vision-Language-Action,图5:图4、图5、图6——潜在轨迹是诊断,不是语义证明。 相同场景改变指令、或将袜子从左扔到右,编码轨迹随任务阶段变化,符合重新定位解释。但PCA压缩可能隐藏差异,动作状态本身也会驱动编码变化;若要证明thought拥有因果作用,需要交换、遮蔽或定向修改编码后检验行为。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
图4、图5、图6——潜在轨迹是诊断,不是语义证明。 相同场景改变指令、或将袜子从左扔到右,编码轨迹随任务阶段变化,符合重新定位解释。但PCA压缩可能隐藏差异,动作状态本身也会驱动编码变化;若要证明thought拥有因果作用,需要交换、遮蔽或定向修改编码后检验行为。
- Continuous Reasoning for Vision-Language-Action,图6:图4、图5、图6——潜在轨迹是诊断,不是语义证明。 相同场景改变指令、或将袜子从左扔到右,编码轨迹随任务阶段变化,符合重新定位解释。但PCA压缩可能隐藏差异,动作状态本身也会驱动编码变化;若要证明thought拥有因果作用,需要交换、遮蔽或定向修改编码后检验行为。
实验/结果图 · 必要原图摘引 · HTML S4.F6,图6
图4、图5、图6——潜在轨迹是诊断,不是语义证明。 相同场景改变指令、或将袜子从左扔到右,编码轨迹随任务阶段变化,符合重新定位解释。但PCA压缩可能隐藏差异,动作状态本身也会驱动编码变化;若要证明thought拥有因果作用,需要交换、遮蔽或定向修改编码后检验行为。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用093-pi05.md的具体机制关系替换或补足承上启下阅读链接
- 补入图4的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图4 · HTML 图4,实际锚点 S4.F4
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 S4.F6
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;HSR真实评估的完整重复次数和独立训练种子尚未确认;阶段分与E2E的差别可以讨论,但不能自行补上标准差或显著性结论。
本次深化
- 计算EMA约115更新的半衰期
- 解释相关教师不能当独立真值
- 提出潜码干预与跨初始化诊断
- v2:删去重复的一行问题—改动—证据汇总表,保留正文机制和边界
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用093-pi05.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图4的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
EMA自验证、衰减0.994、共享潜码及去验证消融定义。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F4的图4图注及相关上下文;其余已定位图表见v2逐篇记录。同一初始场景、每条指令五次运行后再做PCA投影。轨迹分开支持条件相关性,却不能赋予坐标轴固定推理语义或证明潜代码可任意交换。
技术关系
- 093-pi05 · 平行方法
潜在thought接口与语言子任务接口各有信息瓶颈。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- HSR真实评估的完整重复次数和独立训练种子尚未确认;阶段分与E2E的差别可以讨论,但不能自行补上标准差或显著性结论。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习WorldSample: Closed-loop Real-robot RL with World Modelling部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:怎样筛选并限制世界模型合成经验
- 二、让真实校准、局部生成与策略学习异步协作
- 三、按真实经历生成局部反事实并控制入库比例
- 四、把成功率、接管率和训练时间一起对照
- 五、局部幻觉与错误自信仍会污染价值
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、让真实校准、局部生成与策略学习异步协作
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、让真实校准、局部生成与策略学习异步协作
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:怎样筛选并限制世界模型合成经验
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、按真实经历生成局部反事实并控制入库比例
将数学机制与真实更新/执行顺序分成连续两步
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、局部幻觉与错误自信仍会污染价值:合成缓存越来越大时,保持固定采样比例是否就保持了相同信息质量?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:2 幅
- WorldSample: Closed-loop Real-robot RL with World Modelling,图5:同时比较成功率和接管率的消融,观察合成经验是否在减少人工纠正时仍保持效果。成功数增加若依赖更多接管,就不能归因为自主能力同等提高。
实验/结果图 · 必要原图摘引 · HTML S4.F5,图5
同时比较成功率和接管率的消融,观察合成经验是否在减少人工纠正时仍保持效果。成功数增加若依赖更多接管,就不能归因为自主能力同等提高。
- WorldSample: Closed-loop Real-robot RL with World Modelling,图3:图3与图5的学习过程。 图3比较任务曲线,图5比较消融曲线,应结合各自横轴理解何谓更快。真实步数优势与端到端训练时间优势不同,尤其视频生成开销可能使复杂任务墙钟收益变小。曲线支持训练轨迹上的观察,不能单凭形状证明价值过估计是唯一失败原因。
方法/设定图 · 必要原图摘引 · HTML S4.F3,图3
图3与图5的学习过程。 图3比较任务曲线,图5比较消融曲线,应结合各自横轴理解何谓更快。真实步数优势与端到端训练时间优势不同,尤其视频生成开销可能使复杂任务墙钟收益变小。曲线支持训练轨迹上的观察,不能单凭形状证明价值过估计是唯一失败原因。
未在正文展示的图/表与范围
- 表1:表单列记录;本次逐图补齐不把表计为Figure。
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用086-hil-serl.md的具体机制关系替换或补足承上启下阅读链接
- 补入图5的可打开原图及专属图例/坐标/比较条件解读
- 将4处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 4 个原文证据入口
- 图3 · HTML 图3,实际锚点 S4.F3
原站图表/证明入口
- 图5 · HTML 图5,实际锚点 S4.F5
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;版本中的成本百分比与部分机制公式存在口径差异;节省量应分别按分钟、真实交互和人工接管计算,不使用一个百分比代替三者。
本次深化
- 手算30%合成奖励偏差的Bellman固定点
- 反驳低熵自动无偏的普遍解释
- 分开成功率/物理步数/墙钟证据
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用086-hil-serl.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图5的可打开原图及专属图例/坐标/比较条件解读
- v2:将4处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入1幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
熵调度启发式、实际线性近似与30%上限、表1真机结果。
- arxiv.org · 所列章节
v2实际核读:HTML锚点S4.F5的图5图注及相关上下文;其余已定位图表见v2逐篇记录。同时比较成功率和接管率的消融,观察合成经验是否在减少人工纠正时仍保持效果。成功数增加若依赖更多接管,就不能归因为自主能力同等提高。
技术关系
- 086-hil-serl · 直接继承
在HIL-SERL式离策略真机系统中扩展合成经验数据流。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 版本中的成本百分比与部分机制公式存在口径差异;节省量应分别按分钟、真实交互和人工接管计算,不使用一个百分比代替三者。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:辅助深度缺失时怎样保留可用动作路径
- 二、联动模态dropout、专家掩码与动作侧稀疏计算
- 三、联合训练缺失模态路径并选择动作侧专家
- 四、分开路由可视化、成功率与计算估算
- 五、错误但可用的深度仍需质量检测
- 六、沿机制关系继续读
- 七、自测三题与参考答案
段落怎样重新安排
- 七、帮助建立理解 → 二、联动模态dropout、专家掩码与动作侧稀疏计算
先用可检查例子辨认方法作用,再进入训练和实验,避免证据之后才解释机制
- 一、先用一分钟讲明白 → 二、联动模态dropout、专家掩码与动作侧稀疏计算
把问题与答案拆开,按推理到检验展开
- 二、研究背景与问题定义 → 一、问题设定:辅助深度缺失时怎样保留可用动作路径
读者在接触方法前知道优化对象与信息权限
- 三、方法:到底改了什么 → 三、联合训练缺失模态路径并选择动作侧专家
将数学机制与真实更新/执行顺序分成连续两步
- 二、机制开头的提前结果;四、结果图说明与证据2 → 四、分开路由可视化、成功率与计算估算/证据2
先讲dropout与可用性掩码,再用对应有/无深度消融检验联动;数字不在机制和实验反复出现。
- 五、计算规模的一般式;二、0.85手算 → 二、一个值得继续验证的公式细节
变量定义、代入与范围一次讲清;第五节专门讨论错误深度和断流条件。
合并的重复说明
- 移除开头预先重复方法、收益和限制的摘要,将具体论据留在相应章节;内容保留于第二节机制、第四节证据和第五节边界;原非摘要实验范围句已移入第四节。
- 文末重复同一文章关系;内容保留于第六节保留原历史关系段及准确机制分类。
- 表格再次复述同篇已经展开的问题、机制、证据和限制,删整张多行摘要而非换位置。;内容保留于方法节逐项机制;实验节原设置表和带出处结果;边界节原具体限制。
- 删除又一次列举组件或泛称贡献的总结,不删独有推导、任务条件或实验反例。;内容保留于第二节方法及其原具体步骤;后继阅读关系。
- 与证据2重复报告同一95.6→91.2及97.6→97.0结果。;内容保留于四、证据2;保留成对行号、全部原数字、单独dropout反例和跨传感器边界,表12图块原样移动。。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 五、错误但可用的深度仍需质量检测:专家负载均衡改善后,为什么不能直接说专家已形成有用分工?
- 四、分开路由可视化、成功率与计算估算:在解释dropout与推理掩码后,一次性读取成对消融并保留反例;删除提前报成绩和重复数字。
- 四、分开路由可视化、成功率与计算估算:区分逐时刻专家dispatch占比与token×CoRE层选择热图,并用视频40→60帧作受限阶段对照。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 仅将文末标题“八、三个问题及答案”改为“八、自测三题与参考答案”;三道问题与答案原文、位置和顺序均不变。
与此前问答的对应
与20bb192逐题比对,三道问题及答案逐字保留。 本轮没有删除、合并、新增或挪用正文问题;文末三题全部保留。
正文配图:11 幅
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图13:token 0为本体状态、1–32为动作查询、33–48为未来动作token;专家也分通用与模态专属。按这个图例读热图,不能把“少更新一部分token”当成少执行动作。
实验/结果图 · 必要原图摘引 · HTML A3.F13,图13
token 0为本体状态、1–32为动作查询、33–48为未来动作token;专家也分通用与模态专属。按这个图例读热图,不能把“少更新一部分token”当成少执行动作。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,表12:表12让缺失深度结论可直接核对:第3、4行去掉推理深度时从95.6降到91.2,第11、12行完整设计从97.6降到97.0。只在相应成对配置内比较;路由热图提供过程线索,不能替代这个任务结果消融。
实验/结果图 · 必要原图摘引 · PDF第19页,表12
表12让缺失深度结论可直接核对:第3、4行去掉推理深度时从95.6降到91.2,第11、12行完整设计从97.6降到97.0。只在相应成对配置内比较;路由热图提供过程线索,不能替代这个任务结果消融。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图6:横轴为环境时间步,纵轴为12个专家编号;颜色编码使用比例。逐列比较派发随时间的变化,不能把专家编号直接解释成独立动作概念。
实验/结果图 · 必要原图摘引 · HTML A3.F6,图6
横轴为环境时间步,纵轴为12个专家编号;颜色编码使用比例。逐列比较派发随时间的变化,不能把专家编号直接解释成独立动作概念。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图7:每根柱是一个专家的汇总使用比例;它展示整体负载分布,不能替代图6逐时间步的路由变化。
实验/结果图 · 必要原图摘引 · HTML A3.F7,图7
每根柱是一个专家的汇总使用比例;它展示整体负载分布,不能替代图6逐时间步的路由变化。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图8:每个时刻同时给出观察帧、专家使用柱形图和各层路由热图;按0、40至256步的顺序对齐阅读,避免把任务进展与单个专家编号直接等同。
实验/结果图 · 必要原图摘引 · HTML A3.F8,图8
每个时刻同时给出观察帧、专家使用柱形图和各层路由热图;按0、40至256步的顺序对齐阅读,避免把任务进展与单个专家编号直接等同。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图9:每行是一条完整任务指令,每列是专家编号,虚线分开通用专家与深度/模态专家。颜色是归一化使用量,跨行比较路由模式而非任务成功率。
实验/结果图 · 必要原图摘引 · HTML A3.F9,图9
每行是一条完整任务指令,每列是专家编号,虚线分开通用专家与深度/模态专家。颜色是归一化使用量,跨行比较路由模式而非任务成功率。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图10:各行保持黑碗操作主题、改变空间位置描述;热图比较不同指令的专家使用分布。颜色尺度表示路由使用量,不是空间定位误差。
实验/结果图 · 必要原图摘引 · HTML A3.F10,图10
各行保持黑碗操作主题、改变空间位置描述;热图比较不同指令的专家使用分布。颜色尺度表示路由使用量,不是空间定位误差。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图11:各行更换放入篮子的目标物体,列仍为相同专家;同一目标动作下比较不同物体的路由分布,不能据热图给专家赋予确定语义。
实验/结果图 · 必要原图摘引 · HTML A3.F11,图11
各行更换放入篮子的目标物体,列仍为相同专家;同一目标动作下比较不同物体的路由分布,不能据热图给专家赋予确定语义。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图12:各行包含开关柜门、操作炉灶和移动物体等目标;虚线两侧属于不同专家组。观察路由差异时须结合右侧色标,不把颜色深浅当执行质量。
实验/结果图 · 必要原图摘引 · HTML A3.F12,图12
各行包含开关柜门、操作炉灶和移动物体等目标;虚线两侧属于不同专家组。观察路由差异时须结合右侧色标,不把颜色深浅当执行质量。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图14:32个专家按环境时间步展开,颜色标出使用比例;与12专家设置相比,专家数和轨迹长度均不同,不能只凭热图更密就推断策略更强。
实验/结果图 · 必要原图摘引 · HTML A3.F14,图14
32个专家按环境时间步展开,颜色标出使用比例;与12专家设置相比,专家数和轨迹长度均不同,不能只凭热图更密就推断策略更强。
- CoRE-VLA: Towards Scalable and Robust Vision-Language-Action Modeling via Conditional Routing of Experts,图15:柱形图汇总32个专家的使用比例,部分专家负载较高;它是路由分布诊断,不是32项独立技能的准确率。
实验/结果图 · 必要原图摘引 · HTML A3.F15,图15
柱形图汇总32个专家的使用比例,部分专家负载较高;它是路由分布诊断,不是32项独立技能的准确率。
未在正文展示的图/表与范围
图形核验覆盖本页所选原图及其直接解读;未重新复现论文实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- 用080-octo.md的具体机制关系替换或补足承上启下阅读链接
- 补入图13的可打开原图及专属图例/坐标/比较条件解读
- 将22处不同图表证据连接到实际原文位置,取消孤立图表号
查看本篇 22 个原文证据入口
- 图10 · HTML 图10,实际锚点 A3.F10
原站图表/证明入口
- 图11 · HTML 图11,实际锚点 A3.F11
原站图表/证明入口
- 图12 · HTML 图12,实际锚点 A3.F12
原站图表/证明入口
- 图13 · HTML 图13,实际锚点 A3.F13
原站图表/证明入口
- 图14 · HTML 图14,实际锚点 A3.F14
原站图表/证明入口
- 图15 · HTML 图15,实际锚点 A3.F15
原站图表/证明入口
- 图6 · HTML 图6,实际锚点 A3.F6
原站图表/证明入口
- 图7 · HTML 图7,实际锚点 A3.F7
原站图表/证明入口
- 图8 · HTML 图8,实际锚点 A3.F8
原站图表/证明入口
- 图9 · HTML 图9,实际锚点 A3.F9
原站图表/证明入口
- 表1 · HTML 表1,实际锚点 S4.T1
原站图表/证明入口
- 表10 · HTML 表10,实际锚点 A1.T10
原站图表/证明入口
- 表11 · HTML 表11,实际锚点 A1.T11
原站图表/证明入口
- 表12 · HTML 表12,实际锚点 A2.T12
原站图表/证明入口
- 表2 · HTML 表2,实际锚点 S4.T2
原站图表/证明入口
- 表3 · HTML 表3,实际锚点 S4.T3
原站图表/证明入口
- 表4 · HTML 表4,实际锚点 A1.T4
原站图表/证明入口
- 表5 · HTML 表5,实际锚点 A1.T5
原站图表/证明入口
- 表6 · HTML 表6,实际锚点 A1.T6
原站图表/证明入口
- 表7 · HTML 表7,实际锚点 A1.T7
原站图表/证明入口
- 表8 · HTML 表8,实际锚点 A1.T8
原站图表/证明入口
- 表9 · HTML 表9,实际锚点 A1.T9
原站图表/证明入口
本轮边界:本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。;图像保留在原论文站点,仅提供外部查看链接;未转载、重绘或仿造实验曲线。;专家配置的表述口径及线性选择器是否具有直接条件作用仍需结合代码核验;路由热图本身不能证明某个专家的因果语义。
本次深化
- 以70/30计算解释整体加速上限
- 区分激活计算、存储和时延
- 限定与Octo/π0专家设计的关系
- v2:移除阅读范围套话,将实质版本/统计限制并入相应图表或机制说明
- v2:用080-octo.md的具体机制关系替换或补足承上启下阅读链接
- v2:补入图13的可打开原图及专属图例/坐标/比较条件解读
- v2:将22处不同图表证据连接到实际原文位置,取消孤立图表号
- inline-v2:正文加入2幅已目检的原论文图形摘引,具备本地放大、原文定位、具体alt与读法。
查核资料
- arxiv.org · 所列章节
条件计算容量、路由开销与整体FLOPs边界、模态专家掩码。
- arxiv.org · 所列章节
v2实际核读:HTML锚点A3.F13的图13图注及相关上下文;其余已定位图表见v2逐篇记录。token 0为本体状态、1–32为动作查询、33–48为未来动作token;专家也分通用与模态专属。按这个图例读热图,不能把“少更新一部分token”当成少执行动作。
技术关系
- 080-octo · 平行方法
都适应输入模态,但模块token接口与稀疏路由设计不同。
仍需留意
- 本轮实际核读所列图表图注、定位和相关上下文,审查全部自测与进阶回答;未重新通读全部附录、逐项复核所有原稿数字或运行复现。
- 专家配置的表述口径及线性选择器是否具有直接条件作用仍需结合代码核验;路由热图本身不能证明某个专家的因果语义。
- inline-v2:仅内嵌所选核心图形,其他证据入口及未内嵌原因见逐篇图像记录。
机器人学习系列总结|从学习动作到让机器人可靠行动部分核验,边界见下
本次深化
- 推导条件成功率乘积且不假设独立
- 新增单位成功耗时手算并列明重试条件
- 增加三组从前作瓶颈出发的可证伪实验问题
- v2:将阅读范围模板改为三组可直接阅读的图表口径案例
- v2:将总结中的四条机制回环改成具体文章链接,保留三个综合问答
- v2:为三条前作瓶颈追问补充不重复自测的参考答案、条件判断与公平实验设计
查核资料
技术关系
- 073-mobile-aloha · 教学联系
分阶段分母与系统可靠性
- 097-mbdpo · 教学联系
训练部署计算分账
仍需留意
- 本轮审查辅助文中的问题是否有答案、来源使用说明与机制阅读链接;没有在辅助文层再次完整审计100篇全部实验或运行复现。
机器人学习机器人学习:从运动基元到视觉语言动作模型部分核验,边界见下
本次深化
- 加入六条问题驱动短阅读路线及学习检查点
- 区分数据物理来源与在线/离线使用方式
- 明确本轮节段核读而非全附录审计
- v2:删除指向旧阅读范围模板的说明,改为原图使用方式与运动—分布—时序的具体阅读路径
查核资料
技术关系
- 00-reading-guide · 教学联系
补齐接口概念再进入专题
- 00-发展时间线总览 · 教学联系
方向关系由时间线与正文进一步解释
仍需留意
- 本轮审查辅助文中的问题是否有答案、来源使用说明与机制阅读链接;没有在辅助文层再次完整审计100篇全部实验或运行复现。
机器人经典Day 0|机器人经典基础阅读入门:让坐标、估计、规划与控制接起来部分核验,边界见下
本次深化
- 加入像素—深度—时间—净空的一阶误差传播教学链
- 区分确定误差界与方差、采集时刻与处理时刻
- 用模块接口说明局部精度不能替代闭环安全
查核资料
- modernrobotics.northwestern.edu · 所列章节
官方文字讲解中变换的三种用途、组合及逆
技术关系
- 042-zhang-calibration · 模块组合
内参连接像素和三维位置
- 044-slam-convergence · 模块组合
估计相关性进入误差传播
- 067-ompl · 模块组合
带模型误差检查规划净空
仍需留意
- 未执行本篇提出的教学实验;各原始论文的证据缺口仍以单篇阅读范围为准。
机器人经典机器人经典基础发展时间线:从几何表示到完整自主系统部分核验,边界见下
本次深化
- 新增四条带关系类型的历史分叉路线
- 纠正RRT-Connect到RRT*的非单线谱系
- 区分历史年代与运行中的信息时序
查核资料
- lavalle.pl · 所列章节
原作者说明RRT与其变体关系
- cdn.aaai.org · 所列章节
条件于轨迹的路标分解
- dair.seas.upenn.edu · 所列章节
相关工作区分直接约束与CIO罚项
技术关系
- 040-rrt · 历史背景
分叉路线起点
- 045-fastslam · 平行方法
与GraphSLAM的不同后验表示
- 075-contact-trajopt · 平行方法
与CIO接触罚项对照
仍需留意
- 未执行本篇提出的教学实验;各原始论文的证据缺口仍以单篇阅读范围为准。
机器人经典A Kinematic Notation for Lower-Pair Mechanisms Based on Matrices部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:编码器角度怎样变成夹爪位姿
- 二、固定坐标约定,再把四个变换乘开
- 三、沿运动链实现递推,并用两连杆查错
- 四、读图检验矩阵方向,再核对原文证据
- 五、从理想刚体走向标定与闭环约束
- 六、追问:两条运动链到达同一工具时,怎样检查闭环几何是否一致?
- 七、沿几何表示继续走向速度与动力学
- 八、自测与参考答案
段落怎样重新安排
- 一、一分钟理解 → 一、问题设定:编码器角度怎样变成夹爪位姿
先定义输入输出,避免一分钟摘要重复正文
- 三、方法与公式:把局部关系按顺序组合 → 二、固定坐标约定,再把四个变换乘开
先说明表示,再解释乘法方向
- 三、方法与公式:把局部关系按顺序组合/五、教学例子:两根平面连杆 → 三、沿运动链实现递推,并用两连杆查错
把实现与可算的查错例子连接起来
- 三、方法与公式:把局部关系按顺序组合/四、证据怎样理解 → 四、读图检验矩阵方向,再核对原文证据
分清教学代数检查与原论文实验
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复概述表示贡献与坐标约定成本;内容保留于问题设定、坐标约定推导与边界节。
- 单行总览重复正文,不承担新的事实或公式;内容保留于问题设定与第五节,原证据局限保留。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:两条运动链到达同一工具时,怎样检查闭环几何是否一致?:两条运动链到达同一工具时,怎样检查闭环几何是否一致?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 3.3.1 Homogeneous Transformation Matrices
描述与全文转录:变换方向、下标对消、左右乘与点坐标
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- D–H 手算:平移必须跟着局部坐标轴转;这张图把正文的 90° 例子投影到 xy 平面,两点的高度都为 1
教学示意 · 原创教学图 · 本文原创手算/几何推导;右列为什么
这张图把正文的 90° 例子投影到 xy 平面,两点的高度都为 1。局部 x 轴已经指向世界 y,故沿局部 x 再走一步应增加世界 y;不能把平移列直接当作世界 x 位移。
原版全文/原图核验缺口仍保留;本次原创教学图不冒充原论文图,也不填补原实验核验缺口。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
本轮边界:原版主体/原图访问缺口仍在;不虚构原图页码,教学推导不冒充原始实验;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 固定点坐标映射方向并展开标准D-H矩阵
- 加入局部点与逆变换可手算检查;修复两处数学定界符
- 区分D-H/指数积平行表示与雅可比模块组合
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- cir.nii.ac.jp · 摘要
出版社原摘要的Crossref镜像:表示方法与两个空间机构例证
- doi.org · 未能读取
原版主体全文无法取得;摘要/后续教材证据不能替代原论文实验
技术关系
- 004-resolved-rate · 模块组合
局部变换提供雅可比所需轴与位置
- 011-brockett · 平行方法
同一运动链的不同几何参数化
仍需留意
- 原版全文仍未取得,矩阵与数值例均是现代标准D-H教学推导
机器人经典A New Approach to Linear Filtering and Prediction Problems列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:历史观测怎样压缩为可递推的状态信念
- 二、从误差正交性推导预测与创新增益
- 三、实现协方差更新,检查标量融合的权重
- 四、用重复观测图辨认虚假信息,再读原文定理
- 五、检查统计失配、多峰后验与不可观测方向
- 六、追问:同一观测复制两份后,怎样设计检验才能暴露重复计数?
- 七、把协方差传入空间关系,或改用多峰表示
- 八、自测与参考答案
段落怎样重新安排
- 二、从观测到状态:首先明确隐藏量 → 一、问题设定:历史观测怎样压缩为可递推的状态信念
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、预测与校正为什么能够分开 → 四、用重复观测图辨认虚假信息,再读原文定理
把可视证据与实验条件/证据局限放在同一节
- 三、预测与校正为什么能够分开 → 三、实现协方差更新,检查标量融合的权重
把求解机制与每步执行顺序分开检验
- 三、预测与校正为什么能够分开 → 二、从误差正交性推导预测与创新增益
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、原文证据:理论论文该看哪里 → 四、用重复观测图辨认虚假信息,再读原文定理
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、教学例子:预测与测量各信多少 → 三、实现协方差更新,检查标量融合的权重
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、局限与延伸 → 五、检查统计失配、多峰后验与不可观测方向
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:历史观测怎样压缩为可递推的状态信念
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从误差正交性推导预测与创新增益
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 二、从误差正交性推导预测与创新增益:在本文现有模型上补一段可逐步验算的单位、坐标或尺度推导,明确不是新增实验。
- 六、追问:同一观测复制两份后,怎样设计检验才能暴露重复计数?:同一观测复制两份后,怎样设计检验才能暴露重复计数?
教法来源与实际阅读范围
- Simo Särkkä · Bayesian Filtering and Smoothing (2013)
§4.2–4.3 PDF74–78页的预测/更新与Kalman推导;§7.1–7.4 PDF136–144页的样本表示、重要性与重采样;另读§7.5 PDF149–151页条件线性高斯分解与RBPF
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Kalman:重复观测怎样制造虚假的确定性;柱长是本文手算的方差,不是采样实验
教学示意 · 原创教学图 · 本文原创手算/几何推导;原创教学反例
柱长是本文手算的方差,不是采样实验。一次独立观测把 1 变为 1/2;把副本当独立数据才会错误地报告 1/3。复制数据没有带来对应的真实信息增加。
选择原创重复观测反例辅助解释协方差;未将原文预测例子重画成实验曲线。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 在相关机制/实验段补明本篇特有的证据条件
- 为最优线性递推补入 Theorem 3 原页入口
- 将理论空标签融入状态压缩、误差正交和创新递推的连贯解释,并补原页链接
查看本篇 4 个原文证据入口
- Theorem 3:递推与协方差方程 · PDF 第 7 页,Theorem 3
原站图表/证明入口
- 引言:状态递推动机 · PDF 第 1 页,引言:状态递推动机
原站图表/证明入口
- 最优估计与正交投影 · PDF 第 3 页,最优估计与正交投影
原站图表/证明入口
- 原文预测例子 · PDF 第 9 页,原文预测例子
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从后验误差协方差求导得到增益
- 明确线性最优与高斯后验的条件差别
- 给出相关测量修正式与重复观测过度自信例
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 在相关机制/实验段补明本篇特有的证据条件
- 为最优线性递推补入 Theorem 3 原页入口
- 将理论空标签融入状态压缩、误差正交和创新递推的连贯解释,并补原页链接
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cs.cmu.edu · 所列章节
Optimal Estimates、Orthogonal Projections与状态/协方差递推
- www.cs.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 017-uncertain-map · 直接继承
后作承接本篇:将协方差线性估计传播到空间关系网络
机器人经典A Formal Basis for the Heuristic Determination of Minimum Cost Paths部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:图上的最短路怎样同时利用已走代价和目标下界
- 二、用g+h排序,并逐项检查重开与终止条件
- 三、实现开放表,再用两条候选路径检查停止时机
- 四、把最优性证明与原稿算法步骤对照
- 五、保留状态模型、内存和启发质量的限制
- 六、追问:把一个可采纳但不一致的启发换成一致启发,改变的是哪项实现责任?
- 七、为搜索补上几何,再让旧搜索可以修复
- 八、自测与参考答案
段落怎样重新安排
- 二、问题定义:图上的最优不等于机器人的最优 → 一、问题设定:图上的最短路怎样同时利用已走代价和目标下界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、评价函数与搜索流程 → 三、实现开放表,再用两条候选路径检查停止时机
把求解机制与每步执行顺序分开检验
- 三、评价函数与搜索流程 → 二、用g+h排序,并逐项检查重开与终止条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、为什么找到的是最短路 → 二、用g+h排序,并逐项检查重开与终止条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、回到原文:算法保证的条件在哪里 → 四、把最优性证明与原稿算法步骤对照
把可视证据与实验条件/证据局限放在同一节
- 五、回到原文:算法保证的条件在哪里 → 二、用g+h排序,并逐项检查重开与终止条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、教学例子与失败边界 → 三、实现开放表,再用两条候选路径检查停止时机
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:图上的最短路怎样同时利用已走代价和目标下界
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用g+h排序,并逐项检查重开与终止条件
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:把一个可采纳但不一致的启发换成一致启发,改变的是哪项实现责任?:把一个可采纳但不一致的启发换成一致启发,改变的是哪项实现责任?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Fig. 1:从 s 直接到 n₂ 的边成本为 7,经 n₁ 的成本是 3+3=6
方法/设定图 · 必要原图摘引 · Fig. 1,PDF 第 3 页;裁切框为原页比例 (0.63, 0.055, 0.88, 0.215)
从 s 直接到 n₂ 的边成本为 7,经 n₁ 的成本是 3+3=6。这个小图把“更晚发现的路径更便宜”画了出来,解释为什么重开与更新不能因节点已经出现过而被省略。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将重开规则及评价函数解释直接连接到原始算法页
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 1 个原文证据入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 增加可采纳但不一致启发的逐步重开反例
- 将原稿第102页重开步骤与实现正确性对齐
- 明确构型空间组合与势场平行方法
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将重开规则及评价函数解释直接连接到原始算法页
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- ai.stanford.edu · 所列章节
第102页原始扫描的Search Algorithm A*、评价函数及重开规则
技术关系
- 009-configuration-space · 模块组合
构型空间提供合法图模型
- 014-potential-field · 平行方法
局部连续梯度与图搜索不同
仍需留意
- 本次重点视觉复核第102页;1972勘误未核读
机器人经典Resolved Motion Rate Control of Manipulators and Human Prostheses部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:夹爪的速度意图怎样分配成各关节速度
- 二、从正运动学求导,区分局部逆映射与全局逆解
- 三、逐周期重算雅可比,用两连杆验证协调运动
- 四、区分现代雅可比教学图与1969原文证据
- 五、追踪奇异放大、积分漂移与执行器限速
- 六、追问:若把控制周期加倍,同一瞬时雅可比解还能保证同样的末端路径吗?
- 七、从奇异速度指令走向任务力矩
- 八、自测与参考答案
段落怎样重新安排
- 二、从位置关系到速度关系 → 一、问题设定:夹爪的速度意图怎样分配成各关节速度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、逆映射及其实际含义 → 三、逐周期重算雅可比,用两连杆验证协调运动
把求解机制与每步执行顺序分开检验
- 三、逆映射及其实际含义 → 二、从正运动学求导,区分局部逆映射与全局逆解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、教学例子:两连杆如何配合向上走 → 四、区分现代雅可比教学图与1969原文证据
把可视证据与实验条件/证据局限放在同一节
- 四、教学例子:两连杆如何配合向上走 → 三、逐周期重算雅可比,用两连杆验证协调运动
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、证据能支持到哪里 → 四、区分现代雅可比教学图与1969原文证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、为什么后来需要奇异鲁棒逆解 → 五、追踪奇异放大、积分漂移与执行器限速
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:夹爪的速度意图怎样分配成各关节速度
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从正运动学求导,区分局部逆映射与全局逆解
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:若把控制周期加倍,同一瞬时雅可比解还能保证同样的末端路径吗?:若把控制周期加倍,同一瞬时雅可比解还能保证同样的末端路径吗?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 8.6 Dynamics in the Task Space
全文转录:V=Jqdot及其求导、任务惯性与姿态依赖
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- 任务速度:两个关节反向运动,末端直向上;蓝、橙箭头是两个关节在当前构型产生的速度贡献,绿色是合成速度
教学示意 · 原创教学图 · 本文原创手算/几何推导;在 $q_1=0
蓝、橙箭头是两个关节在当前构型产生的速度贡献,绿色是合成速度。水平方向抵消只在此刻的雅可比下成立,持续运动后必须重新计算。
原版全文/原图核验缺口仍保留;本次原创教学图不冒充原论文图,也不填补原实验核验缺口。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
本轮边界:原版主体/原图访问缺口仍在;不虚构原图页码,教学推导不冒充原始实验;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 用转轴叉积逐列构造几何雅可比
- 区分工具点线速度与空间旋量及索引
- 从功率推出J转置力映射并建立准确关系链接
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- doi.org · 书目信息
原文出版对象;全文受限
- modernrobotics.northwestern.edu · 所列章节
现代空间雅可比与旋量约定
- doi.org · 未能读取
原版主体全文无法取得;摘要/后续教材证据不能替代原论文实验
技术关系
- 001-dh · 模块组合
运动学提供关节轴位置
- 007-hybrid-force · 模块组合
速度与力的对偶接口
- 016-damped-ik · 直接继承
后作承接本篇:处理微分逆运动学奇异性
仍需留意
- 1969原文实验全文未取得;新增公式为现代教学推导
机器人经典On-Line Computational Scheme for Mechanical Manipulators部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:给定关节运动后怎样在线求出驱动力矩
- 二、向外传播运动,再向内回传力与力矩
- 三、实现两遍递推,用水平静杆检查重力项
- 四、结合原版勘误阅读递推证据与教学图
- 五、核对外力符号、惯性坐标与刚体假设
- 六、追问:只用静止水平杆测试通过,为什么仍不能确认速度相关项正确?
- 七、反求加速度,或在线修正未知参数
- 八、自测与参考答案
段落怎样重新安排
- 二、逆动力学究竟解什么 → 一、问题设定:给定关节运动后怎样在线求出驱动力矩
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、两次递推:运动向外,受力向内 → 四、结合原版勘误阅读递推证据与教学图
把可视证据与实验条件/证据局限放在同一节
- 三、两次递推:运动向外,受力向内 → 三、实现两遍递推,用水平静杆检查重力项
把求解机制与每步执行顺序分开检验
- 三、两次递推:运动向外,受力向内 → 二、向外传播运动,再向内回传力与力矩
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、为什么不必显式形成完整惯性矩阵 → 二、向外传播运动,再向内回传力与力矩
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、原文证据与现代检验 → 四、结合原版勘误阅读递推证据与教学图
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、教学例子:一根静止水平杆 → 三、实现两遍递推,用水平静杆检查重力项
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、局限与前置概念 → 五、核对外力符号、惯性坐标与刚体假设
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:给定关节运动后怎样在线求出驱动力矩
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、向外传播运动,再向内回传力与力矩
将场景、机制和证据范围分别放回实际论证位置
- 原版勘误与复现版本 → 四、结合原版勘误阅读递推证据与教学图
在解释原实验前交代版本边界
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:只用静止水平杆测试通过,为什么仍不能确认速度相关项正确?:只用静止水平杆测试通过,为什么仍不能确认速度相关项正确?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 8.3 Newton-Euler Inverse Dynamics
转录开头:连杆坐标、向外运动、向内力矩与关节输入
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Newton–Euler 回传:末端负载也改变根部力矩;箭头标出各重力的真实作用点
教学示意 · 原创教学图 · 本文原创手算/几何推导;原创静态回传例
箭头标出各重力的真实作用点。新增末端载荷对两个关节的力臂分别为 2 m 和 1 m,因此需要增加 20 与 10 N·m,不能只在第二关节补力矩。
原版全文/原图核验缺口仍保留;本次原创教学图不冒充原论文图,也不填补原实验核验缺口。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
本轮边界:原版主体/原图访问缺口仍在;不虚构原图页码,教学推导不冒充原始实验;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推出空间力转置回传及功率守恒
- 加入两连杆静态载荷回传数值检查
- 区分逆动力学、前向动力学和参数自适应
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- cir.nii.ac.jp · 摘要
原作者摘要的递推结构与历史实现说明
- royfeatherstone.org · 所列章节
后续现代ID算法的空间向量接口
- doi.org · 未能读取
原版主体全文无法取得;摘要/后续教材证据不能替代原论文实验
技术关系
- 010-featherstone · 平行方法
相同刚体模型的互补前向动力学算法
- 019-adaptive-control · 模块组合
逆动力学可作为模型前馈的计算模块
仍需留意
- 1980主体全文和完整计时设置未取得;新增递推为现代形式
机器人经典Random Sample Consensus: A Paradigm for Model Fitting with Applications to Image Analysis and Automated Cartography列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:粗大错误对应怎样避免主导几何拟合
- 二、从最小样本到一致集合,推算成功抽样概率
- 三、执行假设验证循环,比较不同最小样本数
- 四、读直线反例与相机定位实验的支持范围
- 五、检查残差单位、退化样本与多模型歧义
- 六、追问:若测量分辨率改变,RANSAC阈值和成功概率能否原样沿用?
- 七、把鲁棒采样接到具体几何求解器
- 八、自测与参考答案
段落怎样重新安排
- 二、噪声和错误对应不是同一件事 → 一、问题设定:粗大错误对应怎样避免主导几何拟合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、算法机制与概率直觉 → 三、执行假设验证循环,比较不同最小样本数
把求解机制与每步执行顺序分开检验
- 三、算法机制与概率直觉 → 二、从最小样本到一致集合,推算成功抽样概率
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何验证 → 四、读直线反例与相机定位实验的支持范围
把可视证据与实验条件/证据局限放在同一节
- 四、实验如何验证 → 四、读直线反例与相机定位实验的支持范围
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、教学例子:样本数为什么如此重要 → 三、执行假设验证循环,比较不同最小样本数
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、局限与实现要点 → 五、检查残差单位、退化样本与多模型歧义
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:粗大错误对应怎样避免主导几何拟合
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从最小样本到一致集合,推算成功抽样概率
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:若测量分辨率改变,RANSAC阈值和成功概率能否原样沿用?:若测量分辨率改变,RANSAC阈值和成功概率能否原样沿用?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Table I:按列区分三种统计量:最终一致集的对应点数、考察过的三元组数,以及求出的相机位置数
实验/结果图 · 必要原图摘引 · Table I,PDF 第 10 页;裁切框为原页比例 (0.5, 0.03, 0.93, 0.287)
按列区分三种统计量:最终一致集的对应点数、考察过的三元组数,以及求出的相机位置数。内点比例 w 变低时,搜索负担会变大;一致集大小是点数,不是生成一致集的次数。
- Fischler与Bolles(1981)图1的直线拟合、逐次最小二乘结果和残差表;点7是粗大错误
方法/设定图 · 必要原图摘引 · Fig. 1, PDF page 2
上方散点与下方逐次剔除记录要一起读:最大残差剔除会先删掉正确点,最后保留错误点7。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、表 I
查看本篇 2 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 表 I · PDF 第 10 页,Table I
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导有限数据不放回抽样的精确概率
- 增加19轮与17轮预算教学对照
- 区分抽中全内点、几何可用与最终正确事件
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、表 I
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.sri.com · 所列章节
第383–385页算法、概率次数与可接受一致集条件
- www.sri.com · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 021-horn · 模块组合
鲁棒抽样可以包裹最小二乘配准
- 023-harris · 模块组合
特征检测不会自动消除错误对应
机器人经典Hybrid Position/Force Control of Manipulators列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:擦拭任务怎样分别指定切向运动和法向力
- 二、统一任务坐标,再选择互补的力与位置误差
- 三、实现两路反馈,检查桌面高度误差的后果
- 四、把平面接触实验、扰动与图中响应对应起来
- 五、约束接触几何、反馈延迟与动态范围
- 六、追问:任务坐标系随曲面法向转动时,固定选择矩阵为什么不够?
- 七、继续设计交互关系与任务动力学
- 八、自测与参考答案
段落怎样重新安排
- 二、自然约束和人为目标 → 一、问题设定:擦拭任务怎样分别指定切向运动和法向力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:先统一坐标,再选择误差 → 三、实现两路反馈,检查桌面高度误差的后果
把求解机制与每步执行顺序分开检验
- 三、方法:先统一坐标,再选择误差 → 二、统一任务坐标,再选择互补的力与位置误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何建立证据 → 四、把平面接触实验、扰动与图中响应对应起来
把可视证据与实验条件/证据局限放在同一节
- 四、实验如何建立证据 → 四、把平面接触实验、扰动与图中响应对应起来
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、教学例子:桌面位置估错时会怎样 → 三、实现两路反馈,检查桌面高度误差的后果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与边界 → 五、约束接触几何、反馈延迟与动态范围
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:擦拭任务怎样分别指定切向运动和法向力
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、统一任务坐标,再选择互补的力与位置误差
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:任务坐标系随曲面法向转动时,固定选择矩阵为什么不够?:任务坐标系随曲面法向转动时,固定选择矩阵为什么不够?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 11.6 Hybrid Motion-Force Control
门把手与擦白板例子、刚性约束及力/运动子空间
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:6 幅
- Fig. 7:下方实线对应 1、5、10 N 力阶跃,5 N 的虚线是仿真;上方位置曲线只记录了 10 N 阶跃时的位置保持
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 6 页;原页比例裁切框 (0.49, 0.055, 0.925, 0.3435);底部另加 18 px 白边以完整保留 TIME (sec) 轴标题
下方实线对应 1、5、10 N 力阶跃,5 N 的虚线是仿真;上方位置曲线只记录了 10 N 阶跃时的位置保持。把这两种来源和设置分清,才不会把一条位置轨迹误读成所有目标力下的共同结果。
- Raibert与Craig(1981)图1:转曲柄与拧螺丝两种任务的约束坐标、自然约束和人工约束
方法/设定图 · 必要原图摘引 · Fig. 1, PDF page 2
两个面板的允许运动与作用力不同,约束方向取决于接触任务。
- Raibert与Craig(1981)图2:位置反馈、力反馈、坐标变换及共同驱动机械臂的混合控制结构
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 3
两路误差经过各自坐标变换和控制器,最后作用于同一台机械臂。
- Raibert与Craig(1981)图3:Scheinman机械臂两个关节与数控X-Y反作用台的平面实验布局
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 4
图中反作用表面的位置与手部接触方向说明了力和位置实验各自受控的方向。
- Raibert与Craig(1981)图4:机械臂和腕部Maltese Cross力传感器的结构
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 4
右侧放大图标出应变片位置;此处展示传感器结构,并非控制响应曲线。
- Raibert与Craig(1981)图8:台面退让扰动下的X方向力、Y方向位置和X方向台面位移三条时间曲线
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 6
从下方台面位移上升的区间,对照上方力和位置响应,才能读出退让扰动的影响。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 7、图 8
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 6 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 7 · PDF 第 6 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 6 页,Figure 8
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从法向构造互补投影并解释功率正交
- 加入倾斜接触面可手算数值例
- 区分六维对偶变换及混合/阻抗/操作空间关系
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 7、图 8
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- fab.cba.mit.edu · 所列章节
自然与人工约束、Hybrid Controller及双自由度实现段落
- fab.cba.mit.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 004-resolved-rate · 模块组合
速度运动学接口
- 018-operational-space · 模块组合
为任务方向控制加入动力学
- 013-impedance · 平行方法
力运动关系控制不同于方向分工
机器人经典An Iterative Image Registration Technique with an Application to Stereo Vision列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:小图像窗口的位移怎样由亮度变化求出
- 二、线性化亮度残差,求解局部梯度正规方程
- 三、执行迭代配准,用退化纹理检查可解方向
- 四、把教学纹理图与原始迭代配准实验分开读
- 五、检查大位移、遮挡与亮度模型失配
- 六、追问:图像没有移动却整体变亮,LK会怎样把光照误差误读成位移?
- 七、从可解窗口走向特征筛选与监控
- 八、自测与参考答案
段落怎样重新安排
- 二、把“图像相似”变成一个可优化问题 → 一、问题设定:小图像窗口的位移怎样由亮度变化求出
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、局部线性化如何给出更新 → 三、执行迭代配准,用退化纹理检查可解方向
把求解机制与每步执行顺序分开检验
- 三、局部线性化如何给出更新 → 二、线性化亮度残差,求解局部梯度正规方程
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、原实验怎样使用迭代配准 → 四、把教学纹理图与原始迭代配准实验分开读
把可视证据与实验条件/证据局限放在同一节
- 四、原实验怎样使用迭代配准 → 四、把教学纹理图与原始迭代配准实验分开读
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、教学例子:有梯度不一定有两个方向的信息 → 三、执行迭代配准,用退化纹理检查可解方向
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、代价、失败情形与三维联系 → 五、检查大位移、遮挡与亮度模型失配
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:小图像窗口的位移怎样由亮度变化求出
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、线性化亮度残差,求解局部梯度正规方程
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:图像没有移动却整体变亮,LK会怎样把光照误差误读成位移?:图像没有移动却整体变亮,LK会怎样把光照误差误读成位移?
教法来源与实际阅读范围
- OpenCV官方文档作者团队 · Optical Flow
Optical Flow及Lucas-Kanade method:亮度恒常、Taylor展开、邻域最小二乘和金字塔;现代接口例子仅作为实现参照
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Figs. 5–8:图 5→6 在低频带做了 7 次深度调整;图 7→8 改用高一倍的频带,人工新增 5 个点,再做 5 次调整
实验/结果图 · 必要原图摘引 · Figs. 5–8,PDF 第 6 页;裁切框为原页比例 (0.06, 0.21, 0.45, 0.865)
图 5→6 在低频带做了 7 次深度调整;图 7→8 改用高一倍的频带,人工新增 5 个点,再做 5 次调整。这不是四张图按同一设置逐步变清晰:频带、点集与迭代次数都必须一并比较。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 5、图 6、图 7、图 8
查看本篇 4 个原文证据入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 6 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 6 页,Figure 8
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 展开三个像素的正规方程并手算更新
- 补充Gauss–Newton省略二阶残差项的条件
- 把实际残差验收与结构张量/鲁棒后端区分
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 5、图 6、图 7、图 8
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- publications.ri.cmu.edu · 所列章节
本地下载六页会议版并视觉复核第676页正规方程/多维化与679页人工引导实验
- publications.ri.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 023-harris · 教学联系
同一梯度二阶矩阵揭示可观测方向
- 006-ransac · 模块组合
后端几何一致性检查
机器人经典Spatial Planning: A Configuration Space Approach列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:机身尺寸与姿态怎样变成搜索的禁区
- 二、从刚体放置推导反射与Minkowski和
- 三、实现构型碰撞查询,用门口旋转检验表示
- 四、核对原文几何构造与教学示意的覆盖范围
- 五、区分无碰撞构型、动力学可执行性与表示规模
- 六、追问:若只预计算一个朝向的障碍膨胀,能否用于任意转向的机器人?
- 七、按需查询距离,再采样高维自由空间
- 八、自测与参考答案
段落怎样重新安排
- 二、工作空间与构型空间有什么不同 → 一、问题设定:机身尺寸与姿态怎样变成搜索的禁区
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、关键公式:为什么要反射机器人的形状 → 三、实现构型碰撞查询,用门口旋转检验表示
把求解机制与每步执行顺序分开检验
- 三、关键公式:为什么要反射机器人的形状 → 二、从刚体放置推导反射与Minkowski和
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、几何结构为什么带来算法收益 → 二、从刚体放置推导反射与Minkowski和
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、原文证据地图 → 四、核对原文几何构造与教学示意的覆盖范围
把可视证据与实验条件/证据局限放在同一节
- 五、原文证据地图 → 四、核对原文几何构造与教学示意的覆盖范围
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、教学例子:门够宽,为什么仍过不去 → 三、实现构型碰撞查询,用门口旋转检验表示
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、边界:无碰撞不等于可执行 → 五、区分无碰撞构型、动力学可执行性与表示规模
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:机身尺寸与姿态怎样变成搜索的禁区
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、核对原文几何构造与教学示意的覆盖范围
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:若只预计算一个朝向的障碍膨胀,能否用于任意转向的机器人?:若只预计算一个朝向的障碍膨胀,能否用于任意转向的机器人?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 4:图里移动的是整个物体 A,但碰撞检验被改写为参考点是否进入扩大后的禁区
方法/设定图 · 必要原图摘引 · Fig. 4,PDF 第 4 页;裁切框为原页比例 (0.065, 0.08, 0.5, 0.265)
图里移动的是整个物体 A,但碰撞检验被改写为参考点是否进入扩大后的禁区。这里保持朝向不变,不能省略旋转自由度后仍声称覆盖任意刚体运动。
- Lozano-Pérez(1983)图1:放置问题与找路问题的二维几何示例
方法/设定图 · 必要原图摘引 · Fig. 1, PDF page 2
上下面板分别要求找到一个合法放置位置与一条连续无碰撞路径,二者的任务不同。
- Lozano-Pérez(1983)图2:固定姿态物体A相对障碍B的构型障碍区域
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 3
阴影区域表示参考点不能进入的区域,已把移动物体的尺寸计入。
- Lozano-Pérez(1983)图3:原空间找路和构型障碍中的参考点路径
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 3
路径绕过扩张后的构型障碍,而不是只检验一个忽略形状的点是否碰到原障碍。
- Lozano-Pérez(1983)图7:凸多边形按边法向顺序合并构造形状差
方法/设定图 · 必要原图摘引 · Fig. 7, PDF page 5
图中的边法向次序对应凸多边形的合并步骤,线性复杂度依赖凸性条件。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 7
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 5 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 3 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 用非对称一维形状检验Minkowski反射与边界
- 推导朝向切片并量化旋转穿门失败
- 区分地图估计、构型建模、搜索与距离查询模块
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 7
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- lis.csail.mit.edu · 所列章节
本地读取期刊原稿第111页Theorem1/2及切片近似段落
- dspace.mit.edu · 摘要
1980技术报告的官方记录,用于区分版本
- lis.csail.mit.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 025-occupancy · 模块组合
栅格估计工作空间障碍
- 003-astar · 模块组合
构型合法性支持图搜索
- 022-gilbert-distance · 模块组合
按需距离查询替代完整显式禁区
机器人经典The Calculation of Robot Dynamics Using Articulated-Body Inertias部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:给定力矩后怎样求出开放链的关节加速度
- 二、消去子机构自由度,形成铰接体惯量
- 三、执行递推恢复,用自由与锁死关节作对照
- 四、读复杂度论证并区分原文与现代教学实现
- 五、检查关节约束、模型拓扑与数值退化
- 六、追问:不形成完整惯性矩阵,能否计算它的逆对一个向量的作用?
- 七、把开放链动力学接到任务与接触
- 八、自测与参考答案
段落怎样重新安排
- 二、与逆动力学的区别 → 一、问题设定:给定力矩后怎样求出开放链的关节加速度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、铰接体惯量到底是什么 → 四、读复杂度论证并区分原文与现代教学实现
把可视证据与实验条件/证据局限放在同一节
- 三、铰接体惯量到底是什么 → 三、执行递推恢复,用自由与锁死关节作对照
把求解机制与每步执行顺序分开检验
- 三、铰接体惯量到底是什么 → 二、消去子机构自由度,形成铰接体惯量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、证据与比较应如何读 → 四、读复杂度论证并区分原文与现代教学实现
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、教学例子:自由关节与锁死关节 → 三、执行递推恢复,用自由与锁死关节作对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、边界与数值问题 → 五、检查关节约束、模型拓扑与数值退化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:给定力矩后怎样求出开放链的关节加速度
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、消去子机构自由度,形成铰接体惯量
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:不形成完整惯性矩阵,能否计算它的逆对一个向量的作用?:不形成完整惯性矩阵,能否计算它的逆对一个向量的作用?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- 铰接体惯量:允许子关节运动,等效惯性就变了;左右不是两种近似精度,而是自由与锁死两种不同边界条件
教学示意 · 原创教学图 · 本文原创手算/几何推导;第二行给出
左右不是两种近似精度,而是自由与锁死两种不同边界条件。Schur 补消去可运动的内部自由度;锁死后则必须保留约束反力,不能沿用自由关节的加速度。
原版全文/原图核验缺口仍保留;本次原创教学图不冒充原论文图,也不填补原实验核验缺口。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
本轮边界:原版主体/原图访问缺口仍在;不虚构原图页码,教学推导不冒充原始实验;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 加入2x2 Schur补数值推导及锁死反力
- 对照作者FDab源代码补齐偏置力与已知力矩回传
- 区分铰接体惯量与操作空间任务惯量
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- doi.org · 未能读取
原版全文仍未取得
- royfeatherstone.org · 全文
现代ABA三遍源码、Schur补和偏置递推
技术关系
- 005-newton-euler · 平行方法
互补的逆/前向动力学问题
- 018-operational-space · 教学联系
不同层次的有效惯量
仍需留意
- 后续作者代码不能替代1983原文实验和计时表
机器人经典Robotic Manipulators and the Product of Exponentials Formula部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同一运动链怎样从零位关节轴建立正运动学
- 二、把螺旋轴指数化,再按关节次序组合
- 三、实现指数积,用偏置转轴检查平移分量
- 四、区分表示推导、教学图与原文证据
- 五、保留坐标约定、非交换性与真实奇异结构
- 六、追问:只交换两个矩阵指数的次序,为什么通常不是同一台机械臂的等价写法?
- 七、用几何微分结构评价能力与控制
- 八、自测与参考答案
段落怎样重新安排
- 问题设定与必要假设 → 一、问题设定:同一运动链怎样从零位关节轴建立正运动学
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:从无穷小运动到有限运动 → 四、区分表示推导、教学图与原文证据
把可视证据与实验条件/证据局限放在同一节
- 方法:从无穷小运动到有限运动 → 三、实现指数积,用偏置转轴检查平移分量
把求解机制与每步执行顺序分开检验
- 方法:从无穷小运动到有限运动 → 二、把螺旋轴指数化,再按关节次序组合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 证据怎样阅读 → 四、区分表示推导、教学图与原文证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:一个偏置转轴 → 三、实现指数积,用偏置转轴检查平移分量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、成本与边界 → 五、保留坐标约定、非交换性与真实奇异结构
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:同一运动链怎样从零位关节轴建立正运动学
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把螺旋轴指数化,再按关节次序组合
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解:先记录轴,再组合运动 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:只交换两个矩阵指数的次序,为什么通常不是同一台机械臂的等价写法?:只交换两个矩阵指数的次序,为什么通常不是同一台机械臂的等价写法?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 4.1.1 Product of Exponentials
全文转录:零位M、转轴线速度分量与从末端到基座的解释
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- 指数积的偏置轴:平移列不是末端位置;圆弧绕 (1,0) 而不是世界原点旋转
教学示意 · 原创教学图 · 本文原创手算/几何推导;对于无螺距转轴
圆弧绕 (1,0) 而不是世界原点旋转。指数变换的平移列为 (1,−1),必须再加旋转后的初始点,才得到终点 (1,1);二者的物理意义不能混淆。
原版全文/原图核验缺口仍保留;本次原创教学图不冒充原论文图,也不填补原实验核验缺口。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
本轮边界:原版主体/原图访问缺口仍在;不虚构原图页码,教学推导不冒充原始实验;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 展开旋转与平移矩阵指数并化简偏置转轴
- 把既有数值例补齐中间平移列
- 加入非交换检查并澄清论文身份与关系
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- doi.org · 未能读取
1984原始章节本次仍无法取得
- modernrobotics.northwestern.edu · 所列章节
零位空间轴与逆序构造推导
技术关系
- 001-dh · 平行方法
同一运动链的替代表示
- 004-resolved-rate · 模块组合
微分产生速度雅可比
- 012-manipulability · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
仍需留意
- 官方教材只验证现代推导,不能替代1984章节原证明与例证
机器人经典Manipulability of Robotic Mechanisms列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同一末端位置附近哪些运动方向更困难
- 二、把关节速度球映成椭球,再解释体积指标
- 三、计算奇异方向,用二连杆构型作对照
- 四、区分机构例题与普遍任务成功率
- 五、检查坐标尺度和单一标量丢失的方向信息
- 六、追问:速度椭球短轴方向,为什么在同一关节力矩预算下可能更能施力?
- 七、从方向能力诊断走向阻尼与惯性
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:需要先说清“容易”是什么 → 一、问题设定:同一末端位置附近哪些运动方向更困难
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 从速度球推导椭球 → 三、计算奇异方向,用二连杆构型作对照
把求解机制与每步执行顺序分开检验
- 从速度球推导椭球 → 二、把关节速度球映成椭球,再解释体积指标
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 理论与机构例题提供了哪些证据 → 四、区分机构例题与普遍任务成功率
把可视证据与实验条件/证据局限放在同一节
- 理论与机构例题提供了哪些证据 → 四、区分机构例题与普遍任务成功率
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:二连杆手臂为何不宜伸直 → 三、计算奇异方向,用二连杆构型作对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与边界 → 五、检查坐标尺度和单一标量丢失的方向信息
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:同一末端位置附近哪些运动方向更困难
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把关节速度球映成椭球,再解释体积指标
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、区分机构例题与普遍任务成功率
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:速度椭球短轴方向,为什么在同一关节力矩预算下可能更能施力?:速度椭球短轴方向,为什么在同一关节力矩预算下可能更能施力?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 5.4 Manipulability
全文转录:速度球、JJᵀ特征轴、速度力对偶及单位
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:8 幅
- Figs. 8–9:左图把最大可操作度随指尖位置的变化画成等值结构,右图对比两连杆的最佳姿态
方法/设定图 · 必要原图摘引 · Figs. 8–9,PDF 第 7 页;裁切框为原页比例 (0.065, 0.055, 0.935, 0.355)
左图把最大可操作度随指尖位置的变化画成等值结构,右图对比两连杆的最佳姿态。读图时应同时追踪位置与机构参数,不能把一个标量当成所有方向上的性能。
- 据二连杆正运动学独立绘制的关节和末端几何图
方法/设定图 · 原创教学图 · Yoshikawa 1985 Fig.1 and Eq.(22)–(23), PDF p3
这是图1所用二转动关节模型的几何重绘,连杆姿态仅为示意;长度和角度进入同一正运动学,操纵度为两长度乘积再乘肘角正弦的绝对值。
- 原创运动学重绘:SCARA: R–R–P–R structure
方法/设定图 · 原创教学图 · Yoshikawa 1985 Fig.2, Eq.(24), PDF p4
独立重绘保留了图2的两个平面转动关节、竖直移动关节和末端旋转关节结构;竖直移动与末端旋转不改变该模型中平面两杆决定的操纵度因子。
- 原创运动学重绘:PUMA: first three joints
方法/设定图 · 原创教学图 · Yoshikawa 1985 Fig.3, Eq.(25), PDF p4
独立重绘对应图3忽略腕部尺寸后的前三个转动关节模型;第一轴改变整条手臂绕竖直轴的方位,末端到该轴的距离会进入操纵度。
- 由式29独立计算的三种PUMA连杆比例及最优肘角
方法/设定图 · 依据公开数据/公式重绘 · Yoshikawa 1985 Fig.4 and Eq.(27)–(29), PDF p5
按原文公式重算,三种连杆比的最优肘角均小于90度;不同于仅考虑平面二连杆面积,第一轴的力臂也影响此处最优姿态。
- 按式31至33独立重算的四关节手指平面子问题最大操纵度曲线
方法/设定图 · 依据公开数据/公式重绘 · Yoshikawa 1985 Fig.6 and Eq.(31)–(33), PDF p6
这条曲线由原文连杆长度和雅可比公式独立重算,不是原图描摹或实验数据;在接近完全伸直的1.1长度边界,平面子问题退化使该指标降为零。
- 给定十种末端距离后独立优化得到的手指关节姿态
方法/设定图 · 依据公开数据/公式重绘 · Yoshikawa 1985 Fig.7 and Eq.(31)–(33), PDF p6
每小图对应一个固定末端距离,三段连杆长度完全相同;姿态由同一理论优化得到,镜像等价解可能不同于原图朝向,不能据此当作真实手指运动测量。
- Yoshikawa图8完整等值线及坐标边界
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 7
补齐旧合图中被截的下方等值线和1.1坐标边界;这是原文在指尖位置平面上给出的最大操纵度,不能把等值线高度当成关节角。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 6、图 7、图 8、图 9、图 5
查看本篇 9 个原文证据入口
- 图 1 · PDF 第 3 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 6 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 7 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 7 页,Figure 9
原站图表/证明入口
- 图 5 · PDF 第 5 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 区分指定方向径向能力和最大投影并手算
- 通过变量替换推导加权速度椭球
- 解释归一化与运动学/动力学能力边界
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 6、图 7、图 8、图 9、图 5
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- tsuneo-yoshikawa.my.coocan.jp · 所列章节
下载视觉复核第4页式6–18的SVD、椭球和尺度归一化
- tsuneo-yoshikawa.my.coocan.jp · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 004-resolved-rate · 教学联系
同一雅可比的能力诊断
- 016-damped-ik · 教学联系
奇异值弱方向与阻尼响应
- 018-operational-space · 模块组合
任务动力学补充运动学能力
机器人经典Impedance Control: An Approach to Manipulation—Part I: Theory列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:接触时怎样设计偏离参考运动的力响应
- 二、把机器人与环境的交互写成阻抗关系
- 三、落实质量阻尼刚度关系,用墙面误差检验
- 四、读Part I理论证据,区分动态关系与实机保证
- 五、检查物理可实现性、采样与环境耦合
- 六、追问:期望刚度翻倍而阻尼不变,目标自由响应的阻尼比怎样变化?
- 七、把期望交互关系放进动力学实现
- 八、自测与参考答案
段落怎样重新安排
- 为什么位置与力不能任意同时指定 → 一、问题设定:接触时怎样设计偏离参考运动的力响应
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法的两层含义 → 三、落实质量阻尼刚度关系,用墙面误差检验
把求解机制与每步执行顺序分开检验
- 方法的两层含义 → 二、把机器人与环境的交互写成阻抗关系
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 原文的五处证据 → 四、读Part I理论证据,区分动态关系与实机保证
把可视证据与实验条件/证据局限放在同一节
- 原文的五处证据 → 四、读Part I理论证据,区分动态关系与实机保证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:墙的位置估计偏了一厘米 → 三、落实质量阻尼刚度关系,用墙面误差检验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、成本与失败边界 → 五、检查物理可实现性、采样与环境耦合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:接触时怎样设计偏离参考运动的力响应
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把机器人与环境的交互写成阻抗关系
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、读Part I理论证据,区分动态关系与实机保证
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解:手要柔顺,但不能失去支撑 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:期望刚度翻倍而阻尼不变,目标自由响应的阻尼比怎样变化?:期望刚度翻倍而阻尼不变,目标自由响应的阻尼比怎样变化?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 11.2.2.2 Second-Order Error Dynamics
全文转录:自然频率、阻尼比、根与瞬态响应
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 7:多个阻抗元件共享同一运动端口,各分支的作用力相加
方法/设定图 · 必要原图摘引 · Fig. 7,PDF 第 6 页;裁切框为原页比例 (0.5, 0.03, 0.925, 0.263)
多个阻抗元件共享同一运动端口,各分支的作用力相加。这张连接图说明可组合的是端口关系,并不保证互相冲突的多个任务目标都能同时精确达到。
- 原论文图2:二连杆机构及对应运动学变换的键合图
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 3
从端点位移到关节运动不总是单值可逆,不能把此端口随意当成受控力源。
- 原论文图3:三连杆机构及对应运动学变换的键合图
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 3
增加内部自由度改变了端口关系;上下图应作为同一机构的几何与因果表示一起读。
- 原论文图4:纯力控制与阻抗控制的两种键合图连接
方法/设定图 · 必要原图摘引 · Fig. 4, PDF page 4
下方面板加入阻抗关系,比较的是端口结构,而不是两组实验精度。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 2、图 4、图 7
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 3 个原文证据入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 7 · PDF 第 6 页,Figure 7
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导固定参考阻抗储能导数与被动性条件
- 加入静态偏移/欠阻尼/临界阻尼手算例
- 限定非线性阻抗叠加与控制器组合的差别
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 2、图 4、图 7
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- bpb-us-e1.wpmucdn.com · 所列章节
Causality与第6页Superposition of Impedances及Summary
- bpb-us-e1.wpmucdn.com · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 007-hybrid-force · 平行方法
方向分工与端口关系两种设计
- 018-operational-space · 模块组合
动力学支持阻抗实现
机器人经典Real-Time Obstacle Avoidance for Manipulators and Mobile Robots列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:新障碍出现时怎样立即生成局部避让动作
- 二、从吸引与排斥势求梯度,再映射到机械作用
- 三、执行局部反馈,用非目标极小值作反例
- 四、读双层控制与动态仿真,区分演示和保证
- 五、检查局部极小、感知误差与动力学限制
- 六、追问:高层规划已经给出路线,为什么仍不能直接删掉势场的失败检查?
- 七、约束势函数结构,或保留方向直方图
- 八、自测与参考答案
段落怎样重新安排
- 它解决的是哪个层次的问题 → 一、问题设定:新障碍出现时怎样立即生成局部避让动作
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把标量代价的梯度变成作用 → 三、执行局部反馈,用非目标极小值作反例
把求解机制与每步执行顺序分开检验
- 方法:把标量代价的梯度变成作用 → 二、从吸引与排斥势求梯度,再映射到机械作用
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 原文证据:从势函数到双层控制系统 → 四、读双层控制与动态仿真,区分演示和保证
把可视证据与实验条件/证据局限放在同一节
- 原文证据:从势函数到双层控制系统 → 四、读双层控制与动态仿真,区分演示和保证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构反例:下降不意味着到达目标 → 三、执行局部反馈,用非目标极小值作反例
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失效情形 → 五、检查局部极小、感知误差与动力学限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:新障碍出现时怎样立即生成局部避让动作
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、读双层控制与动态仿真,区分演示和保证
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:高层规划已经给出路线,为什么仍不能直接删掉势场的失败检查?:高层规划已经给出路线,为什么仍不能直接删掉势场的失败检查?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Fig. 2:沿连杆的重叠姿态追踪四自由度机构在围栏中的运动:控制作用需要照顾整条手臂,而不只是末端点
实验/结果图 · 必要原图摘引 · Fig. 2,PDF 第 5 页;裁切框为原页比例 (0.5, 0.07, 0.93, 0.385)
沿连杆的重叠姿态追踪四自由度机构在围栏中的运动:控制作用需要照顾整条手臂,而不只是末端点。图是给定场景的动态仿真序列,不是全局无局部极小的保证。
- 原论文图3:人工势场实时障碍避让的双层控制系统框图
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 7
框图把较高层目标协调与较低层实时作用分开,不能由它推出全局规划完备性。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3
查看本篇 2 个原文证据入口
- 图 2 · PDF 第 5 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 7 页,Figure 3
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 展开距离势梯度的符号和量级
- 增加离散负梯度仍发散的手算反例
- 从原稿动力学映射区分高层规划与局部场组合
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- khatib.stanford.edu · 所列章节
视觉复核第93页式17–20及第96页COSMOS实机与分层频率
- khatib.stanford.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 018-operational-space · 直接继承
后作承接本篇:同作者操作空间动力学框架的专文发展
- 003-astar · 模块组合
全局中间目标与局部避障
- 022-gilbert-distance · 模块组合
凸物体距离查询
- 009-configuration-space · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
机器人经典A Robust Layered Control System for a Mobile Robot列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:高层规划未完成时怎样保留基础避障能力
- 二、以异步行为分层,明确消息抑制和覆盖范围
- 三、运行行为模块,用探索停顿检验底层响应
- 四、读仿真与实体系统,检查模块组合的证据
- 五、区分可增量构建与全局任务保证
- 六、追问:若高层模块持续发送过时输出,底层仍在运行是否足以保证避障?
- 七、继续比较地图路线与通信基础设施
- 八、自测与参考答案
段落怎样重新安排
- 背景:功能分解与行为分解的区别 → 一、问题设定:高层规划未完成时怎样保留基础避障能力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 机制:谁可以覆盖哪条消息 → 三、运行行为模块,用探索停顿检验底层响应
把求解机制与每步执行顺序分开检验
- 机制:谁可以覆盖哪条消息 → 二、以异步行为分层,明确消息抑制和覆盖范围
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验与证据:关注模块组合而非单一准确率 → 四、读仿真与实体系统,检查模块组合的证据
把可视证据与实验条件/证据局限放在同一节
- 实验与证据:关注模块组合而非单一准确率 → 四、读仿真与实体系统,检查模块组合的证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:探索模块突然停顿 → 三、运行行为模块,用探索停顿检验底层响应
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价和思想边界 → 五、区分可增量构建与全局任务保证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:高层规划未完成时怎样保留基础避障能力
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、以异步行为分层,明确消息抑制和覆盖范围
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、读仿真与实体系统,检查模块组合的证据
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:若高层模块持续发送过时输出,底层仍在运行是否足以保证避障?:若高层模块持续发送过时输出,底层仍在运行是否足以保证避障?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 9:细线轨迹在房间内折返并避开墙体,展示低层 wander 与避障的组合结果
实验/结果图 · 必要原图摘引 · Fig. 9,PDF 第 8 页;裁切框为原页比例 (0.5, 0.37, 0.925, 0.686)
细线轨迹在房间内折返并避开墙体,展示低层 wander 与避障的组合结果。这里没有全局地图上的最短路目标,轨迹绕行不能据此被误解为最优规划失败。
- 原论文图5:Subsumption的第0层控制系统:声呐、碰撞、逃离与转向模块
方法/设定图 · 必要原图摘引 · Fig. 5, PDF page 6
沿声呐输出追踪到避碰及转向接口,可见低层行为自身已有闭环。
- 原论文图6:在第0层上叠加第1层wander模块的控制连线
方法/设定图 · 必要原图摘引 · Fig. 6, PDF page 7
上方wander产生的方向进入avoid,新增行为仍需通过底层避障环路。
- 原论文图7:在第0、1层上进一步叠加第2层视觉探索与路径控制
方法/设定图 · 必要原图摘引 · Fig. 7, PDF page 7
框图上部的视觉与目标模块连接到既有底层,连线体现扩展关系。
- 原论文图8:含墙面镜面反射和不返回情况的十二束模拟声呐
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 8
射线不会全都垂直反射回机器人,这正是本例的非理想感知条件。
- 原论文图10:机器人受高层目标指引后穿过房间的两个轨迹面板
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 9
上下两条路径对应不同高层场景指引;到达目标前仍经过障碍边缘的绕行。
- 原论文图11:MIT AI Lab用于分层行为控制实验的实体移动机器人
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 9
这张设备图证明实物平台存在;机外计算的范围仍应以正文说明为准。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 5、图 6、图 7、图 8、图 9、图 10、图 11
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 7 个原文证据入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 7 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 8 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 8 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 9 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 9 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 加入替代有效期、独立停止线及超时恢复事件轨迹
- 依据原稿明确被抑制消息丢失而非排队
- 补充故障注入证据边界与势场/搜索组合关系
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 5、图 6、图 7、图 8、图 9、图 10、图 11
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.robolabo.etsit.upm.es · 所列章节
本次成功下载期刊全文并核模块消息语义、第V节仿真与实机
- www.robolabo.etsit.upm.es · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 014-potential-field · 模块组合
Avoid模块可以使用斥力机制
- 003-astar · 模块组合
后续混合设计中长程目标输入
- 025-occupancy · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
机器人经典Inverse Kinematic Solutions With Singularity Robustness for Robot Manipulator Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:奇异附近怎样避免不可执行的巨大关节速度
- 二、加入正则化,按奇异方向解释逆增益
- 三、计算阻尼逆解,用最弱方向手算误差
- 四、区分理论、仿真主张与未核实数值
- 五、检查跟踪偏差、硬限位与碰撞约束
- 六、追问:单纯增大阻尼能否同时解决关节硬限位和碰撞?
- 七、在动态一致性与任务优先级中处理约束
- 八、自测与参考答案
段落怎样重新安排
- 问题设定:病态与无解不是同一件事 → 一、问题设定:奇异附近怎样避免不可执行的巨大关节速度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把两个相互冲突的要求放进一个目标 → 四、区分理论、仿真主张与未核实数值
把可视证据与实验条件/证据局限放在同一节
- 方法:把两个相互冲突的要求放进一个目标 → 三、计算阻尼逆解,用最弱方向手算误差
把求解机制与每步执行顺序分开检验
- 方法:把两个相互冲突的要求放进一个目标 → 二、加入正则化,按奇异方向解释逆增益
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 理论与仿真怎样判断 → 四、区分理论、仿真主张与未核实数值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构数值例子:最弱方向到底发生了什么 → 三、计算阻尼逆解,用最弱方向手算误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失败情形 → 五、检查跟踪偏差、硬限位与碰撞约束
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:奇异附近怎样避免不可执行的巨大关节速度
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、区分理论、仿真主张与未核实数值
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:单纯增大阻尼能否同时解决关节硬限位和碰撞?:单纯增大阻尼能否同时解决关节硬限位和碰撞?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- 阻尼逆解:抑制放大,同时牺牲任务速度;曲线由正文解析公式直接计算,不是原论文仿真曲线
教学示意 · 原创教学图 · 本文原创手算/几何推导;当 $\sigma_i$ 很小
曲线由正文解析公式直接计算,不是原论文仿真曲线。橙线在零附近发散,蓝线的峰值被 5 限制;右侧数值同时展示关节速度下降与任务速度损失。
原版全文/原图核验缺口仍保留;本次原创教学图不冒充原论文图,也不填补原实验核验缺口。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
本轮边界:原版主体/原图访问缺口仍在;不虚构原图页码,教学推导不冒充原始实验;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 补齐二次目标求导与两种线性系统等价关系
- 定量计算阻尼零空间泄漏反例
- 区分总速度范数界、逐关节硬限速与动态投影
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- doi.org · 未能读取
原刊全文访问403
- cir.nii.ac.jp · 摘要
Crossref原摘要镜像核SR-inverse近似运动、性质与仿真范围
技术关系
- 004-resolved-rate · 直接继承
本篇发展局部速度逆映射的奇异鲁棒求解
- 012-manipulability · 教学联系
同一奇异值几何诊断
- 018-operational-space · 教学联系
动力学投影条件不同
仍需留意
- 原文SR-inverse权重/调度与仿真仍未核实,新增推导为标准等权DLS教学模型
机器人经典On the Representation and Estimation of Spatial Uncertainty列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:带误差的空间关系串联后应报告怎样的不确定性
- 二、对合成、求逆和融合进行一阶误差传播
- 三、实现坐标与协方差运算,用穿门风险作检查
- 四、对照Monte Carlo与非高斯反例读置信图
- 五、保留相关性,辨认一阶近似失效
- 六、追问:两点各自位置误差都很大,它们的相对距离误差能很小吗?
- 七、追踪联合地图相关性,或改变空间表示
- 八、自测与参考答案
段落怎样重新安排
- 场景与问题定义 → 一、问题设定:带误差的空间关系串联后应报告怎样的不确定性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三种运算:合成、反向、融合 → 三、实现坐标与协方差运算,用穿门风险作检查
把求解机制与每步执行顺序分开检验
- 三种运算:合成、反向、融合 → 二、对合成、求逆和融合进行一阶误差传播
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 证据与实验设定 → 四、对照Monte Carlo与非高斯反例读置信图
把可视证据与实验条件/证据局限放在同一节
- 证据与实验设定 → 四、对照Monte Carlo与非高斯反例读置信图
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:相同位置误差,不同穿门风险 → 三、实现坐标与协方差运算,用穿门风险作检查
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与限制 → 五、保留相关性,辨认一阶近似失效
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:带误差的空间关系串联后应报告怎样的不确定性
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、对合成、求逆和融合进行一阶误差传播
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、对合成、求逆和融合进行一阶误差传播
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解:坐标变换也会带着误差旅行 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:两点各自位置误差都很大,它们的相对距离误差能很小吗?:两点各自位置误差都很大,它们的相对距离误差能很小吗?
教法来源与实际阅读范围
- Simo Särkkä · Bayesian Filtering and Smoothing (2013)
§4.2–4.3 PDF74–78页的预测/更新与Kalman推导;§7.1–7.4 PDF136–144页的样本表示、重要性与重采样;另读§7.5 PDF149–151页条件线性高斯分解与RBPF
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 5:上方近似椭圆的点云与下方弯月状点云要对照着看:角度不确定性经非线性坐标变换后,分布形状可能脱离高斯族
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 10 页;裁切框为原页比例 (0.135, 0.195, 0.895, 0.6)
上方近似椭圆的点云与下方弯月状点云要对照着看:角度不确定性经非线性坐标变换后,分布形状可能脱离高斯族。协方差接近并不等于置信椭圆的概率解释仍准确。
- 图1:世界坐标W与机器人位置L1至L4之间的变换链及不确定性椭圆
方法/设定图 · 必要原图摘引 · 图 1, PDF page 2
沿实线读相邻位姿的变换,再对照相对世界坐标的虚线;椭圆表达的是关系的不确定性,不能只把各段均值相加。
- 图2:两种三角形变换合成,第二种需要先反向B
方法/设定图 · 必要原图摘引 · 图 2, PDF page 5
两幅三角形的端点相同,但B的方向不同;右图必须先求反向关系,再进行合成,反向操作也必须传播协方差。
- 图3:带横向边C的四节点变换网络
方法/设定图 · 必要原图摘引 · 图 3, PDF page 7
横向的C把两条路径耦合起来;仅靠串联合成与并联合并,无法把这个桥式网络直接压缩成任意两点的一条关系。
- 图4:桥式关系图的三角形到Y形变换
方法/设定图 · 必要原图摘引 · 图 4, PDF page 8
对照虚线的三角关系与中心新增的Y形分支;这是网络约化的具体构造,图形变简单不等于已经解决任意拓扑的联合估计。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 5
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 4 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 5 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 7 页,Figure 3
原站图表/证明入口
- 图 5 · PDF 第 10 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 用共享原点例同时演示差分方差与融合方差
- 补写航向到横向误差的雅可比中间项
- 核对原文相关块与静态Kalman融合条件
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 5
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- people.csail.mit.edu · 所列章节
第3节58–60页误差传播、非零交叉块条件与第4节静态Kalman融合
- people.csail.mit.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 002-kalman · 直接继承
本篇明确使用静态Kalman融合方程
- 025-occupancy · 平行方法
关系协方差和单元占据概率不同表示
机器人经典A Unified Approach for Motion and Force Control of Robot Manipulators: The Operational Space Formulation列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同样的末端力为何在不同构型产生不同加速度
- 二、把关节惯性映成任务惯性,构造动态一致分解
- 三、实现任务力矩映射,用冗余一维任务验算
- 四、分别读解耦、受约束运动与COSMOS系统证据
- 五、检查模型失准、雅可比秩与执行器能力
- 六、追问:所有关节都匀速时,末端加速度为什么仍可能不为零?
- 七、继续组织多个任务与全身约束
- 八、自测与参考答案
段落怎样重新安排
- 问题定义与对照方法 → 一、问题设定:同样的末端力为何在不同构型产生不同加速度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把关节惯性“投影”成末端惯性 → 三、实现任务力矩映射,用冗余一维任务验算
把求解机制与每步执行顺序分开检验
- 方法:把关节惯性“投影”成末端惯性 → 二、把关节惯性映成任务惯性,构造动态一致分解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 原文证据:解耦、内部运动和真实控制系统 → 四、分别读解耦、受约束运动与COSMOS系统证据
把可视证据与实验条件/证据局限放在同一节
- 原文证据:解耦、内部运动和真实控制系统 → 四、分别读解耦、受约束运动与COSMOS系统证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:两个关节共同完成一维任务 → 三、实现任务力矩映射,用冗余一维任务验算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失效边界 → 五、检查模型失准、雅可比秩与执行器能力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:同样的末端力为何在不同构型产生不同加速度
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把关节惯性映成任务惯性,构造动态一致分解
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、分别读解耦、受约束运动与COSMOS系统证据
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:所有关节都匀速时,末端加速度为什么仍可能不为零?:所有关节都匀速时,末端加速度为什么仍可能不为零?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 8.6 Dynamics in the Task Space
全文转录:V=Jqdot及其求导、任务惯性与姿态依赖
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 5:左侧叠加机构姿态,右侧画对应运动量随时间的变化;它们共同展示奇异构型附近的运动处理
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 10 页;裁切框为原页比例 (0.215, 0.07, 0.825, 0.313)
左侧叠加机构姿态,右侧画对应运动量随时间的变化;它们共同展示奇异构型附近的运动处理。单条轨迹的平滑表现不能替代其他任务方向与惯性参数下的分析。
- 图1:接触约束下末端五、四、三个运动自由度的三种几何情形
方法/设定图 · 必要原图摘引 · 图 1, PDF page 2
依次对照(a)、(b)、(c)与接触面的关系;任务坐标应描述实际允许的运动,受约束方向还需要单独指定接触力。
- 图2:沿槽单自由度运动、约束力方向与两个坐标系
方法/设定图 · 必要原图摘引 · 图 2, PDF page 3
先看槽方向,再看力箭头和任务坐标系;位置与力的选择矩阵只有在约定坐标系后才有明确含义。
- 图4:冗余机械臂稳定化过程与最终构型两个面板
实验/结果图 · 必要原图摘引 · 图 4, PDF page 9
左图叠加不同姿态,右图给出稳定后的构型;末端任务完成后,零空间内的关节运动仍需要控制。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 4、图 5
查看本篇 4 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 9 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 10 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 用最小动能约束推导惯性加权逆
- 展开动态一致等式的抵消步骤
- 为既有反例补上正确零空间力矩数值对照
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 4、图 5
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- khatib.stanford.edu · 所列章节
视觉复核第50页Lemma、式55–68与冗余内部运动稳定性
- khatib.stanford.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 004-resolved-rate · 直接继承
本篇承接前作:从几何任务速度映射发展到动态一致任务控制
- 013-impedance · 模块组合
任务动力学用于实现期望端口行为
- 050-task-priority · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
机器人经典On the Adaptive Control of Robot Manipulators部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未知负载怎样在运动中修正而不破坏跟踪稳定性
- 二、利用参数线性结构,把更新律接入能量分析
- 三、实现参考运动与参数更新,区分两类误差
- 四、读未知负载仿真,分开跟踪改善和参数辨识
- 五、检查持续激励、模型类别与未建模扰动
- 六、追问:要比较两个参数更新律,为什么只画末端轨迹不够?
- 七、区分在线参数适应与滚动模型优化
- 八、自测与参考答案
段落怎样重新安排
- 问题设定与假设 → 一、问题设定:未知负载怎样在运动中修正而不破坏跟踪稳定性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:让参数误差在能量导数里抵消 → 三、实现参考运动与参数更新,区分两类误差
把求解机制与每步执行顺序分开检验
- 方法:让参数误差在能量导数里抵消 → 二、利用参数线性结构,把更新律接入能量分析
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 仿真如何验证 → 四、读未知负载仿真,分开跟踪改善和参数辨识
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:跟踪正确,但质量估计未必正确 → 四、读未知负载仿真,分开跟踪改善和参数辨识
把可视证据与实验条件/证据局限放在同一节
- 自构例子:跟踪正确,但质量估计未必正确 → 三、实现参考运动与参数更新,区分两类误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与局限 → 五、检查持续激励、模型类别与未建模扰动
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:未知负载怎样在运动中修正而不破坏跟踪稳定性
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、利用参数线性结构,把更新律接入能量分析
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、读未知负载仿真,分开跟踪改善和参数辨识
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、利用参数线性结构,把更新律接入能量分析 / 仿真如何验证 → 四、读未知负载仿真,分开跟踪改善和参数辨识
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
- 一分钟理解:机器人拿起重物后,不必仍按空手模型控制 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
- 合并重复限定,保留其具体机制依据;内容保留于桥段、第二节能量展开与第三节质量块例子。
- 合并重复限定,保留其具体机制依据;内容保留于桥段、第二节能量展开与第三节质量块例子。
- 合并重复限定,保留其具体机制依据;内容保留于桥段、第二节能量展开与第三节质量块例子。
- 合并重复限定,保留其具体机制依据;内容保留于桥段、第二节能量展开与第三节质量块例子。
- 合并重复限定,保留其具体机制依据;内容保留于桥段、第二节能量展开与第三节质量块例子。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 二、利用参数线性结构,把更新律接入能量分析:基线已有的Lyapunov交叉项展开与瞬时质量块检查保留;把夹在其后的原文仿真证据移到第四节,方法到实现只保留一条依赖说明。
- 六、追问:要比较两个参数更新律,为什么只画末端轨迹不够?:要比较两个参数更新律,为什么只画末端轨迹不够?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- 跟踪正确,不等于未知质量已经学准;左侧三个不同质量都解释同一个零输入、零加速度记录;右侧才出现能够区分质量的信息
教学示意 · 原创教学图 · 本文原创手算/几何推导;考虑一维质量块
左侧三个不同质量都解释同一个零输入、零加速度记录;右侧才出现能够区分质量的信息。这是辨识条件的自构反例,不能代替尚未取得的原论文双连杆仿真曲线。
未在正文展示的图/表与范围
- 图2:未取得可核验的原论文图像:SAGE原文需要付费访问,作者公开出版物目录未找到可读PDF。保留原图号与原文入口;现有原创教学图不是该原图的替代,也不计为完成。
- 图3:未取得可核验的原论文图像:SAGE原文需要付费访问,作者公开出版物目录未找到可读PDF。保留原图号与原文入口;现有原创教学图不是该原图的替代,也不计为完成。
- 图4:未取得可核验的原论文图像:SAGE原文需要付费访问,作者公开出版物目录未找到可读PDF。保留原图号与原文入口;现有原创教学图不是该原图的替代,也不计为完成。
- 图5:未取得可核验的原论文图像:SAGE原文需要付费访问,作者公开出版物目录未找到可读PDF。保留原图号与原文入口;现有原创教学图不是该原图的替代,也不计为完成。
- 图6:未取得可核验的原论文图像:SAGE原文需要付费访问,作者公开出版物目录未找到可读PDF。保留原图号与原文入口;现有原创教学图不是该原图的替代,也不计为完成。
- 图7:未取得可核验的原论文图像:SAGE原文需要付费访问,作者公开出版物目录未找到可读PDF。保留原图号与原文入口;现有原创教学图不是该原图的替代,也不计为完成。
- 图8:未取得可核验的原论文图像:SAGE原文需要付费访问,作者公开出版物目录未找到可读PDF。保留原图号与原文入口;现有原创教学图不是该原图的替代,也不计为完成。
未取得可可靠查看的原论文图 2–8 双连杆仿真曲线,未核实 PDF 页序;仅核对公开正文与图注转录。原创辨识反例不能代替原实验图。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 为正文讨论的原图保留在线阅读器入口,明确当前像素访问限制
- 收紧原图访问说明并保留原前置概念段连续性
查看本篇 1 个原文证据入口
本轮边界:本轮原 PDF 直取失败,仅重新核查公开原稿转录正文/图注;原图像素和精确 PDF 页序未验证;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 逐项展开Lyapunov抵消和时变参数额外项
- 构造参数误差暂增而总储能下降的可手算例
- 区分控制自适应与统计估计
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 为正文讨论的原图保留在线阅读器入口,明确当前像素访问限制
- 收紧原图访问说明并保留原前置概念段连续性
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.mit.edu · 书目信息
作者官方书目核论文归属
- www.scribd.com · 所列章节
原稿文本镜像第2节与第4节Example1–3及持续激励说明
技术关系
- 005-newton-euler · 模块组合
逆动力学为模型前馈提供计算
- 002-kalman · 教学联系
目标不同的两类在线更新
- 018-operational-space · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
仍需留意
- 原稿镜像部分公式图片解析不完整;不引用缺损角度数值,新增瞬时例独立推导
- 本轮原 PDF 直取失败,仅重新核查公开原稿转录正文/图注;原图像素和精确 PDF 页序未验证
机器人经典A Versatile Camera Calibration Technique for High-Accuracy 3D Machine Vision Metrology Using Off-the-Shelf TV Cameras and Lenses列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:焦距外参与径向畸变耦合时怎样分阶段标定
- 二、利用径向方向不变量,先消去部分未知量
- 三、实现两阶段求解,用方向保持的点检验
- 四、核对实际标定与独立测试点的误差口径
- 五、检查成像假设、标定几何与预知参数
- 六、追问:训练标定点的误差下降,为什么仍要保留独立测试点?
- 七、接上手眼关系,再比较平面多视图标定
- 八、自测与参考答案
段落怎样重新安排
- 标定究竟输出什么 → 一、问题设定:焦距外参与径向畸变耦合时怎样分阶段标定
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 两阶段方法的几何直觉 → 三、实现两阶段求解,用方向保持的点检验
把求解机制与每步执行顺序分开检验
- 两阶段方法的几何直觉 → 二、利用径向方向不变量,先消去部分未知量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处关键证据 → 四、核对实际标定与独立测试点的误差口径
把可视证据与实验条件/证据局限放在同一节
- 五处关键证据 → 四、核对实际标定与独立测试点的误差口径
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:为什么“方向”能绕开畸变 → 三、实现两阶段求解,用方向保持的点检验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、成本与边界 → 五、检查成像假设、标定几何与预知参数
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:焦距外参与径向畸变耦合时怎样分阶段标定
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、利用径向方向不变量,先消去部分未知量
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、核对实际标定与独立测试点的误差口径
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:训练标定点的误差下降,为什么仍要保留独立测试点?:训练标定点的误差下降,为什么仍要保留独立测试点?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 11:方格角点与畸变修正位置叠加在同一幅真实图像中
实验/结果图 · 必要原图摘引 · Fig. 11,PDF 第 16 页;裁切框为原页比例 (0.23, 0.053, 0.83, 0.394)
方格角点与畸变修正位置叠加在同一幅真实图像中。沿画面边缘比较偏移更容易看出径向畸变,图像叠加展示修正行为,空间精度仍要看独立测试点。
- 图3:径向排列约束中的世界坐标、摄像机坐标和畸变前后像点
方法/设定图 · 必要原图摘引 · 图 3, PDF page 8
图中畸变前后像点沿同一径向方向;这条方向约束解释了为何能先求部分外参,再求焦距与畸变参数。
- 图4:单视图共面标定点、相机和采集计算硬件的连接
方法/设定图 · 必要原图摘引 · 图 4, PDF page 8
棋盘角点处于同一平面,相机通过采集系统进入计算机;注意共面条件是该配置的假设,并非任意三维点集。
- 图5:重投影射线与测试平面的交点偏差及歧义区域
方法/设定图 · 必要原图摘引 · 图 5, PDF page 12
从理想点P追踪反投影射线与平面的交点P′;歧义半径衡量三维重建偏差,与像平面重投影误差不是同一指标。
- 图10:棋盘灰度图及提取到的白色亚像素角点
实验/结果图 · 必要原图摘引 · 图 10, PDF page 15
白点位于黑方格边角;读图时把特征定位质量与后续相机参数估计分开,不能仅凭标定板图像断言整体三维精度。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 10
查看本篇 4 个原文证据入口
- 图 3 · PDF 第 8 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 8 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 12 页,Figure 5
原站图表/证明入口
- 图 10 · PDF 第 15 页,Figure 10
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 展开单平面五组合未知量的线性设计行
- 加入数值代入与正对平面焦距深度退化检查
- 衔接角点、相机标定、手眼标定及鲁棒对应
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 10
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cs.auckland.ac.nz · 所列章节
第326/329–331页RAC、单平面式10/秩/尺度条件及337页独立测试误差
- www.cs.auckland.ac.nz · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 023-harris · 模块组合
特征提取可提供标定图像观测
- 024-hand-eye · 模块组合
成像标定和目标位姿提供手眼输入
- 006-ransac · 模块组合
筛除错误对应的互补工具
- 042-zhang-calibration · 平行方法
不同平面视图与内参先验设定
机器人经典Closed-Form Solution of Absolute Orientation Using Unit Quaternions列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:已知对应的两组三维点怎样满足刚体约束地对齐
- 二、先中心化,再把合法旋转转成四元数特征值解
- 三、实现尺度与平移恢复,用共线点检查歧义
- 四、对照闭式推导、原文例子与教学图
- 五、检查对应、误差模型和尺度目标
- 六、追问:去掉均值后配准很好,为什么仍要检查恢复平移时采用的尺度?
- 七、从已知对应走向ICP与鲁棒认证
- 八、自测与参考答案
段落怎样重新安排
- 问题定义与过去的困难 → 一、问题设定:已知对应的两组三维点怎样满足刚体约束地对齐
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:先平移,再旋转 → 三、实现尺度与平移恢复,用共线点检查歧义
把求解机制与每步执行顺序分开检验
- 方法:先平移,再旋转 → 二、先中心化,再把合法旋转转成四元数特征值解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 尺度是一个不能跳过的细节 → 二、先中心化,再把合法旋转转成四元数特征值解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处原文证据 → 四、对照闭式推导、原文例子与教学图
把可视证据与实验条件/证据局限放在同一节
- 五处原文证据 → 四、对照闭式推导、原文例子与教学图
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:同一条直线藏着未被测到的旋转 → 三、实现尺度与平移恢复,用共线点检查歧义
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与代价 → 五、检查对应、误差模型和尺度目标
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:已知对应的两组三维点怎样满足刚体约束地对齐
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、先中心化,再把合法旋转转成四元数特征值解
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、先中心化,再把合法旋转转成四元数特征值解
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:去掉均值后配准很好,为什么仍要检查恢复平移时采用的尺度?:去掉均值后配准很好,为什么仍要检查恢复平移时采用的尺度?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Fig. 2:三点确定局部坐标系,但所选三点会决定哪些测量直接进入坐标构造
方法/设定图 · 必要原图摘引 · Fig. 2,PDF 第 2 页;裁切框为原页比例 (0.5, 0.74, 0.93, 0.884)
三点确定局部坐标系,但所选三点会决定哪些测量直接进入坐标构造。它解释了为何使用全部对应点的对称最小二乘问题,比任意挑三点搭坐标系更有意义。
- 图1:同一组空间点在左右两个坐标系中的观测向量
方法/设定图 · 必要原图摘引 · 图 1, PDF page 2
虚线连接同一点在两个坐标系中的表示;问题是求共同的刚体变换,而不是为每一对点独立拟合。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2
查看本篇 2 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 2 页,Figure 2
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 新增四点完整H/N矩阵和特征向量手算
- 用最优残差及旋转方向做双重验算
- 澄清共面非退化及点配准/手眼约束区别
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- people.csail.mit.edu · 所列章节
第1节点数/共线条件及第4节四元数二次型
- people.csail.mit.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 006-ransac · 模块组合
稳健样本筛选后求闭式旋转
- 024-hand-eye · 平行方法
运动共轭与点对应是不同估计问题
- 028-icp · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
机器人经典A Fast Procedure for Computing the Distance Between Complex Objects in Three-Dimensional Space列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:两个凸物体怎样不用枚举全部面就求最近距离
- 二、利用支持点查询在Minkowski差中逼近原点
- 三、迭代小单纯形,用非凸形状检验适用范围
- 四、读6000多面体测试与教学差集图
- 五、区分经验效率、容差退化与非凸分解
- 六、追问:若支持点查询返回近似最远点,原来的停止判断还能无条件沿用吗?
- 七、把凸体距离接入轨迹碰撞约束
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:距离与碰撞并不完全等价 → 一、问题设定:两个凸物体怎样不用枚举全部面就求最近距离
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:差集、支持点与最短向量 → 三、迭代小单纯形,用非凸形状检验适用范围
把求解机制与每步执行顺序分开检验
- 方法:差集、支持点与最短向量 → 二、利用支持点查询在Minkowski差中逼近原点
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:效率来自什么条件 → 四、读6000多面体测试与教学差集图
把可视证据与实验条件/证据局限放在同一节
- 实验:效率来自什么条件 → 四、读6000多面体测试与教学差集图
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:为什么非凸形状会被“填平” → 三、迭代小单纯形,用非凸形状检验适用范围
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与边界 → 五、区分经验效率、容差退化与非凸分解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:两个凸物体怎样不用枚举全部面就求最近距离
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、利用支持点查询在Minkowski差中逼近原点
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、利用支持点查询在Minkowski差中逼近原点
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
- 原摘要的实验结果前置在方法开头,且与第四节重复;合并到具体试验条件和数值旁,保留全部范围限定。;内容保留于**第 VII 节,[图 4](https://graphics.stanford.edu/courses/cs448b-00-winter/papers/gilbert.pdf#page=8)。** 12 类多面体选 20 对,每类状态 100 个例子;覆盖相离、刚接触、相交,共 6000 个;不等于真实机器人场景统计分布。在这些测试中,计算成本随总顶点数近似线性,属于经验观察,不能推广为任意输入的最坏情况界。。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:若支持点查询返回近似最远点,原来的停止判断还能无条件沿用吗?:若支持点查询返回近似最远点,原来的停止判断还能无条件沿用吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 6:沿横轴的运动进程比较物体间距离,距离降至零的位置标出接触可能发生的区间
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 9 页;裁切框为原页比例 (0.49, 0.065, 0.895, 0.27)
沿横轴的运动进程比较物体间距离,距离降至零的位置标出接触可能发生的区间。这里按离散路径参数计算,不能把采样点之间未检查的位置自动算作无碰撞。
- 图4:顶点总数与计算量、CPU时间关系,含碰撞、刚接触和接近三类点
实验/结果图 · 必要原图摘引 · 图 4, PDF page 8
横轴是顶点总数M,左轴为等效运算量、右轴为CPU时间;三类样本的分散程度说明平均趋势不等于最坏情况界。
- 图5:移动多面体K4与五个固定障碍物的碰撞检测场景
实验/结果图 · 必要原图摘引 · 图 5, PDF page 9
把运动起点与终点和K1至K5固定障碍物对应起来,再读图6的各条距离曲线;几何图本身不显示碰撞时间。
- 表I:不同轨迹采样数下单点初始化与专用初始化的CPU时间
实验/结果图 · 必要原图摘引 · 表 I, PDF page 9
逐行比较相同采样数下的两种初始化;采样更密时复用已有近邻关系的相对收益增大,表内时间仍依赖原硬件。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 6
查看本篇 3 个原文证据入口
- 图 4 · PDF 第 8 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 9 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 9 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 从支持超平面推导距离上下界和容差单位
- 加入两轮线段单纯形完整迭代
- 区分显式构型障碍与按需凸距离查询
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- graphics.stanford.edu · 所列章节
下载视觉复核第196页差集支持、Theorem1与距离算法
- doczz.net · 所列章节
原稿转录第VII节6000随机几何例条件
- graphics.stanford.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 009-configuration-space · 教学联系
共享Minkowski差,具体算法谱系不等同
- 014-potential-field · 模块组合
距离与最近点可供局部避障
- 073-trajopt · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
机器人经典A Combined Corner and Edge Detector列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:局部图像怎样区分平坦区域、边和角点
- 二、把微小平移后的灰度变化写成结构张量
- 三、计算角点响应,用两个特征值检查方向信息
- 四、读边角连接图,限制可视化比较的结论
- 五、检查尺度、阈值、光照与真实对应
- 六、追问:若要验证角点重复性,为什么只数每张图检测到多少点不够?
- 七、从角点检测走向跟踪质量监控
- 八、自测与参考答案
段落怎样重新安排
- 背景:机器人需要可以反复认出的局部证据 → 一、问题设定:局部图像怎样区分平坦区域、边和角点
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:从移动窗口到结构张量 → 三、计算角点响应,用两个特征值检查方向信息
把求解机制与每步执行顺序分开检验
- 方法:从移动窗口到结构张量 → 二、把微小平移后的灰度变化写成结构张量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验与证据:结果图足以说明什么 → 四、读边角连接图,限制可视化比较的结论
把可视证据与实验条件/证据局限放在同一节
- 实验与证据:结果图足以说明什么 → 四、读边角连接图,限制可视化比较的结论
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 真正的贡献与容易误会的边界 → 五、检查尺度、阈值、光照与真实对应
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个可以手算的小例子 → 三、计算角点响应,用两个特征值检查方向信息
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:局部图像怎样区分平坦区域、边和角点
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把微小平移后的灰度变化写成结构张量
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把微小平移后的灰度变化写成结构张量
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:若要验证角点重复性,为什么只数每张图检测到多少点不够?:若要验证角点重复性,为什么只数每张图检测到多少点不够?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 4:四个面板使用同一测试图案,比较角点算子在曲线、轮廓和细节附近的响应分布
实验/结果图 · 必要原图摘引 · Fig. 4,PDF 第 3 页;裁切框为原页比例 (0.05, 0.6, 0.475, 0.95)
四个面板使用同一测试图案,比较角点算子在曲线、轮廓和细节附近的响应分布。它是受控输入下的定性对照,不能读成数据集上的准确率排名。
- 对应Harris原图5的独立计算图:特征值平面中的平坦、边缘与角点区域,以及Harris响应等值线
方法/设定图 · 依据公开数据/公式重绘 · Fig. 5, PDF page 4; independent reconstruction from source equations/theorem statements
读图:灰色区域先由 trace(M)<2 排除;其余区域再按 R 的正负分类,粗深线为 R=0,细线为等响应线。这里自行选择 k=0.04、平坦阈值2与两个特征值0至6的范围,原文未给出统一的这些参数;网格为601×601。A、B、C的数值直接代入原响应公式,显示正R的低能量点也可被平坦阈值排除。它对应原图5的区域划分和等响应线机制,不是对原图曲线描摹,也不是原论文影像实验结果。
- 两帧室外场景的未连接Canny边缘双面板
实验/结果图 · 必要原图摘引 · Figure 2, PDF p.2
两帧中的灌木细边缘变化明显;这对结果是作者质疑仅靠边缘维持稳定拓扑的具体视觉证据。
- 同两帧室外场景的连接后Canny边缘双面板
实验/结果图 · 必要原图摘引 · Figure 3, PDF p.2
连接后保留的主轮廓与短枝条仍不完全一致;这张与前一张形成必要的处理前后对照,并不证明角点也能在任意场景中保持稳定。
未在正文展示的图/表与范围
- 图1:已摘引 Canny 连接前后与检测器对照,并独立重绘特征值响应机制;尚缺的是原始户外双帧及初步/最终特征连接输出。继续加入会连同输入和完整输出链重现该短文的主要影像表达,且原文另列 HMSO 灰度影像权利。当前保留三项入口,属于具体累计影像范围的编辑判断,并非版权标记自动禁止摘引。
- 图6:已摘引 Canny 连接前后与检测器对照,并独立重绘特征值响应机制;尚缺的是原始户外双帧及初步/最终特征连接输出。继续加入会连同输入和完整输出链重现该短文的主要影像表达,且原文另列 HMSO 灰度影像权利。当前保留三项入口,属于具体累计影像范围的编辑判断,并非版权标记自动禁止摘引。
- 图7:已摘引 Canny 连接前后与检测器对照,并独立重绘特征值响应机制;尚缺的是原始户外双帧及初步/最终特征连接输出。继续加入会连同输入和完整输出链重现该短文的主要影像表达,且原文另列 HMSO 灰度影像权利。当前保留三项入口,属于具体累计影像范围的编辑判断,并非版权标记自动禁止摘引。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 1、图 4、图 2、图 3、图 5、图 6、图 7
查看本篇 7 个原文证据入口
- 图 1 · PDF 第 1 页,Figure 1
原站图表/证明入口
- 图 4 · PDF 第 3 页,Figure 4
原站图表/证明入口
- 图 2 · PDF 第 2 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 2 页,Figure 3
原站图表/证明入口
- 图 5 · PDF 第 4 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 4 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导响应与特征值比例的关系
- 提供正响应但条件数差的数值例
- 以噪声协方差连接LK并限定教学扩展
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 1、图 4、图 2、图 3、图 5、图 6、图 7
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.bmva-archive.org.uk · 所列章节
第149–150页局部自相关二次型、特征值分类与连续方向改进
- www.bmva-archive.org.uk · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 008-lucas-kanade · 教学联系
结构张量与位移信息矩阵同构
- 020-tsai-calibration · 模块组合
角点作为标定观测
- 006-ransac · 模块组合
几何一致性验证特征对应
- 033-good-features · 平行方法
同一结构张量的不同选择判据;Shi–Tomasi从LK跟踪条件推导,不把相似评分结构当作代码继承。
机器人经典A New Technique for Fully Autonomous and Efficient 3D Robotics Hand/Eye Calibration列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:相机与机械臂末端的固定关系怎样从相对运动恢复
- 二、用AX=XB消去世界变换,再分解旋转和平移
- 三、实现两阶段求解,用运动轴分布检查可观测性
- 四、区分预测姿态误差、手眼误差与机器人自身误差
- 五、保留运动噪声、转动激励与原稿疑点
- 六、追问:增加姿态数量却保持相同运动范围,误差为什么可能不再明显下降?
- 七、把标定关系交给视觉反馈
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题定义 → 一、问题设定:相机与机械臂末端的固定关系怎样从相对运动恢复
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把六个未知量拆成两个小问题 → 三、实现两阶段求解,用运动轴分布检查可观测性
把求解机制与每步执行顺序分开检验
- 方法:把六个未知量拆成两个小问题 → 二、用AX=XB消去世界变换,再分解旋转和平移
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置与验证意图 → 四、区分预测姿态误差、手眼误差与机器人自身误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四处关键证据如何阅读 → 四、区分预测姿态误差、手眼误差与机器人自身误差
把可视证据与实验条件/证据局限放在同一节
- 四处关键证据如何阅读 → 四、区分预测姿态误差、手眼误差与机器人自身误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价和一个值得保留的原文疑点 → 五、保留运动噪声、转动激励与原稿疑点
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子与前置概念 → 三、实现两阶段求解,用运动轴分布检查可观测性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:相机与机械臂末端的固定关系怎样从相对运动恢复
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用AX=XB消去世界变换,再分解旋转和平移
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、区分预测姿态误差、手眼误差与机器人自身误差
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:增加姿态数量却保持相同运动范围,误差为什么可能不再明显下降?:增加姿态数量却保持相同运动范围,误差为什么可能不再明显下降?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Figs. 8–9:两图横轴都是运动几何退化程度的倒数尺度:转动角太小,恢复旋转和平移都会变得敏感
实验/结果图 · 必要原图摘引 · Figs. 8–9,PDF 第 11 页;裁切框为原页比例 (0.055, 0.035, 0.925, 0.325)
两图横轴都是运动几何退化程度的倒数尺度:转动角太小,恢复旋转和平移都会变得敏感。曲线增长支持条件数分析,不能把更多几乎相同的姿态当成更多独立信息。
- 图12:站位数平方根倒数与平移误差,含RMS及最大值曲线
实验/结果图 · 必要原图摘引 · 图 12, PDF page 12
实线是RMS、虚线是最大误差;横轴向左对应更多站位,均方误差下降不意味着最坏误差完全消失。
- 图13:站位数平方根倒数与旋转误差,含RMS及最大值曲线
实验/结果图 · 必要原图摘引 · 图 13, PDF page 12
与图12使用同一横轴含义;分别读实线的平均尺度和虚线的最大误差,避免把样本数量收益当成几何激励的替代。
- 图3:手眼标定实验中机器人、相机和标定装置的整体照片
实验/结果图 · 必要原图摘引 · 图 3, PDF page 3
这张整体照片用于核对眼在手上的实际安装关系;它说明实验装置,不能单独证明标定精度。
- 图4:刚性安装在机器人末端的CCD相机近景
实验/结果图 · 必要原图摘引 · 图 4, PDF page 3
近景补充图3的整体视角,重点看相机与末端刚性连接;固定的手眼变换正依赖这一机械假设。
- 图6:多姿态站位、相邻旋转轴与参考坐标系的选择
方法/设定图 · 必要原图摘引 · 图 6, PDF page 5
对照不同姿态之间的连线与旋转轴方向;需要足够的旋转激励和轴向差异,不能仅增加相似姿态的数量。
- 图10:旋转轴夹角倒数与旋转RMS误差的关系
实验/结果图 · 必要原图摘引 · 图 10, PDF page 11
横轴是两条主要旋转轴夹角的倒数;越接近平行,横轴越大、误差越高,体现了退化方向的影响。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 12、图 13、图 3、图 4、图 6、图 8、图 9、图 10、图 11
查看本篇 9 个原文证据入口
- 图 12 · PDF 第 12 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 12 页,Figure 13
原站图表/证明入口
- 图 3 · PDF 第 3 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 3 页,Figure 4
原站图表/证明入口
- 图 6 · PDF 第 5 页,Figure 6
原站图表/证明入口
- 图 8 · PDF 第 11 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 11 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 11 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 12 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从四元数乘法推导叉乘线性方程与符号条件
- 两组90度转轴手算恢复平移并解释同轴不可观
- 核对视觉外参前端及相对运动精度要求
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 12、图 13、图 3、图 4、图 6、图 8、图 9、图 10、图 11
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- kmlee.gatech.edu · 所列章节
第348–350页相对运动方向、观测、式12–16及特殊旋转分支
- kmlee.gatech.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 020-tsai-calibration · 模块组合
相机标定为停靠姿态提供外参
- 021-horn · 平行方法
点配准和运动共轭约束不同
- 037-visual-servo · 模块组合
前部路线明确说明后续模块组合,未主张未经核实的引用继承
机器人经典Using Occupancy Grids for Mobile Robot Perception and Navigation列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:带方向歧义的测距怎样累积成占据信念
- 二、从单次观测证据推到栅格概率更新
- 三、实现逐格融合,用重复观测检验独立性
- 四、读声呐与双目建图,区分地图表示与精度排名
- 五、检查定位误差、离散化和相关证据
- 六、追问:把栅格分辨率提高一倍,能否在不改传感器模型时认为地图信息增加了?
- 七、扩展三维存储,再把占据信念交给规划
- 八、自测与参考答案
段落怎样重新安排
- 背景:几何描述之前,先保留传感器确实知道什么 → 一、问题设定:带方向歧义的测距怎样累积成占据信念
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:一份新证据如何改变旧地图 → 三、实现逐格融合,用重复观测检验独立性
把求解机制与每步执行顺序分开检验
- 方法:一份新证据如何改变旧地图 → 四、读声呐与双目建图,区分地图表示与精度排名
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验如何支撑这套框架 → 四、读声呐与双目建图,区分地图表示与精度排名
把可视证据与实验条件/证据局限放在同一节
- 实验如何支撑这套框架 → 四、读声呐与双目建图,区分地图表示与精度排名
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 为什么地图可能越来越确定,却越来越错 → 五、检查定位误差、离散化和相关证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构例子:两次“看见”为什么不能随便相加 → 三、实现逐格融合,用重复观测检验独立性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:带方向歧义的测距怎样累积成占据信念
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从单次观测证据推到栅格概率更新
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从单次观测证据推到栅格概率更新
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 四、证据节内以“证据”命名的机制段 → 二、从单次观测证据推到栅格概率更新
“观测证据”是推断算法的输入,不是实验结果;恢复先推导概率更新、再实现、最后看原文实验的依赖。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:把栅格分辨率提高一倍,能否在不改传感器模型时认为地图信息增加了?:把栅格分辨率提高一倍,能否在不改传感器模型时认为地图信息增加了?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:8 幅
- Fig. 13:依次比较声呐、双目和融合地图中的占据区域:两种传感器对同一环境的盲区不同,融合后的形状体现互补信息;这里没有逐格概率校准曲线
实验/结果图 · 必要原图摘引 · Fig. 13,PDF 第 8 页;裁切框为原页比例 (0.615, 0.37, 0.895, 0.735)
依次比较声呐、双目和融合地图中的占据区域:两种传感器对同一环境的盲区不同,融合后的形状体现互补信息;这里没有逐格概率校准曲线。
- 图3:高斯距离传感器观测下的一维占据概率曲线
方法/设定图 · 必要原图摘引 · 图 3, PDF page 4
沿横轴读距离,纵轴读占据概率;测量附近概率上升、之前区域降低,未观测区域仍保留先验,不能把未知等同空闲。
- 图4:二维高斯传感器的占据概率曲面
方法/设定图 · 必要原图摘引 · 图 4, PDF page 4
近处的低谷与回波附近的峰对应自由空间和障碍证据;沿波束的测距与横向的不确定性共同决定曲面形状。
- 图9:室内声呐二维占据栅格与房间及障碍轮廓
实验/结果图 · 必要原图摘引 · 图 9, PDF page 7
对照边界、圆形障碍与机器人采样位置;扫描版为灰度,原图注中的颜色信息不可直接从这里恢复。
- 图10:图9声呐地图对应的三维占据概率视图
实验/结果图 · 必要原图摘引 · 图 10, PDF page 7
高度表示每个栅格的占据概率;这是同一地图的概率视图,不是环境物体的真实三维高度。
- 图11:走廊地图、机器人采样位置与声呐射线
实验/结果图 · 必要原图摘引 · 图 11, PDF page 7
从各停靠点发出的射线展示观测如何累计成地图;墙面和门洞的可分辨程度与声呐模型及栅格分辨率共同有关。
- 图12:室外树林测试的声呐占据地图和行驶轨迹
实验/结果图 · 必要原图摘引 · 图 12, PDF page 8
黑色障碍与中央行驶轨迹对应室外测试;这张图展示一次运行的结果,不能推出所有植被环境下的可靠性。
- 图16:局部机器人视图网络、运动路径与全局地图的两层表示
方法/设定图 · 必要原图摘引 · 图 16, PDF page 11
上层保存各局部视图及位姿关系,下层保留融合地图;保留关系网络有助于避免把每次观测不可逆地压平到单一网格。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 7、图 8、图 13、图 3、图 9、图 11、图 12、图 15、图 16
查看本篇 9 个原文证据入口
- 图 7 · PDF 第 6 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 6 页,Figure 8
原站图表/证明入口
- 图 13 · PDF 第 8 页,Figure 13
原站图表/证明入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 9 · PDF 第 7 页,Figure 9
原站图表/证明入口
- 图 11 · PDF 第 7 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 8 页,Figure 12
原站图表/证明入口
- 图 15 · PDF 第 10 页,Figure 15
原站图表/证明入口
- 图 16 · PDF 第 9 页,Figure 16
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 从贝叶斯赔率推出非0.5先验的逆模型校正
- 用二格联合状态展示独立近似损失
- 核对原文Dolphin的A*与势场组合并区分机身几何
- 在一分钟理解后加入本篇独有的历史问题路线与有类型区分的相对链接
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 7、图 8、图 13、图 3、图 9、图 11、图 12、图 15、图 16
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- mediawiki.isr.ist.utl.pt · 所列章节
本地下载并视觉核第47页零阶随机场与表示范围
- www.researchgate.net · 所列章节
作者上传原稿的融合地图与Dolphin规划段落
- mediawiki.isr.ist.utl.pt · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 017-uncertain-map · 教学联系
两种概率表示的相关性问题
- 003-astar · 模块组合
原文Dolphin图搜索
- 014-potential-field · 模块组合
原文Dolphin局部避障
- 009-configuration-space · 模块组合
机器人尺寸与碰撞含义
- 074-octomap · 直接继承
后续概率占据地图的三维八叉树扩展
机器人经典The Vector Field Histogram—Fast Obstacle Avoidance for Mobile Robots部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:狭窄通道的信息怎样避免被单一合力抹掉
- 二、从栅格权重生成方向直方图,再选择候选谷
- 三、执行方向与速度选择,检查车宽和近距盲区
- 四、读Fig.11轨迹并结合硬件周期与检测边界
- 五、限制局部到达、阈值和细障碍检测结论
- 六、追问:只比较平均速度,怎样会把传感器能力误算成算法收益?
- 七、继续检查候选方向是否来得及刹停
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题:局部方向选择不是完整路径规划 → 一、问题设定:狭窄通道的信息怎样避免被单一合力抹掉
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:栅格、直方图、谷与动作 → 三、执行方向与速度选择,检查车宽和近距盲区
把求解机制与每步执行顺序分开检验
- 方法:栅格、直方图、谷与动作 → 二、从栅格权重生成方向直方图,再选择候选谷
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置:速度必须与硬件和障碍一起看 → 四、读Fig.11轨迹并结合硬件周期与检测边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据与它们的边界 → 四、读Fig.11轨迹并结合硬件周期与检测边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失败模式 → 五、限制局部到达、阈值和细障碍检测结论
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:方向可用,不等于车身能通过 → 三、执行方向与速度选择,检查车宽和近距盲区
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:狭窄通道的信息怎样避免被单一合力抹掉
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从栅格权重生成方向直方图,再选择候选谷
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、读Fig.11轨迹并结合硬件周期与检测边界
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:只比较平均速度,怎样会把传感器能力误算成算法收益?:只比较平均速度,怎样会把传感器能力误算成算法收益?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:6 幅
- Fig. 11:沿 Start 到 Target 的连续路径看机器人如何穿过细杆障碍,旁边标注的是这次代表运行的速度与控制设置
实验/结果图 · 必要原图摘引 · Fig. 11,PDF 第 21 页;裁切框为原页比例 (0.485, 0.135, 0.91, 0.588)
沿 Start 到 Target 的连续路径看机器人如何穿过细杆障碍,旁边标注的是这次代表运行的速度与控制设置。它支持实时反应的可行性,不能给出任意未知障碍场的安全保证。
- 图4:活动窗口内栅格到极坐标障碍直方图的映射
方法/设定图 · 必要原图摘引 · 图 4, PDF page 10
每个活动格按相对方向进入一个扇区,再由距离和确定度贡献障碍密度;这一步连接二维地图与一维转向选择。
- 图5:障碍场景与对应直方图栅格,保留a、b两面板及图例
实验/结果图 · 必要原图摘引 · 图 5, PDF page 12
先在(a)定位墙面、隔板和细杆,再在(b)看相应占据格;图例中的确定度不是直接的距离值。
- 图6:同一障碍直方图的笛卡尔与极坐标表示,含阈值与方向图例
方法/设定图 · 必要原图摘引 · 图 6, PDF page 12
上图的低谷对应可选方向,下图把同一密度映射回机器人周围;A、B、C峰需要与图5中的障碍一一对应。
- 图8:离障碍过近、过远和合适距离时的三种转向
方法/设定图 · 必要原图摘引 · 图 8, PDF page 14
对照(a)、(b)、(c)中的目标方向与实际转向;控制规则会根据距离偏差向外或向内修正,形成沿障碍稳定行驶。
- 图9:目标方向受阻时从自由扇区中选择转向方向
方法/设定图 · 必要原图摘引 · 图 9, PDF page 15
目标方向落入受阻区域时,选择由自由谷边界限定的转向;这是一种局部决策,不能推出必然存在全局可达路线。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 11、图 4、图 5、图 6、图 8、图 9、图 10
查看本篇 7 个原文证据入口
- 图 11 · PDF 第 21 页,Figure 11
原站图表/证明入口
- 图 4 · PDF 第 10 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 12 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 12 页,Figure 6
原站图表/证明入口
- 图 8 · PDF 第 14 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 15 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 20 页,Figure 10
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导扇区直方图为何不具概率语义
- 加入置信计数平方与阈值的手算例
- 区分栅格表示、势场和速度空间避障
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 11、图 4、图 5、图 6、图 8、图 9、图 10
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.valentiniweb.com · 所列章节
第3节VFF离散力抖动和第4节直方图构造;教学数字独立构造。 下载原稿补读第6节:CARMEL传感器、0.78米/秒、1.34米几何检测界、0.58米/秒杆阵与27毫秒周期。
- www.valentiniweb.com · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 014-potential-field · 平行方法
局部避障的不同降维与决策形式
- 025-occupancy · 历史背景
栅格思想相关,但概率语义不同
- 038-dwa · 平行方法
方向筛选与动力学速度筛选对照
仍需留意
- 第3–4及6节已核读;未复现实机,作者没有报告独立试验总数或置信区间。
机器人经典Study of Dynamic Biped Locomotion on Rugged Terrain—Derivation and Application of the Linear Inverted Pendulum Mode部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:双足复杂受力怎样变成可解析的水平运动模型
- 二、代入质心直线约束,检查非线性项如何相消
- 三、计算一步前的质心演化,核对模型补偿接口
- 四、区分独立教学推导与尚未取得的会议实验
- 五、检查腿质量、角动量与接触切换代价
- 六、追问:若下层不能维持所选质心轨迹,继续使用线性预测会错在哪一层?
- 七、从线性模式走向预瞄与停止分析
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:身体质量、无质量腿与固定支撑点 → 一、问题设定:双足复杂受力怎样变成可解析的水平运动模型
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法推导:斜直线为什么也能留下线性方程 → 四、区分独立教学推导与尚未取得的会议实验
把可视证据与实验条件/证据局限放在同一节
- 方法推导:斜直线为什么也能留下线性方程 → 三、计算一步前的质心演化,核对模型补偿接口
把求解机制与每步执行顺序分开检验
- 方法推导:斜直线为什么也能留下线性方程 → 二、代入质心直线约束,检查非线性项如何相消
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 证据与实验:哪些能确认,哪些仍不能 → 四、区分独立教学推导与尚未取得的会议实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与边界:好的简化需要知道删掉了什么 → 五、检查腿质量、角动量与接触切换代价
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构算例:一步之前就能看见不稳定性 → 三、计算一步前的质心演化,核对模型补偿接口
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:双足复杂受力怎样变成可解析的水平运动模型
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、代入质心直线约束,检查非线性项如何相消
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、区分独立教学推导与尚未取得的会议实验
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:不是忽略非线性,而是主动选择一种运动 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:若下层不能维持所选质心轨迹,继续使用线性预测会错在哪一层?:若下层不能维持所选质心轨迹,继续使用线性预测会错在哪一层?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- 线性倒立摆:要消掉的是增长模态;两条直线都是零轨道能量分支,只有绿色分支朝平衡收敛
教学示意 · 原创教学图 · 本文原创手算/几何推导;其中 $x_0,\dot x_0$
两条直线都是零轨道能量分支,只有绿色分支朝平衡收敛。橙色的两个点来自正文解析例,0.2 秒内偏移约翻倍;“线性”和“稳定”不是同一概念。
原版全文/原图核验缺口仍保留;本次原创教学图不冒充原论文图,也不填补原实验核验缺口。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
本轮边界:原版主体/原图访问缺口仍在;不虚构原图页码,教学推导不冒充原始实验;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 分解倒立摆的增长与衰减模态
- 计算同初始状态在有限时间的发散量
- 补核1991同年日文原始摘要,区分会议全文缺口与1995后续研究
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- doi.org · 未能读取
1991会议原文入口,全文本轮未取得;后续论文不能代替本篇实验核验。
- www.jstage.jst.go.jp · 摘要
同作者1995年后续原始研究的支撑切换与动量损失;1991年的模型作独立教学推导。
- www.jstage.jst.go.jp · 摘要
实际读取同作者1991年日文原始研究 Study of Dynamic Walk Control of a Biped Robot on Rugged Terrain: Derivation and Application of the Linear Inverted Pendulum Mode 的英文摘要(177–184页,DOI 10.9746/sicetr1965.27.177):集中质量/无质量腿、平面直线约束、恒定躯干角速度及仿真验证。
技术关系
- 054-capture-point · 教学联系
从增长模态推导捕获位置,非原论文优先权主张
- 047-preview-zmp · 历史背景
LIP模型家族用于后来的ZMP预瞄
仍需留意
- 1991 ICRA会议全文仍未取得;同年日文期刊摘要通过J-STAGE卷期页读取,不能替代会议图表核验。1995来源是独立后续论文,不能据此验证1991硬件或实验结果。
机器人经典A Method for Registration of 3-D Shapes部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未知点对应与刚体变换怎样交替求解
- 二、交替找最近点与刚体拟合,逐步证明目标不增
- 三、实现配准循环,用周期结构检查错误稳定解
- 四、读八点示例与初始化反例,区分残差和正确性
- 五、检查重叠、采样密度、离群点与局部极值
- 六、追问:改用截断对应或近似最近邻后,为什么不能直接引用原单调下降证明?
- 七、把交替配准接入连续扫描
- 八、自测与参考答案
段落怎样重新安排
- 背景:几何最近与物理对应不是同一个概念 → 一、问题设定:未知点对应与刚体变换怎样交替求解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:一个带隐含对应的优化问题 → 三、实现配准循环,用周期结构检查错误稳定解
把求解机制与每步执行顺序分开检验
- 方法:一个带隐含对应的优化问题 → 二、交替找最近点与刚体拟合,逐步证明目标不增
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 单调下降到底证明了什么 → 二、交替找最近点与刚体拟合,逐步证明目标不增
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计与证据 → 四、读八点示例与初始化反例,区分残差和正确性
把可视证据与实验条件/证据局限放在同一节
- 实验设计与证据 → 四、读八点示例与初始化反例,区分残差和正确性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与适用边界 → 五、检查重叠、采样密度、离群点与局部极值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:错误对应可以形成稳定答案 → 三、实现配准循环,用周期结构检查错误稳定解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:未知点对应与刚体变换怎样交替求解
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、交替找最近点与刚体拟合,逐步证明目标不增
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、交替找最近点与刚体拟合,逐步证明目标不增
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:先猜对应,再对齐;对齐之后,再猜对应 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
- 原摘要的实验结果前置在方法开头,且与第四节重复;合并到具体试验条件和数值旁,保留全部范围限定。;内容保留于六次迭代、不到一秒、RMS 0.437608 mm(约0.438 mm) 是这个示例的条件性结果。。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:改用截断对应或近似最近邻后,为什么不能直接引用原单调下降证明?:改用截断对应或近似最近邻后,为什么不能直接引用原单调下降证明?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Figs. 4–5:上下对照配准前后的两个小点集,观察形状通过刚体变换重合
实验/结果图 · 必要原图摘引 · Figs. 4–5,PDF 第 11 页;裁切框为原页比例 (0.105, 0.08, 0.485, 0.545)
上下对照配准前后的两个小点集,观察形状通过刚体变换重合。这里的收敛展示依赖该初值和几何,不能从这一对图推出任意部分重叠点云都收敛到正确解。
- 表I:用于三维点集配准测试的两组点坐标
实验/结果图 · 必要原图摘引 · 表 I, PDF page 11
先确认两组点的规模不同,再对照图4与图5;表中坐标是可复核的输入,不能将配准成功解释为预先已知点对对应。
- 图6:配准前的理想空间曲线与部分带噪曲线
实验/结果图 · 必要原图摘引 · 图 6, PDF page 12
两条曲线的起始相对位姿差异很大,而且其中一条只覆盖局部;这同时考验初值搜索、局部对应和噪声稳健性。
- 图7:配准后的理想空间曲线与部分带噪曲线
实验/结果图 · 必要原图摘引 · 图 7, PDF page 12
与图6并排比较重叠段;未重叠部分仍存在,因此视觉贴合只说明该例的局部匹配效果。
- 图8:配准前的噪声点集与三角网格曲面
实验/结果图 · 必要原图摘引 · 图 8, PDF page 12
散点和网格是不同表示,最近点需落在曲面上;这是ICP可处理点到曲面匹配的例子,图8本身是配准前状态。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 6、图 7、图 8
查看本篇 5 个原文证据入口
- 图 4 · PDF 第 11 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 11 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 12 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 12 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 12 页,Figure 8
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 用双不等式说明交替配准的条件性下降
- 构造最近点关联导致局部停滞的反例
- 区分局部收敛与全局正确配准
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 6、图 7、图 8
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.researchgate.net · 摘要
作者上传摘要中的六自由度配准及局部距离极小收敛;双不等式和反例为独立教学推导。
- graphics.stanford.edu · 所列章节
以页面图像补读第242–245页:对应点刚体配准、ICP步骤、式31–35单调性证明和加速方案。
- graphics.stanford.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 021-horn · 模块组合
固定对应子问题的刚体闭式解
- 096-teaser · 平行方法
外点匹配鲁棒估计问题对照
- 100-kissicp · 直接继承
后作承接本篇:继承交替匹配和对齐框架
仍需留意
- 扫描原稿关键方法页已视觉核读;未重新核对其余全部实验图。新增反例为无等距平局的原创一维算例。
机器人经典Exact Robot Navigation Using Artificial Potential Functions部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:势函数怎样避免非目标稳定低谷并保留边界保证
- 二、约束临界点结构,再从几何下降接到机械控制
- 三、构造导航反馈,用鞍点稳定流形检查例外初态
- 四、对照合法几何、理论条件与平面仿真
- 五、保留完整地图、初始能量与数值实现限制
- 六、追问:连续时间有到达保证,离散积分后为什么还要单独做步长检查?
- 七、转向不依赖解析场的采样规划
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题定义 → 一、问题设定:势函数怎样避免非目标稳定低谷并保留边界保证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:导航函数的四个要求 → 三、构造导航反馈,用鞍点稳定流形检查例外初态
把求解机制与每步执行顺序分开检验
- 方法:导航函数的四个要求 → 二、约束临界点结构,再从几何下降接到机械控制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 从几何下降到机械控制:为什么初始速度重要 → 二、约束临界点结构,再从几何下降接到机械控制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 理论与仿真证据的覆盖范围 → 四、对照合法几何、理论条件与平面仿真
把可视证据与实验条件/证据局限放在同一节
- 理论与仿真证据的覆盖范围 → 四、对照合法几何、理论条件与平面仿真
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与实现困难 → 五、保留完整地图、初始能量与数值实现限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:零测度失败不等于不存在失败 → 三、构造导航反馈,用鞍点稳定流形检查例外初态
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:势函数怎样避免非目标稳定低谷并保留边界保证
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、约束临界点结构,再从几何下降接到机械控制
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、约束临界点结构,再从几何下降接到机械控制
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:势场的坏名声,来自缺少结构保证 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:连续时间有到达保证,离散积分后为什么还要单独做步长检查?:连续时间有到达保证,离散积分后为什么还要单独做步长检查?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Fig. 8:上方是允许的星形树组合,下方是禁止情形
方法/设定图 · 必要原图摘引 · Fig. 8,PDF 第 11 页;裁切框为原页比例 (0.1, 0.08, 0.49, 0.455)
上方是允许的星形树组合,下方是禁止情形。重点不在障碍像不像星形,而是父子连接与中心位置是否满足构造条件;不合格的几何不能直接套用导航函数定理。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。;第 IV 节其余仿真图参数尚未完整核实;选择已核实的星形树合法性图,不声明仿真结果已完整补齐。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 8
查看本篇 1 个原文证据入口
- 图 8 · PDF 第 11 页,Figure 8
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 展开导航函数梯度的驻点条件
- 加入一维导航函数的显式下降计算
- 补读有界力矩与初始能量条件,并加入势能增益手算
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 8
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cs.cmu.edu · 所列章节
通过PDF页面图像补读第502–506页:问题假设、有界力矩与初始能量、导航函数定义及坐标变换不变性;梯度与数值例为原创推导。
- www.cs.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 014-potential-field · 直接继承
本篇承接前作:以更强函数条件修复势场非目标局部极小
- 035-prm · 平行方法
解析函数构造与概率采样两种规划路线
仍需留意
- 第502–506页已视觉核读;后续几何构造长证明和完整仿真图仍未逐页核验,未新增未核实实验数字。
机器人经典Planning Optimal Grasps部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:都满足力闭合的抓取怎样比较最弱抗扰动方向
- 二、从摩擦锥和力预算构造广义力集合
- 三、实现质量计算,用长薄与均匀集合对照
- 四、读平面质量图,核对尺度和执行器预算
- 五、区分名义质量、机构可控力与真实抓取成功
- 六、追问:若任务只会受到少数方向的扰动,最大内接球仍是唯一合理排序吗?
- 七、继续检查机械手实际能控制哪些力
- 八、自测与参考答案
段落怎样重新安排
- 背景:质量指标需要对应物理限制 → 一、问题设定:都满足力闭合的抓取怎样比较最弱抗扰动方向
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:从摩擦锥到广义力集合 → 三、实现质量计算,用长薄与均匀集合对照
把求解机制与每步执行顺序分开检验
- 方法:从摩擦锥到广义力集合 → 二、从摩擦锥和力预算构造广义力集合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 力与力矩不能直接相加比较 → 二、从摩擦锥和力预算构造广义力集合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 证据与验证设置 → 四、读平面质量图,核对尺度和执行器预算
把可视证据与实验条件/证据局限放在同一节
- 证据与验证设置 → 四、读平面质量图,核对尺度和执行器预算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与局限:分数高不等于稳稳抓起 → 五、区分名义质量、机构可控力与真实抓取成功
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:体积很大,最弱方向仍可能很弱 → 三、实现质量计算,用长薄与均匀集合对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:都满足力闭合的抓取怎样比较最弱抗扰动方向
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从摩擦锥和力预算构造广义力集合
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、从摩擦锥和力预算构造广义力集合
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:能抗扰动,与需要多大手指力,是两个问题 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:若任务只会受到少数方向的扰动,最大内接球仍是唯一合理排序吗?:若任务只会受到少数方向的扰动,最大内接球仍是唯一合理排序吗?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 12.2.3 Force Closure
摩擦锥正包、满秩与正内力、机构驱动力限制段
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Fig. 1:从接触处的力方向追踪到下方广义力集合:两种总力预算产生不同的可行集合,最小抗扰能力取决于集合离原点最近的边界,不是某一方向的最大力
方法/设定图 · 必要原图摘引 · Fig. 1,PDF 第 5 页;裁切框为原页比例 (0.125, 0.24, 0.475, 0.62)
从接触处的力方向追踪到下方广义力集合:两种总力预算产生不同的可行集合,最小抗扰能力取决于集合离原点最近的边界,不是某一方向的最大力。
- 图2:三个夹爪接触多边形物体的平面抓取示意
方法/设定图 · 必要原图摘引 · 图 2, PDF page 6
三个接触面围住物体并不自动保证某个质量值;需要把接触可施加的力映射到扳手空间,再检查包络和抗扰动半径。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2
查看本篇 2 个原文证据入口
- 图 1 · PDF 第 5 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 6 页,Figure 2
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 由支持函数区分独立力预算与总力预算
- 用两指贡献0.4和0.7计算两种质量值
- 解释扳手尺度对质量比较的影响
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- users.cs.duke.edu · 所列章节
检索提取原文第4.3–4.4节最大力与总力预算及Minkowski/凸包构造。
- users.cs.duke.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 034-force-closure · 平行方法
从可实现接触力补充名义几何质量
- 013-impedance · 模块组合
静态抓取评价需与接触动态控制连接
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Novel Approach to Nonlinear/Non-Gaussian Bayesian State Estimation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:多峰后验怎样避免被单一均值压到不可能的位置
- 二、传播粒子、计算似然,再分析重采样与修整
- 三、运行样本递推,用有限独特粒子检查信息来源
- 四、分别读一维非线性与纯方位跟踪实验
- 五、检查粒子退化、高维成本和置信区间解释
- 六、追问:以相同粒子数比较两种提议分布,怎样知道改进来自哪里?
- 七、把多假设表示用于视觉与定位
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:估计对象是一个分布 → 一、问题设定:多峰后验怎样避免被单一均值压到不可能的位置
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:传播、打分、再抽一次 → 三、运行样本递推,用有限独特粒子检查信息来源
把求解机制与每步执行顺序分开检验
- 方法:传播、打分、再抽一次 → 二、传播粒子、计算似然,再分析重采样与修整
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 为什么还需要 Roughening 与 Prior Editing → 二、传播粒子、计算似然,再分析重采样与修整
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:两个例子分别验证什么 → 四、分别读一维非线性与纯方位跟踪实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 结果证据:图形之外最重要的限制 → 四、分别读一维非线性与纯方位跟踪实验
把可视证据与实验条件/证据局限放在同一节
- 结果证据:图形之外最重要的限制 → 四、分别读一维非线性与纯方位跟踪实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与适用边界 → 五、检查粒子退化、高维成本和置信区间解释
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构例子与五个前置概念 → 三、运行样本递推,用有限独特粒子检查信息来源
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能回答这些,才算理解采样的作用 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:多峰后验怎样避免被单一均值压到不可能的位置
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、传播粒子、计算似然,再分析重采样与修整
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、传播粒子、计算似然,再分析重采样与修整
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:以相同粒子数比较两种提议分布,怎样知道改进来自哪里?:以相同粒子数比较两种提议分布,怎样知道改进来自哪里?
教法来源与实际阅读范围
- Simo Särkkä · Bayesian Filtering and Smoothing (2013)
§4.2–4.3 PDF74–78页的预测/更新与Kalman推导;§7.1–7.4 PDF136–144页的样本表示、重要性与重采样;另读§7.5 PDF149–151页条件线性高斯分解与RBPF
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 4:同一时刻的后验密度中,粒子核密度保留分开的峰,而高斯近似只能用一个峰概括
实验/结果图 · 必要原图摘引 · Fig. 4,PDF 第 4 页;裁切框为原页比例 (0.485, 0.122, 0.835, 0.346)
同一时刻的后验密度中,粒子核密度保留分开的峰,而高斯近似只能用一个峰概括。图中的平滑曲线也是有限样本估计,不应把它当成已知的精确后验。
- 图2:EKF后验均值、真实状态和95%概率区间随时间的变化
实验/结果图 · 必要原图摘引 · 图 2, PDF page 4
星形真实状态与估计曲线及置信边界需同时看;狭窄区间若漏掉真值,表示不确定性描述失配,而非估计很精确。
- 图3:Bootstrap滤波后验均值、真实状态和95%概率区间
实验/结果图 · 必要原图摘引 · 图 3, PDF page 4
与图2使用同类图例比较;粒子表示改善了该非线性例子的跟踪,但少数时刻仍可能落在经验区间之外。
- 图6:目标在平面中的真实轨迹与Bootstrap、EKF估计轨迹
实验/结果图 · 必要原图摘引 · 图 6, PDF page 5
三角形是真实目标位置,实线和虚线分别是两种估计;后段的系统偏离应结合后验形状理解,不能只比平均误差。
- 图7:时刻24的500个Bootstrap位置样本与真实目标位置
实验/结果图 · 必要原图摘引 · 图 7, PDF page 5
点云沿斜向拉伸且不规则,显示位置后验的相关性与非高斯形状;不要把点云中心误当作唯一可信状态。
- Bootstrap滤波位置后验均值和95%区域及完整图例
实验/结果图 · 必要原图摘引 · Figure 8, PDF p.5
三角形真值与估计及区间一起读取,后半段真值仍处于所示区域附近;这是一次弯曲目标轨迹上的位置分量,不是速度分量或普遍校准保证。
- 同一位置分量的EKF估计和95%区域及完整图例
实验/结果图 · 必要原图摘引 · Figure 10, PDF p.6
同一位置分量在约第13步后出现明显偏离,而所报区间较窄;与Bootstrap图配对后才能说明本例中过度自信的问题。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 8、图 2、图 3、图 4、图 6、图 7、图 9、图 10、图 11
查看本篇 9 个原文证据入口
- 图 8 · PDF 第 5 页,Figure 8
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 6 · PDF 第 5 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
- 图 9 · PDF 第 5 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 6 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 6 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 追踪多峰重要性权重与重采样概率
- 用三粒子例计算整支模式消失概率
- 区分重采样无偏性与单次保留保证
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 8、图 2、图 3、图 4、图 6、图 7、图 9、图 10、图 11
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- gaoyichao.com · 所列章节
第2–3节贝叶斯递推、重采样与样本贫化,第4.1节非线性示例的覆盖率比较。
- gaoyichao.com · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 002-kalman · 平行方法
同一贝叶斯递推的不同分布表示
- 039-isard-condensation · 直接继承
后作承接本篇:采样贝叶斯传播用于视觉跟踪
- 041-mcl · 直接继承
后作承接本篇:粒子表示用于移动机器人定位
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Optimal and Efficient Path Planning for Partially-Known Environments部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:地图改变后怎样修复当前路线而不重算全部搜索
- 二、维护到目标的代价依赖,传播增减两类变化
- 三、执行状态处理与停止条件,用断桥检查远处影响
- 四、分开阅读最优性证明与随机地图重规划计时
- 五、区分当前地图最优、全知最优和复用成本
- 六、追问:改变传感器视野后,重规划总耗时还能只归因于D*实现吗?
- 七、改写增量搜索,再加入质量调节
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:最优性究竟针对哪个世界 → 一、问题设定:地图改变后怎样修复当前路线而不重算全部搜索
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:维护一个指向目标的路标网络 → 二、维护到目标的代价依赖,传播增减两类变化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 输入、处理与输出:停止条件也是算法的一部分 → 三、执行状态处理与停止条件,用断桥检查远处影响
把求解机制与每步执行顺序分开检验
- 输入、处理与输出:停止条件也是算法的一部分 → 二、维护到目标的代价依赖,传播增减两类变化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验与证明如何各司其职 → 四、分开阅读最优性证明与随机地图重规划计时
把可视证据与实验条件/证据局限放在同一节
- 实验与证明如何各司其职 → 四、分开阅读最优性证明与随机地图重规划计时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处关键证据及其边界 → 四、分开阅读最优性证明与随机地图重规划计时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失败边界 → 五、区分当前地图最优、全知最优和复用成本
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:一座桥为何会影响很远 → 三、执行状态处理与停止条件,用断桥检查远处影响
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:地图改变后怎样修复当前路线而不重算全部搜索
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、维护到目标的代价依赖,传播增减两类变化
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、维护到目标的代价依赖,传播增减两类变化
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:改变传感器视野后,重规划总耗时还能只归因于D*实现吗?:改变传感器视野后,重规划总耗时还能只归因于D*实现吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Table 1:在同一状态规模下,对照两种累计耗时与加速比
实验/结果图 · 必要原图摘引 · Table 1,PDF 第 7 页;裁切框为原页比例 (0.515, 0.53, 0.905, 0.636)
在同一状态规模下,对照两种累计耗时与加速比。表中比值是各次试验比值的平均,不能用两种耗时的均值再相除来替代;优势来自地图更新后的复用。
- 图1:初始代价传播形成的栅格回指针场
方法/设定图 · 必要原图摘引 · 图 1, PDF page 4
箭头指向当前估计的最优后继;初始传播尚未知道新障碍,因此局部路径可以指向后来需要修复的区域。
- 图2:RAISE状态传播代价增加,LOWER状态绕过障碍进入原路径区域
方法/设定图 · 必要原图摘引 · 图 2, PDF page 4
先找RAISE与LOWER两个区域,再追踪分界处箭头;D*重新处理受影响的状态,而非从头重算全部地图。
- 图3:障碍变化处理后得到的最终回指针场
方法/设定图 · 必要原图摘引 · 图 3, PDF page 5
与图1比较障碍附近箭头如何绕行;远处仍可保留旧回指针,因此图中的局部修复不能解释成整图处处已更新。
- 图4:已知完整分形地形时的规划路径
实验/结果图 · 必要原图摘引 · 图 4, PDF page 5
这张完整地图给出对照路线;不同灰度表示不同通行成本,不应把所有非黑区域都按同一距离度量。
- 图5:从乐观未知地图出发逐渐发现障碍后的路径
实验/结果图 · 必要原图摘引 · 图 5, PDF page 5
白色区域最初按可通行处理,机器人随后发现死路并回退;读图要区分执行轨迹与事先知道完整地图时的最短路径。
- 图6:在粗分辨率先验地图上规划和局部细化的路径
实验/结果图 · 必要原图摘引 · 图 6, PDF page 6
粗网格提供先验地形代价,行进中才获得细节;与图4、5对照时,应把先验信息量作为自变量。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、图 1、图 2、图 3、图 4、图 5、图 6
查看本篇 7 个原文证据入口
- 表 1 · PDF 第 7 页,Table 1
原站图表/证明入口
- 图 1 · PDF 第 4 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 5 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 5 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 逐边追踪障碍变化后的路径价值修复
- 计算两分支图中最优路径的切换
- 解释局部信息复用与最坏传播范围
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、图 1、图 2、图 3、图 4、图 5、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- publications.ri.cmu.edu · 摘要
机构摘要确认部分已知及变化环境中的重规划目标;数值依赖图为教学构造。
- www2.cs.sfu.ca · 所列章节
下载原稿补读第3–4节:最优与完备条件、10格半径、五地图平均、排除初始规划的累计重规划CPU时间与加速比平均。
- www2.cs.sfu.ca · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 003-astar · 历史背景
保持最短路目标但增量复用
- 046-dstar-lite · 历史背景
同任务的后续算法重构,队列规则不同
仍需留意
- 未复现图搜索,原文未给随机种子与方差;本轮方法和实验条件已补核。
机器人经典Good Features to Track部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:适合求位移的窗口怎样在跟踪中继续保持可信
- 二、按最小特征值选点,再用仿射残差监控
- 三、实现平移跟踪与模板检查,识别外观破坏
- 四、读序列对照,分开正常形变与错误特征
- 五、保留遮挡、光度变化与镜面亮斑反例
- 六、追问:每次都把最新窗口当监控模板,会怎样改变检测漂移的能力?
- 七、把特征轨迹交给视觉惯性估计
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题:先问跟踪器需要什么 → 一、问题设定:适合求位移的窗口怎样在跟踪中继续保持可信
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法一:用最弱方向决定是否值得追踪 → 二、按最小特征值选点,再用仿射残差监控
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法二:追踪时简单,检查时允许形变 → 三、实现平移跟踪与模板检查,识别外观破坏
把求解机制与每步执行顺序分开检验
- 方法二:追踪时简单,检查时允许形变 → 二、按最小特征值选点,再用仿射残差监控
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置与对照 → 四、读序列对照,分开正常形变与错误特征
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:分别支持什么 → 四、读序列对照,分开正常形变与错误特征
把可视证据与实验条件/证据局限放在同一节
- 五处证据:分别支持什么 → 四、读序列对照,分开正常形变与错误特征
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失效方式 → 五、保留遮挡、光度变化与镜面亮斑反例
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个教学例子与五个前置概念 → 三、实现平移跟踪与模板检查,识别外观破坏
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:适合求位移的窗口怎样在跟踪中继续保持可信
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、按最小特征值选点,再用仿射残差监控
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、按最小特征值选点,再用仿射残差监控
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:每次都把最新窗口当监控模板,会怎样改变检测漂移的能力?:每次都把最新窗口当监控模板,会怎样改变检测漂移的能力?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:9 幅
- Fig. 15:多数曲线留在低差异带,若干特征的残差明显升高
实验/结果图 · 必要原图摘引 · Fig. 15,PDF 第 7 页;裁切框为原页比例 (0.5, 0.375, 0.905, 0.592)
多数曲线留在低差异带,若干特征的残差明显升高。仿射补偿先解释正常形变,再把异常轨迹凸显出来;高残差可以报警,低残差却不能证明对应必然正确。
- 图3:两段特征窗口在纯平移与仿射模型下的不相似度曲线
实验/结果图 · 必要原图摘引 · 图 3, PDF page 4
虚线为纯平移、实线为仿射模型;同一特征必须对应同一种点标记,才能区分形变建模带来的下降和遮挡造成的升高。
- 图8:硬币纹理的仿射跟踪过程及误差与参数轨迹
实验/结果图 · 必要原图摘引 · 图 8, PDF page 5
上排展示局部图像逐步对齐,下排与图7同类地显示误差和参数变化;纹理更复杂并不改变所拟合的仿射模型。
- 图9:四个亮斑错误匹配十字目标时的迭代图像与残差
实验/结果图 · 必要原图摘引 · 图 9, PDF page 6
即使参数迭代趋于稳定,不相似度仍保持较高;这一反例说明收敛不等于匹配对象正确。
- 表1:仿真实验中真实与求得的仿射变形矩阵和位移
实验/结果图 · 必要原图摘引 · 表 1, PDF page 5
逐项比较真实矩阵、估计矩阵与平移向量;表中误差展示数值恢复程度,不能据此推出任意初值均能收敛。
- 图6:三种仿射变化下原图、迭代过程与含噪目标图的三行五列对比
实验/结果图 · 必要原图摘引 · 图 6, PDF page 5
每行从最左原图读到最右含噪目标,中间列是不同迭代阶段;收敛是模型与纹理共同决定的,不能仅凭终帧相似断言唯一解。
- 图7:三种仿射变化中不相似度、位移误差、形变误差及参数迭代轨迹
实验/结果图 · 必要原图摘引 · 图 7, PDF page 5
前三列是不同误差量,后两列是参数轨迹;先分别确认纵轴和迭代步数,避免把不同量纲的下降速度直接比较。
- 图12:纯平移模型下各特征的不相似度时间曲线
实验/结果图 · 必要原图摘引 · 图 12, PDF page 6
许多曲线一起上升,难以将真正失效的特征分离出来;与原有图15的仿射补偿结果对照,才能理解质量监测的改进。
- 六个桌面特征在六帧中的局部图像块及帧编号
实验/结果图 · 必要原图摘引 · Figure 14, PDF p.7
第4行特征60对应细字区域,随运动出现混叠;这解释了为什么仅靠较低的外观差异分数也可能接受不可靠特征。该图来自作者桌面序列,不是Manhattan电影帧。
未在正文展示的图/表与范围
- 图1:剩余四幅含《Manhattan》电影帧及其技术处理局部,属于论文之外的影像来源;当前已展示作者桌面实验拼图、合成实验和定量曲线,不再将两组电影序列成套加入。论文公开下载并不能说明电影画面的再利用条件;这不是对单幅必要评论摘引的绝对禁止判断。
- 图2:剩余四幅含《Manhattan》电影帧及其技术处理局部,属于论文之外的影像来源;当前已展示作者桌面实验拼图、合成实验和定量曲线,不再将两组电影序列成套加入。论文公开下载并不能说明电影画面的再利用条件;这不是对单幅必要评论摘引的绝对禁止判断。
- 图4:剩余四幅含《Manhattan》电影帧及其技术处理局部,属于论文之外的影像来源;当前已展示作者桌面实验拼图、合成实验和定量曲线,不再将两组电影序列成套加入。论文公开下载并不能说明电影画面的再利用条件;这不是对单幅必要评论摘引的绝对禁止判断。
- 图5:剩余四幅含《Manhattan》电影帧及其技术处理局部,属于论文之外的影像来源;当前已展示作者桌面实验拼图、合成实验和定量曲线,不再将两组电影序列成套加入。论文公开下载并不能说明电影画面的再利用条件;这不是对单幅必要评论摘引的绝对禁止判断。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 5、图 8、图 9、图 6、图 7、图 12、图 15、图 14
查看本篇 12 个原文证据入口
- 图 1 · PDF 第 4 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 4 页,Figure 5
原站图表/证明入口
- 图 8 · PDF 第 5 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 6 页,Figure 9
原站图表/证明入口
- 图 6 · PDF 第 5 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
- 图 12 · PDF 第 6 页,Figure 12
原站图表/证明入口
- 图 15 · PDF 第 7 页,Figure 15
原站图表/证明入口
- 图 14 · PDF 第 7 页,Figure 14
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 从正规矩阵推导定位误差的方向性
- 比较最小特征值不同的两个特征块
- 区分局部可跟踪性与跨图可识别性
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 5、图 8、图 9、图 6、图 7、图 12、图 15、图 14
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- publications.ri.cmu.edu · 摘要
原作者机构摘要中的选点、仿射扩展、遮挡及非物理特征监控。
- cs.ucf.edu · 所列章节
以页面图像补读印刷第595–596页:结构张量最小特征值条件、跨帧平移与长期仿射监控的分工、遮挡差异图。
- cs.ucf.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 008-lucas-kanade · 直接继承
本篇承接前作:从跟踪法的线性化条件设计选点
- 023-harris · 平行方法
同结构张量但不同响应
- 092-vinsmono · 模块组合
局部特征跟踪是视觉惯性前端模块
仍需留意
- 第4–5节已视觉核读;未新核对全篇所有矩阵表项或复现跟踪。
机器人经典On the Closure Properties of Robotic Grasping部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:名义接触力怎样区分为机构真正能控制的力
- 二、分开形式闭合、内力零空间和可控内力
- 三、执行闭合判定,用联动手指检查可实现维数
- 四、读几何命题与数值搜索,区分辅助系统和机器人
- 五、检查接触、刚度、驱动模型与任务方向
- 六、追问:改变手指传动耦合而保持接触点不变,哪些旧结论需要重新检查?
- 七、比较全身接触中的可控力约束
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:四个不同的问题不要合并 → 一、问题设定:名义接触力怎样区分为机构真正能控制的力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 形式闭合:从不等式描述剩余自由 → 三、执行闭合判定,用联动手指检查可实现维数
把求解机制与每步执行顺序分开检验
- 形式闭合:从不等式描述剩余自由 → 二、分开形式闭合、内力零空间和可控内力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 力闭合:内力零空间只是第一步 → 二、分开形式闭合、内力零空间和可控内力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 从判定到优化:辅助动力系统不是机器人运动 → 二、分开形式闭合、内力零空间和可控内力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 证据:理论和数值例子分别承担什么 → 四、读几何命题与数值搜索,区分辅助系统和机器人
把可视证据与实验条件/证据局限放在同一节
- 证据:理论和数值例子分别承担什么 → 四、读几何命题与数值搜索,区分辅助系统和机器人
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与边界 → 五、检查接触、刚度、驱动模型与任务方向
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构小例子与五个前置概念 → 三、执行闭合判定,用联动手指检查可实现维数
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:名义接触力怎样区分为机构真正能控制的力
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、分开形式闭合、内力零空间和可控内力
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、分开形式闭合、内力零空间和可控内力
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:改变手指传动耦合而保持接触点不变,哪些旧结论需要重新检查?:改变手指传动耦合而保持接触点不变,哪些旧结论需要重新检查?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 12.2.3 Force Closure
摩擦锥正包、满秩与正内力、机构驱动力限制段
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Fig. 9:横轴改变抓取姿态,质量函数只在一个角度区间内保持有效余量
实验/结果图 · 必要原图摘引 · Fig. 9,PDF 第 22 页;裁切框为原页比例 (0.12, 0.16, 0.92, 0.515)
横轴改变抓取姿态,质量函数只在一个角度区间内保持有效余量。峰值位置属于给定三指机构、物体与摩擦设置,不能变成所有三指抓取的通用最佳角度。
- 图1:四种接触与夹持构型,用于区分不同闭合定义
方法/设定图 · 必要原图摘引 · 图 1, PDF page 3
对照(a)至(d)的接触约束和夹具自由度;几何上限制运动、可施加内力与承受外扰是不同命题。
- 图8:三指夹持三角柱的实体视图与平面接触法线
方法/设定图 · 必要原图摘引 · 图 8, PDF page 20
左图定位真实夹爪结构,右图给出接触点、法线与转角;之后的质量分析依赖这些接触约束,而不只是手指数量。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 8、图 9
查看本篇 3 个原文证据入口
- 图 1 · PDF 第 3 页,Figure 1
原站图表/证明入口
- 图 8 · PDF 第 20 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 22 页,Figure 9
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 将接触力零空间与执行器可达性联系
- 给出闭合几何成立却驱动力不成立的反例
- 区分形式闭合、力闭合与可实现抓握
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 8、图 9
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.centropiaggio.unipi.it · 所列章节
作者稿引言同接触不同机构反例及闭合定义;一维受限驱动例为原创。
- www.centropiaggio.unipi.it · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 030-grasp-quality · 历史背景
引言明确讨论传统闭合测试忽略机构能力
- 080-wholebody-qp · 教学联系
教学对照任务合力与关节可实现性;质心全身轨迹优化并未自动包含全部关节力矩界。
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Probabilistic Roadmaps for Path Planning in High-Dimensional Configuration Spaces部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:高维构型空间怎样形成可复用的连通图
- 二、采样自由构型,再用局部连接验证边
- 三、实现建图和查询,用成本摊销检验多次任务
- 四、读高维机构实验,连同预处理和碰撞成本报告
- 五、检查窄通道、有限图失败与路径质量
- 六、追问:环境改变后,旧道路图的哪些信息还能安全复用?
- 七、从多次查询走向随机树与极限质量
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:图的顶点必须是一整个机器人姿态 → 一、问题设定:高维构型空间怎样形成可复用的连通图
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:采样、连接、扩展、查询 → 三、实现建图和查询,用成本摊销检验多次任务
把求解机制与每步执行顺序分开检验
- 方法:采样、连接、扩展、查询 → 二、采样自由构型,再用局部连接验证边
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 数学目标、机制与指标各是什么 → 二、采样自由构型,再用局部连接验证边
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验怎样检验道路图是否有用 → 四、读高维机构实验,连同预处理和碰撞成本报告
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:结论应落在哪一层 → 四、读高维机构实验,连同预处理和碰撞成本报告
把可视证据与实验条件/证据局限放在同一节
- 五处证据:结论应落在哪一层 → 四、读高维机构实验,连同预处理和碰撞成本报告
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与适用边界 → 五、检查窄通道、有限图失败与路径质量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个教学例子与五个前置概念 → 三、实现建图和查询,用成本摊销检验多次任务
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否把速度与可靠性说清楚 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:高维构型空间怎样形成可复用的连通图
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、采样自由构型,再用局部连接验证边
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、采样自由构型,再用局部连接验证边
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:随机采样不是随机乱走 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:环境改变后,旧道路图的哪些信息还能安全复用?:环境改变后,旧道路图的哪些信息还能安全复用?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Fig. 11:表中把建图时间与成功比例并列,必须在相同场景及局部规划器下比较
实验/结果图 · 必要原图摘引 · Fig. 11,PDF 第 13 页;裁切框为原页比例 (0.095, 0.092, 0.825, 0.2)
表中把建图时间与成功比例并列,必须在相同场景及局部规划器下比较。查询很快并不抹去前期建图成本,随机多次运行的成功率也不是完备性证明。
- 图2:七旋转关节固定基座机械臂在窄门场景中的八种测试构型
实验/结果图 · 必要原图摘引 · 图 2, PDF page 9
C1至C8是不同查询构型,障碍布局相同;比较查询成功率时,应保留构型差异,不能仅用平均成功率代表所有窄通道。
- 图12:通用规划器在图2场景的学习时间、碰撞检测与各构型成功率表
实验/结果图 · 必要原图摘引 · 图 12, PDF page 13
逐列看C1、C4、C7、C8的成功率,再对照学习成本;扩展路网可以改善困难构型,但额外预处理并非免费。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 11、图 12
- 明确印刷页与文件页序的差别,避免误述存在额外前页
查看本篇 3 个原文证据入口
- 图 2 · PDF 第 9 页,Figure 2
原站图表/证明入口
- 图 11 · PDF 第 13 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 13 页,Figure 12
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 以覆盖球事件推导有限样本失败上界
- 计算狭窄区域概率与样本预算的关系
- 补核30图接入协议与预算成功率,区分预处理摊销和渐近保证
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 11、图 12
- 明确印刷页与文件页序的差别,避免误述存在额外前页
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.kavrakilab.org · 摘要
作者摘要核对学习/查询两阶段、静态环境和局部规划器;覆盖概率为条件明确的教学界。
- www.cs.cmu.edu · 所列章节
期刊扫描稿已下载并视觉补读569、571、574、578–579页:跨分量连接、失败率引导扩展、30张道路图/2.5秒接入、Fig.11–12各预算成功率及预处理成本。
- www.cs.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 040-rrt · 平行方法
多查询道路图与单查询树的对照
- 062-rrtstar · 历史背景
可行性与渐近最优性条件应区分
仍需留意
- 本轮补核所列方法、实验协议和关键表;其余几何细节与图示沿用此前整理,未逐页重读或重新运行实验。
机器人经典An Implicit Time-Stepping Scheme for Rigid Body Dynamics with Inelastic Collisions and Coulomb Friction部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:碰撞瞬间的速度突变怎样进入有限时间步模拟
- 二、把法向互补与摩擦写成冲量约束
- 三、联合推进位置与速度,用冲量和平均力查单位
- 四、读杆落桌与多球实验,检查步长收敛口径
- 五、区分数值误差、接触模型与真实物理验证
- 六、追问:接触步只更新速度、不校验下一位置,会遗漏什么约束?
- 七、把接触模型接入优化和仿真组件
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:力、冲量和接触模式 → 一、问题设定:碰撞瞬间的速度突变怎样进入有限时间步模拟
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把下一步位置和接触冲量一起求出来 → 三、联合推进位置与速度,用冲量和平均力查单位
把求解机制与每步执行顺序分开检验
- 方法:把下一步位置和接触冲量一起求出来 → 二、把法向互补与摩擦写成冲量约束
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 为什么位置层面的非穿透很重要 → 二、把法向互补与摩擦写成冲量约束
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验和证明如何分工 → 四、读杆落桌与多球实验,检查步长收敛口径
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:哪些稳定性已经被观察到 → 四、读杆落桌与多球实验,检查步长收敛口径
把可视证据与实验条件/证据局限放在同一节
- 五处证据:哪些稳定性已经被观察到 → 四、读杆落桌与多球实验,检查步长收敛口径
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价和失败边界 → 五、区分数值误差、接触模型与真实物理验证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 小例子:同样的冲量,不同的平均力 → 三、联合推进位置与速度,用冲量和平均力查单位
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否辨认模型误差与积分误差 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:碰撞瞬间的速度突变怎样进入有限时间步模拟
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把法向互补与摩擦写成冲量约束
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把法向互补与摩擦写成冲量约束
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:刚体碰撞为什么不是普通的积分问题 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:接触步只更新速度、不校验下一位置,会遗漏什么约束?:接触步只更新速度、不校验下一位置,会遗漏什么约束?
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Planning and Control through Contact
混合系统modes/guards/resets,Direct shooting与接触时刻梯度、最小及浮动基坐标
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 4:首次撞击附近不同步长出现不同尖峰,随后曲线又接近
实验/结果图 · 必要原图摘引 · Fig. 4,PDF 第 17 页;裁切框为原页比例 (0.17, 0.135, 0.86, 0.59)
首次撞击附近不同步长出现不同尖峰,随后曲线又接近。应把接触瞬间单独读:整体走势相似不能掩盖粗步长造成的瞬时数值误差。
- 图1:连续摩擦圆锥与八个切向方向形成的多面体近似
方法/设定图 · 必要原图摘引 · 图 1, PDF page 7
圆形截面与内接多边形对应连续摩擦方向和离散基方向;更多方向可减小几何近似误差,同时增大计算问题规模。
- 图2:下落并旋转的杆在步长0.0025下的连续构型
实验/结果图 · 必要原图摘引 · 图 2, PDF page 15
数字标注对应模拟时刻,杆先后发生接触并最终平躺;这是离散时间求解的几何结果,不是独立实验真值。
- 图3:不同时间步长下旋转下落杆的垂直速度曲线及完整图例
实验/结果图 · 必要原图摘引 · 图 3, PDF page 16
各曲线在接触时刻出现跳变,步长减小时事件附近的差异缩小;应比较状态轨迹,而非把有限步长的跳变斜率解释为真实接触力。
- 表1:四球数值解随步长变化的速度误差、位置误差和速度总变差
实验/结果图 · 必要原图摘引 · 表 1, PDF page 19
参考行使用更细步长0.00125;两种误差量的定义不同,随步长下降只能支持该模型的数值趋近,不能代替现实精度验证。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4
查看本篇 4 个原文证据入口
- 图 1 · PDF 第 7 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 15 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 16 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 17 页,Figure 4
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 逐步计算自由预测、接触冲量与速度更新
- 用一维落地例检验离散非穿透条件
- 连接接触仿真与后作直接接触优化
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- iro.uiowa.edu · 摘要
机构记录中的冲量、非穿透与数值实验范围;教学离散质点例自行求解。
- www.cse.lehigh.edu · 所列章节
原稿文本乱码,以页面图像补读第7–8页式14–16:离散动量位置更新、接触互补和摩擦耗散。
- www.cse.lehigh.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 071-mujoco · 平行方法
不同接触模型和求解器设计
- 075-contact-trajopt · 模块组合
接触互补离散关系进入轨迹优化
仍需留意
- 离散公式已通过原稿图像补核;未逐行重做存在性证明,数值实验全图未新核。
机器人经典A Tutorial on Visual Servo Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:图像误差怎样闭合成机器人速度反馈
- 二、对照PBVS与IBVS,推导图像和任务雅可比
- 三、接通观察到动作链条,用像素位移例子查符号
- 四、读教程解析关系与已有系统,避免伪造排行榜
- 五、检查深度、时延、特征维数与奇异性
- 六、追问:同一组像素误差用不同深度估计得到不同速度,应该怎样做公平比较?
- 七、为视觉反馈补上标定与可靠特征
- 八、自测与参考答案
段落怎样重新安排
- 先分清三个容易混淆的分类 → 四、读教程解析关系与已有系统,避免伪造排行榜
把可视证据与实验条件/证据局限放在同一节
- 先分清三个容易混淆的分类 → 一、问题设定:图像误差怎样闭合成机器人速度反馈
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- PBVS:先恢复三维,再在任务空间控制 → 二、对照PBVS与IBVS,推导图像和任务雅可比
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- IBVS:直接消除图像特征误差 → 二、对照PBVS与IBVS,推导图像和任务雅可比
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 输入、处理和输出的完整链条 → 三、接通观察到动作链条,用像素位移例子查符号
把求解机制与每步执行顺序分开检验
- 输入、处理和输出的完整链条 → 二、对照PBVS与IBVS,推导图像和任务雅可比
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 如何评价这篇教程,而不是硬套实验排行榜 → 四、读教程解析关系与已有系统,避免伪造排行榜
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处原文证据 → 四、读教程解析关系与已有系统,避免伪造排行榜
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与理解边界 → 五、检查深度、时延、特征维数与奇异性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个可算的小例子 → 三、接通观察到动作链条,用像素位移例子查符号
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否把观察与动作对上 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:图像误差怎样闭合成机器人速度反馈
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、对照PBVS与IBVS,推导图像和任务雅可比
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、对照PBVS与IBVS,推导图像和任务雅可比
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:看见偏差以后,怎样把像素变成动作 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:同一组像素误差用不同深度估计得到不同速度,应该怎样做公平比较?:同一组像素误差用不同深度估计得到不同速度,应该怎样做公平比较?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Figs. 2–3:上方区分眼在手上与固定相机,下方展示视觉估计和内层机器人控制的连接
方法/设定图 · 必要原图摘引 · Figs. 2–3,PDF 第 5 页;裁切框为原页比例 (0.1, 0.085, 0.93, 0.468)
上方区分眼在手上与固定相机,下方展示视觉估计和内层机器人控制的连接。这两条分类轴独立:相机安装位置本身不决定使用图像误差还是三维位姿误差。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3
查看本篇 2 个原文证据入口
- 图 2 · PDF 第 5 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 5 页,Figure 3
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读;扫描稿使用原页 OCR 定位并对重点页看图;未从模糊曲线反演新增数值
本次深化
- 推导深度估计误差如何改变视觉闭环收敛率
- 手算像素误差、速度命令与实际误差变化
- 明确相机坐标速度和深度正值假设
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- faculty.cc.gatech.edu · 所列章节
检索读取第661页第V节图像误差、图像雅可比及求逆关系。
- faculty.cc.gatech.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 004-resolved-rate · 模块组合
图像雅可比与机器人速度逆解组合
- 042-zhang-calibration · 模块组合
投影内参进入视觉控制接口
- 033-good-features · 模块组合
特征跟踪构成视觉反馈前端
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典The Dynamic Window Approach to Collision Avoidance部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:几何可通的方向怎样变成当前可达且可刹停的速度
- 二、用圆弧预测,求硬件、动态窗口与停车集合交集
- 三、筛选后评价速度,用停车距离检查安全条件
- 四、把RHINO速度结果与传感制动条件一起读
- 五、保留短视决策、感知时延与动态障碍限制
- 六、追问:提高控制频率却不改变制动能力,停车安全范围会自动等比例扩大吗?
- 七、比较路径上的提前减速问题
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:局部控制不是全局找路 → 一、问题设定:几何可通的方向怎样变成当前可达且可刹停的速度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法一:用圆弧压缩运动预测 → 二、用圆弧预测,求硬件、动态窗口与停车集合交集
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法二:三个集合取交集 → 二、用圆弧预测,求硬件、动态窗口与停车集合交集
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法三:安全筛选之后再优化偏好 → 三、筛选后评价速度,用停车距离检查安全条件
把求解机制与每步执行顺序分开检验
- 方法三:安全筛选之后再优化偏好 → 二、用圆弧预测,求硬件、动态窗口与停车集合交集
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置:传感、制动和计算周期共同决定能力 → 四、把RHINO速度结果与传感制动条件一起读
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:速度数字不能脱离任务 → 四、把RHINO速度结果与传感制动条件一起读
把可视证据与实验条件/证据局限放在同一节
- 五处证据:速度数字不能脱离任务 → 四、把RHINO速度结果与传感制动条件一起读
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、局限和失败条件 → 五、保留短视决策、感知时延与动态障碍限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个可算的停车例子 → 三、筛选后评价速度,用停车距离检查安全条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否区分可达、可停和有用 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:几何可通的方向怎样变成当前可达且可刹停的速度
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用圆弧预测,求硬件、动态窗口与停车集合交集
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、把RHINO速度结果与传感制动条件一起读
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:目标在右边,不代表现在就能右转 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:提高控制频率却不改变制动能力,停车安全范围会自动等比例扩大吗?:提高控制频率却不改变制动能力,停车安全范围会自动等比例扩大吗?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:12 幅
- Fig. 20:同一门口几何下,不同动态参数会改变可执行的转弯轨迹
实验/结果图 · 必要原图摘引 · Fig. 20,PDF 第 19 页;裁切框为原页比例 (0.28, 0.175, 0.785, 0.395)
同一门口几何下,不同动态参数会改变可执行的转弯轨迹。图中绕行不是单纯目标方向估计错误,而是加速度与制动能力限制了当前可选动作。
- 图2:机器人沿走廊前进而目标位于侧门外的场景
方法/设定图 · 必要原图摘引 · 图 2, PDF page 4
当前位置、朝向与目标位置需要一起读;目标在右侧并不意味着当前速度下能安全立即转右。
- 图4:由障碍物与制动约束形成的可容许速度空间
方法/设定图 · 必要原图摘引 · 图 4, PDF page 10
横轴为角速度、纵轴为线速度,灰区对应不可容许速度;图中的墙名映射回图2的障碍,而不是机器人当前位置。
- 图5:动态窗口、当前速度以及可容许速度的交集
方法/设定图 · 必要原图摘引 · 图 5, PDF page 11
先找到当前速度点,再看有限时间内可达的矩形窗口;最终搜索域还要与制动安全域相交。
- 图12:相同加速度约束下两个当前线速度对应的动态窗口
方法/设定图 · 必要原图摘引 · 图 12, PDF page 14
两个窗口的中心不同,表示当前速度不同;即使目标与障碍相同,可行的下一步控制也随当前运动状态改变。
- 图13:较高当前速度对应的动态窗口内目标函数曲面
方法/设定图 · 必要原图摘引 · 图 13, PDF page 15
被窗口裁掉的速度不参与最终优化;读曲面峰值时,应先确认它位于本次可行域,不能用全局曲面峰替代可执行动作。 原页曲面内标签写(70,0),图注写(75,0),两者不一致;这里保留原貌,不替作者改数。
- 图14:较低当前速度对应的动态窗口内目标函数曲面
方法/设定图 · 必要原图摘引 · 图 14, PDF page 15
与图13对照当前速度变化后峰的位置;更低速度使可行的转弯曲率范围发生变化,路径选择因此不同。
- 图15:较低线加速度与角加速度限制下的动态窗口
方法/设定图 · 必要原图摘引 · 图 15, PDF page 16
缩小的可达窗口限制了下一步速度变化;不能只降低最高速度而忽略加速度对可执行转向的限制。
- 图16:低加速度条件下整个速度空间的目标函数曲面
方法/设定图 · 必要原图摘引 · 图 16, PDF page 16
这是完整速度空间的评价,存在的高峰未必在当前动态窗口中;必须与图17的受限评价一起读。
- 图17:低加速度条件下动态窗口内的目标函数曲面
方法/设定图 · 必要原图摘引 · 图 17, PDF page 16
与图16使用相同评价思路,但只保留当前可达部分;可执行最优动作可能与全速度空间最优点不同。
- 图21:走廊中绕过单个人体障碍的机器人轨迹
实验/结果图 · 必要原图摘引 · 图 21, PDF page 19
轨迹展示这一场景中的绕行与恢复直行;它是一次实验路径,不给出对任意动态障碍的全局安全保证。
- 图22:拥挤走廊中绕过多个人体障碍的轨迹
实验/结果图 · 必要原图摘引 · 图 22, PDF page 20
沿虚线追踪机器人在多个障碍和门口之间的运动;最窄处的可通过性需连同机器人尺寸与速度约束理解。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 4、图 5、图 12、图 13、图 15、图 16、图 20、图 21、图 22
查看本篇 10 个原文证据入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 10 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 11 页,Figure 5
原站图表/证明入口
- 图 12 · PDF 第 14 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 15 页,Figure 13
原站图表/证明入口
- 图 15 · PDF 第 16 页,Figure 15
原站图表/证明入口
- 图 16 · PDF 第 16 页,Figure 16
原站图表/证明入口
- 图 20 · PDF 第 19 页,Figure 20
原站图表/证明入口
- 图 21 · PDF 第 19 页,Figure 21
原站图表/证明入口
- 图 22 · PDF 第 20 页,Figure 22
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 把感知制动延迟加入停车距离教学模型
- 计算可停速度与动态窗口加速度界
- 补核RHINO周期与速度条件,区分模型可停与实机闭环安全
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 4、图 5、图 12、图 13、图 15、图 16、图 20、图 21、图 22
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- publications.ri.cmu.edu · 摘要
机构摘要核实synchro-drive及RHINO最高95厘米/秒的实验范围;延迟界为教学扩展。
- publications.ri.cmu.edu · 所列章节
23页作者稿第3.3、4、5及6节:圆弧误差界、可停速度/动态窗口、0.25秒周期与0.4秒声呐扫描、72条线、72/65厘米每秒平均速度及95厘米每秒上限。
- publications.ri.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 026-vfh · 平行方法
局部方向选择与速度可行域对照
- 093-toppra · 教学联系
停车可行性和后向可控集共享直觉但问题不同
仍需留意
- 方法与关键实验正文已补核,未重新读取全部图中曲面数值、播放实验视频或复现RHINO。
机器人经典CONDENSATION—Conditional Density Propagation for Visual Tracking部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:视觉杂波中的多个轮廓解释怎样保留到下一帧
- 二、将样本预测与轮廓似然结合,维护多峰分布
- 三、运行动态模型与重采样,用错误峰恢复作检查
- 四、读舞者与多人图,连同粒子数和速度比较
- 五、区分多峰表示、初始化与多目标身份跟踪
- 六、追问:正确峰已经被全部重采样掉时,未来图像更清晰为何也未必能恢复?
- 七、将多峰状态表示迁移到定位
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:状态不是每个像素,而是低维轮廓参数 → 一、问题设定:视觉杂波中的多个轮廓解释怎样保留到下一帧
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:预测分布乘上当前图像证据 → 三、运行动态模型与重采样,用错误峰恢复作检查
把求解机制与每步执行顺序分开检验
- 方法:预测分布乘上当前图像证据 → 四、读舞者与多人图,连同粒子数和速度比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 观测模型:为什么没看到边缘也不能直接判死刑 → 二、将样本预测与轮廓似然结合,维护多峰分布
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 优化了什么:估计质量与计算量的交换 → 二、将样本预测与轮廓似然结合,维护多峰分布
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置与训练来源 → 四、读舞者与多人图,连同粒子数和速度比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据及其限度 → 四、读舞者与多人图,连同粒子数和速度比较
把可视证据与实验条件/证据局限放在同一节
- 五处证据及其限度 → 四、读舞者与多人图,连同粒子数和速度比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、局限和一个重要反直觉 → 五、区分多峰表示、初始化与多目标身份跟踪
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 教学例子和前置概念 → 三、运行动态模型与重采样,用错误峰恢复作检查
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否真正理解“多保留一个答案” → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:视觉杂波中的多个轮廓解释怎样保留到下一帧
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、将样本预测与轮廓似然结合,维护多峰分布
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、将样本预测与轮廓似然结合,维护多峰分布
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:一帧图像不够时,别急着只选一个目标 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
- 四、证据节内以“证据”命名的机制段 → 二、将样本预测与轮廓似然结合,维护多峰分布
“观测证据”是推断算法的输入,不是实验结果;恢复先推导概率更新、再实现、最后看原文实验的依赖。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:正确峰已经被全部重采样掉时,未来图像更清晰为何也未必能恢复?:正确峰已经被全部重采样掉时,未来图像更清晰为何也未必能恢复?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 12:左右采用相同运动模型,却因密度表示不同而出现不同跟踪结果
实验/结果图 · 必要原图摘引 · Fig. 12,PDF 第 15 页;裁切框为原页比例 (0.155, 0.155, 0.9, 0.403)
左右采用相同运动模型,却因密度表示不同而出现不同跟踪结果。看右侧轨迹被杂波拉走的时段,再对照左侧保留的轨迹;这仍只是所示序列的比较。
- 图1:高斯状态密度依次经历确定性漂移、随机扩散与观测校正
方法/设定图 · 必要原图摘引 · 图 1, PDF page 2
按箭头顺序读四个分布;在高斯假设下,变化仍可由均值和协方差概括,这是后续多峰传播图的对照。
- 图2:多峰状态密度经历漂移、扩散与观测校正
方法/设定图 · 必要原图摘引 · 图 2, PDF page 3
与图1比较,多个峰可在预测和校正后继续存在;保留竞争假设是粒子表示的关键,并非仅让单个高斯变宽。
- 图9:杂乱室内三个人物的初始实验画面
实验/结果图 · 必要原图摘引 · 图 9, PDF page 12
此图建立图10的目标与遮挡关系:一个人物移动到另外两人前方;它本身不是跟踪精度结果。
- 图10:多峰密度随时间演变及对应八个图像片段
实验/结果图 · 必要原图摘引 · 图 10, PDF page 13
左侧密度峰与右侧人物位置对应,时间向下推进;峰的合并和分离说明多假设能在遮挡期间继续传播。
- 图13:连续四帧中从失跟到恢复的粒子轮廓分布
实验/结果图 · 必要原图摘引 · 图 13, PDF page 16
四面板分别为900至960毫秒;先看错误假设如何分裂,再看概率较高的假设回到人物,不能把单帧恢复当作保证。
- 图16:杂乱桌面背景上手部轮廓随运动与形变的三帧跟踪结果
实验/结果图 · 必要原图摘引 · 图 16, PDF page 18
三帧轮廓既平移旋转,也随手指形变变化;这是特定形状模型与样本设置下的展示,不能外推为任意手势识别。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 9、图 10、图 12、图 13、图 16
查看本篇 7 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 9 · PDF 第 12 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 13 页,Figure 10
原站图表/证明入口
- 图 12 · PDF 第 15 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 16 页,Figure 13
原站图表/证明入口
- 图 16 · PDF 第 18 页,Figure 16
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 计算先验与似然冲突时的两模态后验
- 量化重采样丢失正确模式的概率
- 补核各视频训练/初始化和粒子速度条件,区分分布表示与覆盖
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 9、图 10、图 12、图 13、图 16
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.robots.ox.ac.uk · 摘要
作者摘要中的多假设随机表示和学习动态模型。
- people.eecs.berkeley.edu · 所列章节
期刊第3–4、6、7.1–7.4及8节:有放回重采样与独立扩散、轮廓似然近似、70帧/500场条件、手动初始化、1500到500粒子及6.5/25/50Hz的不同配置。
- people.eecs.berkeley.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 031-bootstrap-filter · 直接继承
本篇承接前作:采样表示和条件密度传播
- 008-lucas-kanade · 平行方法
单局部解与多假设轮廓跟踪对照
仍需留意
- 关键方法、实验正文与图注已补核;原始视频未逐帧播放,附录证明未逐行重验,未复现跟踪器。
机器人经典Rapidly-Exploring Random Trees: A New Tool for Path Planning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:一次规划怎样让树优先长向尚未覆盖的区域
- 二、随机采目标,再以最近邻短步扩展产生Voronoi偏置
- 三、实现合法短控制推进,检查状态中的速度分量
- 四、读短报告算例,分开探索形态与质量保证
- 五、检查距离设计、非完整约束和已有解不改进
- 六、追问:改变最近邻距离而保持同一随机样本,会改变树的探索偏置吗?
- 七、让树更快会合,或持续改进旧路径
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:树长在状态空间,不一定只长在位置空间 → 一、问题设定:一次规划怎样让树优先长向尚未覆盖的区域
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:随机状态只是方向,不是必须到达的点 → 三、实现合法短控制推进,检查状态中的速度分量
把求解机制与每步执行顺序分开检验
- 方法:随机状态只是方向,不是必须到达的点 → 二、随机采目标,再以最近邻短步扩展产生Voronoi偏置
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- Voronoi 偏置:为什么外缘节点更容易被选中 → 二、随机采目标,再以最近邻短步扩展产生Voronoi偏置
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 数学目标、机制与实验指标 → 四、读短报告算例,分开探索形态与质量保证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 算例设置:短报告能支持多强的结论 → 三、实现合法短控制推进,检查状态中的速度分量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据与不能推出的结论 → 四、读短报告算例,分开探索形态与质量保证
把可视证据与实验条件/证据局限放在同一节
- 五处证据与不能推出的结论 → 四、读短报告算例,分开探索形态与质量保证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与最常见误解 → 五、检查距离设计、非完整约束和已有解不改进
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个教学例子与五个前置概念 → 三、实现合法短控制推进,检查状态中的速度分量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否解释树为什么会长成这样 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:一次规划怎样让树优先长向尚未覆盖的区域
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、随机采目标,再以最近邻短步扩展产生Voronoi偏置
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、随机采目标,再以最近邻短步扩展产生Voronoi偏置
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 原错误归类位置 → 二、随机采目标,再以最近邻短步扩展产生Voronoi偏置
把局部扩展目标和父节点结构先讲清,再说明由最近邻产生的探索偏置;第四节只保留原报告图与统计范围。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:改变最近邻距离而保持同一随机样本,会改变树的探索偏置吗?:改变最近邻距离而保持同一随机样本,会改变树的探索偏置吗?
教法来源与实际阅读范围
- Steven M. LaValle · Planning Algorithms, Chapter 5: Sampling-Based Motion Planning
PDF1–3页:概率完备、收敛速度、单次/多次查询、构型空间度量
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- PDF p.3 无编号生长三联图:从左到右观察树如何把分支送往尚未覆盖的区域
方法/设定图 · 必要原图摘引 · PDF p.3 无编号生长三联图,PDF 第 3 页;裁切框为原页比例 (0.075, 0.157, 0.49, 0.255)
从左到右观察树如何把分支送往尚未覆盖的区域。图显示 Voronoi 偏置带来的空间扩张,不是在相同硬件和运行时间下统计得到的速度优势曲线。
- 原论文 Figure 1:动力学车辆随机树的二维投影
方法/设定图 · 必要原图摘引 · Figure 1, PDF p.1
粗线给出从树中取出的可行车辆轨迹;分枝是五维状态树的二维投影,不能把平面上的交点都当成可连接状态。
未在正文展示的图/表与范围
- 图unnumbered-p4:缺的是同页完整四组受约束 RRT 运行结果,而非通用树结构示意。短报告的生长过程和模型对照已展示;再加入该组会重现其主要完整视觉例证集。没有同一随机运行数据,另跑示例不能冒充这些原结果。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1
- 为无编号的 RRT 生长图与约束示例提供真实 PDF 页入口
查看本篇 3 个原文证据入口
- 图 1 · PDF 第 1 页,Figure 1
原站图表/证明入口
- p.3 无障碍生长三联图 · PDF 第 3 页,无编号树图
原站图表/证明入口
- p.4 四个约束示例与研究问题 · PDF 第 4 页,无编号树图
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 用一维Voronoi区间计算节点扩展概率
- 解释探索偏置不等于沿目标最快到达
- 区分原始RRT与后续Connect、RRT*分支
- 加入分叉式前部路线,并重新核读原文全部四页及实验条件
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1
- 为无编号的 RRT 生长图与约束示例提供真实 PDF 页入口
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- lavalle.pl · 全文
下载并渲染逐页核读四页原报告:算法、Voronoi偏置、二维凸空间1.3–2.0倍初步观察、受限车辆和12维状态算例。
- lavalle.pl · 所列章节
原作者对RRT探索机制与后续变体的回顾;Voronoi算例为原创。
- lavalle.pl · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 035-prm · 平行方法
道路图与树的采样结构不同
- 043-rrt-connect · 直接继承
后作承接本篇:双树扩展原始RRT
- 062-rrtstar · 直接继承
后作承接本篇:加入重接和邻域理论
仍需留意
- 原PDF文本解析乱码已通过逐页图像阅读补足;未复现原始模拟,报告自身没有统一重复次数、硬件和现代统计基准。
机器人经典Monte Carlo Localization for Mobile Robots部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:已知地图中怎样从多个位置假设逐步定位
- 二、用运动传播与地图似然更新位姿粒子
- 三、实现全局到局部定位,检查实时丢帧
- 四、对照后验图、误差曲线与长日志
- 五、保留粒子贫化、绑架恢复与计算预算限制
- 六、追问:两个相似走廊对应的粒子峰,什么时候会被同一观测进一步区分?
- 七、从已知地图定位走向轨迹条件化建图
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题:定位已有地图,不是同时建图 → 一、问题设定:已知地图中怎样从多个位置假设逐步定位
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:同一套贝叶斯递推,换一种表示 → 三、实现全局到局部定位,检查实时丢帧
把求解机制与每步执行顺序分开检验
- 方法:同一套贝叶斯递推,换一种表示 → 二、用运动传播与地图似然更新位姿粒子
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 为什么粒子没有固定网格精度,却仍会不准确 → 二、用运动传播与地图似然更新位姿粒子
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计:日志重放也必须计算实时成本 → 四、对照后验图、误差曲线与长日志
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:后验图、误差曲线和长日志分别说明什么 → 四、对照后验图、误差曲线与长日志
把可视证据与实验条件/证据局限放在同一节
- 五处证据:后验图、误差曲线和长日志分别说明什么 → 四、对照后验图、误差曲线与长日志
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价和失败边界 → 五、保留粒子贫化、绑架恢复与计算预算限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个小例子与五个前置概念 → 三、实现全局到局部定位,检查实时丢帧
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否解释为什么更多粒子反而更差 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:已知地图中怎样从多个位置假设逐步定位
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用运动传播与地图似然更新位姿粒子
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用运动传播与地图似然更新位姿粒子
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:两个相似走廊对应的粒子峰,什么时候会被同一观测进一步区分?:两个相似走廊对应的粒子峰,什么时候会被同一观测进一步区分?
教法来源与实际阅读范围
- Simo Särkkä · Bayesian Filtering and Smoothing (2013)
§4.2–4.3 PDF74–78页的预测/更新与Kalman推导;§7.1–7.4 PDF136–144页的样本表示、重要性与重采样;另读§7.5 PDF149–151页条件线性高斯分解与RBPF
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 8:横轴粒子数采用对数尺度,纵轴是平均定位误差;粒子减少节省计算,却可能损害估计质量
实验/结果图 · 必要原图摘引 · Fig. 8,PDF 第 6 页;裁切框为原页比例 (0.155, 0.18, 0.43, 0.35)
横轴粒子数采用对数尺度,纵轴是平均定位误差;粒子减少节省计算,却可能损害估计质量。声呐与激光曲线的差异也表明,地图和观测信息量会改变预算需求。
- 原论文 Figure 7:网格尺寸与声呐、激光定位误差
实验/结果图 · 必要原图摘引 · Figure 7, PDF p.5
横轴是网格单元尺寸,纵轴是平均估计误差;两种传感器的误差都随网格变粗而增大,可与本文已有图8的粒子数实验分开比较。
- 原论文 Figure 1:四阶段概率密度与粒子表示
方法/设定图 · 必要原图摘引 · Figure 1, PDF p.4
A到D依次对照先验、运动预测、观测加权和重采样;上排连续密度与下排粒子云对应,粒子向观测兼容的两个区域集中。
- 原论文 Figure 6:机器人测试路径和编号参考位置
实验/结果图 · 必要原图摘引 · Figure 6, PDF p.5
编号参考位置沿路径分布,用来测量实际定位误差;这里是评价所依赖的地图与路线,不是粒子数量的性能曲线。
- 全局定位初始时粒子覆盖多处候选位置
实验/结果图 · 必要原图摘引 · Figure 3, PDF p.5
初始粒子在多个走廊与房间中分布,体现尚未知道全局位姿时保留多种假设。
- 对称环境中粒子仍保留两个位姿假设
实验/结果图 · 必要原图摘引 · Figure 4, PDF p.5
环境的对称结构造成两个相互分离的假设,单一高斯不足以表达这种歧义。
- 进一步观测后粒子集中到正确位置
实验/结果图 · 必要原图摘引 · Figure 5, PDF p.5
后续观测消除先前对称歧义,粒子收敛到正确房间;这组帧展示全局定位过程,不是所有布局的成功率。
未在正文展示的图/表与范围
- 图9:三阶段多峰定位过程及定量误差已经补齐;剩余是大型博物馆场景地图。当前评论使用运行里程、速度和时间,地图本身不能直接验证这些数字,故不继续扩展场景图像的累计展示。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 7、图 1、图 3、图 4、图 5、图 6、图 8、图 9
查看本篇 8 个原文证据入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
- 图 1 · PDF 第 4 页,Figure 1
原站图表/证明入口
- 图 3 · PDF 第 5 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 5 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 5 页,Figure 6
原站图表/证明入口
- 图 8 · PDF 第 6 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 6 页,Figure 9
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 手算两个走廊假设的归一化权重
- 将粒子数与实时更新预算放在同一算例
- 解释全局多峰表示仍受粒子耗尽限制
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 7、图 1、图 3、图 4、图 5、图 6、图 8、图 9
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- sites.cc.gatech.edu · 所列章节
摘要与引言全局定位/跟踪区别及粒子表示动机;吞吐算例为原创。
- sites.cc.gatech.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 031-bootstrap-filter · 直接继承
本篇承接前作:粒子贝叶斯估计用于已知地图定位
- 045-fastslam · 历史背景
由定位粒子扩展到轨迹与条件地图分解
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典A Flexible New Technique for Camera Calibration部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不测平板运动时怎样由多姿态图像恢复相机内参
- 二、先求单应性,再用旋转正交性约束内参
- 三、联合细化重投影误差,检查图案姿态与覆盖
- 四、读远近图案对照,分开焦距和畸变信息
- 五、检查平面精度、尺度与参数可辨识性
- 六、追问:标定板的两条轴同时换一个平面坐标基,哪些量应该变化?
- 七、把内参接入运动估计与手眼标定
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:内参共用,外参每张不同 → 一、问题设定:不测平板运动时怎样由多姿态图像恢复相机内参
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法第一步:平面把投影变成单应性 → 二、先求单应性,再用旋转正交性约束内参
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法第二步:旋转正交性给出内参约束 → 二、先求单应性,再用旋转正交性约束内参
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法第三步:从代数误差转向重投影误差 → 三、联合细化重投影误差,检查图案姿态与覆盖
把求解机制与每步执行顺序分开检验
- 方法第三步:从代数误差转向重投影误差 → 二、先求单应性,再用旋转正交性约束内参
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:用远近图案检查可观测性 → 四、读远近图案对照,分开焦距和畸变信息
把可视证据与实验条件/证据局限放在同一节
- 实验:用远近图案检查可观测性 → 四、读远近图案对照,分开焦距和畸变信息
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处关键证据 → 四、读远近图案对照,分开焦距和畸变信息
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失败边界 → 五、检查平面精度、尺度与参数可辨识性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 教学例子与五个前置概念 → 三、联合细化重投影误差,检查图案姿态与覆盖
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否解释为什么这块板足够,又为什么有时不够 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:不测平板运动时怎样由多姿态图像恢复相机内参
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、先求单应性,再用旋转正交性约束内参
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、先求单应性,再用旋转正交性约束内参
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:不必知道手移动了多少,但必须知道平板是什么形状 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:标定板的两条轴同时换一个平面坐标基,哪些量应该变化?:标定板的两条轴同时换一个平面坐标基,哪些量应该变化?
教法来源与实际阅读范围
- OpenCV官方文档作者团队 · Camera Calibration
Basics径向/切向畸变、object/image points及标定板单位段
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Table 1:分别比较近距离图像组 A、远距离组 B 与合并组 A+B 的参数,关注图案覆盖改变后的差异
实验/结果图 · 必要原图摘引 · Table 1,PDF 第 5 页;裁切框为原页比例 (0.185, 0.085, 0.74, 0.195)
分别比较近距离图像组 A、远距离组 B 与合并组 A+B 的参数,关注图案覆盖改变后的差异。低重投影残差并不能单独保证所有内参和畸变参数都准确。
- 原论文 Figure 1:近距离和远距离平面标定图像
实验/结果图 · 必要原图摘引 · Figure 1, PDF p.4
左右两列分别来自近距离和较远距离拍摄,各展示三种板姿;视角改变提供约束,但照片本身不能给出表1中的标定误差。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、图 1
查看本篇 2 个原文证据入口
- 表 1 · PDF 第 5 页,Table 1
原站图表/证明入口
- 图 1 · PDF 第 4 页,Figure 1
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从单应约束解释内参矩阵的秩条件
- 构造正对平面时焦距与距离不可分的退化例
- 区分更多图像与更多独立几何约束
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、图 1
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- web.cecs.pdx.edu · 所列章节
摘要、引言的平面已知几何与不同朝向条件;秩和正面退化为独立教学分析。
- web.cecs.pdx.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 020-tsai-calibration · 平行方法
不同标定装置与解法
- 024-hand-eye · 模块组合
相机内参标定为手眼外参提供基础
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典RRT-Connect: An Efficient Approach to Single-Query Path Planning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:单次查询怎样让起点树和目标树更快会合
- 二、区分一次EXTEND与持续CONNECT
- 三、实现双树交换,检查两端之间的整段连接
- 四、比较空旷与拥挤场景的搜索耗时
- 五、保留概率完备、有限期限和动力学边界
- 六、追问:比较EXTEND和CONNECT时,为什么节点数少仍可能耗时更多?
- 七、接入规划库,再给路径安排时间
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:姿态空间里的线段是什么 → 一、问题设定:单次查询怎样让起点树和目标树更快会合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:EXTEND 与 CONNECT 的区别 → 三、实现双树交换,检查两端之间的整段连接
把求解机制与每步执行顺序分开检验
- 方法:EXTEND 与 CONNECT 的区别 → 二、区分一次EXTEND与持续CONNECT
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 理论:概率完备不等于按时完成 → 二、区分一次EXTEND与持续CONNECT
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验怎样支持结论 → 四、比较空旷与拥挤场景的搜索耗时
把可视证据与实验条件/证据局限放在同一节
- 实验怎样支持结论 → 四、比较空旷与拥挤场景的搜索耗时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与边界 → 五、保留概率完备、有限期限和动力学边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个小例子与五个前置概念 → 三、实现双树交换,检查两端之间的整段连接
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否解释机制,而不只背算法名字 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:单次查询怎样让起点树和目标树更快会合
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、区分一次EXTEND与持续CONNECT
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、区分一次EXTEND与持续CONNECT
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:比较EXTEND和CONNECT时,为什么节点数少仍可能耗时更多?:比较EXTEND和CONNECT时,为什么节点数少仍可能耗时更多?
教法来源与实际阅读范围
- Steven M. LaValle · Planning Algorithms, Chapter 5: Sampling-Based Motion Planning
PDF1–3页:概率完备、收敛速度、单次/多次查询、构型空间度量
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 7:左列是双树探索,右列是同一场景的最终路径;三行改变障碍与机器人形状
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 5 页;裁切框为原页比例 (0.515, 0.107, 0.905, 0.58)
左列是双树探索,右列是同一场景的最终路径;三行改变障碍与机器人形状。它展示几何规划可行性,不提供动力学受限机器人沿反向目标树执行的保证。
- 原论文 Figure 2:基本RRT的BUILD与EXTEND伪代码
方法/设定图 · 必要原图摘引 · Figure 2, PDF p.2
BUILD反复抽取随机构型,EXTEND只尝试一次局部推进,并区分Reached、Advanced和Trapped三种结果。
- 原论文 Figure 5:CONNECT与双树RRT-Connect伪代码
方法/设定图 · 必要原图摘引 · Figure 5, PDF p.3
CONNECT在Advanced时持续推进,主循环再交换两棵树;只有第二棵树真正到达连接点时才返回连接路径。
- 原论文 Figure 8:钢琴在障碍环境中的规划结果
实验/结果图 · 必要原图摘引 · Figure 8, PDF p.6
上排对照平面搜索和三维场景,下图叠加钢琴沿路径的多个姿态;轨迹需要同时处理平移与旋转,不能只检查质点中心。
- 原论文 Figure 9:六自由度Puma机器人路径序列
实验/结果图 · 必要原图摘引 · Figure 9, PDF p.6
四个姿态展示机械臂绕过工作台周围障碍的运动;它是可行性实例,不能单独证明所有构型空间中的速度优势。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 5、图 7、图 8、图 9
查看本篇 4 个原文证据入口
- 图 5 · PDF 第 3 页,Figure 5
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 6 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 6 页,Figure 9
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 追踪双树EXTEND和CONNECT的具体节点序列
- 用薄障碍反例说明必须检查整条边
- 限定几何局部连接器与动力学可达性
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 5、图 7、图 8、图 9
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.kuffner.org · 所列章节
第2–3节无微分约束前提、图2/5的扩展与双树连接。
- www.kuffner.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 040-rrt · 直接继承
本篇承接前作:双树与CONNECT继承RRT
- 067-ompl · 模块组合
作为库内规划算法
- 093-toppra · 模块组合
满足条件的几何路径再做时间参数化
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典A Solution to the Simultaneous Localization and Map Building (SLAM) Problem部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:反复观测后地图的相关误差究竟收敛到什么
- 二、保留车辆与地标联合协方差,拆开三类结论
- 三、执行观测关联与滤波,用共同平移误差验算
- 四、对照理论条件与室外雷达实验
- 五、区分相对精度、绝对参考与非线性失配
- 六、追问:如果所有路标和机器人一起平移,内部相对观测能否发现这次变化?
- 七、以不同表示扩展联合地图估计
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题定义 → 一、问题设定:反复观测后地图的相关误差究竟收敛到什么
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:联合协方差究竟记录什么 → 二、保留车辆与地标联合协方差,拆开三类结论
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三个结论怎样读才准确 → 二、保留车辆与地标联合协方差,拆开三类结论
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 输入到输出:完整滤波之前还要确认路标 → 三、执行观测关联与滤波,用共同平移误差验算
把求解机制与每步执行顺序分开检验
- 输入到输出:完整滤波之前还要确认路标 → 三、执行观测关联与滤波,用共同平移误差验算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设定与证据 → 四、对照理论条件与室外雷达实验
把可视证据与实验条件/证据局限放在同一节
- 实验设定与证据 → 四、对照理论条件与室外雷达实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价和未解决的问题 → 五、区分相对精度、绝对参考与非线性失配
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:两根柱子都偏了一米 → 三、执行观测关联与滤波,用共同平移误差验算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:反复观测后地图的相关误差究竟收敛到什么
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、保留车辆与地标联合协方差,拆开三类结论
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、保留车辆与地标联合协方差,拆开三类结论
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:共同犯错,反而能知道彼此相隔多远 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:如果所有路标和机器人一起平移,内部相对观测能否发现这次变化?:如果所有路标和机器人一起平移,内部相对观测能否发现这次变化?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:8 幅
- Fig. 8:比较估计位置误差与图中的置信界,而不是只看最终轨迹是否重合;真实误差与内部协方差描述的是不同对象
实验/结果图 · 必要原图摘引 · Fig. 8,PDF 第 9 页;裁切框为原页比例 (0.49, 0.072, 0.925, 0.335)
比较估计位置误差与图中的置信界,而不是只看最终轨迹是否重合;真实误差与内部协方差描述的是不同对象。一次符合置信界的运行不等于严格的长期一致性证明。
- 原论文 Figure 5:雷达观测、车辆路径与反射器
实验/结果图 · 必要原图摘引 · Figure 5, PDF p.8
图例分开原始雷达观测、车辆路径和反射器,远离真实反射器的散点说明原始返回并不都能直接当作可靠地标。
- 原论文 Figure 7:实测与估计地标位置及车辆闭合路线
实验/结果图 · 必要原图摘引 · Figure 7, PDF p.9
圆圈和星号分别对应实测与估计地标,环形曲线是车辆路线;视觉接近只是定性检查,还需和误差及协方差图一起读。
- 原论文 Figure 9:距离与方位创新及置信界
实验/结果图 · 必要原图摘引 · Figure 9, PDF p.9
上下两图分别显示距离和方位创新,外侧曲线是对应置信界;应对照时间段检查残差是否与所估计的不确定性相符。
- 原论文 Figure 10:第一号地标的x、y位置误差
实验/结果图 · 必要原图摘引 · Figure 10, PDF p.10
实线是地标误差,虚线给出置信边界;边界收窄与误差始终为零是不同的命题。
- 原论文 Figure 12:地标x方向标准差随时间变化
实验/结果图 · 必要原图摘引 · Figure 12, PDF p.10
多条曲线代表不同地标的x方向标准差,首次观测和再观测发生在不同时间;下降趋势不应误读为所有地标同时初始化。
- 第三个路标的两方向估计误差及置信范围
实验/结果图 · 必要原图摘引 · Figure 11, PDF p.10
这个路标较晚被观测,初始化时的置信范围与此前路标不同;保留这张对照才能检验车辆不确定性向新路标传播的论点。
- 全部路标在y方向的估计标准差随时间变化
实验/结果图 · 必要原图摘引 · Figure 13, PDF p.10
与另一方向分开读取能看出不同坐标的不确定性;确认前人为显示为零的作图约定不能当作实际确定性。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 5、图 7、图 8、图 9、图 10、图 11、图 12、图 13、图 6
查看本篇 9 个原文证据入口
- 图 5 · PDF 第 8 页,Figure 5
原站图表/证明入口
- 图 7 · PDF 第 9 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 9 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 9 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 10 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 10 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 10 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 10 页,Figure 13
原站图表/证明入口
- 图 6 · PDF 第 9 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 计算强相关地图变量的相对位置方差
- 展示整体平移规范自由度与相对精度并存
- 区分协方差收缩与绝对定位可观测性
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 5、图 7、图 8、图 9、图 10、图 11、图 12、图 13、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cs.cmu.edu · 所列章节
第II节静态路标、相对观测及联合协方差模型。
- www.cs.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 017-uncertain-map · 历史背景
地图与位姿相关性的基础
- 045-fastslam · 平行方法
联合高斯与条件粒子分解
- 053-graphslam · 平行方法
历史轨迹稀疏约束表示
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典FastSLAM: A Factored Solution to the Simultaneous Localization and Mapping Problem部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:地图相关性怎样在轨迹条件化后分解计算
- 二、把联合后验分成轨迹粒子与条件路标滤波
- 三、更新粒子地图,并用共享树避免整图复制
- 四、一起阅读路标规模、精度和困难程度
- 五、检查轨迹退化、非线性近似与关联错误
- 六、追问:条件于一条轨迹时路标独立,混合两条轨迹后为什么又相关?
- 七、改善粒子提议,或改用稀疏历史优化
- 八、自测与参考答案
段落怎样重新安排
- 问题与假设 → 一、问题设定:地图相关性怎样在轨迹条件化后分解计算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 核心公式:条件独立与边缘独立不是一回事 → 二、把联合后验分成轨迹粒子与条件路标滤波
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一步更新究竟做什么 → 三、更新粒子地图,并用共享树避免整图复制
把求解机制与每步执行顺序分开检验
- 一步更新究竟做什么 → 二、把联合后验分成轨迹粒子与条件路标滤波
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 为什么平衡树不是可有可无的实现技巧 → 二、把联合后验分成轨迹粒子与条件路标滤波
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:规模、精度和困难程度要一起读 → 四、一起阅读路标规模、精度和困难程度
把可视证据与实验条件/证据局限放在同一节
- 实验:规模、精度和困难程度要一起读 → 四、一起阅读路标规模、精度和困难程度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 代价与失败边界 → 五、检查轨迹退化、非线性近似与关联错误
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构小例子 → 三、更新粒子地图,并用共享树避免整图复制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:地图相关性怎样在轨迹条件化后分解计算
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把联合后验分成轨迹粒子与条件路标滤波
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把联合后验分成轨迹粒子与条件路标滤波
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:同一条路线确定以后,地图点就容易分开估计 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:条件于一条轨迹时路标独立,混合两条轨迹后为什么又相关?:条件于一条轨迹时路标独立,混合两条轨迹后为什么又相关?
教法来源与实际阅读范围
- Simo Särkkä · Bayesian Filtering and Smoothing (2013)
§4.2–4.3 PDF74–78页的预测/更新与Kalman推导;§7.1–7.4 PDF136–144页的样本表示、重要性与重采样;另读§7.5 PDF149–151页条件线性高斯分解与RBPF
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 6:两幅曲线分别改变路标数和粒子数,并给出区间
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 6 页;裁切框为原页比例 (0.515, 0.055, 0.87, 0.415)
两幅曲线分别改变路标数和粒子数,并给出区间。更多路标一方面加大地图,另一方面增加定位信息,因此误差下降不能解释为任何大地图都更容易。
- 原论文 Figure 2:八个地标估计的平衡树结构
方法/设定图 · 必要原图摘引 · Figure 2, PDF p.4
内部节点按地标索引分支,叶节点存各自的均值与协方差;查找一个地标只需沿树的一条路径下降。
- 原论文 Figure 3:粒子复制时的地标树结构共享
方法/设定图 · 必要原图摘引 · Figure 3, PDF p.4
虚线上方的新粒子只新建发生变化的路径节点,下方其余子树仍可共享;这解释了重采样不必逐次完整复制全部地标。
- FastSLAM岩石环境中的机器人、原始观测与估计地图
实验/结果图 · 必要原图摘引 · Figure 4, PDF p.5
三面板分别展示平台、带噪声的观测/路径与估计出的岩石位置;图中的小测试场景不能替代任意大规模环境的成功率。
- 按FastSLAM概率因子分解独立绘制的轨迹、控制、地标与观测依赖图
方法/设定图 · 原创教学图 · Figure 1, PDF p.2
此图独立重绘了原文图1的结构关系:控制影响后续位姿,位姿与地标共同决定观测;给定整条轨迹后,不同地标的后验可以分解。蓝色底带表示被条件化的轨迹,不是新的测量数据。
未在正文展示的图/表与范围
- 图5:概率依赖关系已原创重绘,三面板岩石平台/观测/地图已补齐;剩余为另一组物理与合成场景地图。当前数值精度、算法结构和具体地图证据已展示,暂不把额外地图集也全部复制。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、图 1、图 4、图 5、图 6
查看本篇 6 个原文证据入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 用混合后验计算路标间相关性
- 解释条件独立不等于边缘独立
- 连接Rao-Blackwell分解与后作提议分布改进
- 加入独有的前作瓶颈、本篇改变与后续阅读路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、图 1、图 4、图 5、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- cdn.aaai.org · 所列章节
引言条件独立分解、Rao–Blackwell形式、复杂度与粒子数困难。
- cdn.aaai.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 041-mcl · 模块组合
定位粒子与条件路标滤波组合
- 044-slam-convergence · 平行方法
相关性的不同后验表示
- 053-graphslam · 平行方法
历史采样与历史优化对照
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典D* Lite部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:起点移动和边代价改变时怎样修复局部一致性
- 二、用g与rhs区分已存代价和一步前瞻
- 三、执行基本版队列循环,检查键修正与停止条件
- 四、把理论保证、版本差异和计时实验拆开读
- 五、限制有限图模型、队列维护与地图未知性
- 六、追问:同一条边先涨价再降价,为什么测试不能只检查最终地图?
- 七、将增量修复与随时改进结合
- 八、自测与参考答案
段落怎样重新安排
- 问题设定:未知地形怎样变成边成本变化 → 一、问题设定:起点移动和边代价改变时怎样修复局部一致性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 两个值:g 是已保存的判断,rhs 是邻居给出的新意见 → 五、限制有限图模型、队列维护与地图未知性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 为什么移动起点不必重新整理整堆节点 → 二、用g与rhs区分已存代价和一步前瞻
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 教学伪代码:使用基本版,避免混入优化版停止条件 → 三、执行基本版队列循环,检查键修正与停止条件
把求解机制与每步执行顺序分开检验
- 教学伪代码:使用基本版,避免混入优化版停止条件 → 二、用g与rhs区分已存代价和一步前瞻
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 理论和实验分别回答什么 → 四、把理论保证、版本差异和计时实验拆开读
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处具体证据 → 四、把理论保证、版本差异和计时实验拆开读
把可视证据与实验条件/证据局限放在同一节
- 五处具体证据 → 四、把理论保证、版本差异和计时实验拆开读
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与代价 → 五、限制有限图模型、队列维护与地图未知性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构例子与前置概念 → 三、执行基本版队列循环,检查键修正与停止条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:起点移动和边代价改变时怎样修复局部一致性
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用g与rhs区分已存代价和一步前瞻
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用g与rhs区分已存代价和一步前瞻
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:同一条边先涨价再降价,为什么测试不能只检查最终地图?:同一条边先涨价再降价,为什么测试不能只检查最终地图?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 7:自适应网格上的三个操作量随问题条件一起变化,完整算法和去掉某些机制的版本可能接近
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 7 页;裁切框为原页比例 (0.09, 0.36, 0.5, 0.627)
自适应网格上的三个操作量随问题条件一起变化,完整算法和去掉某些机制的版本可能接近。它说明收益依赖表示与工作负载,不能凭单一结构宣布每项机制始终必要。
- 原论文 Figure 3:D星Lite基础版完整伪代码
方法/设定图 · 必要原图摘引 · Figure 3, PDF p.4
把CalculateKey、UpdateVertex和ComputeShortestPath连起来看:不一致顶点进入队列,主循环在边代价变化后修复已有搜索结果。
- 原论文 Figure 4:D星Lite优化版完整伪代码
方法/设定图 · 必要原图摘引 · Figure 4, PDF p.5
与基础版相比,更新分支区分旧代价与新代价,移动起点时累积km;这些细节改变更新工作量,不改变任务的最短路目标。
- 原论文 Figure 1:机器人首次移动前后的网格代价
方法/设定图 · 必要原图摘引 · Figure 1, PDF p.2
上下网格对照新障碍被发现前后的信息,灰色区域标出发生变化的距离;环境更新并不要求每个格点重新计算。
- 原论文 Figure 5:Focused D星相对D星Lite的三项开销
实验/结果图 · 必要原图摘引 · Figure 5, PDF p.6
三块图分别统计额外顶点扩展、顶点访问和堆调整,横轴均为迷宫尺寸;百分比开销不能直接当作总运行时间。
- 均匀离散化目标导航中三项搜索工作量比较
实验/结果图 · 必要原图摘引 · Figure 6, PDF p.7
三个面板分别统计顶点扩展、访问和堆操作,不能把其中一个数量的减少直接当作同倍墙钟时间加速。
- 未知地形建图任务中三项搜索工作量随传感范围变化
实验/结果图 · 必要原图摘引 · Figure 8, PDF p.7
横轴改为传感器范围,这与目标导航实验不是同一个自变量;该图补齐增量修复在另一任务设置下的对照。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 1、图 5、图 6、图 7、图 8
查看本篇 7 个原文证据入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 7 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 7 页,Figure 8
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 不一致有两种方向,不能用同一种赋值修复
- 在叙事内加入可复算教学例,并明确:继承任务而非原D*队列算法;后作融合增量搜索与anytime质量调节
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 1、图 5、图 6、图 7、图 8
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- idm-lab.org · 所列章节
作者摘要明确LPA*来源、与Focused D*行为相同算法不同;勘误指定rhs无路判断。
- cdn.aaai.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 032-dstar · 历史背景
继承任务而非原D*队列算法
- 052-anytime-dstar · 直接继承
后作融合增量搜索与anytime质量调节
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Biped Walking Pattern Generation by Using Preview Control of Zero-Moment Point部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未来支撑参考怎样提前改变当前质心运动
- 二、由倒立摆写出ZMP模型,拆解三项控制作用
- 三、从脚位生成关节参考,并检查模型偏差补偿
- 四、对照预瞄长度、误差补偿与行走实验
- 五、保留落脚可行性、模型精度与预知范围
- 六、追问:比较两种预瞄长度时,为什么必须保持未来ZMP参考和补偿层一致?
- 七、从计划步态转向受扰停止与滚动控制
- 八、自测与参考答案
段落怎样重新安排
- 背景:为什么只调整落脚点不够 → 一、问题设定:未来支撑参考怎样提前改变当前质心运动
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 从倒立摆到桌面小车模型 → 二、由倒立摆写出ZMP模型,拆解三项控制作用
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 优化目标与三项控制作用 → 二、由倒立摆写出ZMP模型,拆解三项控制作用
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 从脚位到关节参考的教学流程 → 三、从脚位生成关节参考,并检查模型偏差补偿
把求解机制与每步执行顺序分开检验
- 从脚位到关节参考的教学流程 → 二、由倒立摆写出ZMP模型,拆解三项控制作用
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计与具体证据 → 四、对照预瞄长度、误差补偿与行走实验
把可视证据与实验条件/证据局限放在同一节
- 实验设计与具体证据 → 四、对照预瞄长度、误差补偿与行走实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与适用边界 → 五、保留落脚可行性、模型精度与预知范围
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子与五个前置概念 → 三、从脚位生成关节参考,并检查模型偏差补偿
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:未来支撑参考怎样提前改变当前质心运动
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、由倒立摆写出ZMP模型,拆解三项控制作用
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、由倒立摆写出ZMP模型,拆解三项控制作用
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:先规划支撑,再让质心提前响应 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:比较两种预瞄长度时,为什么必须保持未来ZMP参考和补偿层一致?:比较两种预瞄长度时,为什么必须保持未来ZMP参考和补偿层一致?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 11:补偿后的多刚体 ZMP 与简化模型参考轨迹放在一起,观察拐点附近仍存在的差异
实验/结果图 · 必要原图摘引 · Fig. 11,PDF 第 6 页;裁切框为原页比例 (0.105, 0.085, 0.47, 0.335)
补偿后的多刚体 ZMP 与简化模型参考轨迹放在一起,观察拐点附近仍存在的差异。改善来自该模型和轨迹下的误差补偿,不是实机上绝对不变的厘米级精度。
- 原论文 Figure 6:预瞄增益随未来时间衰减
方法/设定图 · 必要原图摘引 · Figure 6, PDF p.4
横轴是向前看的时间,纵轴为预瞄增益;较近的未来目标影响更大,曲线并不是机器人执行后的跟踪误差。
- 原论文 Figure 7:较长预瞄时间的前向和侧向轨迹
实验/结果图 · 必要原图摘引 · Figure 7, PDF p.5
上、下图分别看x与y,ZMP实线紧跟参考的分段变化,而质心轨迹平滑跨越步间切换。
- 原论文 Figure 8:缩短预瞄时间后的前向和侧向轨迹
实验/结果图 · 必要原图摘引 · Figure 8, PDF p.5
与图7使用相同轴比较,参考跳变附近出现更明显的ZMP偏差;不能只看最终位置相近就断定中途稳定性相同。
- 原论文 Figure 10:小车桌模型与多体模型的ZMP差异
实验/结果图 · 必要原图摘引 · Figure 10, PDF p.5
图例区分多体模型ZMP、小车桌ZMP和质心;同一动作在多体模型下出现额外偏差,形成随后图11修正的动机。
- 原论文 Figure 5:ZMP阶跃目标与质心提前移动
方法/设定图 · 必要原图摘引 · Figure 5, PDF p.3
左图的质心曲线在ZMP参考跳变前开始变化,右图以小车桌模型解释运动方向;这是预瞄控制的因果输入设置。
- 旋转楼梯上预瞄规划的ZMP与质心投影
实验/结果图 · 必要原图摘引 · Figure 12, PDF p.6
阶梯状支撑区域和两条投影轨迹对应同一已知楼梯几何;它是规划/仿真设置,不能解读为实机成功率。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 6、图 7、图 9、图 10、图 11、图 12、图 13、图 5
查看本篇 8 个原文证据入口
- 图 6 · PDF 第 4 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
- 图 9 · PDF 第 5 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 5 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 6 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 6 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 7 页,Figure 13
原站图表/证明入口
- 图 5 · PDF 第 3 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- ZMP先向后,质心才可能向前加速
- 在叙事内加入可复算教学例,并明确:本篇采用LIP模型家族;相同简化动力学上研究不同控制目标
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 6、图 7、图 9、图 10、图 11、图 12、图 13、图 5
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- people.csail.mit.edu · 所列章节
第1–3节踏石动机、ZMP输出重写和小车桌面模型。
- people.csail.mit.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 027-lipm · 直接继承
本篇采用LIP模型家族
- 054-capture-point · 平行方法
相同简化动力学上研究不同控制目标
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Distinctive Image Features from Scale-Invariant Keypoints部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:尺度与旋转变化后怎样识别同一局部纹理
- 二、检测尺度极值,再做方向归一化与梯度描述
- 三、执行描述子匹配,用比值检验筛候选
- 四、拆开读检测、描述与匹配各组实验
- 五、保留视角变化、遮挡和几何验证条件
- 六、追问:要区分检测器和描述子的贡献,实验输入应该怎样固定?
- 七、降低描述成本,或进入完整重建
- 八、自测与参考答案
段落怎样重新安排
- 背景:检测重复性与描述区分度是两道关 → 一、问题设定:尺度与旋转变化后怎样识别同一局部纹理
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 检测:在尺度空间寻找局部极值 → 二、检测尺度极值,再做方向归一化与梯度描述
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 描述:保留粗略布局,容忍小位移 → 二、检测尺度极值,再做方向归一化与梯度描述
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 匹配:最近不够,还要明显胜过第二名 → 三、执行描述子匹配,用比值检验筛候选
把求解机制与每步执行顺序分开检验
- 匹配:最近不够,还要明显胜过第二名 → 二、检测尺度极值,再做方向归一化与梯度描述
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验如何拆开验证 → 四、拆开读检测、描述与匹配各组实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组图的证据强度 → 四、拆开读检测、描述与匹配各组实验
把可视证据与实验条件/证据局限放在同一节
- 五组图的证据强度 → 四、拆开读检测、描述与匹配各组实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与机器人中的边界 → 五、保留视角变化、遮挡和几何验证条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子与前置概念 → 三、执行描述子匹配,用比值检验筛候选
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:尺度与旋转变化后怎样识别同一局部纹理
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、检测尺度极值,再做方向归一化与梯度描述
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、检测尺度极值,再做方向归一化与梯度描述
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:旋转和缩放之后,仍能认出同一块纹理 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:要区分检测器和描述子的贡献,实验输入应该怎样固定?:要区分检测器和描述子的贡献,实验输入应该怎样固定?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 9:横轴增加视角变化时,定位、方向分配和最终匹配的重复率下降幅度不同
实验/结果图 · 必要原图摘引 · Fig. 9,PDF 第 18 页;裁切框为原页比例 (0.265, 0.103, 0.75, 0.362)
横轴增加视角变化时,定位、方向分配和最终匹配的重复率下降幅度不同。看各阶段之间的差距,才能区分特征检测丢失与描述子匹配失败。
- 原论文 Figure 3:每倍频程采样层数的重复率与关键点数
实验/结果图 · 必要原图摘引 · Figure 3, PDF p.8
左右图共享采样层数横轴:重复率在几层后趋于平缓,而关键点数量继续增加;因此增加计算量不保证同比提高匹配质量。
- 原论文 Figure 4:预平滑尺度与检测重复率
实验/结果图 · 必要原图摘引 · Figure 4, PDF p.9
横轴为每倍频程的预平滑sigma,纵轴为重复率;两条曲线分别检查位置尺度一致性和描述子匹配,不能把二者当成同一指标。
- 原论文 Figure 5:关键点筛选的四个阶段
方法/设定图 · 必要原图摘引 · Figure 5, PDF p.11
从原图到候选点,再去除低对比度点和边缘响应,箭头数量逐步减少;保留下来的点并不是所有强边缘上的像素。
- 原论文 Figure 8:描述子空间宽度与方向桶数量
实验/结果图 · 必要原图摘引 · Figure 8, PDF p.17
横轴是描述子网格宽度,三条曲线使用4、8和16个方向;增加空间范围先明显改善匹配,随后收益减小。
- 原论文 Figure 10:数据库关键点数量与匹配重复率
实验/结果图 · 必要原图摘引 · Figure 10, PDF p.19
横轴采用对数刻度,数据库增大时最近描述子匹配曲线有所下降;位置、尺度和方向检测曲线用于区分检测与匹配的影响。
- 原论文 Figure 11:最近与次近距离比值的正确错误匹配分布
方法/设定图 · 必要原图摘引 · Figure 11, PDF p.20
正确匹配密度偏向较小距离比,错误匹配更多聚集在接近1的位置;阈值筛选利用的是相对歧义,而不是固定绝对距离。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 8、图 9、图 10、图 11、图 12、图 13、图 6
查看本篇 10 个原文证据入口
- 图 3 · PDF 第 8 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 9 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 11 页,Figure 5
原站图表/证明入口
- 图 8 · PDF 第 17 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 18 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 19 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 20 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 23 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 24 页,Figure 13
原站图表/证明入口
- 图 6 · PDF 第 14 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 描述子的稳定,来自连续投票而非绝对不变
- 在叙事内加入可复算教学例,并明确:从检测重复性走向可区分描述;二进制描述与浮点梯度描述的取舍;特征模块进入SfM链
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 8、图 9、图 10、图 11、图 12、图 13、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cs.ubc.ca · 所列章节
第6.1–6.2节方向归一化、三线性投票、128维表示及阈值归一化。
- www.cs.ubc.ca · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 023-harris · 历史背景
从检测重复性走向可区分描述
- 060-orb · 平行方法
二进制描述与浮点梯度描述的取舍
- 088-colmap · 模块组合
特征模块进入SfM链
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典An Efficient Solution to the Five-Point Relative Pose Problem部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:已标定的五组对应怎样产生相对运动候选
- 二、施加本质矩阵约束,再求多项式候选根
- 三、接入采样评分与精化,检查候选数和尺度
- 四、按小基线、运动方向与浅场景分别读实验
- 五、保留多解、标定误差与退化几何
- 六、追问:五点求解器输出多个实根时,只保留第一个会怎样改变鲁棒采样流程?
- 七、把运动候选接入关键帧系统
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:本质矩阵比任意秩二矩阵知道得更多 → 一、问题设定:已标定的五组对应怎样产生相对运动候选
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:先压缩线性自由度,再解非线性约束 → 三、接入采样评分与精化,检查候选数和尺度
把求解机制与每步执行顺序分开检验
- 方法:先压缩线性自由度,再解非线性约束 → 二、施加本质矩阵约束,再求多项式候选根
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:不同图测量的不是同一种“准确率” → 四、按小基线、运动方向与浅场景分别读实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组证据:结果支持到哪里 → 四、按小基线、运动方向与浅场景分别读实验
把可视证据与实验条件/证据局限放在同一节
- 五组证据:结果支持到哪里 → 四、按小基线、运动方向与浅场景分别读实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与边界 → 五、保留多解、标定误差与退化几何
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构例子:少抽三个点能改变多少成功概率 → 三、接入采样评分与精化,检查候选数和尺度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能解释清楚,才算真正理解 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:已标定的五组对应怎样产生相对运动候选
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、施加本质矩阵约束,再求多项式候选根
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、施加本质矩阵约束,再求多项式候选根
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:五个匹配点为什么能帮助机器人判断自己怎么动了 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:五点求解器输出多个实根时,只保留第一个会怎样改变鲁棒采样流程?:五点求解器输出多个实根时,只保留第一个会怎样改变鲁棒采样流程?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:13 幅
- Fig. 15:两面板改变焦距误标定而观察平移方向误差;不同方法的排序会随标定偏差而改变
实验/结果图 · 必要原图摘引 · Fig. 15,PDF 第 10 页;裁切框为原页比例 (0.035, 0.747, 0.47, 0.906)
两面板改变焦距误标定而观察平移方向误差;不同方法的排序会随标定偏差而改变。纵轴是方向误差,不能把它换算成未经尺度观测的平移距离误差。
- 原论文 Figure 1:一般场景与平面场景的数值误差分布
实验/结果图 · 必要原图摘引 · Figure 1, PDF p.6
两幅直方图都用数值误差的十进对数作横轴;峰值位置说明这一求解组合的数值精度,不能当作像素噪声下的位姿误差。
- 原论文 Figure 4:SVD与伴随矩阵组合的数值误差分布
实验/结果图 · 必要原图摘引 · Figure 4, PDF p.6
与图1对照同类数值实验时,误差分布明显改变;应先区分求解器数值误差和随后真实图像中的测量噪声。
- 原论文 Figure 5:两个求解步骤产生的假设数量分布
实验/结果图 · 必要原图摘引 · Figure 5, PDF p.6
左右柱图对应表2中的两个步骤,横轴是假设数量;多项式产生多个候选,并不表示每个候选都满足物理可见性。
- 原论文 Figure 6:产生多个物理解的五组对应点
方法/设定图 · 必要原图摘引 · Figure 6, PDF p.7
左侧标出对应点,右侧给出五组归一化坐标;这是多解存在性的具体反例,不能把五点最小集误解成唯一位姿保证。
- 原论文 Figure 9:困难默认条件下噪声与平移角误差
实验/结果图 · 必要原图摘引 · Figure 9, PDF p.8
四个面板分开最小集、多点以及侧向、前向运动;各面板的曲线和误差尺度应独立读,不能把某一运动方向的优势外推到全部场景。
- 原论文 Figure 11:匹配点数增加时的平移角误差
实验/结果图 · 必要原图摘引 · Figure 11, PDF p.9
左右面板分别对应侧向和前向运动;多点迭代方法随点数增加改善,但最小求解器曲线的行为不能只按点数一项解释。
- 原论文 Figure 21:长走廊手持相机运动重建
实验/结果图 · 必要原图摘引 · Figure 21, PDF p.12
左侧将相机姿态叠到视频场景中,右侧展示不同阶段累积的轨迹;这是长直运动重建实例,仍需结合噪声和标定条件理解。
- 将QR换成SVD后的数值误差分布
实验/结果图 · 必要原图摘引 · Figure 2, PDF p.6
一般场景和平面场景分开统计,横轴是误差的对数;这张消融隔离了第一步数值分解选择的影响。
- 以伴随矩阵特征分解替代Sturm步骤后的误差分布
实验/结果图 · 必要原图摘引 · Figure 3, PDF p.6
两种场景的误差分布用于区分求根方法的数值行为,不能把接近真值的最佳候选残差等同于最终系统定位误差。
- 不同运动方向下的平移方向误差三面板
实验/结果图 · 必要原图摘引 · Figure 12, PDF p.9
横轴是相对于前向运动的方向,三面板又改变点数和条件;优势取决于具体几何,不能只看某一方向的最低曲线。
- 不同平移幅度与运动设置下的误差四面板
实验/结果图 · 必要原图摘引 · Figure 13, PDF p.9
四面板分别区分横向/前向和最小/过定约束条件,完整图例使五点与其它方法的比较保持可追溯。
- 浅场景深度变化下的平移方向误差三面板
实验/结果图 · 必要原图摘引 · Figure 14, PDF p.10
横轴是深度而不是时间,前向和横向配置给出不同表现;这组结果说明几何退化条件必须随结论保留。
未在正文展示的图/表与范围
- 表2:表格独立清点;不计入Figure内嵌目标。
- 图17:已补不同数值分解、求根方法、运动方向/幅度/深度的必要定量对照;剩余三幅为额外的重建影像序列。当前已摘引走廊重建例证,不再扩展到各场景的整套图像展示。
- 表3:表格独立清点;不计入Figure内嵌目标。
- 表4:表格独立清点;不计入Figure内嵌目标。
- 图20:已补不同数值分解、求根方法、运动方向/幅度/深度的必要定量对照;剩余三幅为额外的重建影像序列。当前已摘引走廊重建例证,不再扩展到各场景的整套图像展示。
- 图22:已补不同数值分解、求根方法、运动方向/幅度/深度的必要定量对照;剩余三幅为额外的重建影像序列。当前已摘引走廊重建例证,不再扩展到各场景的整套图像展示。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、表 2、图 5、图 6、图 9、图 15、表 3、表 4、图 20、图 21、图 22
查看本篇 14 个原文证据入口
- 图 1 · PDF 第 6 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 6 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 6 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 6 页,Figure 4
原站图表/证明入口
- 表 2 · PDF 第 6 页,Table 2
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
- 图 9 · PDF 第 8 页,Figure 9
原站图表/证明入口
- 图 15 · PDF 第 10 页,Figure 15
原站图表/证明入口
- 表 3 · PDF 第 7 页,Table 3
原站图表/证明入口
- 表 4 · PDF 第 7 页,Table 4
原站图表/证明入口
- 图 20 · PDF 第 12 页,Figure 20
原站图表/证明入口
- 图 21 · PDF 第 12 页,Figure 21
原站图表/证明入口
- 图 22 · PDF 第 12 页,Figure 22
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 本质矩阵的尺度自由度不能变成米制平移
- 在叙事内加入可复算教学例,并明确:内参为五点相对姿态提供输入;最小求解器用于鲁棒假设生成;进入视觉几何初始化链
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、表 2、图 5、图 6、图 9、图 15、表 3、表 4、图 20、图 21、图 22
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- engineering.purdue.edu · 所列章节
引言五点作RANSAC假设、更多观测评分和精化,以及标定模型用途。
- engineering.purdue.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 042-zhang-calibration · 模块组合
内参为五点相对姿态提供输入
- 006-ransac · 模块组合
最小求解器用于鲁棒假设生成
- 082-orbslam · 模块组合
进入视觉几何初始化链
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Synthesis of Whole-Body Behaviors Through Hierarchical Control of Behavioral Primitives部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:手部目标与平衡冲突时怎样保证低优先级退让
- 二、构造动态一致层级,区分约束任务和姿态
- 三、执行剩余方向分配,用权重折中作对照
- 四、读重心与手部任务同级或分级的仿真
- 五、检查可行性、模型误差与剩余自由度
- 六、追问:一个任务被投到高优先级零空间后,它的秩应按哪个雅可比判断?
- 七、比较全身约束的联合优化路线
- 八、自测与参考答案
段落怎样重新安排
- 背景:冗余不是无限的备用自由度 → 一、问题设定:手部目标与平衡冲突时怎样保证低优先级退让
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:为什么普通几何零空间还不够 → 二、构造动态一致层级,区分约束任务和姿态
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 可行性:低优先级任务有权失败 → 三、执行剩余方向分配,用权重折中作对照
把求解机制与每步执行顺序分开检验
- 可行性:低优先级任务有权失败 → 二、构造动态一致层级,区分约束任务和姿态
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:重心与手部同级,还是重心优先 → 四、读重心与手部任务同级或分级的仿真
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:哪些结论来自图,哪些依赖假设 → 四、读重心与手部任务同级或分级的仿真
把可视证据与实验条件/证据局限放在同一节
- 五处证据:哪些结论来自图,哪些依赖假设 → 四、读重心与手部任务同级或分级的仿真
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与代价:层级是一种明确的取舍 → 五、检查可行性、模型误差与剩余自由度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:为什么调大权重与真正优先不同 → 三、执行剩余方向分配,用权重折中作对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三个问题检验是否理解层级 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:手部目标与平衡冲突时怎样保证低优先级退让
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、构造动态一致层级,区分约束任务和姿态
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、构造动态一致层级,区分约束任务和姿态
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:一个任务被投到高优先级零空间后,它的秩应按哪个雅可比判断?:一个任务被投到高优先级零空间后,它的秩应按哪个雅可比判断?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 5:同时看重心误差和右手位置:提高平衡优先级后,重心接近目标,手仍保留明显残差
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 12 页;裁切框为原页比例 (0.125, 0.395, 0.9, 0.825)
同时看重心误差和右手位置:提高平衡优先级后,重心接近目标,手仍保留明显残差。这张图最重要的是误差被分配到低优先级任务,而非所有误差都消失。
- 原论文 Figure 1:手部目标、躯干姿态与重心任务分解
方法/设定图 · 必要原图摘引 · Figure 1, PDF p.3
箭头把手部位置、躯干竖直和重心落在足部支撑区三项要求分开;并行提出目标以后,还需要优先级处理互相冲突的方向。
- 原论文 Figure 4:重心与手部同级时的四组响应
实验/结果图 · 必要原图摘引 · Figure 4, PDF p.11
同时查看平衡误差、手部高度及膝肘角度:关节限制激活后,平衡误差仍会偏离零,可与已有图5的优先级设置对照。
- 避障任务与保持手部位置同时激活的三帧全身姿态
实验/结果图 · 必要原图摘引 · Figure 2, PDF p.6
三面板中障碍改变了躯干和腿部姿态,而手的目标位置保持固定;这是任务优先级协调的具体例子,不证明全局规划完备。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 4、图 5、图 3
查看本篇 5 个原文证据入口
- 图 1 · PDF 第 3 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 6 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 11 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 12 页,Figure 5
原站图表/证明入口
- 图 3 · PDF 第 9 页,Figure 3
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 动力学一致的“看不见”,要在加速度层检查
- 在叙事内加入可复算教学例,并明确:本篇明确扩展动态一致任务零空间;层级投影与约束QP的不同控制框架
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 4、图 5、图 3
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- ai.stanford.edu · 所列章节
第2节动态一致逆和投影任务可行性条件;惯性算例为原创。
- ai.stanford.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 018-operational-space · 直接继承
本篇明确扩展动态一致任务零空间
- 080-wholebody-qp · 平行方法
教学对照任务合力与关节可实现性;质心全身轨迹优化并未自动包含全部关节力矩界。
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典A Generalized Iterative LQG Method for Locally-Optimal Feedback Control of Constrained Nonlinear Stochastic Systems部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:非线性轨迹怎样同时配上偏离后的局部反馈
- 二、沿轨迹线性化并反向递推控制律和值函数
- 三、更新名义轨迹,检查输入约束与控制相关噪声
- 四、读倒立摆和肌肉手臂的闭环对照
- 五、保留初值、导数和局部近似的范围
- 六、追问:只比较无噪声名义轨迹代价,能否确认控制相关噪声处理有效?
- 七、比较轨迹平滑与滚动执行
- 八、自测与参考答案
段落怎样重新安排
- 背景:为什么既不用全局网格,也不只做开环优化 → 一、问题设定:非线性轨迹怎样同时配上偏离后的局部反馈
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把局部模型、控制律和值函数同时说明白 → 二、沿轨迹线性化并反向递推控制律和值函数
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 约束和非凸性:不能把一个逆矩阵当成万能答案 → 三、更新名义轨迹,检查输入约束与控制相关噪声
把求解机制与每步执行顺序分开检验
- 约束和非凸性:不能把一个逆矩阵当成万能答案 → 二、沿轨迹线性化并反向递推控制律和值函数
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验如何设计 → 四、读倒立摆和肌肉手臂的闭环对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组证据,以及它们不能证明的事情 → 四、读倒立摆和肌肉手臂的闭环对照
把可视证据与实验条件/证据局限放在同一节
- 五组证据,以及它们不能证明的事情 → 四、读倒立摆和肌肉手臂的闭环对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、局限与几个容易误读的词 → 五、保留初值、导数和局部近似的范围
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:为什么“用力更大”未必更稳 → 三、更新名义轨迹,检查输入约束与控制相关噪声
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:把局部反馈的边界讲清楚 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:非线性轨迹怎样同时配上偏离后的局部反馈
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、沿轨迹线性化并反向递推控制律和值函数
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、沿轨迹线性化并反向递推控制律和值函数
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:轨迹之外,也要有办法 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:只比较无噪声名义轨迹代价,能否确认控制相关噪声处理有效?:只比较无噪声名义轨迹代价,能否确认控制相关噪声处理有效?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 5:左图以 CPU 时间而非迭代次数比较代价下降,右图展示不同初始化的路径
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 6 页;裁切框为原页比例 (0.5, 0.725, 0.94, 0.9)
左图以 CPU 时间而非迭代次数比较代价下降,右图展示不同初始化的路径。应同时看计算预算与最终代价,不能仅用一次迭代更快判断完整求解更快。
- 原论文 Figure 2:摆系统在不同初态下的局部最优轨迹
实验/结果图 · 必要原图摘引 · Figure 2, PDF p.6
九个相平面面板展示不同初态与轨迹形状;黑色轨迹可以绕行后再到目标,因此局部反馈优化不等于总沿最短几何路径运动。
- 原论文 Figure 4:噪声下开环与反馈到达分布
实验/结果图 · 必要原图摘引 · Figure 4, PDF p.6
三组轨迹末端的椭圆范围不同;相同目标附近的散布揭示反馈抗扰能力,而不是只比较一条无噪声名义轨迹。
- 原论文Figure 5完整图:ILQG计算时间与成本,以及优化前后的手部轨迹
实验/结果图 · 必要原图摘引 · Figure 5, PDF p.6, complete replacement supplement
A面板完整显示纵轴顶端−1刻度,成本随CPU计算时间下降;B面板保留随机初始控制的插图、黑色优化轨迹和青色差局部解,不能把每次优化都视为全局成功。
- 独立绘制的受限力矩倒立摆及两关节六肌群控制模型
方法/设定图 · 原创教学图 · Figure 1, PDF p.5
左侧保留原文的摆方程、5秒时限与力矩界;右侧只画两关节与六个执行肌群的功能结构,不临摹人体外形。肌肉激活状态也属于控制状态,不能只凭末端路径评价总代价。
未在正文展示的图/表与范围
- 图3:两种控制问题模型已独立重绘,相平面轨迹、噪声反馈和定量结果已展示;剩余为十六方向肌肉控制、速度和路径组成的大型复合实验图。缺少该次优化的完整数据,不能用任意仿真或教学线条替代。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 5
查看本篇 5 个原文证据入口
- 图 1 · PDF 第 5 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 6 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 6 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 6 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 配方一次平方,反馈项与前馈项就分开了
- 在叙事内加入可复算教学例,并明确:轨迹优化中模型与更新结构不同;局部/简化模型有限时域求解的联系
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1、图 2、图 3、图 4、图 5
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- roboti.us · 所列章节
第III–IV节偏差动力学、控制相关噪声和仿射反馈形式。
- roboti.us · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 059-chomp · 平行方法
轨迹优化中模型与更新结构不同
- 094-cheetah-mpc · 教学联系
局部/简化模型有限时域求解的联系
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Anytime Dynamic A*: An Anytime, Replanning Algorithm部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:既来不及求最优又遇地图变化时怎样保留可用路线
- 二、把随时改进与增量修复接到一致性状态
- 三、调节质量要求并修复路径,核对版本规则
- 四、读每步时间预算下的执行成本与质量界
- 五、检查大变化、过时路径与状态维护成本
- 六、追问:地图更新后,旧的质量界能否随旧路径直接展示给执行器?
- 七、继续用启发信息分配采样预算
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:质量界是相对于哪个最优解 → 一、问题设定:既来不及求最优又遇地图变化时怎样保留可用路线
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:保存两种代价,识别谁需要重算 → 三、调节质量要求并修复路径,核对版本规则
把求解机制与每步执行顺序分开检验
- 方法:保存两种代价,识别谁需要重算 → 二、把随时改进与增量修复接到一致性状态
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个必须保留的版本说明 → 二、把随时改进与增量修复接到一致性状态
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验如何把时间和变化同时引入 → 四、读每步时间预算下的执行成本与质量界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组证据:不要把示例等同于普遍加速 → 四、读每步时间预算下的执行成本与质量界
把可视证据与实验条件/证据局限放在同一节
- 五组证据:不要把示例等同于普遍加速 → 四、读每步时间预算下的执行成本与质量界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与局限:保存旧信息不总比重算便宜 → 五、检查大变化、过时路径与状态维护成本
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:一次变化可能使质量界暂时失效 → 三、调节质量要求并修复路径,核对版本规则
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:能否解释三个常见误用 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:既来不及求最优又遇地图变化时怎样保留可用路线
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把随时改进与增量修复接到一致性状态
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把随时改进与增量修复接到一致性状态
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:地图更新后,旧的质量界能否随旧路径直接展示给执行器?:地图更新后,旧的质量界能否随旧路径直接展示给执行器?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 10:左侧给出机械臂与末端路径,右侧把环境变化概率与计算指标相连
实验/结果图 · 必要原图摘引 · Fig. 10,PDF 第 9 页;裁切框为原页比例 (0.05, 0.05, 0.93, 0.279)
左侧给出机械臂与末端路径,右侧把环境变化概率与计算指标相连。变化越频繁时复用与重新改善解的权衡不同,不能将某一静态地图耗时概括为全部在线性能。
- 原论文 Figure 4:AD星键值、状态更新与改善路径过程
方法/设定图 · 必要原图摘引 · Figure 4, PDF p.4
图中把过一致与欠一致状态的键值分开,并用OPEN、CLOSED和INCONS保存不同状态;读循环时要同时检查g与rhs。
- 原论文 Figure 5:AD星主循环及次优界更新
方法/设定图 · 必要原图摘引 · Figure 5, PDF p.4
主循环在有余裕时降低epsilon并重新安排队列,也在代价变化时更新受影响状态;持续改进与动态修复在同一流程中交替进行。
- 原论文 Figure 9:第一实验的机械臂场景、解代价与展开量
实验/结果图 · 必要原图摘引 · Figure 9, PDF p.8
左侧给出最优路线和末端轨迹,右侧分别比较解代价与状态展开;AD星的计算优势与结果次优性必须一起看。
- 原论文 Figure 6:六种搜索策略的网格展开过程
方法/设定图 · 必要原图摘引 · Figure 6, PDF p.6
三行图把A星、D星Lite及ARA星/AD星在相同障碍变化下并排比较,阴影是搜索工作,连线是路径;不能只按最后路径形状估计计算量。
- 原论文 Figure 11:AD星随规划轮次降低解代价
实验/结果图 · 必要原图摘引 · Figure 11, PDF p.10
每组场景后接代价曲线,横轴为规划轮次而非连续秒数;阶梯下降表明继续计算带来更低代价,但改善不是每一步都发生。
- ATRV平台及两次在线导航地图和更新路径
实验/结果图 · 必要原图摘引 · Figure 7, PDF p.7
蓝色路线随新障碍观测而更新,地图和平台同屏展示了集成设置;它不提供碰撞率或最坏延迟保证。
未在正文展示的图/表与范围
- 图8:已补 ATRV 平台及更新路径的三面板实证;剩余是静态 Segbot 平台照片,对搜索工作量和持续改进论证不增加独立数据,当前保留来源。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 9、图 10、图 6、图 7、图 8、图 11
查看本篇 8 个原文证据入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 4 页,Figure 5
原站图表/证明入口
- 图 9 · PDF 第 8 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 9 页,Figure 10
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 7 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 7 页,Figure 8
原站图表/证明入口
- 图 11 · PDF 第 10 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 质量界需要一份仍然有效的下界
- 在叙事内加入可复算教学例,并明确:本篇融合其增量一致性结构;anytime解改善但搜索空间与理论不同
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 9、图 10、图 6、图 7、图 8、图 11
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- cdn.aaai.org · 所列章节
第2节D* Lite背景、g/rhs一致性和增量图代价变化。
- cdn.aaai.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 046-dstar-lite · 直接继承
本篇融合其增量一致性结构
- 081-bitstar · 教学联系
anytime解改善但搜索空间与理论不同
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典The GraphSLAM Algorithm with Applications to Large-Scale Mapping of Urban Structures部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:回环观测怎样重新分配整段轨迹的误差
- 二、用稀疏约束建图,再消去地标变量
- 三、解位姿系统并回代,用单地标消元验算
- 四、读城市地图与GPS案例,分开代数和系统证据
- 五、检查线性化、初值、关联错误与批量存储
- 六、追问:地标消元后图里出现新的位姿连接,是否代表新增了传感器观测?
- 七、从历史稀疏图走向增量分解
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:估计当前状态,还是估计整段历史 → 一、问题设定:回环观测怎样重新分配整段轨迹的误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:稀疏图从哪里来 → 二、用稀疏约束建图,再消去地标变量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 精确消元与近似求解并不矛盾 → 三、解位姿系统并回代,用单地标消元验算
把求解机制与每步执行顺序分开检验
- 精确消元与近似求解并不矛盾 → 二、用稀疏约束建图,再消去地标变量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置:大地图来自怎样的数据 → 四、读城市地图与GPS案例,分开代数和系统证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:从代数机制到城市地图 → 四、读城市地图与GPS案例,分开代数和系统证据
把可视证据与实验条件/证据局限放在同一节
- 五处证据:从代数机制到城市地图 → 四、读城市地图与GPS案例,分开代数和系统证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 公式阅读中的具体边界 → 五、检查线性化、初值、关联错误与批量存储
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失败边界 → 五、检查线性化、初值、关联错误与批量存储
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:一个地标怎样变成两帧之间的约束 → 三、解位姿系统并回代,用单地标消元验算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三个问题理解图优化 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:回环观测怎样重新分配整段轨迹的误差
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用稀疏约束建图,再消去地标变量
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用稀疏约束建图,再消去地标变量
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:机器人回到旧地方时,过去也可以被修正 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:地标消元后图里出现新的位姿连接,是否代表新增了传感器观测?:地标消元后图里出现新的位姿连接,是否代表新增了传感器观测?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 6:上下使用同一室内外数据,下面加入室外 GPS 因子
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 21 页;裁切框为原页比例 (0.245, 0.135, 0.755, 0.825)
上下使用同一室内外数据,下面加入室外 GPS 因子。比较道路与建筑轮廓的整体位置变化,才能看出额外绝对约束的作用;这不等于没有 GPS 时地图也具有同样的全局准确度。
- 原论文 Figure 1:位姿、地标与非线性约束构成的GraphSLAM图
方法/设定图 · 必要原图摘引 · Figure 1, PDF p.5
三角节点是位姿、星形节点是地标,实边和虚边分别连接运动及观测约束;下方总成本由这些局部约束共同组成。
- 原论文 Figure 2:观测及运动因子对信息矩阵块的贡献
方法/设定图 · 必要原图摘引 · Figure 2, PDF p.6
三个面板将左侧图关系对应到右侧矩阵阴影;增加观测或运动边会填入关联变量的块,而不是无差别改变所有元素。
- 原论文 Figure 3:消去地标后的位姿图与填充项
方法/设定图 · 必要原图摘引 · Figure 3, PDF p.7
从上到下消去地标时,原先共同观测地标的位姿之间形成新约束;最终只剩位姿变量,但矩阵的连接会比原来稠密。
未在正文展示的图/表与范围
- 表10:表格独立清点;不计入Figure内嵌目标。
- 表8:表格独立清点;不计入Figure内嵌目标。
- 表9:表格独立清点;不计入Figure内嵌目标。
- 图4:已展示图模型、信息矩阵、消元机制及室内外约束的地图对照;剩余采集平台/扫描演示和两组大型三维建图展示,暂不将方法图与整套场景视觉结果全部重组。原数据未取得,不能独立重建相同点云。
- 表3:表格独立清点;不计入Figure内嵌目标。
- 表7:表格独立清点;不计入Figure内嵌目标。
- 图5:已展示图模型、信息矩阵、消元机制及室内外约束的地图对照;剩余采集平台/扫描演示和两组大型三维建图展示,暂不将方法图与整套场景视觉结果全部重组。原数据未取得,不能独立重建相同点云。
- 图7:已展示图模型、信息矩阵、消元机制及室内外约束的地图对照;剩余采集平台/扫描演示和两组大型三维建图展示,暂不将方法图与整套场景视觉结果全部重组。原数据未取得,不能独立重建相同点云。
- 图8:已展示图模型、信息矩阵、消元机制及室内外约束的地图对照;剩余采集平台/扫描演示和两组大型三维建图展示,暂不将方法图与整套场景视觉结果全部重组。原数据未取得,不能独立重建相同点云。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 10、表 8、图 4、图 1、图 2、图 3、表 3、表 7、图 5、图 6、图 7、图 8、表 9
查看本篇 13 个原文证据入口
- 表 10 · PDF 第 18 页,Table 10
原站图表/证明入口
- 表 8 · PDF 第 16 页,Table 8
原站图表/证明入口
- 图 4 · PDF 第 20 页,Figure 4
原站图表/证明入口
- 图 1 · PDF 第 5 页,Figure 1
原站图表/证明入口
- 图 2 · PDF 第 6 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 7 页,Figure 3
原站图表/证明入口
- 表 3 · PDF 第 12 页,Table 3
原站图表/证明入口
- 表 7 · PDF 第 15 页,Table 7
原站图表/证明入口
- 图 5 · PDF 第 20 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 21 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 22 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 23 页,Figure 8
原站图表/证明入口
- 表 9 · PDF 第 18 页,Table 9
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 消去一个地标,会在哪些位姿之间长出新边
- 在叙事内加入可复算教学例,并明确:历史采样和历史优化的区别;后作研究稀疏分解的增量更新;后作通过消元结构管理重线性化
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 10、表 8、图 4、图 1、图 2、图 3、表 3、表 7、图 5、图 6、图 7、图 8、表 9
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- robots.stanford.edu · 所列章节
第3节全轨迹后验、局部观测/运动概率;消元例为原创。
- robots.stanford.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 045-fastslam · 平行方法
历史采样和历史优化的区别
- 057-isam · 历史背景
后作研究稀疏分解的增量更新
- 068-isam2 · 历史背景
后作通过消元结构管理重线性化
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Capture Point: A Step toward Humanoid Push Recovery部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:质心位置与速度怎样决定一步能否停住
- 二、推导捕获点,再加入受限飞轮与地面作用
- 三、计算可捕获范围,用迈步时延检查目标变化
- 四、读平面模型恢复案例与参数分析
- 五、保留摆腿时间、角动量预算与接触可行性
- 六、追问:同一瞬间算出的捕获点可达,为什么延迟落脚仍可能失败?
- 七、从可停止性走向接触力滚动优化
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:停止的含义比“瞬间速度为零”更强 → 一、问题设定:质心位置与速度怎样决定一步能否停住
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法一:线性倒立摆的唯一捕获点 → 二、推导捕获点,再加入受限飞轮与地面作用
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法二:角动量为什么把一个点变成区域 → 二、推导捕获点,再加入受限飞轮与地面作用
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法三:力矩更大,还要看地面能否承受 → 三、计算可捕获范围,用迈步时延检查目标变化
把求解机制与每步执行顺序分开检验
- 方法三:力矩更大,还要看地面能否承受 → 二、推导捕获点,再加入受限飞轮与地面作用
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置与参数分析 → 四、读平面模型恢复案例与参数分析
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组证据及其适用范围 → 四、读平面模型恢复案例与参数分析
把可视证据与实验条件/证据局限放在同一节
- 五组证据及其适用范围 → 四、读平面模型恢复案例与参数分析
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与局限:一个清楚的停止条件,胜过模糊的“保持平衡” → 五、保留摆腿时间、角动量预算与接触可行性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构例子:迈步越慢,目标可能跑得越远 → 三、计算可捕获范围,用迈步时延检查目标变化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三个问题理解捕获 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:质心位置与速度怎样决定一步能否停住
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、推导捕获点,再加入受限飞轮与地面作用
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、读平面模型恢复案例与参数分析
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:站得正,不等于不会倒 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:同一瞬间算出的捕获点可达,为什么延迟落脚仍可能失败?:同一瞬间算出的捕获点可达,为什么延迟落脚仍可能失败?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:1 幅
- Fig. 7:位置、速度、轨道能量、身体俯仰与髋力矩随时间的五组仿真曲线
实验/结果图 · 必要原图摘引 · 原论文 Fig. 7;作者上传独立图页;完整 PDF 页序未核实
对齐 0.5 s 扰动时刻,速度跳变后髋力矩先负后正,身体俯仰增加后停止,轨道能量回到接近零。这是无需迈步的平面简模仿真,不能替代三维实机的扰动恢复极限。
未在正文展示的图/表与范围
- 图3:完整作者PDF下载超时;公开检索镜像未取得可用文件或可截取图像,未获得本图可像素核实的原图。保留原文链接,没有用教学示意或正文截图代替。本图的ResearchGate原图下载另返回403。
- 图5:完整作者PDF下载超时;公开检索镜像未取得可用文件或可截取图像,未获得本图可像素核实的原图。保留原文链接,没有用教学示意或正文截图代替。本图的ResearchGate原图下载另返回403。
- 图6:完整作者PDF下载超时;公开检索镜像未取得可用文件或可截取图像,未获得本图可像素核实的原图。保留原文链接,没有用教学示意或正文截图代替。本图的ResearchGate原图下载另返回403。
- 图8:完整作者PDF下载超时;公开检索镜像未取得可用文件或可截取图像,未获得本图可像素核实的原图。保留原文链接,没有用教学示意或正文截图代替。
- 图2:完整作者PDF下载超时;公开检索镜像未取得可用文件或可截取图像,未获得本图可像素核实的原图。保留原文链接,没有用教学示意或正文截图代替。
- 图4:完整作者PDF下载超时;公开检索镜像未取得可用文件或可截取图像,未获得本图可像素核实的原图。保留原文链接,没有用教学示意或正文截图代替。
- 图9:完整作者PDF下载超时;公开检索镜像未取得可用文件或可截取图像,未获得本图可像素核实的原图。保留原文链接,没有用教学示意或正文截图代替。
本次取得并目检作者公开上传的 Fig. 7 原图;完整 PDF 页序仍未核实,其余所引图未内嵌。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 6、图 8、图 5
- 区分已核验的独立原图与整份原稿入口,补明相图坐标及隐藏状态
- 取得并内嵌作者上传的 Fig. 7 原始五组仿真时间序列;未声称核实完整 PDF 页序。
查看本篇 5 个原文证据入口
- 图 3 · 作者上传的原论文图 3 独立图页
原站图表/证明入口
- 图 6 · 作者上传的原论文图 6 独立图页
原站图表/证明入口
- 图 8 · 作者上传的原论文图 8 独立图页
原站图表/证明入口
- 图 5 · 作者上传的原论文图 5 独立图页
原站图表/证明入口
- 图 7 · 作者上传的原论文 Fig. 7 独立图页;未核实完整 PDF 页序
原图必要摘引,版权保留
本轮边界:通过作者上传的独立原图页核验图 3、5、6、8;其他图保留正文定位,未获得可用整份 PDF 页序;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 捕获点本身也会向外跑
- 在叙事内加入可复算教学例,并明确:本篇从LIP模型扩展捕获分析;同模型家族的计划跟踪与受扰恢复
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 6、图 8、图 5
- 区分已核验的独立原图与整份原稿入口,补明相图坐标及隐藏状态
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.researchgate.net · 所列章节
作者上传摘要与图注的LIP飞轮扩展、平面仿真与角动量边界。
- www.researchgate.net · 所列章节
v2 局部核对:逐项复核现有三题问答;核对作者上传的图 3、5、6、8 独立原图页及图注,未取得整份 PDF 的可验证页序;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 027-lipm · 直接继承
本篇从LIP模型扩展捕获分析
- 047-preview-zmp · 平行方法
同模型家族的计划跟踪与受扰恢复
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
- 通过作者上传的独立原图页核验图 3、5、6、8;其他图保留正文定位,未获得可用整份 PDF 页序
机器人经典Improved Techniques for Grid Mapping With Rao-Blackwellized Particle Filters部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:新扫描怎样在抽样之前减少无效轨迹粒子
- 二、结合扫描与里程计构造提议,再选择性重采样
- 三、执行局部匹配和权重更新,用窄似然验算
- 四、比较拓扑正确率门槛、粒子数与计算成本
- 五、检查局部模式遗漏和粒子地图代价
- 六、追问:更少粒子达到同样正确率,是否已经证明总计算更少?
- 七、区分粒子地图与历史图优化
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:一个粒子其实带着一段历史 → 一、问题设定:新扫描怎样在抽样之前减少无效轨迹粒子
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把测量放到抽样之前 → 三、执行局部匹配和权重更新,用窄似然验算
把求解机制与每步执行顺序分开检验
- 方法:把测量放到抽样之前 → 二、结合扫描与里程计构造提议,再选择性重采样
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验如何验证 → 四、比较拓扑正确率门槛、粒子数与计算成本
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据,以及不能推出的结论 → 四、比较拓扑正确率门槛、粒子数与计算成本
把可视证据与实验条件/证据局限放在同一节
- 五处证据,以及不能推出的结论 → 四、比较拓扑正确率门槛、粒子数与计算成本
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 新意、代价与边界 → 五、检查局部模式遗漏和粒子地图代价
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个可手算的小例子 → 三、执行局部匹配和权重更新,用窄似然验算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:新扫描怎样在抽样之前减少无效轨迹粒子
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、结合扫描与里程计构造提议,再选择性重采样
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、比较拓扑正确率门槛、粒子数与计算成本
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:更少粒子达到同样正确率,是否已经证明总计算更少?:更少粒子达到同样正确率,是否已经证明总计算更少?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:6 幅
- Fig. 7:横轴粒子数、纵轴成功比例把多环境的预算需求并列
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 8 页;裁切框为原页比例 (0.065, 0.735, 0.5, 0.84)
横轴粒子数、纵轴成功比例把多环境的预算需求并列。先看每个场景何时开始稳定成功,再讨论建议粒子数;不同地图的阈值不能简单互换。
- 原论文 Figure 2:走廊中运动先验与观测提议的粒子分布
方法/设定图 · 必要原图摘引 · Figure 2, PDF p.4
三个面板对照粒子沿走廊和横向的散布;观测约束能压缩某些方向的不确定性,却不能凭空消除走廊方向的歧义。
- 原论文 Figure 6:室内地图及墙面细节放大
实验/结果图 · 必要原图摘引 · Figure 6, PDF p.8
多个放大框检查同一地图的局部墙线重合情况;整体轮廓看似完整时,局部重影仍可能暴露累积位姿误差。
- 原论文 Figure 4:大范围闭环地图与局部细节
实验/结果图 · 必要原图摘引 · Figure 4, PDF p.7
左图显示整体地图和轨迹,右图放大方框区域;闭环后局部墙线是否对齐比只看轨迹是否围成一圈更有诊断价值。
- 原论文 Figure 8:沿路径的有效粒子比例变化
实验/结果图 · 必要原图摘引 · Figure 8, PDF p.8
上方路径标记对应下方Neff/N曲线的时间点;急剧下降说明权重集中,重采样时机应依据这一退化信号。
- 原论文Figure 7完整图:四种环境中粒子数与建图成功率
实验/结果图 · 必要原图摘引 · Figure 7, PDF p.8, complete replacement supplement
完整横轴标为number of particles并使用对数尺度,纵轴为成功率;四组环境达到高成功率所需粒子数不同,MIT-2还禁用了自适应重采样,不能把所有差异都归因于地图大小。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 7、图 2、表 II、图 6、图 4、表 III、图 11
查看本篇 7 个原文证据入口
- 图 7 · PDF 第 8 页,Figure 7
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 表 II · PDF 第 8 页,Table II
原站图表/证明入口
- 图 6 · PDF 第 8 页,Figure 6
原站图表/证明入口
- 图 4 · PDF 第 7 页,Figure 4
原站图表/证明入口
- 表 III · PDF 第 10 页,Table III
原站图表/证明入口
- 图 11 · PDF 第 10 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 把观测移到提议分布里,权重公式也必须一起改
- 在叙事内加入可复算教学例,并明确:条件地图与轨迹采样骨架;每粒子条件占据地图
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 7、图 2、表 II、图 6、图 4、表 III、图 11
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.ipb.uni-bonn.de · 所列章节
第II–III节重要性权重递推、提议分布和自适应重采样。
- www.ipb.uni-bonn.de · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 045-fastslam · 直接继承
本篇承接前作:条件地图与轨迹采样骨架
- 025-occupancy · 模块组合
每粒子条件占据地图
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Parallel Tracking and Mapping for Small AR Workspaces部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:每帧跟踪怎样不必等待全图束调整
- 二、拆开跟踪和关键帧建图的时钟
- 三、更新共享地图,用线程分工检查延迟来源
- 四、读桌面AR与有真值合成比较
- 五、限制地图增长、初始化与静态纹理条件
- 六、追问:跟踪帧率保持稳定,为什么仍要报告关键帧建图的滞后?
- 七、给关键帧分工补上长期地图能力
- 八、自测与参考答案
段落怎样重新安排
- 背景:位姿更新和全局解释不必共用时钟 → 一、问题设定:每帧跟踪怎样不必等待全图束调整
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:一张共享地图,两种工作节奏 → 三、更新共享地图,用线程分工检查延迟来源
把求解机制与每步执行顺序分开检验
- 方法:一张共享地图,两种工作节奏 → 二、拆开跟踪和关键帧建图的时钟
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计与比较口径 → 四、读桌面AR与有真值合成比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 读懂五组结果 → 四、读桌面AR与有真值合成比较
把可视证据与实验条件/证据局限放在同一节
- 读懂五组结果 → 四、读桌面AR与有真值合成比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与局限 → 五、限制地图增长、初始化与静态纹理条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个理解并行的例子 → 三、更新共享地图,用线程分工检查延迟来源
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:每帧跟踪怎样不必等待全图束调整
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、拆开跟踪和关键帧建图的时钟
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、拆开跟踪和关键帧建图的时钟
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:跟踪帧率保持稳定,为什么仍要报告关键帧建图的滞后?:跟踪帧率保持稳定,为什么仍要报告关键帧建图的滞后?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 4:点数增长与每帧跟踪耗时同图呈现:红色尖峰对应特定跟踪事件,平均时间不能代表每帧延迟
实验/结果图 · 必要原图摘引 · Fig. 4,PDF 第 7 页;裁切框为原页比例 (0.1, 0.69, 0.91, 0.866)
点数增长与每帧跟踪耗时同图呈现:红色尖峰对应特定跟踪事件,平均时间不能代表每帧延迟。关键帧建图与实时跟踪分离,也并不保证耗时永远恒定。
- 原论文 Figure 3:桌面地图与选取的关键帧
实验/结果图 · 必要原图摘引 · Figure 3, PDF p.7
上排从两个角度显示地图点和相机位姿,下方排列实际关键帧;关键帧集合服务于地图优化,并非视频每一帧都进入同样的优化。
- 原论文 Figure 5:合成序列中PTAM与EKF-SLAM的地图及轨迹
实验/结果图 · 必要原图摘引 · Figure 5, PDF p.8
先看两种方法的地图表示,再看右侧与真值对齐的轨迹;这组受控实验不能直接覆盖任意真实场景和快速运动。
- 原论文 Figure 6:由键盘近景到整间房的跨尺度跟踪
实验/结果图 · 必要原图摘引 · Figure 6, PDF p.9
四张画面从近到远仍显示同一空间中的增强标记;它展示尺度跨度下的跟踪能力,不等于没有模糊或遮挡限制。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、表 1、表 2、图 5、图 6、图 4
查看本篇 6 个原文证据入口
- 图 3 · PDF 第 7 页,Figure 3
原站图表/证明入口
- 表 1 · PDF 第 6 页,Table 1
原站图表/证明入口
- 表 2 · PDF 第 6 页,Table 2
原站图表/证明入口
- 图 5 · PDF 第 8 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 9 页,Figure 6
原站图表/证明入口
- 图 4 · PDF 第 7 页,Figure 4
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 双线程没有消灭工作量,而是改变了截止时间
- 在叙事内加入可复算教学例,并明确:每帧联合滤波与关键帧批优化;双视图初始化模块;后作发展关键帧系统分工
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、表 1、表 2、图 5、图 6、图 4
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.robots.ox.ac.uk · 所列章节
第2节拆分动机、关键帧与BA、五点初始化和处理期限。
- www.robots.ox.ac.uk · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 044-slam-convergence · 平行方法
每帧联合滤波与关键帧批优化
- 049-five-point · 模块组合
双视图初始化模块
- 082-orbslam · 历史背景
后作发展关键帧系统分工
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典iSAM: Incremental Smoothing and Mapping部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:新约束加入后怎样复用已有平方根分解
- 二、增量QR更新,再按需重排序和重线性化
- 三、更新三角系统并查询协方差,用小图验算
- 四、读回环、速度与稀疏结构证据
- 五、区分线性系统精确解与非线性全局正确
- 六、追问:平均更新时间很小,为什么还要单独报告回环时的峰值?
- 七、继续局部化非线性结构更新
- 八、自测与参考答案
段落怎样重新安排
- 背景:为什么更多变量有时更稀疏 → 一、问题设定:新约束加入后怎样复用已有平方根分解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把新测量加入已有三角方程 → 三、更新三角系统并查询协方差,用小图验算
把求解机制与每步执行顺序分开检验
- 方法:把新测量加入已有三角方程 → 二、增量QR更新,再按需重排序和重线性化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计 → 四、读回环、速度与稀疏结构证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处核心证据 → 四、读回环、速度与稀疏结构证据
把可视证据与实验条件/证据局限放在同一节
- 五处核心证据 → 四、读回环、速度与稀疏结构证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价和容易误读的“精确” → 五、区分线性系统精确解与非线性全局正确
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个能亲手推导的例子 → 三、更新三角系统并查询协方差,用小图验算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:新约束加入后怎样复用已有平方根分解
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、增量QR更新,再按需重排序和重线性化
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、增量QR更新,再按需重排序和重线性化
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:平均更新时间很小,为什么还要单独报告回环时的峰值?:平均更新时间很小,为什么还要单独报告回环时的峰值?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:9 幅
- Fig. 10:原始里程计、优化地图和稀疏因子结构并排看:地图变好是几何结果,右侧结构则解释增量更新成本;稀疏不等于没有填充或所有更新时间都相同
实验/结果图 · 必要原图摘引 · Fig. 10,PDF 第 10 页;裁切框为原页比例 (0.05, 0.365, 0.95, 0.592)
原始里程计、优化地图和稀疏因子结构并排看:地图变好是几何结果,右侧结构则解释增量更新成本;稀疏不等于没有填充或所有更新时间都相同。
- 原论文图3:新增约束逐步消元后的稀疏三角因子及增量更新位置
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 4
新增行主要改变与它相连的因子部分;图中的颜色区分已有结构与更新。
- 原论文图4:每步Givens旋转次数随探索步骤变化的红色曲线
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 4
横轴是增量步骤,尖峰表示单步工作量变化,平均值不代表最坏延迟。
- 原论文图5:回环示例、重排序前后三角因子和三种排序策略的耗时曲线
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 5
先对照回环时刻与因子填充,再读线性和对数时间轴上的开销差异。
- 原论文图7:红色轨迹、绿色保守协方差椭圆与蓝色精确协方差椭圆
方法/设定图 · 必要原图摘引 · Fig. 7, PDF page 7
绿色椭圆通常更大;这里比较的是同一线性化问题的边缘协方差近似。
- 原论文图8:Victoria Park的纯里程计轨迹、优化轨迹和稀疏因子
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 8
中间图叠加实景作为位置背景,右侧展示的是矩阵结构,不是另一张地图。
- 原论文图9:Manhattan数据优化前后地图和最终三角因子
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 10
几何重影与矩阵稀疏性是不同观察量,需分别读左右面板。
- 原论文图11:Killian序列纯里程计、优化地图及最终稀疏因子
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 10
比较同一序列的轨迹形状,再看右侧因子中保留的非零结构。
- 原论文图12:四种数据集每列非零矩阵条目平均数随步骤变化
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 11
纵轴计数描述稀疏程度,不是定位误差或每步耗时。
未在正文展示的图/表与范围
- 表I:Source-linked table, tracked separately; not counted as a missing Figure.
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 7、表 I、图 8、图 9、图 10、图 11、图 12
查看本篇 10 个原文证据入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 5 页,Figure 5
原站图表/证明入口
- 图 7 · PDF 第 7 页,Figure 7
原站图表/证明入口
- 表 I · PDF 第 8 页,Table I
原站图表/证明入口
- 图 8 · PDF 第 8 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 10 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 10 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 10 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 11 页,Figure 12
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导增量QR手算,并区分Square Root SAM直接前作与GraphSLAM平行路线
- 在叙事内加入可复算教学例,并明确:面向相同稀疏历史估计问题的增量求解;后作发展增量消元与重线性化
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 7、表 I、图 8、图 9、图 10、图 11、图 12
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cs.cmu.edu · 摘要
作者论文页中增量平方根信息分解、重排序与重线性化目标。
- www.cs.cmu.edu · 所列章节
下载原稿补读IV及VI节:100步重排与重线性化、回环填充、Victoria Park完整回代预算、Manhattan目标值比较。
- www.cs.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 053-graphslam · 平行方法
共享稀疏历史估计问题;本篇直接技术前作是作者的Square Root SAM。
- 068-isam2 · 直接继承
后作发展增量消元与重线性化
仍需留意
- 未重跑数据;本轮核对周期计算与关键实验条件,没有独立证明全部收敛主张。
机器人经典ROS: an open-source Robot Operating System部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:算法各自可用,抓杯子的系统为何仍接不起来
- 二、先让算法库独立,再定义节点怎样交换结果
- 三、沿网络拓扑建立连接,再把观察工具接进同一数据流
- 四、在类型检查之外,校验坐标和采集时刻
- 五、按部署、复用和调试职责读系统证据
- 六、把通信便利与闭环正确性的保证分开
- 七、沿接口边界继续接入规划库与估计器
- 八、自测与参考答案
段落怎样重新安排
- 一分钟理解 → 一、问题设定/二、独立库与节点/五、系统证据
系统论文用集成任务引入,不套训练或优化框架
- 方法:把连接关系从算法代码里移出来 → 二、先让算法库独立,再定义节点怎样交换结果
明确可替换性由代码边界和协议边界共同提供
- 方法中的点对点与工具段 → 三、沿网络拓扑建立连接,再把观察工具接进同一数据流
运行与调试都复用同一数据流接口
- 一个具体小例子 → 四、在类型检查之外,校验坐标和采集时刻
把接口类型正确但物理语义错误的因果链讲完
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 独立一句话摘要重复接口贡献与边界;内容保留于第二节接口机制与第六节局限。
- 三行概述重复库、接口和日志责任;内容保留于第二、三、六节。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、把通信便利与闭环正确性的保证分开:从新增订阅者的链路拓扑检验通信预算,并把30 MB/s换算为240 Mb/s以比较链路容量。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Fig. 1:节点跨机器连接,消息通信把多个进程组成机器人系统
方法/设定图 · 必要原图摘引 · Fig. 1,PDF 第 1 页;裁切框为原页比例 (0.52, 0.255, 0.925, 0.38)
节点跨机器连接,消息通信把多个进程组成机器人系统。图展示通信与部署结构,不是关于硬实时调度或安全隔离已经得到保证的证据。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1
查看本篇 1 个原文证据入口
- 图 1 · PDF 第 1 页,Figure 1
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 接口类型正确,为什么机器人仍可能把地图画歪
- 在叙事内加入可复算教学例,并明确:坐标语义是通信类型之外的约束;通信系统承载估计算法;规划库可与中间件分层组合
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 1
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- ai.stanford.edu · 所列章节
第II节点对点、master查找、IDL与thin设计。
- ai.stanford.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 001-dh · 教学联系
坐标语义是通信类型之外的约束
- 053-graphslam · 模块组合
通信系统承载估计算法
- 067-ompl · 模块组合
规划库可与中间件分层组合
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典CHOMP: Gradient Optimization Techniques for Efficient Motion Planning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:碰撞路点的修正怎样沿整条轨迹平滑传播
- 二、选择轨迹度量与距离场,推导协变更新
- 三、手算一次更新,检查局部梯度的传播
- 四、读机械臂与摆腿实验,分开可行性和质量
- 五、保留非凸性、离散碰撞与初值敏感
- 六、追问:时间重参数化后沿弧长的障碍代价不变,为什么离散实现仍可能改变?
- 七、改用随机试探或逐次凸化
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题定义 → 一、问题设定:碰撞路点的修正怎样沿整条轨迹平滑传播
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:两种几何都要选对 → 三、手算一次更新,检查局部梯度的传播
把求解机制与每步执行顺序分开检验
- 方法:两种几何都要选对 → 二、选择轨迹度量与距离场,推导协变更新
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置 → 四、读机械臂与摆腿实验,分开可行性和质量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组证据 → 四、读机械臂与摆腿实验,分开可行性和质量
把可视证据与实验条件/证据局限放在同一节
- 五组证据 → 四、读机械臂与摆腿实验,分开可行性和质量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与失败边界 → 五、保留非凸性、离散碰撞与初值敏感
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 手算一次协变更新 → 三、手算一次更新,检查局部梯度的传播
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:碰撞路点的修正怎样沿整条轨迹平滑传播
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、选择轨迹度量与距离场,推导协变更新
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、选择轨迹度量与距离场,推导协变更新
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:时间重参数化后沿弧长的障碍代价不变,为什么离散实现仍可能改变?:时间重参数化后沿弧长的障碍代价不变,为什么离散实现仍可能改变?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 5:左图按迭代看目标下降,右图比较直线初始化(绿)与双向 RRT 初始化(红)
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 6 页;裁切框为原页比例 (0.09, 0.235, 0.49, 0.348)
左图按迭代看目标下降,右图比较直线初始化(绿)与双向 RRT 初始化(红)。初值改变可能进入不同局部极小;log-objective 差异不能直接解释为相同比例的路径长度改善。
- 原论文图3:CHOMP障碍代价场中的路径与一维代价梯度比较
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 4
左图解释避障代价的空间结构,右图对照其梯度关系。
- 原论文图4:CHOMP优化后的六个关节轨迹及关节限位
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 6
每个面板对应一个关节,轨迹与红色边界的关系用于检查限位约束。
- 原论文图7:四足机器人实物运动及相应规划姿态序列
实验/结果图 · 必要原图摘引 · Fig. 7, PDF page 8
左右图把实物执行与规划形态联系起来,但不能从单例推出普遍成功率。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 7、图 6
查看本篇 5 个原文证据入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 6 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 7 · PDF 第 8 页,Figure 7
原站图表/证明入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 协变更新如何把一个碰撞梯度扩散成整段弯曲
- 在叙事内加入可复算教学例,并明确:局部优化与探索可行通道;后作以随机扰动代替解析梯度
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 找到迁移后作者原稿并补核机械臂与LittleDog关键实验
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 7、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- publications.ri.cmu.edu · 摘要
原作者摘要的协变梯度与轨迹优化框架;度量步推导为原创。
- personalrobotics-files.cs.washington.edu · 所列章节
作者实验室当前页面链接的8页原稿,补读II-A/B/D/F、III与IV节:逆度量更新、99/105问题、400迭代约12秒、排除失败的log-objective比较、LittleDog离线优化与100Hz轨迹。
- personalrobotics.cs.washington.edu · 未能读取
旧链接返回404;已通过作者实验室当前出版页找到并读取新域名原稿。
- personalrobotics-files.cs.washington.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
仍需留意
- 旧PDF路径404已找到作者官方迁移地址;关键方法和实验数字已补核,未复现代码或逐像素读出所有曲线。
机器人经典ORB: An Efficient Alternative to SIFT or SURF部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:方向补偿后的二进制描述怎样保持区分力
- 二、给FAST估方向,再筛选高方差低相关测试
- 三、构造rBRIEF并匹配,检查有效比特信息
- 四、读速度与匹配实验,固定实现和图像条件
- 五、限制方向不稳、尺度处理和强视角变化
- 六、追问:256位描述子有很多重复测试时,增加长度为什么未必增加区分力?
- 七、把二进制特征交给检索与SLAM
- 八、自测与参考答案
段落怎样重新安排
- 背景与任务定义 → 一、问题设定:方向补偿后的二进制描述怎样保持区分力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:方向补偿之后,还要修复统计性质 → 三、构造rBRIEF并匹配,检查有效比特信息
把求解机制与每步执行顺序分开检验
- 方法:方向补偿之后,还要修复统计性质 → 二、给FAST估方向,再筛选高方差低相关测试
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置与证据范围 → 四、读速度与匹配实验,固定实现和图像条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组结果怎样读 → 四、读速度与匹配实验,固定实现和图像条件
把可视证据与实验条件/证据局限放在同一节
- 五组结果怎样读 → 四、读速度与匹配实验,固定实现和图像条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与边界 → 五、限制方向不稳、尺度处理和强视角变化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个关于“256 位不等于 256 份信息”的例子 → 三、构造rBRIEF并匹配,检查有效比特信息
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:方向补偿后的二进制描述怎样保持区分力
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、给FAST估方向,再筛选高方差低相关测试
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、给FAST估方向,再筛选高方差低相关测试
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:256位描述子有很多重复测试时,增加长度为什么未必增加区分力?:256位描述子有很多重复测试时,增加长度为什么未必增加区分力?
教法来源与实际阅读范围
- OpenCV官方文档作者团队 · ORB (Oriented FAST and Rotated BRIEF)
Theory:方向质心、旋转采样、比特方差与相关性;不采用页面过时专利断言
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:8 幅
- Fig. 7:横轴旋转角、纵轴匹配内点比例,比较各描述子在同一旋转试验中的曲线
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 5 页;裁切框为原页比例 (0.08, 0.365, 0.475, 0.55)
横轴旋转角、纵轴匹配内点比例,比较各描述子在同一旋转试验中的曲线。某些角度的峰谷暴露方向处理的影响;这不能替代不同真实场景上的泛化评估。
- 方向估计误差标准差随图像噪声强度变化
实验/结果图 · 必要原图摘引 · Fig. 2, PDF page 3
蓝色质心法曲线在所测噪声范围内明显低于另两种方向方法;横轴只是这里测试的高斯强度噪声,不包含所有成像变化。
- BRIEF及旋转和筛选版本的位响应均值直方图
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 3
简单旋转后的红柱分布扩展,说明测试位的均值性质发生变化;该分布是选择低偏置测试对的依据之一。
- 不同BRIEF版本的PCA特征值谱
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 4
前三组谱的下降形态用于诊断测试位之间的相关性;PCA在这里是分析手段,不是在线计算描述子的步骤。
- 内点和外点描述子距离分布的对比
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 4
实线和虚线分别对应匹配与非匹配距离,分布分离程度决定阈值辨识的难易;不能只凭曲线峰值判断所有场景的匹配率。
- 多种噪声设置下匹配内点比例随旋转角变化
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 5
不同噪声水平形成多条曲线,各方法相对表现随角度和噪声变化;这组人工旋转试验不能代替真实透视变化评测。
- 两个图像数据集的哈希桶大小分布
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 6
横轴为桶大小、纵轴为桶数量,三种描述子的分布不同;该差异与候选检索负担有关,但还受索引设置影响。
- 查询成功比例与每特征查询时间的散点权衡
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 6
每点对应一组系统设置,横轴成功比例与纵轴对数时间共同构成权衡;比较时仍需注意数据库规模和参数并不完全相同。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、图 4、图 5、图 6、图 7、图 8、图 9、图 10
查看本篇 9 个原文证据入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 3 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 4 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 5 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 5 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 5 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 6 页,Figure 10
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 一个二进制测试的方差,只是信息量的第一道门槛
- 在叙事内加入可复算教学例,并明确:浮点梯度描述和二进制测试;二进制特征可用于地点检索;ORB作为后作前端核心模块
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、图 4、图 5、图 6、图 7、图 8、图 9、图 10
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- dev.ipol.im · 所列章节
第4节steered BRIEF、均值方差相关性和图2方向噪声实验。
- dev.ipol.im · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 048-sift · 平行方法
浮点梯度描述和二进制测试
- 066-dbow · 模块组合
二进制特征可用于地点检索
- 082-orbslam · 模块组合
ORB作为后作前端核心模块
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典STOMP: Stochastic Trajectory Optimization for Motion Planning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:只能评价轨迹而难求梯度时怎样继续局部改进
- 二、生成时间相关扰动,再按代价加权更新
- 三、执行随机试探,用平滑噪声检查整段运动
- 四、读代价选择与机器人轨迹实验
- 五、检查候选评价开销与局部最优
- 六、追问:比较不同采样扰动时,为什么应固定候选评价次数而不只固定迭代轮数?
- 七、比较逐次凸化的局部优化路线
- 八、自测与参考答案
段落怎样重新安排
- 二、背景与问题定义 → 一、问题设定:只能评价轨迹而难求梯度时怎样继续局部改进
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:从独立抖动到有结构的试探 → 三、执行随机试探,用平滑噪声检查整段运动
把求解机制与每步执行顺序分开检验
- 三、方法:从独立抖动到有结构的试探 → 二、生成时间相关扰动,再按代价加权更新
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验怎样验证 → 四、读代价选择与机器人轨迹实验
把可视证据与实验条件/证据局限放在同一节
- 四、实验怎样验证 → 四、读代价选择与机器人轨迹实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、结果与证据强度 → 四、读代价选择与机器人轨迹实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、检查候选评价开销与局部最优
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、建立直觉 → 三、执行随机试探,用平滑噪声检查整段运动
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:只能评价轨迹而难求梯度时怎样继续局部改进
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、生成时间相关扰动,再按代价加权更新
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、读代价选择与机器人轨迹实验
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:比较不同采样扰动时,为什么应固定候选评价次数而不只固定迭代轮数?:比较不同采样扰动时,为什么应固定候选评价次数而不只固定迭代轮数?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:4 幅
- Fig. 5:左图是多次运行的平均成本与一个标准差,右图比较有无力矩优化时各关节绝对力矩之和
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 6 页;裁切框为原页比例 (0.08, 0.06, 0.5, 0.193)
左图是多次运行的平均成本与一个标准差,右图比较有无力矩优化时各关节绝对力矩之和。均值下降不代表每次随机更新都下降,力矩指标减少也不直接等于电池能耗同幅度减少。
- 原论文图3:STOMP机械臂绕开不同障碍的三组轨迹渲染
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 4
三个场景的可行轨迹展示任务差异,不能将图像本身当成成功率统计。
- 原论文图4:STOMP机械臂在约束任务中的三组运动轨迹
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 5
并排姿态显示约束场景下的整条运动,需结合正文给定任务读图。
- STOMP图5的轨迹成本和关节力矩完整双面板
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 6
左图是十次运行的平均成本及标准差,右图是有无力矩优化的时间曲线;面板标记现已完整保留。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、图 5、图 3、图 4、图 2
查看本篇 6 个原文证据入口
- 表 I · PDF 第 3 页,Table I
原站图表/证明入口
- 表 II · PDF 第 5 页,Table II
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 随机扰动为什么必须带时间相关性
- 在叙事内加入可复算教学例,并明确:本篇针对解析代价梯度要求作改进;随机扰动与动态局部二次近似
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、图 5、图 3、图 4、图 2
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- whiteoak.umd.edu · 所列章节
第III节差分平滑矩阵、随机扰动与指数代价权重。
- whiteoak.umd.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 059-chomp · 历史背景
本篇针对解析代价梯度要求作改进
- 051-id-iLQR · 平行方法
随机扰动与动态局部二次近似
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Sampling-Based Algorithms for Optimal Motion Planning部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:新采样怎样修复随机树中早先形成的绕路
- 二、在邻域选父并重连,核对连接尺度条件
- 三、更新累计代价,用旧邻居换父验算
- 四、分开比较首解、长期代价与计算预算
- 五、保留渐近条件和有限时间限制
- 六、追问:重连后只改父指针而不更新受影响的累计代价,会损坏哪一步判断?
- 七、集中采样,再优先验证候选连接
- 八、自测与参考答案
段落怎样重新安排
- 二、问题与假设 → 一、问题设定:新采样怎样修复随机树中早先形成的绕路
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、算法到底改了什么 → 三、更新累计代价,用旧邻居换父验算
把求解机制与每步执行顺序分开检验
- 三、算法到底改了什么 → 二、在邻域选父并重连,核对连接尺度条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何检验 → 四、分开比较首解、长期代价与计算预算
把可视证据与实验条件/证据局限放在同一节
- 四、实验如何检验 → 四、分开比较首解、长期代价与计算预算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、挑选四组关键证据 → 四、分开比较首解、长期代价与计算预算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献与适用边界 → 五、保留渐近条件和有限时间限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、建立直觉 → 三、更新累计代价,用旧邻居换父验算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:新采样怎样修复随机树中早先形成的绕路
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、在邻域选父并重连,核对连接尺度条件
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、在邻域选父并重连,核对连接尺度条件
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:重连后只改父指针而不更新受影响的累计代价,会损坏哪一步判断?:重连后只改父指针而不更新受影响的累计代价,会损坏哪一步判断?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:13 幅
- Fig. 13:上图是 500 次运行的平均最好路径代价,下图是方差,横轴均为迭代次数
实验/结果图 · 必要原图摘引 · Fig. 13,PDF 第 38 页;裁切框为原页比例 (0.265, 0.105, 0.765, 0.505)
上图是 500 次运行的平均最好路径代价,下图是方差,横轴均为迭代次数。蓝色 RRT* 继续趋近黑色最优参考,红色 RRT 的平台说明可行路径扩展与渐近最优是两回事。
- 原论文图10:不同近邻数sPRM与PRM*的最优路径代价随迭代次数变化
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 35
横轴为对数刻度;固定近邻数曲线的停滞与PRM*逐渐改善是不同现象。
- 原论文图11:二维至五维自由空间中PRM*路径代价的四个面板
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 36
维数和采样数量须一起考虑,不能把不同面板视为相同难度的重复试验。
- 原论文图12:无障碍环境中RRT与RRT*的多阶段树和路径比较
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 37
按面板顺序追踪最优路径变化;密集分支并不自动意味着路径更优。
- 原论文图14:障碍环境中RRT和RRT*最终树结构与红色路径
实验/结果图 · 必要原图摘引 · Fig. 14, PDF page 39
相同几何场景下,红线表示返回路径,而绿色和蓝色线条表示探索结构。
- 原论文图15:障碍环境中RRT*从500至20000次迭代的六个阶段
实验/结果图 · 必要原图摘引 · Fig. 15, PDF page 40
树继续增密的同时,重连可使红色路径绕障形状逐步变化。
- 原论文图16:障碍环境中RRT与RRT*路径代价均值及方差随迭代变化
实验/结果图 · 必要原图摘引 · Fig. 16, PDF page 41
上下两幅分别展示代价与波动,不能只看均值而忽略随机性。
- 原论文图17:含不同区域代价的环境中RRT*最终树和红色最优路径
实验/结果图 · 必要原图摘引 · Fig. 17, PDF page 42
黄色区域改变穿行代价;几何最短与加权代价最小因此不是同一个目标。
- 原论文图18:无障碍环境中RRT*与RRT计算耗时比随迭代变化
实验/结果图 · 必要原图摘引 · Fig. 18, PDF page 42
纵轴是两个实现的耗时比,不是某一算法的绝对运行时间。
- 原论文图19:障碍环境中RRT*与RRT计算耗时比随迭代变化
实验/结果图 · 必要原图摘引 · Fig. 19, PDF page 43
把这张曲线与其障碍设置一起读,不能移用成所有环境的固定倍率。
- 原论文图20:代价区域示例中RRT与RRT*最优路径代价和方差
实验/结果图 · 必要原图摘引 · Fig. 20, PDF page 44
算法比较保留同一代价定义;蓝色曲线的下降不是单纯几何长度的变化。
- 原论文图21:不同代价区域设置中RRT与RRT*的运行时间比
实验/结果图 · 必要原图摘引 · Fig. 21, PDF page 45
代价改善的同时仍要检查计算成本,横轴是采样或迭代预算。
- 原论文图22:另一约束示例中RRT与RRT*路径代价及波动随采样变化
实验/结果图 · 必要原图摘引 · Fig. 22, PDF page 46
上下两幅应结合阅读,有限预算下的趋势并不等于已经达到极限最优。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 10、图 11、图 12、图 13、图 14、图 15、图 16、图 17、图 18、图 19、图 20、图 21、图 22
查看本篇 13 个原文证据入口
- 图 10 · PDF 第 35 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 36 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 37 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 38 页,Figure 13
原站图表/证明入口
- 图 14 · PDF 第 39 页,Figure 14
原站图表/证明入口
- 图 15 · PDF 第 40 页,Figure 15
原站图表/证明入口
- 图 16 · PDF 第 41 页,Figure 16
原站图表/证明入口
- 图 17 · PDF 第 42 页,Figure 17
原站图表/证明入口
- 图 18 · PDF 第 42 页,Figure 18
原站图表/证明入口
- 图 19 · PDF 第 43 页,Figure 19
原站图表/证明入口
- 图 20 · PDF 第 44 页,Figure 20
原站图表/证明入口
- 图 21 · PDF 第 45 页,Figure 21
原站图表/证明入口
- 图 22 · PDF 第 46 页,Figure 22
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 重接改变的是代价到达方式,不是点本身的位置
- 在叙事内加入可复算教学例,并明确:本篇增加选父及重接;论文同时提出PRM*最优邻域条件;后作聚焦可改善子集
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 10、图 11、图 12、图 13、图 14、图 15、图 16、图 17、图 18、图 19、图 20、图 21、图 22
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
采样图连通条件、RRT/PRM比较及渐近理论;重接数字例为原创。
- arxiv.org · 摘要
后续原始研究指出RRT*原证明逻辑缺口,并提出考虑时间顺序的充分半径尺度。
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 040-rrt · 直接继承
本篇增加选父及重接
- 035-prm · 直接继承
本篇承接前作:论文同时提出PRM*最优邻域条件
- 079-informed-rrtstar · 直接继承
后作聚焦可改善子集
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
- 后续理论修订仅核读摘要,未重做证明或断言该理论问题的全部最新状态。
机器人经典g2o: A General Framework for Graph Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:不同估计任务怎样复用稀疏非线性求解基础设施
- 二、分离变量更新、残差与块矩阵求解
- 三、装配并求解线性化系统,用小图检查信息矩阵
- 四、对照计算预算、求解器和数据集条件
- 五、区分框架效率、建模正确性与全局最优
- 六、追问:因子和测量都没变,为什么重新给一组初值仍要重建线性方程?
- 七、把通用求解器接入系统与增量估计
- 八、自测与参考答案
段落怎样重新安排
- 二、背景:图究竟表示什么 → 一、问题设定:不同估计任务怎样复用稀疏非线性求解基础设施
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:沿用成熟数学,组织高效实现 → 三、装配并求解线性化系统,用小图检查信息矩阵
把求解机制与每步执行顺序分开检验
- 三、方法:沿用成熟数学,组织高效实现 → 二、分离变量更新、残差与块矩阵求解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设计与公平性 → 四、对照计算预算、求解器和数据集条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、四组关键结果 → 四、对照计算预算、求解器和数据集条件
把可视证据与实验条件/证据局限放在同一节
- 五、四组关键结果 → 四、对照计算预算、求解器和数据集条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、局限与复现障碍 → 五、区分框架效率、建模正确性与全局最优
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、建立直觉 → 三、装配并求解线性化系统,用小图检查信息矩阵
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:不同估计任务怎样复用稀疏非线性求解基础设施
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、分离变量更新、残差与块矩阵求解
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、分离变量更新、残差与块矩阵求解
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、分离变量更新、残差与块矩阵求解 / 四组关键结果 → 四、对照计算预算、求解器和数据集条件
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:因子和测量都没变,为什么重新给一组初值仍要重建线性方程?:因子和测量都没变,为什么重新给一组初值仍要重建线性方程?
教法来源与实际阅读范围
- Frank Dellaert · Factor Graphs and GTSAM
§1后验分解、§2.1–2.5三位姿图/噪声/初值/优化与协方差近似
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:3 幅
- Fig. 9:两种图上比较不同旋转参数化的目标下降,横轴为迭代数
实验/结果图 · 必要原图摘引 · Fig. 9,PDF 第 6 页;裁切框为原页比例 (0.53, 0.185, 0.9, 0.29)
两种图上比较不同旋转参数化的目标下降,横轴为迭代数。更少迭代不一定意味着相同比例的实际加速,还要看残差构建、线性求解与参数更新成本。
- 原论文图3:g2o由误差和雅可比到线性结构、求解器和状态更新的流程
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 4
线性结构与求解器分别可选,系统效率不能仅归于一种线性求解方法。
- 原论文图7:g2o与多个专用方法在不同数据集上的每迭代耗时柱状图
实验/结果图 · 必要原图摘引 · Fig. 7, PDF page 5
纵轴为对数时间刻度;每轮更快与达到相同精度所需总时间要分开比较。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 7、表 II、表 III、表 I、图 9
查看本篇 6 个原文证据入口
- 图 3 · PDF 第 4 页,Figure 3
原站图表/证明入口
- 图 7 · PDF 第 5 页,Figure 7
原站图表/证明入口
- 表 II · PDF 第 6 页,Table II
原站图表/证明入口
- 表 III · PDF 第 7 页,Table III
原站图表/证明入口
- 表 I · PDF 第 5 页,Table I
原站图表/证明入口
- 图 9 · PDF 第 6 页,Figure 9
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 信息矩阵的一个权重,就是一种噪声承诺
- 在叙事内加入可复算教学例,并明确:通用实现承载图SLAM最小二乘;批式通用优化与增量分解;后作采用图优化后端模块
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 7、表 II、表 III、表 I、图 9
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- mengwenhe-cmu.github.io · 所列章节
第III节参数块、误差、信息矩阵和Gauss–Newton线性化。
- mengwenhe-cmu.github.io · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 053-graphslam · 模块组合
通用实现承载图SLAM最小二乘
- 057-isam · 平行方法
批式通用优化与增量分解
- 082-orbslam · 模块组合
后作采用图优化后端模块
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典KinectFusion: Real-Time Dense Surface Mapping and Tracking部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:噪声深度怎样变成下一帧也能使用的表面模型
- 二、把跟踪、TSDF融合与模型预测接成循环
- 三、执行深度到模型配准,检查融合反馈
- 四、读表面和轨迹证据,区分图像外观与位姿误差
- 五、检查体积内存、几何退化与长期漂移
- 六、追问:暂时跟踪错误后继续融合,为什么不能只把它当一帧位姿噪声?
- 七、修复稠密地图,并引入外部轨迹评价
- 八、自测与参考答案
段落怎样重新安排
- 二、背景与问题定义 → 一、问题设定:噪声深度怎样变成下一帧也能使用的表面模型
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:四个组件形成循环 → 三、执行深度到模型配准,检查融合反馈
把求解机制与每步执行顺序分开检验
- 三、方法:四个组件形成循环 → 二、把跟踪、TSDF融合与模型预测接成循环
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验怎样验证 → 四、读表面和轨迹证据,区分图像外观与位姿误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五组图能证明什么 → 四、读表面和轨迹证据,区分图像外观与位姿误差
把可视证据与实验条件/证据局限放在同一节
- 五、五组图能证明什么 → 四、读表面和轨迹证据,区分图像外观与位姿误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、检查体积内存、几何退化与长期漂移
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、建立直觉 → 三、执行深度到模型配准,检查融合反馈
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:噪声深度怎样变成下一帧也能使用的表面模型
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把跟踪、TSDF融合与模型预测接成循环
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把跟踪、TSDF融合与模型预测接成循环
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、把跟踪、TSDF融合与模型预测接成循环 / 五组图能证明什么 → 四、读表面和轨迹证据,区分图像外观与位姿误差
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:暂时跟踪错误后继续融合,为什么不能只把它当一帧位姿噪声?:暂时跟踪错误后继续融合,为什么不能只把它当一帧位姿噪声?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:6 幅
- Fig. 13:堆叠面积把不同系统阶段的耗时分开,横轴增加体积网格分辨率
实验/结果图 · 必要原图摘引 · Fig. 13,PDF 第 9 页;裁切框为原页比例 (0.51, 0.266, 0.925, 0.394)
堆叠面积把不同系统阶段的耗时分开,横轴增加体积网格分辨率。看清哪一部分增长,才能把实时性结论绑定到所用 GPU、分辨率和处理范围。
- 原论文图8:KinectFusion逐帧跟踪、部分回环、全回环及重复回环重建比较
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 8
上排轨迹和下排表面重建共同显示累计漂移怎样随跟踪方式改变。
- 原论文图9:KinectFusion渲染的带球体、鞋和物体的测试场景
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 8
这张图给出测试几何,不是传感器在真实环境中的误差统计。
- 原论文图10:KinectFusion不同模型融合次数下的相机位姿示意
方法/设定图 · 必要原图摘引 · Fig. 10, PDF page 9
三幅使用不同的融合设置,不能把模型的重复使用等同于新增独立观测。
- 原论文图11:逐帧跟踪与逐模型跟踪的相机回环轨迹和重建比较
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 9
左右相同视角便于比较漂移;上下面板则给出俯视与侧视的几何差异。
- 原论文图12:KinectFusion绕物体一周的相机轨迹及相应表面模型
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 9
轨迹闭合与局部表面完整性是两种指标,不应只凭其中一张图宣称全面准确。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 13、图 8、图 9、图 11、图 12、图 1
查看本篇 6 个原文证据入口
- 图 13 · PDF 第 9 页,Figure 13
原站图表/证明入口
- 图 8 · PDF 第 8 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 8 页,Figure 9
原站图表/证明入口
- 图 11 · PDF 第 9 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 9 页,Figure 12
原站图表/证明入口
- 图 1 · PDF 第 1 页,Figure 1
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 融合是降噪还是把错误固化,取决于配准
- 在叙事内加入可复算教学例,并明确:ICP跟踪与融合模型反馈组合;后作改用surfel并加入长程一致性
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 13、图 8、图 9、图 11、图 12、图 1
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.microsoft.com · 所列章节
第4节投影TSDF、未知区域、截断和加权融合。
- www.microsoft.com · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 028-icp · 模块组合
ICP跟踪与融合模型反馈组合
- 084-elasticfusion · 历史背景
后作改用surfel并加入长程一致性
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Minimum Snap Trajectory Generation and Control for Quadrotors部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:穿过航点的四旋翼轨迹怎样同时照顾姿态和输入
- 二、用微分平坦性连接位置导数与minimum-snap目标
- 三、求分段多项式,检查时间分配与连接条件
- 四、读静态圆环和抛出圆环飞行实验
- 五、保留执行能力、连续安全与模型误差
- 六、追问:若两段路径形状固定,总时长应该怎样分给两段才降低snap代价?
- 七、把几何轨迹与时间安排分开求解
- 八、自测与参考答案
段落怎样重新安排
- 二、研究背景与问题定义 → 一、问题设定:穿过航点的四旋翼轨迹怎样同时照顾姿态和输入
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:到底优化什么 → 三、求分段多项式,检查时间分配与连接条件
把求解机制与每步执行顺序分开检验
- 三、方法:到底优化什么 → 二、用微分平坦性连接位置导数与minimum-snap目标
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设置 → 四、读静态圆环和抛出圆环飞行实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、四组关键证据 → 四、读静态圆环和抛出圆环飞行实验
把可视证据与实验条件/证据局限放在同一节
- 五、四组关键证据 → 四、读静态圆环和抛出圆环飞行实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献与局限 → 五、保留执行能力、连续安全与模型误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、建立直觉 → 三、求分段多项式,检查时间分配与连接条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:穿过航点的四旋翼轨迹怎样同时照顾姿态和输入
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用微分平坦性连接位置导数与minimum-snap目标
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用微分平坦性连接位置导数与minimum-snap目标
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:若两段路径形状固定,总时长应该怎样分给两段才降低snap代价?:若两段路径形状固定,总时长应该怎样分给两段才降低snap代价?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 9.4 Time-Optimal Time Scaling
路径参数s及其导数、代入动力学后m(s)sddot+c(s)sdot²+g(s)
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 6:左侧是同一轨迹的不同空间投影,右侧上下比较不同运动时间的跟踪误差
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 6 页;裁切框为原页比例 (0.105, 0.23, 0.465, 0.395)
左侧是同一轨迹的不同空间投影,右侧上下比较不同运动时间的跟踪误差。更短运动时间会放大执行困难,几何路径相似不表示动态跟踪同样精确。
- 原论文图2:最小snap穿越四个航点的两种路径约束示例
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 5
左图只规定航点,右图额外限制中间通道;约束改变了整条曲线形状。
- 原论文图3:迭代分配时间后的路径和总目标值
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 5
右图按迭代次数记录目标变化,不能把该次数当作飞行时间。
- 原论文图4:四旋翼位置跟踪误差和期望、实测速度曲线
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 5
位置误差与速度响应分两幅给出,需按各自单位读数。
- 原论文图5:四旋翼沿规划路径飞行的叠加照片
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 6
重叠机身显示同一次运动的连续姿态,不能据此读出多次重复试验成功率。
- 原论文图7:四旋翼穿越圆环的叠加飞行照片
实验/结果图 · 必要原图摘引 · Fig. 7, PDF page 6
圆环给出了场景约束;照片是该次实机穿越展示。
- 四旋翼轨迹及8秒和4秒飞行的误差四面板
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 6
右侧两个时间设置的误差幅度不同,比较时需要同时读取飞行周期标签;左侧给出了同一空间轨迹的两个投影。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 6、图 2、图 3、图 4
查看本篇 4 个原文证据入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 2 · PDF 第 5 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 5 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 多给一倍时间,为什么snap代价会降128倍
- 在叙事内加入可复算教学例,并明确:不同对象与平滑代价的轨迹优化;固定形状时间缩放与路径时间参数化对照
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 6、图 2、图 3、图 4
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- xplorestaging.ieee.org · 摘要
IEEE检索返回的原摘要及引言,确认走廊约束、非线性控制与快速穿越设置。
- raw.githubusercontent.com · 所列章节
下载原稿补读第II–VI节文字:平坦性、稳定性假设限制、时间缩放、走廊离散约束与Vicon穿环实验数字。
- raw.githubusercontent.com · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 059-chomp · 平行方法
不同对象与平滑代价的轨迹优化
- 093-toppra · 教学联系
固定形状时间缩放与路径时间参数化对照
仍需留意
- 已补核关键实验正文0.9秒、3.6米/秒、60度及快慢轨迹;未逐像素核查全部曲线或复现飞行。
机器人经典Bags of Binary Words for Fast Place Recognition in Image Sequences部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:历史图像怎样快速筛出可信闭环候选
- 二、量化二进制视觉词,再做时间与几何验证
- 三、执行检索和验证,用相似走廊检查误报
- 四、同时报告召回、误报与单帧耗时
- 五、区分有限序列零误报与未来可靠性
- 六、追问:提高几何验证阈值后零误报保持不变,为什么仍不能说检测器没有退步?
- 七、将检索候选变成几何回环
- 八、自测与参考答案
段落怎样重新安排
- 二、背景与问题定义 → 一、问题设定:历史图像怎样快速筛出可信闭环候选
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:从二进制字符串到闭环 → 三、执行检索和验证,用相似走廊检查误报
把求解机制与每步执行顺序分开检验
- 三、方法:从二进制字符串到闭环 → 二、量化二进制视觉词,再做时间与几何验证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设计与公平性 → 四、同时报告召回、误报与单帧耗时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五处证据怎样读 → 四、同时报告召回、误报与单帧耗时
把可视证据与实验条件/证据局限放在同一节
- 五、五处证据怎样读 → 四、同时报告召回、误报与单帧耗时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、区分有限序列零误报与未来可靠性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、建立自己的理解 → 三、执行检索和验证,用相似走廊检查误报
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:历史图像怎样快速筛出可信闭环候选
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、量化二进制视觉词,再做时间与几何验证
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、量化二进制视觉词,再做时间与几何验证
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:提高几何验证阈值后零误报保持不变,为什么仍不能说检测器没有退步?:提高几何验证阈值后零误报保持不变,为什么仍不能说检测器没有退步?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 4:这是未做几何验证的精确率—召回率曲线,同时改变连续匹配数 k 和处理频率 f
实验/结果图 · 必要原图摘引 · Fig. 4,PDF 第 5 页;裁切框为原页比例 (0.51, 0.47, 0.895, 0.633)
这是未做几何验证的精确率—召回率曲线,同时改变连续匹配数 k 和处理频率 f。更严格的时间一致性可能过滤错配,也可能漏掉短暂重访;不能把所有曲线差异只归于一个参数。
- 原论文图2:BRIEF、SURF64及U-SURF128的精确率召回率曲线
实验/结果图 · 必要原图摘引 · Fig. 2, PDF page 4
同一描述子在不同数据集上的曲线不同,比较时不能混用两组曲线的最好点。
- 原论文图3:回环候选影像中的匹配连线及错误对应示例
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 5
蓝色连线是对应关系,仍需几何检验才能成为可靠回环。
- 原论文图5:NewCollege逐图查询中总耗时和各模块耗时曲线
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 6
横轴是图像序号,尖峰展示单次查询波动;不能只报告平均耗时。
未在正文展示的图/表与范围
- 表II:Source-linked table, tracked separately; not counted as a missing Figure.
- 表VI:Source-linked table, tracked separately; not counted as a missing Figure.
- 表III:Source-linked table, tracked separately; not counted as a missing Figure.
- 表V:Source-linked table, tracked separately; not counted as a missing Figure.
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 III、图 2、图 3、图 4、表 II、图 5、表 V
查看本篇 7 个原文证据入口
- 表 III · PDF 第 6 页,Table III
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 5 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 表 II · PDF 第 6 页,Table II
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 表 V · PDF 第 7 页,Table V
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 词袋相似只提供候选,几何一致才提供约束
- 手算L1检索分数,并复核双索引、计时表与基线公平性
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 III、图 2、图 3、图 4、表 II、图 5、表 V
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- doriangalvez.com · 未能读取
2012原论文入口;本轮PDF直读失败,接口说明仅以官方代码核验。
- github.com · 所列章节
官方README的层次词汇树、倒排/直接文件和描述子接口。
- gaoyichao.com · 所列章节
下载九页原稿补读IV–VI节、表II–VI:双索引、几何与时序验证、21.60/51.68毫秒计时、CityCentre反例及基线频率差异。
- gaoyichao.com · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 060-orb · 模块组合
二进制描述子输入词袋
- 082-orbslam · 模块组合
后作将词袋用于回环与重定位候选
仍需留意
- 作者站PDF仍无法直取,已用现有存档补核方法和关键表;未重新运行系统或独立核查全部数据标注。
机器人经典The Open Motion Planning Library部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:规划器比较怎样避免混入碰撞和状态实现差异
- 二、按状态空间、有效性、目标和规划器划分接口
- 三、组装规划问题,再固定预算运行基准
- 四、读几何、动力学与ROS集成案例
- 五、保留应用模型责任和实验可比性
- 六、追问:两个规划器使用同一OMPL接口,为什么仍需核对运动有效性检查分辨率?
- 七、组合具体规划器与通信框架
- 八、自测与参考答案
段落怎样重新安排
- 二、研究背景与问题定义 → 一、问题设定:规划器比较怎样避免混入碰撞和状态实现差异
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:软件架构到底改了什么 → 二、按状态空间、有效性、目标和规划器划分接口
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、论文怎样验证设计 → 四、读几何、动力学与ROS集成案例
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五处证据应该怎样读 → 四、读几何、动力学与ROS集成案例
把可视证据与实验条件/证据局限放在同一节
- 五、五处证据应该怎样读 → 四、读几何、动力学与ROS集成案例
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留应用模型责任和实验可比性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、帮助建立理解 → 三、组装规划问题,再固定预算运行基准
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:规划器比较怎样避免混入碰撞和状态实现差异
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、按状态空间、有效性、目标和规划器划分接口
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、按状态空间、有效性、目标和规划器划分接口
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、按状态空间、有效性、目标和规划器划分接口 / 论文怎样验证设计 → 四、读几何、动力学与ROS集成案例
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
- 一、先用一分钟讲明白 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:两个规划器使用同一OMPL接口,为什么仍需核对运动有效性检查分辨率?:两个规划器使用同一OMPL接口,为什么仍需核对运动有效性检查分辨率?
教法来源与实际阅读范围
- OMPL项目作者团队 · How to Benchmark Planners
预算和重复次数示例;输出指标、严格有效性检查、progress properties与默认参数结果的警告
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 4:GUI 把机器人模型、规划参数和路径可视化并置,展示库如何接入真实几何场景
方法/设定图 · 必要原图摘引 · Fig. 4,PDF 第 8 页;裁切框为原页比例 (0.075, 0.05, 0.49, 0.266)
GUI 把机器人模型、规划参数和路径可视化并置,展示库如何接入真实几何场景。界面里能显示路径,不代表任意碰撞模型、距离函数或一秒预算都具有同样保证。
- 原论文图2:OMPL状态空间、采样、有效性、目标与规划器的接口关系
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 4
颜色和箭头区分用户配置的对象与库实现的抽象接口。
- 原论文图5:OMPL通过ROS接口为PR2双臂构造规划问题的场景
方法/设定图 · 必要原图摘引 · Fig. 5, PDF page 9
模型、关节组和碰撞场景仍是必要输入,统一接口并不免除这些设定。
- OMPL原论文图3:用SE(3)状态空间、有效性回调和SimpleSetup求解的完整Python示例
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 7
最后的solve(1.0)只给本示例一秒期限,不承诺任意机器人场景在一秒内求解成功。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。;本篇侧重理论、教程或软件接口,所选图用于其核心几何/系统论证;未将示意图归类为定量实验。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、图 4、图 5
查看本篇 4 个原文证据入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 7 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 8 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 9 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 相同接口不等于相同问题,比较前先锁定可行性检查
- 在叙事内加入可复算教学例,并明确:库提供规划器实现;库提供规划器实现;库提供最优规划器实现;原文明确集成通信及机器人软件栈
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、图 4、图 5
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- kavrakilab.org · 所列章节
第II节采样规划共同组件、Benchmark框和ROS集成。
- kavrakilab.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 035-prm · 模块组合
库提供规划器实现
- 043-rrt-connect · 模块组合
库提供规划器实现
- 062-rrtstar · 模块组合
库提供最优规划器实现
- 058-ros · 模块组合
原文明确集成通信及机器人软件栈
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典iSAM2: Incremental Smoothing and Mapping Using the Bayes Tree部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:新增约束怎样只重建受影响的稀疏估计结构
- 二、以Bayes tree管理消元与流动重线性化
- 三、编辑受影响子树,再按阈值回代
- 四、比较精度、更新成本与大回环峰值
- 五、检查近似阈值和非线性收敛条件
- 六、追问:把重线性化阈值调大后速度提高,应怎样确认付出的精度代价?
- 七、让高频测量与增量后端配合
- 八、自测与参考答案
段落怎样重新安排
- 二、研究背景与问题定义 → 一、问题设定:新增约束怎样只重建受影响的稀疏估计结构
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:到底改了什么 → 二、以Bayes tree管理消元与流动重线性化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何验证方法 → 四、比较精度、更新成本与大回环峰值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、结果:证据到底有多强 → 四、比较精度、更新成本与大回环峰值
把可视证据与实验条件/证据局限放在同一节
- 五、结果:证据到底有多强 → 四、比较精度、更新成本与大回环峰值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、检查近似阈值和非线性收敛条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、帮助建立理解 → 三、编辑受影响子树,再按阈值回代
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:新增约束怎样只重建受影响的稀疏估计结构
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、以Bayes tree管理消元与流动重线性化
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、以Bayes tree管理消元与流动重线性化
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:把重线性化阈值调大后速度提高,应怎样确认付出的精度代价?:把重线性化阈值调大后速度提高,应怎样确认付出的精度代价?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:13 幅
- Fig. 14(a):左侧每步耗时有明显尖峰,右侧累计时间反映总工作量
实验/结果图 · 必要原图摘引 · Fig. 14(a),PDF 第 14 页;裁切框为原页比例 (0.1, 0.08, 0.92, 0.245)
左侧每步耗时有明显尖峰,右侧累计时间反映总工作量。City20000 的这个对照提醒我们:平均可在线与最坏延迟可满足控制期限是不同要求,也不能预设 iSAM2 始终最快。
- 原论文图5:逐步加入约束时Bayes树中受影响团与未受影响子树
方法/设定图 · 必要原图摘引 · Fig. 5, PDF page 7
红色部分标出需重新消元的范围,灰色子树可被复用。
- 原论文图6:由Bayes树取出受影响部分、更新因子后重新接回子树
方法/设定图 · 必要原图摘引 · Fig. 6, PDF page 8
按四个阶段追踪同一组变量,子树保留的是其条件关系。
- 原论文图7:不同变量消元顺序对应的因子图与Bayes树
方法/设定图 · 必要原图摘引 · Fig. 7, PDF page 8
蓝色椭圆所示变量组合改变团结构,排序会影响后续更新工作量。
- 原论文图8:增量排序的地图示例、非零矩阵条目与受影响变量数
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 10
填充量与受影响变量计数是计算工作指标,不是独立定位真值误差。
- 原论文图9:重线性化阈值变化下的归一化目标差异与计算条目
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 11
较大的阈值可减少更新工作,但上图也需同时检查求解质量。
- 原论文图10:回代阈值变化下的目标差异与受影响变量数
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 11
两幅图把节省的工作和代价变化并列展示,不能只看速度一侧。
- 原论文图11:City20000、W10000、Intel和Killian Court四组测试地图
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 12
这些是不同结构和规模的数据集,不能把跨数据集耗时当成同难度比较。
- 原论文图12:Trees10000合成地标场景与Victoria Park实测轨迹
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 15
上图为合成结构、下图为真实场景,两种证据的来源不同。
- 原论文图13:Sphere2500与Torus10000优化前后的三维结构
实验/结果图 · 必要原图摘引 · Fig. 13, PDF page 13
左右的整齐程度对应优化前后几何,不能据此替代独立真值误差统计。
- 原论文图15:iSAM2计算时间在消元、重线性化、求解与重排序中的分配
实验/结果图 · 必要原图摘引 · Fig. 15, PDF page 15
扇区百分比说明该测量设置下的耗时构成,不是所有图问题的固定比例。
- 原论文图16:不同优化器相对充分优化参考解的归一化卡方差异
实验/结果图 · 必要原图摘引 · Fig. 16, PDF page 16
参考解是同一目标充分优化后的结果,不是外部动作捕捉真值。
- iSAM2所有数据集的逐步耗时和累计耗时八组面板
实验/结果图 · 必要原图摘引 · Fig. 14, PDF page 14
前两组同时给出每步和累计时间,其余六组比较累计时间;同一幅图覆盖不同规模和结构的数据集,不能只凭第一组代替全部比较。
未在正文展示的图/表与范围
- 表1:Source-linked table, tracked separately; not counted as a missing Figure.
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、图 5、图 6、图 8、图 9、图 10、图 14、图 16、图 11、图 12、图 13、图 15
查看本篇 12 个原文证据入口
- 表 1 · PDF 第 14 页,Table 1
原站图表/证明入口
- 图 5 · PDF 第 7 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 8 页,Figure 6
原站图表/证明入口
- 图 8 · PDF 第 10 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 11 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 11 页,Figure 10
原站图表/证明入口
- 图 14 · PDF 第 14 页,Figure 14
原站图表/证明入口
- 图 16 · PDF 第 16 页,Figure 16
原站图表/证明入口
- 图 11 · PDF 第 12 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 15 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 13 页,Figure 13
原站图表/证明入口
- 图 15 · PDF 第 15 页,Figure 15
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- “局部改树”不等于“只会改变局部位置”
- 在叙事内加入可复算教学例,并明确:本篇用Bayes tree发展增量分解;后作将预积分因子交增量后端;后作使用增量因子图优化
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、图 5、图 6、图 8、图 9、图 10、图 14、图 16、图 11、图 12、图 13、图 15
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cs.cmu.edu · 所列章节
Bayes tree新增因子影响路径、未影响子树重接与图5。
- www.cs.cmu.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 057-isam · 直接继承
本篇用Bayes tree发展增量分解
- 083-imu-preintegration · 模块组合
后作将预积分因子交增量后端
- 097-liosam · 模块组合
后作使用增量因子图优化
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典A Benchmark for the Evaluation of RGB-D SLAM Systems部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:同一RGB-D输入下怎样可信比较轨迹误差
- 二、组织标定、同步和动作捕捉真值
- 三、关联时间戳并固定ATE与RPE评测流程
- 四、读真值精度、轨迹图与评测工具验证
- 五、区分轨迹指标、地图可用性与场景覆盖
- 六、追问:固定RPE时间间隔和固定路程间隔,是否在问同一个漂移问题?
- 七、比较道路与飞行数据域的评价条件
- 八、自测与参考答案
段落怎样重新安排
- 二、研究背景与问题定义 → 一、问题设定:同一RGB-D输入下怎样可信比较轨迹误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:数据和指标到底改了什么 → 二、组织标定、同步和动作捕捉真值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何验证基准 → 四、读真值精度、轨迹图与评测工具验证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、结果:证据到底有多强 → 四、读真值精度、轨迹图与评测工具验证
把可视证据与实验条件/证据局限放在同一节
- 五、结果:证据到底有多强 → 四、读真值精度、轨迹图与评测工具验证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、区分轨迹指标、地图可用性与场景覆盖
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、帮助建立理解 → 三、关联时间戳并固定ATE与RPE评测流程
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:同一RGB-D输入下怎样可信比较轨迹误差
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、组织标定、同步和动作捕捉真值
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、组织标定、同步和动作捕捉真值
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、先用一分钟讲明白 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:固定RPE时间间隔和固定路程间隔,是否在问同一个漂移问题?:固定RPE时间间隔和固定路程间隔,是否在问同一个漂移问题?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:5 幅
- Fig. 6:时间轴上的尖峰暴露短时间相对位姿失配,不能被一个整程汇总均值抹平
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 6 页;裁切框为原页比例 (0.5, 0.057, 0.925, 0.197)
时间轴上的尖峰暴露短时间相对位姿失配,不能被一个整程汇总均值抹平。RBM 与 GICP 的漂移表现属于该序列,RPE 也不能直接替代全局对齐后的 ATE。
- 原论文图2:TUM RGB-D四类场景影像及各自相机轨迹
实验/结果图 · 必要原图摘引 · Fig. 2, PDF page 2
上排场景与下排轨迹成对对应,场景难度不只由轨迹长度决定。
- 原论文图4:深度测量与真实棋盘距离、深度误差标准差的关系
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 5
误差随距离增加而变化,不能把近距离标定精度当作所有量程的常数。
- 原论文图5:移动棋盘和时间偏移对应的重投影误差曲线
方法/设定图 · 必要原图摘引 · Fig. 5, PDF page 6
右图的最低点用于估计时间同步偏移,不是空间标定误差本身。
- 原论文图7:真值与估计轨迹、ATE与RPE关系的示例
方法/设定图 · 必要原图摘引 · Fig. 7, PDF page 7
ATE与RPE测量不同性质,即使两者在样例中相关,也不能互相替代。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 II、表 I、图 2、图 4、图 5、图 6、图 7、图 1
查看本篇 8 个原文证据入口
- 表 II · PDF 第 4 页,Table II
原站图表/证明入口
- 表 I · PDF 第 4 页,Table I
原站图表/证明入口
- 图 2 · PDF 第 2 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 7 页,Figure 7
原站图表/证明入口
- 图 1 · PDF 第 1 页,Figure 1
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 同一条轨迹,用不同对齐方法可以得出不同答案
- 在叙事内加入可复算教学例,并明确:RGB-D系统需要外部真值评估;室内RGB-D与室外驾驶基准;不同传感器运动域的评价
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 II、表 I、图 2、图 4、图 5、图 6、图 7、图 1
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- jsturm.de · 所列章节
第II节内部误差与外部真值区别、第V节深度尺度和四元数格式。
- cvg.cit.tum.de · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Are We Ready for Autonomous Driving? The KITTI Vision Benchmark Suite部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:道路视觉算法怎样在统一真实输入上暴露失效
- 二、构造车载标定、真值与分任务数据划分
- 三、固定任务指标和测试协议,检查训练测试隔离
- 四、读大位移、弱纹理与遮挡条件下的结果
- 五、保留真值覆盖、静态假设与闭环驾驶边界
- 六、追问:只比较所有像素的平均误差,怎样会掩盖道路任务的具体失效?
- 七、把道路基准用于里程计并对照飞行域
- 八、自测与参考答案
段落怎样重新安排
- 二、研究背景与问题定义 → 一、问题设定:道路视觉算法怎样在统一真实输入上暴露失效
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:基准如何被构造 → 四、读大位移、弱纹理与遮挡条件下的结果
把可视证据与实验条件/证据局限放在同一节
- 三、方法:基准如何被构造 → 二、构造车载标定、真值与分任务数据划分
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何验证方法 → 四、读大位移、弱纹理与遮挡条件下的结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、结果:证据到底有多强 → 四、读大位移、弱纹理与遮挡条件下的结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留真值覆盖、静态假设与闭环驾驶边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、帮助建立理解 → 三、固定任务指标和测试协议,检查训练测试隔离
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:道路视觉算法怎样在统一真实输入上暴露失效
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、构造车载标定、真值与分任务数据划分
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、构造车载标定、真值与分任务数据划分
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:只比较所有像素的平均误差,怎样会掩盖道路任务的具体失效?:只比较所有像素的平均误差,怎样会掩盖道路任务的具体失效?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 5:四个面板分别按子段长度和速度统计平移、旋转误差
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 6 页;裁切框为原页比例 (0.51, 0.3, 0.92, 0.515)
四个面板分别按子段长度和速度统计平移、旋转误差。先看单位,再比较不同速度区间;平移百分比与每米旋转角都不是某个时刻的绝对位置误差。
- 原论文图4:KITTI光流的较好与较坏场景和误差区域对照
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 5
把原始道路影像、流场与错误区域一起看,才能辨认弱纹理和大位移困难。
- 原论文图6:不同目标模型的精确率召回率与平均朝向相似性曲线
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 7
朝向相似性与检测精度是两个指标,纵轴含义不可混为准确率。
- KITTI里程计平移与旋转误差按轨迹长度和速度分组
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 6
上排按子轨迹长度平均,下排按速度区间平均,单位也不同;不能把不同横轴条件下的百分比与每米角度误差混合。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 5、表 2、表 1、图 4、图 6、表 3、图 3
查看本篇 7 个原文证据入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 表 2 · PDF 第 6 页,Table 2
原站图表/证明入口
- 表 1 · PDF 第 3 页,Table 1
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
- 表 3 · PDF 第 7 页,Table 3
原站图表/证明入口
- 图 3 · PDF 第 5 页,Figure 3
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 真值空白并不是零误差,也不是任意位置都被评分
- 在叙事内加入可复算教学例,并明确:运动关联用于GPS/IMU与激光外参;点云累计与传感器标定;不同域的基准;后作在驾驶数据中评价里程计
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 5、表 2、表 1、图 4、图 6、表 3、图 3
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.cvlibs.net · 所列章节
第2.2–2.3节手眼/ICP标定、稀疏真值及歧义区域处理。
- www.cvlibs.net · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 024-hand-eye · 模块组合
运动关联用于GPS/IMU与激光外参
- 028-icp · 模块组合
点云累计与传感器标定
- 069-tum-rgbd · 平行方法
不同域的基准
- 077-loam · 历史背景
后作在驾驶数据中评价里程计
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典MuJoCo: A Physics Engine for Model-Based Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:控制优化怎样反复调用可计算的接触动力学
- 二、从广义坐标动力学转到接触空间求解
- 三、选择求解与逆动力学接口,检查速度精度取舍
- 四、按模型和调用预算读吞吐计时
- 五、区分数值可用性、真实接触与策略迁移
- 六、追问:在相同总时间内增加仿真调用次数,为什么仍需报告接触求解精度?
- 七、把接触求解交给外层动作优化
- 八、自测与参考答案
段落怎样重新安排
- 问题与建模设定 → 一、问题设定:控制优化怎样反复调用可计算的接触动力学
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:从关节动力学投影到接触空间 → 三、选择求解与逆动力学接口,检查速度精度取舍
把求解机制与每步执行顺序分开检验
- 方法:从关节动力学投影到接触空间 → 二、从广义坐标动力学转到接触空间求解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计 → 四、按模型和调用预算读吞吐计时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三组证据怎样阅读 → 四、按模型和调用预算读吞吐计时
把可视证据与实验条件/证据局限放在同一节
- 三组证据怎样阅读 → 四、按模型和调用预算读吞吐计时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与教学例子 → 五、区分数值可用性、真实接触与策略迁移
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:控制优化怎样反复调用可计算的接触动力学
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 四、按模型和调用预算读吞吐计时
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:在相同总时间内增加仿真调用次数,为什么仍需报告接触求解精度?:在相同总时间内增加仿真调用次数,为什么仍需报告接触求解精度?
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Planning and Control through Contact
混合系统modes/guards/resets,Direct shooting与接触时刻梯度、最小及浮动基坐标
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:3 幅
- Table 2:固定状态批量下对照线程数和接触数,观察总计算时间
实验/结果图 · 必要原图摘引 · Table 2,PDF 第 7 页;裁切框为原页比例 (0.515, 0.77, 0.93, 0.87)
固定状态批量下对照线程数和接触数,观察总计算时间。这里可并行的是大量独立动力学评估,不能用表内加速比预测一条串行控制轨迹的单步延迟。
- 原论文图2:MuJoCo接触示例及法向冲量、竖直速度曲线
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 4
右侧曲线以仿真时间为横轴,速度与冲量峰值不能当成求解耗时。
- 原论文图3:MuJoCo四种机器人或肌肉骨骼仿真模型
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 8
四面板展示建模范围;是否适合具体控制任务仍需检查接触与动力学设定。
未在正文展示的图/表与范围
- 表1:Source-linked table, tracked separately; not counted as a missing Figure.
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、表 2、图 2、图 3
查看本篇 4 个原文证据入口
- 表 1 · PDF 第 7 页,Table 1
原站图表/证明入口
- 表 2 · PDF 第 7 页,Table 2
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 8 页,Figure 3
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 接触空间有效质量把整台机构带进一个小方程
- 在叙事内加入可复算教学例,并明确:RNE用于偏置项;不同离散接触求解设计
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 1、表 2、图 2、图 3
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- roboti.us · 所列章节
第II节配置/速度维度、CRB/RNE、接触空间投影与SD/FAST比较范围。
- roboti.us · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 005-newton-euler · 模块组合
RNE用于偏置项
- 036-impulse-contact · 平行方法
不同离散接触求解设计
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Contact-Invariant Optimization for Hand Manipulation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:接触顺序未知时怎样同时寻找手部运动和作用点
- 二、用连续辅助变量连接接触活动与力
- 三、联合优化轨迹和接触,检查残差
- 四、读抓取、转动与画图的合成案例
- 五、保留软约束、手部简化与实际执行差距
- 六、追问:减小动作目标误差却增大物理约束残差,应怎样解释这条轨迹?
- 七、对照硬互补约束的接触规划
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题边界 → 一、问题设定:接触顺序未知时怎样同时寻找手部运动和作用点
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:给接触一个可优化的中间表示 → 三、联合优化轨迹和接触,检查残差
把求解机制与每步执行顺序分开检验
- 方法:给接触一个可优化的中间表示 → 二、用连续辅助变量连接接触活动与力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验如何验证 → 四、读抓取、转动与画图的合成案例
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 证据:自动化到了哪一步 → 四、读抓取、转动与画图的合成案例
把可视证据与实验条件/证据局限放在同一节
- 证据:自动化到了哪一步 → 四、读抓取、转动与画图的合成案例
把可视证据与实验条件/证据局限放在同一节
- 证据:自动化到了哪一步 → 四、读抓取、转动与画图的合成案例
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、限制与一个小例子 → 五、保留软约束、手部简化与实际执行差距
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:接触顺序未知时怎样同时寻找手部运动和作用点
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用连续辅助变量连接接触活动与力
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:减小动作目标误差却增大物理约束残差,应怎样解释这条轨迹?:减小动作目标误差却增大物理约束残差,应怎样解释这条轨迹?
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Planning and Control through Contact
混合系统modes/guards/resets,Direct shooting与接触时刻梯度、最小及浮动基坐标
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Fig. 2:左右对照接触活动变量与手、物体几何位置是否一致
方法/设定图 · 必要原图摘引 · Fig. 2,PDF 第 4 页;裁切框为原页比例 (0.5, 0.102, 0.875, 0.217)
左右对照接触活动变量与手、物体几何位置是否一致。把活动设为开启还不够,接触力与距离残差必须共同收敛;图中的可行姿态不是全部优化实例的成功率。
- Fig. 1:抓握、持笔绘图与双手操作等不同任务的合成结果
实验/结果图 · 必要原图摘引 · Fig. 1,PDF 第 1 页;原页比例裁切框 (0.12, 0.3, 0.86, 0.416)
这些是不同操作任务的合成结果选图,包括抓握、持笔绘图和双手操作,并非同一次运动的连续帧。动作看起来可行支持任务合成能力,但渲染姿态不能量化接触残差,更不能充当实机执行证据。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2
查看本篇 2 个原文证据入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 图 1 · PDF 第 1 页,Figure 1 操作合成结果
原图必要摘引,版权保留
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 连续接触变量提供优化通道,也引入“隔空受力”的检查责任
- 在叙事内加入可复算教学例,并明确:连续罚项接触与直接互补约束的区别
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 2
- 正文内嵌 2 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- roboti.us · 所列章节
第3–4节接触辅助变量、曲面作用点、软约束及联合力优化。
- roboti.us · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 075-contact-trajopt · 平行方法
连续罚项接触与直接互补约束的区别
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典Finding Locally Optimal, Collision-Free Trajectories with Sequential Convex Optimization部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:碰撞初始轨迹怎样经局部凸化变成可行路径
- 二、分开凸子问题、信赖域与外层惩罚
- 三、迭代求解并验证扫掠体,检查路点之间
- 四、读多初始化比较与计算预算
- 五、保留局部解、几何近似与原约束检查
- 六、追问:多初始化版本成功率更高,怎样避免把额外预算误算成单次求解器优势?
- 七、连接距离查询与连续时间轨迹表示
- 八、自测与参考答案
段落怎样重新安排
- 问题设定与最相关前作 → 一、问题设定:碰撞初始轨迹怎样经局部凸化变成可行路径
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:三层循环各管什么 → 三、迭代求解并验证扫掠体,检查路点之间
把求解机制与每步执行顺序分开检验
- 方法:三层循环各管什么 → 二、分开凸子问题、信赖域与外层惩罚
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 碰撞:位置安全不等于运动安全 → 二、分开凸子问题、信赖域与外层惩罚
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计 → 四、读多初始化比较与计算预算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 结果与证据强度 → 四、读多初始化比较与计算预算
把可视证据与实验条件/证据局限放在同一节
- 结果与证据强度 → 四、读多初始化比较与计算预算
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、限制与教学例子 → 五、保留局部解、几何近似与原约束检查
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:碰撞初始轨迹怎样经局部凸化变成可行路径
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、分开凸子问题、信赖域与外层惩罚
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:多初始化版本成功率更高,怎样避免把额外预算误算成单次求解器优势?:多初始化版本成功率更高,怎样避免把额外预算误算成单次求解器优势?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Tables I–II:上下分开看手臂与全身任务;每一类中再同时比较成功比例、时间和路径长度
实验/结果图 · 必要原图摘引 · Tables I–II,PDF 第 8 页;裁切框为原页比例 (0.065, 0.06, 0.86, 0.253)
上下分开看手臂与全身任务;每一类中再同时比较成功比例、时间和路径长度。多初始化改善成功率,但增加预算,高自由度结果不能沿用手臂的亚秒结论。
- 原论文图5:TrajOpt连续碰撞检测中的扫掠几何示意
方法/设定图 · 必要原图摘引 · Fig. 5, PDF page 6
中间姿态的扫掠体有助于检查两端都无碰撞但中途穿障的情况。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、图 5
查看本篇 3 个原文证据入口
- 表 I · PDF 第 8 页,Table I
原站图表/证明入口
- 表 II · PDF 第 8 页,Table II
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 不光滑罚项为什么仍能放进一个QP
- 在叙事内加入可复算教学例,并明确:协变梯度与逐次凸化;随机扰动与逐次凸化;几何距离查询支撑碰撞线性化
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、图 5
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- roboticsproceedings.org · 所列章节
第III节L1罚项、松弛变量、信赖域及算法1三层循环。
- roboticsproceedings.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 059-chomp · 平行方法
协变梯度与逐次凸化
- 061-stomp · 平行方法
随机扰动与逐次凸化
- 022-gilbert-distance · 模块组合
几何距离查询支撑碰撞线性化
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典OctoMap: An Efficient Probabilistic 3D Mapping Framework Based on Octrees部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:三维占据证据怎样兼顾未知空间与存储规模
- 二、用八叉树组织概率更新,区分三种压缩
- 三、逐射线更新并剪枝,检查不同尺度查询
- 四、读内存、精度和地图数据的比较
- 五、保留位姿依赖、概率损失与规划语义
- 六、追问:剪枝后再查询更细分辨率,能否恢复压缩前的全部占据概率?
- 七、把未知体积的处理交给具体规划任务
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:它是地图框架,不是完整 SLAM → 一、问题设定:三维占据证据怎样兼顾未知空间与存储规模
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法一:八叉树解决存储,不替代概率模型 → 二、用八叉树组织概率更新,区分三种压缩
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法二:把测量变成可累积证据 → 三、逐射线更新并剪枝,检查不同尺度查询
把求解机制与每步执行顺序分开检验
- 方法二:把测量变成可累积证据 → 二、用八叉树组织概率更新,区分三种压缩
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法三:三种“压缩”不能混为一谈 → 二、用八叉树组织概率更新,区分三种压缩
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计 → 四、读内存、精度和地图数据的比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 结果:证据支持哪些结论 → 四、读内存、精度和地图数据的比较
把可视证据与实验条件/证据局限放在同一节
- 结果:证据支持哪些结论 → 四、读内存、精度和地图数据的比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、局限与例子 → 五、保留位姿依赖、概率损失与规划语义
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:三维占据证据怎样兼顾未知空间与存储规模
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用八叉树组织概率更新,区分三种压缩
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
- 四、证据节内以“证据”命名的机制段 → 二、用八叉树组织概率更新,区分三种压缩
“观测证据”是推断算法的输入,不是实验结果;恢复先推导概率更新、再实现、最后看原文实验的依赖。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:剪枝后再查询更细分辨率,能否恢复压缩前的全部占据概率?:剪枝后再查询更细分辨率,能否恢复压缩前的全部占据概率?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Figs. 16–17:上图改变地图分辨率,看每个测量点的插入耗时;下图改变查询深度,看地图遍历成本
实验/结果图 · 必要原图摘引 · Figs. 16–17,PDF 第 14 页;两块原图按原上下顺序拼接,仅移除长图注;原页比例裁切框 [(0.49, 0.1, 0.915, 0.261), (0.49, 0.305, 0.915, 0.455)]
上图改变地图分辨率,看每个测量点的插入耗时;下图改变查询深度,看地图遍历成本。它们是不同操作,不能把单点插入耗时当作整次扫描的处理时间。
- 原论文图10:OctoMap射线更新在正常测量与异常回波下的差别
方法/设定图 · 必要原图摘引 · Fig. 10, PDF page 10
红色射线与表面位置共同决定哪些体素应更新为空闲或占据。
- 原论文图11:同一表面在连续表示与不同体素构建中的结构
方法/设定图 · 必要原图摘引 · Fig. 11, PDF page 10
离散分辨率改变边界形状,稠密外观不能直接说明概率校准。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 10、图 11、表 1、表 2、图 16、图 17、图 4、图 14
查看本篇 8 个原文证据入口
- 图 10 · PDF 第 10 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 10 页,Figure 11
原站图表/证明入口
- 表 1 · PDF 第 11 页,Table 1
原站图表/证明入口
- 表 2 · PDF 第 13 页,Table 2
原站图表/证明入口
- 图 16 · PDF 第 14 页,Figure 16
原站图表/证明入口
- 图 17 · PDF 第 14 页,Figure 17
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 14 · PDF 第 13 页,Figure 14
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 一条射线携带的是一串不同证据
- 在叙事内加入可复算教学例,并明确:概率占据融合扩展到三维八叉树;占据体积与表面距离场;地图作为运动合法性查询
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 10、图 11、表 1、表 2、图 16、图 17、图 4、图 14
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- courses.cs.washington.edu · 所列章节
第3.1–3.2节射线自由/未知状态、剪枝、概率和log-odds。
- courses.cs.washington.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 025-occupancy · 直接继承
本篇承接前作:概率占据融合扩展到三维八叉树
- 064-kinfu · 平行方法
占据体积与表面距离场
- 067-ompl · 模块组合
地图作为运动合法性查询
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典A Direct Method for Trajectory Optimization of Rigid Bodies Through Contact部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:状态控制与接触模式怎样在一个轨迹问题中共同决定
- 二、把接触力和互补约束加入离散动力学
- 三、联合求解候选接触,检查模式与力的一致性
- 四、读操作和步态案例中的接触顺序变化
- 五、保留非凸性、初始化与离散执行差距
- 六、追问:两次求解得到不同接触顺序而代价相近,应先比较哪些可行性证据?
- 七、比较软接触与全身一致性模型
- 八、自测与参考答案
段落怎样重新安排
- 二、研究背景与问题定义 → 一、问题设定:状态控制与接触模式怎样在一个轨迹问题中共同决定
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:把接触也纳入决策 → 三、联合求解候选接触,检查模式与力的一致性
把求解机制与每步执行顺序分开检验
- 三、方法:把接触也纳入决策 → 二、把接触力和互补约束加入离散动力学
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何验证 → 四、读操作和步态案例中的接触顺序变化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五处证据与读法 → 四、读操作和步态案例中的接触顺序变化
把可视证据与实验条件/证据局限放在同一节
- 五、五处证据与读法 → 四、读操作和步态案例中的接触顺序变化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留非凸性、初始化与离散执行差距
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自构例子与前置知识 → 三、联合求解候选接触,检查模式与力的一致性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:状态控制与接触模式怎样在一个轨迹问题中共同决定
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把接触力和互补约束加入离散动力学
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把接触力和互补约束加入离散动力学
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:两次求解得到不同接触顺序而代价相近,应先比较哪些可行性证据?:两次求解得到不同接触顺序而代价相近,应先比较哪些可行性证据?
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Planning and Control through Contact
混合系统modes/guards/resets,Direct shooting与接触时刻梯度、最小及浮动基坐标
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:8 幅
- Fig. 7:从左到右读 FastRunner 的周期运动,细线还表示弹簧与肌腱
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 16 页;裁切框为原页比例 (0.21, 0.153, 0.825, 0.26)
从左到右读 FastRunner 的周期运动,细线还表示弹簧与肌腱。它展示复杂模型上的优化轨迹,不是实机跑步录像帧,也不能由渲染姿态判断全部接触残差。
- 两连杆手指、被推动椭圆与关节角和间隙标注
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 12
红色两连杆必须先改变姿态建立接触,绿色椭圆才会运动;图中间隙变量对应互补约束的几何距离。
- 平面抓取器、球体和三处黑色接触点
方法/设定图 · 必要原图摘引 · Fig. 4, PDF page 13
黑点是候选接触位置,手指关节与球体都参与动力学;中间抓握约束仍由任务设计者给定。
- Spring Flamingo步行序列及优化前后质心高度随时间曲线
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 14
下图蓝线的质心高度变化较小,但上图脚部离地很低;这正对应成本下降与未显式约束足够抬脚高度的取舍。
- 左右脚接触模式随时间的优化前后对照
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 15
蓝线与红虚线在左右脚接触切换的时刻明显不同,说明优化改变的是模式序列,不只是固定模式内的连续轨迹。
- FastRunner初始及优化后的接触模式序列
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 17
蓝色序列经历更多不同模式,不能把模式编号的高低解释成性能好坏;时间轴显示的是单个周期内的切换。
- FastRunner在台阶上抬升和下降的姿态序列
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 17
台阶任务改变了足端落点和躯干姿态;这些是已知几何约束下的规划结果,并非未知地形上的在线适应试验。
- FastRunner跨越离散落脚平台的步态序列
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 18
落脚平台之间的间隙迫使步幅调整,展示的是明确足端位置约束对原有周期步态的修改。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 6、图 7
查看本篇 5 个原文证据入口
- 图 3 · PDF 第 12 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 13 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 14 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 15 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 16 页,Figure 7
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 互补点为什么让普通非线性优化器格外难受
- 在叙事内加入可复算教学例,并明确:本篇使用时间步进接触积分建模;硬互补与软接触罚项
- 在一分钟理解后加入独有前作瓶颈、本篇改动与后续去向。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 保留具体机制承接链接,去掉重复的阅读提示口号
- 将具体图表引用连接到已核对的原稿页面:图 3、图 4、图 5、图 6、图 7
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- dair.seas.upenn.edu · 所列章节
第2.2–2.3节互补、Stewart–Trinkle及与CIO软约束的差异。
- dair.seas.upenn.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 036-impulse-contact · 直接继承
本篇使用时间步进接触积分建模
- 072-contact-implicit · 平行方法
硬互补与软接触罚项
仍需留意
- 未重新运行原始实验;本轮仅核对列明的一手来源范围,原有其余数值不构成新增复核。
机器人经典LSD-SLAM: Large-Scale Direct Monocular SLAM部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:直接单目跟踪怎样修正长期尺度漂移
- 二、连接半稠密深度、直接对齐与Sim(3)图
- 三、更新关键帧和尺度约束,用回访例子检查
- 四、分开读长轨迹、误差与收敛范围实验
- 五、保留单目尺度、光度假设与初始化边界
- 六、追问:回环把地图尺度拉一致后,为什么仍不能宣称恢复了米制尺度?
- 七、转向稀疏联合光度优化
- 八、自测与参考答案
段落怎样重新安排
- 二、背景:直接法缺少的不是更多像素,而是全局约束 → 一、问题设定:直接单目跟踪怎样修正长期尺度漂移
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:局部跟踪、深度更新、全局优化分别干什么 → 二、连接半稠密深度、直接对齐与Sim(3)图
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设计:不同实验回答不同问题 → 四、分开读长轨迹、误差与收敛范围实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、证据:五处最值得对照原文的地方 → 四、分开读长轨迹、误差与收敛范围实验
把可视证据与实验条件/证据局限放在同一节
- 五、证据:五处最值得对照原文的地方 → 四、分开读长轨迹、误差与收敛范围实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留单目尺度、光度假设与初始化边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、用一个自构例子把思想连起来 → 三、更新关键帧和尺度约束,用回访例子检查
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:直接单目跟踪怎样修正长期尺度漂移
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、连接半稠密深度、直接对齐与Sim(3)图
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、连接半稠密深度、直接对齐与Sim(3)图
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:回环把地图尺度拉一致后,为什么仍不能宣称恢复了米制尺度?:回环把地图尺度拉一致后,为什么仍不能宣称恢复了米制尺度?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:6 幅
- Fig. 9:表内是按序列比较的厘米级轨迹 RMSE
实验/结果图 · 必要原图摘引 · Fig. 9,PDF 第 13 页;裁切框为原页比例 (0.345, 0.623, 0.924, 0.741)
表内是按序列比较的厘米级轨迹 RMSE。fr2/xyz 上某 RGB-D 对照更低,fr2/desk 上本方法又较强;不同传感器与初始化信息不应被压成“所有序列冠军”。
- 不同深度方差阈值下的三幅点云地图
实验/结果图 · 必要原图摘引 · Fig. 2, PDF page 3
从左到右点云更密,却出现更多离散噪声点;增大保留阈值不能等同于几何更准确。
- LSD-SLAM跟踪、深度估计和地图优化三模块流程
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 6
跟踪向深度估计提供相机位姿,关键帧再进入地图优化;三列共同说明实时系统并非只有一个直接配准器。
- 参考图、不同相机运动及相应残差逆方差图
方法/设定图 · 必要原图摘引 · Fig. 4, PDF page 8
同一深度误差在旋转与平移下投影不同,所以下方权重图随运动改变;不能用统一常数替代这种几何关系。
- 长室外轨迹闭环前后点云及局部和关键帧对照
实验/结果图 · 必要原图摘引 · Fig. 7, PDF page 12
左右两幅全局地图显示闭环前后的一致性变化,红框对应的局部放大和下方深度图保留了重建细节。
- 两段序列的跟踪误差、不同金字塔层级收敛范围和示例帧
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 14
下方彩条记录哪些初始化能成功,上方曲线记录成功后的误差;扩大收敛范围与提高最终精度是两个不同指标。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 3、图 2、图 4、图 7、图 9、图 10、图 5、图 8
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 8 个原文证据入口
- 图 3 · PDF 第 6 页,Figure 3
原站图表/证明入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 8 页,Figure 4
原站图表/证明入口
- 图 7 · PDF 第 12 页,Figure 7
原站图表/证明入口
- 图 9 · PDF 第 13 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 14 页,Figure 10
原站图表/证明入口
- 图 5 · PDF 第 9 页,Figure 5
原站图表/证明入口
- 图 8 · PDF 第 13 页,Figure 8
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 按式14展开像素/逆深度不确定性传播数值例
- 补充高梯度双重作用及纯旋转初始化边界
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 3、图 2、图 4、图 7、图 9、图 10、图 5、图 8
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- cvg.cit.tum.de · 所列章节
本地下载11MB作者原稿,核§3.1–3.3初始化、状态及式12–14
- cvg.cit.tum.de · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 008-lucas-kanade · 教学联系
共享光度局部配准机制
- 085-dso · 平行方法
后续直接法不同后端和目标
仍需留意
- 本轮直接读取作者PDF的§3.1–3.3并复算新增例子;原稿保留的图9轨迹数值及全套实验图像未在本轮逐项复核,不能把本次方法核验视为全篇实验复现。
机器人经典LOAM: Lidar Odometry and Mapping in Real-time部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:扫描内运动怎样与实时点云配准一同估计
- 二、用线面特征和双速模块组织运动补偿
- 三、按采集时刻校正点,再完成地图配准
- 四、核对里程计和建图实验的输入与真值
- 五、保留几何退化、运动近似和无回环漂移
- 六、追问:只在已经去畸变的扫描上测误差,能否验证LOAM的运动补偿机制?
- 七、加入地面先验,或紧耦合惯性
- 八、自测与参考答案
段落怎样重新安排
- 问题定义与先修概念 → 一、问题设定:扫描内运动怎样与实时点云配准一同估计
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把几何结构和采集时间一起用起来 → 三、按采集时刻校正点,再完成地图配准
把求解机制与每步执行顺序分开检验
- 方法:把几何结构和采集时间一起用起来 → 二、用线面特征和双速模块组织运动补偿
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设定与比较的公平性 → 四、核对里程计和建图实验的输入与真值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五处证据:结论能走多远 → 四、核对里程计和建图实验的输入与真值
把可视证据与实验条件/证据局限放在同一节
- 五处证据:结论能走多远 → 四、核对里程计和建图实验的输入与真值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、边界与一个具体例子 → 五、保留几何退化、运动近似和无回环漂移
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:扫描内运动怎样与实时点云配准一同估计
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用线面特征和双速模块组织运动补偿
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用线面特征和双速模块组织运动补偿
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:只在已经去畸变的扫描上测误差,能否验证LOAM的运动补偿机制?:只在已经去畸变的扫描上测误差,能否验证LOAM的运动补偿机制?
原论文校准与展开范围
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:6 幅
- Fig. 12:上方轨迹与下方地图对照不同 IMU 使用方式:直接使用有漂移的朝向可能使几何结构变差,预处理辅助与完全信任朝向不是一回事
实验/结果图 · 必要原图摘引 · Fig. 12,PDF 第 8 页;裁切框为原页比例 (0.095, 0.065, 0.49, 0.46)
上方轨迹与下方地图对照不同 IMU 使用方式:直接使用有漂移的朝向可能使几何结构变差,预处理辅助与完全信任朝向不是一回事。视觉对齐仍不能代替独立逐时刻真值。
- 运动扫描产生几何畸变的彩色激光点云
方法/设定图 · 必要原图摘引 · Fig. 5, PDF page 4
移动中采集的一次扫描包含不同时间的点,几何边界因此会歪斜;这幅点云是畸变机制的例子。
- 扫描起止时间与激光点姿态补偿示意
方法/设定图 · 必要原图摘引 · Fig. 6, PDF page 4
横轴是扫描时间,箭头将不同时刻的点映射到统一时刻;该关系不等于所有运动模式下的误差保证。
- 走廊、大厅、植被道路及果园的地图和实景八面板
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 7
每对面板将重建与同场景照片并列,规则建筑与植被的几何差异为后面的配准误差比较提供背景。
- 四类场景的匹配误差密度分布
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 6
走廊和大厅的误差分布更窄,植被场景分布更宽;这里测量的是地图与静止扫描之间的配准误差。
- 激光里程计有无IMU辅助的三维轨迹与完整地图细节
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 8
上方三条轨迹对比不同IMU使用方式,下方整幅重建与局部细节对照说明预处理影响;起点接近不能替代整条轨迹的真值误差测量。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、图 5、图 6、图 10、图 11、图 12
查看本篇 7 个原文证据入口
- 表 I · PDF 第 7 页,Table I
原站图表/证明入口
- 表 II · PDF 第 8 页,Table II
原站图表/证明入口
- 图 5 · PDF 第 4 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 4 页,Figure 6
原站图表/证明入口
- 图 10 · PDF 第 7 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 6 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 8 页,Figure 12
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 用静止目标和运动雷达手算去畸变变换
- 补充双频率旧修正与新里程计增量的组合关系
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、图 5、图 6、图 10、图 11、图 12
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.roboticsproceedings.org · 所列章节
本地读取§V-C插值与Algorithm1、地图配准及实验设置
- www.roboticsproceedings.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 028-icp · 直接继承
本篇承接前作:延续几何对应与迭代配准机制
- 095-legoloam · 直接继承
后续沿LOAM结构加入地面先验
仍需留意
- 本轮重点核§V-C扫描内插值、地图配准和实验设置;原稿各场景精度与完整计时结果未逐项重新核验。
机器人经典SVO: Fast Semi-Direct Monocular Visual Odometry部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:相邻视频帧怎样连接亮度初始化与几何精修
- 二、先直接对齐,再独立调块和优化重投影
- 三、跟踪并延迟接受深度,用多帧证据检查新点
- 四、读速度与精度的各自测试条件
- 五、保留小运动、光度和单目漂移限制
- 六、追问:去掉图像块独立微调而直接进入几何优化,会改变哪条信息接口?
- 七、比较半直接分工与直接联合优化
- 八、自测与参考答案
段落怎样重新安排
- 背景与问题定义 → 一、问题设定:相邻视频帧怎样连接亮度初始化与几何精修
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:三个阶段分别解决什么 → 三、跟踪并延迟接受深度,用多帧证据检查新点
把求解机制与每步执行顺序分开检验
- 方法:三个阶段分别解决什么 → 二、先直接对齐,再独立调块和优化重投影
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设置:速度和精度采用了哪些条件 → 四、读速度与精度的各自测试条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五组证据与边界 → 四、读速度与精度的各自测试条件
把可视证据与实验条件/证据局限放在同一节
- 五组证据与边界 → 四、读速度与精度的各自测试条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价与自构小例子 → 五、保留小运动、光度和单目漂移限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:相邻视频帧怎样连接亮度初始化与几何精修
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、先直接对齐,再独立调块和优化重投影
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、先直接对齐,再独立调块和优化重投影
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟:为什么一定要先给每个点找名字 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:去掉图像块独立微调而直接进入几何优化,会改变哪条信息接口?:去掉图像块独立微调而直接进入几何优化,会改变哪条信息接口?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:8 幅
- Figs. 13–14:上下分别是笔记本与嵌入式平台,横轴单位均为处理时间
实验/结果图 · 必要原图摘引 · Figs. 13–14,PDF 第 7 页;裁切框为原页比例 (0.505, 0.055, 0.935, 0.297)
上下分别是笔记本与嵌入式平台,横轴单位均为处理时间。先读完整运动估计与各阶段,再讨论吞吐;处理能力高于相机帧率不表示获得了更多观测。
- SVO两种配置随时间跟踪的特征数
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 6
蓝色与绿色曲线分别受各自的特征预算限制,因此速度和精度比较同时改变了计算规模。
- SVO和PTAM的三轴位置漂移时间曲线
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 6
三个分量随时间的变化并不相同,初始对齐不能消除后续积累的位置漂移。
- SVO和PTAM的三轴姿态漂移时间曲线
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 6
三组曲线给出各姿态分量的误差变化,局部波动与长期偏差都应看清,而不能只比较某一瞬间。
- 不同方法的尺度漂移随时间变化
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 6
纵轴是尺度漂移百分比,曲线仍在零点附近波动并偏离,不能据初始真值对齐声称单目系统自行恢复了绝对尺度。
- 重复高频纹理场景中的四帧特征跟踪结果
实验/结果图 · 必要原图摘引 · Fig. 15, PDF page 7
绿色特征点覆盖地面和墙面重复纹理;这是所示场景的跟踪证据,不是所有重复纹理条件下的成功率统计。
- SVO与PTAM点云的侧视外点对比
实验/结果图 · 必要原图摘引 · Fig. 16, PDF page 7
右图箭头指出偏离主体几何的外点,而左图点云更集中;该对照用于解释深度过滤的效果。
- 安装处理器与下视相机的微型四旋翼平台
实验/结果图 · 必要原图摘引 · Fig. 17, PDF page 8
箭头标明机载处理器和相机位置,说明系统集成的硬件条件;飞行控制仍依赖额外状态估计和控制模块。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、图 12、表 II、图 8、图 9、图 10、图 13、图 14、图 15、图 16、图 17
查看本篇 11 个原文证据入口
- 表 I · PDF 第 6 页,Table I
原站图表/证明入口
- 图 12 · PDF 第 6 页,Figure 12
原站图表/证明入口
- 表 II · PDF 第 7 页,Table II
原站图表/证明入口
- 图 8 · PDF 第 6 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 6 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 6 页,Figure 10
原站图表/证明入口
- 图 13 · PDF 第 7 页,Figure 13
原站图表/证明入口
- 图 14 · PDF 第 7 页,Figure 14
原站图表/证明入口
- 图 15 · PDF 第 7 页,Figure 15
原站图表/证明入口
- 图 16 · PDF 第 7 页,Figure 16
原站图表/证明入口
- 图 17 · PDF 第 8 页,Figure 17
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导内点责任概率并比较密度与概率
- 给出内点高斯融合手算及高帧率不等于独立信息的边界
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、图 12、表 II、图 8、图 9、图 10、图 13、图 14、图 15、图 16、图 17
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- rpg.ifi.uzh.ch · 所列章节
§IV三阶段、§V混合观测与逆深度实现、§VI参数
- rpg.ifi.uzh.ch · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 008-lucas-kanade · 直接继承
本篇承接前作:局部亮度对齐用于隐式对应
- 076-lsdslam · 平行方法
同期不同直接视觉估计路线
仍需留意
- 本轮核§IV–VI的方法、混合模型与参数;原稿保留的全部轨迹曲线和耗时图没有逐项重新读数。
机器人经典Informed RRT*: Optimal Sampling-based Path Planning Focused via Direct Sampling of an Admissible Ellipsoidal Heuristic列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:已有首解后怎样只采可能改进路径的区域
- 二、由可采纳长度下界构造长旋转椭球
- 三、直接采样并连接,检查区域不等于当前路径细管
- 四、读采样效率与最终代价,核对证明版本
- 五、保留障碍、下界有效性与有限预算限制
- 六、追问:当前最好路径趋近起终点直线距离时,椭球短轴会怎样变化?
- 七、继续安排采样图中的候选边顺序
- 八、自测与参考答案
段落怎样重新安排
- 二、背景与问题定义 → 一、问题设定:已有首解后怎样只采可能改进路径的区域
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、关键思想与推导 → 三、直接采样并连接,检查区域不等于当前路径细管
把求解机制与每步执行顺序分开检验
- 三、关键思想与推导 → 二、由可采纳长度下界构造长旋转椭球
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何验证 → 四、读采样效率与最终代价,核对证明版本
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五组证据 → 四、读采样效率与最终代价,核对证明版本
把可视证据与实验条件/证据局限放在同一节
- 五、五组证据 → 四、读采样效率与最终代价,核对证明版本
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留障碍、下界有效性与有限预算限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自构算例与前置知识 → 三、直接采样并连接,检查区域不等于当前路径细管
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:已有首解后怎样只采可能改进路径的区域
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、由可采纳长度下界构造长旋转椭球
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、由可采纳长度下界构造长旋转椭球
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:当前最好路径趋近起终点直线距离时,椭球短轴会怎样变化?:当前最好路径趋近起终点直线距离时,椭球短轴会怎样变化?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:6 幅
- Fig. 8:随着问题空间尺度扩大,红色 RRT* 与蓝色 Informed RRT* 达到目标质量所需的中位时间增长不同
实验/结果图 · 必要原图摘引 · Fig. 8,PDF 第 8 页;裁切框为原页比例 (0.08, 0.058, 0.495, 0.179)
随着问题空间尺度扩大,红色 RRT* 与蓝色 Informed RRT* 达到目标质量所需的中位时间增长不同。目标是最优代价 2% 范围,不能把达到容差写成有限时间精确最优。
- 相同五秒计算时间下RRT星与InformedRRT星搜索树
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 7
同为五秒,右侧树更集中于可改进当前路径的区域;树形差异体现采样聚焦,但单幅案例不代替统计实验。
- 狭窄通道中两种算法搜索树和找到路径的时间
实验/结果图 · 必要原图摘引 · Fig. 7, PDF page 7
图下注明12.32秒与4.00秒,这是一组示例;右图仍可寻找不同通路,聚焦并不意味着固定在原路径类别。
- 目标路径成本容差与CPU时间关系及误差条
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 8
横轴容差收紧时,红色时间曲线上升明显;纵轴衡量CPU时间,不是迭代次数。
- 通道相对高度与CPU时间关系及误差条
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 8
通道变窄时两种方法的计算时间变化不同,误差条提示该趋势来自重复试验而非单条搜索轨迹。
- 不同状态维度下的路径成本改善百分比
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 8
横轴是状态维度,纵轴是改善百分比;这个比较不能直接转换成任意机器人上的固定运行时间加速。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 6、图 7、图 8、图 9、图 11
查看本篇 5 个原文证据入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 7 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 8 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 8 页,Figure 9
原站图表/证明入口
- 图 11 · PDF 第 8 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从椭球体积推导接近最优时的维数效应
- 给出11.8%到2.9%命中比例并区分改善概率
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 6、图 7、图 8、图 9、图 11
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
式3体积上界、Theorem1严格条件及§VI配对100次/60秒实验
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 062-rrtstar · 直接继承
本篇承接前作:直接修改RRT*采样区域
- 081-bitstar · 直接继承
后续同时组织知情采样和启发式搜索
机器人经典Whole-body Motion Planning with Centroidal Dynamics and Full Kinematics列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:全身几何与压缩动力学怎样描述同一具机器人
- 二、用质心动量与完整运动学的一致约束连接两层变量
- 三、联合规划接触和关节姿态,检查一致性
- 四、读数值动作与部分闭环仿真
- 五、保留执行器能力、非凸性和初始化假设
- 六、追问:质心和接触力满足动力学,为什么还要核对关节姿态中的质心位置?
- 七、比较更强近似下的在线接触力规划
- 八、自测与参考答案
段落怎样重新安排
- 二、背景与问题定义 → 一、问题设定:全身几何与压缩动力学怎样描述同一具机器人
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:两套表示必须描述同一具身体 → 三、联合规划接触和关节姿态,检查一致性
把求解机制与每步执行顺序分开检验
- 三、方法:两套表示必须描述同一具身体 → 二、用质心动量与完整运动学的一致约束连接两层变量
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设计 → 四、读数值动作与部分闭环仿真
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五处证据与限制 → 四、读数值动作与部分闭环仿真
把可视证据与实验条件/证据局限放在同一节
- 五、五处证据与限制 → 四、读数值动作与部分闭环仿真
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留执行器能力、非凸性和初始化假设
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自构例子与前置知识 → 三、联合规划接触和关节姿态,检查一致性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:全身几何与压缩动力学怎样描述同一具机器人
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用质心动量与完整运动学的一致约束连接两层变量
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用质心动量与完整运动学的一致约束连接两层变量
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:质心和接触力满足动力学,为什么还要核对关节姿态中的质心位置?:质心和接触力满足动力学,为什么还要核对关节姿态中的质心位置?
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Trajectory Optimization
Direct Transcription、与shooting比较、连续离散化及双积分器精确例子
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:7 幅
- Fig. 7:将质心高度和归一化竖直反力放在同一运动阶段看,尤其检查触地、支撑与离地的对应
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 6 页;裁切框为原页比例 (0.105, 0.265, 0.495, 0.435)
将质心高度和归一化竖直反力放在同一运动阶段看,尤其检查触地、支撑与离地的对应。力归一化后仍不是电机功率,网格点满足约束也不是连续时间自动无误差。
- 人形机器人足端、手部目标和视线几何约束示例
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 3
绿色视线锥与手部目标展示了完整运动学表达的约束,不能据这个姿态图判断动力学跟踪是否成功。
- 人形机器人越过障碍的空中运动规划姿态
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 5
图中身体各关节共同满足腾空运动约束;这是一段规划的可视化,不是硬件执行成功率统计。
- 人形机器人踏上台阶的三阶段规划姿态
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 5
三个姿态展示起跳、跨越和落地的几何安排;台阶高度是任务条件,不能当作机器人平台的普遍性能上限。
- 人形机器人奔跑的触地、支撑与离地姿态
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 6
面板按触地、支撑中段和脚尖离地排列,说明周期轨迹中的接触与姿态变化;指定奔跑速度是规划目标。
- 人形机器人在低障碍下通过的三帧姿态
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 6
机器人同时调整腿部和躯干以满足空间约束;采用完整运动学使这些躯体碰撞条件可以显式表达。
- 固定与自由接触顺序优化得到的不同落地姿态
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 6
两面板的左右脚先后落地顺序不同,说明允许改变接触模式会改变优化结果;这不意味着已经遍历全部离散模式。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 2、图 4、图 5、图 6、图 7、图 8、图 10
查看本篇 7 个原文证据入口
- 图 2 · PDF 第 3 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 5 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 7 · PDF 第 6 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 6 页,Figure 8
原站图表/证明入口
- 图 10 · PDF 第 6 页,Figure 10
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 解释六维整体方程替代的驱动假设
- 加入双脚25/75N平衡与执行器限制反例
- 定位双线性非凸项并澄清QP命名
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 2、图 4、图 5、图 6、图 7、图 8、图 10
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- groups.csail.mit.edu · 所列章节
本地读取§II-A等价条件与式1/2、§III任务和仿真范围
- groups.csail.mit.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 027-lipm · 平行方法
不同简化程度的身体规划模型
- 075-contact-trajopt · 模块组合
接触约束思想可组合
- 094-cheetah-mpc · 平行方法
不同实时预算和近似模型
机器人经典Batch Informed Trees (BIT*): Sampling-Based Optimal Planning via the Heuristically Guided Search of Implicit Random Geometric Graphs列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:批量采样图中怎样优先检查最可能改善的连接
- 二、区分三类代价,用双队列延迟昂贵验证
- 三、扩充样本批次并复用搜索,检查下界剪枝
- 四、同时读首解时间、最终代价与成功率
- 五、保留队列成本、有限预算和理论条件
- 六、追问:减少碰撞检查次数,为什么未必等量减少总运行时间?
- 七、回看启发采样,再比较局部轨迹优化
- 八、自测与参考答案
段落怎样重新安排
- 1.背景与问题定义 → 一、问题设定:批量采样图中怎样优先检查最可能改善的连接
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 2.三个代价必须区分 → 二、区分三类代价,用双队列延迟昂贵验证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 3.双队列:先便宜判断,再昂贵验证 → 三、扩充样本批次并复用搜索,检查下界剪枝
把求解机制与每步执行顺序分开检验
- 3.双队列:先便宜判断,再昂贵验证 → 二、区分三类代价,用双队列延迟昂贵验证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 4.为何可能有效,理论保证又是什么 → 二、区分三类代价,用双队列延迟昂贵验证
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 5.实验设计与公平性 → 四、同时读首解时间、最终代价与成功率
把可视证据与实验条件/证据局限放在同一节
- 5.实验设计与公平性 → 四、同时读首解时间、最终代价与成功率
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 6.结果:首解、代价与成功率需要一起看 → 四、同时读首解时间、最终代价与成功率
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 7.贡献、代价与局限 → 五、保留队列成本、有限预算和理论条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 8.自构例子与前置概念 → 三、扩充样本批次并复用搜索,检查下界剪枝
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 9.自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:批量采样图中怎样优先检查最可能改善的连接
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、区分三类代价,用双队列延迟昂贵验证
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、区分三类代价,用双队列延迟昂贵验证
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 五、保留队列成本、有限预算和理论条件 → 四、同时读首解时间、最终代价与成功率
实验结果及百分点计算与图、预算、统计纳入规则放在一起,边界段只保留机制成本与扩展条件
- 一分钟理解:采样决定有哪些路,搜索决定先看哪条路 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:减少碰撞检查次数,为什么未必等量减少总运行时间?:减少碰撞检查次数,为什么未必等量减少总运行时间?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“9.自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:4 幅
- Fig. 5:上排看预算内成功比例,下排看已求解样本的中位代价
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 6 页;裁切框为原页比例 (0.08, 0.055, 0.93, 0.32)
上排看预算内成功比例,下排看已求解样本的中位代价。较低代价必须与多少运行成功一起解释;成功样本集合随时间改变,中位数也不必逐时刻下降。
- 原论文图4:四种采样规划器在同一二维障碍场景中的树与返回路径
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 5
四个面板达到相同指定路径代价时才停止;图下时间与各自搜索结构应一起比较。
- 原论文图3:BIT*加入批次、启发式搜索与剪枝的四阶段示意
方法/设定图 · 必要原图摘引 · Fig. 3, PDF page 3
绿点和红点给出起终点;每次加入样本后只改变搜索支持集,不应把蓝色连线数量当成实测运行时间。
- BIT星二维和八维随机环境的四面板结果及完整六方法图例
实验/结果图 · 必要原图摘引 · Fig.5, PDF p6, complete original panels/legend
补齐原有裁切缺失的完整图例,四面板分别区分成功比例与解成本;各条曲线的颜色必须与下方算法名称一起读取。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 1、图 3、图 6
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 5 个原文证据入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 6 页,Figure 5
原站图表/证明入口
- 图 1 · PDF 第 1 页,Figure 1
原站图表/证明入口
- 图 3 · PDF 第 3 页,Figure 3
原站图表/证明入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 展开三道候选边检查并区分下界与当前树代价
- 新增候选通过前两关却无法重连的手算轨迹
- 把图4同代价时间比较与操作成本分开
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 4、图 5、图 1、图 3、图 6
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
III-B队列与边处理、图4及实验设置
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 079-informed-rrtstar · 直接继承
本篇承接前作:继承informed区域限制
- 003-astar · 模块组合
启发式排序与采样图结合
- 073-trajopt · 平行方法
局部轨迹优化与采样搜索不同路线
机器人经典ORB-SLAM: A Versatile and Accurate Monocular SLAM System部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:单目关键帧地图怎样支持重定位与长期回访
- 二、统一ORB特征,区分共视图与回环约束
- 三、完成初始化跟踪和地图维护,检查尺度
- 四、按系统模式读轨迹误差与恢复结果
- 五、保留低视差、弱纹理与单目尺度自由度
- 六、追问:关闭回环后与另一视觉里程计比较,为什么不能把结论直接写成完整SLAM排名?
- 七、将单目系统扩展到深度输入
- 八、自测与参考答案
段落怎样重新安排
- 1.问题定义:相机位姿和地图一起估计 → 一、问题设定:单目关键帧地图怎样支持重定位与长期回访
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 2.地图里的几种图,各负责什么 → 二、统一ORB特征,区分共视图与回环约束
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 3.初始化:宁可等待,也不急着选错解释 → 二、统一ORB特征,区分共视图与回环约束
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 4.跟踪、BA 与回环的数学关系 → 三、完成初始化跟踪和地图维护,检查尺度
把求解机制与每步执行顺序分开检验
- 4.跟踪、BA 与回环的数学关系 → 二、统一ORB特征,区分共视图与回环约束
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 5.实验设计与评价口径 → 四、按系统模式读轨迹误差与恢复结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 6.关键证据:系统优势不代表每个单项都赢 → 四、按系统模式读轨迹误差与恢复结果
把可视证据与实验条件/证据局限放在同一节
- 6.关键证据:系统优势不代表每个单项都赢 → 四、按系统模式读轨迹误差与恢复结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 7.贡献、代价与局限 → 五、保留低视差、弱纹理与单目尺度自由度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 8.自构例子与前置概念 → 三、完成初始化跟踪和地图维护,检查尺度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 9.自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:单目关键帧地图怎样支持重定位与长期回访
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、统一ORB特征,区分共视图与回环约束
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、统一ORB特征,区分共视图与回环约束
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解:建过的地图应该帮助下一次定位 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:关闭回环后与另一视觉里程计比较,为什么不能把结论直接写成完整SLAM排名?:关闭回环后与另一视觉里程计比较,为什么不能把结论直接写成完整SLAM排名?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“9.自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:3 幅
- Fig. 9:横轴时间增长时,对比重复观察同一静态环境的关键帧数量
实验/结果图 · 必要原图摘引 · Fig. 9,PDF 第 13 页;裁切框为原页比例 (0.075, 0.28, 0.5, 0.42)
横轴时间增长时,对比重复观察同一静态环境的关键帧数量。冗余删除让 ORB-SLAM 曲线趋缓,证据范围是重访环境,不意味着探索无限新区域时地图仍固定大小。
- 原论文图10:动态环境中关键帧数量、创建销毁和存活比例三个面板
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 13
(a)统计当前地图中的关键帧,(b)每条横线表示一帧的寿命,(c)统计相对剩余序列长度的存活比例;三者的纵轴不能混用。
- 原论文图13:KITTI 09中四种回环处理方案与真值的轨迹对比
实验/结果图 · 必要原图摘引 · Fig. 13, PDF page 15
按无回环、BA、Essential Graph以及二者组合的顺序读四个面板;地图变得闭合仍需结合正文误差衡量。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:表 I、表 III、表 IV、图 9、表 VI、图 13、图 3
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 7 个原文证据入口
- 表 I · PDF 第 10 页,Table I
原站图表/证明入口
- 表 III · PDF 第 12 页,Table III
原站图表/证明入口
- 表 IV · PDF 第 13 页,Table IV
原站图表/证明入口
- 图 9 · PDF 第 13 页,Figure 9
原站图表/证明入口
- 表 VI · PDF 第 15 页,Table VI
原站图表/证明入口
- 图 13 · PDF 第 15 页,Figure 13
原站图表/证明入口
- 图 3 · PDF 第 7 页,Figure 3
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导Sim(3)投影到SE(3)时平移除尺度的原因
- 新增地图点随关键帧修正的坐标手算
- 区分规范固定与实验尺度对齐
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:表 I、表 III、表 IV、图 9、表 VI、图 13、图 3
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
VII回环、附录Sim(3)、VIII实验协议;各数值表未全核
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 056-ptam · 直接继承
本篇承接前作:承接关键帧并行跟踪建图架构
- 060-orb · 模块组合
统一ORB观测
- 066-dbow · 模块组合
词袋地点检索
- 089-orbslam2 · 直接继承
后作扩展传感器模式
仍需留意
- 本轮核VII回环、附录Sim(3)及VIII实验协议;原稿各数据集误差表和恢复实验数值未逐项再次核对。
机器人经典IMU Preintegration on Manifold for Efficient Visual-Inertial Maximum-a-Posteriori Estimation部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:关键帧状态被修改时怎样避免反复重放全部IMU
- 二、在局部坐标预积分,并传播相关噪声和偏置导数
- 三、缓存区间增量,检查一阶偏置修正
- 四、读误差与计算时间,核对惯性和视觉输入
- 五、保留短区间模型、标定和初始化限制
- 六、追问:预积分的旋转、速度和位置误差为什么不能各自独立加权?
- 七、把惯性因子接入完整估计系统
- 八、自测与参考答案
段落怎样重新安排
- 二、问题定义:IMU 测到的不是位置 → 一、问题设定:关键帧状态被修改时怎样避免反复重放全部IMU
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:增量可以缓存,状态仍要优化 → 四、读误差与计算时间,核对惯性和视觉输入
把可视证据与实验条件/证据局限放在同一节
- 三、方法:增量可以缓存,状态仍要优化 → 三、缓存区间增量,检查一阶偏置修正
把求解机制与每步执行顺序分开检验
- 三、方法:增量可以缓存,状态仍要优化 → 二、在局部坐标预积分,并传播相关噪声和偏置导数
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验怎样安排 → 四、读误差与计算时间,核对惯性和视觉输入
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、哪些结论有证据,哪些不能推出 → 四、读误差与计算时间,核对惯性和视觉输入
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与适用边界 → 五、保留短区间模型、标定和初始化限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、用一个小例子建立直觉 → 三、缓存区间增量,检查一阶偏置修正
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:关键帧状态被修改时怎样避免反复重放全部IMU
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、在局部坐标预积分,并传播相关噪声和偏置导数
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、在局部坐标预积分,并传播相关噪声和偏置导数
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟理解:优化器为什么不该反复重放 IMU → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:预积分的旋转、速度和位置误差为什么不能各自独立加权?:预积分的旋转、速度和位置误差为什么不能各自独立加权?
教法来源与实际阅读范围
- Frank Dellaert · Factor Graphs and GTSAM
§1后验分解、§2.1–2.5三位姿图/噪声/初值/优化与协方差近似
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:5 幅
- Fig. 10:按纵轴从左到右读位置、速度和旋转的一阶偏置修正误差,横轴扩大偏置扰动
实验/结果图 · 必要原图摘引 · Fig. 10,PDF 第 8 页;裁切框为原页比例 (0.475, 0.055, 0.935, 0.172)
按纵轴从左到右读位置、速度和旋转的一阶偏置修正误差,横轴扩大偏置扰动。误差随扰动上升提醒我们修正是局部近似,不能把小扰动下的小误差当作永不重新积分的保证。
- 原论文图7:三种视觉惯性方法随行进距离变化的平移、偏航和倾斜误差箱线图
实验/结果图 · 必要原图摘引 · Fig. 7, PDF page 7
三个纵轴对应不同误差量,箱体与离群点展示分布;不能把最小一条中位数当成所有指标都占优。
- 原论文图8:增量视觉惯性估计的每关键帧处理耗时曲线
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 7
横轴是关键帧编号,尖峰与常态耗时分开读;均值不能替代实时系统对最坏延迟的要求。
- 原论文图9:闭合室外轨迹上所提方法和Tango的估计路径
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 8
路径起终点设在同一坐标处;轨迹看起来接近不等于每个位置都有真值误差保证。
- 原论文图1:楼梯场景下所提方法与Tango三维轨迹的两个投影视图
实验/结果图 · 必要原图摘引 · Fig. 1, PDF page 1
两个投影呈现同一段上下楼运动;要同时比较平面位移和高度变化,避免只凭单个视图判断漂移。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 10、图 7、图 8、图 9、图 1
查看本篇 5 个原文证据入口
- 图 10 · PDF 第 8 页,Figure 10
原站图表/证明入口
- 图 7 · PDF 第 7 页,Figure 7
原站图表/证明入口
- 图 8 · PDF 第 7 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 8 页,Figure 9
原站图表/证明入口
- 图 1 · PDF 第 1 页,Figure 1
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导两步积分的速度位置交叉协方差
- 新增相关系数0.894的可手算例
- 区分噪声传播检验与偏置修正实验
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 10、图 7、图 8、图 9、图 1
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.roboticsproceedings.org · 所列章节
V-B九维联合噪声、V-C偏置修正、图10实验
- www.roboticsproceedings.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 068-isam2 · 模块组合
预积分因子与增量后端组合
- 092-vinsmono · 直接继承
后作承接预积分构造VIO系统
仍需留意
- 本轮核V-B/C联合噪声与偏置修正、图10的100条测量和1000次模拟条件;其他真实轨迹图表及图9正文/图注数值分歧未本轮重新视觉核验,保留原文疑点。
机器人经典ElasticFusion: Dense SLAM Without a Pose Graph部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:已经融合到表面的漂移怎样在回访时修正
- 二、管理活跃表面,并以回环约束驱动形变
- 三、跟踪融合与形变交替,检查表面关联
- 四、分开读重建表面和相机轨迹结果
- 五、保留GPU预算、地图增长与错误回环风险
- 六、追问:地图变形后表面看起来闭合,怎样检查不是把错误对应强行拉到一起?
- 七、比较稀疏关键帧与稠密表面路线
- 八、自测与参考答案
段落怎样重新安排
- 二、背景与问题定义 → 一、问题设定:已经融合到表面的漂移怎样在回访时修正
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:跟踪、融合、变形各优化什么 → 三、跟踪融合与形变交替,检查表面关联
把求解机制与每步执行顺序分开检验
- 三、方法:跟踪、融合、变形各优化什么 → 二、管理活跃表面,并以回环约束驱动形变
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设计与公平性 → 四、分开读重建表面和相机轨迹结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、结果:表面更好不代表每条轨迹都第一 → 四、分开读重建表面和相机轨迹结果
把可视证据与实验条件/证据局限放在同一节
- 五、结果:表面更好不代表每条轨迹都第一 → 四、分开读重建表面和相机轨迹结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留GPU预算、地图增长与错误回环风险
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、教学例子与前置概念 → 三、跟踪融合与形变交替,检查表面关联
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:已经融合到表面的漂移怎样在回访时修正
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、管理活跃表面,并以回环约束驱动形变
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、管理活跃表面,并以回环约束驱动形变
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、管理活跃表面,并以回环约束驱动形变 / 结果:表面更好不代表每条轨迹都第一 → 四、分开读重建表面和相机轨迹结果
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
- 一、一分钟讲明白 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:地图变形后表面看起来闭合,怎样检查不是把错误对应强行拉到一起?:地图变形后表面看起来闭合,怎样检查不是把错误对应强行拉到一起?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:2 幅
- Fig. 6:随着视频帧推进,蓝色 surfel 数量与红色帧耗时一同增长
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 8 页;裁切框为原页比例 (0.5, 0.06, 0.94, 0.218)
随着视频帧推进,蓝色 surfel 数量与红色帧耗时一同增长。这里是两个纵轴,不是耗时对 surfel 数直接回归;整体平均接近实时仍不能作为严格最坏执行时间界。
- 原论文图4:六种重建方法在kt0场景的正视误差热图
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 7
各面板共用0至0.1米色标;被剔除的更大误差点不会显示为更深的颜色。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、表 III、表 IV、图 6、图 4
查看本篇 6 个原文证据入口
- 表 I · PDF 第 7 页,Table I
原站图表/证明入口
- 表 II · PDF 第 7 页,Table II
原站图表/证明入口
- 表 III · PDF 第 7 页,Table III
原站图表/证明入口
- 表 IV · PDF 第 8 页,Table IV
原站图表/证明入口
- 图 6 · PDF 第 8 页,Figure 6
原站图表/证明入口
- 图 4 · PDF 第 7 页,Figure 4
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从切向正交推导法向逆转置变换
- 新增非均匀伸缩法向与旋转混合退化手算
- 明确混合法向规则和完整形变雅可比的区别
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、表 III、表 IV、图 6、图 4
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.roboticsproceedings.org · 所列章节
III跟踪、IV形变式8至10;本轮未逐项复核原稿全部实验表
- www.roboticsproceedings.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 064-kinfu · 历史背景
修复已融合表面漂移的前作瓶颈
- 082-orbslam · 平行方法
稠密形变与稀疏位姿图平行选择
仍需留意
- 本轮直接核III跟踪和IV形变式8至10;原稿表I至IV的各项实验数字和热图过滤条件没有逐项重新复核。
机器人经典Direct Sparse Odometry列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:少量像素怎样支持位姿深度和亮度的联合估计
- 二、校准光度残差,再组织窗口变量与边缘化
- 三、执行点选择与联合优化,检查信息分布
- 四、按光度条件与模式读视觉里程计比较
- 五、保留初始化、畸变和无回环漂移限制
- 六、追问:窗口删去旧状态后,新估计能否随意重写已经边缘化的信息?
- 七、比较直接残差的不同含义与后端
- 八、自测与参考答案
段落怎样重新安排
- 二、问题与假设 → 一、问题设定:少量像素怎样支持位姿深度和亮度的联合估计
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:让亮度比较成为可解释的残差 → 四、按光度条件与模式读视觉里程计比较
把可视证据与实验条件/证据局限放在同一节
- 三、方法:让亮度比较成为可解释的残差 → 三、执行点选择与联合优化,检查信息分布
把求解机制与每步执行顺序分开检验
- 三、方法:让亮度比较成为可解释的残差 → 二、校准光度残差,再组织窗口变量与边缘化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设计 → 四、按光度条件与模式读视觉里程计比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五组证据怎样读 → 四、按光度条件与模式读视觉里程计比较
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献与局限 → 五、保留初始化、畸变和无回环漂移限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、例子与五个前置概念 → 二、校准光度残差,再组织窗口变量与边缘化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:少量像素怎样支持位姿深度和亮度的联合估计
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、校准光度残差,再组织窗口变量与边缘化
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、校准光度残差,再组织窗口变量与边缘化
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、方法中的具体例子与前置概念 → 三、执行点选择与联合优化,检查信息分布
把可检查的亮度、插值或双目数值例子接在实现后,五项前置概念原文完整保留
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:窗口删去旧状态后,新估计能否随意重写已经边缘化的信息?:窗口删去旧状态后,新估计能否随意重写已经边缘化的信息?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:8 幅
- Fig. 18:累计曲线比较关键帧频率,读同一误差阈值下能成功达到的运行数量
实验/结果图 · 必要原图摘引 · Fig. 18,PDF 第 14 页;裁切框为原页比例 (0.065, 0.068, 0.44, 0.21)
累计曲线比较关键帧频率,读同一误差阈值下能成功达到的运行数量。更频繁纳入关键帧会更早边缘化旧信息,因此提升采样频率并不保证最终估计更准。
- 原论文图13:ORB-SLAM与DSO在EuRoC及ICL NUIM序列上的误差热图
实验/结果图 · 必要原图摘引 · Fig. 13, PDF page 11
每格是一次方向与序列的评估;先按各自色标读取,不能用一片蓝色替代失败率和误差数值。
- 原论文图14:ORB-SLAM与DSO在50个TUM monoVO序列正反向运行的误差热图
实验/结果图 · 必要原图摘引 · Fig. 14, PDF page 12
横向不同序列与纵向重复运行共同保留了波动;两种方法应在同一序列位置比较。
- 原论文图10:EuRoC和ICL NUIM数据集的对齐后平移RMSE累计分布
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 10
纵轴是误差低于横轴阈值的运行数;实线、虚线与带圆点曲线对应不同实时或资源设置。
- 原论文图12:TUM monoVO上的对齐、旋转和尺度误差累计分布
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 11
三个子图横轴不同,纵轴均为满足阈值的运行数;曲线不能跨不同误差定义直接相减。
- 原论文图15:逐步移除曝光、渐晕和响应校准后的误差累计分布
实验/结果图 · 必要原图摘引 · Fig. 15, PDF page 13
每条曲线对应一组光度信息可用条件;图例中的亮度常数模型也是单独基线。
- 原论文图16:改变优化窗口关键帧数和点数时的误差累计分布
实验/结果图 · 必要原图摘引 · Fig. 16, PDF page 13
上下图分别改变窗口大小与采样点数;固定窗基线与自适应边缘化的差别需按图例读。
- 原论文图20:图像几何扰动示意及DSO和ORB-SLAM随扰动变化的误差曲线
实验/结果图 · 必要原图摘引 · Fig. 20, PDF page 14
上方近景框展示扰动怎样改变局部几何,下方颜色编码扰动强度;这是受控噪声实验。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 18、图 13、图 14、图 10、图 15、图 16、图 20
查看本篇 7 个原文证据入口
- 图 18 · PDF 第 14 页,Figure 18
原站图表/证明入口
- 图 13 · PDF 第 11 页,Figure 13
原站图表/证明入口
- 图 14 · PDF 第 12 页,Figure 14
原站图表/证明入口
- 图 10 · PDF 第 10 页,Figure 10
原站图表/证明入口
- 图 15 · PDF 第 13 页,Figure 15
原站图表/证明入口
- 图 16 · PDF 第 13 页,Figure 16
原站图表/证明入口
- 图 20 · PDF 第 14 页,Figure 20
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 展开边缘化Schur补并固定梯度符号约定
- 新增消元、删除、固定旧变量三种不同曲率的手算
- 联系图18解释信息冻结时机
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 18、图 13、图 14、图 10、图 15、图 16、图 20
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
2.3边缘化与FEJ、4评测协议和图15至18文字条件
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 076-lsdslam · 历史背景
从半稠密直接系统转向稀疏联合估计
- 082-orbslam · 平行方法
光度与特征几何残差的平行方法
- 099-fastlio2 · 教学联系
direct含义的跨传感器对照
机器人经典The EuRoC Micro Aerial Vehicle Datasets部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:飞行视觉惯性轨迹怎样与独立参考测量对齐
- 二、统一传感器标定、时间和被测刚体坐标
- 三、按序列关联估计与真值,检查机体杆臂
- 四、读采集条件、真值精度与已知数据问题
- 五、保留运动覆盖与参考系统误差
- 六、追问:机器人纯旋转时,棱镜位置变化为什么不一定是机体平移?
- 七、作为视觉惯性系统的共同评测输入
- 八、自测与参考答案
段落怎样重新安排
- 二、研究背景与任务 → 一、问题设定:飞行视觉惯性轨迹怎样与独立参考测量对齐
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:设计一个可比较的测量系统 → 三、按序列关联估计与真值,检查机体杆臂
把求解机制与每步执行顺序分开检验
- 三、方法:设计一个可比较的测量系统 → 二、统一传感器标定、时间和被测刚体坐标
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、采集与证据表 → 四、读采集条件、真值精度与已知数据问题
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、三组图表与已知问题怎样读 → 四、读采集条件、真值精度与已知数据问题
把可视证据与实验条件/证据局限放在同一节
- 五、三组图表与已知问题怎样读 → 四、读采集条件、真值精度与已知数据问题
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留运动覆盖与参考系统误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、自构例子与前置概念 → 三、按序列关联估计与真值,检查机体杆臂
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:飞行视觉惯性轨迹怎样与独立参考测量对齐
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、统一传感器标定、时间和被测刚体坐标
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、统一传感器标定、时间和被测刚体坐标
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:机器人纯旋转时,棱镜位置变化为什么不一定是机体平移?:机器人纯旋转时,棱镜位置变化为什么不一定是机体平移?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 3.3.1 Homogeneous Transformation Matrices
描述与全文转录:变换方向、下标对消、左右乘与点坐标
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:2 幅
- Fig. 5:这两幅结构参考来自对房间的独立三维扫描,用于检查地图而非只检查相机轨迹
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 5 页;裁切框为原页比例 (0.1, 0.14, 0.485, 0.431)
这两幅结构参考来自对房间的独立三维扫描,用于检查地图而非只检查相机轨迹。它们同样受遮挡与配准条件限制,评估时要固定双方可见的区域。
- 原论文图4:机器大厅三个难度序列的俯视飞行轨迹
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 4
坐标单位为米,三条轨迹的覆盖范围与折返不同;easy、medium、difficult不是仅由路径长度定义。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 1、表 2、图 4、图 5
查看本篇 4 个原文证据入口
- 表 1 · PDF 第 3 页,Table 1
原站图表/证明入口
- 表 2 · PDF 第 4 页,Table 2
原站图表/证明入口
- 图 4 · PDF 第 4 页,Figure 4
原站图表/证明入口
- 图 5 · PDF 第 5 页,Figure 5
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导连续噪声密度到离散测量及偏置增量的换算
- 新增200Hz与一秒累计噪声的手算一致性检查
- 修正当前官方页已迁移后的已知问题来源标签
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 1、表 2、图 4、图 5
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.researchgate.net · 所列章节
4.3噪声约定、5同步、6已知问题
- projects.asl.ethz.ch · 所列章节
当前官方数据概览与迁移入口
- www.researchgate.net · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 069-tum-rgbd · 平行方法
室内RGB-D与飞行VIO基准不同覆盖
- 070-kitti · 平行方法
车载与微型飞行器基准不同覆盖
- 092-vinsmono · 模块组合
后作使用数据集评测
- 098-orbslam3 · 模块组合
后作使用数据集评测
仍需留意
- 本轮核传感器概览、4.3噪声、5同步与6已知问题;表2的各序列长度和时长未逐项重新核验,未下载原始数据。
机器人经典Motion Planning as Probabilistic Inference Using Gaussian Processes and Factor Graphs部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:稀疏轨迹变量怎样兼顾中间时刻的碰撞检查
- 二、用Markov高斯过程先验组织稀疏因子图
- 三、插值检查障碍并回传支持状态,核对增量更新
- 四、同时读求解时间、成功率与任务改变
- 五、保留软约束、局部解和插值检查密度
- 六、追问:增加插值检查点而不增加支持状态,优化问题哪些部分会变大?
- 七、衔接时间参数化与增量求解
- 八、自测与参考答案
段落怎样重新安排
- 二、问题定义与前人瓶颈 → 一、问题设定:稀疏轨迹变量怎样兼顾中间时刻的碰撞检查
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:概率只是表达方式,优化对象仍是一条轨迹 → 三、插值检查障碍并回传支持状态,核对增量更新
把求解机制与每步执行顺序分开检验
- 三、方法:概率只是表达方式,优化对象仍是一条轨迹 → 二、用Markov高斯过程先验组织稀疏因子图
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验怎么比较 → 四、同时读求解时间、成功率与任务改变
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、四组关键证据 → 四、同时读求解时间、成功率与任务改变
把可视证据与实验条件/证据局限放在同一节
- 五、四组关键证据 → 四、同时读求解时间、成功率与任务改变
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留软约束、局部解和插值检查密度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、例子与五个前置概念 → 三、插值检查障碍并回传支持状态,核对增量更新
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:稀疏轨迹变量怎样兼顾中间时刻的碰撞检查
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用Markov高斯过程先验组织稀疏因子图
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用Markov高斯过程先验组织稀疏因子图
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、方法中的具体例子与前置概念 → 三、插值检查障碍并回传支持状态,核对增量更新
把可检查的亮度、插值或双目数值例子接在实现后,五项前置概念原文完整保留
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
- 原摘要的实验结果前置在方法开头,且与第四节重复;合并到具体试验条件和数值旁,保留全部范围限定。;内容保留于**[表 II](https://www.roboticsproceedings.org/rss12/p01.pdf#page=8):增量加速付出了代价。** WAM 重规划从 30.21 ms 降到 2.38 ms,但成功率从 100% 降至 90.6%;PR2 从 26.70 ms 降至 4.27 ms,成功率从 96.4% 降至 75.0%,下降 **21.4 个百分点**。作者正文称损失较小,但在需要可靠执行的应用中,后一差异不能轻描淡写。。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:增加插值检查点而不增加支持状态,优化问题哪些部分会变大?:增加插值检查点而不增加支持状态,优化问题哪些部分会变大?
教法来源与实际阅读范围
- Frank Dellaert · Factor Graphs and GTSAM
§1后验分解、§2.1–2.5三位姿图/噪声/初值/优化与协方差近似
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Table II:对两台机械臂同时读成功率、平均与最大耗时
实验/结果图 · 必要原图摘引 · Table II,PDF 第 8 页;裁切框为原页比例 (0.105, 0.065, 0.47, 0.22)
对两台机械臂同时读成功率、平均与最大耗时。增量版本明显省时却丢掉部分成功问题,因此不能把成功子集上的速度直接宣布为同可靠性加速。
- 原论文图6:不同障碍噪声参数下的机械臂轨迹对照
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 6
左右使用不同的障碍代价尺度;左侧成功与右侧失败说明参数会改变避障权衡,不是任意设定都稳健。
- 原论文图2:系统状态、碰撞检查与输出轨迹在时间轴上的不同分辨率
方法/设定图 · 必要原图摘引 · Fig. 2, PDF page 4
空心点表示离散状态,较密点表示插值检查或输出;插值增密并没有同时增加全部优化变量。
未在正文展示的图/表与范围
- 表I:本轮逐Figure补齐范围外的表格引用;原文链接、页号和正文仍保留,未计入Figure完成率。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 6、图 2、表 I、表 II
查看本篇 4 个原文证据入口
- 图 6 · PDF 第 6 页,Figure 6
原站图表/证明入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 表 I · PDF 第 7 页,Table I
原站图表/证明入口
- 表 II · PDF 第 8 页,Table II
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从积分核推导GP转移协方差及交叉项
- 新增联合残差代价12与4的手算
- 新增三次插值中点碰撞例说明有限检查边界
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 6、图 2、表 I、表 II
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- www.roboticsproceedings.org · 所列章节
II-D插值、IV-A先验式26、表I成功条件耗时;表II数值未全核
- www.roboticsproceedings.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 059-chomp · 历史背景
密集轨迹优化的变量成本瓶颈
- 068-isam2 · 模块组合
增量版复用后端工具
- 093-toppra · 平行方法
选路径与时间参数化互补任务
仍需留意
- 本轮核II-D插值、IV-A先验、表I的成功率及成功条件耗时;原稿增量iGPMP2表II各项结果未逐项重新核验。
机器人经典Structure-from-Motion Revisited部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:无序照片中的错误怎样避免沿增量重建连锁传播
- 二、依次改进选图、三角化与束调整
- 三、注册相机并重检旧点,用局部错误检查传播
- 四、分开读注册完整性、点数、误差与耗时
- 五、保留纹理、初始对与几何退化限制
- 六、追问:三角化点加入后,为什么后续视角可能迫使它被拆分或重建?
- 七、比较无序重建与时序SLAM
- 八、自测与参考答案
段落怎样重新安排
- 二、问题定义 → 一、问题设定:无序照片中的错误怎样避免沿增量重建连锁传播
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:沿着错误传播链逐段改进 → 四、分开读注册完整性、点数、误差与耗时
把可视证据与实验条件/证据局限放在同一节
- 三、方法:沿着错误传播链逐段改进 → 三、注册相机并重检旧点,用局部错误检查传播
把求解机制与每步执行顺序分开检验
- 三、方法:沿着错误传播链逐段改进 → 二、依次改进选图、三角化与束调整
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设置与预算 → 四、分开读注册完整性、点数、误差与耗时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五组结果怎样读 → 四、分开读注册完整性、点数、误差与耗时
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留纹理、初始对与几何退化限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、教学例子与前置概念 → 三、注册相机并重检旧点,用局部错误检查传播
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:无序照片中的错误怎样避免沿增量重建连锁传播
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、依次改进选图、三角化与束调整
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、依次改进选图、三角化与束调整
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟讲明白 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:三角化点加入后,为什么后续视角可能迫使它被拆分或重建?:三角化点加入后,为什么后续视角可能迫使它被拆分或重建?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Fig. 5:两面板将注册数量与位置误差分开:注册集合相近仍可能得到不同精度
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 7 页;裁切框为原页比例 (0.49, 0.087, 0.935, 0.171)
两面板将注册数量与位置误差分开:注册集合相近仍可能得到不同精度。覆盖评分帮助选择注册顺序,但曲线并未证明该代理等于严格的位姿协方差。
- 原论文图6:Dubrovnik轨迹外点比例分布与三角化抽样开销
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 7
左图是数据本身的外点分布,右图是不同策略的平均抽样数;两幅的横轴含义不同。
- 原论文图8:标准与分组Bundle Adjustment中的相机数随全局优化次数变化
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 8
纵轴是进入优化的相机数量;它解释工作量来源,却不是算法耗时的直接测量。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 5、表 2、图 6、表 1、图 8
查看本篇 5 个原文证据入口
- 图 5 · PDF 第 7 页,Figure 5
原站图表/证明入口
- 表 2 · PDF 第 8 页,Table 2
原站图表/证明入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
- 表 1 · PDF 第 8 页,Table 1
原站图表/证明入口
- 图 8 · PDF 第 8 页,Figure 8
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 补全多尺度网格的原文权重与占据计数
- 新增100聚集点与4分散点的评分手算
- 用局部信息矩阵解释代理分数不等于协方差保证
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 5、表 2、图 6、表 1、图 8
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- demuc.de · 所列章节
4.2选图评分、图5顺序实验、表1至2
- demuc.de · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 048-sift · 模块组合
COLMAP以SIFT局部特征建立候选图像对应,再交给几何验证和重建模块。
- 049-five-point · 模块组合
两视图几何模块
- 089-orbslam2 · 平行方法
无序离线SfM与在线SLAM平行任务
仍需留意
- 本轮核4.2选图、图5协议、表1至2及图8文字说明;原稿Quad的0.85/0.89/1.01米数值未在本轮文本中独立定位,未将新增教学评分当作该实验的复现。
机器人经典ORB-SLAM2: an Open-Source SLAM System for Monocular, Stereo and RGB-D Cameras部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:双目和RGB-D怎样接入原有单目SLAM架构
- 二、统一观测表达,区分近点远点的信息
- 三、运行局部与全局优化,检查米制尺度来源
- 四、按传感器模式读跨场景实验
- 五、保留纯单目尺度、标定与稀疏地图边界
- 六、追问:把RGB-D深度转成虚拟右图坐标后,是否意味着其噪声就与真实双目相同?
- 七、加入惯性和多地图,或转向稠密表面
- 八、自测与参考答案
段落怎样重新安排
- 二、问题定义与背景 → 一、问题设定:双目和RGB-D怎样接入原有单目SLAM架构
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:统一输入并保留不同信息强度 → 三、运行局部与全局优化,检查米制尺度来源
把求解机制与每步执行顺序分开检验
- 三、方法:统一输入并保留不同信息强度 → 二、统一观测表达,区分近点远点的信息
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验设计与公平性 → 四、按传感器模式读跨场景实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、五组关键结果 → 四、按传感器模式读跨场景实验
把可视证据与实验条件/证据局限放在同一节
- 五、五组关键结果 → 四、按传感器模式读跨场景实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与边界 → 五、保留纯单目尺度、标定与稀疏地图边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、具体例子与前置概念 → 三、运行局部与全局优化,检查米制尺度来源
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:双目和RGB-D怎样接入原有单目SLAM架构
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、统一观测表达,区分近点远点的信息
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、统一观测表达,区分近点远点的信息
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、统一观测表达,区分近点远点的信息 / 五组关键结果 → 四、按传感器模式读跨场景实验
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
- 二、方法中的具体例子与前置概念 → 三、运行局部与全局优化,检查米制尺度来源
把可检查的亮度、插值或双目数值例子接在实现后,五项前置概念原文完整保留
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:把RGB-D深度转成虚拟右图坐标后,是否意味着其噪声就与真实双目相同?:把RGB-D深度转成虚拟右图坐标后,是否意味着其噪声就与真实双目相同?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Table I:同一序列中同时检查相对平移误差和绝对 RMSE,两种指标可能给出相反排序
实验/结果图 · 必要原图摘引 · Table I,PDF 第 6 页;裁切框为原页比例 (0.51, 0.07, 0.93, 0.285)
同一序列中同时检查相对平移误差和绝对 RMSE,两种指标可能给出相反排序。KITTI 01 说明双目可完成单目困难场景,但并非每一列都比对照更低。
- 原论文图3:KITTI 01中近点和远点的彩色特征跟踪画面
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 6
绿色点以立体基线倍数定义为近点,蓝色点更远;颜色并非跟踪正确与错误的标签。
- 原论文图5:KITTI 08单目与双目估计轨迹分别对照真值
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 7
黑色为估计轨迹、红色为真值;左右使用不同传感信息,不能解释成只替换了优化器。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 IV、表 I、图 3、表 II、表 III
查看本篇 5 个原文证据入口
- 表 IV · PDF 第 9 页,Table IV
原站图表/证明入口
- 表 I · PDF 第 6 页,Table I
原站图表/证明入口
- 图 3 · PDF 第 6 页,Figure 3
原站图表/证明入口
- 表 II · PDF 第 7 页,Table II
原站图表/证明入口
- 表 III · PDF 第 8 页,Table III
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导虚拟左右坐标共享误差的协方差
- 新增视差方差0.25与错误独立假设2.25的手算
- 区分原实现权重、几何统一与深度尺度补偿
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 IV、表 I、图 3、表 II、表 III
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
III-A观测与近远点、III-B权重、IV实验协议;各数值表未全核
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 082-orbslam · 直接继承
本篇承接前作:架构与特征系统直接承接
- 098-orbslam3 · 直接继承
后作扩展惯性和多地图
- 084-elasticfusion · 平行方法
RGB-D稠密与稀疏地图选择
仍需留意
- 本轮核III-A/B观测和权重、IV评测协议与KITTI近远点解释;原稿全部KITTI、EuRoC和RGB-D数值表未逐项重新核验。
机器人经典SE-Sync: A Certifiably Correct Algorithm for Synchronization over the Special Euclidean Group部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:位姿候选怎样用目标下界检验全局最优
- 二、由半正定松弛走到低秩求解与证书
- 三、恢复可行位姿,检查上界和下界是否闭合
- 四、分开读证书成功、代价与计算时间
- 五、保留噪声模型、松弛紧致性和错误关联
- 六、追问:把所有位姿图信息权重同时乘正常数,最优位姿和证书间隙怎样变?
- 七、比较另一类可认证鲁棒估计
- 八、自测与参考答案
段落怎样重新安排
- 二、问题定义与前人局限 → 一、问题设定:位姿候选怎样用目标下界检验全局最优
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 三、方法:下界怎样变成证书 → 三、恢复可行位姿,检查上界和下界是否闭合
把求解机制与每步执行顺序分开检验
- 三、方法:下界怎样变成证书 → 二、由半正定松弛走到低秩求解与证书
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 四、实验如何验证 → 四、分开读证书成功、代价与计算时间
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 五、四组证据与不能推出的结论 → 四、分开读证书成功、代价与计算时间
把可视证据与实验条件/证据局限放在同一节
- 五、四组证据与不能推出的结论 → 四、分开读证书成功、代价与计算时间
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 六、贡献、代价与局限 → 五、保留噪声模型、松弛紧致性和错误关联
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 七、一个自构证书例子 → 三、恢复可行位姿,检查上界和下界是否闭合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 八、自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:位姿候选怎样用目标下界检验全局最优
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、由半正定松弛走到低秩求解与证书
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、由半正定松弛走到低秩求解与证书
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一、一分钟理解 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:把所有位姿图信息权重同时乘正常数,最优位姿和证书间隙怎样变?:把所有位姿图信息权重同时乘正常数,最优位姿和证书间隙怎样变?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“八、自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Table 1:先比较两方法的目标值,再看运行时间和次优性上界
实验/结果图 · 必要原图摘引 · Table 1,PDF 第 24 页;裁切框为原页比例 (0.1, 0.11, 0.89, 0.253)
先比较两方法的目标值,再看运行时间和次优性上界。这里相同最优目标支持速度与证书优势,证书的小数值不是轨迹的米制定位误差。
- 原论文图2:SE-Sync立方体实验中的目标值、计算时间与相对次优性上界十二面板
实验/结果图 · 必要原图摘引 · Fig. 2, PDF page 22
每行改变一种条件,每列分别报告目标值、计算时间与相对次优性上界;对数坐标和噪声范围必须同时保留。
- 原论文图3:六个SLAM基准数据集的全局最优解几何形状
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 23
六个子图对应不同图结构;几何外观本身并不构成最优性证明,证书仍来自论文的验证条件。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 1、图 2、图 3
查看本篇 3 个原文证据入口
- 表 1 · PDF 第 24 页,Table 1
原站图表/证明入口
- 图 2 · PDF 第 22 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 23 页,Figure 3
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从半正定乘子推导可验证下界与互补条件
- 新增二维双旋转的零代价证书
- 新增梯度为零但证书有负特征值的反例
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 1、图 2、图 3
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
问题6至7、附录C定理7;本轮未逐项复核原稿图2和表1
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 063-g2o · 历史背景
局部后端缺少全局证书的瓶颈
- 096-teaser · 平行方法
不同估计目标上的认证方法
仍需留意
- 本轮核问题6至7、附录C定理7和证书构造;原稿Cube曲线与表1耗时数值未逐项再次核验,长证明未全篇独立复证。
机器人经典Control Barrier Function Based Quadratic Programs for Safety Critical Systems列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:性能目标怎样在安全集合边界主动退让
- 二、把屏障导数变成允许控制集合
- 三、求带松弛性能项的QP,检查输入可行性
- 四、读巡航与车道仿真,保留连续模型条件
- 五、检查模型误差、采样延迟与安全初态
- 六、追问:名义QP可行而执行器实际饱和时,屏障证明的哪项前提需要重查?
- 七、区分屏障约束与有限时域接触约束
- 八、自测与参考答案
段落怎样重新安排
- 1.问题定义:需要守住的是状态集合 → 一、问题设定:性能目标怎样在安全集合边界主动退让
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 2.关键思想:内部可以靠近边界,边界上不能向外走 → 二、把屏障导数变成允许控制集合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 3.方法:把性能软化,把安全留作硬约束 → 三、求带松弛性能项的QP,检查输入可行性
把求解机制与每步执行顺序分开检验
- 3.方法:把性能软化,把安全留作硬约束 → 二、把屏障导数变成允许控制集合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 4.实验怎样验证 → 四、读巡航与车道仿真,保留连续模型条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 5.图里可以读出什么 → 四、读巡航与车道仿真,保留连续模型条件
把可视证据与实验条件/证据局限放在同一节
- 5.图里可以读出什么 → 四、读巡航与车道仿真,保留连续模型条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 6.贡献、代价与适用边界 → 五、检查模型误差、采样延迟与安全初态
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 7.一个可以手算的例子 → 三、求带松弛性能项的QP,检查输入可行性
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 8.自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:性能目标怎样在安全集合边界主动退让
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把屏障导数变成允许控制集合
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、把屏障导数变成允许控制集合
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、把屏障导数变成允许控制集合 / 图里可以读出什么 → 四、读巡航与车道仿真,保留连续模型条件
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:名义QP可行而执行器实际饱和时,屏障证明的哪项前提需要重查?:名义QP可行而执行器实际饱和时,屏障证明的哪项前提需要重查?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“8.自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 6:三面板一起检查横向位置、加速度与屏障函数:控制量受限时状态仍保持在模型规定的安全区域
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 15 页;裁切框为原页比例 (0.075, 0.07, 0.925, 0.232)
三面板一起检查横向位置、加速度与屏障函数:控制量受限时状态仍保持在模型规定的安全区域。它是给定模型的仿真,不包含感知失效或未知附着条件。
- 原论文图2:自适应巡航的速度、归一化加速度与安全约束量
实验/结果图 · 必要原图摘引 · Fig. 2, PDF page 11
左图比较速度跟踪,中图检查输入界,右图以安全约束量的非负性表示满足约束;三个指标需联合阅读。
- 原论文图4:不同自适应巡航二次规划下的速度和车辆间距比较
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 14
上图读跟踪性能,下图检查间距与安全边界;相近的速度轨迹可能对应不同的安全余量。
- 对应CBF-QP原图1的原创定理关系图:区分RBF到内部不变、ZBF到闭集不变、紧致条件下的逆命题,以及严格内指条件下的屏障构造
方法/设定图 · 原创教学图 · Fig. 1, PDF page 2; independent reconstruction from source equations/theorem statements
读图:第一组分别给出定理1的RBF充分条件和命题1的ZBF充分条件;第二组增加非空、紧致条件后,以命题3补上ZBF关系的反向结论,且定义域明确取D=C。第三组把原图中紧致且contractive条件下的关系,展开为定理2构造B=1/h及h,再由定理1得到内部正向不变;原图的条件性双向关系不能被读成无条件等价。图按原文定理陈述独立组织,保留Int(C)与C的区别;它尚不是含输入约束系统的可行性保证。
- RCBF与ZCBF在两种约束构造下的输入力对比
实验/结果图 · 必要原图摘引 · Figure 5, PDF p.14
上下面板分别采用保守和优化约束,输入曲线形状与速度/距离不同;在所示设置中更平滑的输入不是对任意扰动的统一保证。
未在正文展示的图/表与范围
- 表I:本轮逐Figure补齐范围外的表格引用;原文链接、页号和正文仍保留,未计入Figure完成率。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 5、表 I、图 2、图 4、图 6
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 6 个原文证据入口
- 图 1 · PDF 第 2 页,Figure 1
原站图表/证明入口
- 图 5 · PDF 第 14 页,Figure 5
原站图表/证明入口
- 表 I · PDF 第 14 页,Table I
原站图表/证明入口
- 图 2 · PDF 第 11 页,Figure 2
原站图表/证明入口
- 图 4 · PDF 第 14 页,Figure 4
原站图表/证明入口
- 图 6 · PDF 第 15 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导单CBF半空间的加权控制投影闭式
- 新增连续更新安全而两秒保持越界的算例
- 明确多约束可行性与连续反馈定理的实现条件
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 1、图 5、表 I、图 2、图 4、图 6
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
III-B推论2、IV-B定理3、V输入界、VI仿真
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 014-potential-field · 教学联系
代价避障与集合不变性的区别
- 094-cheetah-mpc · 平行方法
不同保证条件的约束控制
机器人经典VINS-Mono: A Robust and Versatile Monocular Visual-Inertial State Estimator部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:单目和IMU怎样完成可信启动并持续恢复定位
- 二、连接尺度重力初始化、预积分与视觉残差
- 三、运行滑窗和全局回环,检查各频率输出
- 四、把纯VIO精度与加入回环后的系统结果拆开
- 五、保留运动激励、标定和失效处理边界
- 六、追问:若长路线误差改善只在加入回环后出现,应该怎样定位收益来源?
- 七、比较视觉惯性系统的恢复与地图管理
- 八、自测与参考答案
段落怎样重新安排
- 1.背景与状态:估计什么,缺什么 → 一、问题设定:单目和IMU怎样完成可信启动并持续恢复定位
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 2.初始化:先找到一个可信的起点 → 二、连接尺度重力初始化、预积分与视觉残差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 3.局部估计:三类证据一起优化 → 四、把纯VIO精度与加入回环后的系统结果拆开
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 4.长期运行:局部窗口之外还需要什么 → 三、运行滑窗和全局回环,检查各频率输出
把求解机制与每步执行顺序分开检验
- 4.长期运行:局部窗口之外还需要什么 → 二、连接尺度重力初始化、预积分与视觉残差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 5.实验设计与比较条件 → 四、把纯VIO精度与加入回环后的系统结果拆开
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 6.结果:怎样避免把不同证据合成一个分数 → 四、把纯VIO精度与加入回环后的系统结果拆开
把可视证据与实验条件/证据局限放在同一节
- 6.结果:怎样避免把不同证据合成一个分数 → 四、把纯VIO精度与加入回环后的系统结果拆开
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 7.贡献与局限:系统完整性也是研究对象 → 五、保留运动激励、标定和失效处理边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 8.自构例子与前置概念 → 三、运行滑窗和全局回环,检查各频率输出
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 9.自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:单目和IMU怎样完成可信启动并持续恢复定位
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、连接尺度重力初始化、预积分与视觉残差
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、连接尺度重力初始化、预积分与视觉残差
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:若长路线误差改善只在加入回环后出现,应该怎样定位收益来源?:若长路线误差改善只在加入回环后出现,应该怎样定位收益来源?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“9.自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:9 幅
- Fig. 17:三条室内轨迹依次比较 OKVIS、无回环 VINS 和含回环 VINS
实验/结果图 · 必要原图摘引 · Fig. 17,PDF 第 13 页;裁切框为原页比例 (0.5, 0.063, 0.925, 0.43)
三条室内轨迹依次比较 OKVIS、无回环 VINS 和含回环 VINS。闭环后的起终点更一致表明全局约束发挥作用,不能由首尾闭合推断中间每一时刻都同样准确。
- 原论文图11:MH03序列中VINS、回环VINS、OKVIS和真值的轨迹比较
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 12
轨迹在同一平面坐标比较,回环后的全局修正与局部里程计漂移需区分。
- 原论文图12:MH03序列各轴平移误差及随路程变化的平移误差
实验/结果图 · 必要原图摘引 · Fig. 12, PDF page 12
上三幅横轴为时间、底图横轴为距离;不能将同一图上的不同横轴误读成同一采样序列。
- 原论文图13:MH05困难序列中多种估计器与真值的平面轨迹
实验/结果图 · 必要原图摘引 · Fig. 13, PDF page 12
在相同坐标轴看局部偏差与全局回环;单条轨迹没有表达跨重复运行的置信区间。
- 原论文图14:MH05序列的平移和旋转误差随行进距离变化
实验/结果图 · 必要原图摘引 · Fig. 14, PDF page 12
上下图单位不同;应同时比较平移与旋转,避免只据一种误差宣称全面更准确。
- 原论文图19:混合室内外序列中OKVIS、无回环VINS和回环VINS三种轨迹
实验/结果图 · 必要原图摘引 · Fig. 19, PDF page 14
红框指出跟踪丢失或错误估计区域;回环修正的全局一致性与局部跟踪稳定性是不同问题。
- 原论文图22:机载无回环VINS与OptiTrack真值的三维轨迹
实验/结果图 · 必要原图摘引 · Fig. 22, PDF page 15
三根坐标轴均以米计;轨迹重叠是该次机载实验的结果,不能替代更长序列的漂移统计。
- 原论文图23:无回环VINS相对OptiTrack的位置、姿态及对应误差时间序列
实验/结果图 · 必要原图摘引 · Fig. 23, PDF page 16
每一组同时保留估计量与误差;姿态角突变要联系角度表示和对应误差一起检查。
- 手机VINS和Tango在起点、开门干扰及终点的九面板比较
实验/结果图 · 必要原图摘引 · Figure 25, PDF p.16
左列是 VINS-Mobile 的 AR 画面,中列是 VINS-Mono 轨迹,右列是 Tango 轨迹;三行依次为起点、开门和结束。开门时 Tango 的偏航与轨迹明显跳变;走完约 264 m 后,VINS 通过闭环与四自由度位姿图优化回到起点,虚拟方块仍注册在原位置,而 Tango 最后一圈仍有漂移。作者同时承认 Tango 的局部状态估计更准确,这一例不能当作所有精度指标的全面领先。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 11、图 12、图 13、图 14、图 17、图 18、图 19、表 I、图 22、图 23、图 25、图 15、图 16
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 13 个原文证据入口
- 图 11 · PDF 第 12 页,Figure 11
原站图表/证明入口
- 图 12 · PDF 第 12 页,Figure 12
原站图表/证明入口
- 图 13 · PDF 第 12 页,Figure 13
原站图表/证明入口
- 图 14 · PDF 第 12 页,Figure 14
原站图表/证明入口
- 图 17 · PDF 第 13 页,Figure 17
原站图表/证明入口
- 图 18 · PDF 第 14 页,Figure 18
原站图表/证明入口
- 图 19 · PDF 第 14 页,Figure 19
原站图表/证明入口
- 表 I · PDF 第 14 页,Table I
原站图表/证明入口
- 图 22 · PDF 第 15 页,Figure 22
原站图表/证明入口
- 图 23 · PDF 第 16 页,Figure 23
原站图表/证明入口
- 图 25 · PDF 第 16 页,Figure 25
原站图表/证明入口
- 图 15 · PDF 第 13 页,Figure 15
原站图表/证明入口
- 图 16 · PDF 第 13 页,Figure 16
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 用视觉二阶差分推导米制尺度信息来源
- 新增加速可定尺度与恒速退化的手算
- 补充加速度偏置与尺度耦合解释初始化取舍
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 11、图 12、图 13、图 14、图 17、图 18、图 19、表 I、图 22、图 23、图 25、图 15、图 16
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
IV预积分、V-B初始化式14至20与重力参数化;IX数值未全核
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 083-imu-preintegration · 直接继承
本篇承接前作:承接预积分思想
- 098-orbslam3 · 平行方法
不同初始化和地图管理的视觉惯性系统
仍需留意
- 本轮核IV预积分、V-B初始化式14至20及重力参数化;原稿式23排版疑点及全部IX节实验图表未重新视觉复核。
机器人经典A New Approach to Time-Optimal Path Parameterization Based on Reachability Analysis列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:固定几何路径怎样安排仍能在终点停住的速度
- 二、以速度平方线性化约束,反向求可控集
- 三、在有后路的速度范围内前向选择
- 四、对照可行性、时间和有限网格误差
- 五、区分离散最优、连续安全与路径选择
- 六、追问:终点速度要求改变但路径不变,为什么不能只修改最后一个速度点?
- 七、区分路径定时与在线接触力规划
- 八、自测与参考答案
段落怎样重新安排
- 1.问题定义:路径与轨迹有什么不同 → 一、问题设定:固定几何路径怎样安排仍能在终点停住的速度
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 2.关键变换:为什么要用速度的平方 → 二、以速度平方线性化约束,反向求可控集
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 3.可达集与可控集:过去和未来的两种问题 → 二、以速度平方线性化约束,反向求可控集
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 4.算法:有后路的贪心 → 三、在有后路的速度范围内前向选择
把求解机制与每步执行顺序分开检验
- 4.算法:有后路的贪心 → 二、以速度平方线性化约束,反向求可控集
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 5.实验如何验证 → 四、对照可行性、时间和有限网格误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 6.五组证据怎样读 → 四、对照可行性、时间和有限网格误差
把可视证据与实验条件/证据局限放在同一节
- 6.五组证据怎样读 → 四、对照可行性、时间和有限网格误差
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 7.贡献、代价与局限 → 五、区分离散最优、连续安全与路径选择
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 8.一个手算例子 → 三、在有后路的速度范围内前向选择
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 9.自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:固定几何路径怎样安排仍能在终点停住的速度
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、以速度平方线性化约束,反向求可控集
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、以速度平方线性化约束,反向求可控集
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解:路线选好了,还要决定什么时候到哪里 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:终点速度要求改变但路径不变,为什么不能只修改最后一个速度点?:终点速度要求改变但路径不变,为什么不能只修改最后一个速度点?
教法来源与实际阅读范围
- Kevin M. Lynch、Frank C. Park · Modern Robotics 9.4 Time-Optimal Time Scaling
路径参数s及其导数、代入动力学后m(s)sddot+c(s)sdot²+g(s)
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“9.自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:5 幅
- Fig. 3:横轴增加约束不等式数量,纵轴是每网格点的平均求解时间,不含设置与解提取
实验/结果图 · 必要原图摘引 · Fig. 3,PDF 第 7 页;裁切框为原页比例 (0.09, 0.418, 0.47, 0.614)
横轴增加约束不等式数量,纵轴是每网格点的平均求解时间,不含设置与解提取。实线与线性、二次拟合虚线说明该实现的扩展性,不能直接替代整个时间参数化管线的总耗时。
- 原论文图2:TOPP-RA与TOPP-NI的关节速度、加速度和路径速度六面板
实验/结果图 · 必要原图摘引 · Fig. 2, PDF page 7
A、B、C列依次展示不同运动量;比较红色限位与曲线,而不是只比较完成时间。
- 原论文图4:约束不等式数变化时TOPP-RA与TOPP-NI的成功率
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 7
横轴增加约束数量;接近100%的柱形仅覆盖图中这组测试实例与实现。
- 原论文图5:网格大小对成功率、约束误差及运动代价差的三个面板
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 7
三个面板依次报告成功率、相对约束误差、相对近似最优运动代价的差;后两幅采用对数纵轴,代价差不是计算耗时。
- 原论文图6:腿式机器人接触受力约束下的动作快照、路径速度和接触力
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 9
A列把时刻对应到姿态,B列比较路径速度与接触力;接触约束使可行域随路径变化,接触力不是关节力矩。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、表 I、图 5、图 6、表 II
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 6 个原文证据入口
- 图 2 · PDF 第 7 页,Figure 2
原站图表/证明入口
- 图 3 · PDF 第 7 页,Figure 3
原站图表/证明入口
- 表 I · PDF 第 6 页,Table I
原站图表/证明入口
- 图 5 · PDF 第 7 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 9 页,Figure 6
原站图表/证明入口
- 表 II · PDF 第 8 页,Table II
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导双端插值检查的连续违反上界Mh²/8
- 新增端点合法但中点超限且网格减半误差降四倍的例子
- 将离散可行性与原文网格误差实验对应
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 2、图 3、表 I、图 5、图 6、表 II
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
III-C可控集、算法1、附录D插值误差及V网格实验
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 035-prm · 模块组合
路径规划可作为时间参数化输入
- 087-gpmp2 · 模块组合
几何轨迹可接时间分配
- 094-cheetah-mpc · 平行方法
固定路径时间分配与接触力MPC
机器人经典Dynamic Locomotion in the MIT Cheetah 3 Through Convex Model-Predictive Control部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:未来腾空阶段怎样提前影响当前接触力
- 二、固定接触计划,以简化刚体模型建立凸QP
- 三、滚动更新支撑力并连接摆腿控制
- 四、读多步态、扰动与奔跑实机证据
- 五、保留接触计划、状态估计和旋转近似
- 六、追问:把落脚时刻也开放为决策变量,为什么不能继续直接宣称原问题仍为同一凸QP?
- 七、重新开放接触决策,或保留全身一致性
- 八、自测与参考答案
段落怎样重新安排
- 1.问题定义:优化地面反力,不学习一套策略 → 一、问题设定:未来腾空阶段怎样提前影响当前接触力
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 2.模型为什么要简化 → 二、固定接触计划,以简化刚体模型建立凸QP
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 3.优化问题:提前看见将来哪些脚不能用 → 三、滚动更新支撑力并连接摆腿控制
把求解机制与每步执行顺序分开检验
- 3.优化问题:提前看见将来哪些脚不能用 → 二、固定接触计划,以简化刚体模型建立凸QP
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 4.实验设计:一个平台,多种动态行为 → 四、读多步态、扰动与奔跑实机证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 5.结果与证据强度 → 四、读多步态、扰动与奔跑实机证据
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 6.贡献、代价与局限 → 五、保留接触计划、状态估计和旋转近似
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 7.一个自构例子 → 四、读多步态、扰动与奔跑实机证据
把可视证据与实验条件/证据局限放在同一节
- 7.一个自构例子 → 三、滚动更新支撑力并连接摆腿控制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 8.自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:未来腾空阶段怎样提前影响当前接触力
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、固定接触计划,以简化刚体模型建立凸QP
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、固定接触计划,以简化刚体模型建立凸QP
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
- 原摘要的实验结果前置在方法开头,且与第四节重复;合并到具体试验条件和数值旁,保留全部范围限定。;内容保留于最高 3 m/s 是硬件结果;第 V-F 节提到的 6 m/s 来自提高腿速后的全多体仿真,两者不能合并成“机器人跑到 6 m/s”。高速度失败还受到摆腿速度、跑步机宽度和机械问题影响。。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:把落脚时刻也开放为决策变量,为什么不能继续直接宣称原问题仍为同一凸QP?:把落脚时刻也开放为决策变量,为什么不能继续直接宣称原问题仍为同一凸QP?
教法来源与实际阅读范围
- Russ Tedrake · Underactuated Robotics: Trajectory Optimization
Direct Transcription、与shooting比较、连续离散化及双积分器精确例子
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“8.自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- 四足 MPC:在还能施力时,为腾空阶段做准备;这是本文自构的接触时序示意,不是 Cheetah 3 原实验
教学示意 · 原创教学图 · 本文原创手算/几何推导;自构例子,未运行
这是本文自构的接触时序示意,不是 Cheetah 3 原实验。黄色阶段没有地面控制力,预测的价值在于提前改变支撑期的角动量;原论文求解时间、扰动与高速实验图仍未补入。
未在正文展示的图/表与范围
- 图2:MIT DSpace正式作者稿下载10:49 UTC单次复查仍HTTP429,未取得与条目MD5匹配的原图文件;未绕过限流。已有原创教学图不替代原图。 独立检索又找到Patrick Wensing的ResearchGate公开作者上传页,但实际PDF下载403,未取得匹配文件,未绕过访问限制。
- 图4:MIT DSpace正式作者稿下载10:49 UTC单次复查仍HTTP429,未取得与条目MD5匹配的原图文件;未绕过限流。已有原创教学图不替代原图。 独立检索又找到Patrick Wensing的ResearchGate公开作者上传页,但实际PDF下载403,未取得匹配文件,未绕过访问限制。
- 图5:MIT DSpace正式作者稿下载10:49 UTC单次复查仍HTTP429,未取得与条目MD5匹配的原图文件;未绕过限流。已有原创教学图不替代原图。 独立检索又找到Patrick Wensing的ResearchGate公开作者上传页,但实际PDF下载403,未取得匹配文件,未绕过访问限制。
- 图7:MIT DSpace正式作者稿下载10:49 UTC单次复查仍HTTP429,未取得与条目MD5匹配的原图文件;未绕过限流。已有原创教学图不替代原图。 独立检索又找到Patrick Wensing的ResearchGate公开作者上传页,但实际PDF下载403,未取得匹配文件,未绕过访问限制。
- 图8:MIT DSpace正式作者稿下载10:49 UTC单次复查仍HTTP429,未取得与条目MD5匹配的原图文件;未绕过限流。已有原创教学图不替代原图。 独立检索又找到Patrick Wensing的ResearchGate公开作者上传页,但实际PDF下载403,未取得匹配文件,未绕过访问限制。
- 图9:MIT DSpace正式作者稿下载10:49 UTC单次复查仍HTTP429,未取得与条目MD5匹配的原图文件;未绕过限流。已有原创教学图不替代原图。 独立检索又找到Patrick Wensing的ResearchGate公开作者上传页,但实际PDF下载403,未取得匹配文件,未绕过访问限制。
- 图10:MIT DSpace正式作者稿下载10:49 UTC单次复查仍HTTP429,未取得与条目MD5匹配的原图文件;未绕过限流。已有原创教学图不替代原图。 独立检索又找到Patrick Wensing的ResearchGate公开作者上传页,但实际PDF下载403,未取得匹配文件,未绕过访问限制。
原 PDF 本轮访问返回 429;控制系统图 2 与第 V 节图 4、5、7–10 的原实验图仍未取得,PDF 页序未核实。原创接触时序图不能代替求解时间、扰动和高速运动结果。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 为正文讨论的原图保留在线阅读器入口,明确当前像素访问限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 1 个原文证据入口
本轮边界:本轮原 PDF 直取失败,仅重新核查公开原稿转录正文/图注;原图像素和精确 PDF 页序未验证;本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 展开两步状态凝聚与严格凸性条件
- 新增支撑后腾空需要提前施力的数值推导
- 明确输入力上限下参考可能不可达
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 为正文讨论的原图保留在线阅读器入口,明确当前像素访问限制
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- dspace.mit.edu · 未能读取
本次web与本地下载均未获得PDF正文
- www.scribd.com · 所列章节
可读镜像原稿IV-C、IV-D式27至32及V硬件实验,非平台自动摘要
- dspace.mit.edu · 摘要
MIT官方记录核题名作者与概要
技术关系
- 080-wholebody-qp · 平行方法
全身一致性与快速简化模型取舍
- 072-contact-implicit · 平行方法
接触搜索与固定接触序列的区别
仍需留意
- MIT直链本次无法读取;方法和实验依据可读镜像中的原稿正文,未从图形估计额外精确数值;官方摘要不能替代该实验正文。
- 本轮原 PDF 直取失败,仅重新核查公开原稿转录正文/图注;原图像素和精确 PDF 页序未验证
机器人经典LeGO-LOAM: Lightweight and Ground-Optimized Lidar Odometry and Mapping on Variable Terrain部分核验,边界见下
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:地面车怎样筛掉昂贵又不稳定的激光特征
- 二、用距离图分割,再分阶段估计运动
- 三、提取地面和平面边缘,检查自由度分工
- 四、读植被场景漂移与计算量对照
- 五、保留地面先验、投影配置与几何退化
- 六、追问:地面提取失败时,为什么不能只把第一阶段误差留给第二阶段自然修正?
- 七、在激光建图中进一步紧耦合惯性
- 八、自测与参考答案
段落怎样重新安排
- 1.背景与问题:小平台上的 LOAM 为什么吃力 → 一、问题设定:地面车怎样筛掉昂贵又不稳定的激光特征
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 2.方法第一步:把点云变成有组织的距离图 → 二、用距离图分割,再分阶段估计运动
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 3.方法第二步:筛选有几何意义的特征 → 二、用距离图分割,再分阶段估计运动
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 4.方法第三步:为什么分成两次优化 → 三、提取地面和平面边缘,检查自由度分工
把求解机制与每步执行顺序分开检验
- 4.方法第三步:为什么分成两次优化 → 二、用距离图分割,再分阶段估计运动
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 5.实验怎样设计 → 四、读植被场景漂移与计算量对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 6.结果:把准确、快速与回环分别看 → 四、读植被场景漂移与计算量对照
把可视证据与实验条件/证据局限放在同一节
- 6.结果:把准确、快速与回环分别看 → 四、读植被场景漂移与计算量对照
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 7.贡献与局限:先验的价值与价格 → 五、保留地面先验、投影配置与几何退化
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 8.自构例子与前置概念 → 三、提取地面和平面边缘,检查自由度分工
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 9.自测:三个问题与参考答案 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:地面车怎样筛掉昂贵又不稳定的激光特征
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用距离图分割,再分阶段估计运动
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、用距离图分割,再分阶段估计运动
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 二、用距离图分割,再分阶段估计运动 / 结果:把准确、快速与回环分别看 → 四、读植被场景漂移与计算量对照
纠正原结果段夹在推导中的位置;实验条件、数值与其证据限制整块迁移到图前,方法末保留依赖说明
- 一分钟理解:不是所有激光点都值得参与匹配 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:地面提取失败时,为什么不能只把第一阶段误差留给第二阶段自然修正?:地面提取失败时,为什么不能只把第一阶段误差留给第二阶段自然修正?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“9.自测:三个问题与参考答案”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题意、顺序和答案全文均保留;既有v2新增就地图表链接及表号空格造成Markdown差异,去链接并规范空格后逐题相同。
正文配图:5 幅
- Fig. 7:同一人行道片段把地图与横截面并排比较:LOAM 的高度漂移与 LeGO-LOAM 的地面约束效果更容易在侧视中辨认
实验/结果图 · 必要原图摘引 · Fig. 7,PDF 第 6 页;裁切框为原页比例 (0.075, 0.27, 0.93, 0.416)
同一人行道片段把地图与横截面并排比较:LOAM 的高度漂移与 LeGO-LOAM 的地面约束效果更容易在侧视中辨认。局部结构改善不等于整段长路线没有累计误差。
- 原论文图4:植被场景中LOAM与LeGO-LOAM提取的边缘和平面特征
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 5
实景与两套特征投影对应同一植被环境;特征几何稳定性需要结合后续地图结果判断。
- 原论文图5:同一植被环境中LOAM与LeGO-LOAM的地图比较
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 5
白箭头标记同一棵树在LOAM地图中的重复出现;这是该序列的关联失败示例。
- 原论文图9:LOAM与LeGO-LOAM在两种计算平台上十次运行的轨迹
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 7
四个面板同时分开算法与平台因素,重叠程度展示重复运行差异;不能只选一条最好的轨迹。
- 原论文图10:KITTI闭环测试的LeGO-LOAM地图和真值轨迹对照
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 8
左图用高度着色地图,右图并列估计轨迹与真值;这一闭环测试的轨迹接近,不意味着所有路段误差都相同。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 4、图 7、表 III、表 IV、图 10、表 V
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
查看本篇 6 个原文证据入口
- 图 4 · PDF 第 5 页,Figure 4
原站图表/证明入口
- 图 7 · PDF 第 6 页,Figure 7
原站图表/证明入口
- 表 III · PDF 第 7 页,Table III
原站图表/证明入口
- 表 IV · PDF 第 7 页,Table IV
原站图表/证明入口
- 图 10 · PDF 第 8 页,Figure 10
原站图表/证明入口
- 表 V · PDF 第 8 页,Table V
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 推导平面点残差的三个强约束与三个零空间方向
- 新增三点雅可比求高度横滚俯仰的手算
- 联系表III区分迭代次数与每步特征处理成本
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 把孤立证据定位表改成图/机制解释段,保留对应限制
- 将具体图表引用连接到已核对的原稿页面:图 4、图 7、表 III、表 IV、图 10、表 V
- 逐列复查原证据表语义,明确哪些结论不能推出;避免限制项被误读为肯定结论
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- personal.stevens.edu · 所列章节
III-D两阶段LM、IV表III与IV计算实验
- personal.stevens.edu · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 077-loam · 直接继承
本篇承接前作:承接快里程计慢建图架构
- 097-liosam · 直接继承
后作发展雷达建图并紧耦合惯性
仍需留意
- 本轮核III-D和表III–IV的两阶段迭代与耗时条件;原稿各路线首尾误差及全部10次回放统计未逐项重新核验。
机器人经典TEASER: Fast and Certifiable Point Cloud Registration列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:大量错误对应下怎样分解变换并检查鲁棒解
- 二、利用不变量分离变量,再求截断估计和证书
- 三、执行筛选与求解,用错误对应检查目标含义
- 四、读外点比例、几何与时间的联合条件
- 五、区分数学认证、物理对应和噪声承诺
- 六、与连续扫描局部配准互补
- 七、自测与参考答案
段落怎样重新安排
- 问题定义:先写清楚输入承诺 → 一、问题设定:大量错误对应下怎样分解变换并检查鲁棒解
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把困难拆成可检查的步骤 → 三、执行筛选与求解,用错误对应检查目标含义
把求解机制与每步执行顺序分开检验
- 方法:把困难拆成可检查的步骤 → 二、利用不变量分离变量,再求截断估计和证书
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验应该怎样读 → 四、读外点比例、几何与时间的联合条件
把可视证据与实验条件/证据局限放在同一节
- 实验应该怎样读 → 四、读外点比例、几何与时间的联合条件
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、代价和适用边界 → 五、区分数学认证、物理对应和噪声承诺
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构检查与五个前置概念 → 三、执行筛选与求解,用错误对应检查目标含义
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三问三答 → 七、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:大量错误对应下怎样分解变换并检查鲁棒解
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、利用不变量分离变量,再求截断估计和证书
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、利用不变量分离变量,再求截断估计和证书
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 四、读外点比例、几何与时间的联合条件:在本文现有模型上补一段可逐步验算的单位、坐标或尺度推导,明确不是新增实验。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;另有 1 道正文追问,均有对应答案。
- 将末节标题改为“自测:三问三答”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。 正文进阶追问独立保留;其20bb192版本未给答案,v2已有的完整参考答案继续保留,不用末尾自测替代。
正文配图:3 幅
- Fig. 6:按列区分已知尺度、极端异常值与未知尺度,再按行比较旋转、平移、尺度误差与时间
实验/结果图 · 必要原图摘引 · Fig. 6,PDF 第 15 页;裁切框为原页比例 (0.075, 0.065, 0.94, 0.735)
按列区分已知尺度、极端异常值与未知尺度,再按行比较旋转、平移、尺度误差与时间。鲁棒区域与计算成本要共同读,合成异常值比例不能替代任意真实错误对应分布。
- 原论文图10:八个场景中TEASER++认证和未认证解的旋转误差散点
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 17
蓝点带有算法证书但并非都贴近零误差;对称场景会让数学最优与语义配准正确性分离。
- 原论文图11:Hotel3淋浴间点云真值和TEASER++估计的俯视、侧视对照
实验/结果图 · 必要原图摘引 · Fig. 11, PDF page 17
左右相似几何可支持接近180度的错误姿态;证书验证既定目标,不排除数据本身的歧义。
未在正文展示的图/表与范围
- 表II:本轮逐Figure补齐范围外的表格引用;原文链接、页号和正文仍保留,未计入Figure完成率。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
4 / 4 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 II、图 6、图 10、图 11
- 给四面体/对称方格实验的开放追问补上独立进阶答案和可检验条件
- 保持前置概念所在原段连续不变,将新增参考答案放在相邻进阶检查段
- 收紧原图访问说明并保留原前置概念段连续性
查看本篇 4 个原文证据入口
- 表 II · PDF 第 17 页,Table II
原站图表/证明入口
- 图 6 · PDF 第 15 页,Figure 6
原站图表/证明入口
- 图 10 · PDF 第 17 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 17 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从反三角不等式推导尺度可行区间和短基线代价
- 新增三个尺度观测的全局标量TLS手算
- 解释自适应投票比较代价而非只数票
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 II、图 6、图 10、图 11
- 给四面体/对称方格实验的开放追问补上独立进阶答案和可检验条件
- 保持前置概念所在原段连续不变,将新增参考答案放在相邻进阶检查段
- 收紧原图访问说明并保留原前置概念段连续性
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
V差分噪声界、VII算法2、XI表II及CERT分母与硬件线程条件
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 021-horn · 历史背景
正确对应最小二乘到高外点鲁棒估计
- 006-ransac · 平行方法
抽样与确定性子问题分解
- 100-kissicp · 平行方法
全局初始化与局部连续配准不同任务
机器人经典LIO-SAM: Tightly-coupled Lidar Inertial Odometry via Smoothing and Mapping列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:扫描时序与惯性偏差怎样进入同一轨迹约束
- 二、连接预积分、激光、GPS与回环因子
- 三、交替去畸变和估计,检查约束信息来源
- 四、按是否使用GPS回环与惯性读精度结果
- 五、保留时间同步、标定与异常全局观测风险
- 六、追问:加入GPS后漂移变小,怎样验证不是把额外全局信息误称为激光前端改进?
- 七、比较因子图平滑与迭代滤波
- 八、自测与参考答案
段落怎样重新安排
- 为什么一帧点云可能是一张歪地图 → 一、问题设定:扫描时序与惯性偏差怎样进入同一轨迹约束
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:把传感器误差放在同一个账本中 → 三、交替去畸变和估计,检查约束信息来源
把求解机制与每步执行顺序分开检验
- 方法:把传感器误差放在同一个账本中 → 二、连接预积分、激光、GPS与回环因子
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:准确性提升是否用了更多信息 → 四、按是否使用GPS回环与惯性读精度结果
把可视证据与实验条件/证据局限放在同一节
- 实验:准确性提升是否用了更多信息 → 四、按是否使用GPS回环与惯性读精度结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 原理有效的前提与实现代价 → 五、保留时间同步、标定与异常全局观测风险
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 用一个小实验建立理解 → 四、按是否使用GPS回环与惯性读精度结果
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三问三答 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:扫描时序与惯性偏差怎样进入同一轨迹约束
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、连接预积分、激光、GPS与回环因子
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解:两种传感器互相纠错 → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:加入GPS后漂移变小,怎样验证不是把额外全局信息误称为激光前端改进?:加入GPS后漂移变小,怎样验证不是把额外全局信息误称为激光前端改进?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“自测:三问三答”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Fig. 4:卫星参考与三种地图同列显示,在 Walking 数据中比较建筑边缘是否反复重影;这组结果没有使用 GPS
实验/结果图 · 必要原图摘引 · Fig. 4,PDF 第 6 页;裁切框为原页比例 (0.08, 0.06, 0.935, 0.277)
卫星参考与三种地图同列显示,在 Walking 数据中比较建筑边缘是否反复重影;这组结果没有使用 GPS。LIO-SAM 更整齐是此序列的定性证据,不能由地图观感得出每个时刻的定位误差。
- 原论文图3:旋转测试的实景、LOAM地图和LIO-SAM地图
实验/结果图 · 必要原图摘引 · Fig. 3, PDF page 5
上图给出场景结构,下两图检查旋转时几何是否保持一致;这是困难运动下的定性比较。
- 原论文图6:公园数据中多种估计轨迹及LIO-SAM地图配准结果
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 7
上图的GPS可用区间与各方法轨迹一起读,下图仅提供地理背景;地图对齐不等于逐点真值评估。
未在正文展示的图/表与范围
- 图2:平台组合照片对当前因子图与误差评论不是必要数据;另一个复合图含校园轨迹及 Google Earth 底图叠加,后者未核清完整 Google/数据提供商署名。只展示轨迹面板不能算整幅图已完成,故保留完整图入口。
- 表I:本轮逐Figure补齐范围外的表格引用;原文链接、页号和正文仍保留,未计入Figure完成率。
- 表II:本轮逐Figure补齐范围外的表格引用;原文链接、页号和正文仍保留,未计入Figure完成率。
- 图5:平台组合照片对当前因子图与误差评论不是必要数据;另一个复合图含校园轨迹及 Google Earth 底图叠加,后者未核清完整 Google/数据提供商署名。只展示轨迹面板不能算整幅图已完成,故保留完整图入口。
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 2、表 I、图 3、图 4、表 II、图 5、图 6
查看本篇 7 个原文证据入口
- 图 2 · PDF 第 4 页,Figure 2
原站图表/证明入口
- 表 I · PDF 第 5 页,Table I
原站图表/证明入口
- 图 3 · PDF 第 5 页,Figure 3
原站图表/证明入口
- 图 4 · PDF 第 6 页,Figure 4
原站图表/证明入口
- 表 II · PDF 第 5 页,Table II
原站图表/证明入口
- 图 5 · PDF 第 7 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 7 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 新增两节点里程计与单GPS因子的解析平滑解
- 手算不同GPS方差如何改变当前及历史状态
- 将协方差门槛和Campus增量因子实验联系
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:图 2、表 I、图 3、图 4、表 II、图 5、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
III-C激光因子、III-D GPS、III-E回环、IV表II
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 095-legoloam · 直接继承
本篇承接前作:承接雷达建图路线
- 083-imu-preintegration · 模块组合
LIO-SAM把相邻关键帧间的高频IMU样本压为预积分因子,联合约束位姿、速度与偏置。
- 068-isam2 · 模块组合
LIO-SAM借助iSAM2增量更新含雷达、惯性、GPS和回环因子的图,使新增约束修正关联历史状态。
- 099-fastlio2 · 平行方法
滤波直接建图与平滑全局因子架构不同
机器人经典ORB-SLAM3: An Accurate Open-Source Library for Visual, Visual-Inertial and Multi-Map SLAM列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:跟踪断裂后怎样保留地图片段并在以后重接
- 二、联合惯性初始化与Atlas数据关联
- 三、管理新图与合并,检查尺度和参考系
- 四、按传感器与对齐方式读恢复和精度实验
- 五、保留标定、激励与可靠跨图关联要求
- 六、追问:两张地图各自残差很小,为什么不能仅据此允许合并?
- 七、比较多地图系统与雷达实时估计
- 八、自测与参考答案
段落怎样重新安排
- 背景:地图不只是最近两帧之间的位移 → 一、问题设定:跟踪断裂后怎样保留地图片段并在以后重接
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:用不同观测反复约束同一组未知量 → 三、管理新图与合并,检查尺度和参考系
把求解机制与每步执行顺序分开检验
- 方法:用不同观测反复约束同一组未知量 → 二、联合惯性初始化与Atlas数据关联
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验设计:先看对齐方法,再看小数点 → 四、按传感器与对齐方式读恢复和精度实验
把可视证据与实验条件/证据局限放在同一节
- 实验设计:先看对齐方法,再看小数点 → 四、按传感器与对齐方式读恢复和精度实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献与局限:恢复能力也有条件 → 五、保留标定、激励与可靠跨图关联要求
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自构实验与前置知识 → 四、按传感器与对齐方式读恢复和精度实验
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三问三答 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:跟踪断裂后怎样保留地图片段并在以后重接
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、联合惯性初始化与Atlas数据关联
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、联合惯性初始化与Atlas数据关联
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:两张地图各自残差很小,为什么不能仅据此允许合并?:两张地图各自残差很小,为什么不能仅据此允许合并?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“自测:三问三答”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:3 幅
- Fig. 5:不同颜色来自多次运行,融合后在同一参考系中叠加
实验/结果图 · 必要原图摘引 · Fig. 5,PDF 第 14 页;裁切框为原页比例 (0.17, 0.076, 0.85, 0.328)
不同颜色来自多次运行,融合后在同一参考系中叠加。历史地图增加了先验信息,因而这幅多会话结果不能与从零开始的单次运行当成相同输入比较。
- 原论文图4:EuRoC多序列十次运行的四组ATE误差热图
实验/结果图 · 必要原图摘引 · Fig. 4, PDF page 11
每格是一轮运行结果,颜色对应共同误差色标;同时观察重复波动与序列差异。
- 原论文图6:室外多会话双目惯性轨迹在卫星背景上的单会话与多会话对比
实验/结果图 · 必要原图摘引 · Fig. 6, PDF page 14
红、蓝轨迹对应不同会话处理方式;背景图用来定位,而定量精度仍须结合正文表格。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 II、图 4、表 IV、表 V、图 5、图 6
查看本篇 6 个原文证据入口
- 表 II · PDF 第 12 页,Table II
原站图表/证明入口
- 图 4 · PDF 第 11 页,Figure 4
原站图表/证明入口
- 表 IV · PDF 第 13 页,Table IV
原站图表/证明入口
- 表 V · PDF 第 13 页,Table V
原站图表/证明入口
- 图 5 · PDF 第 14 页,Figure 5
原站图表/证明入口
- 图 6 · PDF 第 14 页,Figure 6
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 澄清视觉残差中的Ti必须是机体到世界变换
- 推导地图合并时位置速度姿态与偏置的不同变换
- 新增缩放旋转地图的手算并区分成熟惯性地图约束
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 II、图 4、表 IV、表 V、图 5、图 6
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
V-B初始化、VI-A重力验证、VI-C融合、VII表II与对齐和重复协议
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 089-orbslam2 · 直接继承
本篇承接前作:架构与地图系统直接承接
- 092-vinsmono · 平行方法
完整VIO系统的平行路线
- 099-fastlio2 · 平行方法
关键帧优化与滤波架构对照
机器人经典FAST-LIO2: Fast Direct LiDAR-inertial Odometry列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:更多原始激光点怎样在实时预算内进入惯性融合
- 二、将迭代测量更新与增量地图索引配合
- 三、维护局部地图,检查原始点到局部平面的残差
- 四、分开评估估计模型与数据结构效率
- 五、保留表面近似、下采样与局部地图边界
- 六、追问:点数量很多但法向几乎相同,测量更新为什么仍会缺少方向信息?
- 七、比较纯激光基线与全局图约束
- 八、自测与参考答案
段落怎样重新安排
- 问题定义:里程计与完整 SLAM 的边界 → 一、问题设定:更多原始激光点怎样在实时预算内进入惯性融合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法一:惯性预测与几何更新 → 二、将迭代测量更新与增量地图索引配合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法二:地图不应每一帧推倒重建 → 三、维护局部地图,检查原始点到局部平面的残差
把求解机制与每步执行顺序分开检验
- 方法二:地图不应每一帧推倒重建 → 二、将迭代测量更新与增量地图索引配合
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:把估计效果和数据结构效果分开验证 → 四、分开评估估计模型与数据结构效率
把可视证据与实验条件/证据局限放在同一节
- 实验:把估计效果和数据结构效果分开验证 → 四、分开评估估计模型与数据结构效率
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 贡献、成本与容易过度解读的地方 → 五、保留表面近似、下采样与局部地图边界
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构实验与五个前置概念 → 四、分开评估估计模型与数据结构效率
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三问三答 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:更多原始激光点怎样在实时预算内进入惯性融合
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、将迭代测量更新与增量地图索引配合
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、将迭代测量更新与增量地图索引配合
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
专业解读如何用于本篇
- 六、追问:点数量很多但法向几乎相同,测量更新为什么仍会缺少方向信息?:点数量很多但法向几乎相同,测量更新为什么仍会缺少方向信息?
教法来源与实际阅读范围
- Frank Dellaert · Factor Graphs and GTSAM
§1后验分解、§2.1–2.5三位姿图/噪声/初值/优化与协方差近似
原论文校准:新段落对照原稿已核公式与证据边界;不新增原论文成绩、样本数、性能保证或历史优先权。本轮未声称逐篇重新取得全部原版PDF。 · 原文 · 原文 · 原文
新增算例和对照设计是教学构造;未运行的新实验不当作结果。现代教程的记号或算法变体不倒写为原论文贡献。
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“自测:三问三答”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:5 幅
- Fig. 11:翻滚动作的姿态、位置、角速度和速度曲线共同给出测试运动范围
实验/结果图 · 必要原图摘引 · Fig. 11,PDF 第 16 页;裁切框为原页比例 (0.5, 0.06, 0.935, 0.31)
翻滚动作的姿态、位置、角速度和速度曲线共同给出测试运动范围。图中峰值是这次机载演示的条件,不是所有激光雷达、点云几何和平台都适用的鲁棒性上界。
- 原论文图5:四种空间索引随树大小变化的每点查询和插入耗时
实验/结果图 · 必要原图摘引 · Fig. 5, PDF page 12
上下图分别是查询与插入,横轴为对数树规模;尖峰与平均趋势都影响在线处理预算。
- 原论文图8:FAST-LIO与FAST-LIO2每扫描处理耗时及地图点数时间序列
实验/结果图 · 必要原图摘引 · Fig. 8, PDF page 15
上图区分处理器与方法并保留平均线,下图给出地图规模增长;时间优势须连同硬件条件解释。
- 原论文图9:翻转实验的无人机、机载视图、外部视图与姿态示意
实验/结果图 · 必要原图摘引 · Fig. 9, PDF page 16
四面板给出急剧旋转的观测条件;模糊的机载画面不能单独证明激光惯性估计的误差大小。
- 原论文图10:翻转实验中FAST-LIO2重建点云与实验室实景并排比较
实验/结果图 · 必要原图摘引 · Fig. 10, PDF page 16
左图是重建结果、右图是场景照片;定性结构一致性与位姿时间序列需要一起判断。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 VII、表 III、图 5、表 IV、图 8、图 9、图 10、图 11
查看本篇 8 个原文证据入口
- 表 VII · PDF 第 15 页,Table VII
原站图表/证明入口
- 表 III · PDF 第 12 页,Table III
原站图表/证明入口
- 图 5 · PDF 第 12 页,Figure 5
原站图表/证明入口
- 表 IV · PDF 第 13 页,Table IV
原站图表/证明入口
- 图 8 · PDF 第 15 页,Figure 8
原站图表/证明入口
- 图 9 · PDF 第 16 页,Figure 9
原站图表/证明入口
- 图 10 · PDF 第 16 页,Figure 10
原站图表/证明入口
- 图 11 · PDF 第 16 页,Figure 11
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 从MAP正规方程推导状态维信息矩阵与逐点累加
- 新增同帧重复融合造成错误均值和过度自信的手算
- 解释迭代切空间与固定先验的关系并联系时间分解实验
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 VII、表 III、图 5、表 IV、图 8、图 9、图 10、图 11
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
II继承关系、IV-B3更新、表VII时间及点数线程分解
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 002-kalman · 历史背景
统计更新基础
- 097-liosam · 平行方法
滤波与平滑架构
- 100-kissicp · 平行方法
惯性直接配准与纯雷达简单基线
机器人经典KISS-ICP: In Defense of Point-to-Point ICP—Simple, Accurate, and Robust Registration If Done the Right Way列明范围已核验
第四版:叙事结构重编
从具体前作问题重新组织正文;以下列出实际章节与段落迁移。
查看本篇的新章节与迁移说明
现在的阅读路线
- 一、问题设定:经典点到点ICP怎样在连续扫描中形成可靠里程计
- 二、围绕预测误差安排去畸变采样和自适应阈值
- 三、运行局部地图配准,逐项检查基础组件
- 四、按原始或已去畸变输入拆开评测
- 五、保留短时运动、重叠和无全局校正限制
- 六、追问:要检验自适应阈值的作用,为什么不能同时改变下采样和运动预测?
- 七、带着传感器条件回看鲁棒配准与惯性融合
- 八、自测与参考答案
段落怎样重新安排
- 背景:连续扫描和任意配准不同 → 一、问题设定:经典点到点ICP怎样在连续扫描中形成可靠里程计
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 方法:围绕预测误差设计配准 → 三、运行局部地图配准,逐项检查基础组件
把求解机制与每步执行顺序分开检验
- 方法:围绕预测误差设计配准 → 二、围绕预测误差安排去畸变采样和自适应阈值
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 实验:已经去畸变的数据不能验证去畸变 → 四、按原始或已去畸变输入拆开评测
把可视证据与实验条件/证据局限放在同一节
- 实验:已经去畸变的数据不能验证去畸变 → 四、按原始或已去畸变输入拆开评测
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 新意、限制与可以迁移的研究思想 → 五、保留短时运动、重叠和无全局校正限制
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 一个自构实验与五个前置概念 → 四、按原始或已去畸变输入拆开评测
按照问题、推导、实现、证据、边界的依赖关系重排原文段落
- 自测:三问三答 → 八、自测与参考答案
原三题和参考答案整块保留,不充当新增正文追问
- 原一分钟概述 → 一、问题设定:经典点到点ICP怎样在连续扫描中形成可靠里程计
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、围绕预测误差安排去畸变采样和自适应阈值
将场景、机制和证据范围分别放回实际论证位置
- 原一分钟概述 → 二、围绕预测误差安排去畸变采样和自适应阈值
将场景、机制和证据范围分别放回实际论证位置
- 推导中代码紧随说明 → 对应执行代码之后
避免正文提前提及已移走的伪代码
- 一分钟理解:不是随便运行一次 ICP → 先接住前作的问题
把已有具体前作问题前移,成为本篇问题设定的入口。
合并的重复说明
- 重复的单行概述拆除;机制、证据与限定条件仍在相应正文;内容保留于问题设定/方法/证据/边界正文。
- 重复摘要不再作为独立模板;条件与代价由原问题和边界正文完整展开;内容保留于问题设定与边界正文。
新增 1 道与原自测不同的正文追问,均附参考答案。
原自测与既有答案、正文图片及出处保留。结构校验不等于独立复现实验。
从原论文展开公式与读图
- 六、追问:要检验自适应阈值的作用,为什么不能同时改变下采样和运动预测?:要检验自适应阈值的作用,为什么不能同时改变下采样和运动预测?
第三版:自测保留与阅读标准复核
文末 3 道自测均有参考答案;
- 将末节标题改为“自测:三问三答”,保留原有三个题目、顺序与全部答案。
与此前问答的对应
与20bb192相比,文末三题的题文、顺序和答案全文逐字保留。
正文配图:1 幅
- Tables V–VI:上表是 KITTI-raw 上不同去畸变方法的比较,同时列误差与频率;下表改变关联门限,列相对平移误差
实验/结果图 · 必要原图摘引 · Tables V–VI,PDF 第 7 页;两块原图按原上下顺序拼接,仅移除长图注;原页比例裁切框 [(0.505, 0.065, 0.935, 0.163), (0.505, 0.239, 0.935, 0.324)]
上表是 KITTI-raw 上不同去畸变方法的比较,同时列误差与频率;下表改变关联门限,列相对平移误差。恒速补偿在该协议有效,自适应门限的收益主要是省去逐场景挑参数,不能夸大成数量级精度提升。
未在正文展示的图/表与范围
仅摘引所列图/表,未托管整篇论文;未重新运行原实验或由图片反演数据。
第二版记录:问答与图证据
3 / 3 道本轮记录问题已有对应答案。含原有自测及本轮查到的进阶追问。
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、表 V、表 VI、表 IV
查看本篇 5 个原文证据入口
- 表 I · PDF 第 6 页,Table I
原站图表/证明入口
- 表 II · PDF 第 6 页,Table II
原站图表/证明入口
- 表 V · PDF 第 7 页,Table V
原站图表/证明入口
- 表 VI · PDF 第 7 页,Table VI
原站图表/证明入口
- 表 IV · PDF 第 7 页,Table IV
原站图表/证明入口
本轮边界:本轮为问答与原文定位复核,未运行代码、仿真或复现实验;未宣称全文逐页通读
本次深化
- 新增RMS与去均值标准差的0.2米手算反例
- 量化同角度误差在10米和100米处的不同门限需求
- 明确历史集合不遗忘及3倍尺度不等于校准置信区间
- 在一分钟理解后加入独有前作瓶颈与后续关系路线
- 移除开头阅读过程说明,将本篇版本与结论限制放到相关证据旁
- 将具体图表引用连接到已核对的原稿页面:表 I、表 II、表 V、表 VI、表 IV
- 正文内嵌 1 幅经目检的科学图/表,附具体读法、出处与图像核验记录。
查核资料
- arxiv.org · 所列章节
III-D运动修正尺度、III-E鲁棒配准、IV-B预去畸变评测及IV-C数据边界
- arxiv.org · 所列章节
v2 局部核对:逐项复核自测答案;按文章引用检查原稿 PDF 图注、文件页序与关联段落;仅这些章节与图注,不宣称全文重读或实验复现;具体图表入口与位置见 feedback_v2.verified_evidence
技术关系
- 028-icp · 直接继承
本篇承接前作:承接点到点ICP
- 099-fastlio2 · 平行方法
有无惯性信息的系统取舍
- 096-teaser · 平行方法
全局初始化与连续局部配准互补
机器人经典机器人经典基础总结:把几何、估计、规划与控制接成闭环部分核验,边界见下
本次深化
- 新增两连杆速度/力矩/功率0.7瓦的完整接口核算
- 从非完整速度约束解释几何路径与可执行运动不同
- 重新核对总结中RRT*后续证明问题的原作者摘要
- 新增到DMP学习系列的运动生成/低层跟踪接口路线
查核资料
- modernrobotics.northwestern.edu · 所列章节
同坐标表达下的雅可比功率对偶
- modernrobotics.northwestern.edu · 所列章节
非完整速度约束与不同车体控制集合
- arxiv.org · 摘要
复核所保留的RRT*后续证明缺口与替代连接尺度
- proceedings.neurips.cc · 所列章节
DMP原文第2节运动学策略假设与第3.1节逆动力学实机跟踪,支持跨系列接口辨析。
技术关系
- 004-resolved-rate · 教学联系
用同一雅可比连接关节速度与末端速度,并以转置力矩映射检查两端功率一致。
- 018-operational-space · 教学联系
力与惯性接口
- 043-rrt-connect · 教学联系
几何连接与非完整约束
- 093-toppra · 教学联系
合适路径的时间参数化
- 001-dmp · 模块组合
学习运动生成器输出参考,下层逆动力学和反馈另行承担可执行性;不把相似吸引子结构宣称为直接谱系。
仍需留意
- 未执行本篇提出的教学实验;各原始论文的证据缺口仍以单篇阅读范围为准。
机器人经典机器人经典基础:100篇论文的技术地图部分核验,边界见下
本次深化
- 将目录前的阅读建议改为四个具体故障问题驱动的链接路线
- 增加每篇可算检查值和反例条件的学习方法
- 明确摘要、章节、作者代码与教学例的证据层级
查核资料
- modernrobotics.northwestern.edu · 所列章节
雅可比与广义力的功率对偶推导
- jsturm.de · 所列章节
内在残差不等价于外部真值准确性
技术关系
- 00-reading-guide · 教学联系
统一坐标与误差接口入门
- 050-task-priority · 教学联系
受力方向问题的递进阅读
- 069-tum-rgbd · 教学联系
地图可视化与真值评估对照
- 093-toppra · 教学联系
路径到可执行轨迹
仍需留意
- 未执行本篇提出的教学实验;各原始论文的证据缺口仍以单篇阅读范围为准。